補足:大規模モデルの基礎知識
初めて大規模モデルをダウンロードしようとするとき、モデルページにある7B、32B、128K、INT4は混乱を招きやすいでしょう:7Bはモデルのサイズを示し、128Kは一冊の本を入れることができるのでしょうか、INT4はなぜモデルのVRAM使用量を減らせるのでしょうか。
実際にモデルを使い始めると、会議録が収まらない、長い会話で前の文脈が忘れられる、モデルの回答に根拠がない、同じモデルで量子化方法を変えると効果が変わるなどの問題に遭遇します。
特定のタスクにモデルが適しているかどうかを判断するには、テキストがどのようにモデルに入り、モデルの能力がどのように訓練され、推論時になぜメモリとVRAMを消費するのかを理解する必要があります。
この知識は3本の主要な流れに整理できます。1つ目はTransformerの全体構造から出発し、Token、Embedding、Attentionを見ることで、テキストがどのようにモデルに入り処理されるかを説明します。2つ目は事前訓練、指令微調整、および後訓練で、モデルの能力がどのように形成されるかを説明します。3つ目はコンテキスト長、KV Cache、量子化、ハードウェアで、モデルがターゲットデバイスで安定して実行できるかどうかを決定します。
本章の内容は、前面の関連章の基礎知識を抽出したものです。例えば、今回言及したモデル推論関連については第6章と第7章を参照できます。モデルSFTについては第9章で紹介されているModelScope搭載のms-swift微調整フレームワークを参照できます。後訓練関連の内容については、第10章で紹介されている偏好対強化学習の内容を参照できます。ドメインモデルの適用や幻覚問題などについては、第13章で紹介されているRAG方法を参照でき、外部知識を活用してドメイン内のQ&A効果を向上させ、さらにモデルの幻覚を軽減できます。
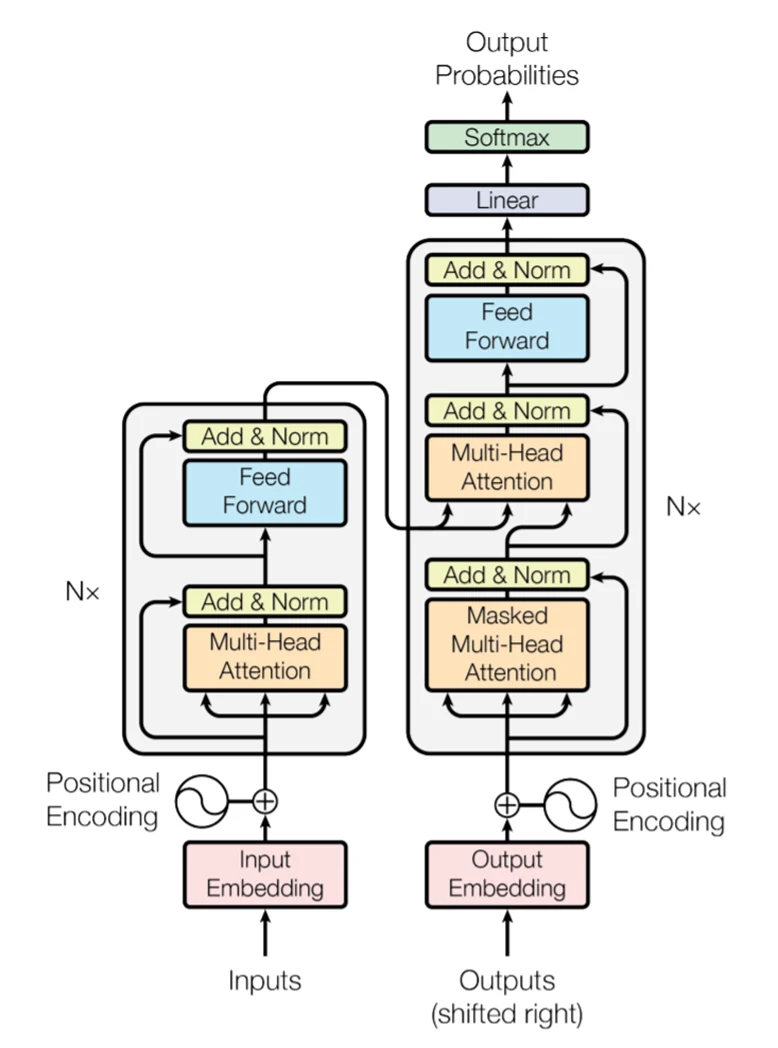
18.1 Transformerの基本構造 Transformerは現在のほとんどの大規模言語モデルが採用している基礎アーキテクチャです。以前の順次処理を行う再帰型ニューラルネットワークとは異なり、Transformerは訓練および入力処理段階で複数の位置を並列に計算し、Attentionを通じて異なる位置間の接続を確立します。古典的なTransformerはエンコーダーとデコーダーで構成されます。各Transformer層は通常、Attentionとフィードフォワードネットワークを含みます。フィードフォワードネットワークはFFNまたはMLPとも呼ばれ、各位置のベクトルに非線形変換を適用します。層内では残差接続と層正規化も使用され、情報が深いネットワークを安定して流れるのを助けます。多くの類似層が重ねられると、モデルは段階的に複雑なテキスト表現と生成能力を形成します。Transformerの全体アーキテクチャは以下の図に示されており、左側がエンコーダー、右側がデコーダーです。図中のN×は類似モジュールが複数回重ねられることを示し、実際の層数はモデルアーキテクチャとパラメータ規模によって異なります。
モデルが推論を行う際、ユーザーがテキストを入力すると、モデル内部では以下の処理が行われます:大規模モデルはテキストを処理する際、まずTokenizerによって生のテキストをTokenに分割し、対応するToken IDに変換します。次に、Embedding層がこれらの離散的なToken IDを連続的なベクトル表現にマッピングし、同時に位置情報を追加して、各Tokenが文中のどの順番にあるかをモデルに伝えます。その後、これらのベクトルは複数のTransformer層を通過して繰り返し処理されます。Attentionメカニズムは異なるToken間が相互に関連し、コンテキスト情報を交換するのを担当し、フィードフォワードネットワークは各位置の特徴をさらに加工します。複数の計算を経た後、モデルは現在のコンテキストの包括的な表現を取得し、これに基づいて次のTokenの確率分布を計算し、次のTokenを選択またはサンプリングし、コンテキストに追加してこのプロセスを繰り返し、全体の生成を完了します。
古典的なTransformerの3つの部分はそれぞれ異なる役割を持ちます:
- エンコーダー(Encoder-only)構造: 主に入力の理解を担当し、入力シーケンスの異なる位置を同時に参照でき、分類、抽出、意味表現などのタスクに適しています。
- デコーダー(Decoder-only)構造: 主に出力の生成を担当し、現在の位置を生成する際は既に出現した内容しか見ることができません。
- エンコーダー—デコーダー(Encoder-Decoder)構造: まず入力を理解し、次に段階的に出力を生成します。翻訳や要約などのシーケンス変換タスクで一般的です。
現代の大規模モデルは必ずしも完全なエンコーダーとデコーダーを同時に使用するわけではありません。この基盤の上で、Transformerに基づく複数のアーキテクチャが派生しています。例えば、GPT系の生成モデルは通常Decoder-only構造を採用し、BERT系のモデルは主にEncoder-onlyを使用し、T5系のモデルはEncoder-Decoder構造を維持しています。
18.2 Token:モデルによるテキスト処理の基本単位 Tokenは、モデルがテキストを読み取り、生成する際に使用する基本単位です。1つの漢字、1つの語、語の一部、句読点、または空白や特殊制御マーカーである場合があります。例えば、同じ文は異なるTokenizerで異なる結果になる場合があります:
原文:大型语言模型正在改变办公方式。

分词器A:大型 / 语言 / 模型 / 正在 / 改变 / 办公 / 方式 / 。
分词器B:大 / 型 / 语言 / 模型 / 正 / 在 / 改变 / 办公 / 方式 / 。
2つの結果は同じ文を表していますが、Token数は異なります。モデルが実際に受け取るのは各Tokenに対応する数字のID、すなわちToken IDです。会議録の整理を例にすると、モデルが見るのは完全な会議記録ではなく、Token IDの列です。会議名、発言内容、時刻、句読点、出力要件はすべてTokenを消費します。モデルが生成する要約、結論、アクション項目も同様にTokenを消費します。したがって、同じ資料で出力をより詳細に要求するほど、生の記録に割けるスペースが少なくなります。
レッスン 1 / 2 0%完了
lessons.completeLesson ✓
完全に文字で分割した場合、語彙は比較的小さくなりますが、シーケンスは長くなります。完全に単語単位で分割した場合、語彙は非常に巨大になり、新しい語、略語、スペル変異に絶えず遭遇します。大規模モデルは通常、部分語彙分割を採用し、文字と完全な単語の間でバランスを取ります。BPE、WordPiece、Unigram、SentencePieceはすべて一般的な方法です。
18.3 Embedding:コンテンツをベクトルに変換 通常、モデルはテキストや画像に対して直接行列演算を行うことはできません。コンテンツを数値ベクトルに変換する必要があります。このプロセスは埋め込みまたはベクトル表現と呼ばれます。テキストの場合、TokenizerがまずテキストをToken IDに変換し、Embedding層がIDに基づいて対応するベクトルを取得します。ベクトル内の単一の数には通常直感的な意味はありませんが、全体のベクトルはそのTokenのモデル内部での特徴を表現できます。Token「会議」を例にすると、対応するToken IDは「15872」のような整数番号であり、そのTokenに対応する表現、すなわちEmbeddingは[0.12, -0.37, 0.08, ……]のようなベクトルになります。Embeddingは訓練过程中で絶えず調整され、類似したコンテキストに出现するTokenのベクトルは、類似した特徴を形成する傾向があります。モデル構造や訓練過程が異なるため、同じ語も複数のTransformer層を処理された後、コンテキストに応じて異なる表現を形成します。
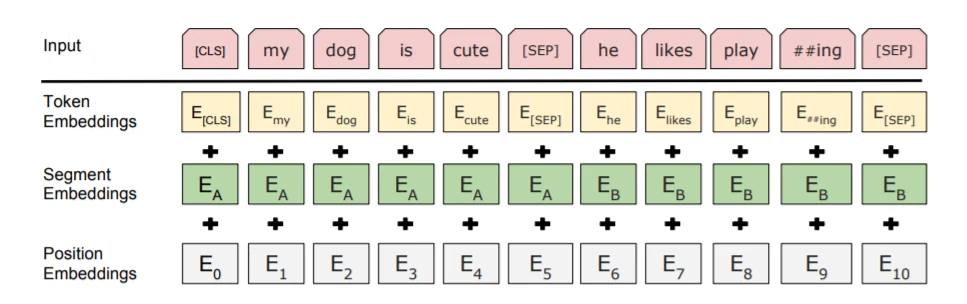
モデルが入力テキストの意味情報を取得する際、Tokenが何であるかだけでなく、それがどの位置にあるかを知る必要があります。Token Embeddingのみの場合、「会議延期」と「延期会議」は類似したTokenを含んでいますが、語順の違いにより異なる意味を表します。したがって、モデルには位置エンコーディングまたは位置表現の追加が必要です。以下の図はBERTの入力層を例にしています。
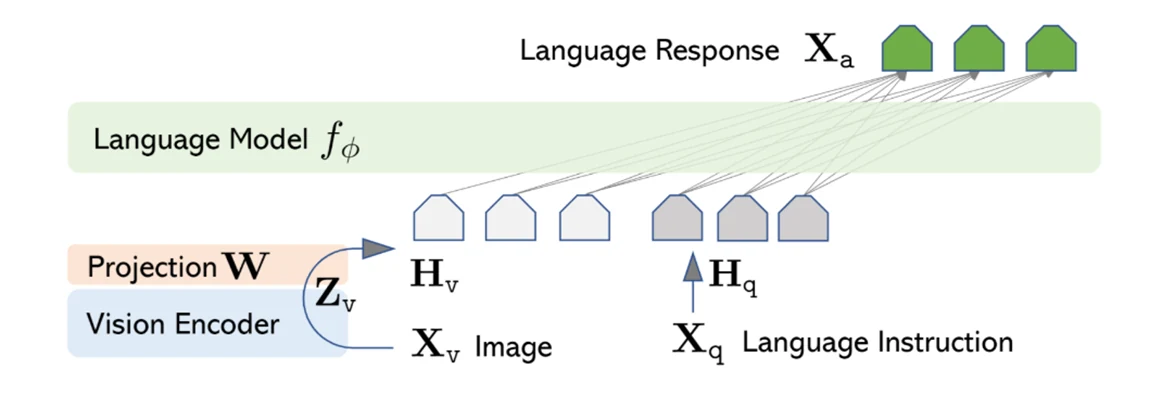
上記の図に示されているBERTの表現方法は、Token Embedding、セグメント Embedding、位置Embeddingの組み合わせ方法を示しています。もちろん、異なるモデル構造や設計方式では、採用される具体的な方法は完全には同じではありません。マルチモーダル大規模モデルを例にすると、画像や音声などのコンテンツもまずベクトルに変換されます。画像は通常、画像パッチャに分割され、視覚エンコーダーが特徴を抽出します。音声はまず音響特徴に変換され、その後オーディオエンコーダーが処理します。異なるモダリティの特徴は、プロジェクトまたは結合モジュール(Projection)を通過した後、大規模モデルが処理できるベクトル空間に入ります。以下の図に示すように、結合モジュールを通じて画像情報と意味情報を融合します。
18.4 Attention:入力間の関連性を計算 Attentionは、現在の位置が入力のどの部分に重点を置くべきかを判断します。これはモデルが既に形成したベクトル表現上で関連度を計算し、単に同じ単語を探すだけではありません。例えば、「プロジェクトが遅延し、報告書がなぜ期限内に完了しなかったかを説明した」という文で、モデルが代名詞「それ」を処理する際、コンテキストに基づいてそれが「プロジェクト」を指すのか「報告書」を指すのかを判断する必要があります。会議録で担当者を抽出する際、モデルはタスクの説明、人物名、分業を表す文を結びつける必要があります。
18.4.1 Q、K、VからAttentionを理解する 各入力ベクトルは異なる変換を経てQuery、Key、Valueを形成します。Attentionの計算式は以下のように簡略化できます:
$\mathrm{Attention}(Q, K, V)=\mathrm{softmax}\left(\frac{QK^{\mathrm{T}}}{\sqrt{d_k}}\right)V$
ここで、Qは現在の位置が何の情報を探しているかを表し、Kは各位置がどの特徴でマッチングできるかを表し、Vはマッチング後に取得する必要がある内容を表します。モデルはまずQとKを比較し、現在の位置と他の位置の間の関連スコアを取得します。次に、softmaxを通じてスコアを重みに変換し、重みに基づいてVを加重集計します。式中の$d_k$はKeyベクトルの次元であり、$\sqrt`$で割るのはスコアの尺度を調整し、計算をより安定させるためです。
Q、K、Vが同じシーケンスからの場合、自己注意力(Self-Attention)と呼ばれ、シーケンス内部の接続を確立するために使用されます。Qがあるシーケンスから、K、Vが別のシーケンスからの場合、クロス注意力(Cross-Attention)と呼ばれます。例えば、エンコーダー—デコーダー翻訳モデルは、デコーダーがクロス注意力を通じてエンコーダーが提供する原文情報を読むことができます。
生成型大規模モデルでは、現在の位置は既に出現した内容しか参照できないため、Attentionには因果マスクを追加し、後続の位置をブロックする必要があります。未来のTokenをブロックしても、完全な因果注意力が処理する関連数はシーケンス長に応じてほぼ二次関数的に増加します。同時に、生成段階では過去のTokenのKとVを保存し、後述するKV Cacheを形成します。コンテキストが長くなるにつれ、Attentionの計算とキャッシュのオーバーヘッドがますます顕著になり、以下で紹介する異なる構造はまさにこれらの問題に対処するために段階的に発展してきました。
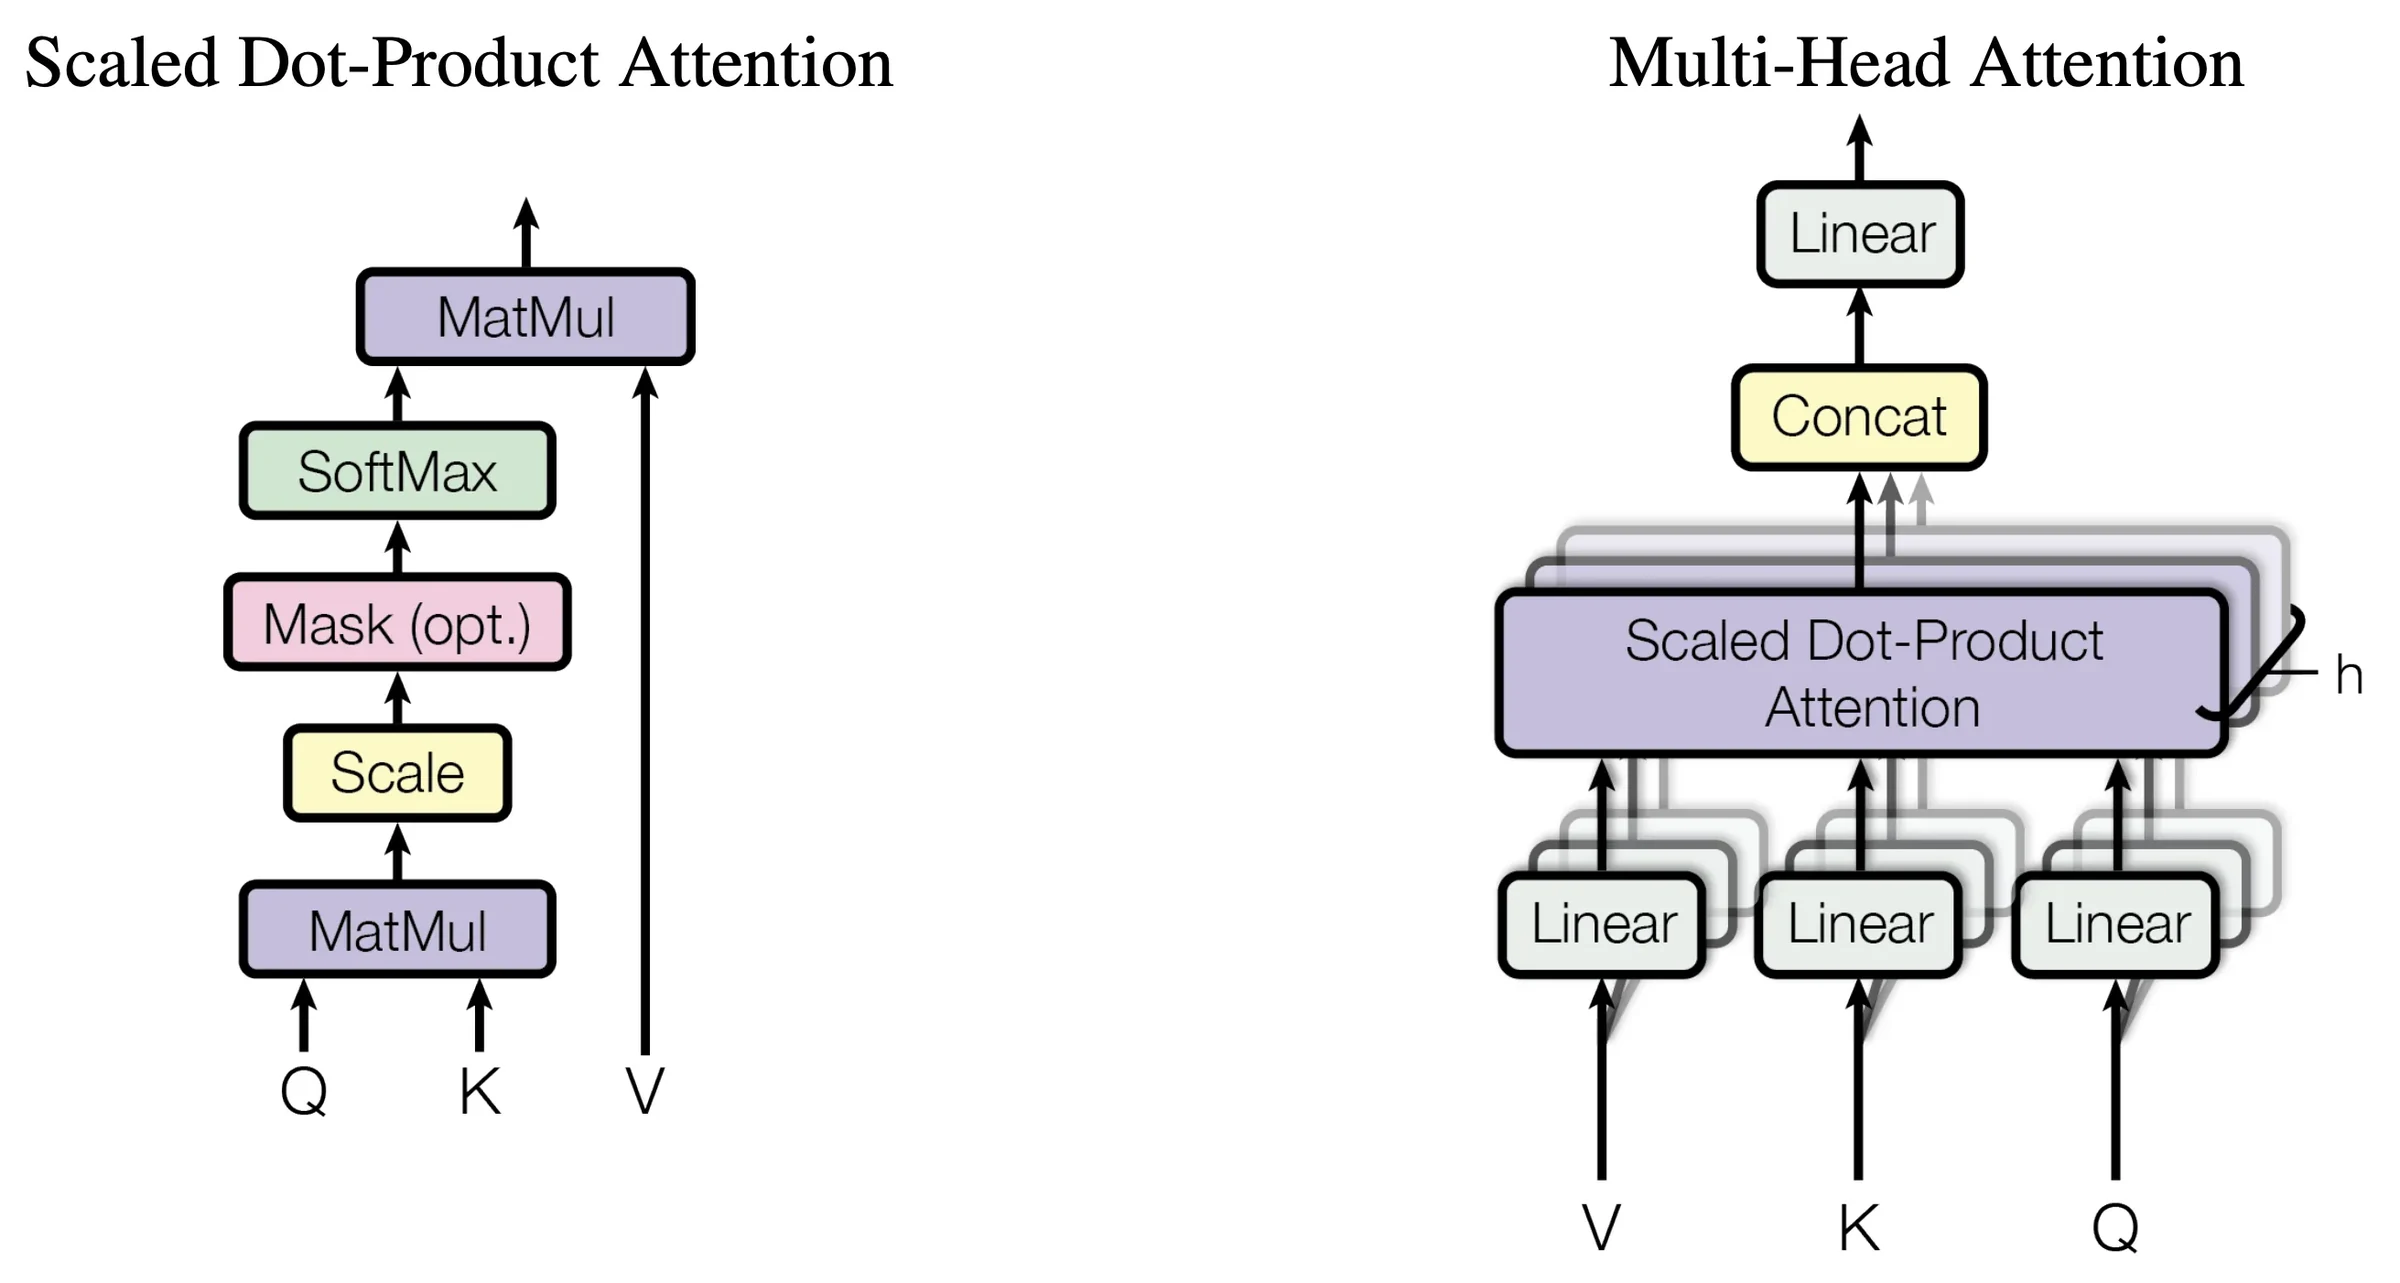
18.4.2 Multi-Head Attention(MHA) Multi-Head Attention(MHA)は2017年のTransformer論文「Attention Is All You Need」で提案され、BERTやLlama 2 7B、13Bなどのモデルに適用されました。単一の注意力計算の基盤に複数の並列な注意力ヘッドを追加することで、モデルが異なる表現空間からコンテキスト関係を抽出できるようにします。
MHAでは、各ヘッドが独自のQ、K、Vを生成する投影パラメータを持ち、それぞれ注意力を計算し、各ヘッドの結果を結合して線形層を通じて出力を形成します。以下の図に示すように、左側はスケーリングドット積注意力の計算プロセスを1セット示しており、右側はこのプロセスを複数回並列に実行し、結果を融合しています。異なるヘッドの注目パターンは訓練により形成され、照合判断、意味関係、長距離依存などのタスクを共同で支援できます。
MHAはモデルが異なるタイプの情報を集約する能力を向上させ、訓練中の並列計算も容易にします。ただし、Tokenごとの生成では、各ヘッドが自分の過去のK、Vを読む必要があります。モデルの層数、ヘッド数、コンテキスト長が増加すると、このキャッシュとデータの読み取りは大量のリソースを消費します。したがって、後の改善ではまず複数のQueryヘッドを維持しながら、保存する必要のあるKeyヘッドとValueヘッドを削減できるかどうかが検討されました。
18.4.3 Multi-Query Attention(MQA) Multi-Query Attention(MQA)はNoam Shazeerによって2019年の論文「Fast Transformer Decoding: One Write-Head is All You Need」で提案され、Falcon-7Bなどの大規模モデルに適用されました。これは主にデコーディング段階のメモリ帯域幅の問題を対象としています:モデルが新しいTokenを生成するたびに、既存のKV Cacheを読む必要があります。読み取り量が大きい場合、計算ユニットに余裕があっても、生成速度が制限されます。
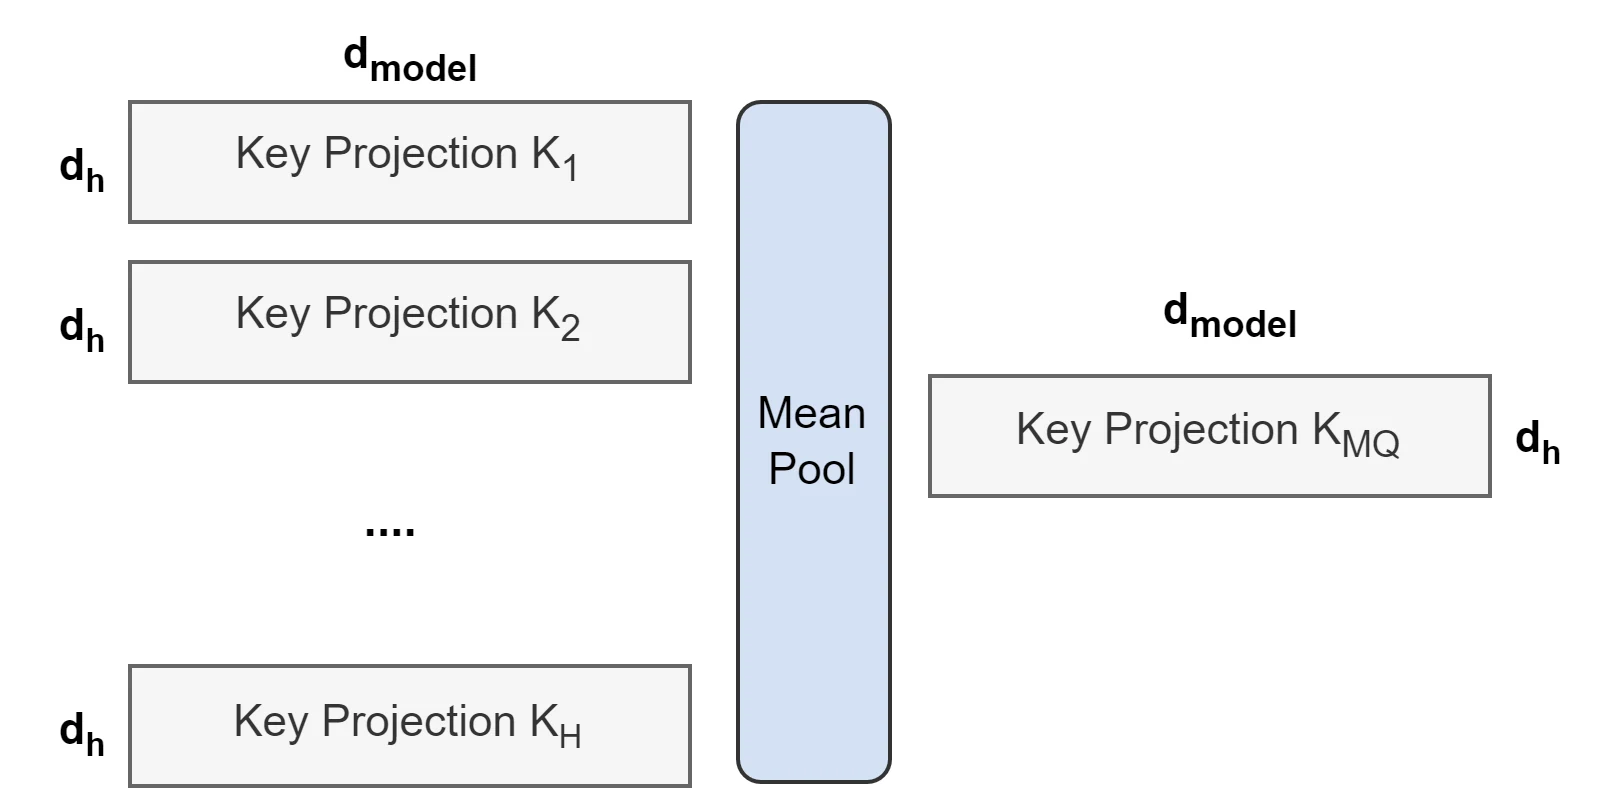
MQAは複数のQueryヘッドを維持しますが、KeyとValueの1セットを共有させます。这样、異なるヘッドは異なるクエリを生成できますが、過去の位置では各ヘッドが共用するK、Vを1つだけ保存すれば済みます。以下の図は、既存のMHAモデルをMQAに変換する際の初期化方法を示しています:複数のKey投影行列を平均化して共有投影を取得し、Value投影も同様に処理できます。変換後もさらに訓練を継続し、モデルを新しい共有構造に適応させます。
この構造を採用することで、MQAはKV Cacheとデコーディングごとのデータ読み取り量を大幅に削減でき、より長い入力やより多くの同時リクエストのためのスペースを空けることができます。例えば、Falcon-7Bは71個のQueryヘッドを持っていますが、KVヘッドは1つだけです。同じヘッド次元、同じ精度の71組のKV構造と比較すると、理論上のKVキャッシュは約71分の1で済みます。共有はK、Vの表現容量も制約するため、この効率的な利益がタスクの品質に与える影響を訓練と評価で確認する必要があります。
18.4.4 Grouped-Query Attention(GQA) Grouped-Query Attention(GQA)はGoogle Researchチームによって2023年のGQA論文で体系的に提案され、Llama 2 70B、Mistral 7Bなどの大規模モデルに適用されました。これはMHAの複数の表現能力とMQAの低いキャッシュオーバーヘッドの間でバランスを取ることを目指し、すべてのQueryヘッドが同じK、Vを使用することを回避します。
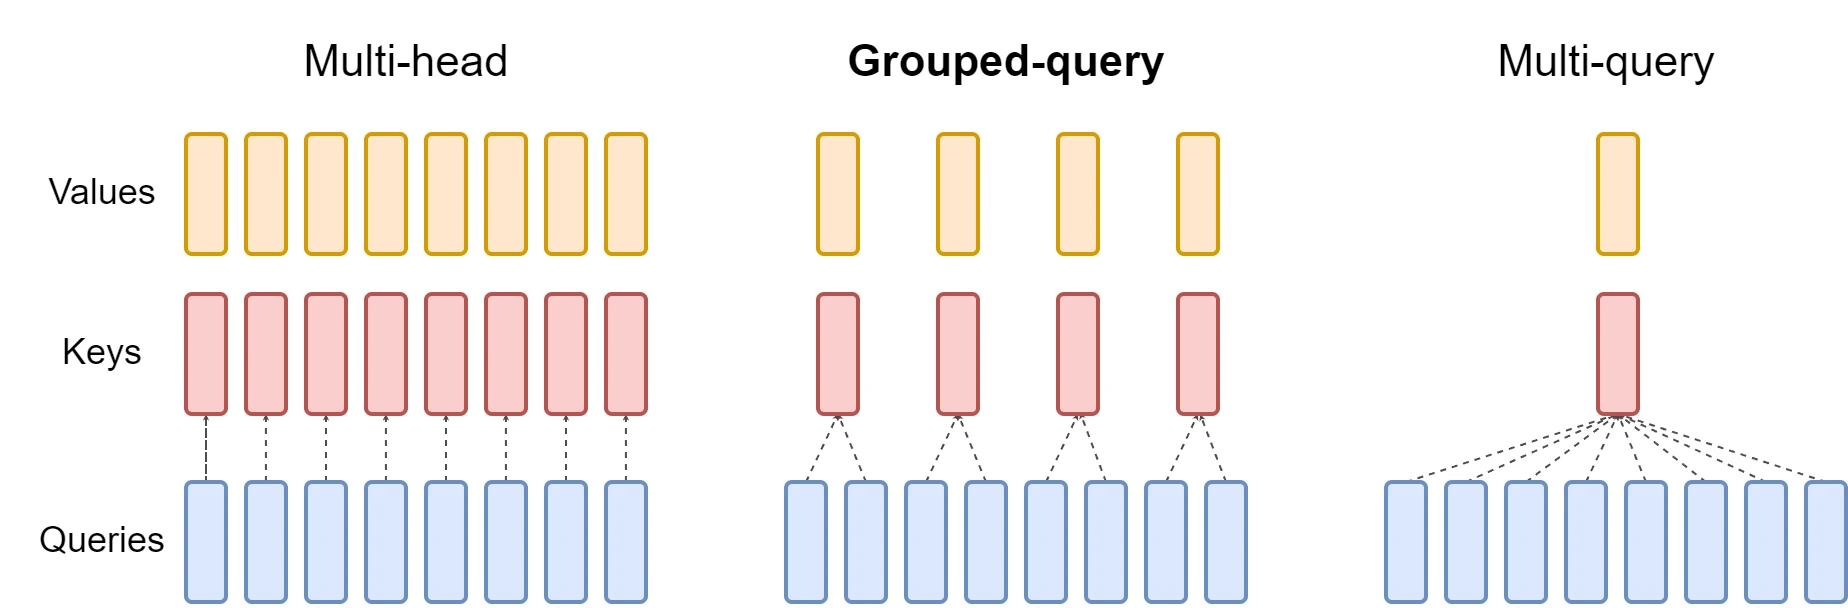
GQAはQueryヘッドを複数のグループに分割し、各グループがKeyとValueの1セットを共有し、異なるグループは異なるK、Vを保持します。以下の図に示すように、MHAは各QueryヘッドにK、Vを設定し、MQAはすべてのQueryヘッドが1セットのK、Vを共有し、GQAはグループ内で共有します。グループ数がQueryヘッド数に等しい場合、GQAはMHAと等価です。1つのみの場合はMQAと等価です。
Mistral 7B v0.1を例にすると、32個のQueryヘッドと8個のKVヘッドを持ち、4つのQueryヘッドごとに1セットのK、Vを共有します。ヘッド次元と精度が同じ場合、このキャッシュはMHAの約4分の1です。実際のデプロイメント而言、キャッシュと読み取り量の削減は通常、同時処理能力とデコーディング効率の向上に役立ちます。異なるグループが独自のK、Vを維持しているため、GQAは完全に共有するMQAよりも多くの表現空間を維持しています。削減されるのはKVヘッド数であり、モデルはアクセスが許可されているすべての過去の位置に引き続き注意力を計算できます。
18.4.5 Sliding Window Attention(SWA) Sliding Window Attention(SWA)は長シーケンスモデリングの局所的注意力の考え方に基づいており、Mistral 7B v0.1ではGQAと組み合わせて使用されています。GQAは各位置で保存する必要のあるKVヘッド数を削減し、SWAはさらに各位置が直接注目できる過去の範囲を制限し、長テキストの計算とキャッシュの負荷を軽減します。
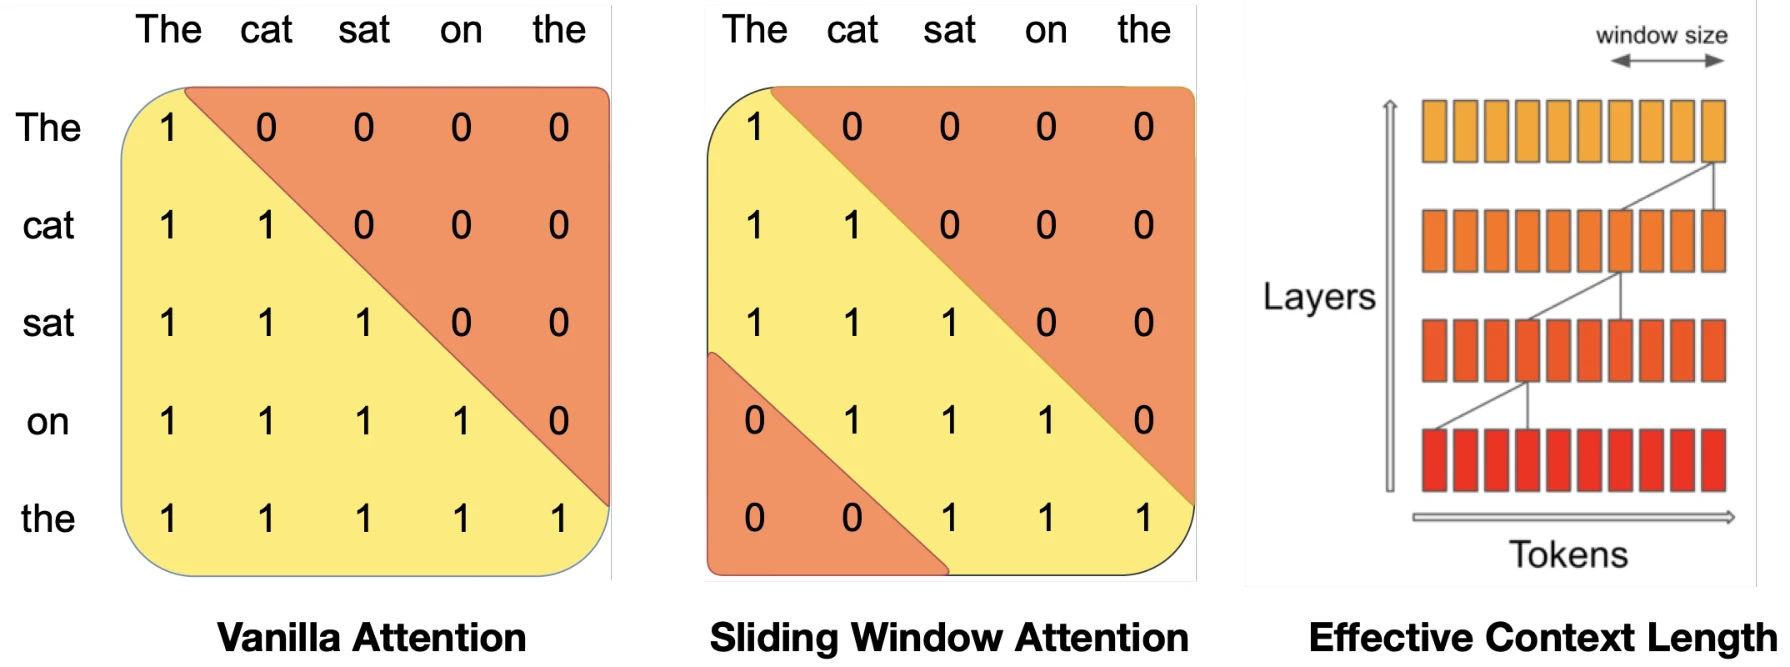
SWAは各Tokenに固定サイズのウィンドウを設定し、ウィンドウ内の最近の位置のみに注目して注意力を計算します。以下の図の左側は完全な因果注意力、中央はスライディングウィンドウ注意力、右側は情報が複数のネットワーク層を通じて後方にどのように伝達されるかを示しています。単一の層は局所範囲のみを読み取りますが、前の層のToken表現はより早期のコンテキスト情報を含んでいるため、モデルは複数の層を処理した後、間接的にウィンドウ外のコンテンツを利用できます。
Mistral 7B v0.1は4096個のTokenのウィンドウを採用し、各層のキャッシュが固定範囲に保たれるように、ウィンドウから移動した古いK、Vをローリングキャッシュで覆っています。論文は16Kシーケンス、4096ウィンドウのテストで、適切なカーネル最適化を経た後の速度が完全な注意力のベースラインの約2倍であることを報告しています。この構造は長テキストのリソース増加を制御できますが、遠くの生の詳細は中間表現を通過して伝達されるため、局所的なウィンドウサイズはモデルが正確に検索できるコンテキスト長と直接同等ではありません。
18.4.6 Multi-head Latent Attention(MLA) Multi-head Latent Attention(MLA)はDeepSeekチームによってDeepSeek-V2で提案され、 subsequently DeepSeek-V3でも使用されました。これはKV Cacheが大きすぎる問題も対象としていますが、キャッシュの保存形式をさらに変更します:緊密な結合表現を学習することで、各Tokenが保存する必要のあるデータを削減し、同時に複数の注意力ヘッドがこの情報を使用できるようにします。
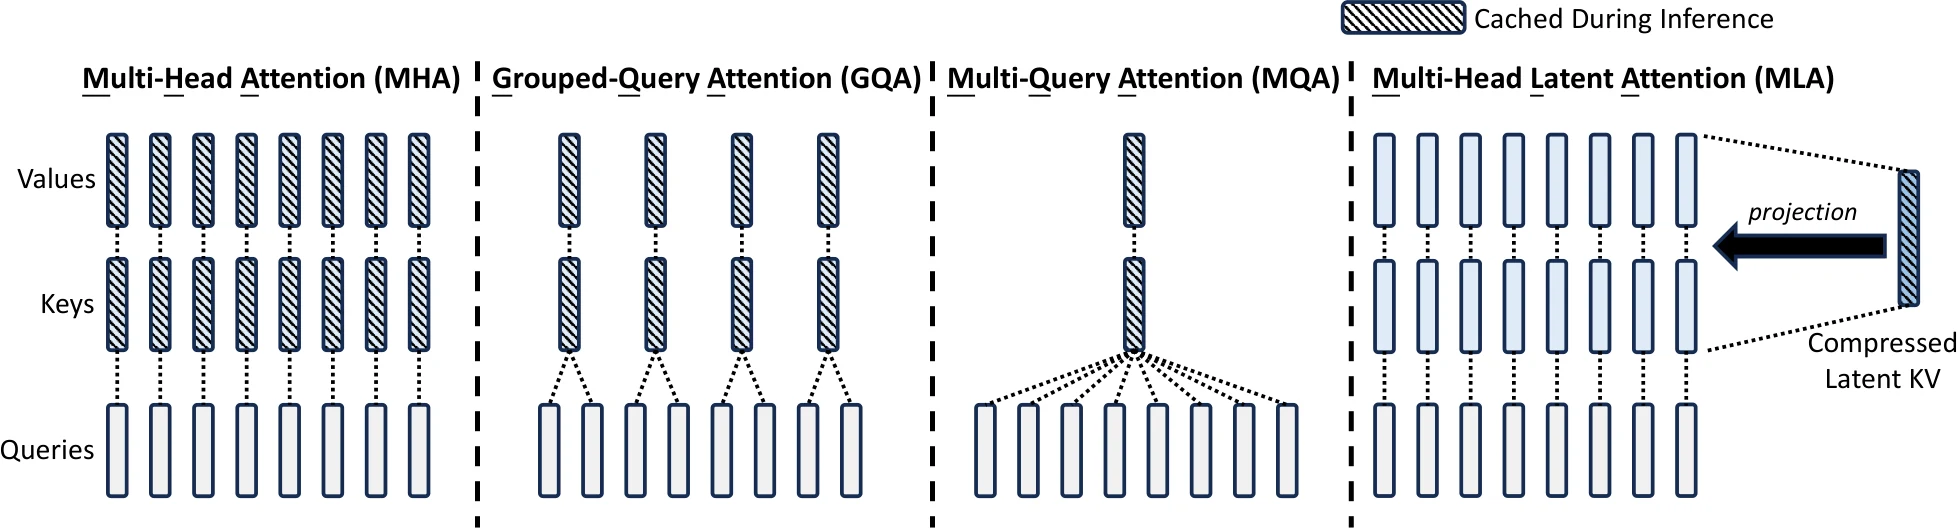
具体的には、MLAはまず低ランク投影を使用してKとVをより低次元の潜在ベクトルに結合表現し、推論時にはこのベクトルと、回転位置情報を単独で担うKey成分をキャッシュします。複数のQueryヘッドはこの共有表現を使用してマッチングと情報集約を完了でき、一部の投影行列は推論時に統合でき、完全なK、Vを明示的に展開する操作を削減できます。以下の図の斜線領域はキャッシュする必要がある内容を示しており、MLAが複数のヘッドのK、Vのキャッシュを右側のより小さな潜在表現に転移したことがわかります。
この設計により、DeepSeek-V2、V3は複数のヘッドの表現能力を維持しながら、長コンテキスト生成のキャッシュ圧力を軽減できます。DeepSeek-V2の報告では、MLAのTokenあたりのKVキャッシュ規模は2.25組のKVヘッドを持つGQAと同等です。これは各位置の表現次元を圧縮するものであり、過去の位置自体は維持されるため、完全な注意力モードでは、モデルは依然としてすべての過去のエントリを読み取り、マッチングする必要があります。実際に計算に参加するエントリをさらに削減するには、スパース注意力を導入する必要があります。
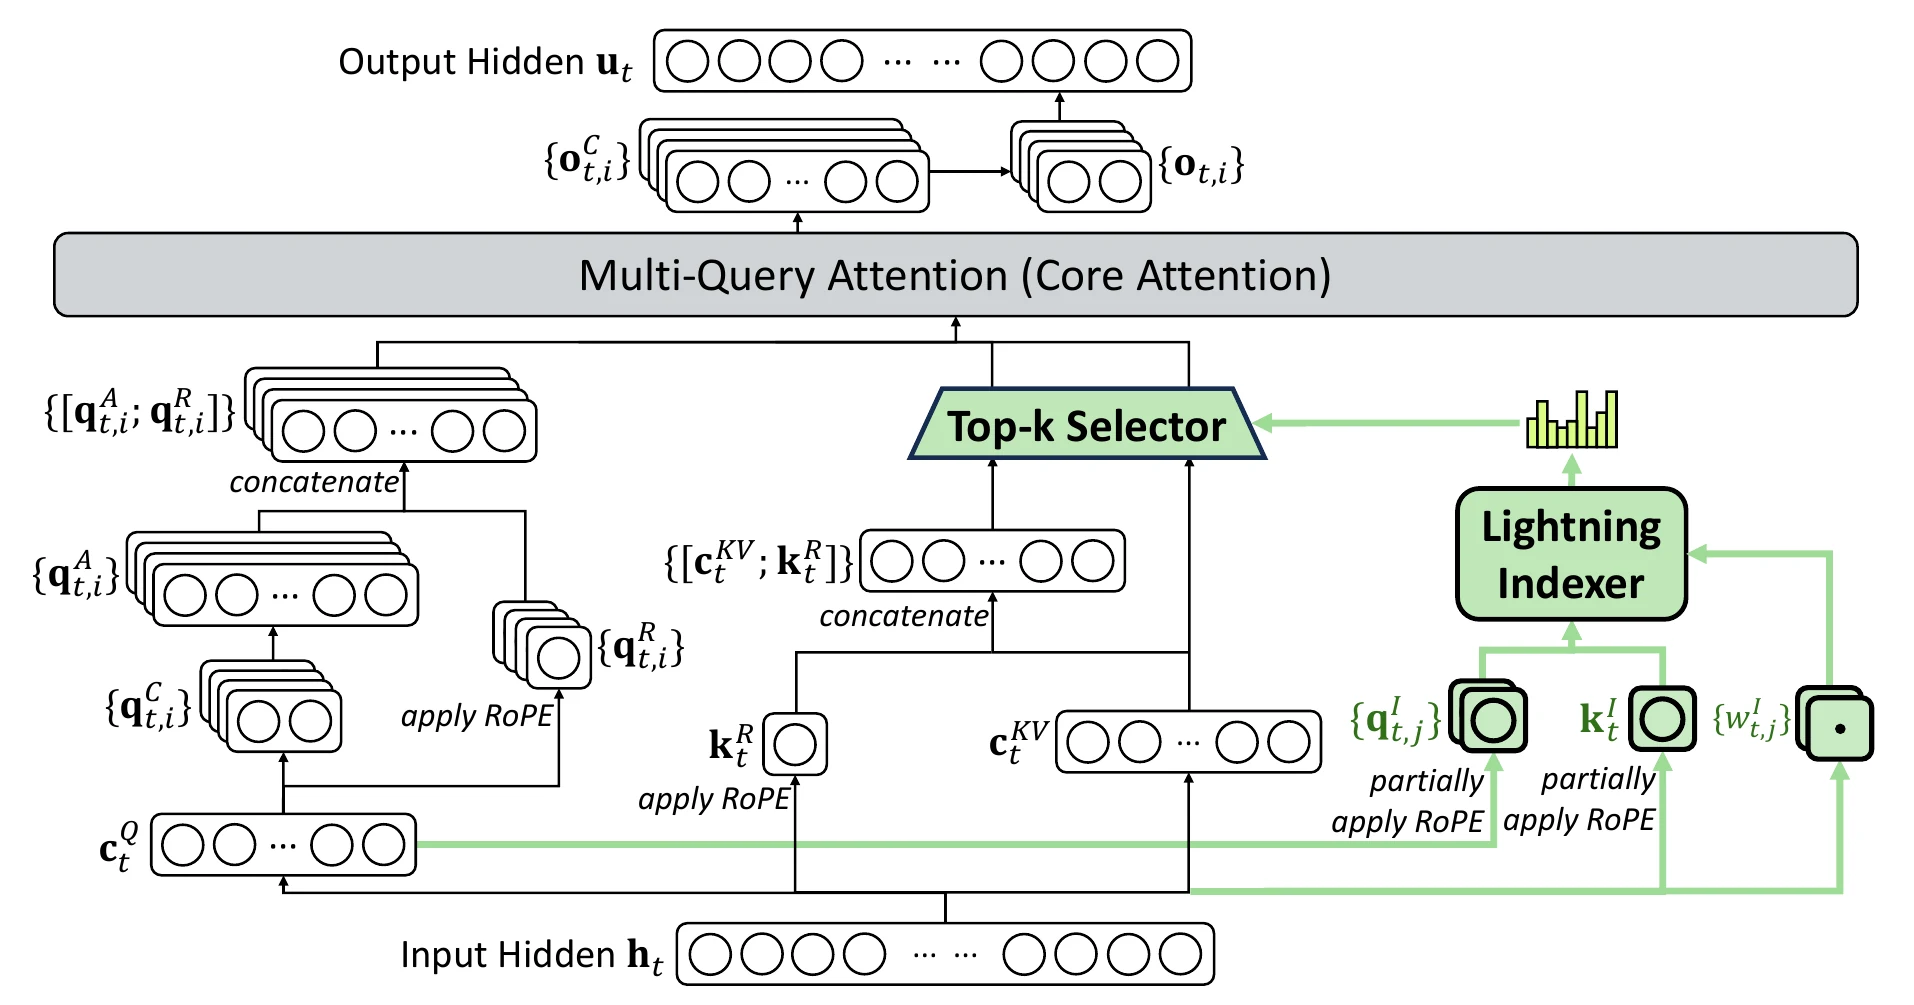
18.4.7 DeepSeek Sparse Attention(DSA) DeepSeek Sparse Attention(DSA)はDeepSeekチームによって提案され、DeepSeek-V3.2-ExpとDeepSeek-V3.2に適用されました。これはMLAの基盤に動的選択メカニズムを追加し、長コンテキストにおいて、単一のKVエントリが小さくても、すべての過去のエントリを読み取り計算することが依然として高コストであるという問題を解決します。
DSAはまずライトウェイトインデクサーLightning Indexerを使用して現在のQueryと過去のTokenの関連スコアを計算し、スコアの高いTop-k個の位置を取得して、メインAttentionに渡して計算を行います。以下の図の緑色部分は追加されたインデックスプロセスを示し、Top-k Selectorが位置を選択し、上部のコアAttentionは選択された位置に対応するMLAキャッシュを読み取ります。インデクサーはより小さな表現とより少ないヘッドで選別を行っており、計算コストは完全なメインAttentionを直接実行するよりも低いです。
DeepSeek-V3.2の報告書の構成は、各Queryが最大2048個のKVエントリを選択することです。コンテキストが増えるにつれ、コアAttentionはこの限られた範囲に集中して処理できるため、長入力の処理と後続の生成コストを大幅に削減できます。今回の選択から漏れた過去のエントリは後続のQueryの検索にまだ利用できるため、スパース選択は主に今回の読み取り量と計算量を削減するものであり、すべてのキャッシュを同じ比例で削除するものではありません。インデクサー自体はまだ過去の候補を処理する必要があるため、実際のコストはコンテキスト長の影響も受けます。
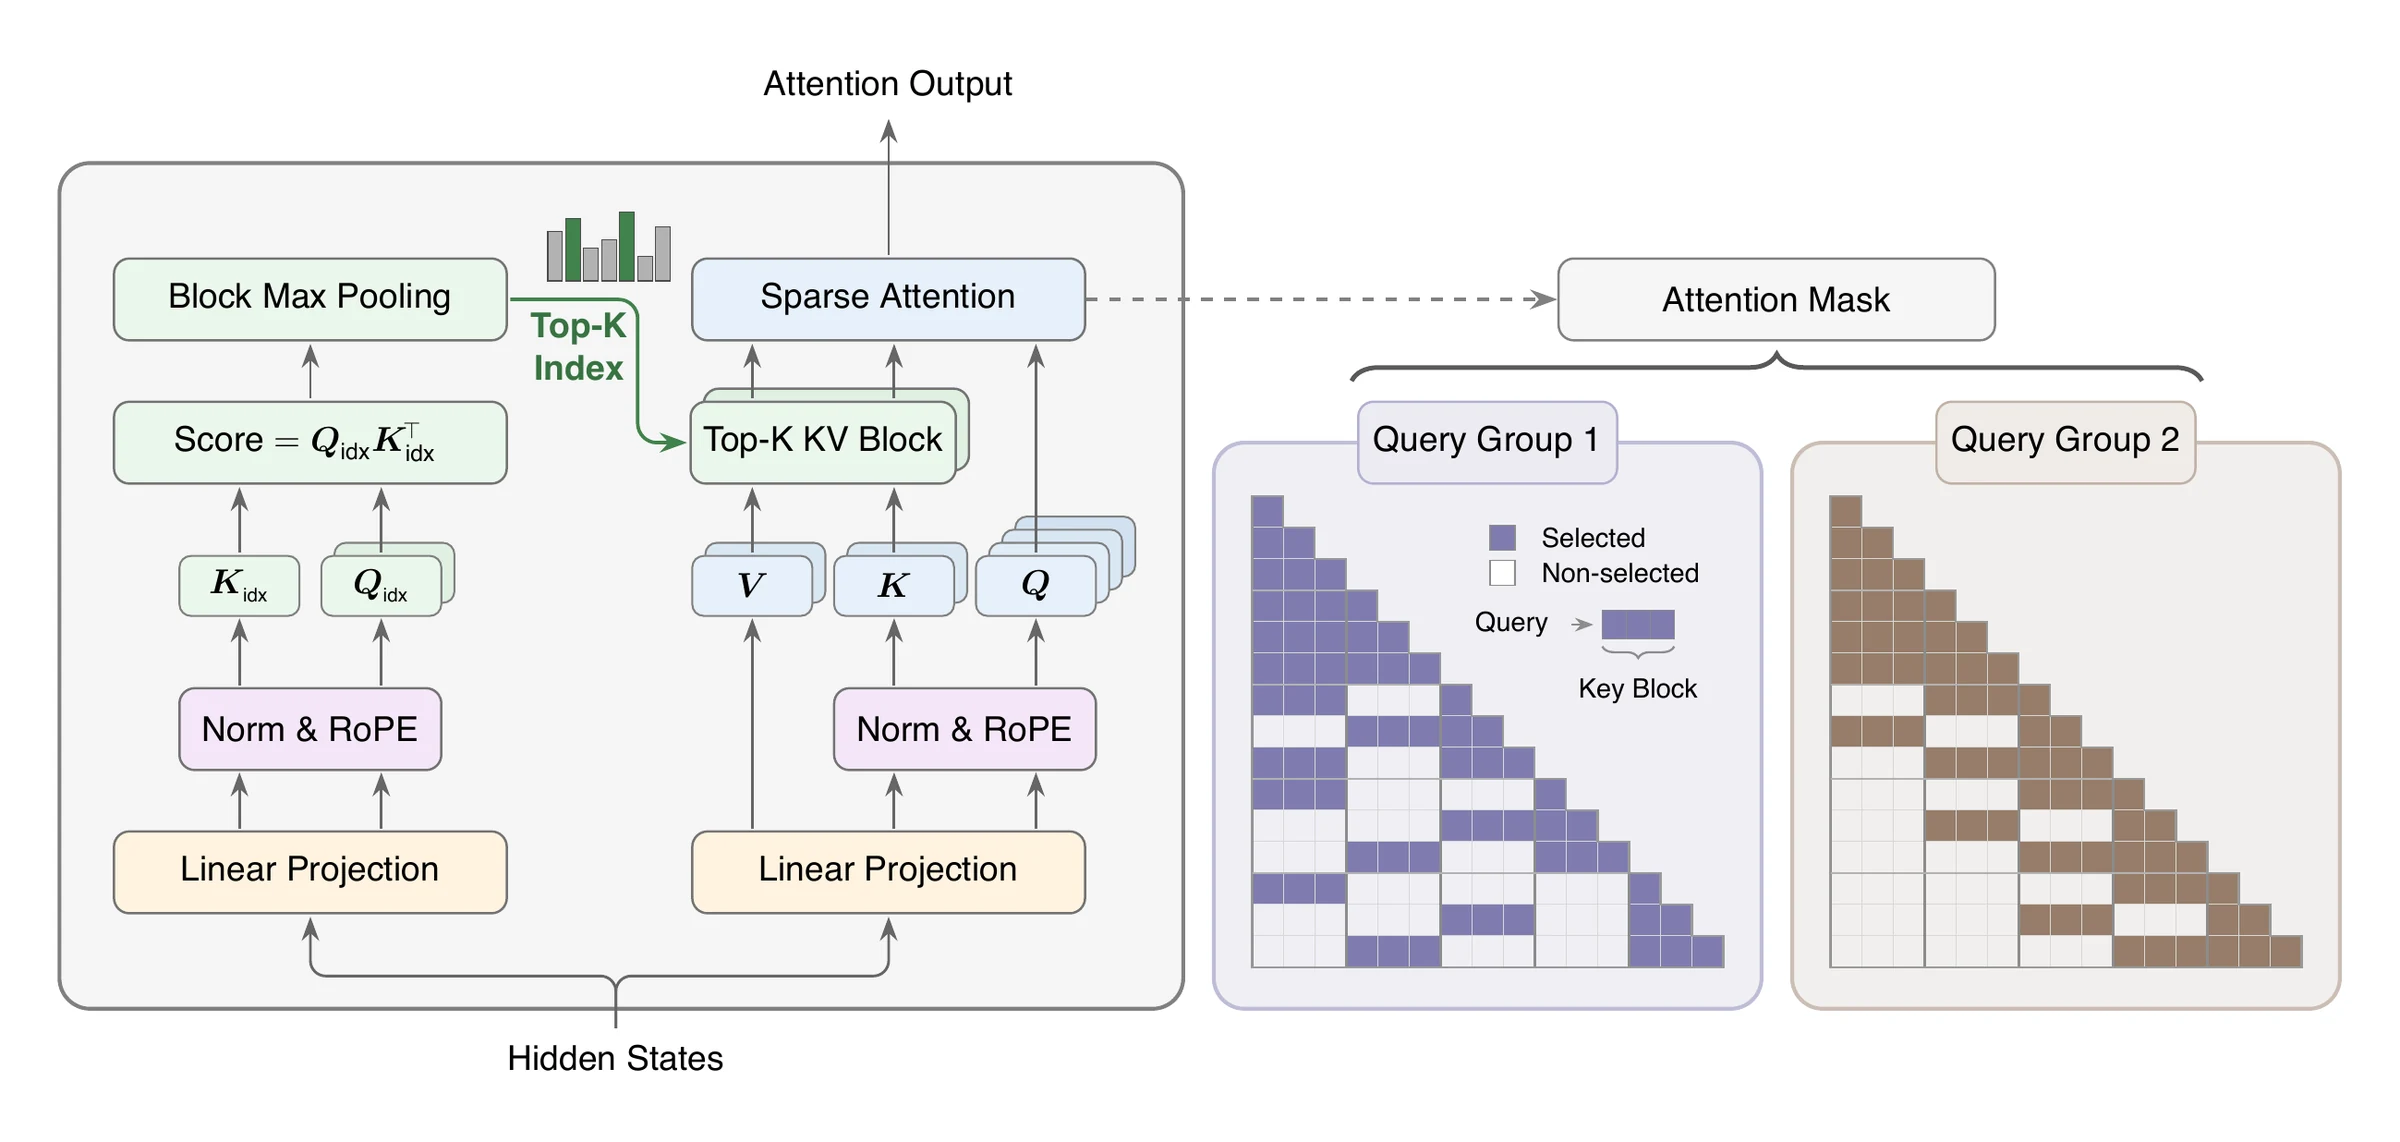
18.4.8 MiniMax Sparse Attention(MSA) MiniMax Sparse Attention(MSA)はMiniMaxチームによって提案され、MiniMax-M3に適用されました。これは100万Tokenコンテキストの効率の問題を対象としており、スパース注意力が理論的に計算に参加するTokenを削減するだけでなく、GPUのバッチ計算に適していることを特に考慮しています。
MSAはGQAの基盤の上に構築され、インデックスブランチとメインブランチで構成されます。インデックスブランチはまずTokenレベルの関連スコアを計算し、各ブロック内の最高スコアをブロックスコアとして取得し、異なるGQAグループに対してそれぞれTop-k個の過去ブロックを選択します。メインブランチは次に選択されたブロック内の因果条件を満たすTokenレベルのK、Vを読み取り、現在の局所ブロックも維持します。以下の図に示すように、右側の2つのQueryグループが異なる選択範囲を形成でき、同じグループ内のQueryヘッドは選択結果を共有します。
ブロック単位でアクセスを組織することでGPUのデータ処理の規則性が向上し、グループ選択により異なるグループが異なる検索パターンを維持できます。109Bパラメータの実験モデルの1Mコンテキストテストでは、論文はMSAのTokenあたりの注意力計算量がGQAの約1/28.4であることを報告しています。専用カーネルと組み合わせることで、H800上で入力のPrefill段階とTokenごとの生成のDecode段階でそれぞれ約14.2倍と7.6倍の速度向上を実現しています。これは、スパースアルゴリズムと計算カーネルを共同設計することで、計算量の削減がより十分に実際の速度向上に変換されることを示しています。
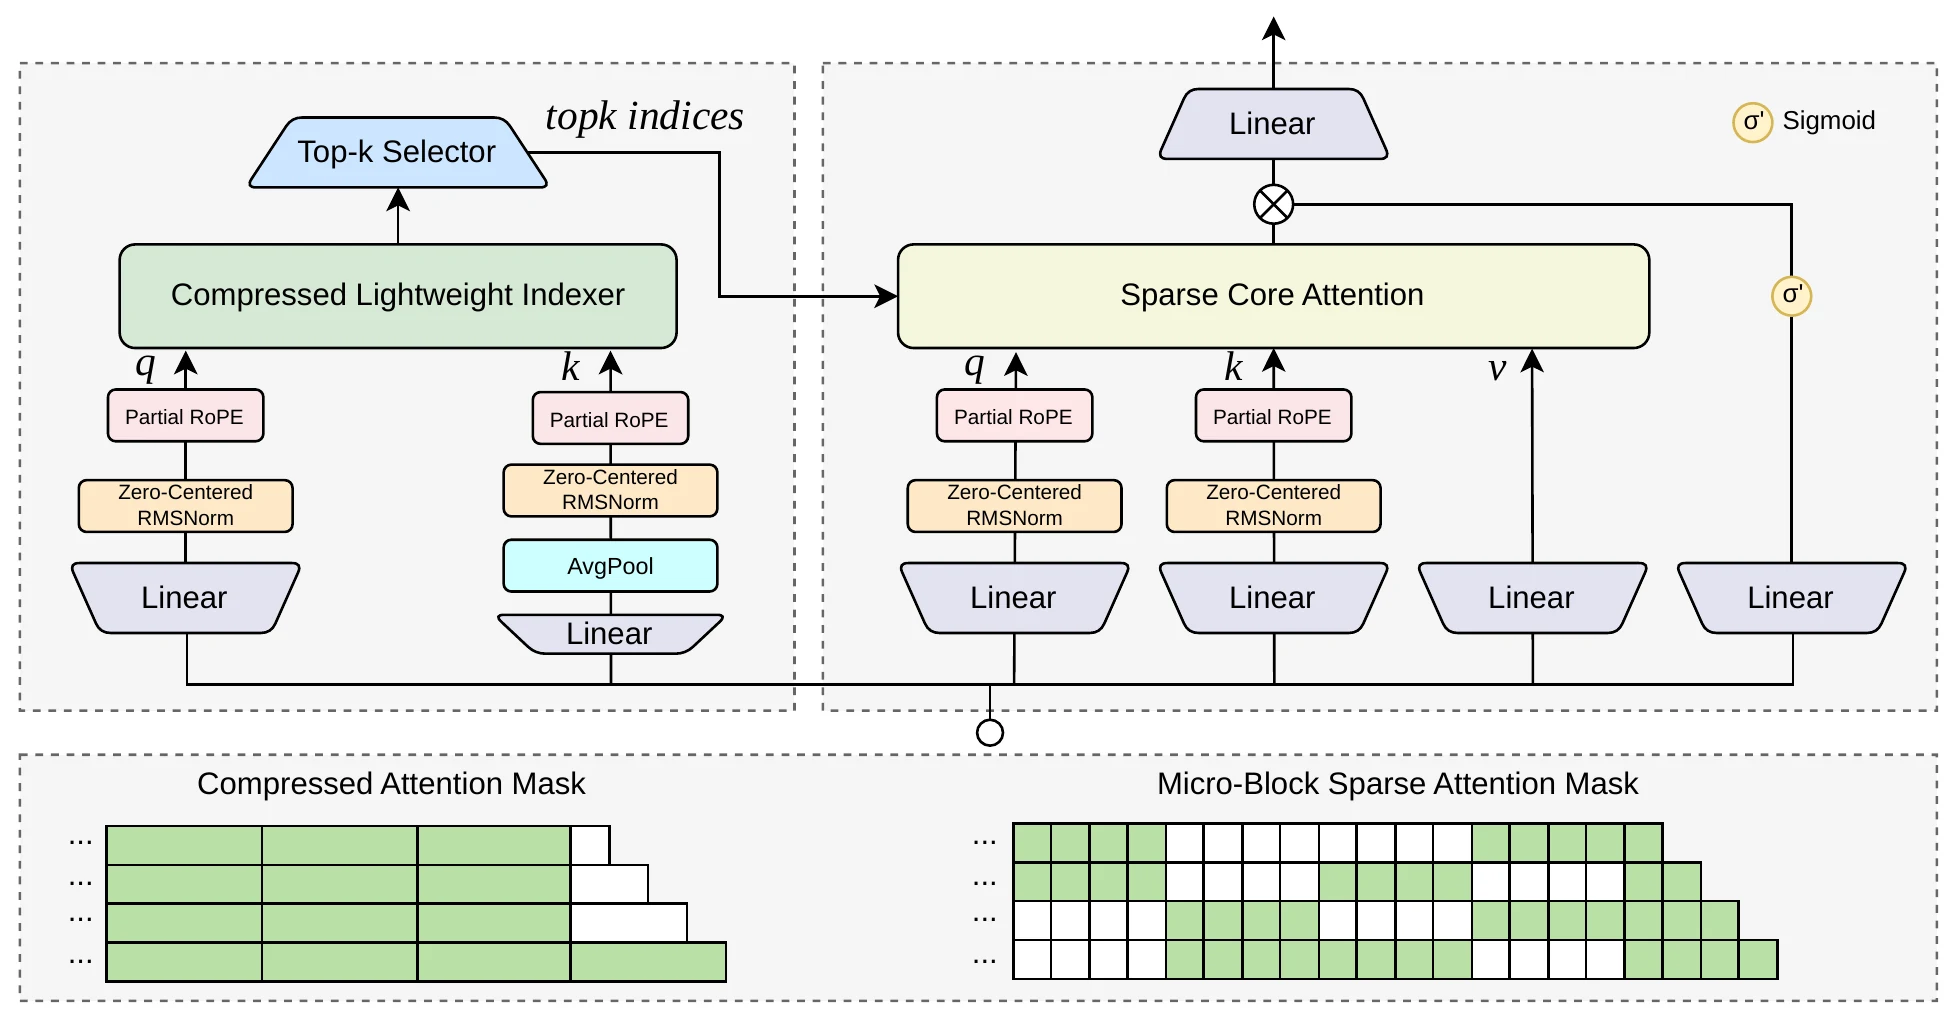
18.4.9 Qwen Sparse Attention(QSA) Qwen Sparse Attention(QSA)はQwenチームによって提案され、Qwen3.8-Flash-Nextに適用されました。このモデルは3層のGated DeltaNetと1層のQSAの混合構造を採用しています:前者は状態更新を通じてシーケンスを効率的に処理し、後者は過去のTokenへの直接検索を維持します。QSAが重点的に扱う問題は、長コンテキストにおいてインデクサー自体も大きなコストを生むことです。
これに対し、QSAはまず連続する複数のTokenのインデックスKeyを平均プーリングでマイクロブロック表現に圧縮し、より短いマイクロブロックシーケンス上で関連スコアを計算してTop-kブロックを選択します。選択後、ブロックを元のToken位置に展開し、コアAttentionが対応するK、Vを読み取ります。完全なブロックを形成できていない末尾のTokenも維持されます。以下の図の左側は圧縮インデックスプロセスを示し、右側は選択結果に基づくマイクロブロックスパースAttentionで、2つの間で渡されるのは位置インデックスです。
これにより、メインAttentionがアクセスする位置を削減するとともに、インデクサーがスキャンする必要のあるシーケンスも短縮されます。Qwen3.8-Flash-Nextの報告では、1Mコンテキストのカーネルテストで、QSAは密度の高い注意力に比べてPrefillとDecodeの速度がそれぞれ約7.6倍と4.9倍向上しています。この構造を理解する際、インデックス表現とメインAttentionキャッシュを区別する必要があります:QSAは前者を圧縮して選別コストを削減しますが、選択後もTokenレベルのKVを読み取るため、選択された領域の細粒度情報を維持できます。
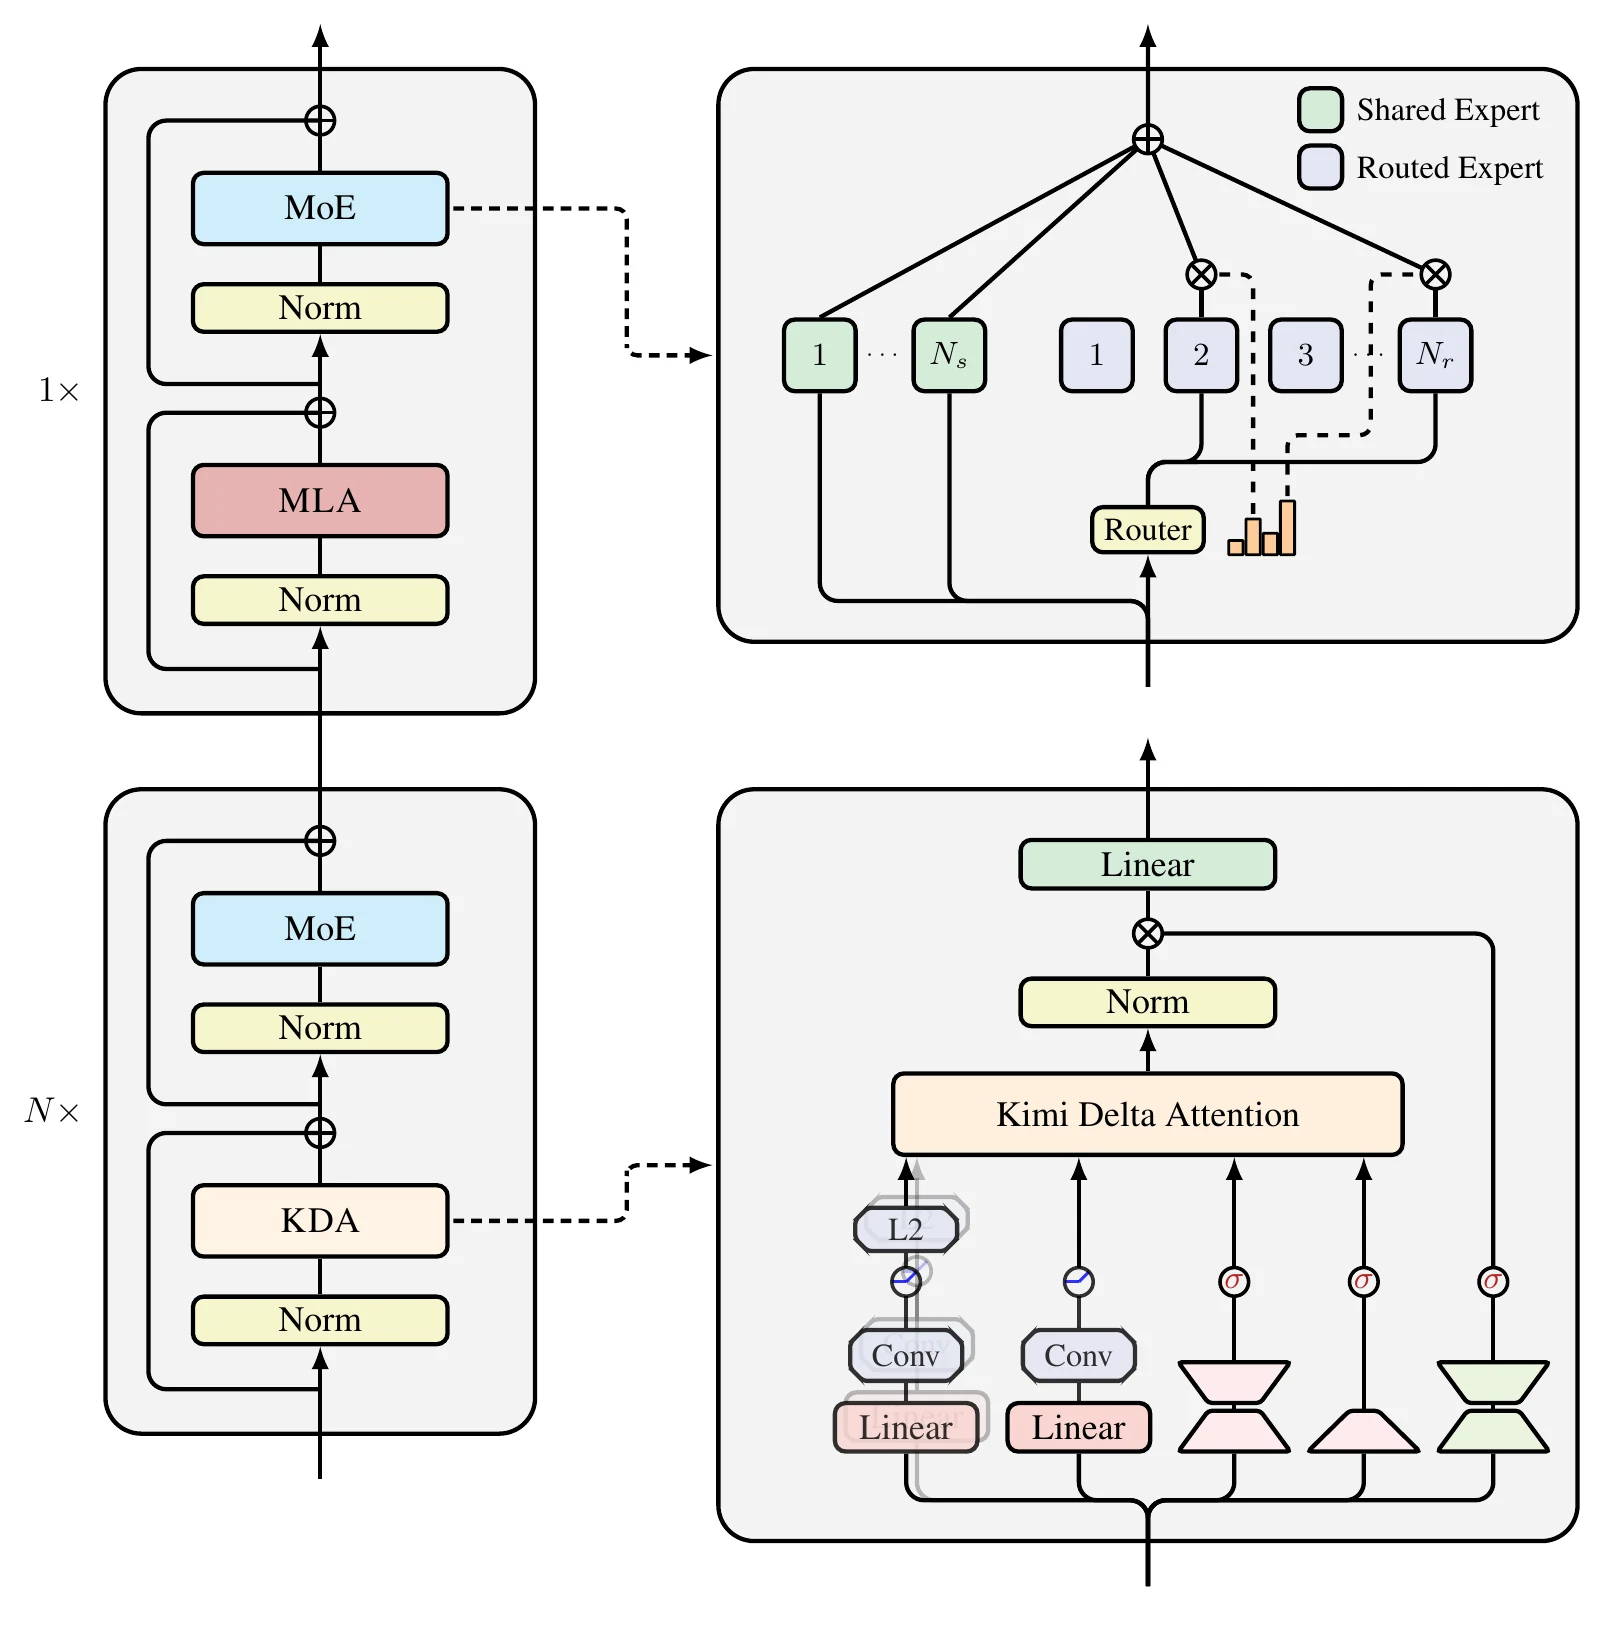
18.4.10 Kimi Delta Attention(KDA) Kimi Delta Attention(KDA)はMoonshot AIチームによってKimi Linearで提案され、実際にはKimi Linearの48B総パラメータ、3Bアクティブパラメータのモデルに適用されました。これは線形アテンションのアプローチを採用し、過去情報を固定サイズの状態に持続的に書き出すことで、各ステップの生成で長い過去シーケンスを繰り返し読むコストを削減します。
KDAはGated DeltaNetの基盤の上により細粒度のゲーティングを導入します。新しいTokenが到着すると、モデルはまず古い状態の異なるチャネルの情報保持度を制御し、次にDeltaルールを使用して既存のキー値関連を修正します。この更新は、新規入力と現在の状態が予測した内容の間の差異を利用して、状態に保存された情報を調整すると理解できます。減衰ゲートがチャネルごとに変化するため、異なる部分が異なる保持速度を使用できます。計算時にはブロック単位で並列にTokenを処理し、GPU効率を高めることもできます。
上記の図は、Kimi Linearが3層のKDAと1層のMLAを交互に使用する方法を示しています。KDA層は固定サイズの状態で長シーケンスのコストを低減し、MLA層は特定の過去位置への直接検索を補完し、固定状態容量の限界を緩和します。論文が同じ訓練方法で比較した場合、この混合モデルは完全なMLAベースラインと比較して最大75%のKV Cacheを削減し、1Mコンテキストで最大約6倍のデコーディングスループットを達成しています。これらの効果はKimi Linearの混合アーキテクチャに対応しており、すべてのKimiモデルの統一構成ではありません。
18.4.11 Compressed Sparse Attention(CSA) Compressed Sparse Attention(CSA)はDeepSeekチームによってDeepSeek-V4で提案され、DeepSeek-V4-ProとDeepSeek-V4-Flashに適用されました。前述のMLAは各TokenのKV表現を圧縮するものですが、CSAはさらにシーケンス方向にエントリ数を削減し、複数のTokenの情報をより少ないKVエントリに集約してからスパース選択を行います。
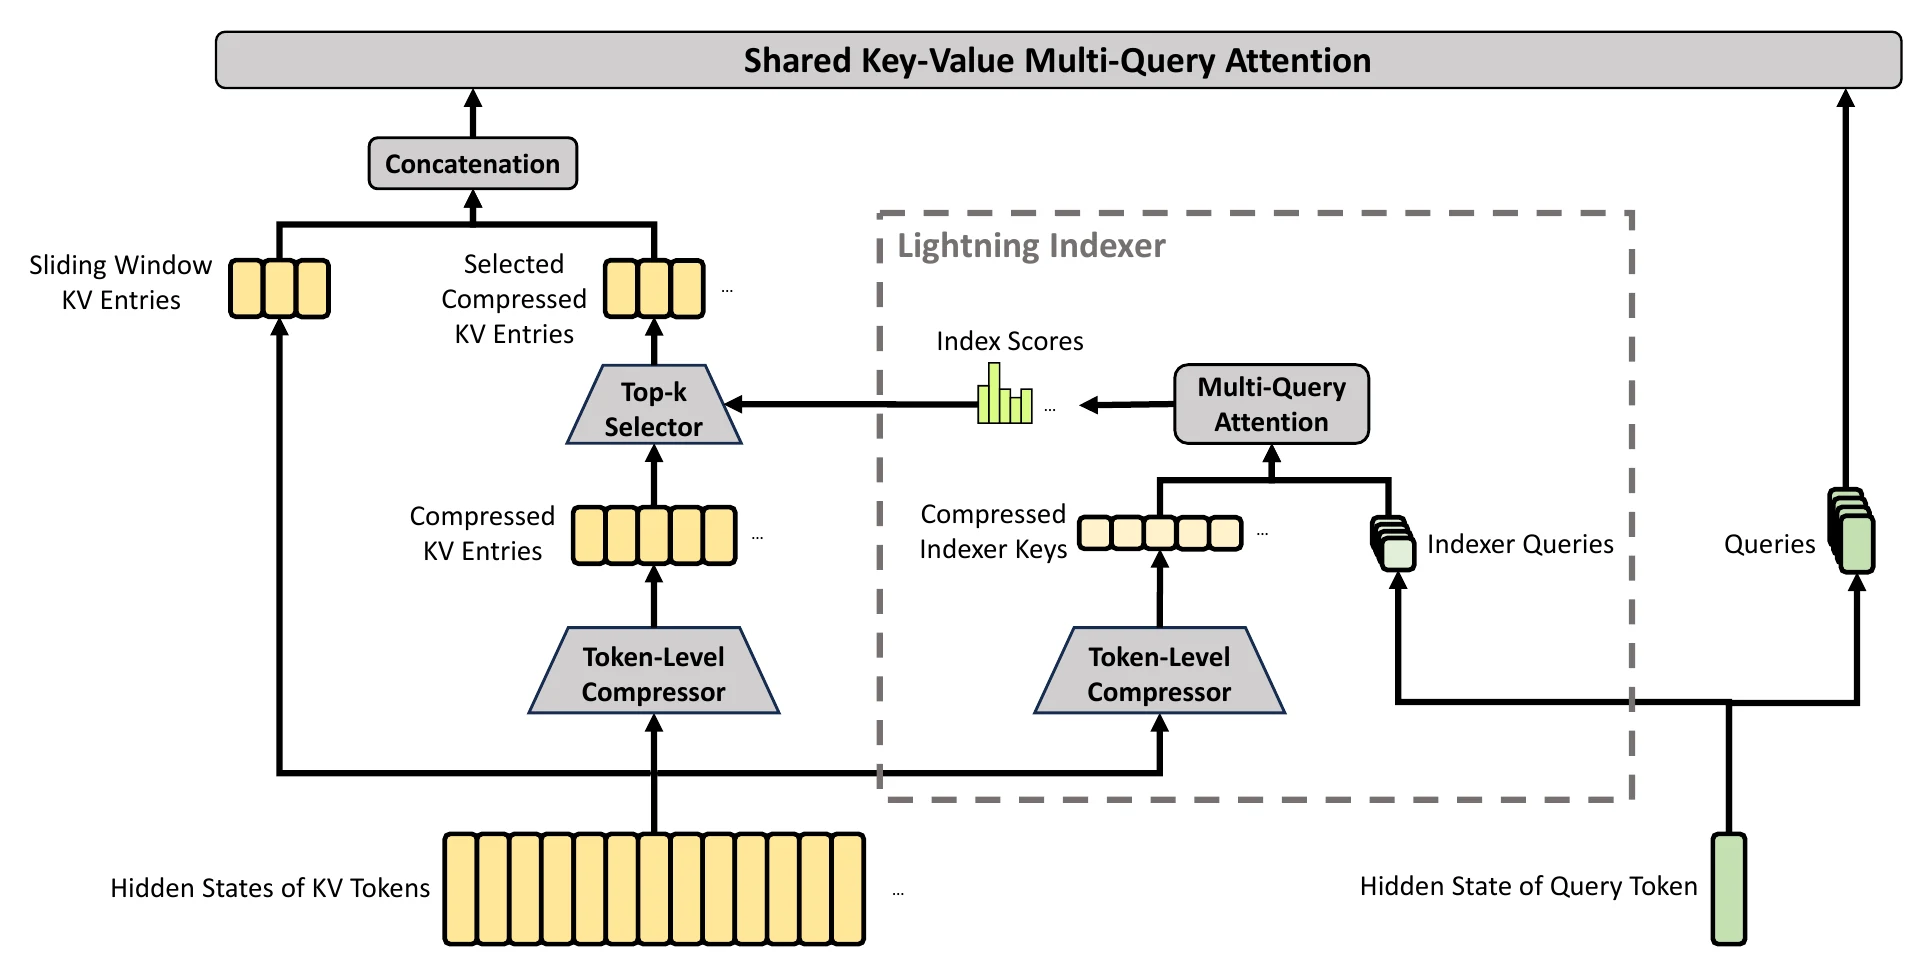
CSAはまず学習可能なTokenレベルのコンプレッサーで連続Tokenを処理し、隣接ブロックの重複情報を組み合わせて圧縮KVを形成します。次に、Lightning Indexerがこれらの圧縮エントリにスコアを付け、Top-kエントリを選択してメインAttentionに参加させます。以下の図では、コンプレッサーはインデックスと選択の前に位置し、メインAttentionは圧縮されたKVを直接読み取ります。左側にはスライディングウィンドウブランチもあり、最近の圧縮されていないTokenも計算に含まれ、局所的な詳細を維持します。
DeepSeek-V4の報告書では、CSAの圧縮率は4、すなわち過去のKVエントリ数が約4分の1に削減され、その中から一部のエントリを選択してコアAttention計算を行うこととされています。したがって、CSAは長期キャッシュ量を削減するとともに、毎回の読み取りと計算の過去コンテンツも削減します。QSAはインデックス圧縮後に元のTokenに戻りますが、CSAは圧縮されたエントリ上で情報集約を完了するため、過去KV自体も圧縮しています。この設計ではコンプレッサーが有用な特徴を維持し、局所ウィンドウが最近の詳細を補完する必要があります。
18.4.12 Heavily Compressed Attention(HCA) Heavily Compressed Attention(HCA)もDeepSeekチームによってDeepSeek-V4で提案され、CSAとともにDeepSeek-V4-ProとFlashの複数層構造で交互に使用されます。これはより強力なシーケンス圧縮を採用し、モデルがより少ないキャッシュで広範囲の過去情報をカバーできるようにし、CSAの選択的読み取りと補完し合います。
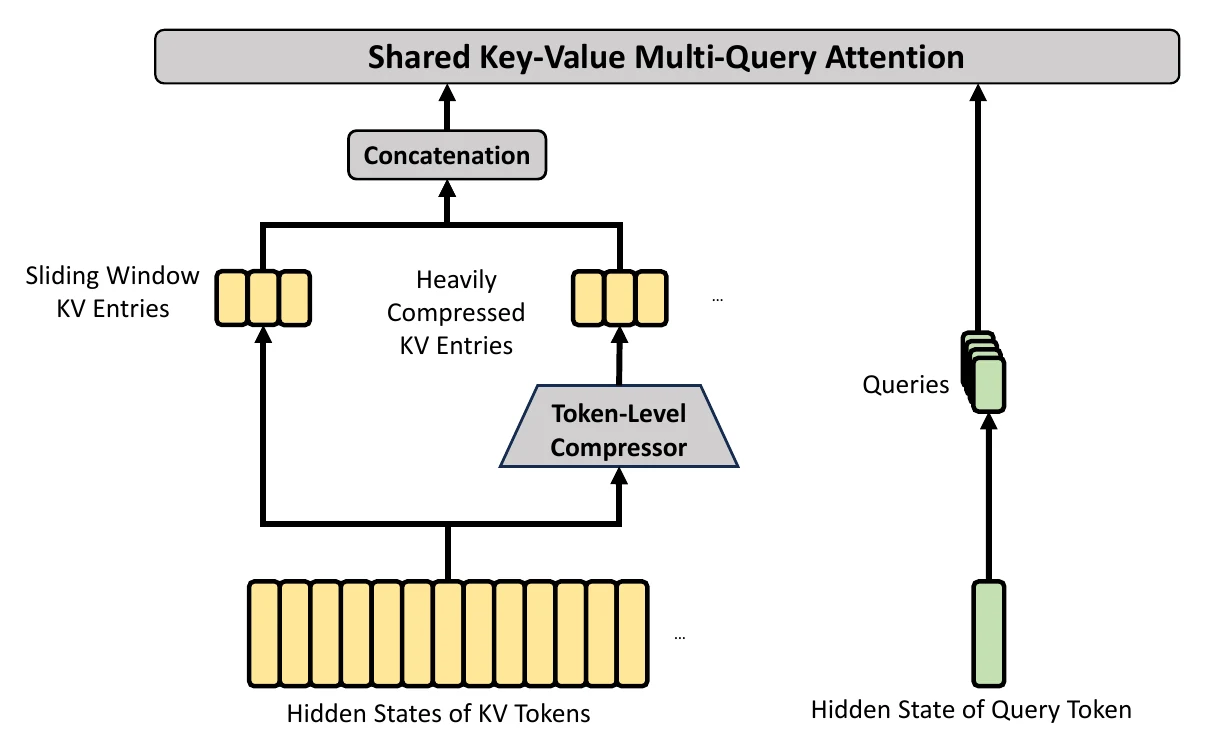
HCAの圧縮率は報告書で128に設定されており、CSAの4を大幅に上回ります。複数のTokenが学習可能な加重集約を通じて1つの圧縮エントリを形成した後、現在のQueryはすべての因果的に可視化された圧縮過去に対してAttentionを実行し、Top-k選別は行われません。以下の図に示すように、HCAは圧縮ブランチと局所スライディングウィンドウブランチを維持しますが、CSAのインデクサーとセレクターは省略されます。ウィンドウは最近のTokenの詳細を提供し、圧縮された過去はより広範囲のコンテキスト情報を提供します。
CSAとHCAを交互に構成することで、DeepSeek-V4は異なる粒度の過去表現を同時に利用できます。報告書では、1Mコンテキストで、DeepSeek-V4-ProのTokenあたりの推論FLOPsとKV CacheはそれぞれDeepSeek-V3.2の約27%と10%です。これは混合Attentionと低精度計算・記憶が共同で作用する全体的な効果です。利用者にとって、この種の構造の意義は、超長コンテキストが限られたハードウェアでより容易に実行できることにあります。具体的なモデルが長い資料の詳細を正確に抽出できるかどうかは、圧縮方法、訓練過程、実際のタスクに依存します。
これらのモデルの設計から、Attentionの改善には1つの方向だけではないことがわかります。MHA、MQA、GQAは主にヘッド間の共有関係を変更し、MLAは各位置のKV表現を圧縮し、DSA、MSA、QSAはコアAttentionがアクセスする位置を削減し、KDAは状態更新を通じて過去を処理し、CSA、HCAは過去エントリをさらに圧縮します。モデルはこれらの方法を複数組み合わせて使用できるため、リソース要件を分析する際は、各構造の層数とキャッシュ形式を考慮する必要があります。どの構造を採用するにしても、Attentionはコンテキスト情報の集約のみを担当し、モデルの全体的な能力はEmbedding、フィードフォワードネットワーク、訓練過程と共同で形成されます。
18.5 事前訓練:大規模データから基礎法則を学ぶ モデル構造は情報の計算方法を決定し、訓練過程はモデルが最終的に何を学ぶかを決定します。大規模モデルの訓練は通常、いくつかの段階に分かれます。まず事前訓練段階では、モデルは大量のテキスト、コードなどのデータ上で言語法則、知識構造、基本的な推論パターンを学び、汎用能力を獲得します。次に、指令微調整(Supervised Fine-Tuning、SFT)段階では、大量の「指令—回答」サンプルを通じて、モデルがユーザーの要求を理解し、指定されたタスク形式に従って回答できるようにします。此基础上、偏好最適化や強化学習がさらに実行され、人間のフィードバックやルールに基づいてモデルの行動を調整し、有用性、正確性、表現スタイル、安全性、行動境界の面で期待に沿うようにします。
事前訓練はモデルが基礎能力を形成する段階です。モデルは大量のテキスト、コード、マルチモーダルデータ上で繰り返し訓練されます。Decoder-only言語モデル(GPTシリーズなど)の場合、一般的な訓練タスクは前の内容に基づいて次のTokenを予測し、予測が間違えた場合にモデルパラメータを調整することです。大量のサンプルが繰り返される中、モデルは徐々に言語構造、表現方法、異なる概念間の統計的関係を学び、Q&A、要約、翻訳、コード生成などのタスクに必要な基礎表現と生成能力を形成します。
モデルが事前訓練で学んだ知識は大量のパラメータに分散しており、1条ずつ照会できるデータベースではありません。学んだ法則を組み合わせて、訓練データに原文のまま出現しなかったコンテンツを生成することもできますが、関連するが完全には一致しない情報を組み合わせて、一見合理的な間違った回答を形成することもあります。もちろん、訓練データは多いほど良いわけではありません。繰り返しコンテンツ、低品質なウェブページ、誤った知識、プライベートデータ、有害コンテンツはすべてモデルに影響を与えます。事前訓練前に通常、フォーマット解析、重複排除、品質選別、安全フィルタリング、データ配分が必要です。データ規模はモデルがどれだけのコンテンツに接触できるかを決定し、データ品質はモデルが从中で何を学べるかに直接影響します。
18.6 指令微調整:モデルに要求に従ってタスクを完了させる 事前訓練を完了した後、モデルはテキストを続写できるようになっていますが、必ずしもユーザーの要求に従って安定したタスクを完了するわけではありません。例えば、ユーザーが3つのアクション項目をリストするよう要求した場合、ベースモデルは質問をさらに拡張し続けるか、指定されたフォーマットを無視するかもしれません。指令微調整は、指令と期待される回答からなるサンプルを使用してモデルを追加訓練します。以下は指令微調整の例です:
指令:把下面的会议记录整理成行动项。
输入:会议记录正文。
输出:包含任务、负责人和截止时间的表格。
Q&A、要約、情報抽出、コード、ツール呼び出し、安全拒否など、さまざまなタイプのサンプル訓練を経て、モデルは徐々にユーザーの意図を認識し、出力要件を遵守できるようになります。指令微調整は主にモデルにどのように既存能力を使用するかを教えます。一部の知識を補完することはできますが、すべての知識更新問題を解決するのに適していません。頻繁に更新する必要があるか、出典を提供する必要があるコンテンツは、ナレッジベース、検索、または外部ツールをランタイムで提供するのにより適しています。
18.7 後訓練:モデルの行動をさらに調整 後訓練は、モデルが事前訓練を完了した後に実行される一連の訓練と整合の総称です。指令微調整は通常、後訓練の一部に含まれ、さらに指令微調整(SFT)、偏好最適化、強化学習もこの段階で発生する可能性があります。したがって、指令微調整と後訓練は2つの独立したステップではなく、前者は具体的な方法の一種であり、後者は複数の方法を含む段階です。いくつかの訓練方法はまず以下の関係で理解できます:
段階または方法
主に使用するデータ
主に解決する問題
事前訓練
大規模なテキスト、コード、マルチモーダルデータ
モデルに言語や知識などの基礎法則を学ばせる
指令微調整/SFT
指令と期待される回答
モデルにタスクの要求に従って出力させる
偏好最適化
同じ質問に対するより良い回答とより悪い回答
モデルに偏好に合った回答をより選好させる
強化学習
プロンプト、モデルの回答、報酬シグナル
報酬に基づいて生成戦略をさらに調整する
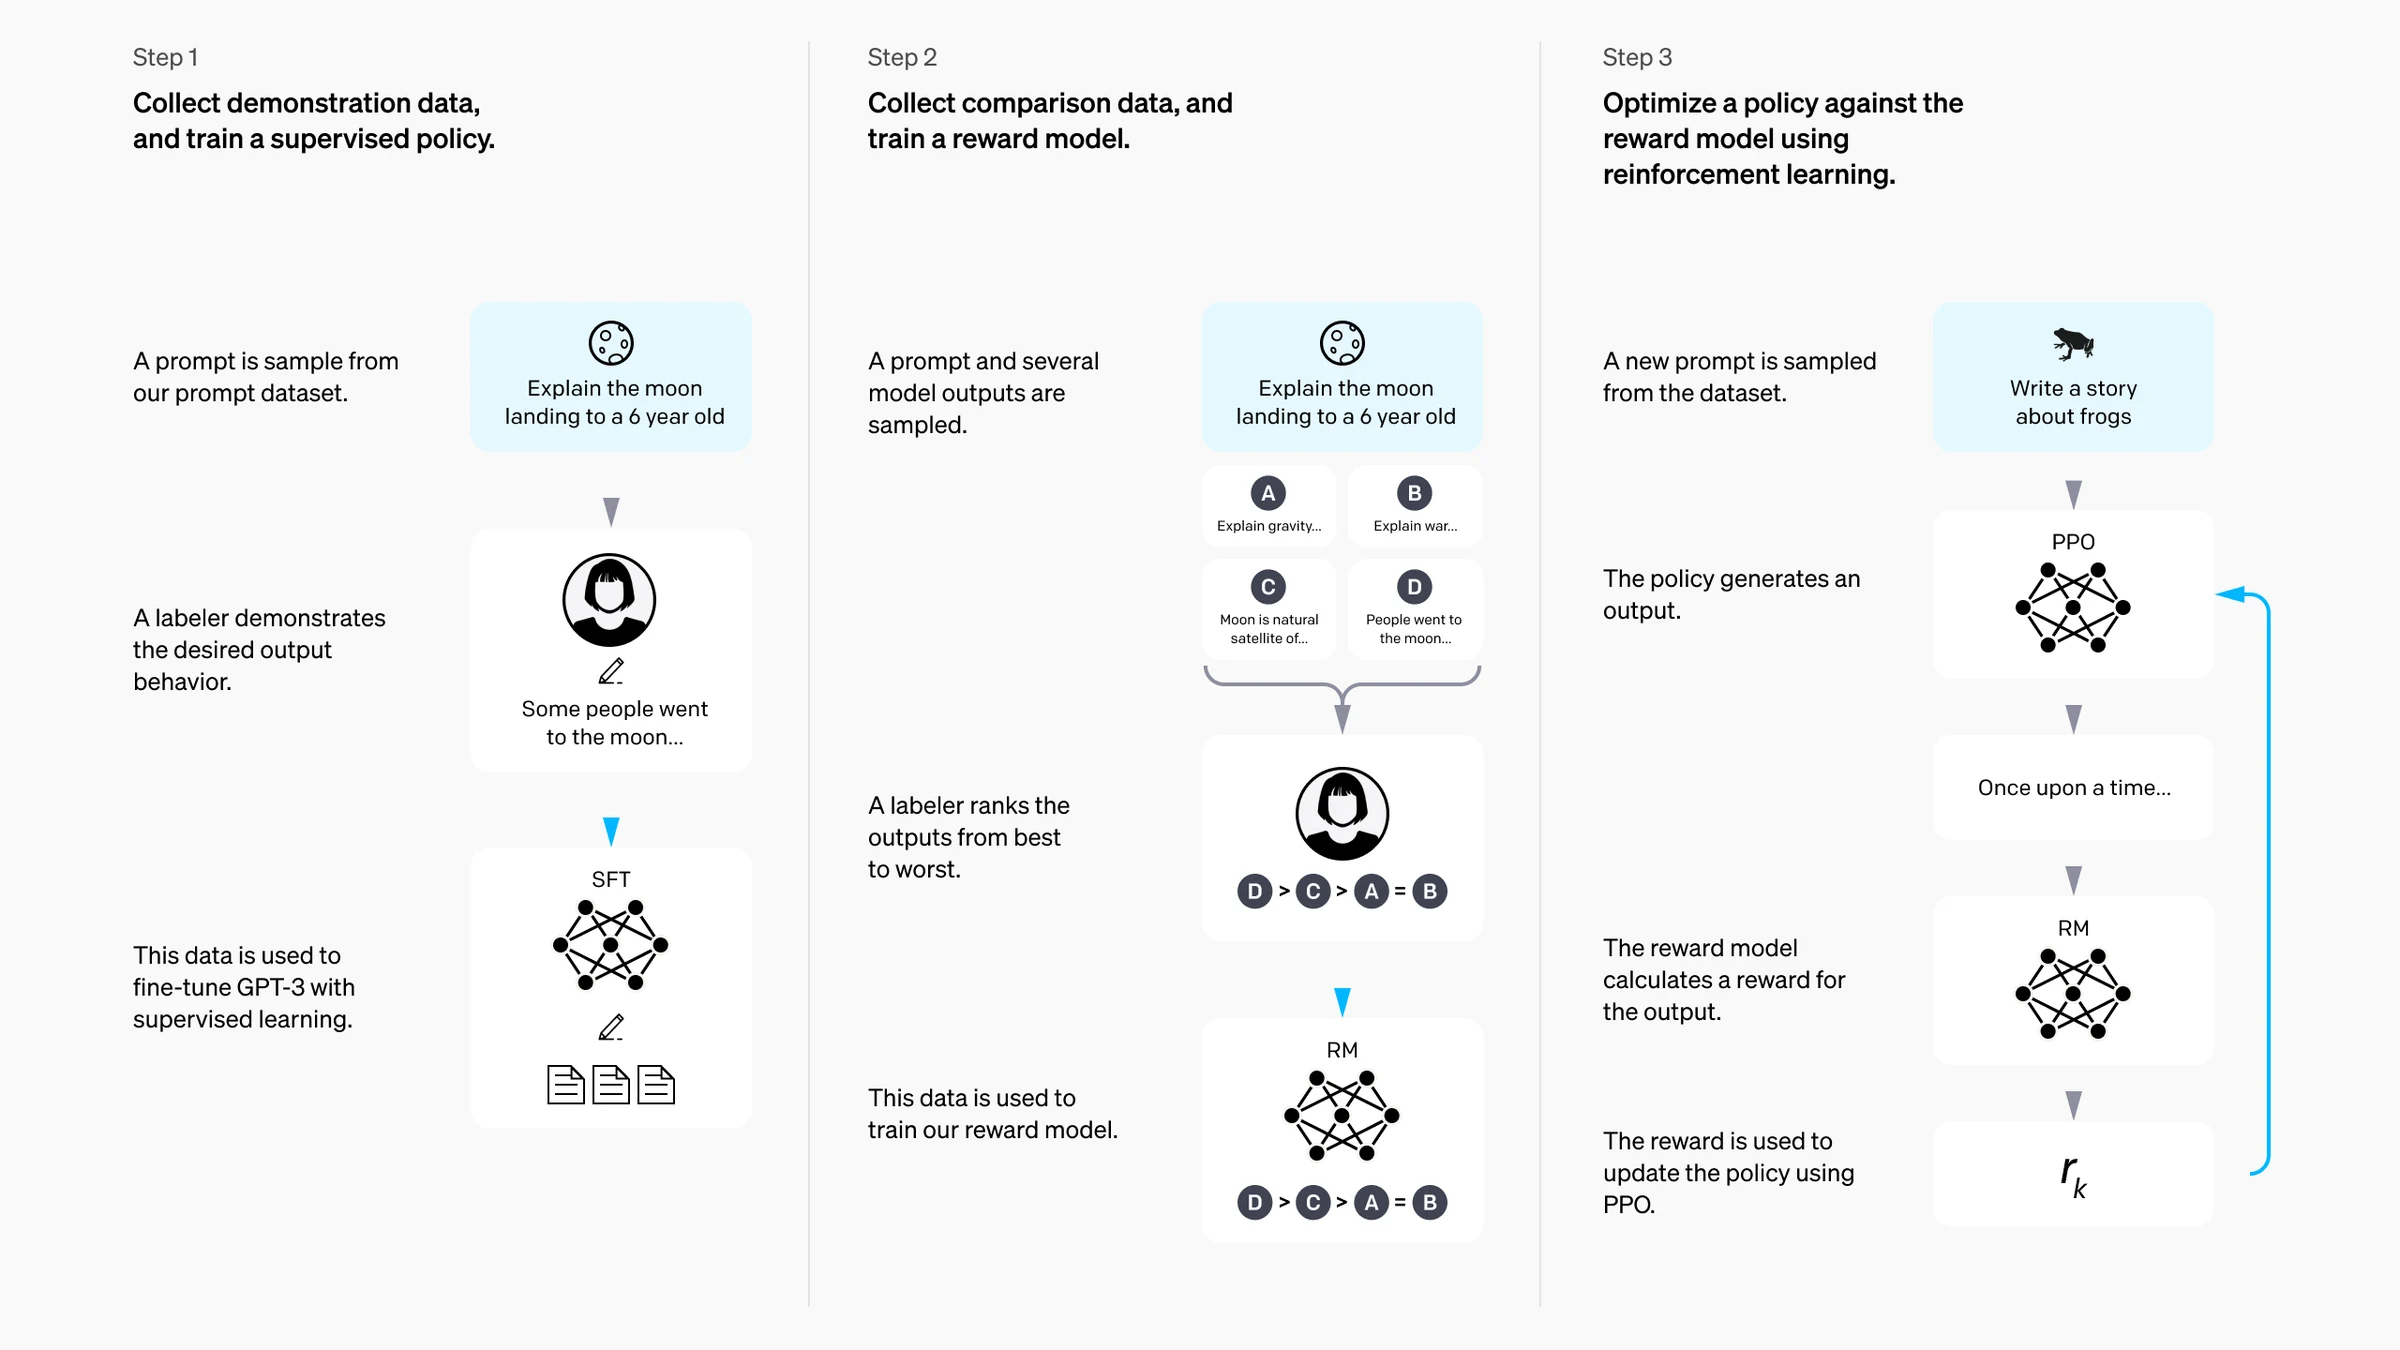
InstructGPTで採用された人間フィードバックに基づく強化学習(Reinforcement Learning from Human Feedback、RLHF)フレームワークを参考にすると、现在已经形成了一条经典的后训练路线。RLHFは通常、最初のステップで人間のデモデータを使用してSFTを完了し、2番目のステップで回答のランク付けデータを使用して報酬モデルを訓練し、3番目のステップで報酬モデルが与えるスコアに基づいて、PPOを使用して言語モデルの生成戦略を最適化します。具体的なプロセスは以下の図に示されています。
ここで、報酬モデルが与えるスコアは一種の偏好を表しており、客観的な真実と同義ではありません。偏好データが不十分にカバーされているか、報酬ルールの設計が不合理的な場合、モデルはスコアリング方法に迎合することを学ぶだけかもしれません。
実際のモデルは必ずしも完全に同じルートを採用するわけではありません。SFT plus DPOを使用するモデル、SFT、報酬モデル、PPOを使用するモデル、さらにAIフィードバック、安全整合、ツール使用訓練、対話データを追加するモデルもあります。前述の事前訓練、指令微調整、後訓練はモデルの能力がどのように形成されるかを説明しました。モデルの訓練が完了した後、利用者がより頻直に直面する問題は、一度にどれだけのコンテンツを入力できるか、実行時にどれだけのVRAMが必要か、限られたハードウェアでどの精度を選択するかです。
18.8 コンテキスト長:モデルが一度に処理できるコンテンツ量 モデルが訓練を完了すると、実際の推論とデプロイ段階に入ります。コンテキスト長は1回のリクエストにどれだけのTokenを入れられるかを決定します。コンテキストが長いほど、モデルが読める材料は増えますが、Attention計算とKV Cacheの占用も増加し、进而推論速度とVRAMの必要量に影響します。ここでいうコンテキストとは、1回のリクエストにおけるシステムプロンプト、対話履歴、現在の入力、ファイル内容、ツールの説明、ツールの戻り値、モデルが既に生成したコンテンツで、以下の式で表現できます:コンテキスト占用= システム指令 + 対話履歴 + 現在の入力+ 添付コンテンツ + ツール情報 + モデル出力。
前述したように、大規模モデルのコンテキスト占用はユーザーの現在の入力コンテンツだけでなく、システム指令、これまでの対話履歴、ユーザーの現在の入力、添付ファイルの関連コンテンツ、ツール呼び出しに必要な情報、モデルが既に出力したコンテンツなど、複数の部分から構成されます。これらのコンテンツはすべてモデルのコンテキストウィンドウを占用するため、対話が長くなったり、添付ファイルが増えたり、ツール情報が複雑になったりするにつれ、後続の入力と生成に利用できるコンテキストスペースは徐々に減少します。例えば、モデルがサポートするコンテキスト長が128Kと标注されている場合、通常は1回のリクエストで処理できるTokenの総量級を示します。出力を含むかどうか、1回の最大出力は多少かは、モデルとサービスインターフェースの制限によります。通常、コンテキストを超えると、プラットフォームはリクエストを拒否したり、コンテンツの一部を切り詰めたり、過去の記録を自動的に圧縮したりする場合があります。
モデルの長文書での推論効率と回答品質を向上させるために、入力材料を提供する前にコンテンツを整理し、タスクに関係ない、重複した、または価値の低い情報を削除し、モデルに重点的に注目すべき章、フィールド、質問範囲を明確に伝え、モデルが大量の無関係なコンテキストに注意を散らすことを避ける必要があります。特に長く、一度に完全に処理するのが難しい材料については、まず章、テーマ、または固定長に分割し、モデルに情報抽出、要約、分析をそれぞれ完了させ、各部分の結果を統一的に集計し、総合的に判断させます。重要な結論、重要なデータ、またはさらに確認が必要なコンテンツについては、対応する原文の場所、章、ページ番号を明記するよう要求し、後の人工チェックと結果のトレーサビリティを容易にし、全体の処理プロセスの正確性、説明可能性、信頼性を向上させます。
18.9 KV Cache:長文本生成のVRAM占用 Transformerアーキテクチャに基づく生成モデルは通常、Tokenを1つずつ生成します。生成の过程中で、各Tokenを生成するたびにそれまでのすべてのTokenの注意力情報を再計算すると、大量の重複作業が発生するため、KV Cacheと呼ばれるキャッシュメカニズムを導入するのが望ましいです。KV Cacheは各層で計算済みのKeyとValueを保存し、次のTokenを生成する際は新しく追加された部分のみを計算するため、生成速度が向上します。Tokenが1つ増えるたびに、各Transformer層が対応するKとVを保存する必要があります。したがって、KV Cacheはコンテキスト長、出力長、同時リクエスト数、モデルの層数の増加に伴い増加します。
一般的なDecoder-onlyモデルの場合、単一シーケンスのキャッシュ占用を以下の簡略化された式で理解できます:
\text{KV Cache占用}
\approx
2 \times \text{層数}
\times \text{Token数}
\times \text{KVヘッド数}
\times \text{各ヘッドの次元}
\times \text{各数のバイト数}
モデルの重みをロードした後の占用は比較的固定されていますが、KV Cacheはリクエストに応じて変化するため、同じ量子化モデルでも短いQ&Aでは正常に動作しても、長文書や多人数同時使用ではVRAM不足が発生する可能性があります。例えば、同じサーバーで短い会議録を1つ処理する場合は正常に動作するかもしれませんが、同時に10人のユーザーが長い記録をアップロードすると、モデルは複数のシーケンスに対してそれぞれKV Cacheを保存する必要があり、VRAMの圧力が大幅に増加します。これも、モデルファイルがVRAMに収まっても、入力テキストの長さと同時規模の増加に伴い、計算リソースの消費が変化することを説明しています。したがって、実際のデプロイメントでは、無関係なコンテキストを短縮したり、最大生成長を制限したり、同時数を減らしたり、ページングキャッシュを使用したり、GQA、MQA構造を採用するモデルを選択してKV Cacheの圧力を軽減し、計算サービスの効率を向上させることができます。
18.10 パラメータ規模、量子化、ハードウェア モデルファイルは実際には現在のモデル構造と関連パラメータを保存しており、これらのパラメータは本質的に一連の数値です。コンピュータ構成原理の知識を組み合わせると、これらのパラメータはコンピュータ内では0と1の表現であり、異なるビット幅を使用して同じ数値を表現する場合、規定された数値範囲は数値の精度も制約します。モデル訓練では通常、FP32、FP16、BF16などの浮動小数点形式が使用され、実際には32ビットまたは16ビットの0と1で1つの数を表します。ビット数が多いほど、表現される数値範囲と数値精度は向上しますが、実際のリソース消費も非常に大きくなります。そこで、さらなるリソース削減のために量子化方法が提案されました。量子化とは、この多位の浮動小数点値を8ビットのINT8や4ビットのINT4などのより低精度な表現に変換し、モデルファイルと実行時のリソース占用を削減することです。以下の表は浮動小数点精度に対応する特徴を示しています:
精度
各パラメータの理論バイト数
一般的な特徴
FP32
4
精度が高く、リソース占用が大きい
FP16/BF16
2
一般的な訓練と高精度推論形式
INT8
1
重みの理論占用は16ビットの約半分
INT4
0.5
重みの理論占用は16ビットの約4分の1
実際の量子化はすべての小数を単純に四捨五入するのではなく、一連の浮動小数点値を有限範囲にマッピングし、スケーリング係数、ゼロ点、グループ情報を保存します。一般的な方法には、モデルの重みのみを圧縮するもの、重みとアクティベーションを同時に量子化するもの、モデル訓練後にPost-Training Quantizationを実行するものがあります。量子化による数値の変化を過度に心配する必要はありません。なぜなら、最終的にモデルが生成する際、各候補Tokenが次の語としての確率を予測し、選択する際は主に関係のランク付けと正規化されたスコアによるものだからです。したがって、量子化の精度には多少の損失がありますが、厳密な制御の下では、モデルの生成効果を効果的に兼ねることができます。
モデル選択の際、VRAMが十分かどうかを判断する必要が frequently あります。モデル名の7B、14B、70Bは通常、約70億、140億、700億個のパラメータを示します。パラメータはモデルの訓練で学んだ数値であり、Attention、フィードフォワードネットワーク、Embeddingなどのモジュールに分散しています。
パラメータ数はモデルファイルのサイズと直接同等ではなく、各パラメータに使用される精度も考慮する必要があります。モデルの重みのみを計算する場合、以下の式を使用できます:
重み占用 ≈ パラメータ数 × 各パラメータのバイト数
パラメータ規模
FP16/BF16
INT8
INT4
7B
約14GB
約7GB
約3.5GB
14B
約28GB
約14GB
約7GB
32B
約64GB
約32GB
約16GB
70B
約140GB
約70GB
約35GB
表の数字はモデルの重みの理論的な下限のみを表しています。量子化モデルはスケーリング係数などの情報も保存する必要があり、実際の推論にはKV Cache、中間計算結果、推論フレームワークのワークスペース、同時リクエストキャッシュも必要です。
例えば、14BモデルのINT4重みは理論上約7GBですが、8GBグラフィックカードではKV Cacheと実行バッファに几乎没有スペースが残りません。短いコンテキスト、単一リクエストでは動作する可能性がありますが、長文書を処理する場合はVRAM不足が発生しやすいです。12GBまたは16GBのVRAMを使用するとより余裕があります。70BのINT4重みは約35GBで、通常48GB以上のVRAMが必要です。デプロイメントでは、より大きなVRAMを持つ計算カード、複数カード、またはCPUメモリを使用した混合推論を選択できます。
18.11 ドメインモデル:汎用モデルを専門シーンに適応させる 汎用大規模モデルは大量の知識とタスクをカバーする必要がありますが、医療、金融、法律、コードなどの専門シーンでは、業界用語、ビジネスプロセス、リスク境界に必ずしも精通していません。ドメインモデルは通常、汎用ベースモデルの上に、専門データとタスクを使用して追加訓練または適応を行い、モデルをより特定のドメインに適応させます。必ずしもゼロから訓練するわけではなく、プロンプトでモデルを専門家に設定するだけでもありません。一般的な訓練と適応方法には以下が含まれます:
ドメイン文献、法规、コードベースなどの未ラベルデータを使用して事前訓練を継続する;
専門Q&A、情報抽出、レポート生成などのデータを使用してドメイン指令微調整を行う;
専門家の偏好、拒否ルール、リスクケースを使用して安全整合を行う;
専門知識ベース、データベース、外部ツールを接続し、更新可能でトレーサブルな情報を提供する。
ここで、ドメインモデルとドメインアプリケーションを区別する必要があります。ドメインモデルは専門データで訓練されており、専門能力はモデルパラメータに書き込まれています。ドメインアプリケーションは汎用モデルを直接使用し、専門知識ベース、ルール、ツールを接続できます。実際のシステムでは、2つの方法を組み合わせて使用することも頻繁にあります。
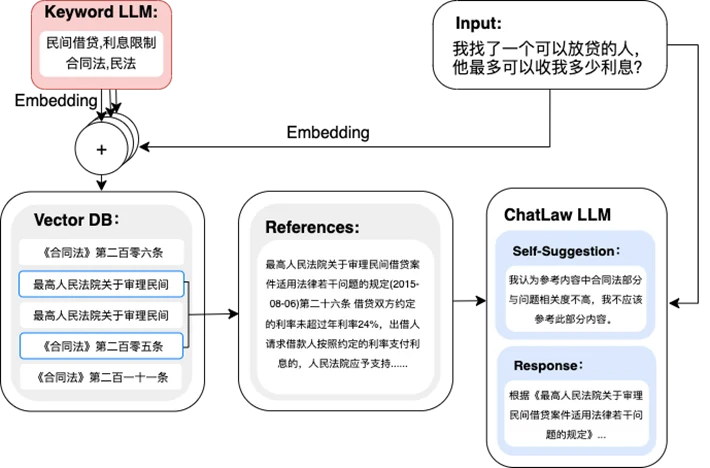
以下の図の法律Q&Aシステムは、まずキーワードを抽出し、次に法规ベクトルベースから参照条文を検索し、最終的に法律大規模モデルが根拠に基づいて回答を生成します。これは専門能力がモデルパラメータにのみ依存するものではなく、外部資料もドメインアプリケーションの重要な構成要素であることを示しています。
専門データは専門的に信頼できるわけではありません。医療モデルは医学的エビデンスと境界を検証する必要があります。法律モデルは法令と引用を検証する必要があります。金融モデルはデータの鮮度と計算結果を検証する必要があります。コードモデルは実行とテストで検証する必要があります。医療、法律、金融などの高リスクタスクでは、専門家の承認を維持すべきです。
18.13 モデル幻覚:一見合理的だが根拠がない モデルを使用して会議録を整理する際、原文に担当者が指定されていないのに、モデルが自分で名前を補完する場合があります。モデルを使用して契約を抽出する際、原文に金額がないのに、モデルが具体的な数字を生成する場合があります。これらはすべてモデル幻覚に該当します。モデル幻覚とは、大規模モデルが流暢で完全な構造を持ちながらも、事実、入力材料、または検証可能な出典と一致しないコンテンツを生成することです。存在しない政策、論文、URLを捏造したり、人物や時刻を間違えたり、形成されていない討論を確定した結論として記載したりすることも含まれます。
大規模モデルの核心タスクはコンテキストに基づいて次のTokenを予測することであり、生成の过程中で、各文が真実であるかを検証することはできません。モデル幻覚を引き起こす原因は多数あります。例えば、事前訓練データに誤りや古い情報が含まれている可能性があります。ユーザーの質問に重要な条件が欠けている場合があります。長文書のエビデンスが無視されたり、切り詰められたりすることもあります。後訓練で設計された報酬関数が、完全で流暢な回答をより奨励する場合、モデルは根拠がなくても生成を続ける可能性があります。
18.13.1 一般的な幻覚のタイプ モデルが生成する幻覚も多様であり、通常、事実幻覚、応用幻覚、推論幻覚などに分類できます。詳細な分類と典型的な表現は以下の表に示されています:
タイプ
典型的な表現
事実幻覚
人名、日付、数字、イベントが実際の状況と一致しない
引用幻覚
論文、法令、リンク、出典を捏造
入力幻覚
元の材料に出现しなかった結論とフィールドを生成
推論幻覚
中間推導に誤りがあるが、回答は確信を持って表現
ツール幻覚
ファイルを読み込んだり、インターフェースを呼び出したと主張するが、実際には成功していない
汎用モデル以外に、訓練で取得したドメインモデルも幻覚を生成します。通常、専門データはドメインのパフォーマンスを改善できますが、すべての回答が正確であることを保証するものではありません。ナレッジベースの検索もすべての幻覚問題を完全に解決できるわけではありません。検索された材料が無関係、古くなっている、または誤りが含まれている場合、モデルは間違った結論に達する可能性があり、さらに幻覚を引き起こします。
18.13.2 幻覚リスクをどのように軽減するか 大規模モデルが幻覚を生成することは、現在のアプリケーションプロセスで比較的よくある問題です。プロンプトに「捏造しないでください」や「回答の正確性を保証してください」という1文を追加するだけでは、通常、この種のリスクを根本的に排除することはできません。モデルは本質的に依然としてコンテキストに基づいて最も出現する可能性の高いコンテンツを予測しており、入力情報が不十分、材料に矛盾がある、または質問自体がモデルの信頼できる知識の範囲を超える場合、一見合理的だが実際には正確でない回答を生成する可能性があります。したがって、幻覚リスクの軽減は、入力制約、外部検証、人間のレビューのシステムに大きく依存します。
まず、モデルに明確で関連性があり、互いに矛盾しない材料を提供し、無関係な情報と矛盾する情報が判断プロセスに干渉することを最小限に抑える必要があります。事実、数字、政策条項、実験結果などの重要なコンテンツについては、モデルに対応する出典、章、ページ番号、または原文の場所を明記するよう要求し、回答をトレーサブルにし、後の検証を容易にする必要があります。ニュース、政策、価格、法規、製品パラメータなどの頻繁に更新される知識については、モデルの内部記憶にのみ依存するのではなく、検索エンジン、ナレッジベース、データベース、API、またはその他の外部ツールで最新情報を取得し、これら信頼できる材料に基づいて分析させる必要があります。
次に、元の材料に特定の情報が確かに欠けている場合、モデルに「確認待ち」「原文で提供されていません」「既存の材料から判断できません」などの方法でマークするよう明確に要求する必要があります。経験に基づいて自分で補完するのではなく、日付、金額、身分証明書番号、統計データ、公式、コード実行結果などの構造化された検証に適したコンテンツについては、プログラムを導入して自動検証を行うこともできます。例えば、数値範囲、フィールドフォーマット、計算結果、コードが実際に実行できるかを確認し、モデルが言語のみに基づいて結果を生成することを回避します。
さらに、重要な結論、特にビジネスの意思決定、プロジェクトの検収、ユーザーの権利に影響を与えるコンテンツについては、人間のレビュー环节を維持すべきです。言語表現が流暢で、論理が一見完全であることは、事実が必ずしも正しいことを意味しないため、「本当に聞こえること」と「確かに真実であること」を直接同等視すべきではありません。医療、法律、金融、生産安全などの高リスクシーンでは、モデルが補助ツールであることを明確にし、最終的な結論は適切な資格と経験を持つ専門家が審査し、確認する必要があります。
したがって、幻覚を軽減する核心的なアイデアはモデルに「常に回答させる」ことではなく、信頼できる根拠が不足している場合に適切に停止させることです。既存の情報では結論を support できない場合、最も適切な行動は「現在哪些の重要な材料が不足しているか」「哪些の結論は一時的に確認できないか」を明確にし、さらにユーザーにどのデータ、文書、またはエビデンスを補充する必要があるかを伝えることです。一見完全だが根拠のない回答を生成し続けるよりも、このアプローチは通常より信頼性が高く、実際のビジネスアプリケーションにもより適しています。