AIUnlimited
🌳

AI-Fundamenten

🌱
AI Seeds

Begin bij nul

🌿
AI Sprouts

Bouw een fundament

🌳
AI Branches

Pas toe in de praktijk

🏕️
AI Canopy

Ga de diepte in

🌲
AI Forest

Beheers AI

🔨

AI-Meesterschap

✏️
AI Sketch

Begin bij nul

🪨
AI Chisel

Bouw een fundament

⚒️
AI Craft

Pas toe in de praktijk

💎
AI Polish

Ga de diepte in

🏆
AI Masterpiece

Beheers AI

📘

AI Praktijk

📖
Open-source modellen begrijpen

Fundamenten en bronnen voor open-source modellen

🎯
Van probleem naar modeltaak

Bedrijfsproblemen omzetten in modeltaken

⚡
Uw eerste model uitvoeren

Zie uw eerste resultaten in 30 minuten

🔧
Fijntuning en evaluatie

Modellen fijntunen en prestaties evalueren

🚀
Applicatiesystemen

Bouw echte AI-toepassingen

🎨
Generatieve AI

Verken open-source AIGC-modellen

🤖
Agents

Leer Agent-frameworks en MCP-tools

📐
Aanvullende fundamenten

LLM-basis en evaluatie

🎓

Claude Academie

🤖
Claude 101

Learn AI basics with Claude

💻
Claude Code 101

Code with Claude as your pair programmer

🤝
Introduction to Claude Cowork

Collaborate with Claude on complex projects

⚙️
Claude Platform 101

Build apps with the Claude API

Lab

7 experimenten geladen
🧬Neuraal Netwerk Sandbox🤖AI of Mens?🥋Prompt Engineering Dojo🏁Algoritme-race🧠AI-triviant🏗️Systeemontwerp Canvas
🎯Proef-sollicitatieGa naar het lab→
🚀

Carrièreontwikkeling

🚀
Interview Startplatform

Start je reis

🌟
Gedragsinterview Meesterschap

Beheers soft skills

💻
Technische Interviews

Slaag voor de codeerronde

🤖
AI- & ML-interviews

ML-interview meesterschap

🏆
Aanbod & verder

Bemachtig het beste aanbod

Begin met leren
AIUnlimited

MIT-licentie.

沪ICP备18025655号-11

Leren

  • AI-basis
  • AI Praktijk
  • Claude Academie
  • Lab
  • Carrièreontwikkeling

Community

  • Over ons
  • FAQ

Ondersteuning

  • footer.terms
  • footer.privacy
  • footer.contact
AI & Engineering Opleidingen›📖 Open-source modellen begrijpen›Lessen›Data: The Foundation of Fine-Tuning
📊
Open-source modellen begrijpen • Beginner⏱️ 12 min leestijd

Data: The Foundation of Fine-Tuning

Data: De Basis van Open Source Model Fine-Tuning

Ben je al een model tegengekomen dat uitstekend codeert en wiskunde oplost, maar willekeurige antwoorden geeft op alledaagse vragen?

We weten allemaal dat je om een specifieke vaardigheid te verbeteren tijdens het trainen de juiste gegevens moet vinden,

Maar veel gegevens vind je niet zomaar via een internetzoekopdracht; er is één uniforme downloadpoort voor gegevens, wat modeltrainers veel moeite bespaart.

Ons open-source Chinese DeepSeek-R1-ge-distilleerde dataset heeft een groot deel van de ruwe gegevens direct van ModelScope gedownload,,
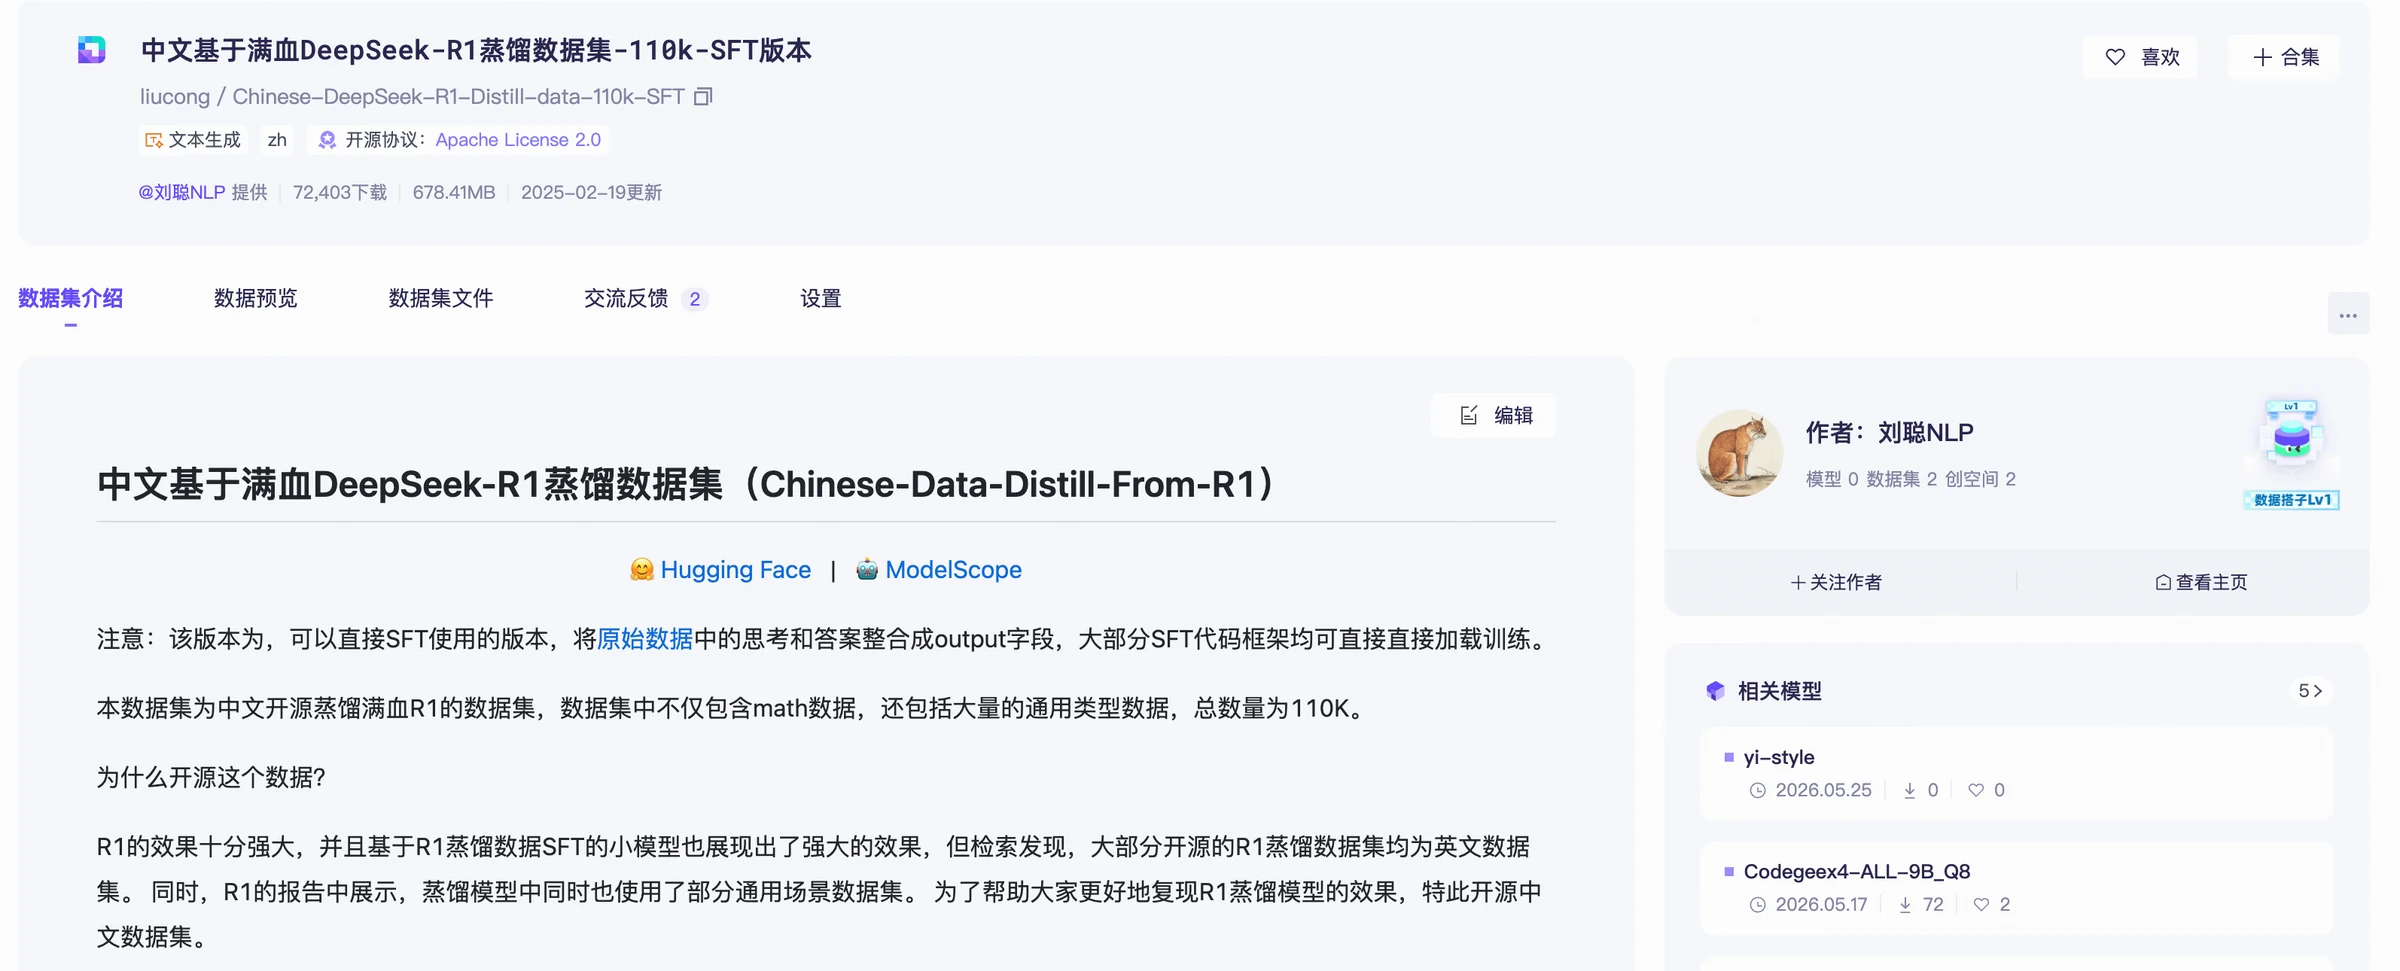
illustratie

Het fijnafstemmen van een model kan beginnen met een bestaande open-source dataset, waardoor het hele proces snel kan worden doorlopen.

Gegevens Vinden Vereist dat je Weet Wat je van Plan Bent

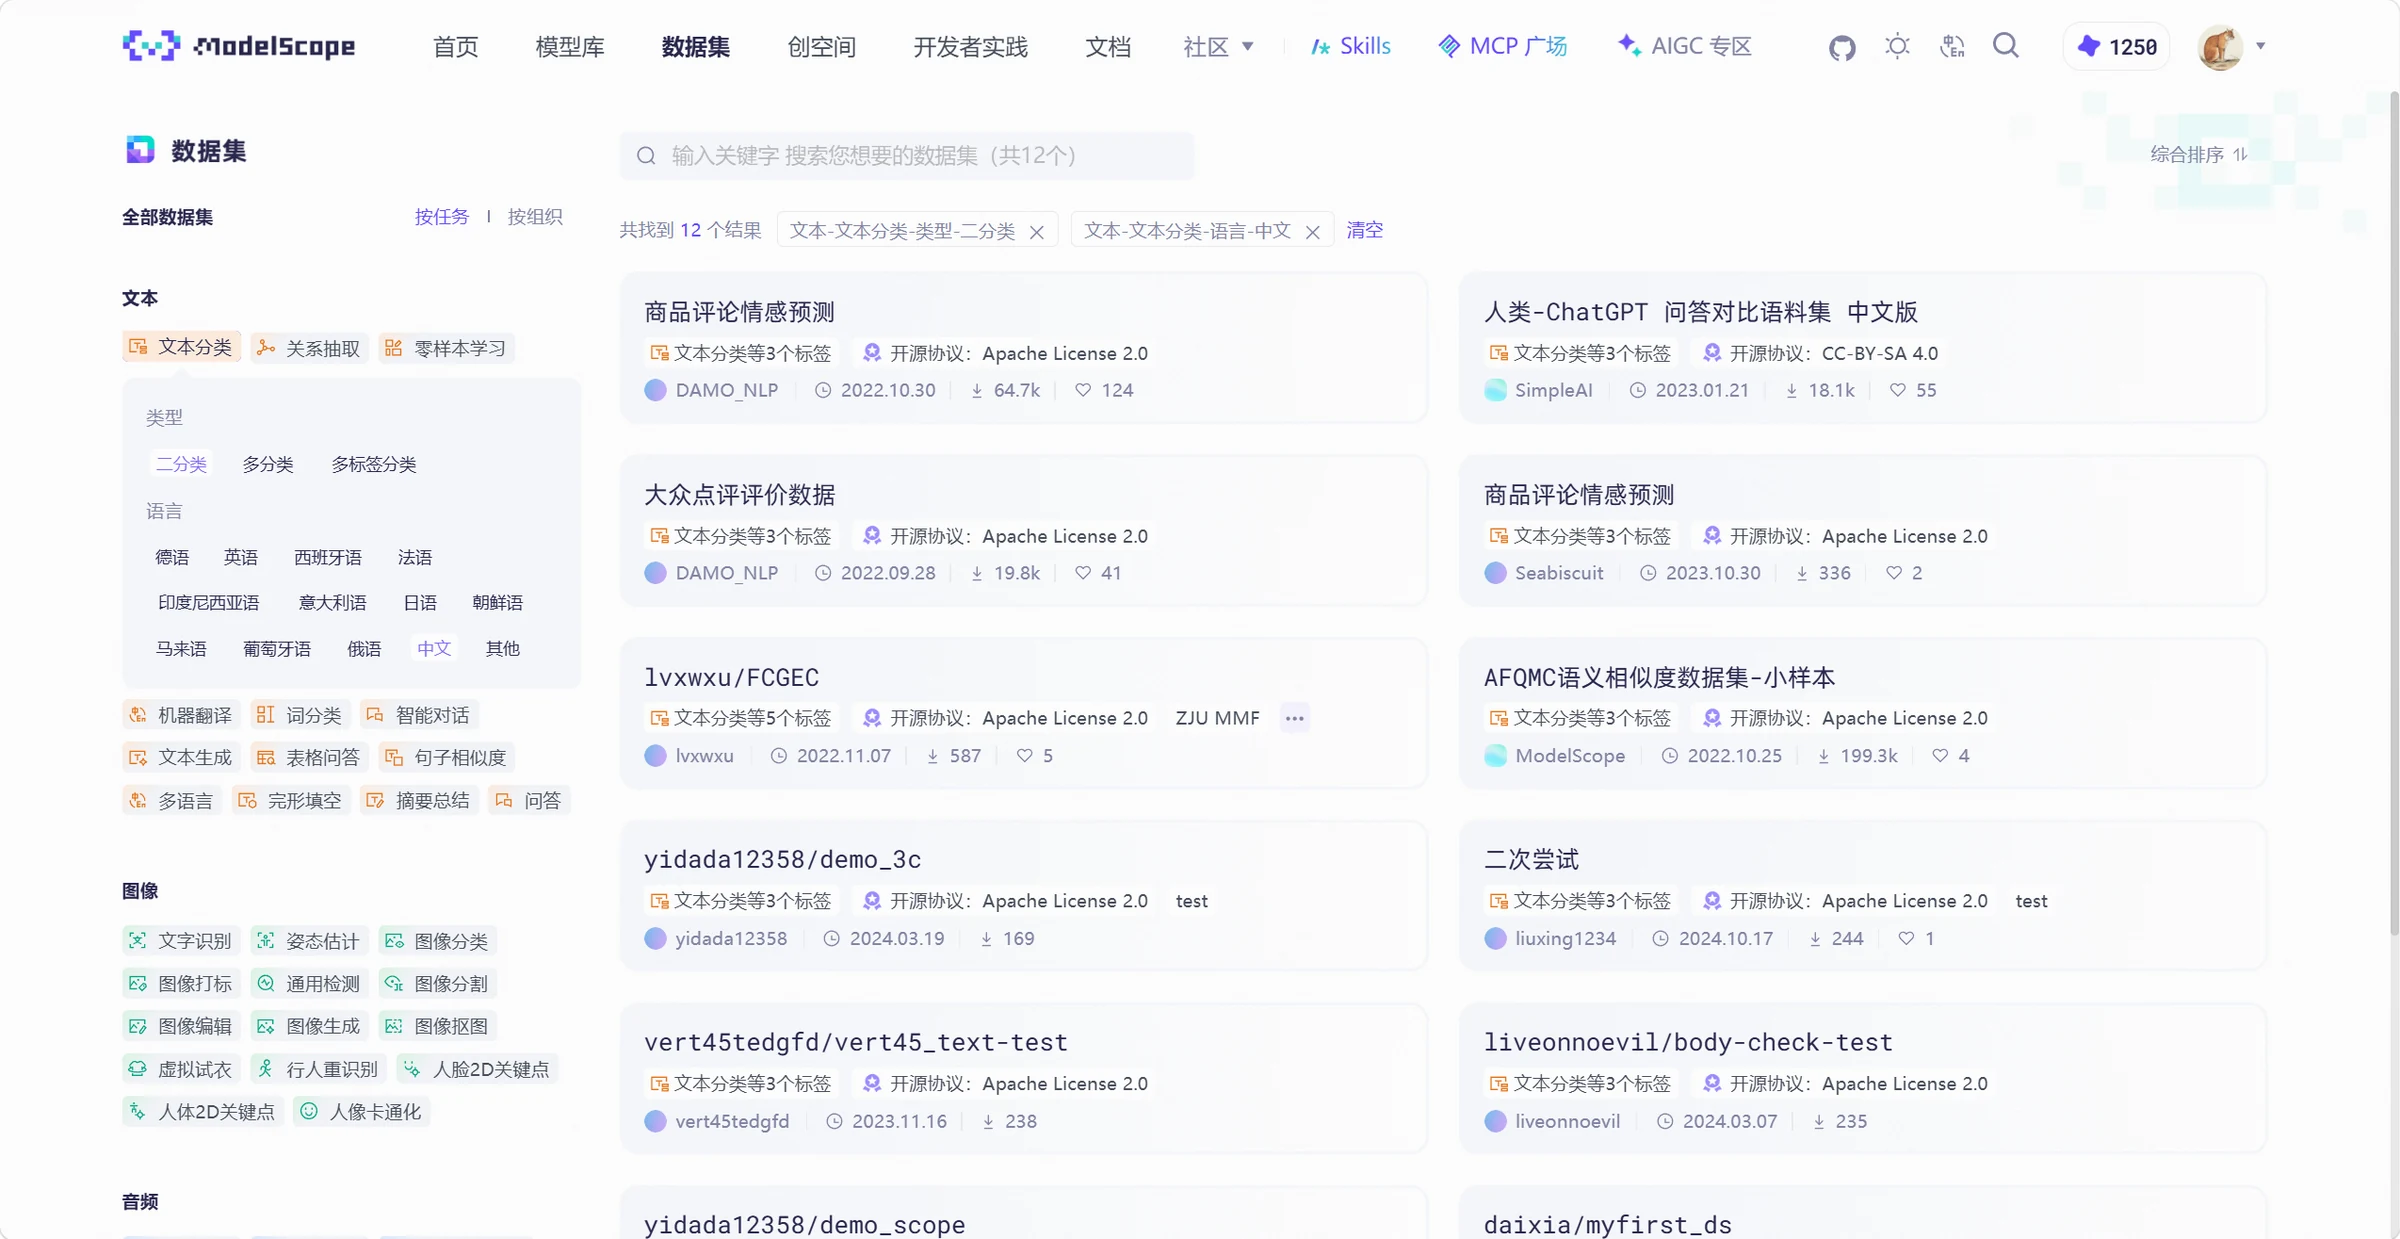
ModelScope heeft meer dan 40.000 open-source datasets met zoekfunctie, voorbeeldweergave, veldbeschrijvingen en versies.

ModelScope ondersteunt zoeken op trefwoorden en taakcategorieën, zoals Chinese binaire tekstclassificatiegegevens,
illustratie

Voordat je Downloadt, Bekijk Eerst een Paar Samples

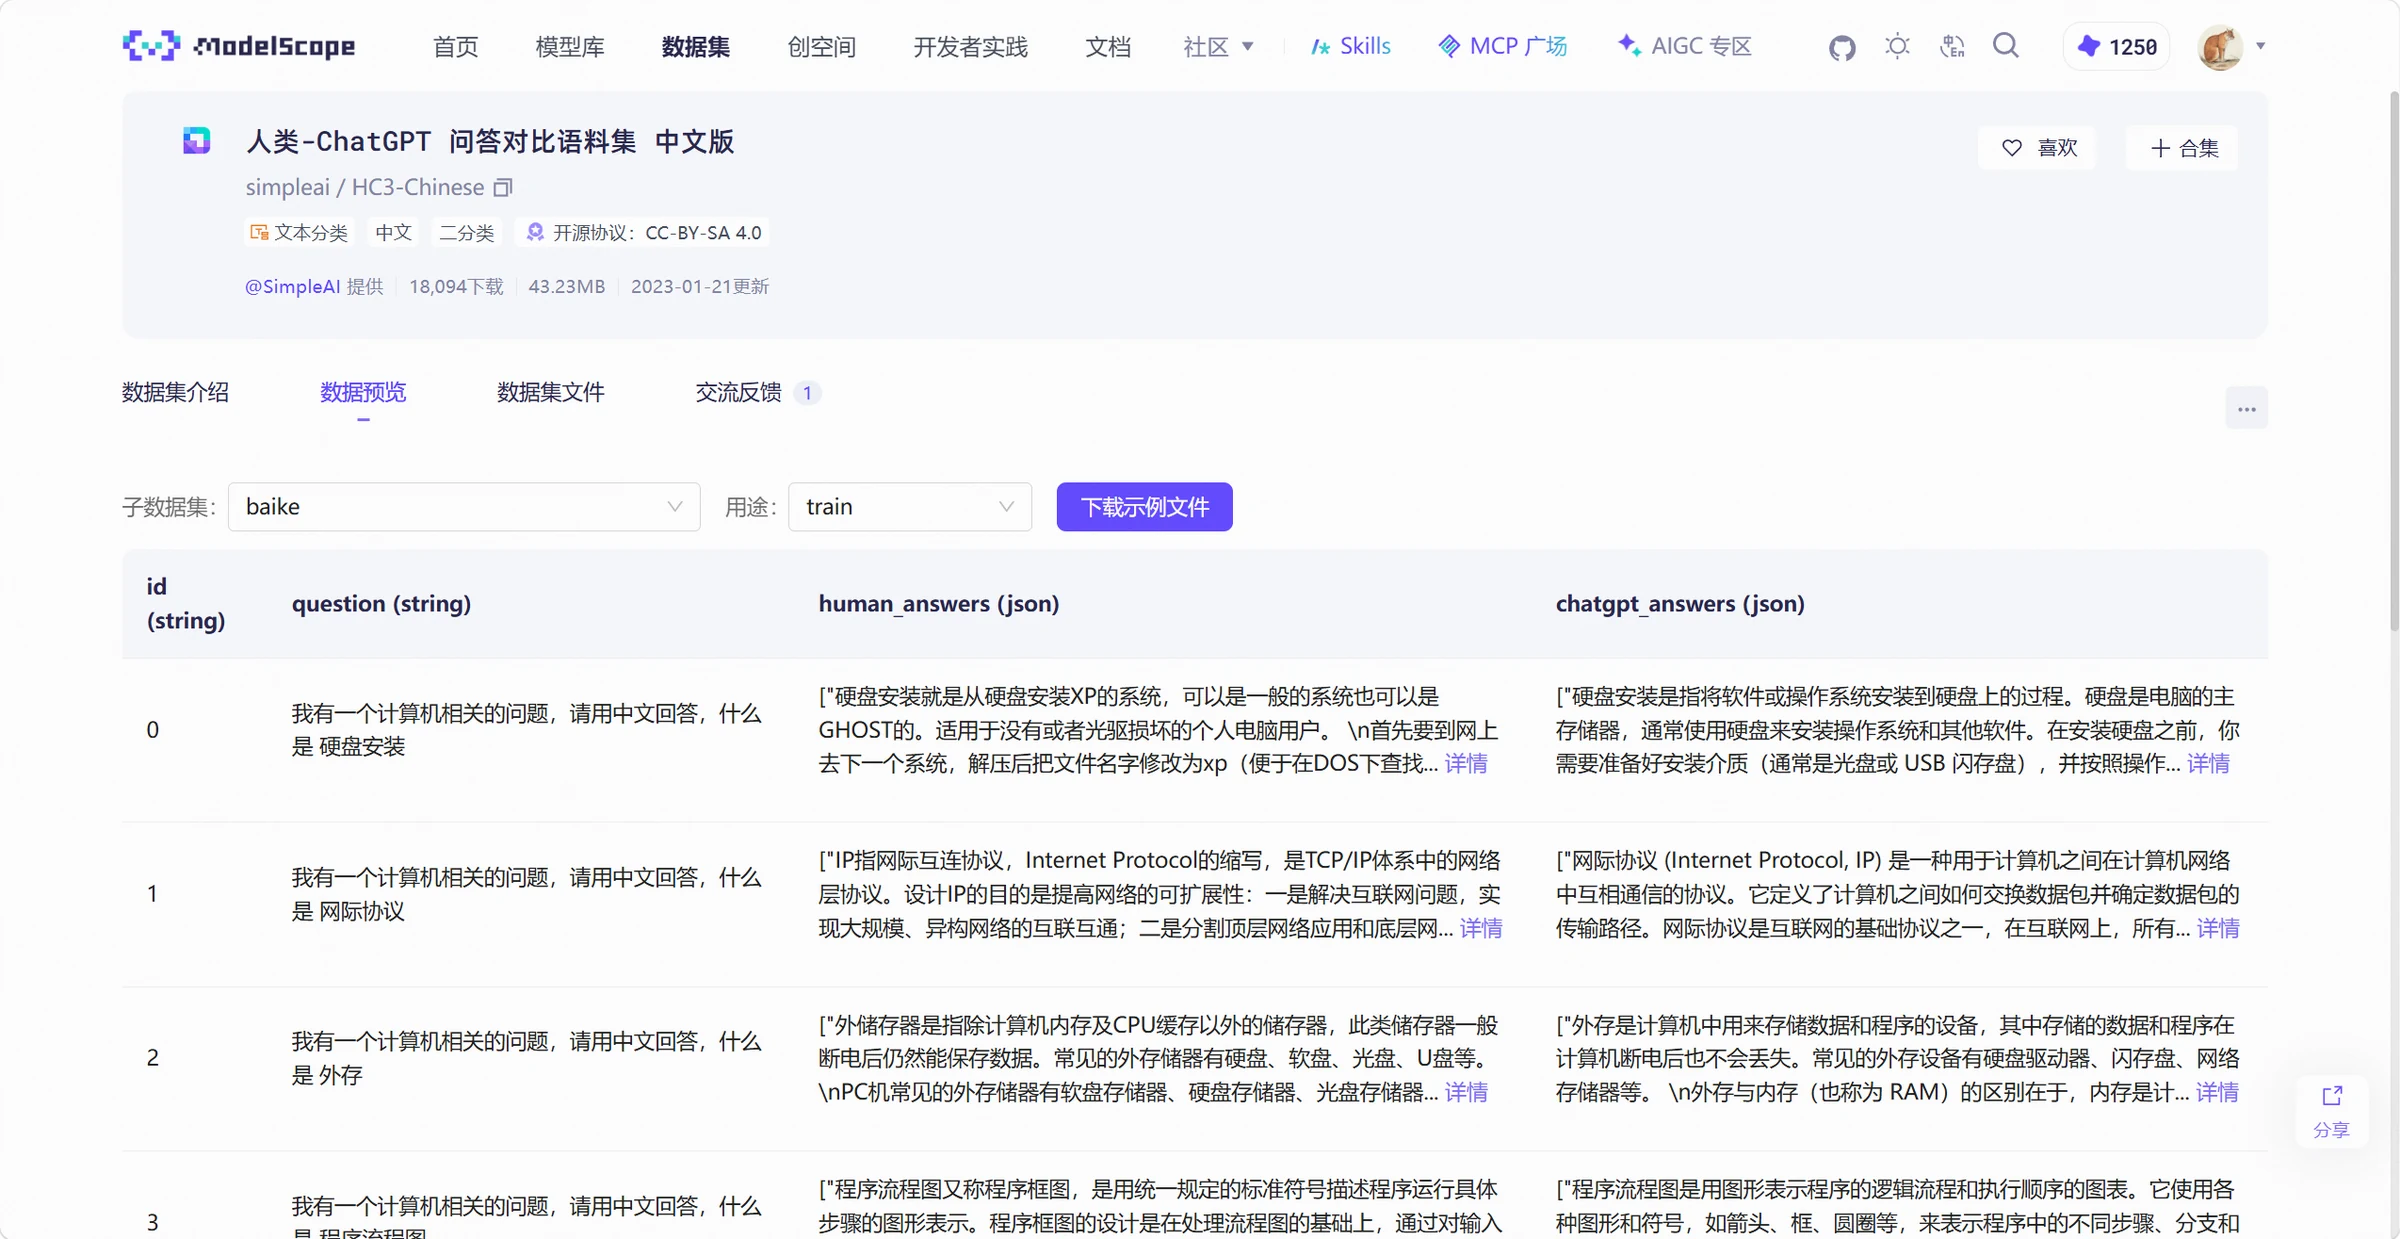
Na het filteren selecteer je een dataset en klik je op 'Voorbeeld' om monsters en veldbeschrijvingen online te bekijken, zoals simpleai/HC3-Chinese.
illustratie

Welke kolom de vraag, het antwoord, labels bevat, en of elk record tekst of dialoog is — alles kan van tevoren worden gecontroleerd.

Bij QA-gegevens kunnen menselijke en modelantwoorden in verschillende velden staan. Beslis welke velden je leest en hoe je organiseert voordat je traint.

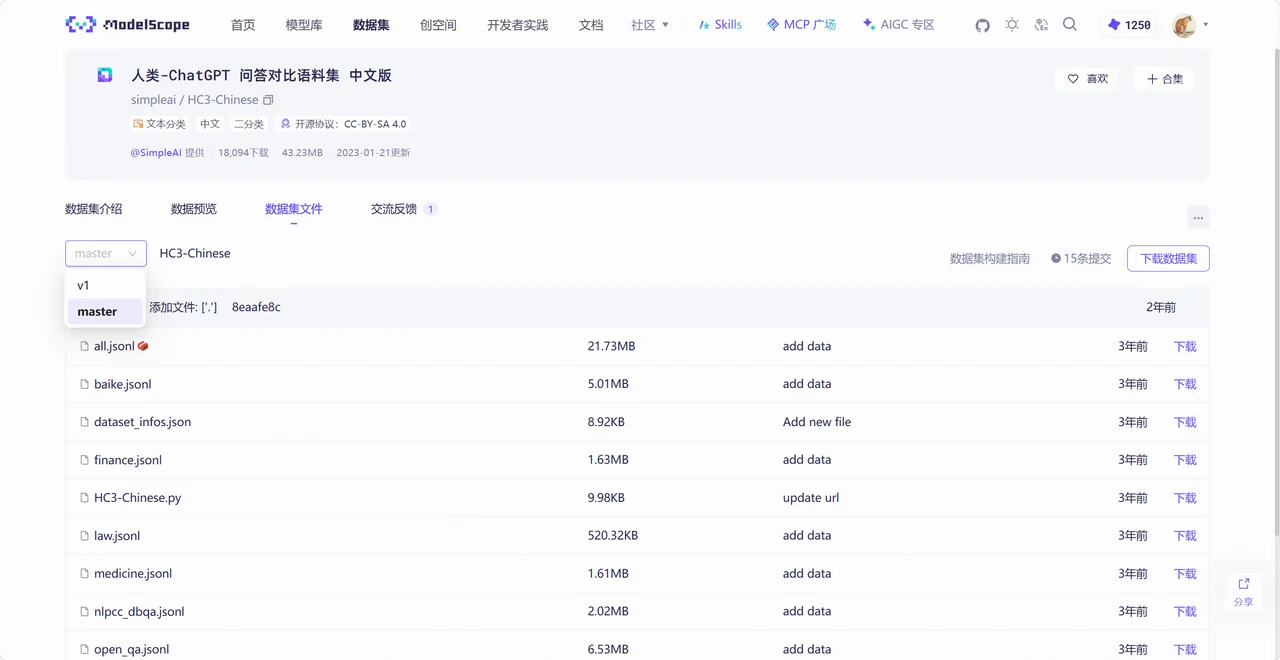
Controleer bestanden en versies. Datasets worden bijgewerkt; noteer de gebruikte versie voor reproduceerbaarheid.
illustratie

Beschrijvingen en licenties zijn het bekijken waard. Gedownloade gegevens kunnen verschillende vereisten hebben voor onderzoek, training of commercieel gebruik.

Laad Eerst de Gegevens, dan Beslis Je Wat te Gebruiken

ModelScope biedt de MsDataset.load-interface om datasets in Python te laden. Na installatie volg je de instructies op de datasetpagina.

Laad Eerst een Volledige Dataset

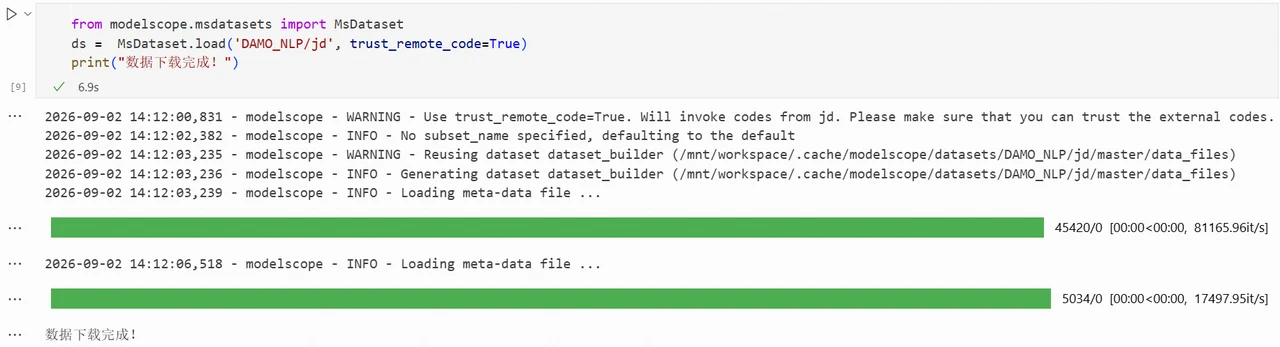
Met DAMO_NLP/jd als voorbeeld, zo lees je de standaardconfiguratie,

from modelscope.msdatasets import MsDataset

ds = MsDataset.load(
    'DAMO_NLP/jd',
    trust_remote_code=True,
)
print(ds)
Les 3 van 40% voltooid
←Model Discovery and Downloads

Discussie

Inloggen deelnemen aan de discussie
illustratie

Als je Alleen een Subset Nodig hebt, Specificeer de Naam

Sommige datasets scheiden gegevens op bron, domein of gebruik. Als je maar een deel nodig hebt, gebruik subset_name.

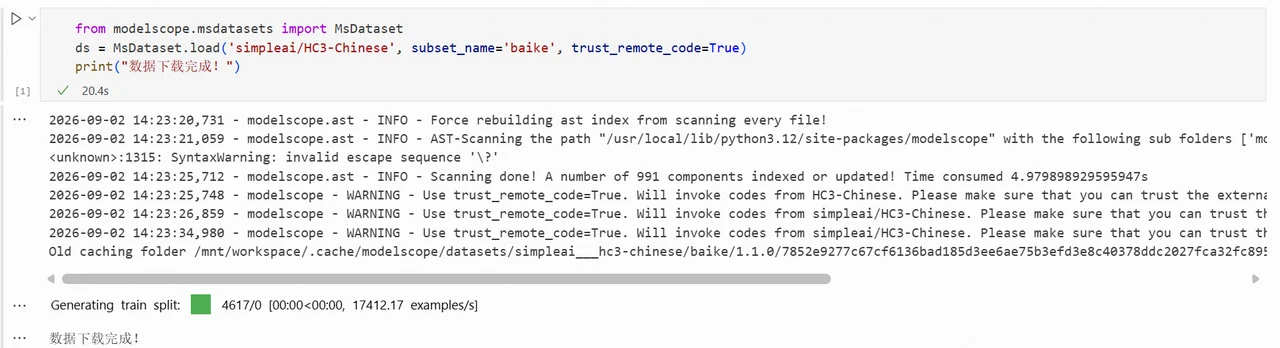
Bijvoorbeeld, laad de baike subset uit HC3-Chinese.

from modelscope.msdatasets import MsDataset

ds = MsDataset.load(
    'simpleai/HC3-Chinese',
    subset_name='baike',
    trust_remote_code=True,
)
print(ds)
illustratie

Bij het wisselen van dataset, controleer welke subsets beschikbaar zijn. baike is specifiek voor deze dataset.

Trainings- en Testsets Kunnen Apart Worden Geladen

De subset selecteert de gegevenscategorie, terwijl split de gegevenspartitie selecteert. Veelvoorkomend zijn train, validation en test.

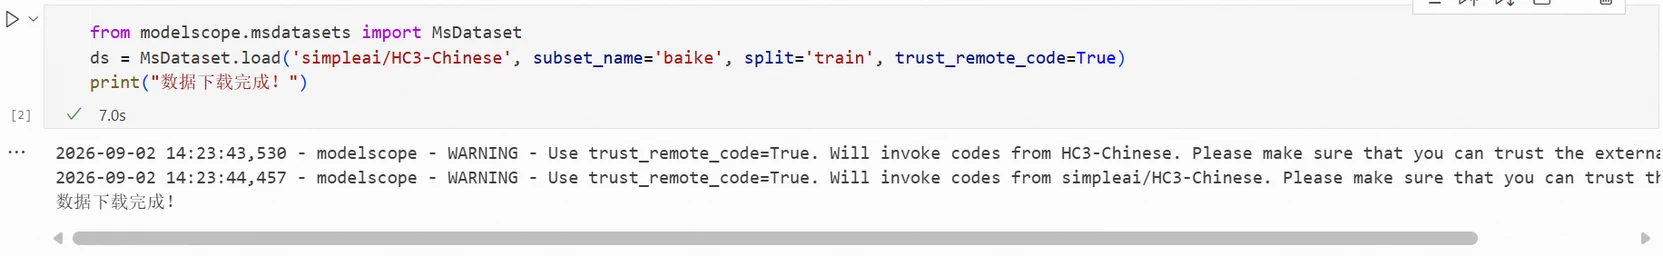
Om alleen de trainingsset van baike te laden, voeg je een extra parameter toe.

from modelscope.msdatasets import MsDataset

ds = MsDataset.load(
    'simpleai/HC3-Chinese',
    subset_name='baike',
    split='train',
    trust_remote_code=True,
)
print(ds[0])
illustratie

Niet alle datasets bieden alle drie de partities aan. Na het verkrijgen van de trainingsset, druk een monster af om te verifiëren.

Om Experimenten te Reproduceren, Noteer de Versie

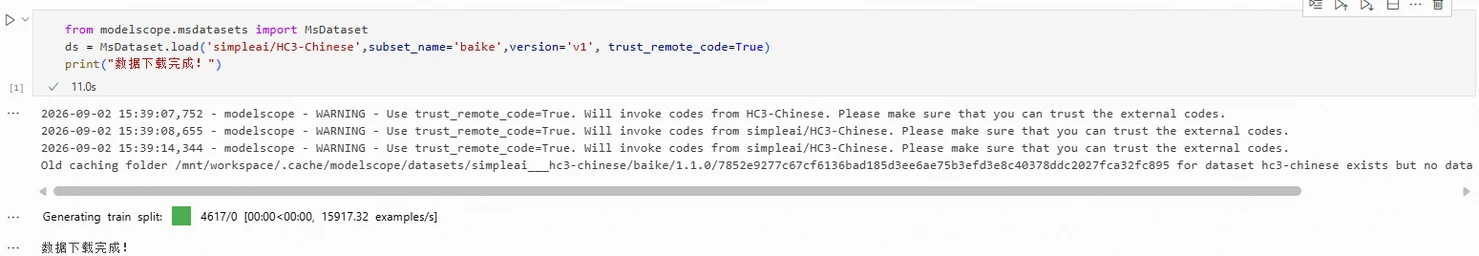
Na updates kan dezelfde code verschillende inhoud lezen. Met HC3-Chinese v1 als voorbeeld, specificeer via version.

from modelscope.msdatasets import MsDataset

ds = MsDataset.load(
    'simpleai/HC3-Chinese',
    subset_name='baike',
    version='v1',
    trust_remote_code=True,
)
print(ds)
illustratie

Controleer beschikbare versies op de datasetpagina. Als een versie continu wordt bijgewerkt, bewaar de gebruikte bestanden of checksums.

Gegevens Gedownload? Forceer ze Niet Direct naar het Model

Controleer eerst een paar monsters op nullen, beschadigde tekens of opvallende fouten, bevestig dan dat de velden aan de eisen van de code voldoen.

Trainings- en testgegevens moeten gescheiden worden. Meng testmonsters niet in de trainingsset.