AIUnlimited
🌳

AI-Fundamenten

🌱
AI Seeds

Begin bij nul

🌿
AI Sprouts

Bouw een fundament

🌳
AI Branches

Pas toe in de praktijk

🏕️
AI Canopy

Ga de diepte in

🌲
AI Forest

Beheers AI

🔨

AI-Meesterschap

✏️
AI Sketch

Begin bij nul

🪨
AI Chisel

Bouw een fundament

⚒️
AI Craft

Pas toe in de praktijk

💎
AI Polish

Ga de diepte in

🏆
AI Masterpiece

Beheers AI

📘

AI Praktijk

📖
Open-source modellen begrijpen

Fundamenten en bronnen voor open-source modellen

🎯
Van probleem naar modeltaak

Bedrijfsproblemen omzetten in modeltaken

⚡
Uw eerste model uitvoeren

Zie uw eerste resultaten in 30 minuten

🔧
Fijntuning en evaluatie

Modellen fijntunen en prestaties evalueren

🚀
Applicatiesystemen

Bouw echte AI-toepassingen

🎨
Generatieve AI

Verken open-source AIGC-modellen

🤖
Agents

Leer Agent-frameworks en MCP-tools

📐
Aanvullende fundamenten

LLM-basis en evaluatie

🎓

Claude Academie

🤖
Claude 101

Learn AI basics with Claude

💻
Claude Code 101

Code with Claude as your pair programmer

🤝
Introduction to Claude Cowork

Collaborate with Claude on complex projects

⚙️
Claude Platform 101

Build apps with the Claude API

Lab

7 experimenten geladen
🧬Neuraal Netwerk Sandbox🤖AI of Mens?🥋Prompt Engineering Dojo🏁Algoritme-race🧠AI-triviant🏗️Systeemontwerp Canvas
🎯Proef-sollicitatieGa naar het lab→
🚀

Carrièreontwikkeling

🚀
Interview Startplatform

Start je reis

🌟
Gedragsinterview Meesterschap

Beheers soft skills

💻
Technische Interviews

Slaag voor de codeerronde

🤖
AI- & ML-interviews

ML-interview meesterschap

🏆
Aanbod & verder

Bemachtig het beste aanbod

Begin met leren
AIUnlimited

MIT-licentie.

沪ICP备18025655号-11

Leren

  • AI-basis
  • AI Praktijk
  • Claude Academie
  • Lab
  • Carrièreontwikkeling

Community

  • Over ons
  • FAQ

Ondersteuning

  • footer.terms
  • footer.privacy
  • footer.contact
AI & Engineering Opleidingen›🔧 Fijntuning en evaluatie›Lessen›Fine-Tuning with ms-swift
🚀
Fijntuning en evaluatie • Beginner⏱️ 25 min leestijd

Fine-Tuning with ms-swift

Snel ms-swift gebruiken om open-source modellen te fijntunen

Wanneer een algemeen model niet direct kan voldoen aan specifieke bedrijfsbehoeften, kunt u uw eigen bedrijfsgegevens gebruiken om het model fijnt te tunen, zodat het specifieke taken en uitvoermethoden beter leert.

Neem entiteitsherkenning in e-commerce als voorbeeld. We hebben een model nodig dat productnamen, merknamen en modelnummers in de tekst herkent, met de bijbehorende categorie en locatie. Het model kan zeer deskundig zijn over deze producten, maar bij daadwerkelijk gebruik mogen de geëxtraheerde informatie niet onvolledig zijn, de velden moeten gestandaardiseerd zijn en het uitvoerformaat moet stabiel zijn.

Als de taak en de uitvoereisen al duidelijk zijn en u georganiseerde voorbeelden heeft, kunt u proberen deze gegevens te gebruiken voor fijntuning, zodat het model het werk leert dat we willen dat het uitvoert.

Hieronder gebruiken we ms-swift om een LoRA-fijntuningsproces door te lopen, inclusief gegevensvoorbereiding, training, gewichtsmerging en inferentie.

Wat verandert fijntuning eigenlijk aan het model?

Algemene large language models bezitten al sterke capaciteiten op het gebied van taalbegrip, kennisvraag-en-antwoord, tekstgeneratie en andere algemene taken. In daadwerkelijke bedrijfsscenario's presteren algemene modellen mogelijk niet direct aan specifieke eisen.

Bijvoorbeeld, we willen dat het model bepaalde informatie-extractietaken nauwkeurig uitvoert, resultaten in een opgegeven formaat produceert of specifieke vragen op een uniforme manier beantwoordt. Voor deze behoeften kunnen we specifieke gegevens gebruiken om op basis van een bestaand model te trainen, zodat het model de bijbehorende taakeisen en antwoordmethoden beter leert. Dit proces wordt model-fijntuning genoemd.

Fijntuning is niet het opnieuw trainen van een model vanaf nul, maar een verdere aanpassing op basis van de bestaande capaciteiten om het beter geschikt te maken voor specifieke toepassingsscenario's.
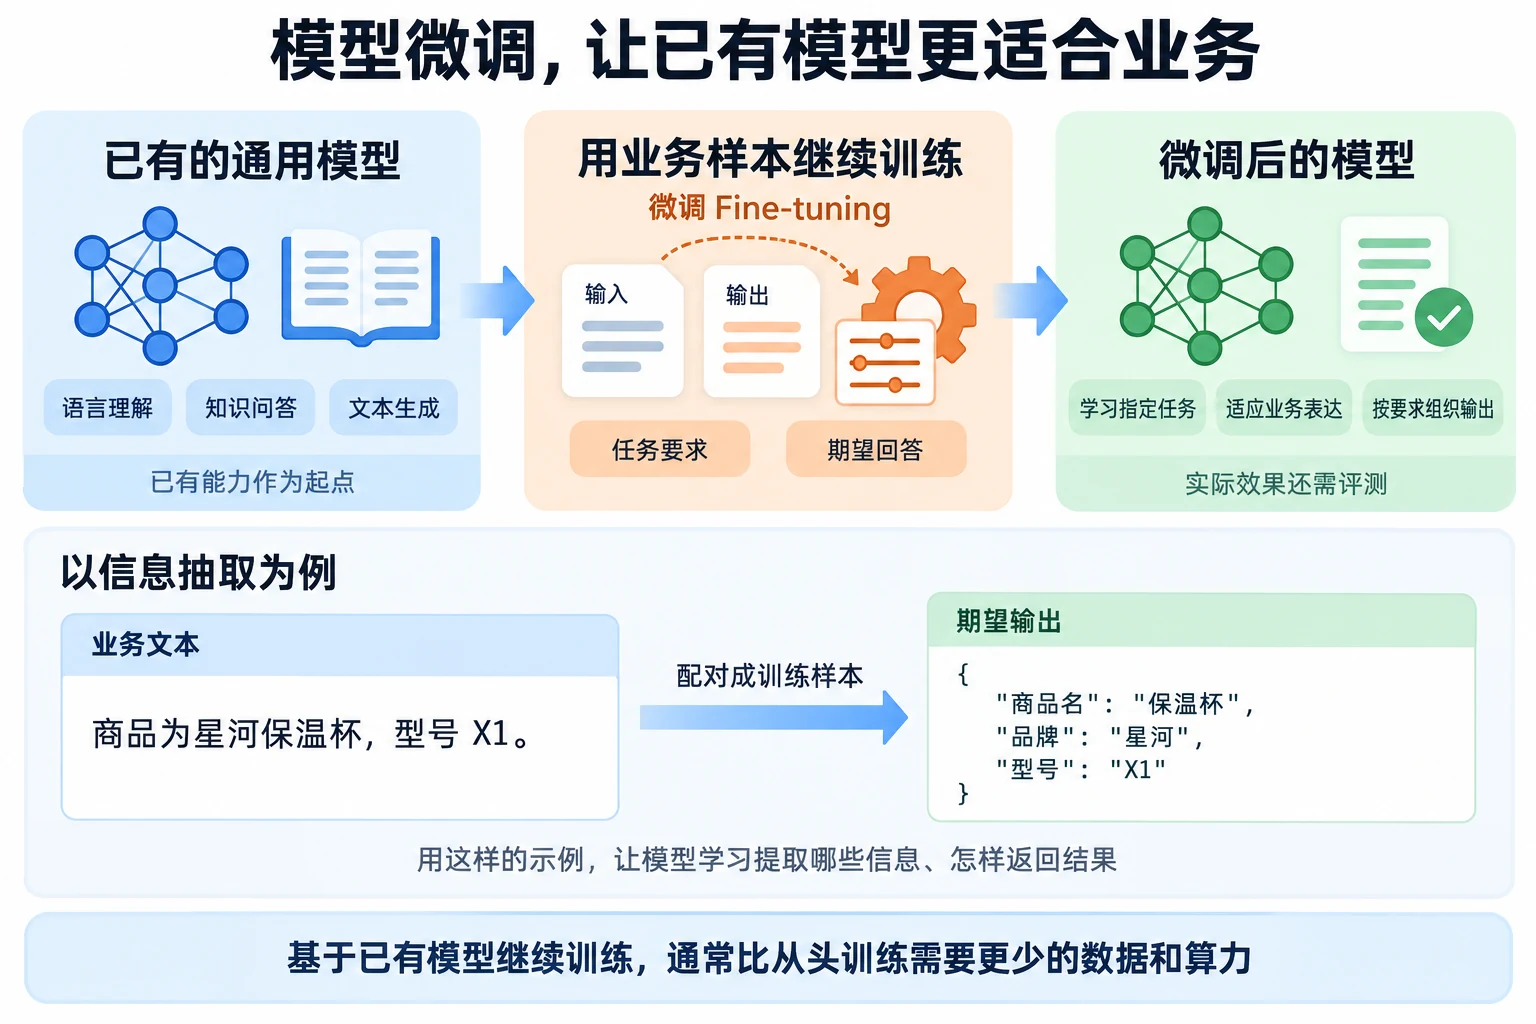
illustratie

Momenteel is SFT (Supervised Fine-Tuning) de meest gebruikelijke methode bij large language model fijntuning. SFT gebruikt gegevens met standaardantwoorden om het model te trainen. Elke trainingsinvoer bevat meestal een invoer en de bijbehorende uitvoer, waardoor het model leert welk type resultaten te genereren bij een gegeven invoer.

Naast SFT kan large language model training ook Versterkend Leren (Reinforcement Learning, RL) gebruiken. In tegenstelling tot SFT dat standaardantwoorden direct levert, beoordeelt versterkend leren voornamelijk met beloningssignalen de kwaliteit van door het model gegenereerde resultaten en past het uitvoergedrag van het model voortdurend aan op basis van beloningsresultaten.

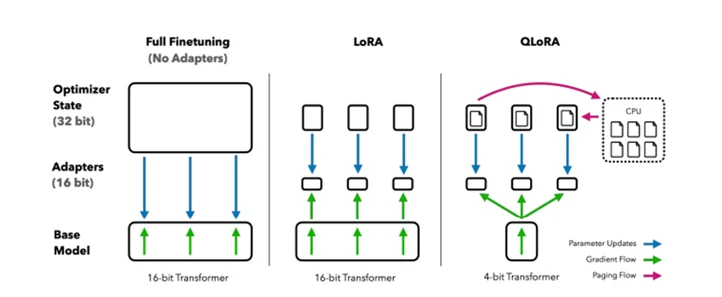
Volledige parameters, LoRA en QLoRA — wat is het verschil?

  1. Volledige-Parameter Fijntuning: Tijdens de training worden alle parameters van het model bijgewerkt. Volledige-parameter fijntuning vereist aanzienlijk meer GPU-geheugen en rekenresources.

Les 2 van 40% voltooid
←Training Data Preparation

Discussie

Inloggen deelnemen aan de discussie
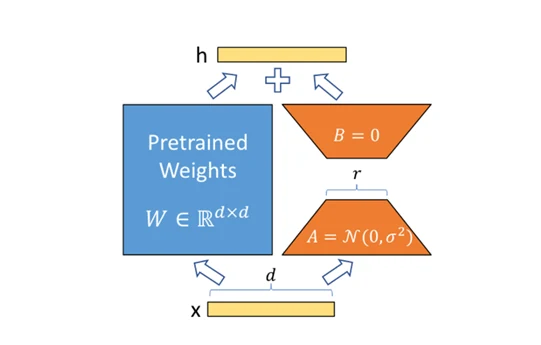
  • LoRA-Fijntuning (Low-Rank Adaptation): Het kernidee van LoRA is om de gewichten van het voortrainde model te bevriezen en traineerbare rangontmatrices in elke laag van de Transformer-architectuur te injecteren.

  • illustratie

    Specifiek, aannemende dat de voortrainde matrix $W_0 \in \mathbb{R}^{d \times k}$ is:

    W = W_0 + \Delta W = W_0 + BA
    

    Waarbij $\Delta W$ de gewichtswisselingen vertegenwoordigt die tijdens fijntuning moeten worden geleerd:

    B \in \mathbb{R}^{d \times r}, \quad A \in \mathbb{R}^{r \times k}, \quad r \ll \min(d,k)
    
    1. QLoRA-Fijntuning (Quantized LoRA): QLoRA vermindert het GPU-geheugengebruik van het basismodel door kwantisatie, waardoor grotere modellen kunnen worden fijngestemd met beperkte GPU-middelen.
    illustratie

    QLoRA's belangrijkste innovaties omvatten:

    1. 4-bit NormalFloat (NF4): informationeel-theoretisch optimaal voor normaal verdeelde gewichten;
    2. Dubbele Kwantisatie: vermindert gemiddeld geheugengebruik;
    3. Gepagineerde Optimizers: helpen om geheugenpieken te beheren.

    Hoe een fijntuningsmethode kiezen: begin met de taak en GPU

    Voor de meeste fijntuningstaken kunt u eerst LoRA proberen. LoRA vereist alleen het trainen van een klein aantal nieuwe parameters.

    Als het basismodel groot is en er na LoRA niet genoeg GPU-geheugen overblijft, kunt u QLoRA overwegen. QLoRA is meer geschikt voor scenario's met grote modelschalen en beperkte GPU-middelen.

    Als de GPU-middelen relatief voldoende zijn en de taak uitgebreidere modelaanpassingen vereist, kunt u volledige-parameter fijntuning overwegen.

    ms-swift gebruiken om een fijntuning uit te voeren

    Welke werk kan ms-swift ons besparen?

    ms-swift (SWIFT, Scalable lightWeight Infrastructure for Fine-Tuning) is een open-source large language model trainings- en deploymentsframework van de ModelScope-community.

    illustratie

    Momenteel ondersteunt het large language models zoals Qwen, DeepSeek, Llama, GLM en InternLM, evenals multimodale modellen zoals Qwen-VL en InternVL.

    U kunt meer gebruiksmethoden vinden op ms-swift.

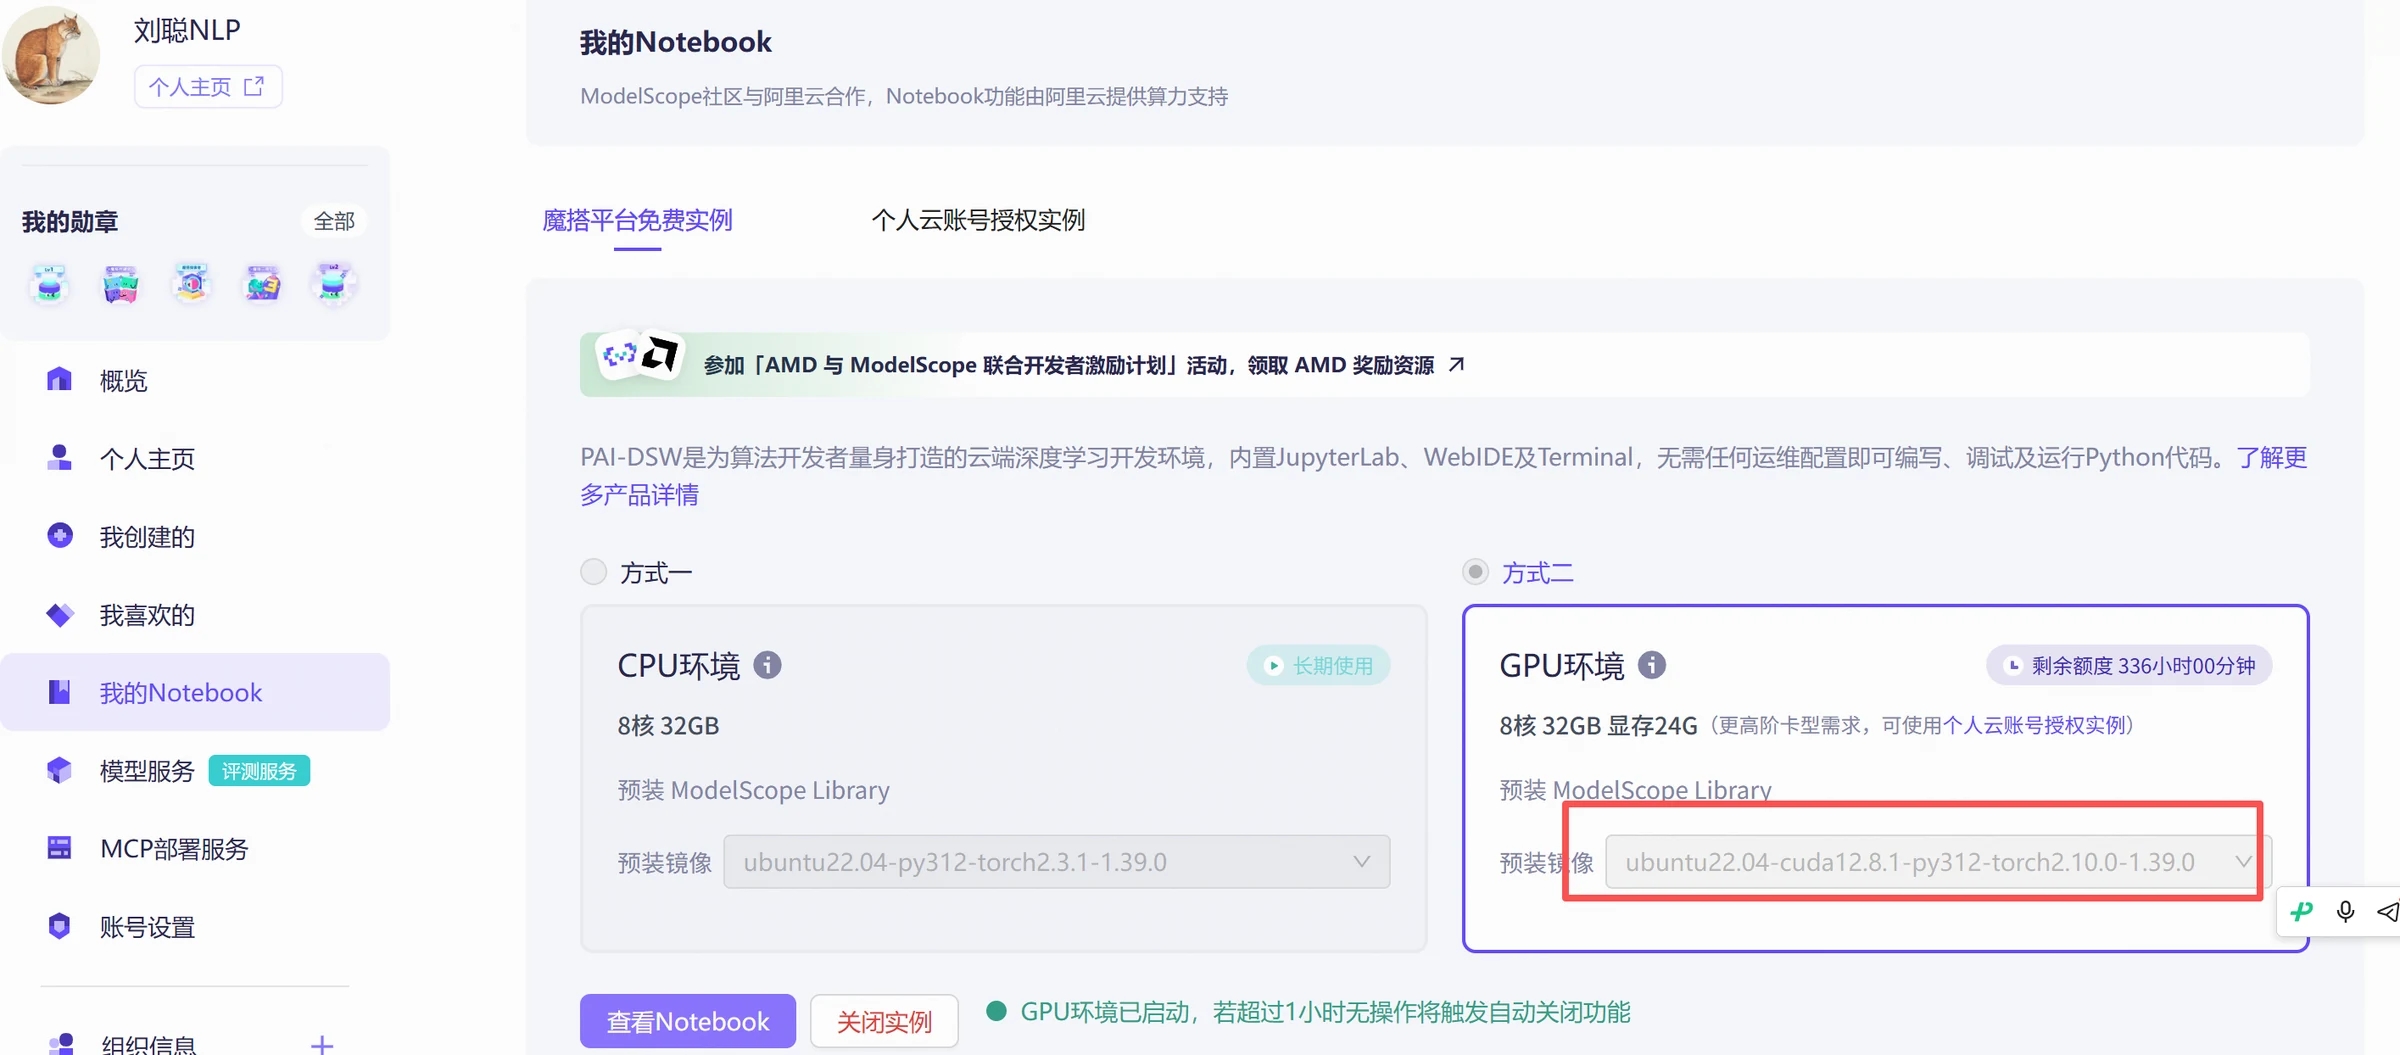
    Praktijktraining met een entiteitsherkenningstaak

    illustratie

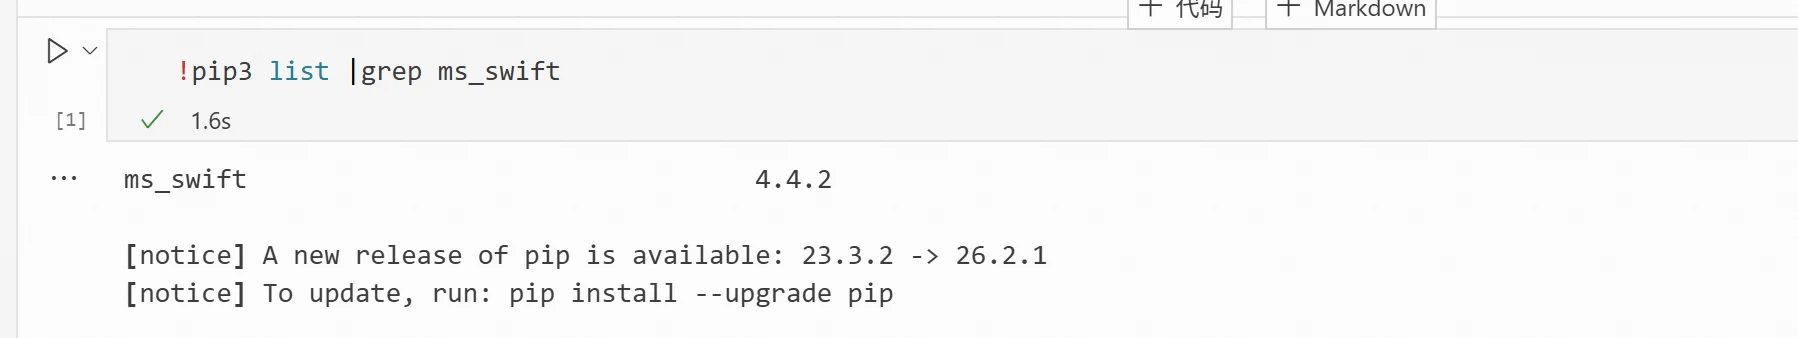
    1) Controleer of ms-swift al is geïnstalleerd:

    !pip3 list |grep ms_swift
    
    illustratie

    Als niet geïnstalleerd:

    !pip3 install ms-swift
    
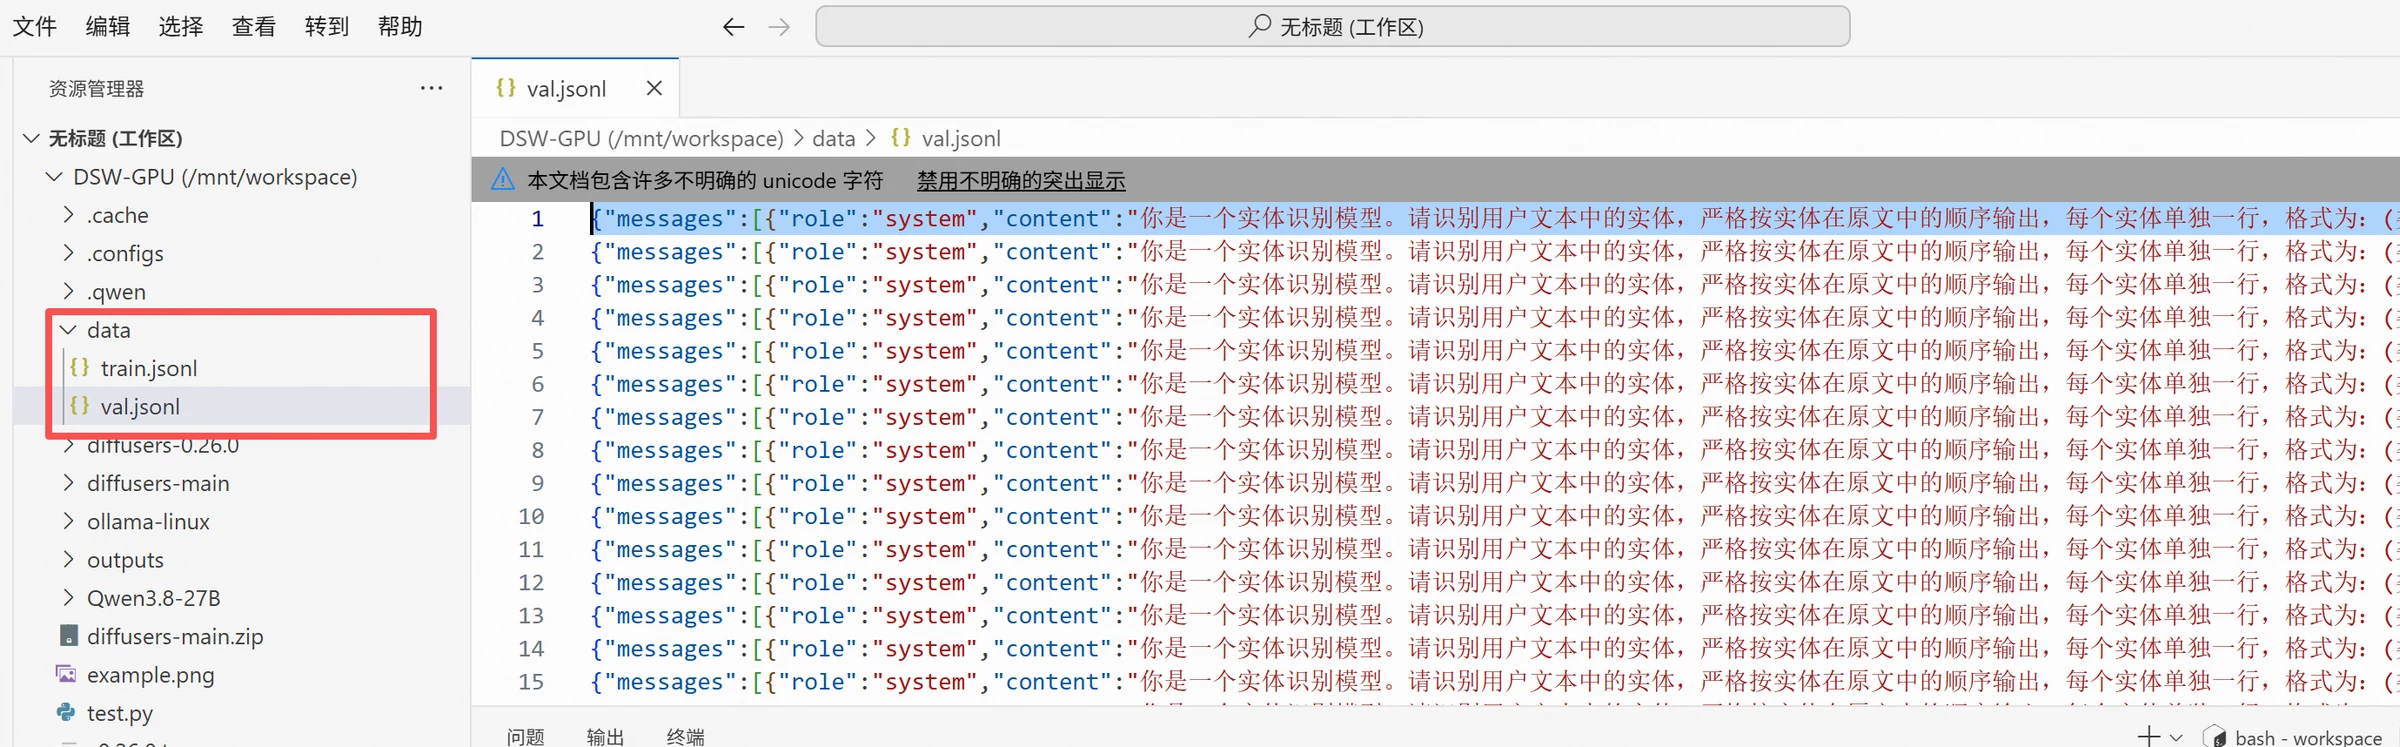
    1. Gegevensvoorbereiding. Het dataset bevat vier entiteitstypen: HCCX, HPPX, XH en MISC.

    3) Maak een data map en upload de gegevens:

    {"messages":[{"role":"system","content":"U bent een entiteitsherkenningmodel. Identificeer entiteiten in de tekst van de gebruiker. Geef entiteiten strikt in hun volgorde van voorkomen in de originele tekst, elk entiteit op een aparte regel in het formaat: (type, entiteit tekst, startpositie)."},{"role":"user","content":"推bb护肤刮痧l背疗橄榄油全身按开背足体按油身m油5摩油摩精00"},{"role":"assistant","content":"(HCCX,橄榄油,10)\n(HCCX,按油,20)\n(HCCX,油,24)\n(HCCX,油,27)"}]}
    
    illustratie
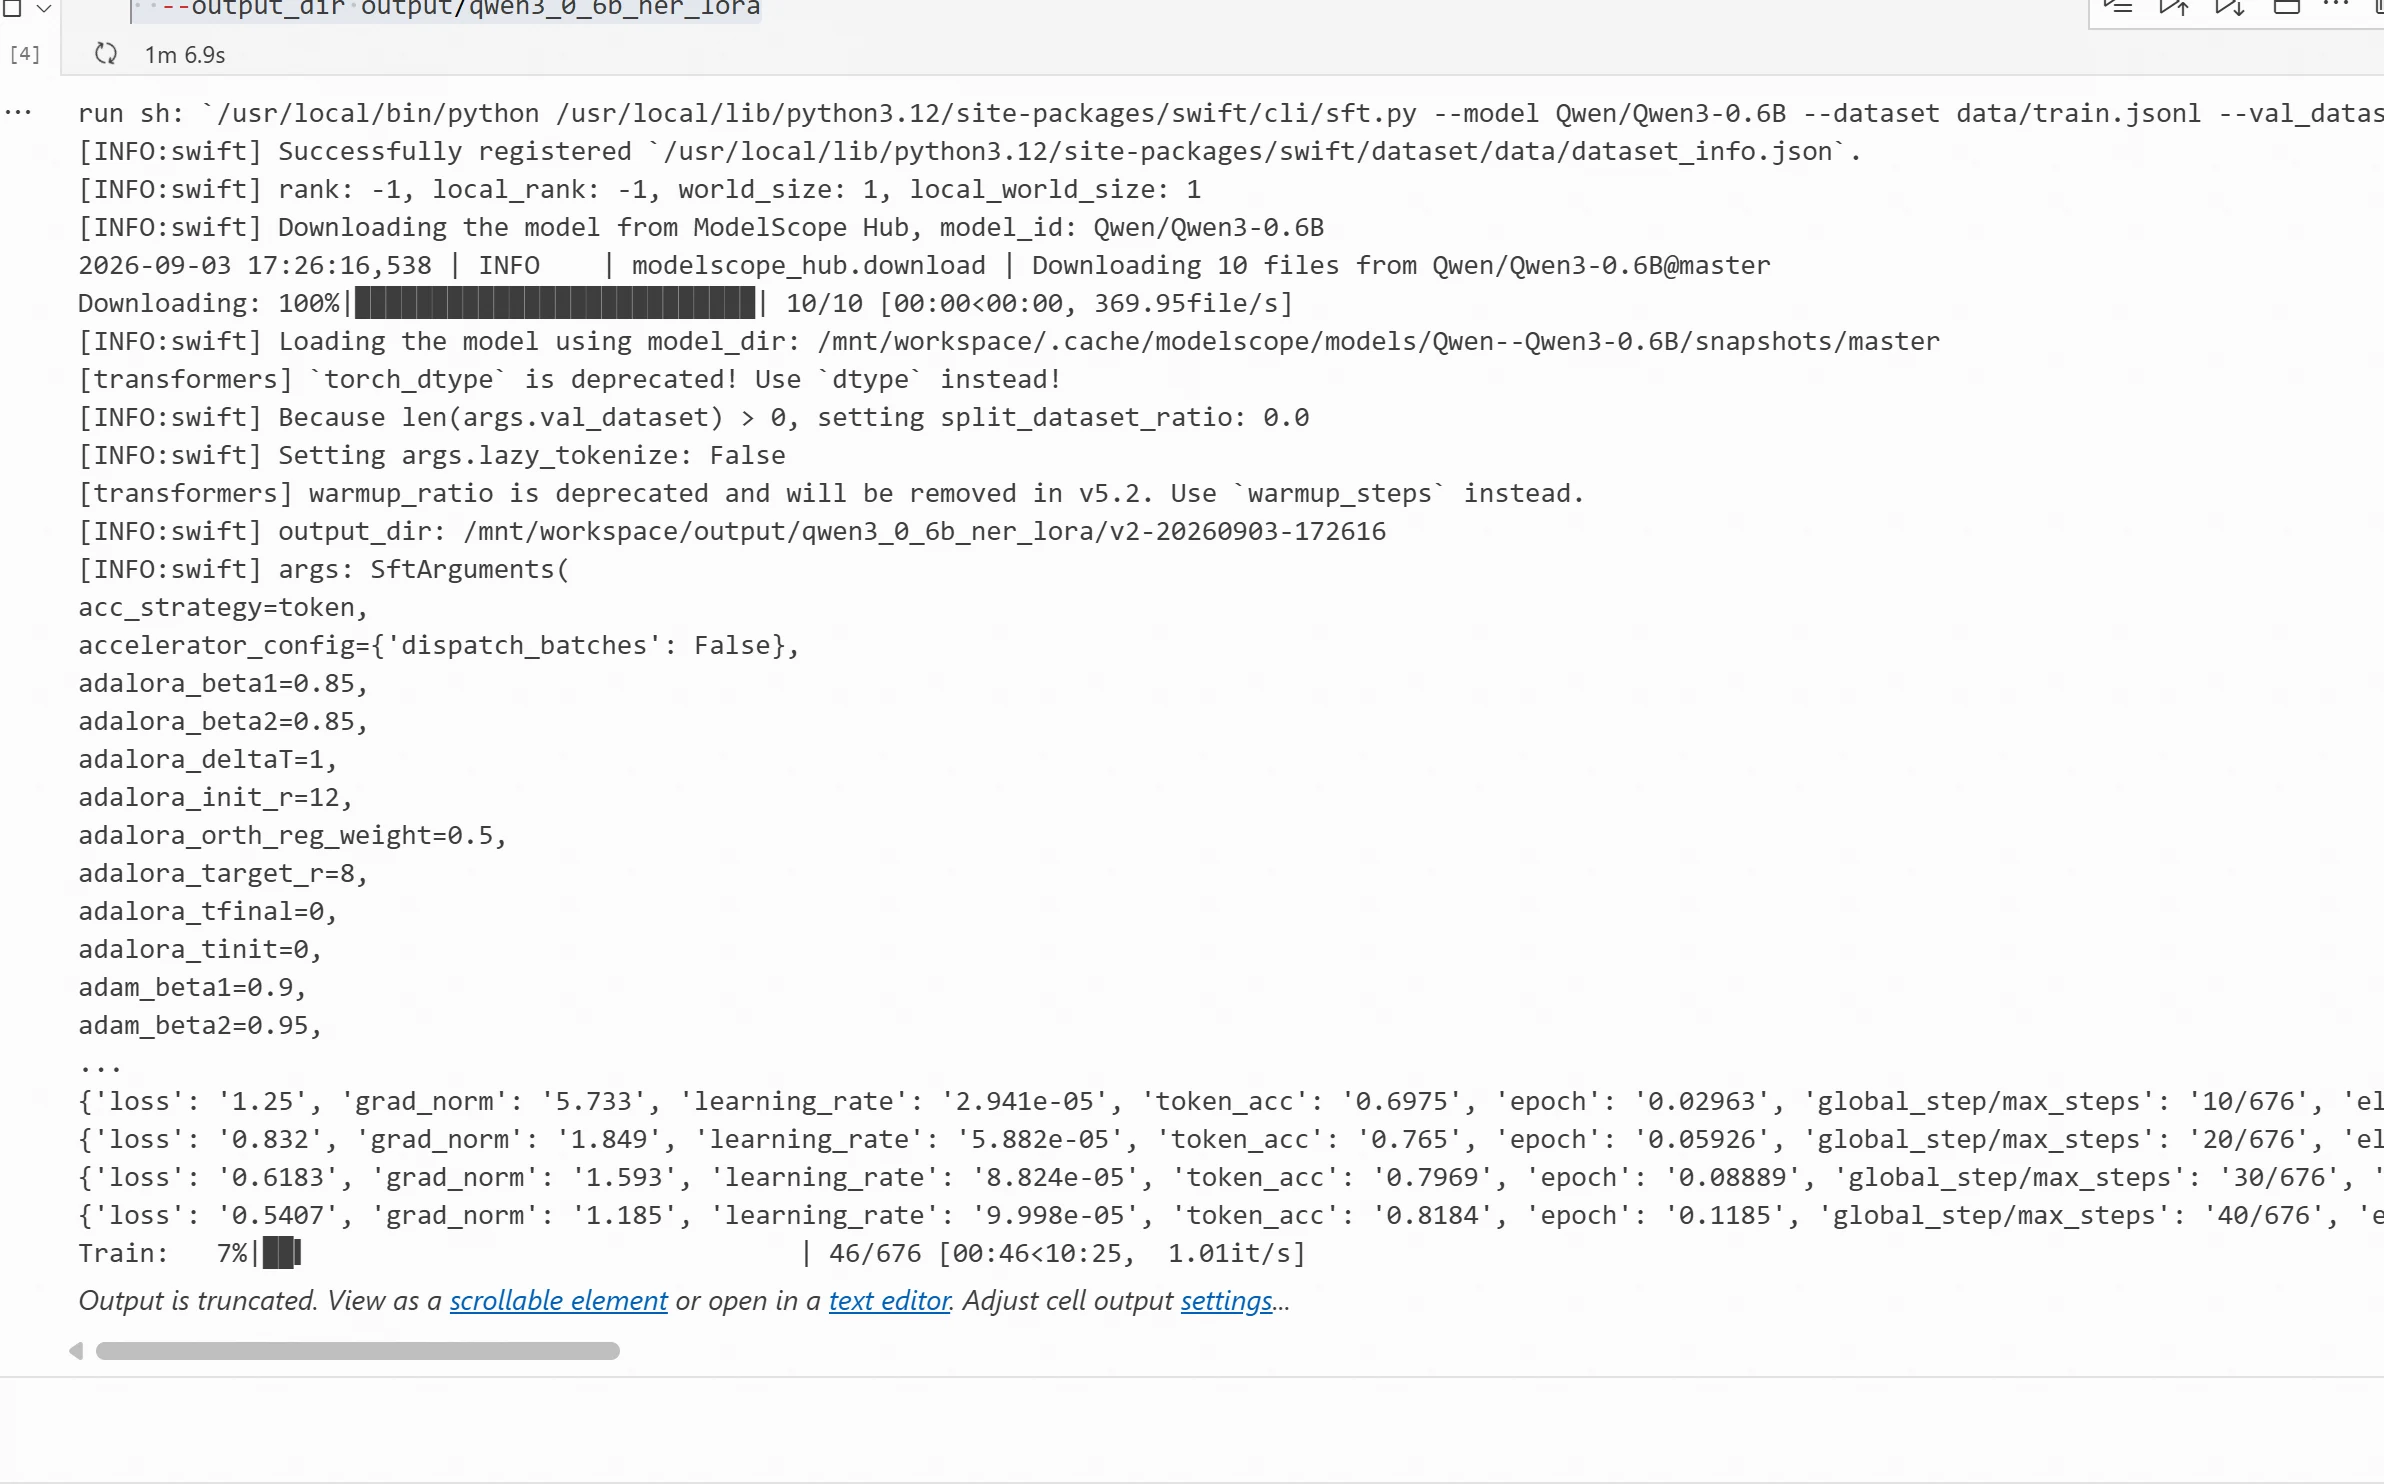
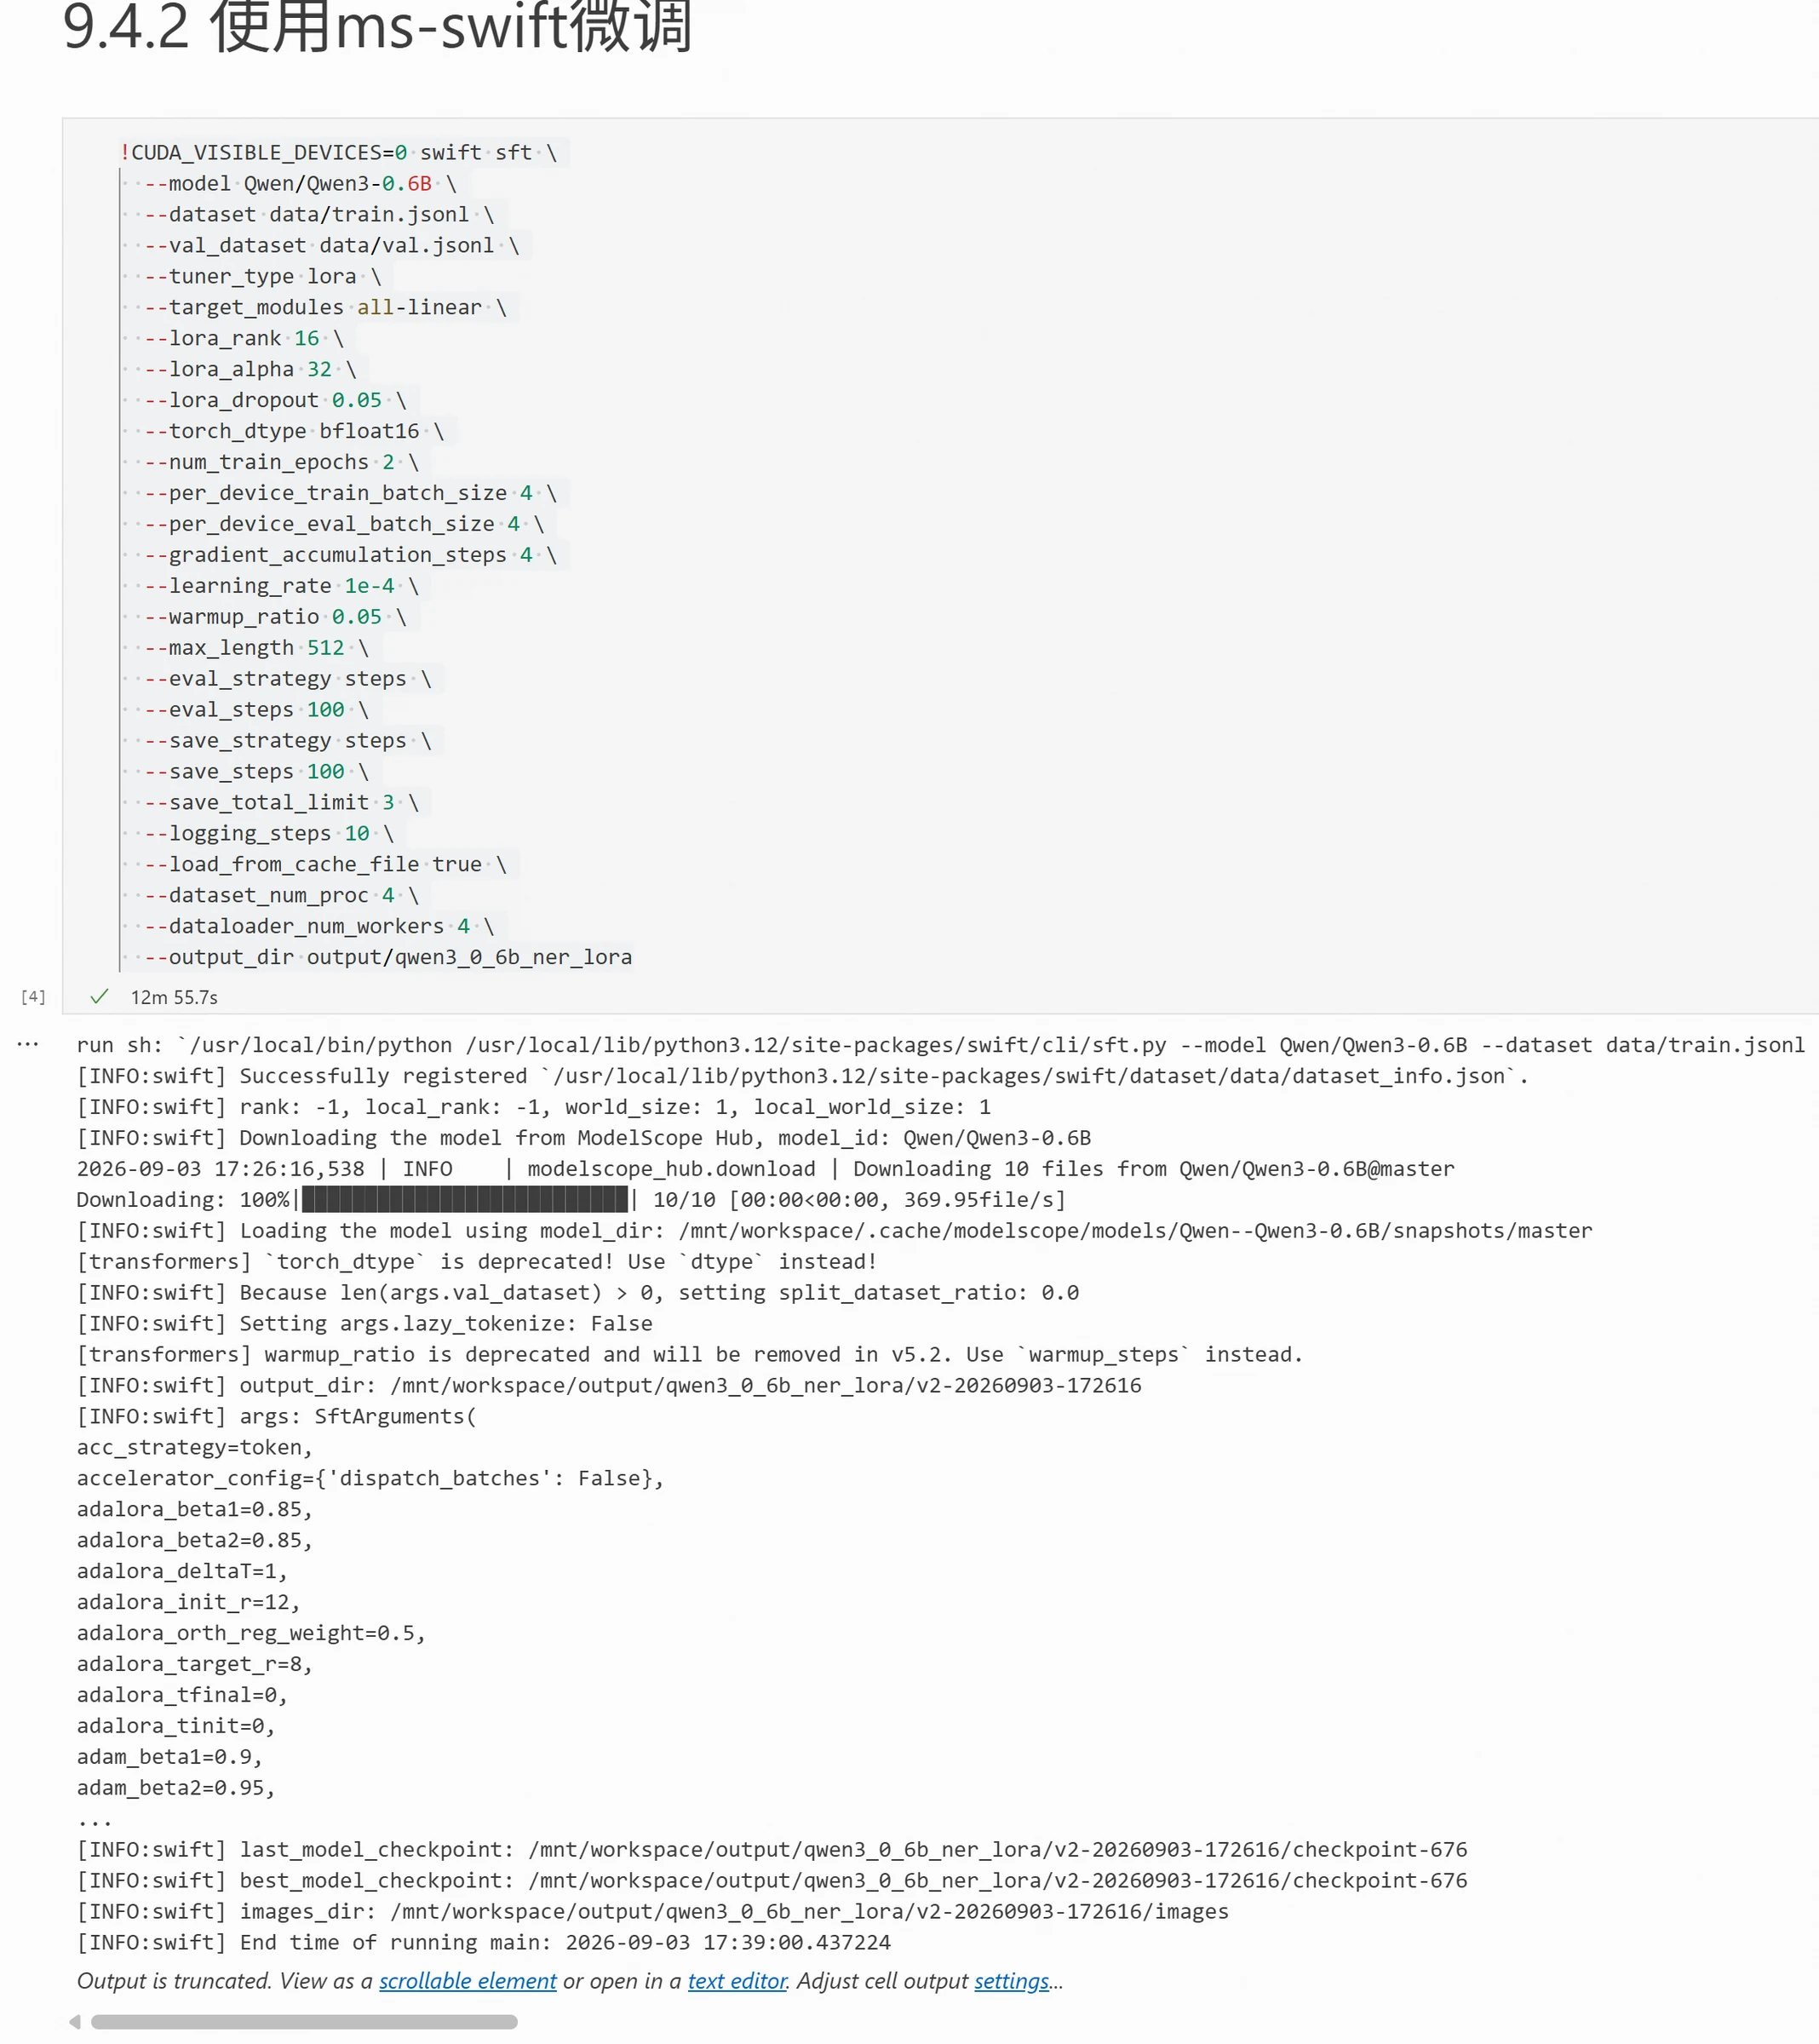
    1. Modeltraining met Qwen/Qwen3-0.6B:
    !CUDA_VISIBLE_DEVICES=0 swift sft \
      --model Qwen/Qwen3-0.6B \
      --dataset data/train.jsonl \
      --val_dataset data/val.jsonl \
      --tuner_type lora \
      --target_modules all-linear \
      --lora_rank 16 \
      --lora_alpha 32 \
      --lora_dropout 0.05 \
      --torch_dtype bfloat16 \
      --num_train_epochs 2 \
      --per_device_train_batch_size 4 \
      --per_device_eval_batch_size 4 \
      --gradient_accumulation_steps 4 \
      --learning_rate 1e-4 \
      --warmup_ratio 0.05 \
      --max_length 512 \
      --eval_strategy steps \
      --eval_steps 100 \
      --save_strategy steps \
      --save_steps 100 \
      --save_total_limit 3 \
      --logging_steps 10 \
      --load_from_cache_file true \
      --dataset_num_proc 4 \
      --dataloader_num_workers 4 \
      --output_dir output/qwen3_0_6b_ner_lora
    
    illustratie
    illustratie

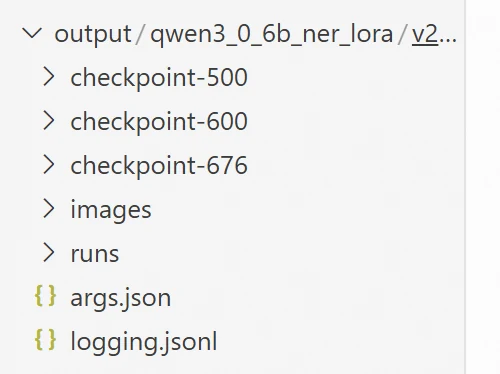
    De training is voltooid — hoe gebruiken we het model?

    LoRA-gewichten samenvoegen met het basismodel

    illustratie
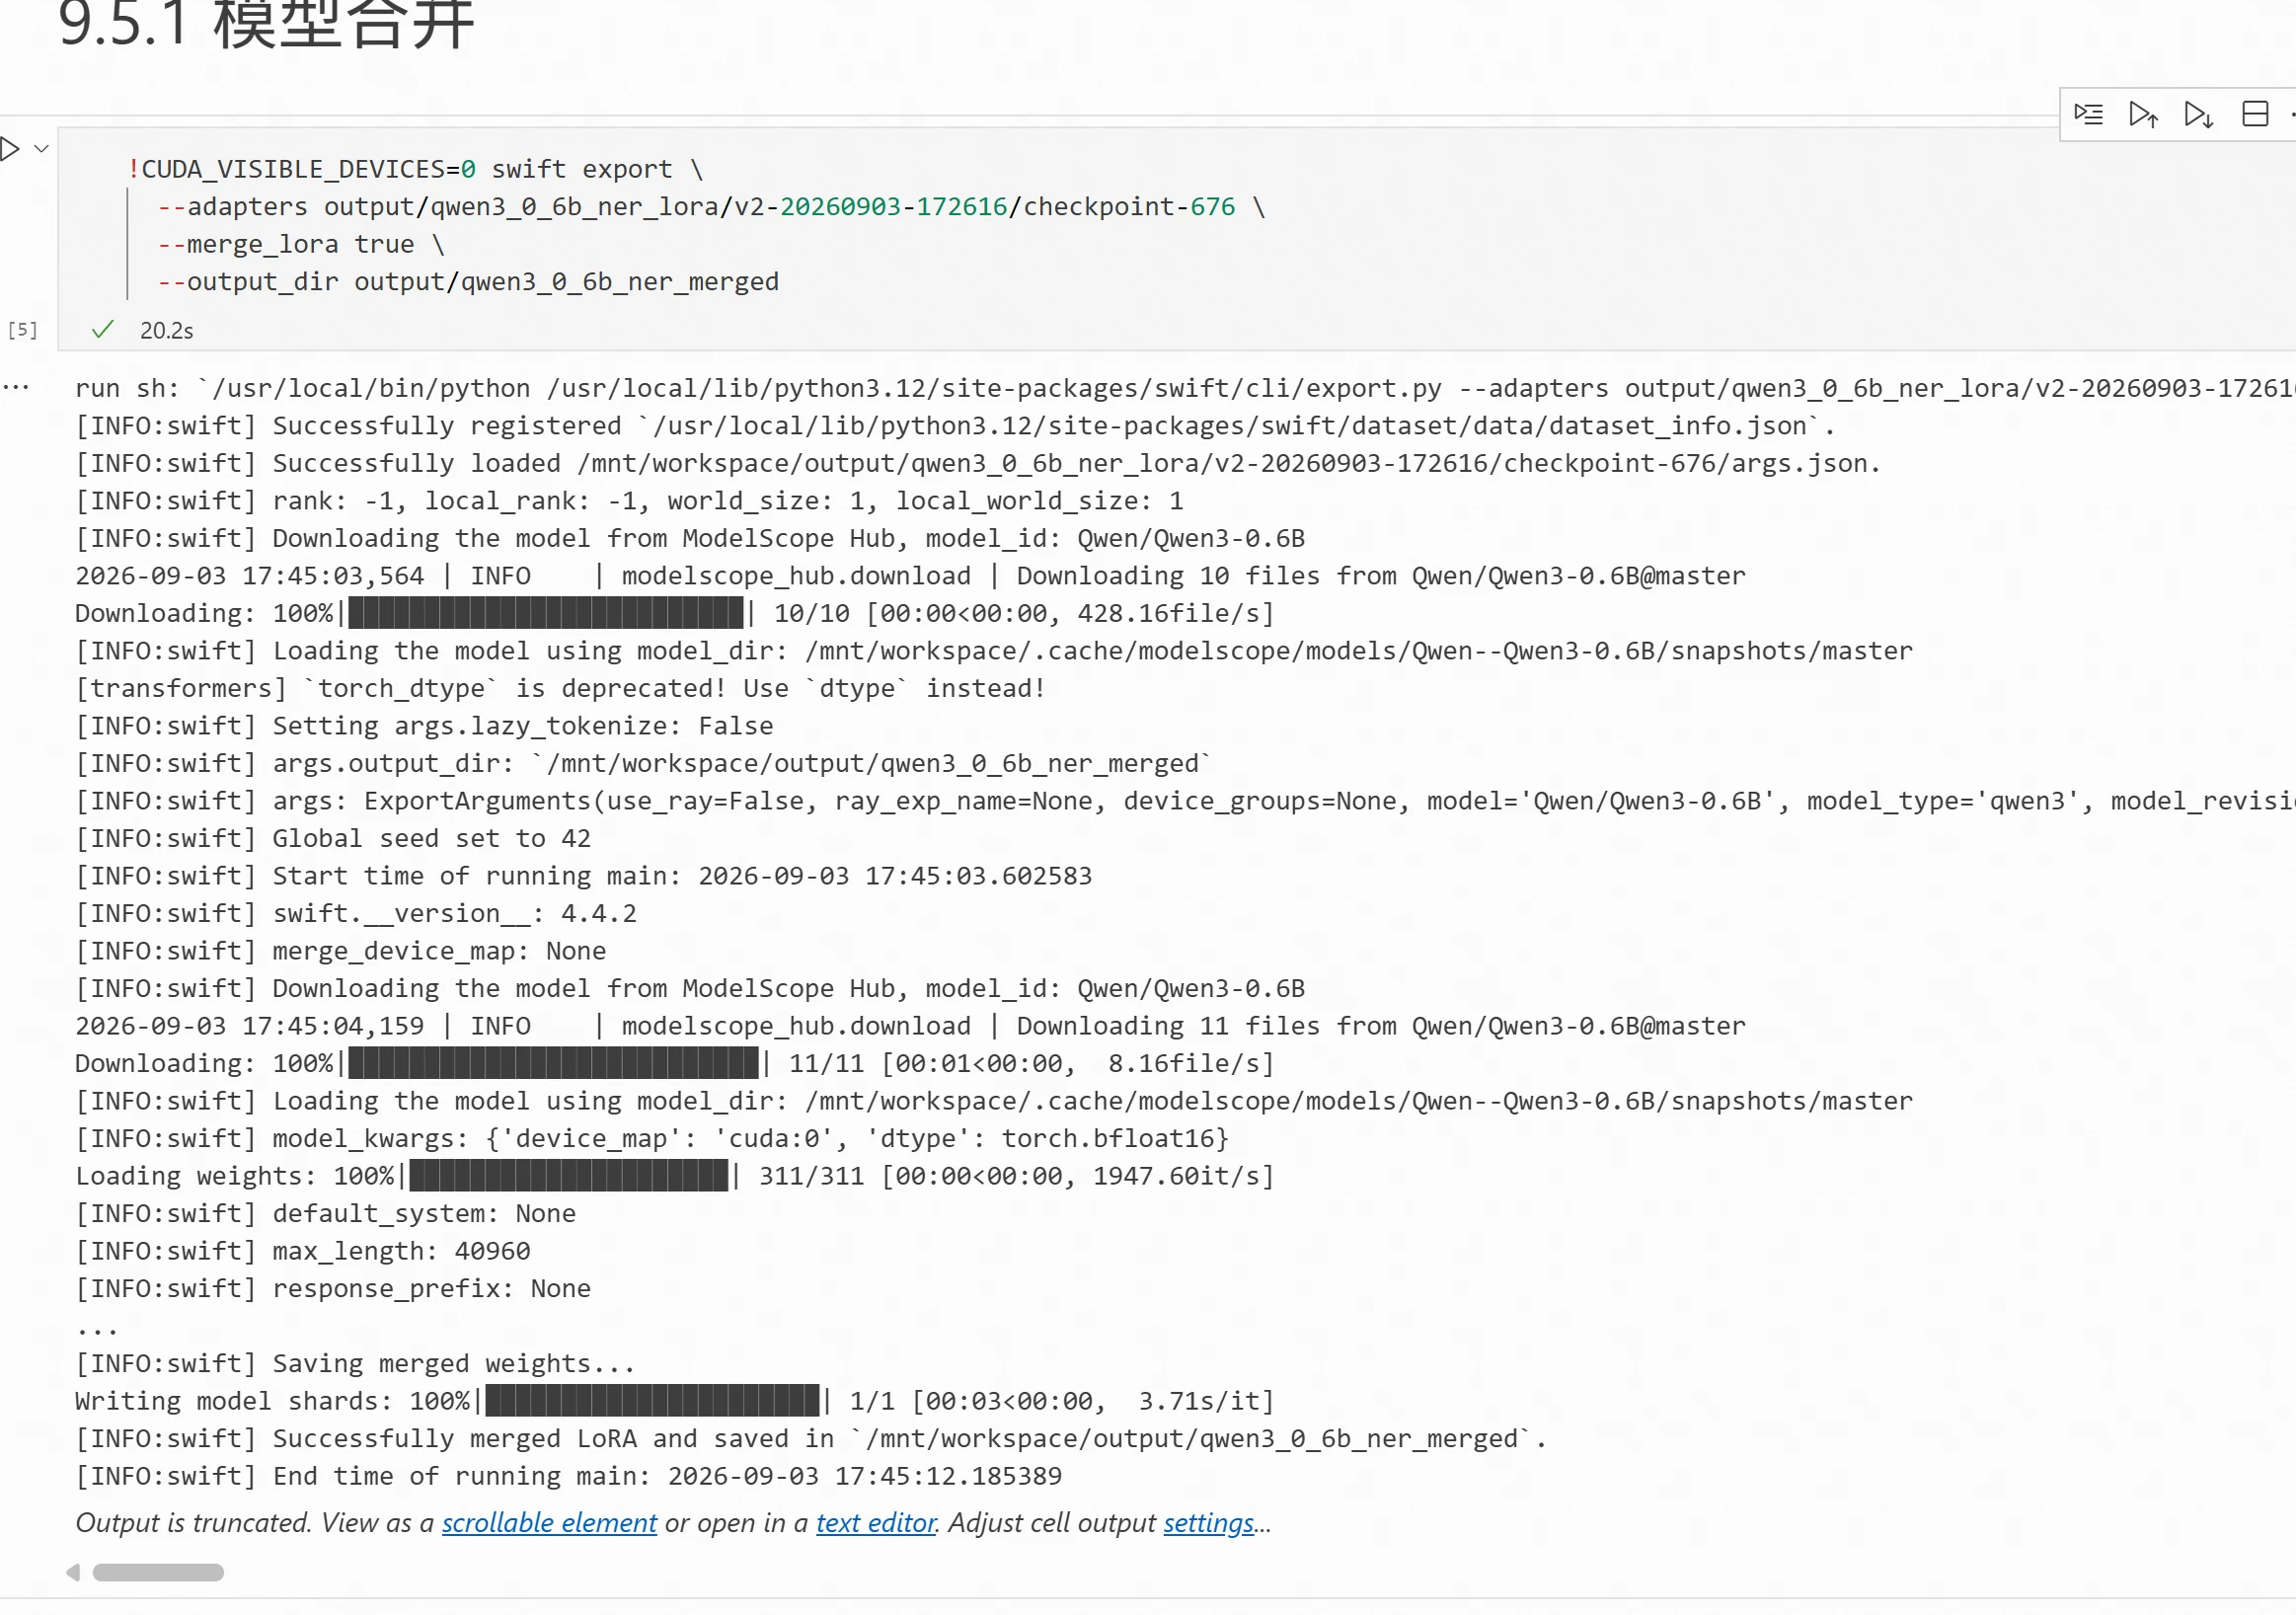
    !CUDA_VISIBLE_DEVICES=0 swift export \
      --adapters output/qwen3_0_6b_ner_lora/v2-20260903-172616/checkpoint-676 \
      --merge_lora true \
      --output_dir output/qwen3_0_6b_ner_merged
    
    illustratie

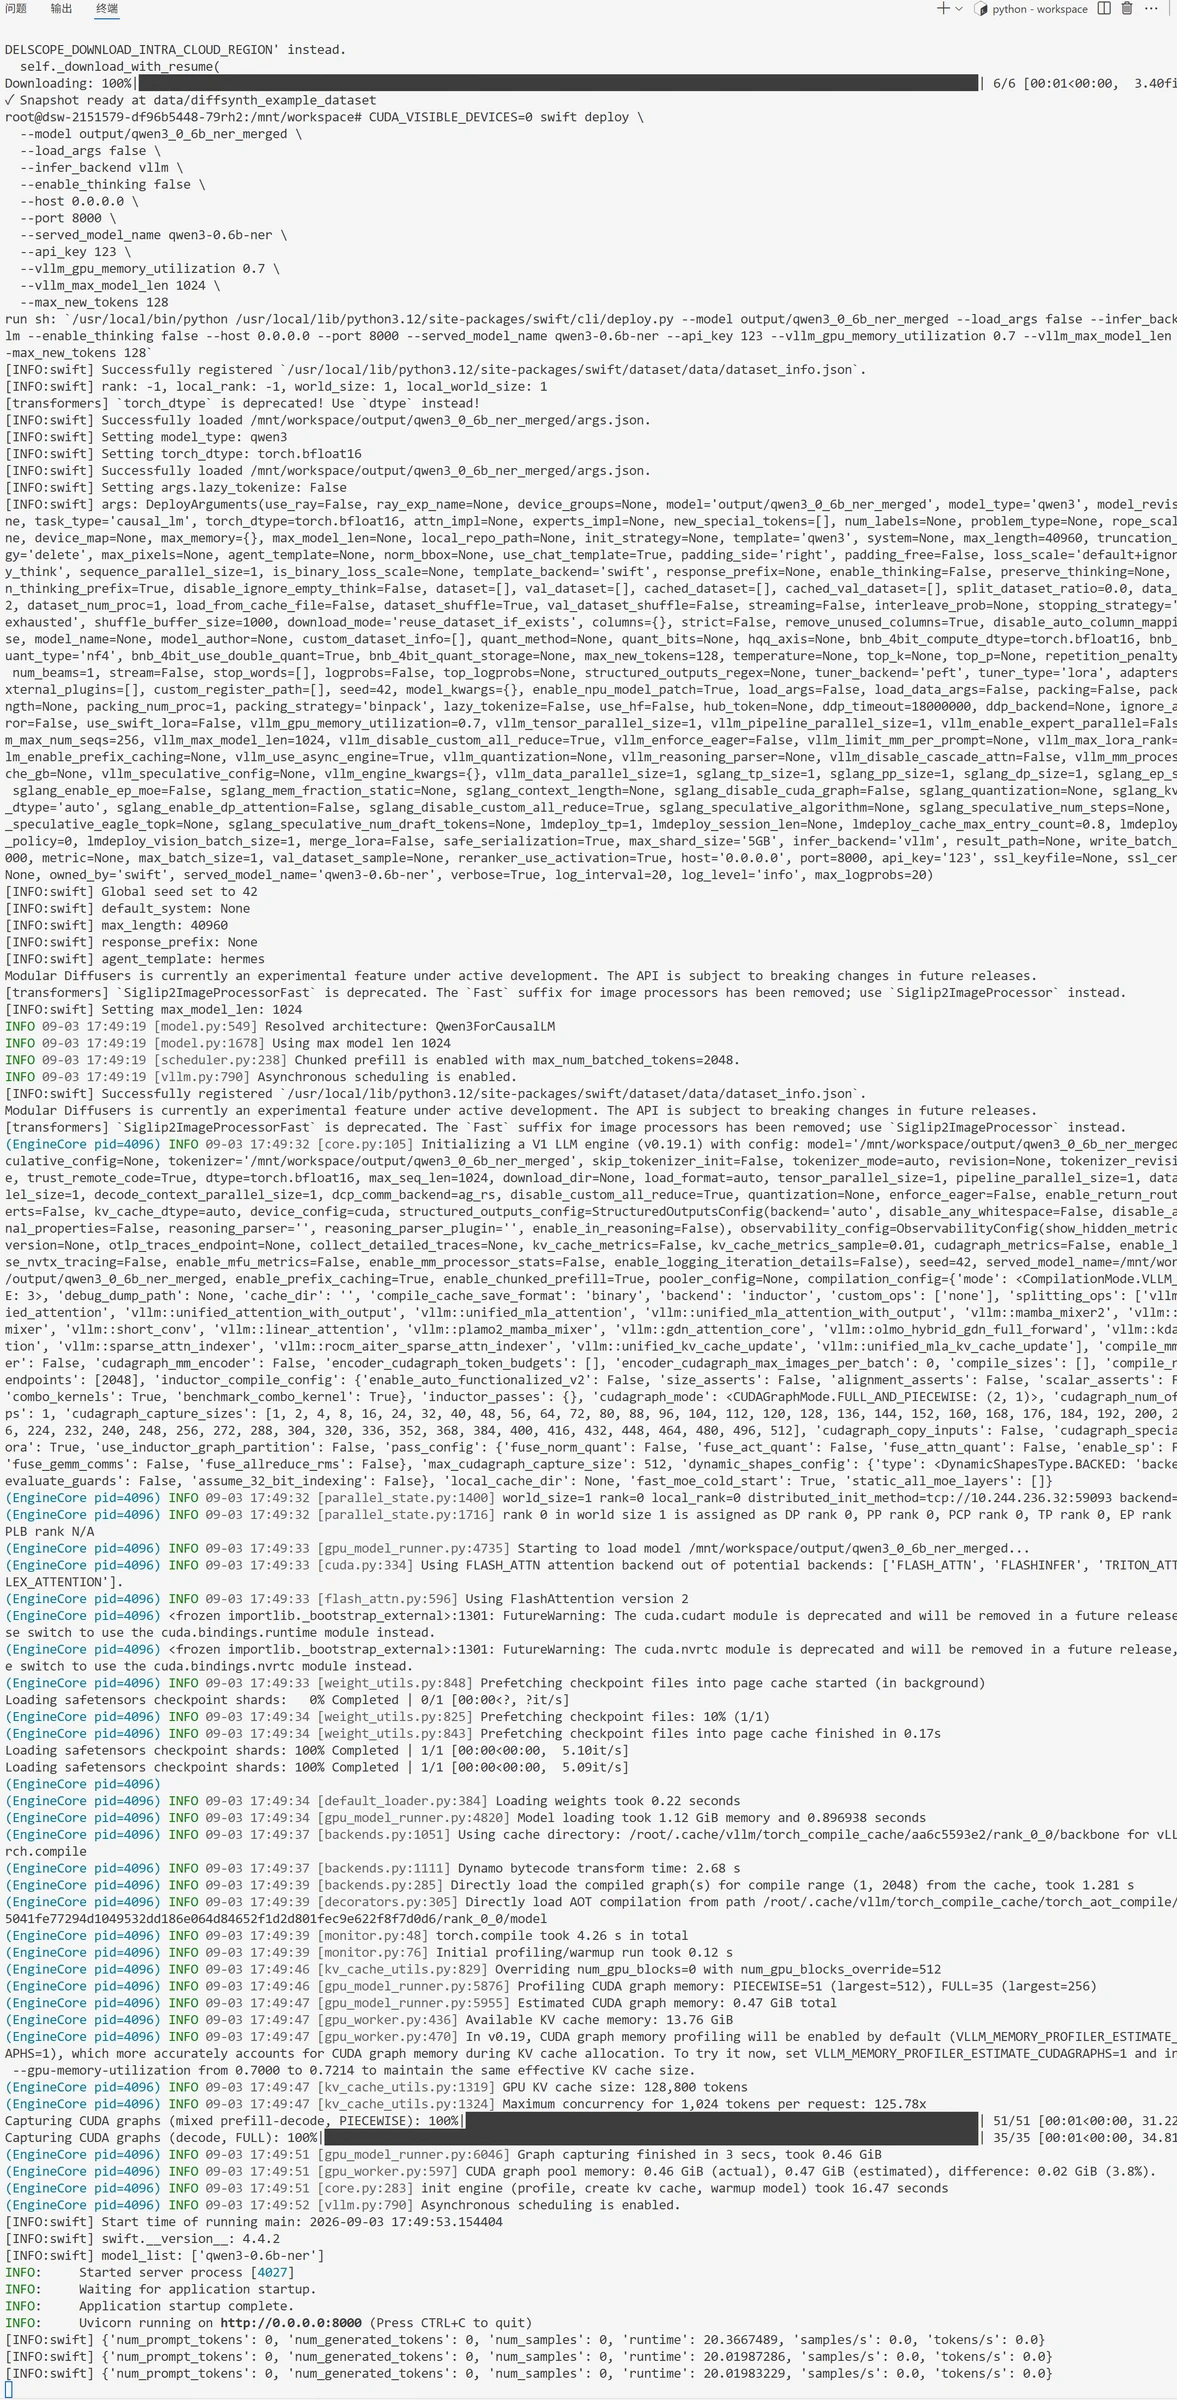
    Het fijngestemde model laden en het effect testen

    CUDA_VISIBLE_DEVICES=0 swift deploy \
      --model output/qwen3_0_6b_ner_merged \
      --load_args false \
      --infer_backend vllm \
      --enable_thinking false \
      --host 0.0.0.0 \
      --port 8000 \
      --served_model_name qwen3-0.6b-ner \
      --api_key 123 \
      --vllm_gpu_memory_utilization 0.7 \
      --vllm_max_model_len 1024 \
      --max_new_tokens 128
    
    illustratie

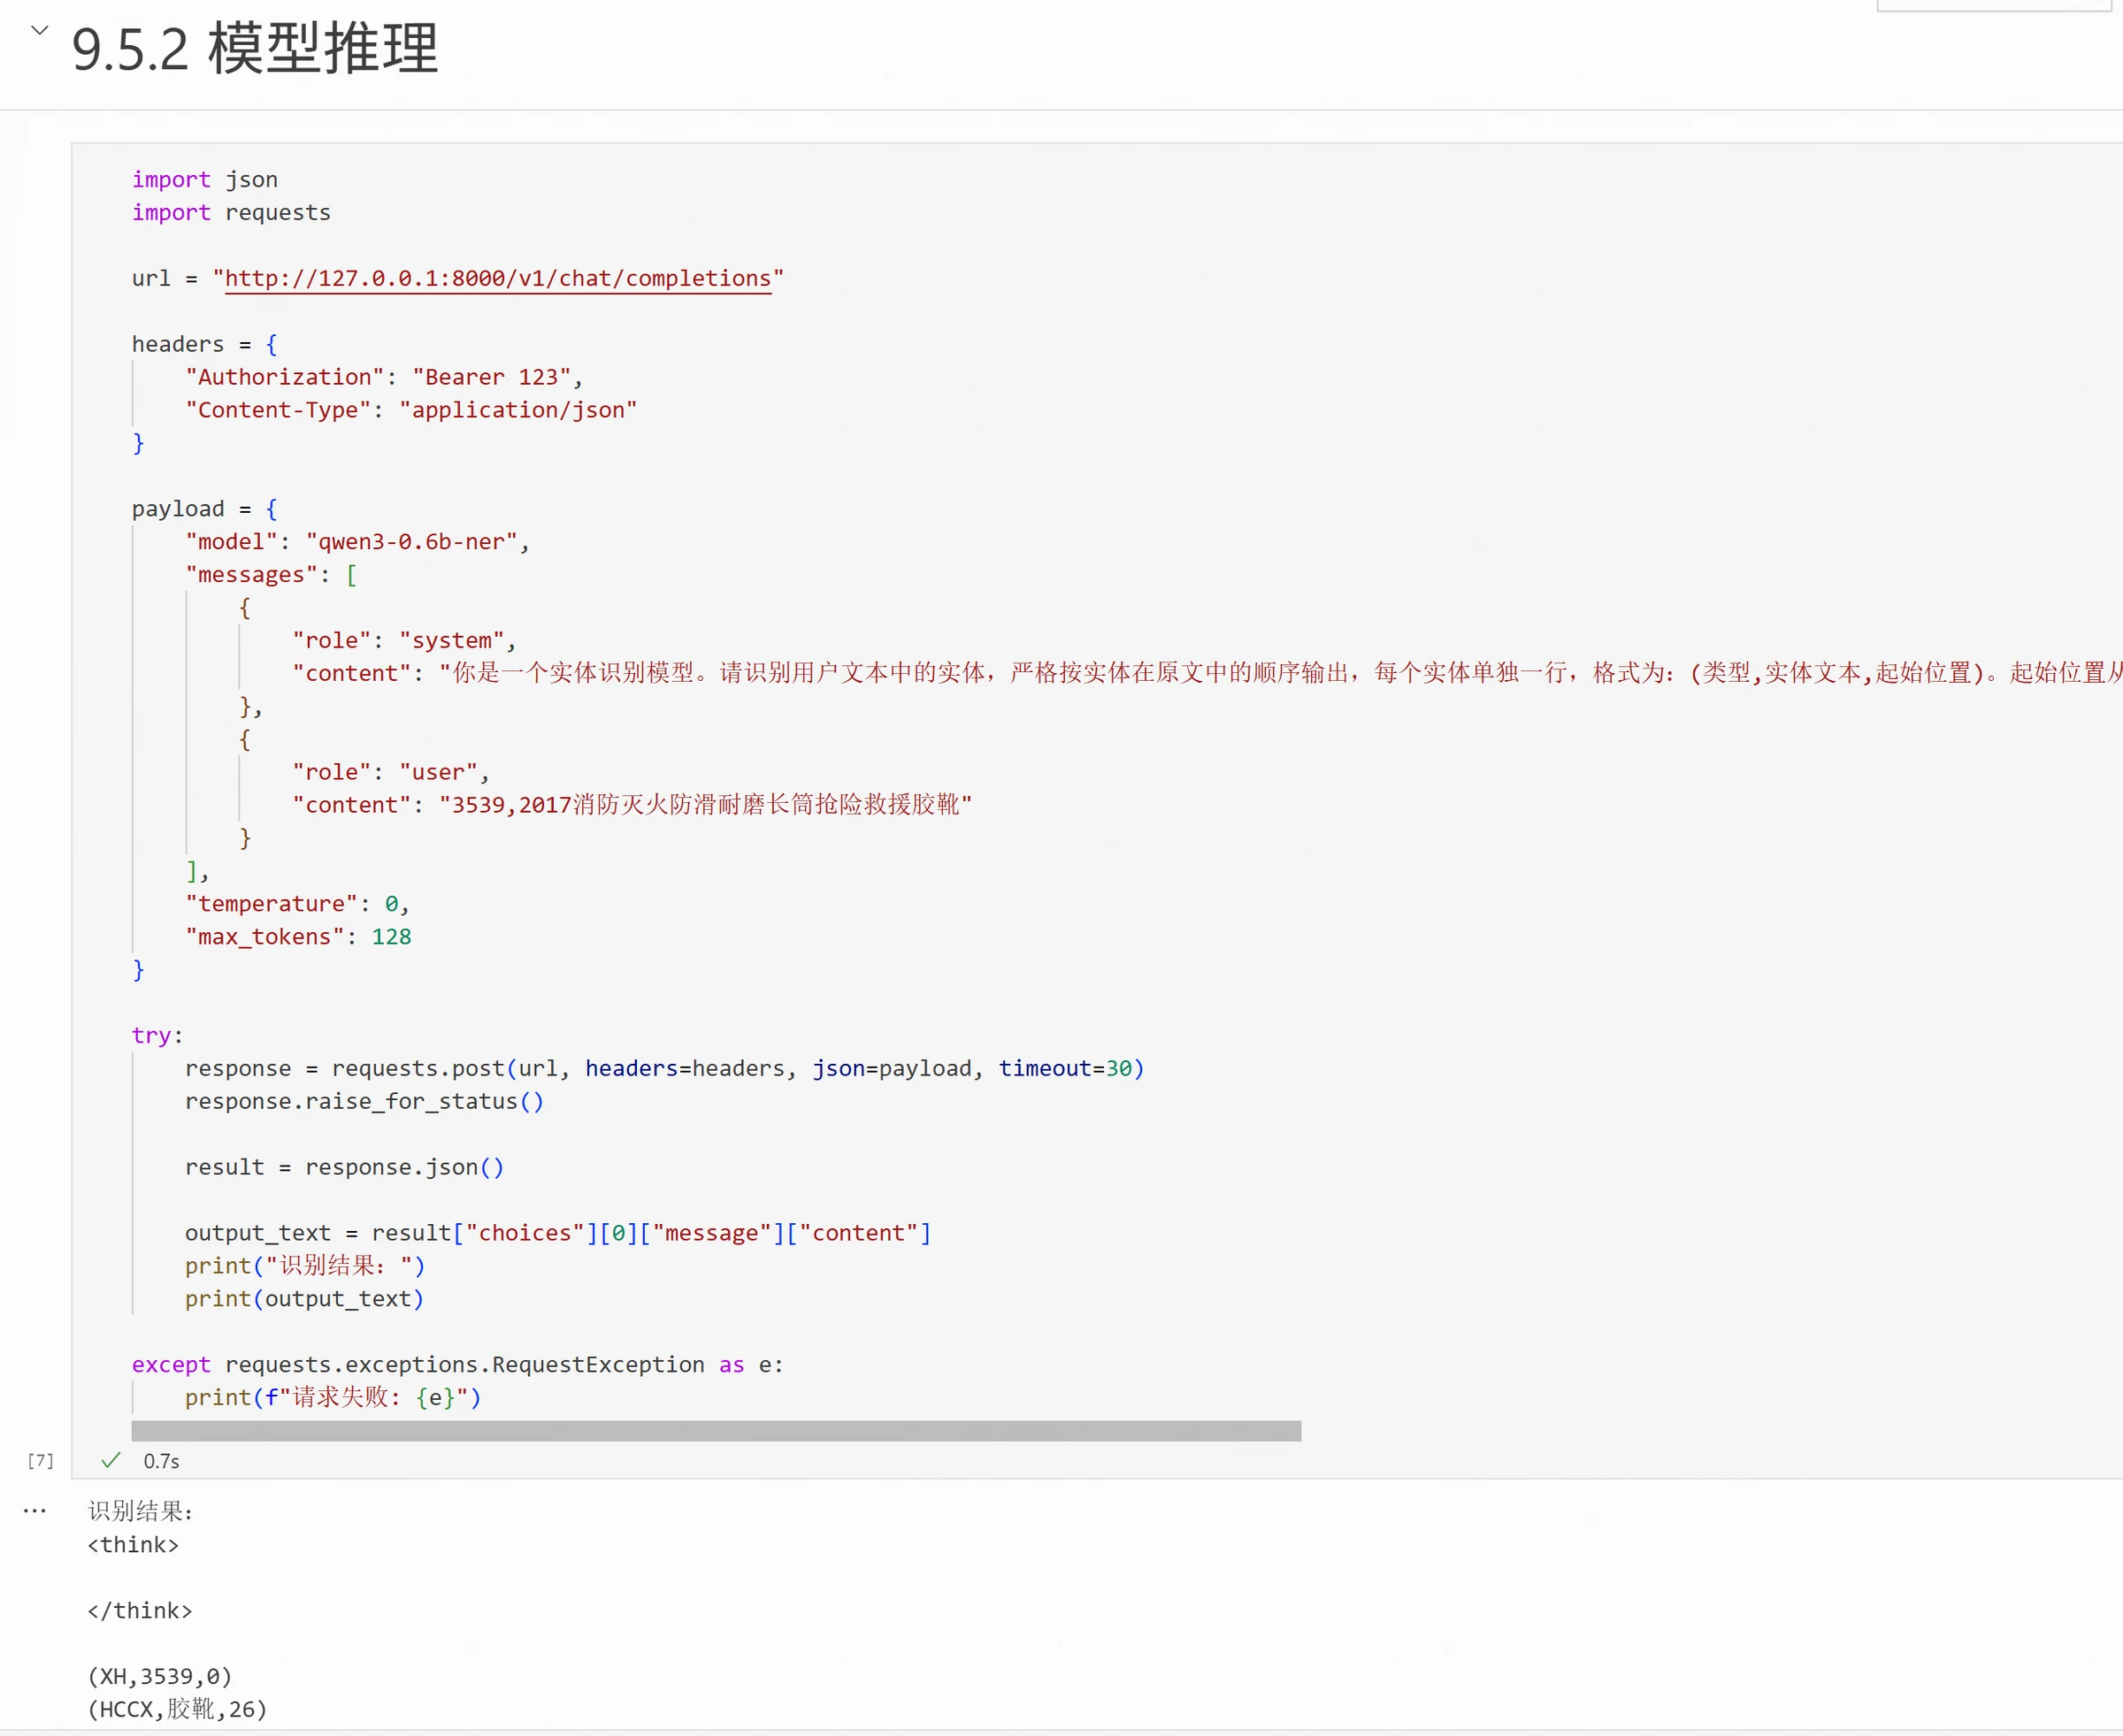
    Test de connectiviteit:

    import json
    import requests
    
    url = "http://127.0.0.1:8000/v1/chat/completions"
    headers = {"Authorization": "Bearer 123", "Content-Type": "application/json"}
    payload = {
        "model": "qwen3-0.6b-ner",
        "messages": [
            {"role": "system", "content": "U bent een entiteitsherkenningmodel. Identificeer entiteiten in de tekst van de gebruiker."},
            {"role": "user", "content": "3539,2017消防灭火防滑耐磨长筒抢险救援胶靴"}
        ],
        "temperature": 0,
        "max_tokens": 128
    }
    try:
        response = requests.post(url, headers=headers, json=payload, timeout=30)
        response.raise_for_status()
        result = response.json()
        print("Herkenningsresultaat:")
        print(result["choices"][0]["message"]["content"])
    except requests.exceptions.RequestException as e:
        print(f"Aanvraag mislukt: {e}")
    
    illustratie

    Alle experimentgegevens en code van dit hoofdstuk: https://modelscope.cn/gallery/liucong/ab458cbd-b47f-4830-91b6-314ea2036fc6