Na fijnafstemming van het model kan het vragen beantwoorden volgens de vereisten, maar als je meerdere antwoorden naast elkaar bekijkt, zijn sommige beter dan andere, en sommige zien er voor de gebruiker prettiger uit.
Neem een terugbetalingsvraag: beide antwoorden vertellen de gebruiker waar hij terecht kan, maar het ene antwoord geeft alleen de toegang, terwijl het andere ook uitlegt dat beoordeling nodig is en of de terugbetaling afhangt van de bestelling. Beide antwoorden gaan over terugbetaling, maar het tweede antwoord legt de mogelijke situaties duidelijker uit en vermindert misverstanden.
Bij SFT zetten we zulke antwoorden in als voorbeelden zodat het model daarvan leert. Nu kunnen we ook verschillende antwoorden op dezelfde vraag naast elkaar leggen en het model vertellen welke we prefereren en wat de beoordelingscriteria zijn.
Dit is Preference Alignment, hier beginnen we.
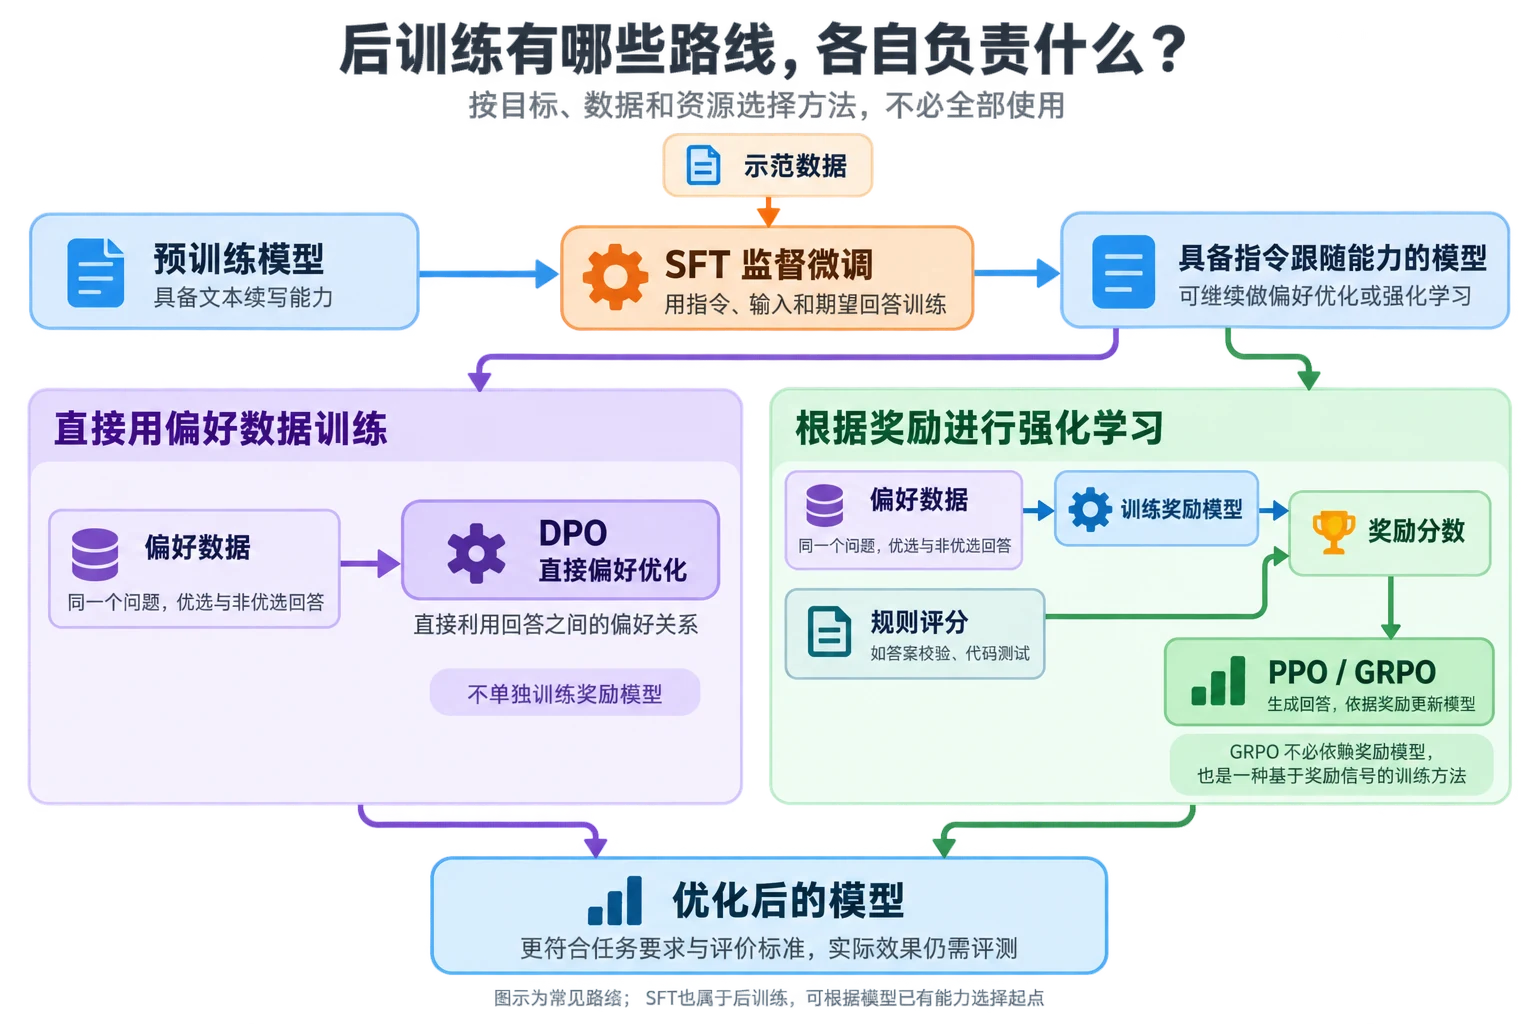
Het hoofddoel van post-training is om het basismodel dat al over de vaardigheid beschikt om tekst voort te zetten, stap voor stap te helpen transformeren tot een model dat beter direct kan dialogeren, instructies kan opvolgen en specifieke taken kan uitvoeren. Post-training is niet één vast algoritme, maar een verzamelnaam voor een groep trainingsmethoden. Veelgebruikte methoden zijn onder meer SFT, preferentieoptimalisering, beloningsmodeltraining en reinforcement learning. Verschillende modellen kiezen verschillende combinaties op basis van trainingsdoelen, gegevenscondities en kosten.
Daarbij gebruikt SFT voornamelijk gegevens in de vorm van "instructie, invoer en gewenst antwoord" om het model te leren hoe het taken moet begrijpen, instructies moet opvolgen en antwoorden in de gewenste vorm en manier. Op basis daarvan kan ook verder voorkeursgegevens worden gebruikt voor alignment, bijvoorbeeld door voor dezelfde vraag een voorkeursantwoord en een niet-voorkeursantwoord te construeren, zodat het model menselijke of bedrijfsbeoordelingscriteria leert. Voorkeursgegevens kunnen worden gebruikt om een beloningsmodel te trainen, waarbij menselijke voorkeuren worden omgezet in berekenbare beloningsscores, en vervolgens in combinatie met PPO, GRPO en andere reinforcement learning-methoden de genereerstrategie van het model continu te optimaliseren. Ook kunnen methoden zoals DPO rechtstreeks worden gebruikt om de voorkeursrelatie tussen voorkeursantwoorden en niet-voorkeursantwoorden direct in het trainingsdoel op te nemen, zonder apart een beloningsmodel te trainen.
Daarom bestaat er geen vast proces voor post-training van grote modellen, en hebben SFT, beloningsmodellen, PPO, GRPO en DPO verschillende verantwoordelijkheden. SFT wordt voornamelijk gebruikt om de basisvaardigheid van instructieopvolging op te bouwen, beloningsmodellen leveren kwantificeerbare beoordelingssignalen, PPO en GRPO optimaliseren de genereerstrategie verder op basis van beloningssignalen, en DPO maakt rechtstreeks gebruik van voorkeursgegevens om modelalignatie uit te voeren. In de praktijk worden niet noodzakelijkerwijs alle methoden gebruikt en niet noodzakelijkerwijs in exact dezelfde volgorde gecombineerd, maar worden ze flexibel gekozen op basis van modelcapaciteit, taakdoelen en trainingsresources.
Inloggen deelnemen aan de discussie
SFT staat voor Supervised Fine-Tuning. Het gebruikt voorbereide invoeren en gewenste uitvoeren om het model verder te trainen, zodat het model bij vergelijkbare invoeren de kans op het genereren van het gewenste antwoord vergroot.
Een SFT-gegevensset kan als volgt worden geschreven:
{
  "instruction": "Genereer een klantenservice-antwoord op basis van de vraag van de gebruiker",
  "input": "Het lidmaatschap is gisteren automatisch verlengd, ik wil een terugbetaling aanvragen.",
  "output": "Ga eerst naar de bestellingspagina om de status van de verlengingsbestelling te controleren. Als u voldoet aan de terugbetalingsvoorwaarden, kunt u een aanvraag indienen in de bestellingsdetails; als er geen terugbetalingsmogelijkheid op de pagina staat, neem dan contact op met de klantenservice voor verificatie."
}
Bij training zet de Tokenizer (Tokenizer) de instructie, invoer en antwoord om in tokens. Het model voorspelt op basis van de vorige tokens het volgende token, en berekent het verlies op basis van het verschil tussen de voorspelling en het gewenste antwoord. Grote modellen gebruiken bij SFT doorgaans kruislingse-entropy-verlies en teacher forcing: bij elke positie ziet het model de reeds gegeven juiste voorgaande tekst uit de gegevens, in plaats van de foutieve inhoud die het zelf zojuist heeft gegenereerd. Veel fijnafstemmingsimplementaties berekenen het verlies alleen voor het antwoordgedeelte; instructie en gebruikersinvoer worden gebruikt om context te leveren, maar het model wordt niet gevraagd om deze opnieuw te genereren.
SFT verandert eerst het taakformaat. Het model gaat geleidelijk begrijpen dat de invoer een gebruikersvraag is en de uitvoer een klantenservice-antwoord moet zijn, in plaats van de vraag van de gebruiker verder aan te vullen. Bij informatiesextrafectie kan het leren om vaste JSON-velden uit te voeren; bij vergadernotities kan het leren om inhoud te organiseren op basis van vergaderinformatie, belangrijke conclusies en actiepunten. Ten tweede verandert SFT de manier waarop het model antwoordt. De toon, lengte, paragraafstructuur, uitlegniveau en manier om te weigeren in de trainingsgegevens worden allemaal nagebootst door het model. Als de gewenste antwoorden over het algemeen beknopt zijn, zal het model eerder geneigd zijn direct conclusies te geven; als de voorbeelden vragen om eerst de onderbouwing uit te leggen en dan stappen te geven, zal het model deze organisatie ook leren. SFT kan het model ook kennis laten maken met domeinvoorbeelden. Bestelstatussen, terugbetalingsvoorwaarden en doorverwijzing naar klantenservice in klantenservicegegevens, de structuur van voorwaarden in juridische gegevens, en het gebruik van interfaces in codedata hebben allemaal invloed op de output van het model bij overeenkomstige taken. Dit betekent echter niet dat het model automatisch alle kennis van het domein beheerst. Het model heeft pas de mogelijkheid om deze patronen in de parameters bij te werken als de SFT-gegevens de betreffende taken dekken, de juiste terminologie bevatten en de juiste verwerkingswijze tonen.
Het trainingsdoel van SFT is in wezen nog steeds het nabootsen van de gewenste uitvoer. Het kan het model laten weten hoe dit type vraag doorgaans wordt beantwoord, maar garandeert niet dat de feiten in het antwoord geverifieerd zijn, en het kan niet op basis van één enkel voorbeeld leren om alle mogelijke antwoorden te vergelijken. Op dezelfde terugbetalingsvraag kunnen de volgende twee antwoorden worden gegeven:
Antwoord A: Vraag een terugbetaling aan in de bestellingsdetails. Als u dit niet kunt doen, neem dan contact op met de klantenservice.

Antwoord B: U kunt eerst de bestelstatus controleren. Als u voldoet aan de terugbetalingsvoorwaarden, kunt u een aanvraag indienen in de bestellingsdetails; als er geen terugbetalingsmogelijkheid staat, neem dan contact op met de klantenservice voor verificatie. De terugbetalingsuitslag en de tijd tot ontvangst zijn afhankelijk van de daadwerkelijke beoordeling.
Beide antwoorden gaan over terugbetaling, maar antwoord B vult de beoordelingsvoorwaarden aan en vermijdt een vaste belofte over de terugbetalingsuitslag. Als het bedrijf meer belang hecht aan informatievolledigheid en naleving van grenzen, is antwoord B meer geschikt. SFT kan antwoord B als voorbeeld aan het model geven, terwijl voorkeursgegevens tegelijkertijd A en B kunnen geven en het model duidelijk kunnen maken waarom B de voorkeur heeft. Dit is de reden om van supervised learning naar preference alignment te gaan.
Preference Alignment richt zich niet op de vraag of het model "kan antwoorden", maar op welk antwoord de voorkeur heeft wanneer meerdere antwoorden mogelijk allemaal correct zijn. Het vergelijkt doorgaans de voor- en nadelen van verschillende antwoorden bij dezelfde invoer en zet eisen zoals nauwkeurigheid, relevantie, nut, uitdrukkingswijze en veiligheid om in trainingssignalen. In vergelijking met SFT, dat meer lijkt op het leren van het model "hoe te antwoorden" (doorgaans met één invoer die overeenkomt met één gewenste uitvoer, zodat het model het taakformaat, de inhoudsstructuur, de domeinuitdrukking en de basisantwoordwijze leert), gaat preference alignment erover het model na het verwerven van basisantwoordvaardigheden verder te leren "hoe beter te antwoorden".
In een terugbetalingsklantenservice-scenario: als een antwoord beoordelingsvoorwaarden mist, een vaste ontvangsttijd belooft, of onzekere zaken als zeker presenteren, kan het worden gemarkeerd als een slechter antwoord; als een ander antwoord het verwerkingspad duidelijk uitlegt, de noodzakelijke beoordelingsgrenzen behoudt en geen beleid verzint, kan het worden gemarkeerd als een beter antwoord. Door veel van dergelijke vergelijkingen in de training, zal het model geleidelijk de kans op het genereren van voorkeursantwoorden vergroten, waardoor het bij vergelijkbare vragen meer geneigd is output te geven die voldoet aan de bedrijfsvereisten. Let op: wat preference alignment leert is niet een abstracte en universele set van "menselijke waarden", maar evaluatiecriteria die zijn gedefinieerd voor specifieke taken in combinatie met een beloningsfunctie. Verschillende taken vereisen voorkeursgegevenspatronen die bij de taak passen. Daarom moet voordat voorkeursgegevens worden geconstrueerd eerst worden vastgesteld "wat beter betekent", anders kunnen verschillende annotatoren vanwege verschillende interpretaties tegenstrijdige keuzes maken.
Bovendien kan preference alignment feitenverificatie niet vervangen. Een antwoord kan vloeiend geformuleerd en vriendelijk van toon zijn, maar toch een verkeerd beleid aanhalen; een ander antwoord kan feitelijk correct zijn maar niet voldoen aan het gevraagde outputformaat. Daarom moet een praktisch beoordelingssysteem doorgaans afzonderlijke criteria definiëren voor feitelijke juistheid, taakvoltooing, uitdrukkingsstijl en veiligheidsnaleving. Voor inhoud die automatisch kan worden geverifieerd, kunnen ook codetests, antwoordverificatie, formaatcontroles en bedrijfsregels worden gebruikt om de beoordeling te ondersteunen, om de vooringenomenheid die ontstaat door volledig te vertrouwen op subjectief menselijk oordeel te verminderen.
Voorkeursgegevens (Preference Data) zijn trainingsgegevens die het model vertellen "welk antwoord beter is bij meerdere opties". Het grootste verschil met SFT-gegevens is: SFT levert doorgaans één invoer en één gewenst antwoord, terwijl voorkeursgegevens doorgaans meerdere kandidaatantwoorden voorbereiden voor hetzelfde Prompt en hun onderlinge voor-nadelenrelatie labelen. Het meest voorkomende voorkeursgegevenspatroon bestaat uit één invoer, één voorkeursantwoord en één niet-voorkeursantwoord:
{
  "prompt": "Het lidmaatschap is gisteren automatisch verlengd, ik wil een terugbetaling aanvragen.",
  "chosen": "Controleer eerst de bestelstatus. Als u voldoet aan de terugbetalingsvoorwaarden, kunt u een aanvraag indienen in de bestellingsdetails; als er geen terugbetalingsmogelijkheid staat, neem dan contact op met de klantenservice voor verificatie.",
  "rejected": "Oké, de terugbetaling wordt binnen drie werkdagen gestort."
}
Daarbij geeft chosen het meer geschikte antwoord aan volgens de huidige beoordelingscriteria, en rejected het relatief minder geschikte antwoord. Het niet-voorkeursantwoord is niet per se volledig fout; het mist mogelijk ook alleen noodzakelijke voorwaarden, is te uitgebreid geformuleerd, de toon voldoet niet aan de eisen, of het bevat beloften zonder basis. Voorkeursgegevens drukken een relatieve relatie uit, en geven niet elk antwoord een permanente correcte of onjuiste label.
Voorkeursgegevens worden doorgaans als volgt opgebouwd:
Als eenzelfde invoer vier antwoorden A, B, C en D oplevert en de annotatie B>A, A>D, D>C aangeeft, kunnen meerdere voorkeursparen worden gevormd. Bij de praktische constructie hoeven niet alle combinaties uitputtend te worden gegenereerd. Antwoorden met te kleine verschillen zijn moeilijk stabiel te annoteren, terwijl antwoorden met te grote verschillen het model alleen kunnen leren om basale fouten te vermijden. Waardevollere gegevens komen doorgaans van antwoorden die allemaal leesbaar zijn, maar duidelijke verschillen vertonen op cruciale voorwaarden, feitelijke grenzen of taakvoltooing.
Voorkeursannotatie wordt beïnvloed door enkele oppervlakkige factoren. Langere antwoorden lijken vollediger, zelfverzekerder geformuleerde antwoorden lijken betrouwbaarder, en kandidaten die eerder worden weergegeven worden mogelijk ook eerder geselecteerd. Om deze vooringenomenheden te verminderen, kan de volgorde van kandidaten willekeurig worden aangepast, de modelnamen worden verborgen, annotatoren worden gevraagd om feiten, taakvoltooing, stijl en veiligheid afzonderlijk te controleren, en op een deel van de monsters kunnen meerdere annotatoren herhaaldelijk annoteren. Als annotatoren in dezelfde batch vaak van mening verschillen, duidt dit doorgaans op onvoldoende duidelijke beoordelingscriteria, en niet simpelweg op het verwijderen van de minderheidsmening.
Voorkeursgegevens hebben het betere antwoord bij eenzelfde Prompt al weergegeven als een relatieve relatie tussen chosen en rejected. De rol van een beloningsmodel (Reward Model, RM) is om deze voorkeursgegevens te gebruiken om een automatische beoordelingsfunctie te leren, waarbij menselijke vergelijkingsresultaten worden omgezet in beloningssignalen die door latere reinforcement learning-algoritmen kunnen worden gebruikt. Veelgebruikte beloningsmodellen nemen een taalmodel als basis en voegen daar een scorelaag toe die een scalair output geeft. Bij training worden de Prompt en het antwoord samengevoegd tot één sequentie, die door het model wordt verwerkt om verborgen toestanden te verkrijgen, waarna de scorelaag een getalswaarde uitvoert.
Een beloningsmodel hoeft niet te weten hoeveel punten elk van de twee antwoorden zou moeten krijgen; het hoeft alleen een relatieve verhouding te leren: bij deze Prompt moet de score van chosen hoger zijn dan die van rejected. Daarom worden bij training doorgaans de Prompt afzonderlijk met de twee kandidaatantwoorden samengevoegd en ingevoerd in het beloningsmodel:
Prompt + chosen   → rchosen
Prompt + rejected → rrejected
Daarbij zijn rchosen en rrejected twee scalare scores die door het beloningsmodel worden uitgevoerd. Het trainingsdoel is dat de score van het voorkeursantwoord hoger is dan die van het niet-voorkeursantwoord. Het veelgebruikte paargewijze rangschikkingsverlies kan als volgt worden geschreven:
\mathcal{L} = -\log \sigma\left(r_{\text{chosen}} - r_{\text{rejected}}\right)
Daarbij geven r_chosen en r_rejected respectievelijk de scores van het beloningsmodel voor het voorkeursantwoord en het niet-voorkeursantwoord aan, en zet σ het scoreverschil om naar een waarde tussen 0 en 1. Hoe hoger de score van het voorkeursantwoord en hoe lager die van het niet-voorkeursantwoord, hoe kleiner het verlies. Na veel voorkeursparen te hebben getraind, kan het beloningsmodel relatieve beoordelingen geven voor antwoorden die het nog niet eerder heeft gezien.
Een beloningsmodel heeft doorgaans een taalmodel als basis en voegt daar een scorehoofd toe dat een scalair score uitvoert. De invoer bestaat nog steeds uit Prompt- en antwoordtekst, maar de uitvoer is niet langer de volgende token, maar een beloningsscore die de relatieve kwaliteit weergeeft. Deze score heeft geen uniforme fysieke betekenis en kan niet direct worden geïnterpreteerd als "nauwkeurigheid" of "X punten van de 10 punten". Echt zinvol is alleen het verschil in scores tussen verschillende antwoorden onder hetzelfde beloningsmodel. Als bijvoorbeeld het ene antwoord 6 punten krijgt en het andere 4 punten, bewijst dit alleen dat het eerste antwoord volgens het huidige beloningsmodel meer voldoet aan de voorkeurscriteria, en niet dat het in objectieve zin "kwaliteit van 6 punten" heeft.
Wat een beloningsmodel kan leren, hangt in hoge mate af van de voorkeursgegevens die eerder zijn geconstrueerd. Als de annotatoren in de voorkeursgegevens altijd geneigd zijn langere antwoorden te kiezen, kan het beloningsmodel de lengte verwarren met kwaliteit; als annotatoren te veel letten op taalvloeiendheid, kan het ook antwoorden met mooie formulering maar feitelijke fouten een hogere score geven. Daarom begrijpt een beloningsmodel niet echt wat het juiste antwoord is, maar bootst het de beoordelingspatronen na die tot uitdrukking komen in de voorkeursgegevens. Dit is ook waarom een beloningsmodel na training niet alleen naar het trainingsverlies kan kijken, maar ook apart moet worden geëvalueerd.
Juist omdat het beloningsmodel zelf alleen verantwoordelijk is voor "beoordelen" en het taalmodel niet rechtstreeks wijzigt, zal het taalmodel in latere reinforcement learning-fasen zoals PPO en GRPO doorgaans nieuwe antwoorden blijven genereren, het beloningsmodel deze antwoorden beoordelen, en het reinforcement learning-algoritme de modelparameters bijwerken op basis van de beloningsresultaten, waardoor het model geleidelijk de kans op beloningsrijke antwoorden vergroot. Let op: als het strategiemodel oppervlakkige patronen ontdekt die stabiel hoge scores opleveren, kan het deze patronen herhaaldelijk benutten in plaats van de taakvaardigheid daadwerkelijk te verbeteren. Dit fenomeen wordt doorgaans reward hacking genoemd. Daarom moet een beloningsmodel niet alleen onderscheid kunnen maken tussen goede en slechte antwoorden in de trainingsgegevens, maar ook zoveel mogelijk worden beschermd tegen "bedrog" door oppervlakkige kenmerken zoals lengte, vaste formuleringen en formatsjabloons.
RLHF (Reinforcement Learning from Human Feedback) wordt doorgaans reinforcement learning op basis van menselijke feedback genoemd. Het beschrijft hoe menselijke feedback deelneemt aan reinforcement learning-training. Het is een trainingskader, niet een specifiek optimalisatiealgoritme of een vast modelarchitectuur.
Klassieke RLHF omvat doorgaans drie fasen:
Het klassieke RLHF-traject bestaat uit drie opeenvolgende fasen zoals in de onderstaande figuur wordt getoond. In de eerste fase schrijven annotatoren demonstratieantwoorden en voltooien ze SFT met deze gegevens; in de tweede fase genereert het model meerdere antwoorden voor dezelfde Prompt, die vervolgens door annotatoren worden gerangschikt, en trainen ze het beloningsmodel met vergelijkingsgegevens; in de derde fase genereert het strategiemodel nieuwe antwoorden, berekent het beloningsmodel de scores, en werkt het de strategie bij met PPO. De drie typen gegevens hebben verschillende rollen: demonstratiegegevens leren het model hoe te antwoorden, vergelijkingsgegevens leren het beloningsmodel hoe te beoordelen, en Prompt en beloningssignalen worden gebruikt voor reinforcement learning.
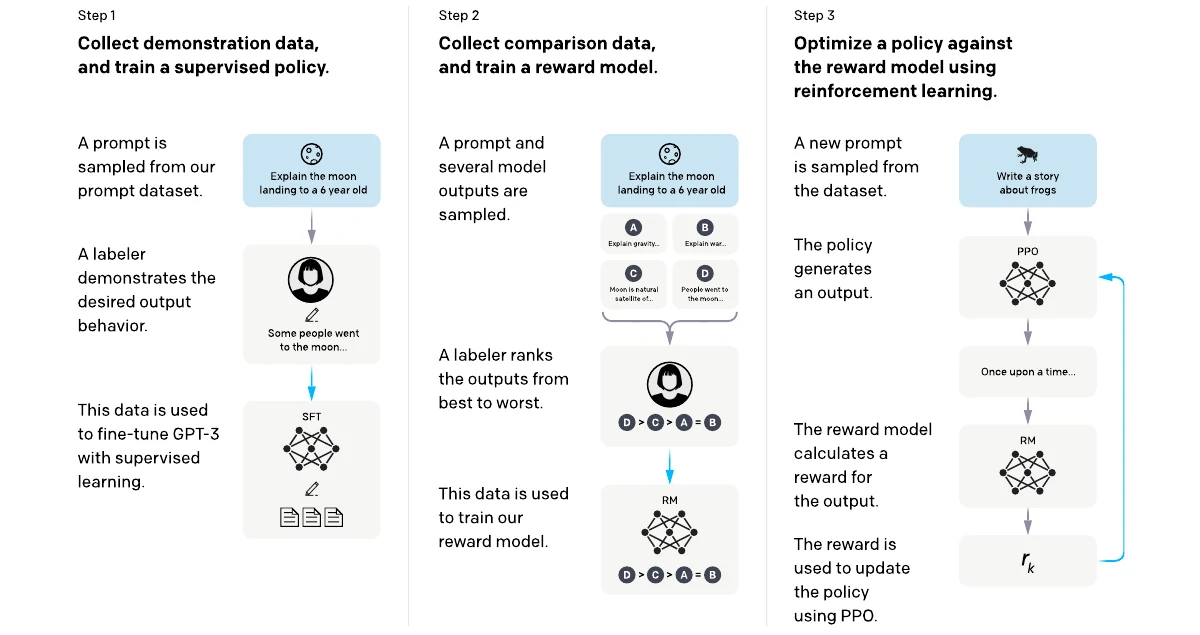
In het kader van reinforcement learning is het taalmodel het strategiemodel, vormen de Prompt en de reeds gegenereerde tokens de huidige toestand, komt het kiezen van het volgende token overeen met het ondernemen van een actie, en vormt het traject van het begin van het antwoord tot het einde van de genereerstek een volledige baan.
In RLHF geeft het beloningsmodel doorgaans na het einde van het antwoord een totaalscore, en bepaalt het reinforcement learning-algoritme vervolgens welke tokenkeuzeprocessen moeten worden verhoogd. Bij RLHF-training wordt doorgaans ook een referentiemodel behouden. Het referentiemodel is doorgaans een bevroren SFT-model, dat wordt gebruikt om te voorkomen dat het in training zijnde strategiemodel te veel afwijkt van de oorspronkelijke taalvaardigheid.
Proximal Policy Optimization (PPO) is een strategiegradiëntalgoritme waarvan het kernedoel is om de beloning te verhogen terwijl de omvang van elke parameterupdate wordt beperkt. Grote modellen hebben veel parameters; als het strategiemodel slechts vanwege een batch antwoorden met hoge scores drastisch zou veranderen, zou het model snel kunnen doorslaan naar een minderheid van beloningspatronen en zelfs de oorspronkelijke taalvaardigheid kunnen aantasten. Het "proximal" in PPO benadrukt dat de nieuwe strategie stap voor stap moet worden bijgewerkt in de buurt van de oude strategie. In post-training van grote modellen omvat één PPO-ronde doorgaans twee fasen. De eerste fase is sampling: er wordt een batch invoeren getrokken uit de Prompt-dataset, het huidige strategiemodel genereert antwoorden, tegelijkertijd worden de kansen van elk token onder de oude strategie opgeslagen, en het beloningsmodel levert scores. De tweede fase is update: op basis van beloningen en waardeschattingen worden voordelen berekend, en deze samples worden gebruikt om het strategiemodel en het waardemodel bij te werken. Na meerdere minibatch-updates wordt met de nieuwe strategie opnieuw data gegenereerd.
PPO moet de kansen van de nieuwe en oude strategie voor hetzelfde token vergelijken. De kansverhouding kan vereenvoudigd worden geschreven als:
r_t(\theta)
=
\frac{\text{Kans dat de nieuwe strategie het huidige token kies}}
{\text{Kans dat de oude strategie het huidige token kiest}}
Daarbij geeft rₜ de berekende score aan,
θ het model dat geoptimaliseerd moet worden.
Wanneer rₜ dicht bij 1 ligt, is het verschil tussen de nieuwe en oude strategie klein; wanneer rₜ duidelijk groter dan 1 is, geeft de nieuwe strategie meer de voorkeur aan het huidige token; wanneer rₜ duidelijk kleiner dan 1 is, verlaagt de nieuwe strategie de kans ervan. Alleen een kansverandering is niet voldoende; er is ook het voordeel Aₜ nodig om te beoordelen of deze tokenkeuze beter of slechter is dan het huidige gemiddelde. Wanneer het voordeel positief is, moet de kans op deze keuze passend worden verhoogd; wanneer het voordeel negatief is, moet deze worden verlaagd.
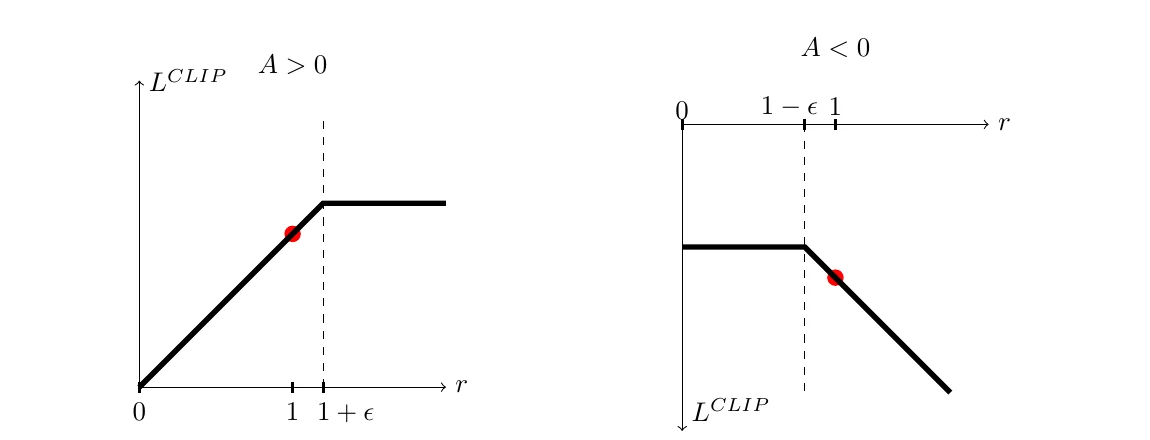
De linkerzijde van de bovenstaande figuur toont een positief voordeel. Wanneer de kansverhouding van 1 naar rechts toeneemt, stijgt het doel eerst mee; na 1+ε wordt de curve plat en verhoogt verdere verhoging van de tokendoelstelling niet. De rechterzijde toont een negatief voordeel. Wanneer de kansverhouding daalt tot onder 1-ε, stopt het doel ook met verbeteren. De twee curves samen illustreren dat PPO de strategie in de juiste richting toestaat aan te passen, maar de extra voordelen van te grote updates verzwakt.
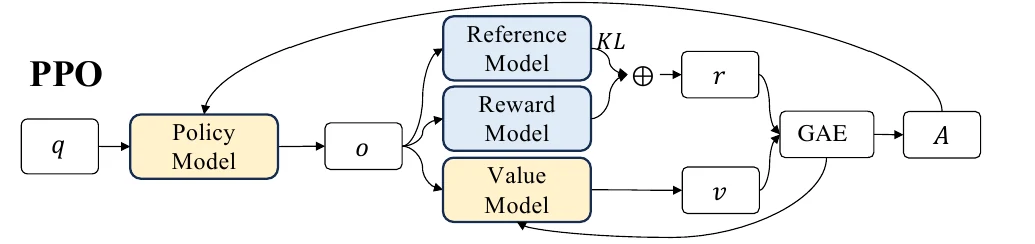
Een typische PPO-training van een groot model moet tegelijkertijd verschillende componenten onderhouden: het strategiemodel is verantwoordelijk voor het genereren en ontvangen van updates; de oude strategie is een snapshot van de strategieparameters op het moment van sampling, gebruikt voor het berekenen van de kansverhouding; het referentiemodel is een bevroren SFT-model, gebruikt voor het berekenen van de KL-beperking; het beloningsmodel beoordeelt volledige antwoorden; het waardemodel schat de mogelijke voordelen op elke gegenereerde positie in. Er bestaat een verschil tussen de schatting van het waardemodel en de werkelijke beloning; PPO gebruikt doorgaans methoden zoals GAE om deze verschillen om te zetten in voordelen voor elk token. Het volledige PPO-proces wordt getoond in de onderstaande figuur. Het strategiemodel genereert een antwoord o op basis van de invoer q, het beloningsmodel en het referentiemodel vormen samen de beloning r, het waardemodel geeft de waardeschatting v, en vervolgens wordt via GAE het voordeel A berekend. Het strategiemodel wordt bijgewerkt op basis van het voordeel en het doel met clipping, terwijl het waardemodel via het waardverlies een nauwkeuriger voordelenschatting leert.
Group Relative Policy Optimization (GRPO) is een variant van PPO die de ideeën van strategiesampling, kansverhoudingsclipping en KL-beperking behoudt. De belangrijkste verandering is dat er geen apart waardemodel meer wordt getraind, maar dat de relatieve scores van meerdere antwoorden onder dezelfde Prompt worden gebruikt om voordelen te schatten. Het algehele GRPO-kader wordt getoond in de onderstaande figuur. Voor dezelfde invoer q genereert het strategiemodel een groep antwoorden o₁ tot oG, en het beloningsmodel of het regelsysteem geeft respectievelijk r₁ tot rG.
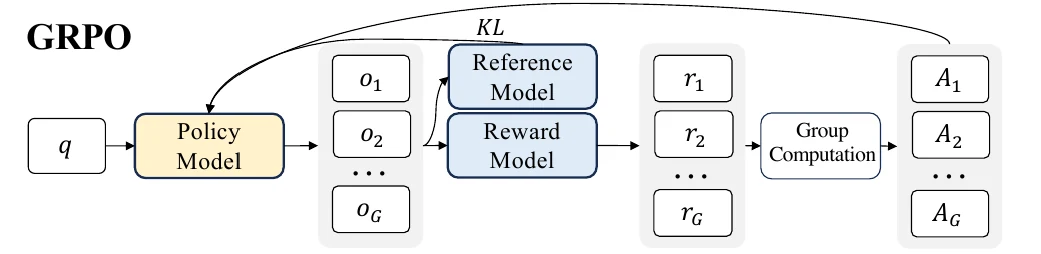
Het systeem berekent eerst het gemiddelde en de standaardafwijking van deze groep beloningen, en zet vervolgens de score van elk antwoord om in een relatief voordeel binnen de groep. Antwoorden met een score boven het groepsgemiddelde krijgen een positief voordeel, en antwoorden onder het gemiddelde krijgen een negatief voordeel. Voor taken die alleen aan het einde van het antwoord één totaalbeloning geven, delen tokens binnen hetzelfde antwoord doorgaans het relatieve voordeel dat door dat antwoord is verkregen; als er ook procesbeloningen worden gegeven, kan er ook fijnere token-gebaseerde feedback worden gevormd. Vervolgens vergelijkt GRPO net als PPO de kansen van de nieuwe en oude strategie, en werkt het het strategiemodel bij via het doel met clipping en de KL-beperking.
In vergelijking met PPO vermindert GRPO de parameters, het geheugengebruik en de trainingskosten die het waardemodel met zich meebrengt, maar dit betekent niet dat de trainingskosten noodzakelijkerwijs laag zijn. Elke Prompt vereist het genereren van meerdere antwoorden, en inferentie-sampling zelf verbruikt veel rekenresources. Als antwoorden in dezelfde groep exact dezelfde scores krijgen en de standaardafwijking bij 0 ligt, is groepsvergelijking moeilijk en kan het geen effectieve richting bieden; de praktische implementatie moet deze gegevens overslaan, gladstrijken of opnieuw sampelen. Groepsgrootte, samplingtemperatuur, beloningsschaal en KL-coëfficiënt hebben ook invloed op de trainingsstabiliteit. Bijvoorbeeld: een wiskundig probleem genereert vier oplossingen, waarvan twee juist zijn, een rekenfout bevat en een niet is voltooid. Het systeem kan antwoordverificatieregels gebruiken om ze te beoordelen, en dan binnen de vier resultaten vergelijken. Correcte en volledig doorlopen antwoorden krijgen een hoger voordeel, foutieve of onvoltooide antwoorden een lager voordeel, en het model verhoogt op basis daarvan de waarschijnlijkheid van betere oplossingen. Taken met code kunnen ook compilatie-resultaten en unit-tests als beloning gebruiken, zonder noodzakelijkerwijs eerst een speciaal beloningsmodel te trainen.
Direct Preference Optimization (DPO). In de titel van hun artikel wijzen de auteurs er expliciet op dat een preferentiemodel mogelijk niet nodig is en dat het grote taalmodel dat we bouwen mogelijk zelf een potentieel preferentiemodel is. Dit idee slaat de afzonderlijke modellering van het preferentiemodel over en vertrekt in plaats daarvan vanuit het oorspronkelijke model met een verliesfunctie die speciaal is ontworpen voor het preferentiemodel, waardoor de optimalisatie van de modeluitvoer verder wordt verbeterd. DPO traint het taalmodel rechtstreeks met reeds verzamelde voorkeursantwoorden en niet-voorkeursantwoorden, zonder expliciet een beloningsmodel te trainen of een online reinforcement learning-cyclus zoals PPO of GRPO uit te voeren.
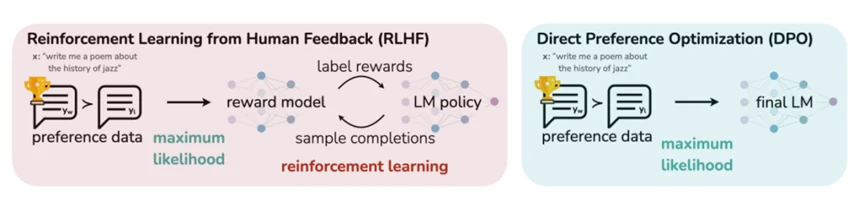
De bovenstaande figuur vergelijkt het klassieke RLHF-traject en DPO. Voorkeursgegevens worden eerst gebruikt om het beloningsmodel te trainen, het strategiemodel genereert vervolgens nieuwe antwoorden en voert reinforcement learning uit op basis van de scores van het beloningsmodel. Bij het DPO-traject gaan voorkeursgegevens direct de taalmodeltraining in. Beide vertrekken vanuit de voor-nadelenrelatie tussen antwoorden, maar de trainingsfasen en resourcebehoeften verschillen. Het volledige DPO-proces vereist slechts twee fasen:
De eerste fase: het construeren van positieve en negatieve steekproeven voor voorkeursgeneratie. In vergelijking met de steekproefconstructie van de vorige fijnafstemmingsfase wordt het oorspronkelijke "Invoer (Input) - Uitvoer (Output)"-gegevensset veranderd in "Invoer (Input) - Positieve feedback (Accept Response) - Negatieve feedback (Negative Response)". Deze trainingsmethode met steekproeven is niet nieuw; het is in feite contrastief leren dat is ontstaan uit het beeldgebied. Onderzoekers naar contrastief leren ontdekten dat het model snel convergeert en de algehele prestatie verder kan verbeteren wanneer het positieve en negatieve voorbeelden tegelijk leert.
De tweede fase: op basis van de ontworpen verliesfunctie, met behulp van methoden voor contrastief leren en de grootste waarschijnlijkheidsfunctie, de parameters van het oorspronkelijke generatiemodel optimaliseren. Dit ontwerp bespaart het oorspronkelijke preferentiebeloningsmodel en het volledige reinforcement learning-proces, wat zowel de efficiëntie verhoogt als de nauwkeurigheid en stabiliteit in vergelijking met PPO aanzienlijk verbetert. Door de optimalisatie en aanpassing in de tweede fase worden de modelparameters voortdurend geoptimaliseerd in de richting van positieve voorbeelden en weg van negatieve voorbeelden, waardoor uiteindelijk de voorkeursalignatie van de modeluitvoer naar positieve inhoud wordt gerealiseerd.
De trainingsvorm van DPO lijkt op gewone SFT. De trainingsgegevens bevatten al de Prompt, het voorkeursantwoord en het niet-voorkeursantwoord; het model hoeft bij elke stap niet opnieuw kandidaten te genereren en het hoeft niet tegelijkertijd het beloningsmodel en het waardemodel uit te voeren. Daarom behoort het tot offline preferentieoptimalisatie: minder componenten, minder geheugengebruik en minder technische complexiteit dan PPO. Deze vereenvoudiging neemt de eisen aan gegevenskwaliteit niet weg. DPO kan alleen leren van verschillen die al in de voorkeursgegevens voorkomen. Als het voorkeursantwoord zelf feitelijke fouten bevat, het niet-voorkeursantwoord te slecht is, of de gegevens voornamelijk afkomstig zijn van een generatieverdeling die sterk afwijkt van het huidige model, kan het model oppervlakkige stijl leren in plaats van de doelvaardigheid. DPO zal ook niet, zoals online reinforcement learning, voortdurend nieuwe antwoorden verkennen en vervolgens feedback verkrijgen op nieuw ontdekte problemen.
In de voorgaande secties zijn de basisprincipes en trainingsmethoden van RLHF, PPO, GRPO en DPO afzonderlijk besproken. Om de relaties tussen deze methoden duidelijker te begrijpen, kunnen we ze vergelijken op basis van verschillende dimensies zoals method positionering, of er online antwoorden moeten worden gegenereerd tijdens de training, en of er een beloningsmodel en waardemodel nodig zijn. Door deze horizontale vergelijking kunnen de belangrijkste verschillen tussen verschillende post-trainingmethoden op het gebied van implementatiepad, trainingskosten en toepassingswijze intuïtiever worden waargenomen. De onderstaande tabel is een vergelijking van de relevante modellen.
Concept | Behoort tot | Genereert nieuwe antwoorden tijdens training | Vereist expliciet beloningsmodel | Vereist waardemodel | Belangrijkste kenmerk |
RLHF | Feedback en reinforcement learning-kader | Doorgaans ja | Klassiek traject: ja | Afhankelijk van het gebruikte optimalisatiealgoritme | Bepaalt hoe menselijke feedback, beloningen en strategie-updates worden gekoppeld |
PPO | Online reinforcement learning-algoritme | Ja | In klassieke RLHF: doorgaans ja | Ja | Stabiele strategie-update via waardeschatting en kansverhoudingsclipping |
GRPO | Online reinforcement learning-algoritme | Ja, dezelfde Prompt genereert doorgaans een groep antwoorden | Kan beloningsmodel of regelgebaseerde beloning gebruiken | Nee | Schat voordelen op basis van relatieve beloningen binnen een groep |
DPO | Offline preferentieoptimalisatiemethode | Doorgaans geen online generatie nodig | Niet apart trainen | Nee | Verhoogt rechtstreeks de kans van voorkeursantwoorden ten opzichte van niet-voorkeursantwoorden |
Samengevat: hoewel RLHF, PPO, GRPO en DPO allemaal verband houden met de voorkeursalignatie van grote modellen, lossen ze niet exact hetzelfde probleem op. RLHF is meer een compleet feedback- en reinforcement learning-kader, PPO en GRPO zijn online reinforcement learning-algoritmen die binnen dit type kader worden gebruikt om het strategiemodel bij te werken, terwijl DPO rechtstreeks bestaande voorkeursgegevens gebruikt om offline optimalisatie uit te voeren. Vanuit het oogpunt van trainingsmechanisme is PPO afhankelijk van beloningsmodellen en waardemodellen, met een vollediger technische keten maar hogere trainingskosten en implementatiecomplexiteit; GRPO schat voordelen op basis van relatieve beloningen binnen een groep, bespaart het waardemodel, en is meer geschikt voor taken met regelgebaseerde beloningen, antwoordverificatie en andere duidelijke feedback; DPO heeft geen online generatie van antwoorden nodig en hoeft geen beloningsmodel en waardemodel apart te trainen, waardoor de implementatie relatief eenvoudig is en het een lage-kosten alignatieoplossing is wanneer voorkeursgegevens voldoende beschikbaar zijn.
In de praktijk moet de methodkeuze vertrekken vanuit de huidige capaciteiten die het model mist, en niet eenvoudigweg één bepaald trainingsalgoritme volgen. Wanneer het model taken nog niet stabiel kan uitvoeren, moet de basisvaardigheid via SFT worden opgebouwd; wanneer het model taken wel kan uitvoeren maar de antwoordkwaliteit en voorkeurskeuze onstabiel zijn, kunnen DPO, PPO of GRPO verder worden ingezet. Wanneer er al hoogwaardige voorkeursgegevens zijn en men de eerste alignatieronde snel wil voltooien, kan DPO de voorkeur krijgen; wanneer taken verifieerbare beloningen hebben en men wil dat het model actief betere oplossingen verkent, kan GRPO worden overwogen; wanneer er een volwassen beloningsmodel, waardemodel en reinforcement learning-infrastructuur beschikbaar is en er fijne controle over online strategie-updates nodig is, kan PPO worden gebruikt. Ongeacht welke methode uiteindelijk wordt gekozen, mag het effect niet alleen worden beoordeeld op basis van trainingsverlies, beloningsscores of voorkeurswinstpercentages, maar moet men terugkeren naar de praktische taak om de nauwkeurigheid, taakvoltooing, veiligheid, bedrijfsgrenzen en algemene vaardigheden van het model continu te evalueren. Het uiteindelijke doel van post-training is niet het verkrijgen van hogere beloningen, maar het model in de praktische gebruiksomgeving stabielere en betrouwbaardere resultaten te laten behalen voor de beoogde taak.
In de voorgaande secties zijn de basisprincipes van preferentiealignatie en reinforcement learning besproken. Hieronder volgen twee concrete experimenten met ms-swift. Het eerste experiment gebruikt Chinese voorkeursgegevens voor DPO-training en observeert hoe de voorkeur van het model voor voorkeursantwoorden en niet-voorkeursantwoorden verandert; het tweede experiment gebruikt wiskundige vraagstukken voor GRPO-training, waarbij het model kandidaatantwoorden genereert en vervolgens beloning krijgt op basis van antwoord en formaat. Beide experimenten gebruiken Qwen2.5-0.5B-Instruct als initieel model, dat al over instructieopvolgingsvaardigheden beschikt, en trainen elk een onafhankelijke LoRA-adapter.
Dit experiment wordt uitgevoerd in de single-GPU-omgeving van de ModelScope Notebook. Het model en de originele gegevensbestanden worden gedownload van de ModelScope-community. De configuratie van de twee experimenten is als volgt:
Item | DPO Chinese voorkeursalignatie | GRPO wiskundige antwoordoptimalisatie |
Initieel model | Qwen/Qwen2.5-0.5B-Instruct | Hetzelfde Qwen2.5-0.5B-Instruct gewicht |
Gegevensset | AI-ModelScope/hh_rlhf_cn | AI-ModelScope/gsm8k |
Gebruikte subset | helpful_base_cn | main |
Trainingsset | 256 voorkeursparen | 128 vraagstukken |
Validatieset | 32 voorkeursparen | 16 vraagstukken |
Testset | 32 voorkeursparen | Alle 1319 vraagstukken uit het officiële testbestand |
Trainingsmethode | LoRA, 20 optimizer update-stappen | LoRA, 10 optimizer update-stappen |
Feedback bij training | Voorkeursantwoord en niet-voorkeursantwoord zoals opgegeven in de gegevens | Na het genereren van antwoorden door het model, worden beloningen berekend door regels |
De trainingsomvang hier is klein, voornamelijk bedoeld om het volledige proces te demonstreren. Trainingsstappen geven het aantal keren aan dat de optimizer de parameters bijwerkt; dit is niet gelijk aan het aantal trainingsrondes en geeft niet aan dat de trainingsgegevens volledig zijn gebruikt. Dit praktijkgedeelte heeft slechts een klein deel van de gegevens gebruikt en een beperkt aantal iteratiestappen toegepast; het experiment dient alleen als referentie.
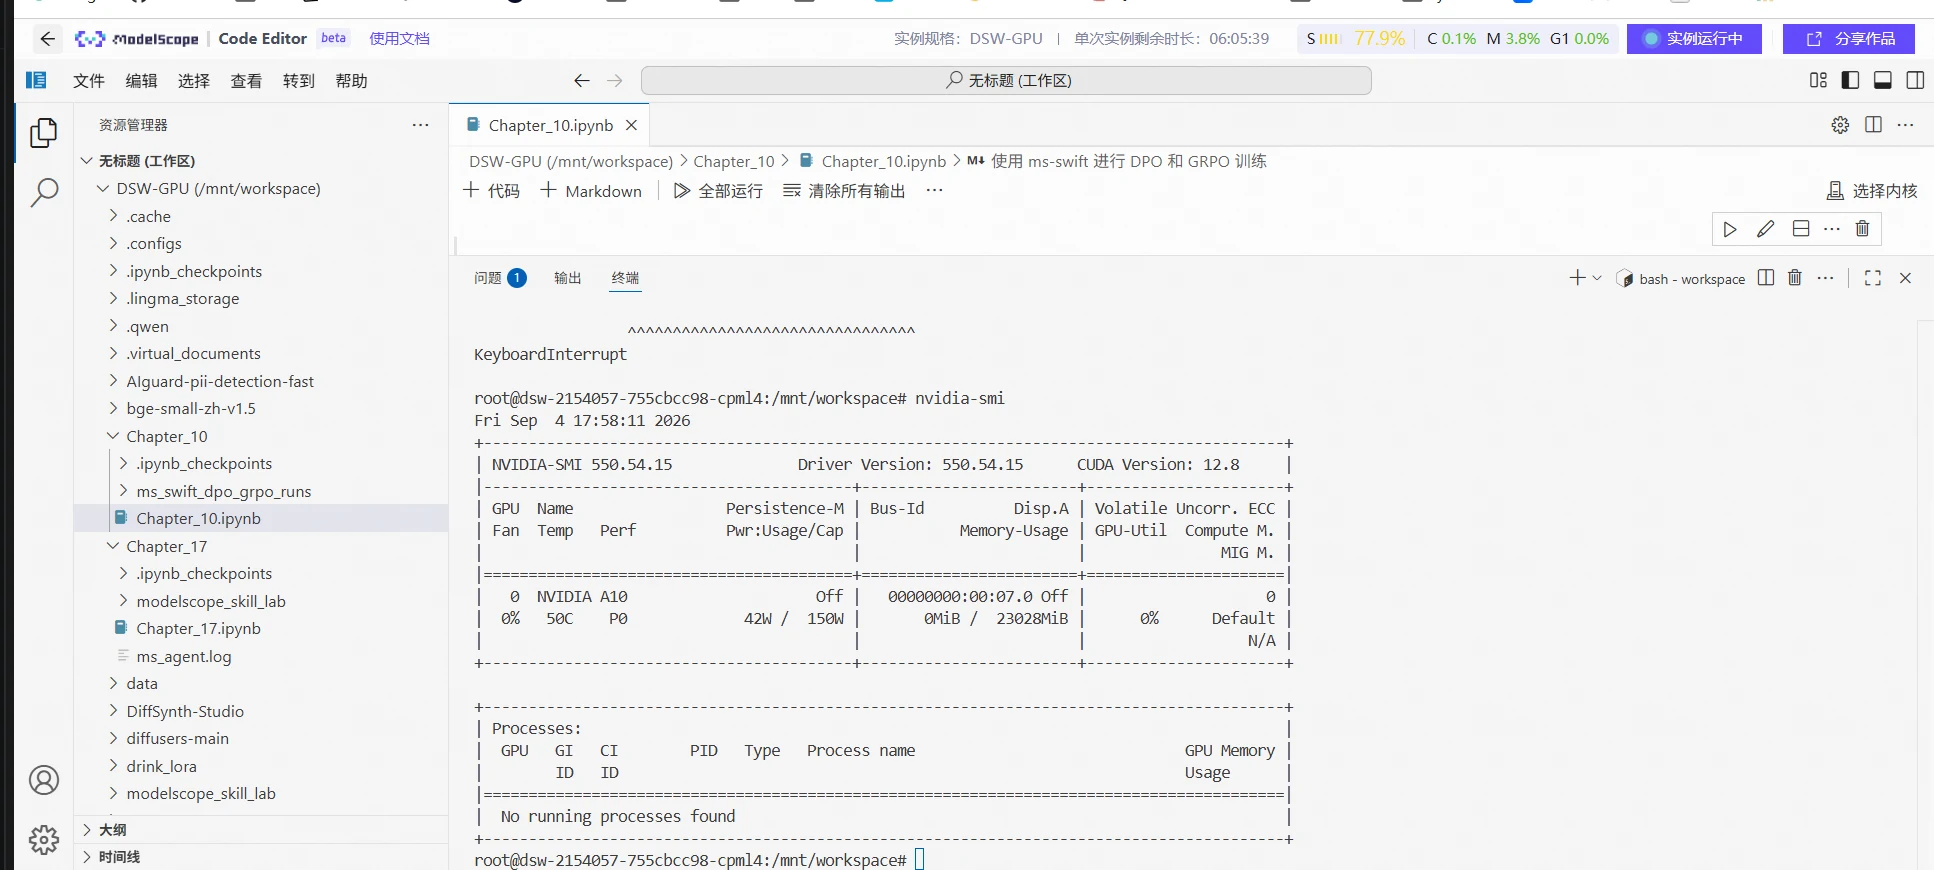
1)Controleer de werkomgeving.
Open de bijbehorende Notebook en controleer eerst of de GPU beschikbaar is en welke softwareversies de huidige kernel daadwerkelijk gebruikt.
2)Bereid het model en de werkmap voor.
Het gemeenschappelijke voorbereidingsgedeelte maakt de cachemap en de experimentmap aan. De kerncode van de modelconfiguratie is als volgt:
MODEL_ID = "Qwen/Qwen2.5-0.5B-Instruct"
MODEL_REVISION = "master"
DPO_DATA_ID = "AI-ModelScope/hh_rlhf_cn"
GRPO_DATA_ID = "AI-ModelScope/gsm8k"
SEED = 42

MODEL_DIR = Path(snapshot_download(
    MODEL_ID,
    revision=MODEL_REVISION,
    cache_dir=str(CACHE_DIR / "models"),
    allow_file_pattern=[
        "*.json", "*.safetensors", "*.txt", "*.model", "*.tiktoken"
    ],
).resolve()
Daarbij komt snapshot_download van ModelScope en wordt CACHE_DIR aangemaakt door de gemeenschappelijke voorbereidingscode. Na het downloaden worden zowel training als inferentie uitgevoerd met het lokale modelsnapshot waarnaar MODEL_DIR verwijst. De inhoud van dit praktijkgedeelte wordt opgeslagen in de map ms_swift_dpo_grpo_runs/. Wanneer lezers opnieuw uitvoeren, genereert het programma nieuwe experimentnummers en moeten ze hun eigen werkmap gebruiken voor RUN_DIR. DPO
DPO heeft twee kandidaatantwoorden onder dezelfde context nodig. Het experiment gebruikt de subset helpful_base_cn van de Chinese HH-RLHF-gegevensset, waarbij context de conversatiegeschiedenis bewaart, chosen het voorkeursantwoord bewaart en rejected het niet-voorkeursantwoord bewaart. De voorkeurs- en niet-voorkeursstatus hier komt van de gegevenssetlabels en betekent niet dat de feiten in het antwoord afzonderlijk zijn geverifieerd.
1)Omzetten naar het door ms-swift gebruikte gegevensformaat.
De voorkeurssteekproefstructuur die door ms-swift wordt gebruikt, is als volgt. Hieronder worden alleen de veldenrelaties getoond; de werkelijke inhoud wordt uit de gegevensset gelezen:
{
  "messages": [
    {"role": "user", "content": "Dezelfde vraag"},
    {"role": "assistant", "content": "Voorkeursantwoord"}
  ],
  "rejected_response": "Niet-voorkeursantwoord"
}
In vergelijking met de SFT-steekproeven uit [Snel ms-swift gebruiken voor lichte fijnafstemming van open-source modellen] is hier rejected_response toegevoegd. Het laatste assistant-bericht in messages bewaart het voorkeursantwoord, en het niet-voorkeursantwoord staat in een apart veld. Eerdere assistant-berichten in multi-turn conversaties behoren nog steeds tot de context en mogen niet per abuis worden aangezien als de antwoorden van deze vergelijking. De conversiefunctie in de Notebook is als volgt:
def convert_dpo(row):
    role_map = {
        "human": "user", "user": "user",
        "assistant": "assistant", "system": "system"
    }
    context = [
        {"role": role_map[m["role"]], "content": m["text"].strip()}
        for m in row["context"]
    ]
    chosen = row["chosen"]["text"].strip()
    rejected = row["rejected"]["text"].strip()

    assert context and context[-1]["role"] == "user"
    assert chosen and rejected and chosen != rejected
    assert all(m["content"] for m in context)
    if context[0]["role"] != "system":
        context.insert(0, {"role": "system", "content": GENERAL_SYSTEM})

    return {
        "messages": context + [{"role": "assistant", "content": chosen}],
        "rejected_response": rejected,
    }
2)Gegevens opschonen en verdelen.
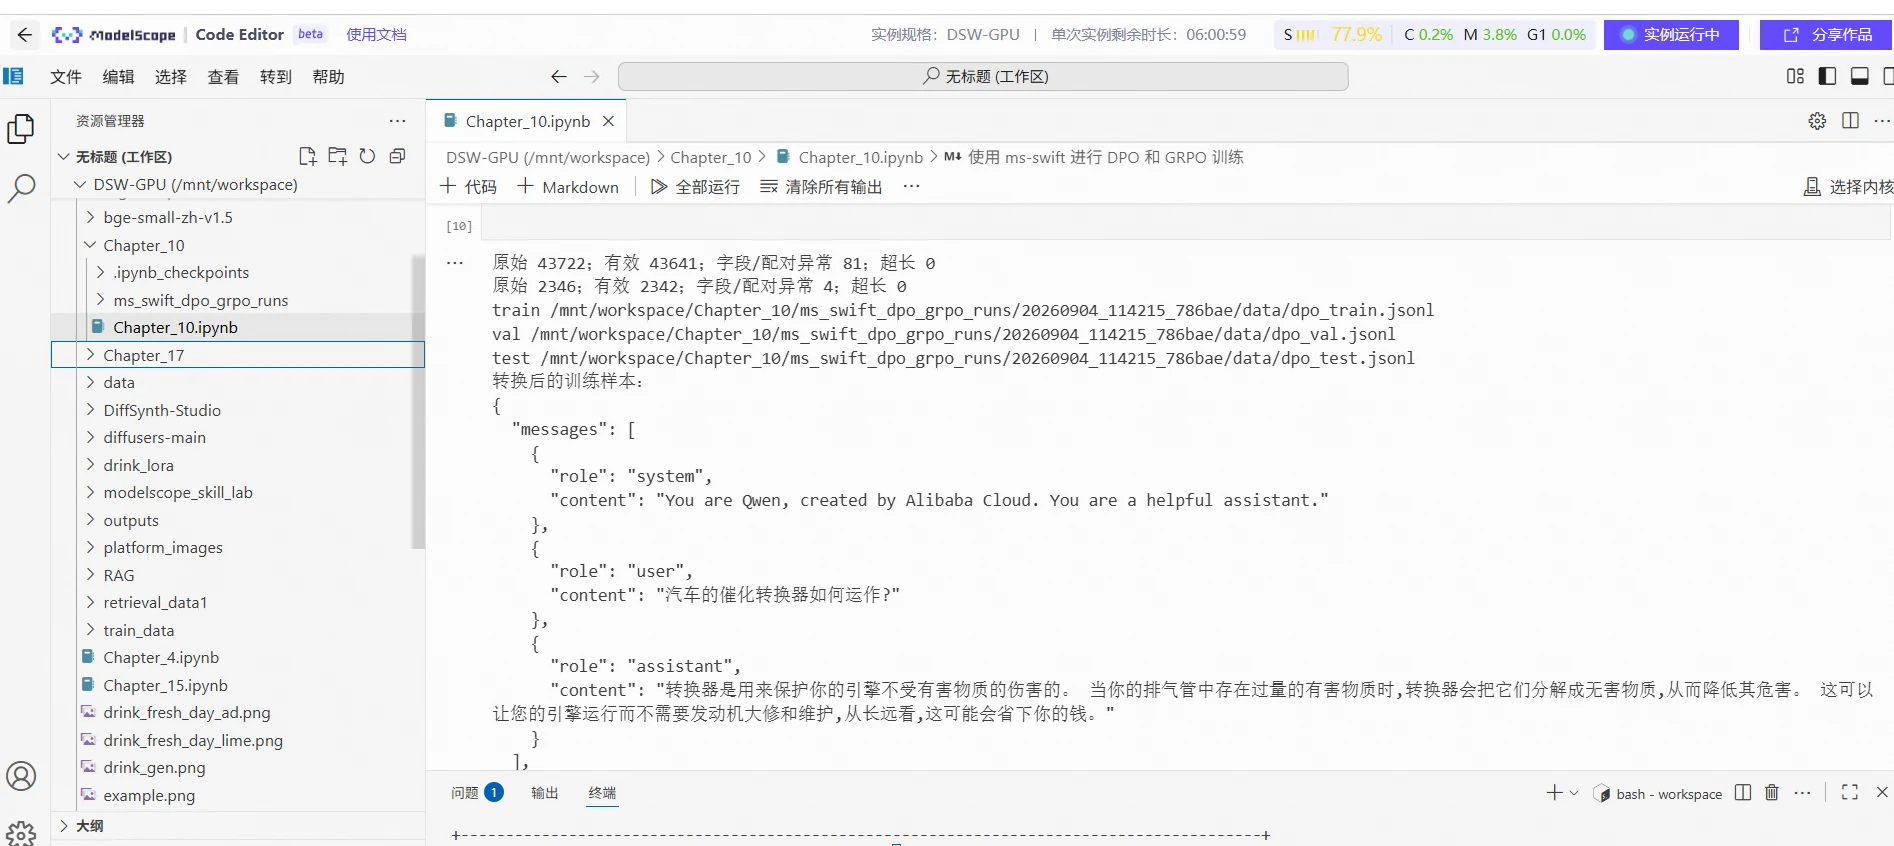
Bij dit experiment worden de lengtes van het voorkeursantwoord en het niet-voorkeursantwoord na samenvoeging met de context afzonderlijk berekend; alleen steekproeven waarvan beide niet meer dan 1024 tokens bedragen, worden behouden. Bij overschrijding wordt het volledige paar verwijderd om te voorkomen dat de sleutelinhoud die het onderscheid tussen goed en slecht bepaalt, bij inkorting wordt verwijderd. Vervolgens worden de gegevens op basis van context gedupliceerd en worden uit de oorspronkelijke trainingsbron 256 trainingsgegevens en 32 validatiegegevens verdeeld. De verwerkte bestanden zijn respectievelijk dpo_train.jsonl, dpo_val.jsonl en dpo_test.jsonl, opgeslagen in de data-map van de werkmap. De drie bestanden hebben verschillende rollen: de trainingsset wordt gebruikt om parameters bij te werken, de validatieset om het trainingsproces te observeren, en de testset voor onafhankelijke vergelijking na training. De bijbehorende uitvoerresultaten worden getoond in de onderstaande figuur.
Voor de training wordt eerst de prestatie van het initiële model op de testset vastgelegd. De functie dpo_evaluate() in de Notebook berekent de log-waarschijnlijkheden van 32 vaste voorkeursparen en genereert antwoorden voor 4 contexten ter vergelijking na training:
def dpo_evaluate(adapter=None):
    def action(model):
        rows = []
        for index, row in enumerate(dpo_test):
            context = row["messages"][:-1]
            lp_chosen = response_logp(model, context, row["messages"][-1]["content"])
            lp_rejected = response_logp(model, context, row["rejected_response"])
            rows.append({"sample_id": index, "chosen_logp": lp_chosen,
                         "rejected_logp": lp_rejected, "gap": lp_chosen - lp_rejected})
        # Er worden 4 antwoorden gegenereerd voor gedetailleerde lezing; de overige paren worden nog steeds gebruikt voor kansdiagnose.
        generations = [{"sample_id": i, "context": dpo_test[i]["messages"][:-1],
                        "response": generate_one(model, dpo_test[i]["messages"][:-1])}
                       for i in range(min(4, len(dpo_test))]
        return rows, generations
    return with_local_model(action, adapter)

dpo_before, dpo_before_text = dpo_evaluate()
De bijbehorende stappen om de DPO-training te starten zijn als volgt:
1)Stel de trainingsparameters in.
Beide experimenten delen de gemeenschappelijke configuratie via common_options(), inclusief het lokale modelpad, het Qwen-conversatiesjabloon, de willekeurige seed, bfloat16-precisie en LoRA-instellingen. De LoRA-rank is 8, alpha is 16, en de doelmodule is all-linear. Hieronder wordt de volledige DPO-experimentconfiguratie weergegeven; de gemeenschappelijke functie moet eerst in de bijbehorende Notebook worden uitgevoerd. De functie common_options() voegt de gemeenschappelijke parameters samen met de parameters van dit experiment. train_swift zet deze parameters om naar opdrachtregelvorm en voert modeltraining uit via swift.cli.rlhf vanuit de huidige kernel.
DPO_OUTPUT = RUN_DIR / "dpo"
DPO_BETA = 0.1
dpo_options = common_options() | {
    "rlhf_type": "dpo", "loss_type": "sigmoid", "beta": DPO_BETA,
    "dataset": str(DPO_PATHS["train"]),
    "val_dataset": str(DPO_PATHS["val"]),
    "output_dir": str(DPO_OUTPUT), "max_length": 1024,
    "truncation_strategy": "delete", "max_steps": 20,
    "learning_rate": 5e-5, "lr_scheduler_type": "cosine",
    "warmup_ratio": 0.1,
    "per_device_train_batch_size": 1,
    "per_device_eval_batch_size": 1,
    "gradient_accumulation_steps": 8,
    "eval_strategy": "steps", "eval_steps": 10,
    "save_strategy": "steps", "save_steps": 10,
}
train_swift(dpo_options, RUN_DIR / "dpo_train.log")
DPO_ADAPTER = latest_adapter(DPO_OUTPUT)
De betekenis van de belangrijkste parameters is als volgt:
Parameter | Waarde in dit experiment | Functie |
rlhf_type / loss_type | dpo / sigmoid | Gebruik het standaard sigmoid-vormige DPO-doel |
beta | 0.1 | Beheert de schaal van het DPO-doel ten opzichte van de referentiestrategie |
learning_rate | 5e-5 | Beheert de omvang van elke parameterupdate |
max_length | 1024 | Beperkt de totale lengte van context en kandidaatantwoorden |
per_device_train_batch_size | 1 | Elke training minibatch op één kaart verwerkt 1 voorkeurspaar |
gradient_accumulation_steps | 8 | Na accumulatie van 8 minibatches worden de parameters één keer bijgewerkt |
max_steps | 20 | Training eindigt na 20 optimizer updates |
eval_steps / save_steps | 10 / 10 | Elke 10 stappen validatie uitvoeren en checkpoints opslaan |
2)Bekijk de trainingsuitvoer.
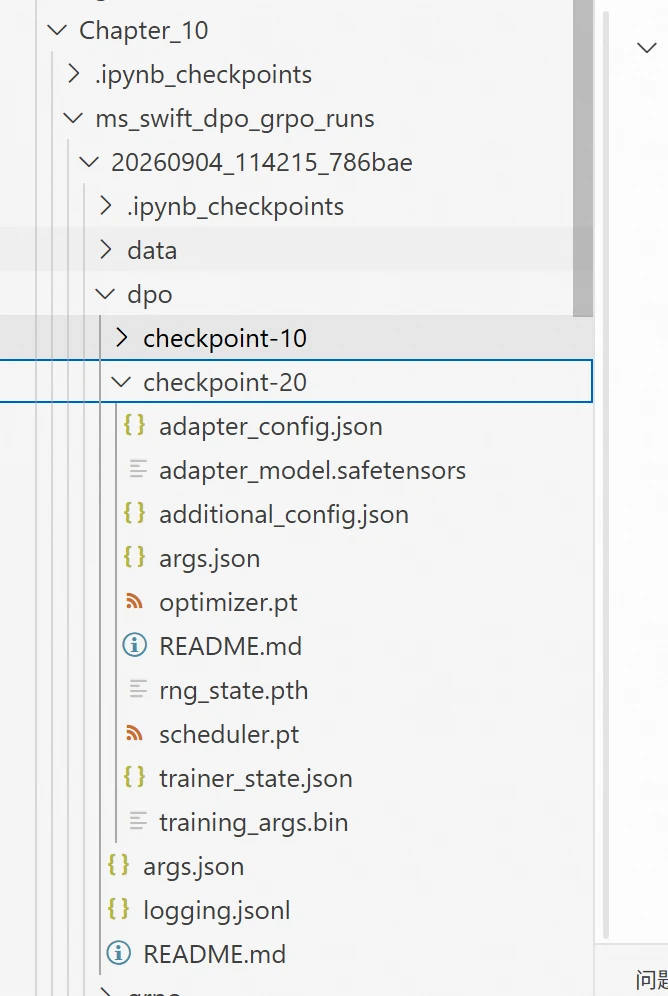
Zodra de training begint, geeft ms-swift het verlies, de impliciete beloningen, validatiemetrics en de opslaglocatie van checkpoints. Na afloop van de training wordt het model opgeslagen in de map dpo/checkpoint. De resultaten van de modeltraining en -opslag worden getoond in de onderstaande figuur.
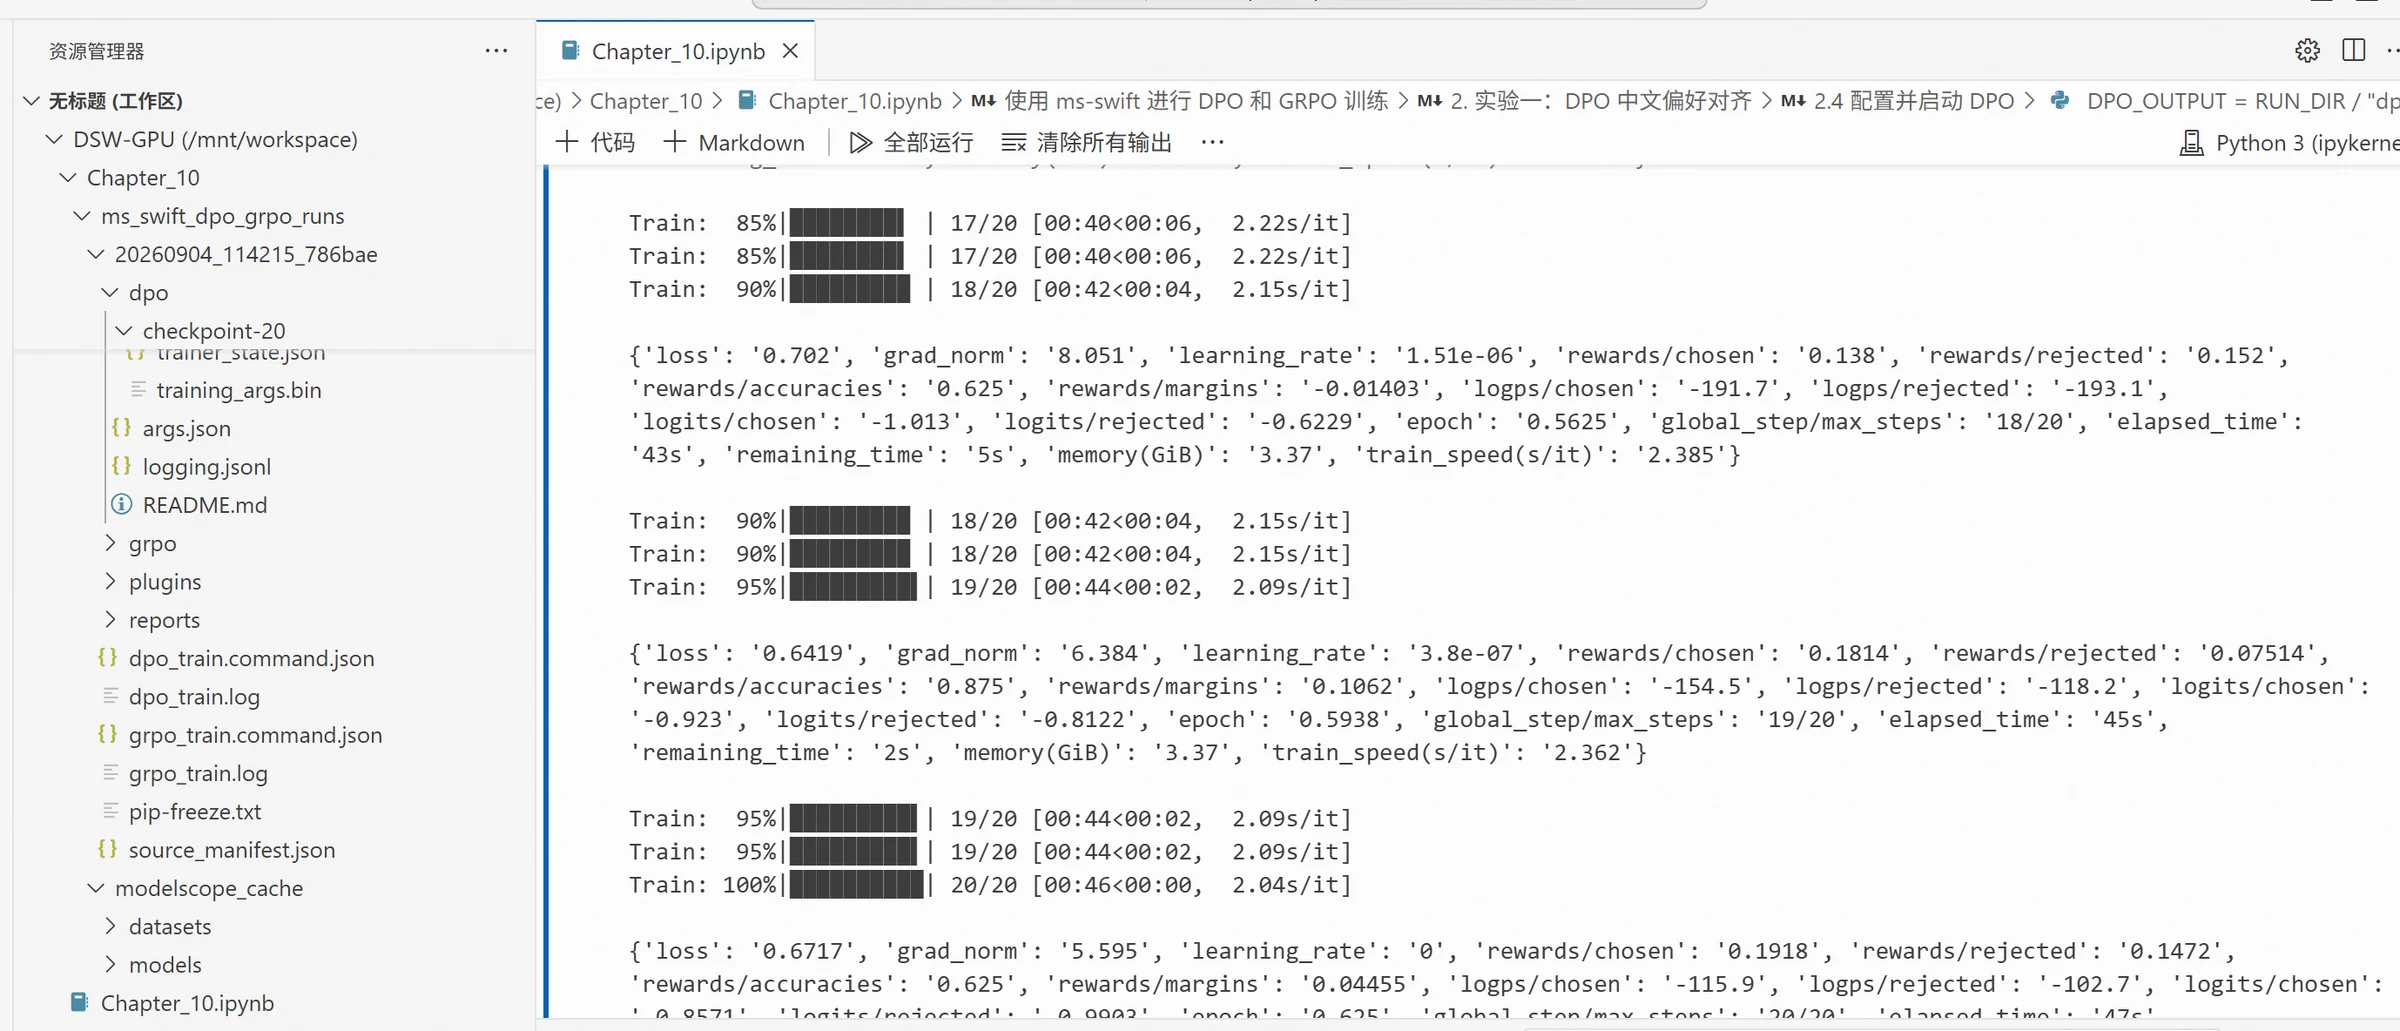
De rewards/chosen en rewards/rejected in de logs zijn impliciete beloningen die worden berekend op basis van het verschil in log-waarschijnlijkheid tussen de strategie en de referentiestrategie, en niet de score van een extern beloningsmodel voor de antwoordkwaliteit. rewards/accuracies geeft het aandeel aan waarin de impliciete beloningsrangschikking overeenkomt met de voorkeurslabels, en mag niet direct worden geïnterpreteerd als de nauwkeurigheid van de door het model gegenereerde antwoorden. De bijbehorende loguitvoerresultaten worden getoond in de onderstaande figuur.
Na het laden van de DPO-adapter wordt opnieuw dezelfde testset gebruikt voor evaluatie. Bij de vergelijking worden het systeembericht, het conversatiesjabloon en de genereerparameters gelijk gehouden om te voorkomen dat veranderingen in prompts of decodingmethoden als trainings-effect worden aangemerkt.
dpo_after, dpo_after_text = dpo_evaluate(DPO_ADAPTER)
before_df = pd.DataFrame(dpo_before).set_index("sample_id")
after_df = pd.DataFrame(dpo_after).set_index("sample_id")

comparison = pd.DataFrame({
    "before_gap": before_df["gap"],
    "after_gap": after_df["gap"],
    "relative_dpo_margin": DPO_BETA * (
        after_df["gap"] - before_df["gap"]
    ),
})
Daarbij is gap gelijk aan de sequentie log-waarschijnlijkheid van het voorkeursantwoord minus de sequentie log-waarschijnlijkheid van het niet-voorkeursantwoord. Een gap groter dan 0 geeft aan dat het huidige model een hogere sequentie-waarschijnlijkheid heeft voor het gegeven voorkeursantwoord. Door het aandeel te berekenen waarvoor deze voorwaarde geldt voor de teststeekproeven, verkrijgt men pair_preference_rate.
De testresultaten van dit experiment worden getoond in de onderstaande figuur:
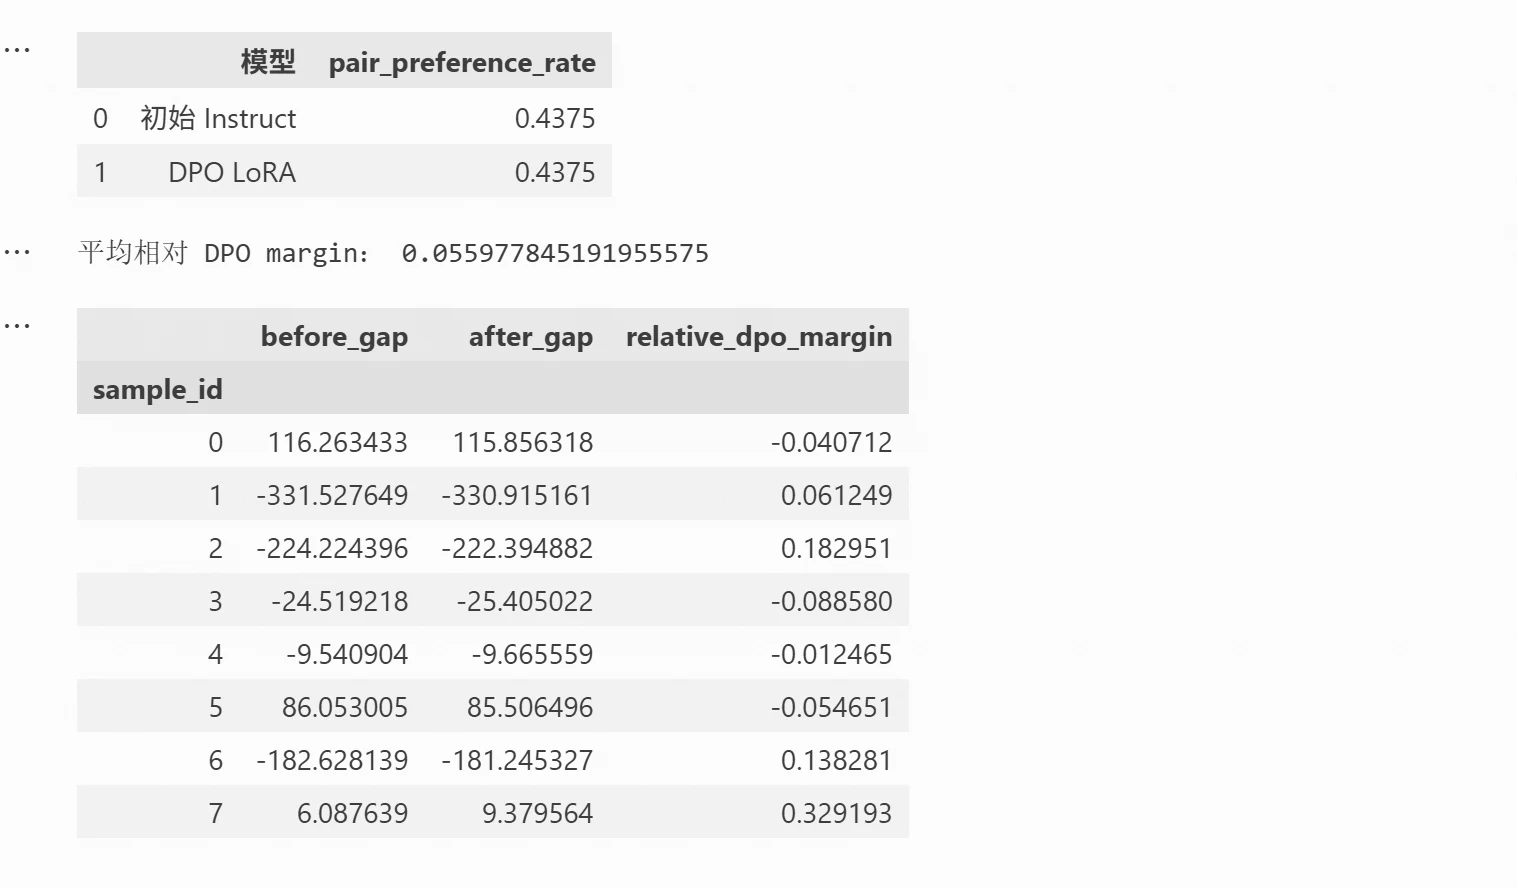
Vanwege het beperkte aantal trainingsrondes kunnen de verschillen bij sommige steekproeven groter worden, maar veranderen ze nog steeds niet van negatief naar positief; sommige steekproeven verbeteren, andere verslechteren. Daarom hoeft een positief gemiddeld relatief margin niet te leiden tot een hoger aandeel steekproeven waarbij het voorkeursantwoord de voorkeur heeft. In dit experiment was dit aandeel zowel voor als na training 43,75%. Als voorbeeld een vraag uit de testset over het signaal van een thuisnetwerk:
Gebruiker: Welke methoden kan ik gebruiken om mijn thuisnetwerksignaal te versterken? Mijn laptop kan moeilijk verbinding maken met de router!
Het antwoord van het initiële model bevatte het volgende (ongewijzigd geciteerd):
1. **Gebruik een draadloze router**: Als u meerdere apparaten heeft die verbinding moeten maken, kunt u overwegen een draadloze router te installeren. Hiermee kunt u via Wi-Fi verbinding maken met internet.
Het antwoord na DPO-training bevatte:
3. **Herstart de router**: Soms kan een eenvoudige herstart enkele netwerkverbindingsproblemen oplossen. Volg de instructies van de router.
Uit de volledige uitvoer blijkt dat het initiële antwoord vaker suggereerde om apparaten te vervangen of toe te voegen, terwijl het antwoord na training meer was georganiseerd rond netwerkinstellingen, stuurprogramma's en herstartprocedures, wat aangeeft dat de training de gegenereerde inhoud heeft gewijzigd. Deze DPO-training heeft de relatieve kansen van enkele vaste kandidaten en enkele gegenereerde antwoorden gewijzigd, maar vanwege de beperkte trainingsomvang en gegevens kunnen lezers grotere datasets en meer trainingsrondes gebruiken om het experiment te reproduceren.
DPO gebruikt de twee antwoorden die al in de gegevens zijn opgegeven, terwijl GRPO vereist dat het model tijdens training kandidaatantwoorden genereert, die vervolgens door de beloningsfunctie worden beoordeeld. Dit experiment gebruikt GSM8K wiskundige toepassingsvragen, waarbij het laatste getal en het outputformaat als automatisch controleerbare feedback dienen, zonder een apart beloningsmodel te trainen.
1)Scheid de vraag en het standaardantwoord.
De originele GSM8K-gegevens bevatten de velden question en answer. In answer staat zowel het oplossingsproces als het laatste getal na ####. Bij gegevenomzetting wordt alleen de vraag aan het model gegeven en wordt het laatste getal naar het veld solution geëxtraheerd. De bijbehorende code is als volgt:
def convert_grpo(row):
    question = row["question"].strip()
    original_answer = row["answer"].strip()
    assert question and "####" in original_answer
    answer = parse_numeric(original_answer.rsplit("####", 1)[-1])
    assert answer is not None
    return {
        "messages": [
            {"role": "system", "content": MATH_SYSTEM},
            {"role": "user", "content": question},
        ],
        "solution": str(answer),
    }
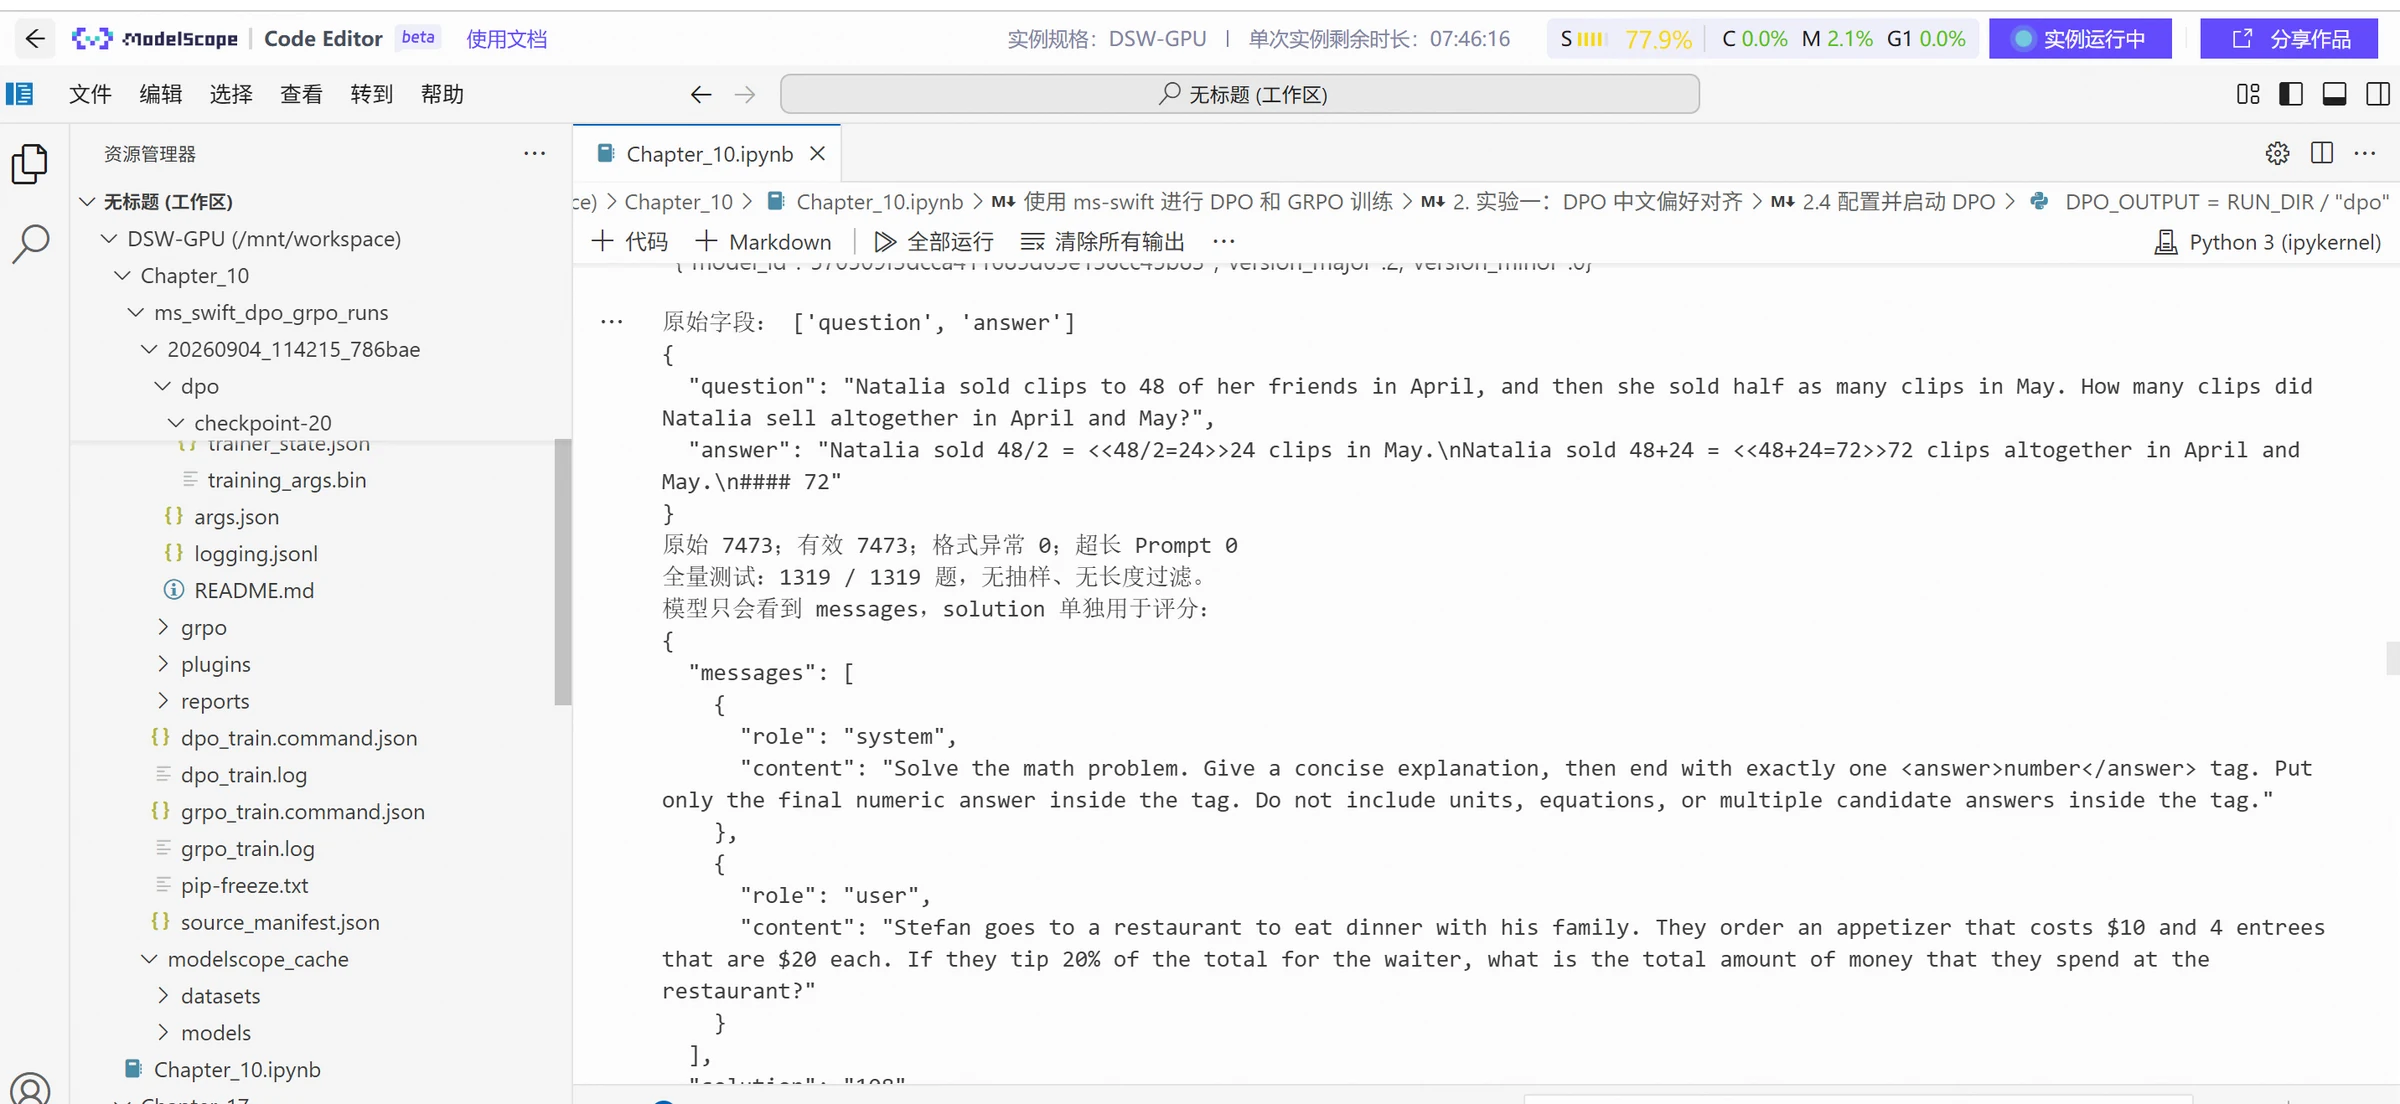
De omgezette messages bevatten geen standaardoplossingsproces en geen assistant-antwoord voor het model om na te bootsen. solution wordt als extra gegevenskolom aan de beloningsfunctie doorgegeven en niet aan de Prompt gehecht. Tijdens de training moet het model dus zelf het antwoord genereren, waarna het beoordelingsprogramma het vergelijkt met het standaardantwoord. Uit de oorspronkelijke trainingsbron werden 128 trainingsvraagstukken en 16 validatievraagstukken opgeschoond, gedupliceerd en verdeeld. De lengtelimiet voor trainings- en validatie-Prompts is 512 tokens. De test gebruikt alle 1319 vraagstukken uit het officiële testbestand, behoudt de originele volgorde, verwijdert geen vraagstukken op basis van de trainingslengtedrempel, en controleert of er overlap is met trainings- en validatiegegevens. De bijbehorende uitvoerresultaten worden getoond in de onderstaande figuur:
2)Definieer de juistheidsbeloning en formaatbeloning.
De totale beloning van dit experiment is:
Totaal = Juistheidsbeloning + 0,1 × Formaatbeloning
De juistheidsbeloning vereist dat de modeloutput voldoet aan het opgegeven labelformaat en dat het getal in het label overeenkomt met solution. Als dit het geval is, is de beloning 1; anders 0. De formaatbeloning controleert alleen of het label uniek is, aan het einde van het antwoord staat en de inhoud als getal kan worden geparsed. Als dit het geval is, is de beloning 1; anders 0. De bijbehorende code is als volgt:
def extract_answer(completion):
    if not isinstance(completion, str):
        return None
    if completion.count("<answer>") != 1 or completion.count("</answer>") != 1:
        return None
    match = re.search(r"<answer>\s*([^<>]+?)\s*</answer>\s*\Z", completion)
    return parse_numeric(match.group(1) if match else None

class Chapter10Accuracy(ORM):
    def __call__(self, completions, solution, **kwargs):
        if len(completions) != len(solution):
            raise ValueError("Aantal kandidaatantwoorden komt niet overeen met solution.")
        rewards = []
        for text, gold in zip(completions, solution):
            expected = parse_numeric(gold)
            if expected is None:
                raise ValueError(f"Ongeldig standaardantwoordformaat: {gold!r}")
            predicted = extract_answer(text)
            rewards.append(float(predicted is not None and predicted == expected))
        return rewards

class Chapter10Format(ORM):
    def __call__(self, completions, **kwargs):
        return [float(extract_answer(text) is not None) for text in completions]
Daarbij is completions een set door het model gegenereerde antwoorden en solution het bijbehorende standaardantwoord dat door de trainer wordt doorgegeven. extract_answer controleert eerst het aantal labels, bevestigt vervolgens dat het label aan het einde van het antwoord staat, en extraheert ten slotte het getal. Deze beloning controleert alleen het eindresultaat en verifieert niet het oplossingsproces. Zelfs als het model geen uitleg geeft, kan het de volledige beloning krijgen als het het juiste antwoordlabel uitvoert. Het "korte uitleg" in het systeembericht is niet in de beoordelingsvoorwaarden opgenomen, dus men mag een hoge score niet interpreteren als dat het model compleet en betrouwbaar redeneren heeft geleerd.
De beloningsklassen moeten ook worden geregistreerd. Het beloningsplugin dat door de trainer van dit experiment wordt gebruikt, is:
orms["chapter10_accuracy"] = Chapter10Accuracy
orms["chapter10_format"] = Chapter10Format
Notebook slaat de volledige plugin op als plugins/chapter10_rewards.py, waarna het bestandspad via external_plugins wordt opgegeven en de bovenstaande registratienamen via reward_funcs. De plugin moet zijn eigen imports en hulpfuncties bevatten, omdat deze onafhankelijk wordt geladen in het trainings subprocess. De registratiemethode kan worden geraadpleegd bij het officiële beloningsplugin-voorbeeld van ms-swift 4.4.2.
3)Controleer de beloningsfunctie voordat u met de training begint.
Hieronder worden de beloningsberekeningen voor enkele resultaten getoond:
Modeluitvoer | Standaardantwoord | Juistheidsbeloning | Formaatbeloning | Totale beloning |
| 12 | 1 | 1 | 1,1 |
| 12 | 1 | 1 | 1,1 |
| 12 | 0 | 1 | 0,1 |
| 12 | 0 | 0 | 0 |
| 12 | 0 | 0 | 0 |
| 12 | 0 | 0 | 0 |
Volgens de beloningsfunctie die in dit experiment wordt gebruikt, voldoet gewone tekst The answer is 12. hoewel het het juiste getal bevat, niet aan het vereiste formaat, dus de strikte juistheidsbeloning is nog steeds 0. Meerdere antwoordlabels zullen ook de controle niet doorstaan, zodat het model geen beloning kan krijgen door antwoorden op te sommen.
Na het voltooien van de voorbereiding van gegevens en beloningsfuncties worden de gerelateerde experimentconfiguratie en taken voltooid.
1)Stel de generatiegroep en trainingsparameters in.
Dit experiment genereert 4 kandidaatantwoorden voor elk vraagstuk; de generatiebatch is ook ingesteld op 4, dus één generatiebatch komt overeen met 4 kandidaten voor 1 vraagstuk. Vervolgens verwerkt elke training minibatch 1 kandidaat, en worden na accumulatie van 4 minibatches de parameters één keer bijgewerkt.
Hieronder volgt de GRPO-experimentconfiguratie van dit experiment. GRPO_PATHS, PLUGIN_PATH en gerelateerde configuratie en inhoud.
GRPO_OUTPUT = RUN_DIR / "grpo"
grpo_options = common_options() | {
    "rlhf_type": "grpo", "loss_type": "grpo",
    "dataset": str(GRPO_PATHS["train"]),
    "val_dataset": str(GRPO_PATHS["val"]),
    "output_dir": str(GRPO_OUTPUT),
    "external_plugins": str(PLUGIN_PATH),
    "reward_funcs": ["chapter10_accuracy", "chapter10_format"],
    "reward_weights": [1.0, 0.1], "remove_unused_columns": False,
    "num_generations": 4, "generation_batch_size": 4,
    "per_device_train_batch_size": 1,
    "gradient_accumulation_steps": 4,
    "per_device_eval_batch_size": 4, "num_generations_eval": 4,
    "max_length": 512, "max_completion_length": 256,
    "truncation_strategy": "left",
    "max_steps": 10, "learning_rate": 1e-5,
    "lr_scheduler_type": "constant", "warmup_ratio": 0.0,
    "beta": 0.04, "num_iterations": 1,
    "temperature": 0.9, "top_p": 0.95,
    "use_vllm": False, "log_completions": True,
    "eval_strategy": "steps", "eval_steps": 5,
    "save_strategy": "steps", "save_steps": 5,
}
train_swift(grpo_options, RUN_DIR / "grpo_train.log")
GRPO_ADAPTER = latest_adapter(GRPO_OUTPUT)
De groepsgrootte en de generatiebatch moeten op elkaar worden afgestemd. De generatiebatch moet deelbaar zijn door de groepsgrootte en ook deelbaar zijn door het product van de training minibatch per kaart en het aantal GPU-processen. Dit experiment heeft één kaart en één proces; generatiebatch 4, groepsgrootte 4 en training minibatch 1 voldoen aan deze voorwaarden; bij validatie zijn zowel de batch als de groepsgrootte ook 4. Als u de groepsgrootte aanpast, moet u tegelijkertijd de generatiebatch, de trainingsgradiëntaccumulatie en de validatieconfiguratie controleren. De training van dit experiment voltooide 10 stappen en sloeg grpo/checkpoint-10 op.
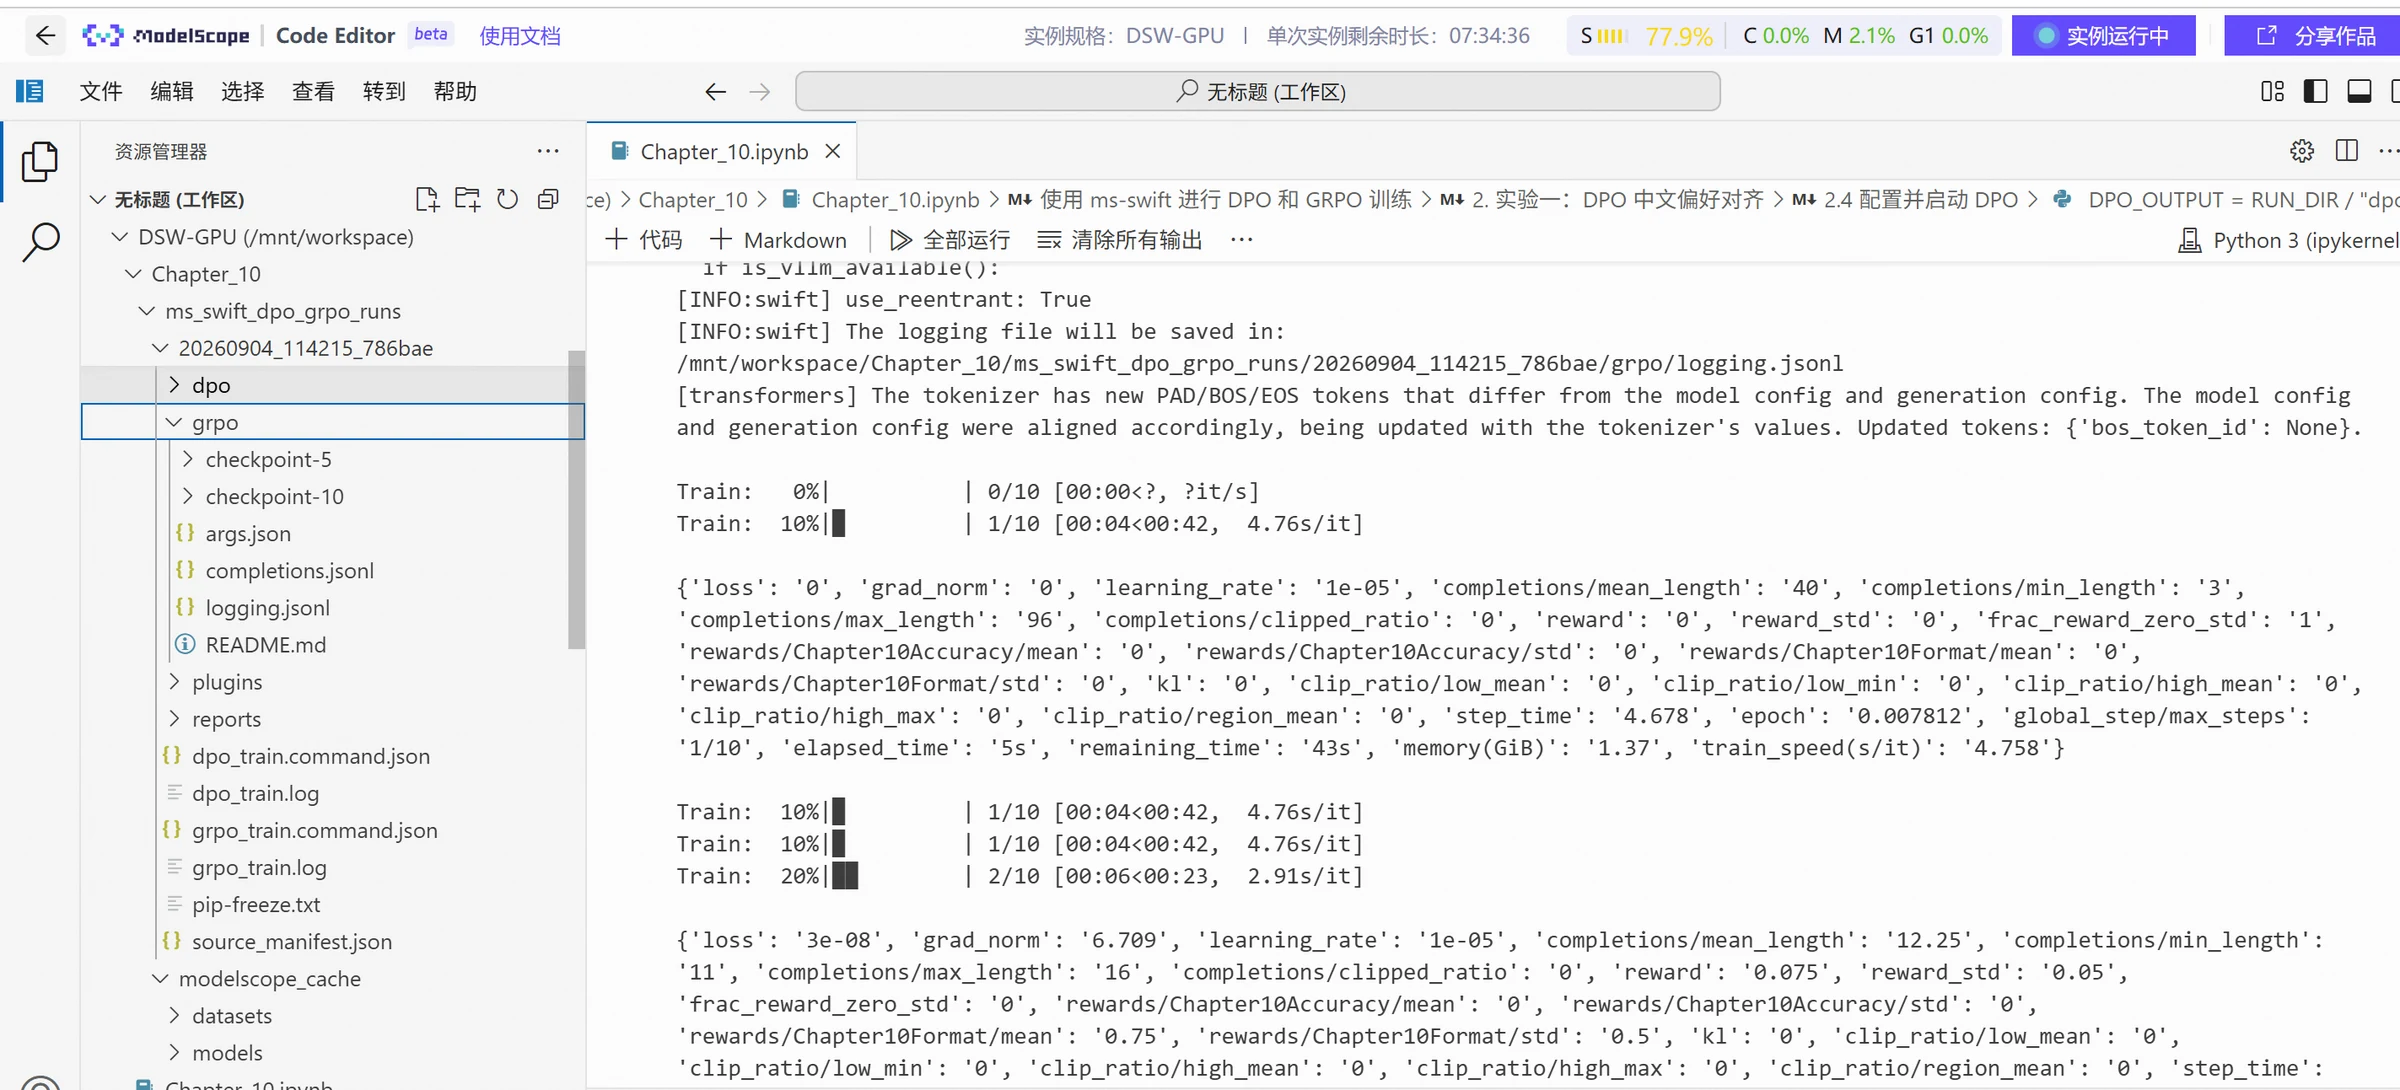
2)Lees het trainingslogboek.
Het GRPO-trainingsverlies is niet gelijk aan de nauwkeurigheid bij wiskundige vraagstukken. Bij het observeren van de training moet men de totale beloning, de afzonderlijke beloningscomponenten en de variatie binnen de groep samen bekijken. De reward in de logs geeft de huidige samengevoegde beloning aan, reward_std wordt gebruikt om de variatie in beloningen binnen een groep te observeren, en frac_reward_zero_std geeft het aandeel groepen aan waarvan de standaardafwijking van de beloning nul is. De bijbehorende visualisatie van trainingsstatistieken wordt getoond in de onderstaande figuur:
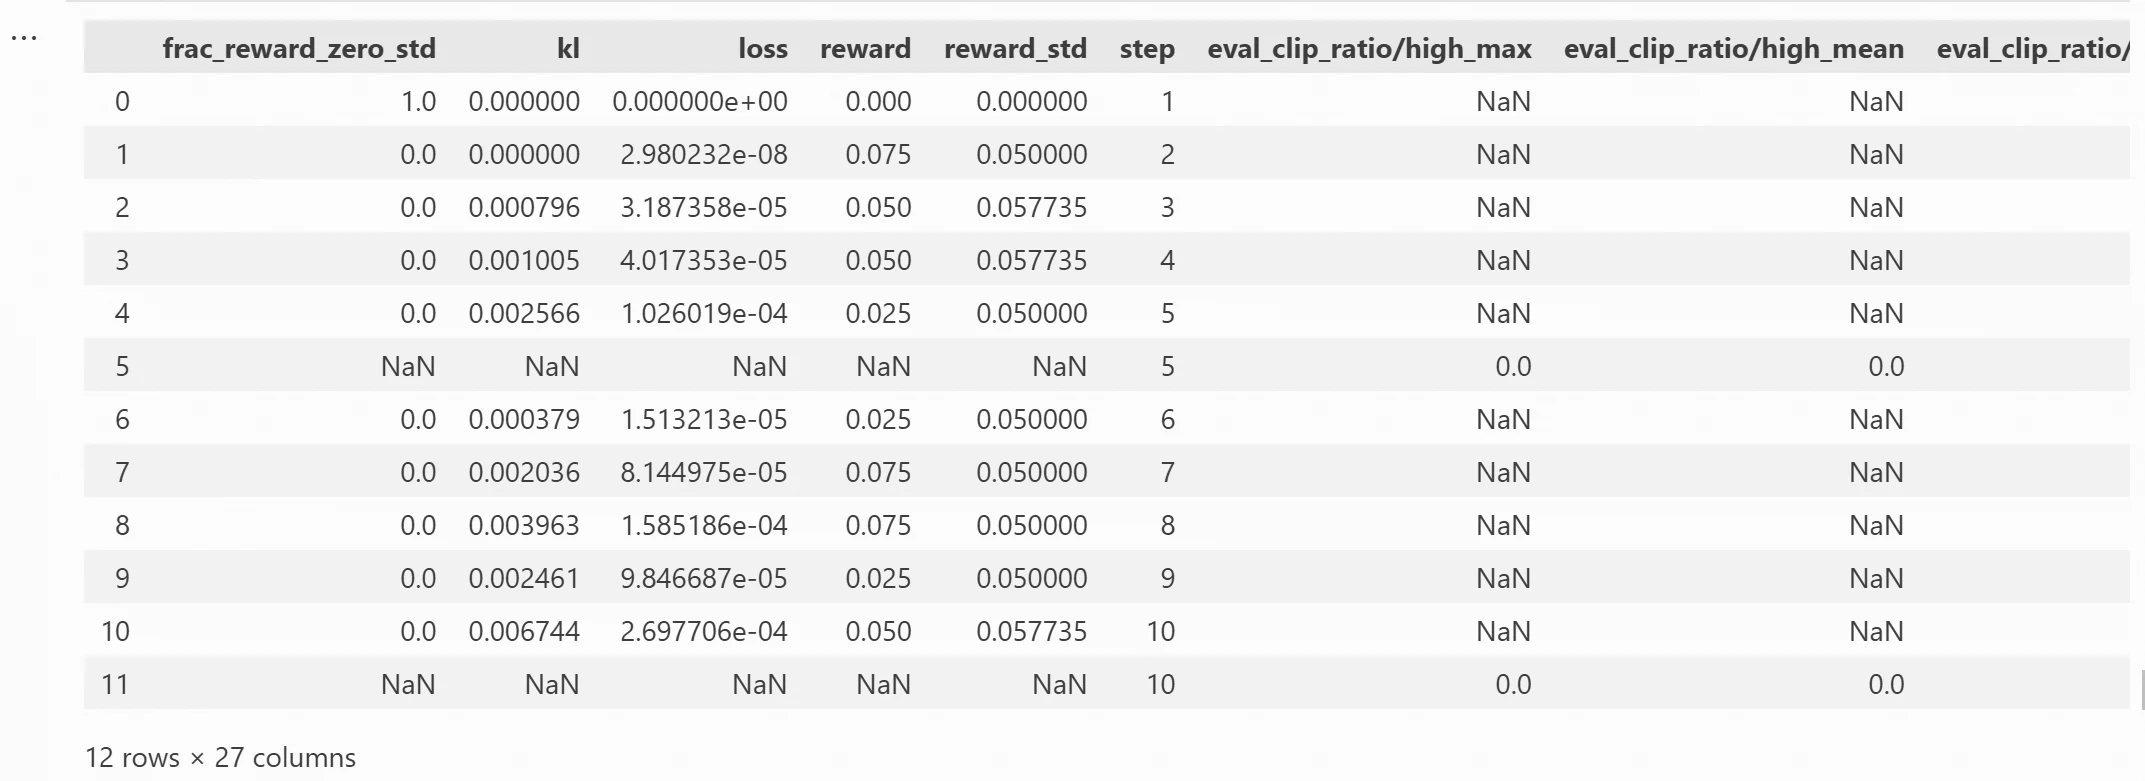
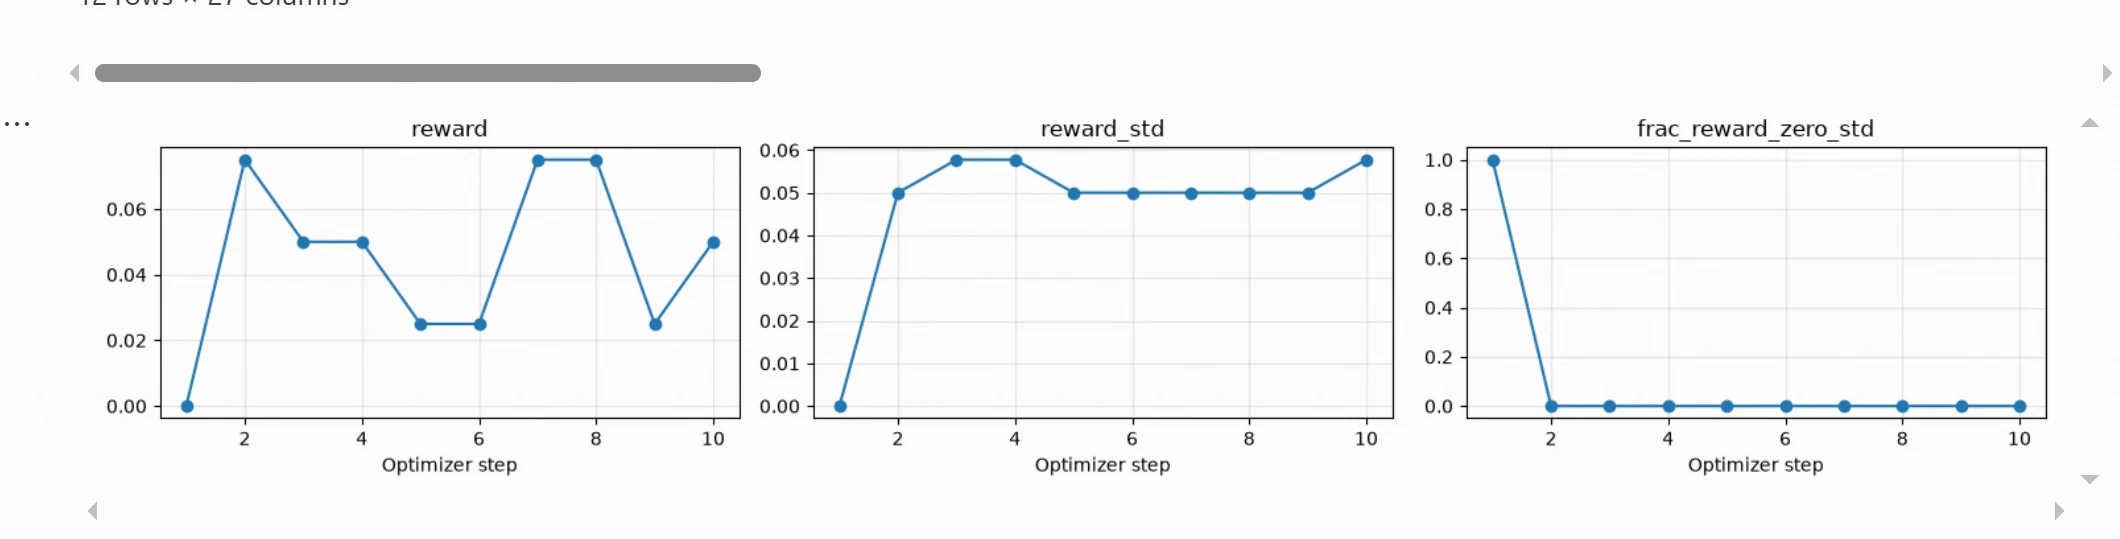
Uit de figuur blijkt dat de training vanaf stap 2 niet-nul variatie in beloningen binnen de groep vertoont en het aandeel met dezelfde score daalt tot 0, wat aangeeft dat de beloningsfunctie onderscheid kan maken tussen verschillende kandidaatantwoorden en effectieve optimalisatiesignalen kan bieden voor GRPO. Dit experiment heeft slechts 10 trainingsstappen uitgevoerd; de juistheidsbeloning is vrij zeldzaam en de nauwkeurigheid bij wiskundige antwoorden is nog niet verbeterd; in de vervolgexperimenten kan het aantal trainingsrondes worden verhoogd zodat het model meer vraagstukken en kandidaatantwoorden leert kennen, en kan de trainingsobservatie in combinatie met de validatieset waarschijnlijk duidelijker zijn.
Het trainingslogboek weerspiegelt de kandidaten die tijdens het trainingsproces zijn gesampled; uiteindelijk moeten de modelprestaties nog worden vergeleken met een onafhankelijke testset. Voor elk vraagstuk wordt slechts één antwoord gegenereerd, wat geen evaluatie is waarbij meerdere willekeurige steekproeven worden genomen en het beste antwoord wordt gekozen.
De initiële resultaten werden opgeslagen door grpo_evaluate() vóór de training. Na de training wordt de GRPO-adapter doorgegeven en worden de resultaten voor dezelfde vraagstukken samengevat. Hieronder worden de evaluatie- en samenvattingscode weergegeven; de Notebook controleert ook of steekproefnummers, vraagstukken en standaardantwoorden één-op-één overeenkomen.
grpo_after = grpo_evaluate(GRPO_ADAPTER)
grpo_summary = pd.DataFrame([
    {
        "Model": name,
        "Strikte antwoordnauwkeurigheid": np.mean([r["correct"] for r in rows]),
        "Aantal juiste antwoorden": int(sum(r["correct"] for r in rows)),
        "Formaat geldig aandeel": np.mean([r["format_ok"] for r in rows]),
        "Aantal vragen met geldig formaat": int(sum(r["format_ok"] for r in rows)),
        "Gemiddelde totale beloning": np.mean([r["total_reward"] for r in rows]),
        "Aantal testvragen": len(rows),
    }
    for name, rows in [
        ("Initieel Instruct", grpo_before), ("GRPO LoRA", grpo_after)
    ]
])
display(grpo_summary)
De volledige evaluatieresultaten van dit experiment zijn als volgt:
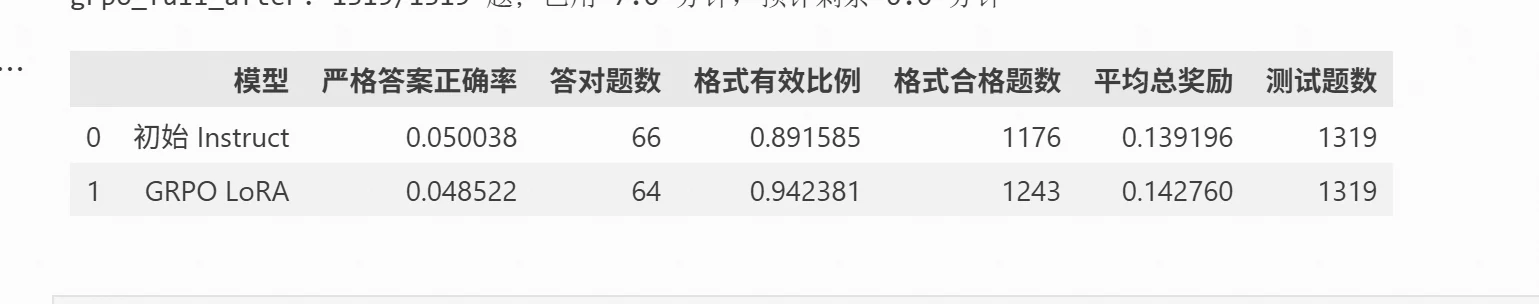
In combinatie met de bovenstaande volledige evaluatieresultaten is het aandeel geldige formats van het model gestegen van 89,16% naar 94,24%, wat de rol van deze training bij het standaardiseren van de outputstructuur aantoont. In vervolgexperimenten en trainingen kunnen de moeilijkheidsgraad van de vraagstukken of het beloningsontwerp verder worden aangepast zodat de vervolgresultaten een vollediger feedback over antwoordnauwkeurigheid kunnen krijgen.
De experimentgegevens en code van dit hoofdstuk zijn beschikbaar op: https://modelscope.cn/gallery/liucong/8a5fefc5-6f90-42df-9a09-bc9781ed3da8