Entendendo modelos open-source • Iniciante⏱️ 15 min de leitura
What Open-Source Models Are Changing
O que os modelos open source estão mudando?
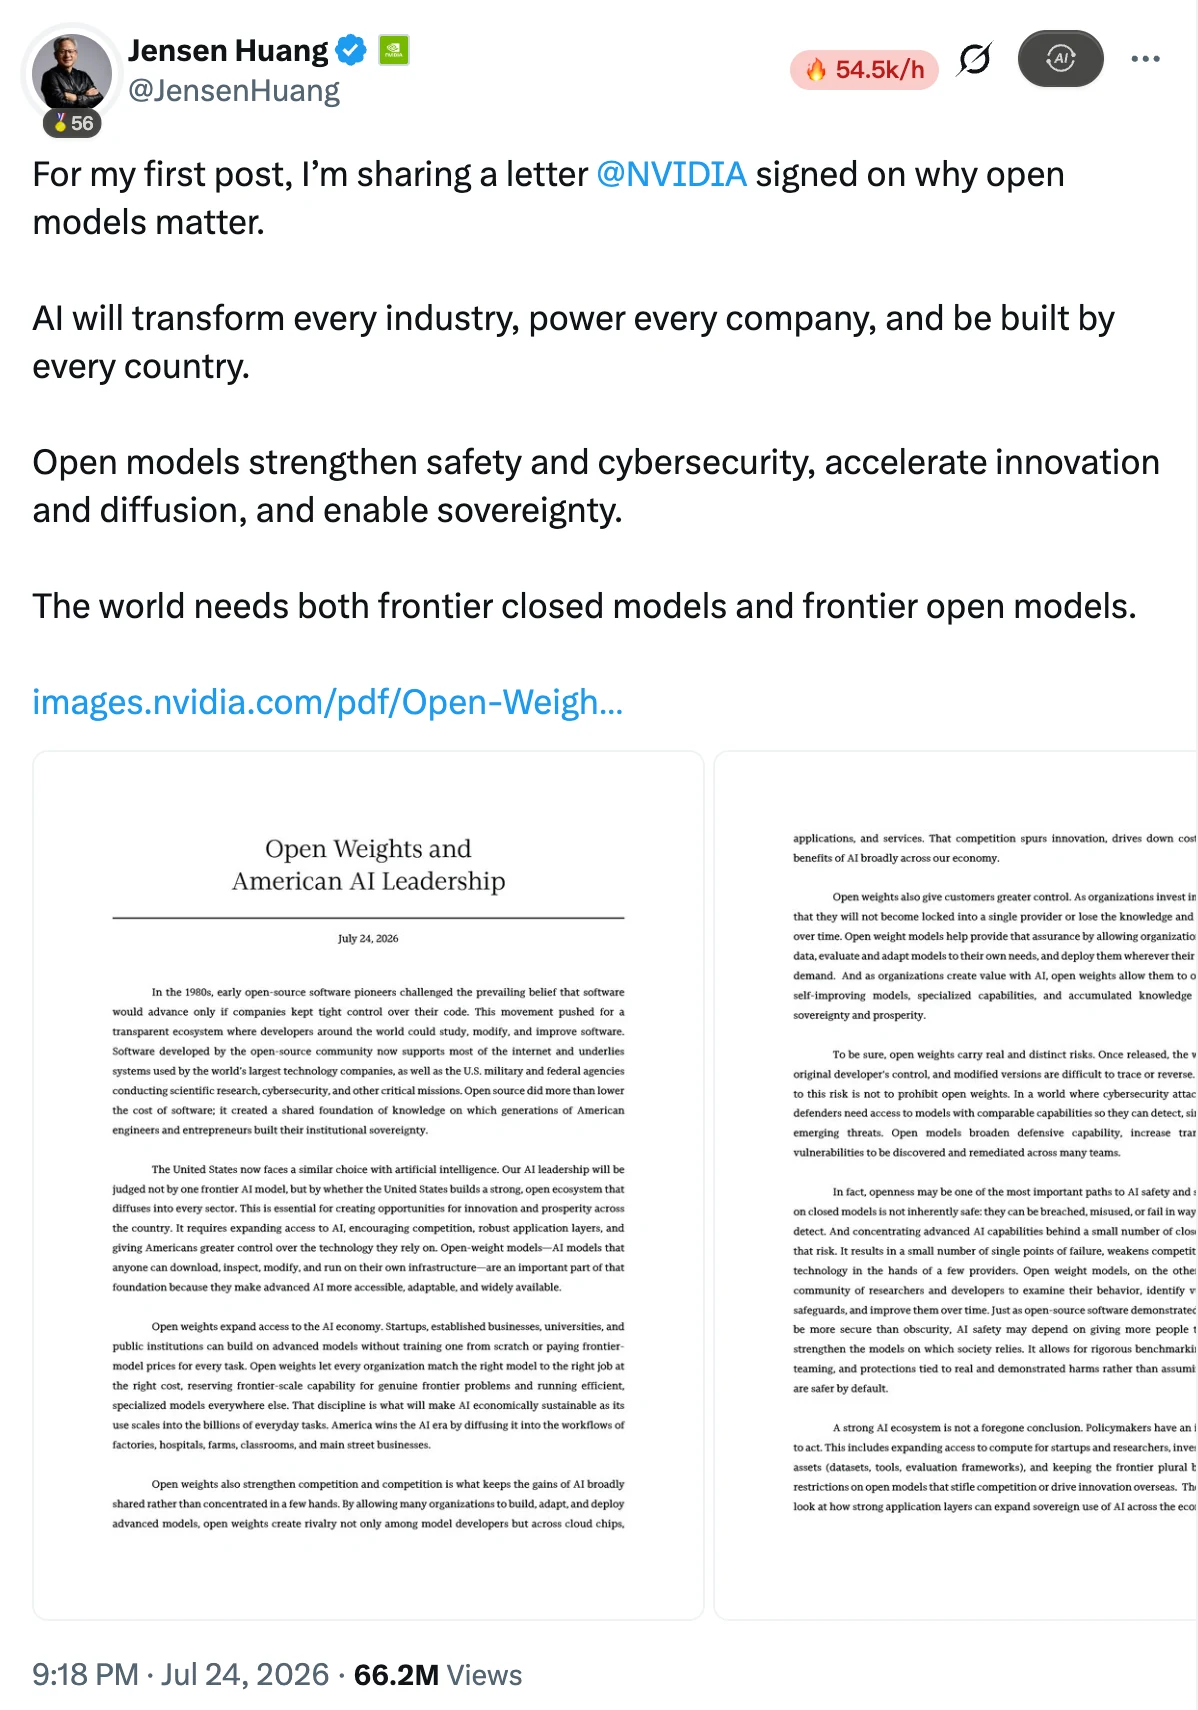
Você não imaginaria que o CEO da Nvidia, Jensen Huang, fez sua primeira postagem no X, e foi dedicada ao open source.
Em 24 de julho de 2026, ele compartilhou uma carta aberta assinada pela Nvidia, discutindo por que modelos abertos são importantes:
Este mundo precisa tanto de modelos proprietários de ponta quanto de modelos abertos de ponta.
Muitas pessoas podem ter se acostumado a abrir uma janela de chat, enviar uma pergunta e esperar que a IA responda. Mas quando você começa a usar IA para processar dados da empresa a longo prazo ou integrar sistemas internos, pode encontrar os seguintes problemas: Os dados estão seguros quando enviados? E se o serviço repentinamente limitar a taxa? O modelo pode aprender como sua empresa processa os dados?
Os modelos open source oferecem outra solução para esses problemas. Você pode baixar o modelo dentro do escopo permitido pela licença, implantá-lo em seu próprio ambiente, continuá-lo refinando e deixar os usuários decidirem como usá-lo.
É claro que o debate entre open source e proprietário para modelos grandes sempre foi um tema de discussão interminável. A carta de Jensen Huang ressoou novamente conosco, e decidimos nos associar a vários co-criadores para iniciar esta jornada prática de aplicações de modelos open source em um livro roxo. Desta vez, trazemos para você conteúdo prático sobre aplicações de modelos open source. Que os modelos open source prosperem!
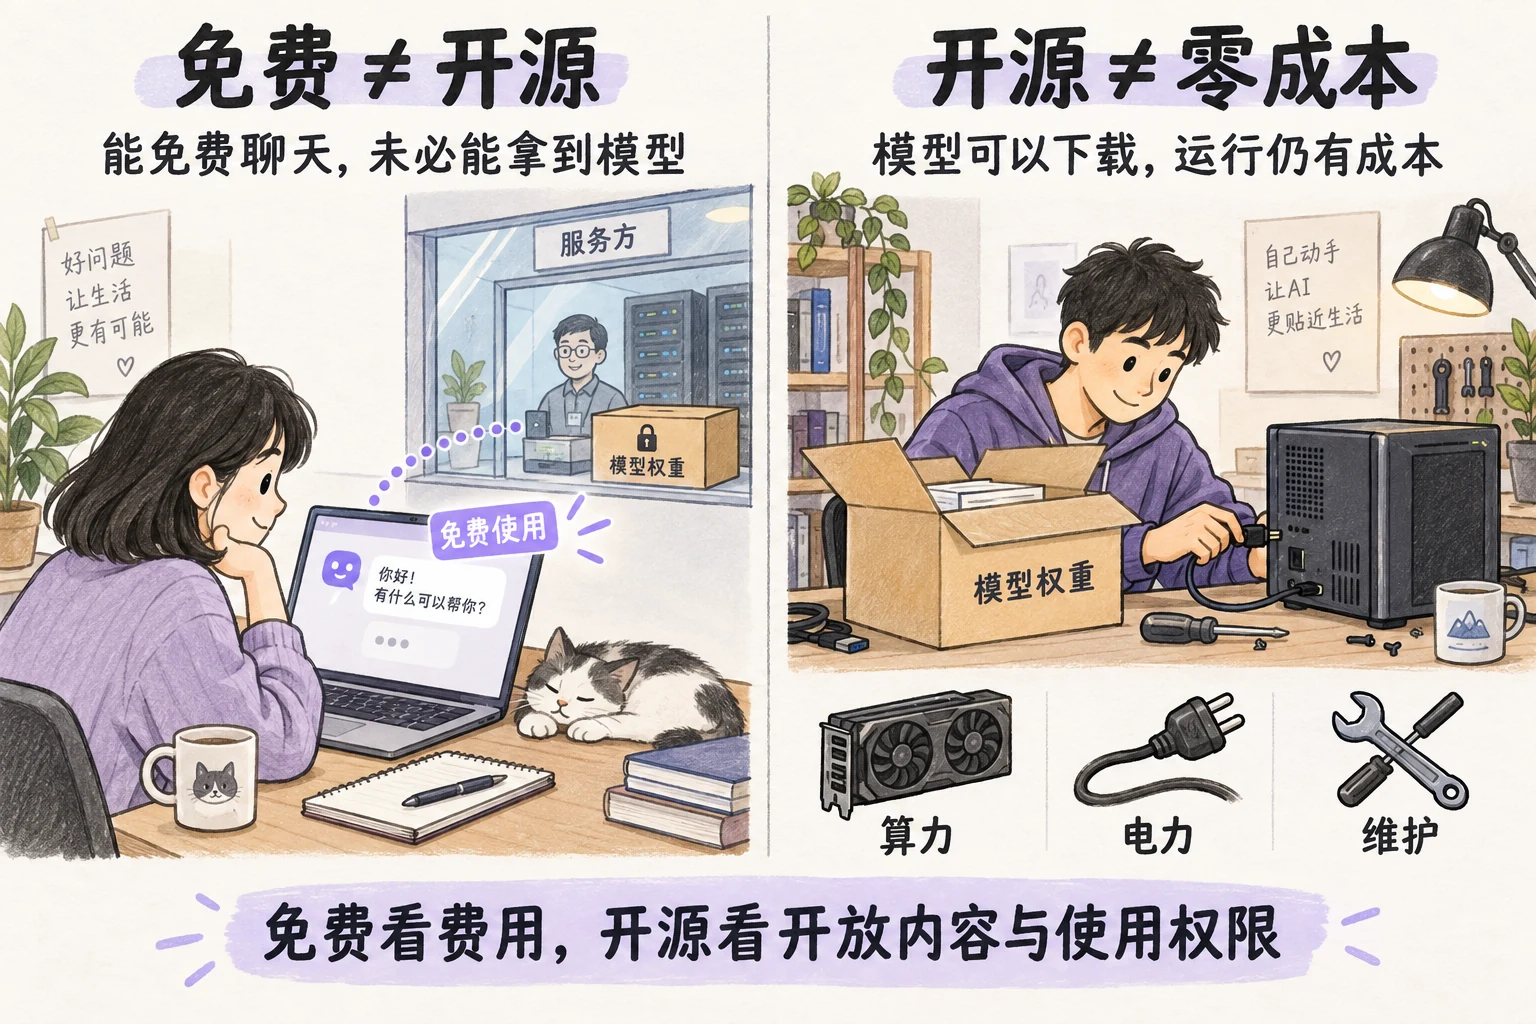
Lembre-se, gratuito não significa necessariamente open source, e open source não significa necessariamente gratuito
Quando você conversa com IA em um site ou consulta um modelo por meio de uma API, o modelo geralmente é executado pelo provedor do modelo. Você envia a entrada, e o provedor retorna os resultados. Você geralmente não precisa se preocupar com como o servidor é configurado ou como o modelo é mantido.
Os modelos open source oferecem outra opção, permitindo que você obtenha os parâmetros do modelo após o treinamento, comumente conhecidos como pesos. Com software e hardware apropriados, esses parâmetros podem ser executados em seu computador, servidor ou nuvem privada. Perguntas que antes precisavam ser enviadas a serviços externos agora podem ser processadas em seu próprio ambiente.
Existem duas coisas aqui que são facilmente confundidas.
«Gratuito» refere-se a se você precisa pagar ou não; «open source» refere-se ao que você pode obter e como está autorizado a usá-lo. Um produto de chat pode ser gratuito sem fornecer os pesos do modelo. Um modelo que é gratuito para baixar ainda requer poder de computação e custos de manutenção para funcionar.
Uma API é simplesmente uma forma de acessar modelos. Os modelos open source podem ser hospedados por provedores de serviço e entregues a você por meio de APIs. Os modelos que você implanta também podem ser disponibilizados para colegas por meio de APIs internas. Portanto, «open source vs. proprietário» e «chamar APIs vs. auto-implantação» devem ser considerados separadamente.
Nas discussões diárias, as pessoas frequentemente se referem coletivamente a modelos cujos pesos podem ser baixados como modelos open source. Também seguiremos essa convenção comum nos capítulos seguintes.
No entanto, ao fazer distinções estritas, esclareceremos que pesos abertos não equivalem a open source para todo o processo de treinamento do modelo. Dados de treinamento, código de treinamento e permissões de uso ainda precisam ser examinados separadamente.
Todos chamados de open source, mas o que é aberto varia~
Após obter um modelo, você provavelmente tem curiosidade sobre como ele foi treinado.
É aqui que as diferenças entre os diferentes modelos se tornam evidentes. Alguns permitem que você os baixe e execute sem divulgar os materiais completos de treinamento. Outros vão além fornecendo código de treinamento e descrições de dados, permitindo que desenvolvedores externos estudem a trajetória de treinamento do modelo.
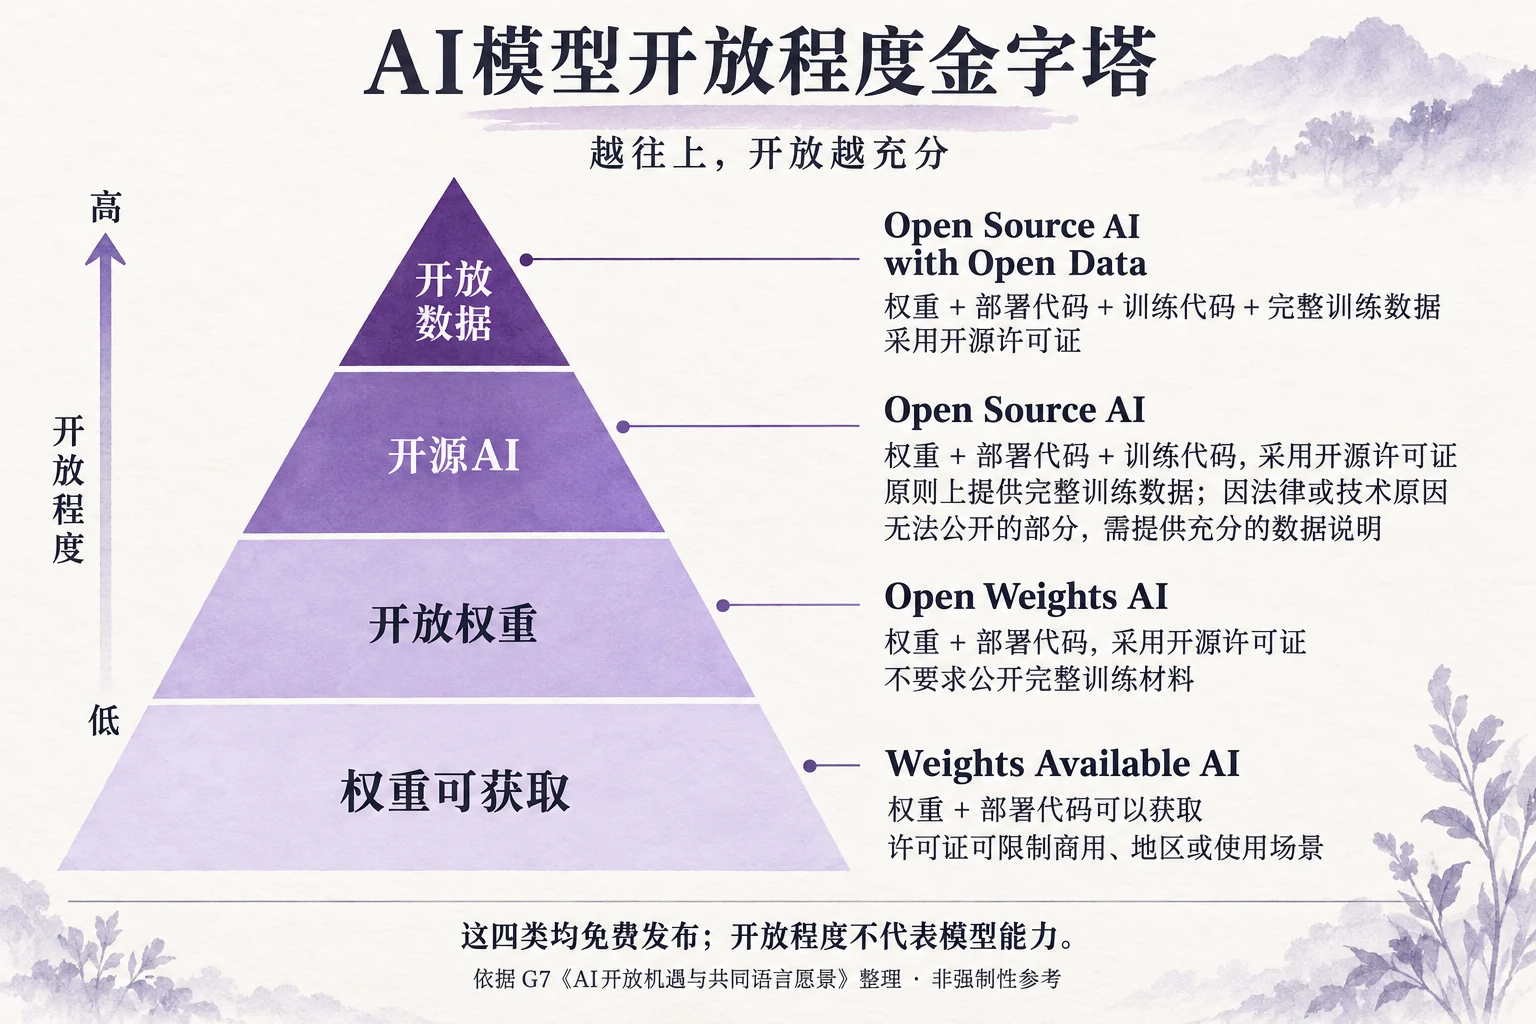
Em maio de 2026, o G7 publicou um documento de referência comum sobre abertura de IA, categorizando essas diferenzes em quatro tipos, do maior ao menor grau de abertura:
Até mesmo dados completos de treinamento são públicos. Pesos do modelo, código de implantação, código de treinamento e dados completos de treinamento são todos fornecidos sob licenças open source, correspondendo a Open Source AI with Open Data.
Pesos e código são públicos, com dados restritos explicados em detalhe. Correspondendo a Open Source AI. Dados completos de treinamento devem em princípio ser fornecidos; partes que não podem ser compartilhadas por razões legais ou técnicas precisam ser adequadamente substituídas por documentação de dados.
Um modelo treinado é entregue a você para execução e modificação. Correspondendo a Open Weights AI, fornecendo pesos e código de implantação sob licenças open source, mas não necessariamente divulgando materiais completos de treinamento.
Baixável, mas com condições adicionais ao usar. Correspondendo a Weights Available AI, onde pesos e código de implantação podem ser obtidos, mas licenças podem restringir uso comercial, regiões de uso ou cenários específicos.
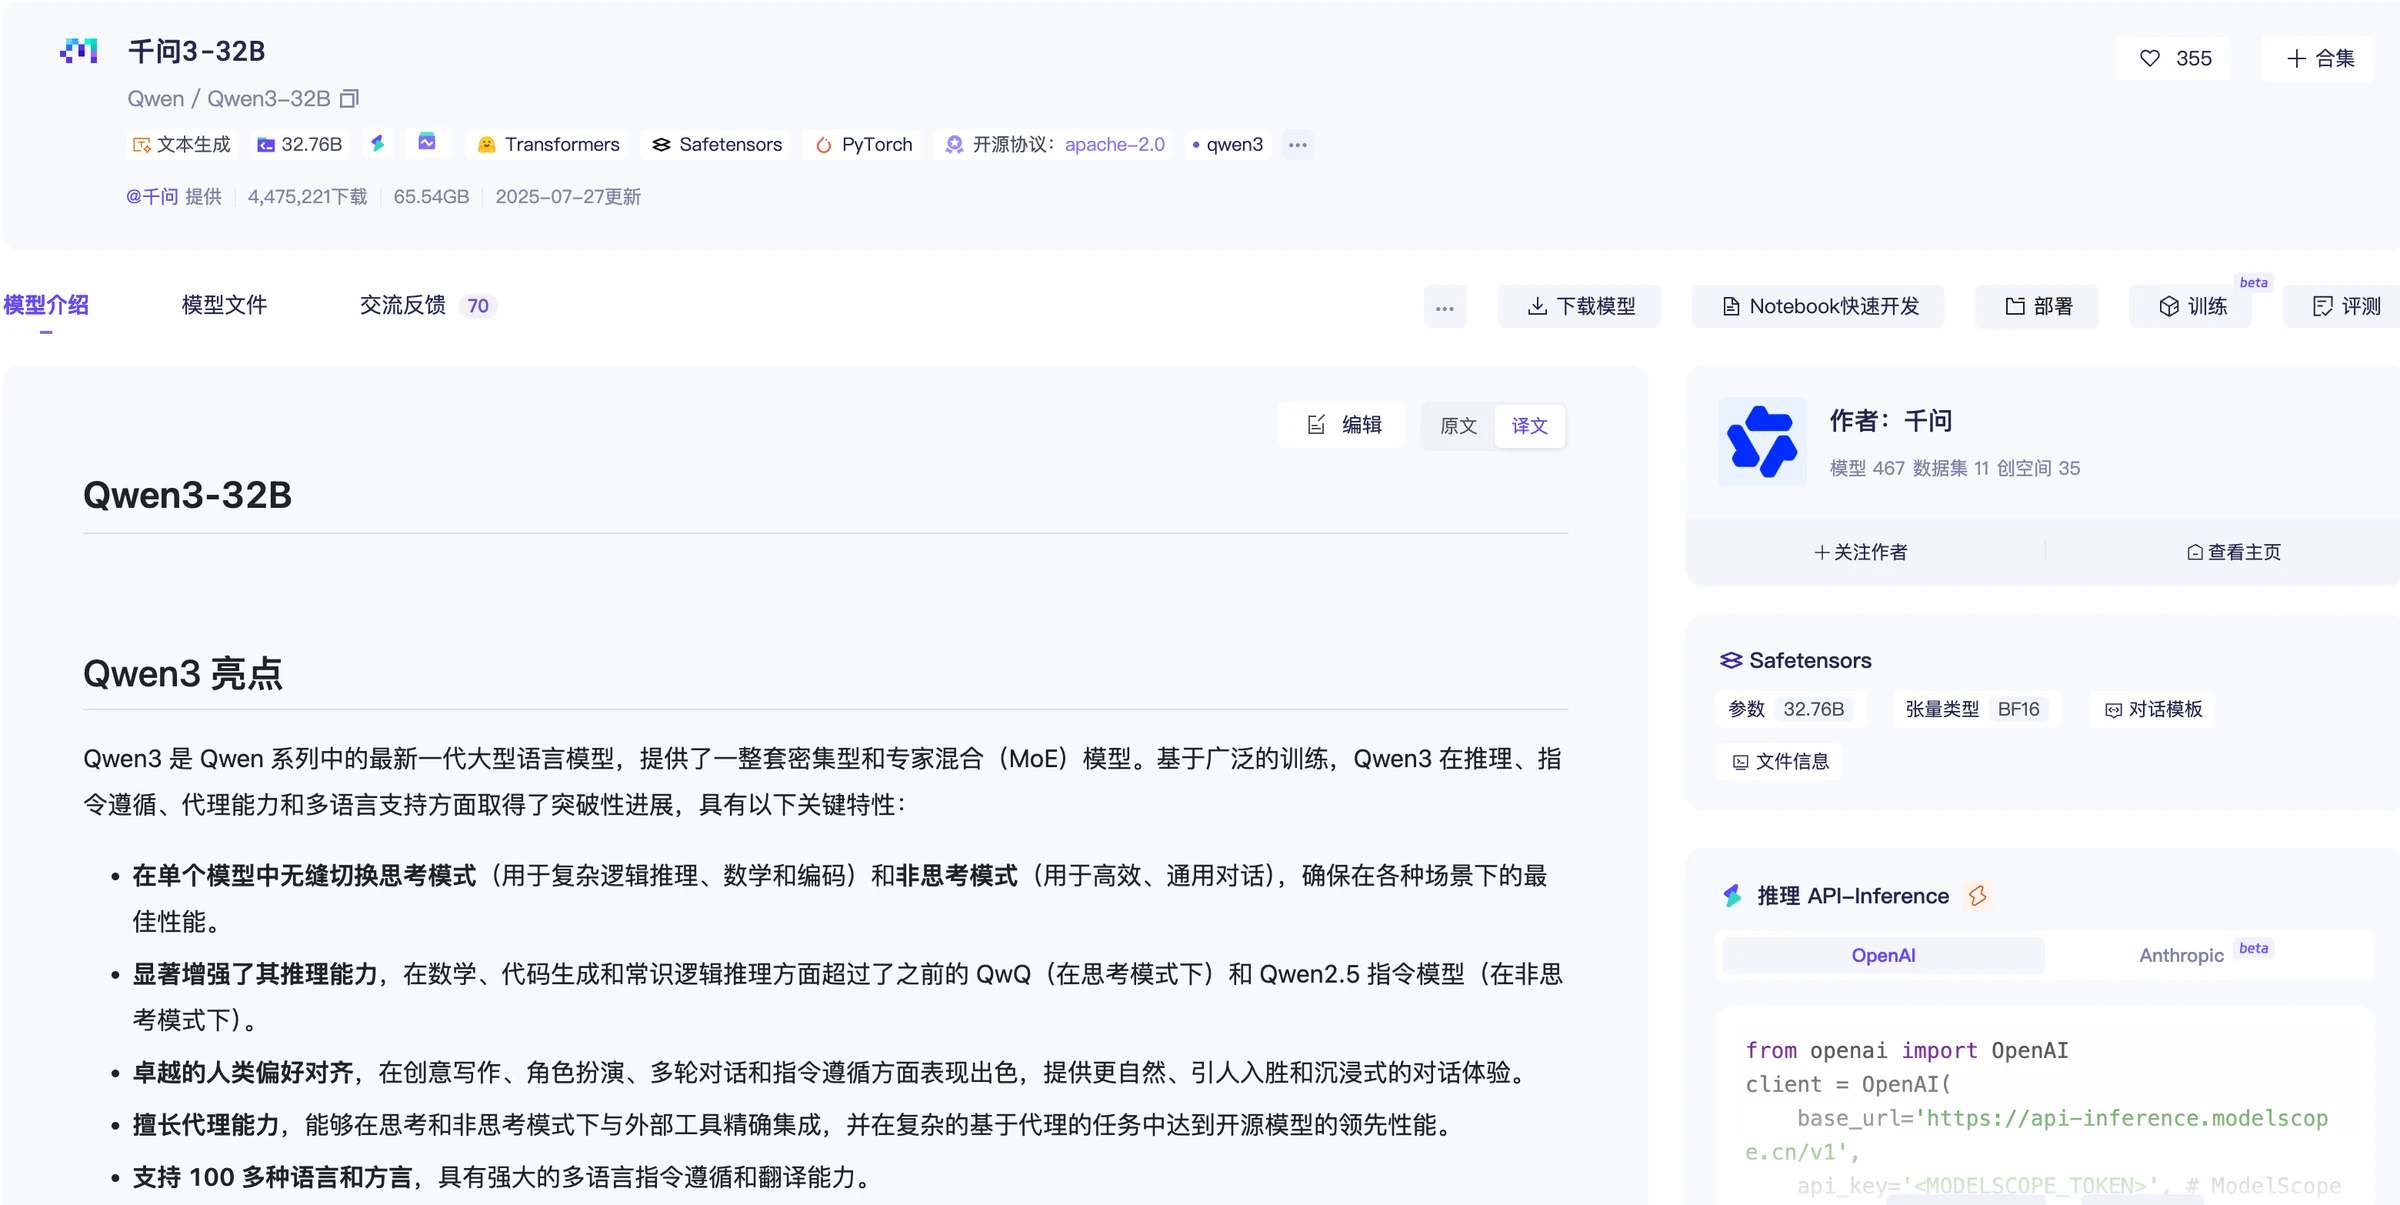
Usando Qwen3 como exemplo, a equipe oficial fornece modelos open weights junto com instruções para execução local, implantação, quantificação e refinamento. Desenvolvedores podem usar ferramentas como Transformers, vLLM, SGLang para executar modelos, e também podem usar ferramentas de refinamento para continuar o treinamento. Com base nas distinções acima, isso demonstra o valor prático do nível open weights.
A maioria das empresas não precisa refazer o pré-treinamento de modelos grandes — poder executar modelos existentes, adaptá-los aos seus próprios dispositivos e refiná-los com amostras de negócios já pode resolver muitos problemas de negócios específicos.
Os modelos open source realmente podem rivalizar com os modelos proprietários?
Poder implantar modelos você mesmo é ótimo, mas se o modelo frequentemente comete erros em cenários de negócios, é difícil confiar trabalho real a ele.
No passado, os modelos open source deram a muitas pessoas a impressão de que eram convenientes para pesquisa mas inferiores aos modelos proprietários mais fortes. Com a atualização contínua das capacidades dos modelos, essa avaliação precisa ser reconsiderada.
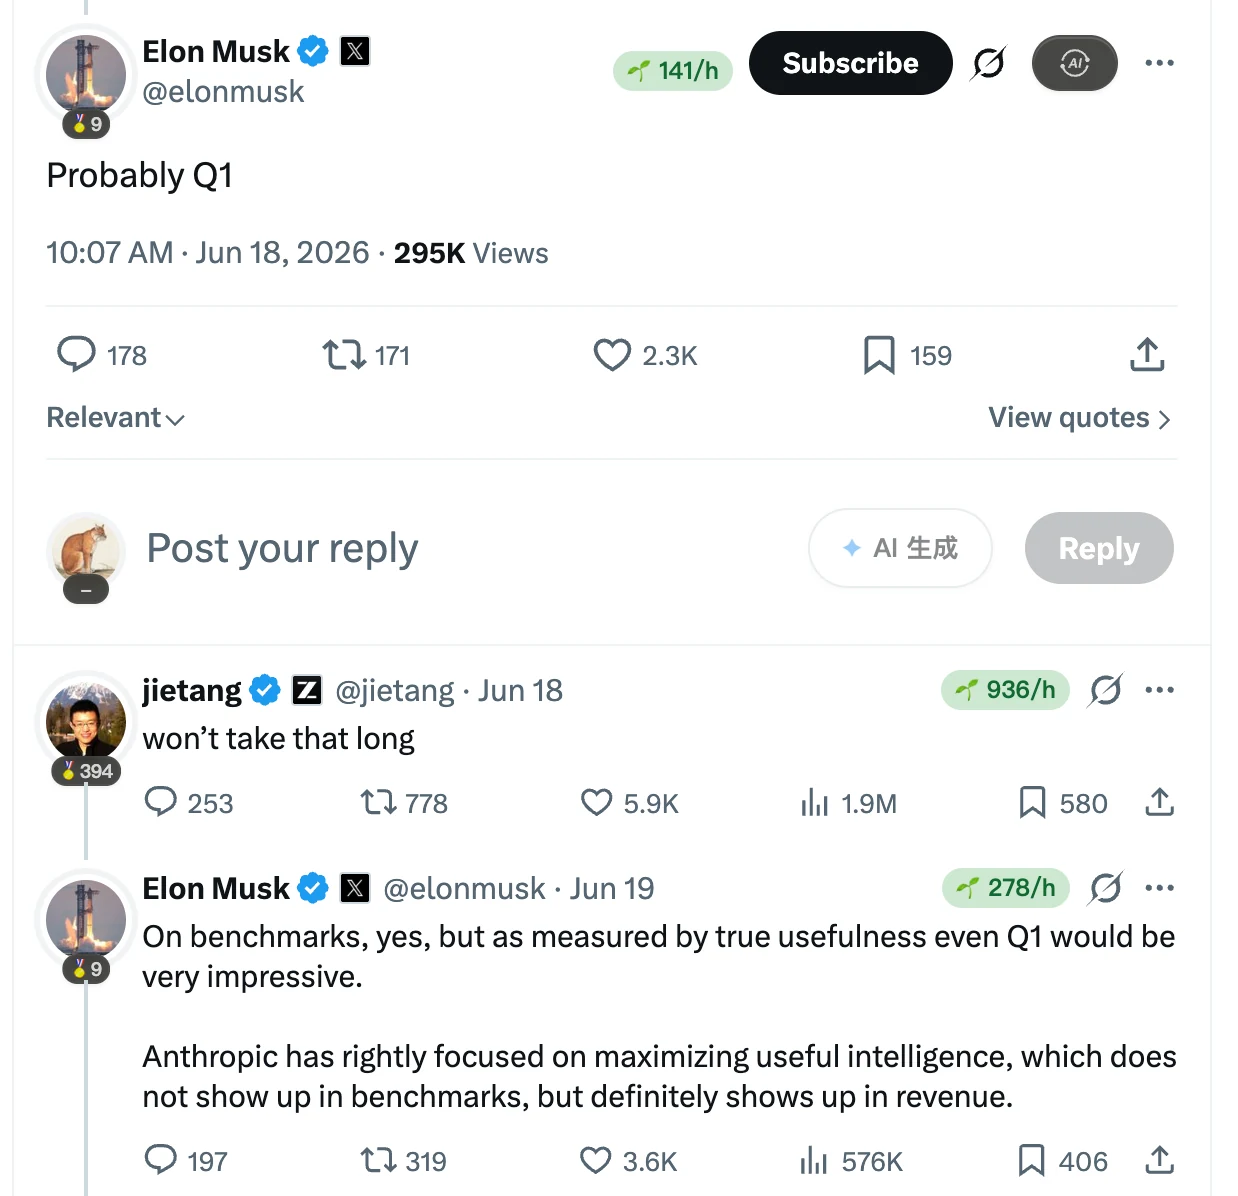
Em 18 de junho de 2026, houve uma interação bastante interessante no X. Usuários discutiam quando modelos chineses poderiam alcançar o nível dos modelos frontier da Anthropic, e Elon Musk previu que poderia levar até o primeiro trimestre de 2027. O co-fundador da Zhipu, Tang Jie, respondeu abaixo com «won't take that long».
Se as previsões dos dois se concretizarão ou não depende do desempenho futuro dos modelos. O aspecto fascinante dessa discussão é que os modelos open source já estão na vanguarda de toda a paisagem de modelos grandes.
Um incidente de segurança divulgado pela Hugging Face em julho de 2026 novamente demonstrou a importância dos modelos open source.
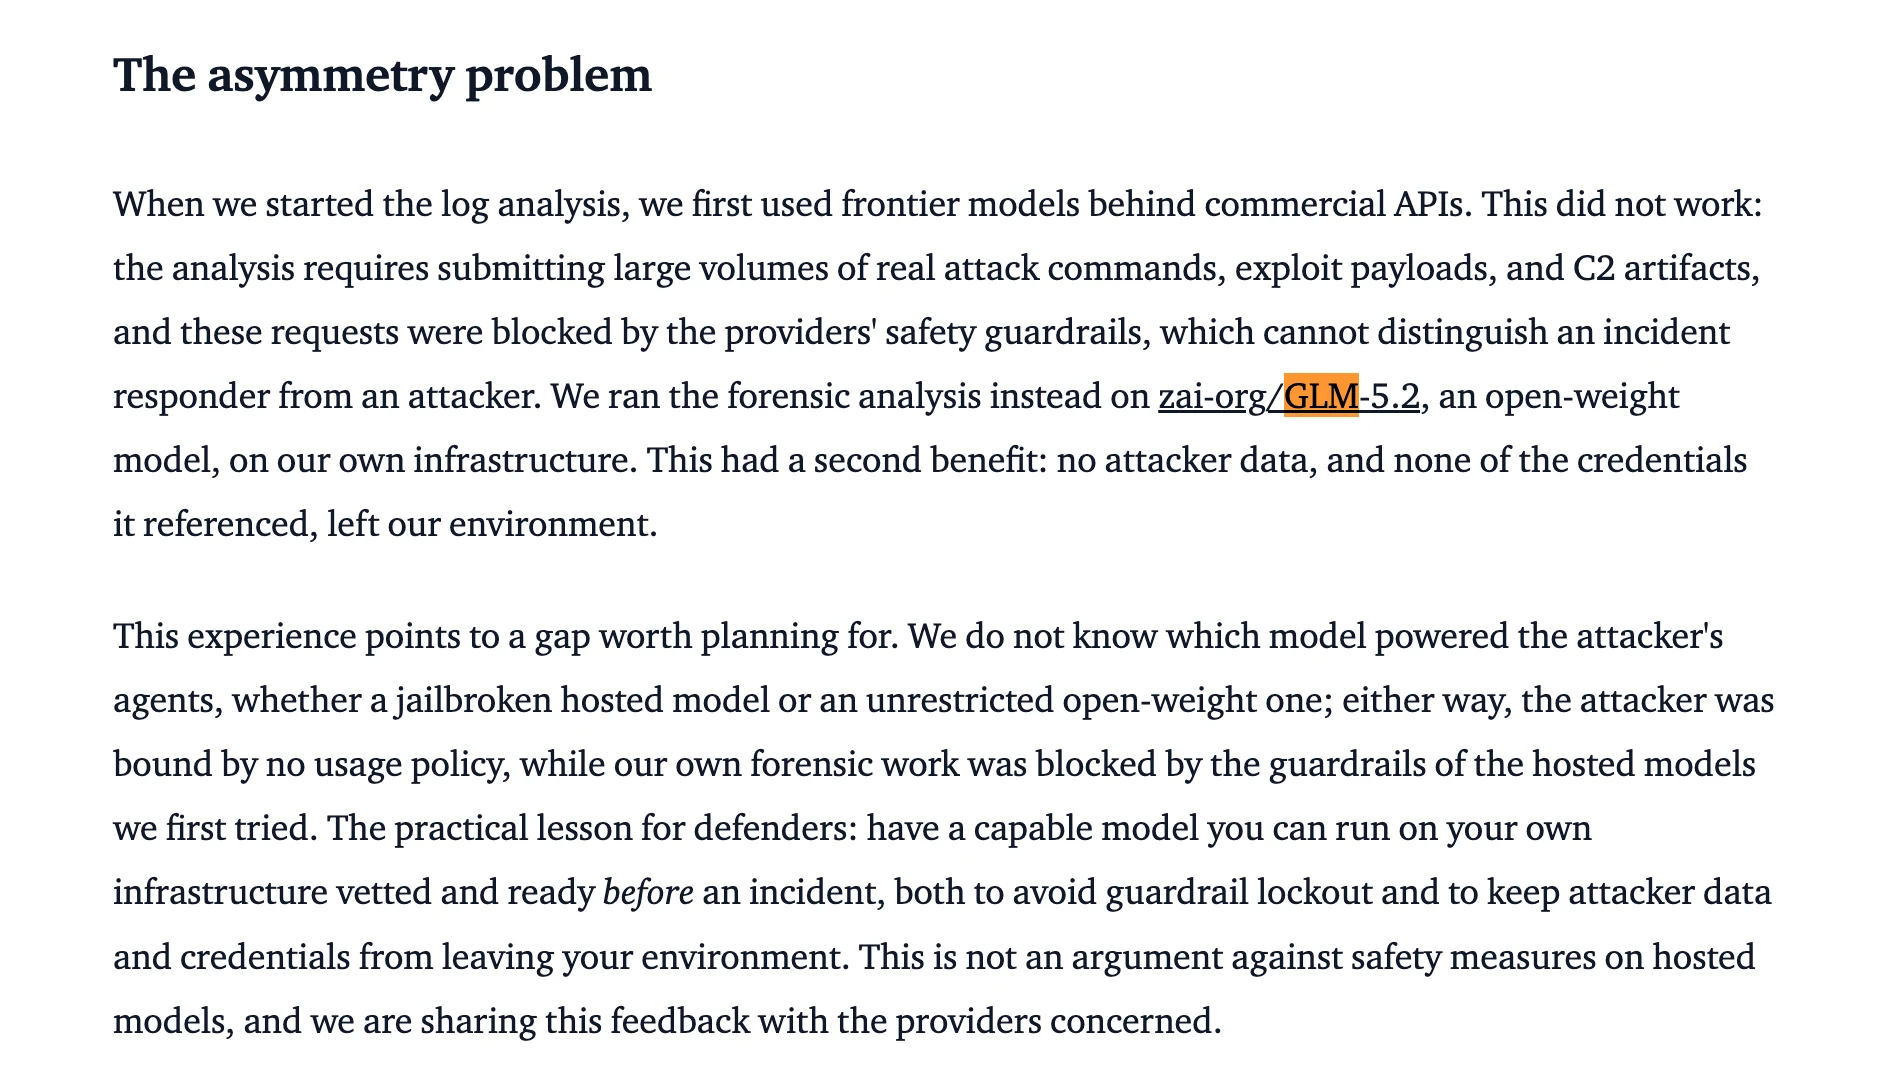
Parte da infraestrutura de produção da Hugging Face foi comprometida, e a equipe de segurança precisou analisar um grande número de registros de ataque para entender o que os atacantes tinham feito, quais credenciais tinham tocado e onde o impacto chegou. A equipe HF primeiro tentou usar modelos frontier por meio de APIs comerciais, mas encontrou um problema embaraçoso. Os comandos reais de ataque e conteúdo de exploração usados para a investigação acionaram as restrições de segurança do provedor de serviço, e as solicitações de análise foram bloqueadas.
Em seguida, a equipe usou o modelo open weights GLM-5.2 em sua própria infraestrutura para conduzir análise forense, permitindo que a investigação continuasse. Os dados de ataque e credenciais relacionados também permaneceram no ambiente interno.
Na revisão técnica subsequente, a Hugging Face explicou adicionalmente que a equipe reconstruiu aproximadamente 17.600 ações de ataque e usou modelos open weights incluindo GLM-5.2 para interpretar payloads de ataque ofuscados e criptografados.
Este incidente demonstrou a importância dos modelos open source.
O uso de modelos open source não está sujeito a restrições proprietárias. Podemos manter dados locais, usá-los offline e tornar a execução de tarefas mais controlável.
Quais cenários são mais adequados para implantação local de modelos open source?
Domínios verticais também são uma direção de aplicação importante para modelos open source. Modelos grandes gerais aprendem a partir de grandes quantidades de dados públicos, mas sua compreensão de nomes de dispositivos internos da empresa, processos de negócios, terminologia da indústria e conhecimentos especializados pode ainda ser limitada. Através de refinamento com dados de domínio vertical, o modelo pode aprender mais esses conhecimentos especializados.
Para tarefas que precisam processar dados sensíveis, a implantação local também tem vantagens. Os modelos podem realizar inferência dentro da rede interna da empresa e se conectar com bases de conhecimento, bancos de dados e sistemas de negócios existentes, reduzindo assim a necessidade de enviar dados sensíveis a serviços externos.
No entanto, nem todas as tarefas requerem modelos open source implantados localmente.
Para tarefas com menos invocações de modelo, necessidades de negócios que mudam rapidamente ou que requerem uso contínuo das últimas capacidades do modelo geral, chamar APIs diretamente geralmente é mais conveniente. Para algumas tarefas de negócios de longo prazo, estáveis e executadas repetidamente, os modelos open source têm maior potencial de aplicação.
Por exemplo, tarefas como classificação de texto, reconhecimento de intenção, extração de informações, resumo de documentos e Q&A de bases de conhecimento geralmente têm formatos de entrada e saída relativamente claros. As empresas podem escolher modelos de tamanho apropriado com base na complexidade da tarefa e usar seus próprios dados de negócios para treinamento ou refinamento. Para essas tarefas, não é necessariamente necessário usar os modelos com maior número de parâmetros.
Lembre-se, poder baixar um modelo não significa que você pode usá-lo como quiser
O modelo funciona e tem bom desempenho, mas se você quiser usá-lo em produtos comerciais ou compartilhar sua versão refinada, ainda precisa verificar a LICENÇA.
Ser baixável, utilizável comercialmente e modificável para redistribuição são permissões diferentes.
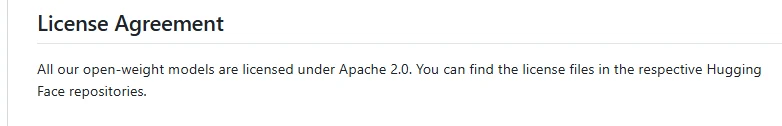
Geralmente falando, MIT e Apache License 2.0 são licenças open source relativamente permissivas que permitem uso comercial e modificação, e não exigem que todo código derivado seja público. Software usando a licença MIT só precisa reter avisos de copyright e licença; Apache 2.0 especifica requisitos de documentação de modificações, retenção de avisos relacionados e tratamento de NOTICE durante redistribuição, e inclui disposições claras de concessão de patentes.
Por exemplo, a série de modelos Qwen3 usa Apache 2.0.
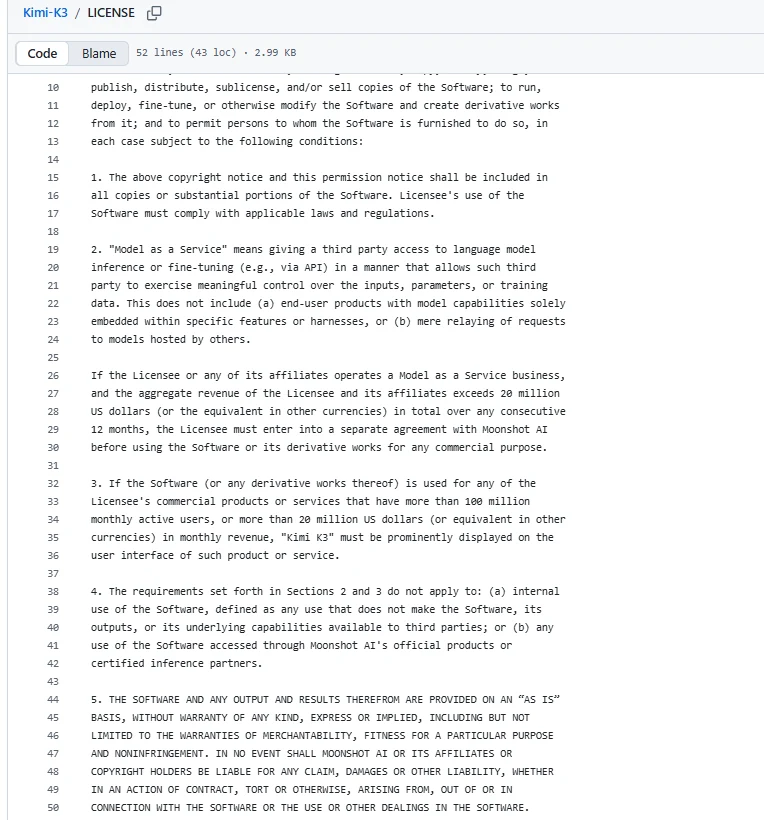
Kimi K3 tem acordos separados para certos usos comerciais, permitindo implantação, refinamento e criação de trabalhos derivados, mas quando serviços de modelo atingem um limite de receita especificado, um acordo separado é necessário.
O código do DeepSeek-V3 usa a licença MIT.
Portanto, ao usar modelos, se você deseja publicar um modelo refinado ou fornecê-lo a outros usuários, precisa reverificar a licença do modelo original para ver se tal uso é permitido, e se você precisa reter o nome do modelo, licença e informações de origem.
Se um novo modelo é obtido pela fusão de múltiplos modelos, você também precisa verificar as licenças de cada modelo separadamente para garantir que seus requisitos não entrem em conflito.