AIUnlimited
🌳

Fundamentos de IA

🌱
AI Seeds

Comece do zero

🌿
AI Sprouts

Construa bases

🌳
AI Branches

Aplique na prática

🏕️
AI Canopy

Aprofunde-se

🌲
AI Forest

Domine a IA

🔨

Mestria em IA

✏️
AI Sketch

Comece do zero

🪨
AI Chisel

Construa bases

⚒️
AI Craft

Aplique na prática

💎
AI Polish

Aprofunde-se

🏆
AI Masterpiece

Domine a IA

📘

Prática de IA

📖
Entendendo modelos open-source

Fundamentos e recursos para modelos open-source

🎯
Do problema à tarefa do modelo

Convertendo problemas de negócio em tarefas de modelo

⚡
Executando seu primeiro modelo

Veja seus primeiros resultados em 30 minutos

🔧
Fine-tuning e avaliação

Ajuste modelos e avalie o desempenho

🚀
Sistemas de aplicação

Construa aplicações IA do mundo real

🎨
IA generativa

Explore modelos AIGC open-source

🤖
Agentes

Aprenda frameworks Agent e ferramentas MCP

📐
Fundamentos complementares

Fundamentos LLM e avaliação

🎓

Claude Academia

🤖
Claude 101

Learn AI basics with Claude

💻
Claude Code 101

Code with Claude as your pair programmer

🤝
Introduction to Claude Cowork

Collaborate with Claude on complex projects

⚙️
Claude Platform 101

Build apps with the Claude API

Laboratório

7 experimentos carregados
🧬Sandbox de Rede Neural🤖IA ou Humano?🥋Dojo de Prompt Engineering🏁Corrida de Algoritmos🧠Trivia de IA🏗️Tela de design de sistemas
🎯Entrevista simuladaEntrar no Laboratório→
🚀

Desenvolvimento de carreira

🚀
Plataforma de Lançamento de Entrevistas

Comece sua jornada

🌟
Domínio Comportamental

Domine habilidades interpessoais

💻
Entrevistas Técnicas

Passe na rodada de programação

🤖
Entrevistas de IA e ML

Domínio em entrevistas de ML

🏆
Oferta e Além

Conquiste a melhor oferta

Começar
AIUnlimited

Licença MIT

沪ICP备18025655号-11

Aprender

  • Fundamentos de IA
  • Prática de IA
  • Claude Academia
  • Laboratório
  • Desenvolvimento de carreira

Comunidade

  • Sobre
  • Perguntas Frequentes

Suporte

  • Termos de Serviço
  • Política de Privacidade
  • Contato
Acadêmicos de IA e Engenharia›⚡ Executando seu primeiro modelo›Aulas›Your First Inference in 30 Minutes
⚡
Executando seu primeiro modelo • Iniciante⏱️ 25 min de leitura

Your First Inference in 30 Minutes

Obtenha seu primeiro resultado em 30 minutos

Após baixar um modelo de código aberto, você pode executá-lo em seu próprio notebook ou alugar um servidor na nuvem, configurando CPU, GPU e o ambiente de execução conforme necessário. Hardware diferente requer preparações diferentes.

Se você só quer experimentar o que um modelo pode fazer primeiro, o ModelScope Notebook oferece um ponto de entrada gratuito. Abra um navegador, selecione uma instância em execução, e você pode escrever código, baixar modelos e visualizar resultados diretamente na página da web.

Esta lição guia você através da criação de um Notebook, verificação do ambiente e carregamento de um modelo. Siga os passos para ver seu primeiro resultado.

Abra o Notebook e conecte-se a uma instância em execução

Vá até o hub de modelos, encontre o modelo Qwen/Qwen3-ASR-1.7B e clique em "Notebook Quick Development" à direita para criar um notebook do ModelScope.

Link do modelo: https://www.modelscope.cn/models/Qwen/Qwen3-ASR-1.7B
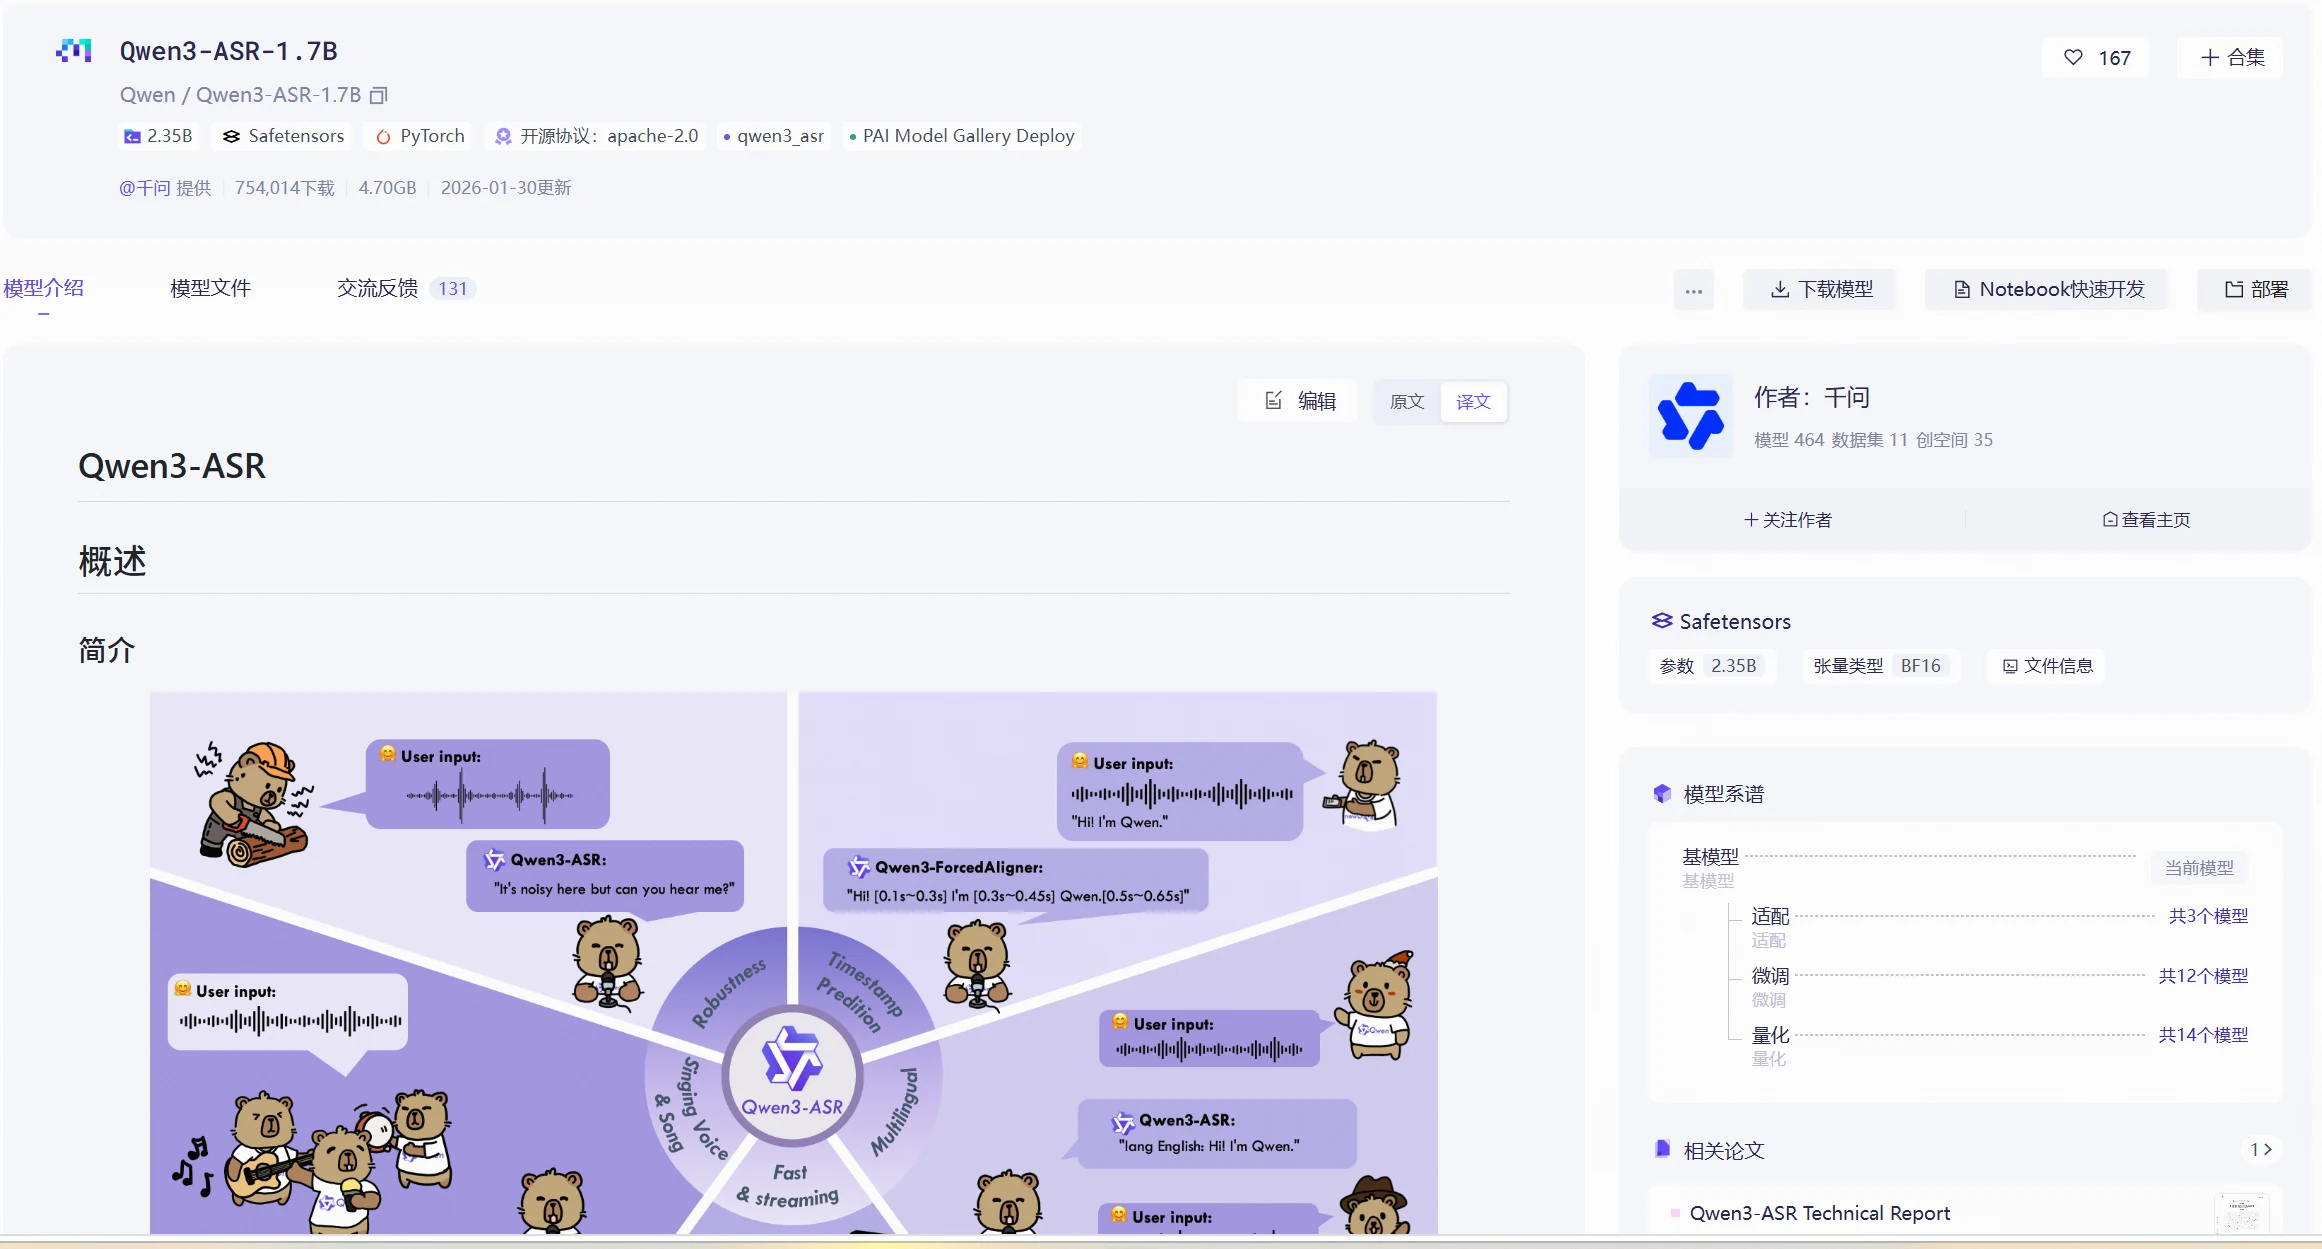
ilustração

Clique em "Connect Runtime" no canto superior direito para selecionar uma instância. Aqui escolhemos GPU para a demonstração. Você pode selecionar uma imagem pré-instalada adequada com base nas dependências do modelo.
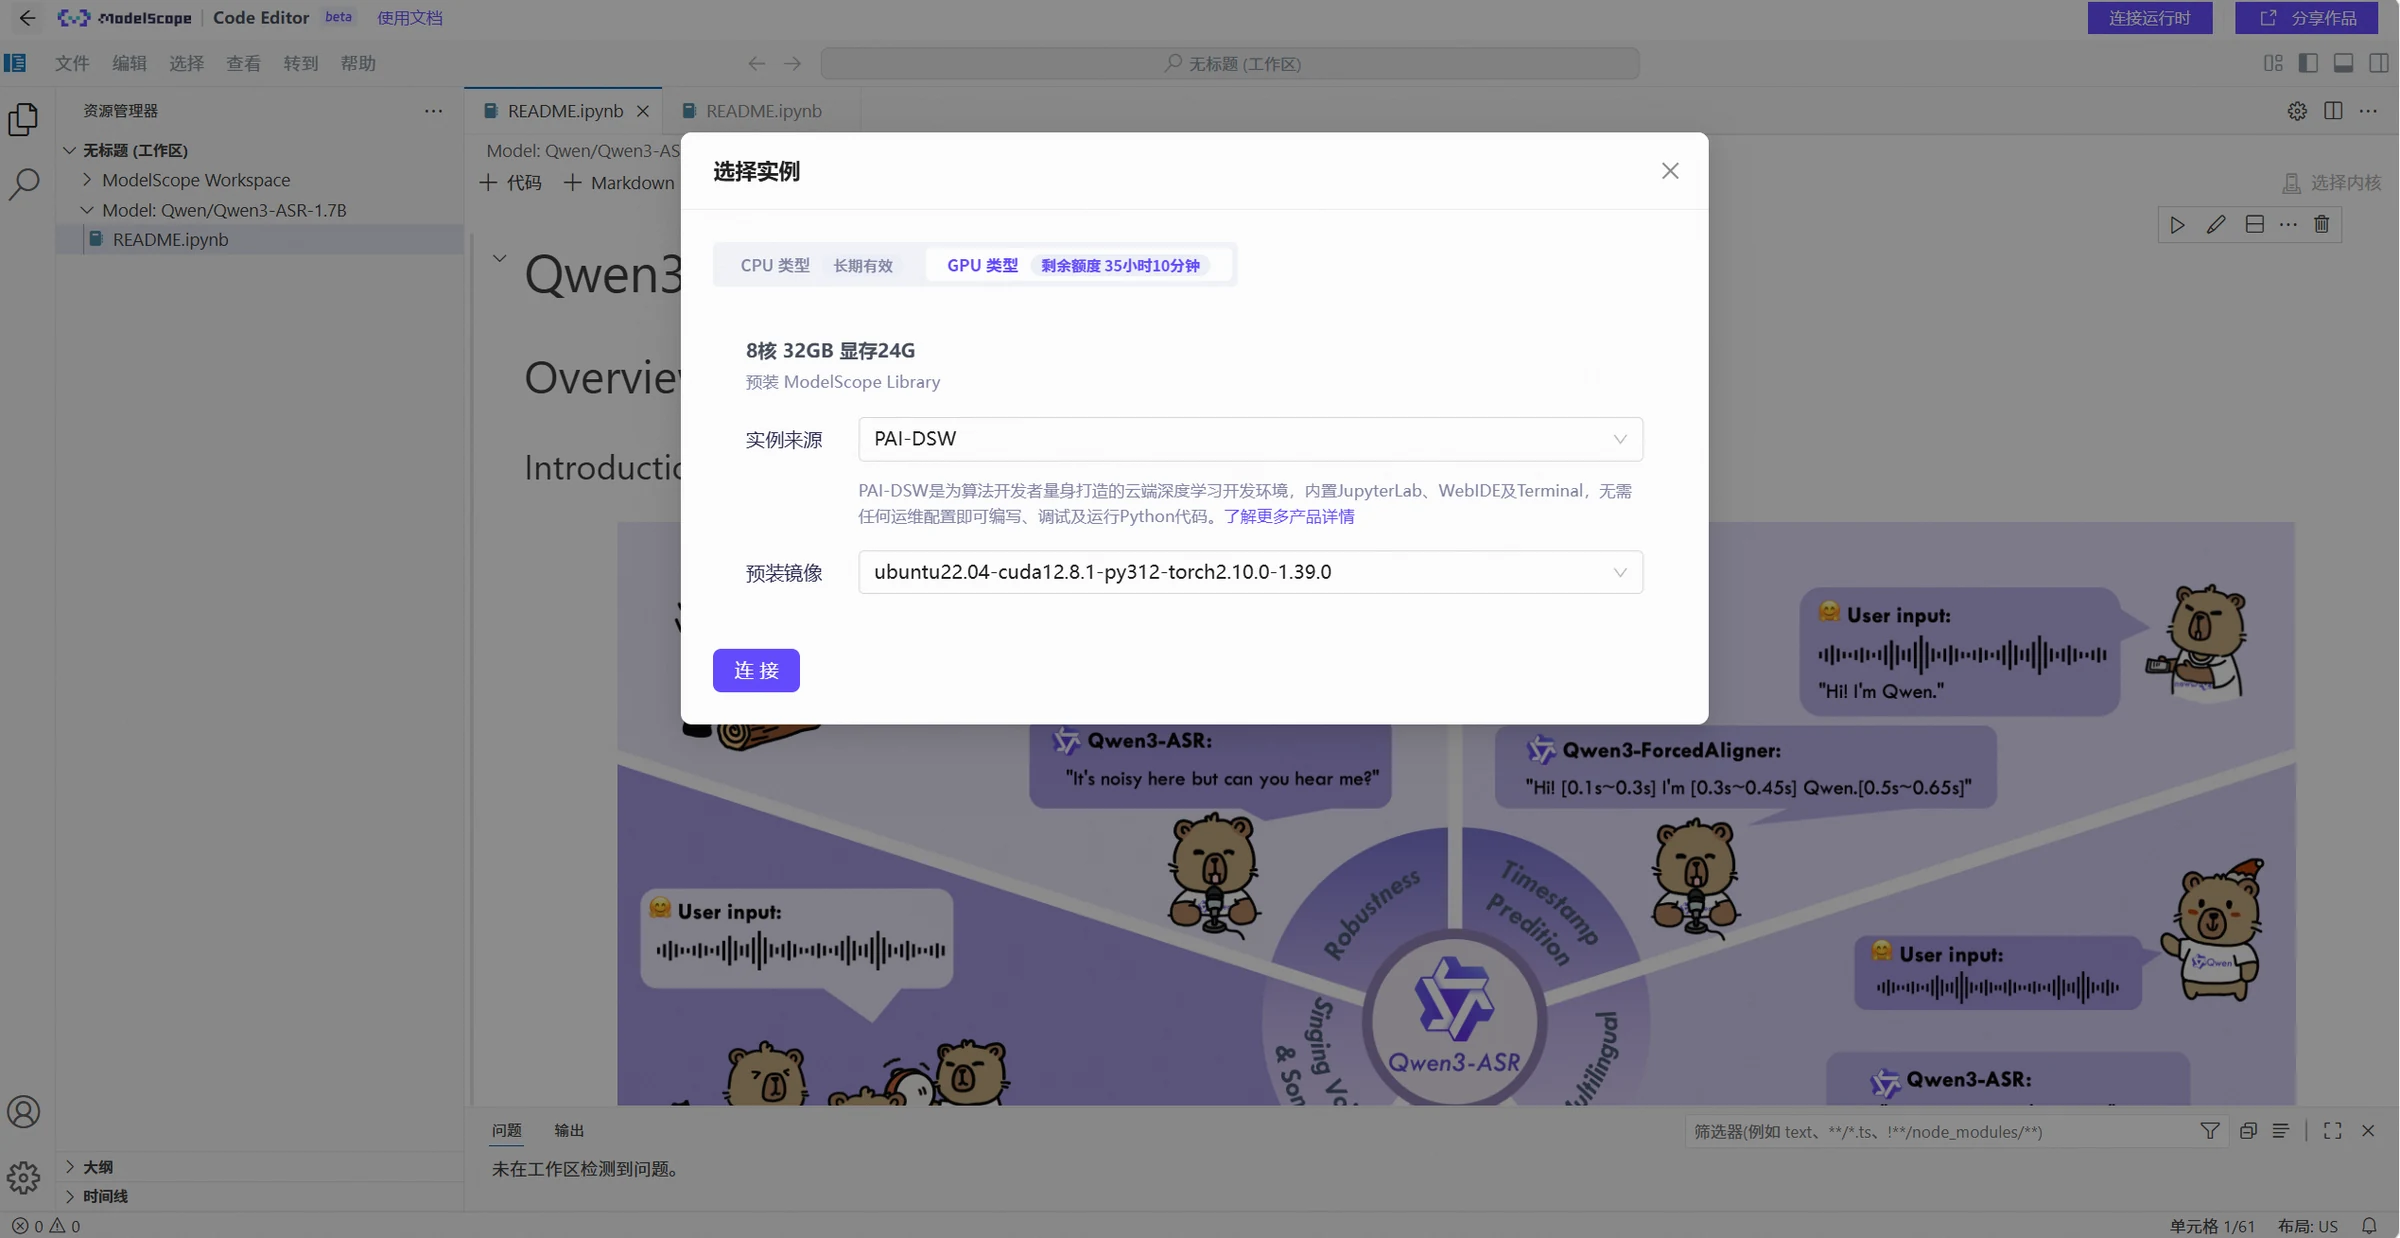
ilustração

Verifique se o ambiente está pronto

Após carregar a instância, o primeiro passo é verificar o ambiente atual. Você pode executar os seguintes comandos no notebook:

  1. Verificar a versão do Python
!python3 --version

Resultado:
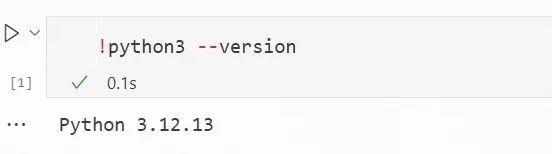
ilustração
  1. Verificar dependências relacionadas

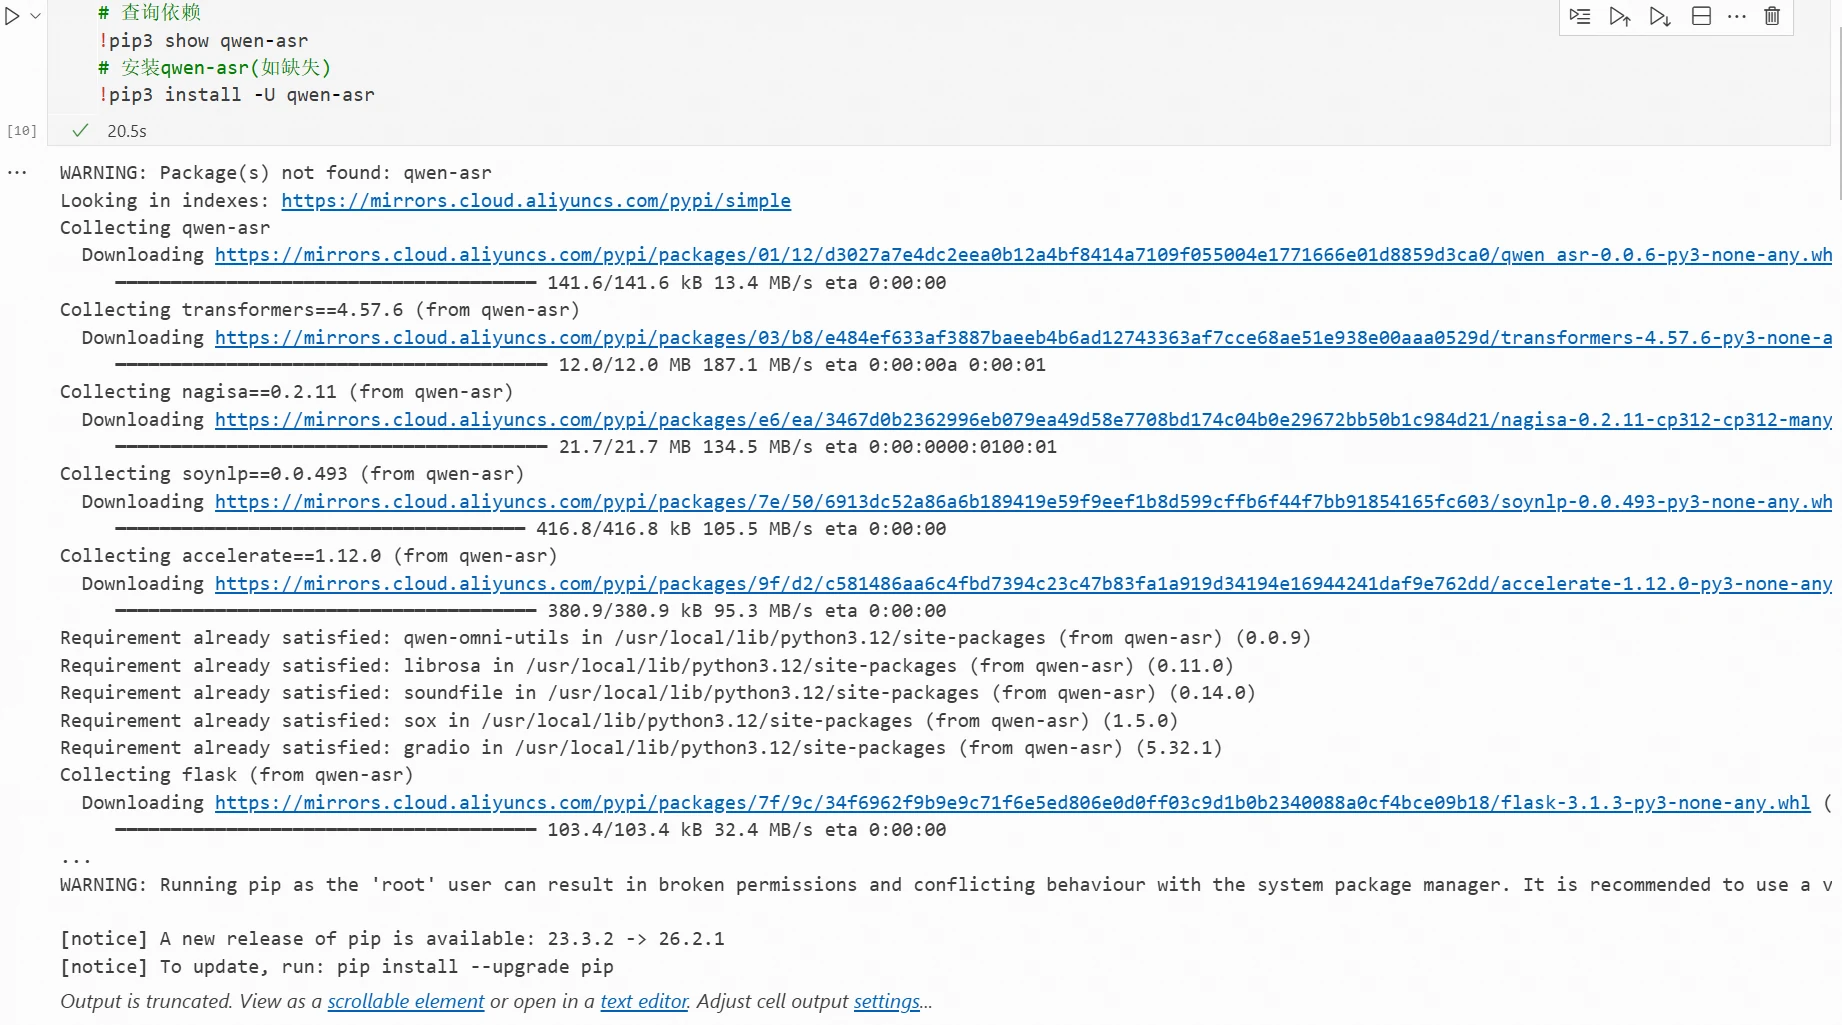
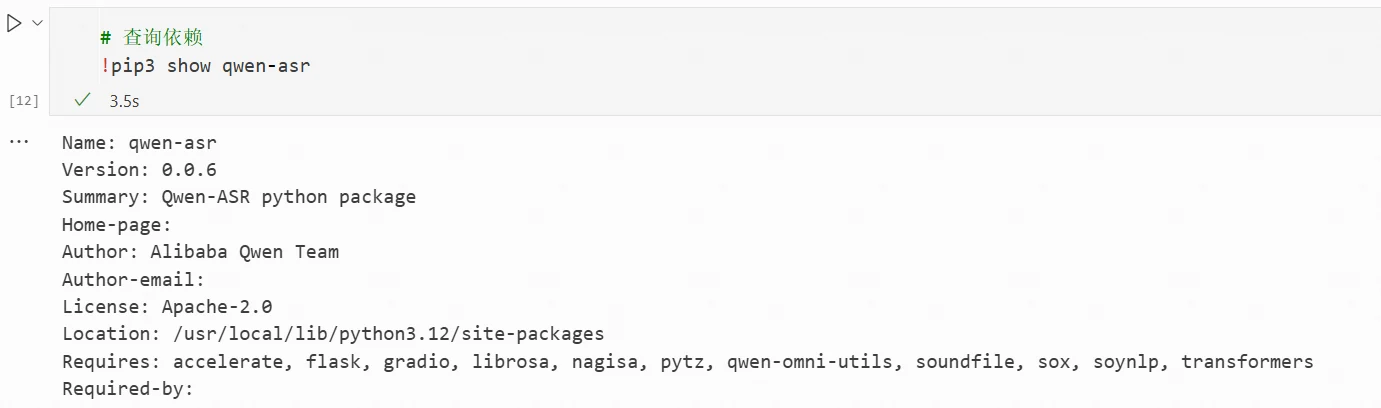
Cada modelo tem dependências diferentes. Você precisa consultar o cartão do modelo para obter informações. De acordo com o cartão do modelo Qwen3-ASR-1.7B, a dependência de inferência é qwen3-asr. Se qwen3-asr estiver faltando no ambiente, você precisa instalá-lo.

# Verificar dependência
!pip3 show qwen-asr
# Instalar qwen-asr (se estiver faltando)
!pip3 install -U qwen-asr

Resultado:
ilustração

Resultado da consulta de instalação bem-sucedida:
ilustração
  1. Verificar configuração da CPU
!lscpu
Aula 1 de 50% concluído
←Voltar ao programa

Discussão

Entrar participar da discussão
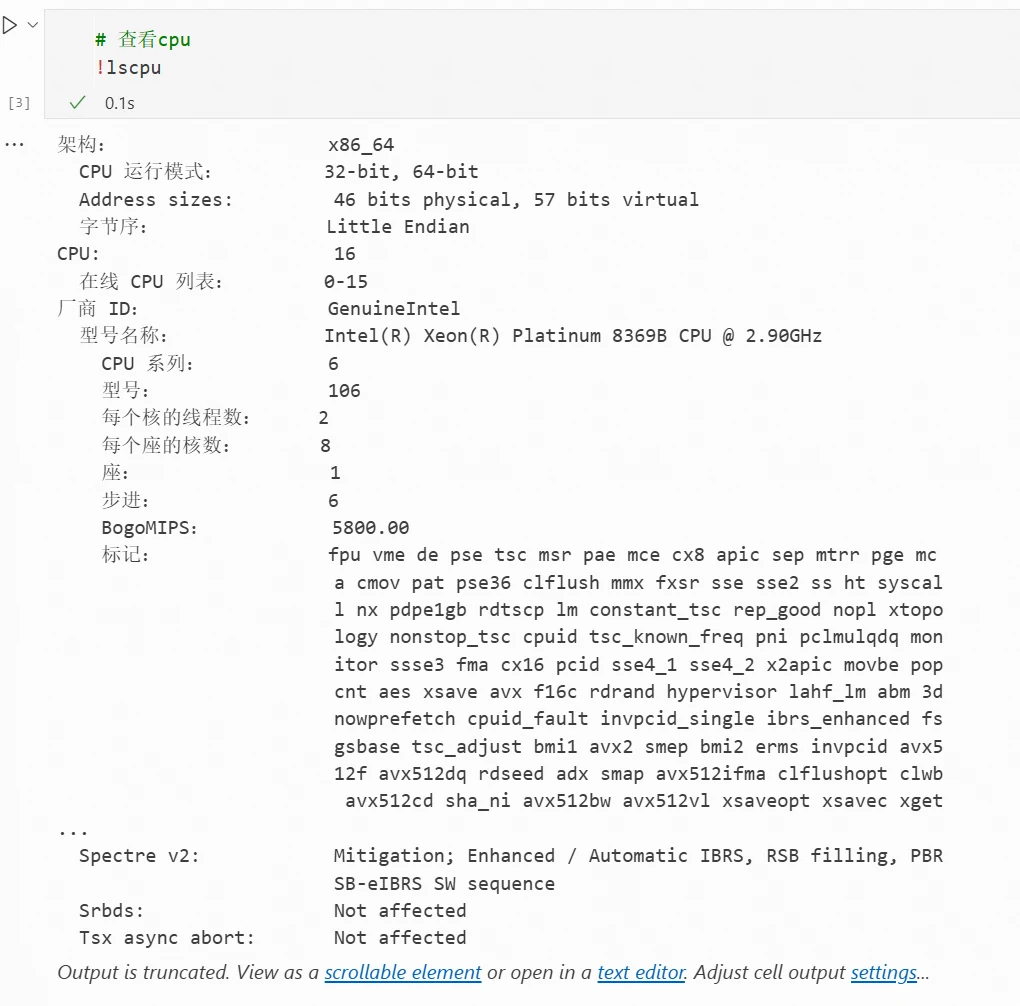
Resultado:

ilustração
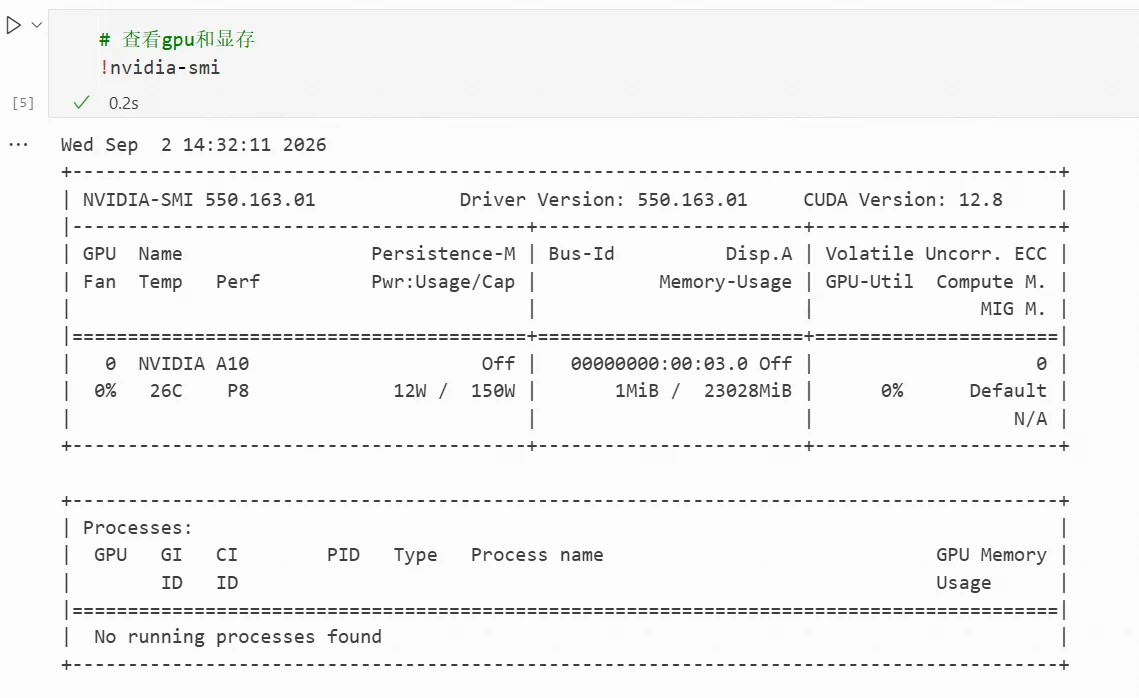
  1. Verificar GPU e memória de vídeo
!nvidia-smi

Resultado:

ilustração
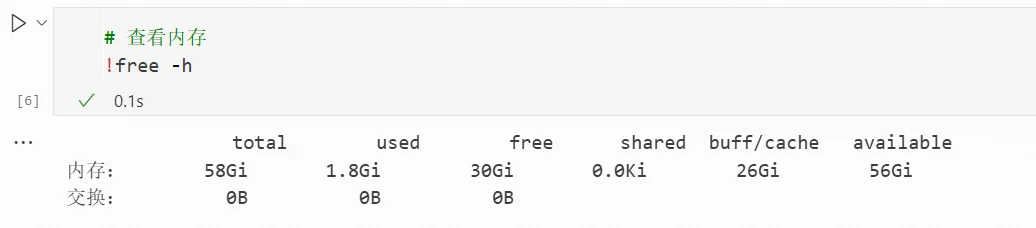
  1. Verificar memória
!free -h

Resultado:

ilustração
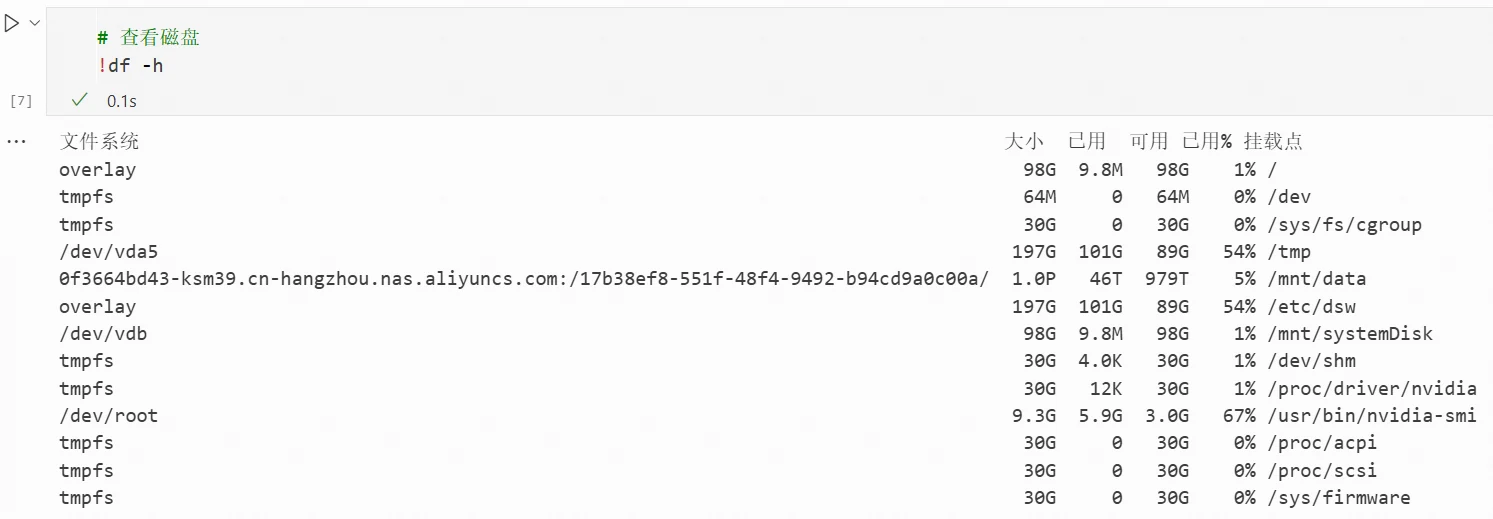
  1. Verificar disco
!df -h

Resultado:

ilustração

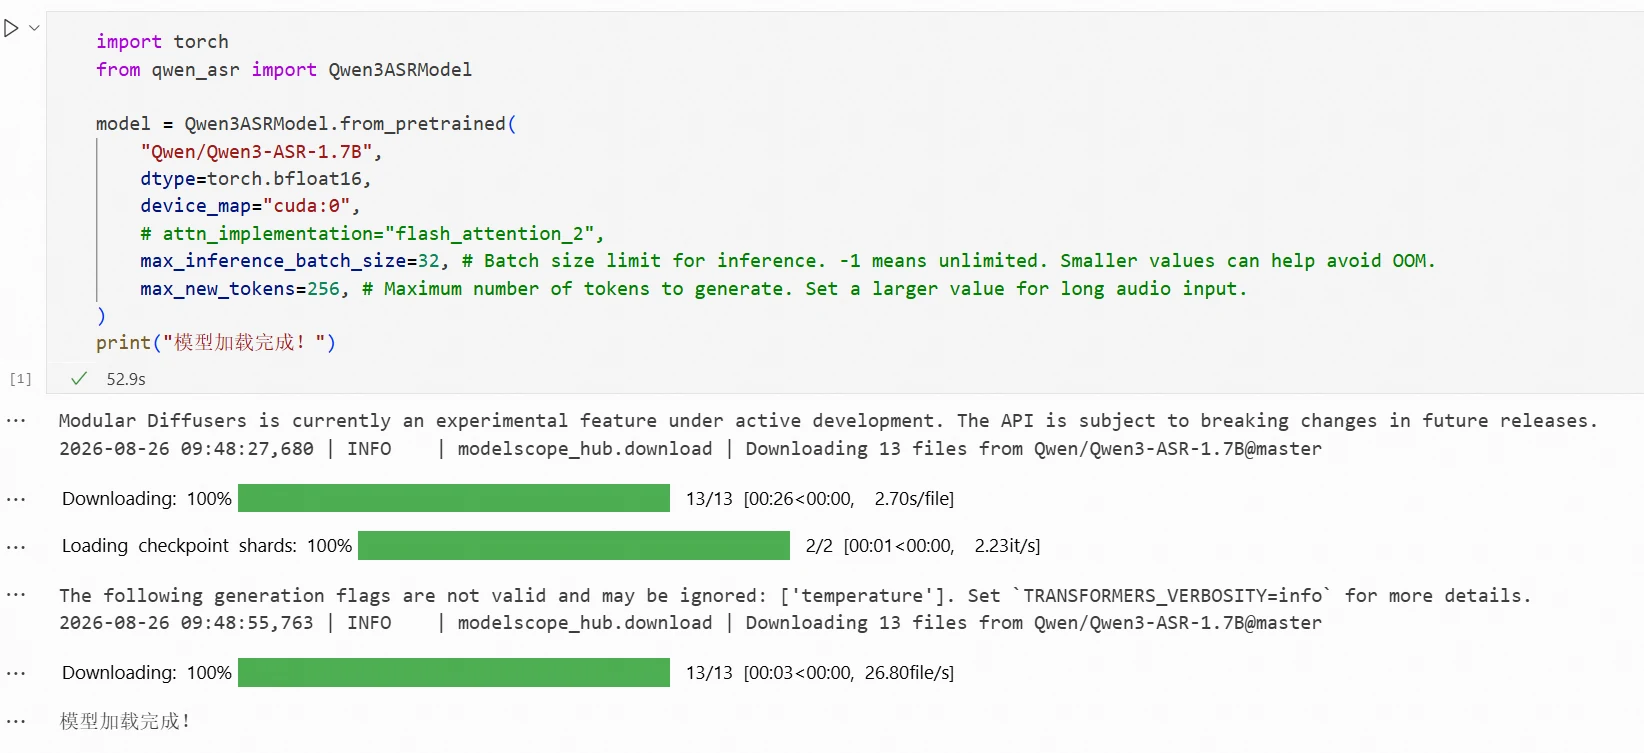
Carregue o modelo diretamente pelo nome

Consulte o código de exemplo no cartão do modelo para carregamento. Os arquivos do modelo necessários serão baixados automaticamente.

import torch
from qwen_asr import Qwen3ASRModel
 
model = Qwen3ASRModel.from_pretrained(
    "Qwen/Qwen3-ASR-1.7B",
    dtype=torch.bfloat16,
    device_map="cuda:0",
    # attn_implementation="flash_attention_2",
    max_inference_batch_size=32, # Batch size limit for inference. -1 means unlimited. Smaller values can help avoid OOM.
    max_new_tokens=256, # Maximum number of tokens to generate. Set a larger value for long audio input.
)
print("Modelo carregado com sucesso!")

Resultado:

ilustração

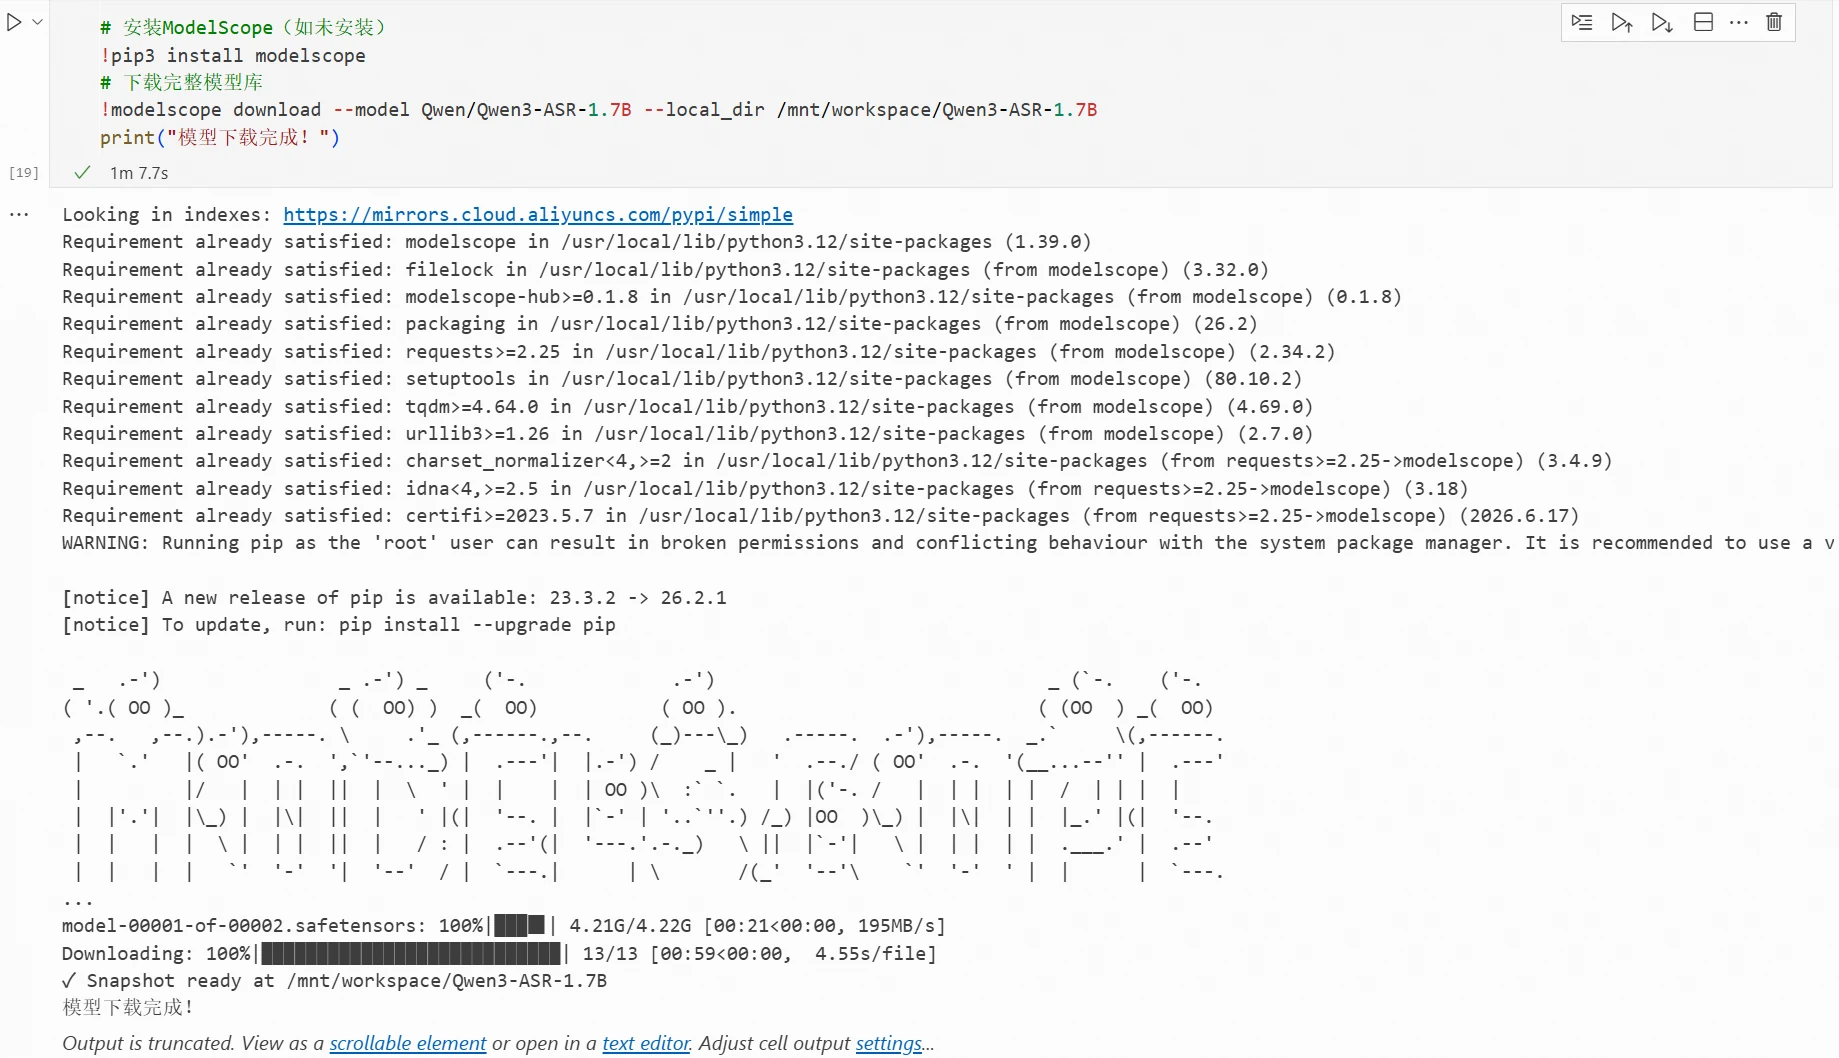
Se você deseja baixar o modelo separadamente, consulte o método de download de modelos na seção 2.5 deste livro. Por exemplo, para baixar o modelo para o diretório /mnt/workspace/Qwen3-ASR-1.7B, usando o download por linha de comando como exemplo, execute o seguinte comando no terminal:

# Instalar ModelScope (se não estiver instalado)
!pip3 install modelscope
# Baixar o repositório completo do modelo
!modelscope download --model Qwen/Qwen3-ASR-1.7B --local_dir /mnt/workspace/Qwen3-ASR-1.7B

Resultado:

ilustração

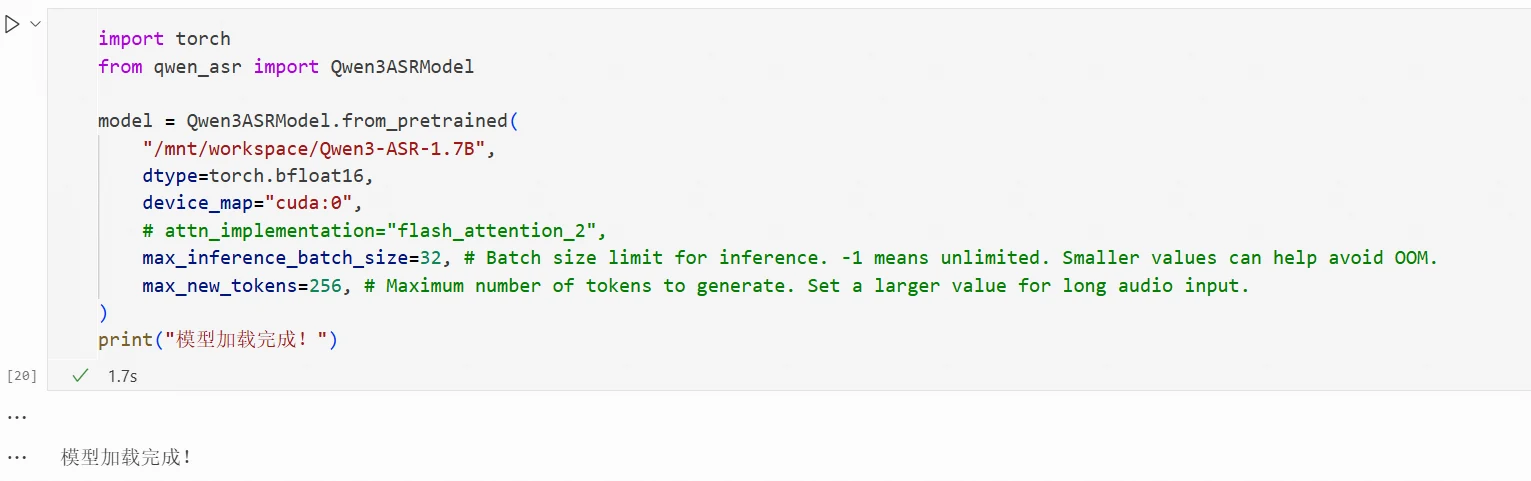
Se você tem os arquivos do modelo baixados, pode substituir Qwen/Qwen3-ASR-1.7B pelo caminho do seu modelo.

import torch
from qwen_asr import Qwen3ASRModel

model = Qwen3ASRModel.from_pretrained(
    "/mnt/workspace/Qwen3-ASR-1.7B",
    dtype=torch.bfloat16,
    device_map="cuda:0",
    # attn_implementation="flash_attention_2",
    max_inference_batch_size=32, # Batch size limit for inference. -1 means unlimited. Smaller values can help avoid OOM.
    max_new_tokens=256, # Maximum number of tokens to generate. Set a larger value for long audio input.
)
print("Modelo carregado com sucesso!")

Resultado:

ilustração

Passe um arquivo de áudio e veja o que é reconhecido

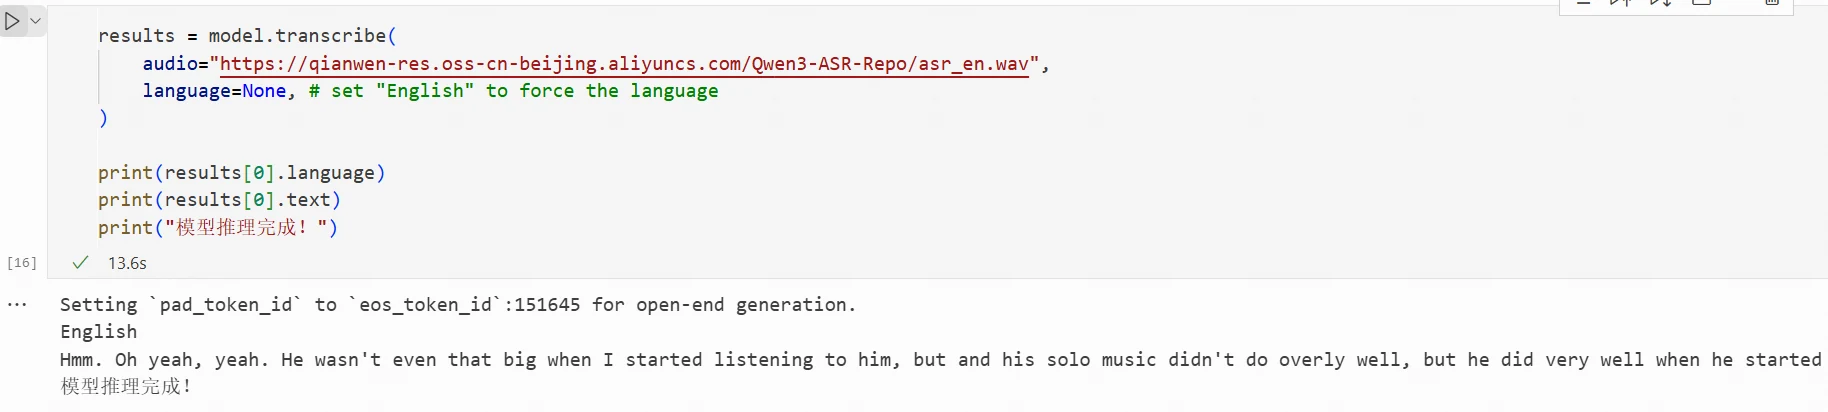
Após o modelo ser carregado, você pode passar arquivos de áudio para inferência do modelo. Você pode substituir o valor do audio pelo caminho do seu arquivo de áudio.

results = model.transcribe(
    audio="https://qianwen-res.oss-cn-beijing.aliyuncs.com/Qwen3-ASR-Repo/asr_en.wav",
    language=None, # set "English" to force the language
)
 
print(results[0].language)
print(results[0].text)
print("Inferência do modelo concluída!")

Resultado:

ilustração

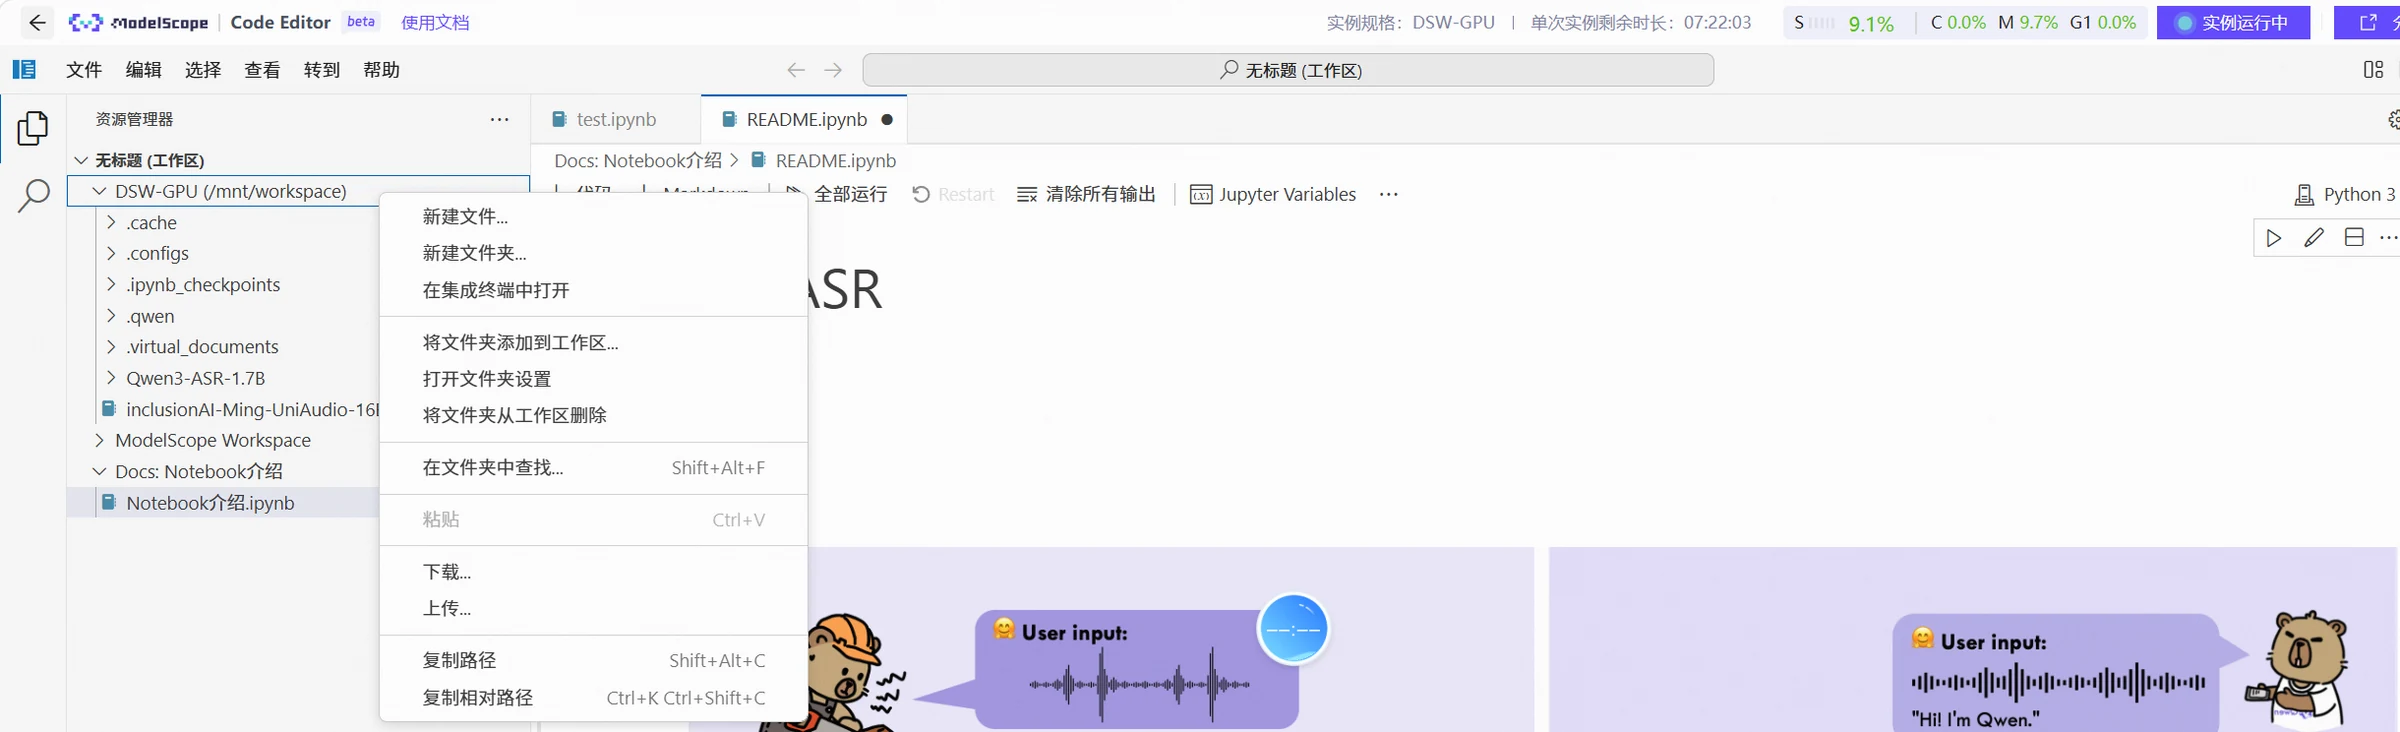
Você pode substituir o valor do audio pelo caminho do seu arquivo de áudio para inferência do modelo. Clique com o botão direito na pasta "DSW-GPU" no espaço de trabalho à esquerda, clique em "Upload", selecione seu arquivo de áudio local e ele será carregado para a pasta "DSW-GPU" do ambiente Notebook.

ilustração

Em seguida, modifique o código da seguinte forma:

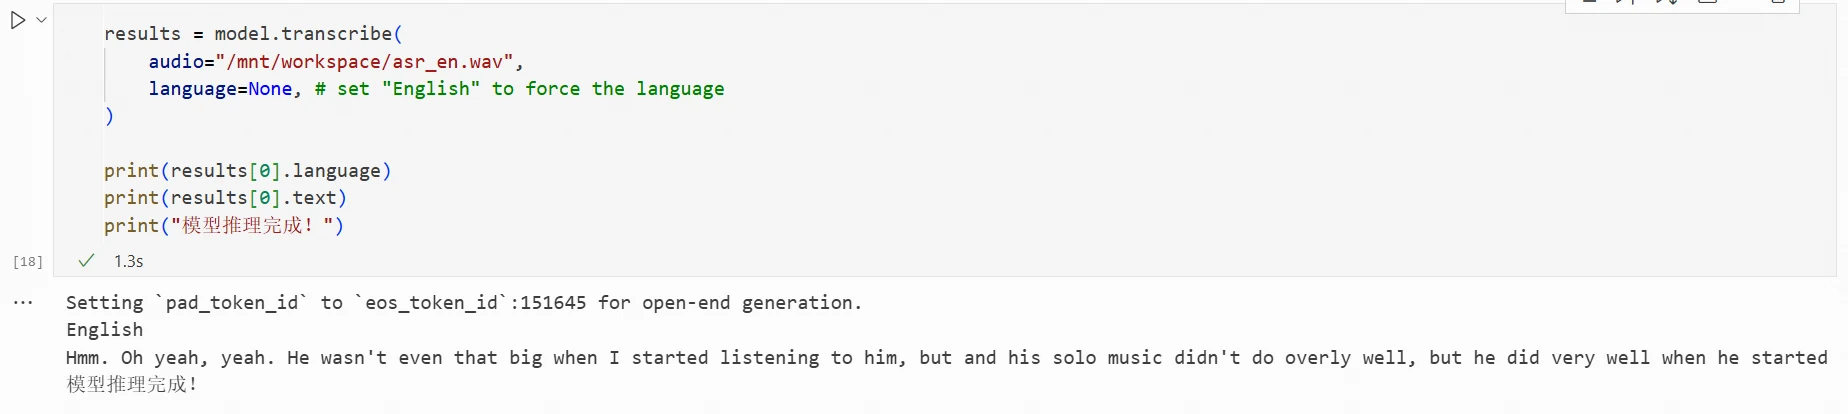
results = model.transcribe(
    audio="/mnt/workspace/asr_en.wav",
    language=None, # set "English" to force the language
)
 
print(results[0].language)
print(results[0].text)
print("Inferência do modelo concluída!")

Resultado:

ilustração

O código e os arquivos relacionados deste capítulo podem ser encontrados em: https://www.modelscope.cn/gallery/liucong/54c2ca38-b797-43d1-97ab-4b9f569aaa95