Fine-tuning e avaliação • Iniciante⏱️ 30 min de leitura
Training Data Preparation
Como transformar materiais de negócios em dados treináveis?
Antes de treinar um modelo, frequentemente encontramos o seguinte problema:
Eu tenho muitos materiais brutos, manuais de produtos, guias de operação e especificações de negócios, cada um em seu próprio formato, e o conteúdo está bastante disperso,
Como posso utilizar esses dados?
E se eu utilizar diretamente dados de domínio ou cenário específicos, o modelo treinado ainda terá a capacidade de responder perguntas de conhecimento geral?
Portanto, o ponto principal é como podemos transformar todos os materiais em dados de treinamento utilizáveis pelo modelo.
Ao mesmo tempo, a limpeza, deduplicação e anonimização de dados também são essenciais. Podemos ter destilado os dados, mas precisamos adaptá-los aos nossos resultados desejados.
Por exemplo, ao treinar um modelo, se os dados de auto-identificação não forem treinados corretamente, ele pode responder que é um modelo ChatGPT, um modelo Claude, etc.
Os dados são a base de tudo. Neste capítulo, começamos pelas fontes de dados e examinamos como esses materiais dispersos passam por síntese, limpeza, deduplicação e anonimização para finalmente se tornarem dados que podem ser usados para o treinamento do modelo.
Aprendendo habilidades de negócios preservando capacidades gerais
Coletar e anotar dados de treinamento do zero requer tempo e custo significativos. Para tarefas comuns como classificação de texto, perguntas e respostas e geração de texto, você pode encontrar conjuntos de dados públicos adequados para incluir no treinamento.
Conjuntos de dados públicos comuns incluem:
Classificação de texto e inferência: GLUE, SuperGLUE, CLUE, etc.;
Compreensão de leitura e perguntas e respostas: SQuAD, CMRC, etc.;
Resumo de texto: CNN/DailyMail, etc.;
Diálogo e ajuste de instruções: Alpaca, ShareGPT, OpenOrca, etc.;
Tarefas multimodais: COCO e outros conjuntos de dados imagem-texto.
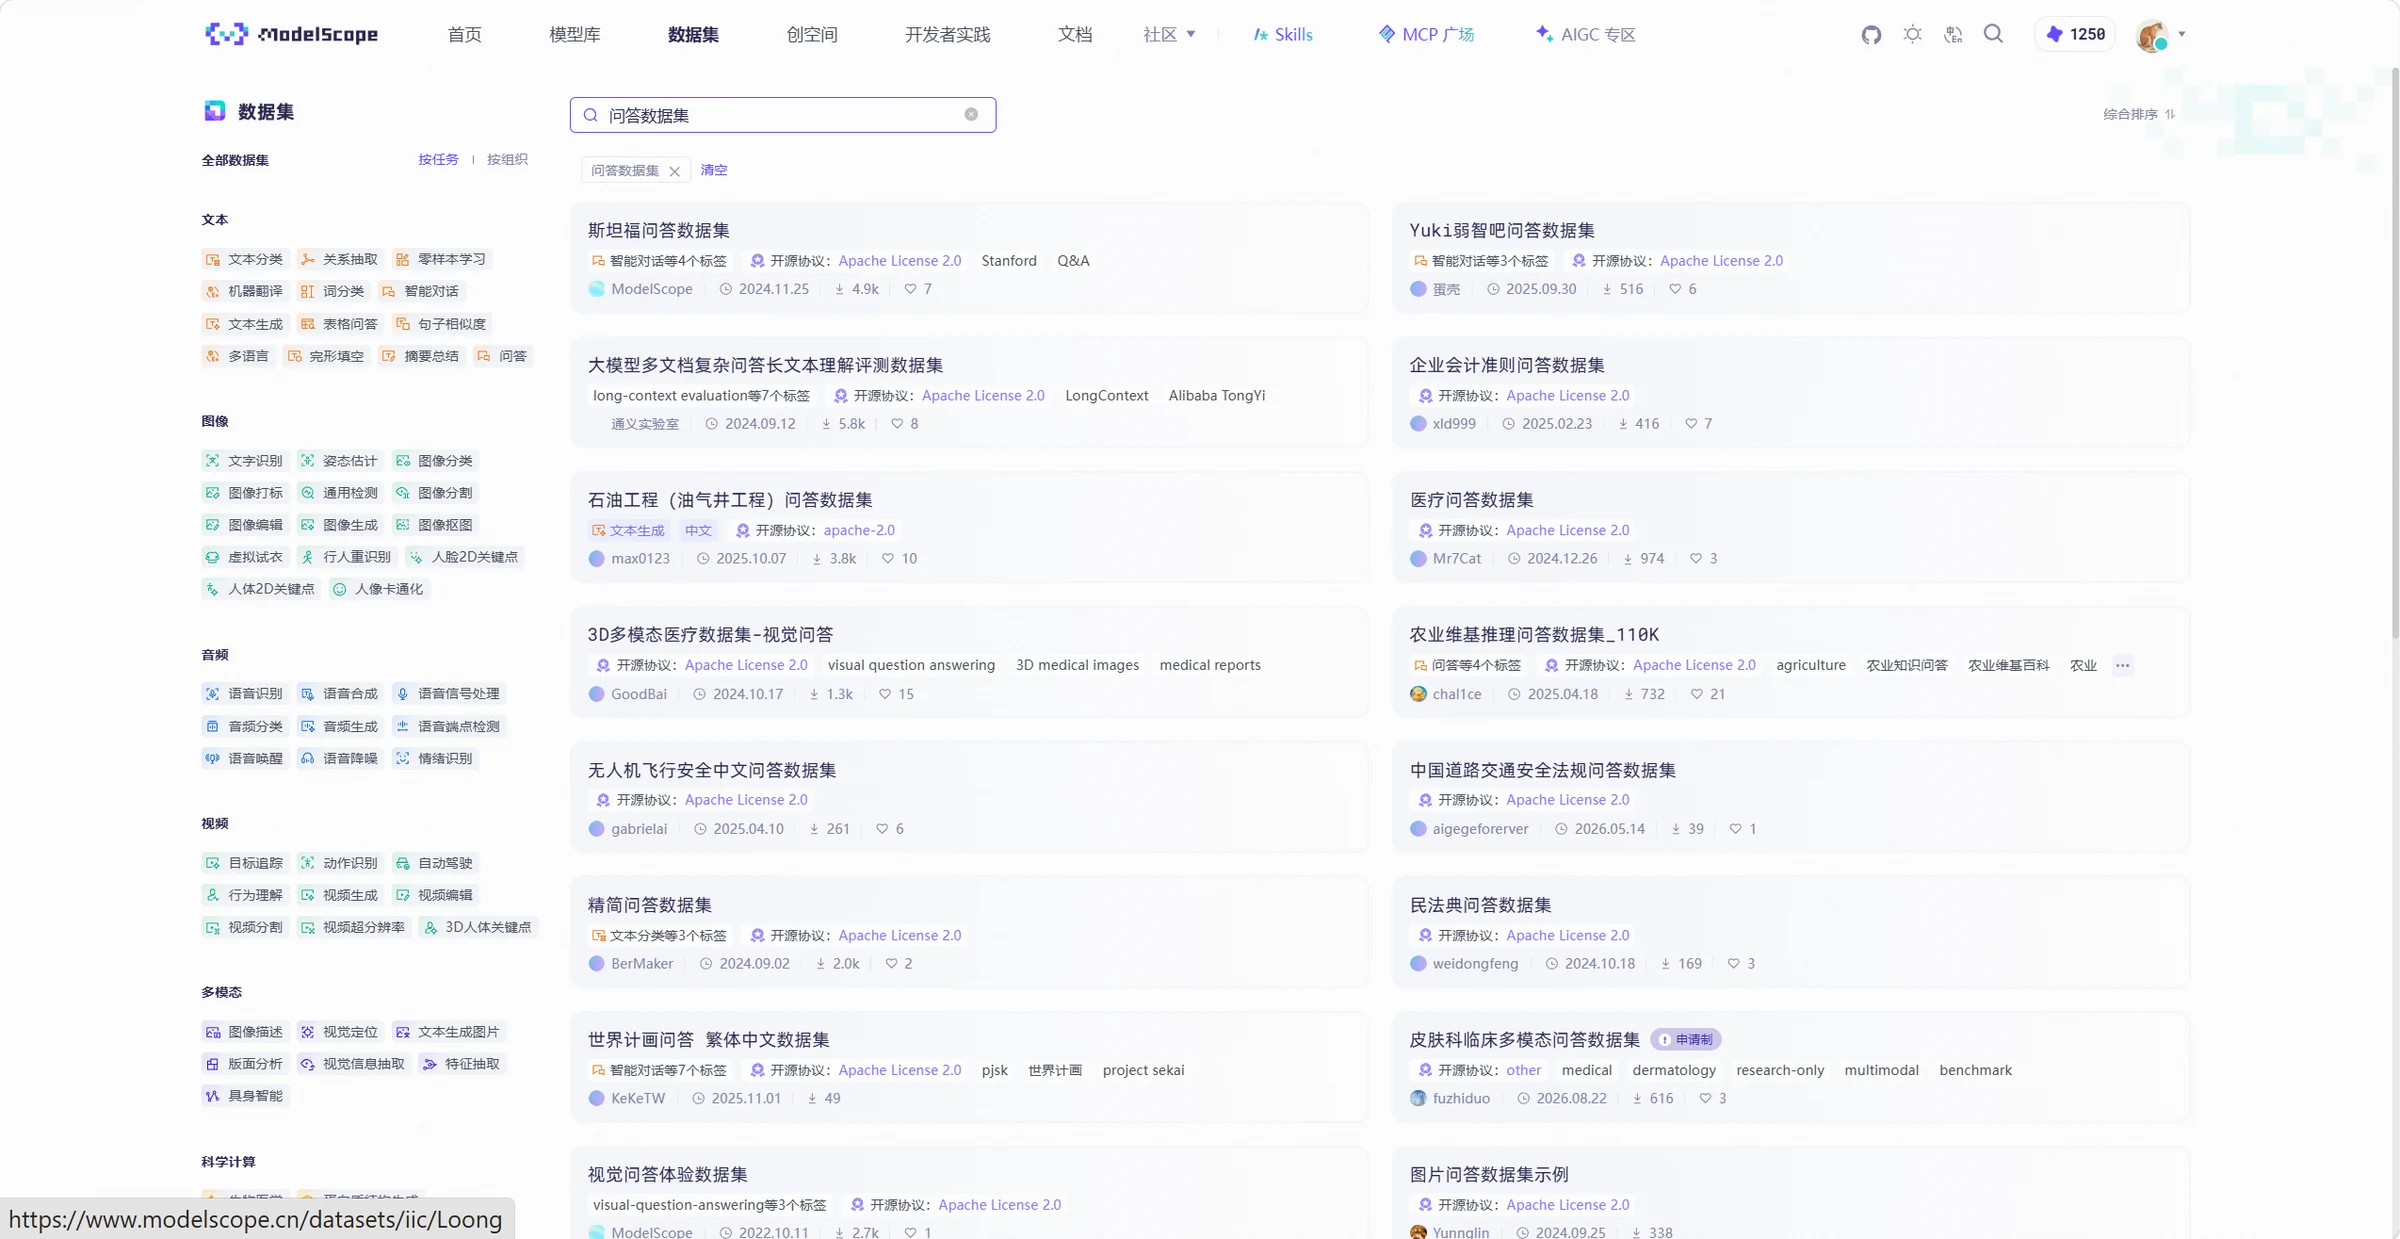
Além de obter dados de sites oficiais de conjuntos de dados, você também pode encontrar e usar conjuntos de dados de código aberto através do Dataset Hub do ModelScope. O Dataset Hub fornece recursos como pesquisa de conjuntos de dados, visualização online e download. Alguns conjuntos de dados também podem ser carregados diretamente através do SDK do ModelScope para processamento e treinamento subsequentes. Para métodos específicos de download de conjuntos de dados, consulte o capítulo "Dados: A Base do Ajuste Fino de Modelos de Código Aberto".
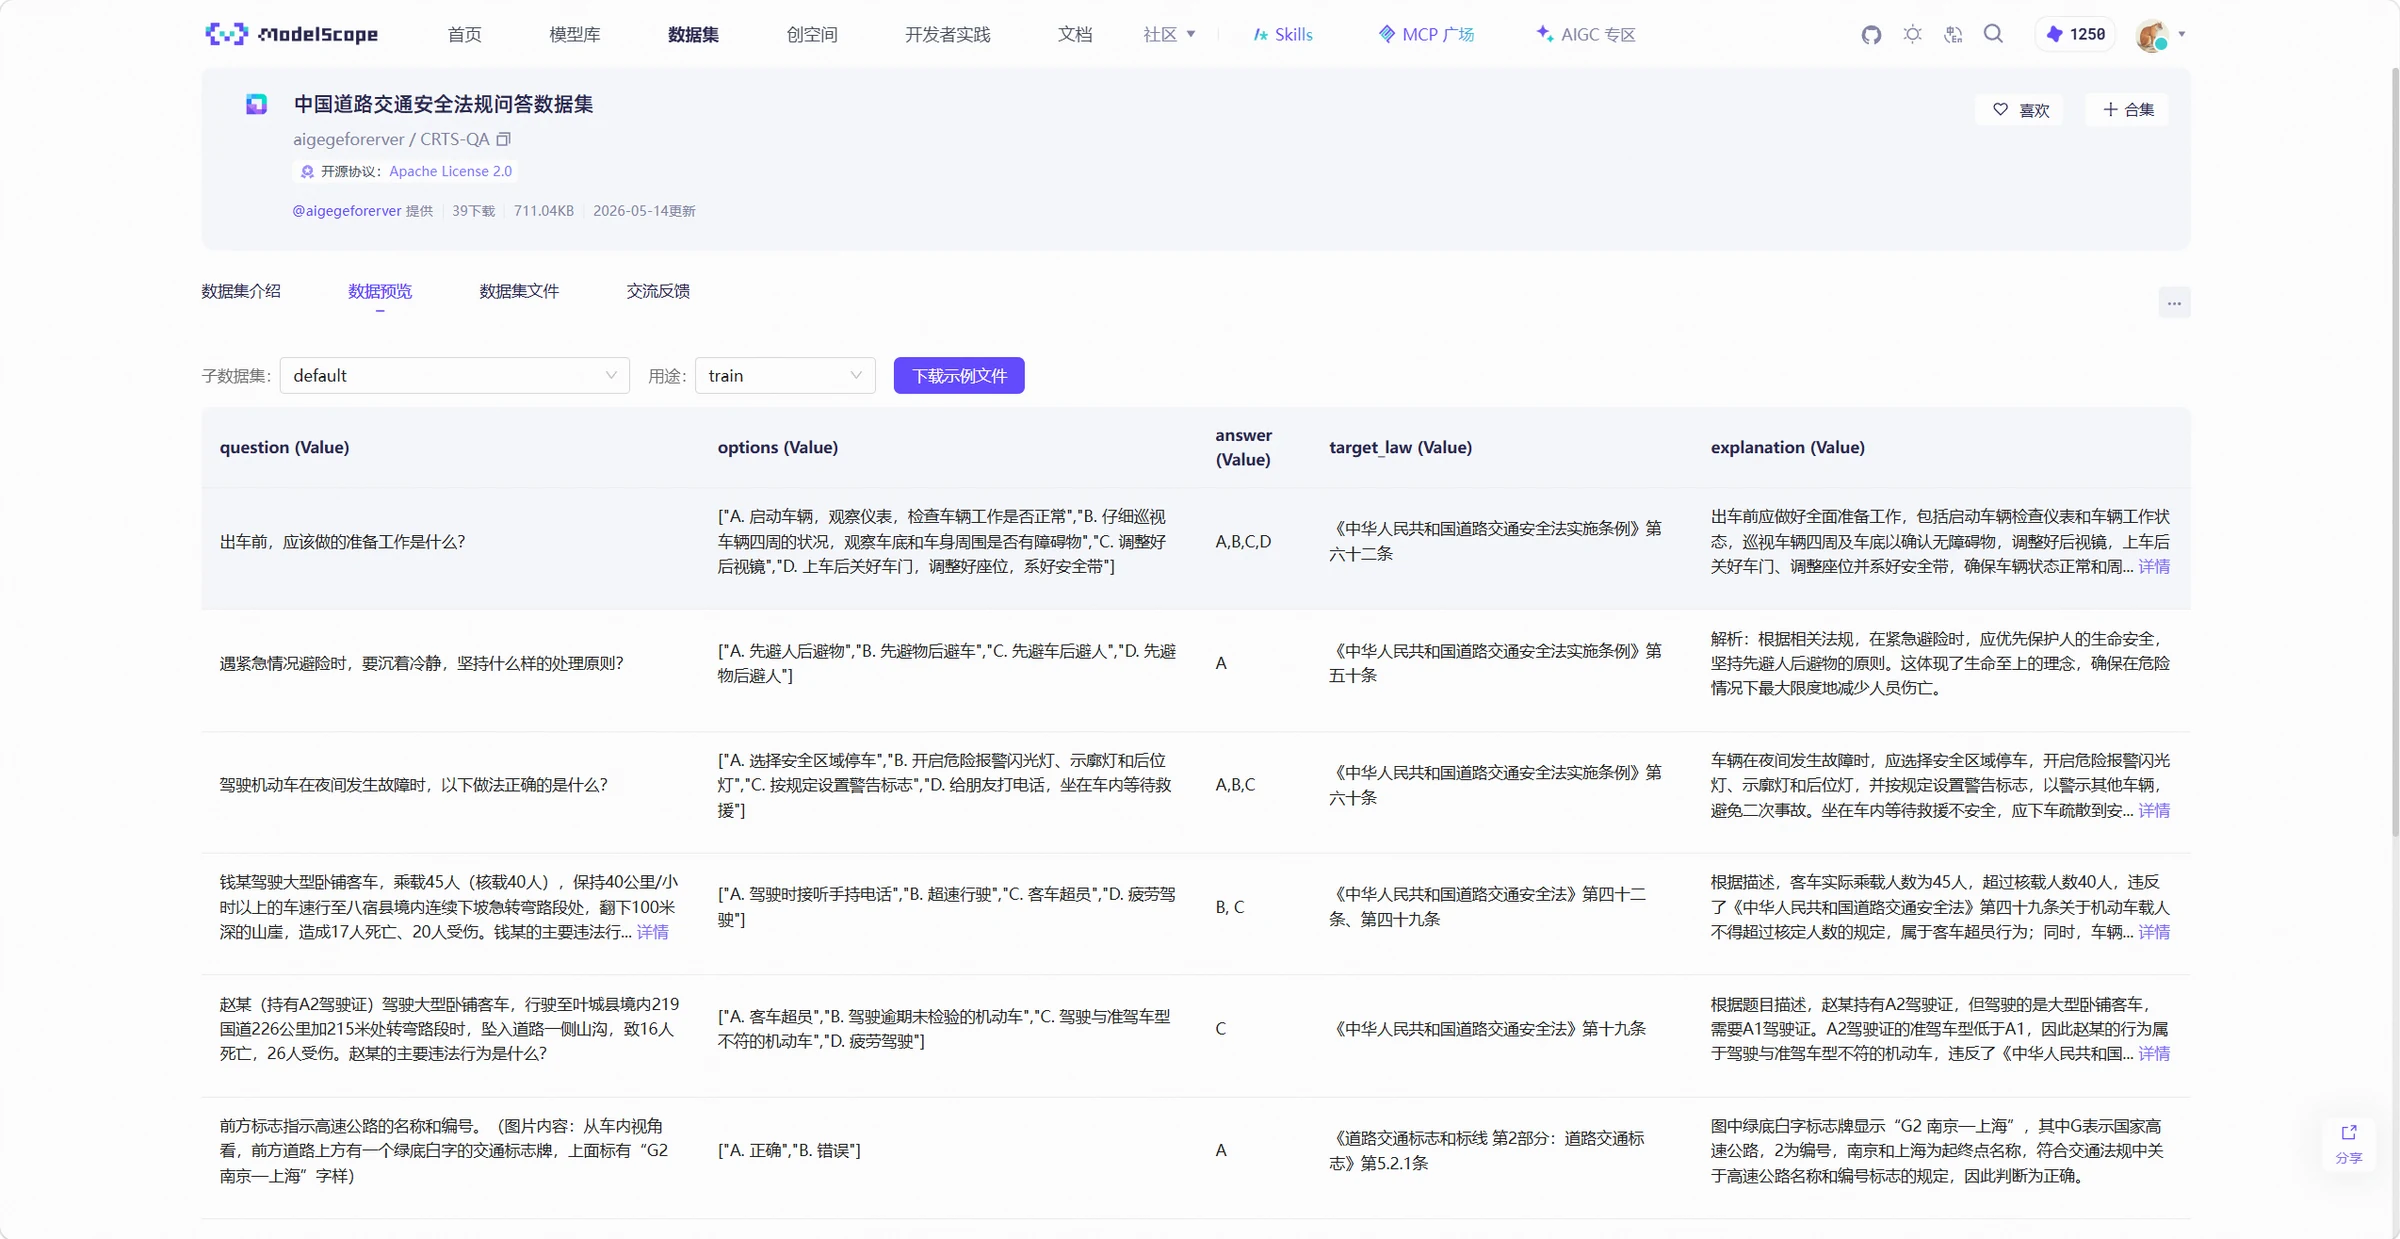
Ao selecionar conjuntos de dados de código aberto, você deve verificar não apenas se o conteúdo dos dados corresponde à tarefa de treinamento, mas também verificar a contagem de amostras, o formato dos campos, os tipos de rótulos e a qualidade dos dados do conjunto de dados para determinar se atende aos requisitos de treinamento. O recurso de visualização de dados fornecido pelo ModelScope pode ajudar a visualizar rapidamente os campos e o conteúdo das amostras do conjunto de dados, conforme mostrado no exemplo seguinte:
Dados de código aberto são usados principalmente para complementar as capacidades gerais do modelo. Se o modelo precisar aprender produtos internos da empresa, terminologia, regras de negócios e fluxos de trabalho, dados de negócios correspondentes precisam ser preparados.
Como usar seus próprios materiais de negócios?
Dados de negócios vêm de sistemas e materiais de negócios reais dentro de uma empresa, tornando-os mais próximos dos cenários onde o modelo será finalmente usado. Dados gerais de perguntas e respostas podem ajudar o modelo a aprender padrões básicos de P&R, enquanto dados internos de P&R da empresa podem ajudar o modelo a aprender nomes de produtos, terminologia de negócios e regras de processamento.
Fontes comuns de dados de negócios incluem:
Documentos empresariais: manuais de produtos, guias de operação, especificações de negócios, documentos de processo, etc., dos quais conhecimentos do produto, regras de negócios e processos operacionais podem ser extraídos;
Registros de atendimento ao cliente: conversas históricas, ordens de trabalho e registros de reclamações entre usuários e atendimento ao cliente, que podem ser usados para construir reconhecimento de intenção, dados de perguntas e respostas e diálogo;
FAQ: perguntas e respostas padrão compiladas pelo pessoal de negócios, que podem ser convertidas diretamente em dados de treinamento de perguntas e respostas;
Casos de especialistas: problemas típicos tratados por especialistas de negócios e suas soluções, que podem ser usados para construir dados de treinamento para cenários de negócios complexos.
Dados de negócios geralmente não podem ser usados diretamente para o treinamento do modelo. Um manual de negócios com várias dezenas de páginas precisa ter seu conteúdo de texto extraído primeiro de arquivos Word, PDF ou outros, e então organizado em pares de perguntas e respostas, amostras de classificação ou dados de instrução de acordo com a tarefa de treinamento. Registros de atendimento ao cliente também podem conter mensagens do sistema, conversas inválidas e conteúdo duplicado, que precisam ser filtrados e organizados primeiro.
Dados de negócios também podem conter informações sensíveis como nomes, números de telefone, números de identificação, endereços e números de conta. Antes de entrar no conjunto de dados de treinamento, a anonimização deve ser realizada de acordo com os requisitos de segurança de dados da empresa para evitar usar informações sensíveis reais diretamente para o treinamento do modelo.
Apenas documentos sem P&R? Deixe o modelo ajudar a sintetizar dados
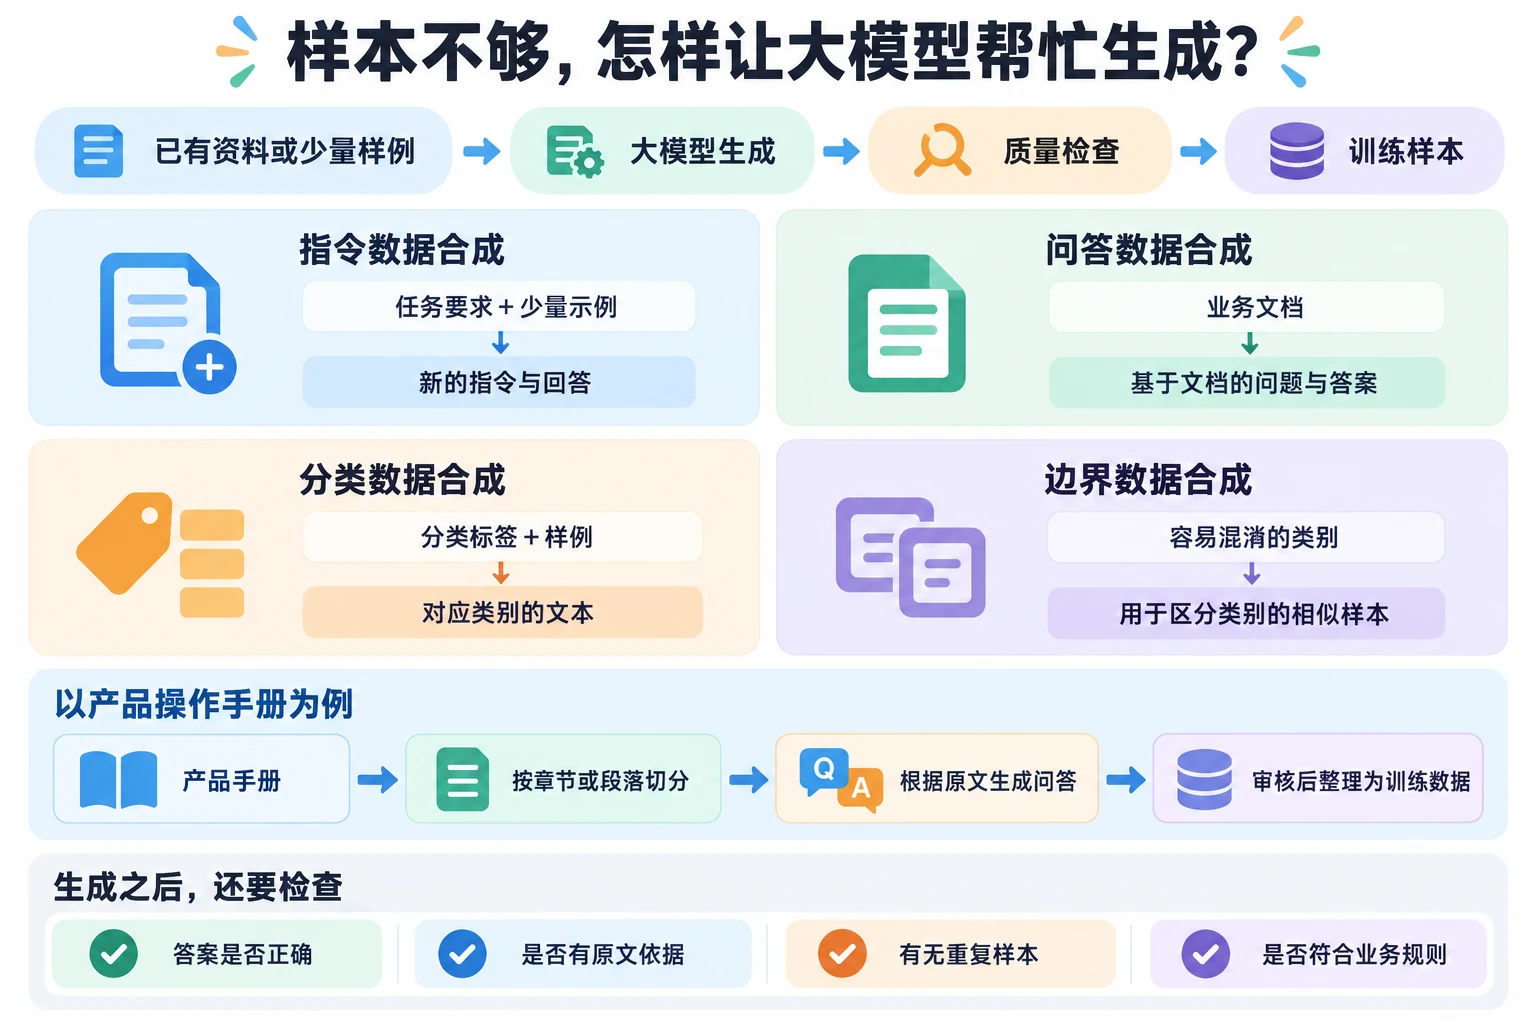
Em projetos reais, os dados existentes podem não atender a todas as necessidades de treinamento. Por exemplo, alguns tipos de negócios têm apenas algumas amostras, ou os documentos existentes contêm conhecimento mas não dados de P&R diretamente utilizáveis para o treinamento. Nesses casos, você pode usar grandes modelos para gerar novas amostras de treinamento, um método conhecido como síntese de dados.
Métodos comuns de síntese de dados incluem:
Síntese de dados de instrução: Com base em tarefas existentes ou alguns exemplos, use um grande modelo para gerar novas instruções e respostas;
Síntese de dados de perguntas e respostas: Insira documentos de negócios e use o grande modelo para gerar perguntas e respostas com base no conteúdo do documento;
Síntese de dados de classificação: Especifique rótulos de classificação e exemplos, e use o grande modelo para gerar texto para as categorias correspondentes;
Síntese de dados de limite: Gere amostras semelhantes para categorias facilmente confundíveis para melhorar a capacidade do modelo de distinguir limites de categorias.
Por exemplo, se uma empresa tiver apenas manuais de operação de produtos sem dados de P&R, o manual precisa ser segmentado por capítulos ou parágrafos, e o grande modelo pode ser usado para gerar várias perguntas e respostas com base no conteúdo dos parágrafos. Após revisar os resultados, organize-os em dados de treinamento de perguntas e respostas.
A síntese de dados pode reduzir o trabalho manual de redação de amostras de treinamento e complementar cenários onde os dados originais são insuficientes. No entanto, dados sintetizados não podem ser usados diretamente para treinamento após a geração. O grande modelo pode gerar respostas incorretas, amostras duplicadas ou fabricar produtos ou regras de negócios inexistentes, então verificações de qualidade ainda são necessárias.
Não se apresse para treinar com dados gerados
A qualidade dos dados sintetizados afeta diretamente a eficácia do treinamento do modelo. Antes de adicionar dados sintetizados ao conjunto de treinamento, você precisa verificar se o conteúdo gerado está correto e filtrar dados errôneos, fabricados, duplicados e excessivamente semelhantes.
A resposta corresponde ao texto original?
Se os dados sintetizados forem gerados a partir de documentos de negócios, você precisa verificar se o conteúdo gerado está consistente com o texto original.
Por exemplo, o documento de negócios original especifica:
Solicitações de reembolso requerem revisão manual, e reembolsos só podem ser processados após aprovação.
Dados de perguntas e respostas gerados pelo modelo:
P: Uma solicitação de reembolso requer revisão?
R: Reembolsos são processados automaticamente após o envio, sem necessidade de revisão manual.
Esta resposta entra em conflito com a regra de negócios. Se usada para treinamento, o modelo pode aprender processos de negócios incorretos.
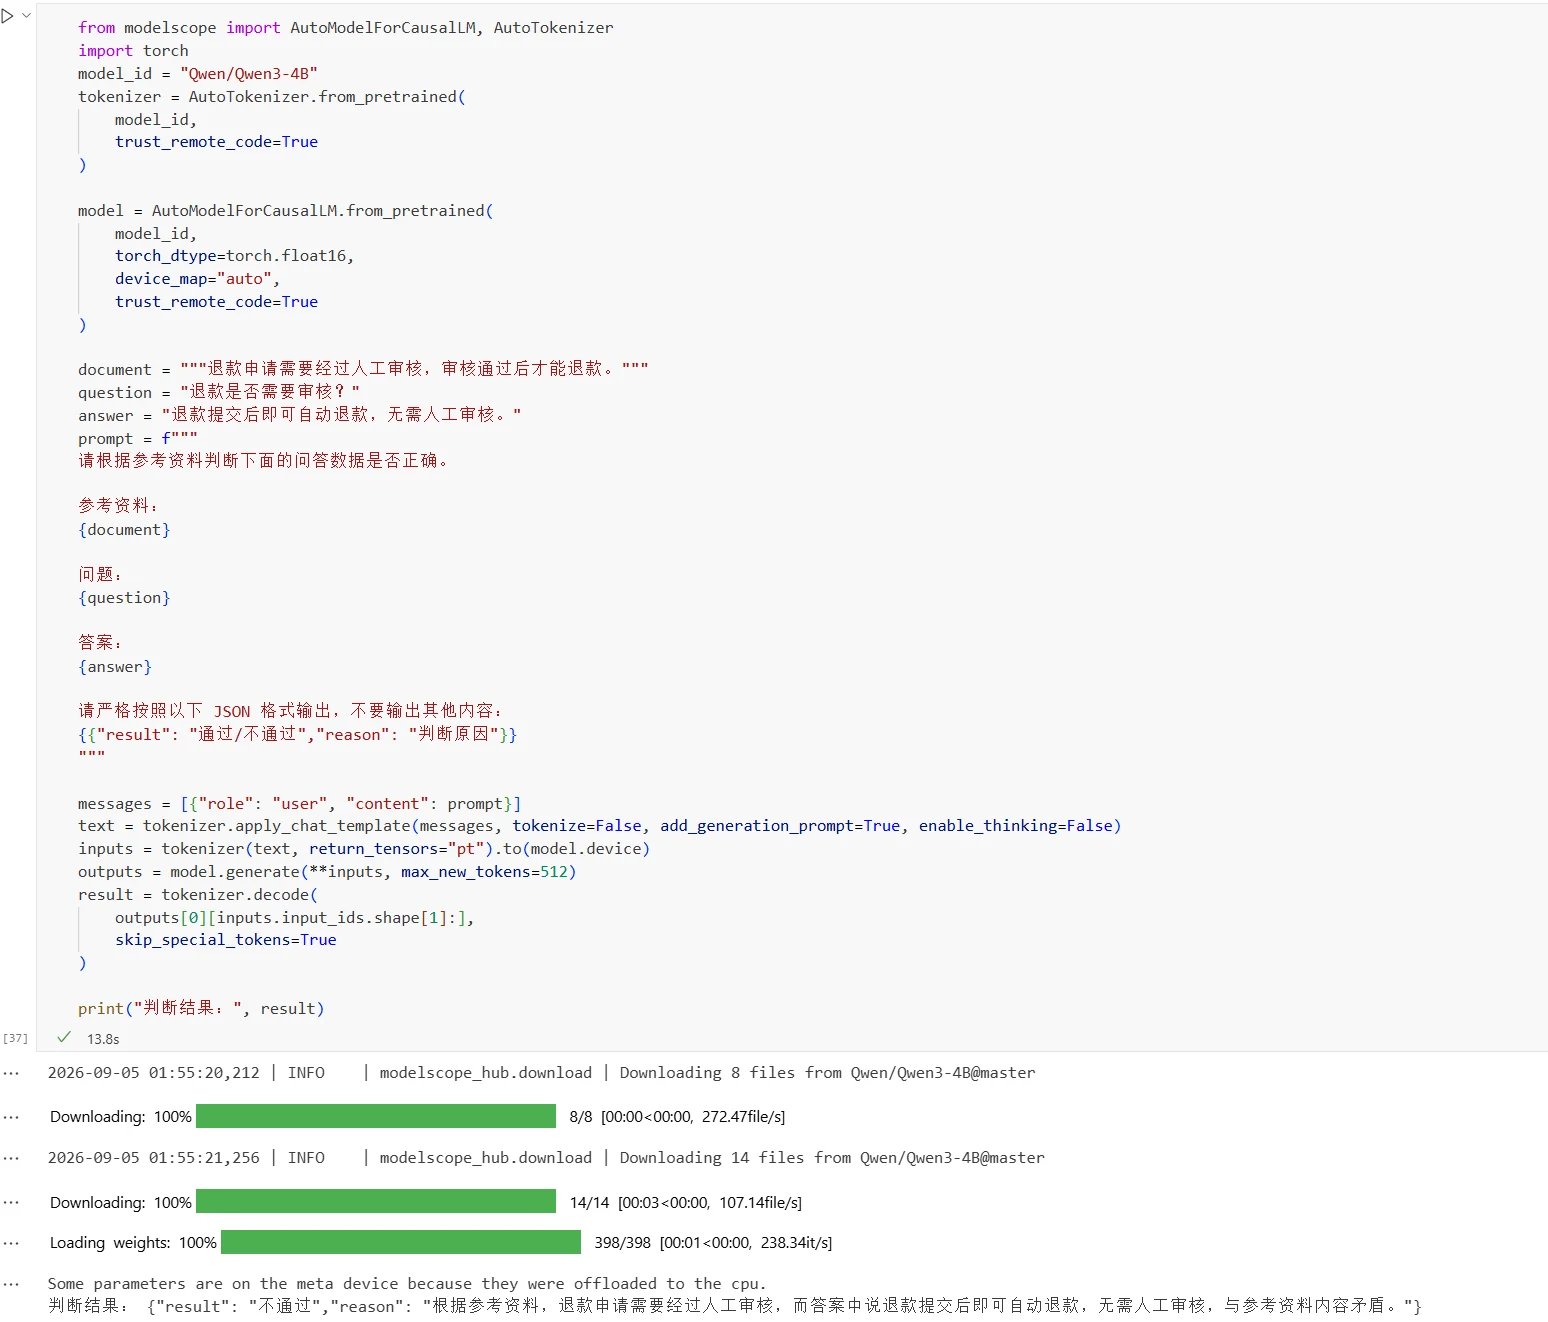
Na prática, você pode usar um grande modelo para realizar uma avaliação de consistência nos dados sintetizados. Insira o material original, a pergunta e a resposta no modelo simultaneamente para determinar se a resposta está consistente com o material. Para dados julgados como incorretos, eles podem ser deletados ou regenerados. O código de processamento é o seguinte:
from modelscope import AutoModelForCausalLM, AutoTokenizer
import torch
model_id = "Qwen/Qwen3-4B"
tokenizer = AutoTokenizer.from_pretrained(
    model_id,
    trust_remote_code=True
)

model = AutoModelForCausalLM.from_pretrained(
    model_id,
    torch_dtype=torch.float16,
    device_map="auto",
    trust_remote_code=True
)

document = """Solicitações de reembolso requerem revisão manual, e reembolsos só podem ser processados após aprovação."""
question = "Uma solicitação de reembolso requer revisão?"
answer = "Reembolsos são processados automaticamente após o envio, sem necessidade de revisão manual."
prompt = f"""
Por favor, determine se os seguintes dados de perguntas e respostas estão corretos com base no material de referência.

Material de referência:
{document}

Pergunta:
{question}

Resposta:
{answer}

Por favor, produza estritamente no seguinte formato JSON e não produza nenhum outro conteúdo:
{{"result": "aprovado/reprovado","reason": "motivo do julgamento"}}
"""

messages = [{"role": "user", "content": prompt}]
text = tokenizer.apply_chat_template(messages, tokenize=False, add_generation_prompt=True, enable_thinking=False)
inputs = tokenizer(text, return_tensors="pt").to(model.device)
outputs = model.generate(**inputs, max_new_tokens=512)
result = tokenizer.decode(
    outputs[0][inputs.input_ids.shape[1]:],
    skip_special_tokens=True
)

print("Resultado do julgamento:", result)
Resultados:
Não deixe o modelo inventar coisas que não estão no texto original
Quando um grande modelo gera dados, ele pode produzir informações que não existem nos materiais originais. Este problema é comumente chamado de alucinação. Por exemplo, gerar nomes de produtos, parâmetros de produtos ou processos de negócios inexistentes.
Por exemplo, o material original afirma:
O produto suporta no máximo 100GB de espaço de armazenamento.
Dados gerados:
P: O produto suporta escalonamento automático?
R: Sim, o sistema escalonará automaticamente quando o espaço de armazenamento for insuficiente
O material original não afirma se o produto suporta escalonamento automático. Portanto, a resposta gerada falta base no material original e constitui informação fabricada.
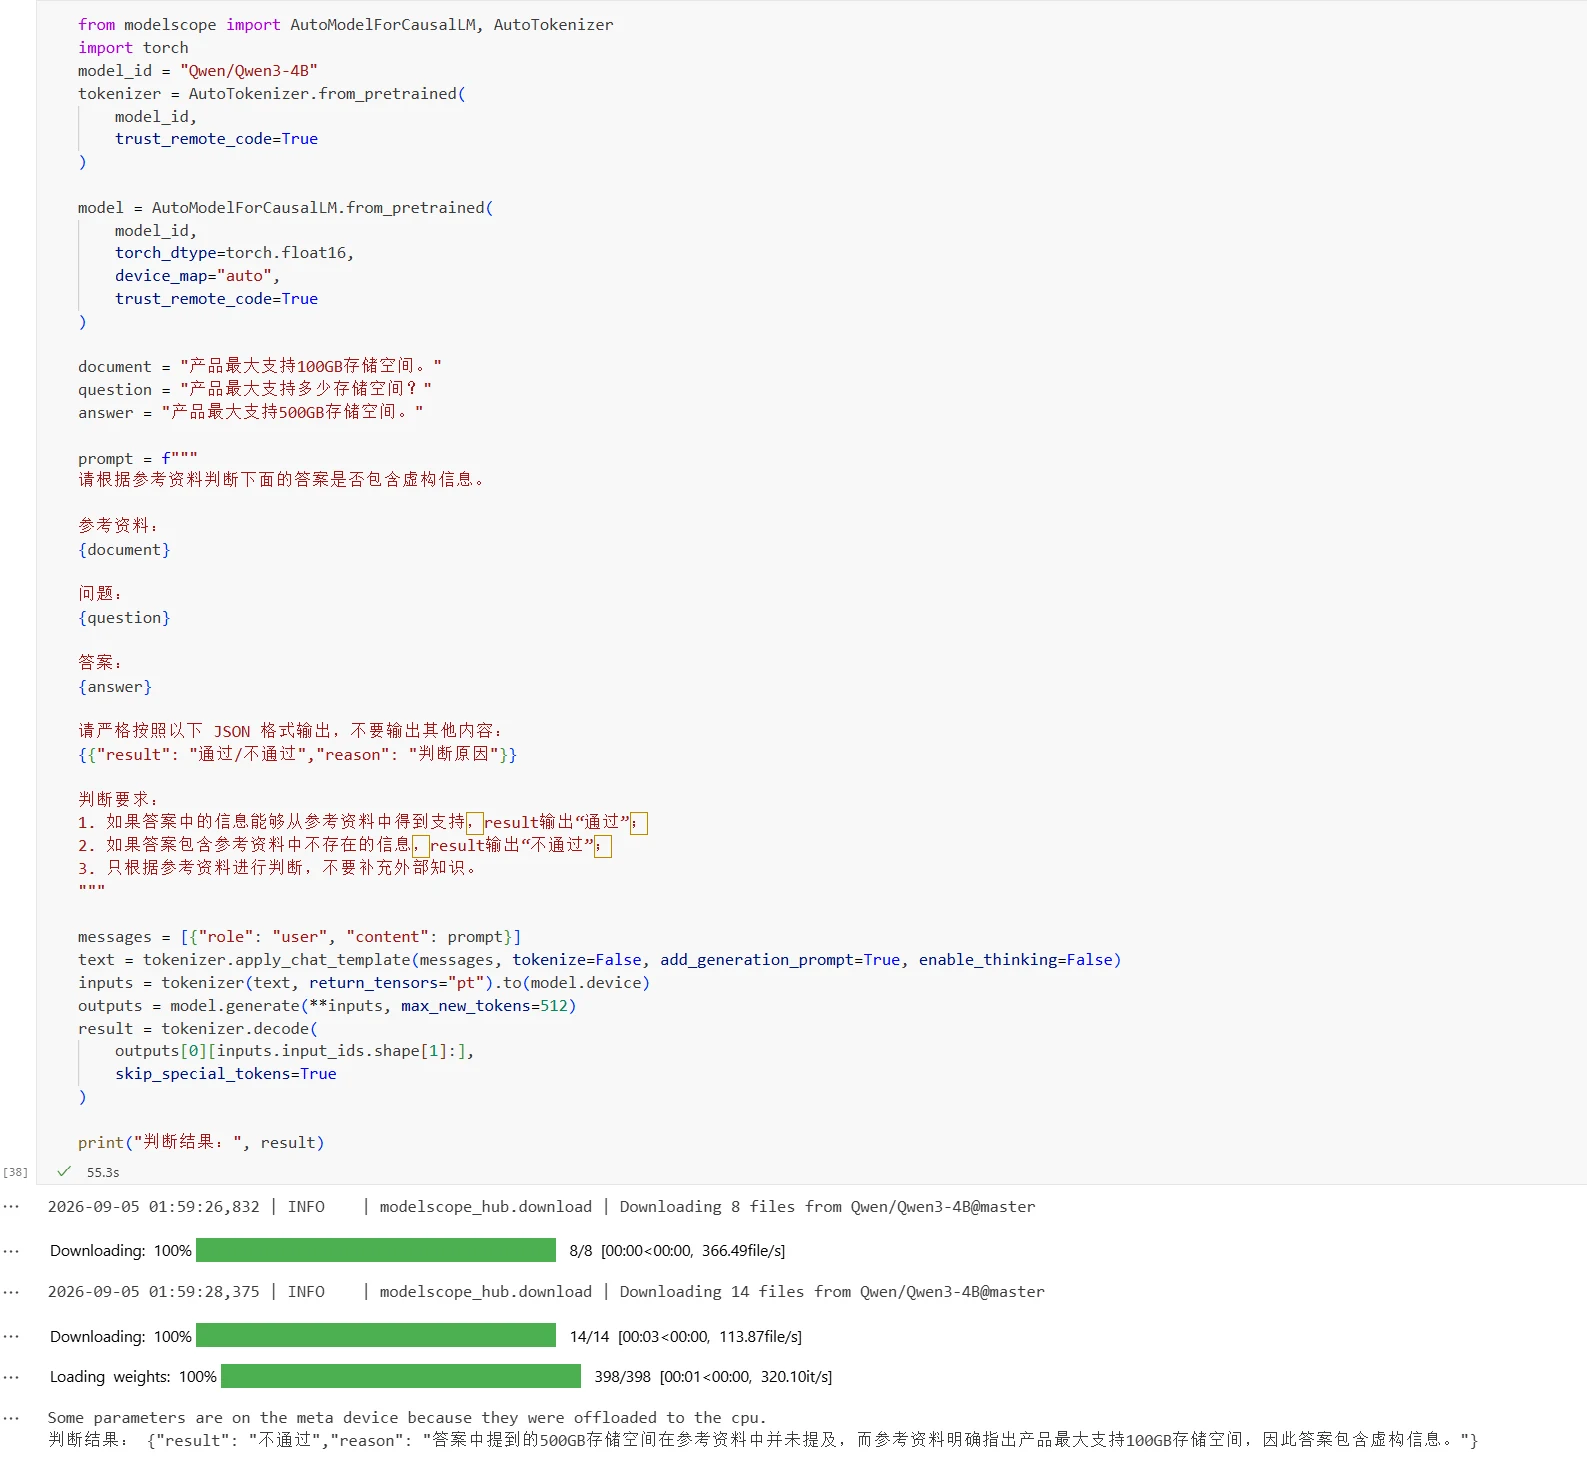
Para dados gerados com base em materiais de negócios, você pode usar um grande modelo para verificação de base para determinar se as informações chave da resposta podem ser suportadas pelos materiais originais. Para dados que faltam base ou que não podem ser confirmados, eles podem ser deletados, regenerados ou revisados manualmente. Quando regras de negócias importantes estão envolvidas, o pessoal de negócios também pode realizar verificações aleatórias. O código de processamento é o seguinte:
from modelscope import AutoModelForCausalLM, AutoTokenizer
import torch
model_id = "Qwen/Qwen3-4B"
tokenizer = AutoTokenizer.from_pretrained(
    model_id,
    trust_remote_code=True
)

model = AutoModelForCausalLM.from_pretrained(
    model_id,
    torch_dtype=torch.float16,
    device_map="auto",
    trust_remote_code=True
)

document = "O produto suporta no máximo 100GB de espaço de armazenamento."
question = "Qual é o espaço de armazenamento máximo que o produto suporta?"
answer = "O produto suporta no máximo 500GB de espaço de armazenamento."

prompt = f"""
Por favor, determine se a seguinte resposta contém informações fabricadas com base no material de referência.

Material de referência:
{document}

Pergunta:
{question}

Resposta:
{answer}

Por favor, produza estritamente no seguinte formato JSON e não produza nenhum outro conteúdo:
{{"result": "aprovado/reprovado","reason": "motivo do julgamento"}}

Requisitos de julgamento:
1. Se as informações da resposta puderem ser suportadas pelo material de referência, o resultado produz "aprovado";
2. Se a resposta contiver informações que não existem no material de referência, o resultado produz "reprovado";
3. Julgue apenas com base no material de referência, não complemente com conhecimento externo.
"""

messages = [{"role": "user", "content": prompt}]
text = tokenizer.apply_chat_template(messages, tokenize=False, add_generation_prompt=True, enable_thinking=False)
inputs = tokenizer(text, return_tensors="pt").to(model.device)
outputs = model.generate(**inputs, max_new_tokens=512)
result = tokenizer.decode(
    outputs[0][inputs.input_ids.shape[1]:],
    skip_special_tokens=True
)

print("Resultado do julgamento:", result)
Resultados:
Reformular pode ainda ser a mesma pergunta
Quando um grande modelo gera dados em lote, é fácil produzir amostras duplicadas ou muito semelhantes. Por exemplo: "Como alterar a senha de login?" e "Como posso mudar minha senha de login?" Estas perguntas têm expressões diferentes, mas basicamente o mesmo conteúdo. Se houver muitas amostras semelhantes, isso reduz o conteúdo informacional efetivo do conjunto de dados.
Após sintetizar dados, você precisa verificar duplicatas e semelhanças entre amostras, filtrar dados completamente duplicados, controlar o número de amostras muito semelhantes e reter amostras representativas. Métodos específicos de deduplicação de dados serão introduzidos nas seções seguintes.
Consolide dados de diferentes fontes
Seja de conjuntos de dados de código aberto, dados de negócios da empresa ou síntese de grandes modelos, eles precisam de processamento unificado antes de serem usados para o treinamento do modelo. Etapas comuns de processamento incluem coleta de dados, limpeza de dados, deduplicação de dados e anonimização de dados.
Primeiro colete o conteúdo necessário e unifique os campos
A coleta de dados envolve obter os dados necessários de diferentes fontes de dados de acordo com a tarefa de treinamento e organizá-los uniformemente.
Antes da coleta, você precisa determinar o conteúdo de dados requerido pela tarefa de treinamento. Tarefas de classificação precisam de texto e rótulos de categoria, tarefas de perguntas e respostas precisam de perguntas e respostas, e ajuste fino de instrução precisa de instruções e as respostas correspondentes. Durante a coleta, retenha apenas dados e campos relacionados à tarefa de treinamento.
As estruturas de dados de diferentes fontes podem diferir. Por exemplo, um conjunto de dados usa os campos question e answer, enquanto outro pode usar os campos query e response. Após a coleta, os nomes dos campos e as estruturas de dados precisam ser unificados para processamento posterior.
Para dados que faltam informações necessárias, elas podem ser complementadas durante a coleta. Por exemplo, adicionando rótulos de categoria para dados de classificação, ou organizando respostas de referência para dados de perguntas e respostas.
Dados precisam ser limpos primeiro
Dados brutos podem conter conteúdo inválido ou incorreto, que precisa ser limpo antes do treinamento.
Processamento comum inclui: remoção de dados vazios e registros inválidos, remoção de tags HTML e caracteres especiais excessivos, padronização de codificação e formato de texto, e correção de erros óbvios de reconhecimento OCR, etc.
A limpeza de dados não significa deletar todo conteúdo especial. Código, fótomas, unidades e pontuação podem ser parte do conteúdo de treinamento, e se devem ser retidos depende da tarefa específica.
Usando um conjunto de dados de FAQ como exemplo, os dados originais:
faq_data = [
    {
        "question": "  Como alterar a senha de login?  ",
        "answer": "<p>Vá ao centro pessoal e clique em 'Alterar Senha'.</p>"
    },
    {
        "question": "",
        "answer": "Por favor, entre em contato com o administrador."
    },
    {
        "question": "E se eu esquecer minha senha?",
        "answer": "Clique em 'Esqueci Minha Senha'\n\ne siga as instruções."
    },
    {
        "question": "Qual é o número de telefone do atendimento ao cliente?",
        "answer": "O número do atendimento ao cliente é 400-123-4567\xa0"
    }
]
Código de limpeza:
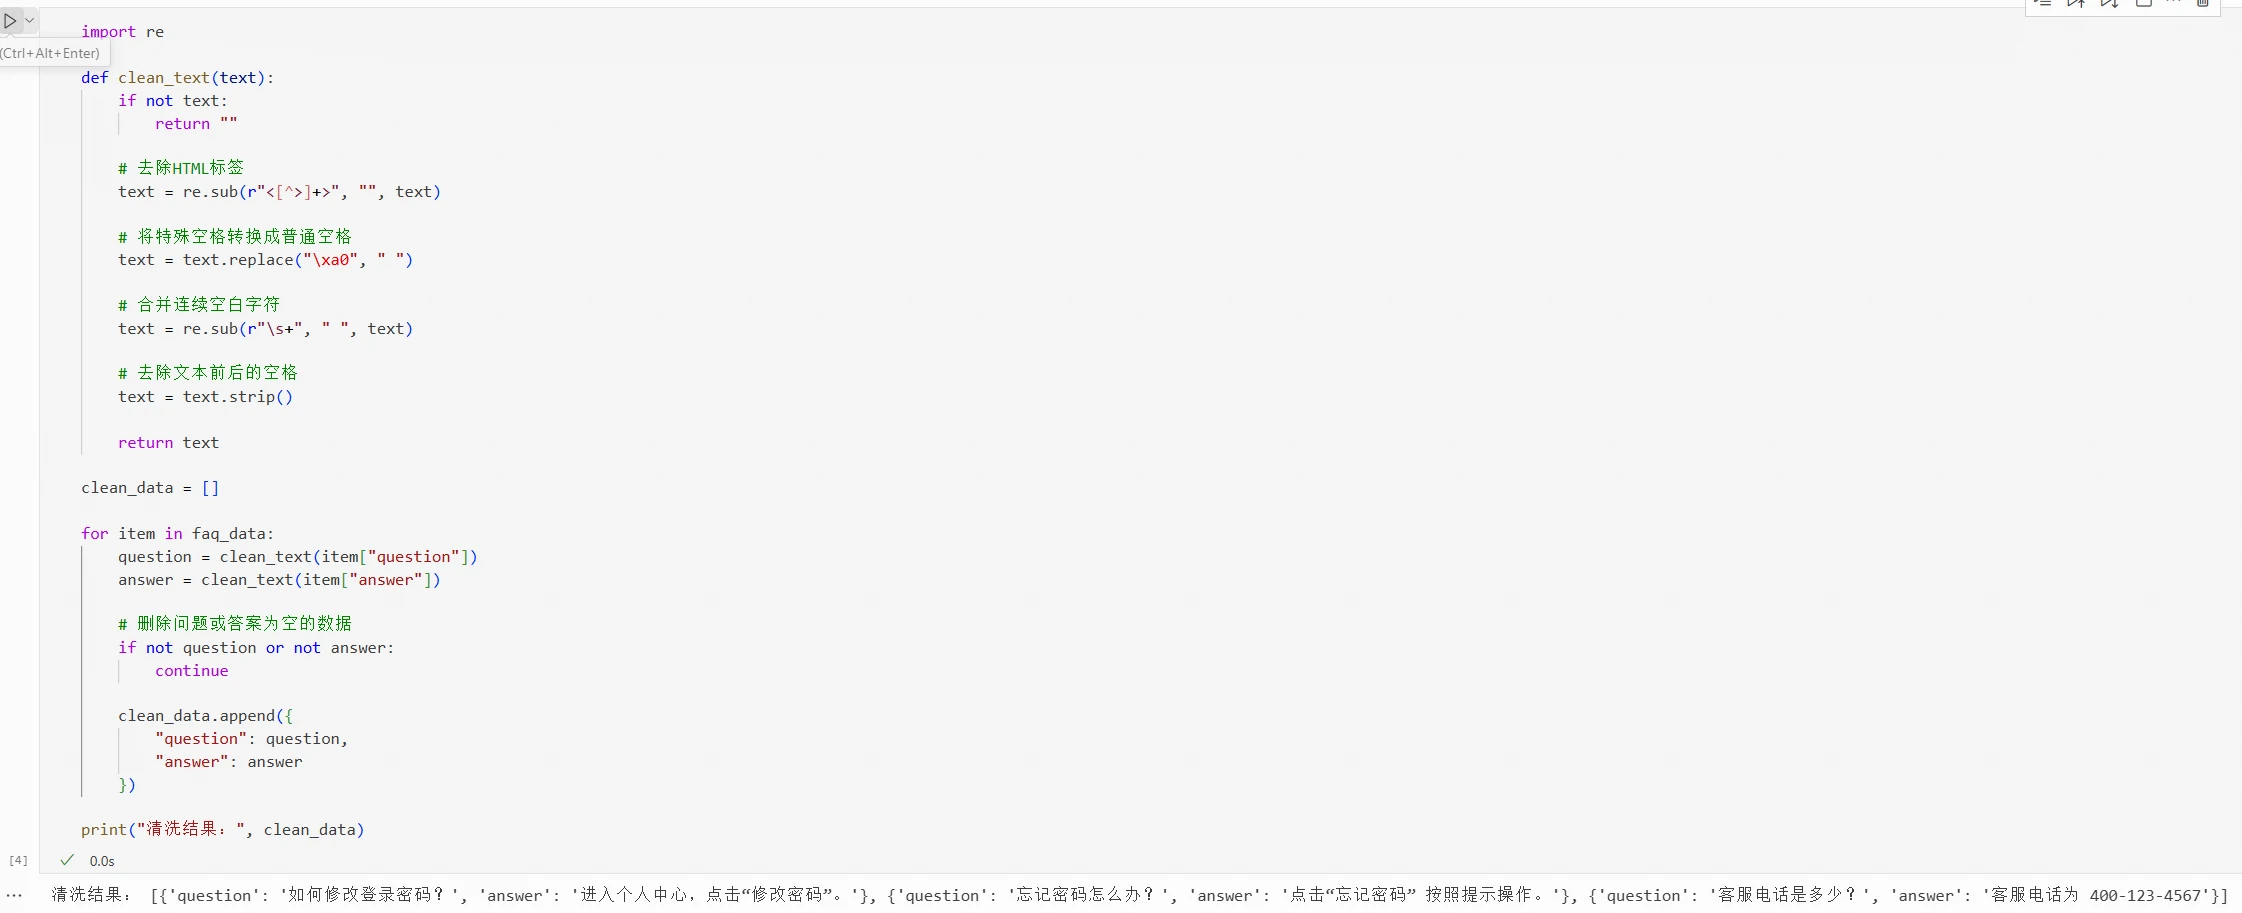
import re

def clean_text(text):
    if not text:
        return ""

    # Remover tags HTML
    text = re.sub(r"<[^>]+>", "", text)

    # Converter espaços especiais em espaços normais
    text = text.replace("\xa0", " ")

    # Mesclar caracteres de espaço consecutivos
    text = re.sub(r"\s+", " ", text)

    # Remover espaços do início e fim do texto
    text = text.strip()

    return text

clean_data = []

for item in faq_data:
    question = clean_text(item["question"])
    answer = clean_text(item["answer"])

    # Deletar dados onde a pergunta ou resposta está vazia
    if not question or not answer:
        continue

    clean_data.append({
        "question": question,
        "answer": answer
    })

print("Resultado da limpeza:", clean_data)
Resultados da limpeza:
As regras de limpeza específicas em negócios reais precisam ser determinadas de acordo com as características dos dados.
Precisa realmente manter todos os dados duplicados?
Após consolidar os dados coletados de diferentes fontes, dados duplicados ou semelhantes podem aparecer. A mesma FAQ pode aparecer simultaneamente em conjuntos de dados públicos, manuais de produtos e bases de conhecimento de atendimento ao cliente. Dados sintetizados também podem ser semelhantes ao conteúdo de dados existentes. Se houver muitos dados duplicados, isso reduz a diversidade dos dados de treinamento, fazendo o modelo sobre-aprender certo conhecimento ou expressões. Portanto, uma deduplicação unificada é necessária antes do treinamento.
De acordo com o grau de duplicação dos dados, a deduplicação de dados pode ser dividida em deduplicação de dados exatos e deduplicação de dados semelhantes:
Deduplicação de dados exatos: Determine se duas peças de dados têm exatamente o mesmo conteúdo. A deduplicação pode ser realizada por correspondência de texto ou valores hash.
Deduplicação de dados semelhantes: Determine se duas peças de dados têm conteúdo semelhante apesar de redações diferentes. Métodos como MinHash, SimHash ou similaridade vetorial podem ser usados para detecção.
Diferentes tipos de dados requerem diferentes regras de deduplicação. Usando um conjunto de dados de FAQ como exemplo, a pergunta e a resposta podem ser combinadas em um único texto, e então determinar se diferentes amostras são duplicatas ou semelhantes.
Deduplicação de dados exatos
Amostras de dados:
faq_data = [
    {
        "question": "Como alterar a senha de login?",
        "answer": "Vá ao centro pessoal e clique em 'Alterar Senha'."
    },
    {
        "question": "E se eu esquecer minha senha?",
        "answer": "Clique em 'Esqueci Minha Senha' e siga as instruções."
    },
    {
        "question": "Como alterar a senha de login?",
        "answer": "Vá ao centro pessoal e clique em 'Alterar Senha'."
    }
]
(1) Correspondência de texto
Código de deduplicação por correspondência de texto:
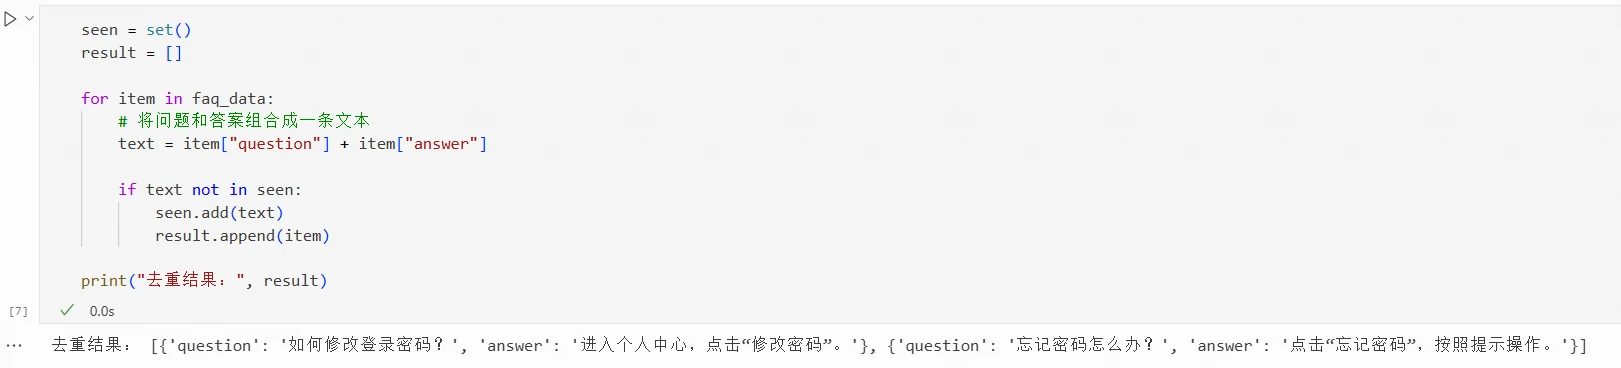
seen = set()
result = []

for item in faq_data:
    # Combinar pergunta e resposta em um único texto
    text = item["question"] + item["answer"]

    if text not in seen:
        seen.add(text)
        result.append(item)

print("Resultado da deduplicação:", result)
Resultados da deduplicação:
Após o processamento, apenas uma das duas FAQs idênticas é retida.
(2) Valores hash
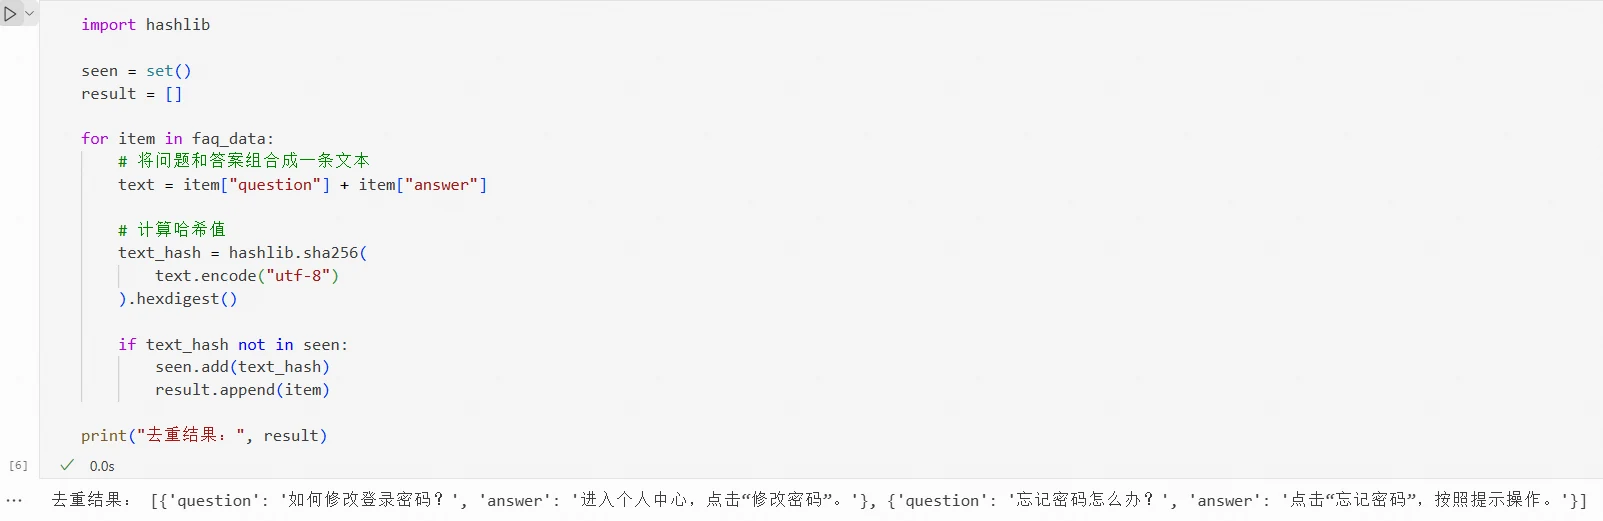
Um algoritmo hash pode converter um texto em um valor de comprimento fixo. Texto idêntico produzirá o mesmo valor hash, permitindo determinar se os dados são duplicados comparando valores hash. Por exemplo:
import hashlib

seen = set()
result = []

for item in faq_data:
    # Combinar pergunta e resposta em um único texto
    text = item["question"] + item["answer"]

    # Calcular valor hash
    text_hash = hashlib.sha256(
        text.encode("utf-8")
    ).hexdigest()

    if text_hash not in seen:
        seen.add(text_hash)
        result.append(item)

print("Resultado da deduplicação:", result)
Resultados da deduplicação:
Valores hash comuns só podem ser usados para determinar se o conteúdo é exatamente o mesmo. Assim que o texto na pergunta ou resposta muda, o valor hash calculado será diferente. Para dados com redação diferente mas conteúdo semelhante, uma avaliação adicional de similaridade é necessária.
Deduplicação de dados semelhantes
Amostras de dados:
faq_data = [
    {
        "question": "Como alterar a senha de login?",
        "answer": "Vá ao centro pessoal e clique em 'Alterar Senha'."
    },
    {
        "question": "Como posso mudar minha senha de login?",
        "answer": "Depois de ir ao centro pessoal, clique em 'Alterar Senha'."
    },
    {
        "question": "Como solicitar uma fatura?",
        "answer": "Vá à página de pedidos, selecione solicitação de fatura e envie as informações."
    }
]
As perguntas e respostas das duas primeiras FAQs diferem na redação, mas expressam um conteúdo relativamente semelhante no geral. Para esses dados, MinHash, SimHash ou similaridade vetorial podem ser usados para detecção.
(1) MinHash
MinHash determina principalmente a similaridade com base na sobreposição de palavras ou caracteres no texto, tornando-o mais adequado para detectar dados literalmente semelhantes. Para dados de FAQ, você pode primeiro combinar a pergunta e a resposta em um único texto, e então dividir o texto em palavras, caracteres ou fragmentos de caracteres para cálculo.
MinHash é tipicamente usado para aproximar a similaridade de Jaccard:
J(A,B)=\frac{|A\cap B|}{|A\cup B|}
onde A e B representam os conjuntos de palavras ou caracteres contidos em dois textos,
A\cap B
representa o conteúdo compartilhado por ambos,
A\cup B
representa todo o conteúdo contido em ambos. O resultado do cálculo está entre 0 e 1, onde valores mais próximos de 1 indicam que os dois textos são mais semelhantes.
Em Python, a biblioteca datasketch pode ser usada para implementar MinHash:
!pip install datasketch
Resultados:
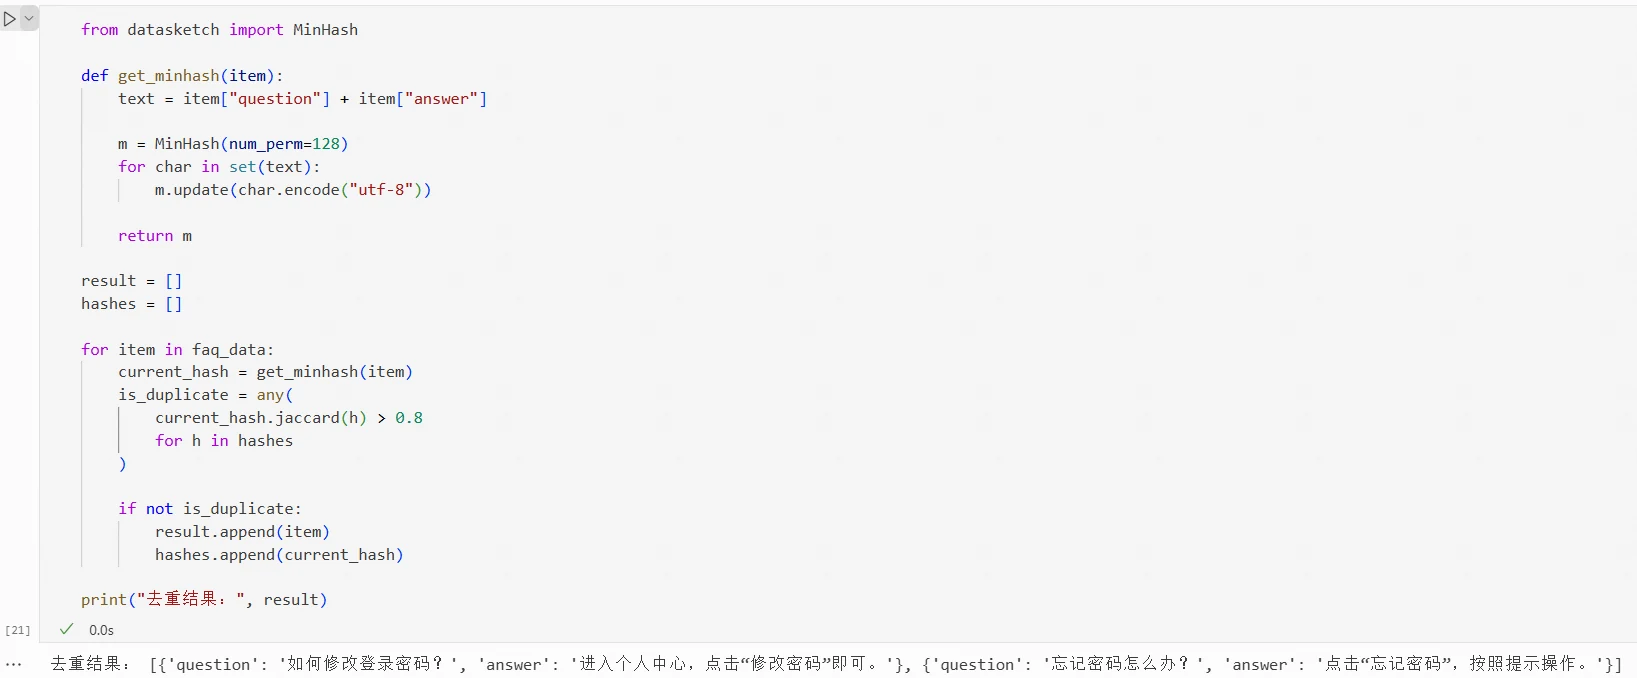
Código de exemplo:
from datasketch import MinHash

def get_minhash(item):
    text = item["question"] + item["answer"]

    m = MinHash(num_perm=128)
    for char in set(text):
        m.update(char.encode("utf-8")

    return m

result = []
hashes = []

for item in faq_data:
    current_hash = get_minhash(item)

    is_duplicate = any(
        current_hash.jaccard(h) > 0.8
        for h in hashes
    )

    if not is_duplicate:
        result.append(item)
        hashes.append(current_hash)

print("Resultado da deduplicação:", result)
Resultados:
(2) SimHash
SimHash gera uma impressão digital de comprimento fixo com base no conteúdo do texto, e então usa a distância de Hamming entre as impressões digitais para determinar se os textos são semelhantes.
Diferente do Hash comum, que determina principalmente se o conteúdo é exatamente o mesmo, SimHash pode detectar textos com conteúdo semelhante. Quanto menor a distância de Hamming entre duas impressões digitais de SimHash, mais semelhantes são os textos em geral.
SimHash precisa ser instalado:
!pip install simhash
Resultados:
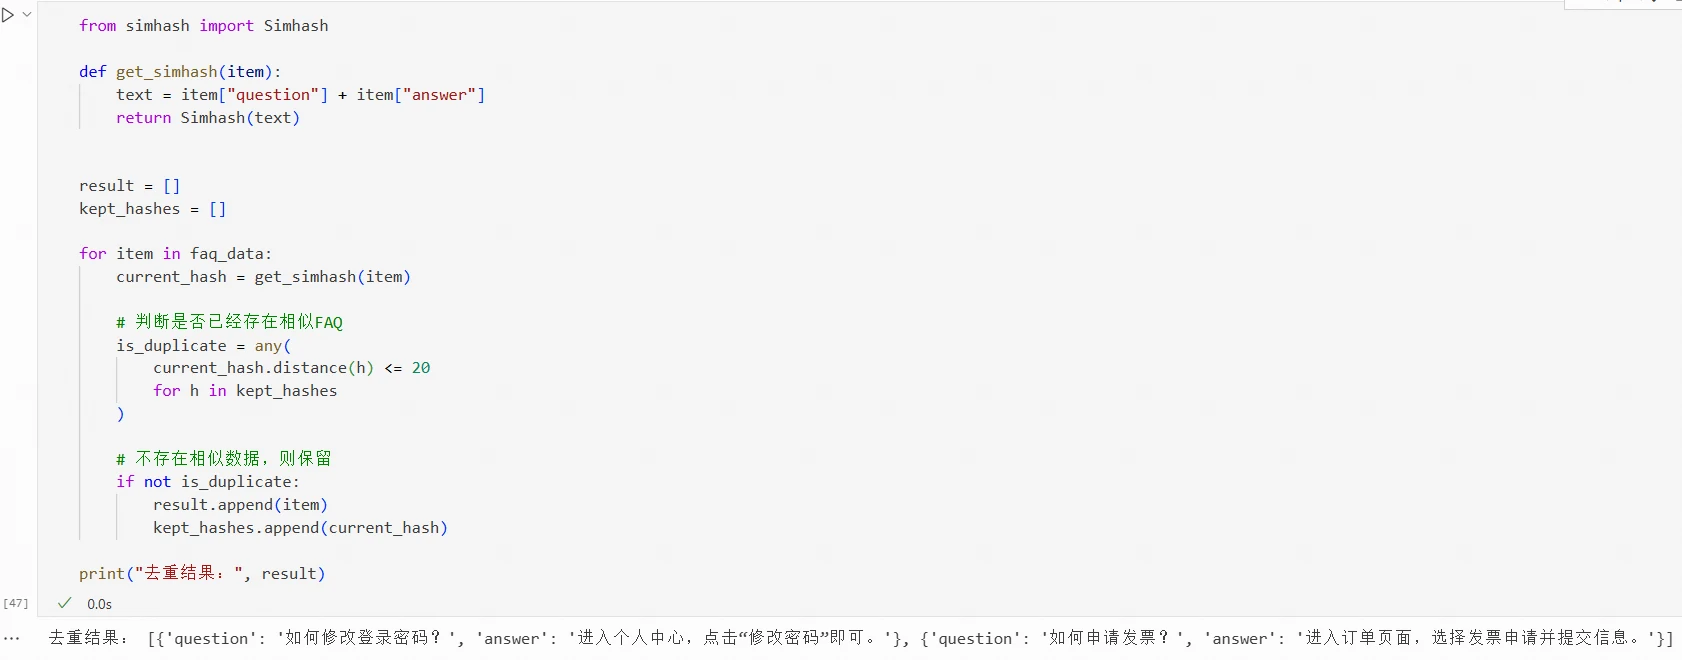
Código para usar SimHash para remover dados semelhantes:
from simhash import Simhash

def get_simhash(item):
    text = item["question"] + item["answer"]
    return Simhash(text)

result = []
kept_hashes = []

for item in faq_data:
    current_hash = get_simhash(item)

    # Verificar se já existe uma FAQ semelhante
    is_duplicate = any(
        current_hash.distance(h) <= 20
        for h in kept_hashes
    )

    # Se não houver dados semelhantes, reter
    if not is_duplicate:
        result.append(item)
        kept_hashes.append(current_hash)

print("Resultado da deduplicação:", result)
Resultados:
(3) Similaridade vetorial
Se duas peças de dados usam palavras diferentes mas expressam semânticas semelhantes, um modelo de vetores de texto pode ser usado para avaliação.
Um modelo de vetores de texto converte texto em um vetor composto por um conjunto de valores numéricos. Para dados de FAQ, combine a pergunta e a resposta em um único texto, e então calcule a similaridade cosseno entre os dois vetores de texto:
onde A e B representam os vetores de texto correspondentes às duas FAQs. Quanto maior a similaridade cosseno, mais próximas são as semânticas das duas FAQs.
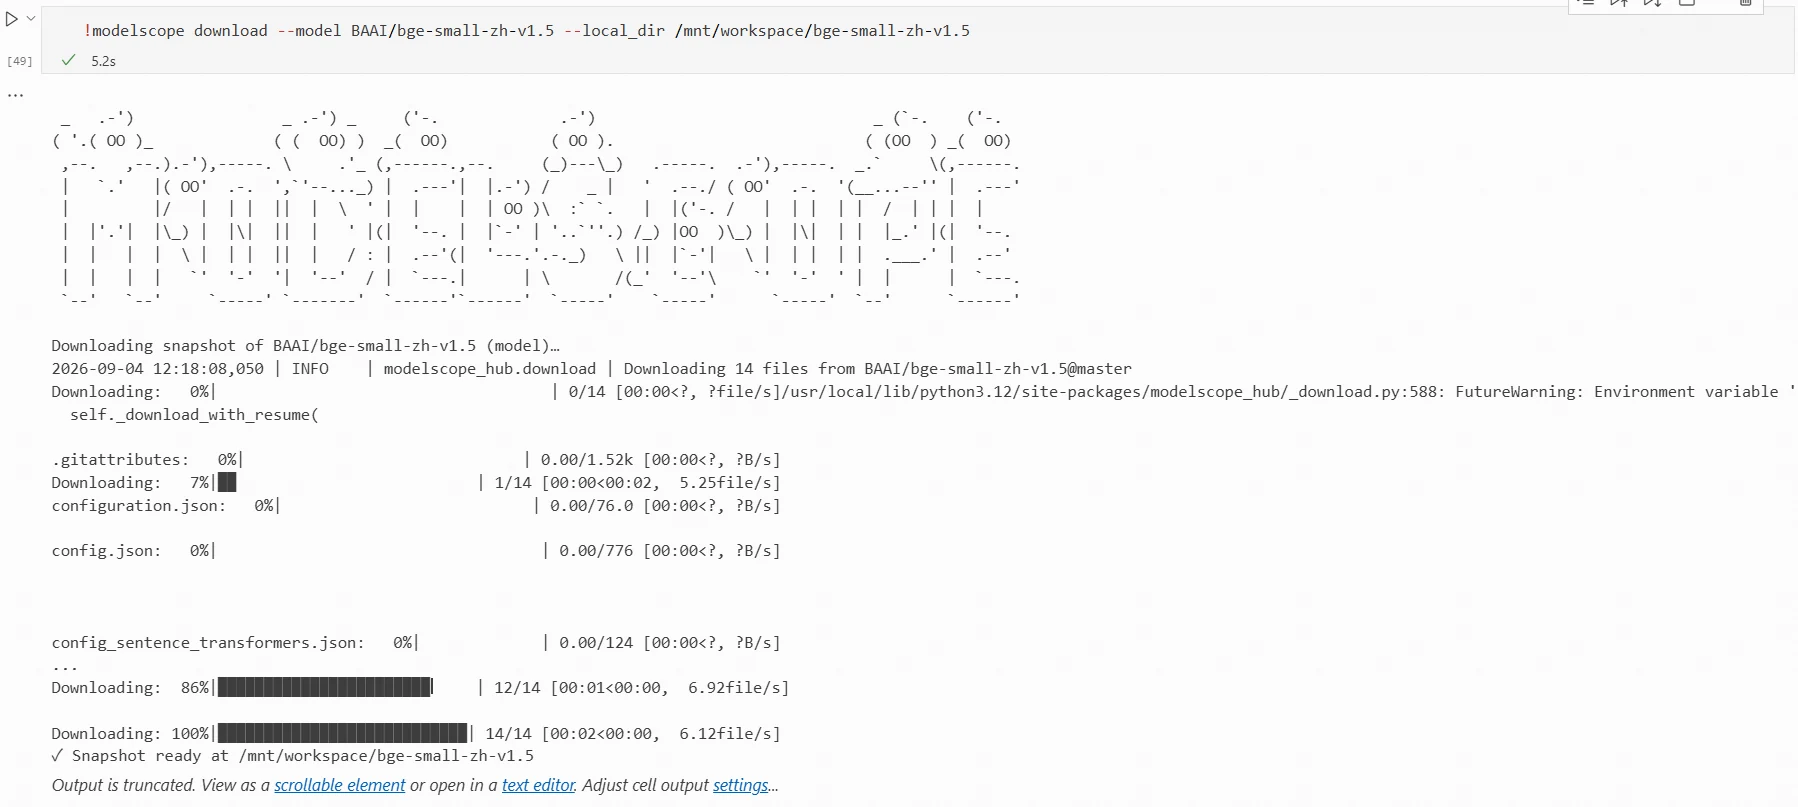
Abaixo, o modelo BAAI/bge-small-zh-v1.5 é usado para cálculo. Este modelo é projetado para tarefas de vetores de texto chinês, com tamanho de modelo de aproximadamente 24M, dimensão de vetor de saída de 512, e é relativamente pequeno e rápido.
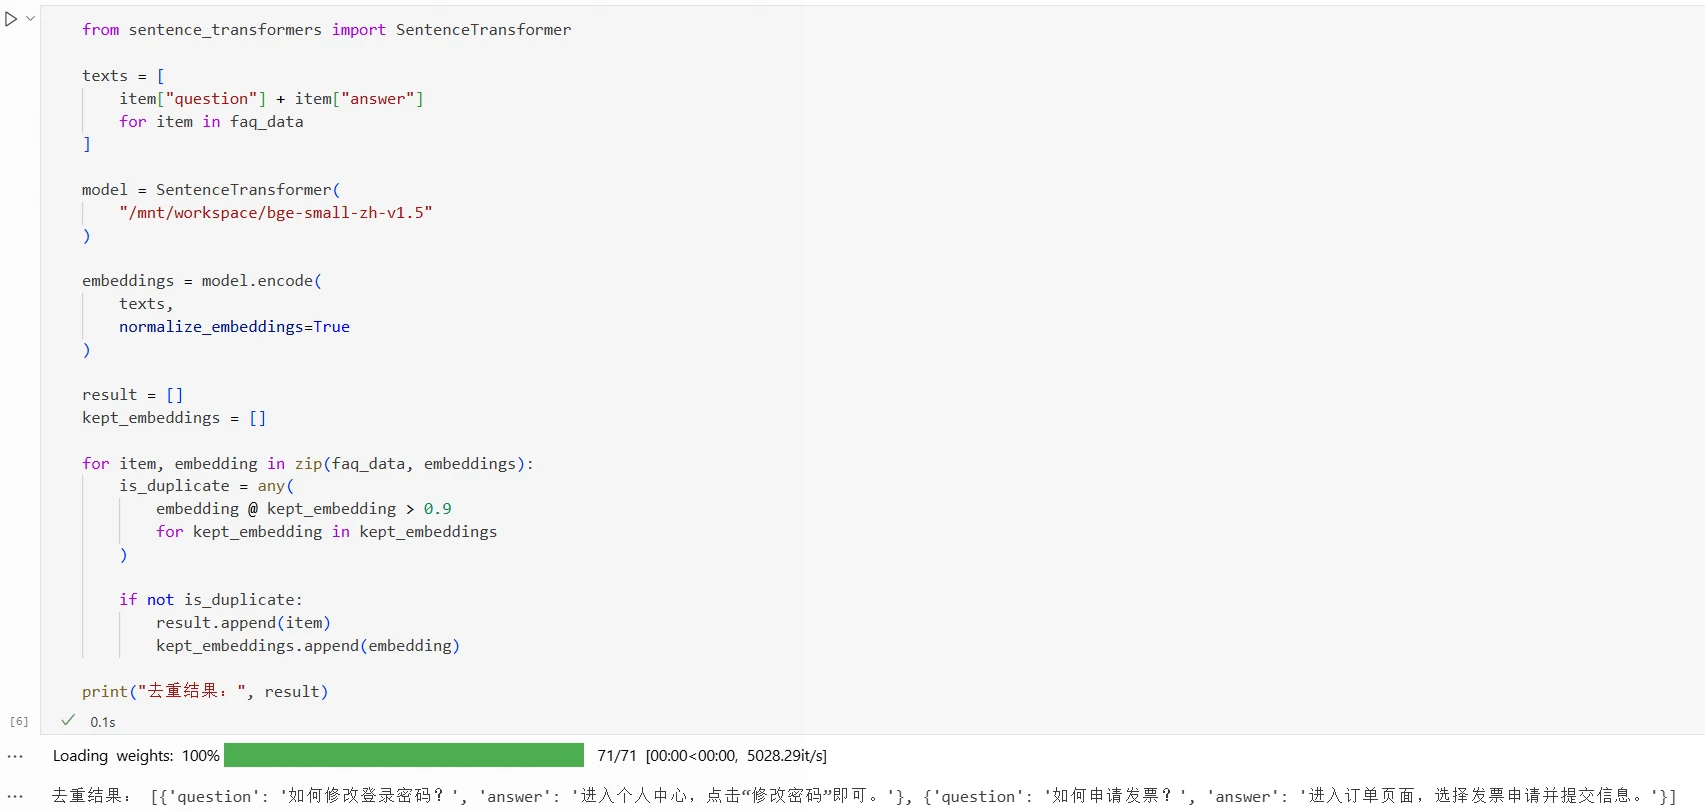
Código para calcular similaridade vetorial e remover dados semelhantes:
from sentence_transformers import SentenceTransformer

texts = [
    item["question"] + item["answer"]
    for item in faq_data
]

model = SentenceTransformer(
    "/mnt/workspace/bge-small-zh-v1.5"
)

embeddings = model.encode(
    texts,
    normalize_embeddings=True
)

result = []
kept_embeddings = []

for item, embedding in zip(faq_data, embeddings):
    is_duplicate = any(
        embedding @ kept_embedding > 0.9
        for kept_embedding in kept_embeddings
    )

    if not is_duplicate:
        result.append(item)
        kept_embeddings.append(embedding)

print("Resultado da deduplicação:", result)
Resultados:
Diferentes métodos são adequados para diferentes tipos de deduplicação de dados:
Método
Basis para o julgamento
Cenários adequados
Correspondência direta de texto
Se o texto é exatamente o mesmo
Pequena quantidade de dados idênticos
Hash
Se os valores hash do texto são idênticos
Grande quantidade de dados idênticos
MinHash
Sobreposição de palavras ou caracteres no texto
Dados com similaridade de conteúdo literal
SimHash
Distância de Hamming entre impressões digitais de texto
Dados com similaridade de conteúdo geral mas modificações menores
Similaridade vetorial
Similaridade semântica do texto
Dados com expressões diferentes mas significados semelhantes
Na prática, você pode primeiro remover dados exatamente duplicados por correspondência de texto ou Hash, e então usar MinHash, SimHash ou similaridade vetorial para detectar dados semelhantes. Para dados semelhantes detectados, você precisa decidir deletar, mesclar ou reter de acordo com o limite de similaridade e requisitos de negócios para evitar deletar acidentalmente dados com valor de treinamento.
Informações reais precisam de anonimização antes do treinamento
Dados de negócios da empresa podem conter informações sensíveis como nomes, números de telefone, números de identificação, endereços e números de conta. Antes de entrar no conjunto de dados de treinamento, este conteúdo precisa ser anonimizado de acordo com os requisitos de segurança de dados.
A anonimização de dados requer primeiro identificar informações sensíveis nos dados, e então selecionar métodos de processamento apropriados com base no tipo de informação sensível.
Métodos para identificar informações sensíveis
Antes de realizar a anonimização, você precisa determinar qual conteúdo nos dados pertence a informações sensíveis. Para dados de texto, expressões regulares ou modelos de reconhecimento de informações sensíveis podem ser usados para identificação.
(1) Usando expressões regulares
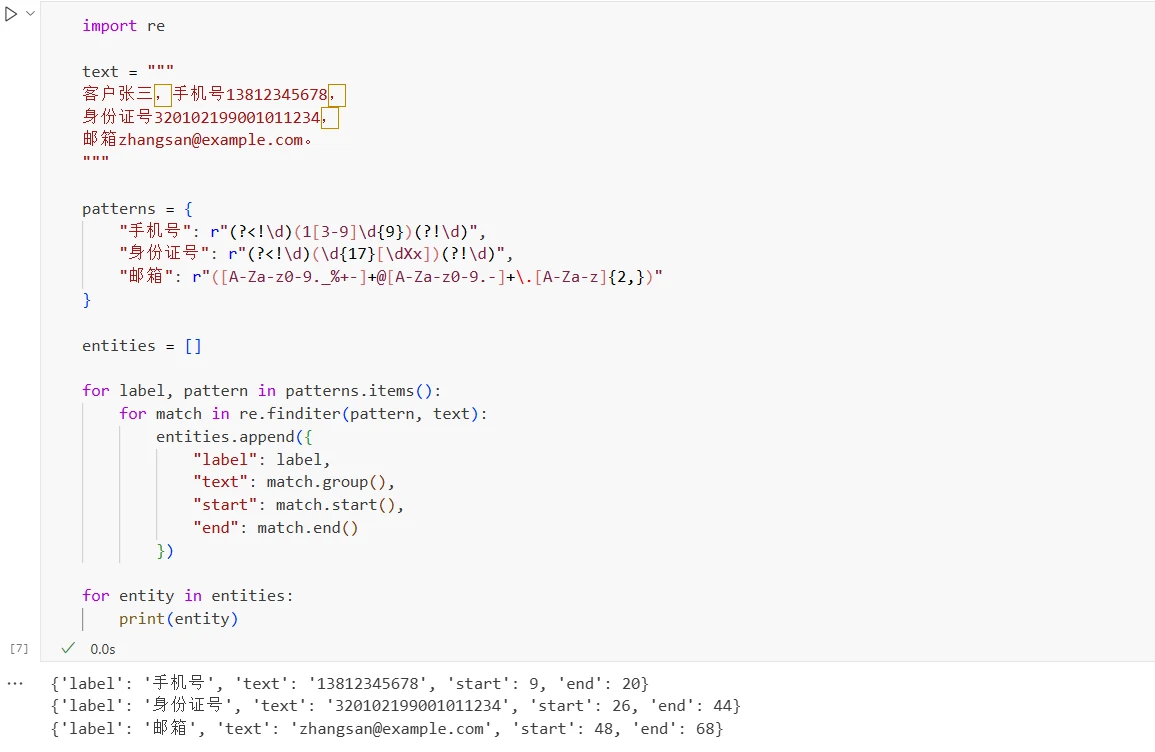
Expressões regulares correspondem ao texto com base em regras de formato predefinidas, tornando-as adequadas para identificar informações com formato fixo, como números de telefone, números de identificação, números de cartão bancário e endereços de e-mail. Código para usar expressões regulares para identificar informações sensíveis:
import re

text = """
Cliente Zhang San, número de telefone 13812345678,
número de identificação 320102199001011234,
e-mail zhangsan@example.com.
"""

patterns = {
    "telefone": r"(?<!\d)(1[3-9]\d{9})(?!\d)",
    "número_id": r"(?<!\d)(\d{17}[\dXx])(?!\d)",
    "e-mail": r"([A-Za-z0-9._%+-]+@[A-Za-z0-9.-]+\.[A-Za-z]{2,})"
}

entities = []

for label, pattern in patterns.items():
    for match in re.finditer(pattern, text):
        entities.append({
            "label": label,
            "text": match.group(),
            "start": match.start(),
            "end": match.end()
        })

for entity in entities:
    print(entity)
Resultados de execução:
Expressões regulares podem obter o conteúdo, o tipo e a posição de informações sensíveis no texto original, que podem ser usados para processamento de anonimização posterior. Expressões regulares baseiam-se principalmente em características de formato e são eficazes para informações com formato fixo. Na prática, regras correspondentes precisam ser desenvolvidas e testadas com base no formato dos dados de negócios. Para informações como nomes e endereços que requerem compreensão contextual, expressões regulares sozinhas são difíceis de identificar com precisão.
(2) Usando modelos de reconhecimento de informações sensíveis
Para informações como nomes, endereços e organizações que requerem compreensão semântica, modelos de reconhecimento de informações sensíveis podem ser usados.
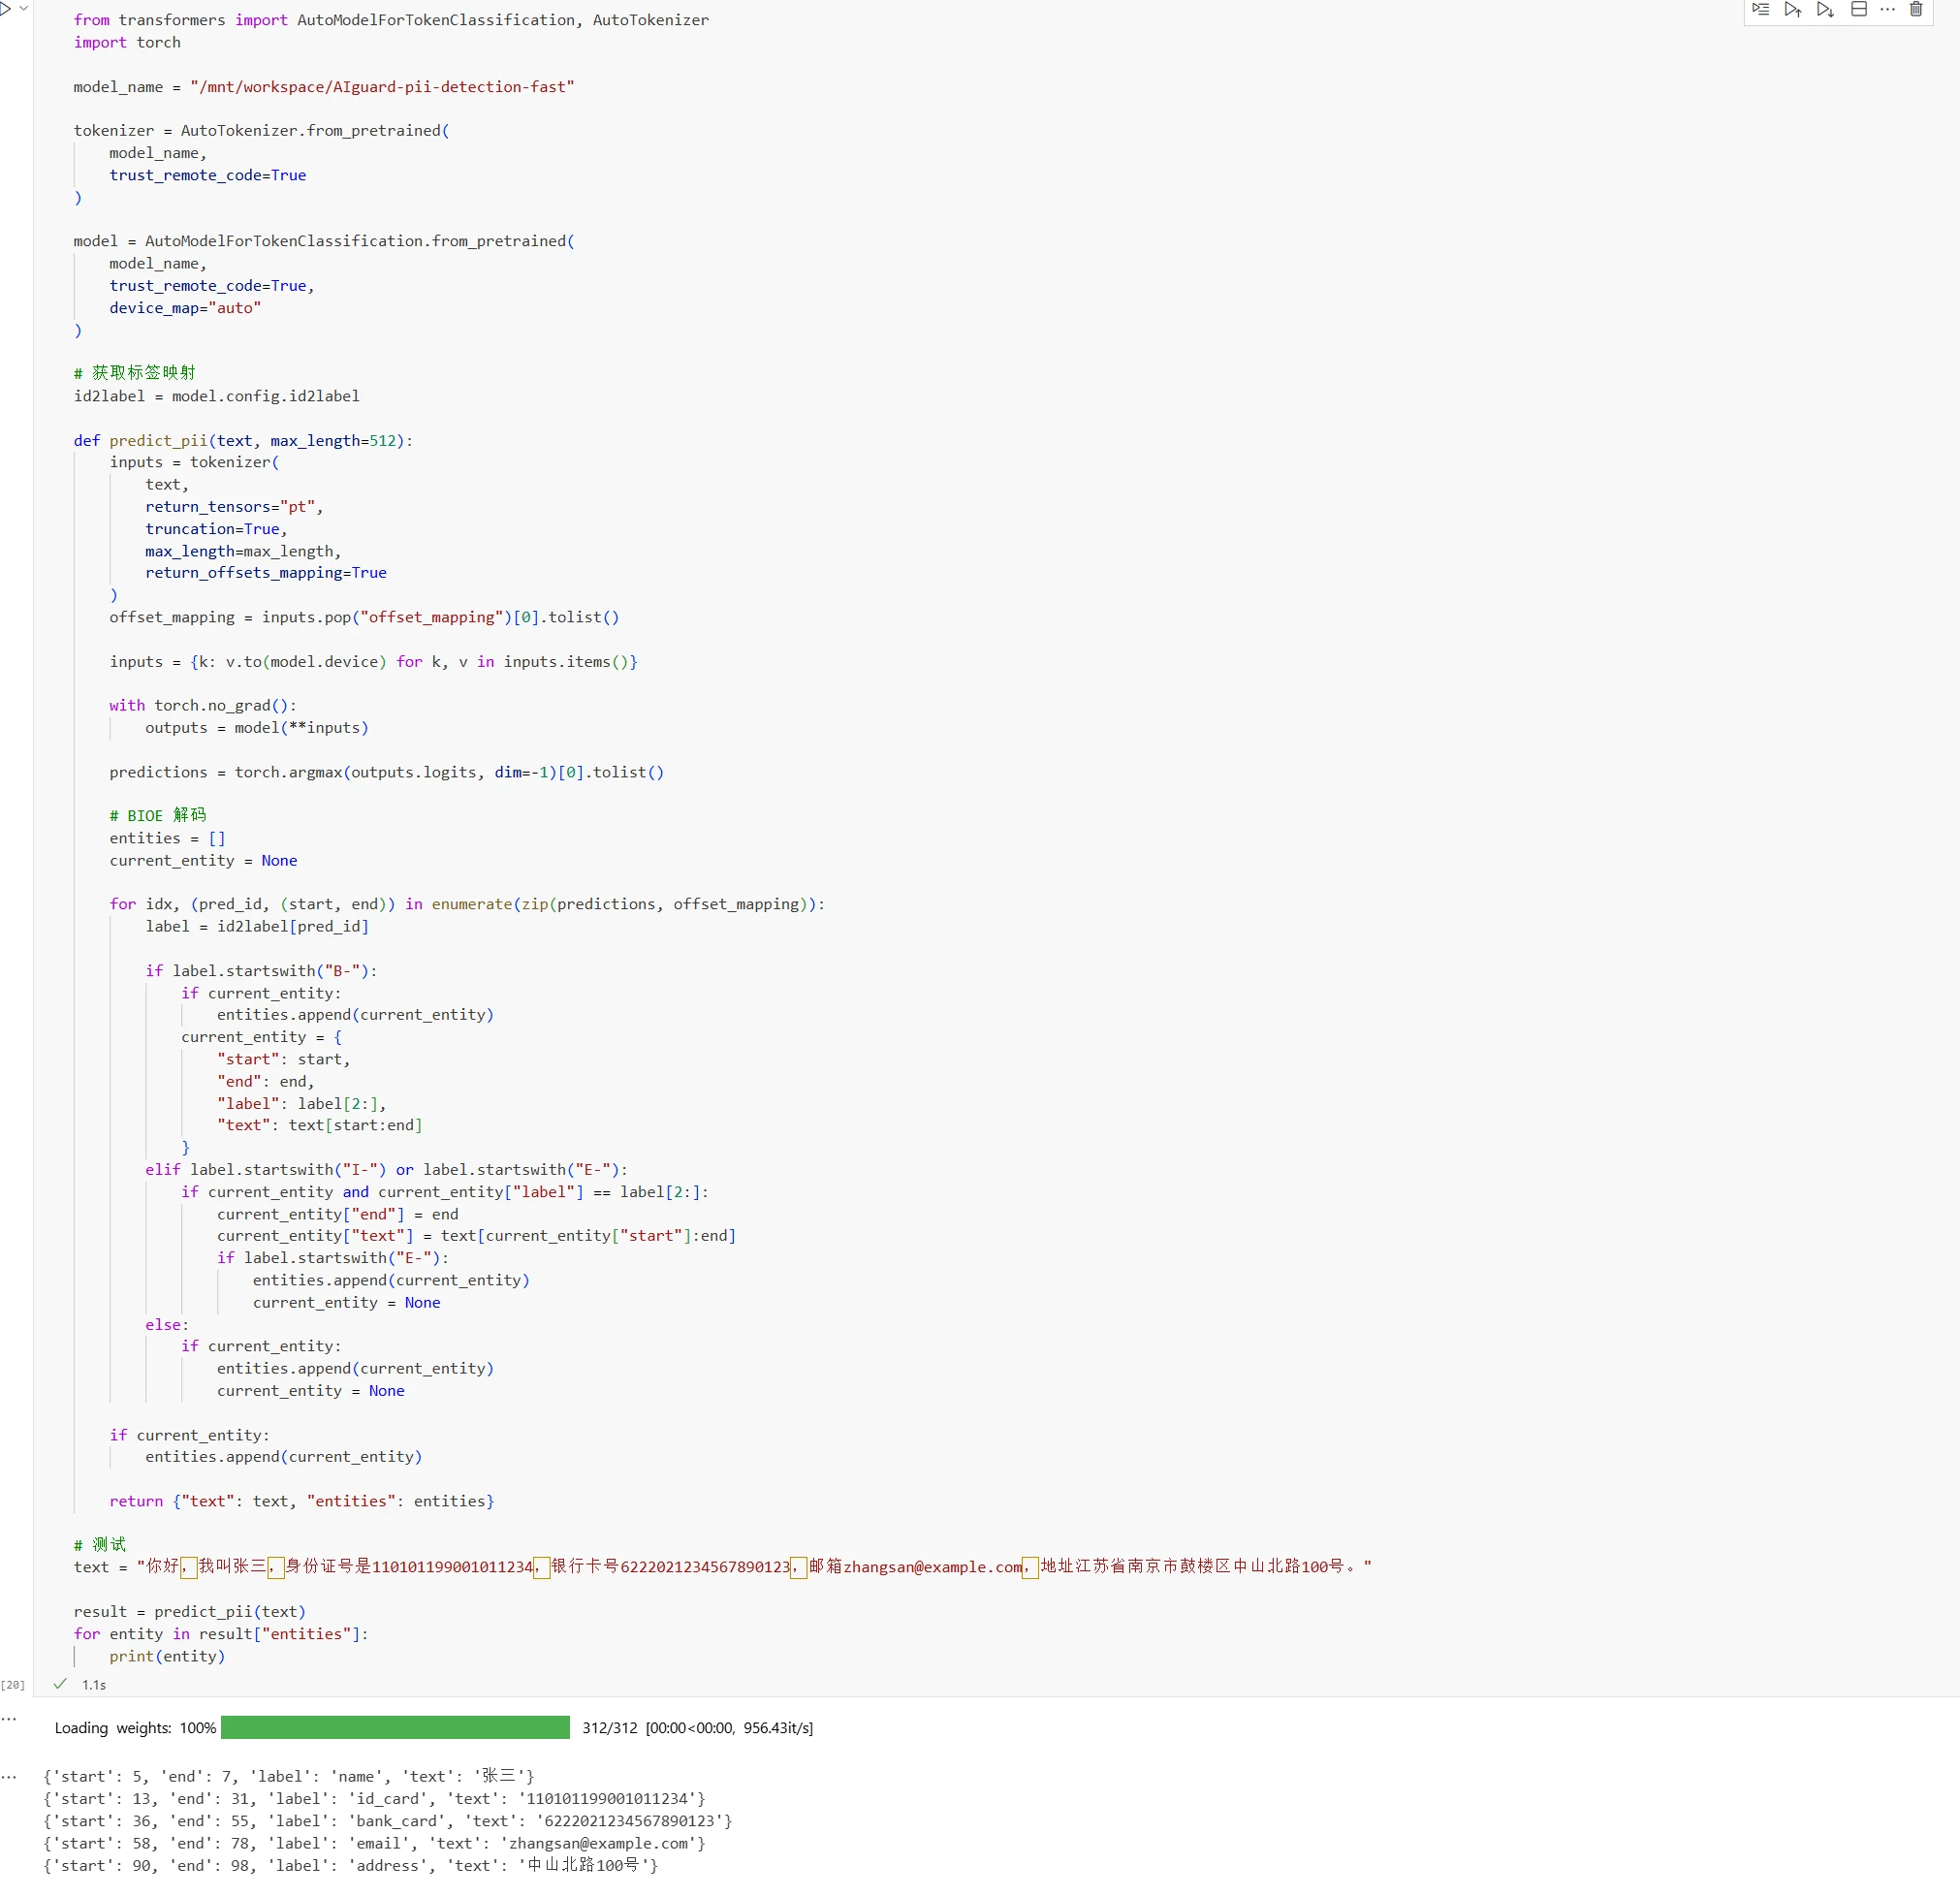
Por exemplo, o código aberto ZJUICSR/AIguard-pii-detection-fast é um modelo projetado para reconhecimento de informações pessoais sensíveis (PII) em chinês, capaz de identificar várias informações sensíveis como nomes, números de telefone, números de identificação, endereços e endereços de e-mail.
Código para usar este modelo para identificar informações sensíveis:
from transformers import AutoModelForTokenClassification, AutoTokenizer
import torch

model_name = "/mnt/workspace/AIguard-pii-detection-fast"

tokenizer = AutoTokenizer.from_pretrained(
    model_name,
    trust_remote_code=True
)

model = AutoModelForTokenClassification.from_pretrained(
    model_name,
    trust_remote_code=True,
    device_map="auto"
)

# Obter mapeamento de rótulos
id2label = model.config.id2label

def predict_pii(text, max_length=512):
    inputs = tokenizer(
        text,
        return_tensors="pt",
        truncation=True,
        max_length=max_length,
        return_offsets_mapping=True
    )
    offset_mapping = inputs.pop("offset_mapping")[0].tolist()

    inputs = {k: v.to(model.device) for k, v in inputs.items()}

    with torch.no_grad():
        outputs = model(**inputs)

    predictions = torch.argmax(outputs.logits, dim=-1)[0].tolist()

    # Decodificação BIOE
    entities = []
    current_entity = None

    for idx, (pred_id, (start, end) in enumerate(zip(predictions, offset_mapping):
        label = id2label[pred_id]

        if label.startswith("B-"):
            if current_entity:
                entities.append(current_entity)
            current_entity = {
                "start": start,
                "end": end,
                "label": label[2:],
                "text": text[start:end]
            }
        elif label.startswith("I-") or label.startswith("E-"):
            if current_entity and current_entity["label"] == label[2:]:
                current_entity["end"] = end
                current_entity["text"] = text[current_entity["start"]:end]
                if label.startswith("E-"):
                    entities.append(current_entity)
                    current_entity = None
        else:
            if current_entity:
                entities.append(current_entity)
                current_entity = None

    if current_entity:
        entities.append(current_entity)

    return {"text": text, "entities": entities}

# Teste
text = "Olá, meu nome é Zhang San, número de identificação 110101199001011234, número de cartão bancário 6222021234567890123, e-mail zhangsan@example.com, endereço Rua Zhongshan Norte 100, Distrito Gulou, Nanjing, Província de Jiangsu."

result = predict_pii(text)
for entity in result["entities"]:
    print(entity)
Resultados:
Os resultados de reconhecimento incluem conteúdo de informações sensíveis, tipo de informações sensíveis e posição no texto original. Subsequentemente, métodos de anonimização apropriados podem ser selecionados com base nessas informações.
Em negócios reais, expressões regulares e modelos de reconhecimento de informações sensíveis são frequentemente usados em combinação. Expressões regulares processam rapidamente informações com formato fixo, como números de telefone e endereços de e-mail; modelos processam informações que requerem compreensão semântica, como nomes e endereços.
Métodos de anonimização
Após completar a identificação de informações sensíveis, métodos de processamento apropriados precisam ser selecionados com base no tipo de informação sensível e nos requisitos da tarefa de treinamento.
Métodos comuns de anonimização incluem:
(1) Substituição
A substituição envolve substituir informações sensíveis reais por outros conteúdos. A substituição pode ser dividida em substituição fixa e substituição aleatória:
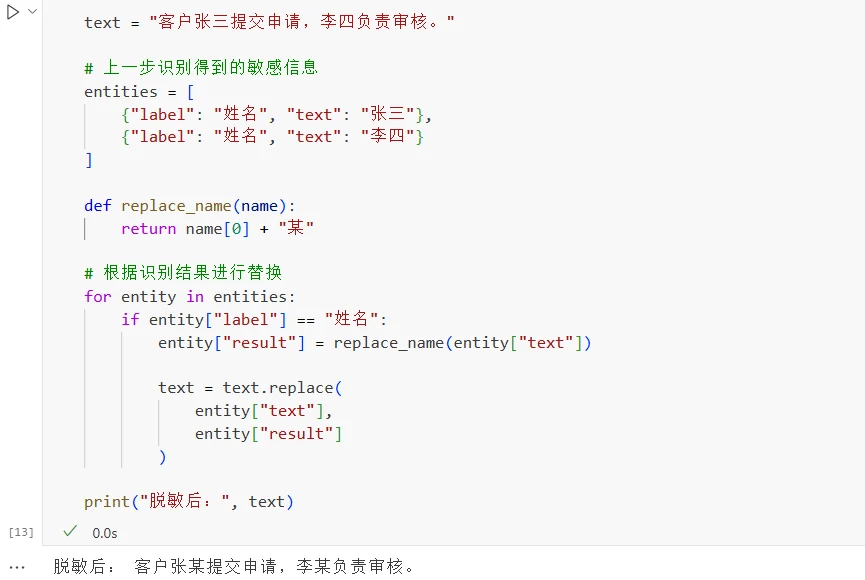
Substituição fixa: Gere resultados de substituição de acordo com regras fixas. Por exemplo, substitua uniformemente o primeiro nome nos nomes por "certa pessoa", "Zhang San" se torna "Zhang certa pessoa", "Li Si" se torna "Li certa pessoa". Como as regras são fixas, a mesma informação sempre produzirá o mesmo resultado, e nenhum mapeamento adicional precisa ser salvo. Código de processamento:
text = "O cliente Zhang San enviou uma solicitação, e Li Si é responsável por revisar."

# Informações sensíveis identificadas no passo anterior
entities = [
    {"label": "nome", "text": "Zhang San"},
    {"label": "nome", "text": "Li Si"}
]

def replace_name(name):
    return name[0] + "certa pessoa"

# Substituir com base nos resultados de identificação
for entity in entities:
    if entity["label"] == "nome":
        entity["result"] = replace_name(entity["text"])

        text = text.replace(
            entity["text"],
            entity["result"]
        )

print("Após anonimização:", text)
Resultados:
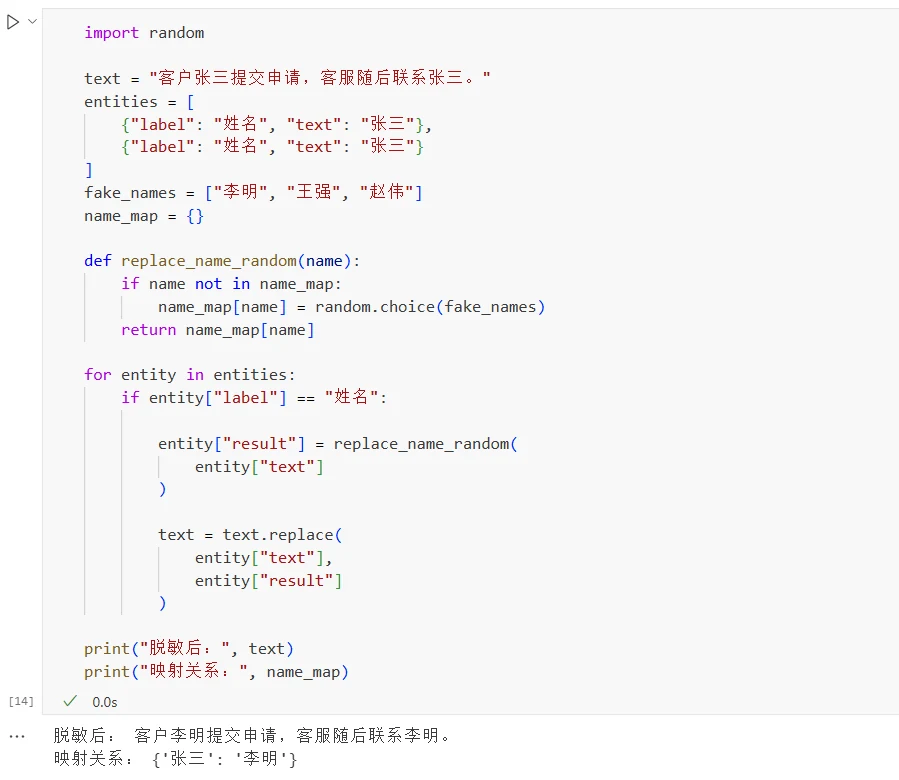
Substituição aleatória: Selecione aleatoriamente informações fabricadas para substituir informações reais, por exemplo, substituir "Zhang San" por "Li Ming". Se o mesmo "Zhang San" aparecer em múltiplos locais, os resultados de substituição precisam ser consistentes. Caso contrário, dados que pertencem à mesma entidade podem ser substituídos por identidades diferentes, destruindo as associações nos dados. Portanto, a substituição aleatória geralmente requer estabelecer uma tabela de mapeamento: {"Zhang San":"Li Ming"}, e quando encontrar "Zhang San" novamente, usar "Li Ming" diretamente. Código de processamento:
import random

text = "O cliente Zhang San enviou uma solicitação, e o atendimento ao cliente então contactou Zhang San."
entities = [
    {"label": "nome", "text": "Zhang San"},
    {"label": "nome", "text": "Zhang San"}
]
fake_names = ["Li Ming", "Wang Qiang", "Zhao Wei"]
name_map = {}

def replace_name_random(name):
    if name not in name_map:
        name_map[name] = random.choice(fake_names)
    return name_map[name]

for entity in entities:
    if entity["label"] == "nome":

        entity["result"] = replace_name_random(
            entity["text"]
        )

        text = text.replace(
            entity["text"],
            entity["result"]
        )

print("Após anonimização:", text)
print("Mapeamento:", name_map)
Resultados:
(2) Máscara
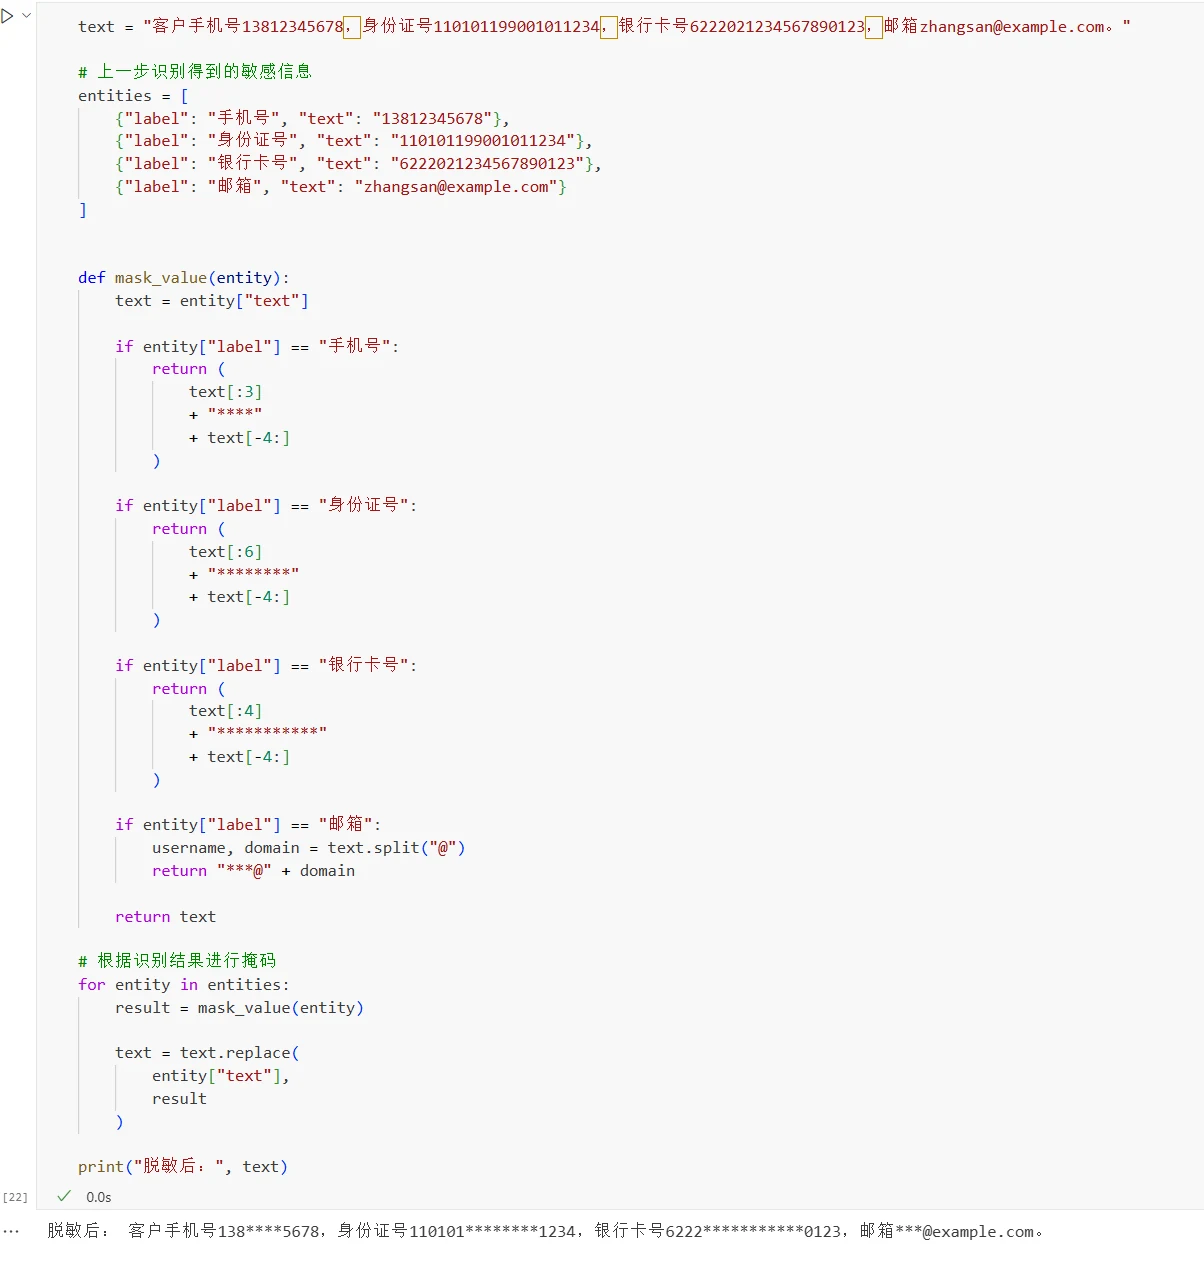
A máscara oculta parte do conteúdo sensível preservando informações parciais, como números de telefone, números de identificação, números de cartão bancário e endereços de e-mail.
Código de processamento:
text = "Número de telefone do cliente 13812345678, número de identificação 110101199001011234, número de cartão bancário 6222021234567890123, e-mail zhangsan@example.com."

# Informações sensíveis identificadas no passo anterior
entities = [
    {"label": "telefone", "text": "13812345678"},
    {"label": "número_id", "text": "110101199001011234"},
    {"label": "cartão_bancário", "text": "6222021234567890123"},
    {"label": "e-mail", "text": "zhangsan@example.com"}
]

def mask_value(entity):
    text = entity["text"]

    if entity["label"] == "telefone":
        return (
            text[:3]
            + "****"
            + text[-4:]
        )

    if entity["label"] == "número_id":
        return (
            text[:6]
            + "********"
            + text[-4:]
        )

    if entity["label"] == "cartão_bancário":
        return (
            text[:4]
            + "***********"
            + text[-4:]
        )

    if entity["label"] == "e-mail":
        username, domain = text.split("@")
        return "***@" + domain

    return text

# Aplicar máscara com base nos resultados de identificação
for entity in entities:
    result = mask_value(entity)

    text = text.replace(
        entity["text"],
        result
    )

print("Após anonimização:", text)
Resultados:
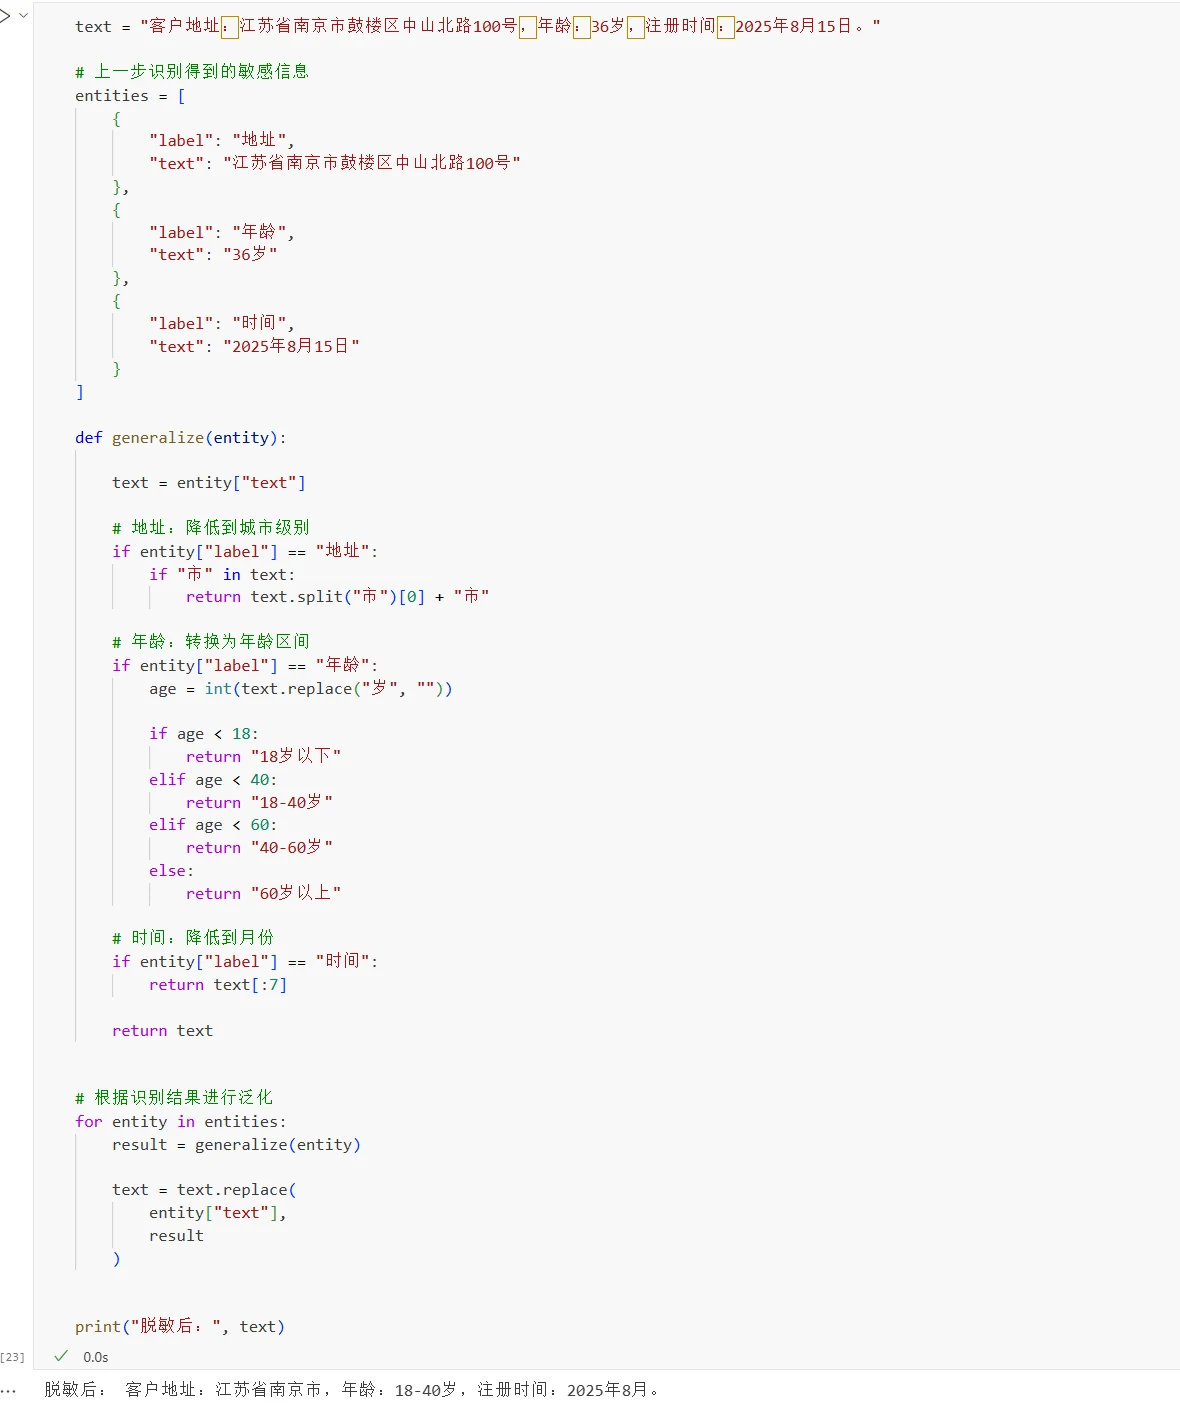
(3) Generalização
A generalização reduz a precisão da informação, reduzindo a capacidade de localizar dados em objetos específicos. É comumente usada para informações contínuas como endereços, idades e horários.
Código de processamento:
text = "Endereço do cliente: Rua Zhongshan Norte 100, Distrito Gulou, Nanjing, Província de Jiangsu, idade: 36 anos, data de registro: 15 de agosto de 2025."

# Informações sensíveis identificadas no passo anterior
entities = [
    {
        "label": "endereço",
        "text": "Rua Zhongshan Norte 100, Distrito Gulou, Nanjing, Província de Jiangsu"
    },
    {
        "label": "idade",
        "text": "36 anos"
    },
    {
        "label": "tempo",
        "text": "15 de agosto de 2025"
    }
]

def generalize(entity):

    text = entity["text"]

    # Endereço: reduzir para nível de cidade
    if entity["label"] == "endereço":
        if "cidade" in text:
            return text.split("cidade")[0] + "cidade"

    # Idade: converter para faixa etária
    if entity["label"] == "idade":
        age = int(text.replace("anos", "")

        if age < 18:
            return "Menores de 18"
        elif age < 40:
            return "18-40"
        elif age < 60:
            return "40-60"
        else:
            return "Maiores de 60"

    # Tempo: reduzir para nível de mês
    if entity["label"] == "tempo":
        return text[:7]

    return text

# Aplicar generalização com base nos resultados de identificação
for entity in entities:
    result = generalize(entity)

    text = text.replace(
        entity["text"],
        result
    )

print("Após anonimização:", text)
Resultados:
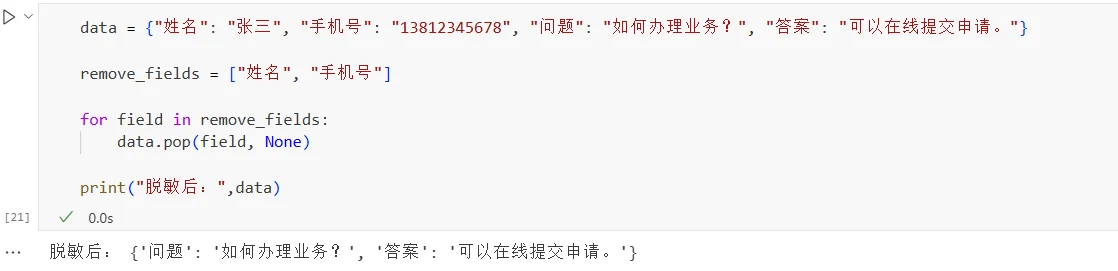
(4) Exclusão
Para campos sensíveis não relacionados à tarefa de treinamento, eles podem ser deletados diretamente. Se a tarefa de treinamento requer apenas aprender relações de perguntas e respostas, nomes e números de telefone podem ser deletados.
data = {"nome": "Zhang San", "telefone": "13812345678", "pergunta": "Como processar o serviço?", "resposta": "Você pode enviar uma solicitação online."}

remove_fields = ["nome", "telefone"]

for field in remove_fields:
    data.pop(field, None)

print("Após anonimização:", data)
Resultados:
Na prática, o método de anonimização precisa ser selecionado de acordo com a tarefa de treinamento e as características dos dados. Quando for necessário preservar associações entre diferentes amostras, substituição fixa ou substituição aleatória com mapeamento pode ser usada; quando for necessário preservar características parciais de informação, máscara ou generalização pode ser usada; para informações sensíveis não relacionadas à tarefa de treinamento, elas devem ser deletadas diretamente.
Diferentes cenários de negócios têm diferentes características de dados, e regras de anonimização específicas precisam ser ajustadas de acordo com os requisitos reais. O código nesta seção é apenas para ilustrar métodos básicos de processamento.
Último passo: organize no formato requerido para o treinamento
Após completar o processamento de dados, os dados ainda precisam ser organizados no formato correspondente de acordo com os requisitos do framework de treinamento.
O ajuste fino de instrução é um método comum de ajuste fino para grandes modelos de linguagem. Dados de treinamento incluem instruções do usuário e as respostas esperadas do modelo, ensinando ao modelo como completar tarefas de acordo com as instruções.
Diferentes frameworks de treinamento podem usar diferentes campos de dados. Formatos comuns de dados de instrução incluem principalmente Alpaca, ShareGPT e Messages.
Formato Alpaca
O formato Alpaca tem uma estrutura simples, tipicamente usando três campos: instruction, input e output. É adequado para dados de instrução de turno único.
{
  "instruction": "Traduzir o seguinte texto chinês para inglês",
  "input": "O tempo está muito bom hoje.",
  "output": "The weather is very nice today."
}
onde: instruction representa a tarefa que o modelo precisa executar; input representa o conteúdo de entrada necessário para completar a tarefa; output representa a resposta que o modelo é esperado gerar.
Se a tarefa em si não requer entrada adicional, o input também pode estar vazio.
Por exemplo:
{
  "instruction": "Introduzir o que é aprendizado de máquina",
  "input": "",
  "output": "Aprendizado de máquina é um método que permite aos computadores aprender padrões a partir de dados."
}
Este formato tem poucos campos e uma estrutura clara, tornando-o adequado para tarefas de treinamento de turno único como perguntas e respostas, classificação e geração de texto.
Formato Messages
Outra abordagem comum é usar messages para armazenar conversas, onde cada mensagem contém dois campos principais: role e content.
Por exemplo:
{
  "messages": [
    {
      "role": "system",
      "content": "Você é um assistente profissional de atendimento ao cliente."
    },
    {
      "role": "user",
      "content": "Quando minha encomenda chegará?"
    },
    {
      "role": "assistant",
      "content": "Por favor, forneça o número do pedido, e eu ajudarei a verificar."
    }
  ]
}
onde system é usado para definir o papel do modelo, os requisitos da tarefa ou regras de resposta, user representa a entrada do usuário, e assistant representa a resposta que o modelo é esperado gerar.
O formato Messages também suporta conversas de múltiplos turnos. Você precisa apenas continuar adicionando mensagens user e assistant na ordem real da conversa.
Por exemplo:
{
  "messages": [
    {
      "role": "system",
      "content": "Você é um assistente profissional de atendimento ao cliente."
    },
    {
      "role": "user",
      "content": "Como alterar a senha de login?"
    },
    {
      "role": "assistant",
      "content": "Vá à página de configurações da conta e selecione 'Alterar Senha'."
    },
    {
      "role": "user",
      "content": "E se eu esquecer a senha original?"
    },
    {
      "role": "assistant",
      "content": "Você pode selecionar 'Esqueci Minha Senha' na página de login, verificar através do número de telefone ou e-mail, e então redefinir a senha."
    }
  ]
}
Formato ShareGPT
ShareGPT é um dos formatos comuns de dados de diálogo no treinamento de modelos de código aberto. Ele tipicamente usa conversations para armazenar diálogos completos e usa human e gpt para distinguir entre usuários e o modelo.
Por exemplo:
{
  "conversations": [
    {
      "from": "human",
      "value": "Traduzir o seguinte texto chinês para inglês: O tempo está muito bom hoje."
    },
    {
      "from": "gpt",
      "value": "The weather is very nice today."
    }
  ]
}
O formato ShareGPT também pode armazenar diálogos de múltiplos turnos:
{
  "conversations": [
    {
      "from": "human",
      "value": "Ajude-me a escrever um e-mail de solicitação de folga."
    },
    {
      "from": "gpt",
      "value": "Por favor, me diga o período e o motivo da folga."
    },
    {
      "from": "human",
      "value": "Estou com gripe e preciso de dois dias de folga médica."
    },
    {
      "from": "gpt",
      "value": "Tudo bem, aqui está um e-mail de solicitação de folga..."
    }
  ]
}
Como escolher um formato de dados
Os formatos Alpaca, Messages e ShareGPT essencialmente descrevem a entrada e a saída esperada do modelo, apenas com diferentes organizações de campos.
Você pode escolher com base no tipo de tarefa e no framework de treinamento:
Formato de dados
Principais características
Cenários adequados
Alpaca
Organiza dados usando instruction, input e output
Instruções de turno único, perguntas e respostas, classificação
Messages
Usa messages para armazenar conversas, distingue papéis via role
Diálogos de turno único ou múltiplos turnos
ShareGPT
Usa conversations para armazenar diálogos, distingue papéis via from
Diálogos de turno único ou múltiplos turnos
Os diferentes formatos geralmente podem ser convertidos entre si. Por exemplo, um dado Alpaca pode ser convertido em um conjunto de mensagens user e assistant, e human e gpt no ShareGPT também podem ser convertidos em user e assistant respectivamente. Durante o treinamento real, você deve primeiro confirmar os formatos de dados e templates de modelo suportados pelo framework de treinamento, e então organizar os dados de acordo com os requisitos correspondentes.
Código do modelo e arquivos relacionados: https://www.modelscope.cn/gallery/liucong/b41e2395-f795-400f-bafd-e53ed7f5c8ca