Modelos de linguagem gerais possuem uma capacidade forte de responder perguntas, mas na aplicação corporativa, muitos problemas envolvem materiais internos da empresa, como documentação de produtos, documentos técnicos, regulamentos de negócios e manuais de operação. Esses conhecimentos geralmente não estão incluídos nos dados de treinamento do modelo e são atualizados constantemente com o negócio.
RAG (Retrieval-Augmented Generation, geração aprimorada por recuperação) oferece uma solução, onde antes de responder uma pergunta, o modelo busca conteúdo relevante em uma base de conhecimento corporativa e o fornece para gerar a resposta.
O conceito central do RAG pode ser resumido como: primeiro recuperação, depois resposta. Os modelos de linguagem tradicionais de resposta a perguntas dependem principalmente do conhecimento já aprendido nos parâmetros do modelo. Por exemplo, quando um usuário faz uma pergunta, o modelo gera uma resposta diretamente com base nas informações aprendidas durante o treinamento. O RAG adiciona uma etapa de recuperação de conhecimento neste processo. Após o usuário fazer uma pergunta, o sistema primeiro busca conteúdo relevante na base de conhecimento externa, depois envia a pergunta e o conteúdo recuperado para o modelo, que combina esses conteúdos para gerar a resposta final.
Um fluxo básico do RAG pode ser representado como: pergunta do usuário → recuperação de conhecimento → obtenção de conteúdo relevante → geração de resposta pelo LLM → retorno do resultado. O RAG não faz com que o modelo re- aprenda esses conhecimentos, mas fornece referências atuais ao modelo quando ele responde a uma pergunta.
O RAG não é necessário para todas as aplicações de modelos de linguagem, mas é muito comum em cenários como perguntas e respostas corporativas, assistentes inteligentes de cliente e ajudantes de documento.
Se o conhecimento de negócio precisa ser atualizado constantemente, geralmente é mais apropriado usar o RAG. Por exemplo, as instruções de produto, regulamentos de negócio e normas operacionais da empresa podem ser ajustadas constantemente. Se esses conhecimentos fossem inseridos no modelo por meio de treinamento, seria necessário re-treinar o modelo toda vez que o conhecimento mudasse, o que tem alto custo e não é fácil de manter.
O RAG pode atualizar diretamente a base de conhecimento externa. Quando um documento é modificado, é suficiente reprocessar os documentos relevantes e atualizar o índice, sem a necessidade de re-treinar todo o modelo grande. Se a resposta precisar de uma base de referência, o RAG também é apropriado. Como a resposta do modelo é baseada no documento recuperado, é possível retornar o nome do documento, capítulo, página ou trecho original, permitindo que o usuário saiba de onde vem a resposta.
Entrar participar da discussão
O RAG e a fine-tuning do modelo podem ser usados para melhorar o desempenho dos modelos de linguagem em negócios reais, mas as abordagens para resolver problemas são diferentes. O RAG resolve principalmente o problema de "o modelo não possui conhecimento relevante", enquanto a fine-tuning do modelo resolve principalmente o problema de "o modelo não pode realizar a tarefa conforme exigido".
O RAG não modifica os parâmetros do modelo em si, mas antes de responder a uma pergunta, busca conteúdo relevante na base de conhecimento externa e o fornece ao modelo como base para a resposta.
A fine-tuning funciona de forma diferente. A fine-tuning requer o uso de dados de treinamento específicos para treinar o modelo adicionalmente e ajustar os parâmetros do modelo durante o treinamento, fazendo com que o modelo aprenda gradualmente como tratar uma tarefa específica. Por exemplo, na tarefa de identificação de entidades mencionada no Capítulo 9, o modelo precisa fornecer uma resposta no formato fixo. Quando as exigências da tarefa mudam significativamente, geralmente é necessário preparar novos dados de treinamento e re-realizar a fine-tuning.
Na aplicação real, pode-se escolher diferentes métodos de acordo com o problema a ser resolvido: para adicionar ou atualizar conhecimento, é mais apropriado usar o RAG; para ajustar a capacidade do modelo, o formato de saída ou o comportamento, é mais apropriado usar a fine-tuning do modelo. O RAG e a fine-tuning podem ser usados em conjunto. Por exemplo, pode-se usar a fine-tuning para fazer com que o modelo domine habilidades de resposta ou seguir instruções, e usar o RAG para fornecer conhecimento do domínio ao modelo, permitindo que o modelo realize as tarefas conforme as exigências do negócio e gere respostas com base no conhecimento mais recente.
Um sistema completo de RAG geralmente pode ser dividido em duas etapas principais: construção da base de conhecimento e pergunta e resposta online. A construção da base de conhecimento é responsável por processar materiais como PDF, Word, Markdown, páginas da web em dados de conhecimento que podem ser pesquisados. A pergunta e resposta online é, após o usuário fazer uma pergunta, buscar conteúdo relevante na base de conhecimento já construída. Neste experimento, adotamos a Lei de Implementação das Disposições do Regulamento Geral sobre a Segurança da Via Pública da República Popular da China como fonte de documentos, para construir um sistema de perguntas e respostas sobre a lei de segurança viária.
O conhecimento corporativo geralmente está distribuído em diferentes tipos de arquivos, como PDF, Word, Excel, Markdown e páginas da web. Dado que os formatos e as estruturas internas desses arquivos têm diferenças significativas, antes de construir a base de conhecimento do RAG, geralmente é necessário converter esses documentos em um formato de texto ou dados estruturados unificados, que é chamado de análise de documentos. Para um sistema de RAG, uma boa ferramenta de análise de documentos não apenas identifica o texto nas palavras, mas também tenta identificar e preservar as informações de estrutura original do documento, como títulos do documento, parágrafos, tabelas, imagens, fórmulas, etc.
Atualmente existem muitos ferramentas de código aberto para análise de documentos, incluindo:
1) MinerU é uma ferramenta de análise de documentos de código aberto direcionada para documentos complexos, que pode converter documentos PDF, imagens, Word, PPT, Excel em formatos de máquina legíveis como Markdown, JSON. Ele pode identificar títulos, texto principal, tabelas, imagens, fórmulas e, sempre que possível, restaurar a estrutura do documento original de acordo com a ordem de leitura humana, portanto, é apropriada como ferramenta de pré-processamento de documentos em sistemas de RAG, opendatalab/MinerU
2) MonkeyOCR é um projeto de análise de documentos baseado em modelos multimodais, que analisa documentos por meio de reconhecimento estrutural, reconhecimento de conteúdo e modelagem de relações, podendo tratar conteúdo de texto, tabelas, fórmulas e complexos, e suporta documentos em chinês e inglês. Para PDFs com layout complexo onde ferramentas de extração de texto tradicionais não têm bons resultados, pode-se considerar métodos de análise baseados em modelos visuais, Yuliang-Liu/MonkeyOCR
3) Dolphin é um modelo de análise de documentos de código aberto da ByteDance, que usa o método "análise primeiro, depois análise" para processar documentos. Ele pode primeiro identificar o layout da página e a ordem de leitura, depois analisar elementos de documento como texto, tabelas, fórmulas, código, etc. É apropriado para tratar PDFs com layout complexo ou documentos escaneados, ByteDance/Dolphin
4) PaddleOCR é uma ferramenta de OCR e análise de documentos de código aberto da PaddlePaddle. Além da identificação de texto comum, fornece análise de layout, reconhecimento de tabelas e análise de estrutura de documentos, podendo converter o conteúdo de PDFs e imagens em dados estruturados mais apropriados para sistemas AI subsequentes. Para PDFs escaneados, documentos em formato de imagem e documentos com muitos textos em chinês, o PaddleOCR é uma escolha comum, PaddlePaddle/PaddleOCR
As ferramentas de análise de documentos têm suas próprias características e não existe uma ferramenta que funcione para todos os documentos. Na construção de sistemas de RAG, pode-se escolher a ferramenta apropriada com base no tipo de documento, a complexidade do layout, a precisão da análise, o custo de implantação e outros fatores.
Neste experimento, usamos MinerU para análise de documentos, primeiro instalamos MinerU no ambiente de Notebook do ModelScope, executando o comando a seguir:
pip install -U "mineru[all]"
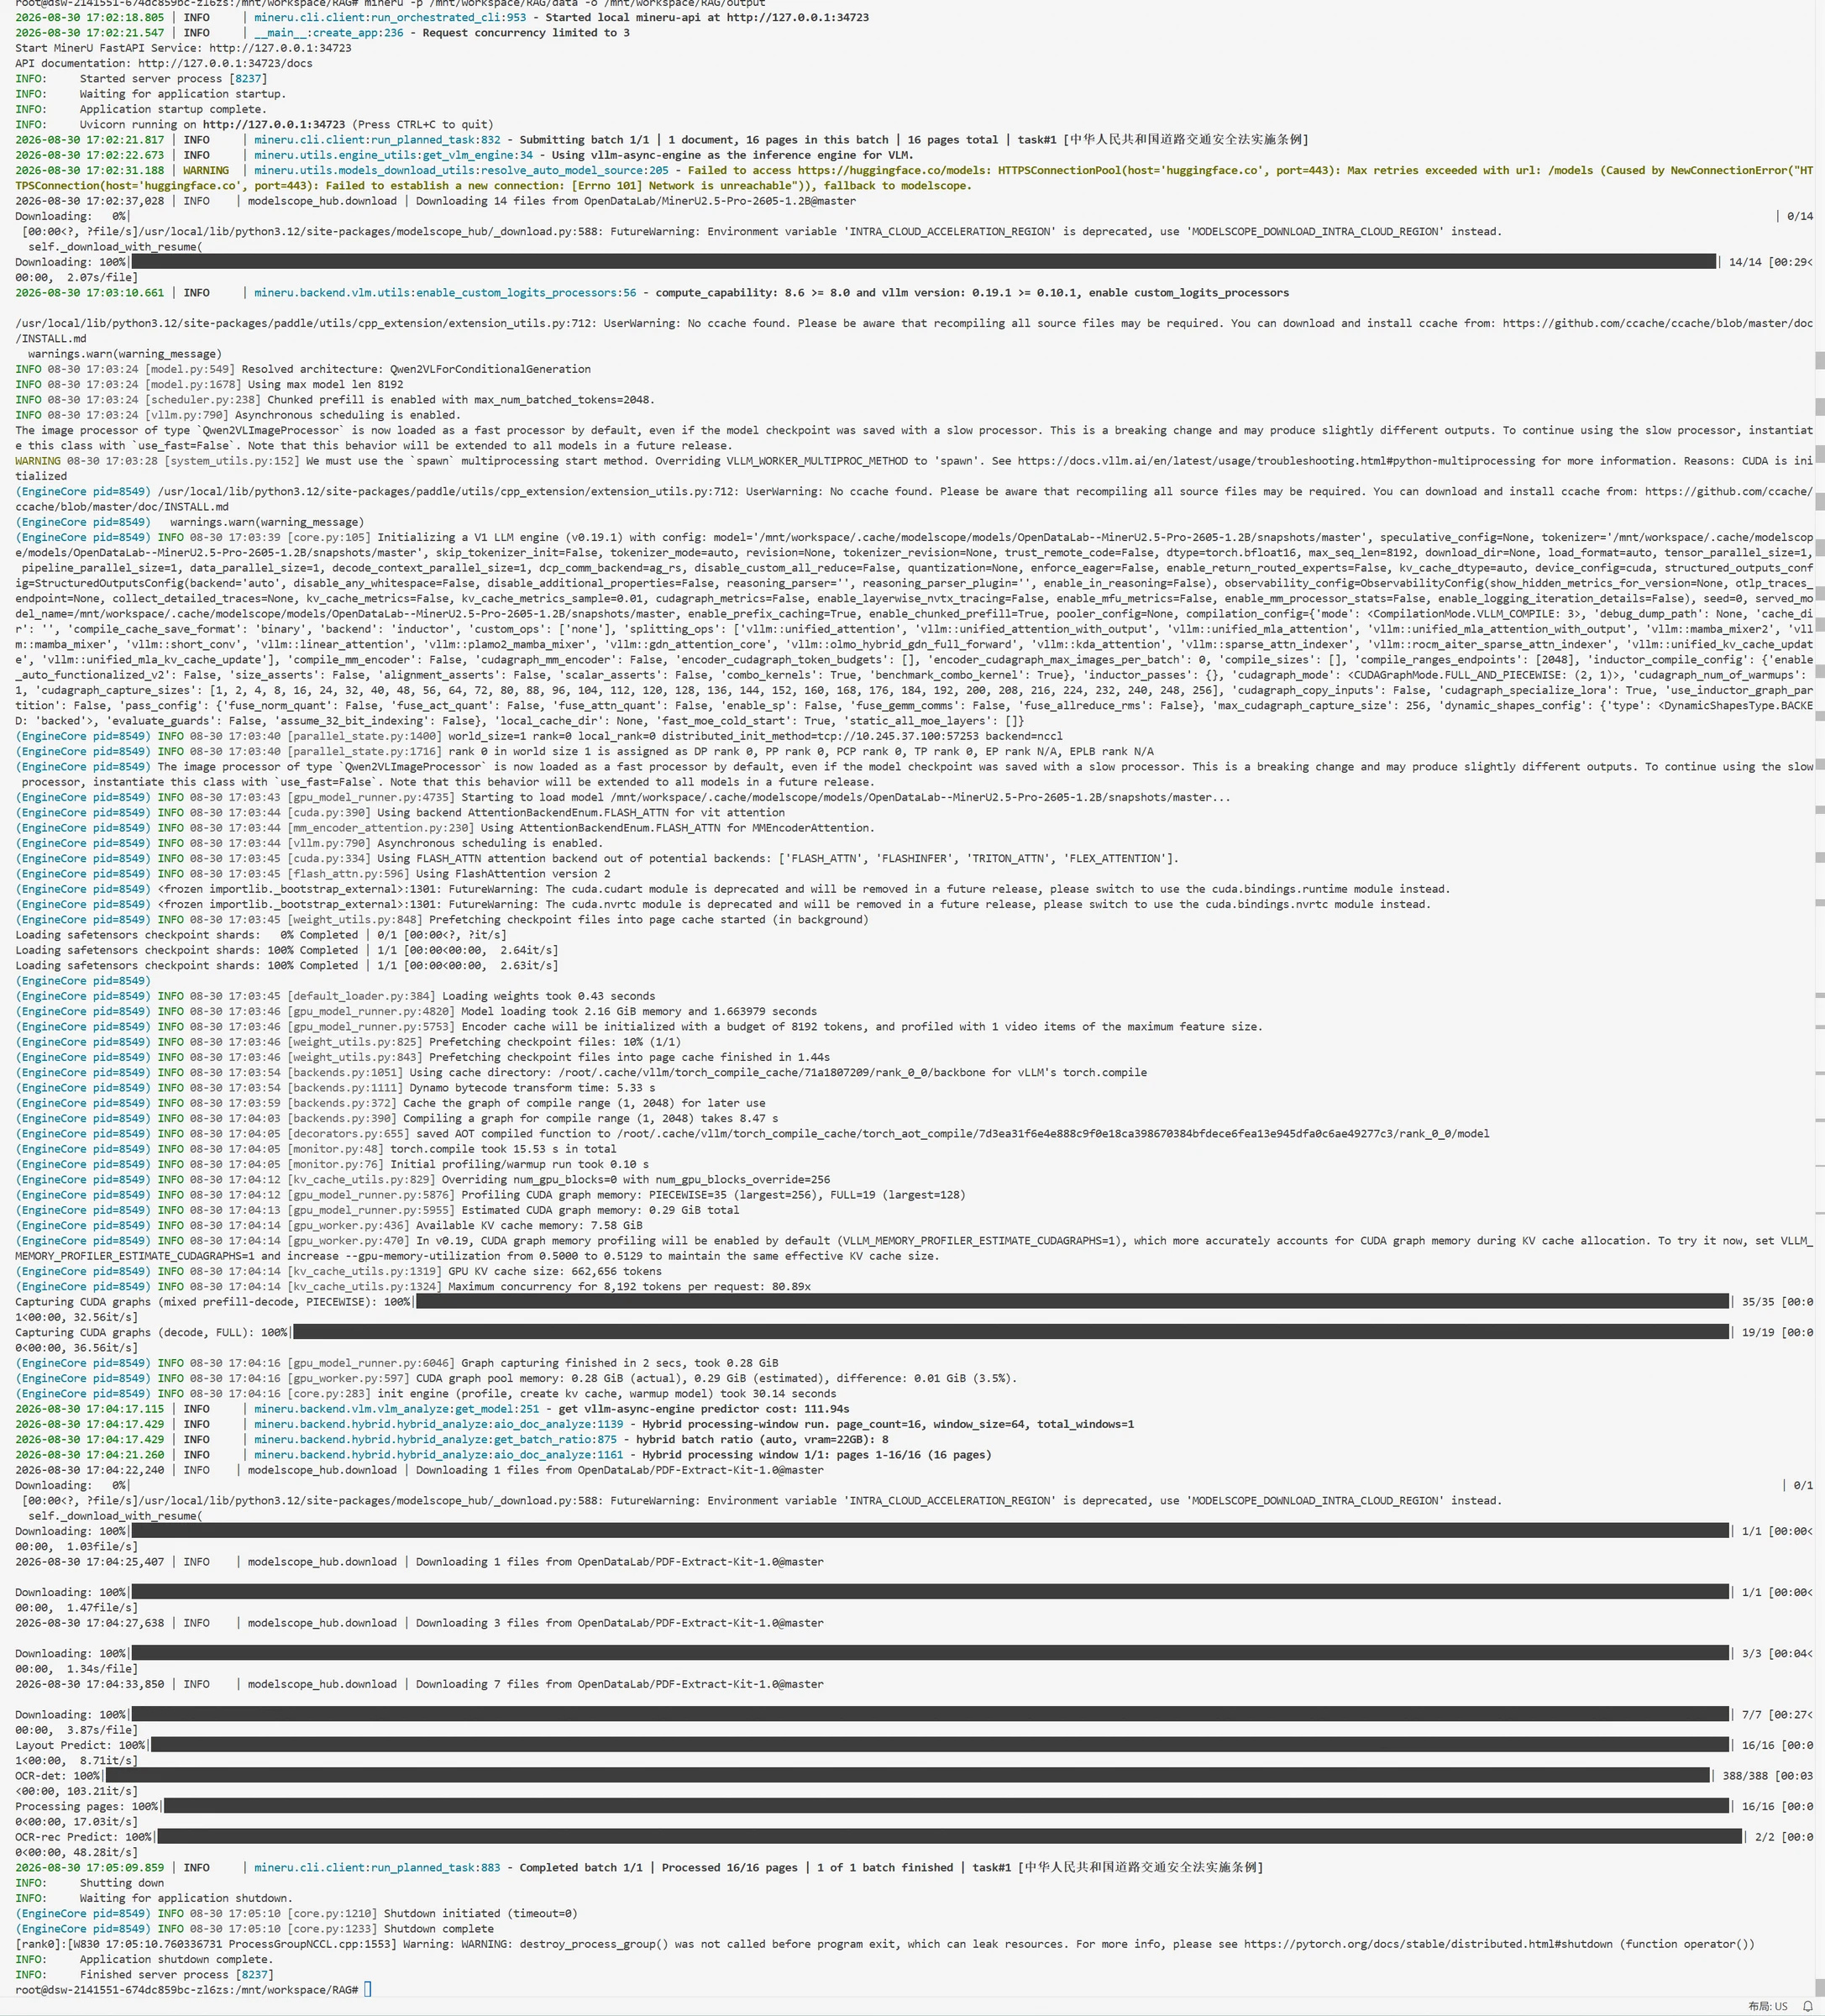
Após a instalação, pode-se analisar diretamente o documento, inserindo o caminho do arquivo a ser analisado e executando o comando a seguir:
mineru -p /mnt/workspace/RAG/data -o /mnt/workspace/RAG/output
No qual: -p é o caminho de entrada do arquivo, -o é o caminho de saída do modelo, ou seja, o texto analisado.
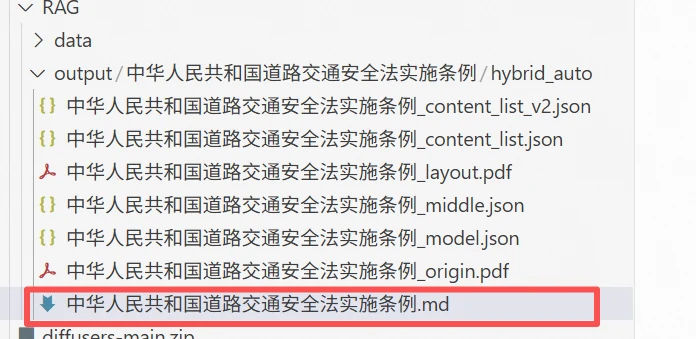
Os arquivos analisados são os seguintes, que incluem muitos arquivos intermediários, pode-se escolher conforme a necessidade. Neste experimento, escolhemos os arquivos .md como a fonte do documento, que incluem informações de formato de parágrafo do texto.
Após a análise de documentos, é necessário dividir documentos longos em vários fragmentos menores de texto, que são frequentemente chamados de Chunk. Em sistemas de RAG, o Embedding e a pesquisa geralmente usam o Chunk como unidade básica, portanto, uma divisão de documentos razoável ajuda a aumentar a precisão da pesquisa posterior.
Para os documentos Markdown analisados, pode-se primeiro dividir o conteúdo por linhas em branco, depois combinar os parágrafos adjacentes de acordo com o tamanho de Chunk definido. Quando o conteúdo excede o tamanho especificado, gera-se um novo Chunk.
Para evitar a perda de informações de contexto na posição de divisão, pode-se definir o chunk_overlap, para que os Chunks adjacentes retenham algum conteúdo repetido. Por exemplo: chunk_size = 500, chunk_overlap = 50, significa que cada Chunk controla cerca de 500 caracteres, e os Chunks adjacentes retêm cerca de 50 caracteres de conteúdo repetido. Após a divisão, pode-se salvar informações como id, content e file para cada Chunk, facilitando a posterior vetorização, pesquisa e localização da fonte da resposta.
A seguir está o código para dividir os Chunks:
import os
import json
def load_markdown(file_path):
    with open(file_path, "r", encoding="utf-8") as f:
        return f.read()

def split_markdown(text, chunk_size=500, chunk_overlap=50):
    """
    Dividir texto Markdown em vários Chunks
    chunk_size: quanta caracteres aproximadamente cada Chunk deve conter
    chunk_overlap: quanta caracteres repetidos devem ser mantidos entre Chunks adjacentes
    """
    paragraphs = text.split("\n\n")

    chunks = []
    current_chunk = ""

    for paragraph in paragraphs:
        paragraph = paragraph.strip()
        if not paragraph:
            continue
        if len(current_chunk) + len(paragraph) <= chunk_size:
            if current_chunk:
                current_chunk += "\n\n" + paragraph
            else:
                current_chunk = paragraph

        else:

            if current_chunk:
                chunks.append(current_chunk)
            overlap_text = current_chunk[-chunk_overlap:] if current_chunk else ""

            current_chunk = overlap_text + "\n\n" + paragraph
    if current_chunk:
        chunks.append(current_chunk)

    return chunks

def save_chunks(chunks, source_file, output_file):
    """
    Salvar os Chunks em um arquivo JSONL
    """
    file_name = os.path.basename(source_file)

    with open(output_file, "w", encoding="utf-8") as f:
        for i, chunk in enumerate(chunks):
            data = {"id": i,"content": chunk,"file": file_name
            }

            f.write(
                json.dumps(data, ensure_ascii=False) + "\n"
            )

if __name__ == "__main__":

    file_path = "./output/Regulamento de Implementação da Lei sobre a Segurança da Via Pública da República Popular da China/hybrid_auto/Regulamento de Implementação da Lei sobre a Segurança da Via Pública da República Popular da China.md"

    text = load_markdown(file_path)
    chunks = split_markdown(
        text,
        chunk_size=500,
        chunk_overlap=50
    )
    print("Número de Chunks:", len(chunks)
    save_chunks(
        chunks,
        source_file=file_path,
        output_file="output/chunks.jsonl"
    )
Após a execução, pode-se ver que o arquivo md analisado anteriormente foi dividido em 39 Chunks.

Após a divisão de documentos, é necessário construir uma base de documentos pesquisável. Como os computadores não podem buscar com base no significado da linguagem natural, é necessário usar modelos de Embedding para converter cada Chunk em uma representação de vetor. Os modelos de Embedding podem mapear o texto para um espaço vetorial de alta dimensão, e os textos com significados mais próximos têm distâncias mais próximas no espaço vetorial. Portanto, após o usuário fazer uma pergunta, pode-se converter a pergunta para um vetor, compará-la com vetores dos Chunks na base de documentos e, dessa forma, recuperar o conteúdo mais relevante.
Atualmente a comunidade de código aberto oferece diversos modelos de Embedding, como BGE-M3 e Qwen3-Embedding. BGE-M3 é um modelo de Embedding multilíngue lançado pela BAAI, suporta mais de 100 idiomas e texto com até 8192 Tokens. Em comparação com modelos de Embedding densos tradicionais, o BGE-M3 suporta tanto busca densa quanto busca esparsa e busca multi-vetor, portanto, pode ser usado tanto para a busca de vetor semântica comum quanto para cenários de busca mista FlagEmbedding.
Qwen3-Embedding é uma série de modelos de vetorização de texto lançada pela equipe Qwen, baseada na arquitetura Qwen3, e se destina a tarefas como busca de texto, clusterização de texto, classificação de texto e busca de código. Qwen3-Embedding oferece diferentes escalas de parâmetros, como 0.6B, 4B e 8B, de acordo com o desempenho do modelo e os recursos de computação, e possui boa capacidade de processamento de linguagens múltiplas e textos longos Qwen3-Embedding.
Nesta seção, usamos o Qwen3-Embedding-0.6B como modelo de Embedding para o experimento, o Capítulo 9 já apresentou o ms-swift, além do treinamento e fine-tuning de modelos grandes, o ms-swift também suporta o treinamento e inferência da série Qwen3-Embedding. Portanto, nesta seção continuamos a usar o ms-swift para iniciar o Qwen3-Embedding-0.6B e completar a vetorização dos Chunks de documento e da pergunta do usuário por meio de uma interface.
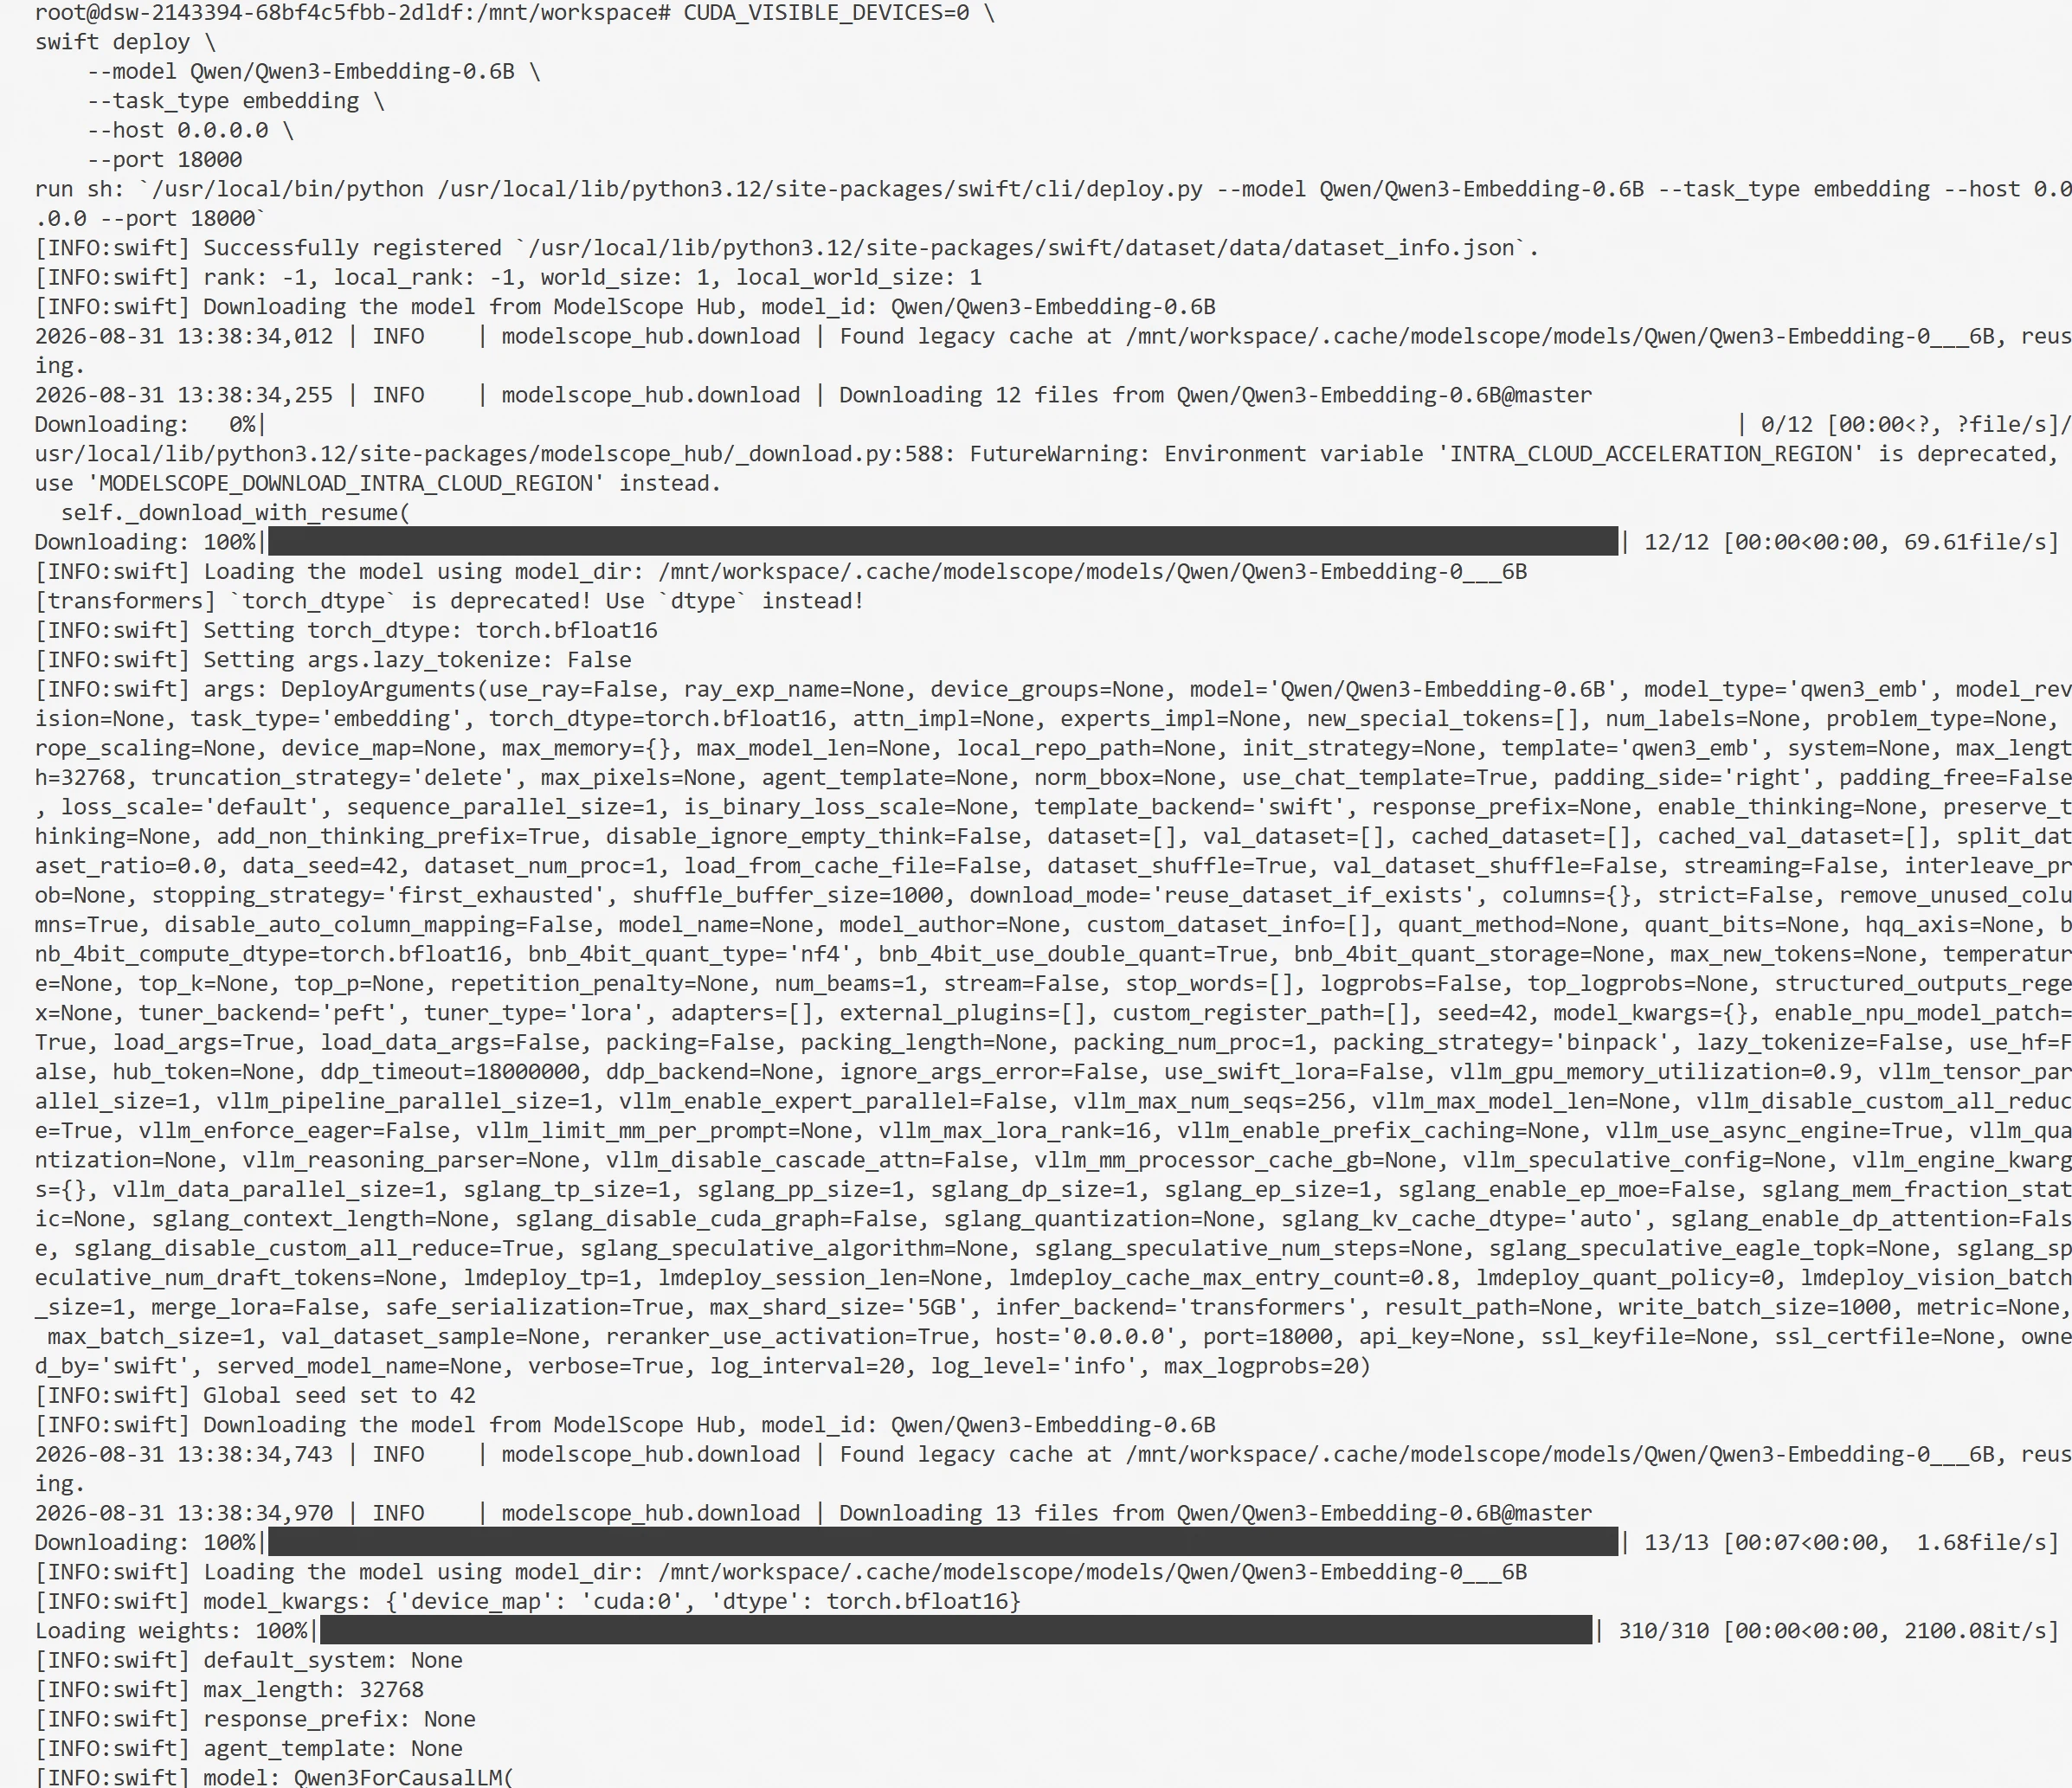
Pode-se usar o seguinte comando para iniciar o serviço de Embedding:
CUDA_VISIBLE_DEVICES=0 \
swift deploy \
    --model Qwen/Qwen3-Embedding-0.6B \
    --task_type embedding \
    --vllm_gpu_memory_utilization 0.2 \
    --vllm_max_model_len 512 \
    --host 0.0.0.0 \
    --port 18000
Após o serviço iniciar, exibe a seguinte informação:
As ferramentas de busca de vetores comuns incluem Faiss e Milvus. Faiss é uma biblioteca de busca de similaridade de vetores de código aberto da Meta, usada principalmente para realizar busca de índice de vetores e busca de vizinhos próximos de forma eficiente. Ele é fácil de implantar, não precisa de um serviço de banco de dados separado e pode ser usado diretamente em programas Python, sendo apropriado para aprendizado, experimentos e sistemas de RAG de pequena e média escala. Milvus é um banco de dados de vetores para dados de escala grande, além da busca de vetores, oferece persistência de dados, armazenamento distribuído, gerenciamento de índice e múltiplas capacidades de consulta. É apropriado para cenários com escala de dados grande, necessidades de execução a longo prazo e implantação de engenharia. Em comparação com o Faiss, o Milvus possui mais recursos completos, mas sua implantação e uso são também mais complexos.
Neste experimento, usamos o Faiss para armazenamento de vetores e busca de similaridade, primeiro instalamos a biblioteca faiss, executando o comando a seguir:
pip install faiss-cpu
Após a instalação, pode-se enviar os Chunks gerados na seção anterior para a interface de Embedding, obter os vetores correspondentes e estabelecer uma relação entre os vetores e as informações de Chunk, como id, content, file, etc. para que possa ser concluída uma busca de similaridade e pesquisa de conhecimento rapidamente posteriormente.
O código para criar o índice build_index.py é o seguinte:
import json
import requests
import numpy as np
import faiss

EMBEDDING_URL = "http://localhost:18000/v1/embeddings"
MODEL_NAME = "Qwen3-Embedding-0.6B"

def get_embedding(text):
    payload = {"model": MODEL_NAME,"input": text}
    response = requests.post(
        EMBEDDING_URL,
        json=payload,
        timeout=60
    )
    response.raise_for_status()
    data = response.json()
    embedding = data["data"][0]["embedding"]
    return np.array(embedding, dtype="float32")

def load_chunks(file_path):
    chunks = []
    with open(file_path, "r", encoding="utf-8") as f:
        for line in f:
            chunks.append(json.loads(line)
    return chunks
def build_faiss_index(chunks,index_path="faiss.index", metadata_path="metadata.json"):

    embeddings = []
    for i, chunk in enumerate(chunks):
        text = chunk["content"]
        embedding = get_embedding(text)
        embeddings.append(embedding)
        print(f"Processado {i + 1}/{len(chunks)}")
    embeddings = np.array(embeddings, dtype="float32")
    faiss.normalize_L2(embeddings)
    dimension = embeddings.shape[1]
    index = faiss.IndexFlatIP(dimension)
    index.add(embeddings)
    print("Número de vetores:", index.ntotal)
    print("Dimensão dos vetores:", dimension)
    faiss.write_index(index, index_path)
    with open(metadata_path, "w", encoding="utf-8") as f:
        json.dump(chunks,f,ensure_ascii=False,indent=2
        )
    print(f"Índice Faiss salvo em: {index_path}")
    print(f"Informações dos Chunks salvas em: {metadata_path}")

if __name__ == "__main__":

    chunks = load_chunks("output/chunks.jsonl")

    build_faiss_index(
        chunks,
        index_path="output/faiss.index",
        metadata_path="output/metadata.json"
    )
Após a execução, gera o arquivo de índice correspondente e os vetores.
Os modelos de Embedding podem converter a pergunta do usuário e os Chunks de documento em vetores, e buscar por meio da similaridade entre vetores. A vantagem desta abordagem é que os vetores dos documentos podem ser calculados e armazenados antecipadamente, e quando o usuário faz uma pergunta, é suficiente calcular o vetor da pergunta apenas uma vez para召回 conteúdo relevante de um grande número de documentos rapidamente. No entanto, esta forma eficiente de busca também tem algumas limitações. Os modelos de Embedding codificam a Query e os Chunks separadamente e comparam a similaridade entre os vetores no espaço vetorial. O modelo de Reranker é uma busca interativa. Ao enviar a Query e os Chunks candidatos ao modelo, ele analisa diretamente a relação semântica entre os textos, permitindo uma comparação semântica mais detalhada.
Portanto, nos sistemas de RAG geralmente adotamos uma busca de duas etapas: busca por Embedding + reordenamento por Reranker. Primeiro, utiliza-se o Embedding para filtrar rapidamente uma lista de resultados candidatos de uma grande quantidade de Chunks, depois utiliza-se o Reranker para realizar uma avaliação mais refinada de relevância e reordenar uma pequena quantidade de resultados candidatos. Dessa forma, garante-se a eficiência da busca e melhora a qualidade do contexto final fornecido ao modelo de linguagem grande.
Nesta seção, usamos o Qwen3-Reranker-0.6B como modelo de reordenamento, pode-se iniciar o serviço com ms-swift:
CUDA_VISIBLE_DEVICES=0 \
swift deploy \
    --model Qwen/Qwen3-Reranker-0.6B \
    --task_type generative_reranker \
    --infer_backend transformers \
    --host 0.0.0.0 \
    --port 18001
Após o serviço iniciar, pode-se enviar a pergunta do usuário e os Chunks candidatos recuperados pelo Embedding para o Reranker, reordenar com base na pontuação de relevância calculada pelo modelo e selecionar os Chunks com pontuação mais alta como referência para o modelo de linguagem grande gerar a resposta.
Antes, completamos o serviço de Embedding, o serviço de Reranker e o índice de vetores do Faiss. Com base nisso, seguindo o método de busca de duas etapas mencionado anteriormente (recuperação por Embedding + reordenamento por Reranker), selecionamos os Chunks candidatos.
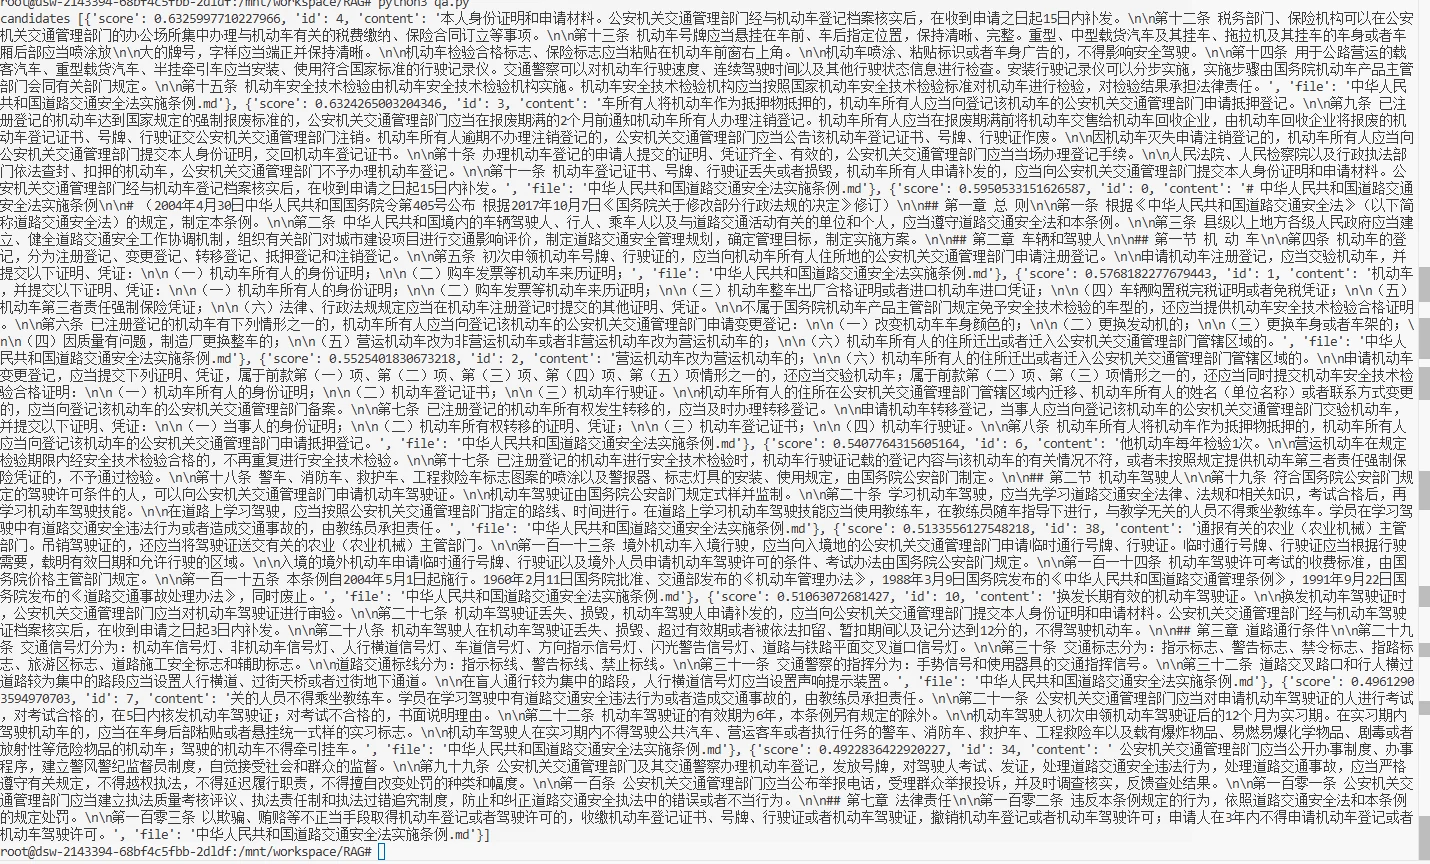
A primeira etapa usa o Faiss para realizar uma busca de vetores na base de conhecimento, primeiro obtém os Chunks candidatos com a similaridade mais alta (top 10), a seguir são os resultados da busca de vetores top 10 para a pergunta: "Para a primeira solicitação de placa de identificação de veículo e licença de condução, para qual departamento solicitar o registro e inscrição?".
import json
import faiss
from build_index import get_embedding
def load_faiss_index(index_path="faiss.index",
                     metadata_path="metadata.json"):

    index = faiss.read_index(index_path)

    with open(metadata_path, "r", encoding="utf-8") as f:
        metadata = json.load(f)

    return index, metadata
def search(query,index,metadata,top_k=10):

    query_embedding = get_embedding(query)
    query_embedding = query_embedding.reshape(1, -1)
    faiss.normalize_L2(query_embedding)
    scores, indices = index.search(query_embedding,top_k)
    results = []
    for score, idx in zip(scores[0], indices[0]):
        if idx == -1:
            continue
        chunk = metadata[idx]
        results.append({
            "score": float(score),
            "id": chunk.get("id"),
            "content": chunk.get("content"),
            "file": chunk.get("file")
        })

    return results
index, metadata = load_faiss_index(
        "output/faiss.index",
        "output/metadata.json"
    )
query="Para a primeira solicitação de placa de identificação de veículo e licença de condução, para qual departamento solicitar o registro e inscrição?"
candidates = search(
    query=query,
    index=index,
    metadata=metadata,
    top_k=10
)

print("candidates",candidates)
A segunda etapa usa o Reranker para reordenar os resultados candidatos. Envia a pergunta do usuário e os Chunks recuperados pelo Embedding para o Reranker, recalcular a pontuação de relevância entre eles e reordenar de acordo com a pontuação, da mais alta para a mais baixa.
def rerank(query, candidates):
    results = []
    for candidate in candidates:
        response = rerank_client.chat.completions.create(
            model="Qwen3-Reranker-0.6B",
            messages=[
                {
                    "role": "user",
                    "content": query
                },
                {
                    "role": "assistant",
                    "content": candidate["content"]
                }
            ]
        )

        score = response.choices[0].message.content[0]
        item = candidate.copy()
        item["rerank_score"] = float(score)
        results.append(item)
    results.sort(
        key=lambda x: x["rerank_score"],
        reverse=True
    )
    for rank, item in enumerate(results, start=1):
        item["rerank_rank"] = rank

    return results
A seguir são os resultados da reordenação do modelo Reranker para a pergunta: "Para a primeira solicitação de placa de identificação de veículo e licença de condução, para qual departamento solicitar o registro e inscrição?".
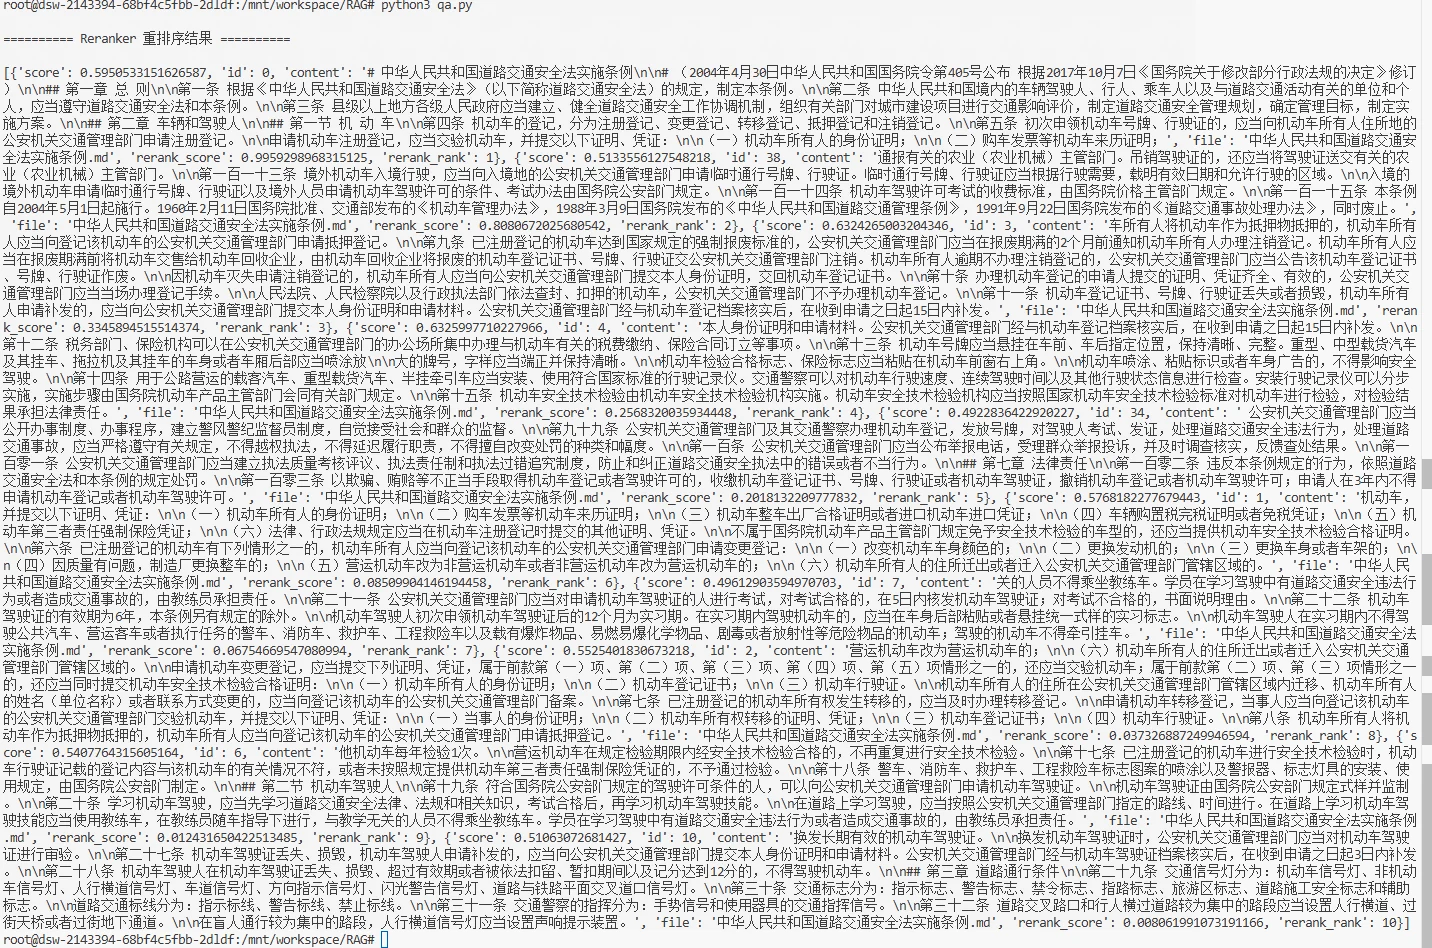
Dos resultados acima, pode-se ver que a ordem dos Chunks após a reordenação mudou significativamente. Em projetos reais, pode-se ajustar a quantidade de Chunks final retidos com base na escala da base de conhecimento, na duração dos Chunks, na complexidade da pergunta e no desempenho da busca real. Por exemplo, para perguntas cuja resposta está distribuída em vários fragmentos de documento, pode-se aumentar a quantidade final de Chunks retidos; também pode-se combinar a busca mista (Hybrid Search), que combina a busca de vetores com a busca de termos-chave como BM25, para fuzionar os resultados de várias buscas e depois reordená-los.
Após a pesquisa e reordenação, já obtemos vários Chunks com alta relevância para a pergunta do usuário. Em seguida, é necessário fornecer esses conteúdos como referência, junto com a pergunta do usuário, para o LLM. Se a relevância for satisfatória, submete os conteúdos recuperados para o modelo de linguagem grande gerar a resposta; se não houver conteúdo suficientemente relevante na base de conhecimento, retorna-se uma resposta de recusa, evitando que o modelo gere uma resposta sem base.
Primeiro, inicia-se o serviço do modelo grande no Notebook, neste experimento, usamos o modelo Qwen3-4B, o modo de inicialização é o seguinte:
CUDA_VISIBLE_DEVICES=0 swift deploy \
  --model Qwen/Qwen3-4B \
  --load_args false \
  --infer_backend vllm \
  --enable_thinking false \
  --host 0.0.0.0 \
  --port 18002 \
  --api_key 123 \
  --vllm_gpu_memory_utilization 0.8 \
  --vllm_max_model_len 8000 \
  --max_new_tokens 2000
Após o serviço iniciar, exibe a seguinte mensagem, indicando que o modelo foi iniciado com sucesso, após o serviço iniciar, pode-se chamar o Qwen3-4B através da porta 18002.
O Reranker reordena de acordo com a relevância entre a pergunta do usuário e os Chunks candidatos. Neste experimento, selecionamos diretamente os 5 Chunks com a maior pontuação como referência para o LLM. Para fazer com que o modelo responda sempre com base no conhecimento da base de dados, pode-se limitar o alcance da resposta no Prompt. Ao mesmo tempo, quando os materiais fornecidos não conseguem responder à pergunta do usuário, exige-se que o modelo respondesse "Não é possível responder a pergunta com base na base de conhecimento atual." O prompt é o seguinte:
prompt = f"""
Baseado nos seguintes materiais, responda à pergunta do usuário.

Materiais de referência:
{context}

Pergunta do usuário:
{query}

Requisitos:
1. Responda apenas com base nos materiais de referência;
2. Responda de forma precisa e concisa;
3. Não adicione informações que não existem nos materiais de referência;
4. Se os materiais de referência não possuem resposta para a pergunta, responda:
   "Não é possível responder a pergunta com base na base de conhecimento atual."
"""
Após o modelo de linguagem gerar a resposta, além de retornar a resposta final para o usuário, também pode-se retornar a fonte dos materiais de referência desta resposta. Para o cenário de perguntas e respostas corporativas, as informações de fonte ajudam o usuário a entender de quais documentos da base de conhecimento a resposta vem, e em caso de necessidade de confirmação adicional, pode-se voltar ao documento original para verificar o conteúdo relevante. As informações de fonte não precisam ser geradas pelo modelo de linguagem, mas obtidas diretamente dos metadados dos resultados da pesquisa. Antes da construção da base