10 casos de uso: o que os modelos open-source de AIGC podem alcançar?
Os modelos mais poderosos de geração de imagens e vídeos atualmente são provavelmente GPT Images 2.5 e Seedance 2.5, empurrando ainda mais os limites da geração.
Se os considerarmos como a primeira categoria de modelos de código fechado, em que nível estão os modelos de código aberto hoje? São apenas brinquedos? Podem realmente trazer produtividade real?
Este artigo examina diretamente o que os especialistas conseguem fazer com modelos de código aberto, usando Z-Image da Alibaba para geração de imagens e MiniMax H3 para geração de vídeos.
Introdução a estes dois modelos
Z-Image é um modelo de geração de imagens de 6B parâmetros, distribuído sob a licença Apache 2.0. O Z-Image completo é um modelo base não destilado que suporta CFG, prompts negativos e fine-tuning; a comunidade usa mais comumente o Z-Image-Turbo, que utiliza apenas 8 passos e prioriza velocidade.
MiniMax H3 é um modelo de geração de áudio-vídeo de 33B parâmetros, capaz de produzir vídeos de 4 a 15 segundos, a 24fps, com áudio estéreo. Estritamente falando, é um modelo de pesos abertos usando a MiniMax H3 Community License. O H3-Base de código aberto pode gerar áudio-vídeo em 768p localmente, mas o módulo Context-IR oficial para compreensão de entradas complexas e o pipeline de regeneração 2K não foram totalmente disponibilizados como open-source.
Z-Image: além de apenas desenhar rostos bonitos
Muitos modelos de geração de imagens hoje podem gerar rostos bonitos. Olhar para um único rosto retoque não é realmente impressionante. As verdadeiras dificuldades são: o texto está escrito corretamente? A contagem está certa? O mesmo produto pode manter consistência em diferentes visões? Relações espaciais complexas são compreendidas corretamente?
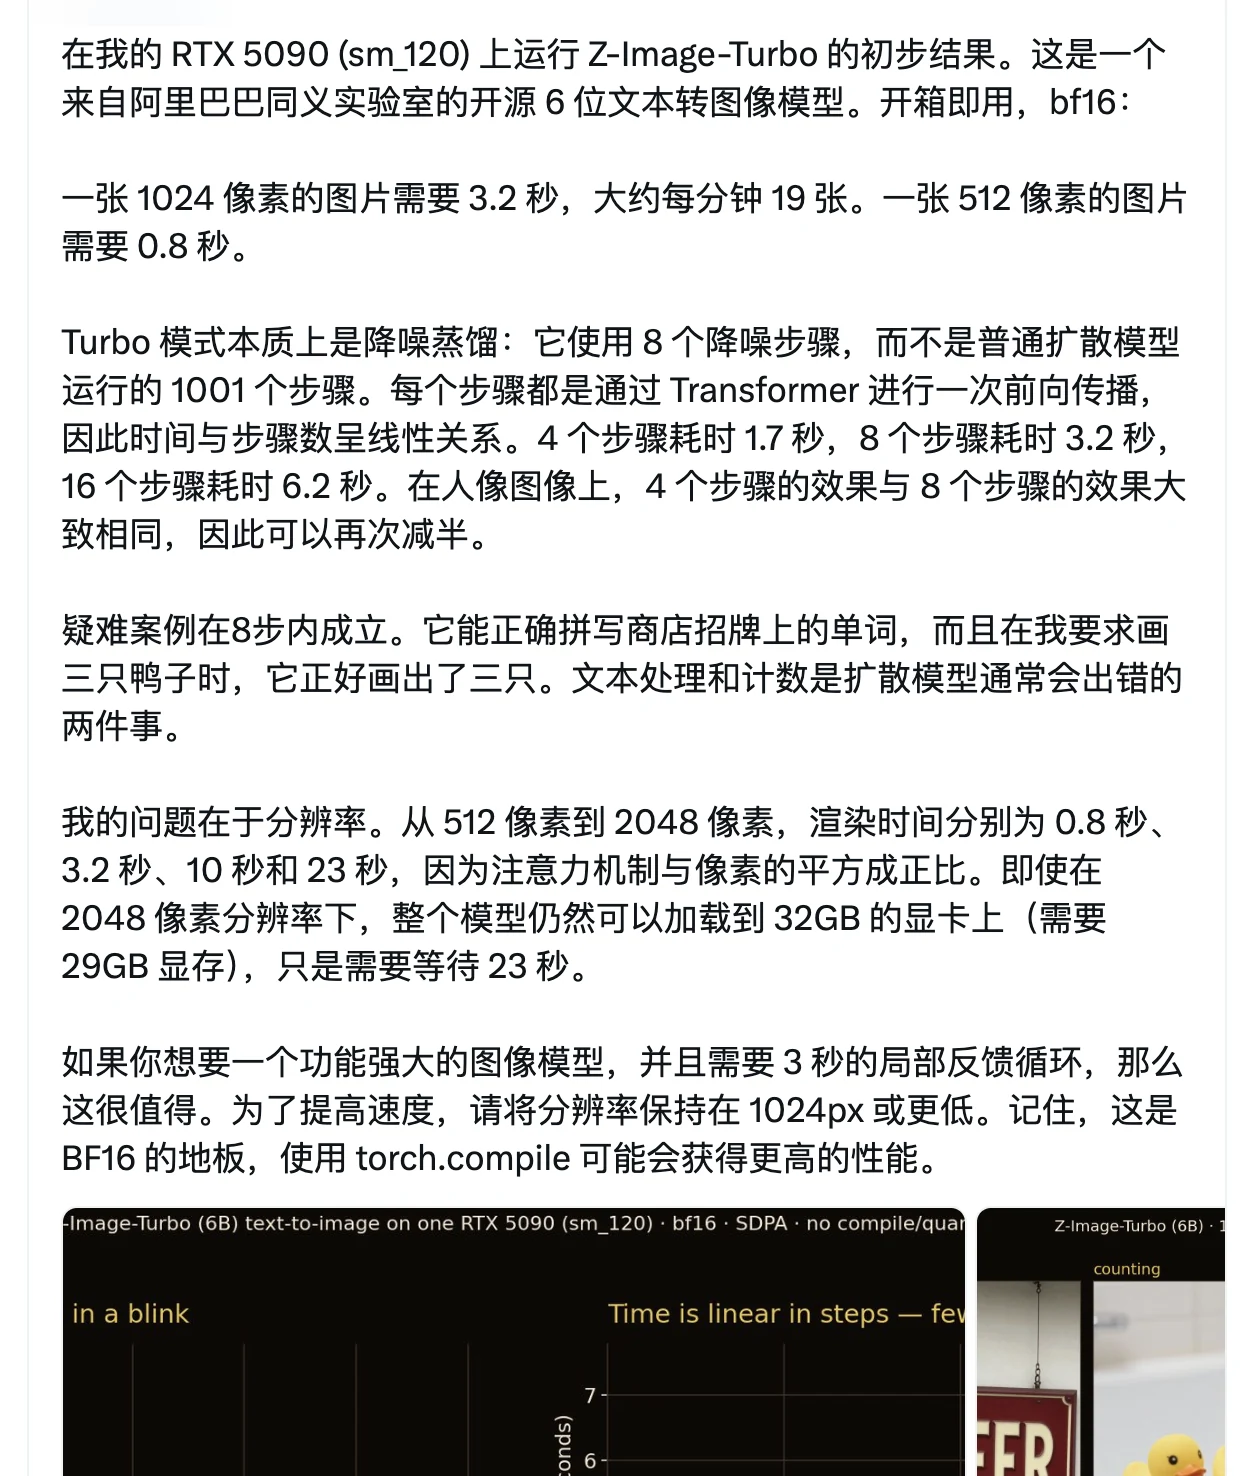
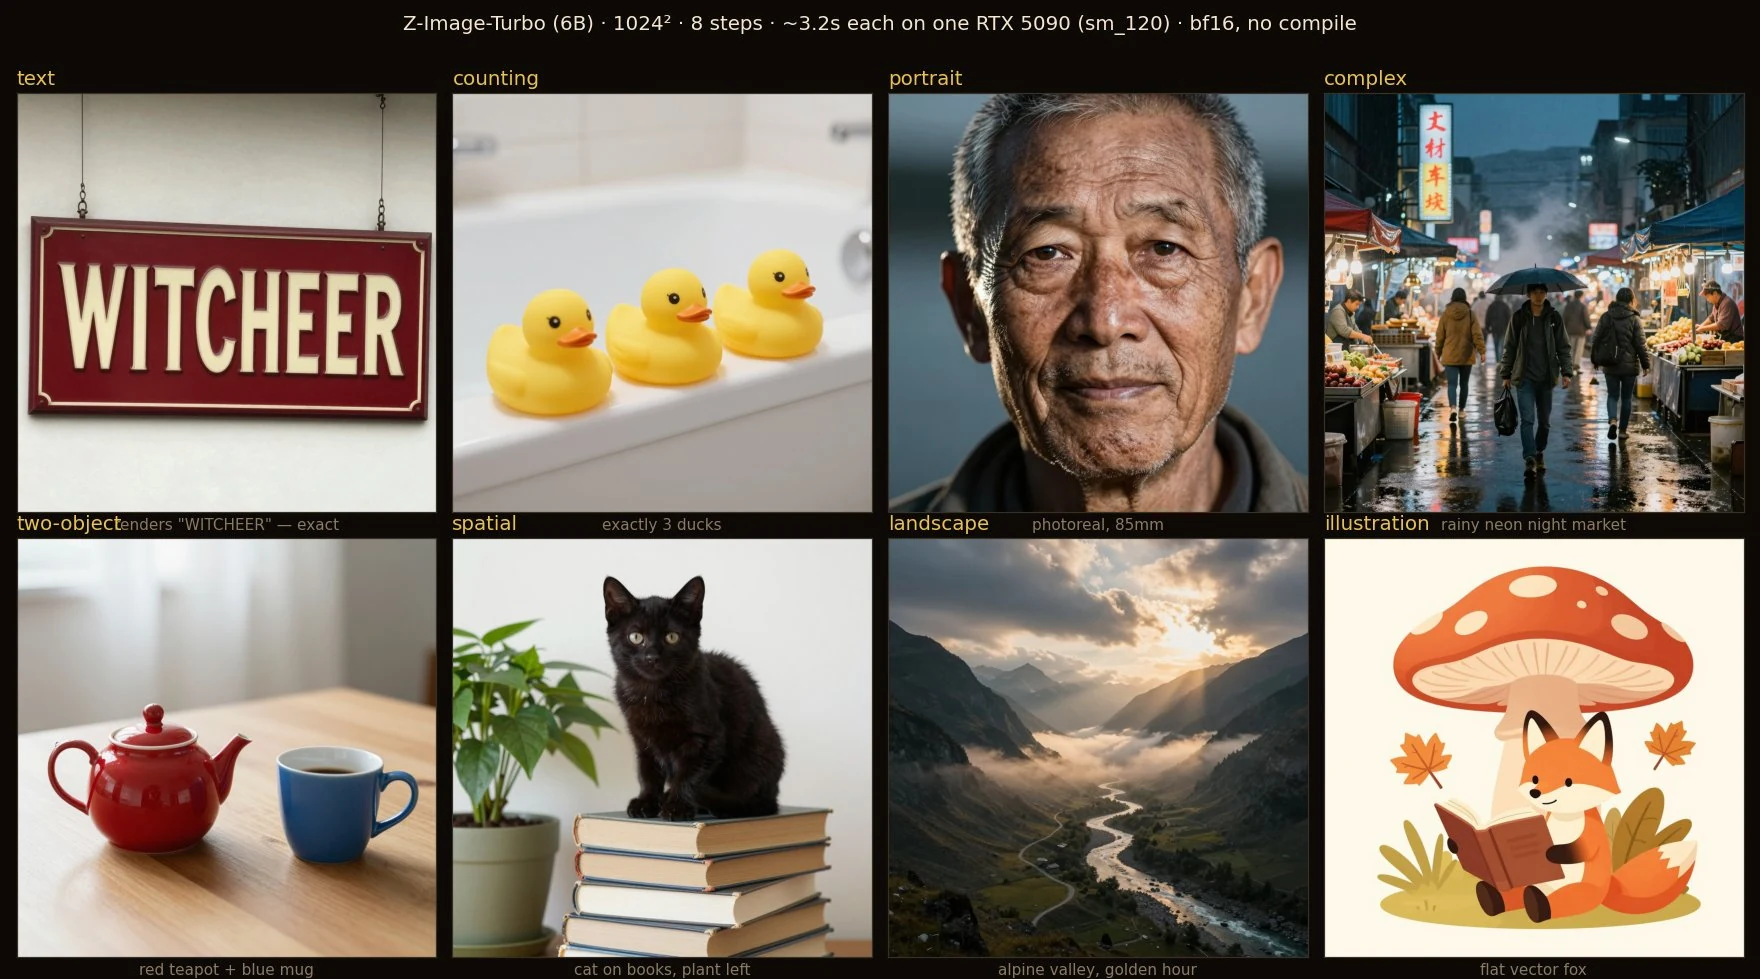
Vamos começar olhando um conjunto de testes locais de @witcheer.
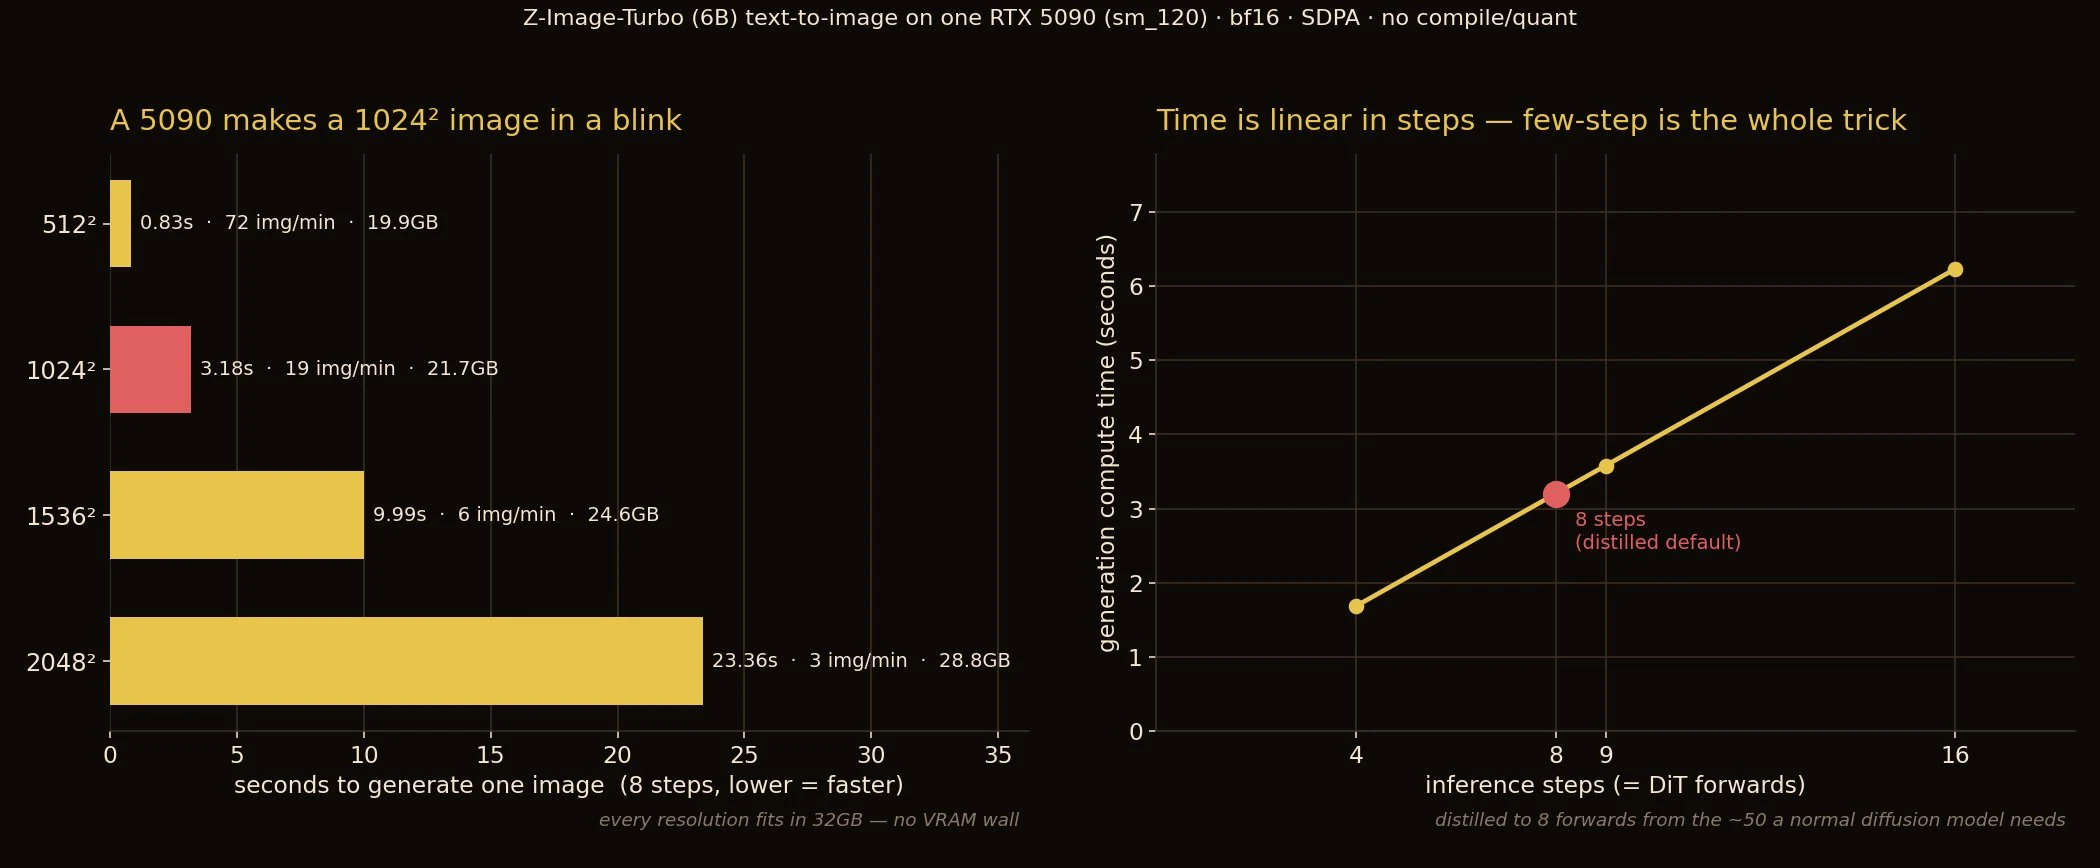
Ele executou Z-Image-Turbo em um RTX 5090, gerando imagens de 1024px em aproximadamente 3,2 segundos cada. O prompt pedia uma placa de loja com palavras especificadas, mais "exatamente três patos", e tanto o texto quanto a contagem estavam corretos.
Essas duas tarefas parecem simples, mas na verdade foram desafios persistentes para modelos de difusão. Letras tendem a borrar, e três patos frequentemente se tornam misteriosamente quatro ou cinco.
Em seguida, um caso mais próximo da produção de e-commerce.
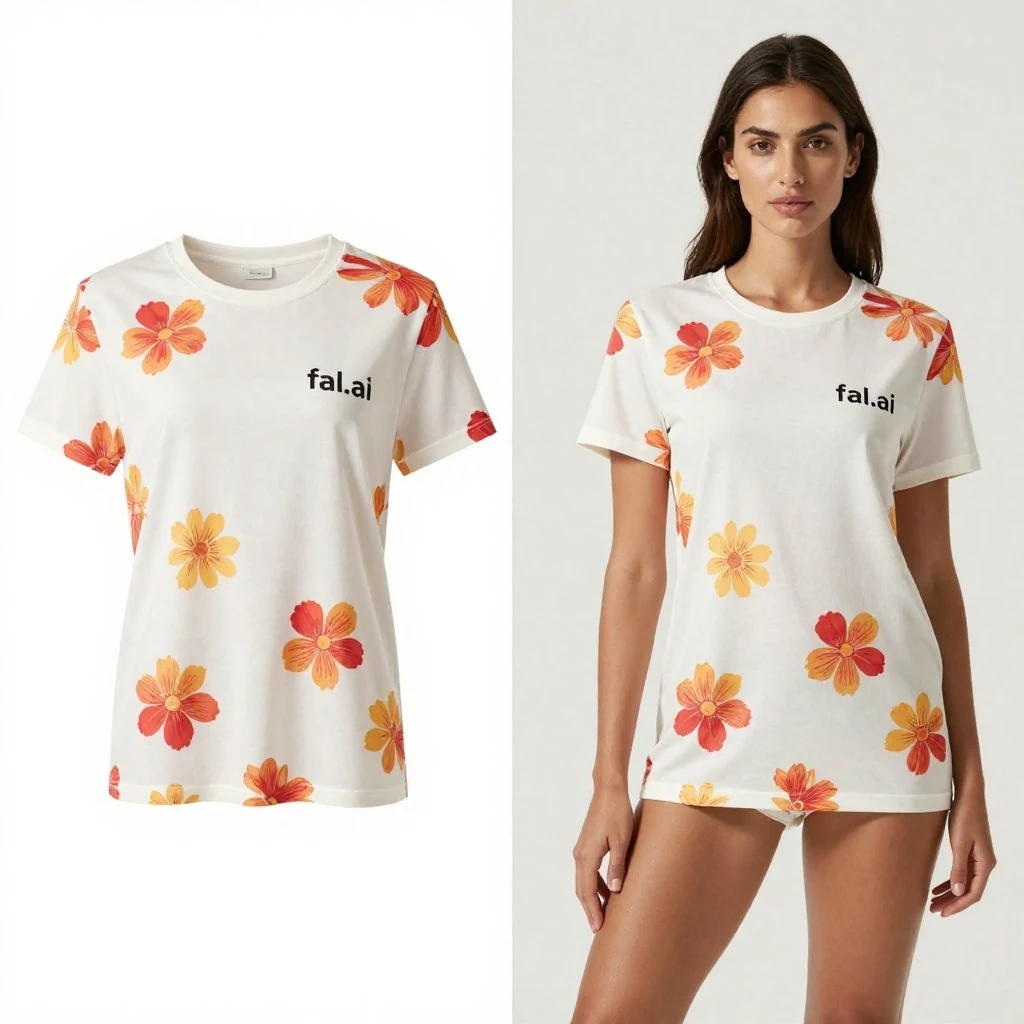
@rizavelioglu pediu ao modelo que gerasse uma imagem dividida lado a lado: à esquerda apenas uma camiseta branca com estampa, à direita um modelo real usando a mesma peça. O prompt também pedia preservar a estampa, o texto, o tecido, as costuras e o corte.
O resultado final mostrou que a roupa dos dois lados não foi gerada independentemente — os padrões e o estilo corresponderam bem. Para equipes de e-commerce, isso é muito mais valioso do que simplesmente gerar uma "bonita foto de modelo". Imagens de produto, imagens de uso e imagens de marketing podem todas continuar a partir do mesmo design.
Claro, esta é apenas uma amostra bem-sucedida, e ainda há uma distância antes da produção em lote estável. Mas pelo menos prova que a direção funciona.
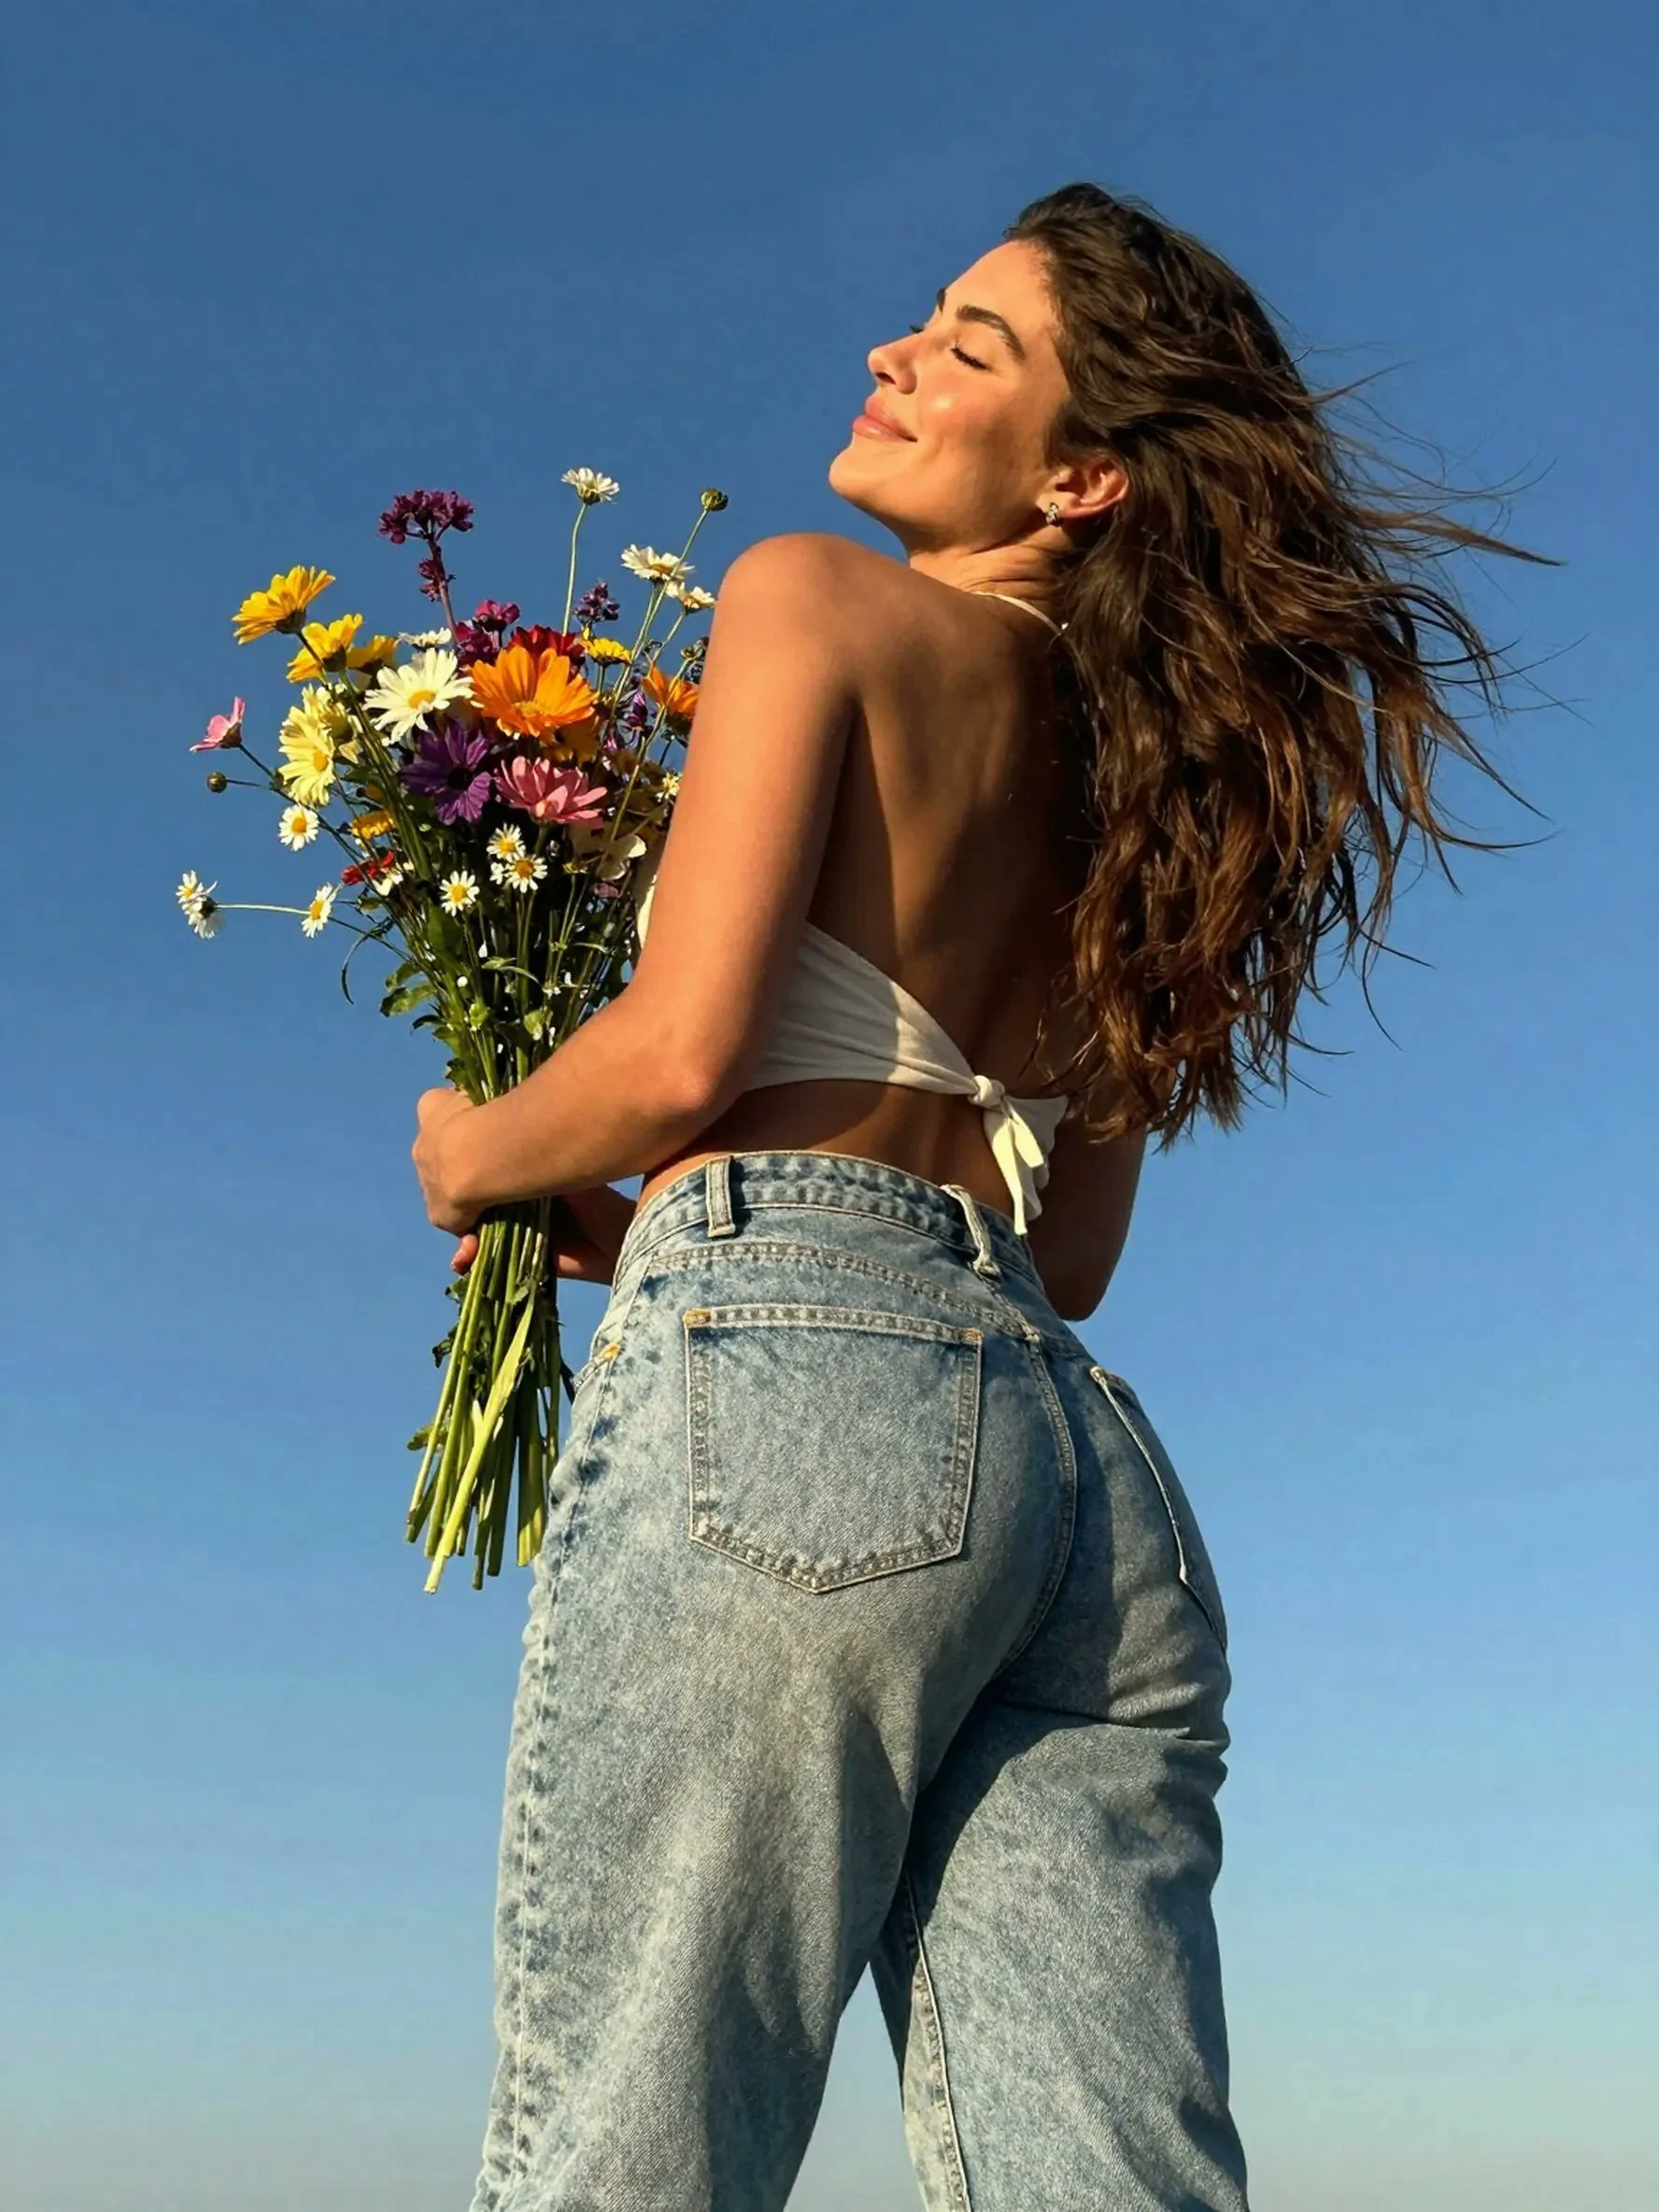
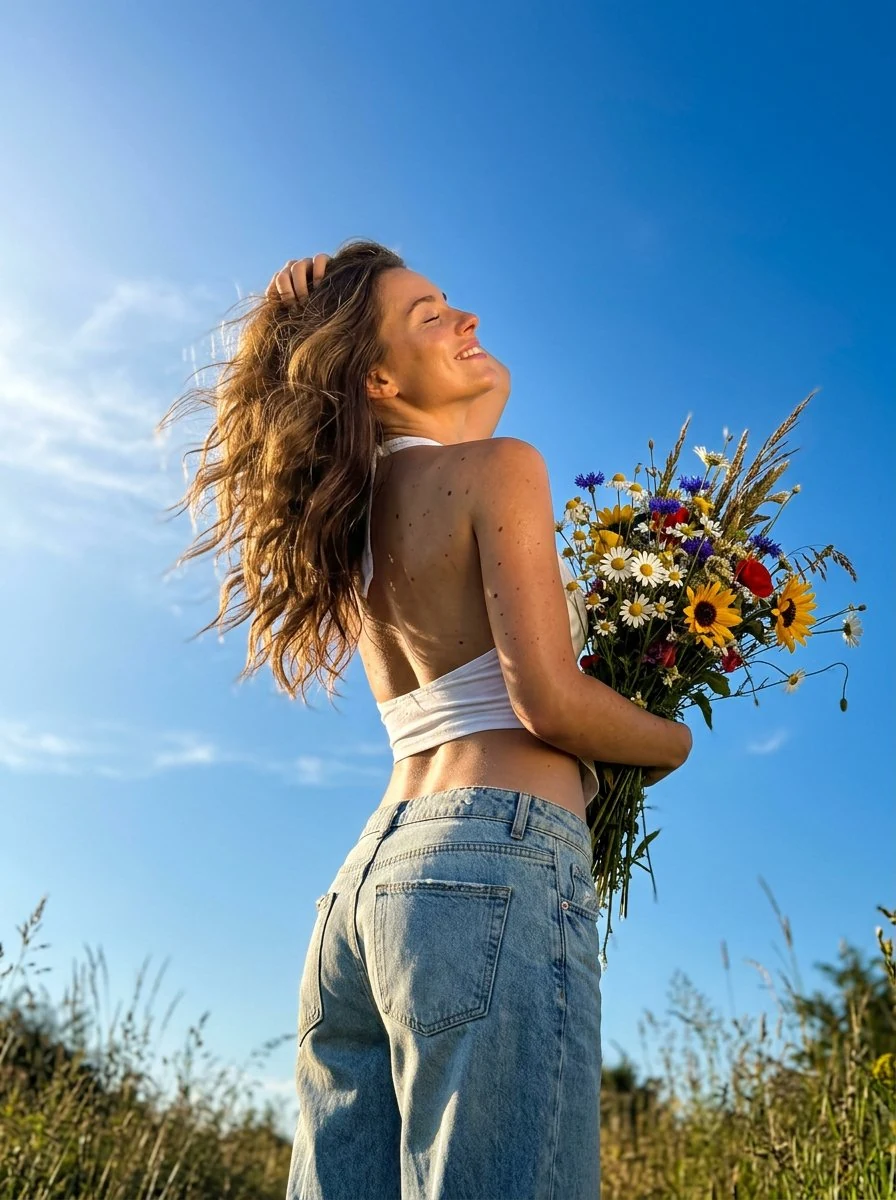
Para retratos realistas, @dreamydigiarts criou uma comparação com o mesmo prompt.
Ele pediu a Z-Image-Turbo e Nano Banana 2 que gerassem ambos uma foto de celular com ângulo baixo: céu azul, contra-luz, pessoa inclinada para trás, segurando um grande buquê de flores selvagens, cabelo soprado pelo vento, preservando a leve granulosidade das fotos de celular.
O resultado do Z-Image já tinha uma forte sensação de foto candid. Jeans, pele e contra-luz não se borraram em uma camada plástica, e a composição com ângulo baixo foi sólida. Para fotos atmosféricas de personagens e imagens de redes sociais, isso já está muito além do nível de brinquedo.
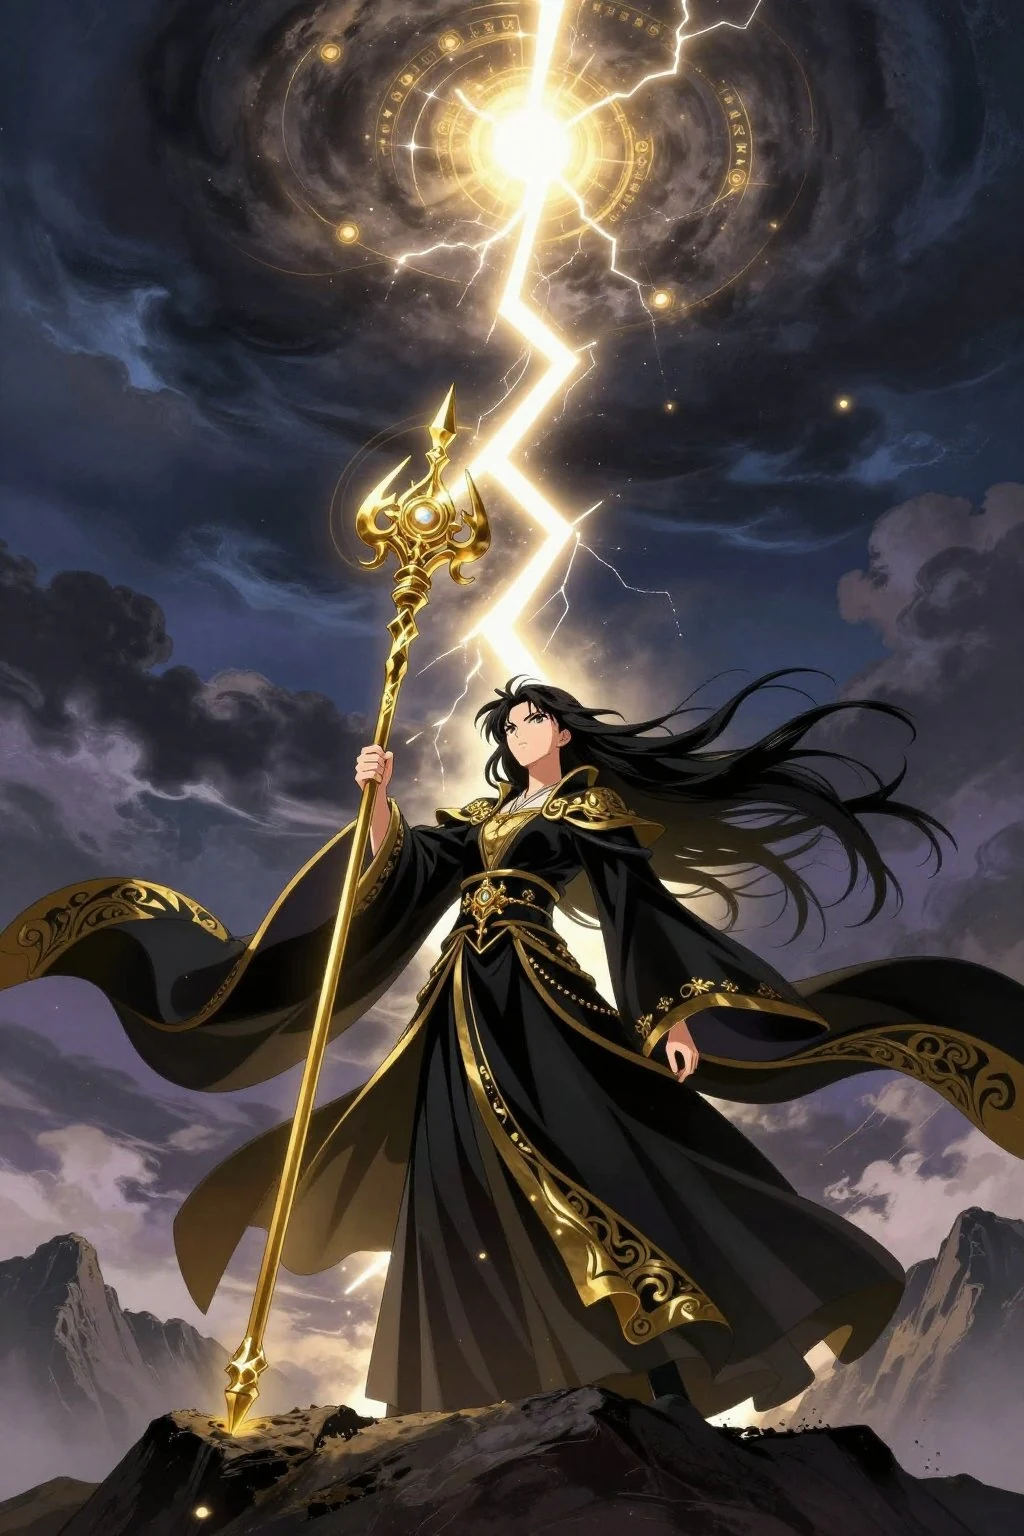
Z-Image também não se limita ao realismo. @tisch_eins testou Boogu, Flux 2 Klein e Z-Image-Turbo com o mesmo prompt. A cena pedia uma feiticeira de cabelo preto de pé no topo de uma montanhem tempestuosa, com um cajado dourado totalmente visível da mão ao topo, um raio disparando da ponta do cajado para as nuvens, além de composição com ângulo baixo, corpo inteiro, capa, runas, arcos elétricos e forte iluminação dourada de contorno.
Esse tipo de prompt é facilmente descuidado: o cajado é cortado, o raio se conecta no lugar errado, e o personagem pode acabar como apenas uma cabeça grande. O resultado do Z-Image manteve todas as relações principais, mostrando forte controle sobre composições de ilustração complexas.
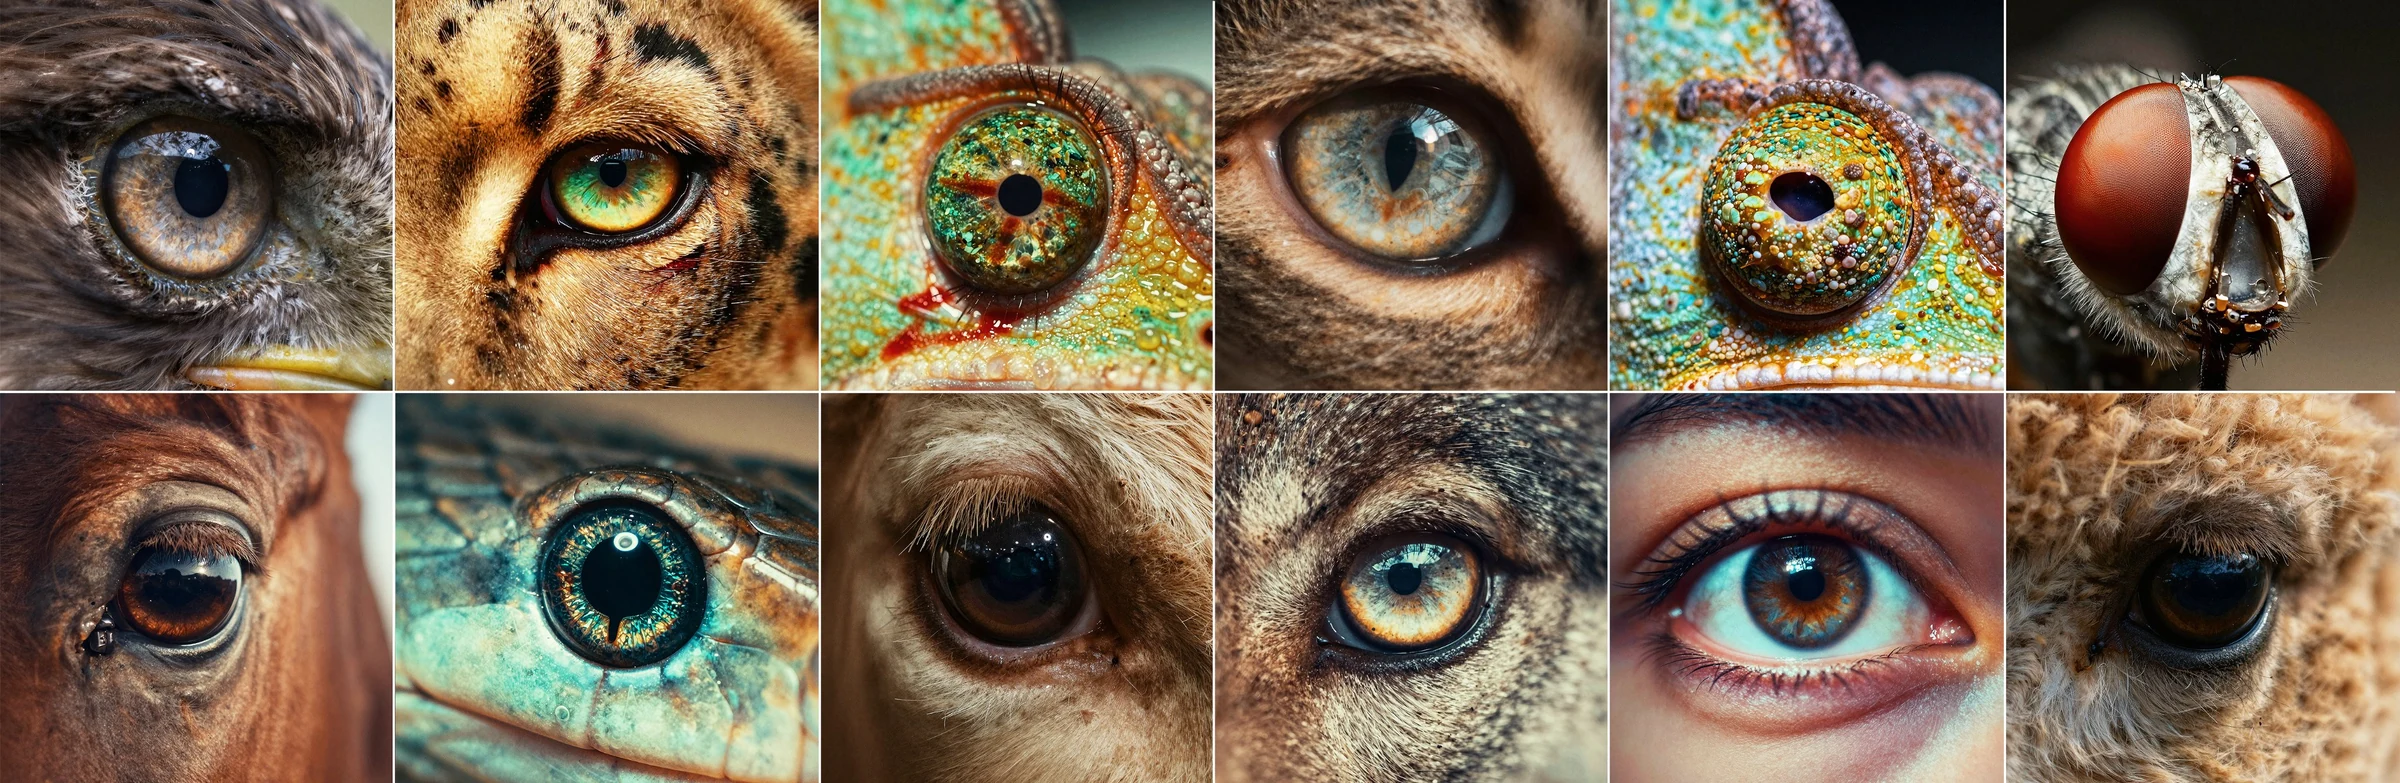
O último é macro extremo. O prompt de @aisthetiic era muito curto: a pupila de um animal preenchendo o quadro principal, com iluminação dramática vindo do canto superior esquerdo revelando a textura da íris, e um fundo em gradiente do escuro para bokeh claro.
O que é ainda mais interessante é que a imagem não desmoronou. O olhar está firmemente fixo na pupila, com luz, sombra e fundo todos servindo ao mesmo sujeito. Ao criar visuais de pôster ou capas emotivas, esse tipo de conformidade composicional é mais útil do que empilhar dez mil palavras-chave "8K, obra-prima, ultra-detalhado".
Olhando esses 5 casos juntos, as vantagens do Z-Image são bastante claras:
O modelo é pequeno, rápido, capaz em realismo, e pode entender prompts de linguagem natural relativamente longos. O modelo base completo também pode ser usado para LoRA, ControlNet e fine-tuning setorial.
MiniMax H3: vídeo open-source começa a ter um toque cinematográfico
Geração de vídeo é muito mais difícil do que geração de imagem. Um único dedo mal desenhado em uma imagem às vezes pode ser cortado. Mas em vídeo, se o rosto do personagem muda em 15 segundos, a câmera não segue a linha do tempo, diálogos se misturam entre personagens, ou efeitos sonoros não combinam com ações — qualquer erro arruína toda a peça.
Nos casos de H3, a primeira coisa que vale a pena examinar é a consistência de personagens duplos.
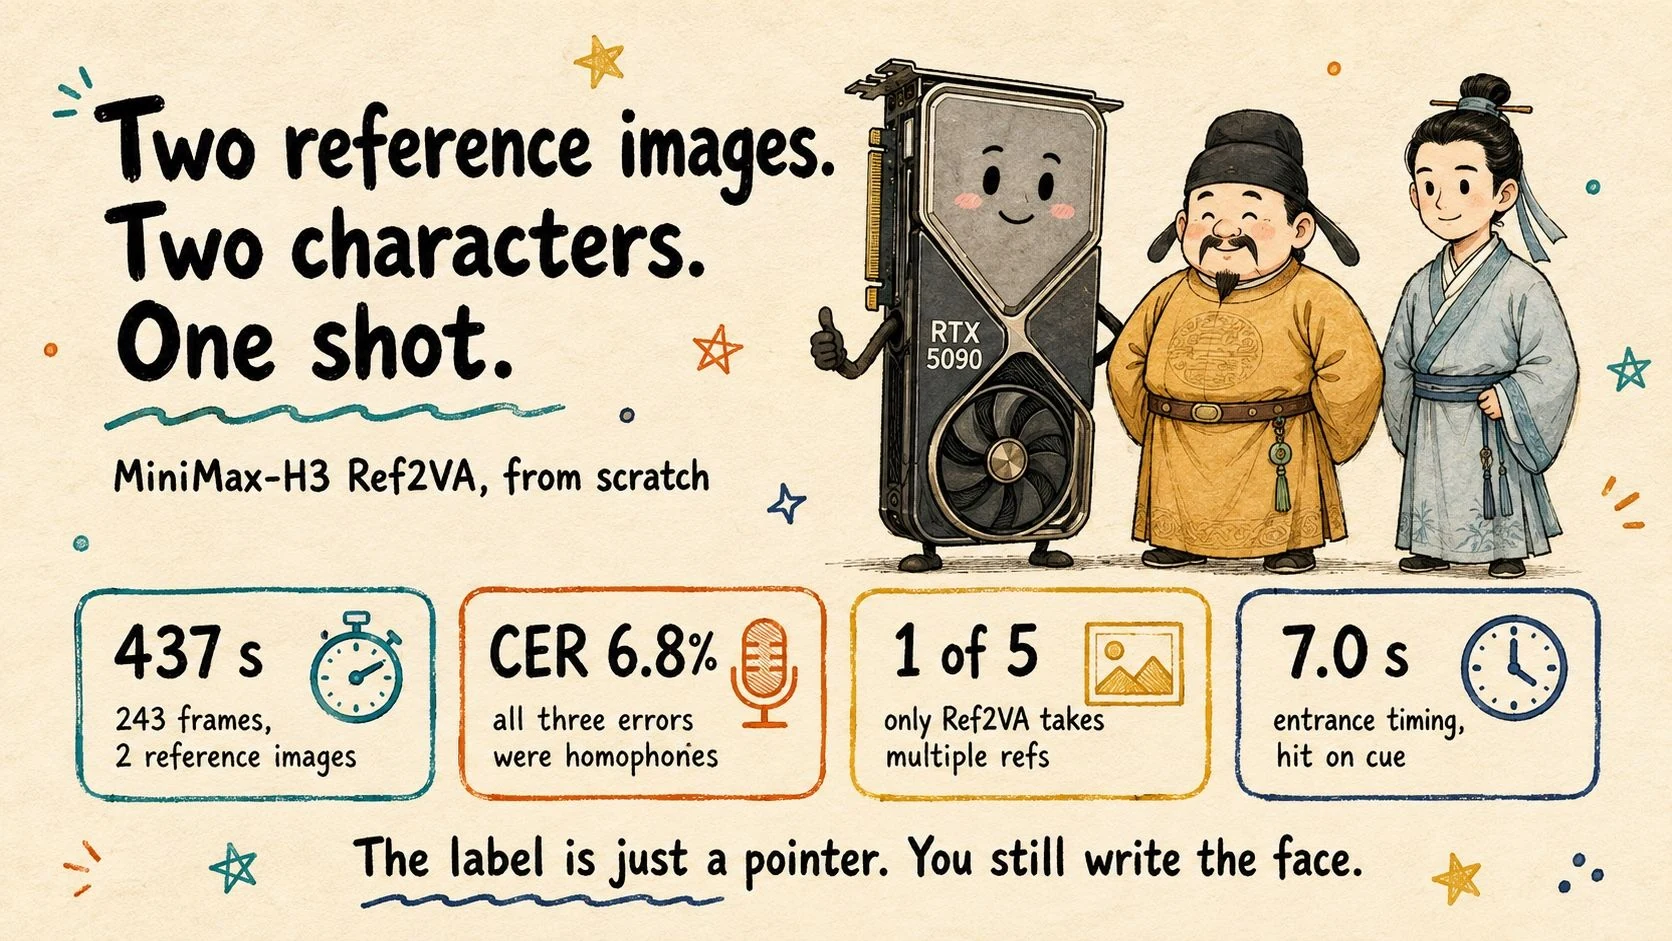
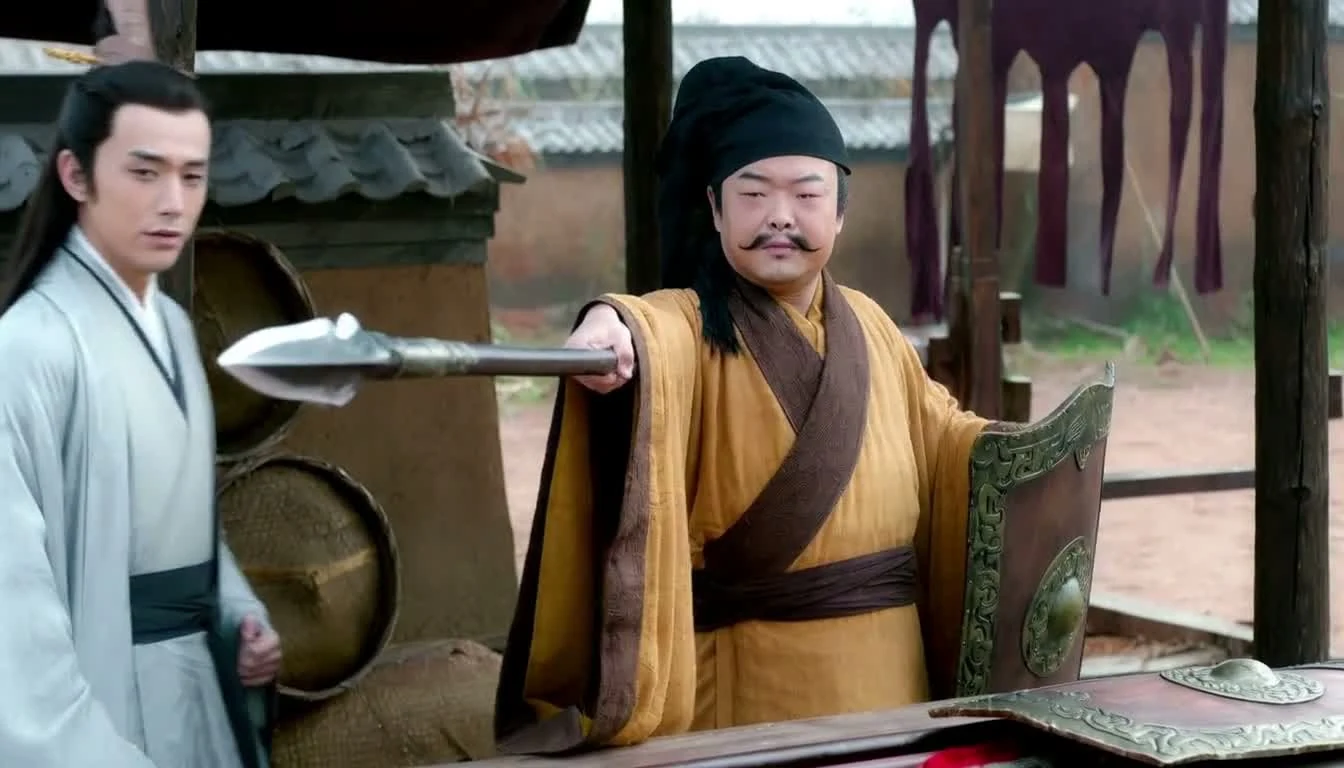
@coolthor alimentou duas imagens de design de personagens geradas por Z-Image no modo Ref2VA do H3. Um veste uma túnica ocre, o outro roupas cinza-azuladas, com aparências deliberadamente diferentes. O prompt programou a entrada de um personagem entre os segundos 6 e 8 e incluiu três linhas de diálogo chinês.
No vídeo de 10,125 segundos, os dois personagens não trocaram rostos nem roupas. O personagem programado para entrar não apareceu na primeira metade e só chegou por volta do segundo 7. O autor então usou ASR para verificar 44 caracteres chineses, alcançando uma taxa de erro de caracteres de 6,8%, com erros sendo homófonos.
Isso foi executado em um único RTX 5090, levando 437 segundos para 243 quadros. A velocidade não é extremamente rápida, mas poder controlar simultaneamente personagem, temporização e diálogo já é muito impressionante.
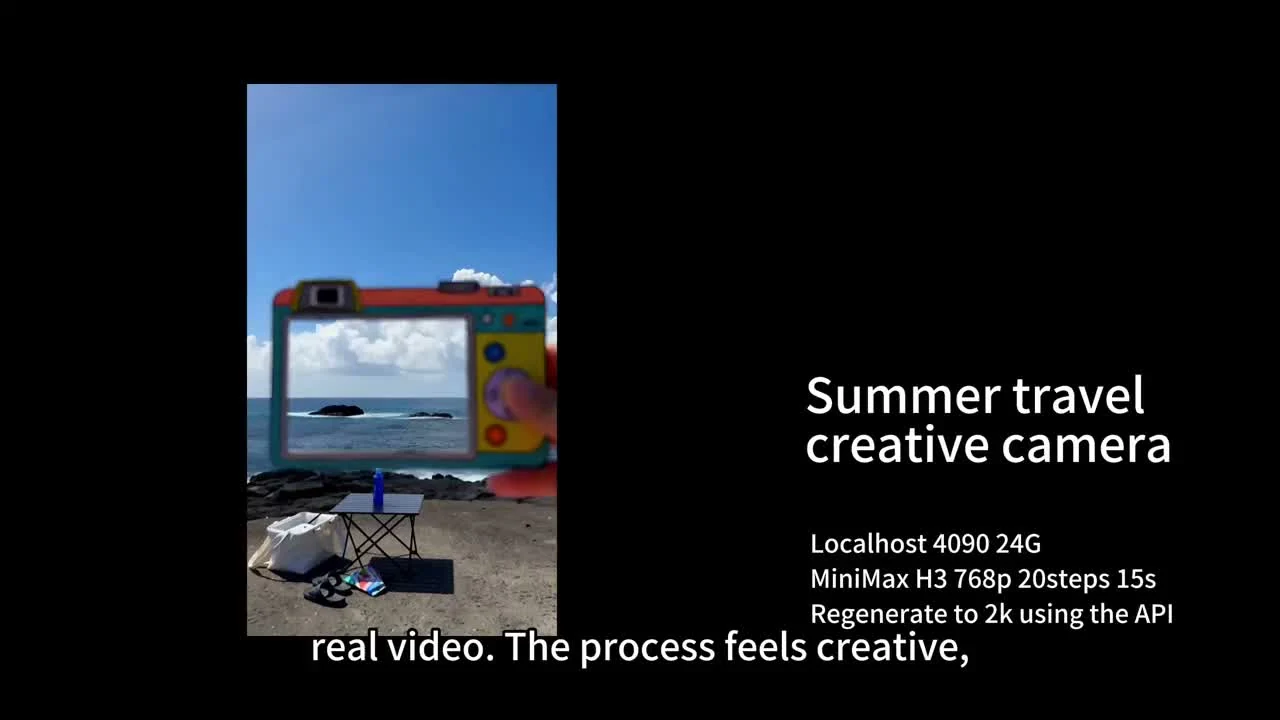
Usando um RTX 4090 e ComfyUI, ele fez três tentativas: um curta-metragem de viagem de quatro cenas, um clipe musical que muda de cena com batidas de tambor, e uma história costeira com 4 planos e som ambiente. A ideia inicial foi primeiro enviada ao Prompt Writing Skill oficial da MiniMax para criar prompts estruturados com planos, temporização, ações e sons, e então passada ao H3.
O aspecto mais útil desse caso é que ele não apenas produziu "imagens bonitas". Quando a batida do tambor chega, a cena realmente muda; no clipe costeiro, os quatro planos, atmosfera e som de fundo saíram todos juntos em uma rodada.
Seus dados de benchmark: o 4090 leva mais de 200 segundos para um vídeo de 15 segundos em baixa resolução com 20 passos; escalar para 768p leva mais de 1000 segundos. Open source permite iterar repetidamente, mas gratuito não significa sem custo — eletricidade, VRAM e tempo de espera também são custos.
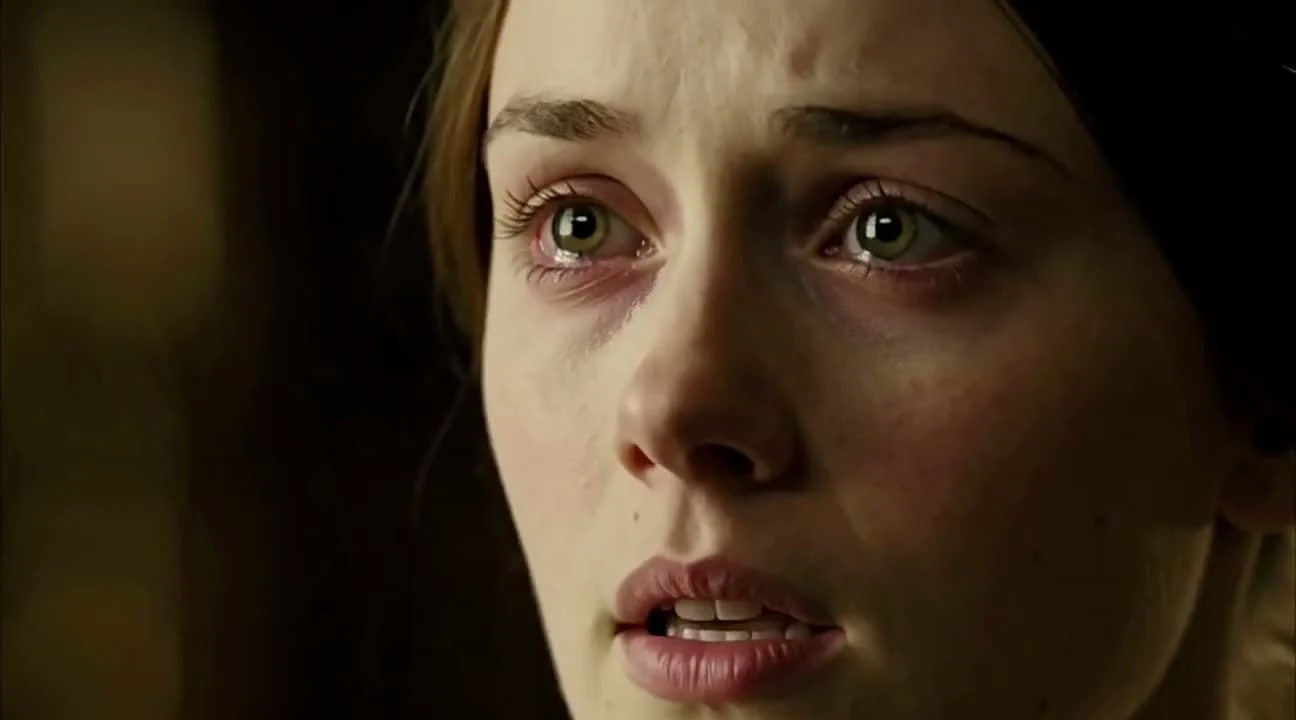
O segmento de 30 segundos ao estilo "Jane Eyre" de uma mansão britânica de @PixelAigc é ainda mais impressionante.
Seu prompt dividiu diretamente os 30 segundos em 4 planos. Cada segmento especificava distância focal, ângulo de câmera, posicionamento de personagens, microexpressões, diálogos, respiração, som ambiente e itens proibidos. As emoções dos personagens progrediram da tentative à réplica até a emoção, com restrições de voz separadas para vozes masculina e feminina.
Esta peça usou ComfyUI local com H3 Turbo LoRA, gerando primeiro em 480p, depois escalando para 1080p com Topaz. O autor relatou que 25 segundos levam aproximadamente 13 a 15 minutos. Isso não representa o desempenho bruto do modelo oficial, mas representa o aspecto mais interessante do ecossistema open-source: um mês após o lançamento do modelo, a comunidade já está modificando velocidade, criando vídeos longos e integrando super-resolução automática.
O limite oficial do H3 para um único segmento é de 15 segundos. Então como fazer vídeos mais longos?
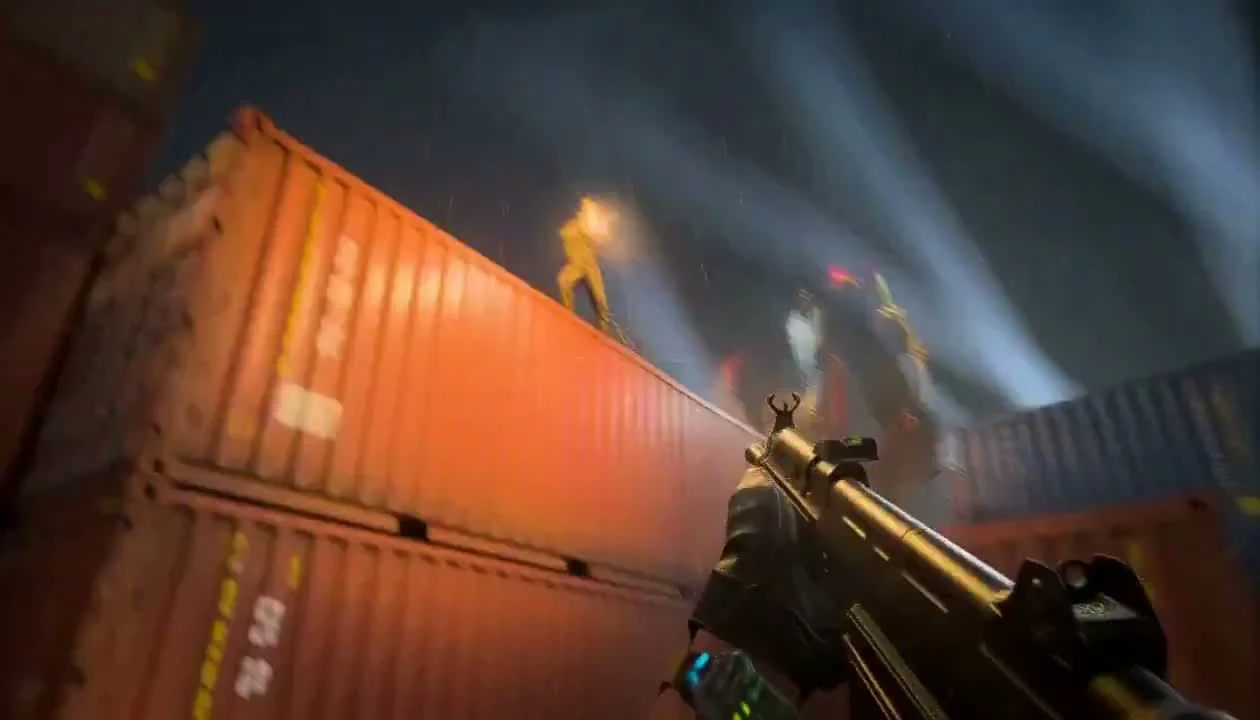
@superalesha usou 4 RTX 3090 para executar um filme de ação em primeira pessoa de 30 segundos. Ele encadeou dois segmentos de 15 segundos, parando deliberadamente o primeiro em um quadro estável, continuando a geração do mesmo quadro no segundo segmento, cortando os quadros duplicados, e deixando o áudio continuar.
A junção está escondida no segundo 15, quase invisível durante a visualização normal. A peça completa levou 44 minutos da geração até a conclusão. O valor deste caso não é que o H3 de repente superou o limite de duração, mas que alguém entendeu o limite e contornou com um fluxo de trabalho.
Também há um caso particularmente útil para estudar "como realmente escrever prompts de vídeo".
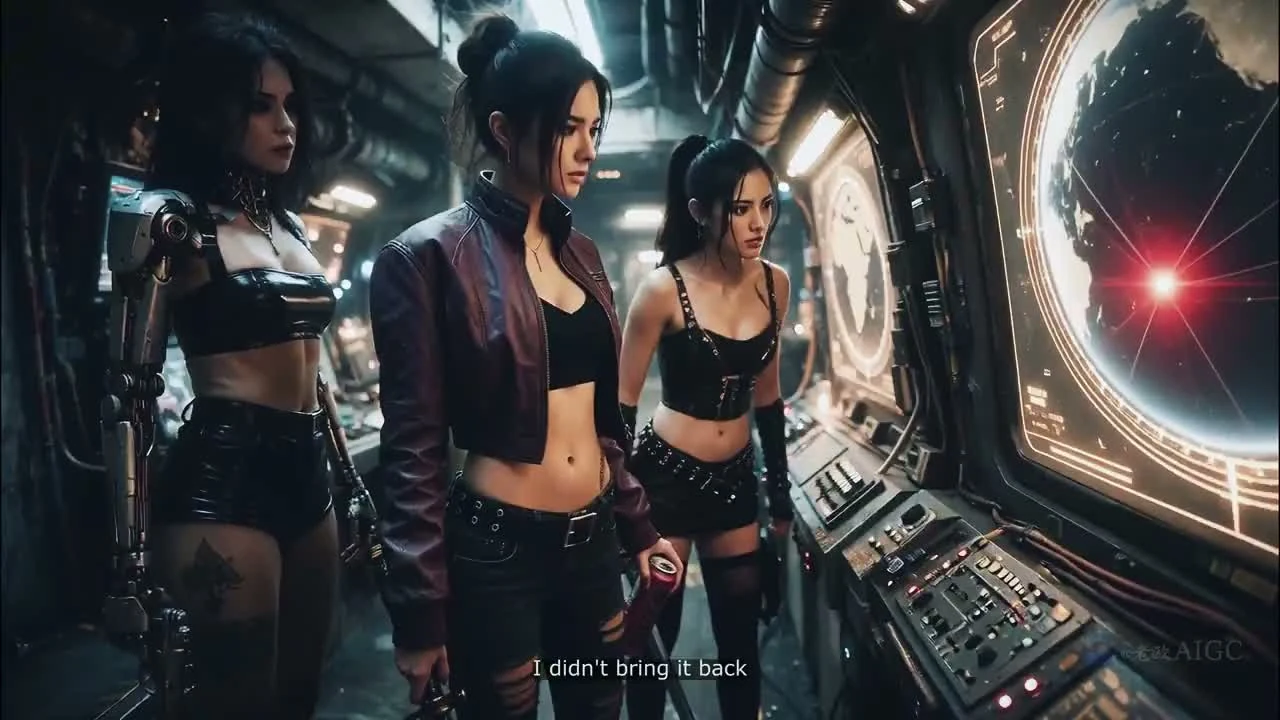
@ou_zhen599 usou ComfyUI local para criar um curta-metragem de nave cibernética de 15 segundos. A cena apresenta três personagens femininas: uma sentada à esquerda, outra de pé no centro com uma faca, e uma terceira de pé à direita segurando uma lata de refrigerante. O prompt não apenas descrevia a trama — especificava quem fala em qual segundo, que personagens silenciosos não devem mover os lábios, que a lata de refrigerante deve permanecer na mão direita o tempo todo, quando o ponto de rastreamento vermelho aparece na tela, e finalmente quando a sombra do lado de fora do portão se aproxima.
A parte mais difícil desse tipo de caso é manter o espaço estável, não perder acessórios, não misturar diálogos, e fazer com que personagens silenciosos realmente fiquem em silêncio. O H3 já conseguiu colocar todas essas restrições em um curta-metragem de 15 segundos. O jogo do vídeo open-source claramente mudou.
Se você apenas quer produzir rapidamente um vídeo pronto, modelos de código fechado ainda são a opção mais fácil.
Mas se você quer iterar repetidamente, gerar em lote, treinar seu próprio estilo, ou integrar capacidades em um fluxo de trabalho local, Z-Image e H3 valem um estudo sério. Use modelos open-source para prototipar rapidamente planos e material primeiro, depois chame modelos de código fechado apenas quando realmente estiver preso — os custos serão muito menores.
Modelos open-source costumavam ser uma consolação para quem esperava. Agora podem genuinamente participar de trabalho criativo real.
Para pessoas que precisam criar imagens e vídeos diariamente, a melhor mudança é que no futuro, cada vez que uma ideia surgir, você não precisará primeiro calcular quantos créditos esta rodada vai queimar.