No passado, criar um poster de promoção de produtos exigia vários passos, como preparação de materiais, design de fundo, disposição do produto, adição de texto e ajuste de dimensões. Se o mesmo produto fosse lançado em múltiplas plataformas, os designers geralmente precisariam ajustar a imagem para diferentes tamanhos.
Agora, com técnicas como geração de imagem a partir de texto (text-to-image), edição de imagem a partir de imagem (image-to-image), edição local e ajuste de modelo, é possível conectar a geração de ideias, design de produtos, modificação de imagens e adaptação de dimensões, formando um fluxo de produção de conteúdo de marketing relativamente completo.
Por exemplo, para um refrigerante, é necessário criar um poster de marketing com o tema "Verão", desejando que a imagem contenha elementos como cubos de gelo, bolhas d'água, limões e folhas verdes. Primeiro, é possível gerar uma imagem inicial de marketing rapidamente por meio da descrição em texto, em seguida, editar a imagem com base na foto do produto (image-to-image), adicionar o logo da marca e continuar modificando elementos locais conforme as necessidades. Finalmente, a mesma imagem de marketing pode ser expandida para diferentes tamanhos para uso em diferentes plataformas, como redes sociais, vídeos curtos e anúncios em sites.
Este capítulo vai usar o exemplo de uma imagem de marketing de bebida FRESH DAY para introduzir como construir uma linha de produção de conteúdo AIGC de marketing simples com modelos de imagem de geração abertos no ModelScope. O experimento começa com a geração de imagem a partir de texto, depois apresenta a edição de imagem a partir de imagem, manutenção do sujeito do produto, edição local, adaptação de dimensões e LoRA de estilo de marca.
A geração de imagem a partir de texto (Text-to-Image) refere-se a gerar imagens diretamente com base em uma descrição em texto. O usuário não precisa preparar materiais de design completos; basta descrever o conteúdo desejado para a imagem através de um Prompt, como tema, sujeito, fundo, cor, composição e estilo visual, e o modelo pode gerar a imagem correspondente com base nessa informação.
Para a produção de conteúdo de marketing, a geração de imagem a partir de texto é mais adequada para a exploração de ideias e geração de esquemas visuais iniciais. Por exemplo, antes de criar um poster de bebida de verão, é possível informar ao modelo "atmosfera de verão refrescante, cubos de gelo, bolhas d'água, limões, tom de azul-verde, estilo de fotografia comercial" e permitir que o modelo gere rapidamente uma imagem completa de marketing. Em comparação com começar a desenhar em uma tela em branco, essa abordagem permite ver rapidamente diferentes esquemas criativos.
Atualmente, a comunidade aberta já oferece modelos como Stable Diffusion, FLUX, Qwen-Image, Z-Image-Turbo e outros para geração de imagem. Diferentes modelos apresentam diferenças em qualidade da imagem, compreensão do Prompt, capacidade de geração de texto e requisitos de recursos de hardware.
Entrar participar da discussão
Nesta seção, o modelo Z-Image-Turbo no ModelScope será usado para experimentos de geração de imagem a partir de texto. A versão Turbo foca na otimização da eficiência de geração, podendo concluir a geração de imagens com menos passos de inferência, sendo ideal para desenvolvedores pessoais e ambientes de experimento com recursos de GPU limitados.
Usamos o framework DiffSynth-Studio para geração de imagem a partir de texto, baixe DiffSynth-Studio
!git clone https://github.com/modelscope/DiffSynth-Studio.git
%cd DiffSynth-Studio
3) Instalação
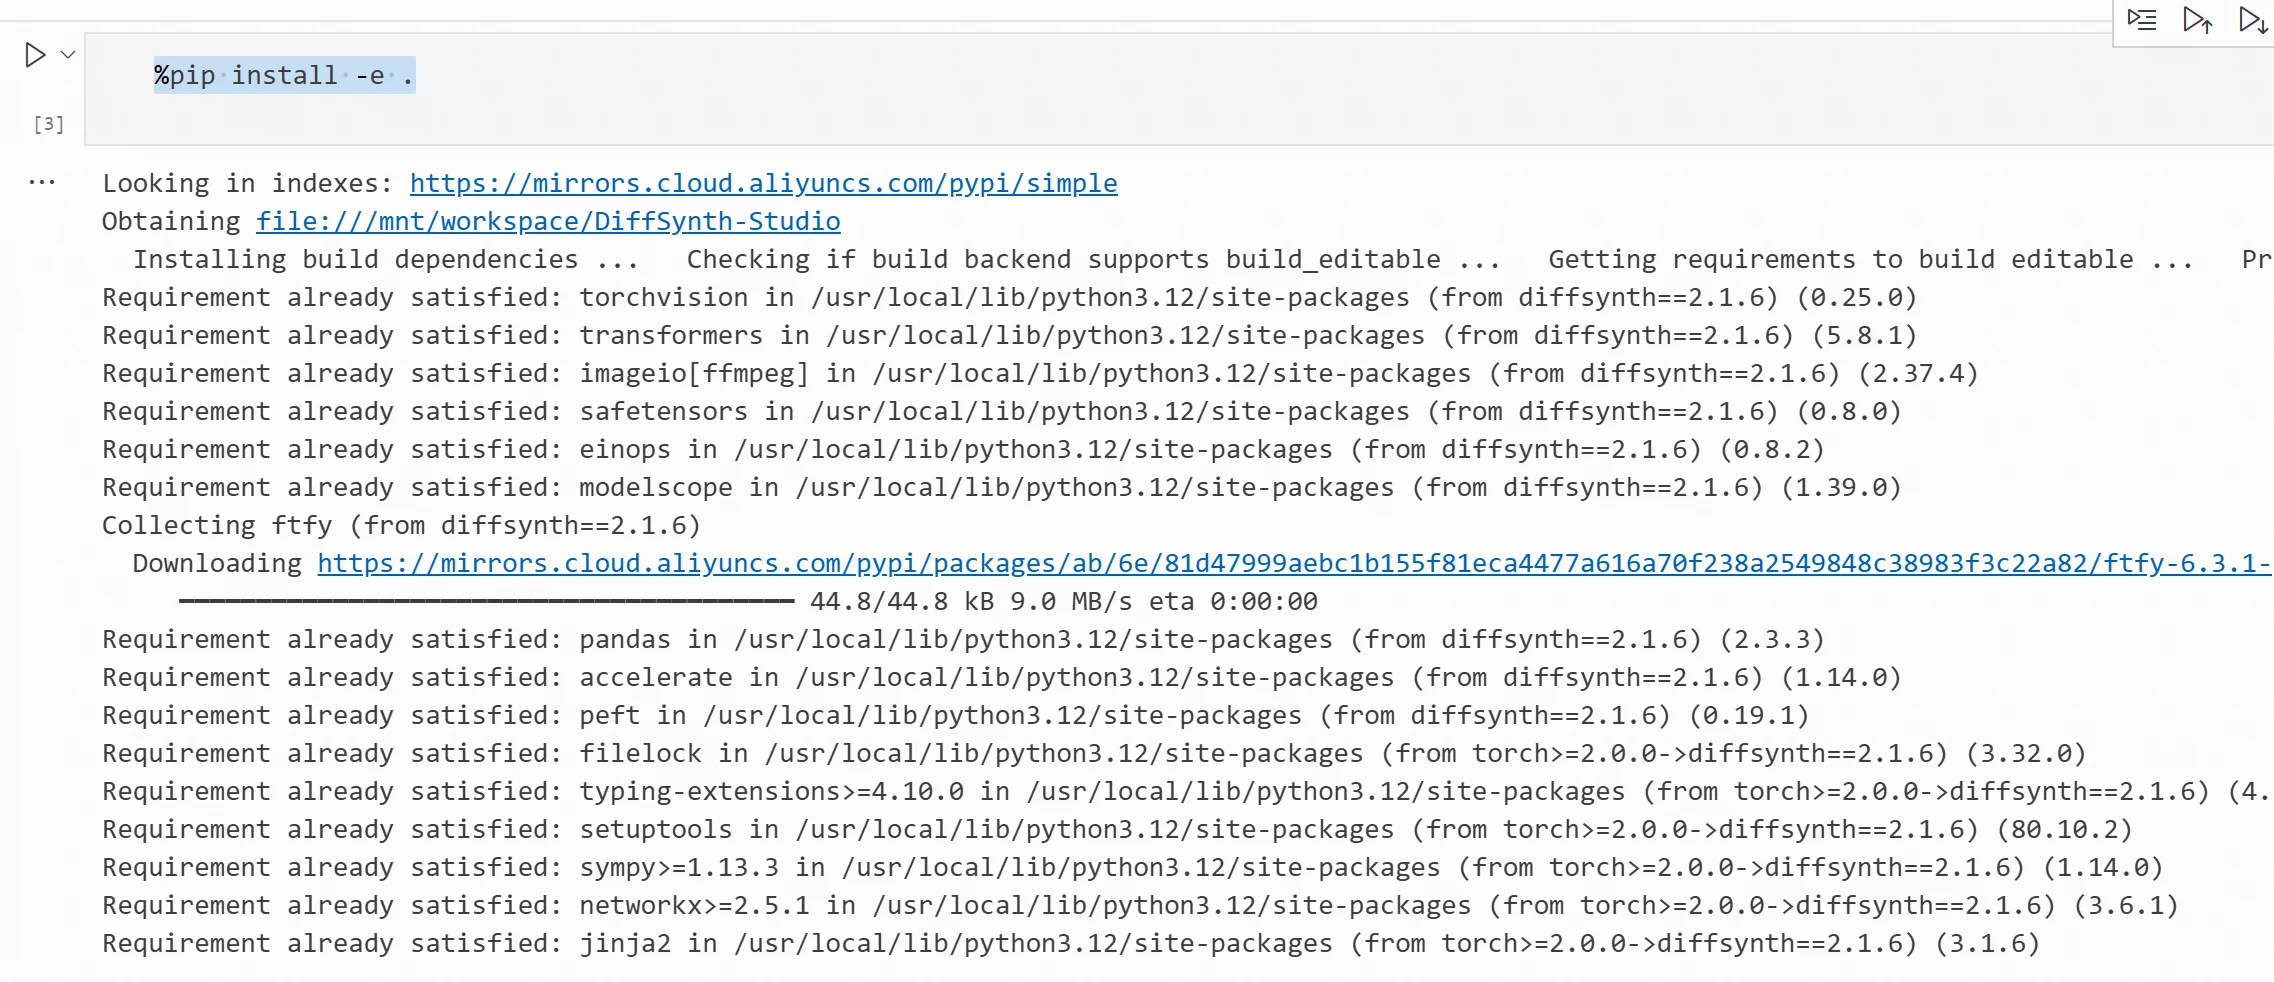
%pip install -e .
4) No Cell unit, digite o código abaixo para a geração de imagem a partir de texto.
import torch
from modelscope import ZImagePipeline
pipe = ZImagePipeline.from_pretrained(
    "Tongyi-MAI/Z-Image-Turbo",
    torch_dtype=torch.bfloat16,
    low_cpu_mem_usage=False,
)
pipe.to("cuda")
print(f"Dispositivo do modelo: {pipe.device}")

prompt = """ 夏日饮料商业宣传海报,
 清爽明亮的夏日氛围, 背景包含冰块、水花、柠檬和绿色树叶, 蓝绿色清爽色调, 商业广告摄影风格, 画面中央预留饮料商品展示区域, 背景简洁,光影自然, 高质量,细节清晰。 """
image = pipe(
    prompt=prompt,
    height=1024,
    width=1024,
    num_inference_steps=9,
    guidance_scale=0.0,
    generator=torch.Generator("cuda").manual_seed(42),
).images[0]

print("88888888888888888888888")
#display(image)
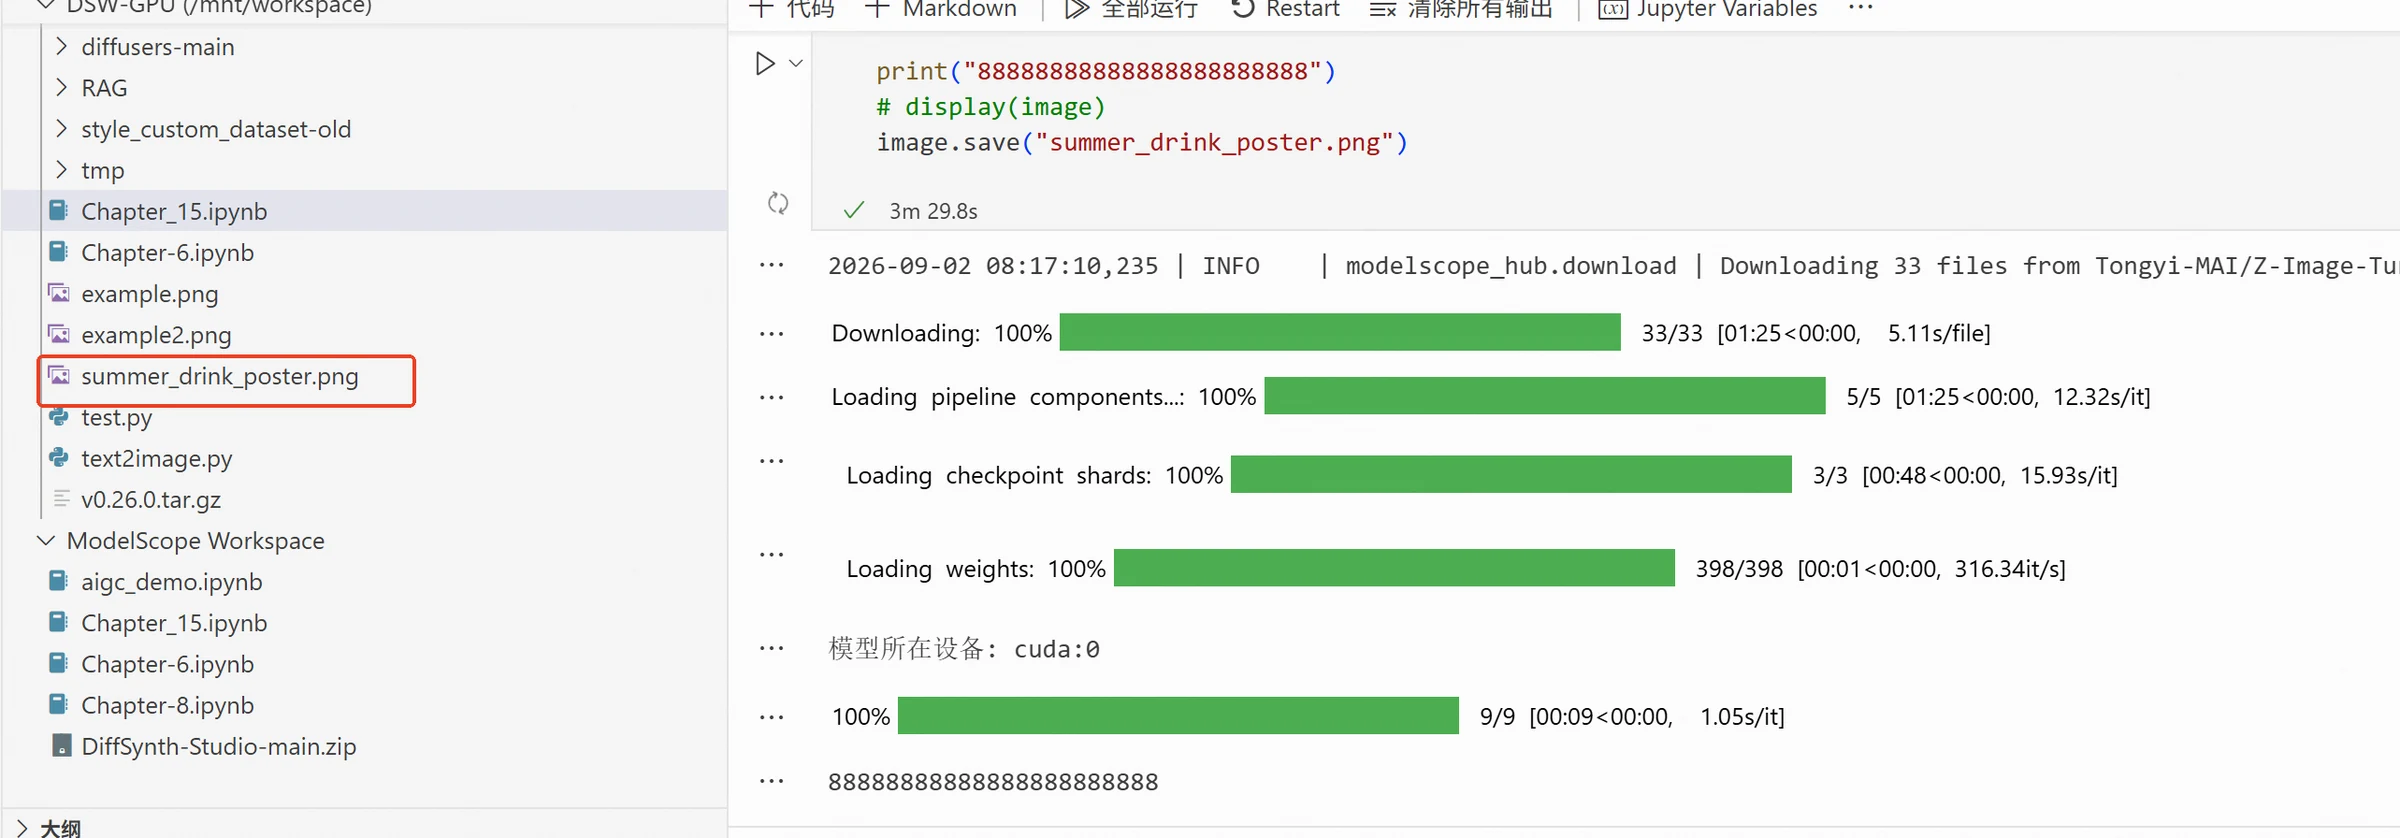
image.save("summer_drink_poster.png")
Após a execução, será possível ver a imagem salva no espaço de trabalho.
O resultado da imagem gerada é o seguinte:
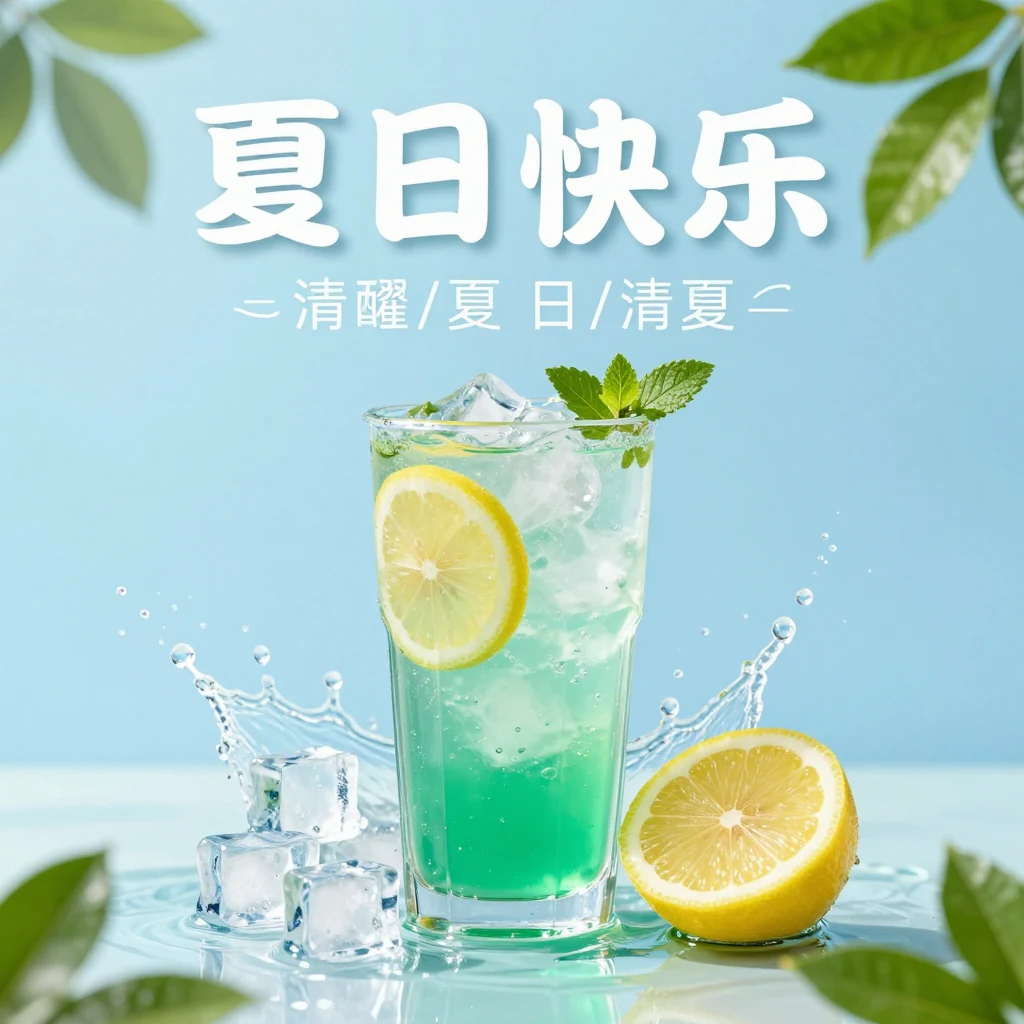
Para iniciantes, não é necessário escrever um Prompt muito complexo no início. Basta descrever as necessidades claras e, com base nos resultados gerados, adicionar detalhes gradualmente.
A geração de imagem a partir de texto é ideal para gerar rapidamente ideias de marketing e esquemas de fundo, mas tem um problema claro: se a imagem for gerada diretamente com base em uma descrição, o pacote, o logo e o texto do produto podem diferir do produto real em cenários de marketing oficiais, que precisam ser tratados com imagens do produto real.
A geração de imagem a partir de imagem (Image-to-Image) leva como entrada uma imagem de referência e uma descrição em texto. O modelo pode referenciar o sujeito do produto, o pacote e a composição da imagem original, ajustando ao mesmo tempo o fundo, a iluminação e os elementos de marketing.
Nesta seção, o modelo SenseNova-U1.5-8B-MoT será usado para edição de imagem. O modelo suporta geração de imagem a partir de texto e edição de imagem, pode entender a imagem de entrada e as instruções em texto ao mesmo tempo, ajustando a imagem original de acordo com o Prompt. Em comparação com gerar imagens apenas com base em texto, SenseNova-U1.5-8B-MoT pode utilizar informações visuais na imagem de entrada, mantendo o sujeito original e a estrutura geral, modificando pacotes de produtos, fundos, cores e elementos decorativos, sendo ideal para a geração e edição de imagens de marketing de produtos.
A parte de experimento continuará usando a imagem gerada na seção anterior como entrada, editando-a com o modelo de edição de imagem. Bases-se na preservação do sujeito da garrafa de bebida e da estrutura geral, adicionando o logo da marca "FRESH DAY" na garrafa, e adicionando elementos de verão como cubos de gelo, bolhas d'água e limões, gerando uma imagem de marketing de produto mais completa. A forma padrão de carregamento do SenseNova-U1.5-8B-MoT causaria falta de memória, portanto, a forma de carregamento com baixa memória será usada no código para reduzir o consumo de memória.
O código é o seguinte:
from diffsynth.pipelines.sensenova_u1_image import (
    SenseNovaU1ImagePipeline,
    ModelConfig
)
from PIL import Image
import torch
import os

MODEL_ID = "SenseNova/SenseNova-U1.5-8B-MoT"
INPUT_IMAGE = "/mnt/workspace/summer_drink_poster.png"
OUTPUT_IMAGE = "/mnt/workspace/drink_fresh_day_ad.png"

vram_config = {
    "offload_dtype": "disk",
    "offload_device": "disk",
    "onload_dtype": "disk",
    "onload_device": "disk",

    # Carregar apenas em BF16 quando realmente necessário para o cálculo
    "preparing_dtype": torch.bfloat16,
    "preparing_device": "cuda",

    "computation_dtype": torch.bfloat16,
    "computation_device": "cuda",
}

print("Carregando SenseNova-U1.5-8B-MoT...")

pipe = SenseNovaU1ImagePipeline.from_pretrained(
    torch_dtype=torch.bfloat16,
    device="cuda",

    model_configs=[
        ModelConfig(
            model_id=MODEL_ID,
            origin_file_pattern="model*.safetensors",
            **vram_config
        ),
    ],

    tokenizer_config=ModelConfig(
        model_id=MODEL_ID,
        origin_file_pattern="./"
    ),
    vram_limit=(
        torch.cuda.mem_get_info("cuda")[1] / (1024 ** 3)
        - 0.5
    ),
)

print("Modelo carregado.")

if not os.path.exists(INPUT_IMAGE):
    raise FileNotFoundError(
        f"Imagem de entrada não encontrada: {INPUT_IMAGE}"
    )

edit_image = Image.open(INPUT_IMAGE).convert("RGB")

print(
    f"Tamanho da imagem de entrada: "
    f"{edit_image.width} × {edit_image.height}"
)

prompt = """
Esta é uma tarefa de edição de imagem de produto de bebida.

Basado na imagem da garrafa de bebida de entrada, gere uma imagem de marketing de bebida profissional e refrescante.

Preste atenção em preservar o sujeito da garrafa original.
Tente manter a forma da garrafa, o tampa, a estrutura do pacote, a proporção da garrafa, o material e a aparência geral do produto, não gere ou substitua outra garrafa de bebida.
A garrafa deve permanecer clara e completa e ser o centro visual da imagem.

Na área de etiqueta da garrafa frontal, adicione um novo identificador de marca para este refrigerante:
"FRESH DAY".

"FRESH DAY" é o nome da marca do refrigerante.
Deixe o logo da marca naturalmente projetado na frente da garrafa, para parecer que foi impresso no pacote do produto real, em vez de um texto comum flutuando na imagem.

O logo da marca deve ter um estilo visual simples, moderno e refrescante.
Use uma fonte de texto clara e destacada em inglês, juntamente com um pequeno símbolo de folha simples, para refletir o sentimento de natureza, saúde, frescor e jovialidade da marca.

"Fresh Day" deve ser mantido completo, claro e fácil de identificar.
Não gere outros nomes de marca, não adicione texto irrelevante,
não repita "Fresh Day" fora do corpo da garrafa.

A base do refrigerante, mantendo o sujeito principal, otimize os elementos de marketing ao redor.

Adicione alguns cubos de gelo transparentes, bolhas refrescantes e naturais, gotas de água condensadas e alguns fatias de limão frescas ao redor da garrafa,
para destacar o frescor, a frescura e a novidade da bebida.

Use luz de fotografia de produto comercial natural e clara,
destacando o brilho da garrafa, as gotas de água condensadas e o material do produto.
O fundo deve ser simples e limpo, sem elementos complexos adicionais.

O estilo geral da imagem deve seguir um estilo de anúncio comercial de verão refrescante, moderno e claro,
com o sujeito destacado, composição simples e com a qualidade de fotografia de produto real.

O resultado final deve parecer um anúncio de marketing profissional de verão para uma marca de bebida real,
em vez de uma ilustração, uma animação ou um design de produto de bebida recriado.
"""

print("Iniciando a geração da imagem de marketing de bebida de verão...")

image = pipe(
    prompt=prompt,

    # Imagem de produto original
    edit_image=edit_image,

    # Semeador fixo para reproducibilidade do experimento
    seed=42,

    # Proporção 3:4 para imagem de marketing vertical
    height=1536,
    width=1152,

    num_inference_steps=50,
    cfg_scale=4.0,
    shift=3.0,
)

image.save(OUTPUT_IMAGE)

print(
    f"Geração concluída, imagem salva em: {OUTPUT_IMAGE}"
)
O resultado da execução é o seguinte:
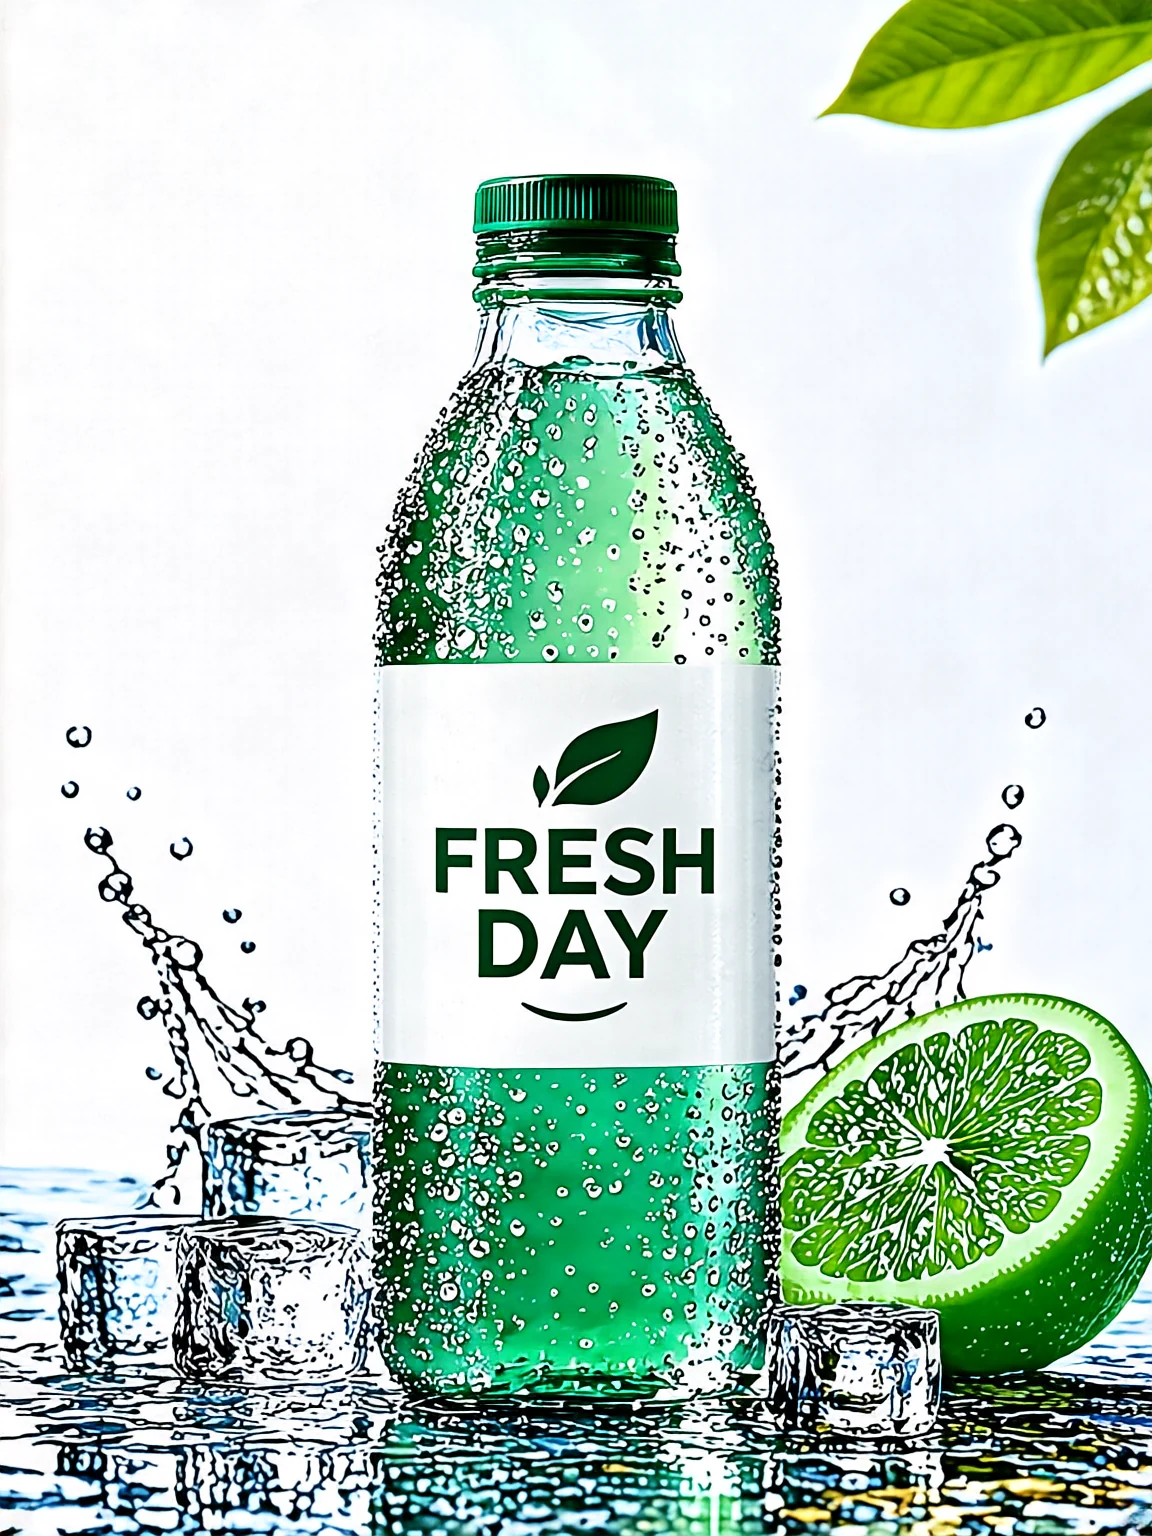
A imagem gerada final é:
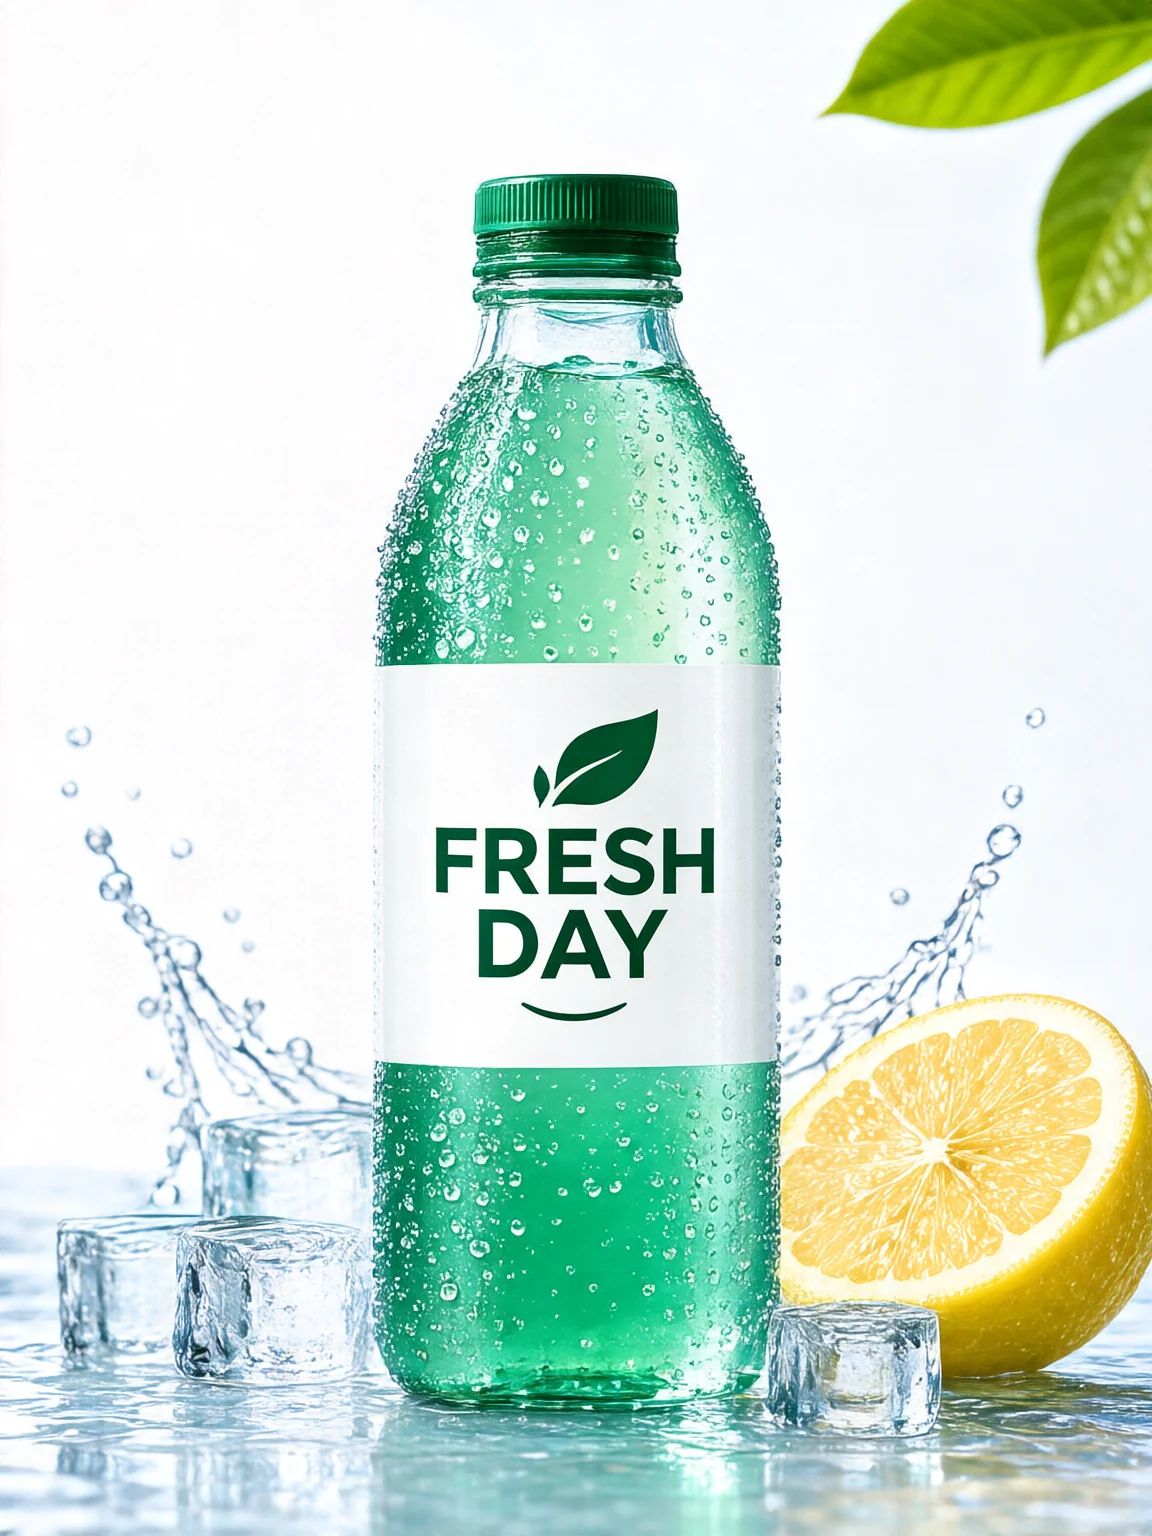
Em comparação com a geração de imagens apenas com base em texto, a edição de imagem pode utilizar informações visuais da imagem original, sendo mais adequada para cenários onde se tem materiais de referência do produto ou esboços de design. Como pode ser visto na imagem gerada acima, ainda há diferenças entre o resultado e o desejado, mesmo que uma imagem real do produto tenha sido fornecida. O modelo pode regerar parte do conteúdo do produto. Em cenários reais, é necessário considerar mais a manutenção do sujeito do produto e a edição local.
No uso real de imagens de marketing de produtos, além de buscar uma aparência bonita, é necessário garantir a precisão das informações do produto. A aparência da garrafa, a estrutura do pacote, o logo da marca etc. pertencem ao conteúdo visual principal do produto, se houver uma mudança clara durante a edição de imagem, a imagem gerada pode não corresponder ao produto real. Ao usar modelos de geração de imagem para edição, é preciso distinguir claramente o que precisa ser mantido e o que pode ser modificado. Por exemplo, pode-se pedir ao modelo para manter a garrafa, o logo da marca e a composição geral, ajustando apenas o fundo, elementos decorativos ou objetos locais. Ao especificar essas restrições no Prompt, pode-se reduzir a regeração do modelo sobre o sujeito do produto, tornando os resultados de edição mais controláveis.
Nesta seção, continuará usando a imagem de marketing de bebida FRESH DAY gerada na seção anterior para edição local. Mantendo o sujeito da garrafa, o logo da marca, os cubos de gelo, as bolhas d'água e a composição geral, modifique o limão amarelo na esquerda inferior da imagem para uma lima verde. Com este exemplo, pode-se entender melhor como usar o Prompt para edições de imagem mais controláveis.
from diffsynth.pipelines.sensenova_u1_image import (
    SenseNovaU1ImagePipeline,
    ModelConfig
)
from PIL import Image
import torch
import os

MODEL_ID = "SenseNova/SenseNova-U1.5-8B-MoT"
INPUT_IMAGE = "/mnt/workspace/drink_fresh_day_ad.png"
OUTPUT_IMAGE = "/mnt/workspace/drink_fresh_day_lime.png"

vram_config = {
    "offload_dtype": "disk",
    "offload_device": "disk",
    "onload_dtype": "disk",
    "onload_device": "disk",

    "preparing_dtype": torch.bfloat16,
    "preparing_device": "cuda",

    "computation_dtype": torch.bfloat16,
    "computation_device": "cuda",
}

print("Carregando modelo...")

pipe = SenseNovaU1ImagePipeline.from_pretrained(
    torch_dtype=torch.bfloat16,
    device="cuda",

    model_configs=[
        ModelConfig(
            model_id=MODEL_ID,
            origin_file_pattern="model*.safetensors",
            **vram_config
        ),
    ],

    tokenizer_config=ModelConfig(
        model_id=MODEL_ID,
        origin_file_pattern="./"
    ),

    vram_limit=(
        torch.cuda.mem_get_info("cuda")[1] / (1024 ** 3)
        - 0.5
    ),
)

print("Modelo carregado.")

if not os.path.exists(INPUT_IMAGE):
    raise FileNotFoundError(
        f"Imagem de entrada não encontrada: {INPUT_IMAGE}"
    )

edit_image = Image.open(INPUT_IMAGE).convert("RGB")

print(
    f"Tamanho da imagem de entrada: "
    f"{edit_image.width} × {edit_image.height}"
)

prompt = """
Esta é uma tarefa de edição de imagem local.

Modifique o limão amarelo na esquerda inferior da imagem para uma lima verde fresca.

Mantenha a posição, tamanho, forma, corte e ângulo de inclinação do fruto original, modifique principalmente a cor e a aparência do fruto, tornando a casca e a polpa amarela em uma lima verde.
Não modifique outros conteúdos na imagem.

Strictamente mantenha o sujeito da garrafa, incluindo a forma da garrafa, o tampa, a cor da garrafa, a estrutura do pacote e a proporção geral.

Mantenha o logo da marca "FRESH DAY" na etiqueta da garrafa, o tipo de letra, a posição e o design da etiqueta inalterados.

Mantenha os cubos de gelo, bolhas d'água, gotas de água condensadas, folhas de fundo, efeitos de iluminação, cor de fundo e composição original.

Apenas modifique a aparência visual do fruto na esquerda inferior,
deixa-lo mudar de limão amarelo para lima verde, mantendo o estilo e a qualidade de fotografia de marketing da imagem original.
"""

print("Iniciando a edição de imagem local...")

image = pipe(
    prompt=prompt,
    edit_image=edit_image,

    seed=42,
    height=1536,
    width=1152,

    num_inference_steps=50,
    cfg_scale=4.0,
    shift=3.0,
)

image.save(OUTPUT_IMAGE)

print(
    f"Edição local concluída, imagem salva em: {OUTPUT_IMAGE}"
)
O resultado do código é o seguinte:
A imagem gerada é a seguinte, pode-se ver que o limão amarelo foi substituído por uma lima verde, mas outras partes também sofreram mudanças. Em cenários reais, podemos obter melhores resultados de geração de imagem modificando o Prompt ou implantando modelos com melhor desempenho.
Depois que a imagem de marketing é concluída, geralmente precisa ser publicada em diferentes plataformas. Diferentes plataformas têm diferentes exigências para o tamanho e a proporção da imagem. As redes sociais costumam usar proporções 1:1 ou 4:5, os canais de vídeos curtos são mais adequados para proporções 9:16 verticais, enquanto os banners de sites e anúncios horizontais usam geralmente proporções 16:9. Se a imagem original for redimensionada diretamente, o sujeito do produto pode ser esticado ou comprimido. Podemos usar modelos de edição de imagem para expandir a imagem, adicionando fundo e elementos decorativos para o redimensionamento, mantendo o sujeito do produto.
A expansão é diferente da redimensionamento comum. Não é apenas mudar o tamanho da imagem original, mas gerar novas áreas com base no conteúdo e estilo da imagem original. Por exemplo, ao converter uma imagem vertical de bebida de marketing para uma proporção 16:9 horizontal, pode-se manter o tamanho e a proporção da garrafa de bebida basicamente inalterados, ao mesmo tempo expandindo os lados esquerdo e direito do fundo, bolhas d'água, cubos de gelo e folhas, para que a área nova se conecte naturalmente com a original.
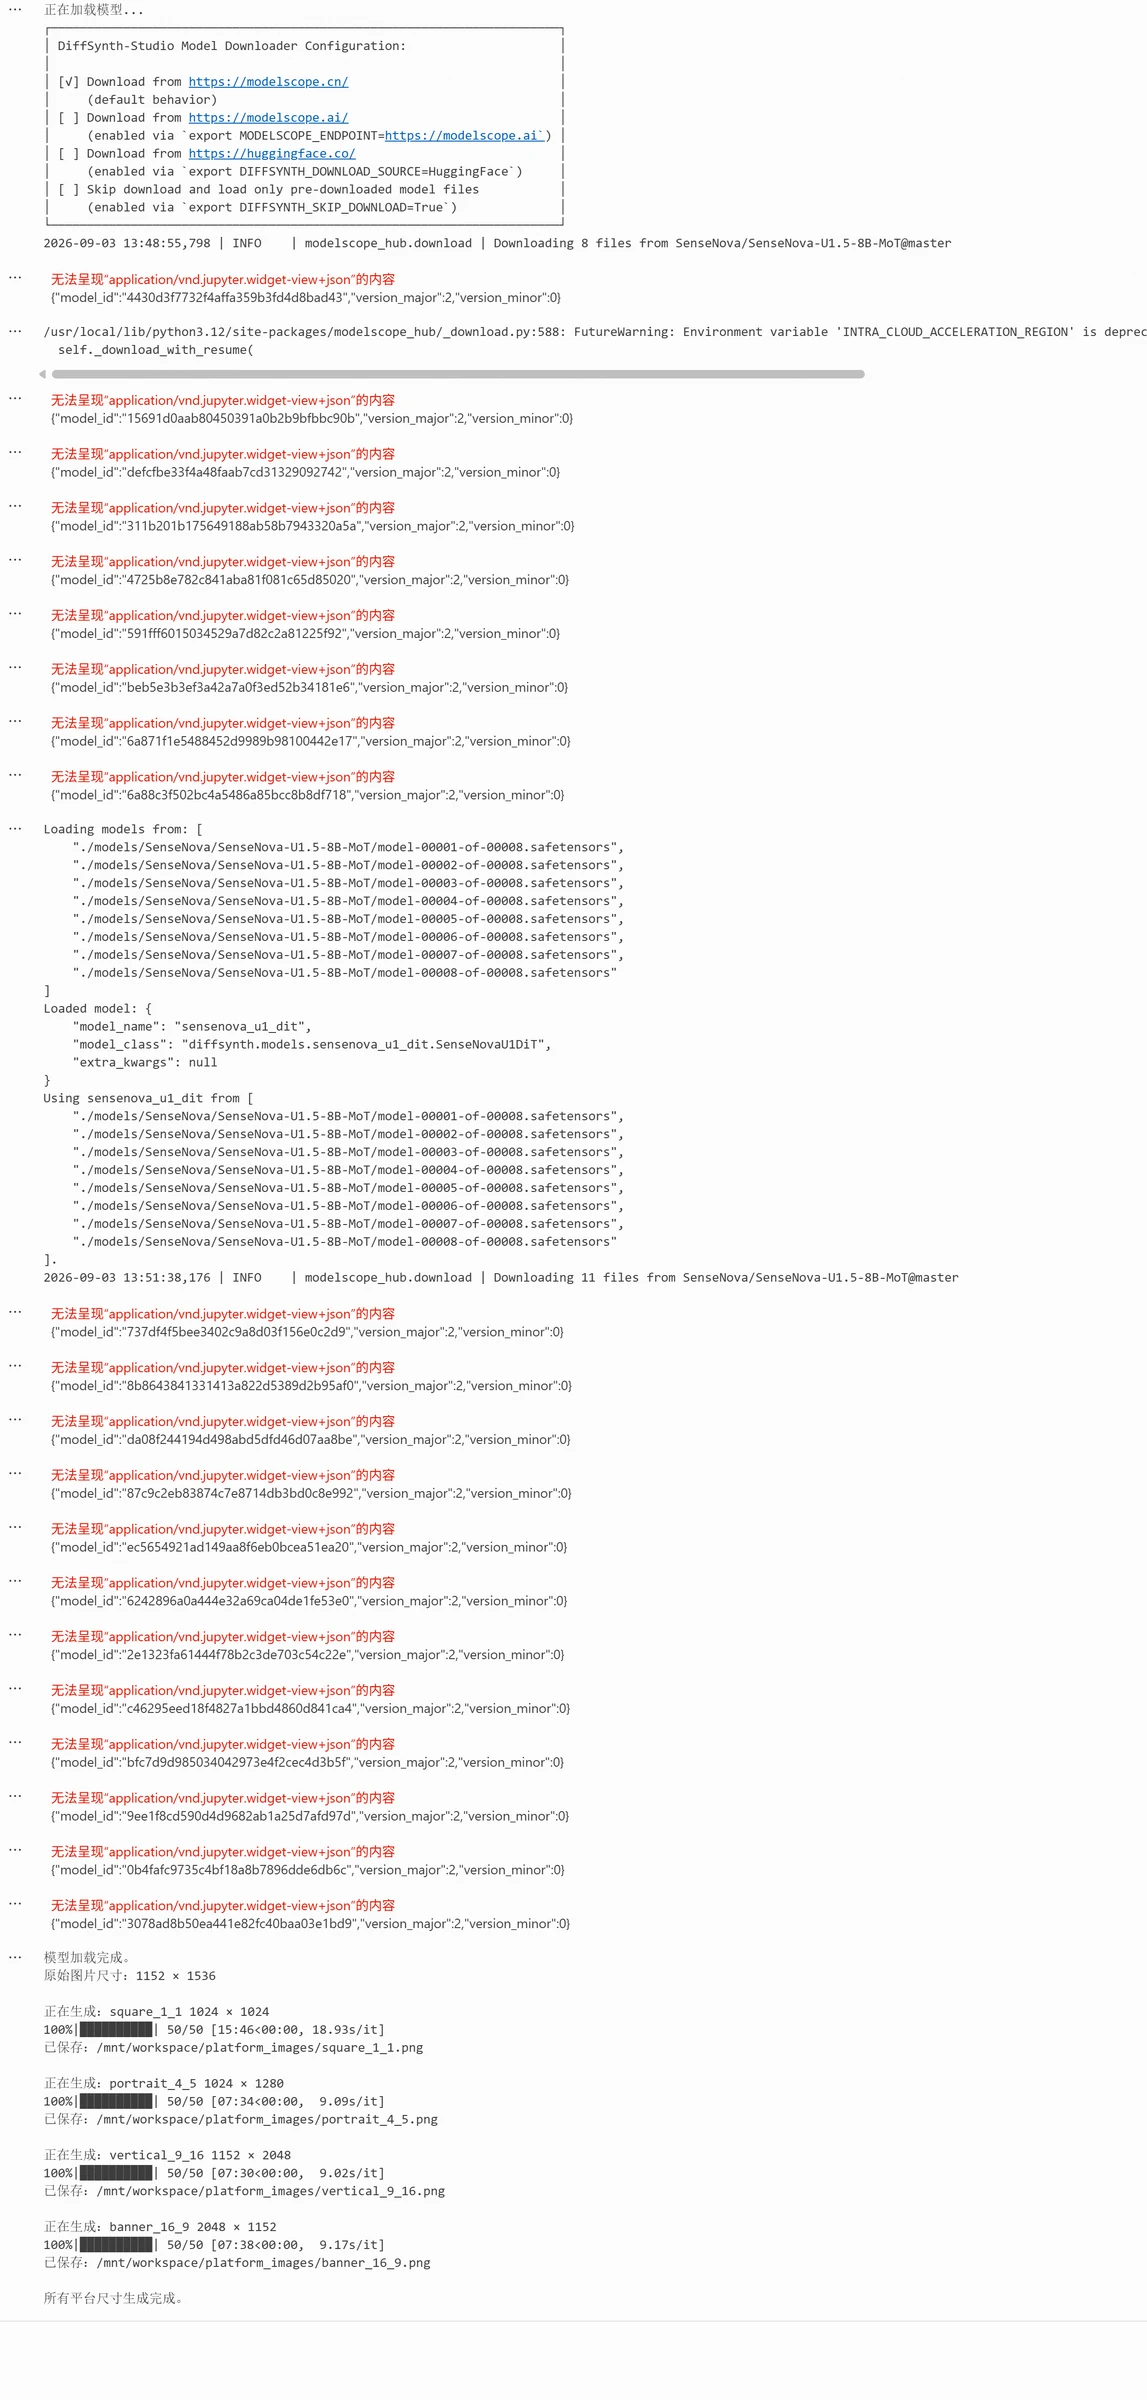
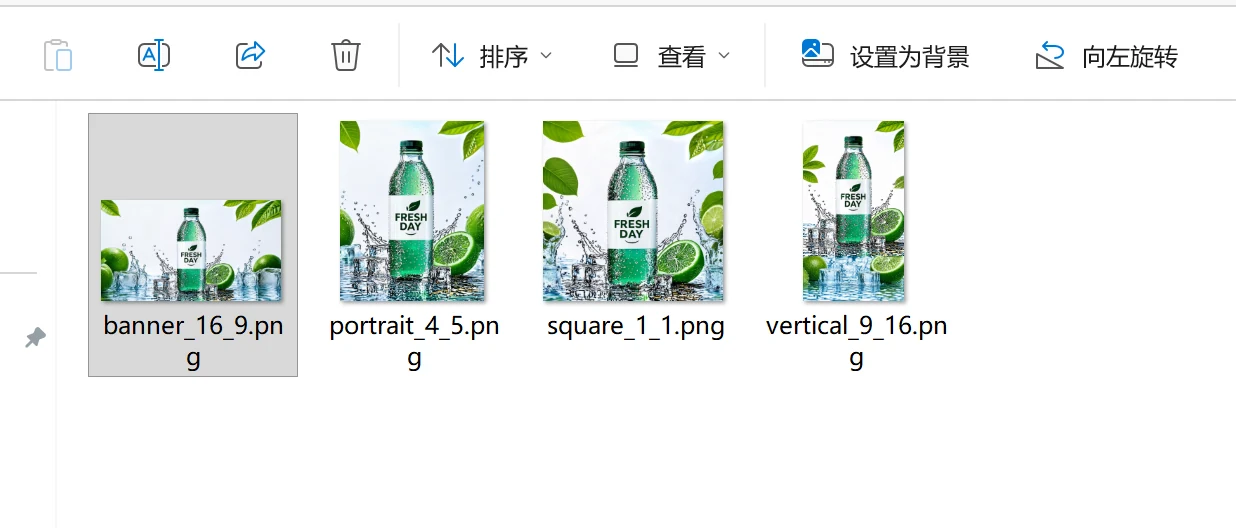
Nesta parte, continuará usando a imagem editada na seção anterior (FRESH DAY bebida de marketing), gerando imagens de diferentes proporções (1:1, 4:5, 9:16 e 16:9) com diferentes tamanhos de saída, exigindo que o modelo mantenha o sujeito da garrafa, o logo da marca e o estilo visual geral, para que o mesmo material de produto possa se adaptar a diferentes plataformas e cenários de exibição, o código é o seguinte:
from diffsynth.pipelines.sensenova_u1_image import (
    SenseNovaU1ImagePipeline,
    ModelConfig
)

from PIL import Image
import torch
import os

MODEL_ID = "SenseNova/SenseNova-U1.5-8B-MoT"
INPUT_IMAGE = "/mnt/workspace/drink_fresh_day_lime.png"

OUTPUT_DIR = "/mnt/workspace/platform_images"

os.makedirs(OUTPUT_DIR, exist_ok=True)

vram_config = {
    "offload_dtype": "disk",
    "offload_device": "disk",
    "onload_dtype": "disk",
    "onload_device": "disk",

    "preparing_dtype": torch.bfloat16,
    "preparing_device": "cuda",

    "computation_dtype": torch.bfloat16,
    "computation_device": "cuda",
}

print("Carregando modelo...")

pipe = SenseNovaU1ImagePipeline.from_pretrained(
    torch_dtype=torch.bfloat16,
    device="cuda",

    model_configs=[
        ModelConfig(
            model_id=MODEL_ID,
            origin_file_pattern="model*.safetensors",
            **vram_config
        ),
    ],

    tokenizer_config=ModelConfig(
        model_id=MODEL_ID,
        origin_file_pattern="./"
    ),

    vram_limit=(
        torch.cuda.mem_get_info("cuda")[1] / (1024 ** 3)
        - 0.5
    ),
)

print("Modelo carregado.")

edit_image = Image.open(INPUT_IMAGE).convert("RGB")

print(
    f"Tamanho da imagem original: "
    f"{edit_image.width} × {edit_image.height}"
)

platform_sizes = {
    # 1:1 Quadrado
    "square_1_1": (1024, 1024),

    # 4:5 Vertical
    "portrait_4_5": (1024, 1280),

    # 9:16 Vertical para vídeos curtos
    "vertical_9_16": (1152, 2048),

    # 16:9 Horizontal
    "banner_16_9": (2048, 1152),
}

prompt = """
Esta é uma tarefa de expansão e adaptação de dimensões de imagem de marketing de produtos.

Seja estritamente fiel ao sujeito da garrafa de bebida na imagem original, incluindo a forma da garrafa, o tampa, a cor da garrafa, o pacote, o logo da marca "FRESH DAY", gotas de água condensadas e a aparência geral do produto.

Recomponha a imagem de acordo com a nova proporção do canvas,
deixe a garrafa sempre ser o sujeito visual central da imagem.

Se o canvas se expandir para a direita, naturalmente expanda os lados esquerdo e direito do fundo, adicionando fundos, bolhas d'água, cubos de gelo, folhas ou elementos de fruta que sejam consistentes com a imagem original, mantendo o estilo de fotografia de produto comercial.

Se o canvas se expandir para cima e para baixo, naturalmente expanda a área superior e inferior da imagem, mantendo a proporção da garrafa completa, sem esticar ou comprimir o sujeito do produto.

Os novos elementos de fundo e decoração adicionados devem se conectar naturalmente à imagem original, mantendo a direção da luz, a cor, a profundidade de campo e o clima fresco de verão.

A composição deve ser simples e equilibrada,
adequada para uso em anúncios de marketing de marcas de bebidas.

Não adicione novos logos de marca, texto ou elementos irrelevantes.
"""

for name, (width, height) in platform_sizes.items():

    print(
        f"\nGerando: {name} "
        f"{width} × {height}"
    )

    image = pipe(
        prompt=prompt,

        edit_image=edit_image,

        seed=42,

        width=width,
        height=height,

        num_inference_steps=50,
        cfg_scale=4.0,
        shift=3.0,
    )

    output_path = os.path.join(
        OUTPUT_DIR,
        f"{name}.png"
    )

    image.save(output_path)

    print(
        f"Salvo: {output_path}"
    )

print("\nTodas as dimensões de plataforma geradas com sucesso.")
O resultado do código é o seguinte:
O resultado final gerado é o seguinte, pode-se ver que o logo da marca foi mantido, o resultado da geração é bom.
Usando modelos de geração de imagem a partir de texto e edição de imagem, é possível gerar rapidamente imagens de marketing de diferentes tipos, mas devido à natureza aleatória de cada geração, mesmo usando o mesmo ou um Prompt semelhante, as imagens geradas em lotes diferentes podem apresentar diferenças nas combinações de cores, composições, efeitos de iluminação e estilo visual geral.
Para a marketing corporativa, geralmente é desejado que diferentes materiais de promoção mantenham uma estética visual relativamente uniforme. Nesta seção, introduzimos o LoRA (Low-Rank Adaptation) para ajuste de modelo, preparando um conjunto de imagens de marketing com um estilo visual uniforme para treinar o modelo, fazendo com que o modelo aprenda características específicas de cor, composição e estilo de imagem, tornando-o mais estável na geração subsequente para apresentar as características visuais de marca desejadas.
Este experimento escolhe ajustar o modelo Z-Image-Turbo. A principal razão é que o modelo atende às necessidades da geração de imagem a partir de texto na seção anterior, ao mesmo tempo em que, em comparação com o modelo SenseNova-U1.5-8B-MoT usado na seção de edição de imagem deste capítulo, o treinamento requer menos recursos de memória, sendo ideal para um ambiente com 24 GB de memória de GPU em uma única placa. Se houver mais recursos de GPU e de cálculo, pode-se tentar ajustar o LoRA no SenseNova-U1.5-8B-MoT.
!accelerate launch examples/z_image/model_training/train.py \
  --dataset_base_path /mnt/workspace/train_data \
  --dataset_metadata_path /mnt/workspace/train_data/metadata_training.csv \
  --max_pixels 589824 \
  --dataset_repeat 50 \
  --model_id_with_origin_paths "Tongyi-MAI/Z-Image-Turbo:transformer/*.safetensors,Tongyi-MAI/Z-Image-Turbo:text_encoder/*.safetensors,Tongyi-MAI/Z-Image-Turbo:vae/diffusion_pytorch_model.safetensors" \
  --learning_rate 1e-4 \
  --num_epochs 2 \
  --remove_prefix_in_ckpt "pipe.dit." \
  --output_path "/mnt/workspace/drink_lora" \
  --lora_base_model "dit" \
  --lora_target_modules "to_q,to_k,to_v,to_out.0,w1,w2,w3" \
  --lora_rank 16 \
  --use_gradient_checkpointing \
  --dataset_num_workers 8
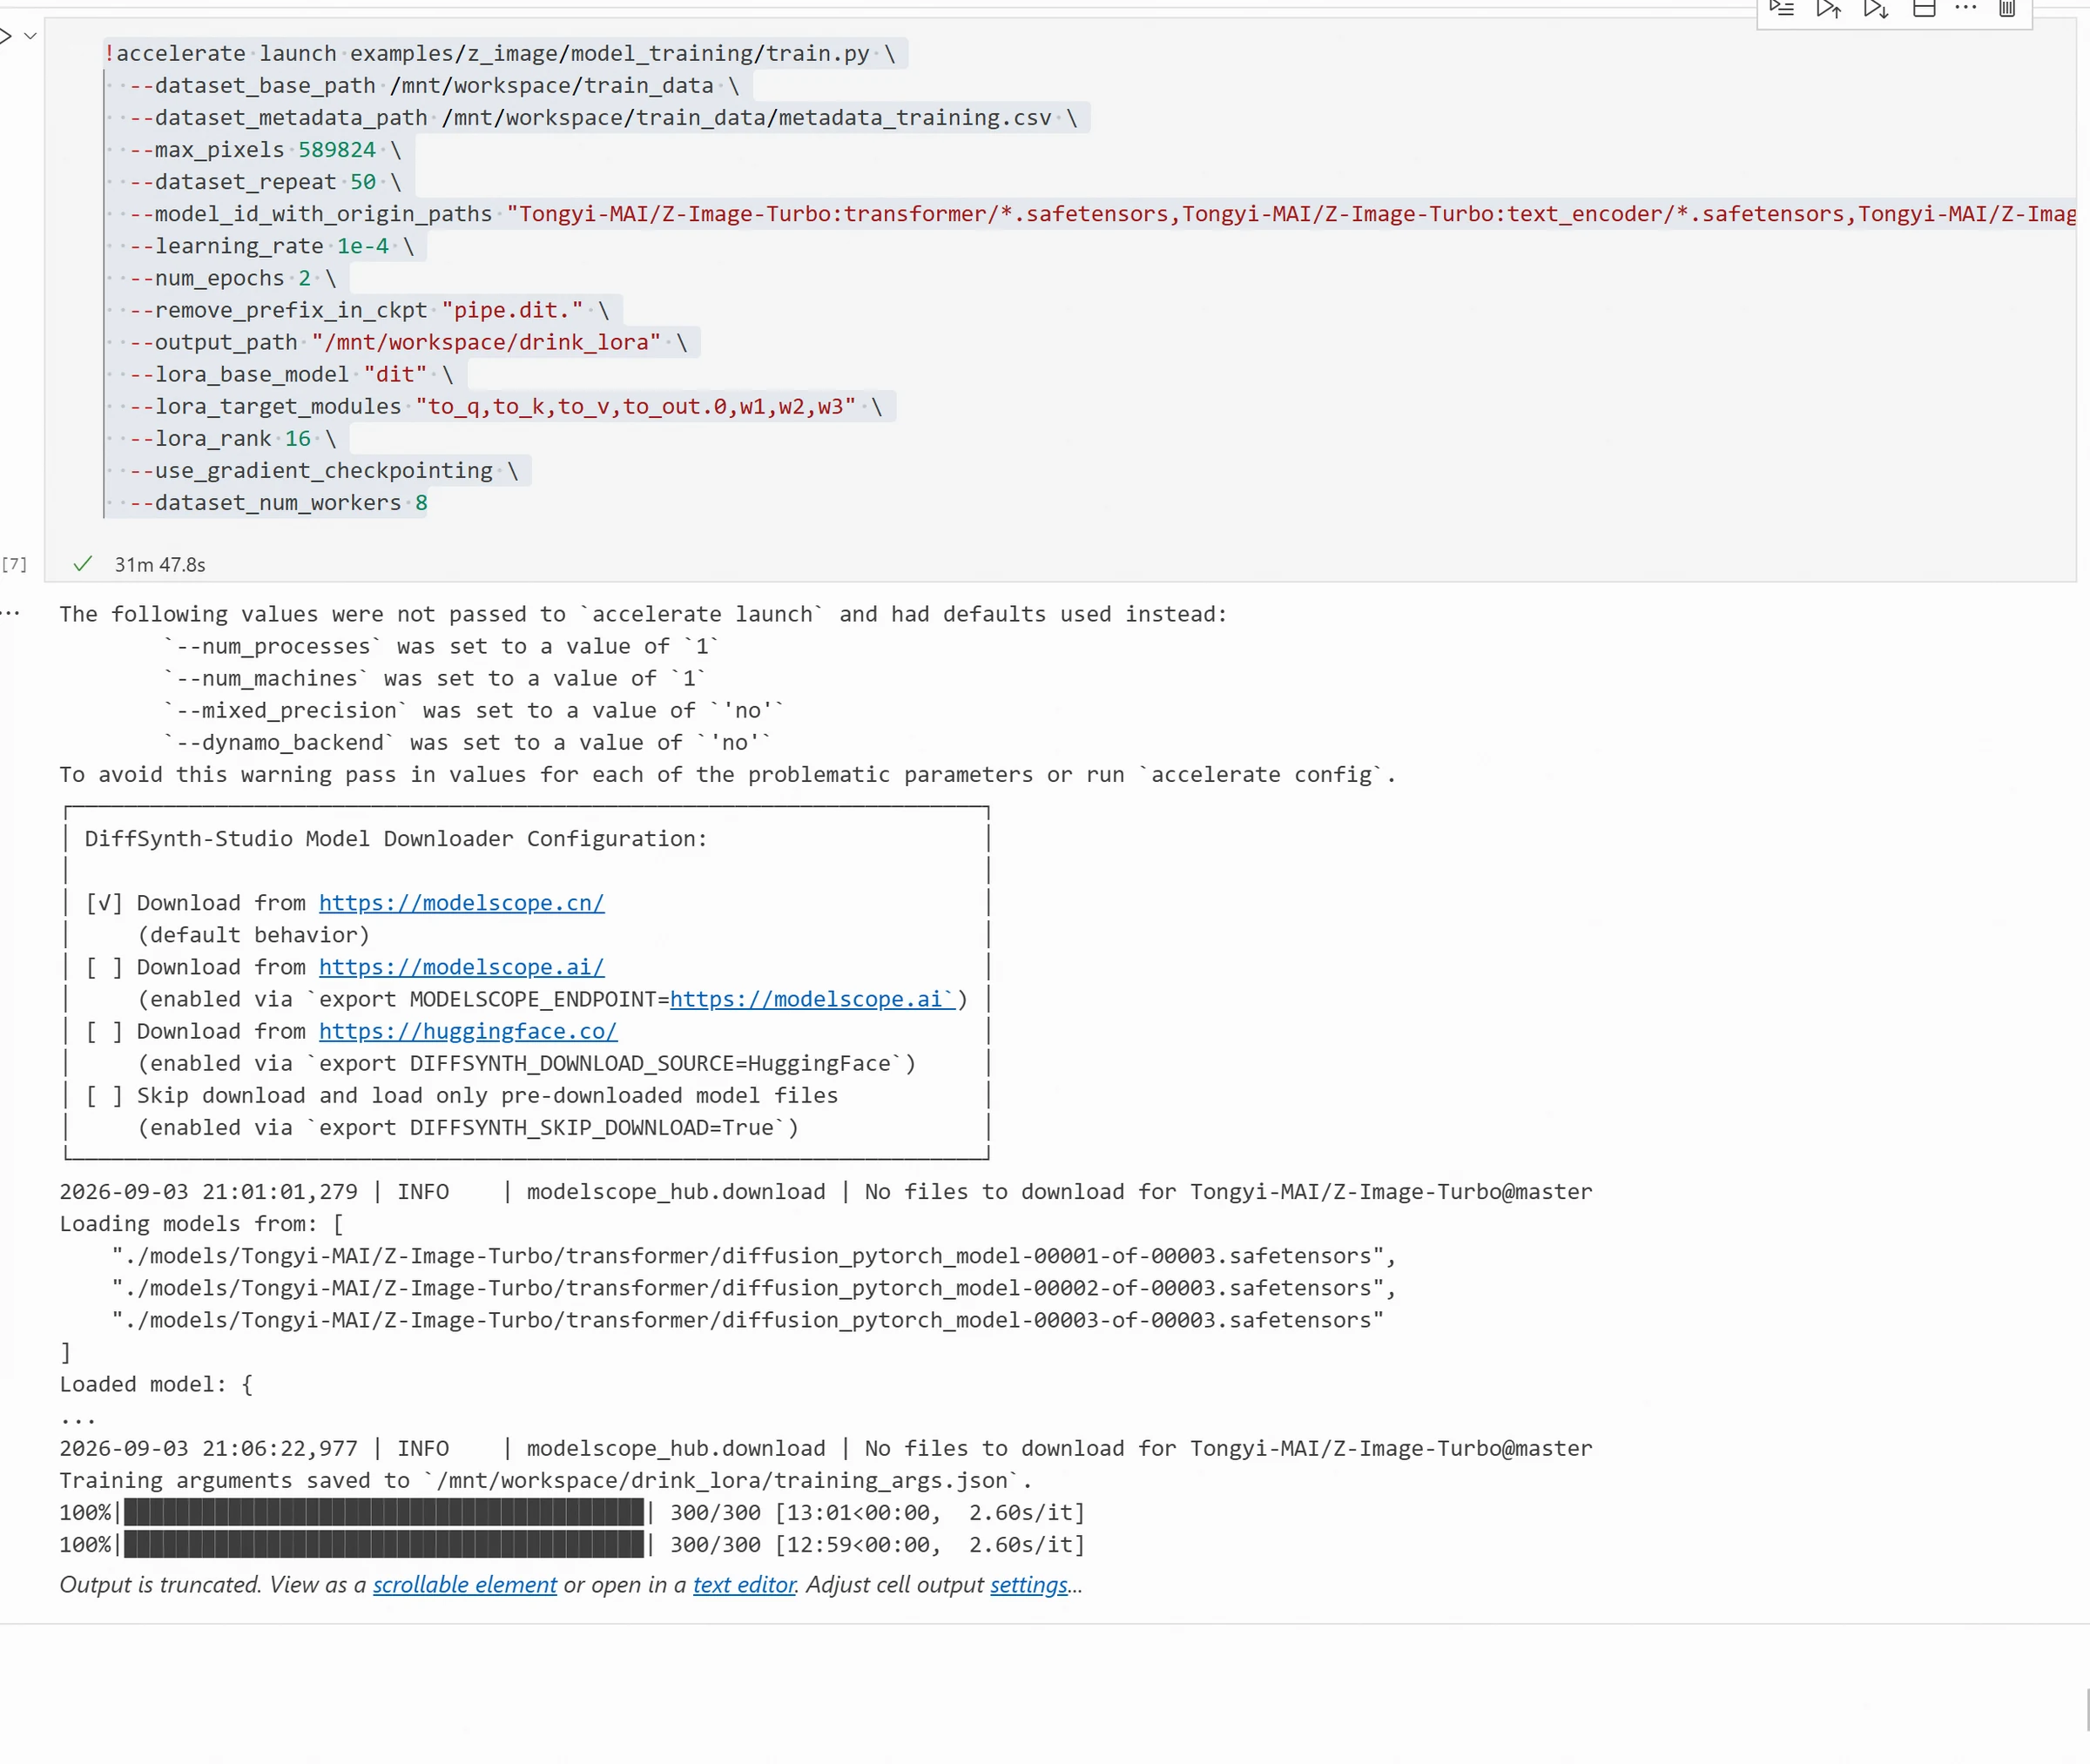
O resultado do treinamento é o seguinte:
Em seguida, use o modelo treinado para inferência, o comando de inferência é o seguinte:
from diffsynth.pipelines.z_image import ZImagePipeline, ModelConfig
import torch

pipe = ZImagePipeline.from_pretrained(
    torch_dtype=torch.bfloat16,
    device="cuda",
    model_configs=[
        ModelConfig(model_id="Tongyi-MAI/Z-Image-Turbo", origin_file_pattern="transformer/*.safetensors"),
        ModelConfig(model_id="Tongyi-MAI/Z-Image-Turbo", origin_file_pattern="text_encoder/*.safetensors"),
        ModelConfig(model_id="Tongyi-MAI/Z-Image-Turbo", origin_file_pattern="vae/diffusion_pytorch_model.safetensors"),
    ],
    tokenizer_config=ModelConfig(model_id="Tongyi-MAI/Z-Image-Turbo", origin_file_pattern="tokenizer/"),
)
pipe.load_lora(pipe.dit, "/mnt/workspace/drink_lora/epoch-1.safetensors")
prompt = """
Anúncio de bebida de espuma de lima, composição vertical. Uma garrafa de vidro transparente e verde curta, verticalmente no centro, mostrando a garrafa inteira, com uma tampa de metal verde. A garrafa coberta de pequenas gotas de água condensada, etiqueta branca com "Lime Sparkling Water