Agent Framework Fundamentals
Complemento: Conhecimentos sobre Frameworks Agent
Principais frameworks de desenvolvimento de Agent
Com o aumento da complexidade das aplicações Agent, os desenvolvedores precisam lidar com chamadas de ferramentas, integração de conhecimento, gerenciamento de estado e colaboração entre múltiplos Agent. Se todas essas funcionalidades fossem desenvolvidas do zero, não apenas o volume de trabalho seria grande, mas também a conexão entre os módulos e o controle da execução seriam complexos.
Os frameworks Agent encapsulam essas capacidades comuns, fornecendo métodos de implementação unificados para o desenvolvimento de Agent. A seguir, são apresentados alguns frameworks representativos de desenvolvimento de Agent.
Framework LangChain
O LangChain foi lançado em 2022 e é um dos primeiros frameworks open-source para construção de aplicações de modelos de linguagem. Inicialmente focado em organizar grandes modelos, prompts e dados externos, expandiu-se gradualmente para chamadas de ferramentas e Agent. Atualmente, o LangChain tornou os Agent uma parte essencial do framework, fornecendo modelos, ferramentas e middlewares para construir rapidamente Agent com capacidade de chamada de ferramentas.
A forma principal de execução do LangChain é formar um loop entre o modelo de linguagem e as ferramentas. O modelo recebe a tarefa do usuário e as ferramentas disponíveis, e com base nas informações atuais, decide se gera diretamente um resultado ou chama uma ferramenta. Se uma chamada de ferramenta for escolhida, o framework executa a ferramenta correspondente e fornece o resultado retornado ao modelo. O modelo continua julgando com base nas novas informações até que nenhuma chamada de ferramenta seja necessária e um resultado final seja gerado. A documentação oficial denomina esse processo de Agent Loop, conforme ilustrado abaixo.
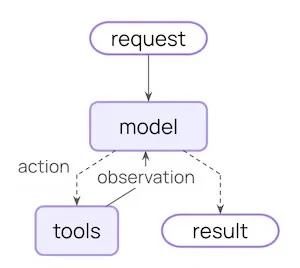
Por exemplo, pode-se configurar um assistente de viagem com ferramentas de consulta meteorológica, pesquisa de mapas e busca na web. Quando um usuário pergunta "Ajude-me a planejar um passeio de um dia em Hangzhou amanhã", o modelo pode determinar que precisa consultar informações sobre clima e atrações, chamar as ferramentas correspondentes para obter os resultados e depois combiná-los para completar o roteiro.
Ferramentas são um meio importante de implementar capacidades externas. Essencialmente são funções chamáveis com entradas e saídas claras, usadas para obter dados em tempo real, executar código, consultar bancos de dados ou operar sistemas externos. Quando os desenvolvedores fornecem as ferramentas necessárias a um Agent, o modelo decide quando chamar qual ferramenta e quais parâmetros fornecer com base na tarefa atual.
Essa abordagem modular é uma característica importante do LangChain. O LangChain fornece interfaces relativamente unificadas para diferentes modelos e ferramentas, permitindo que os desenvolvedores combinem esses componentes no mesmo framework sem precisar tratar separadamente a lógica de chamada entre diferentes modelos e capacidades externas. Portanto, é particularmente adequado para construir rapidamente Agent baseados em chamadas de ferramentas e é adequado para iniciantes entenderem o processo básico de um Agent.
Framework LlamaIndex
O LlamaIndex, lançado em 2022, era inicialmente usado principalmente para resolver problemas de conexão entre modelos de linguagem e dados externos. Oferece capacidades de carregamento de dados, indexação, recuperação e consulta, permitindo conectar dados externos como documentos de empresas e bancos de dados a aplicações de modelos de linguagem. Sobre essa base, o LlamaIndex adicionou gradualmente funcionalidades como Agent e Workflows, permitindo que Agent usem esses dados para realizar tarefas mais complexas.
Os modelos de linguagem por si só não compreendem dados externos como documentos internos de produtos, dados de negócios e bancos de dados da empresa. Quando um Agent precisa usar esses dados para realizar uma tarefa, primeiro precisa encontrar informações relevantes para a tarefa atual. O LlamaIndex pode carregar, organizar e indexar dados externos e depois realizar pesquisas e consultas através de componentes como Retriever e Query Engine. A Query Engine pode receber perguntas em linguagem natural, buscar dados relevantes no index e também pode ser encapsulada como uma ferramenta que o Agent pode chamar. Conforme ilustrado abaixo, após receber a tarefa do usuário, o Agent pode selecionar a ferramenta de consulta apropriada para obter informações conforme necessário e depois analisá-las com o modelo para gerar o resultado final. Dessa forma, não é necessário colocar todos os dados externos diretamente no contexto; os dados relevantes podem ser consultados e usados conforme a necessidade da tarefa.
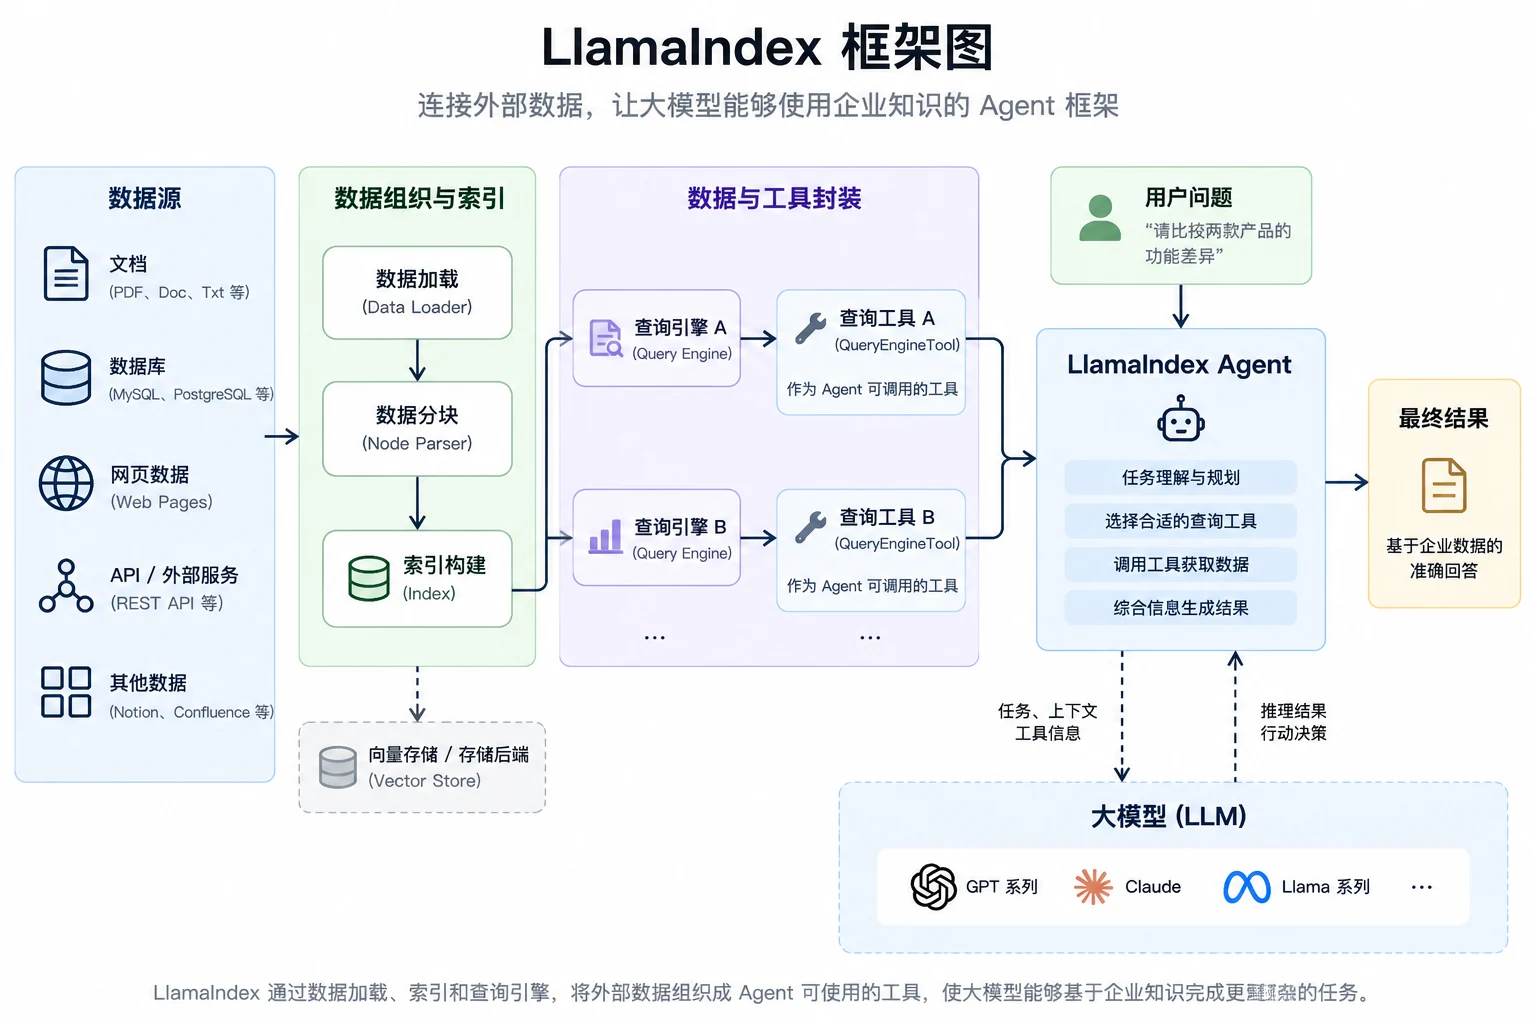
Por exemplo, para um Agent de análise empresarial, configuram-se ferramentas de consulta de documentação de produtos e dados operacionais. Quando o usuário solicita comparar diferenças funcionais entre dois produtos, o Agent chama a ferramenta de consulta correspondente aos documentos de produto; se o usuário continuar perguntando sobre as vendas dos dois produtos, chama a ferramenta de consulta de dados operacionais. Para perguntas mais complexas, o Agent também pode chamar múltiplas ferramentas de consulta de dados consecutivamente e depois combinar resultados de diferentes fontes de dados para completar a tarefa.
O LlamaIndex não foi projetado originalmente para desenvolvimento de Agent; suas características refletem-se principalmente no processamento de dados e conhecimento. Não apenas permite que modelos pesquisem documentos, mas também pode organizar diferentes dados e capacidades de consulta em ferramentas que Agent podem selecionar e usar. É particularmente adequado para aplicações de perguntas e respostas em bases de conhecimento, análise de documentos, consultas em múltiplas fontes de dados e aplicações Agent que requerem acesso a numerosos documentos empresariais, bases de conhecimento ou dados estruturados.
Framework AutoGen
O AutoGen foi lançado pela equipe de pesquisa da Microsoft em 2023 e é um framework open-source representativo na área de desenvolvimento multi-Agent. Com o Multi-Agent Conversation como conceito central, permite que múltiplos Agent realizem tarefas juntos através de diálogos.
O AutoGen projeta Agent como entidades dialogáveis e personalizáveis; um Agent pode ser composto por um modelo de linguagem, ferramentas, entrada manual ou uma combinação dessas capacidades. Os desenvolvedores também podem definir a forma de interação entre Agent, permitindo que diferentes Agent formem diferentes modos de conversa. O design geral é ilustrado abaixo.
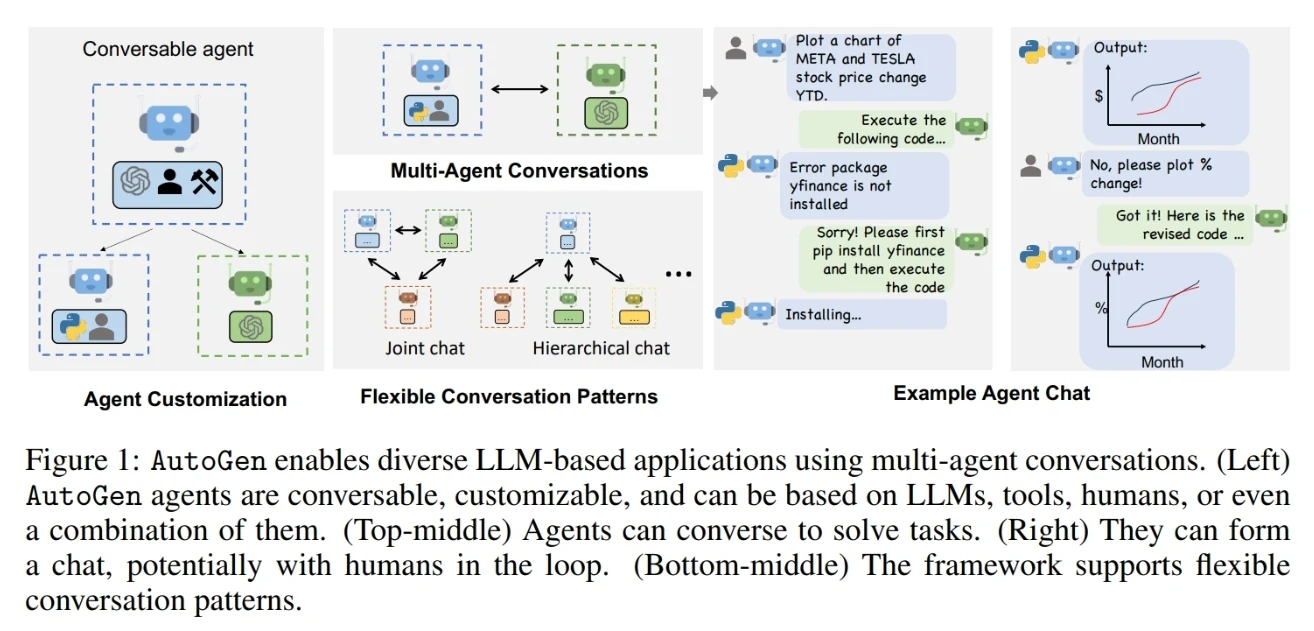
Este diagrama reflete dois importantes conceitos de design do AutoGen. Primeiro, diferentes Agent podem ter diferentes capacidades. Segundo, múltiplos Agent podem ser organizados através de diferentes Conversation Patterns, comunicando-se e colaborando de diferentes maneiras.
Por exemplo, em uma tarefa de desenvolvimento de software, pode-se definir um Agent para analisar requisitos, um Agent para escrever código e outro Agent para verificar resultados. Após o Agent de programação gerar código, envia o resultado para o Agent de verificação; se problemas forem detectados, o Agent de verificação pode fornecer feedback ao Agent de programação para continuar modificando até que os requisitos da tarefa sejam atendidos.
Atualmente, o AutoGen oferece principalmente dois níveis de capacidade: AgentChat e Core. AgentChat é uma interface de alto nível para construir aplicações de Agent único e multi-Agent, fornecendo componentes como Agent e Team. Os desenvolvedores podem combinar múltiplos Agent em um Team e organizar colaboração através de turnos, seleção dinâmica do próximo Agent, etc. O Core usa abordagens baseadas em eventos, fornecendo capacidades fundamentais para sistemas multi-Agent mais flexíveis e escaláveis.
A característica do AutoGen é colocar a comunicação e colaboração entre Agent como foco do design do framework, sendo adequado para tarefas complexas que requerem que múltiplos Agent dividam trabalho. Sistemas multi-Agent requerem design adicional das responsabilidades e formas de colaboração dos Agent; para tarefas simples, geralmente não é necessário usar múltiplos Agent.
Framework CrewAI
O CrewAI também é focado em colaboração multi-Agent, mas adota uma organização mais próxima de equipes reais. Os desenvolvedores podem definir papéis, objetivos e ferramentas para diferentes Agent e depois organizar esses Agent através de tarefas e fluxos de trabalho para trabalhar juntos. O CrewAI oferece principalmente dois tipos de organização: Crews enfatizam a colaboração autônoma entre múltiplos Agent, enquanto Flows enfatizam o controle estruturado de fluxo de trabalho.
A estrutura de framework fornecida oficialmente pelo CrewAI é ilustrada abaixo.
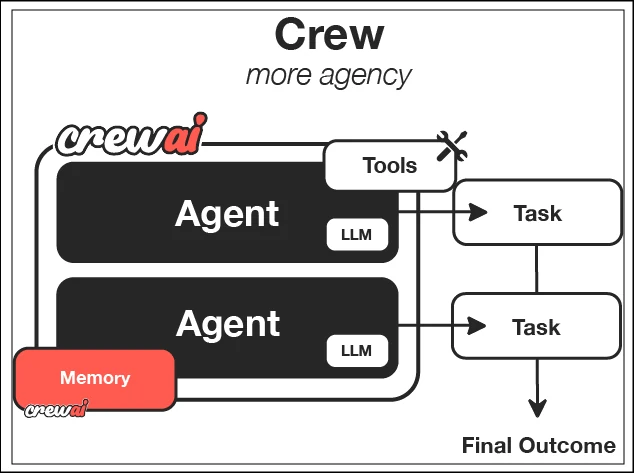
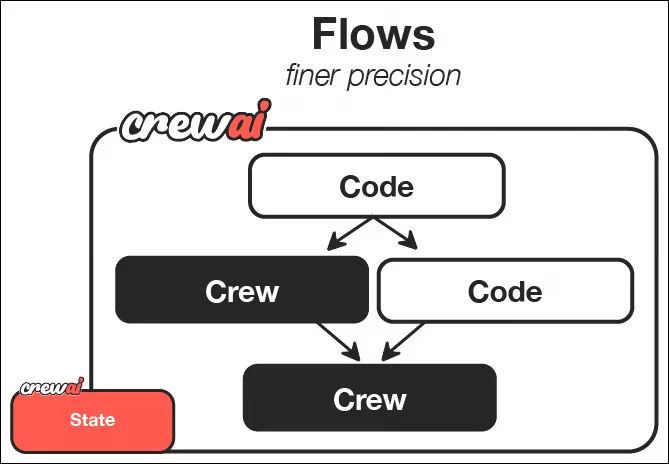
Em um Crew, Agent podem ser compreendidos como membros da equipe com responsabilidades específicas, Tasks representam as tarefas concretas a serem realizadas, Process define a forma de execução dos Agent e tarefas, e Crew organiza esses Agent e tarefas juntos para atingir o objetivo final.
Por exemplo, para produzir um relatório de pesquisa de setor, pode-se criar um Agent de pesquisa, um Agent de redação e um Agent de revisão. O Agent de pesquisa é responsável por encontrar e organizar materiais, o Agent de redação gera o relatório com base nos resultados da pesquisa, e o Agent de revisão verifica problemas no relatório. Diferentes Agent assumem diferentes responsabilidades e trabalham juntos através da vinculação de tarefas.
Flows podem organizar a execução de tarefas de acordo com um processo predefinido e suportar capacidades como verificação de condições, loops e gerenciamento de estado. Crews e Flows também podem ser combinados; por exemplo, um Flow pode controlar o processo de negócios geral e, em uma etapa complexa, chamar um Crew, onde múltiplos Agent colaboram para completar a tarefa.
A característica do CrewAI é organizar a colaboração multi-Agent através de papéis, tarefas e equipes, com um design geral que se aproxima do trabalho em equipe real. É particularmente adequado para aplicações multi-Agent com limites claros de papéis e tarefas, como pesquisa, geração de conteúdo, análise de dados e cenários de revisão.
Framework LangGraph
O LangGraph foi lançado pela equipe do LangChain em 2024 e é um framework de orquestração de baixo nível para construir e gerenciar Agent de longa duração e com estado. Diferente do uso de Agent pré-construídos, o LangGraph permite que os desenvolvedores definam explicitamente a estrutura de execução do Agent, sendo especialmente adequado para Agent com fluxos de trabalho complexos como estado, ramificação, loop e intervenção humana.
O LangGraph pode construir tanto fluxos de trabalho com caminhos de execução relativamente claros quanto Agent dinamicamente determinados pelo modelo de linguagem. Os fluxos de trabalho podem definir antecipadamente o caminho de execução das tarefas e organizar diferentes etapas através de métodos sequenciais, paralelos, de roteamento e de loop; os Agent podem determinar dinamicamente a próxima operação com base no estado atual e nos resultados das ferramentas. Na prática, fluxos de trabalho e Agent também podem ser combinados, onde o fluxo de trabalho determina o processo geral e o Agent é responsável pelas etapas que requerem decisões dinâmicas.
Os modos de fluxo de trabalho e Agent suportados pelo LangGraph são ilustrados abaixo.
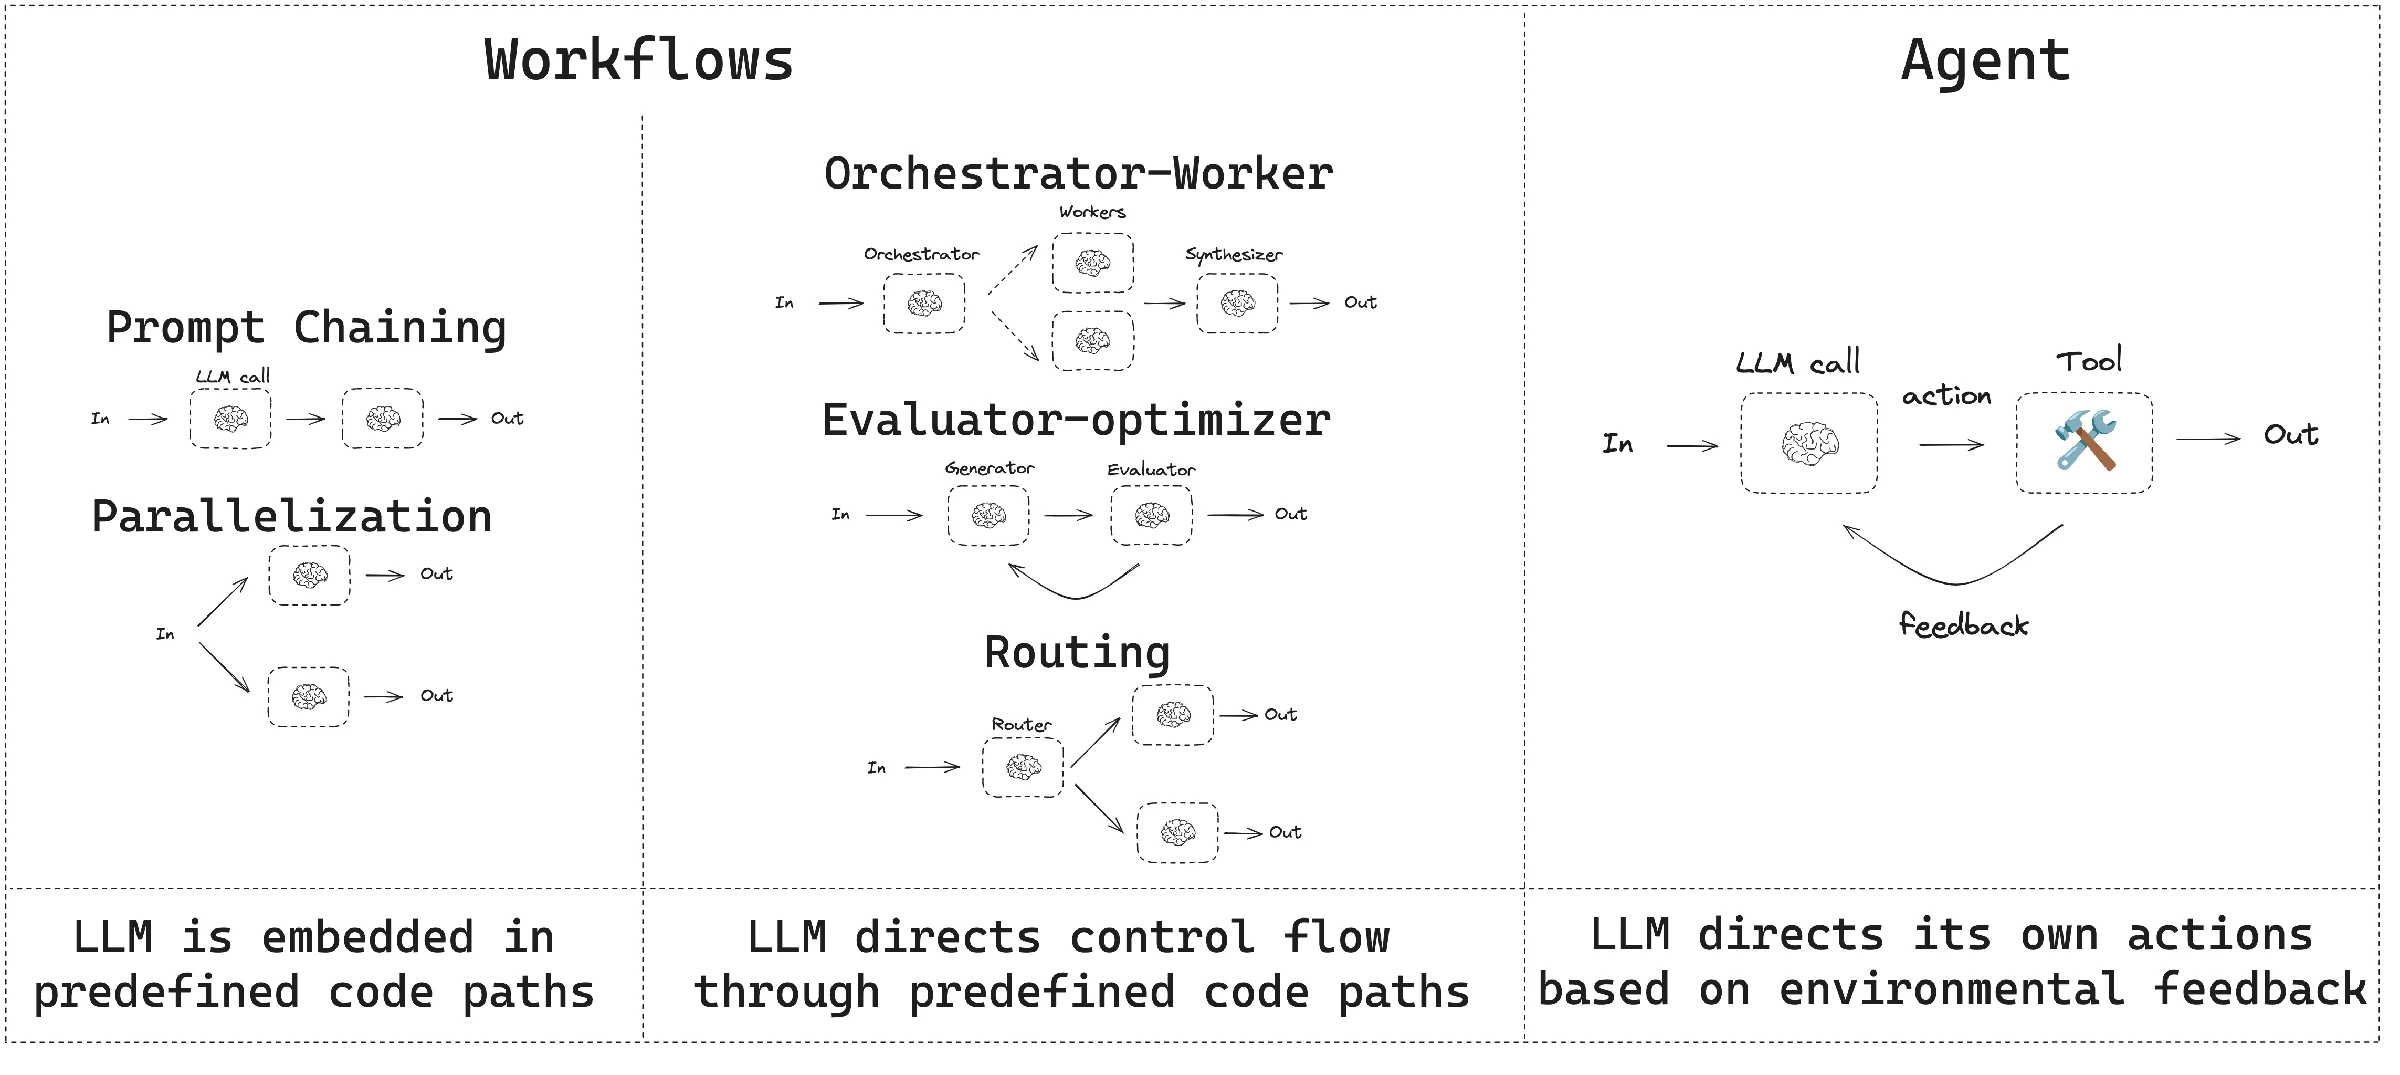
Para implementar esses diferentes caminhos de execução, o LangGraph usa grafos para descrever o processo de execução das tarefas, onde três conceitos básicos são State, Node e Edge. State serve para armazenar informações que precisam ser compartilhadas durante a execução da tarefa; Node representa uma etapa de processamento concreta, como chamada de modelo de linguagem, pesquisa de conhecimento ou execução de ferramenta; Edge conecta diferentes nós e decide em qual nó a tarefa entrará a seguir.
Por exemplo, um Agent de perguntas e respostas sobre conhecimento pode primeiro analisar a pergunta do usuário, depois pesquisar o conhecimento, gerar uma resposta e verificar o resultado. Se a resposta não passar na verificação, pode entrar novamente no nó de pesquisa através de uma ramificação condicional; se passar, entra no nó de saída final. Durante todo o processo, perguntas do usuário, resultados de pesquisa, respostas intermediárias e outras informações podem ser armazenadas no State e compartilhadas entre diferentes nós.
Esse design difere da dependência completa do modelo de linguagem para determinar a próxima operação. O LangGraph permite prescrever antecipadamente a estrutura geral de execução das tarefas e usar modelos de linguagem para tomada de decisão nos nós que requerem julgamento. Assim, mantém-se a capacidade do Agent de julgar dinamicamente com base nas circunstâncias reais, e o caminho crítico de execução pode ser controlado.
Além da estrutura de grafos e gerenciamento de estado, o LangGraph também oferece capacidades como Durable Execution e Human-in-the-loop. Tarefas de longa duração podem salvar o estado de execução e continuar após interrupções; antes de operações importantes, o Agent também pode ser pausado para aguardar verificação ou modificação de estado manual antes de continuar a execução. Portanto, a documentação oficial do LangGraph posiciona-o como framework de orquestração de baixo nível para Agent de longa duração e com estado.
O LangGraph pode controlar o estado e o caminho de execução com granularidade fina, mas também requer mais design de fluxo de trabalho por parte dos desenvolvedores. Para Agent simples de chamada de ferramentas, não é necessário construir grafos complexos desde o início. A documentação oficial do LangGraph também recomenda que iniciantes que estão começando a aprender sobre Agent ou que precisam de maior abstração comecem com Agent do LangChain.
Framework MS-Agent
O MS-Agent é um framework leve de desenvolvimento de Agent da comunidade ModelScope, voltado principalmente para tarefas que requerem exploração autônoma e execução em múltiplas etapas, oferecendo capacidades de chamada de modelo, integração de ferramentas e colaboração multi-Agent, podendo ser usado para construir aplicações de pesquisa profunda, análise de documentos e geração de código.
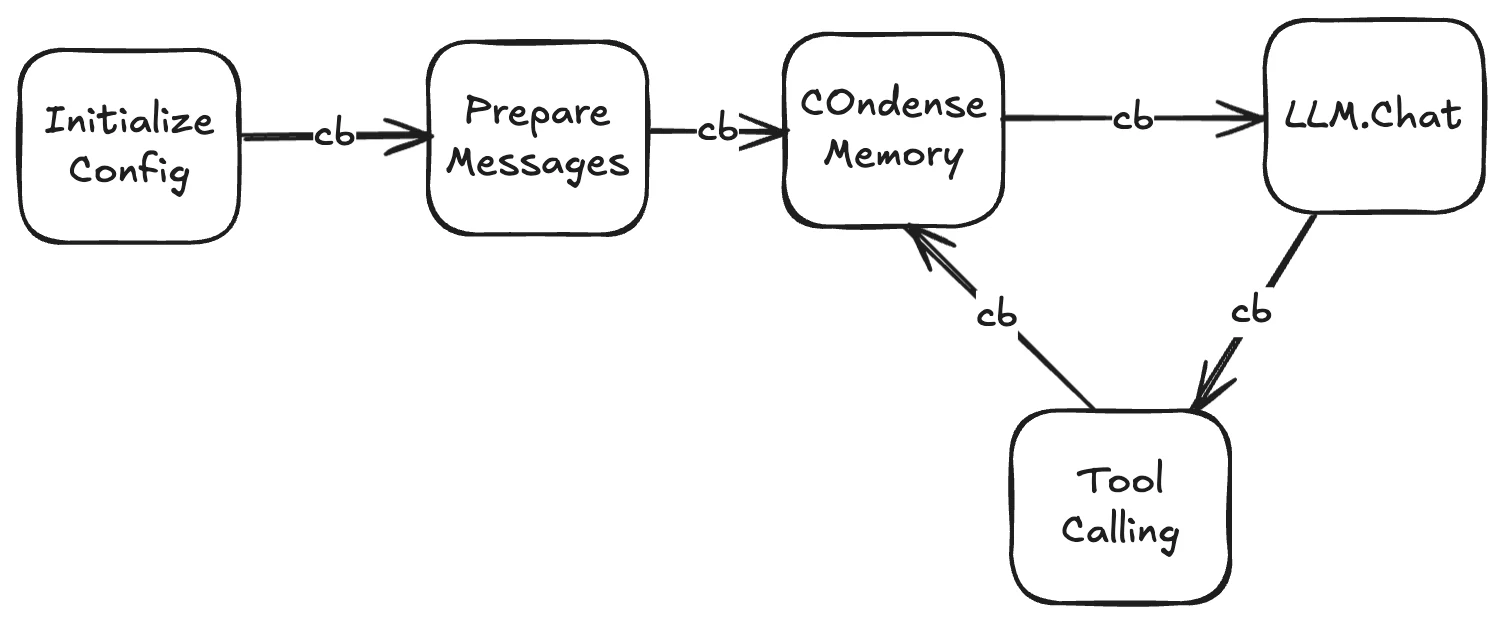
O componente básico do MS-Agent é o LLMAgent, responsável por organizar diálogos do modelo de linguagem e chamadas de ferramentas. Os desenvolvedores podem especificar o modelo, prompts e ferramentas através de arquivos de configuração. Após receber a tarefa do usuário, o LLMAgent fornece a tarefa e as ferramentas disponíveis ao modelo, que decide a próxima operação. Se uma chamada de ferramenta for necessária, o framework executa a operação correspondente e retorna o resultado ao modelo para processamento contínuo, até que o modelo gere uma resposta que não contenha mais chamadas de ferramentas ou atinja o número máximo de rodadas de execução.
O processo básico de execução do LLMAgent é ilustrado abaixo. Após completar a inicialização da configuração e preparação de mensagens, o Agent alterna entre chamadas de modelo e execução de ferramentas, comprimindo o contexto quando necessário. O cb no diagrama representa callback; os desenvolvedores podem adicionar registro de log ou outro processamento personalizado nas etapas correspondentes.
A integração de ferramentas é uma capacidade importante do MS-Agent. O framework oferece ferramentas integradas como leitura/escrita de arquivos, execução de código e divisão de tarefas, e também suporta integração de ferramentas externas através do MCP (Model Context Protocol). Os desenvolvedores podem reutilizar serviços MCP existentes ou escrever ferramentas personalizadas, permitindo que o Agent acesse os dados e sistemas externos necessários.
Para tarefas que requerem múltiplas etapas, o MS-Agent suporta combinação de diferentes Agent através de fluxos de trabalho. O LLMAgent é responsável pelas etapas que requerem decisão e geração do modelo de linguagem, enquanto o CodeAgent é responsável por operações determinísticas de execução de código. Os desenvolvedores podem organizar análise de dados, processamento de dados e geração de resultados em um fluxo de trabalho e especificar o relacionamento de execução das etapas através de arquivos de configuração.
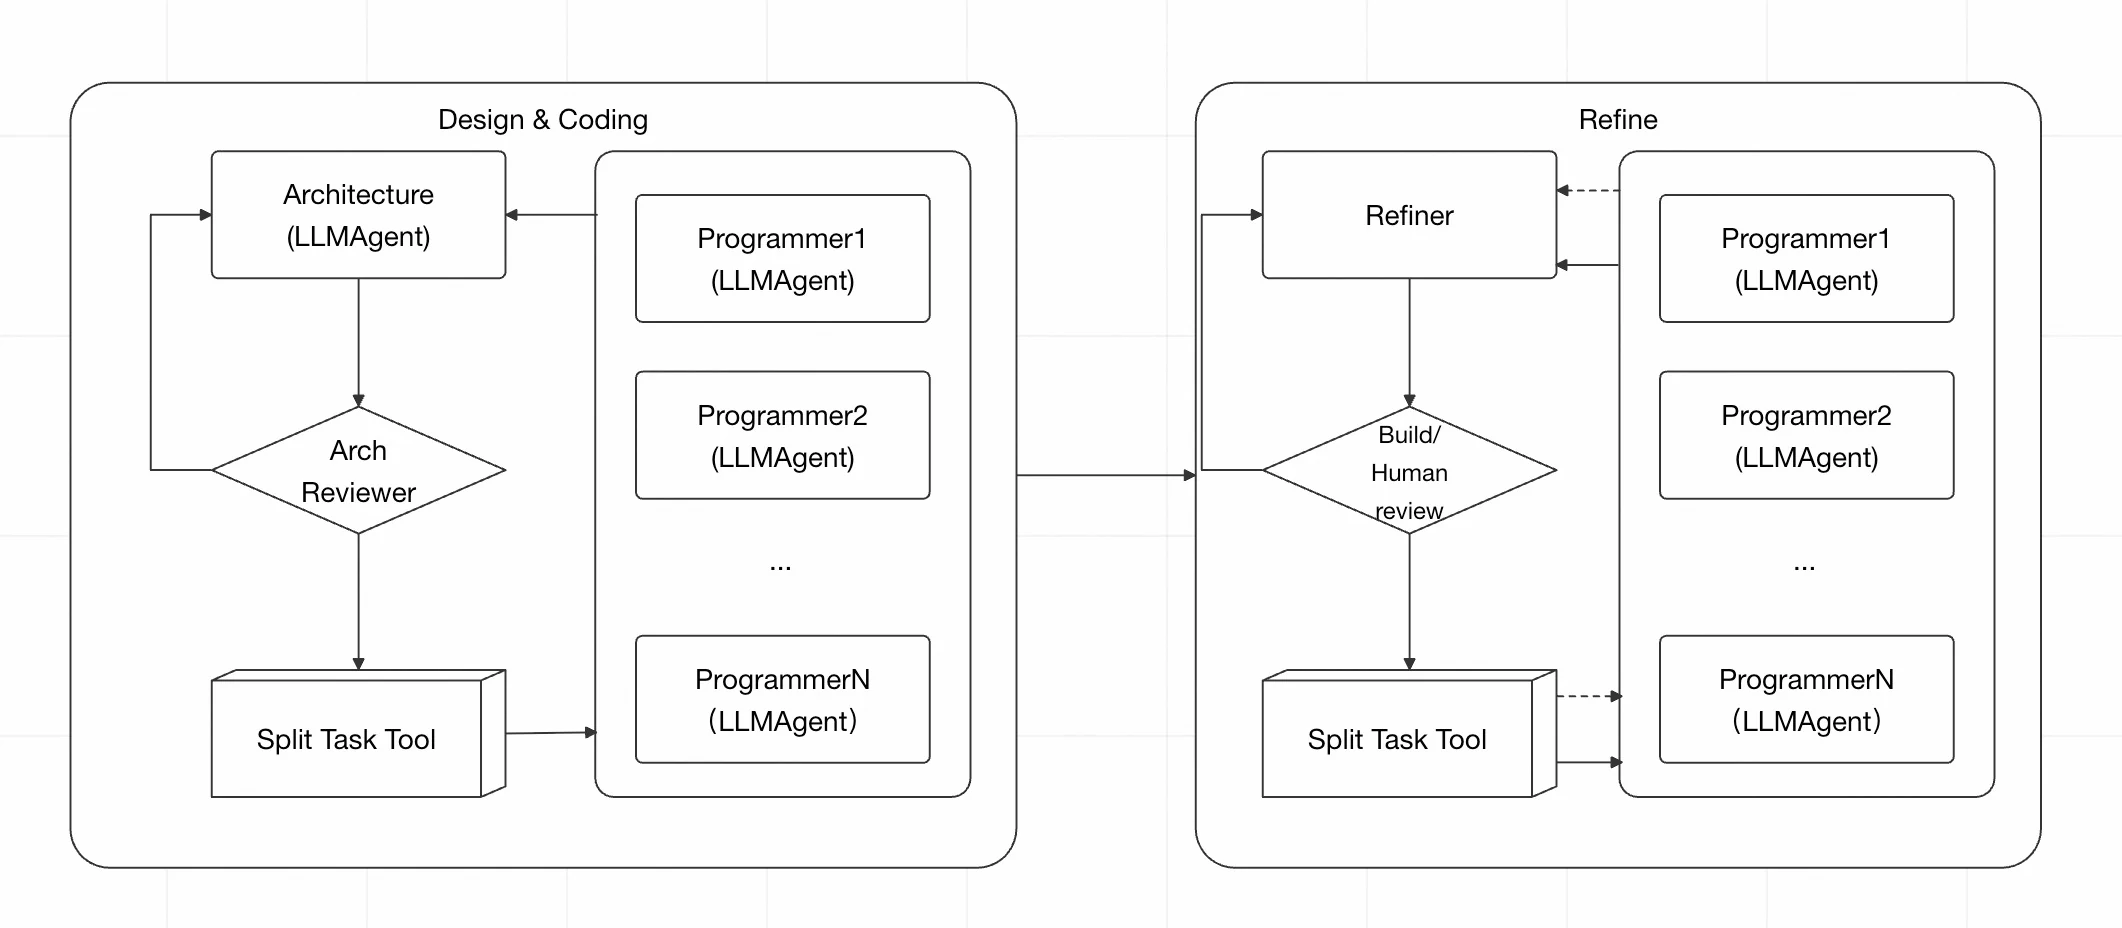
Por exemplo, o projeto MS-Agent Code Genesis oferece um exemplo de colaboração multi-Agent para geração de código, dividindo o processo em duas partes: design e codificação, verificação e otimização. O Agent de arquitetura é responsável pelo design, e a ferramenta de divisão de tarefas distribui o trabalho para múltiplos Agent de programação; ao entrar na fase de otimização, as tarefas de modificação são divididas com base no feedback de construção ou verificação manual e processadas continuamente pelos Agent de programação.
Agent SDK
Além do uso de frameworks de desenvolvimento de Agent, alguns provedores de modelos também oferecem capacidades de desenvolvimento de Agent na forma de SDK (Software Development Kit), encapsulando chamadas de modelo, chamadas de ferramentas e execução de tarefas em interfaces, classes e componentes, ajudando os desenvolvedores a criar e executar Agent em suas aplicações. Tanto frameworks Agent quanto SDK Agent podem ser usados para construir Agent, oferecendo capacidades sobrepostas, mas diferindo na organização e foco. A seguir, são apresentados dois SDK Agent representativos.
OpenAI Agents SDK
A OpenAI lançou em 2025 o OpenAI Agents SDK, que enfatiza a construção de aplicações Agent com poucas abstrações centrais. Usando Agent como unidade básica de execução, oferece chamadas de ferramentas, transferência de tarefas, restrições de execução e rastreamento de execução ao redor do Agent. Tools servem para consultar dados, executar código, chamar APIs ou operar outros sistemas externos; Handoffs permitem que o Agent atual transfira a tarefa para outro Agent mais adequado para processá-la; Guardrails verificam as entradas, saídas e parcialmente chamadas de ferramentas dos Agent; e Tracing registra eventos de geração de modelo, chamadas de ferramentas, transferência de tarefas e Guardrail durante a execução do Agent.
O OpenAI Agents SDK também oferece Agent Visualization, que pode gerar uma estrutura de grafo para o Agent e os outros Agent, Tools e MCP Server conectados a ele. As conexões direcionadas entre Agent podem representar Handoffs, enquanto as conexões entre Tools e Agent representam chamadas de ferramentas.
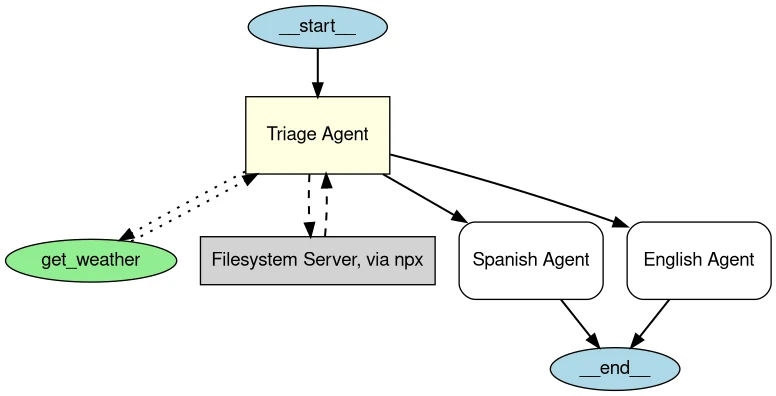
Por exemplo, em um sistema de atendimento ao cliente, pode-se configurar um Agent de entrada responsável por identificar perguntas do usuário e depois Agent de pedido, Agent de reembolso e Agent de FAQ para processar diferentes tipos de negócios. Quando um usuário consulta sobre reembolso, o Agent de entrada pode transferir a tarefa para o Agent de reembolso através de Handoff; o Agent de reembolso então chama ferramentas de consulta de pedido, solicitação de reembolso, etc., conforme necessário, para completar a tarefa. Handoffs são particularmente adequados para cenários onde diferentes Agent especializados processam diferentes tarefas.
Guardrails e Tracing consideram restrições e problemas de observação durante a execução real do Agent. Guardrails podem verificar antes e depois de entradas do Agent, saídas finais e chamadas de ferramentas de função personalizadas; Tracing registra eventos de geração de modelo, chamadas de ferramentas, Handoffs e Guardrail durante uma execução do Agent, ajudando os desenvolvedores a entender quais etapas o Agent percorreu e onde os problemas ocorreram.
A característica do OpenAI Agents SDK é que os conceitos centrais são relativamente concentrados. Os desenvolvedores podem começar com um único Agent e Tools e gradualmente adicionar capacidades de colaboração multi-Agent, Guardrails e Tracing. Em comparação com o LangGraph, o foco dos dois designs difere: LangGraph enfatiza controle granular de estado e fluxo de trabalho; OpenAI Agents SDK concentra-se em capacidades abrangentes ao redor do Agent como chamadas de ferramentas, transferência de tarefas, restrições de execução e rastreamento de execução.
Claude Agent SDK
O Claude Agent SDK é um SDK de desenvolvimento de Agent lançado pela Anthropic, originalmente chamado de Claude Code SDK e posteriormente renomeado para Claude Agent SDK. Ele torna as capacidades de Agent do Claude Code disponíveis para desenvolvedores, permitindo que criem em suas aplicações Agent capazes de usar ferramentas, acessar o ambiente de execução e executar tarefas continuamente.
Em comparação com as ferramentas de desenvolvimento de Agent apresentadas anteriormente, uma característica proeminente do Claude Agent SDK é sua maior ênfase no acesso e operação do Agent ao ambiente de execução real. Além de chamar ferramentas externas, oferece capacidades integradas como leitura, modificação de arquivos e execução de comandos, permitindo que o Agent processe arquivos diretamente, execute programas e comandos, e acesse mais ferramentas e dados externos através do MCP. Além disso, oferece mecanismos como controle de permissões, Hooks e Subagents; o controle de permissões restringe as operações que o Agent pode executar; Hooks podem inserir lógica de processamento personalizada em estágios críticos como chamadas de ferramentas; Subagents podem delegar partes de tarefas a sub-Agent independentes.
Durante a execução, o Agent decide a próxima operação com base na tarefa atual e no contexto, como ler arquivos, modificar código ou executar comandos. Após a execução da ferramenta, os resultados são retornados ao Agent, que então continua decidindo com base nas novas informações até que a tarefa seja concluída. O Claude Agent SDK organiza esse processo de execução e nele trata chamadas de ferramentas, verificações de permissão e passagem de contexto.
Por exemplo, em uma tarefa de desenvolvimento de software, pode-se pedir ao Agent que leia o código do projeto, modifique arquivos de acordo com os requisitos do usuário e depois execute os testes. Se um teste falhar, o Agent pode ler as informações de erro e continuar modificando até concluir a tarefa. Nesse processo, o modelo de linguagem é responsável por entender a tarefa e decidir a próxima operação, enquanto o Claude Agent SDK fornece capacidades de execução como sistema de arquivos, terminal e ferramentas, e gerencia permissões e o processo de execução da tarefa.
O Claude Agent SDK é particularmente adequado para aplicações Agent que requerem acesso a arquivos e ambiente de execução, chamada contínua de ferramentas e execução de tarefas em múltiplas etapas, especialmente para cenários como desenvolvimento de software e tarefas de automação.
No desenvolvimento real de Agent, capacidades como ambiente de execução, gerenciamento de contexto, controle de permissões, estado da tarefa e feedback de execução estão recebendo cada vez mais atenção. Como organizar essas capacidades ao redor do modelo de linguagem e gerenciar e controlar o processo de execução de tarefas tornou-se uma questão importante no design de sistemas Agent, e é exatamente sobre essas questões que o Harness se concentra.
Harness
O que é Harness?
Com a melhoria contínua das capacidades dos modelos de linguagem, o problema enfrentado pelos Agent passou gradualmente de "o modelo pode completar uma determinada tarefa?" para "o modelo pode completar uma tarefa real de forma contínua e confiável?". Em uma simples pergunta e resposta, o modelo de linguagem precisa apenas gerar um resultado com base na entrada; mas em tarefas complexas como desenvolvimento de software, análise de dados e automação de negócios, o Agent pode precisar trabalhar por um longo período, salvar progresso entre múltiplas etapas, chamar diferentes ferramentas e ajustar continuamente operações subsequentes com base nos resultados reais de execução. Nesses casos, apenas confiar na capacidade de raciocínio do modelo não garante que a tarefa seja finalizada corretamente.
Por exemplo, um Agent de código pode conseguir entender corretamente a demanda de "modificar uma determinada funcionalidade" e gerar código de alta qualidade, mas durante o processo real de execução podem ocorrer vários problemas: modificar código sem ler as especificações do projeto, modificar muitos arquivos ao mesmo tempo, omitir etapas necessárias, perder progresso de tarefas anteriores durante a execução, ou considerar a tarefa concluída antes que o código passe nos testes. Esses problemas não vêm totalmente das capacidades do modelo em si, mas estão relacionados ao ambiente de trabalho do modelo e à forma de execução da tarefa.
Harness é um conjunto de ambiente de trabalho e mecanismos de execução construídos ao redor do modelo de linguagem, para definir quais informações o modelo pode receber, quais operações pode executar, como salvar o estado da tarefa, como determinar se a tarefa está concluída e como processar quando surgem problemas. Através desses mecanismos, as operações e raciocínios independentes do modelo podem ser organizados em um processo de execução de tarefas restrito, capaz de ser executado continuamente e de ter seus resultados verificados.
O foco do Harness não é melhorar ainda mais o conhecimento ou a capacidade de raciocínio do modelo de linguagem, mas garantir que as capacidades existentes do modelo possam ser aplicadas de forma mais confiável a tarefas reais. O modelo continua responsável por entender a tarefa, analisar problemas e decidir a próxima operação; o Harness é responsável por criar as condições de trabalho necessárias para o modelo completar a tarefa e impor restrições e feedback em todo o processo de execução.
Do ponto de vista da execução, o Harness faz com que o Agent forme um ciclo contínuo: o Agent julga com base na tarefa atual e no estado, executa a operação correspondente e obtém novos resultados do ambiente de execução; esses resultados, após serem registrados, verificados e recebidos feedback, tornam-se novamente a base para a próxima decisão. Se os resultados não satisfizerem os requisitos, o Agent continua modificando e executando; apenas quando as condições pré-definidas de conclusão são atingidas, a tarefa realmente termina.
O Harness difere significativamente de prompts simples ou chamadas de ferramentas. O Prompt comunica ao modelo principalmente através de instruções os objetivos da tarefa e os requisitos de comportamento; as ferramentas permitem ao modelo executar operações concretas; e o Harness considera além disso como essas instruções e ferramentas são organizadas e gerenciadas ao longo de todo o processo de execução da tarefa. É necessário fazer com que o Agent saiba onde começou, onde está atualmente, quais operações podem ser executadas, como os resultados são verificados, quando pode terminar e como continuar após uma interrupção da tarefa. Para Agent que precisam ser executados por longo tempo e em múltiplas etapas, esses mecanismos afetam diretamente se a tarefa pode ser concluída de forma estável.
Principais componentes do Harness
O Harness não tem uma implementação única; diferentes sistemas Agent oferecem diferentes mecanismos de execução dependendo do tipo de tarefa. Do ponto de vista dos problemas que precisam ser resolvidos durante a execução real do Agent, o Harness pode ser resumido em cinco partes que trabalham em conjunto: instruções e contexto, ferramentas, ambiente de execução, estado e continuidade da tarefa, e validação e feedback.
(1) Instruções e contexto
Instruções e contexto determinam o que um Agent "sabe" e "deve seguir" na tarefa atual.
As instruções incluem não apenas a entrada atual do usuário, mas também prompts do sistema, regras do projeto, padrões de código, restrições de negócios, limites da tarefa e condições de conclusão. Por exemplo, um Agent de programação pode entender a estrutura de diretórios, padrões de desenvolvimento, métodos de teste e áreas bloqueadas através de AGENTS.md, CLAUDE.md ou documentação do projeto.
Contexto refere-se às informações relevantes fornecidas ao modelo durante a execução, incluindo requisitos do usuário, operações anteriores, conteúdo de arquivos, resultados da execução de ferramentas e estado atual da tarefa. Como a janela de contexto do modelo é limitada, o Harness frequentemente precisa selecionar, comprimir e reorganizar o contexto, para que o modelo receba as informações realmente necessárias para a tarefa atual, em vez de simplesmente anexar continuamente todo o histórico.
Para tarefas complexas, pode-se usar instruções hierárquicas e carregamento progressivo de contexto. Por exemplo, primeiro fazer o Agent ler a descrição geral do projeto e, ao entrar em um módulo, carregar as regras locais desse módulo; quando a execução da tarefa é longa e o contexto aumenta continuamente, os processos anteriores podem ser comprimidos, mantendo apenas conclusões chave, estado da tarefa e informações ainda necessárias para o futuro. Através desses mecanismos, pode-se fornecer continuamente informações relevantes ao Agent na janela de contexto limitada e restringir o alcance da tarefa e os limites de comportamento do Agent através de instruções.
(2) Ferramentas
Os modelos de linguagem são responsáveis principalmente por compreensão, raciocínio e geração de decisões. Para realmente ler informações externas ou executar operações concretas, é necessário usar ferramentas. Portanto, as ferramentas determinam quais ações um Agent pode realmente executar.
Para Agent de programação, as ferramentas comuns incluem leitura de arquivos, modificação de arquivos, busca de código, execução de comandos Shell, operações Git e ferramentas de teste; para Agent empresariais, podem incluir consulta a bancos de dados, pesquisa em bases de conhecimento, navegador, APIs de negócios e sistemas externos conectados via MCP.
O Harness nessa camada não apenas mantém uma lista de ferramentas, mas também precisa processar descrição de ferramentas, organização de parâmetros, roteamento de chamadas, retorno de resultados de execução e tratamento de exceções. Por exemplo, após o modelo de linguagem decidir "executar testes do projeto", o Harness precisa chamar a ferramenta correspondente, executar o comando de teste no ambiente especificado e depois retornar a saída padrão, informações de erro e status de saída organizados ao modelo, para que o Agent possa decidir a próxima operação com base nos resultados da execução.
As chamadas de ferramentas precisam ser coordenadas com controle de segurança e permissão apropriado. Algumas ferramentas só podem ler arquivos, outras podem modificar conteúdo; ao deletar arquivos, acessar a rede, executar comandos do sistema ou operar sistemas de produção, podem ser impostas restrições com base no nível de risco, sendo necessárias confirmações manuais quando necessário. Mecanismos como Hooks podem ser inseridos antes e depois das chamadas de ferramentas para verificar parâmetros, registrar processos de execução ou bloquear operações que não atendam às regras.
Em sistemas que suportam Subagent, o Agent principal também pode delegar partes de tarefas a Subagentes especializados. Por exemplo, trabalhos relativamente independentes como busca de código, análise de testes ou organização de materiais podem ser distribuídos para diferentes Subagentes e seus resultados consolidados. Dessa forma, pode-se expandir a capacidade de processamento de tarefas de um único Agent e reduzir a pressão de tarefas complexas concentradas em um único contexto de execução.
(3) Ambiente de execução
As ferramentas respondem à pergunta "o que um Agent pode fazer?"; o ambiente de execução determina "onde essas operações ocorrem".
Para Agent de programação, o ambiente de execução pode ser um diretório local do projeto, um contêiner, uma máquina virtual, uma Sandbox na nuvem ou um Git Worktree independente. O Agent precisa utilizar um ambiente concreto de execução para ler e modificar arquivos, executar comandos Shell, instalar dependências e rodar testes.
O Harness precisa preparar e gerenciar o ambiente de execução, como inicialização de repositórios de código, instalação de dependências, configuração de variáveis de ambiente, inicialização de serviços necessários e verificação se o ambiente atual atende às condições de execução da tarefa. Para tarefas de longa duração, também é necessário evitar que durante a execução ocorram falta de dependências, anormalidades em serviços ou inconsistências no estado dos recursos.
O isolamento de ambiente também é um conteúdo importante do gerenciamento do ambiente de execução. Se múltiplos Agent ou múltiplas tarefas processam o mesmo projeto simultaneamente, operações diretas no mesmo diretório de trabalho podem causar sobreposição de arquivos e conflitos de estado. Para diferentes tarefas, podem ser criados Sandboxes, contêineres ou Worktrees independentes, para que diferentes tarefas operem em espaços relativamente isolados. Mesmo que uma tarefa falhe, o impacto em outras tarefas e no ambiente hospedeiro pode ser reduzido.
O ambiente de execução também assume o controle dos limites de acesso a recursos. Por exemplo, pode-se restringir o Agent a acessar apenas diretórios especificados, conectar-se apenas a redes específicas, não ler arquivos sensíveis do sistema ou configurar diferentes credenciais de acesso para diferentes tarefas. As ferramentas definem quais capacidades um Agent pode usar; o ambiente de execução restringe quais arquivos, processos, redes e recursos do sistema essas capacidades podem realmente afetar.
(4) Estado e continuidade da tarefaUma chamada individual do modelo de linguagem não possui estado de tarefa de longo prazo inerente, mas tarefas complexas de Agent podem durar minutos, horas ou até múltiplas sessões. Se as informações da tarefa existirem apenas no contexto atual, após compressão do contexto, interrupção do processo ou reinício da sessão, o Agent pode não conseguir julgar com precisão qual trabalho já foi concluído.
O Harness precisa manter o estado da tarefa, como objetivo atual, resultado da divisão da tarefa, etapas concluídas, etapas em processamento, arquivos modificados, resultados importantes da execução de ferramentas e conteúdos a serem processados a seguir.
Esses estados podem ser salvos na memória ou gravados em arquivos de tarefa, bancos de dados, histórico Git ou outros armazenamentos externos. Para Agent de longa duração, o armazenamento persistente de estado é especialmente importante. Novas sessões de Agent podem ler o progresso da tarefa e resultados-chave salvos anteriormente e continuar a execução do ponto de interrupção anterior, sem precisar reanalisar toda a tarefa.
O gerenciamento de estado permeia todo o ciclo de vida da tarefa. No início da tarefa, um estado inicial é estabelecido; durante a execução, progresso e resultados-chave são registrados continuamente; após a conclusão da tarefa, o estado final é salvo; se a tarefa for interrompida devido a anormalidades, timeouts ou reinicialização do sistema, pode-se retornar à posição de execução anterior através de mecanismos de checkpoint. Para tarefas complexas com Subagent, podem ser registrados o status de conclusão, resultados de execução e dependências entre diferentes subtarefas.
O foco do estado e da continuidade da tarefa é manter um processo de execução de tarefas continuamente atualizável, persistente e recuperável, para que o Agent, mesmo em execução de longa duração ou entre sessões, saiba onde a tarefa está.
(5) Validação e feedback
Quando um Agent executa uma ação, isso não significa que a tarefa foi concluída corretamente. Por exemplo, o Agent modificou um arquivo de código com sucesso, mas o código pode não compilar; gerou um relatório de análise, mas pode faltar dados importantes; chamou uma API de negócios com sucesso, mas pode produzir um resultado que não atende às regras de negócios. Portanto, o Harness também precisa estabelecer mecanismos de validação e feedback, verificar os resultados da execução e fornecer os resultados da verificação novamente ao Agent.
O método de validação depende da tarefa específica. Para tarefas de desenvolvimento de software, podem ser usados testes unitários, Lint, verificação de tipos, compilação e testes de ponta a ponta; para tarefas de negócios, podem ser usadas verificações de regras de negócios, comparação de resultados ou avaliadores independentes. O núcleo da validação é fornecer uma base verificável para a conclusão da tarefa, em vez de depender apenas do julgamento do modelo de que "a tarefa está concluída".
O feedback fornece os resultados da validação novamente ao Agent. Por exemplo, após falha no teste, o Harness pode retornar informações de erro e logs relevantes ao modelo; o Agent, com base nessas informações, continua analisando a causa, modificando o código e testando novamente, formando um ciclo "execução → validação → receber feedback → correção → revalidação". Esse ciclo permite que o Agent corrija continuamente decisões anteriores com base em resultados reais de execução, em vez de encerrar a tarefa diretamente após uma operação.
O Harness também pode inserir controle de execução nesse processo. Por exemplo, o código só pode ser submetido após todos os testes passarem; após múltiplas falhas consecutivas de execução, a tarefa é interrompida ou delegada para processamento manual; envolvendo modificações em ambiente de produção, exclusão de dados e outras operações de alto risco, a tarefa é pausada antes da execução real e requer aprovação manual. Após confirmação, a execução continua; sem confirmação, a operação é encerrada ou ajustada.
Essas cinco partes suportam conjuntamente a execução contínua do Agent: instruções e contexto fornecem objetivos da tarefa, regras e informações necessárias; ferramentas fornecem capacidades de ação reais; ambiente de execução abriga essas operações e limita os recursos; estado e continuidade da tarefa registram o progresso e suportam recuperação; validação e feedback verificam os resultados da execução e impulsionam o Agent a continuar corrigindo ou concluir a tarefa. Através desses mecanismos, o Harness organiza as chamadas individuais do modelo de linguagem do Agent em um processo completo de execução de tarefas que pode ser executado continuamente, restrito e com resultados verificáveis.
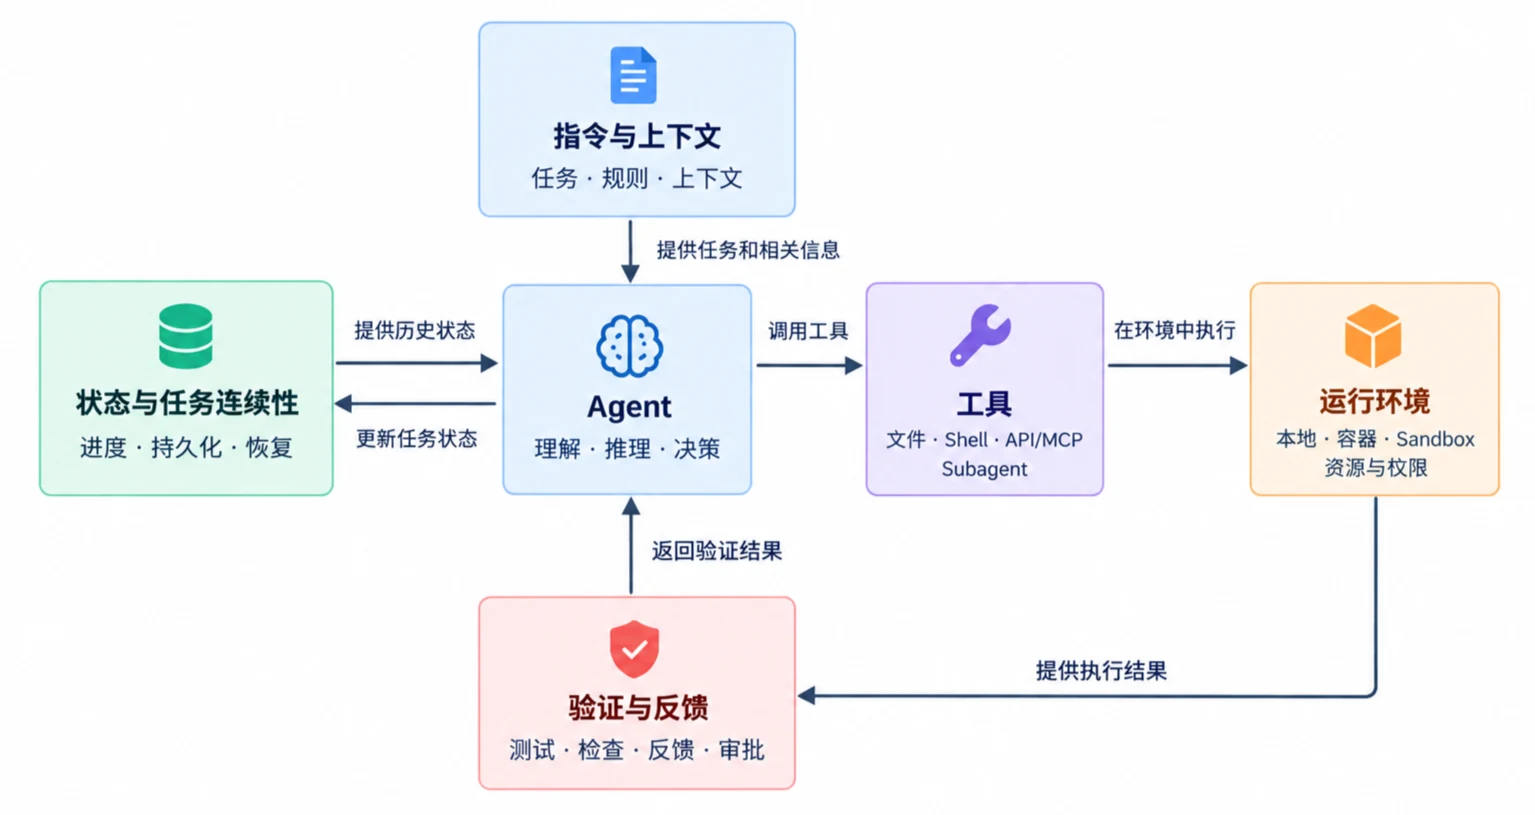
Relação entre Harness e Agent
Agent e Harness não são dois conceitos que se substituem mutuamente, mas estão em diferentes níveis. Durante a execução do Agent, o modelo de linguagem é responsável principalmente por entender a tarefa, analisar informações atuais e decidir a próxima operação; o Harness fornece ao Agent instruções e contexto, ferramentas, ambiente de execução, gerenciamento de estado, validação e feedback, para que as decisões do Agent sejam realmente executadas e, durante o processo de execução, sejam restritas e verificadas.
A relação entre os dois é de "suporte à decisão e execução". O Agent julga, com base na tarefa atual e nas informações disponíveis, o que deve ser feito a seguir; o Harness é responsável por fornecer as ferramentas e o ambiente necessários para realizar essa operação e registrar os estados e resultados gerados durante o processo de execução. Após a conclusão da execução, o Harness também pode validar os resultados através de testes, verificações de regras, etc., e fornecer o feedback ao Agent. O Agent continua julgando a próxima operação com base no novo estado e feedback, e assim por diante, até que as condições de conclusão da tarefa sejam atendidas.
Por exemplo, um Agent de programação julga que é necessário modificar login.py e executar testes. A análise do código e a decisão de como modificar dependem principalmente das capacidades de compreensão e raciocínio do modelo de linguagem; mas se login.py pode ser modificado, de onde ler o arquivo, por qual ferramenta modificar, em qual Sandbox o comando de teste é executado, como o progresso da modificação é salvo, como o resultado do teste é verificado e como continuar após uma falha, requer mecanismos de execução fornecidos pelo Harness. Após falha no teste, as informações de erro são fornecidas novamente ao Agent, que analisa a causa e decide o próximo plano de modificação com base nessas informações.
O grau de perfeição do Harness afeta os tipos de tarefas que um Agent pode processar. Um Harness simples pode oferecer apenas poucas ferramentas e um mecanismo básico de chamada, sendo adequado para tarefas com poucas etapas; um Harness mais completo pode oferecer gerenciamento de contexto, isolamento de ambiente, estado persistente da tarefa, controle de permissões, validação automática, recuperação após falhas e mecanismos de aprovação manual, permitindo que o Agent execute continuamente tarefas mais longas e complexas. Mesmo usando o mesmo modelo de linguagem, as diferentes condições de execução oferecidas por diferentes Harness podem levar a diferenças significativas na capacidade de processamento de tarefas e estabilidade do Agent em tarefas complexas.
Há certa sobreposição entre Harness e frameworks Agent; ambos envolvem chamadas de ferramentas, gerenciamento de contexto, gerenciamento de estado e controle de execução de tarefas, mas os focos diferem. Os frameworks Agent concentram-se mais em capacidades de desenvolvimento para construção de Agent e organização de tarefas, como definição de Agent, chamadas de ferramentas, gerenciamento de estado, orquestração de fluxos de trabalho e colaboração multi-Agent; o Harness concentra-se mais em mecanismos de suporte e controle ao redor da execução do Agent, como organização de contexto, fornecimento de ferramentas e ambiente de execução, manutenção da continuidade da tarefa e validação dos resultados da execução. Com o desenvolvimento contínuo de frameworks Agent e SDK Agent, algumas capacidades do Harness estão sendo cada vez mais integradas aos frameworks ou SDKs, portanto não há limites funcionais absolutos entre os dois na implementação concreta.
No geral, a relação entre os três pode ser resumida da seguinte forma: modelos de linguagem fornecem inteligência, Agent organizam decisões, Harness garante execução.
Com o aumento da complexidade das tarefas executadas por Agent, o papel do Harness se torna mais evidente.
DeepSeek Harness
A seguir, tomando o DeepSeek Harness como exemplo, será explicado como o Harness é organizado em sistemas Agent reais.
O DeepSeek Harness é um Agent Harness open-source lançado pela DeepSeek em 2026, cuja característica é organizar ferramentas, Skills, sessões, Sandboxes e capacidades de execução de tarefas necessárias para o funcionamento do modelo através de uma arquitetura baseada em plugins, oferecendo suporte de execução extensível para Agent.
A DeepSeek compreende um Agent executável como:
Agent = Model + Harness
Onde o Model é responsável pela compreensão de tarefas e tomada de decisão, e o Harness organiza as ferramentas, contexto e ambiente de execução necessários para o modelo completar a tarefa.
O design central do DeepSeek Harness é "Everything is a Plugin" (Tudo é um Plugin). Capacidades como modelos, ferramentas, Skills, sessões, Sandboxes, armazenamento, loops de execução, agendamento de tarefas e sub-Agent podem ser fornecidas todas por plugins, organizados pelo sistema de plugins Cordis subjacente. O Cordis é responsável pelo carregamento, descarregamento, gerenciamento de dependências e ciclo de vida dos plugins, enquanto as capacidades específicas do Agent são fornecidas por diferentes plugins. Os desenvolvedores podem combinar, substituir ou estender diferentes plugins de acordo com as necessidades reais.
A arquitetura geral baseada em plugins é ilustrada abaixo.
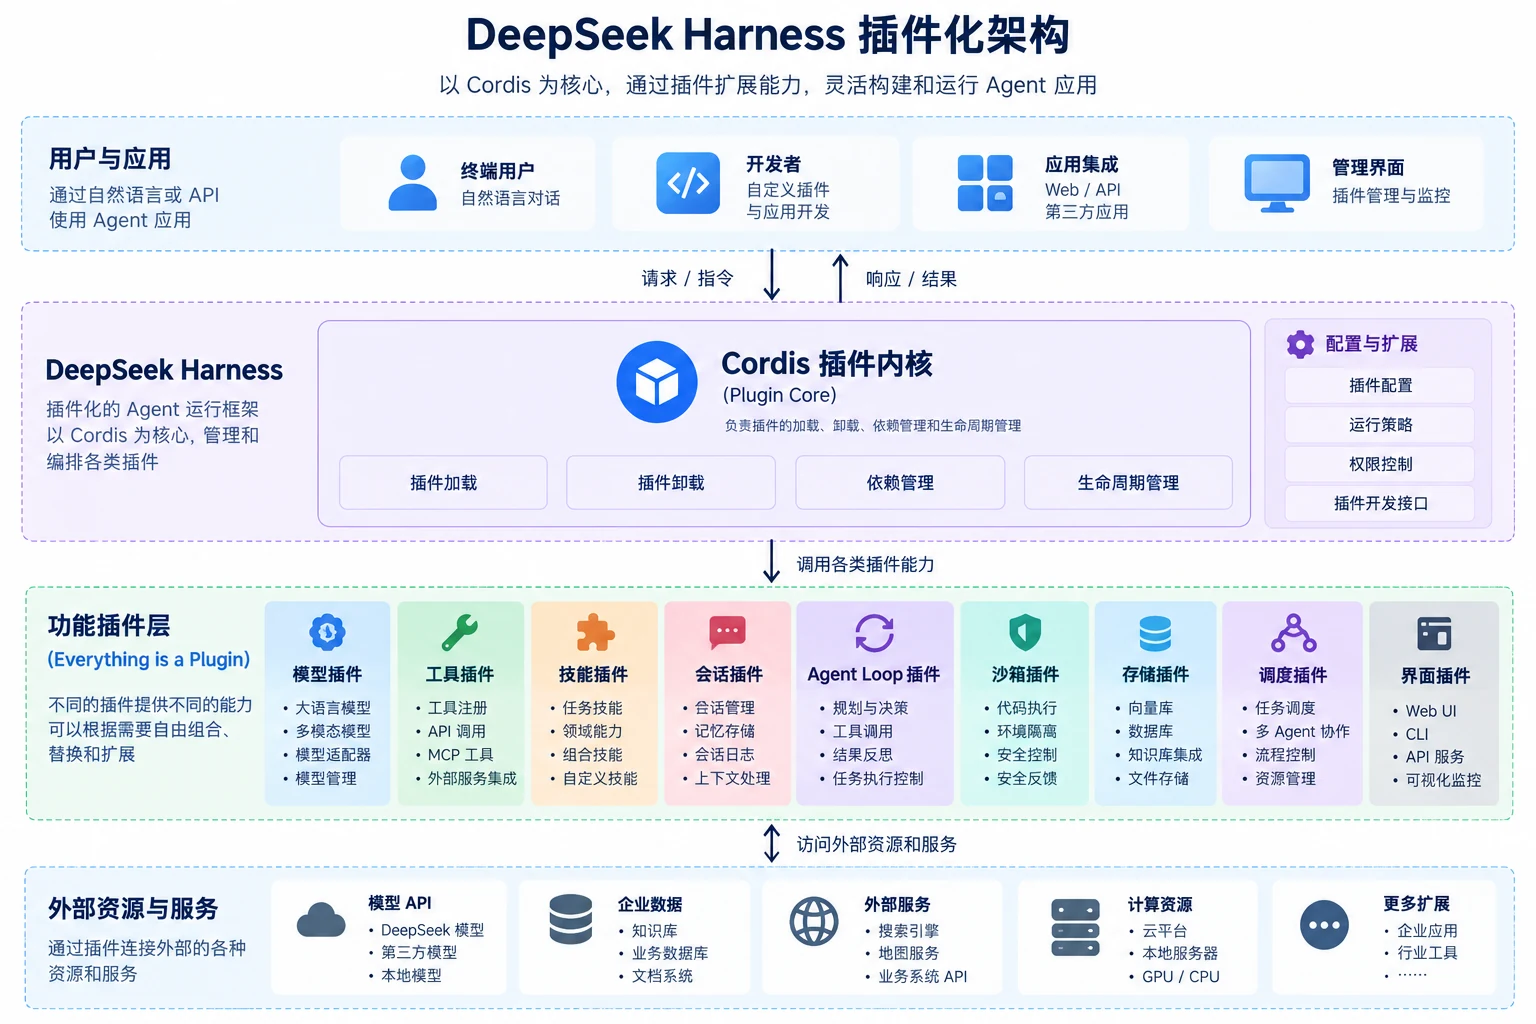
Por exemplo, usar o DeepSeek Harness para construir um Agent de análise de dados. O Agent lê arquivos de dados fornecidos pelo usuário, chama as ferramentas correspondentes para processamento e análise de dados de acordo com a tarefa, e pode usar Skills para tarefas específicas de análise de dados. Se a tarefa for complexa, uma parte do trabalho pode ser delegada a Subagent. O modelo é responsável por determinar a próxima operação a ser realizada, enquanto o Harness fornece e organiza as capacidades necessárias para realizar essas operações.
Além do design baseado em plugins, o DeepSeek Harness também oferece mecanismos de registro de sessão e execução. Informações como prompts do sistema, chamadas de ferramentas e seus resultados, agendamento de Subagent e injeção de contexto vistas pelo modelo podem ser registradas em logs de sessão e consultadas via Trajectory. Com base nesses registros, tarefas podem ser restauradas, bifurcadas, recuperadas e reproduzidas, auxiliando os desenvolvedores a observar e depurar o processo de execução do Agent.
Atualmente, o DeepSeek Harness ainda está em fase de Developer Preview, com seus plugins e APIs principais em iteração contínua. Portanto, é mais adequado considerá-lo como um caso representativo para entender o design baseado em plugins e a implementação técnica do Harness, em vez de tratar as interfaces atuais como padrões de desenvolvimento fixos.
Discussão
Entrar participar da discussão