మీ ల్యాప్టాప్లో మోడల్ రన్ అవుతోంది, మీరు పెద్ద మోడల్ ప్రయత్నించాలనుకుంటున్నారు, లేదా ఇమేజ్ జనరేట్ చేయాలనుకుంటున్నారు — కానీ మీ దగ్గర సరైన హార్డ్వేర్ ఉండకపోవచ్చు. మీరు కంప్యూటేషన్ను క్లౌడ్కు ఆఫ్లోడ్ చేసి సర్వర్ పని చేయనివ్వవచ్చు.
క్లౌడ్ సర్వర్లను అవసరం ప్రకారం కాన్ఫిగర్ చేయవచ్చు. ఇక్కడ మేము ModelScope Notebook ఉపయోగించడం కొనసాగిస్తాము — బ్రౌజర్లో నేరుగా CPU లేదా GPU రన్టైమ్ ఇన్స్టాన్స్ ఎంచుకోండి, మోడల్ డౌన్లోడ్ చేసి కోడ్ రన్ చేయండి. పేజీ మీ కంప్యూటర్లో రన్ అవుతుంది; మోడల్ కనెక్ట్ చేసిన క్లౌడ్ ఇన్స్టాన్స్లో రన్ అవుతుంది.
ఈ అధ్యాయంలో రెండు ప్రయోగాలు ఉన్నాయి. ముందుగా, CPU ఉపయోగించి 0.5B-స్థాయి మోడల్ రన్ చేసి సమీక్ష యొక్క సెంటిమెంట్ జడ్జ్ చేయండి. తర్వాత GPU ఉపయోగించి ఇమేజ్ జనరేషన్ మోడల్ రన్ చేసి టెక్స్ట్ వివరణలను చిత్రాలుగా మార్చండి. ప్రతి ఒక్కటి వేర్వేరు రిసోర్స్లు, వేర్వేరు టాస్క్లు మరియు వేర్వేరు మోడల్లతో ఉపయోగాన్ని ప్రదర్శిస్తుంది, కాబట్టి మీరు CPU vs GPU ను రన్టైమ్ ద్వారా నేరుగా పోల్చలేరు.
ఇతర క్లౌడ్ సర్వర్ రిసోర్స్లు తర్వాత జోడించబడతాయి.ModelScope మోడల్ పేజీ నుండి, "Notebook త్వరిత అభివృద్ధి"కి వెళ్ళండి, తర్వాత "రన్టైమ్ కనెక్ట్" పై క్లిక్ చేయండి. ముందుగా సెంటిమెంట్ విశ్లేషణ కోసం CPU ఇన్స్టాన్స్ ఎంచుకోండి, తర్వాత ఇమేజ్ జనరేషన్ కోసం GPU ఇన్స్టాన్స్కు మారండి. Notebook పేజీ ఆపరేషన్స్ కోసం "30 నిమిషాల్లో మీ మొదటి ఫలితం చూడండి" అధ్యాయం చూడండి.
ఇన్స్టాన్స్ మారిన తర్వాత, అసలు Python ప్రాసెస్ మరియు లోడ్ చేసిన మోడల్లు స్వయంచాలకంగా కొత్త ఇన్స్టాన్స్కు ట్రాన్స్ఫర్ అవ్వవు. మీరు ప్రస్తుత వాతావరణంలో డిపెండెన్సీలను మళ్ళీ చెక్ చేసి, ప్రయోగ కోడ్ను ప్రారంభం నుండి అమలు చేయాలి.
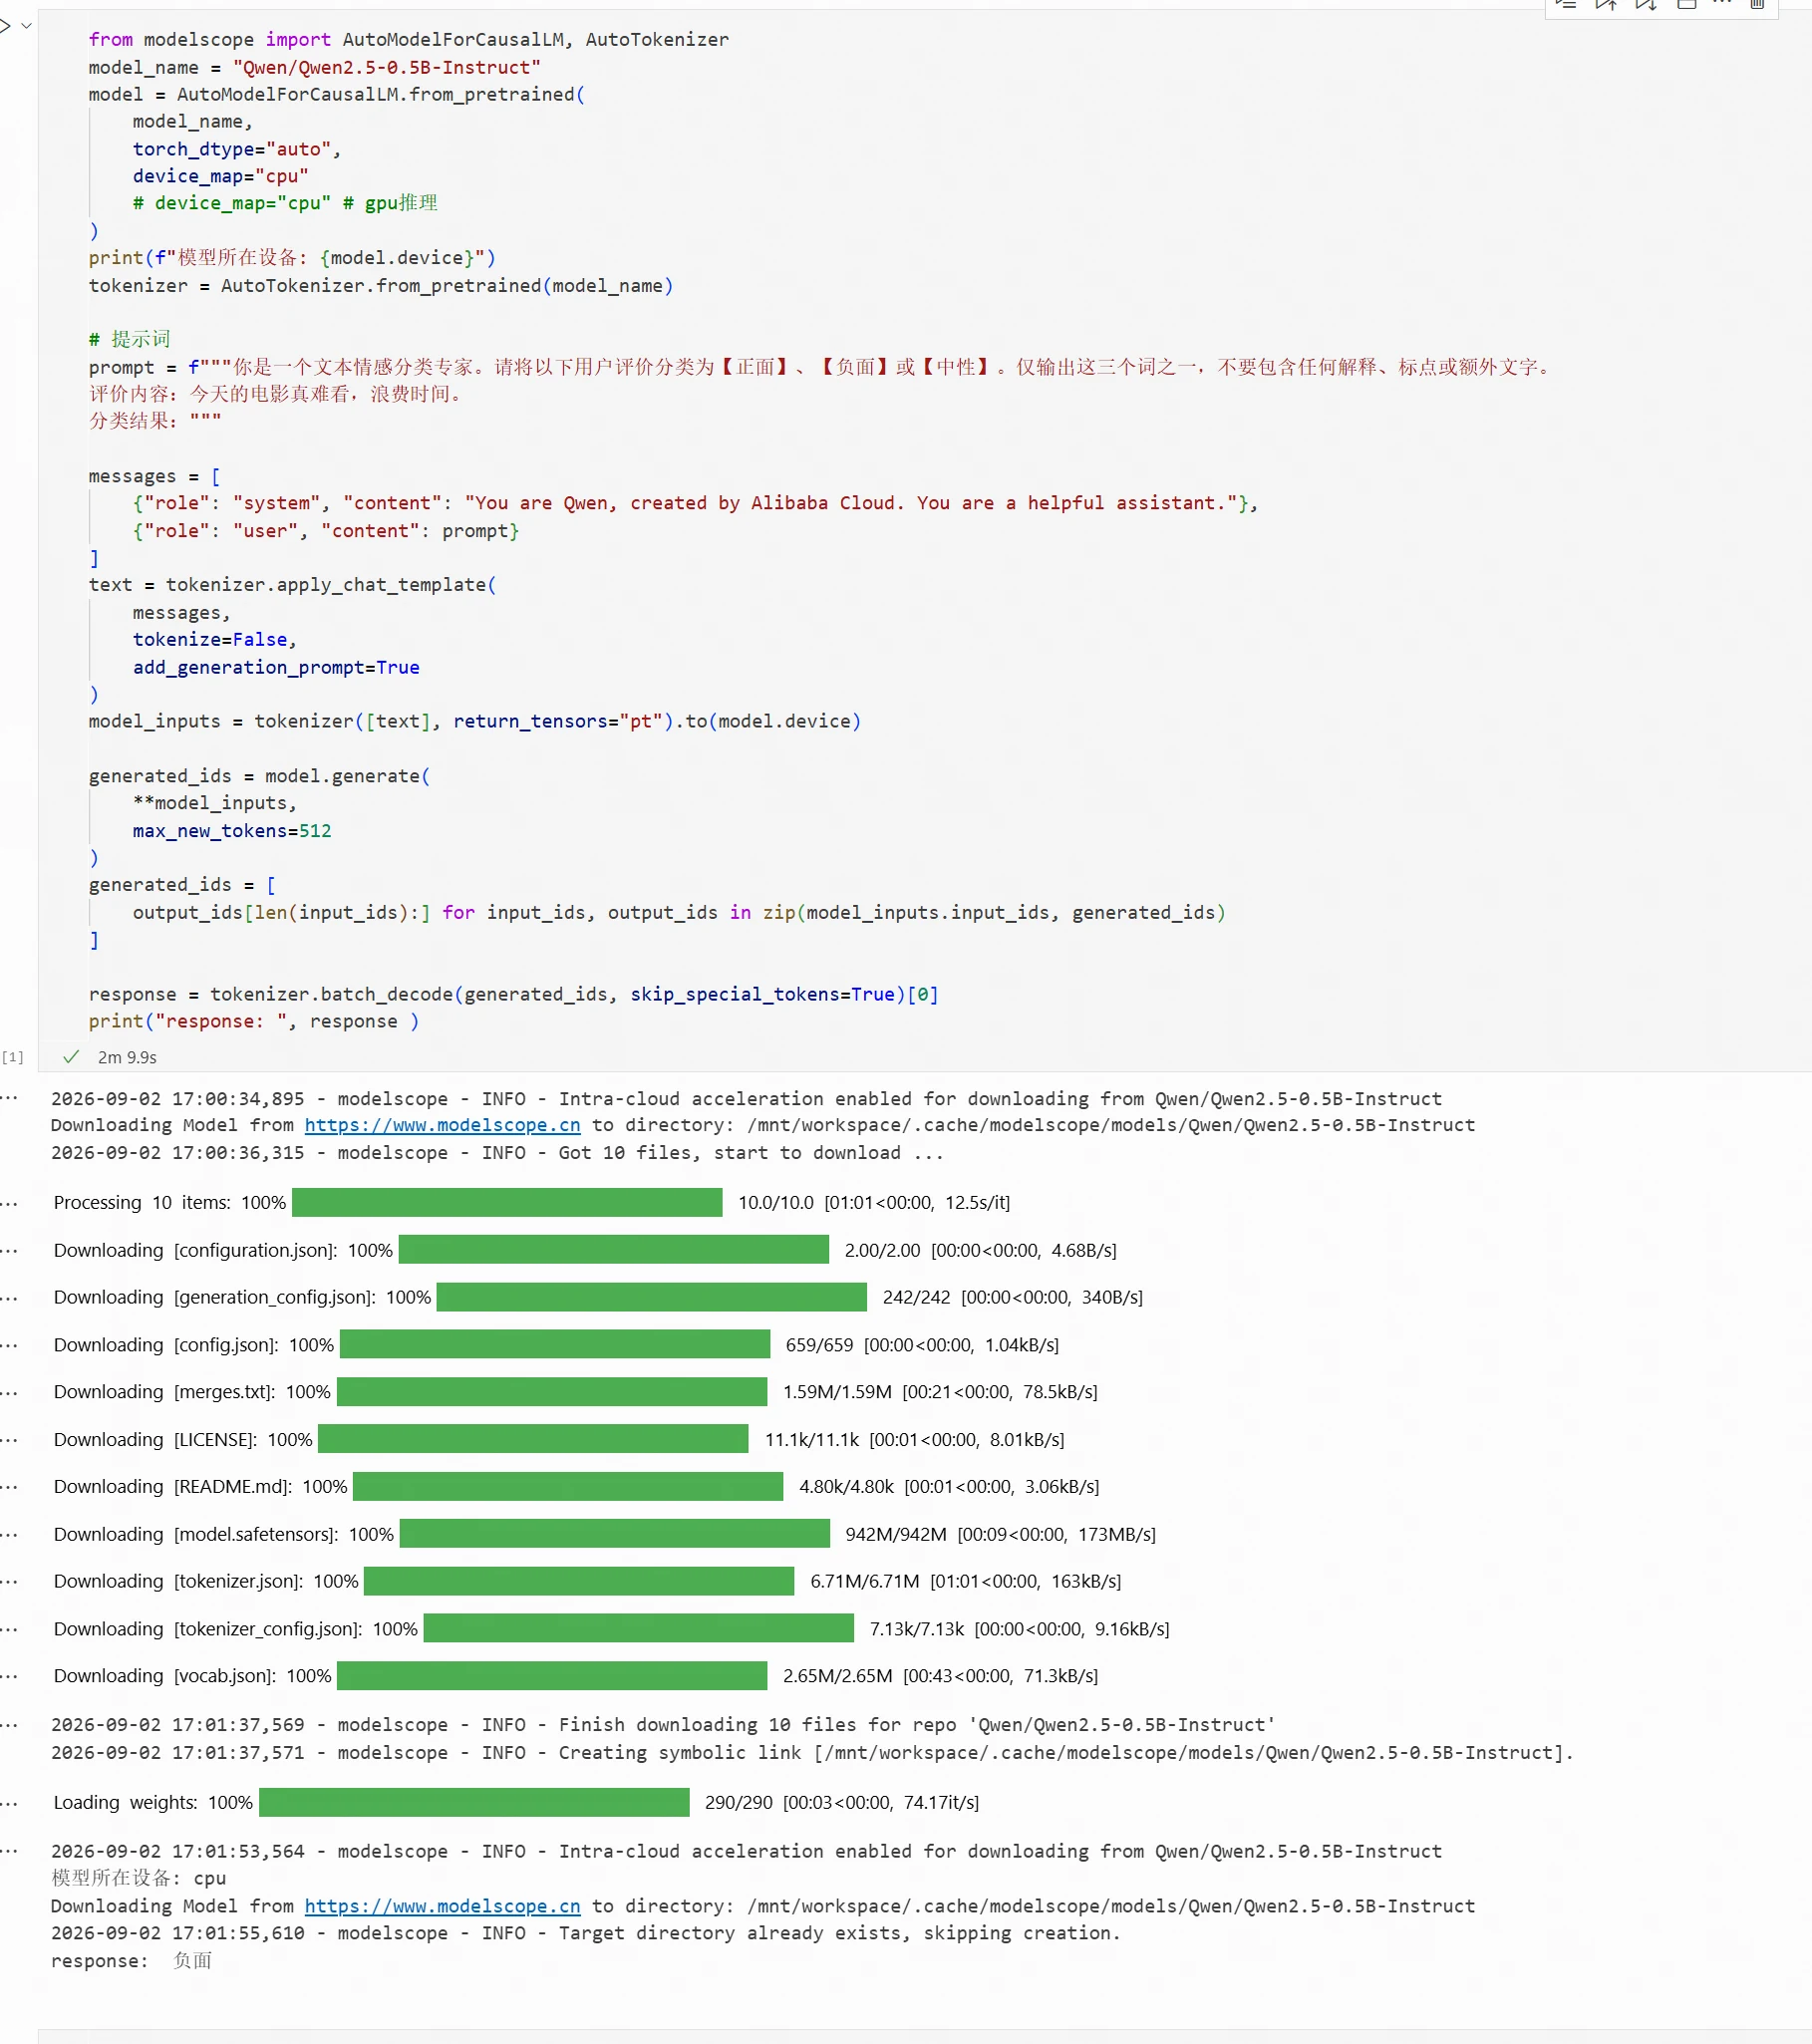
Qwen/Qwen2.5-0.5B-Instruct మోడల్ను ఉదాహరణగా ఉపయోగిస్తూ, CPU పై 0.5B-స్థాయి మోడల్ను సెంటిమెంట్ విశ్లేషణ పని కోసం ఎలా ఉపయోగించాలో మేము చూపిస్తాము.
CPU ఇన్స్టాన్స్ ప్రారంభించిన తర్వాత, Notebook డెవలప్మెంట్ ఎన్విరాన్మెంట్లోకి ప్రవేశించండి. మోడల్ లోడింగ్ మరియు ఇన్ఫరెన్స్ కోడ్:
from modelscope import AutoModelForCausalLM, AutoTokenizer
model_name = "Qwen/Qwen2.5-0.5B-Instruct"
model = AutoModelForCausalLM.from_pretrained(
model_name,
torch_dtype="auto",
device_map="cpu"
# device_map="cpu" # GPU ఇన్ఫరెన్స్
)
print(f"మోడల్ డివైస్: {model.device}")
tokenizer = AutoTokenizer.from_pretrained(model_name)
# ప్రామ్ప్ట్
prompt = f"""మీరు టెక్స్ట్ సెంటిమెంట్ క్లాసిఫికేషన్ నిపుణుడు. దయచేసి ఈ క్రింది వినియోగదారు సమీక్షను 【పాజిటివ్】, 【నెగటివ్】 లేదా 【న్యూట్రల్】 గా వర్గీకరించండి. ఈ మూడు పదాలలో ఒక్కటి మాత్రమే అవుట్పుట్ చేయండి, వివరణ, విరామ చిహ్నాలు లేదా అదనపు టెక్స్ట్ లేకుండా.
సమీక్ష:ఈ సినిమా చాలా చెడ్డది, సమయం వృథా.
క్లాసిఫికేషన్ ఫలితం:"""
messages = [
{"role": "system", "content": "You are Qwen, created by Alibaba Cloud. You are a helpful assistant."},
{"role": "user", "content": prompt}
]
text = tokenizer.apply_chat_template(
messages,
tokenize=False,
add_generation_prompt=True
)
model_inputs = tokenizer([text], return_tensors="pt").to(model.device)
generated_ids = model.generate(
**model_inputs,
max_new_tokens=512
)
generated_ids = [
output_ids[len(input_ids):] for input_ids, output_ids in zip(model_inputs.input_ids, generated_ids)
]
response = tokenizer.batch_decode(generated_ids, skip_special_tokens=True)[0]
print("response: ", response )
సైన్ ఇన్ చర్చలో చేరండి
ఫలితం:
Tongyi-MAI/Z-Image-Turbo మోడల్ ఉపయోగిస్తూ, GPU పై మోడల్ ఎలా లోడ్ చేసి ఇమేజ్ జనరేషన్ పని ఎలా పూర్తి చేయాలో మేము చూపిస్తాము.
GPU ఇన్స్టాన్స్ ప్రారంభించిన తర్వాత, Notebook డెవలప్మెంట్ ఎన్విరాన్మెంట్లోకి ప్రవేశించండి.
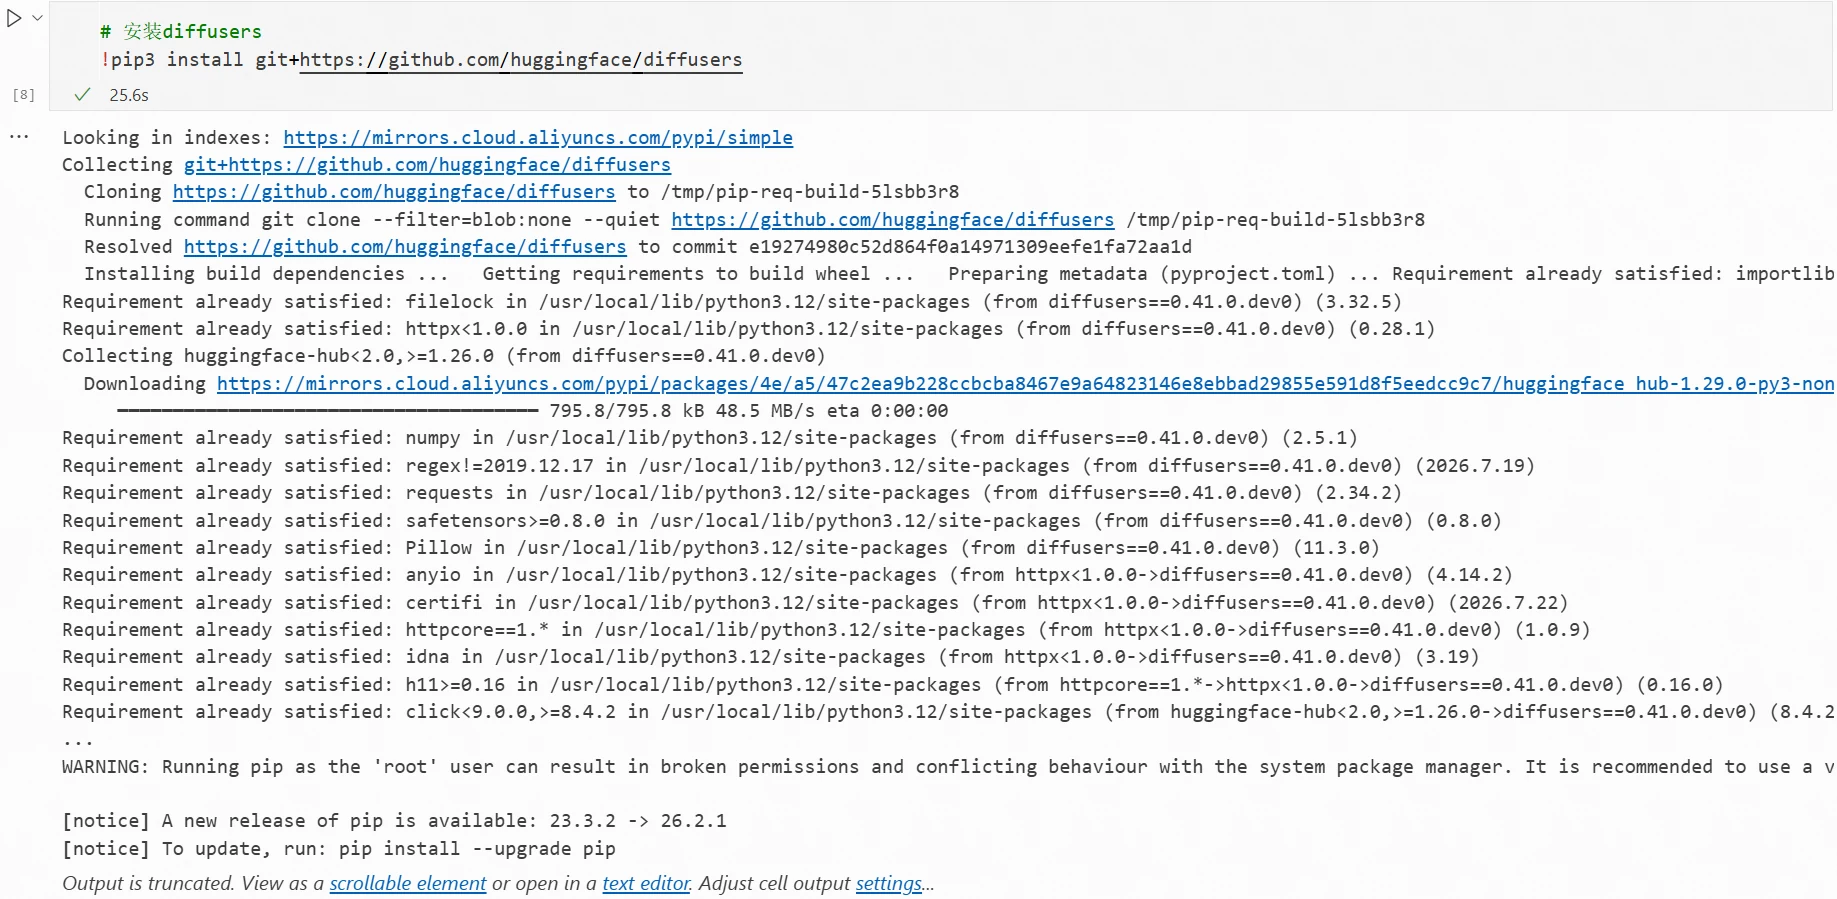
మోడల్ కార్డ్ ప్రకారం, టెర్మినల్లో diffusers యొక్క తాజా వెర్షన్ను ఇన్స్టాల్ చేయండి:
!pip3 install git+https://github.com/huggingface/diffusers
ఇన్స్టాలేషన్ పూర్తయింది:
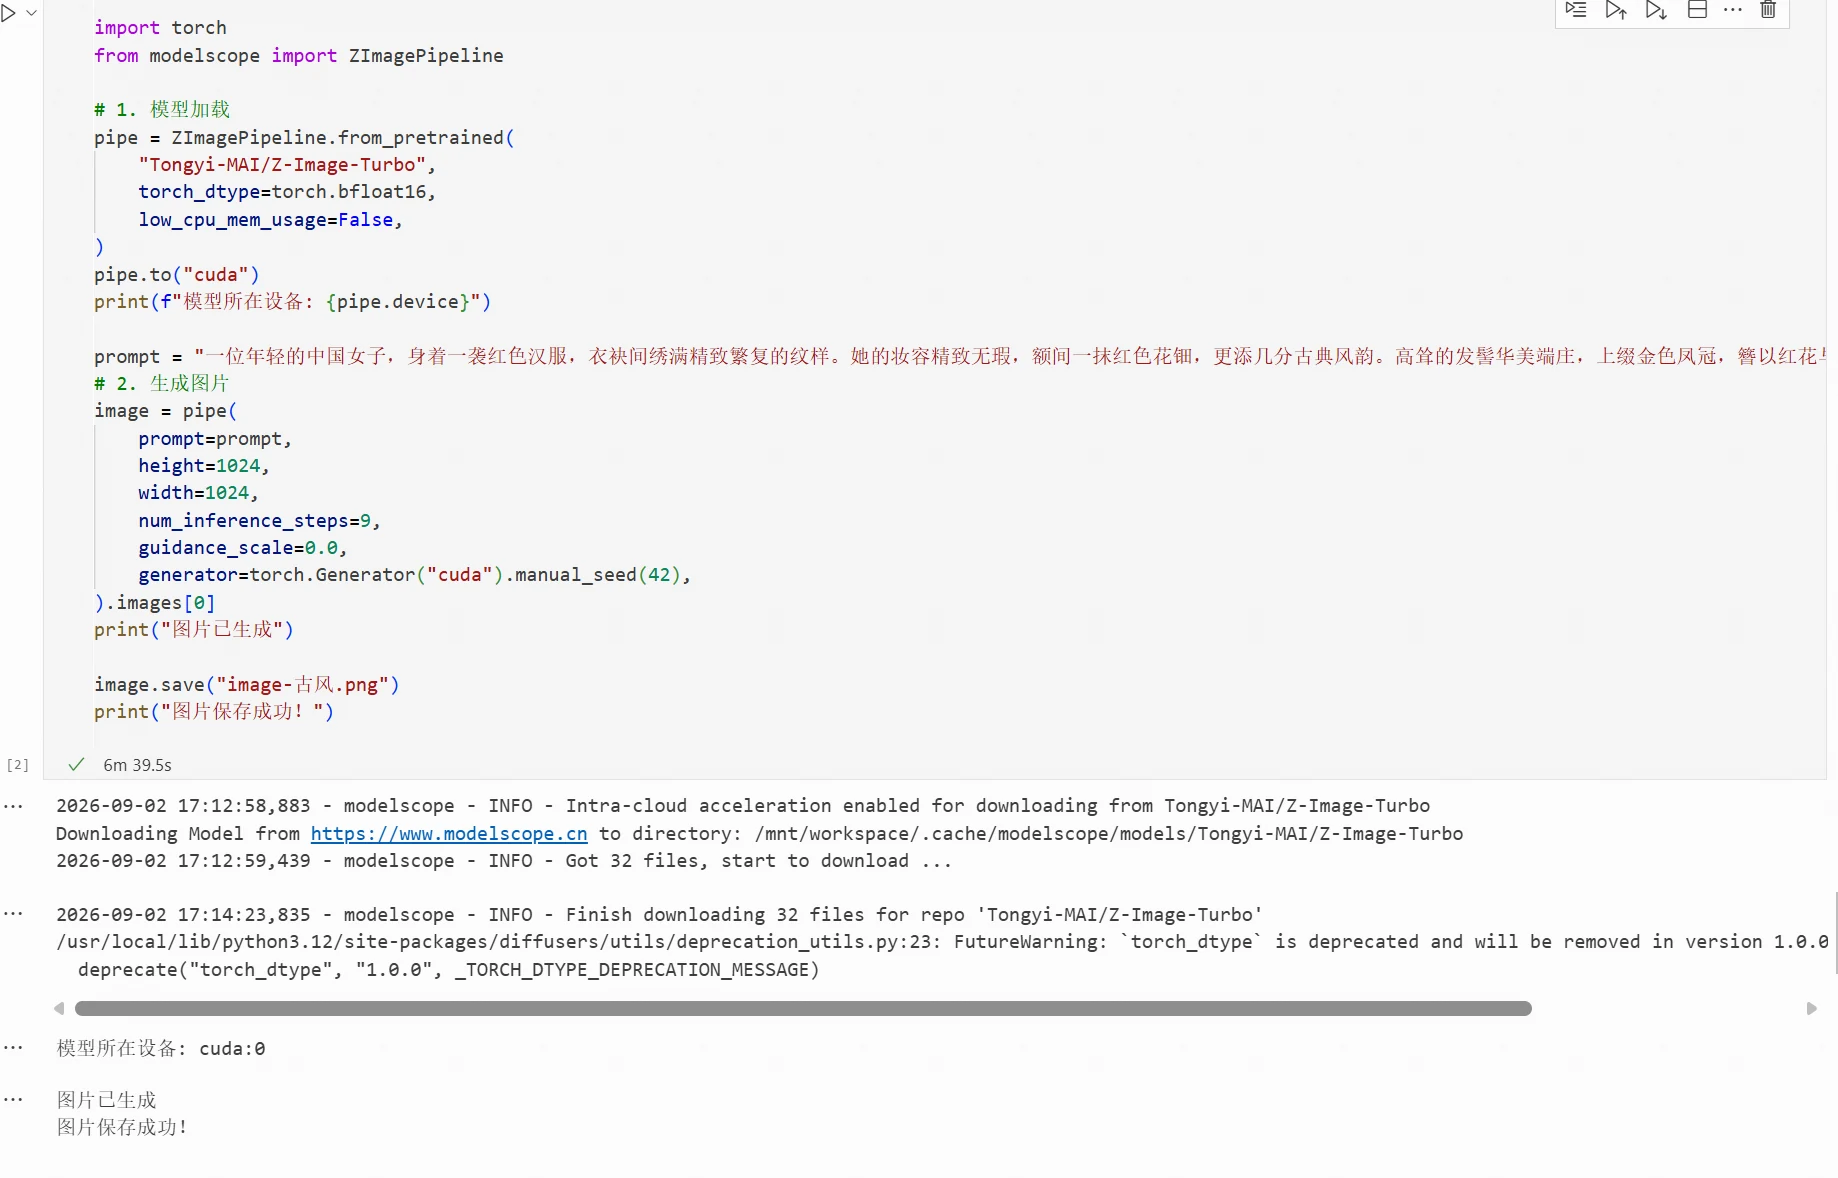
మోడల్ లోడింగ్ మరియు ఇన్ఫరెన్స్ కోడ్:
import torch
from modelscope import ZImagePipeline

# 1. మోడల్ లోడింగ్
pipe = ZImagePipeline.from_pretrained(
    "Tongyi-MAI/Z-Image-Turbo",
    torch_dtype=torch.bfloat16,
    low_cpu_mem_usage=False,
)
pipe.to("cuda")
print(f"మోడల్ డివైస్: {pipe.device}")

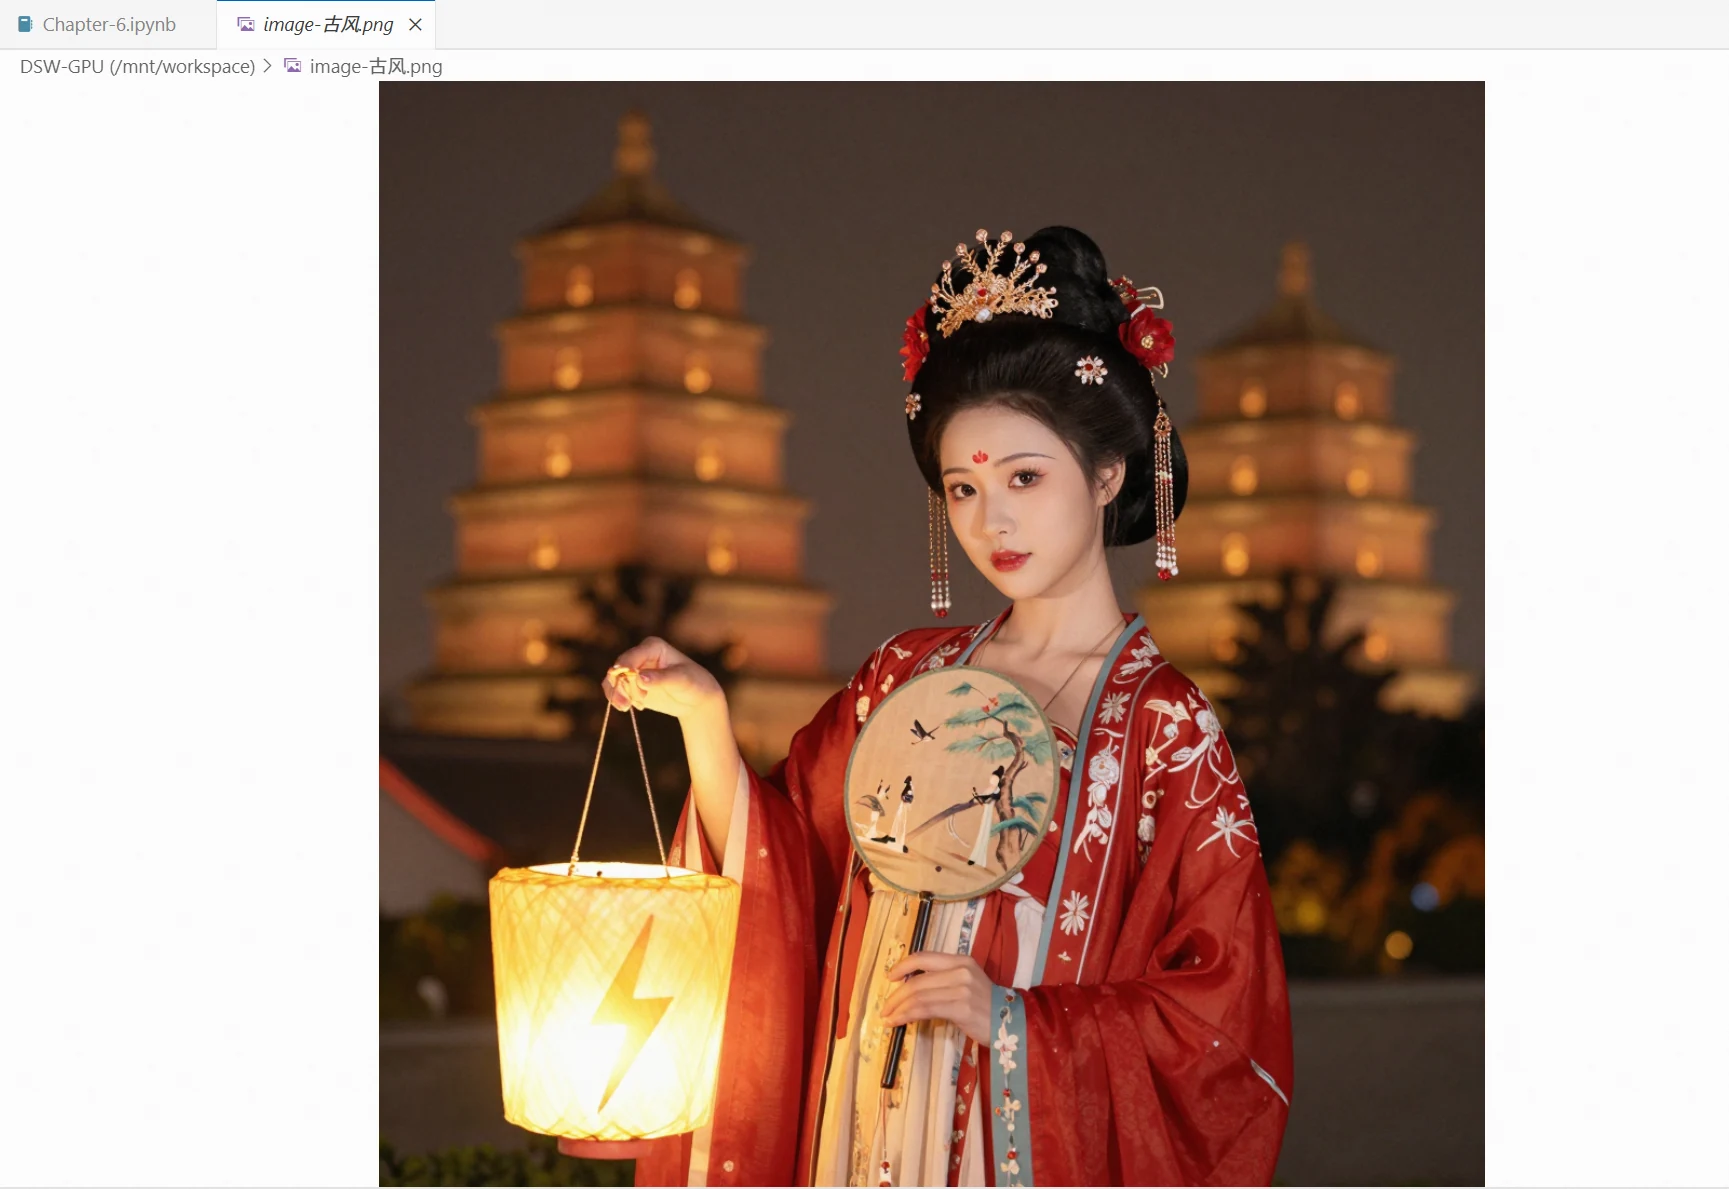
prompt = "A young Chinese woman dressed in a red hanfu, its sleeves and hem embroidered with intricate, elaborate patterns. Her makeup is flawless, with a red huadian mark on her forehead adding a touch of classical elegance. Her towering hairstyle is majestic and dignified, topped with a golden phoenix crown and adorned with red flowers and pearl strings that sway gracefully. She holds a round folding fan painted with a lady, an ancient tree, and birds in a tranquil mood. A neon lightning-shaped lamp hangs above her outstretched left palm, casting a bright warm-yellow glow. The night is gentle, the lantern light hazy; in the distance, the layered tiers of Xi'an's Giant Wild Goose Pagoda emerge faintly from a soft halo, with dappled bokeh in the background, dreamlike and ethereal."
# 2. ఇమేజ్ జనరేట్ చేయండి
image = pipe(
    prompt=prompt,
    height=1024,
    width=1024,
    num_inference_steps=9,
    guidance_scale=0.0,
    generator=torch.Generator("cuda").manual_seed(42),
).images[0]
print("ఇమేజ్ జనరేట్ అయింది")

image.save("image-vintage.png")
print("ఇమేజ్ విజయవంతంగా సేవ్ చేయబడింది!")
ఫలితం:
జనరేట్ చేసిన ఇమేజ్:
ఈ అధ్యాయంలో కోడ్ మరియు సంబంధిత ఫైల్లు: https://www.modelscope.cn/gallery/liucong/4a8eb492-54dc-4062-82c0-65b17fd94d5f