జనరల్ మోడల్ నిర్దిష్ట వ్యాపార అవసరాలను నేరుగా తృప్తి పరచలేనప్పుడు, మోడల్ను మీ వ్యాపార డేటాతో ఫైన్-ట్యూన్ చేయవచ్చు.
ఇ-కామర్స్ ఎంటిటీ గుర్తింపు పని ఉదాహరణగా, మేము మోడల్ నుండి ఉత్పత్తి పేరు, బ్రాండ్ పేరు, మోడల్ నంబర్ కనుగొని, సంబంధిత వర్గం మరియు స్థానాన్ని అందించాలి.
పని మరియు అవుట్పుట్ అవసరాలు ఇప్పటికే స్పష్టంగా ఉంటే, ఈ డేటాతో ఫైన్-ట్యూనింగ్ ప్రయత్నించవచ్చు.
ms-swift తో ఒక LoRA ఫైన్-ట్యూనింగ్ నుండి ప్రారంభిద్దాం, డేటా సిద్ధాంతం, శిక్షణ, బరువు విలీనం మరియు ఇన్ఫెరెన్స్ వరుసగా నడుపుదాం.
జనరల్ పెద్ద మోడల్స్ ఇప్పటికే బలమైన భాషా అవగాహన, జ్ఞాన ప్రశ్నోత్తరాలు, వచన రూపకల్పన వంటి సాధారణ సామర్థ్యాలను కలిగి ఉన్నాయి.
ఉదాహరణకు, మేము మోడల్ నిర్దిష్ట సమాచార సంగ్రహణ పనిని ఖచ్చితంగా పూర్తి చేయగలదని, నిర్ణీత ఫార్మాట్లో ఫలితాలను అవుట్పుట్ చేయగలదని కోరుకుంటాము.
ఫైన్-ట్యూనింగ్ అంటే మోడల్ను మళ్లీ శిక్షణ ఇవ్వడం కాదు, మోడల్ యొక్క ఇప్పటికే ఉన్న సామర్థ్యం ఆధారంగా మరింత సవరించడం.
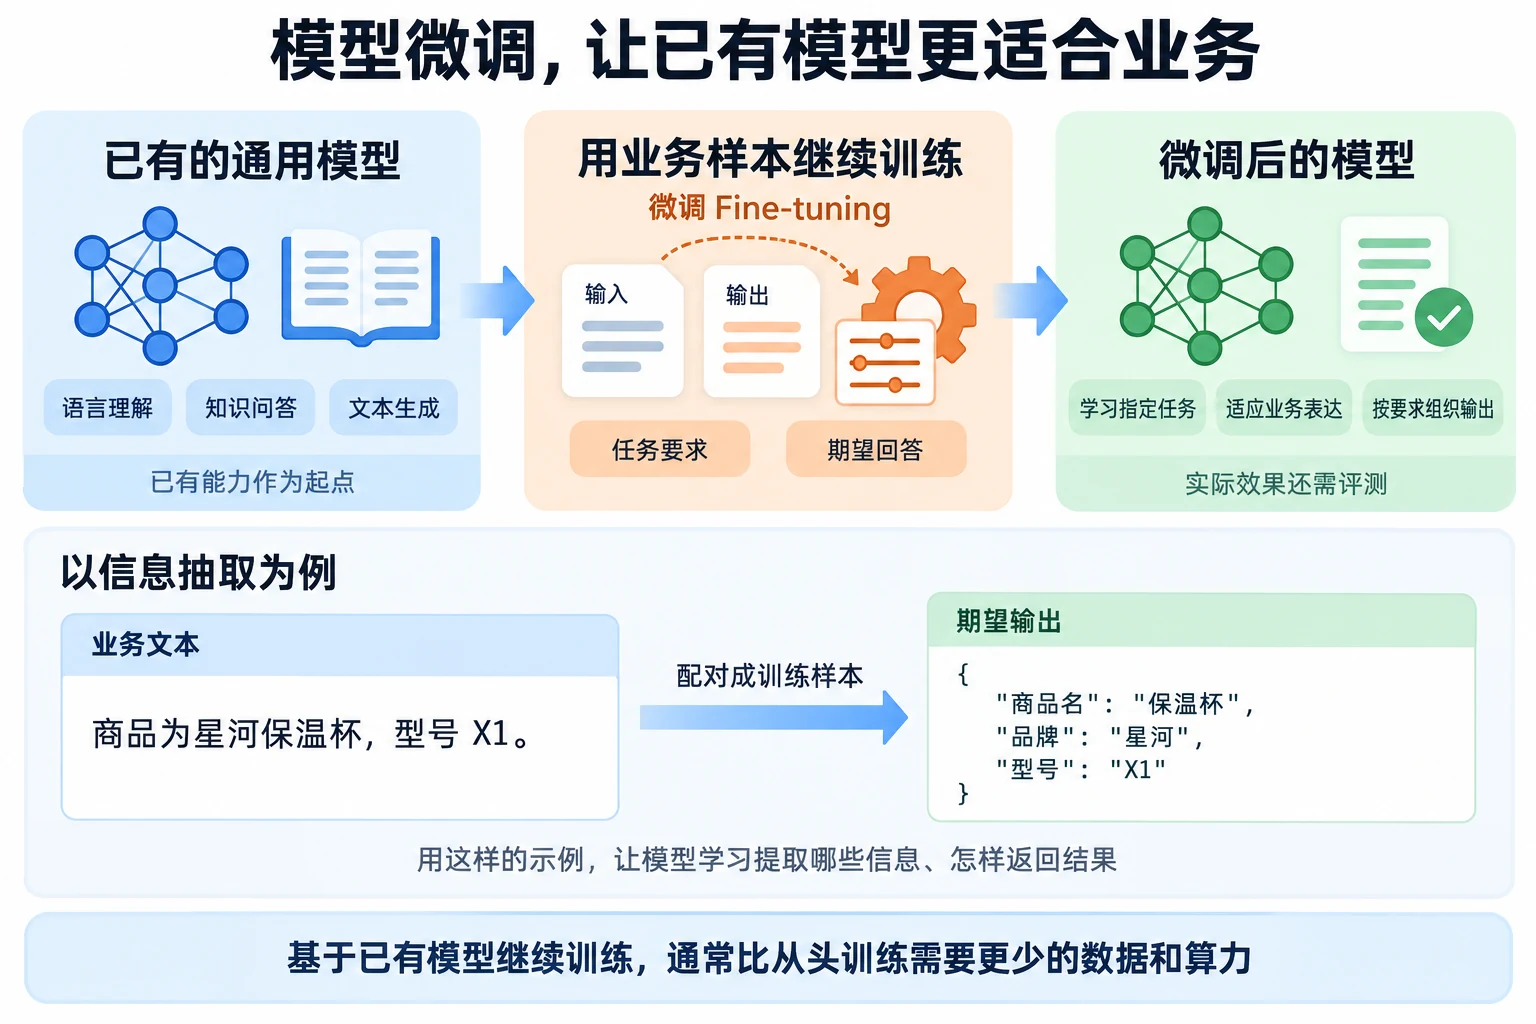
ప్రస్తుతం, పెద్ద మోడల్ ఫైన్-ట్యూనింగ్లో అత్యంత సాధారణ పద్ధతి SFT (Supervised Fine-Tuning).
SFT తో పాటు, పెద్ద మోడల్ శిక్షణ రీన్ఫోర్స్మెంట్ లెర్నింగ్ (RL) ను కూడా ఉపయోగించవచ్చు.
శిక్షణ పద్ధతి మరియు హార్డ్వేర్ వనరుల ఆధారంగా, LoRA, QLoRA లేదా ఫుల్ పారామితుల ఫైన్-ట్యూనింగ్ వంటి పద్ధతులను ఎంచుకోవచ్చు.
1, ఫుల్ పారామితుల ఫైన్-ట్యూనింగ్, శిక్షణ ప్రక్రియలో మోడల్ యొక్క అన్ని పారామితులు నవీకరణలో పాల్గొంటాయి.
2, LoRA ఫైన్-ట్యూనింగ్ (Low-Rank Adaptation), పెద్ద మోడల్ ఫైన్-ట్యూనింగ్ హార్డ్వేర్ వనరుల అవసరాలను తగ్గించడానికి.
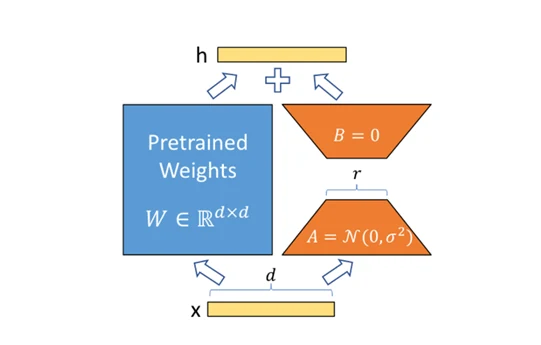
వివరంగా చూస్తే, ప్రీ-ట్రైన్డ్ మేట్రిక్స్ W_0 యొక్క నవీకరణ ఈ విధంగా వ్యక్తీకరించవచ్చు:
W = W_0 + \Delta W = W_0 + BA
ఇక్కడ, ΔW ఫైన్-ట్యూనింగ్ ప్రక్రియలో నేర్చుకోవాల్సిన బరువు మార్పును సూచిస్తుంది,
B \in \mathbb{R}^{d \times r}, \quad
A \in \mathbb{R}^{r \times k}, \quad
r \ll \min(d,k)
A మరియు B LoRA కొత్తగా జోడించి శిక్షణలో పాల్గొనే పారామితులు.
3, QLoRA ఫైన్-ట్యూనింగ్ (Quantized LoRA), LoRA ప్రధానంగా శిక్షణ పారామితుల వనరుల ఖర్చును తగ్గిస్తుంది.
సంబంధిత మోడల్ ఆర్కిటెక్చర్ చిత్రంలో చూపబడింది, QLoRA అనేది LoRA యొక్క మెరుగుదల.
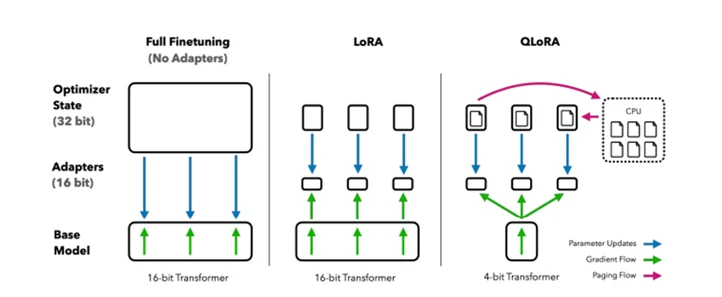
QLoRA ను సాధారణంగా క్వాంటైజేషన్ మరియు LoRA సంయోజనంగా అర్థం చేసుకోవచ్చు.
4bit NormalFloat (NF4), NF4 అనేది సాధారణ పంపిణీ బరువుల కోసం సమాచార సిద్ధాంతపరంగా అత్యుత్తమ ఎంపిక.
డ్యూయల్ క్వాంటైజేషన్ టెక్నాలజీ, సగటు మెమరీ వినియోగాన్ని తగ్గిస్తుంది.
సైన్ ఇన్ చర్చలో చేరండి
పేజ్డ్ ఆప్టిమైజర్, మెమరీ పీక్ నిర్వహించడంలో సహాయపడుతుంది.
ఏ ఫైన్-ట్యూనింగ్ పద్ధతిని ఎంచుకోవాలో, మోడల్ పరిమాణం, పని అవసరాలు, GPU వనరులు మరియు శిక్షణ ఖర్చును సమగ్రంగా పరిగణించాలి.
ప్రాథమిక మోడల్ పరిమాణం పెద్దదిగా ఉంటే, LoRA ఉపయోగించినప్పటికీ, తగినంత విద్యుత్ మెమరీ ఉండకపోతే, QLoRA ను పరిగణించవచ్చు.
GPU వనరులు సమృద్ధిగా ఉంటే, మరియు పనికి మోడల్ను మరింత సంపూర్ణంగా సవరించాల్సిన అవసరం ఉంటే, ఫుల్ పారామితుల ఫైన్-ట్యూనింగ్ పరిగణించవచ్చు.
వాస్తవ ప్రాజెక్టుల్లో, మేము తక్కువ ఖర్చుతో మొదట ఫలితాన్ని ధృవీకరించవచ్చు.
ms-swift (SWIFT, Scalable lightWeight Infrastructure for Fine-Tuning) అనేది ModelScope కమ్యూనిటీ ఓపెన్-సోర్స్ పెద్ద మోడల్ శిక్షణ మరియు మోహరింపు ఫ్రేమ్వర్క్.

ప్రస్తుతం Qwen, DeepSeek, Llama, GLM, InternLM వంటి ప్రధాన భాషా మోడల్స్ మరియు Qwen-VL, InternVL వంటి మల్టీమోడల్ మోడల్స్ను మద్దతు ఇస్తుంది.
మరిన్ని వినియోగ పద్ధతుల కోసం ms-swift ను చూడవచ్చు.
శిక్షణతో పాటు, ms-swift మోడల్ వినియోగ ప్రక్రియను కూడా అందిస్తుంది.
ప్రారంభకులకు, ms-swift యొక్క ఒక ప్రత్యేకత ఏమిటంటే పెద్ద మోడల్ శిక్షణ ప్రక్రియలోని సంక్లిష్టమైన కాన్ఫిగరేషన్లను ఏకీకృతం చేయడం.
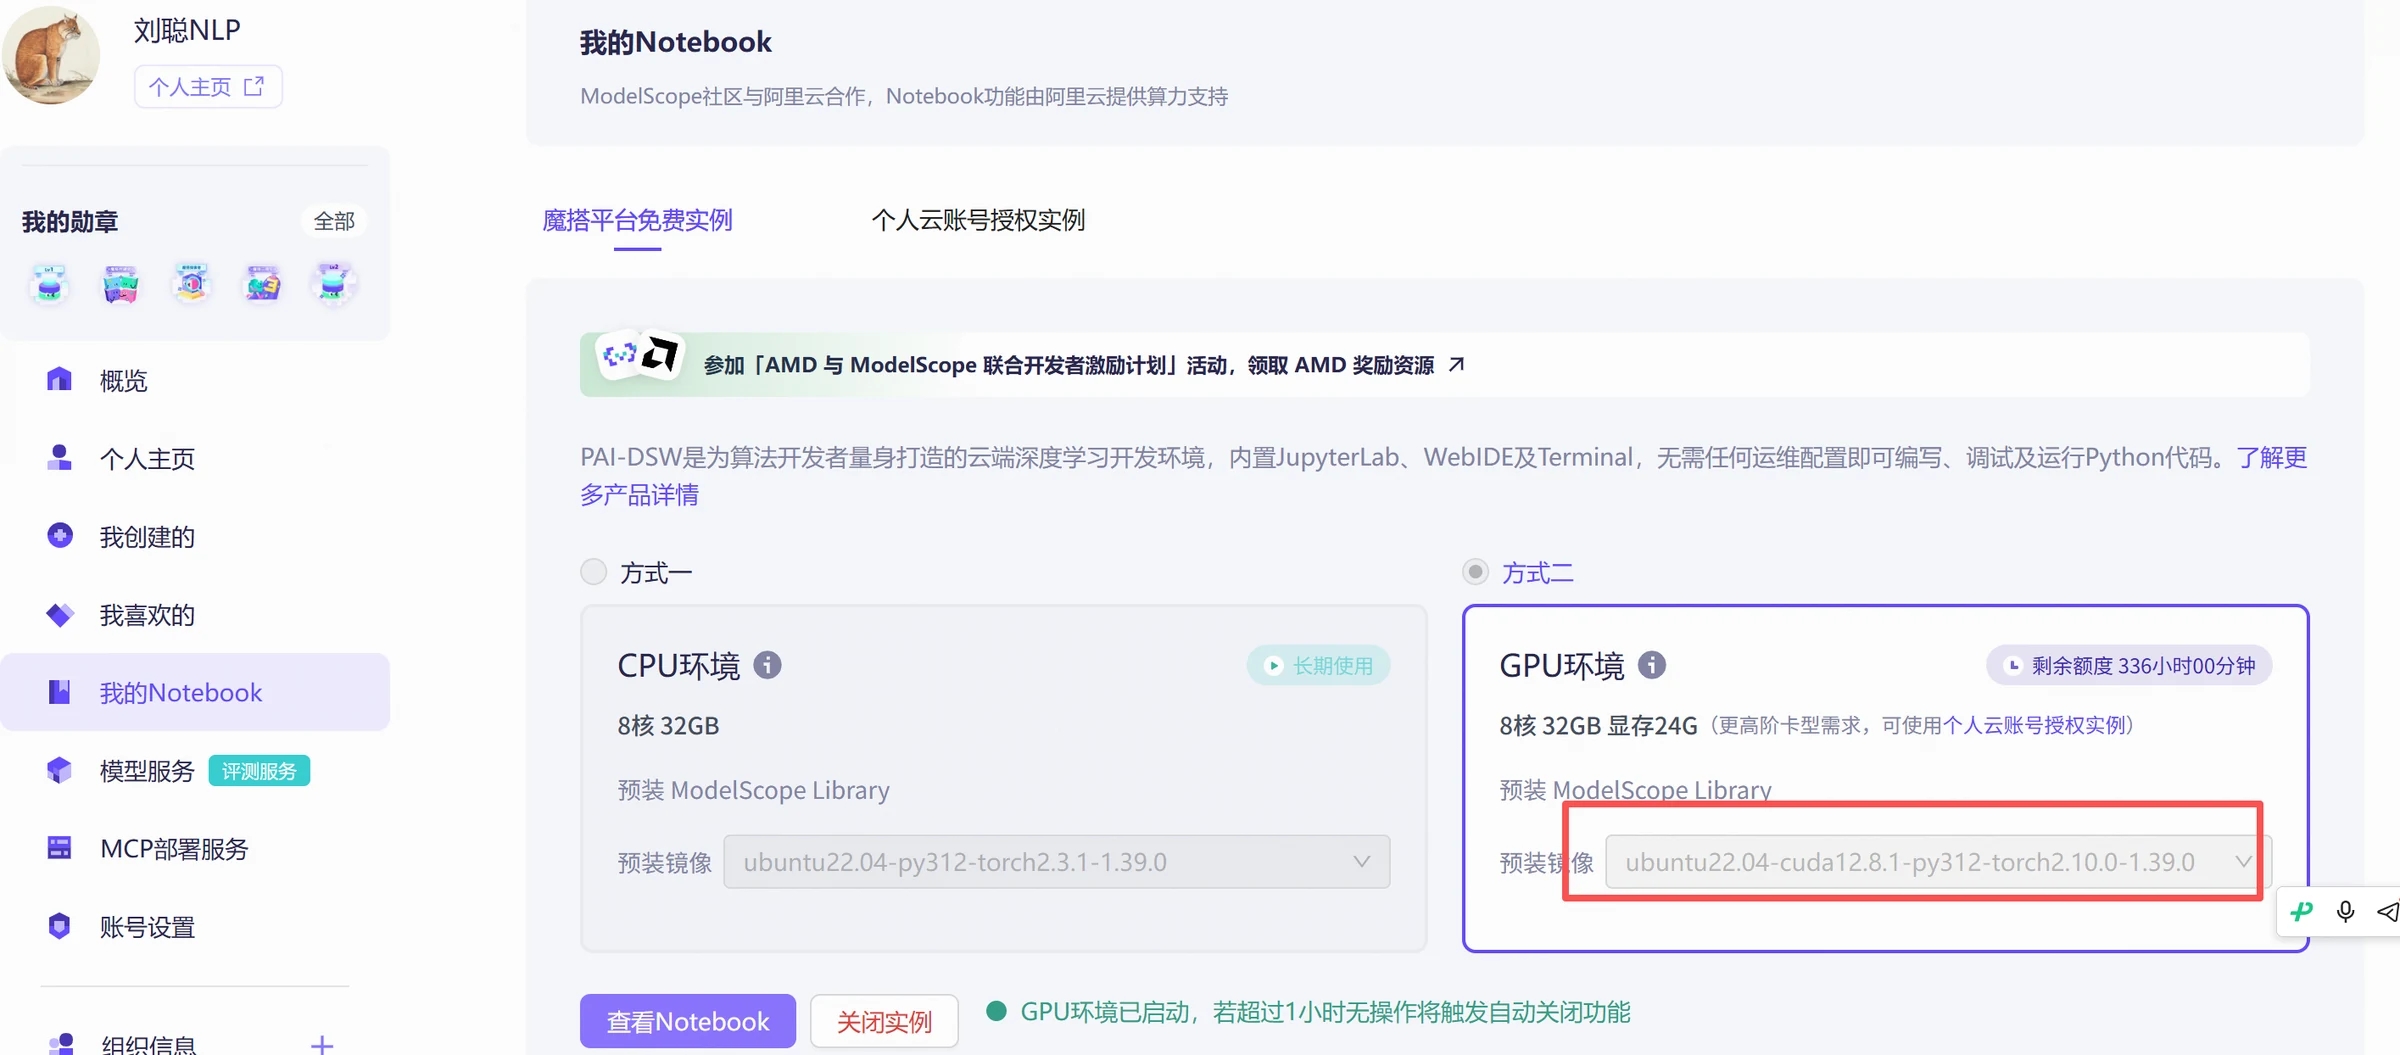
ఎంటిటీ గుర్తింపు పని ఉదాహరణగా, ModelScope Notebook వాతావరణంలో పూర్తి మోడల్ ఫైన్-ట్యూనింగ్ ప్రక్రియను ప్రదర్శిస్తుంది.

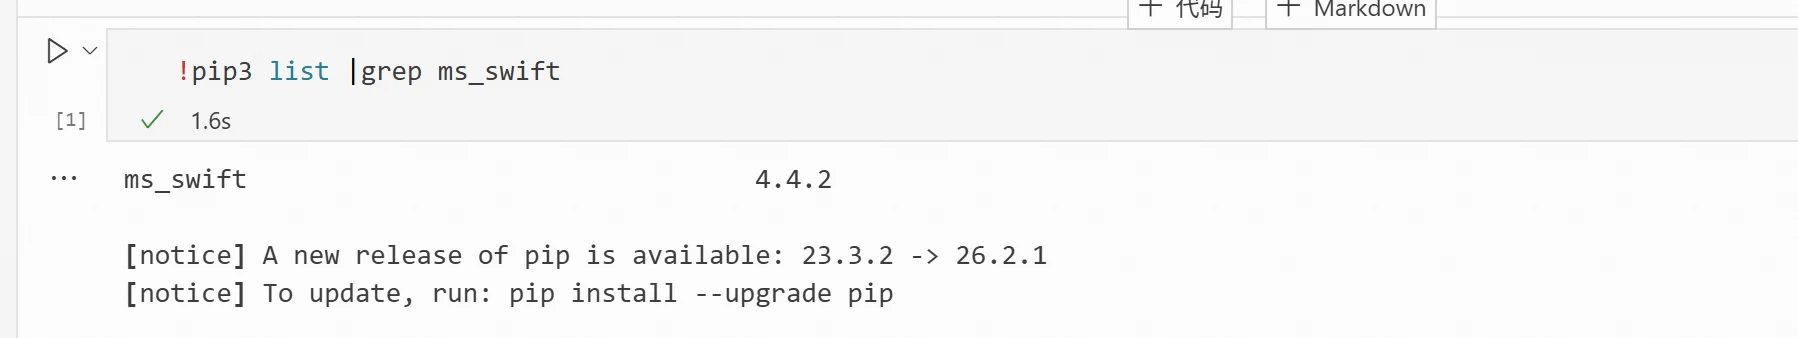
!pip3 list |grep ms_swift
ఈ రూపంలో చూపిస్తే, ms-swift ఇన్స్టాల్ చేయబడిందని అర్థం.

ఇన్స్టాల్ చేయకపోతే, ఈ క్రింది ఆదేశాన్ని అమలు చేయండి.
!pip3 install ms-swift
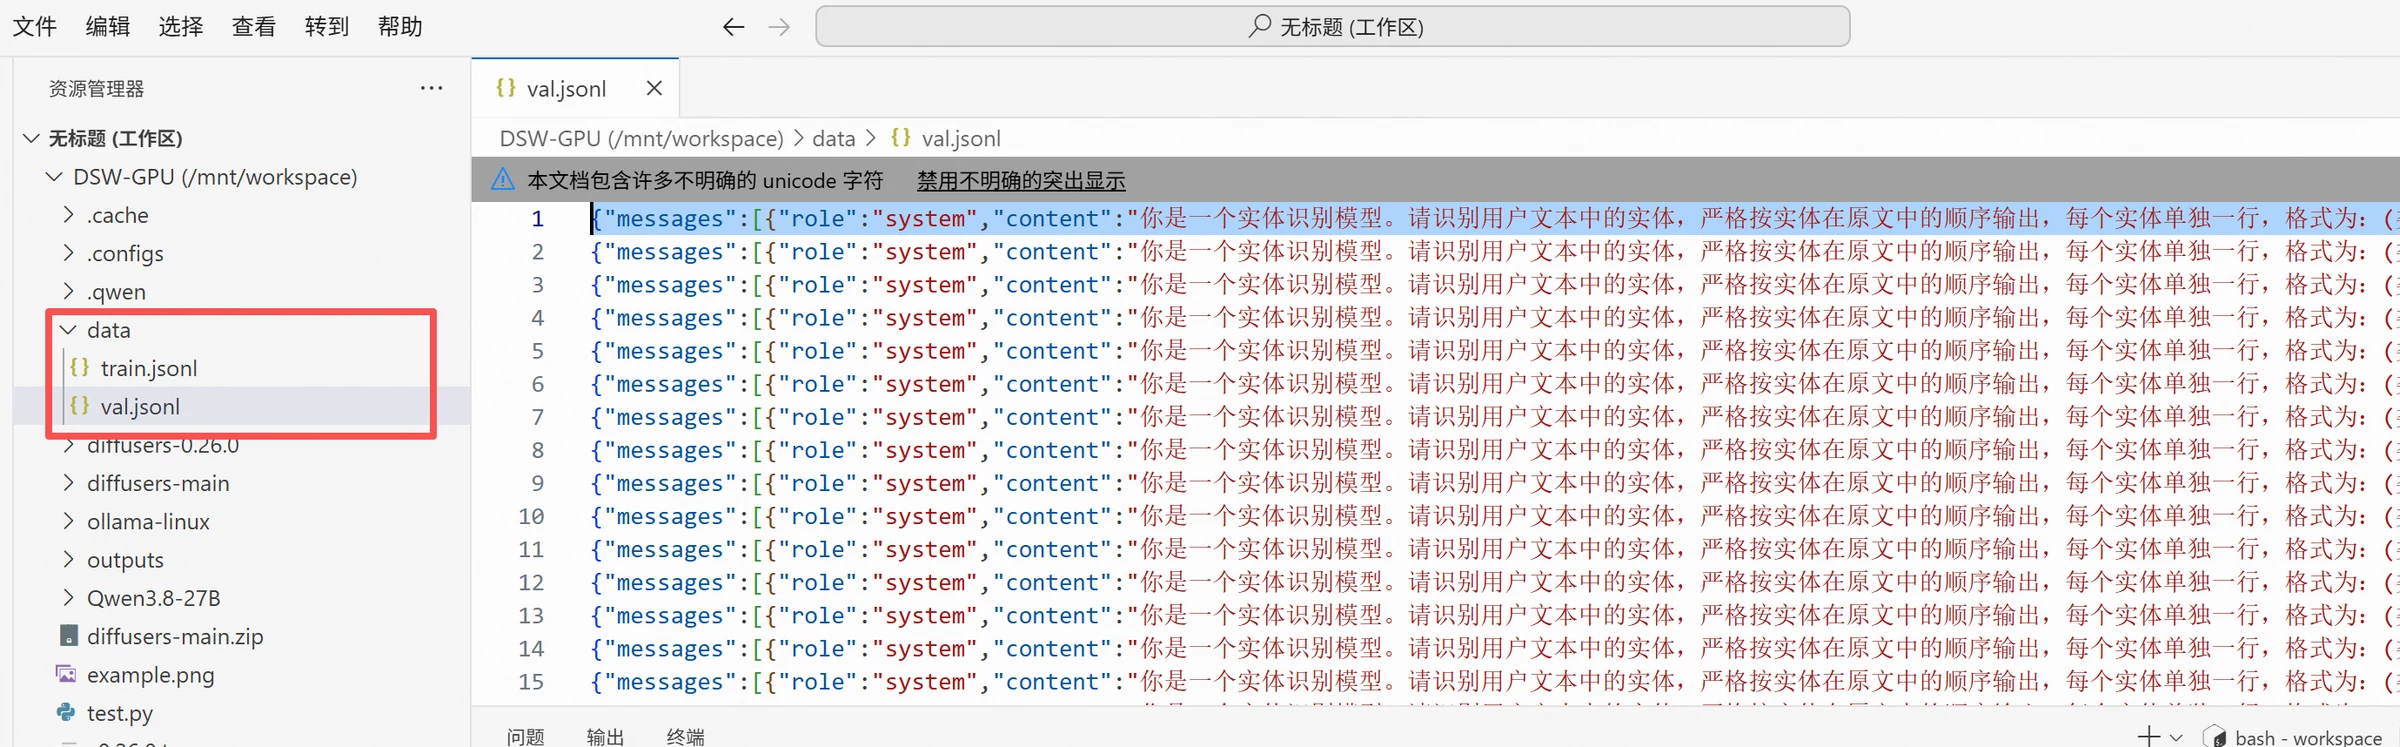
డేటా సిద్ధాంతం, ఈ ప్రయోగం ఓపెన్-సోర్స్ డేటాను ఉపయోగిస్తుంది, ఇ-కామర్స్ ఎంటిటీ గుర్తింపు.
ముందుగా data అనే డైరెక్టరీని సృష్టించి, డేటాను అప్లోడ్ చేయండి.
{"messages":[{"role":"system","content":"మీరు ఒక ఎంటిటీ గుర్తింపు మోడల్. వినియోగదారు టెక్స్ట్లోని ఎంటిటీలను గుర్తించండి. ఎంటిటీలను అసలు టెక్స్ట్లో వాటి క్రమంలో ఖచ్చితంగా అవుట్పుట్ చేయండి, ప్రతి ఎంటిటీని వేరు వేరు లైన్లో, ఈ ఫార్మాట్లో: (రకం,ఎంటిటీ టెక్స్ట్,ప్రారంభ స్థానం). ప్రారంభ స్థానం 0 నుండి మొదలవుతుంది; రకం HCCX, HPPX, MISC, XH లలో ఒకటే కావచ్చు. ఎంటిటీలు లేకపోతే ఇది మాత్రమే అవుట్పుట్ చేయండి: ఎంటిటీలు లేవు. వివరణలు, Markdown లేదా ఇతర కంటెంట్ అవుట్పుట్ చేయవద్దు."},{"role":"user","content":"push bb skincare guasha l back therapy olive oil full body back open foot body oil m oil 5 massage oil massage essence 00"},{"role":"assistant","content":"(HCCX,olive oil,10)\n(HCCX,massage oil,20)\n(HCCX,oil,24)\n(HCCX,oil,27)"}]}
డైరెక్టరీ ఫార్మాట్ ఈ క్రింది విధంగా ఉంటుంది:

!CUDA_VISIBLE_DEVICES=0 swift sft \
--model Qwen/Qwen3-0.6B \
--dataset data/train.jsonl \
--val_dataset data/val.jsonl \
--tuner_type lora \
--target_modules all-linear \
--lora_rank 16 \
--lora_alpha 32 \
--lora_dropout 0.05 \
--torch_dtype bfloat16 \
--num_train_epochs 2 \
--per_device_train_batch_size 4 \
--per_device_eval_batch_size 4 \
--gradient_accumulation_steps 4 \
--learning_rate 1e-4 \
--warmup_ratio 0.05 \
--max_length 512 \
--eval_strategy steps \
--eval_steps 100 \
--save_strategy steps \
--save_steps 100 \
--save_total_limit 3 \
--logging_steps 10 \
--load_from_cache_file true \
--dataset_num_proc 4 \
--dataloader_num_workers 4 \
--output_dir output/qwen3_0_6b_ner_lora
ప్రధాన పారామితుల వివరణ:
| Parameter | Description |
| --model Qwen/Qwen3-0.6B | Use Qwen3-0.6B base model |
| --tuner_type lora | Use LoRA fine-tuning |
| --target_modules all-linear | Add LoRA to all linear layers |
| --lora_rank 16 | LoRA capacity |
| --lora_alpha 32 | LoRA scaling factor |
| --num_train_epochs 2 | Training epochs |
| --per_device_train_batch_size 4 | 4 samples per step per GPU |
| --gradient_accumulation_steps 4 | Accumulate 4 steps before update |
| --learning_rate 1e-4 | LoRA learning rate |
| --max_length 512 | Maximum length per sample |
| --eval_steps 100 | Validate every 100 steps |
| --save_steps 100 | Save every 100 steps |
| --save_total_limit 3 | Keep at most 3 checkpoints |
| --output_dir | Model and log save path |
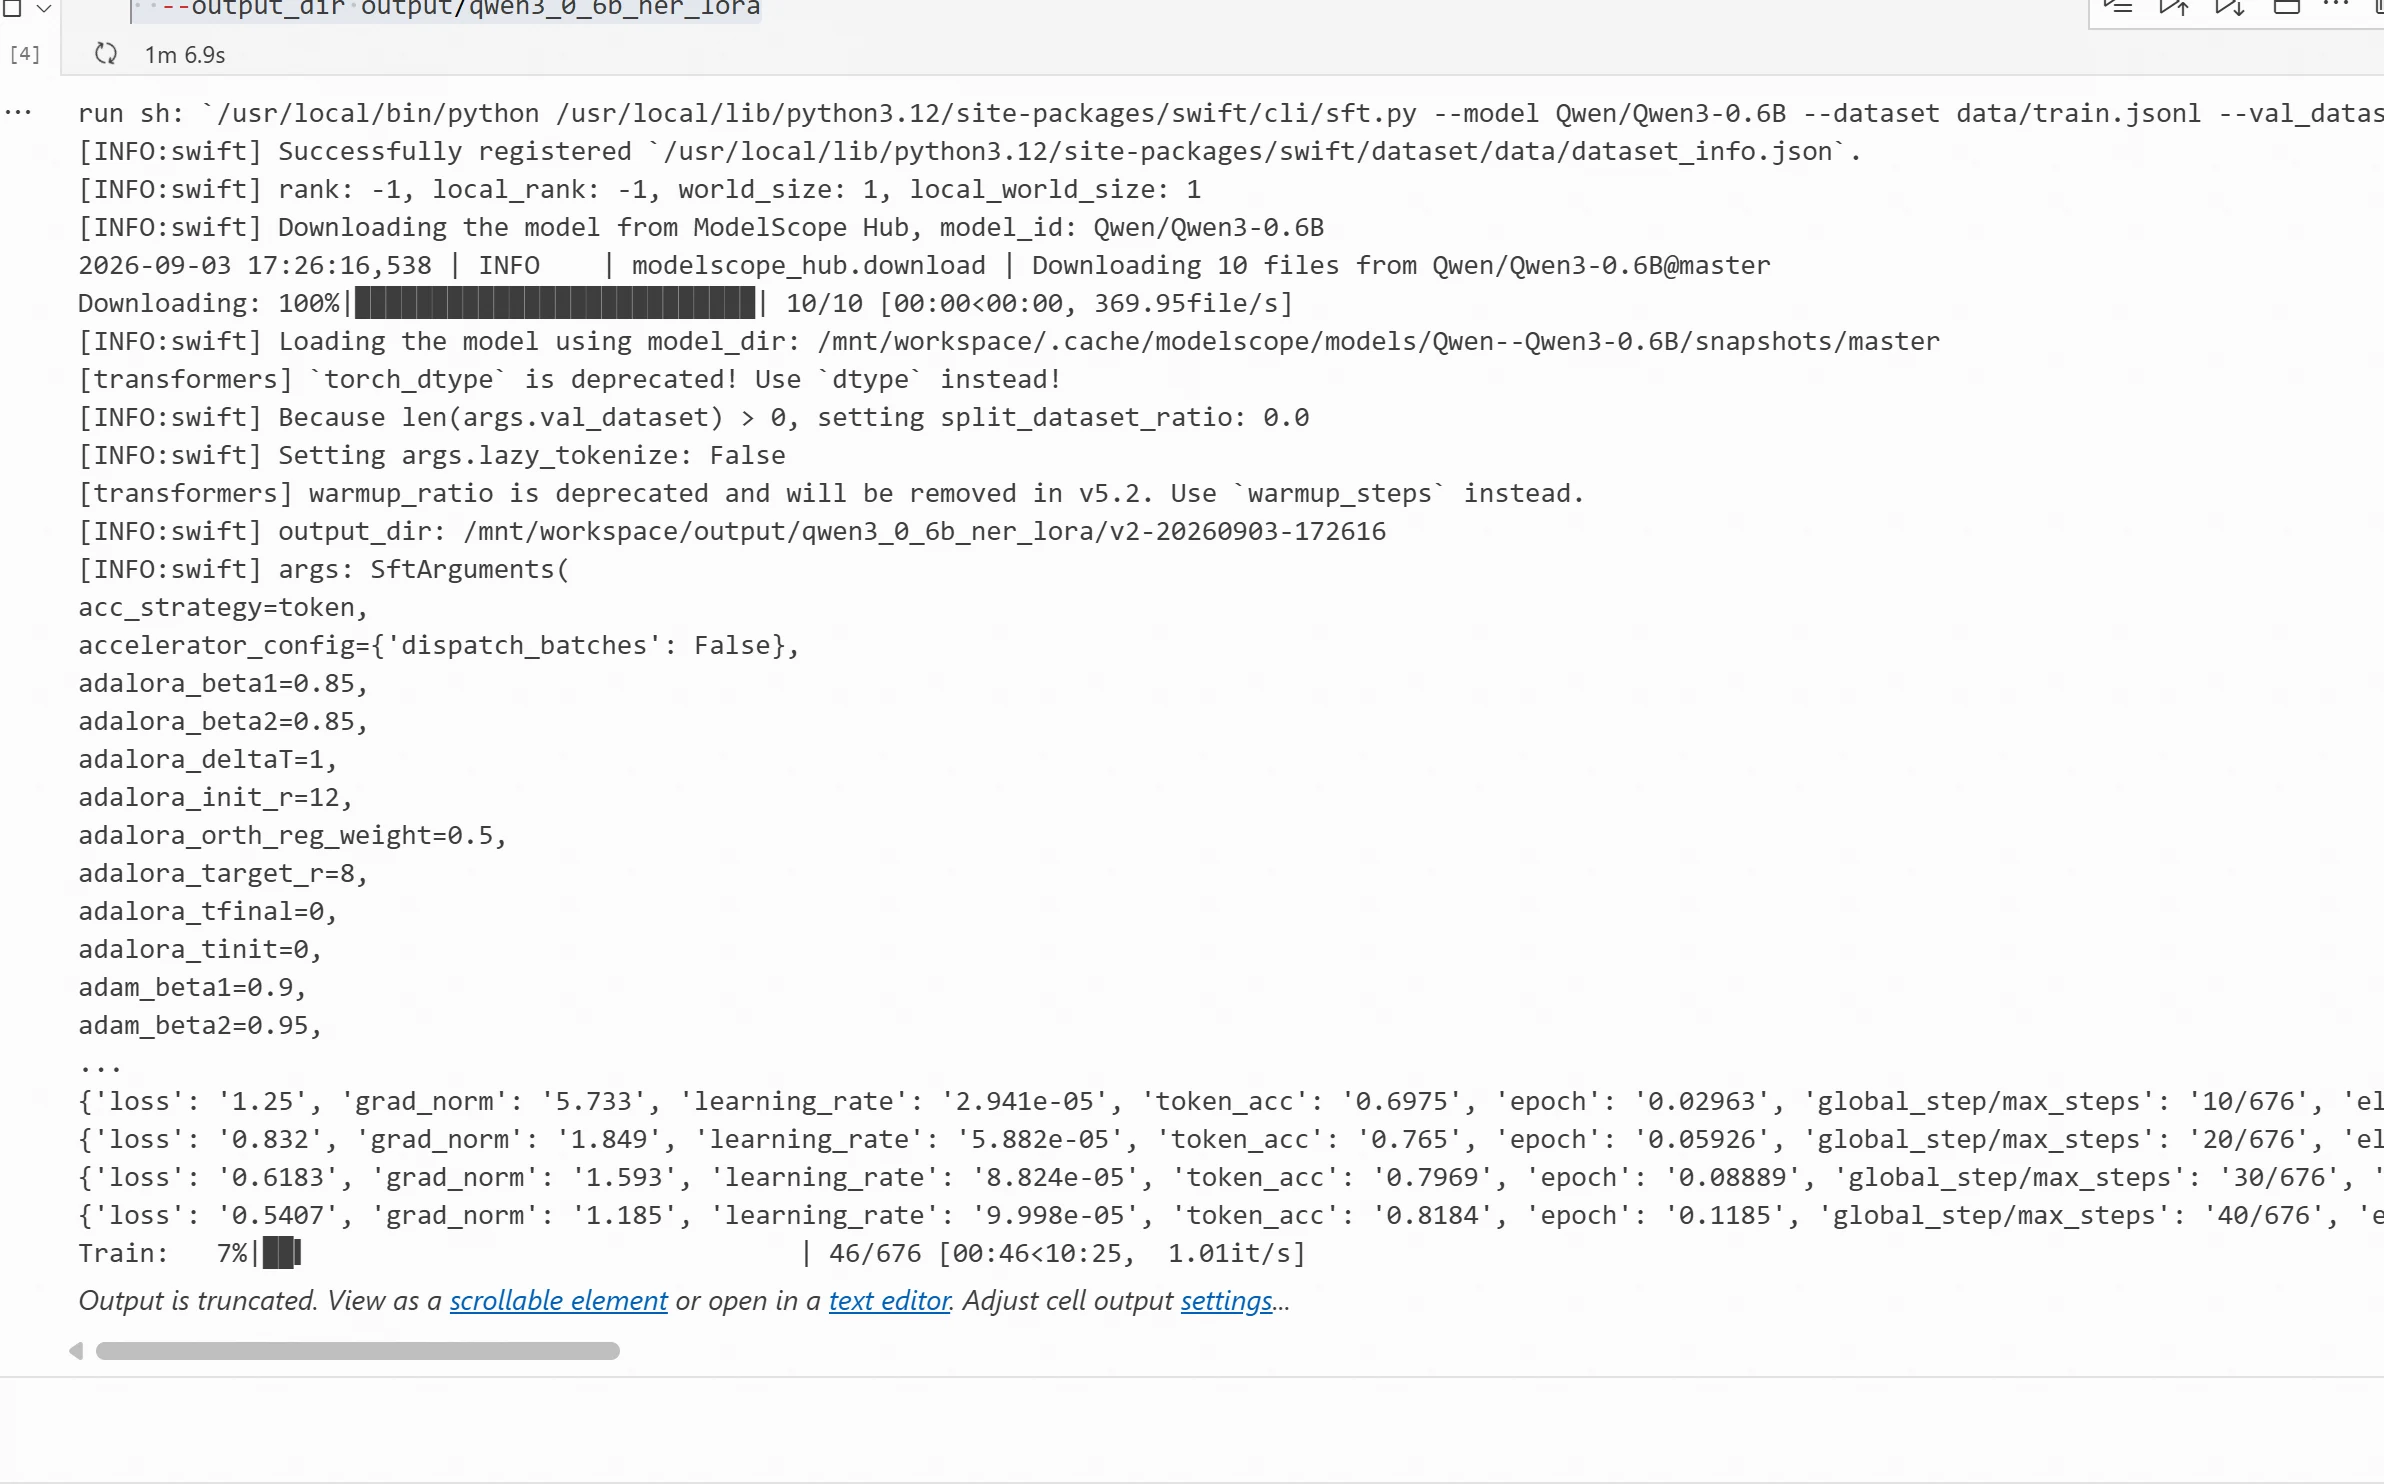
శిక్షణ ప్రారంభించిన తర్వాత, ms-swift ప్రస్తుత శిక్షణ సమాచారాన్ని నిరంతరం అవుట్పుట్ చేస్తుంది.


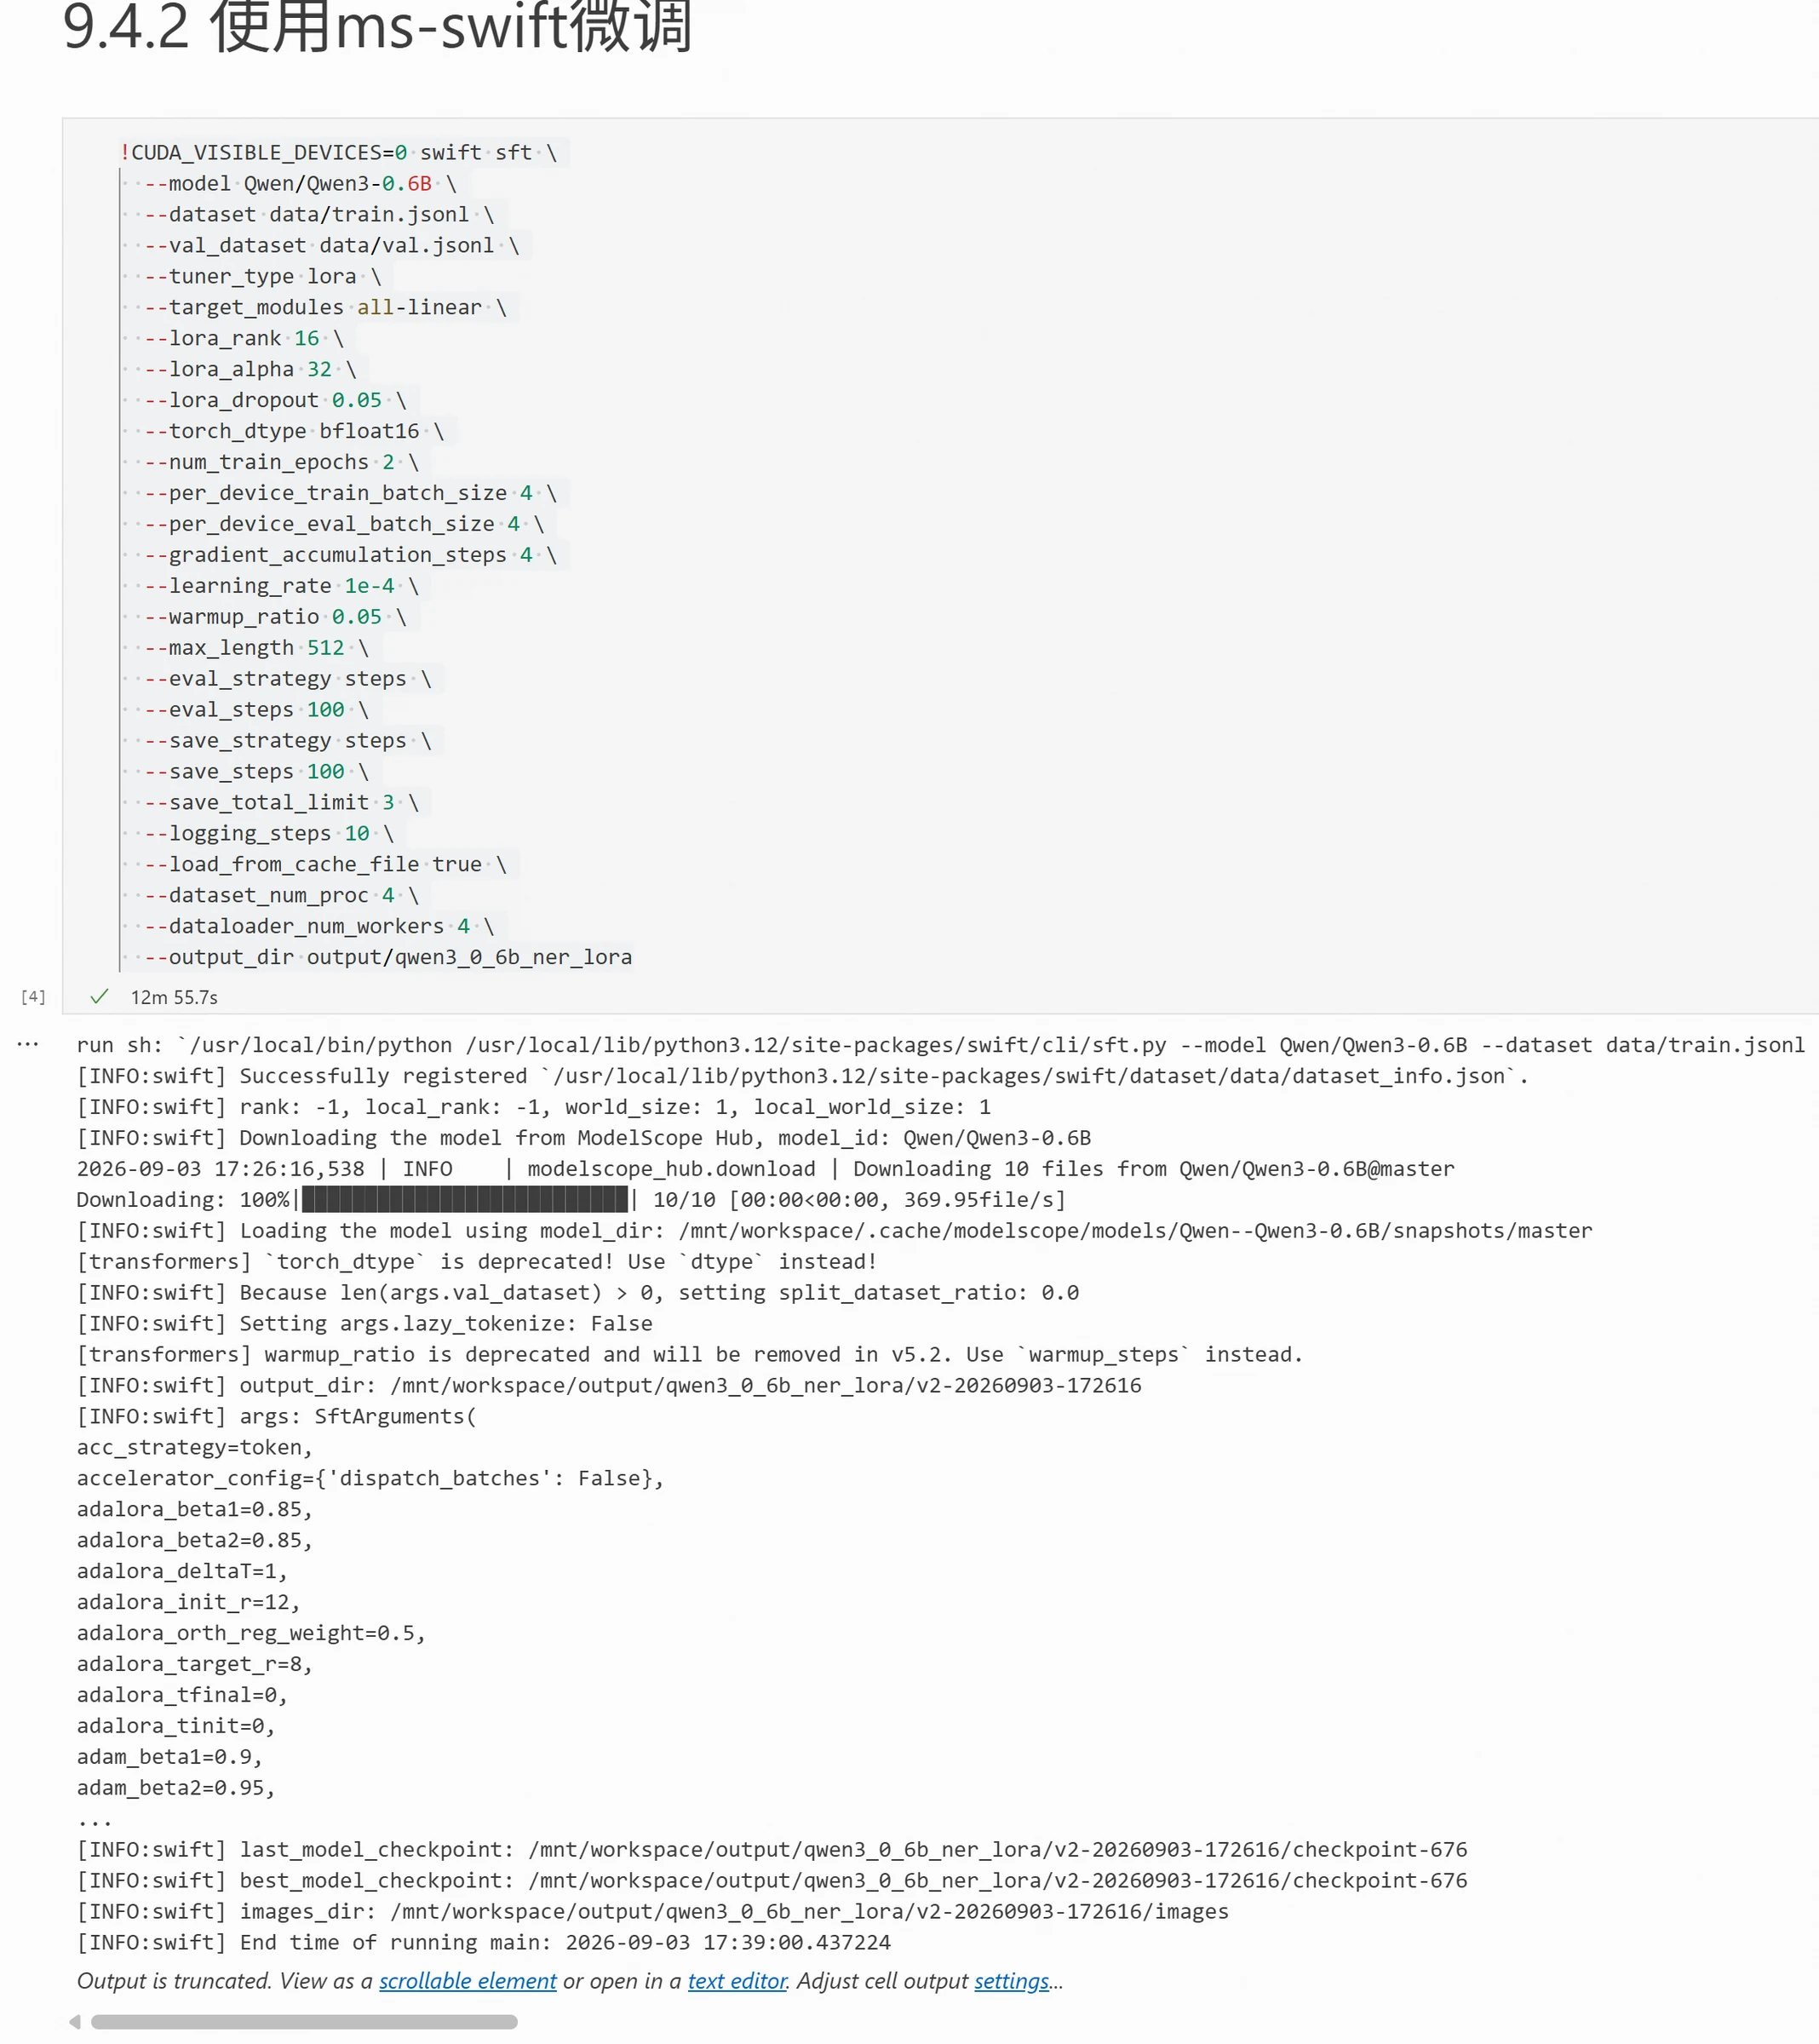
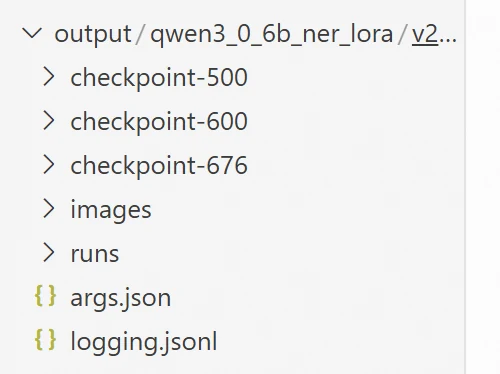
LoRA శిక్షణ పూర్తయిన తర్వాత, సంబంధిత LoRA Adapter సేవ్ చేయబడుతుంది.

మోడల్ విలీనం ఆదేశం ఈ క్రింది విధంగా ఉంటుంది:
!CUDA_VISIBLE_DEVICES=0 swift export \
--adapters output/qwen3_0_6b_ner_lora/v2-20260903-172616/checkpoint-676 \
--merge_lora true \
--output_dir output/qwen3_0_6b_ner_merged
ఇక్కడ, --adapters శిక్షణ ద్వారా పొందిన LoRA checkpoint మార్గాన్ని సూచిస్తుంది.
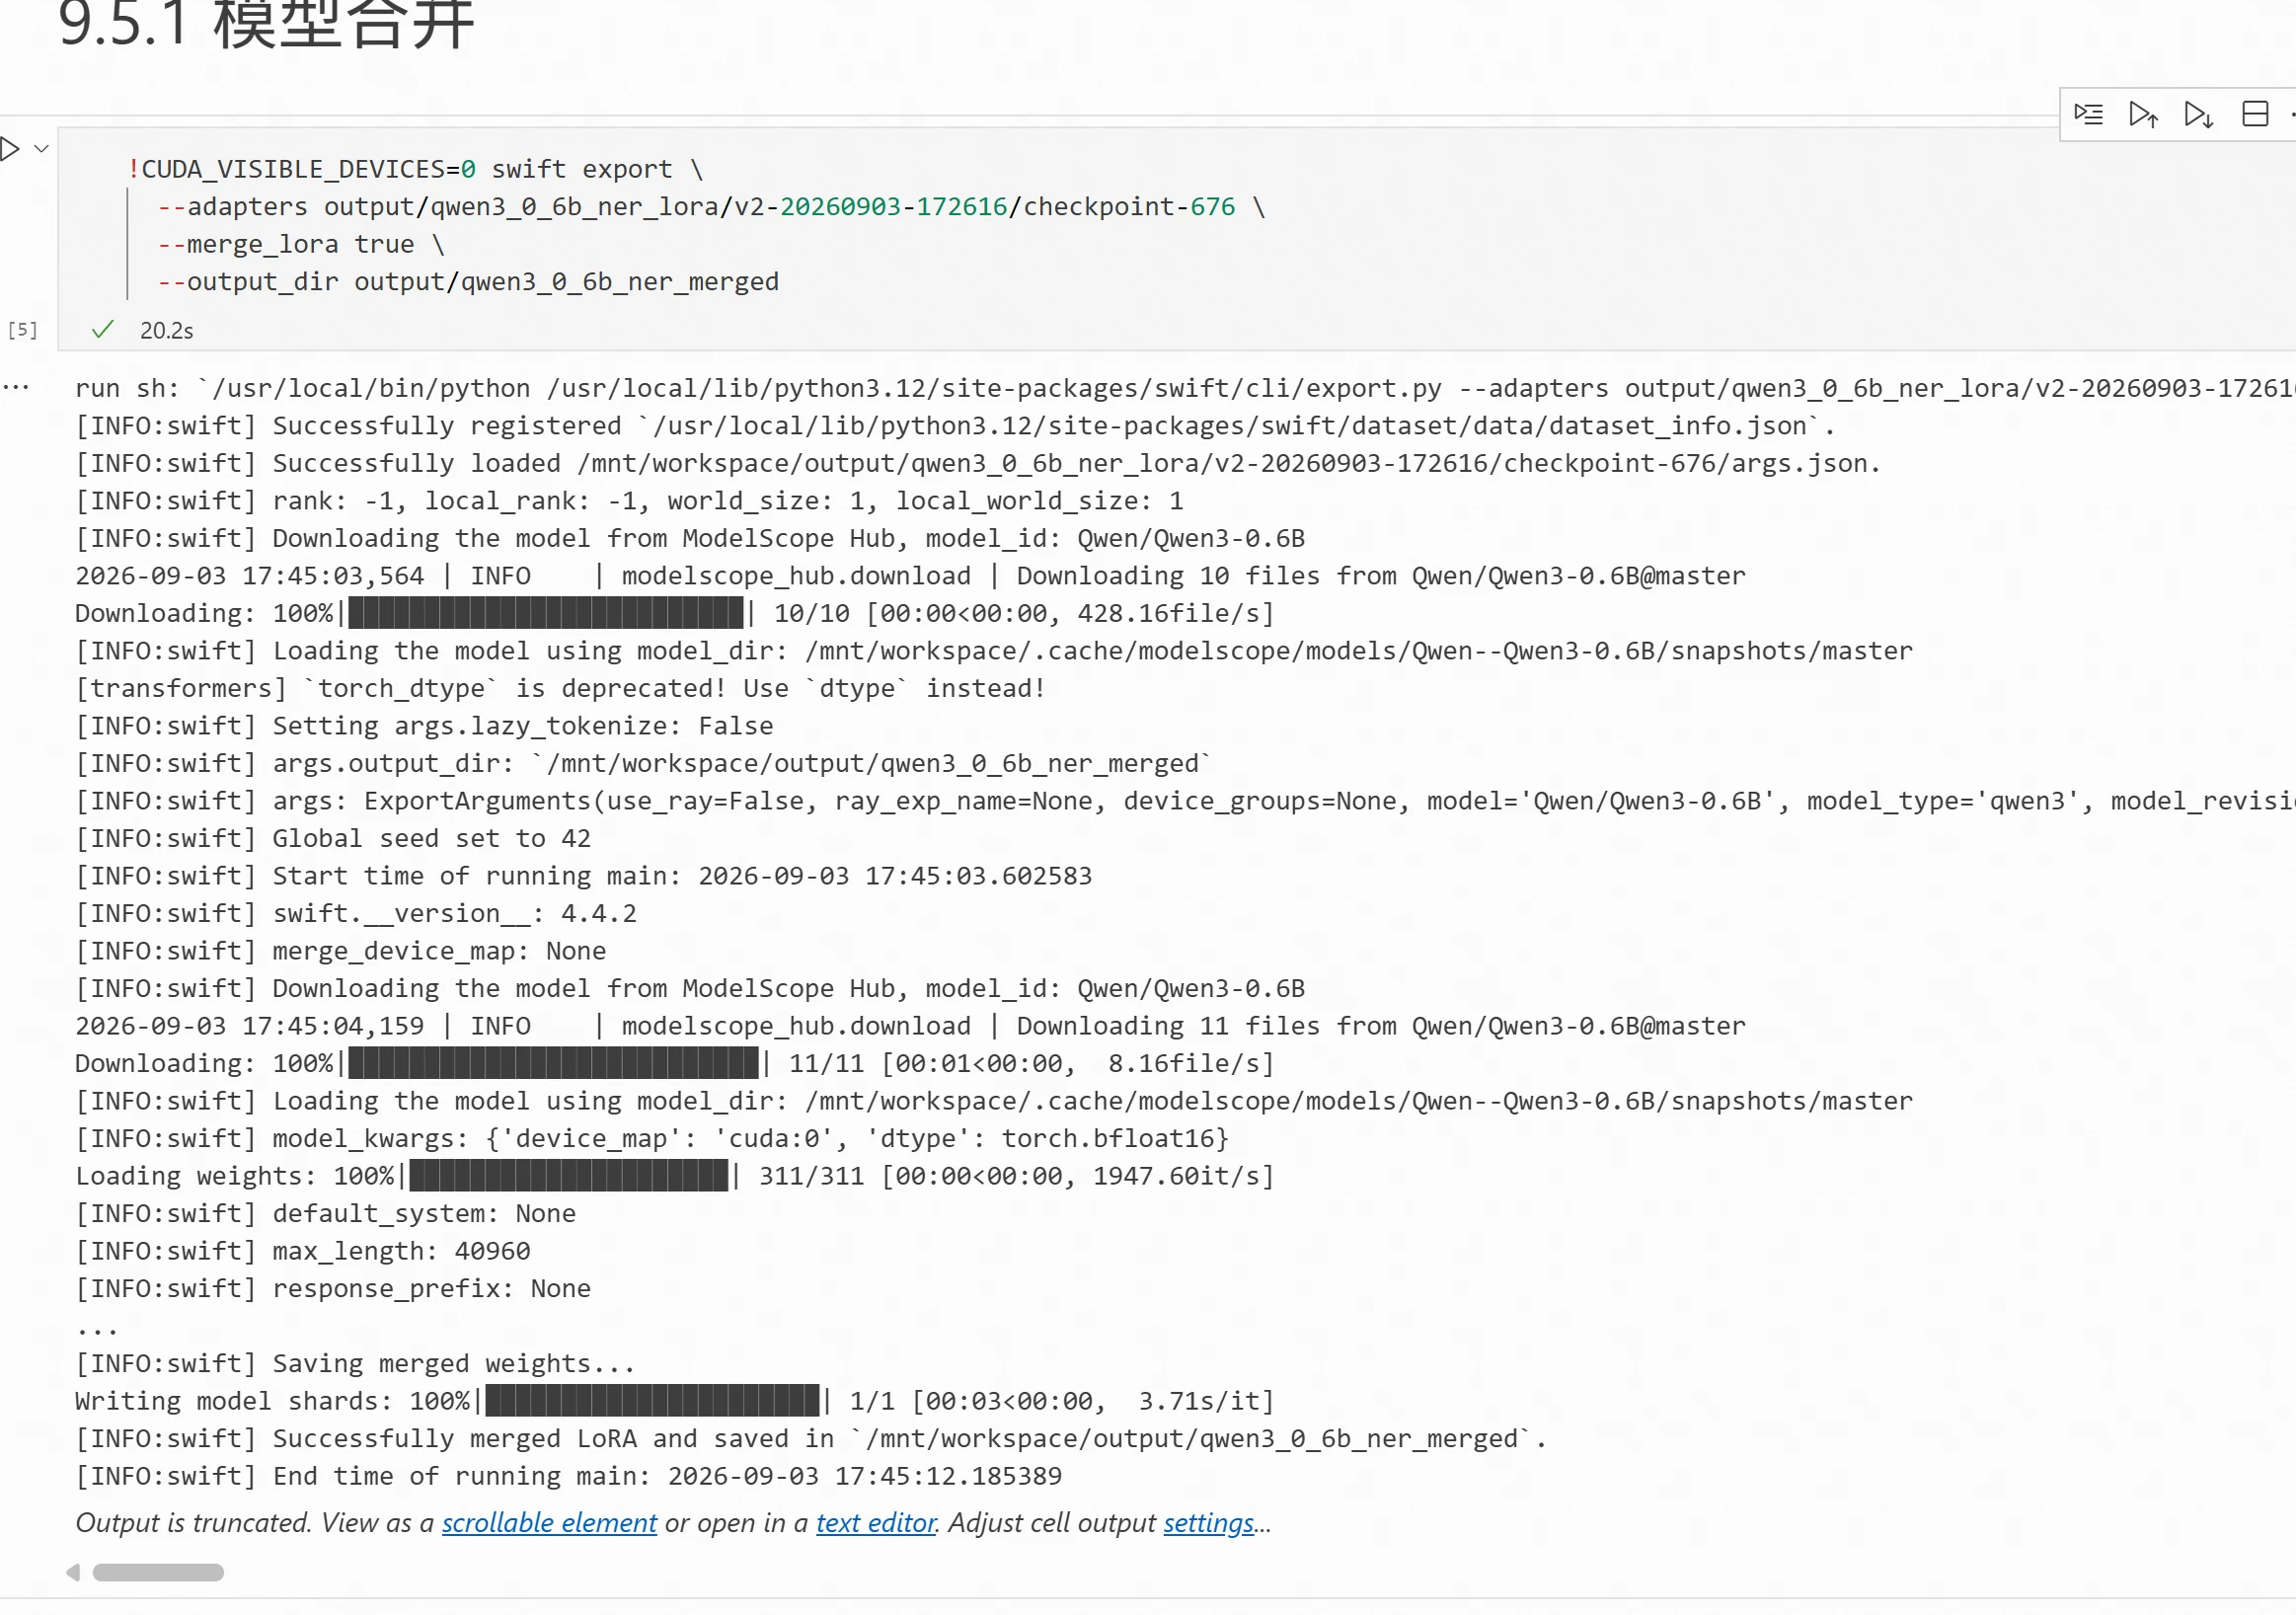
అమలు ఫలితం ఈ క్రింది విధంగా ఉంటుంది:

విలీనం పూర్తయిన తర్వాత, జనరేట్ చేసిన పూర్తి మోడల్ను నేరుగా లోడ్ చేసి ఇన్ఫెరెన్స్ చేయవచ్చు.
CUDA_VISIBLE_DEVICES=0 swift deploy \
--model output/qwen3_0_6b_ner_merged \
--load_args false \
--infer_backend vllm \
--enable_thinking false \
--host 0.0.0.0 \
--port 8000 \
--served_model_name qwen3-0.6b-ner \
--api_key 123 \
--vllm_gpu_memory_utilization 0.7 \
--vllm_max_model_len 1024 \
--max_new_tokens 128
పారామితుల వివరణ ఈ క్రింది విధంగా ఉంటుంది:
| Parameter | Description |
| swift deploy | Start ms-swift OpenAI compatible service |
| --model | Specify merged full model directory |
| --load_args | Do not load args.json from model directory |
| --infer_backend | Use vLLM inference engine |
| --enable_thinking | Disable Qwen3 thinking mode |
| --host | Interface IP |
| --port | Port |
| --served_model_name | Set interface model name |
| --api_key | Set interface API key |
| --vllm_gpu_memory_utilization | Model uses ~70% GPU memory |
| --vllm_max_model_len | Maximum total tokens |
| --max_new_tokens | Maximum output length |
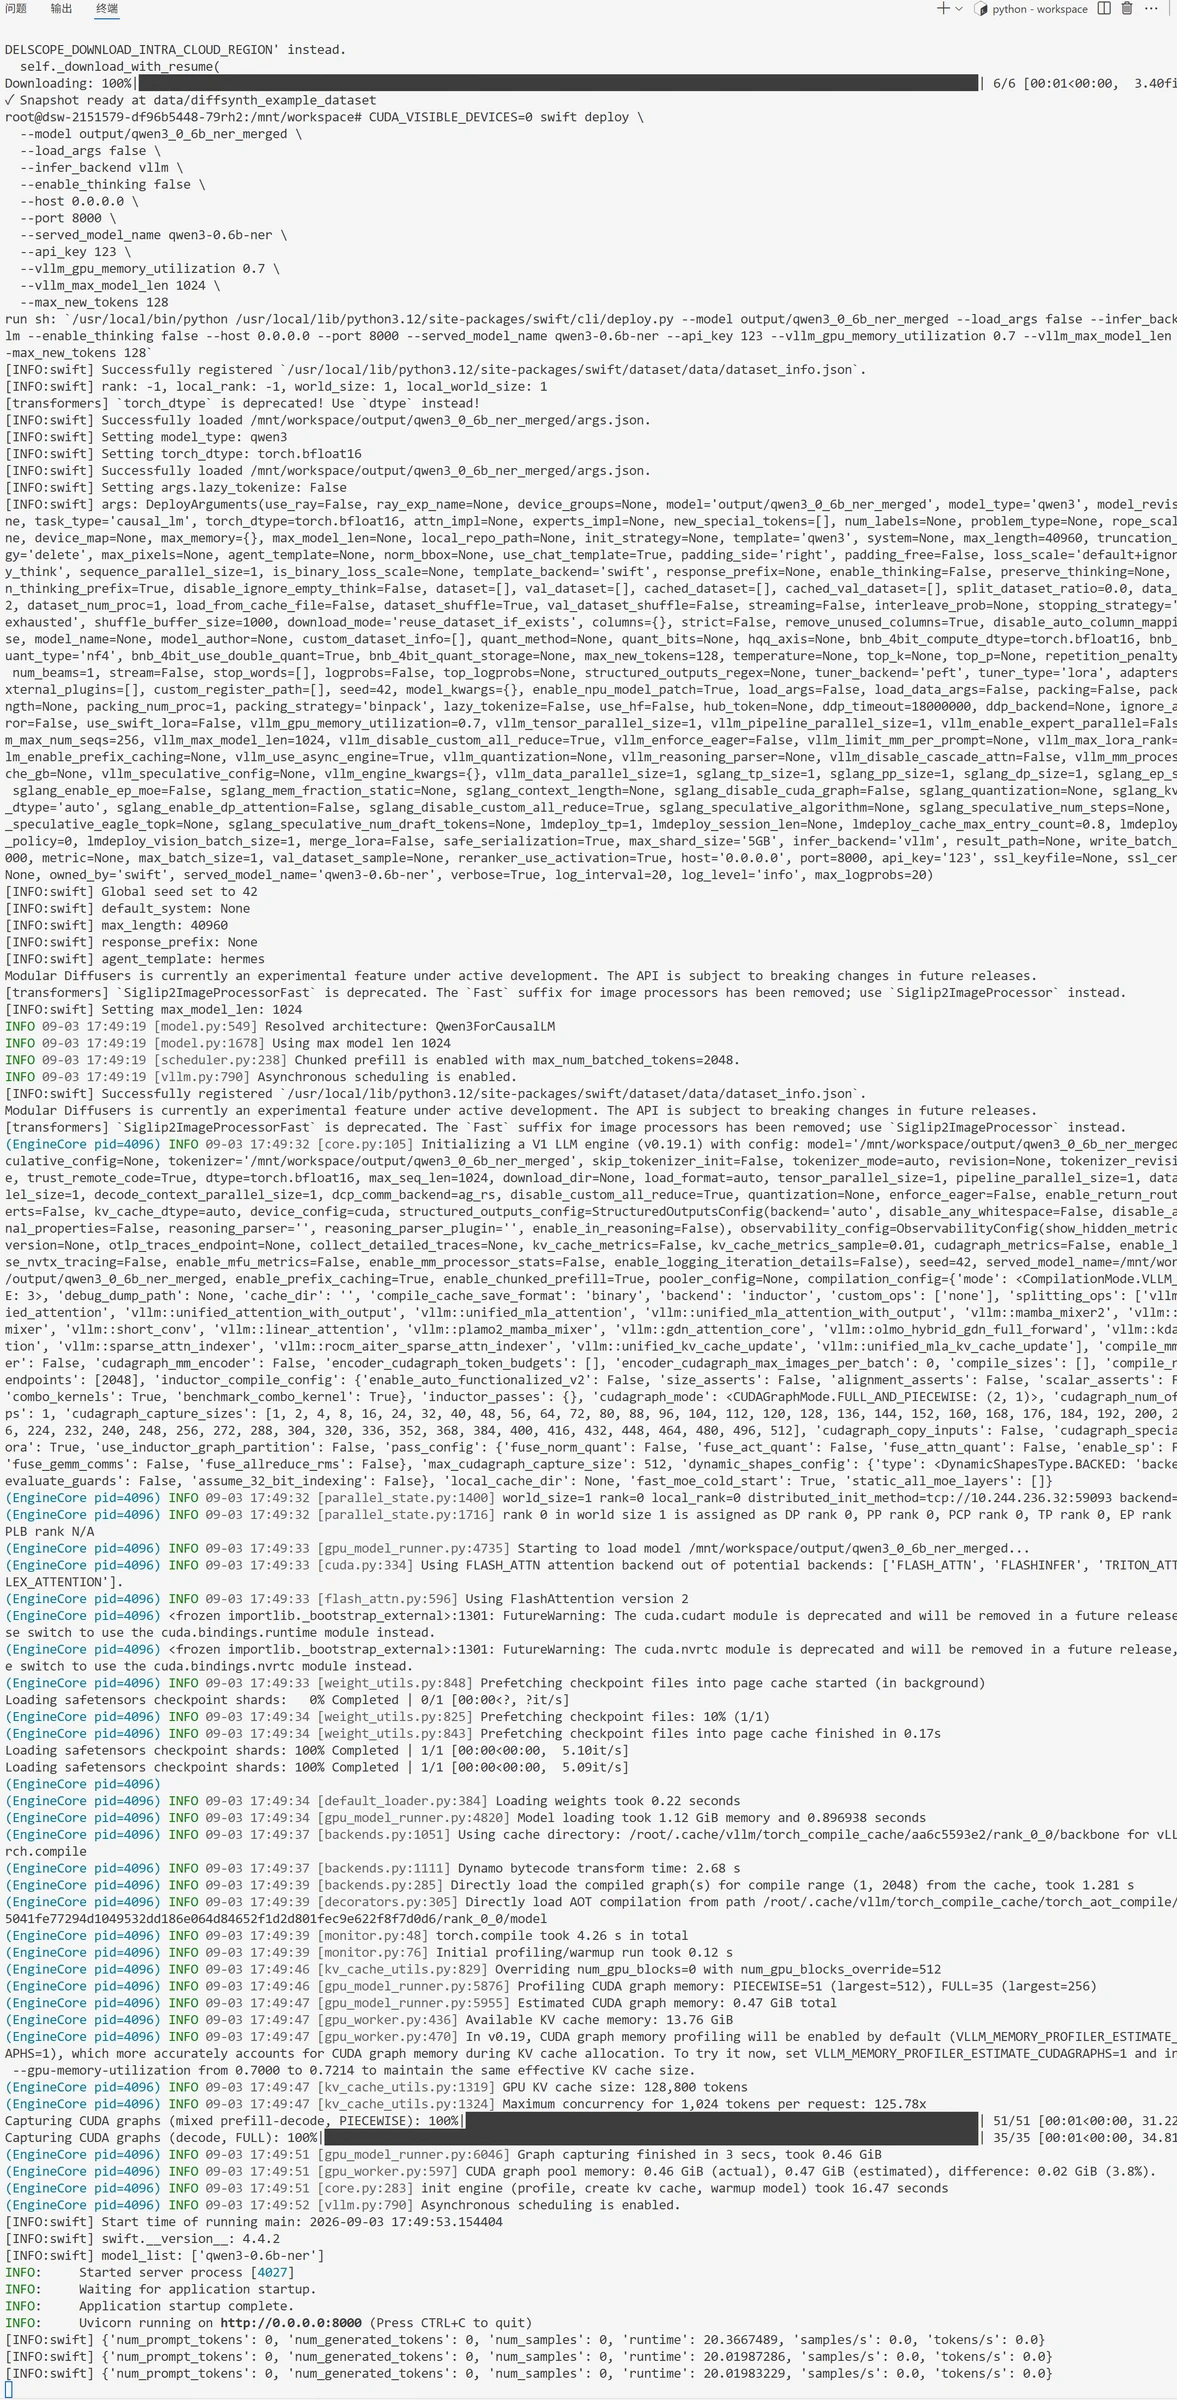
మోడల్ ప్రారంభించిన తర్వాత, ఫలితం ఈ క్రింది విధంగా ఉంటుంది:

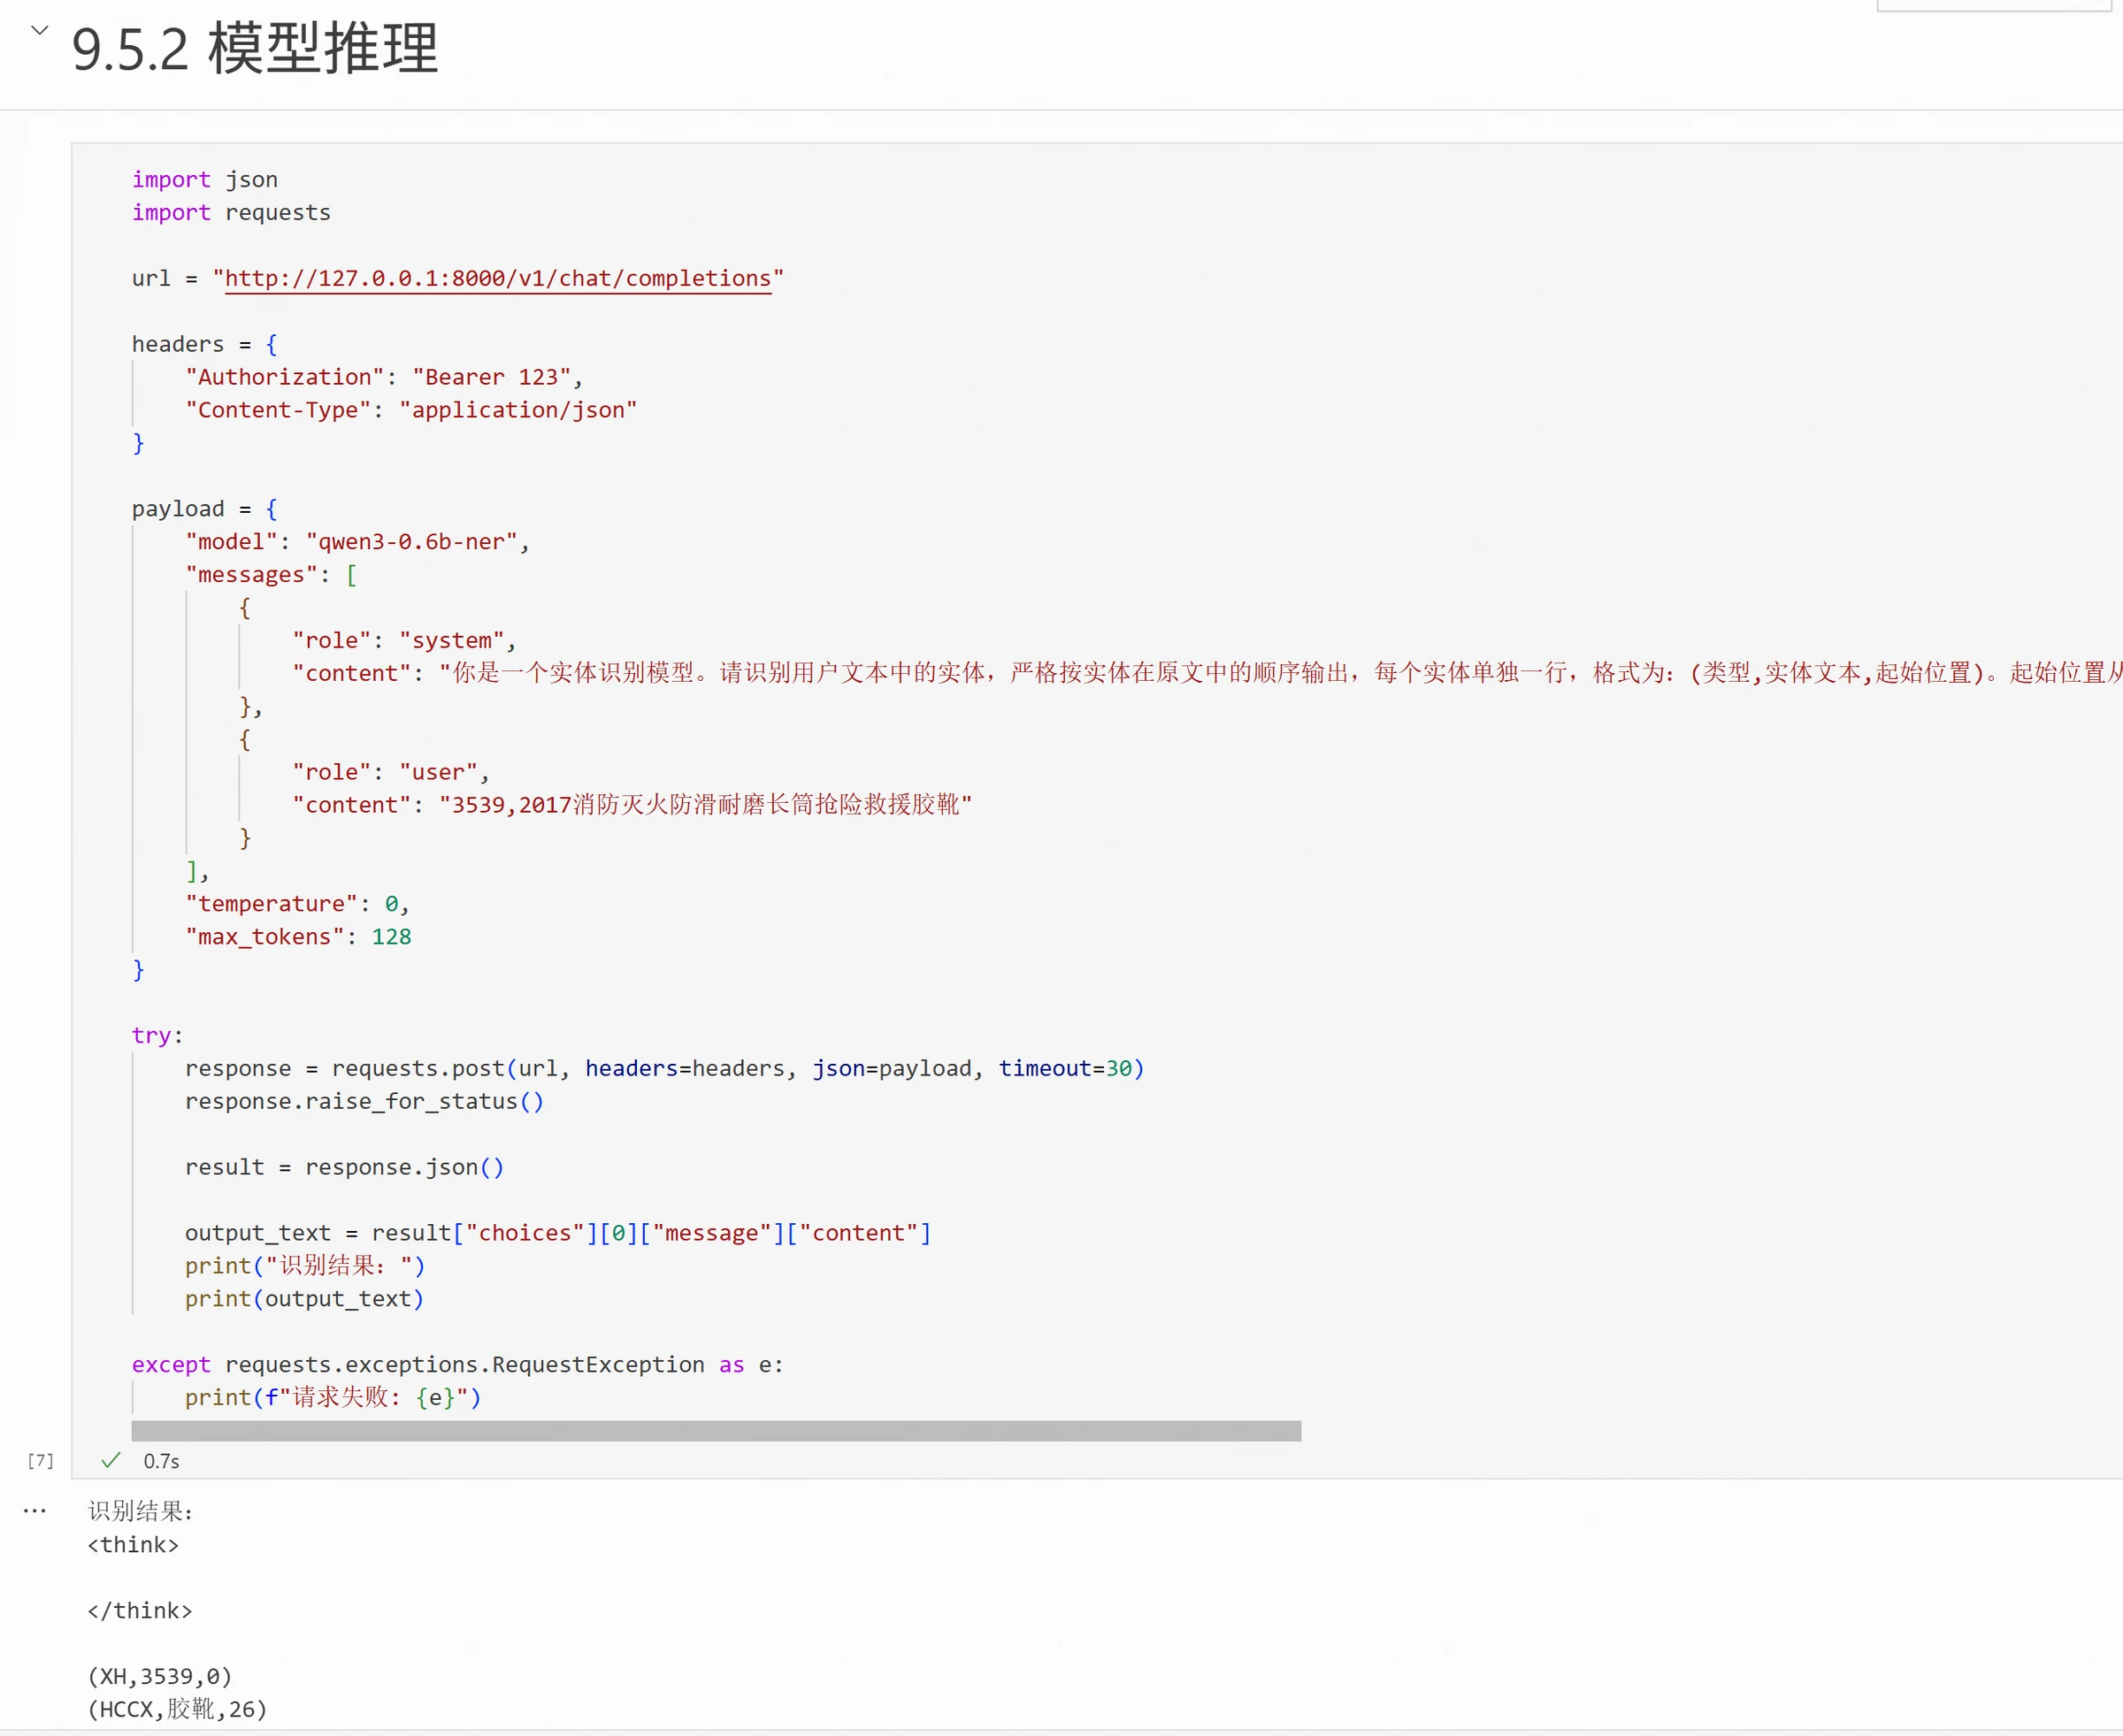
మోడల్ ప్రారంభించిన తర్వాత, ఇంటర్ఫేస్ ద్వారా కనెక్టివిటీని పరీక్షించవచ్చు.
import json
import requests
url = "http://127.0.0.1:8000/v1/chat/completions"
headers = {
"Authorization": "Bearer 123",
"Content-Type": "application/json"
}
payload = {
"model": "qwen3-0.6b-ner",
"messages": [
{
"role": "system",
"content": "మీరు ఒక ఎంటిటీ గుర్తింపు మోడల్. వినియోగదారు టెక్స్ట్లోని ఎంటిటీలను గుర్తించండి. ఎంటిటీలను అసలు టెక్స్ట్లో వాటి క్రమంలో ఖచ్చితంగా అవుట్పుట్ చేయండి, ప్రతి ఎంటిటీని వేరు వేరు లైన్లో, ఈ ఫార్మాట్లో: (రకం,ఎంటిటీ టెక్స్ట్,ప్రారంభ స్థానం). ప్రారంభ స్థానం 0 నుండి మొదలవుతుంది; రకం HCCX, HPPX, MISC, XH లలో ఒకటే కావచ్చు. ఎంటిటీలు లేకపోతే ఇది మాత్రమే అవుట్పుట్ చేయండి: ఎంటిటీలు లేవు. వివరణలు, Markdown, think గుర్తు లేదా ఇతర కంటెంట్ అవుట్పుట్ చేయవద్దు."
},
{
"role": "user",
"content": "3539,2017 fire-fighting non-slip wear-resistant tall emergency rescue boots"
}
],
"temperature": 0,
"max_tokens": 128
}
try:
response = requests.post(url, headers=headers, json=payload, timeout=30)
response.raise_for_status()
result = response.json()
output_text = result["choices"][0]["message"]["content"]
print("గుర్తింపు ఫలితం:")
print(output_text)
except requests.exceptions.RequestException as e:
print(f"అభ్యర్థన విఫలమైంది: {e}")
మోడల్ అవుట్పుట్ ఫలితం ఈ క్రింది విధంగా ఉంటుంది, think ట్యాగ్ను regex ద్వారా తొలగించవచ్చు.

ఈ అధ్యాయంలోని అన్ని ప్రయోగ డేటా మరియు కోడ్, https://modelscope.cn/gallery/liucong/ab458cbd-b47f-4830-91b6-314ea2036fc6 లో చూడవచ్చు.