数据,是你要做开源模型微调的基石
数据,是你要做开源模型微调的基石
你是否遇到过这种情况,一个模型可以在写代码、做数学题表现的十分优秀,但你问一个日常的问题,却给你瞎回答。
我们都知道模型在训练的过程中,想要那个部分的能力提高,就针对性的找那类的数据,
但很多数据,你直接互联网检索,很难找到,有一个数据的统一下载入口,对于模型训练者来说,会节省很大的精力。
比如,我们当时开源的中文基于满血DeepSeek-R1蒸馏数据集,其中很多原始数据都是从魔搭上直接下载的,
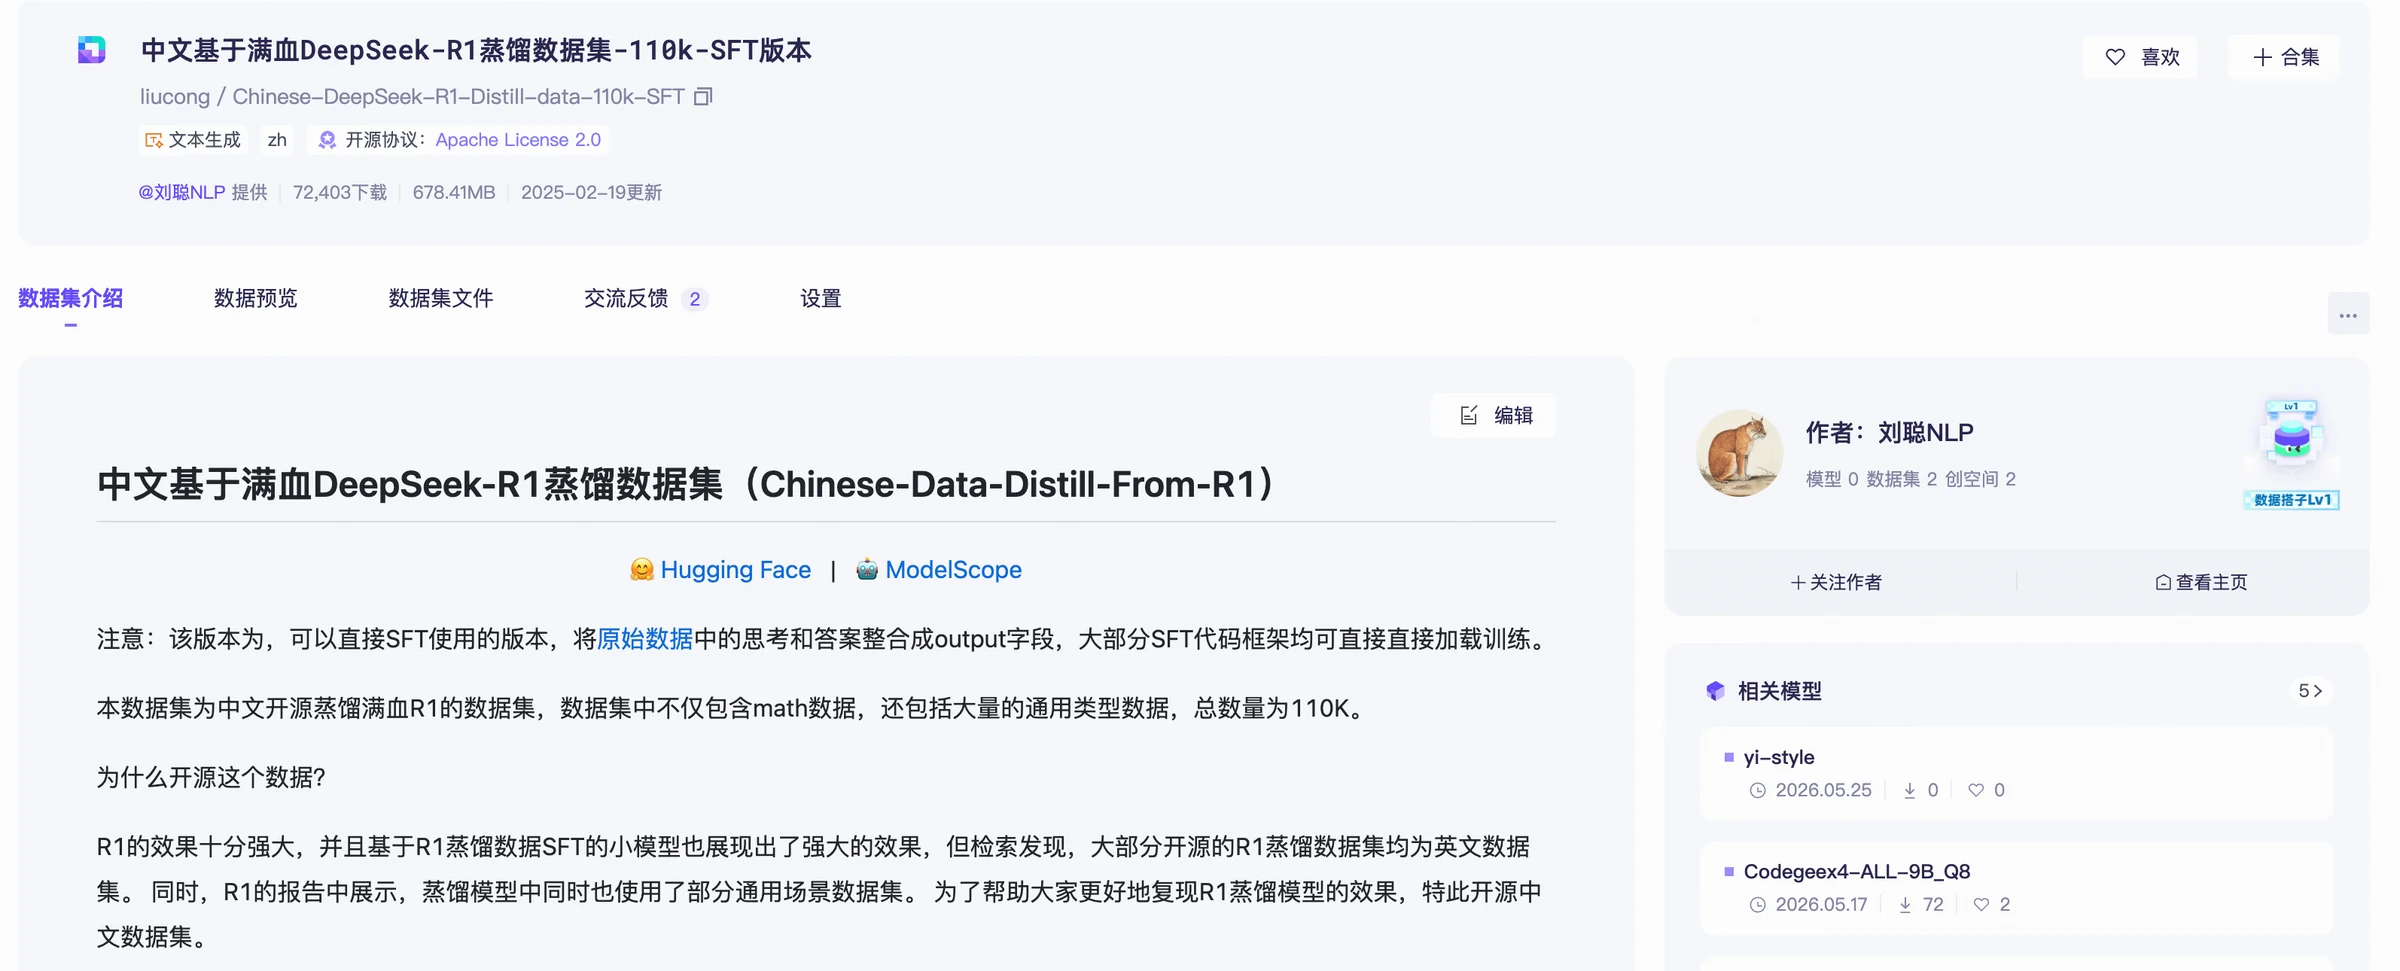
我们模型的微调,可以从一份现成的开源数据集开始,这样可以快速跑通整个流程。
找数据,也要先知道自己准备做什么
魔搭整合了超过4万个开源数据集,平台支持数据集搜索和预览,提供字段说明及数据集版本。
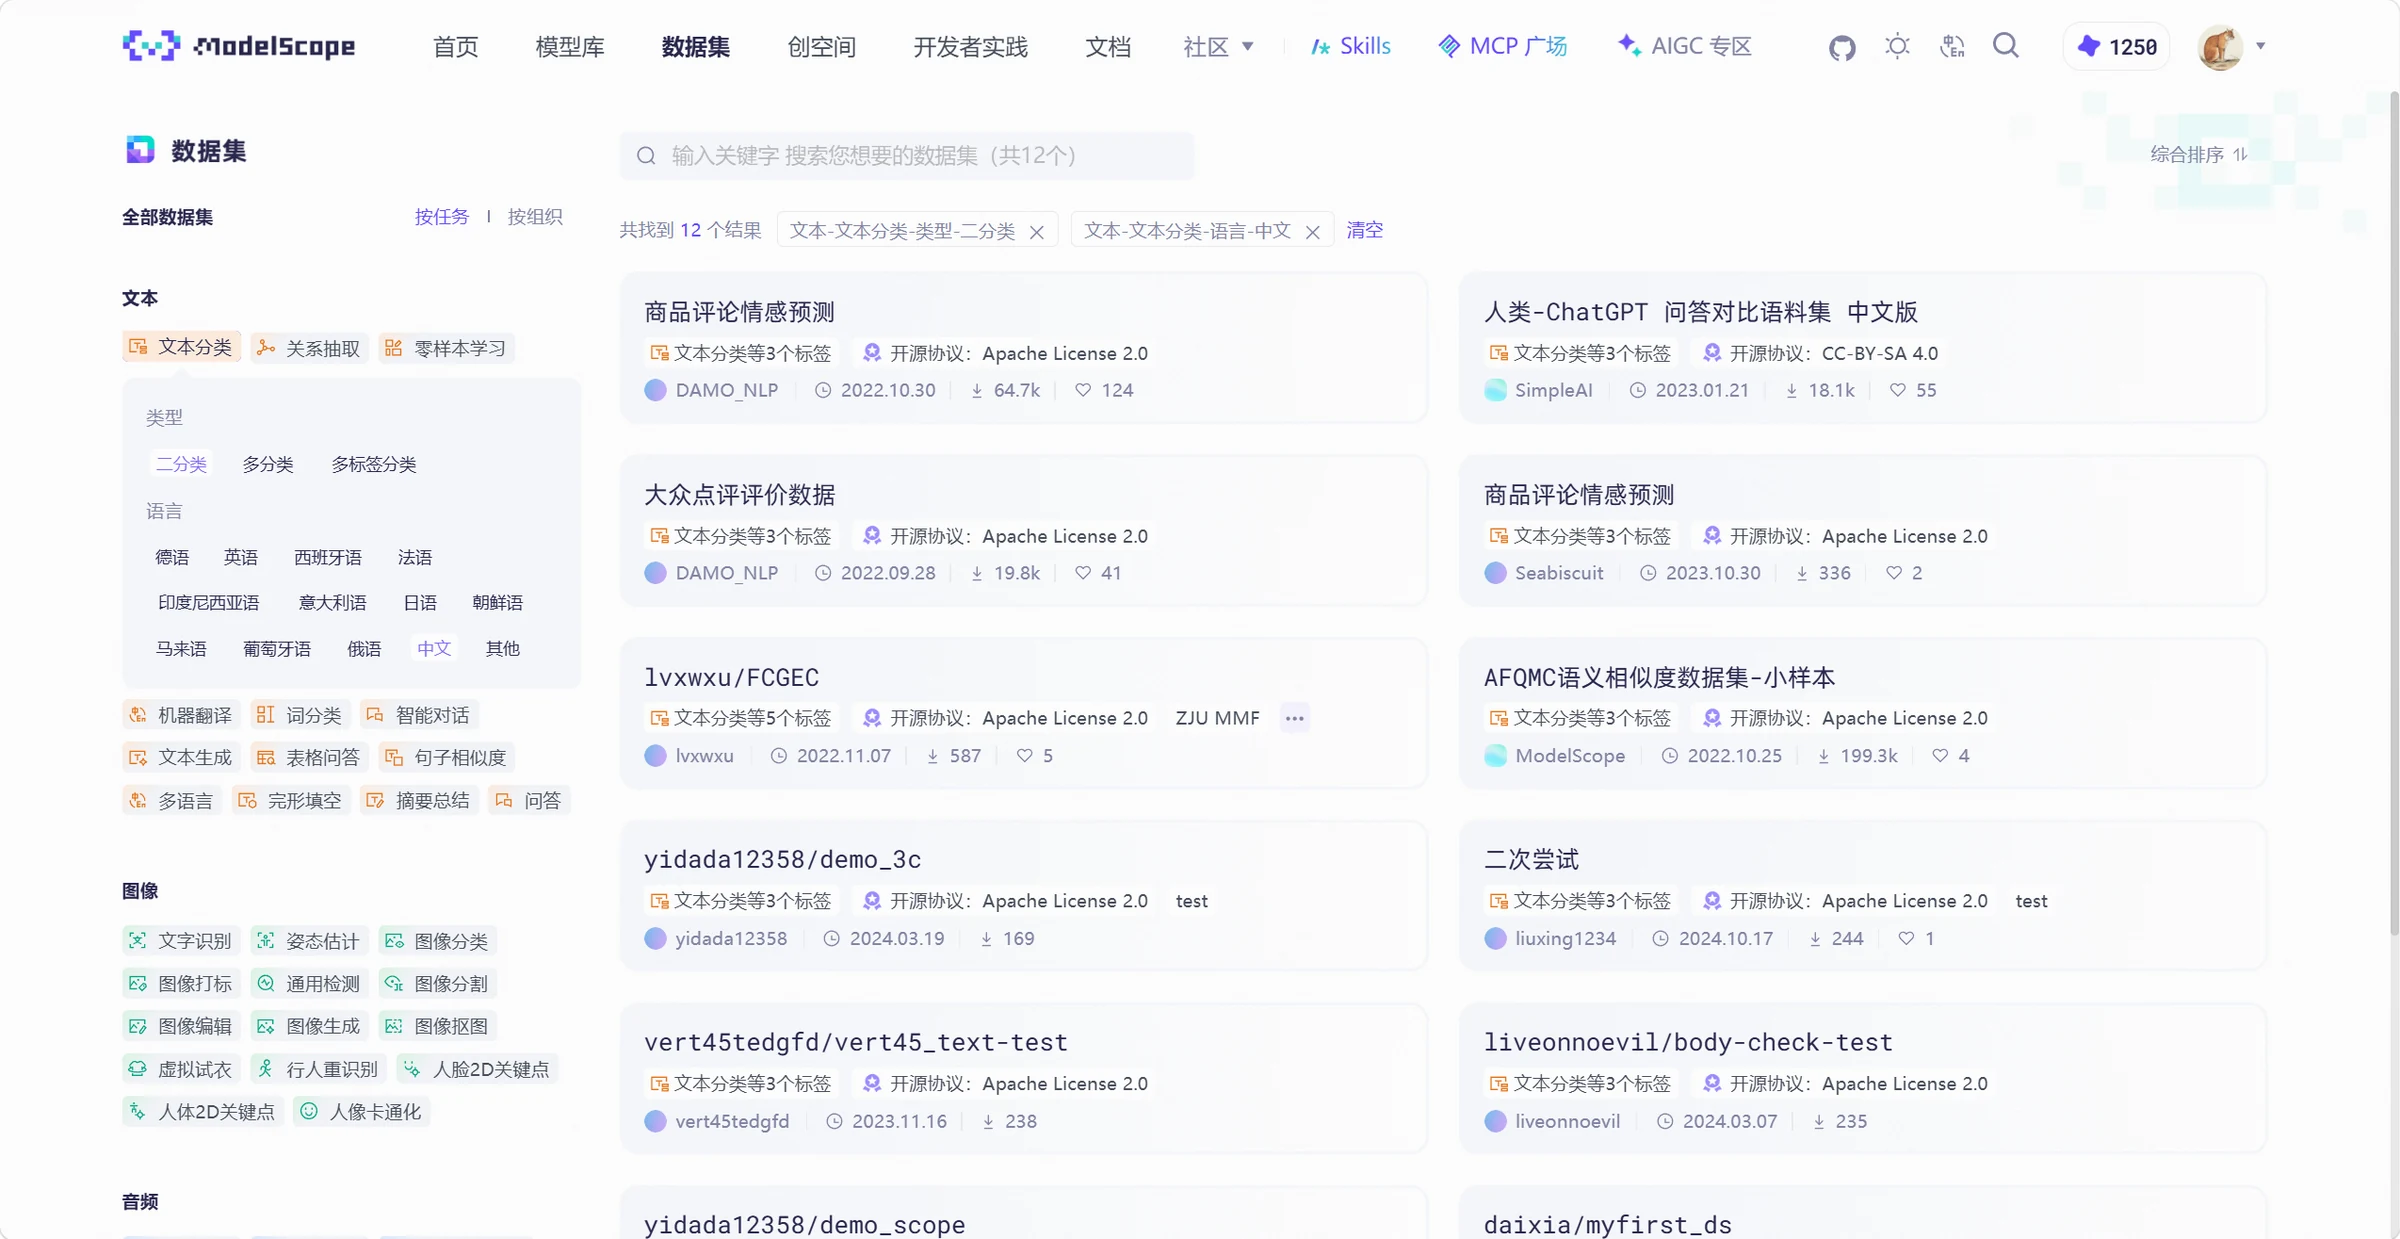
魔搭支持根据关键词标签及任务类别搜索数据集,如,检索语言中文的二分类文本分类数据,
下载之前,先翻几条数据看看
筛选出数据集后,选择感兴趣的数据集,点击“数据预览”可以在线查看样本内容与字段说明,辅助数据选型决策,如simpleai/HC3-Chinese。
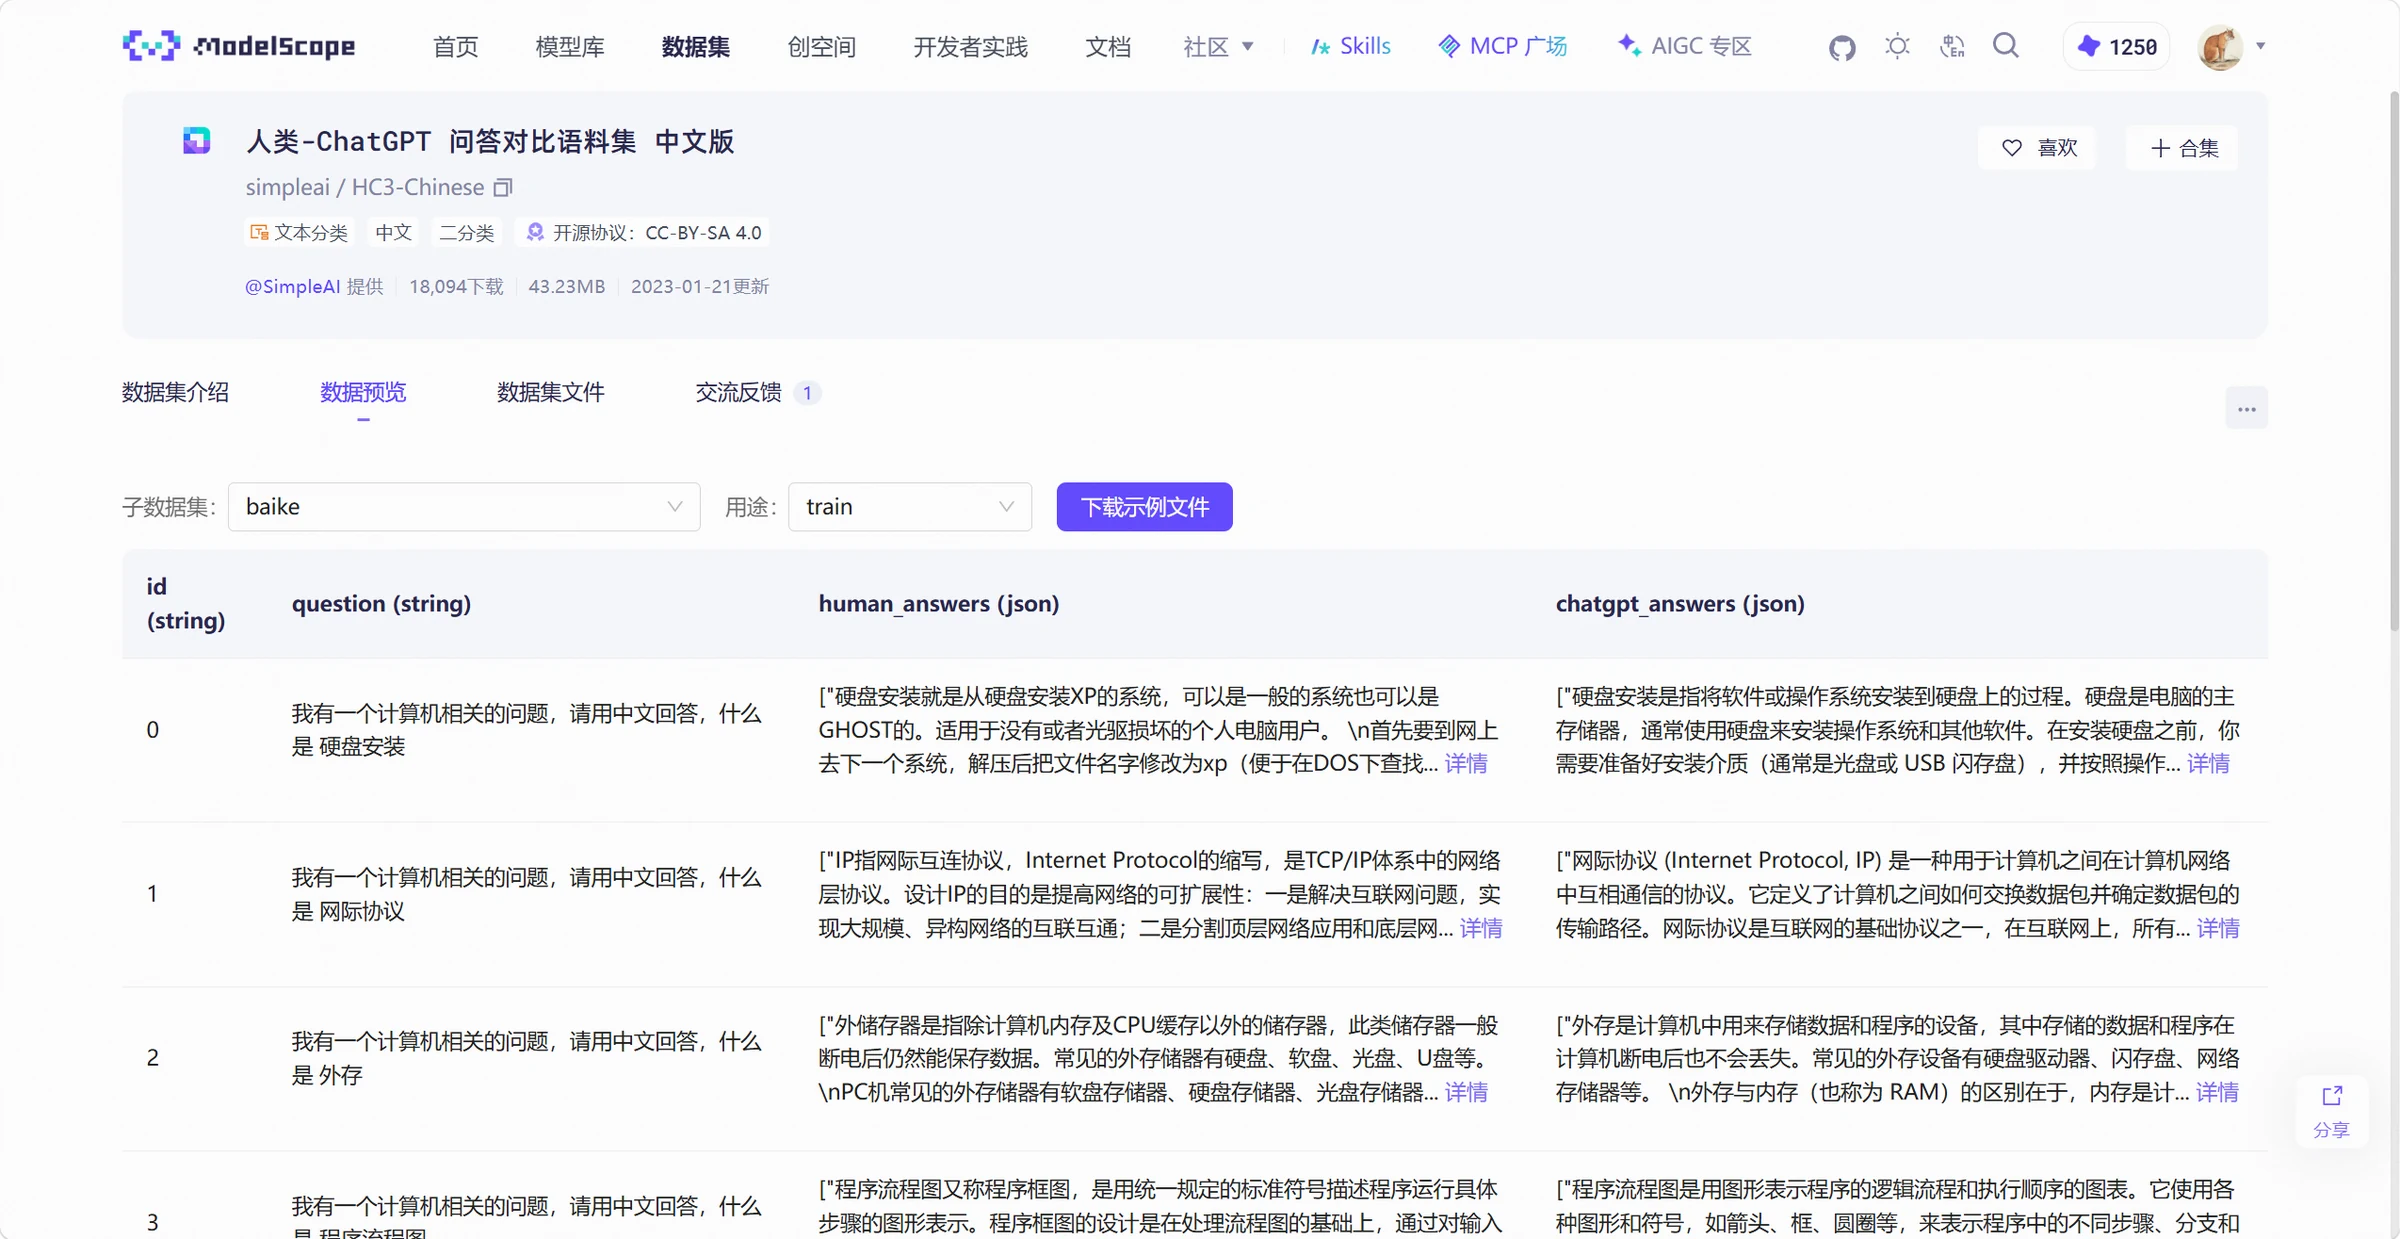
问题放在哪一列,答案放在哪一列,有没有标签,一条数据里是一段文字还是一组对话,这些都可以先看清楚。后面写处理代码时,就不用对着字段名猜了。
以问答数据为例,人类回答和模型回答可能分别保存在不同字段里,准备拿它做什么任务,就要决定读取哪些字段、怎样整理,不能只看到问答两个字就直接开始训练。
再到数据集文件里看看文件和版本,同一份数据集会更新,训练样本、字段或者划分也可能变化。做实验时记下用的是哪个版本,后面才容易复现。
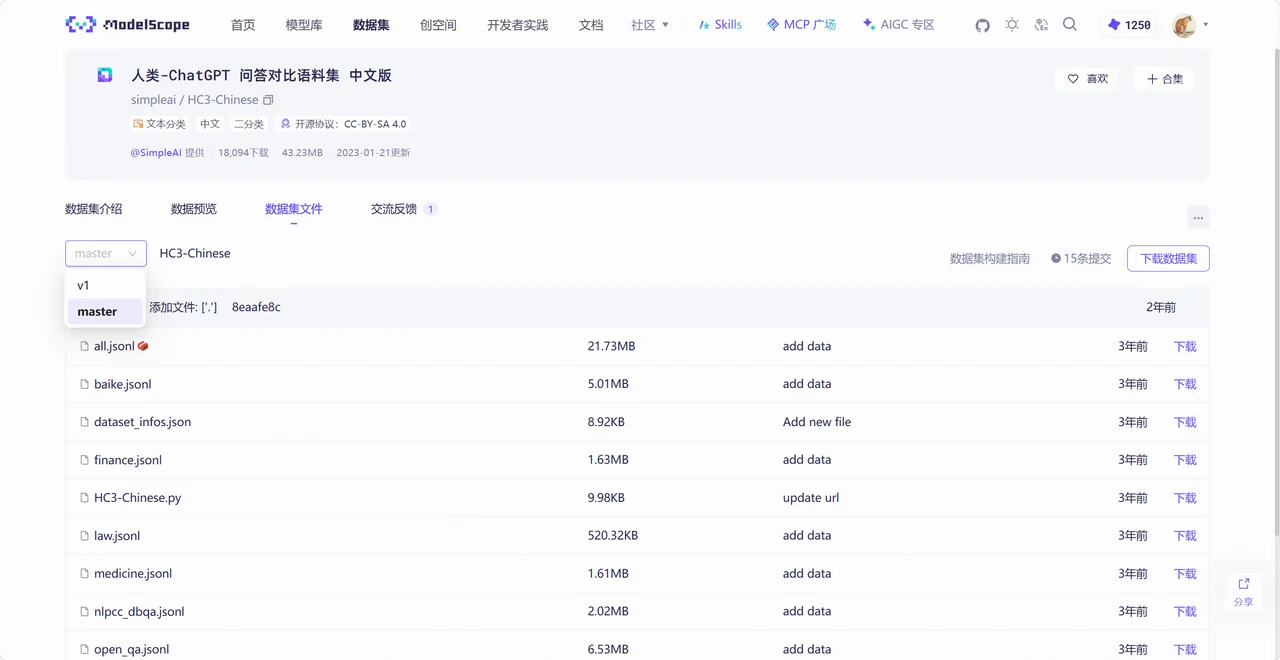
数据集的说明和许可证也值得一起看。能下载的数据,用于研究、训练或者商业产品时,可能有不同要求。
先把数据读进来,再决定用哪一部分
魔搭提供了MsDataset.load接口,可以在Python里加载数据集。安装ModelScope后,就可以按数据集页面的使用说明操作。
先加载一份完整的数据
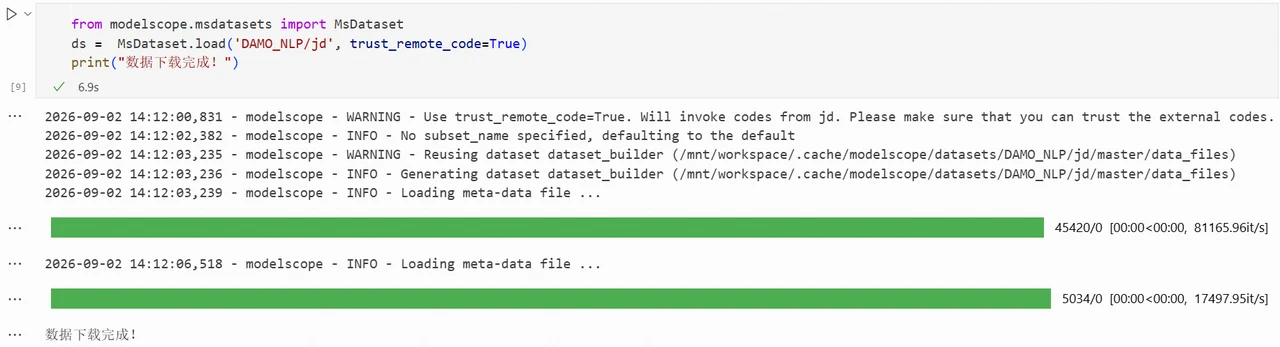
以DAMO_NLP/jd为例,可以这样读取默认配置下的数据,
from modelscope.msdatasets import MsDataset

ds = MsDataset.load(
    'DAMO_NLP/jd',
    trust_remote_code=True,
)
print(ds)
只需要其中一个子集,就把名字写清楚
有些数据集会把不同来源、领域或用途的数据分开保存。如果只关心其中一部分,就用subset_name指定子集。
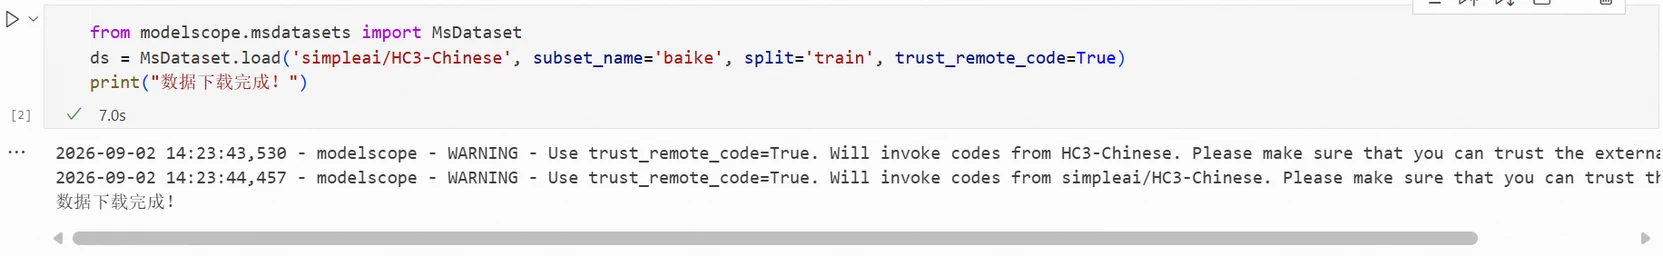
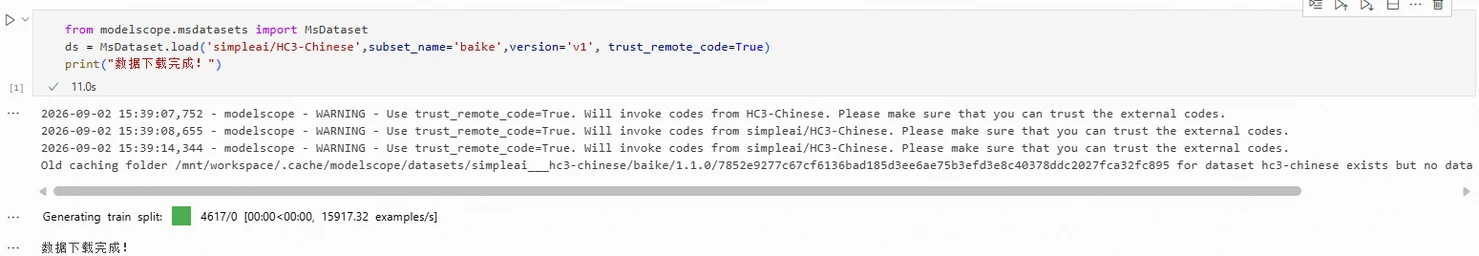
例如,读取HC3-Chinese里的baike子集。
from modelscope.msdatasets import MsDataset

ds = MsDataset.load(
    'simpleai/HC3-Chinese',
    subset_name='baike',
    trust_remote_code=True,
)
print(ds)
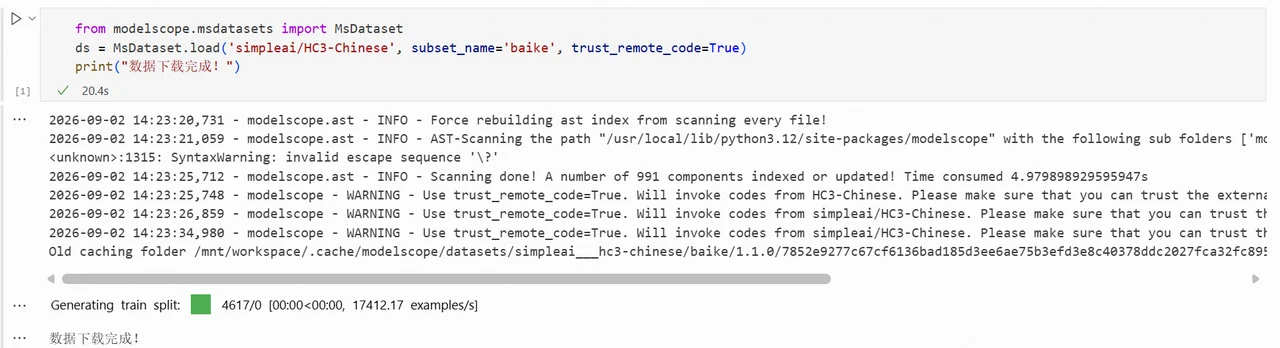
换一份数据集时,要先查它有哪些子集。baike是这里的具体名称,不能原样套到其他数据集上。
训练集和测试集,也可以分开取
子集选的是哪一类数据,split选的是数据的哪一个划分。常见的有训练集、验证集和测试集。
讨论
登录 参与讨论