开源模型还没用上,先卡在下载这一步?
开源模型还没用上,先卡在下载这一步?
早在23年,我就写过一篇文章《大模型下载使我痛苦》,
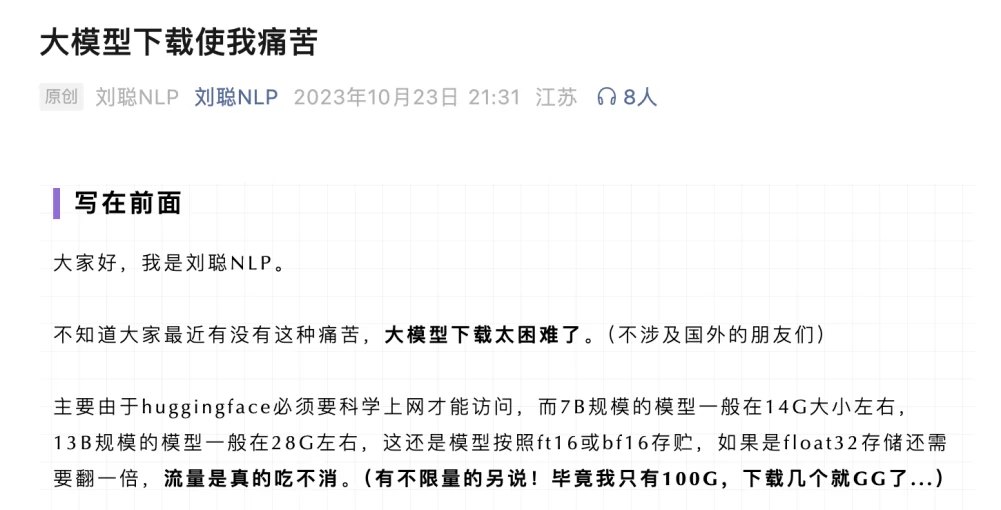
那时HF需要科学上网才能使用,模型少说十几G,流量有有限,可能有一些镜像网站,但不一定全,也不一定稳定。
现在,如果问在国内下载开源模型先去哪里,那毋庸置疑是魔搭。模型下载快,同时基本上所有国内外的开源模型都会第一时间上架,已然成为国内第一大开源模型社区(当然不止模型)。
教你如何在魔搭上找到你想要的开源模型
模型库是魔搭的基础功能模块,平台按任务类型(如文本生成、图像分类、语音识别等)对模型进行分类组织,支持关键词检索与多维度筛选。

已经知道模型名字,可以直接搜索。
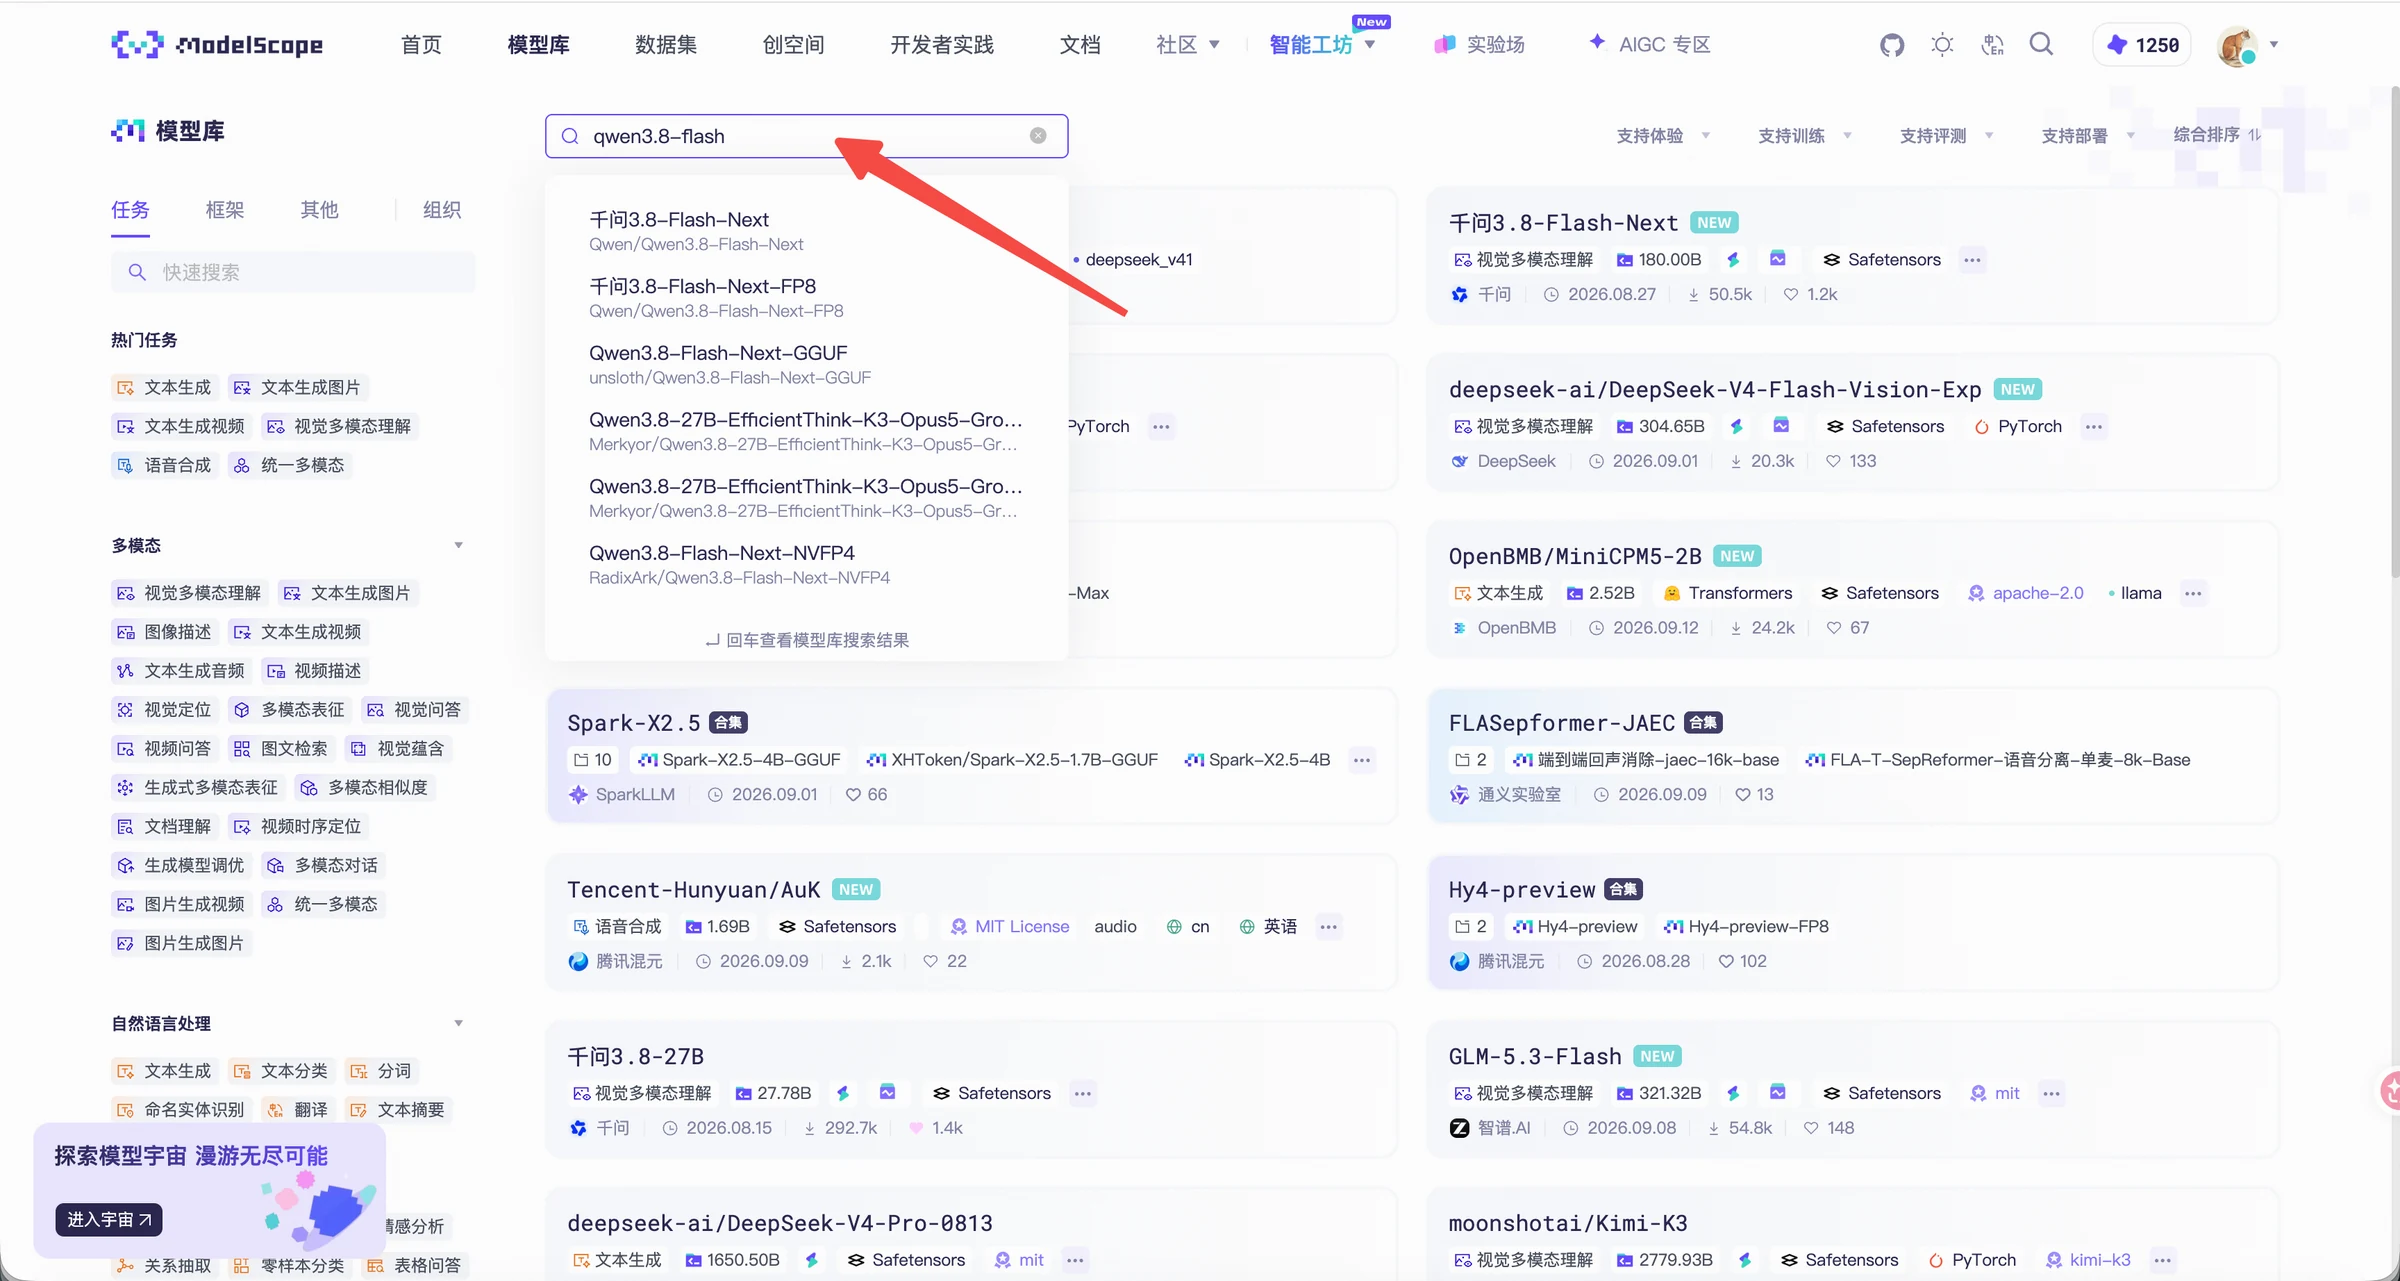
还没确定用哪个,就先想清楚要让模型做什么。
比如,想把录音转成文字,就从可以语音识别开始找,再结合语言、参数规模、运行框架和许可证,逐步缩小范围,
具体想找到适合你业务的模型,可以看【把业务问题翻译成模型任务】章节内容。
开源模型的Model Card,值得多看两眼
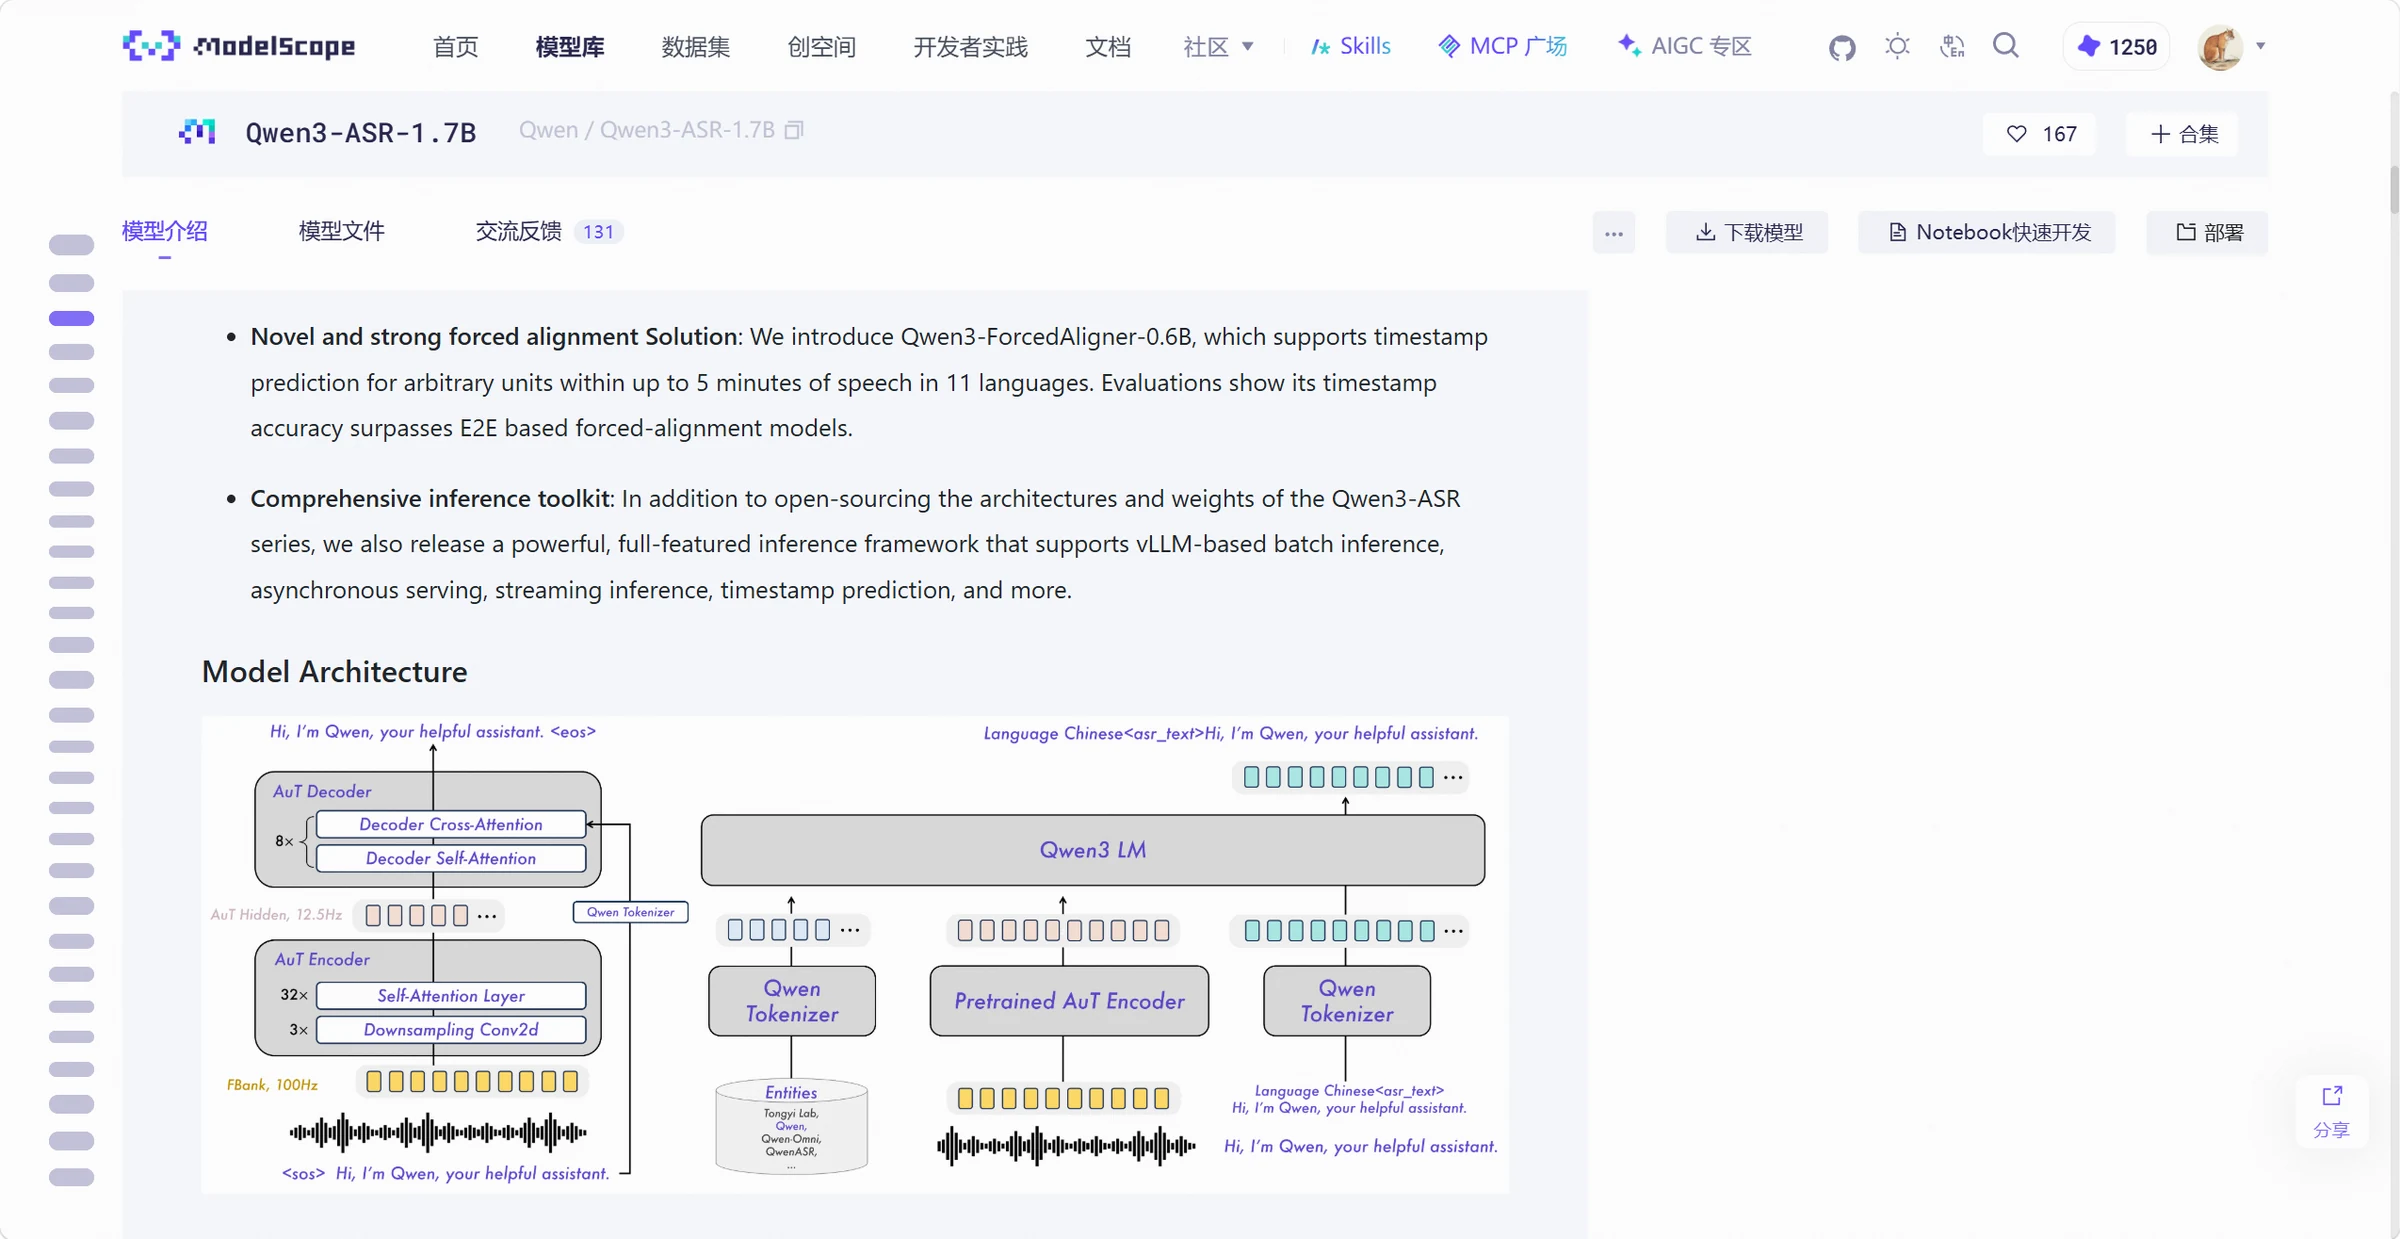
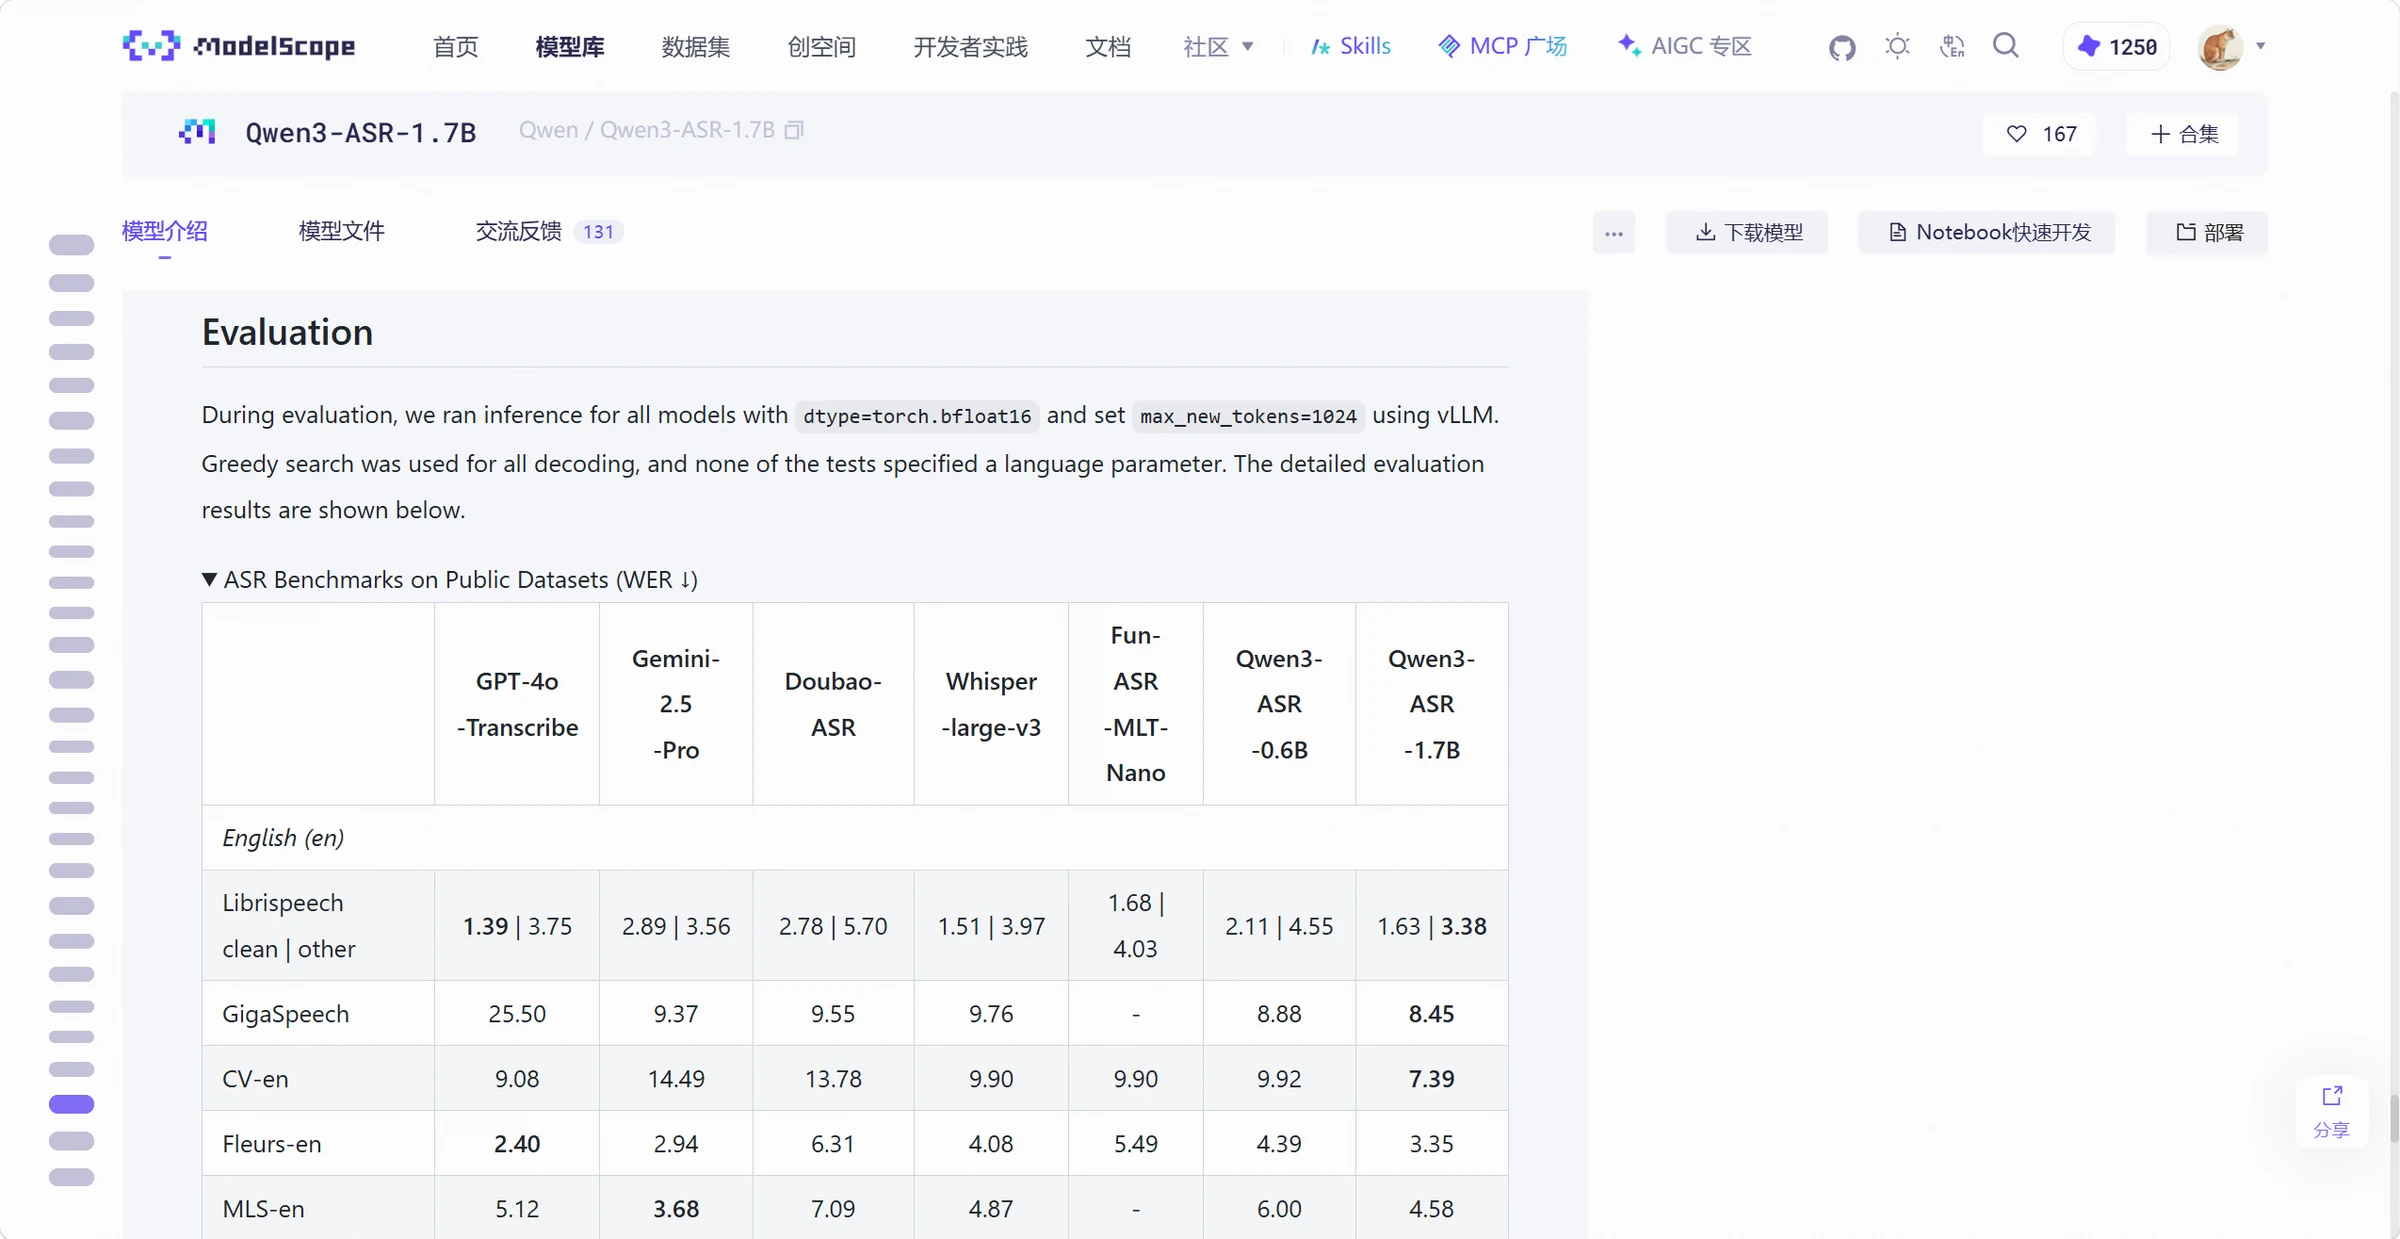
找到感兴趣的模型后,点进去看它的模型卡片。以Qwen3-ASR-1.7B为例,模型页面会把介绍、使用方法和效果评估放在一起。
先看这是什么模型,能做什么。模型名称、基本介绍和架构说明,可以帮我们确认有没有找错方向。
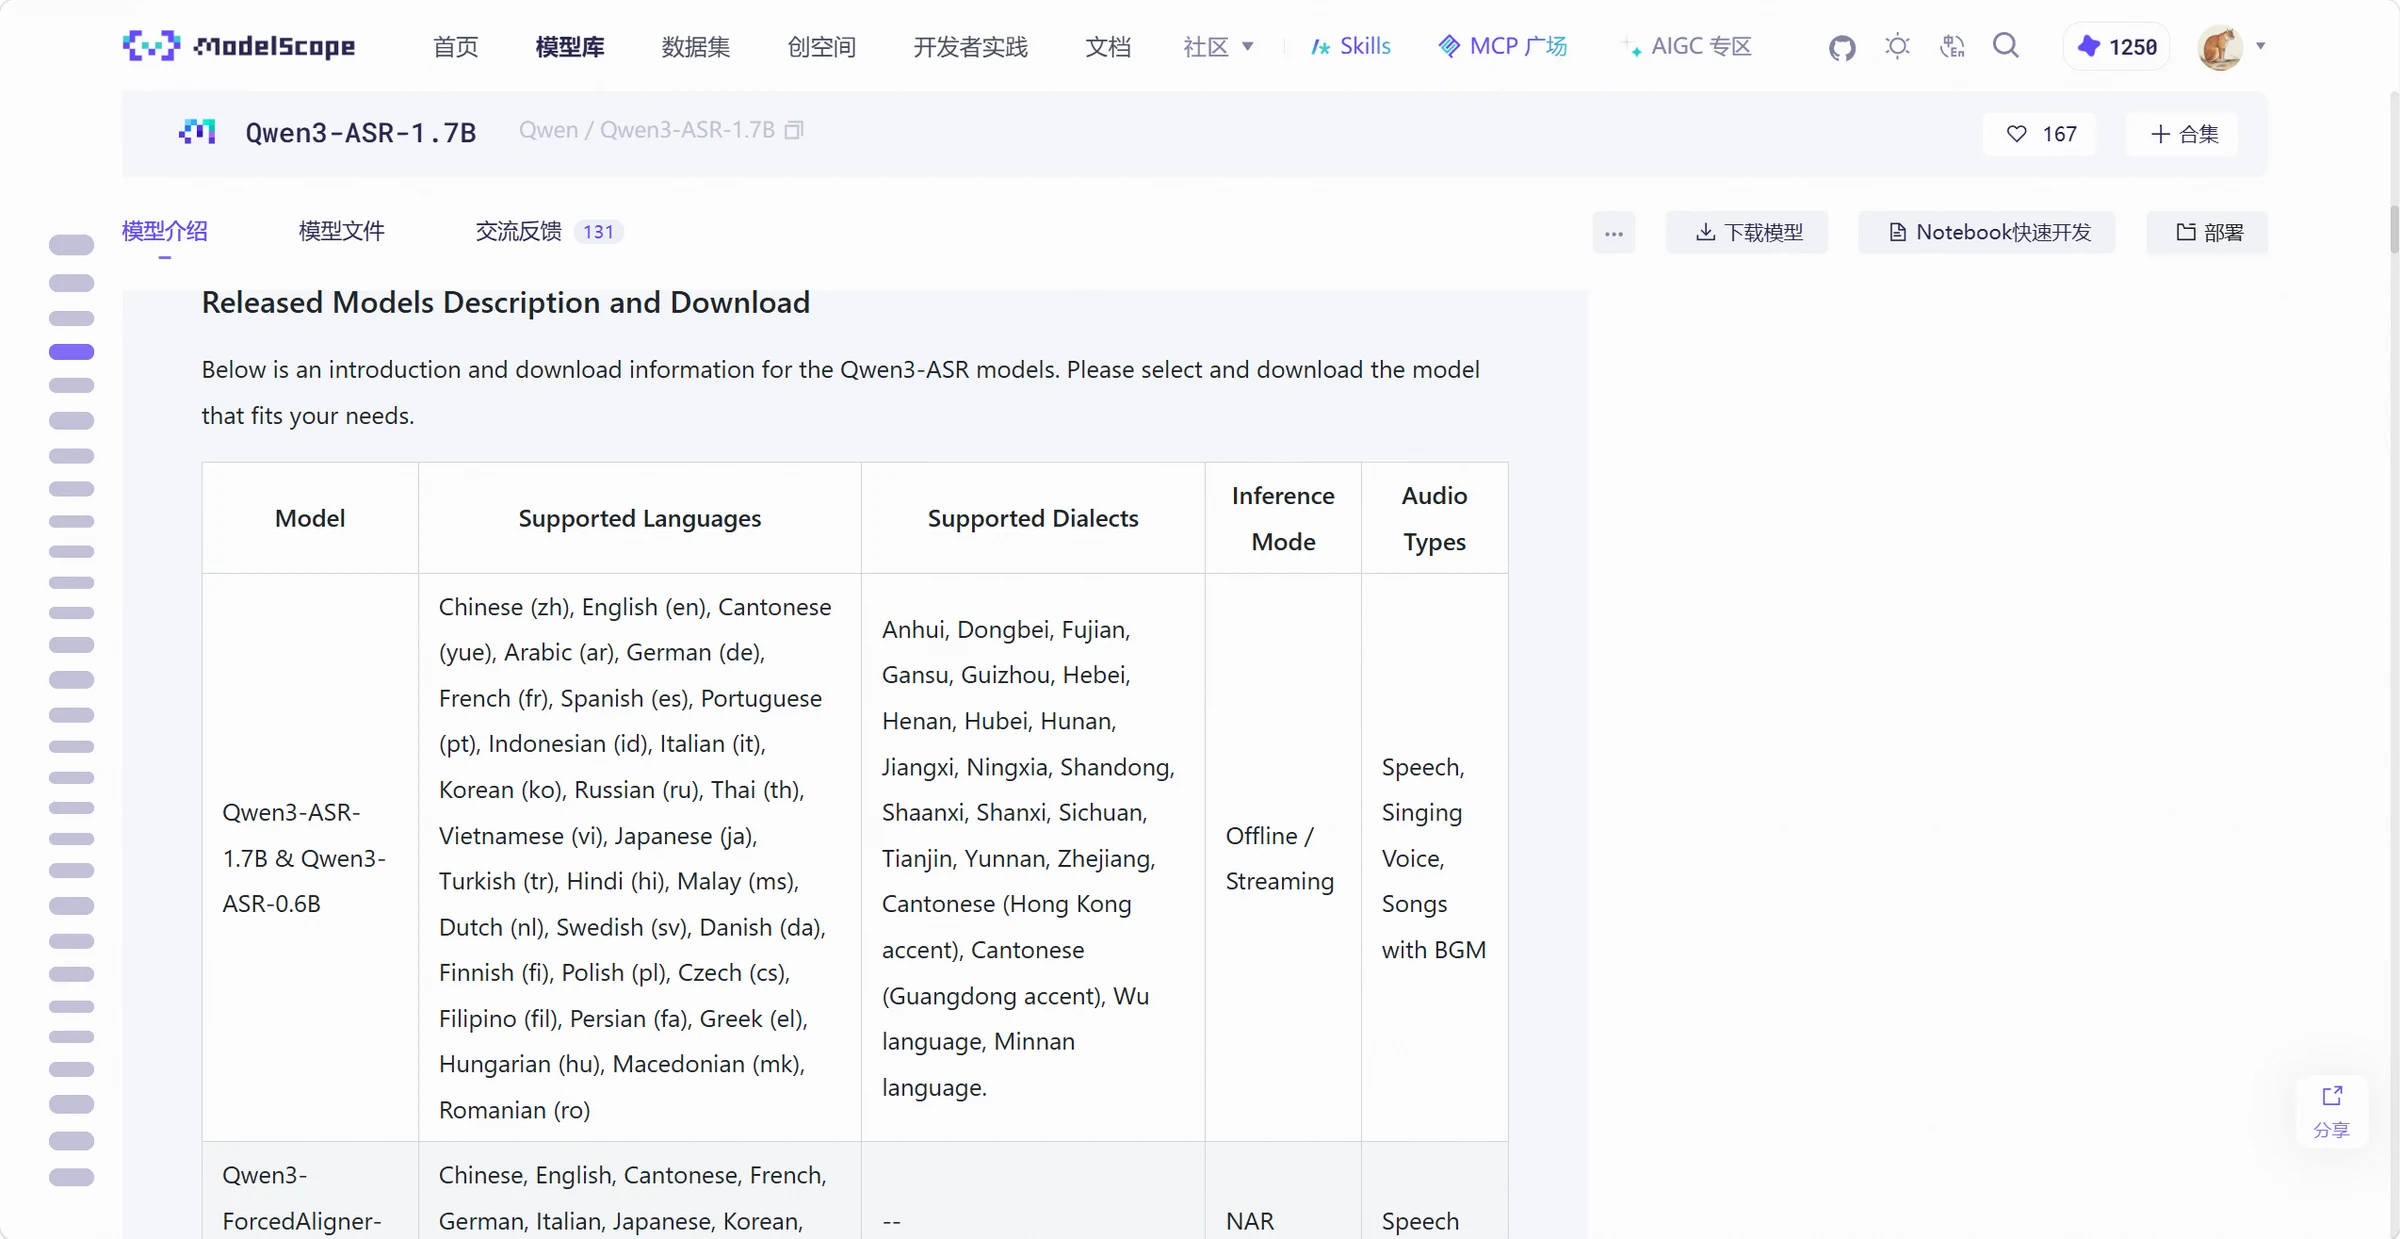
再看适用范围,支持哪些语言、适合什么输入、有哪些限制,都和自己的任务有关。
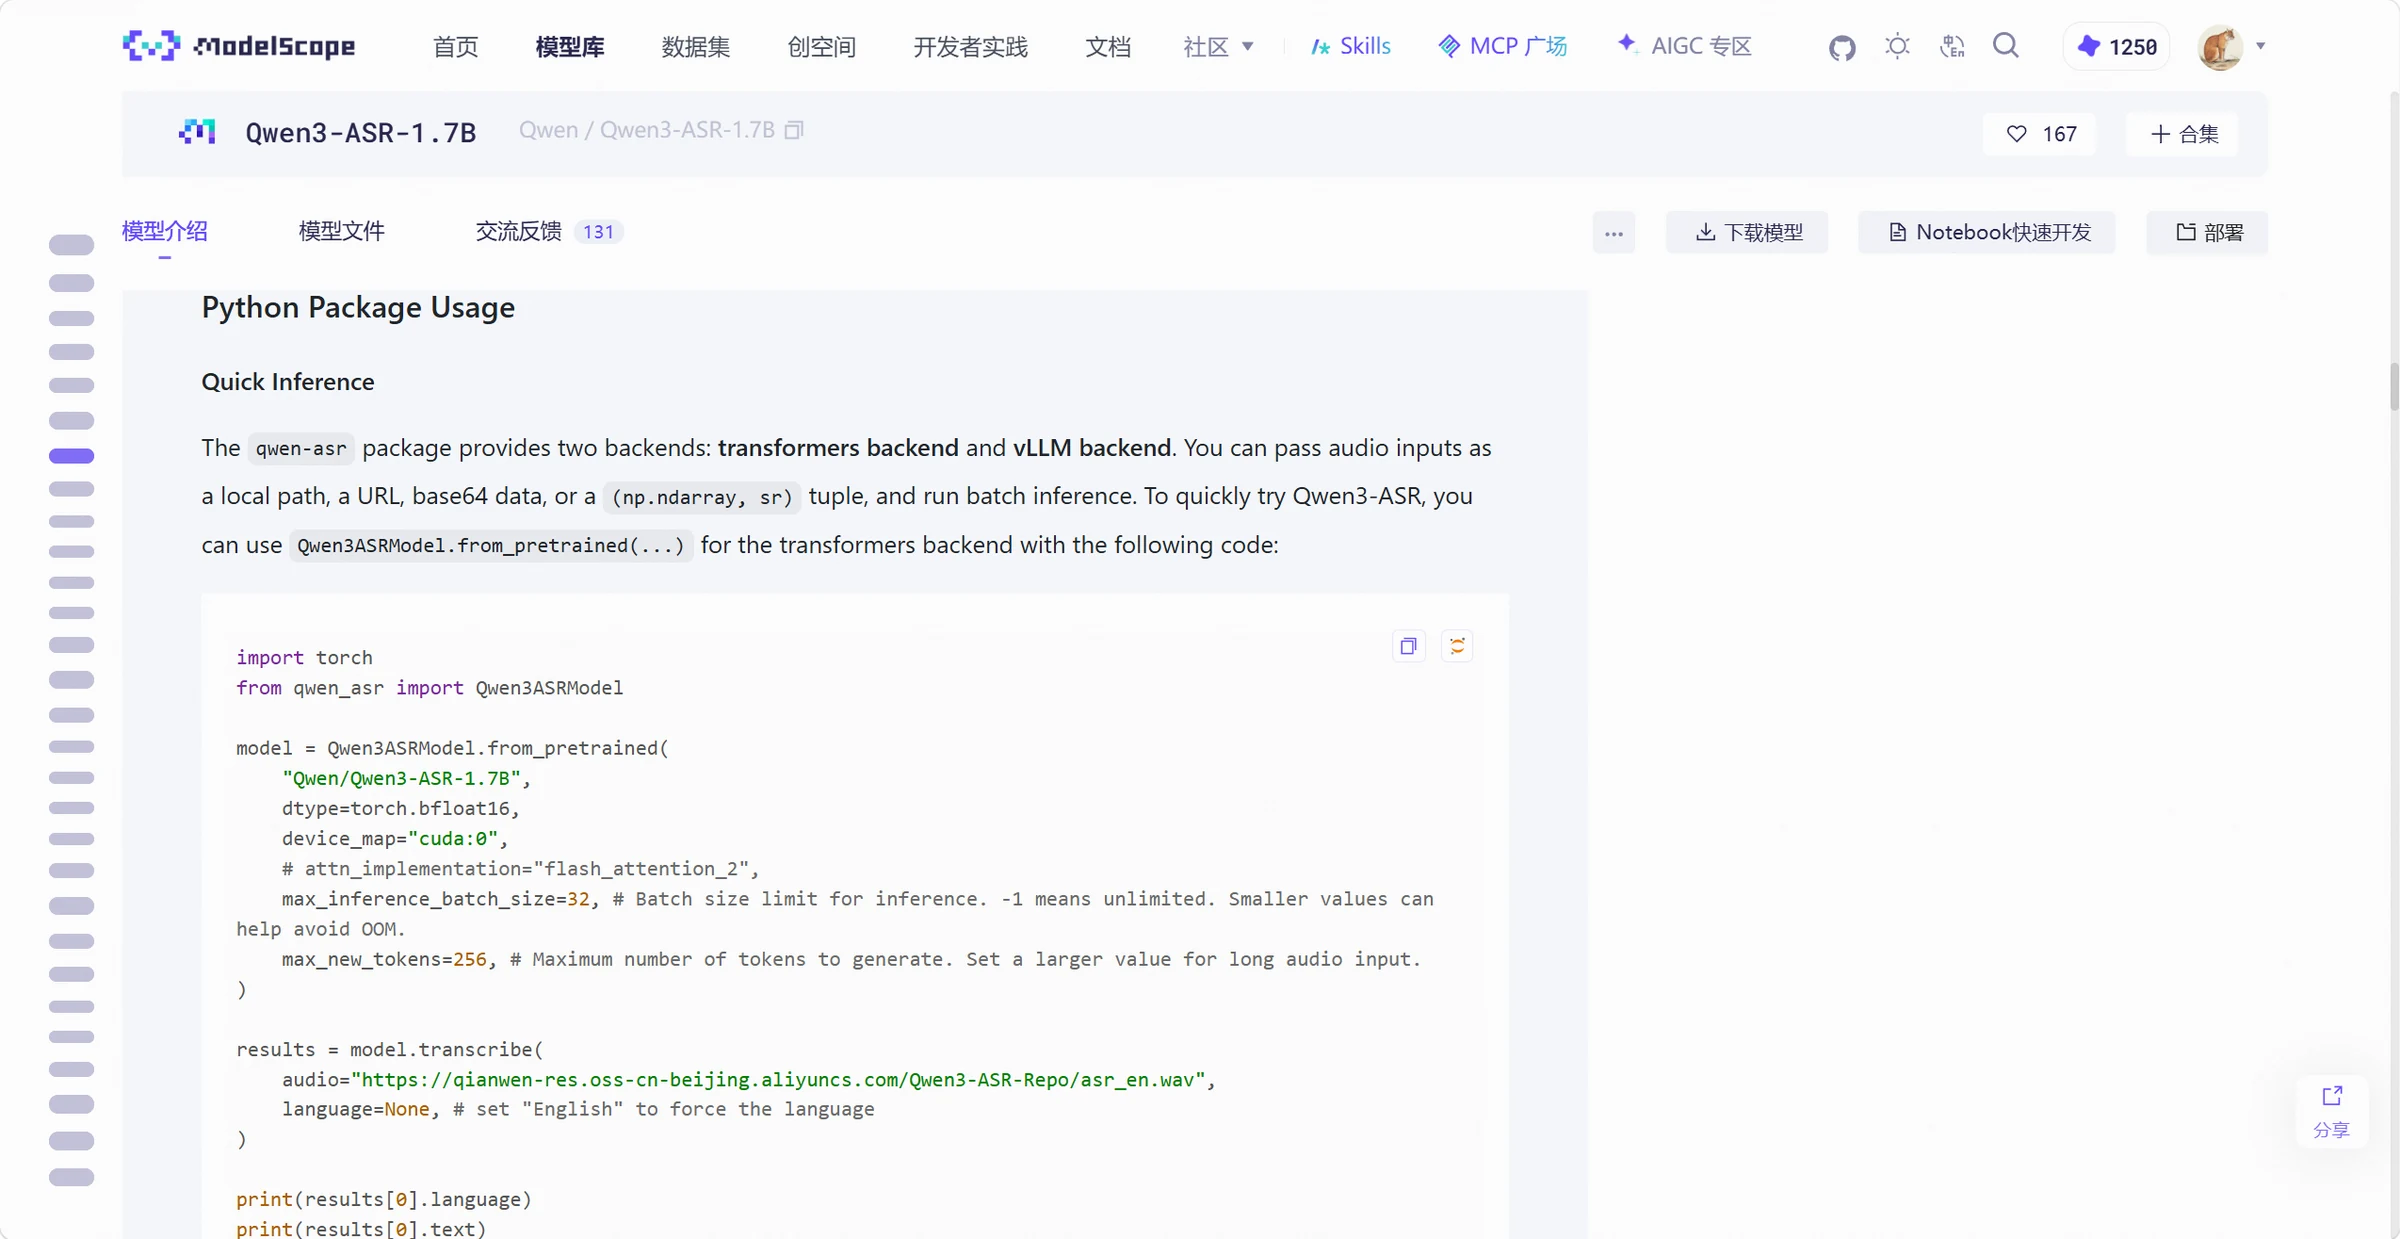
接着看使用方法,需要什么运行环境,依赖哪些工具,输入应该怎样准备,通常都能在示例中找到。下载之前读一下,可以避免文件下载完了,才发现环境部署不了。
最后看评估结果,这个模型在哪些数据上测过,比较的是什么指标,可以作为选型参考。当然具体效果怎么样,还是要拿自己真实数据试一试才知道,榜单只能作为一个参考。
模型页面还提供文件清单、版本和许可证信息,上一章提过,能使用不等于能商用,
准备商用或者继续微调时,这一步千万别跳过。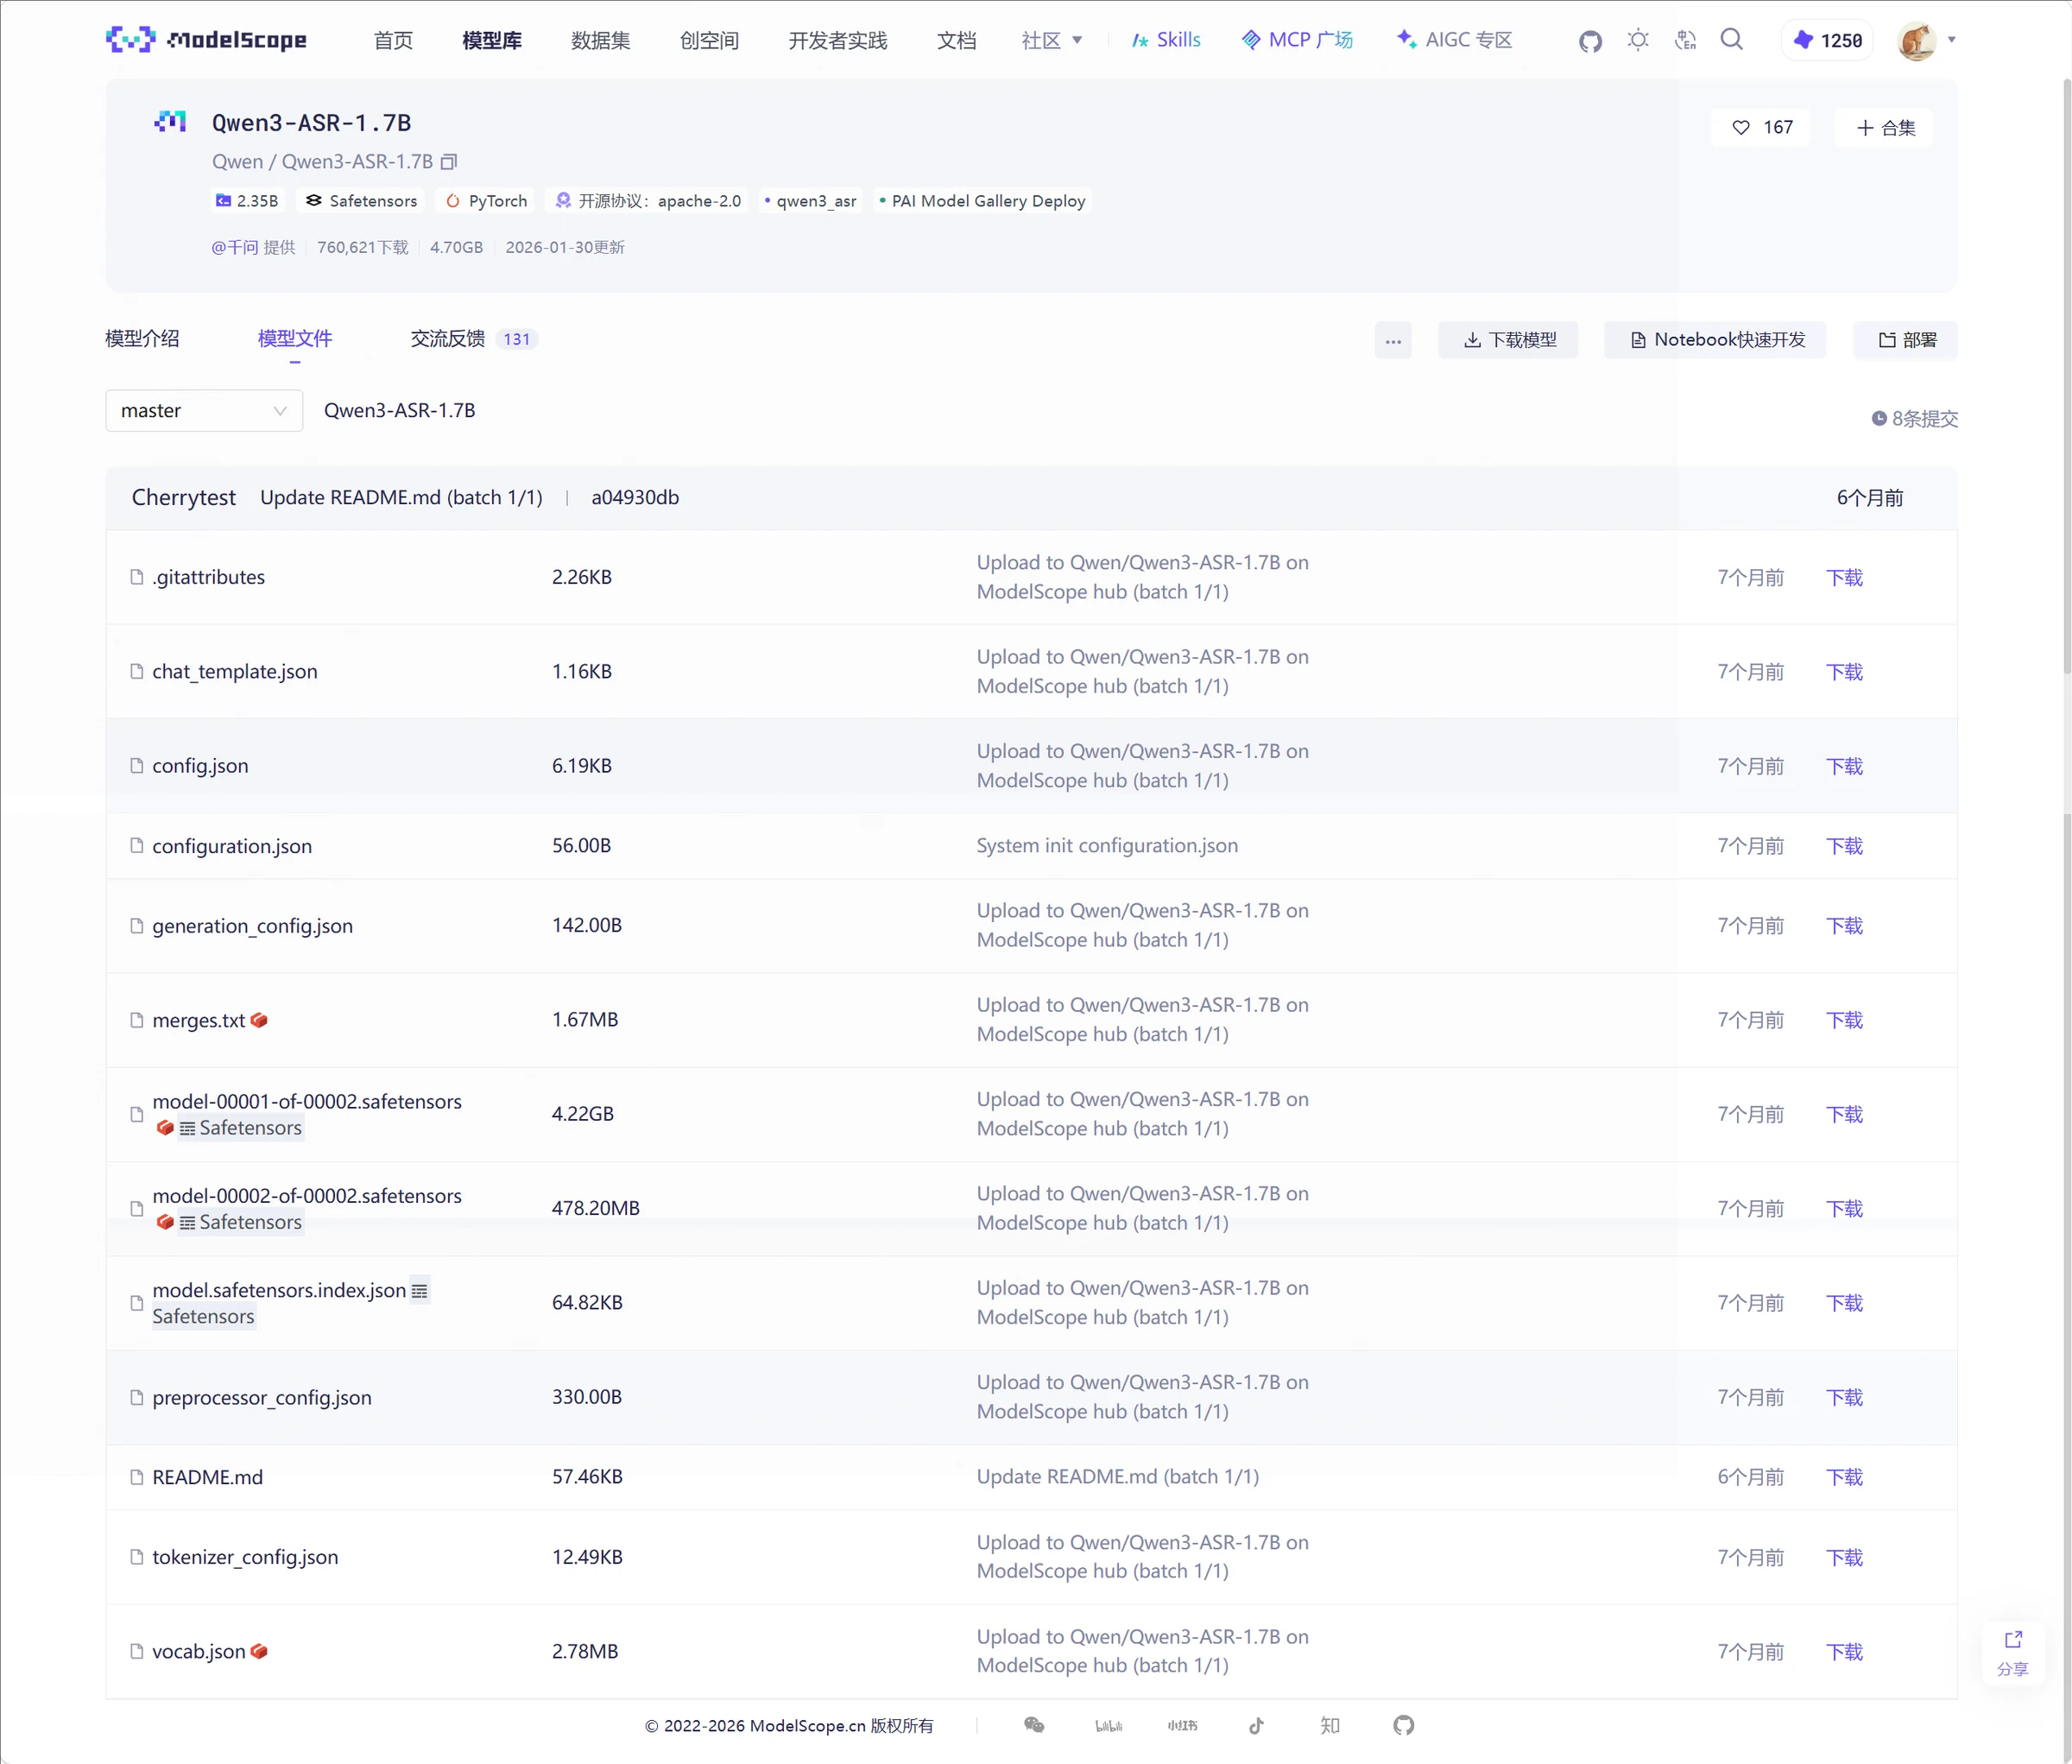
部分模型还提供在线体验入口,遇到可以直接试用的模型,也能帮助判断这个模型是否值得下载。
下载模型方式有很多,选一个喜欢的就行
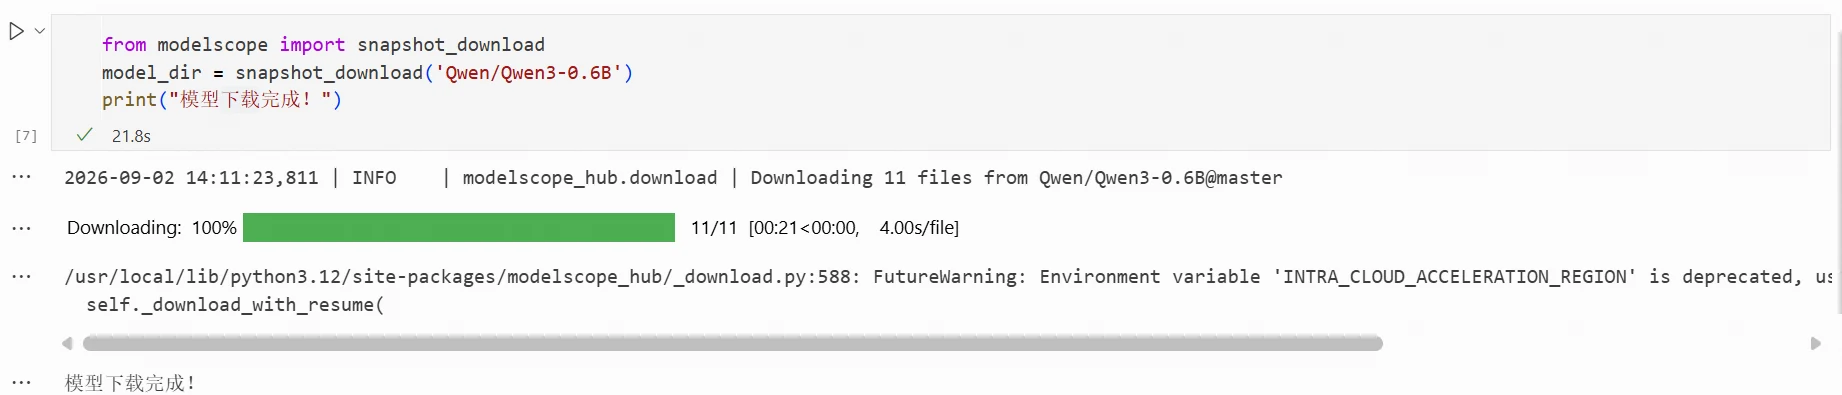
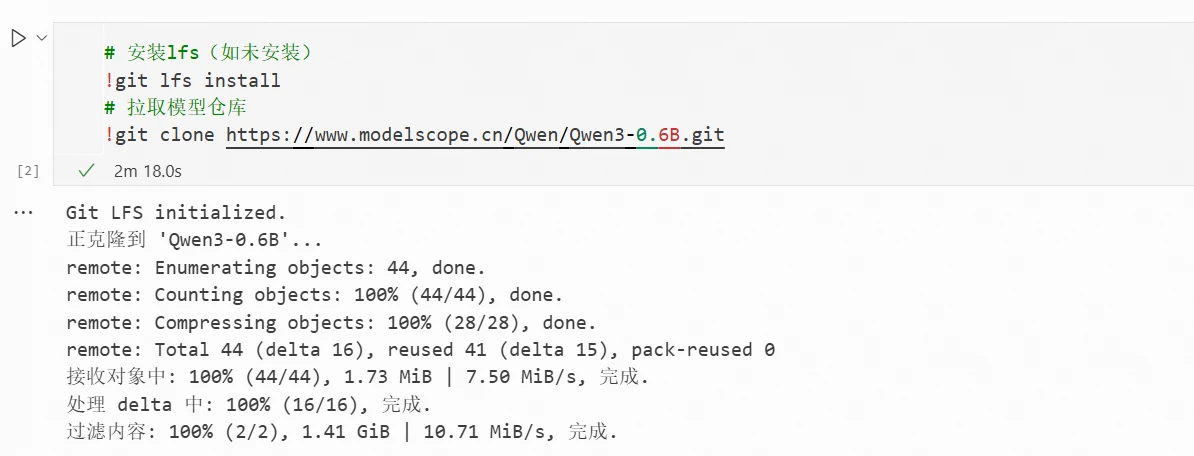
魔搭提供网页、命令行、Git和Python SDK等下载方式,下面继续用较小的Qwen/Qwen3-0.6B演示,方便第一次操作。
只想在网页上点几下
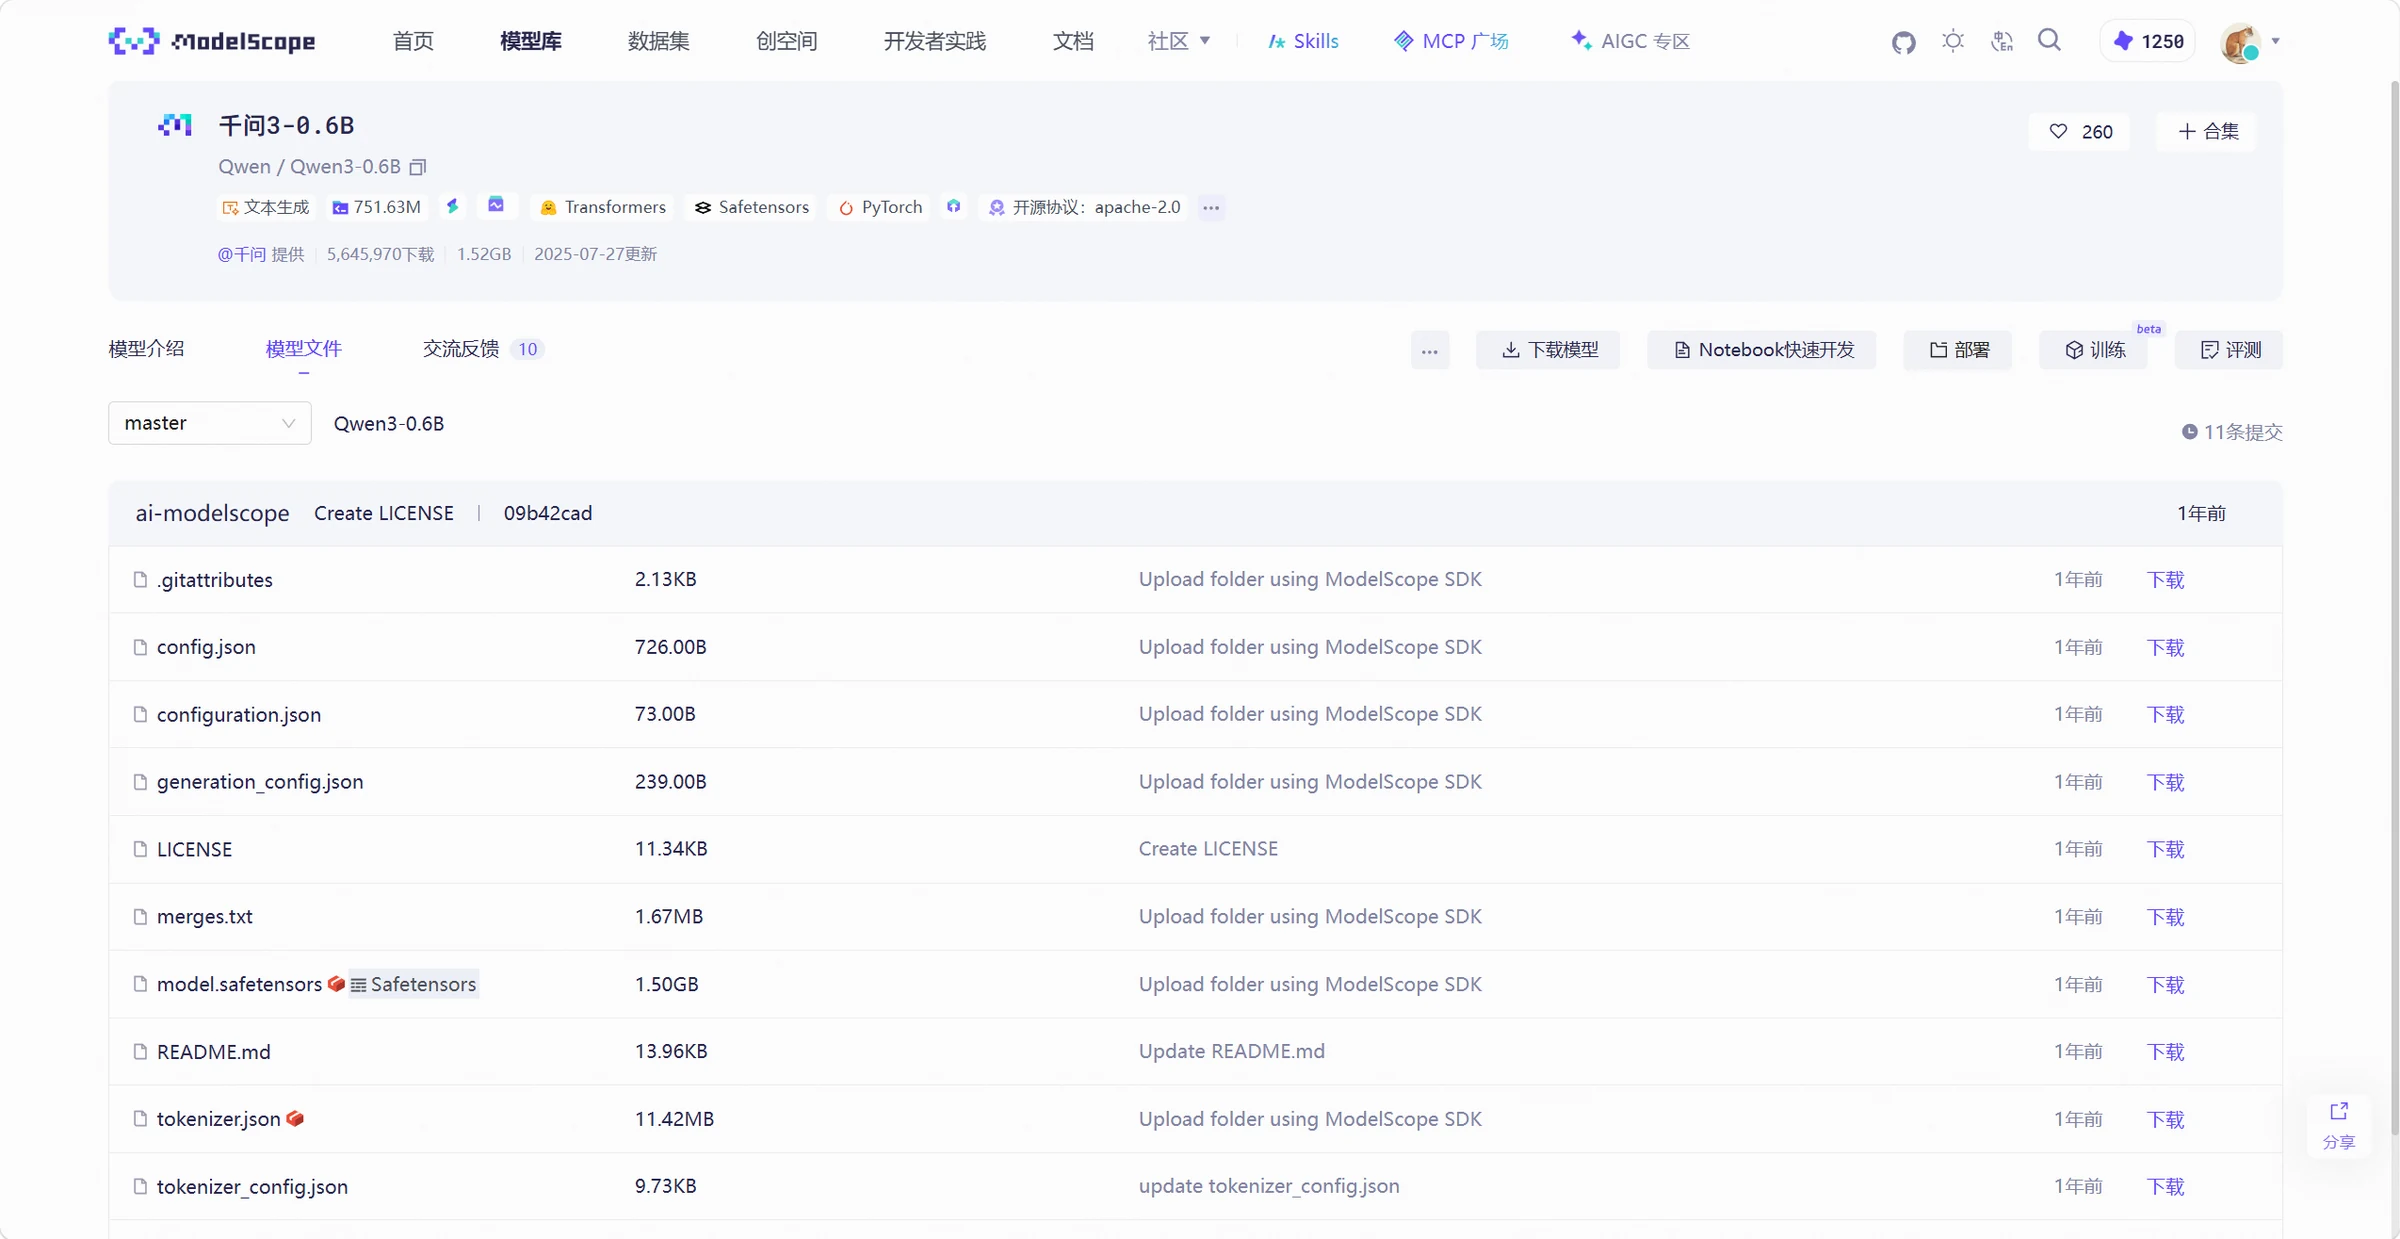
进入模型的文件页面,找到需要的文件,点击下载按钮即可。网页方式适合查看文件和下载少量内容。
通过模型页面提供的下载按钮获取文件,示例:
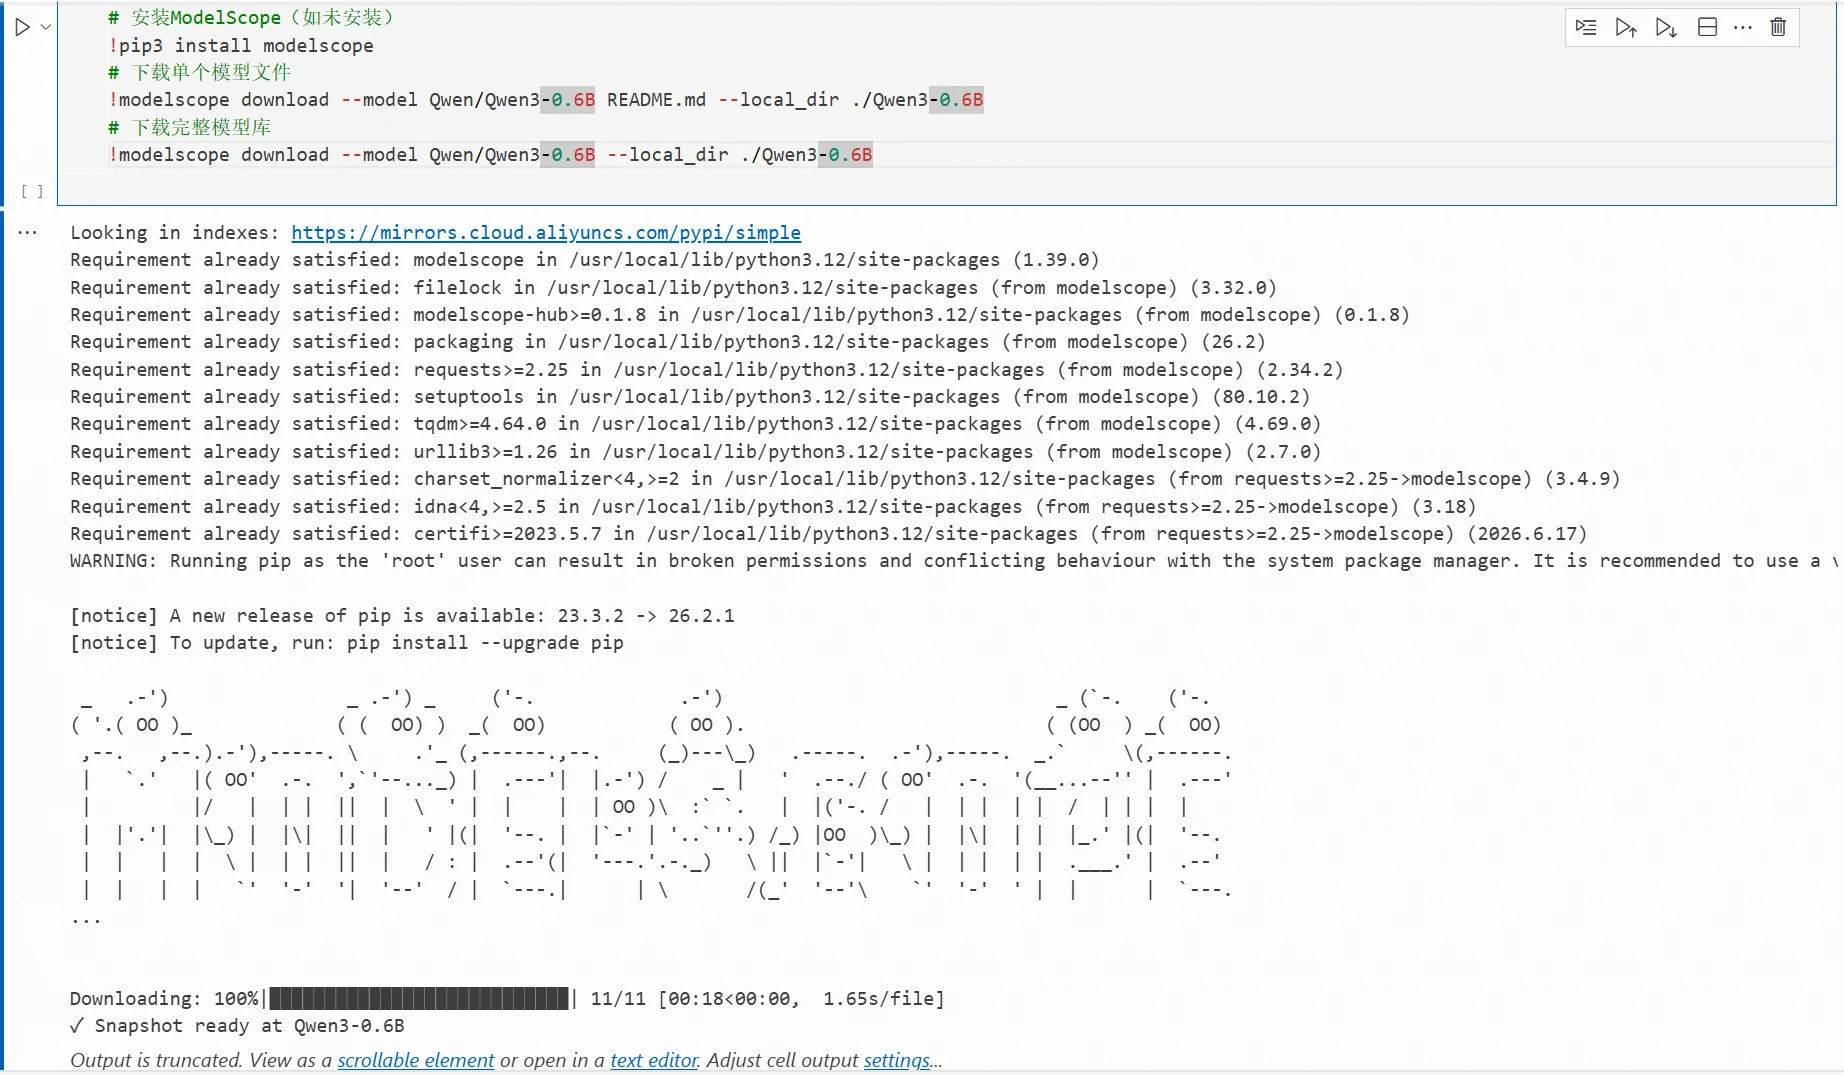
在终端里,一条命令下载
先安装最新版的ModelScope Python包,
pip install -U modelscope
只下载一个文件,可以把文件名写在模型名称后面,下面这条命令只下载说明文档,适合先检查下载是否正常。
modelscope download --model Qwen/Qwen3-0.6B README.md --local_dir ./Qwen3-0.6B
如果要下载整个模型,去掉文件名即可,
modelscope download --model Qwen/Qwen3-0.6B --local_dir ./Qwen3-0.6B
--model后面是模型在魔搭上的名称,后面是本地保存目录,换一个模型时,把这两个位置改成自己需要的值。
讨论
登录 参与讨论