当通用模型无法直接满足具体的业务需求时,可以使用自己的业务数据对模型进行微调,让模型进一步学习特定的任务和输出方式。
拿电商实体识别任务来说,我们需要模型从文本里找出商品名、品牌名、型号,给出对应类别和位置。模型聊起这些商品也许头头是道,但最终使用时,要求该提取的信息不能漏,字段要统一,输出格式也得稳定。
如果任务和输出要求已经明确,也有了整理好的示例,就可以尝试用这些数据做微调,让模型学习我们希望它完成的工作。至于要不要更新全部参数、手里的显卡够不够用,还得结合任务和资源来选。
下面就用ms-swift,从一次LoRA微调开始,把数据准备、训练、权重合并和推理依次跑通。
通用大模型本身已经具备较强的语言理解、知识问答、文本生成等通用能力。但在实际业务中,通用模型的表现并不一定能够直接满足具体需求。
例如,我们希望模型能够准确完成某类信息抽取任务、并按照规定的格式输出结果,或者采用统一的方式回答特定问题。针对这些需求,可以在已有模型的基础上,使用特定数据进行训练,从而使模型进一步学习相应的任务要求和回答方式,其实这个过程就称为模型微调(Fine-tuning)。
微调并不是重新训练一个模型,而是在模型已有能力的基础上进一步调整,让它更加适合具体的应用场景。与从头训练大模型相比,微调需要的数据和计算资源通常更少。
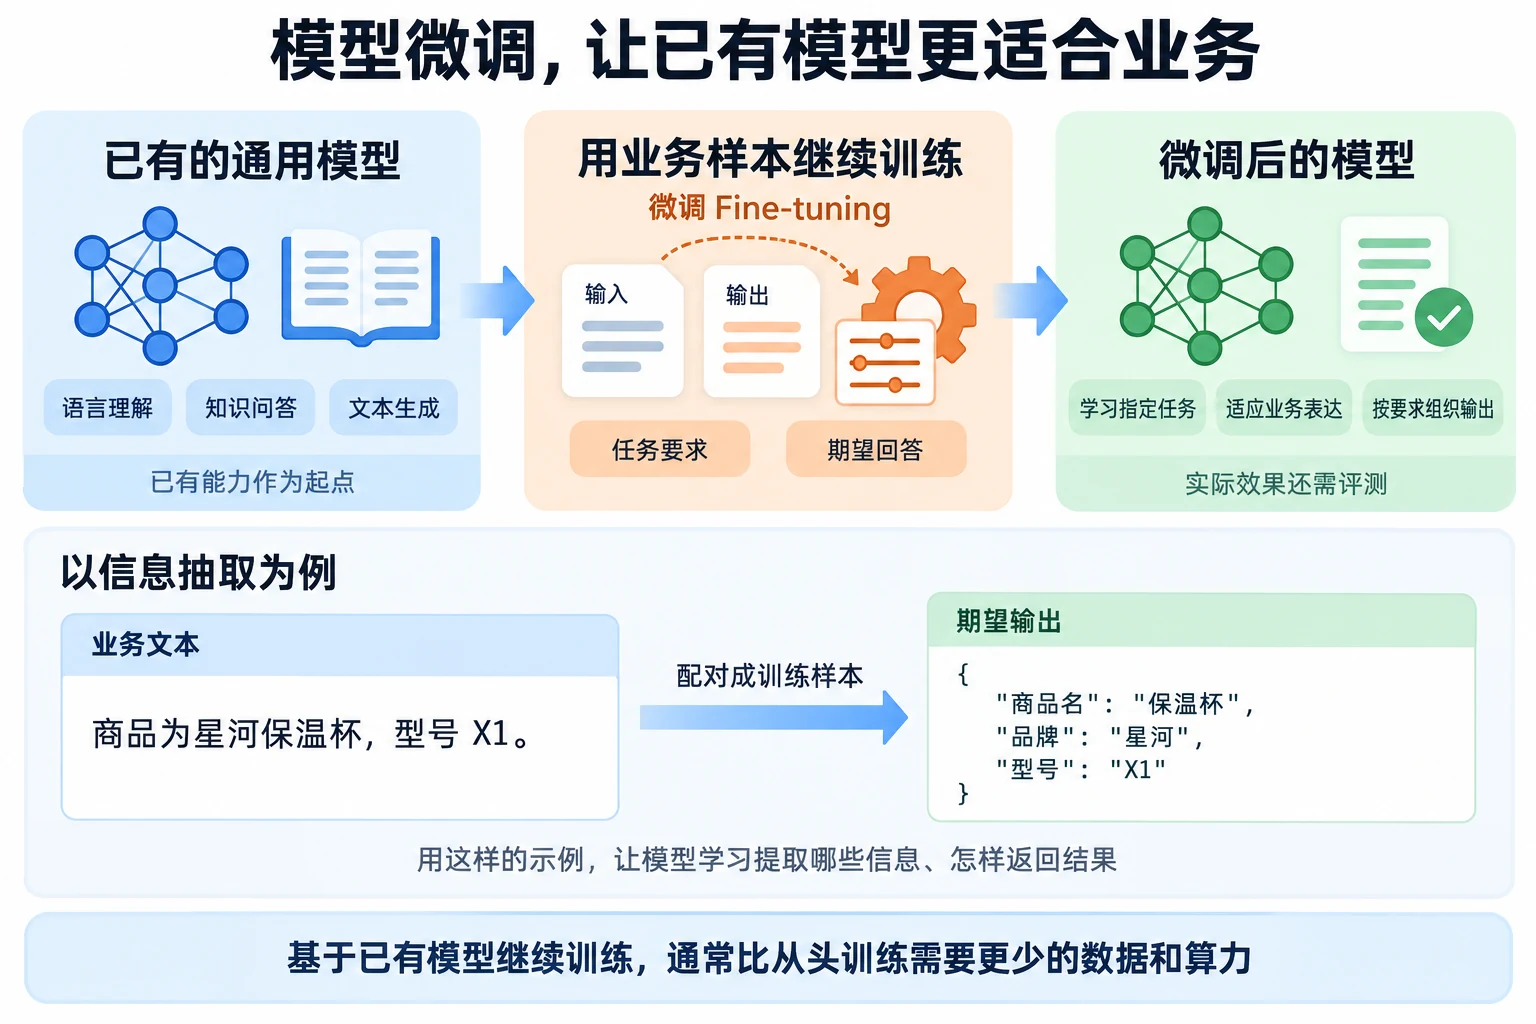
目前,大模型微调中比较常见的方法是 SFT(Supervised Fine-Tuning,监督微调)。SFT 使用带有标准答案的数据对模型进行训练,每条训练数据通常包含输入和对应的输出,让模型学习在给定输入后应该生成什么样的结果。例如,在信息抽取任务中,可以将一段文本作为输入,将正确的字段抽取结果作为输出。SFT比较适合能够准备明确训练样本的任务,例如文本分类、信息抽取、问答和固定格式生成等。
除了SFT之外,大模型训练还可以使用强化学习(Reinforcement Learning,RL)。与SFT直接提供标准答案不同,强化学习主要通过奖励信号来评价模型生成结果的好坏,并根据奖励结果不断调整模型的输出行为。SFT 和强化学习都属于大模型的后训练(Post-training)阶段。后训练是指模型完成大规模预训练之后,为了进一步提升指令遵循、推理以及特定任务能力而进行的一系列训练。大模型训练通常会先通过 SFT 学习如何按照指令完成任务,再结合强化学习等方法进一步优化模型的回答质量和行为表现。
根据训练方式和硬件资源的不同,可以选择LoRA、QLoRA或者全参数微调等方式,不同方式在训练参数量、显存占用和计算成本等方面存在一定差异。
1、全参数微调(Full Fine-Tuning),在训练过程中,模型的全部参数都会参与更新,因此模型能够进行较为充分的调整。全参数微调需要的显存和计算资源也会明显增加,训练成本较高。
2、LoRA微调(Low-Rank Adaptation),为了降低大模型微调对硬件资源的要求,LoRA的核心思想是通过冻结预训练模型的权重,并将可训练的秩分解矩阵注入到Transformer架构的每一层,从而显著减少下游任务中可训练参数的数量。在训练过程中,只需要固定原始模型的参数,然后训练降维矩阵A和升维矩阵B。LoRA的相关示意图如图所示。
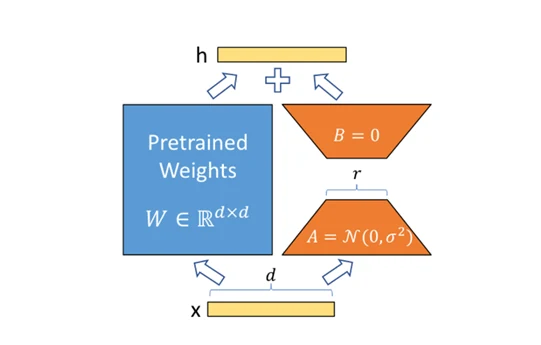
具体来看,假设预训练的矩阵为$W_0 \in \mathbb{R}^{d \times k}$ ,它的更新可表示为:
W = W_0 + \Delta W = W_0 + BA
其中,$\Delta W$表示微调过程中需要学习的权重变化,
B \in \mathbb{R}^{d \times r}, \quad
A \in \mathbb{R}^{r \times k}, \quad
r \ll \min(d,k)
,A和 B是 LoRA 新增并参与训练的参数,模型训练完成后,会得到一个单独的 LoRA Adapter 文件,保存本次微调得到的参数。使用时,需要将基础模型和对应的 Adapter 一起加载。
3、QLoRA微调(Quantized LoRA),LoRA 主要减少的是训练参数带来的资源开销,基础模型本身仍然需要加载到显存中。如果模型规模较大,加载基础模型依然可能占用较多显存。为了进一步降低显存需求,可以使用 QLoRA微调.
相关模型架构如图所示,从图中可以看出,QLoRA是针对LoRA的改进,而改进的主要模式是采用4-bit精度和分页优化来共同减少模型的显存消耗。
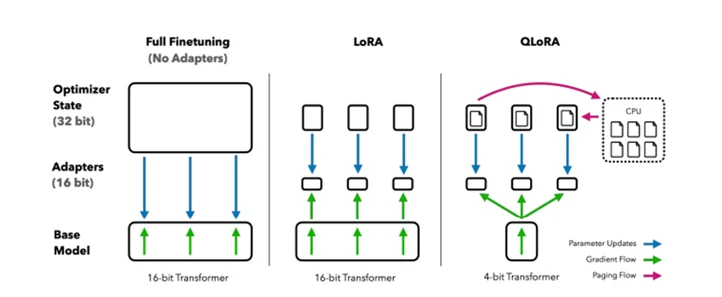
QLoRA 可以简单理解为量化与 LoRA 的结合。它将基础模型以较低精度进行量化,QLoRA的创新内容主要如下:
1)4bit NormalFloat(NF4),NF4是一种新型数据类型,它对正态分布的权重来说是信息理论上的最优选择;
2)双重量化技术,双重量化减少了平均内存使用,它通过对已量化的常量进行再量化实现此目的;
3)分页优化器,分页优化器使用有助于管理内存峰值,防止梯度检查点时出现内存不足的错误。
登录 参与讨论
选择哪种微调方式,主要需要综合考虑模型规模、任务需求、GPU 资源和训练成本。不同方式各有适用场景,并不是更新的模型参数越多,微调效果就一定越好。对于大多数微调任务,可以优先尝试 LoRA。LoRA 只需要训练少量新增参数,对 GPU 显存和计算资源的要求相对较低,训练得到的 Adapter 文件也比较小,便于保存。
如果基础模型规模较大,即使采用 LoRA,加载模型后仍然没有足够的显存进行训练,可以进一步考虑 QLoRA。QLoRA 通过量化降低基础模型本身的显存占用,使较大的模型也能够在有限的 GPU 资源下进行微调。QLoRA 更适合模型规模较大、GPU 显存有限的场景。
如果 GPU 资源比较充足,并且任务需要对模型进行更充分的调整,则可以考虑全参数微调。由于训练过程中需要更新模型的全部参数,全参数微调对显存、计算资源和训练数据的要求都更高,训练和保存模型的成本也更大,因此通常需要结合实际任务判断是否有必要采用。
在实际项目中,我们可以先用较低的成本验证效果,再根据实际需求选择是否增加训练成本。 如果 LoRA 已经能够达到预期效果,通常没有必要仅仅为了更新更多参数而选择全参数微调。
ms-swift(SWIFT,Scalable lightWeight Infrastructure for Fine-Tuning)是 ModelScope 社区开源的大模型训练与部署框架,主要面向大语言模型和多模态大模型,提供从模型训练、微调到推理、评测和部署的一整套工具。

目前已经支持 Qwen、DeepSeek、Llama、GLM、InternLM 等主流大语言模型,以及 Qwen-VL、InternVL 等多模态模型,同时支持Embedding、Reranker 和文本分类等模型或任务的训练。
可以在ms-swift查看更多使用方法。
除了训练之外,ms-swift 还提供了比较完整的模型使用流程。训练完成后,可以直接使用 swift infer 进行模型推理,也可以通过 swift deploy 将模型部署为 OpenAI 兼容的 API 服务。在推理和部署方面,还可以结合 vLLM、SGLang、LMDeploy 等推理引擎进行加速。
对于初学者来说,ms-swift 的一个特点是将大模型训练过程中很多复杂的配置进行了统一封装。通过命令行参数指定基础模型、训练数据、微调方式以及训练参数,就可以完成一次模型微调。在下面的实验中,我们将使用 ms-swift 完成一次完整的模型微调流程,包括准备训练数据、启动 LoRA 训练、查看训练结果、合并 LoRA 权重以及加载微调后的模型进行推理和部署。
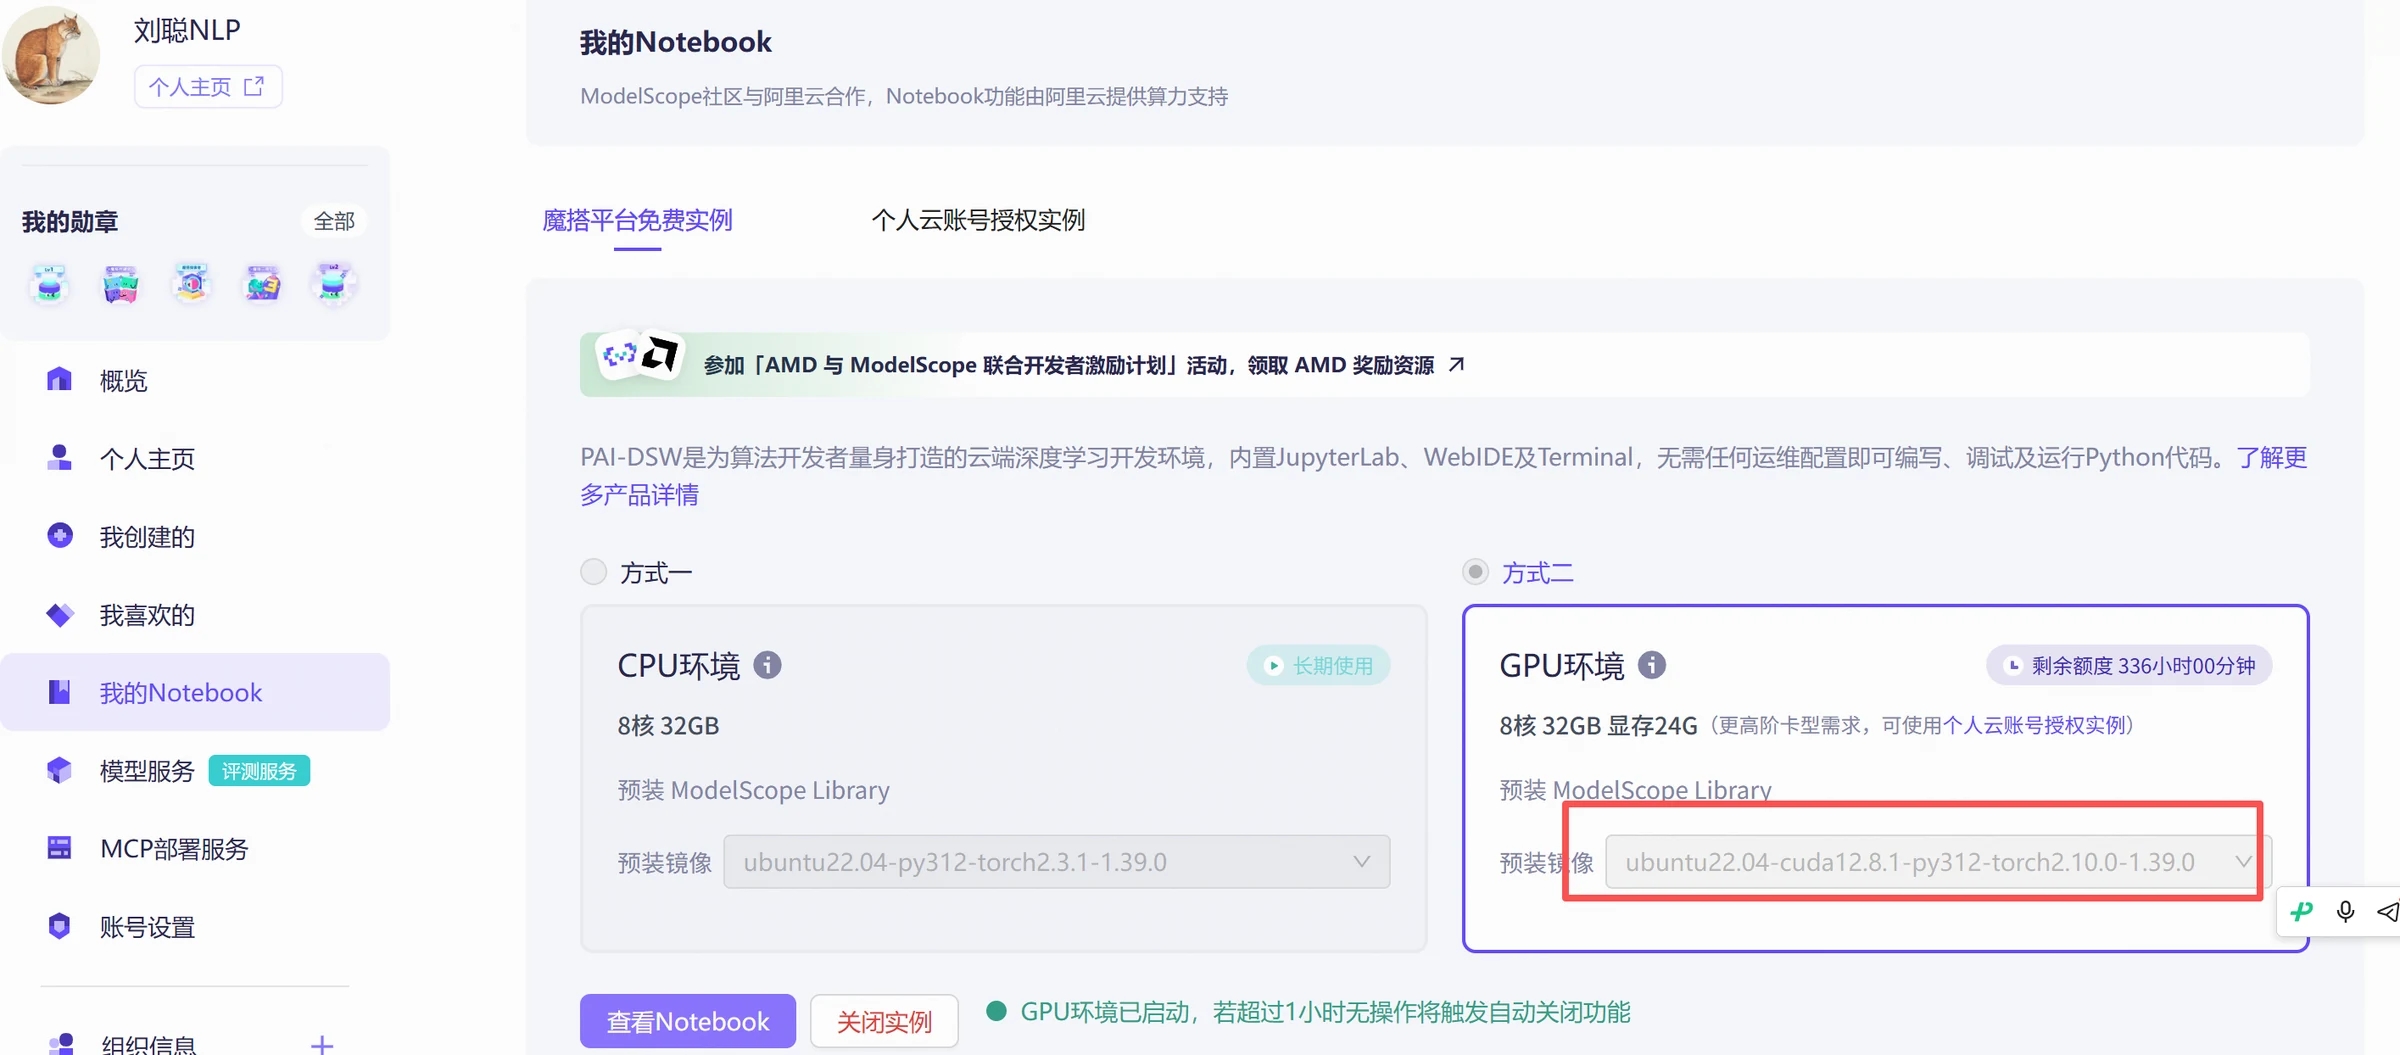
下面将以一个实体识别任务为例,在 ModelScope Notebook 环境中演示完整的模型微调流程,包括数据准备、模型训练以及微调后的模型推理等步骤。通过这个示例,可以了解如何使用 ms-swift 从零开始完成大模型微调。本实验继续使用 ubuntu22.04-cuda12.8.1-py312-torch2.10.0-1.39.0 镜像作为运行环境。

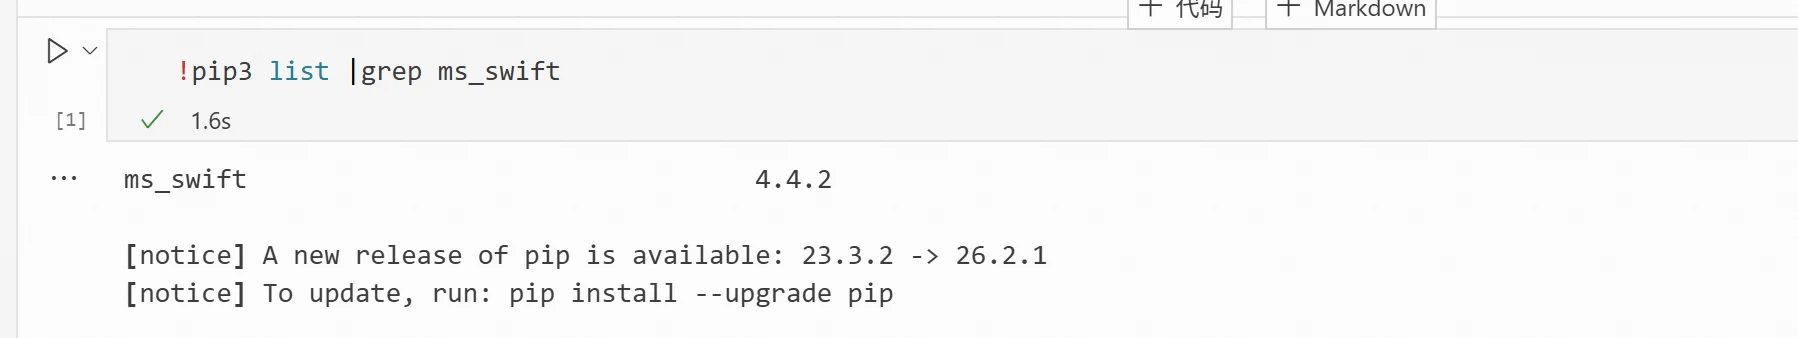
1) 查看环境中是否已经安装ms-swift,,注意安装包是ms_swift
!pip3 list |grep ms_swift
显示下面这种形式,说明已经安装了ms-swift

如果没有安装,则执行
!pip3 install ms-swift
2)数据准备,本次实验的数据采用的是开源数据,电商实体识别,数据集包含四种实体类型:HCCX 商品名,HPPX 品牌名,XH 商品型号,MISC 表示其他实体,包括国家、尺寸容量、人物、作品及活动名称等。
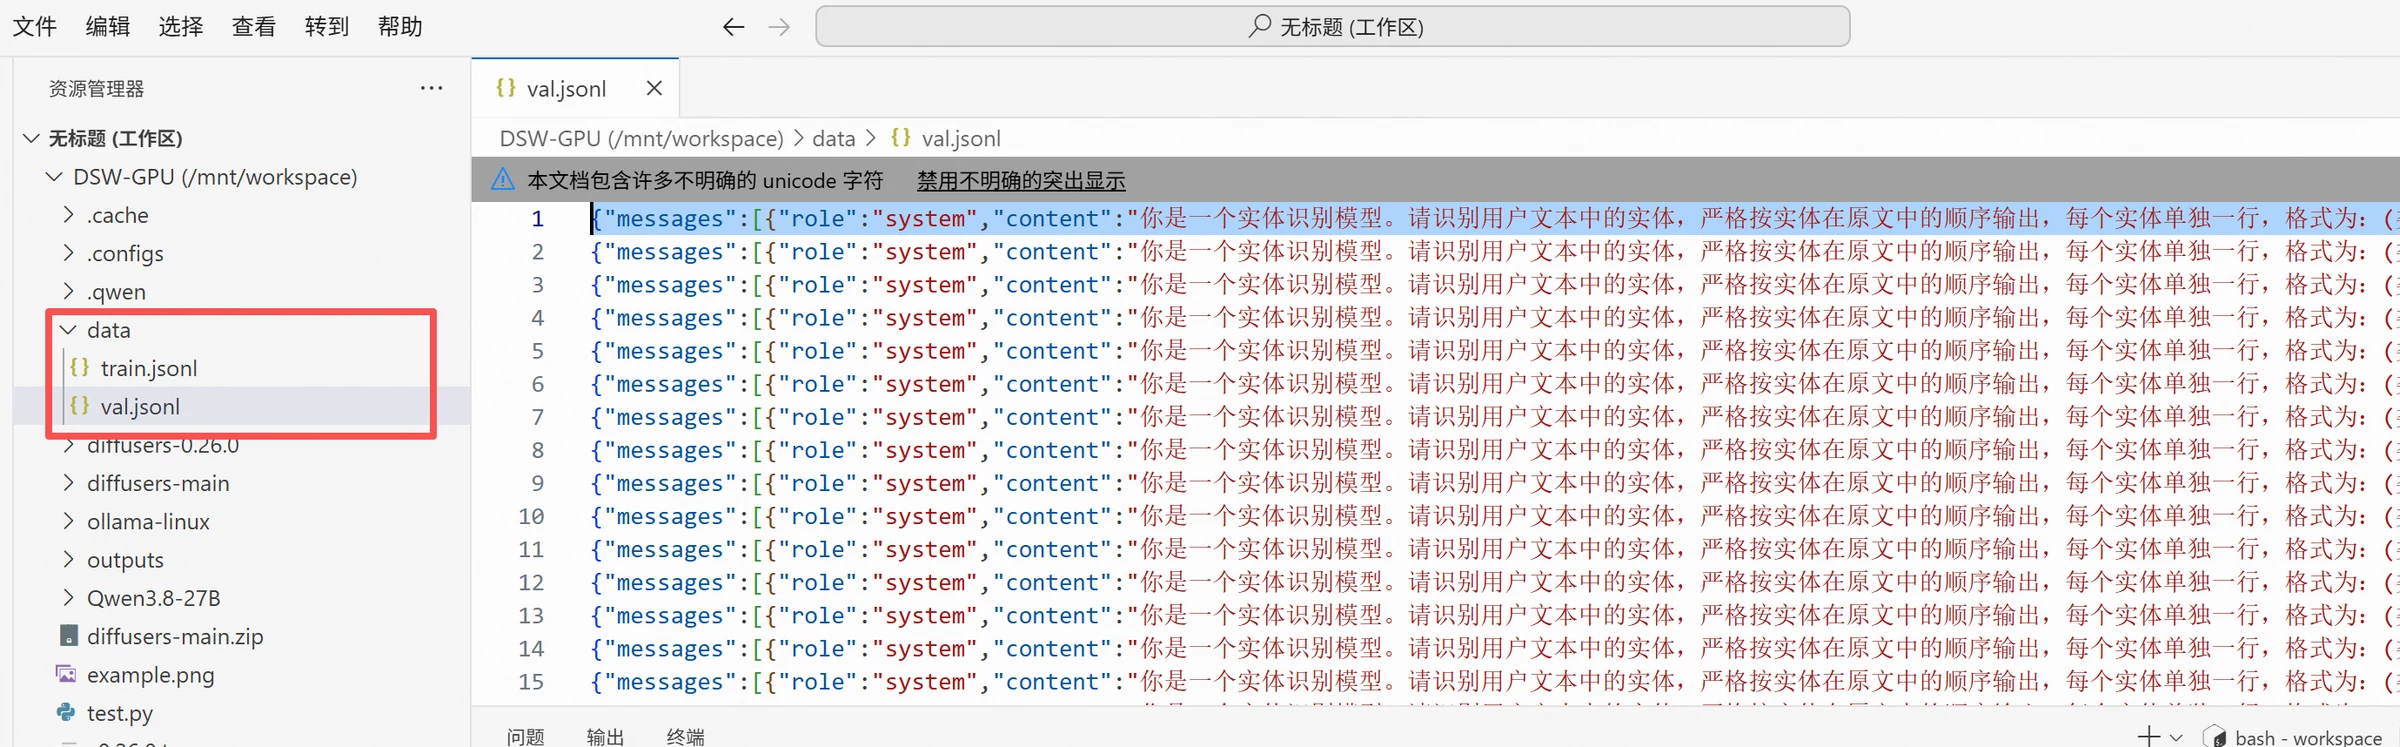
3)首新建一个目录data,然后把数据右击上传至文件夹中,数据形式如下,这个任务只要求模型输出实体类别,实体,以及实体在文本中对应的起始位置,数据划分为训练集和测试集,其中train.jsonl为5400 条,val.jsonl为600 条。
{"messages":[{"role":"system","content":"你是一个实体识别模型。请识别用户文本中的实体,严格按实体在原文中的顺序输出,每个实体单独一行,格式为:(类型,实体文本,起始位置)。起始位置从0开始;类型只能是HCCX、HPPX、MISC、XH之一。没有实体时只输出:无实体。不要输出解释、Markdown或其他内容。"},{"role":"user","content":"推bb护肤刮痧l背疗橄榄油全身按开背足体按油身m油5摩油摩精00"},{"role":"assistant","content":"(HCCX,橄榄油,10)\n(HCCX,按油,20)\n(HCCX,油,24)\n(HCCX,油,27)"}]}
目录格式如下:

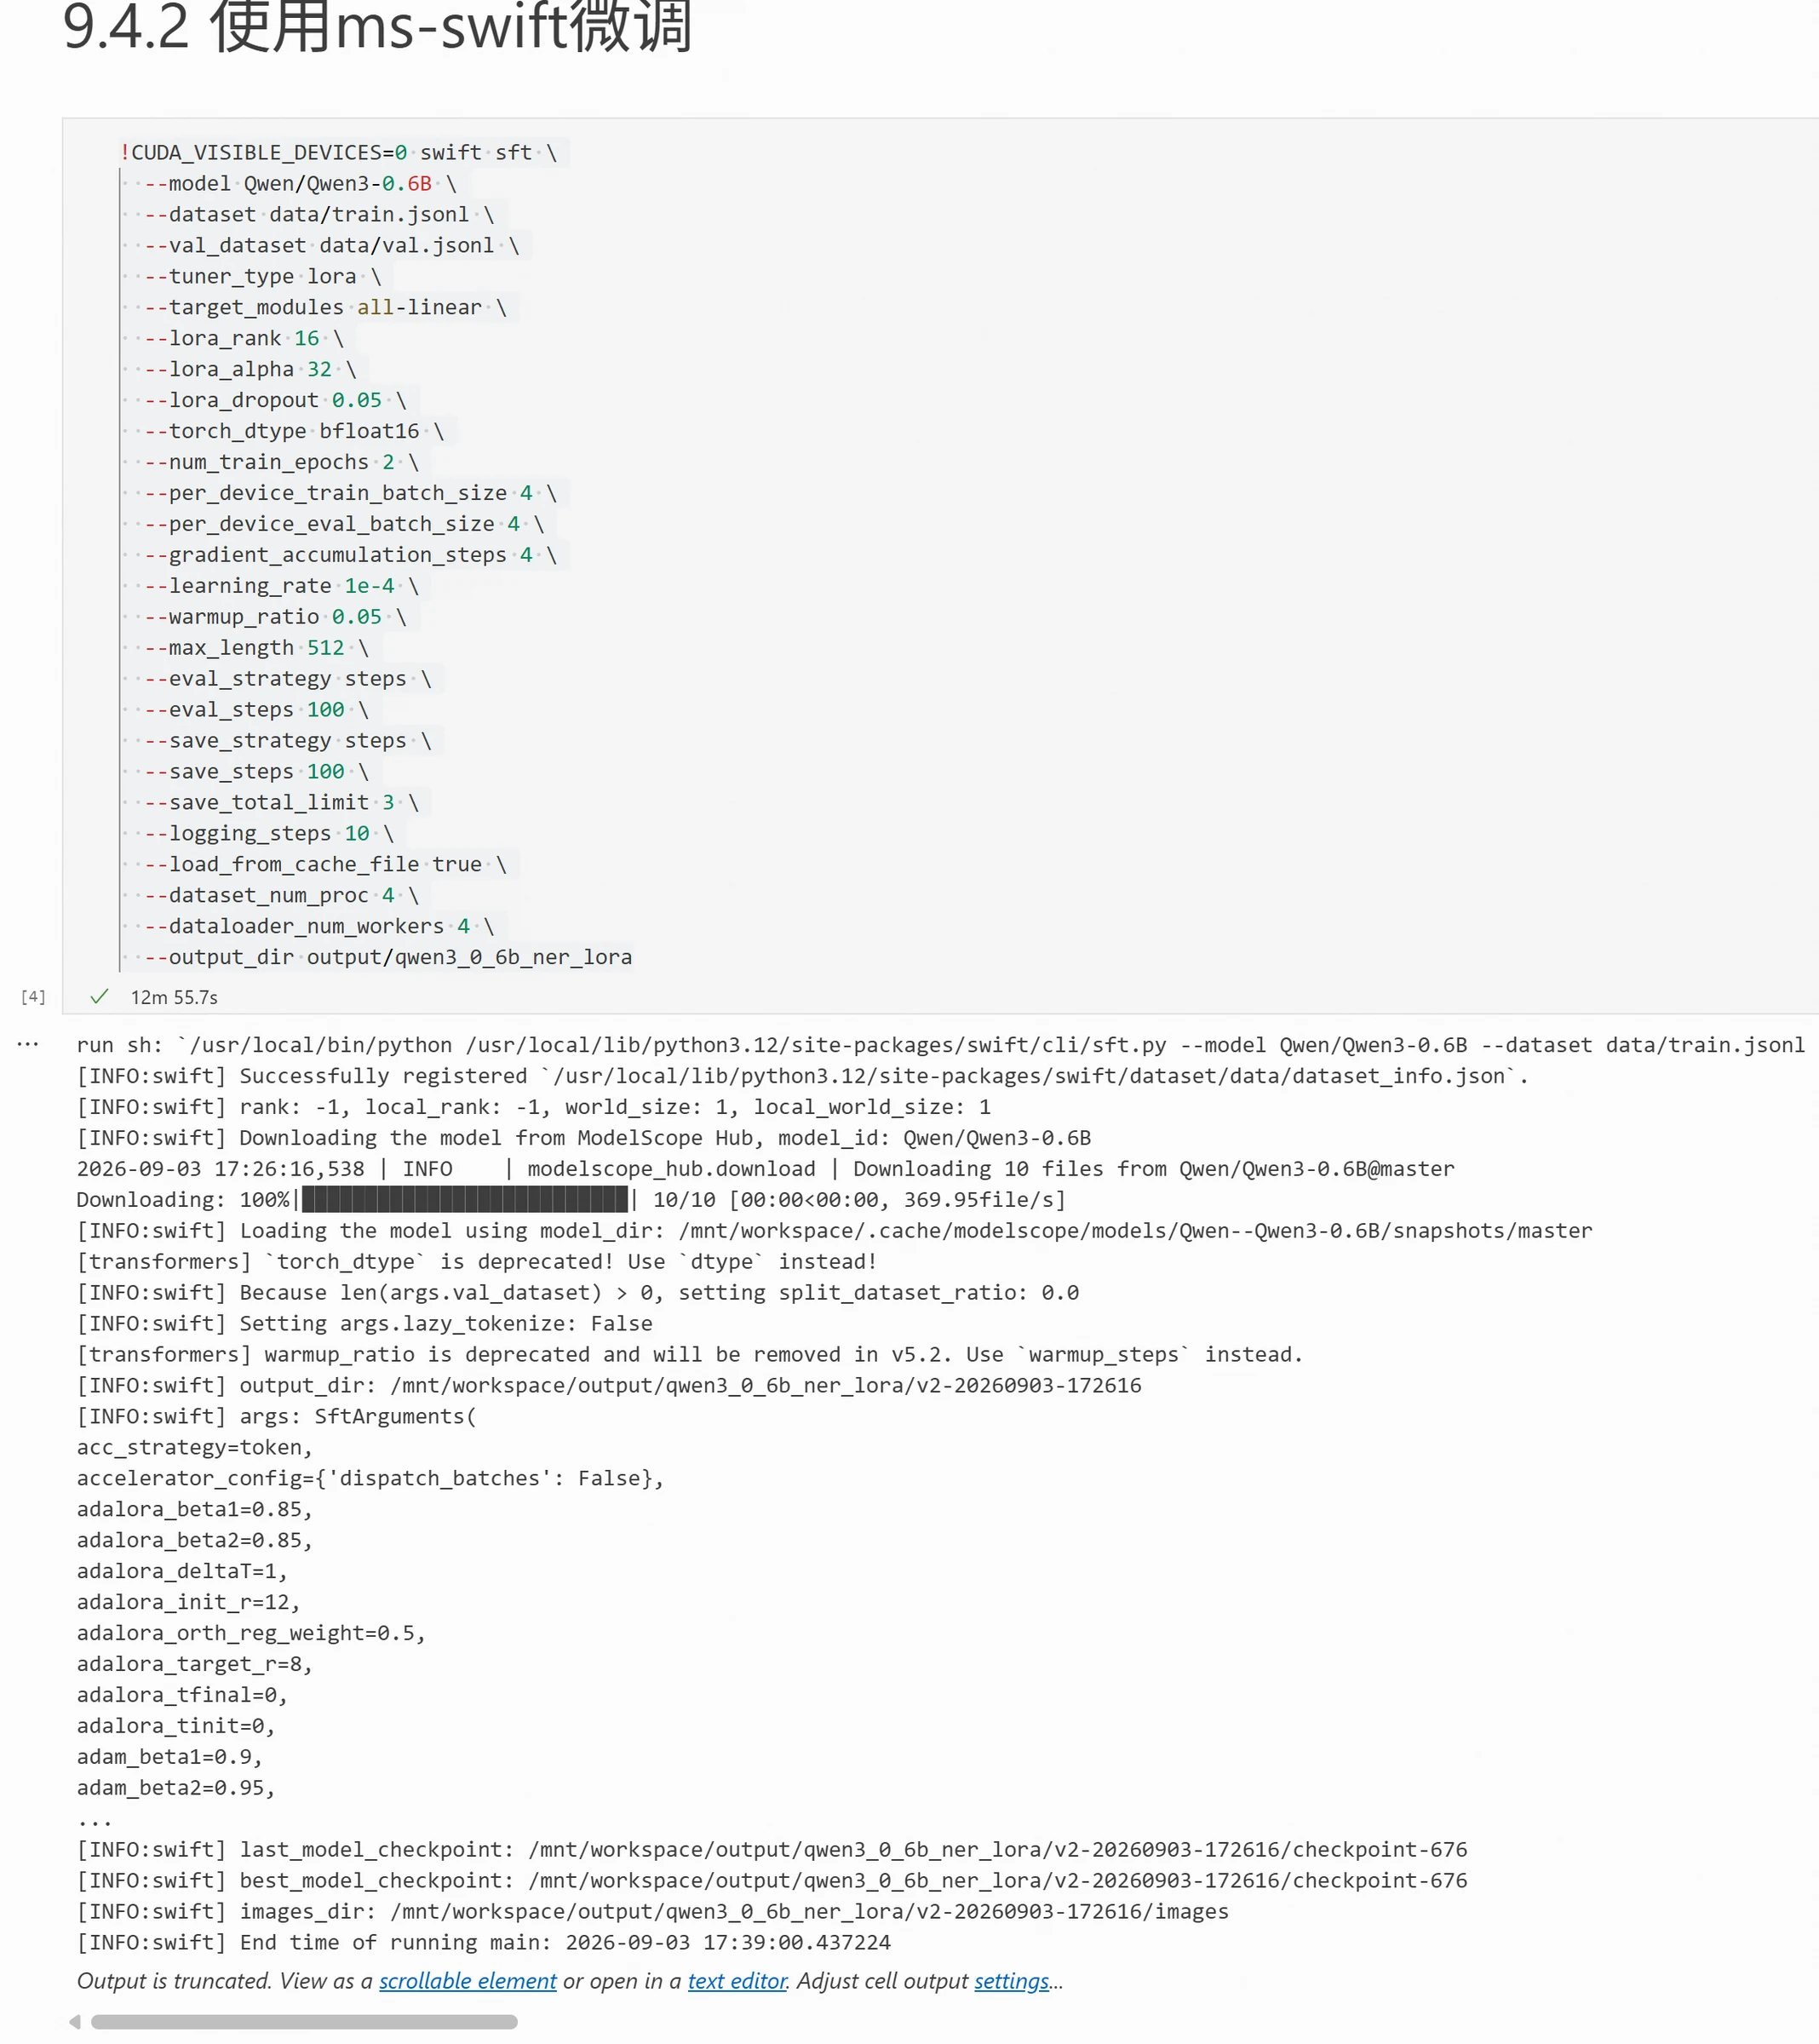
4)模型训练,此部分采用Qwen/Qwen3-0.6B进行微调,在终端中直接输入下面命令即可训练
!CUDA_VISIBLE_DEVICES=0 swift sft \
--model Qwen/Qwen3-0.6B \
--dataset data/train.jsonl \
--val_dataset data/val.jsonl \
--tuner_type lora \
--target_modules all-linear \
--lora_rank 16 \
--lora_alpha 32 \
--lora_dropout 0.05 \
--torch_dtype bfloat16 \
--num_train_epochs 2 \
--per_device_train_batch_size 4 \
--per_device_eval_batch_size 4 \
--gradient_accumulation_steps 4 \
--learning_rate 1e-4 \
--warmup_ratio 0.05 \
--max_length 512 \
--eval_strategy steps \
--eval_steps 100 \
--save_strategy steps \
--save_steps 100 \
--save_total_limit 3 \
--logging_steps 10 \
--load_from_cache_file true \
--dataset_num_proc 4 \
--dataloader_num_workers 4 \
--output_dir output/qwen3_0_6b_ner_lora
核心参数说明:
| 参数 | 含义 |
| --model Qwen/Qwen3-0.6B | 使用 Qwen3-0.6B 基础模型 |
| --tuner_type lora | 使用 LoRA 微调 |
| --target_modules all-linear | 对全部线性层添加 LoRA |
| --lora_rank 16 | LoRA 容量 |
| --lora_alpha 32 | LoRA 缩放系数 |
| --num_train_epochs 2 | 训练轮数 |
| --per_device_train_batch_size 4 | 单卡每步4条数据 |
| --gradient_accumulation_steps 4 | 累积4步更新一次参数 |
| --learning_rate 1e-4 | LoRA 学习率 |
| --max_length 512 | 单条样本最大长度 |
| --eval_steps 100 | 每100步验证一次 |
| --save_steps 100 | 每100步保存一次 |
| --save_total_limit 3 | 最多保留3个检查点 |
| --output_dir | 模型和日志保存路径 |
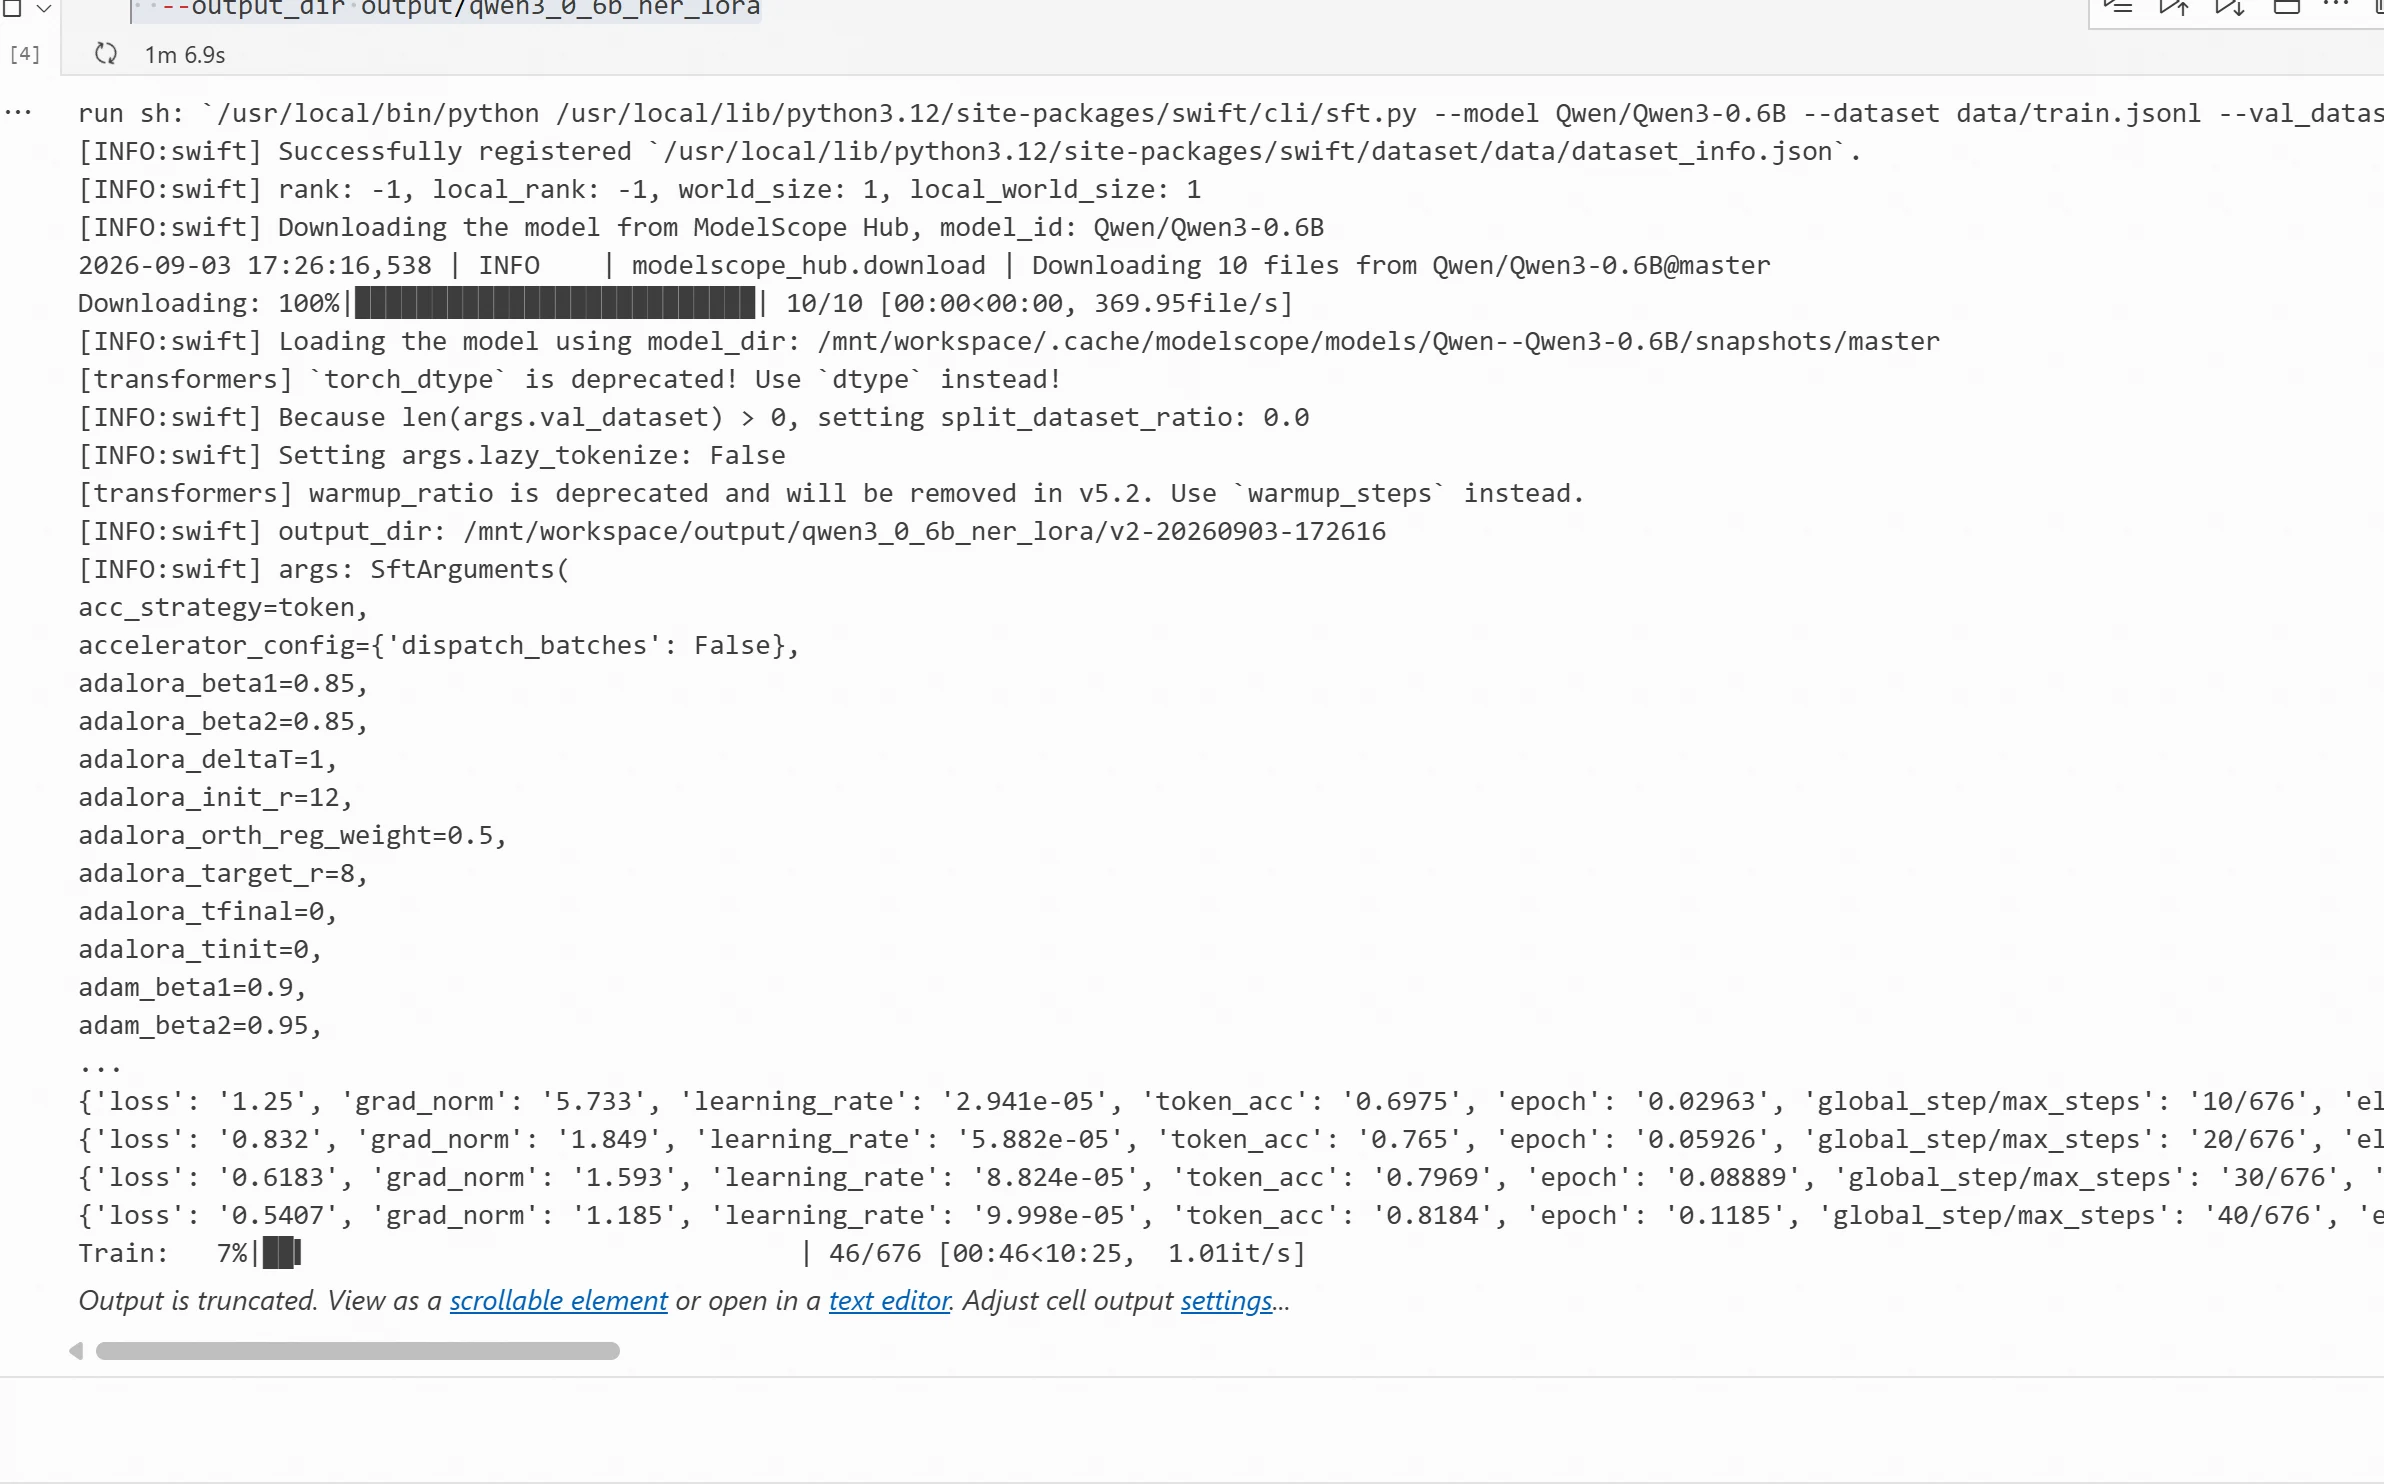
启动训练以后,ms-swift会不断输出当前的训练信息,如下:


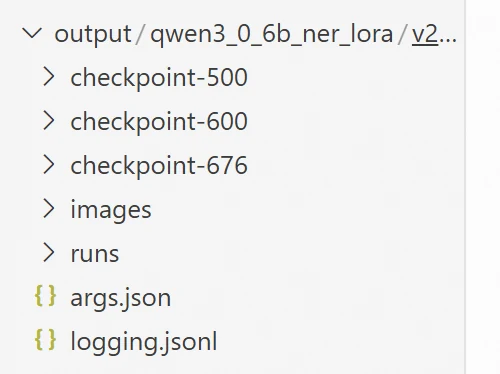
LoRA训练完成以后,会保存对应的LoRA Adapter。Adapter并不是一个完整的大模型,因此在使用时还需要加载原来的基础模型,通过训练脚本中的output_dir,可以在目录中看到的 checkpoint 以及对应的Adapter 文件,在实际部署时,可以将 LoRA Adapter 合并到基础模型中,生成一个完整的模型,在离线部署或模型迁移时更加方便。模型训练完成后的目录形式如下:

模型合并命令如下:
!CUDA_VISIBLE_DEVICES=0 swift export \
--adapters output/qwen3_0_6b_ner_lora/v2-20260903-172616/checkpoint-676 \
--merge_lora true \
--output_dir output/qwen3_0_6b_ner_merged
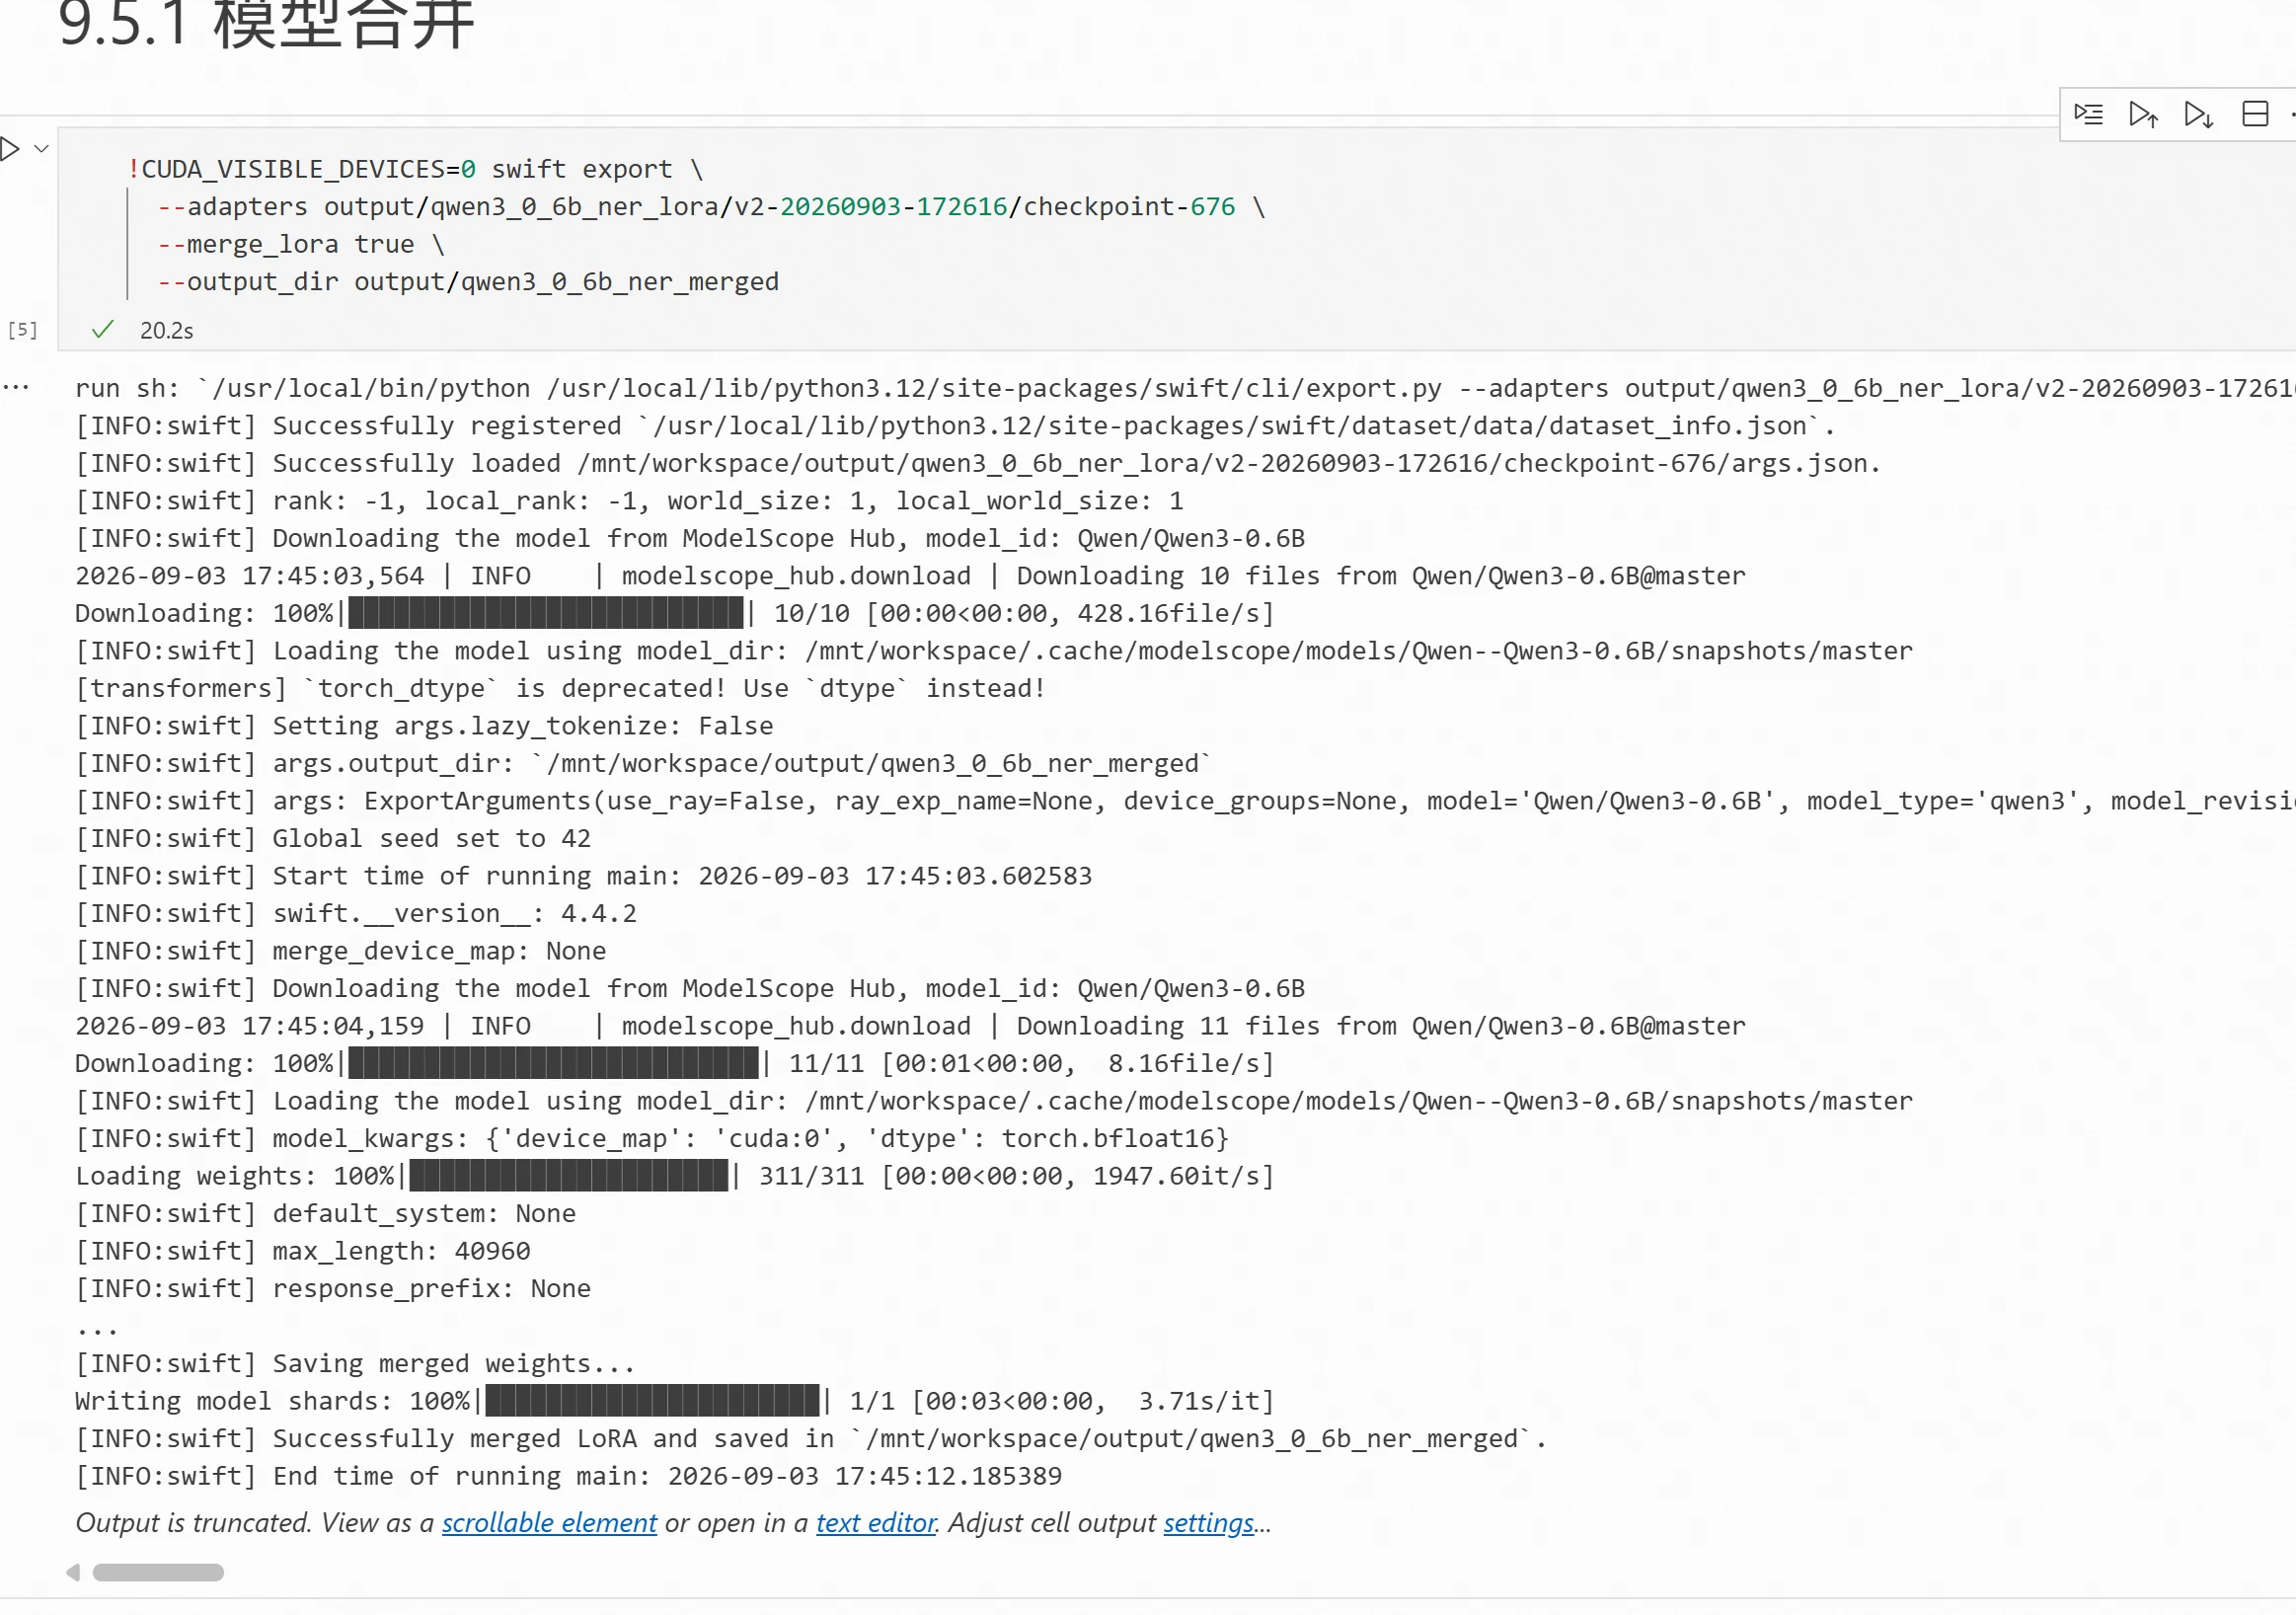
其中,--adapters 指定训练得到的 LoRA checkpoint路径,--merge_lora true 表示将 LoRA 参数合并到基础模型中,--output_dir 指定合并后模型的保存目录。
执行结果如下:

合并完成后,可以直接加载生成的完整模型进行推理。为了方便应用程序调用,也可以将模型启动为 OpenAI 兼容接口,通过 API 的方式访问微调后的模型,这个也是一个常驻服务,需要在终端中启动,可以参考第七章怎么在终端中启动命令,启动命令如下:
CUDA_VISIBLE_DEVICES=0 swift deploy \
--model output/qwen3_0_6b_ner_merged \
--load_args false \
--infer_backend vllm \
--enable_thinking false \
--host 0.0.0.0 \
--port 8000 \
--served_model_name qwen3-0.6b-ner \
--api_key 123 \
--vllm_gpu_memory_utilization 0.7 \
--vllm_max_model_len 1024 \
--max_new_tokens 128
参数说明如下:
| 参数 | 含义 |
| swift deploy | 启动 ms-swift 的 OpenAI 兼容服务 |
| --model | 指定合并后的完整模型目录 |
| --load_args | 不加载模型目录中 args.json参数 |
| --infer_backend | 使用 vLLM 推理引擎 |
| --enable_thinking | 关闭 Qwen3 思考模式 |
| --host | 接口IP |
| --port | 端口 |
| --served_model_name | 设置接口访问模型名称 |
| --api_key | 设置接口访问密钥 |
| --vllm_gpu_memory_utilization | 模型使用约 70% 显存 |
| --vllm_max_model_len | 最大总 token 数 |
| --max_new_tokens | 最大输出长度 |
模型启动完成后,结果如下:

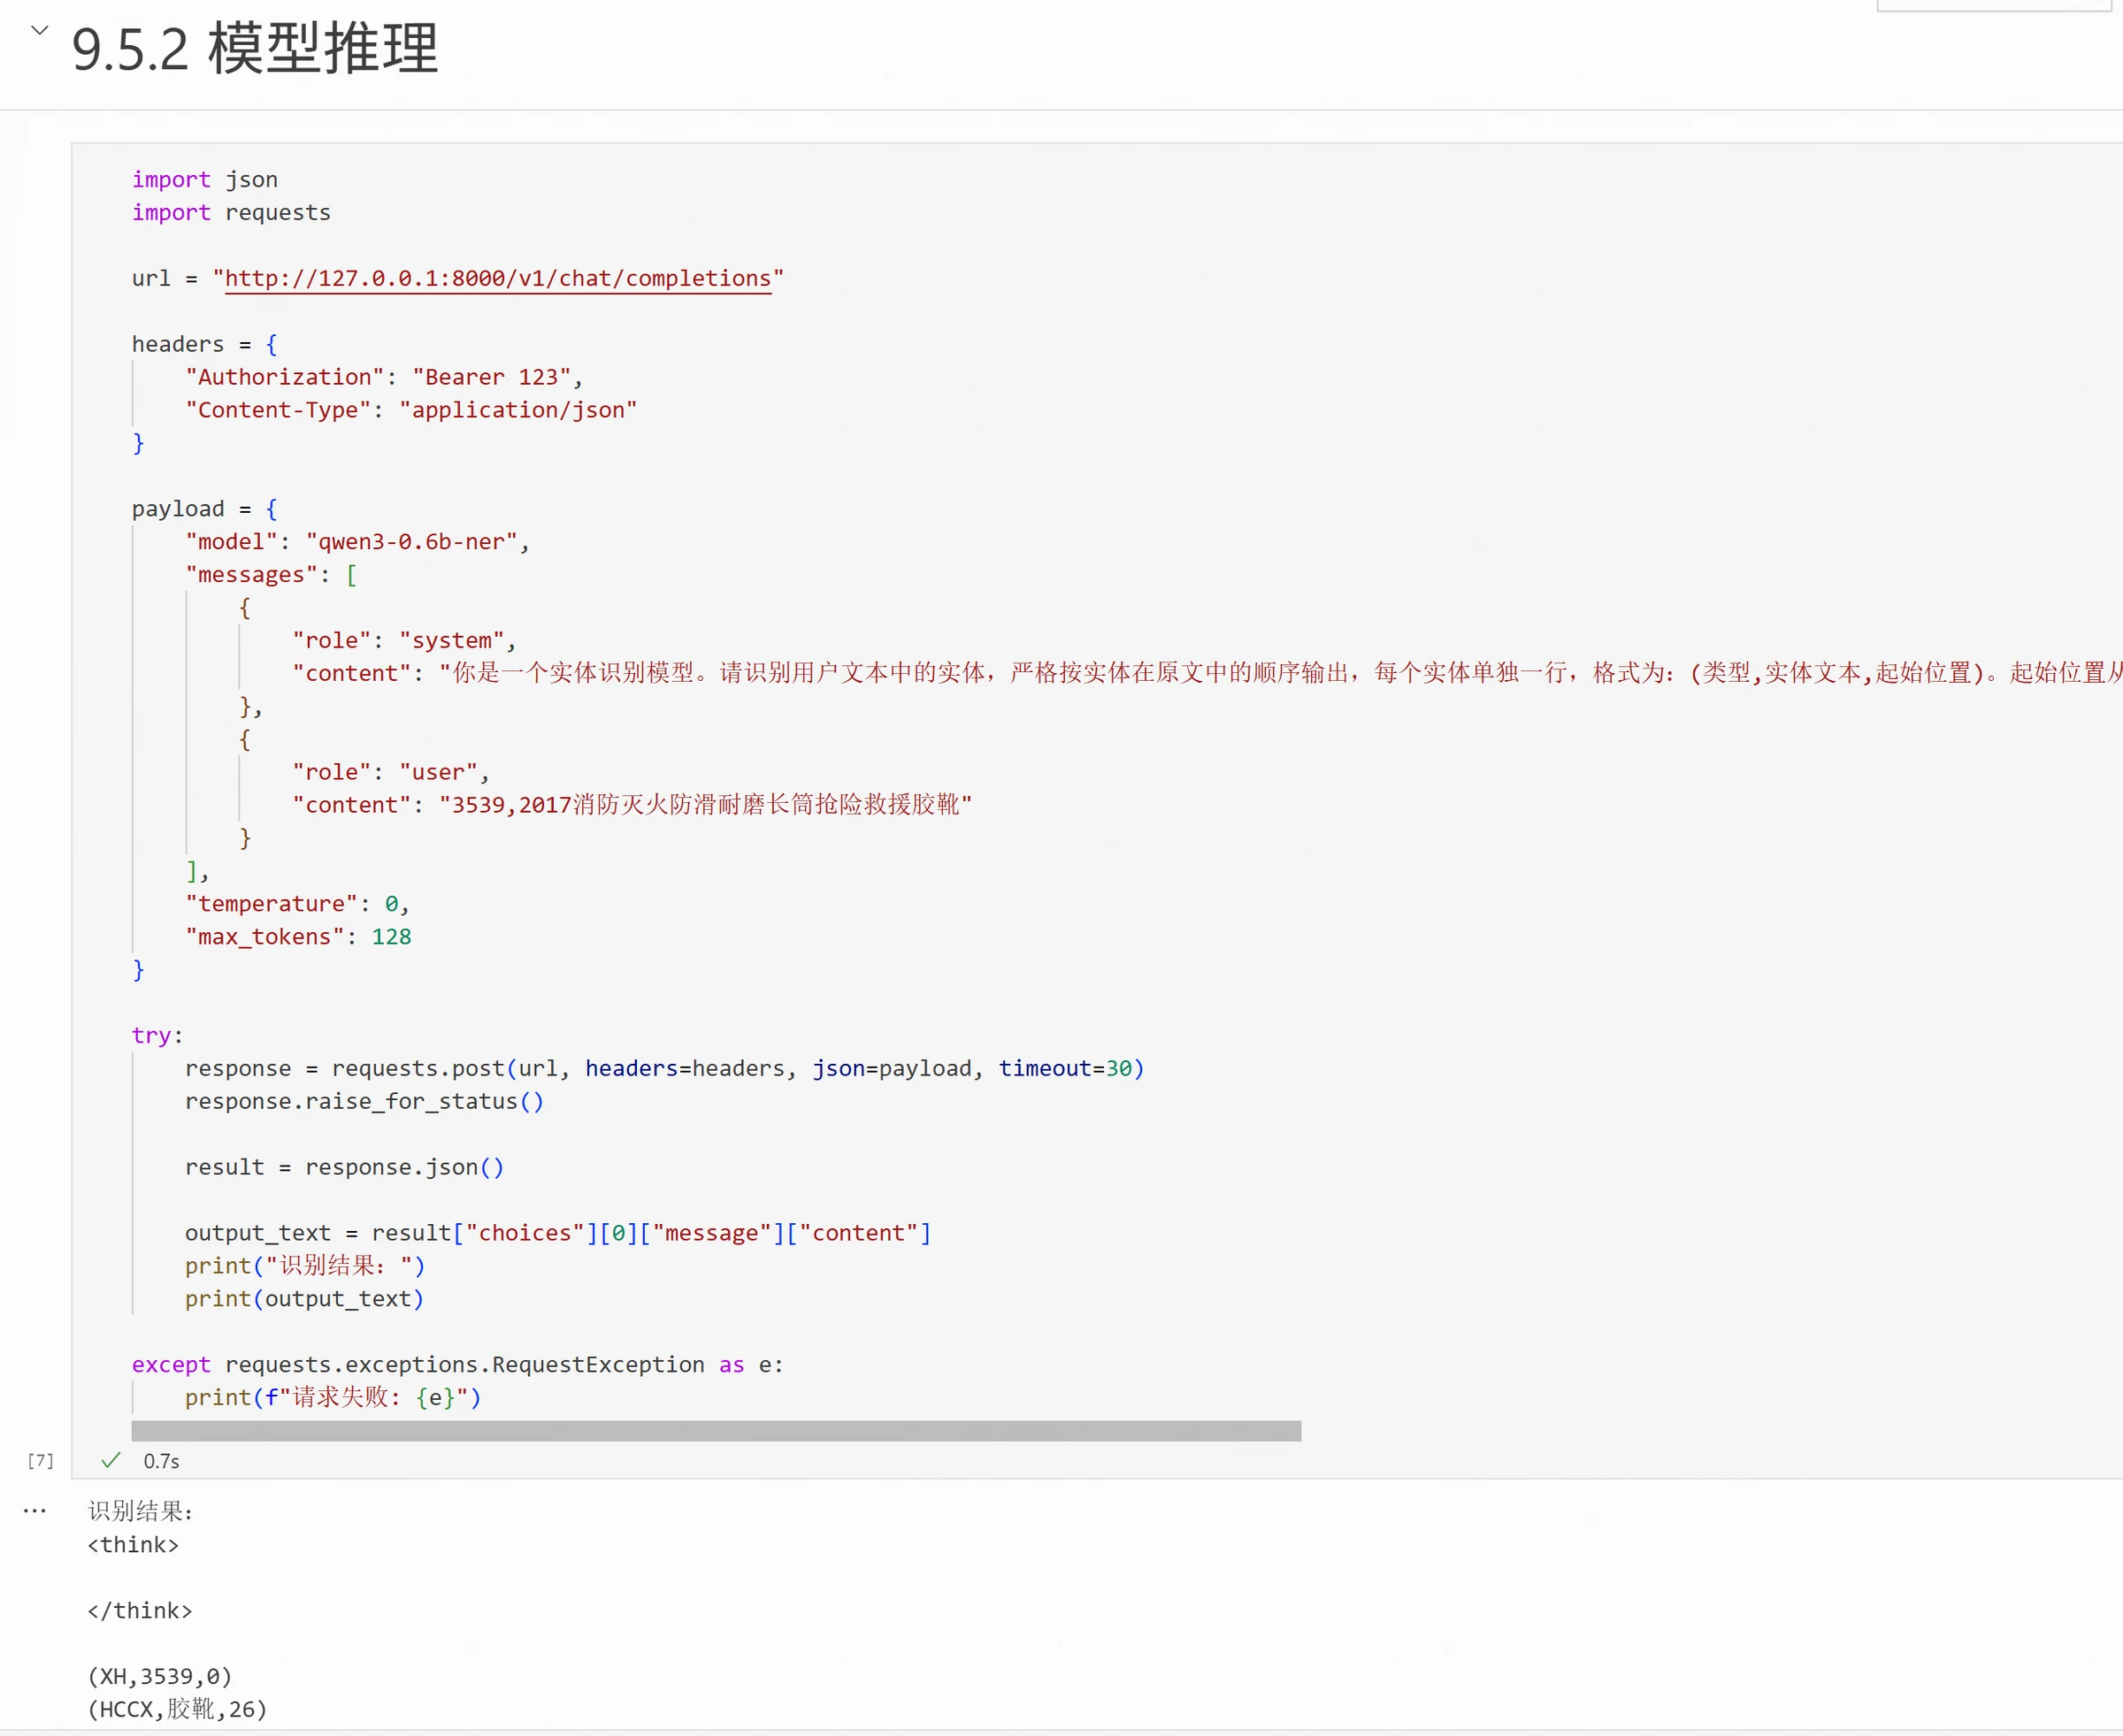
模型启动完成后,可以通过接口测试下是否连通,代码如下:
import json
import requests
url = "http://127.0.0.1:8000/v1/chat/completions"
headers = {
"Authorization": "Bearer 123",
"Content-Type": "application/json"
}
payload = {
"model": "qwen3-0.6b-ner",
"messages": [
{
"role": "system",
"content": "你是一个实体识别模型。请识别用户文本中的实体,严格按实体在原文中的顺序输出,每个实体单独一行,格式为:(类型,实体文本,起始位置)。起始位置从0开始;类型只能是HCCX、HPPX、MISC、XH之一。没有实体时只输出:无实体。不要输出解释、Markdown、think标记或其他内容。"
},
{
"role": "user",
"content": "3539,2017消防灭火防滑耐磨长筒抢险救援胶靴"
}
],
"temperature": 0,
"max_tokens": 128
}
try:
response = requests.post(url, headers=headers, json=payload, timeout=30)
response.raise_for_status()
result = response.json()
output_text = result["choices"][0]["message"]["content"]
print("识别结果:")
print(output_text)
except requests.exceptions.RequestException as e:
print(f"请求失败: {e}")
模型输出结果如下,我们也可以用正则把think标签去除掉。

本章节所有实验数据和代码,可参考:https://modelscope.cn/gallery/liucong/ab458cbd-b47f-4830-91b6-314ea2036fc6