AI & 工程学习计划 › 🔧 微调与评测 › 课程 › 模型已经会回答了,为什么还要做偏好对齐? 模型已经会回答了,为什么还要做偏好对齐?
模型微调完,能按要求回答问题了,可把几条回复放在一起看,会有好有坏,并且有些人看起来会更舒服一些。
拿退款咨询来说,同样是在告诉用户去哪里申请,一个回答只给了操作入口,另一个还说明需要审核、能否退款要看订单情况。两条回复都谈到了退款,后者把用户接下来可能遇到的情况交代得更清楚,也少了一些误解。
前面做SFT时,我们会把这样的回答整理成示例,让模型照着学习。现在还可以把同一个问题的不同回答放在一起,告诉模型我们更认可哪一个,以及评价的标准是什么。
这就是偏好对齐,我们从这里开始。
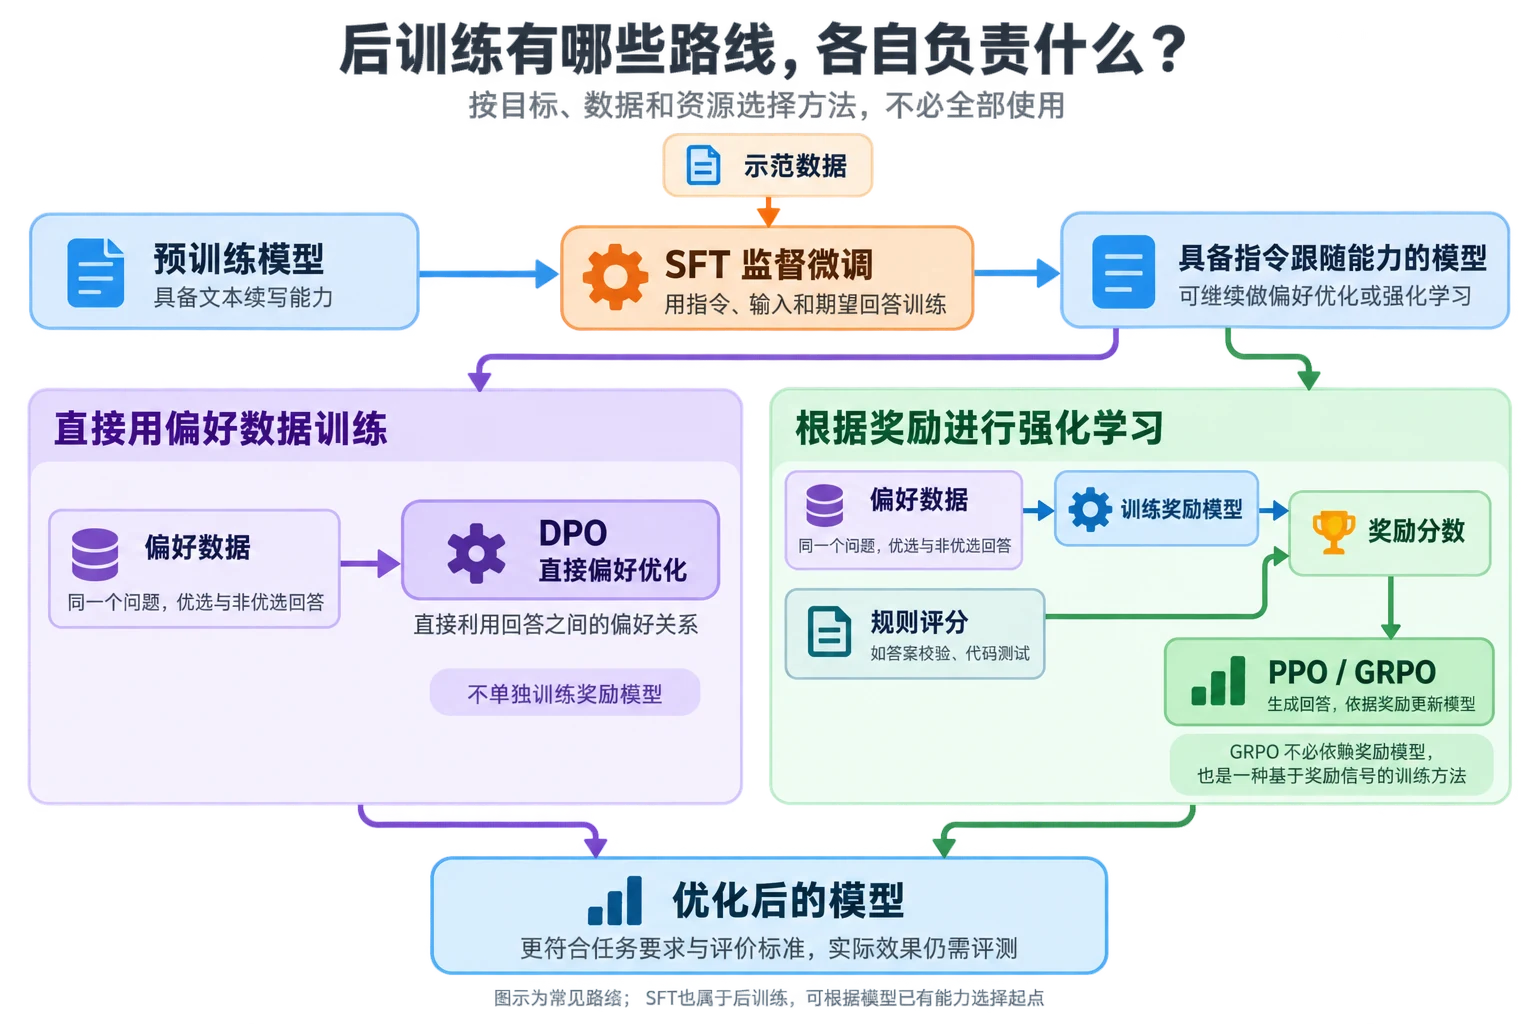
先梳理一下,后训练有哪些做法? 大模型后训练的主要目的是,帮助已经具备文本续写能力的基础模型,逐步变成能够更好地直接对话、遵循指令并完成等具体任务。后训练并不是某一种固定算法,而是一组训练方法的统称,常见方法包括 SFT、偏好优化、奖励模型训练以及强化学习等,不同模型会根据训练目标、数据条件和成本选择不同的组合方式。
其中,SFT 主要使用“指令、输入和期望回答”形式的数据,让模型学习如何理解任务、遵循指令以及按照期望的格式和方式回答。在此基础上,还可以进一步利用偏好数据进行对齐,例如为同一个问题构造优选回答和非优选回答,让模型学习人类或业务评价标准。偏好数据既可以用于训练奖励模型,把人工偏好转化为可计算的奖励分数,再结合 PPO、GRPO 等强化学习方法持续优化模型的生成策略;也可以直接采用 DPO 等方法,将优选与非优选回答之间的偏好关系直接写入训练目标,而不单独训练奖励模型。
因此,大模型的后训练并不存在一套固定流程,SFT、奖励模型、PPO、GRPO 和 DPO 也承担着不同职责。SFT主要用于建立基础的指令跟随能力,奖励模型负责提供可量化的评价信号,PPO和GRPO根据奖励信号进一步优化生成策略,而DPO则直接利用偏好数据完成模型对齐。实际训练过程中,这些方法不一定全部使用,也不一定按照完全相同的顺序组合,而是根据模型能力、任务目标和训练资源灵活选择。
给模型看示范,SFT能教会它什么? SFT即监督微调,它使用已经整理好的输入和期望输出继续训练模型,让模型在看到类似输入时,提高生成期望答案的概率。
一条SFT数据可以写成下面的形式:
{
  "instruction": "根据用户的问题生成客服回复",
  "input": "会员昨天自动续费,我想申请退款。",
  "output": "请先进入订单页面确认续费订单状态。符合退款条件时,可以在订单详情中提交申请;如果页面没有退款入口,请联系人工客服核验。"
}
训练时,分词器(Tokenizer)会把指令、输入和回答转换为词元(Token)。模型根据前面的Token预测下一个Token,再用预测结果与期望答案之间的差异计算损失。大模型SFT通常采用交叉熵损失和教师强制训练:训练每个位置时,模型看到的是数据中已经给出的正确前文,而不是自己刚刚生成的错误内容。很多指令微调实现只对回答部分计算损失,指令和用户输入用于提供上下文,但不要求模型把它们重新生成出来。
SFT首先改变的是任务格式。模型会逐渐理解,输入是一条用户咨询,输出应是一段客服回复,而不是继续补写用户问题。用于信息抽取时,它可以学习输出固定JSON字段;用于会议纪要时,它可以学习按照会议信息、关键结论和行动项组织内容。其次,SFT会改变模型的回答方式。训练数据中的语气、篇幅、段落结构、解释程度和拒答方式,都会成为模型模仿的对象。如果期望回答普遍简洁,模型会更倾向直接给出结论;如果示例要求先说明依据再给出步骤,模型也会学习这种组织方式。SFT还可以让模型接触领域示例。客服数据中的订单状态、退款条件和升级人工服务,法律数据中的条款结构,代码数据中的接口用法,都会影响模型在相应任务中的输出。不过,这并不意味着模型自动掌握了该领域的全部知识。SFT数据覆盖到什么任务、包含什么术语和处理方式,模型才有机会在参数更新中学习这些模式。
SFT的训练目标本质上仍是模仿期望输出。它能让模型知道这类问题通常怎样回答,却不能保证回答中的事实已经经过核验,也不能仅凭一条示范学会比较所有可能答案。同一个退款问题可能得到下面两条回复:
回答A:请在订单详情中申请退款,如无法操作,请联系人工客服。

回答B:您可以先查看订单状态。符合退款条件时,可在订单详情中提交申请;如果没有退款入口,请联系人工客服核验。退款结果和到账时间以实际审核为准。
两条回答都与退款相关,但回答B补充了审核条件,也避免承诺确定的退款结果。如果业务更重视信息完整和合规边界,回答B更合适。SFT可以把回答B作为示范交给模型,偏好数据则可以同时给出A和B,并明确告诉模型为什么更倾向B。这就是从监督学习进入偏好对齐的原因。
同一个问题,怎样的回答更合适?
偏好对齐关注的重点,不是模型“能不能回答”,而是面对多个可能都能成立的回答时,应该更倾向于生成哪一种。它通常通过比较同一输入下不同回答的优劣,将准确性、相关性、帮助性、表达方式、安全性等要求转化为训练信号。与 SFT 相比,SFT 更像是在教模型“怎么答”,通常使用一个输入对应一个期望输出的数据,让模型学习任务格式、内容结构、领域表达和基本回答方式;偏好对齐则是在模型已经具备一定回答能力之后,进一步教模型“怎样答得更好”。
以退款客服场景为例,如果一个回答遗漏审核条件、承诺固定到账时间,或者把不确定事项表述成确定结果,就可以被标记为较差回答;如果另一个回答能够明确说明办理路径、保留必要的审核边界,同时没有虚构政策,则可以被标记为更优回答。通过大量这样的比较训练,模型会逐渐提高优选回答的生成概率,从而在相似问题中更倾向于输出符合业务要求的结果。需要注意的是,偏好对齐学习的并不是一套抽象且统一的“人类价值”,而是结合奖励函数,针对具体任务定义的评价标准。不同的任务需要构造与任务匹配的偏好数据模式。因此,在构造偏好数据之前,需要先明确“什么叫更好”,否则不同标注人员可能因为理解不同而给出相互矛盾的选择。
此外,偏好对齐也不能替代事实验证。一个回答可能表达流畅、语气友好,却引用了错误政策;另一个回答也可能事实正确,却没有遵循要求的输出格式。因此,实际评价体系通常需要分别定义事实正确性、任务完成度、表达风格和安全合规等标准。对于能够自动验证的内容,还可以结合代码测试、答案校验、格式检查和业务规则等方式进行评价,以减少完全依赖人工主观判断带来的偏差。
偏好数据应该怎样构造 偏好数据(Preference Data)是用来告诉模型“多个回答中哪个更好”的训练数据。它与 SFT 数据最大的区别在于:SFT 通常提供一个输入和一个期望答案,而偏好数据通常会针对同一个 Prompt 准备多个候选回答,并标注它们之间的优劣关系。最常见的偏好数据由一个输入、一个优选回答和一个非优选回答组成:
{
  "prompt": "会员昨天自动续费,我想申请退款。",
  "chosen": "请先查看订单状态。符合退款条件时,可以在订单详情中提交申请;如果没有退款入口,请联系人工客服核验。",
  "rejected": "可以,退款会在三个工作日内到账。"
}
其中,chosen表示在当前评价标准下更合适的回答,rejected表示相对不合适的回答。非优选回答不一定完全错误,也可能只是遗漏必要条件、表达过于冗长、语气不符合要求,或者包含没有依据的承诺。偏好数据表达的是相对关系,而不是给每个回答贴上永久的正确或错误标签。
从真实业务或测试集中准备能够代表任务分布的Prompt;
使用当前模型、不同版本模型或不同采样参数,为同一个Prompt生成多个候选回答;
按照统一的评价标准,让标注人员对回答进行两两比较或完整排序;
把排序结果转换为优选回答和非优选回答组成的数据对;
抽查标注一致性,并把无法判断、事实依据不足和意见冲突的样本交给复核人员处理。
如果同一个输入生成了A、B、C和D四个回答,标注结果为B优于A、A优于D、D优于C,就可以转换成多组偏好对。实际构造时不一定要穷举所有组合。差异过小的回答很难稳定标注,差异过大的回答又可能只让模型学会避开低级错误。更有价值的数据通常来自都能读通、但在关键条件、事实边界或任务完成度上存在明确差别的回答。
偏好标注容易受到一些表面因素影响。较长的回答看起来更完整,措辞更自信的回答看起来更可靠,排在前面的候选也可能更容易被选择。为了降低这些偏差,可以随机调整候选顺序,隐藏模型名称,要求标注人员分别检查事实、任务完成度、风格和安全性,并在部分样本上安排多人重复标注。若同一批数据中标注者经常意见相反,通常说明评价标准还不够清楚,而不是简单地把少数意见删除。
奖励模型怎样学会给回答打分? 偏好数据已经把“同一个 Prompt 下哪个回答更好”表示成了 chosen 和 rejected 之间的相对关系。奖励模型(Reward Model,RM)的作用,就是利用这些偏好数据学习一个自动评分函数,把人工比较结果转换成可以被后续强化学习算法使用的奖励信号。常见奖励模型会以语言模型为基础,在最后增加一个输出标量的评分层。训练时,Prompt和回答会被拼接成一段序列,经过模型得到隐藏状态,再由评分层输出一个数值。
奖励模型并不需要知道两个回答分别应该得到多少分,它只需要学习一个相对关系:在这个 Prompt 下,chosen 的得分应该高于 rejected。因此,训练时通常会分别把 Prompt 与两个候选回答拼接后输入奖励模型:
Prompt + chosen   → rchosen
Prompt + rejected → rrejected
其中,rchosen和 rrejected 是奖励模型输出的两个标量分数。训练目标就是让优选回答的分数高于非优选回答。常见的成对排序损失可以写成:
\mathcal{L} = -\log \sigma\left(r_{\text{chosen}} - r_{\text{rejected}}\right)
其中,r_chosen和r_rejected分别表示奖励模型对优选回答和非优选回答的评分,σ表示把分数差映射到0至1之间。优选回答得分越高、非优选回答得分越低,损失越小。经过大量偏好对训练后,奖励模型可以对没有见过的回答作出相对评价。
奖励模型通常以语言模型为基础,再增加一个输出标量分数的评分头。它输入的仍然是 Prompt 和回答文本,只是输出不再是下一个 Token,而是一个用于表示相对质量的奖励分数。这个分数没有统一的物理含义,也不能直接理解为“正确率”或“满分 10 分中的几分”。真正有意义的是同一个奖励模型下,不同回答之间的分数高低。例如,某个回答得到 6 分,另一个得到 4 分,只能说明前者在当前奖励模型看来更符合偏好标准,并不意味着它在客观意义上就是“6 分质量”。
奖励模型能学到什么,很大程度上取决于前面构造的偏好数据。如果偏好数据中的标注者总是倾向于选择更长的回答,奖励模型可能把长度误认为质量;如果标注人员过度关注语言流畅性,它也可能给措辞漂亮但事实错误的回答较高分。因此,奖励模型并不会真正理解什么是正确的答案,而是在模仿偏好数据中体现出来的评价规律。这也是为什么奖励模型训练完成后不能只看训练损失,还需要单独进行评测。
正是由于奖励模型本身只负责“评价”,不会直接修改语言模型。因而,后续在 PPO、GRPO 等强化学习阶段,语言模型会持续生成新的回答,奖励模型对这些回答进行打分,强化学习算法再根据奖励结果更新模型参数,使模型逐渐提高高奖励回答的生成概率。需要注意的是,如果策略模型发现某些表面模式能够稳定获得高分,就可能反复利用这些模式,而不是真正提升任务能力,这种现象通常称为奖励投机(Reward Hacking) 。因此,奖励模型不仅需要能够区分训练数据中的优劣回答,还要尽量避免被简单的长度、固定措辞、格式模板等表面特征“欺骗”。
RLHF,人类的反馈怎样参与训练? RLHF(Reinforcement Learning from Human Feedback)通常称为基于人类反馈的强化学习。它描述人工反馈怎样进入强化学习训练,是一套训练框架,不是一种具体的优化算法,也不是某个固定的模型结构。
收集人工示范数据,通过SFT得到能够遵循指令的初始策略模型;
对同一Prompt下的多个回答进行人工排序,使用这些偏好数据训练奖励模型;
让策略模型生成新回答,由奖励模型评分,再使用PPO等强化学习算法更新策略模型。
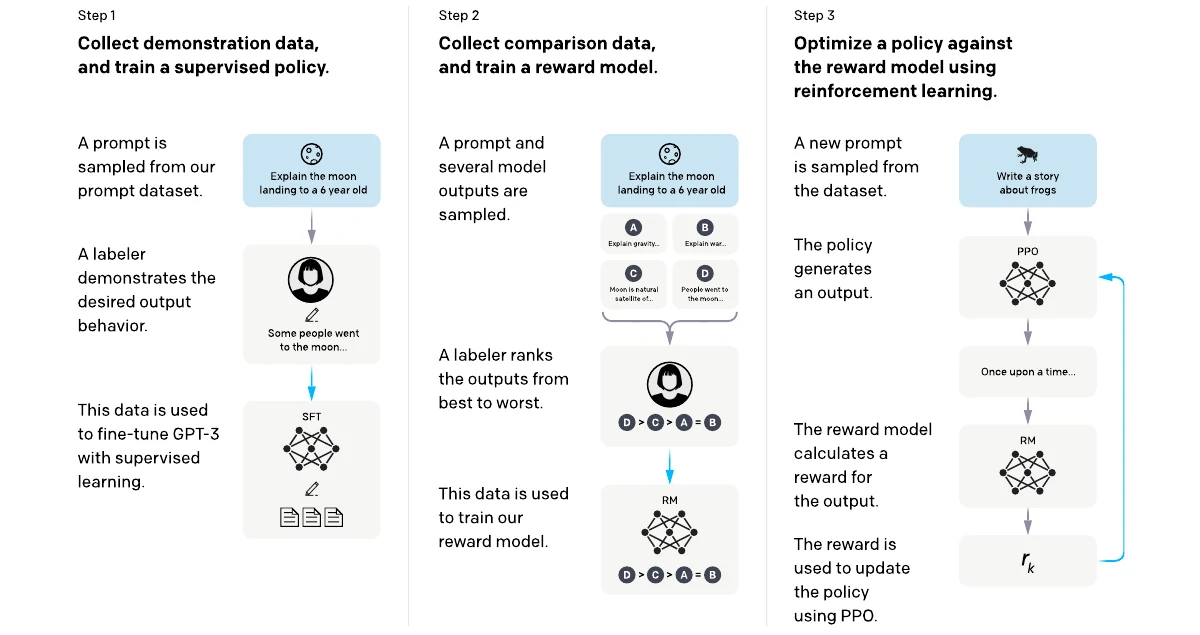
经典RLHF路线分成三个连续阶段如下图所示。第一阶段由标注人员编写示范回答,用这些数据完成SFT;第二阶段让模型针对同一个Prompt生成多个回答,再由标注人员排序,用比较数据训练奖励模型;第三阶段让策略模型生成新回答,由奖励模型计算分数,并使用PPO更新策略。三类数据承担的作用不同:示范数据教模型怎样回答,比较数据教奖励模型怎样评价,Prompt和奖励信号则用于强化学习。
把这个过程放到强化学习概念中,语言模型就是策略模型,Prompt和已经生成的Token构成当前状态,模型选择下一个Token相当于采取动作,从开始回答到生成结束标记构成一次完整轨迹。
在RLHF中,奖励模型通常在回答结束后给出一个总体分数,强化学习算法再判断应该提高哪些Token选择的概率。在RLHF的训练通常还会保留参考模型。参考模型一般是冻结的SFT模型,用于约束正在训练的策略模型不要偏离原有语言能力太远。
PPO,让模型根据奖励逐步调整 近端策略优化(Proximal Policy Optimization, PPO)。它是一种策略梯度算法,核心目标是在提高奖励的同时,限制每次参数更新的幅度。大模型参数很多,如果仅因为一批回答获得高分就大幅改变策略,模型可能很快偏向少数奖励模式,甚至破坏原有的语言能力。PPO中的近端,强调新策略要在旧策略附近逐步更新。在大模型后训练中,一轮PPO通常包含两个阶段。第一个阶段是采样:从Prompt数据集中抽取一批输入,让当前策略模型生成回答,同时保存每个Token在旧策略下的概率,再由奖励模型给出分数。第二个阶段是更新:根据奖励和价值估计计算优势,使用这些样本更新策略模型和价值模型。完成若干次小批量更新后,再用新的策略重新生成数据。
PPO需要比较新策略和旧策略对同一个Token给出的概率。概率比可以简化写成:
r_t(\theta)
=
\frac{\text{新策略选择当前Token的概率}}
{\text{旧策略选择当前Token的概率}}
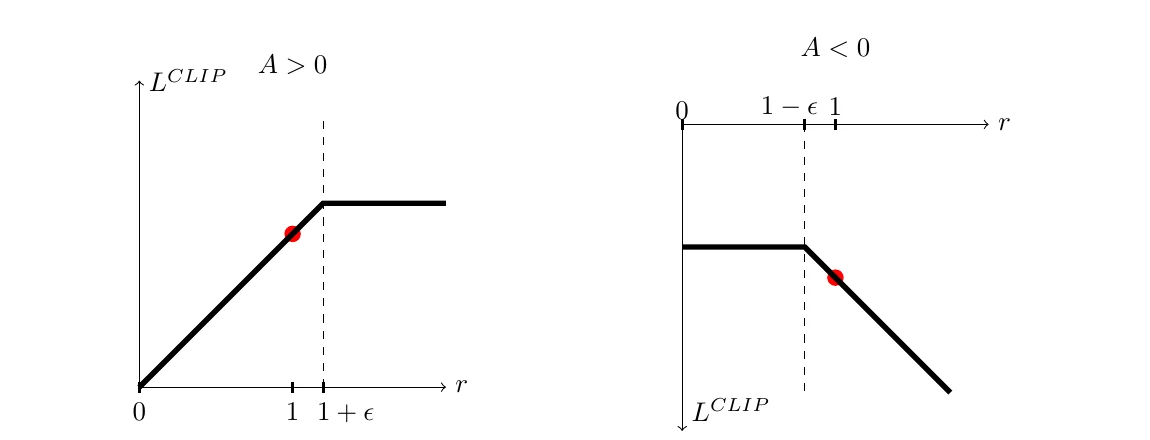
当rₜ接近1,表示新旧策略差别不大;当rₜ明显大于1,表示新策略更倾向当前Token;当rₜ明显小于1,则表示新策略降低了它的概率。只有概率变化还不够,还需要优势Aₜ判断这个Token选择比当前平均水平好还是差。优势为正时,应适当提高该选择的概率;优势为负时,应降低它的概率。
上图左侧表示优势为正的情况。概率比从1向右增加时,目标先随之提高;超过1+ε后曲线变平,继续提高该Token的概率不再增加目标。右侧表示优势为负的情况。当概率比下降到1-ε以下后,目标同样停止继续改善。两条曲线共同说明,PPO允许策略朝正确方向调整,但会削弱过大更新带来的额外收益。
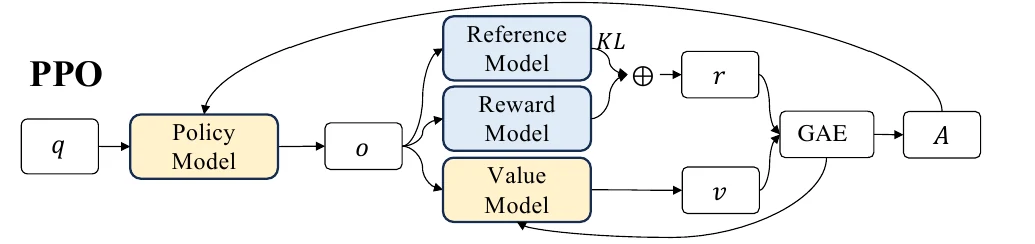
一套典型的大模型PPO训练需要同时维护几个组件:策略模型负责生成并接受更新;旧策略是采样时策略参数的快照,用于计算概率比;参考模型是冻结的SFT模型,用于计算KL约束;奖励模型负责评价完整回答;价值模型负责估计每个生成位置后续可能获得的收益。价值模型的估计与实际奖励之间存在差异,PPO通常使用GAE等方法把这些差异整理为每个Token的优势。PPO的整体流程如下图所示。策略模型根据输入q生成回答o,奖励模型和参考模型共同形成奖励r,价值模型给出价值估计v,随后通过GAE计算得到优势A。策略模型根据优势和裁剪目标更新,价值模型则通过价值损失学习更准确的收益估计。
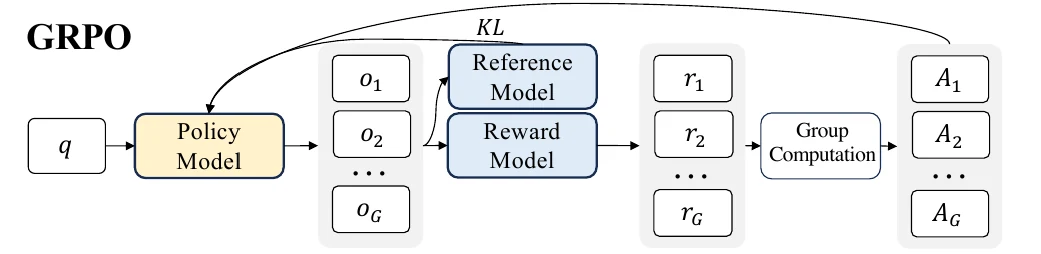
GRPO,同一道题多答几次,再比较得分 组相对策略优化(Group Relative Policy Optimization, GRPO)。它是PPO的一种变体,保留了策略采样、概率比裁剪和KL约束等思路,主要变化是不再单独训练价值模型,而是使用同一个Prompt下多条回答的相对得分估计优势。GRPO的整体框架如下图所示。对于同一个输入q,策略模型一次生成一组回答o₁到oG,奖励模型或规则系统分别给出r₁到rG。
系统先计算这一组奖励的平均值和标准差,再把每条回答的得分转换为组内相对优势,得分高于组内平均水平的回答获得正优势,低于平均水平的回答获得负优势。对于只在回答结束时给一次总体奖励的任务,同一回答中的Token通常共享由该回答得到的相对优势;如果还提供过程奖励,也可以进一步形成更细的Token级反馈。随后,GRPO像PPO一样比较新旧策略概率,并通过裁剪目标和KL约束更新策略模型。
相较于PPO,GRPO减少了价值模型带来的参数、显存和训练开销,但并不意味着训练成本一定很低。每个Prompt需要生成多条回答,推理采样本身会消耗大量计算资源。如果同一组回答得分完全相同,标准差接近0,组内比较就很难提供有效方向,实际实现需要跳过、平滑或重新采样这类数据。组大小、采样温度、奖励尺度和KL系数也会影响训练稳定性。例如,一个数学问题生成四个解答,其中两个答案正确,一个计算错误,一个没有完成。系统可以使用答案校验规则给它们评分,再在四个结果内部比较。正确且过程完整的回答得到较高优势,错误或未完成的回答得到较低优势,模型据此提高较好解法出现的概率。代码任务也可以使用编译结果和单元测试作为奖励,不一定先训练一个专门的奖励模型。
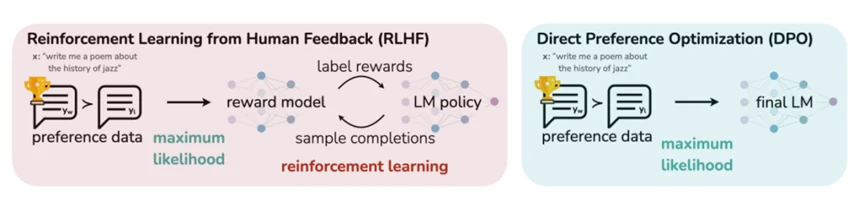
DPO,直接从回答的优劣中学习 直接偏好优化(Direct Preference Optimization,DPO)。在其论文标题中,作者就明确指出,偏好模型可能并不需要,我们构建的大语言模型本身也许就是潜在的偏好模型。这种想法直接放弃了偏好模型的单独建模,而是直接从原有模型出发,增加单独为偏好模型专项设计的损失函数,使其在优化模型生成结果得到进一步提高。DPO通过使用已经收集好的优选回答和非优选回答直接训练语言模型,不需要显式训练奖励模型,也不需要运行PPO或GRPO那样的在线强化学习循环。
上图对比了经典RLHF路线和DPO。偏好数据先用于训练奖励模型,策略模型再生成新回答,根据奖励模型的分数进行强化学习。DPO路线,偏好数据直接进入语言模型训练。两条路线都从回答之间的优劣关系出发,但训练环节和资源需求不同。DPO的整体流程仅需两个阶段:
第一阶段,构造生成偏好正负例样本。这步相较于之前微调阶段的样本构造方式,将原有的“输入(Input)-输出(Output)”数据集改为“输入(Input)-正反馈(Accept Response)-负反馈(Negative Response)”。这种样本训练学习方法并不是首创,其实就是从图像领域兴起的对比学习。对比学习的研究者发现,模型在同时学习正负例时,模型可以快速收敛,整体表现可以进一步提升。
第二阶段,基于设计好的损失函数,利用对比学习相关方法,通过极大似然函数,对原始生成模型进行参数优化。这样的设计省去了原有偏好奖励模型与强化学习过程训练全过程,在效率提高的同时,精度与稳定性相比于PPO也有显著提升。通过第二阶段的优化调整,模型参数朝着靠近正例远离负例的方向不断优化,最终实现模型生成向正例内容的偏好对齐。
DPO的训练形式接近普通SFT。训练数据已经包含Prompt、优选回答和非优选回答,模型不需要在每一步重新生成候选,也不需要同时运行奖励模型和价值模型。因此,它属于离线偏好优化,组件少,显存和工程复杂度通常低于PPO。这种简化并没有消除对数据质量的要求。DPO只能学习偏好数据中已经出现的差异。如果优选回答本身存在事实错误,非优选回答过于低劣,或者数据主要来自与当前模型差异很大的生成分布,模型可能学到表面风格而不是目标能力。DPO也不会像在线强化学习那样不断探索新回答,再针对新出现的问题获取反馈。
RLHF、PPO、GRPO和DPO,到底怎么区分和选择? 前文已经分别介绍了 RLHF、PPO、GRPO 和 DPO 的基本原理与训练方式。为了更清楚地理解它们之间的关系,可以进一步从方法定位、训练过程中是否需要在线生成回答、是否依赖奖励模型和价值模型等几个维度进行对比。通过这种横向比较,可以更直观地看出不同后训练方法在实现路径、训练成本和适用方式上的主要差异。下表是相关模型对比。
概念
属于什么
训练时是否生成新回答
是否需要显式奖励模型
是否需要价值模型
主要特点
RLHF
反馈与强化学习框架
通常需要
经典路线需要
取决于所用优化算法
规定人工反馈、奖励和策略更新怎样衔接
PPO
在线强化学习算法
需要
经典RLHF中通常需要
需要
通过价值估计和概率比裁剪稳定更新策略
GRPO
在线强化学习算法
需要,同一Prompt通常生成一组回答
可以使用奖励模型或规则奖励
不需要
用组内相对奖励估计优势
DPO
离线偏好优化方法
通常不需要在线生成
不需要单独训练
不需要
直接提高优选回答相对于非优选回答的概率
综合来看,RLHF、PPO、GRPO 和 DPO 虽然都与大模型偏好对齐有关,但它们解决的问题并不完全相同。RLHF 更偏向一套完整的反馈与强化学习框架,PPO 和 GRPO 则是在这一类框架中用于更新策略模型的在线强化学习算法,而 DPO 则直接利用已有偏好数据完成离线优化。从训练机制上看,PPO 依赖奖励模型和价值模型,整体工程链路更完整,但训练成本和实现复杂度也更高;GRPO 通过组内相对奖励估计优势,省去了价值模型,更适合具有规则奖励、答案校验等明确反馈的任务;DPO 不需要在线生成回答,也不需要单独训练奖励模型和价值模型,因此实现相对简单,适合作为偏好数据较充分时的低成本对齐方案。
在实际应用中,方法选择应从模型当前缺少的能力出发,而不是简单追随某一种训练算法。模型还不能稳定完成任务时,应优先通过 SFT 建立基础能力;模型已经能够完成任务,但回答质量和偏好选择不稳定时,可以进一步采用 DPO、PPO 或 GRPO。已有高质量偏好数据、希望快速完成第一轮对齐时,可以优先考虑 DPO;任务具有可验证奖励并希望模型主动探索更优解时,可以考虑 GRPO;具备成熟奖励模型、价值模型和强化学习基础设施,并需要精细控制在线策略更新时,则可以采用 PPO。无论最终选择哪种方法,都不能只用训练损失、奖励分数或偏好胜率判断效果,而应回到真实任务中持续评估模型的准确性、任务完成度、安全性、业务边界和通用能力。后训练的最终目标不是获得更高的奖励,而是让模型在真实使用环境中更稳定、更可靠地完成目标任务。
用ms-swift,试试DPO和GRPO 前面介绍了偏好对齐和强化学习的基本原理,下面使用ms-swift完成两个具体实验。第一个实验使用中文偏好数据进行DPO训练,观察模型对优选回答和非优选回答的偏好怎样变化;第二个实验使用数学题进行GRPO训练,让模型生成候选回答,再根据答案和格式得到奖励。两个实验都使用已经具备指令跟随能力的Qwen2.5-0.5B-Instruct作为初始模型,分别训练一个独立的LoRA适配器。
实验准备 本次实验在魔搭Notebook的单卡GPU环境中完成,模型和原始数据文件均从魔搭社区下载。两个实验的配置如下:
项目
DPO中文偏好对齐
GRPO数学答案优化
初始模型
Qwen/Qwen2.5-0.5B-Instruct
同一份Qwen2.5-0.5B-Instruct权重
数据集
AI-ModelScope/hh_rlhf_cn
AI-ModelScope/gsm8k
使用子集
helpful_base_cn
main
训练集
256条偏好对
128道题
验证集
32条偏好对
16道题
测试集
32条偏好对
官方测试文件全部1319道题
训练方式
LoRA,20个优化器更新步骤
LoRA,10个优化器更新步骤
训练时的反馈
数据中给定的优选回答和非优选回答
模型生成回答后,由规则计算奖励
这里的训练规模较小,主要用于演示完整流程。训练步骤表示优化器更新参数的次数,不等于训练轮数,也不表示训练数据已经全部使用一遍。本次实操部分仅使用了较小部分的数据,并采用了较少次数的迭代步骤,实验仅作参考。
打开配套Notebook后,先检查GPU是否可用,以及当前内核实际使用的软件版本。
公共准备部分会建立缓存目录和本次实验目录。模型配置的核心代码如下:
MODEL_ID = "Qwen/Qwen2.5-0.5B-Instruct"
MODEL_REVISION = "master"
DPO_DATA_ID = "AI-ModelScope/hh_rlhf_cn"
GRPO_DATA_ID = "AI-ModelScope/gsm8k"
SEED = 42

MODEL_DIR = Path(snapshot_download(
    MODEL_ID,
    revision=MODEL_REVISION,
    cache_dir=str(CACHE_DIR / "models"),
    allow_file_pattern=[
        "*.json", "*.safetensors", "*.txt", "*.model", "*.tiktoken"
    ],
).resolve()
其中,snapshot_download来自ModelScope,CACHE_DIR由公共准备代码建立。下载完成后,训练和推理都使用MODEL_DIR指向的本地模型快照。本次实操内容将保存在ms_swift_dpo_grpo_runs/目录下。读者重新运行时,程序会生成新的实验编号,后面的RUN_DIR应使用自己的运行目录。DPO
准备DPO偏好数据 DPO需要同一个上下文下的两个候选回答。实验使用中文HH-RLHF数据集的helpful_base_cn子集,其中context保存对话历史,chosen保存优选回答,rejected保存非优选回答。这里的优选和非优选来自数据集标签,不表示回答中的事实已经逐条核验。
ms-swift使用的偏好样本结构如下。下面只展示字段关系,实际内容从数据集读取:
{
  "messages": [
    {"role": "user", "content": "同一个问题"},
    {"role": "assistant", "content": "优选回答"}
  ],
  "rejected_response": "非优选回答"
}
与【快速用ms-swift,完成开源模型的轻量微调】的SFT样本相比,这里增加了rejected_response。messages最后一条assistant消息保存优选回答,非优选回答放在单独字段中。多轮对话里的历史assistant消息仍然属于上下文,不能把它们误当成本次比较的回答。Notebook中的转换函数如下:
def convert_dpo(row):
    role_map = {
        "human": "user", "user": "user",
        "assistant": "assistant", "system": "system"
    }
    context = [
        {"role": role_map[m["role"]], "content": m["text"].strip()}
        for m in row["context"]
    ]
    chosen = row["chosen"]["text"].strip()
    rejected = row["rejected"]["text"].strip()

    assert context and context[-1]["role"] == "user"
    assert chosen and rejected and chosen != rejected
    assert all(m["content"] for m in context)
    if context[0]["role"] != "system":
        context.insert(0, {"role": "system", "content": GENERAL_SYSTEM})

    return {
        "messages": context + [{"role": "assistant", "content": chosen}],
        "rejected_response": rejected,
    }
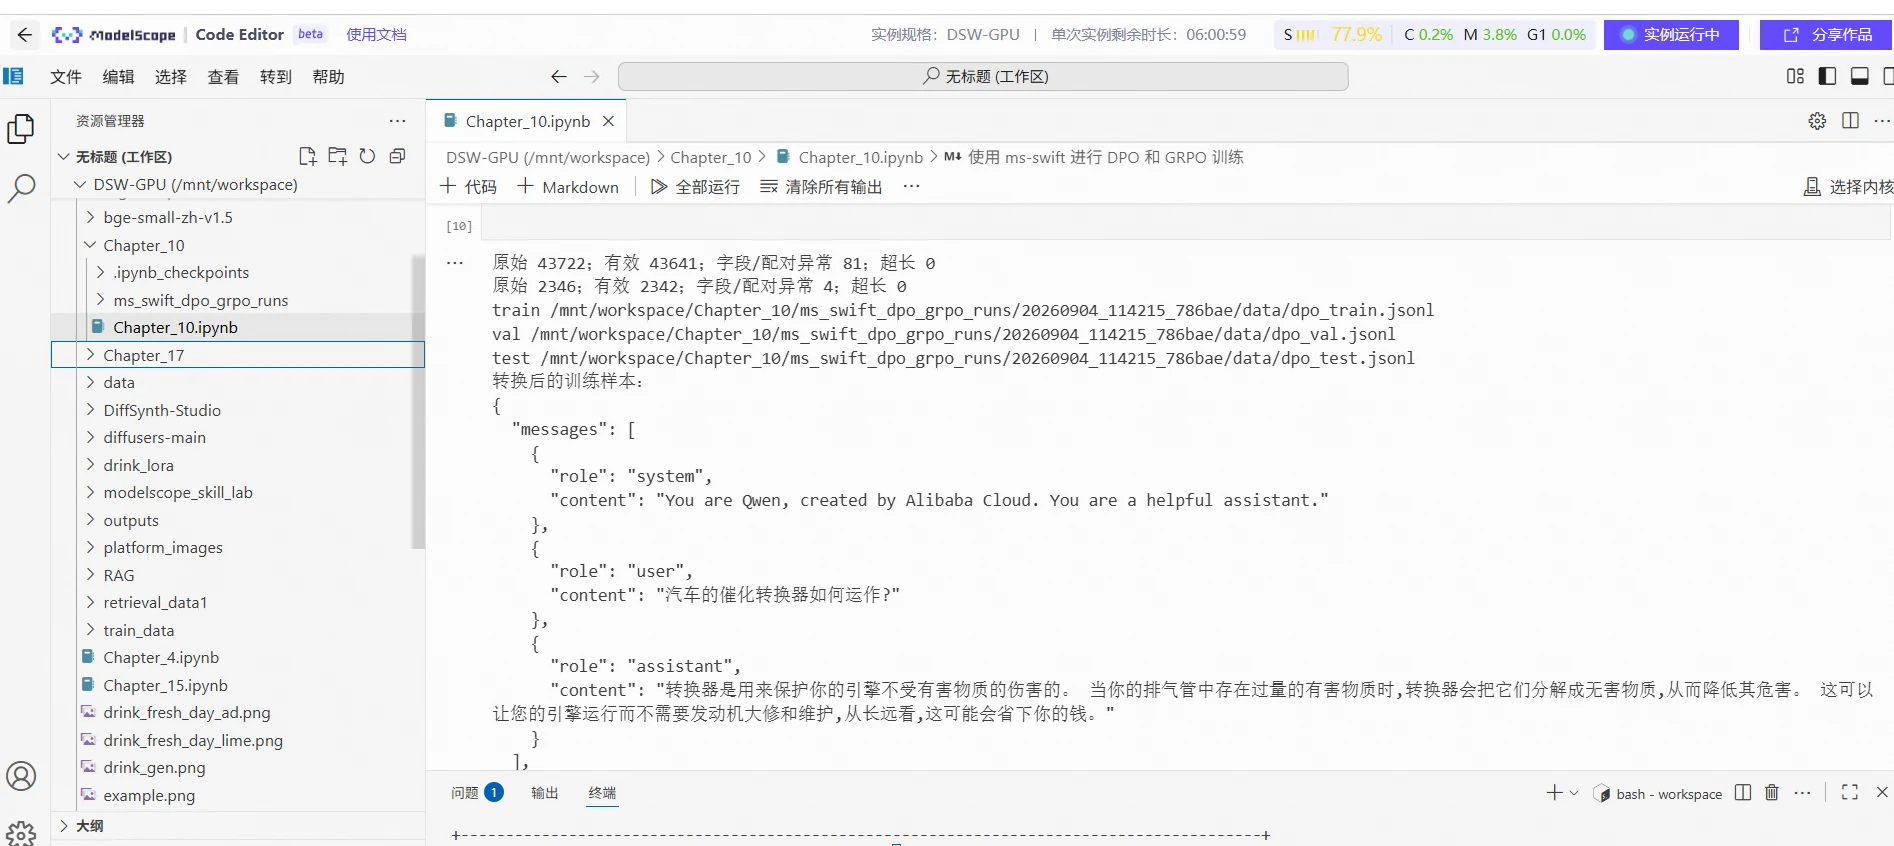
本次分别计算优选回答和非优选回答与上下文拼接后的长度,只保留两者均不超过1024 Token的样本。超长时丢弃整对数据,避免截断后恰好删掉决定回答优劣的关键内容。随后按上下文去重,从原始训练来源中划分256条训练数据和32条验证数据。处理后的文件分别为dpo_train.jsonl、dpo_val.jsonl和dpo_test.jsonl,保存在本次运行目录的data文件夹中。三个文件承担的作用不同:训练集用于更新参数,验证集用于观察训练过程,测试集用于训练后的独立比较。相关执行结果如下图所示。
启动DPO训练 训练前,先用初始模型记录测试集上的表现。Notebook中的dpo_evaluate()会计算32条固定候选对的回答对数概率,并对其中4个上下文生成回答,供训练后比较:
def dpo_evaluate(adapter=None):
    def action(model):
        rows = []
        for index, row in enumerate(dpo_test):
            context = row["messages"][:-1]
            lp_chosen = response_logp(model, context, row["messages"][-1]["content"])
            lp_rejected = response_logp(model, context, row["rejected_response"])
            rows.append({"sample_id": index, "chosen_logp": lp_chosen,
                         "rejected_logp": lp_rejected, "gap": lp_chosen - lp_rejected})
        # 只生成 4 条供精读,其余候选对仍参与概率诊断。
        generations = [{"sample_id": i, "context": dpo_test[i]["messages"][:-1],
                        "response": generate_one(model, dpo_test[i]["messages"][:-1])}
                       for i in range(min(4, len(dpo_test)]
        return rows, generations
    return with_local_model(action, adapter)

dpo_before, dpo_before_text = dpo_evaluate()
两个实验通过common_options()复用公共配置,包括本地模型路径、Qwen对话模板、随机种子、bfloat16精度和LoRA设置。其中LoRA rank为8、alpha为16,目标模块为all-linear。下面保留DPO的完整实验配置;公共函数需要先在配套Notebook中运行。common_options() 函数把公共参数与本实验参数合并。train_swift将这些参数转换为命令行形式,并通过当前内核的Python调用swift.cli.rlhf实现模型训练。
DPO_OUTPUT = RUN_DIR / "dpo"
DPO_BETA = 0.1
dpo_options = common_options() | {
    "rlhf_type": "dpo", "loss_type": "sigmoid", "beta": DPO_BETA,
    "dataset": str(DPO_PATHS["train"]),
    "val_dataset": str(DPO_PATHS["val"]),
    "output_dir": str(DPO_OUTPUT), "max_length": 1024,
    "truncation_strategy": "delete", "max_steps": 20,
    "learning_rate": 5e-5, "lr_scheduler_type": "cosine",
    "warmup_ratio": 0.1,
    "per_device_train_batch_size": 1,
    "per_device_eval_batch_size": 1,
    "gradient_accumulation_steps": 8,
    "eval_strategy": "steps", "eval_steps": 10,
    "save_strategy": "steps", "save_steps": 10,
}
train_swift(dpo_options, RUN_DIR / "dpo_train.log")
DPO_ADAPTER = latest_adapter(DPO_OUTPUT)
参数
本实验值
作用
rlhf_type / loss_type
dpo / sigmoid
使用标准sigmoid形式的DPO目标
beta
0.1
控制DPO目标中相对参考策略的尺度
learning_rate
5e-5
控制每次参数更新的幅度
max_length
1024
限制上下文与候选回答的总长度
per_device_train_batch_size
1
单卡每个训练微批次处理1条偏好对
gradient_accumulation_steps
8
累计8个微批次后更新一次参数
max_steps
20
完成20次优化器更新后结束训练
eval_steps / save_steps
10 / 10
每10步进行验证并保存检查点
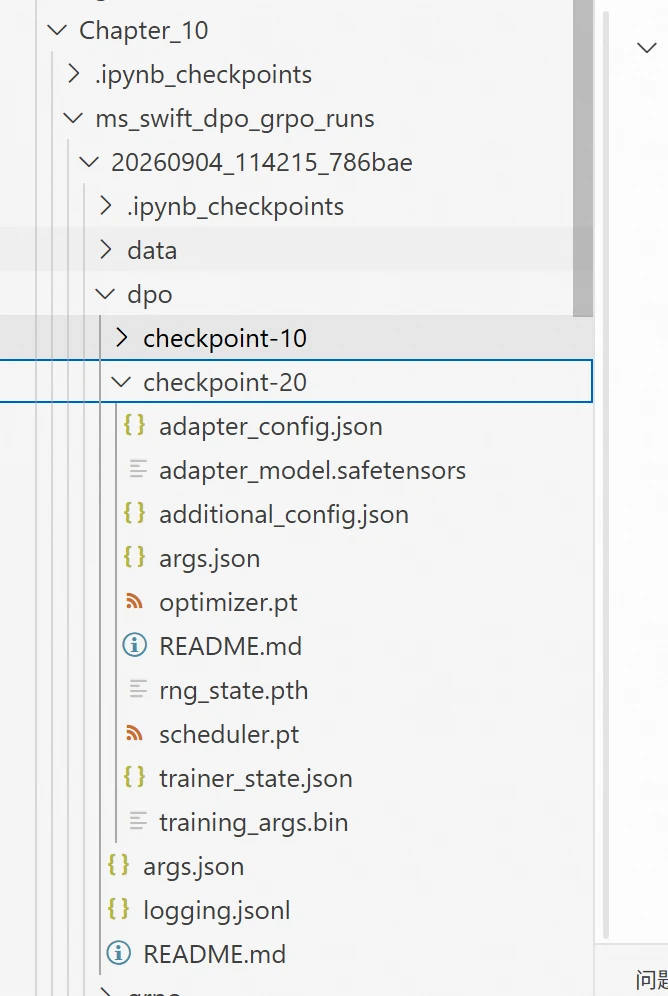
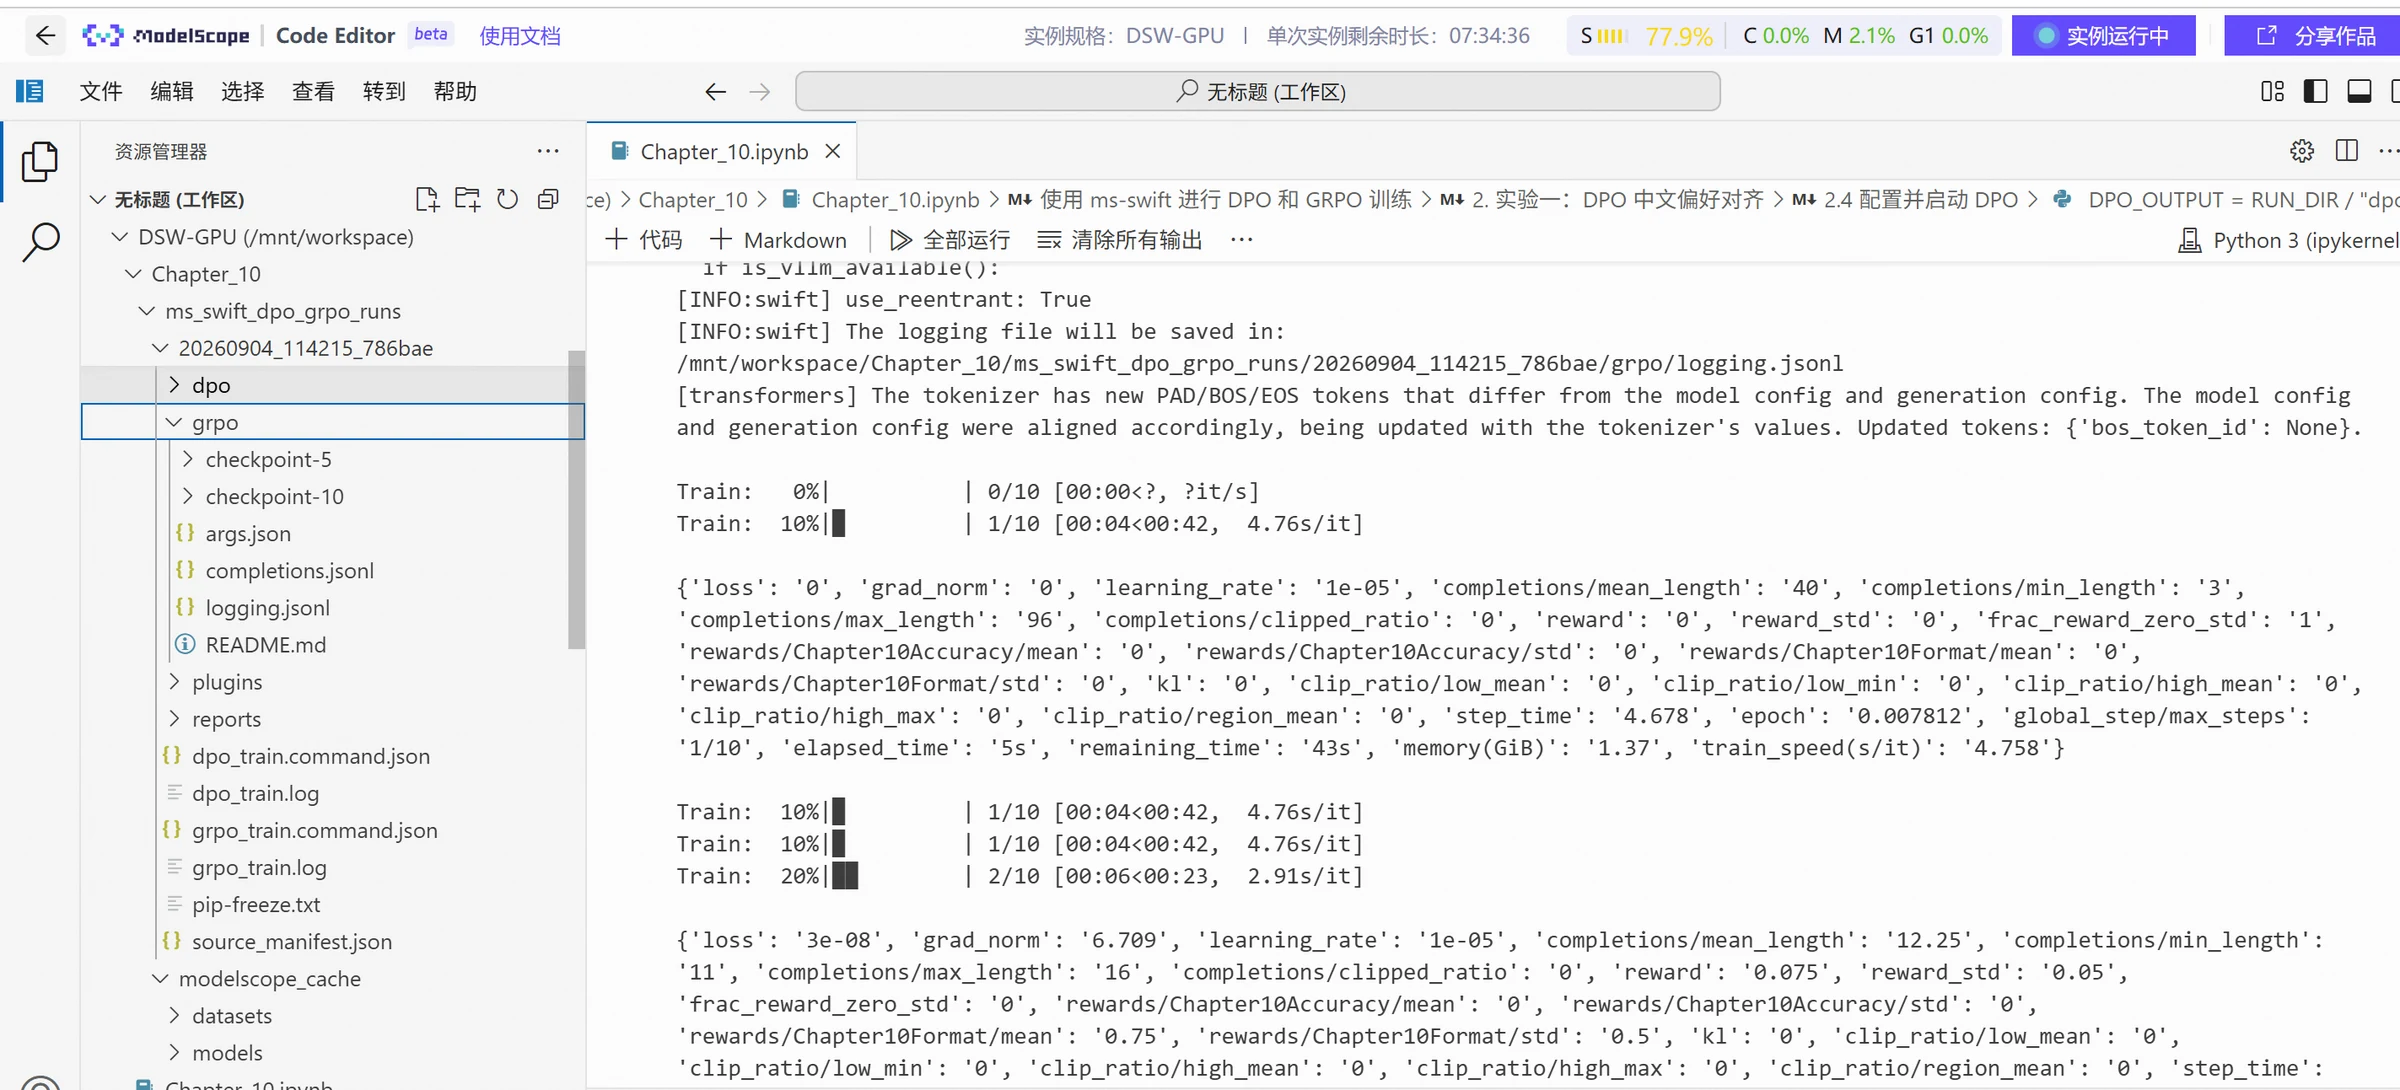
训练开始后,ms-swift会输出损失、隐式奖励、验证指标和检查点保存位置。本次训练完成后,模型将保存于dpo/checkpoint 目录中。模型训练及保存的结果如下图所示。
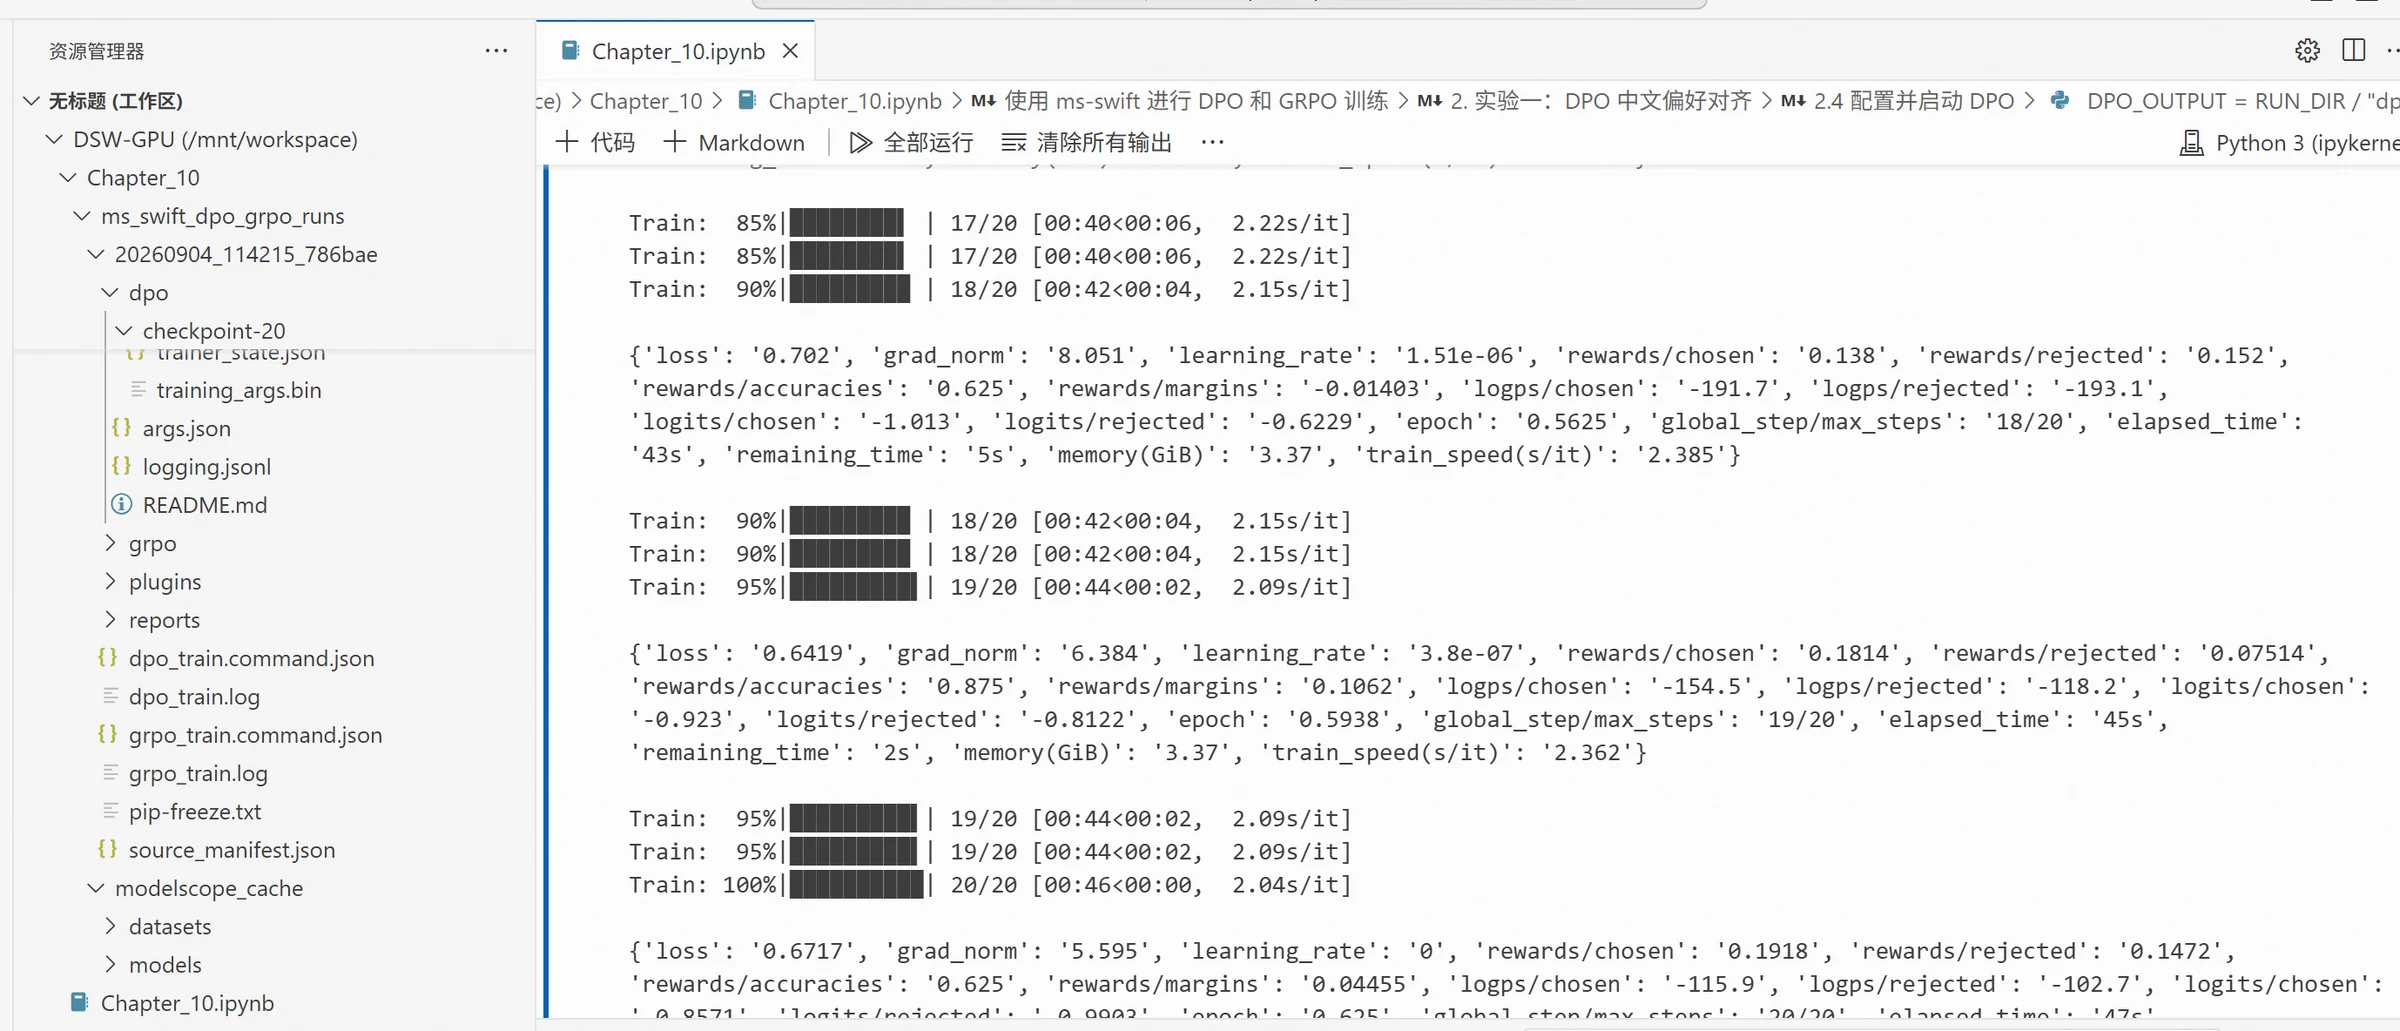
日志中的rewards/chosen和rewards/rejected是根据策略与参考策略的对数概率差计算的隐式奖励,不是某个外部奖励模型对回答质量打出的分数。rewards/accuracies表示隐式奖励排序符合偏好标签的比例,不能直接理解为模型生成回答的正确率。相关日志执行结果如下图所示。
比较DPO训练前后的结果 加载DPO适配器后,再次使用相同测试数据进行评测。比较时保持系统提示、对话模板和生成参数一致,避免把提示词变化或解码方式变化当成训练效果。
dpo_after, dpo_after_text = dpo_evaluate(DPO_ADAPTER)
before_df = pd.DataFrame(dpo_before).set_index("sample_id")
after_df = pd.DataFrame(dpo_after).set_index("sample_id")

comparison = pd.DataFrame({
    "before_gap": before_df["gap"],
    "after_gap": after_df["gap"],
    "relative_dpo_margin": DPO_BETA * (
        after_df["gap"] - before_df["gap"]
    ),
})
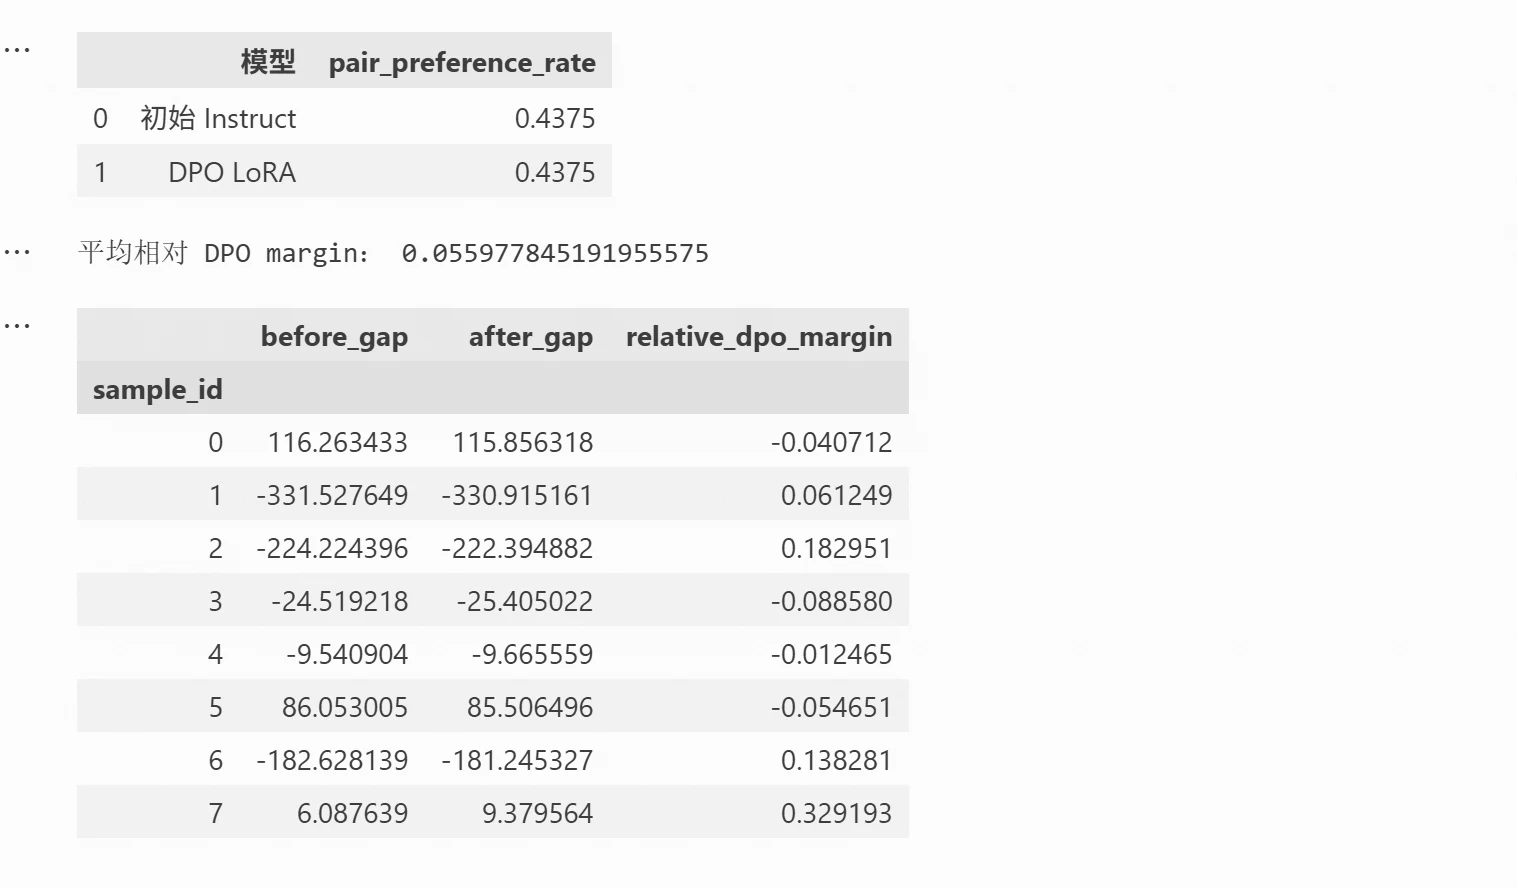
其中,gap等于优选回答的序列对数概率减去非优选回答的序列对数概率。gap大于0,表示当前模型对给定优选回答的序列概率更高。对测试样本统计这一条件成立的比例,就得到pair_preference_rate。
由于训练轮数较少,部分样本的差值可以变大,但仍然没有从负数变成正数,有些样本改善,有些样本退步。因此,平均相对margin为正,不一定会让优选回答占优的样本比例提高。本次实验中,这个比例在训练前后都为43.75%。以测试集中的一个用户询问家庭网络信号的问题为例:
用户:我能用什么方法强化我的家庭网络信号?我的笔记本电脑很难连接到网络路由器!
1. **使用无线路由器**:如果你的家中有多个设备需要上网,可以考虑安装一个无线路由器。这将允许你通过Wi-Fi连接到互联网。
3. **重启路由器**:有时,简单的重启可以解决一些网络连接的问题。请按照路由器的指示进行操作。
从完整输出看,初始回答较多地建议更换或增加设备,训练后更多地围绕网络设置、驱动和重启等操作组织回答,说明训练改变了生成内容。本次DPO的训练改变了部分固定候选的相对概率和部分生成回答,但受限于训练论述和数据,读者可以使用更大规模的数据和训练轮数镜像实验。
准备GRPO数据与奖励函数 DPO使用数据中已经给定的两个回答,GRPO则需要模型在训练时生成候选回答,再由奖励函数评价。本实验使用GSM8K数学应用题,以最终数字和输出格式作为可自动检查的反馈,不单独训练奖励模型。
原始GSM8K数据包含question和answer两个字段。answer中既有解题过程,也有位于####之后的最终数字。数据转换时,只把题目交给模型,把最终数字提取到solution字段中,相关代码如下:
def convert_grpo(row):
    question = row["question"].strip()
    original_answer = row["answer"].strip()
    assert question and "####" in original_answer
    answer = parse_numeric(original_answer.rsplit("####", 1)[-1])
    assert answer is not None
    return {
        "messages": [
            {"role": "system", "content": MATH_SYSTEM},
            {"role": "user", "content": question},
        ],
        "solution": str(answer),
    }
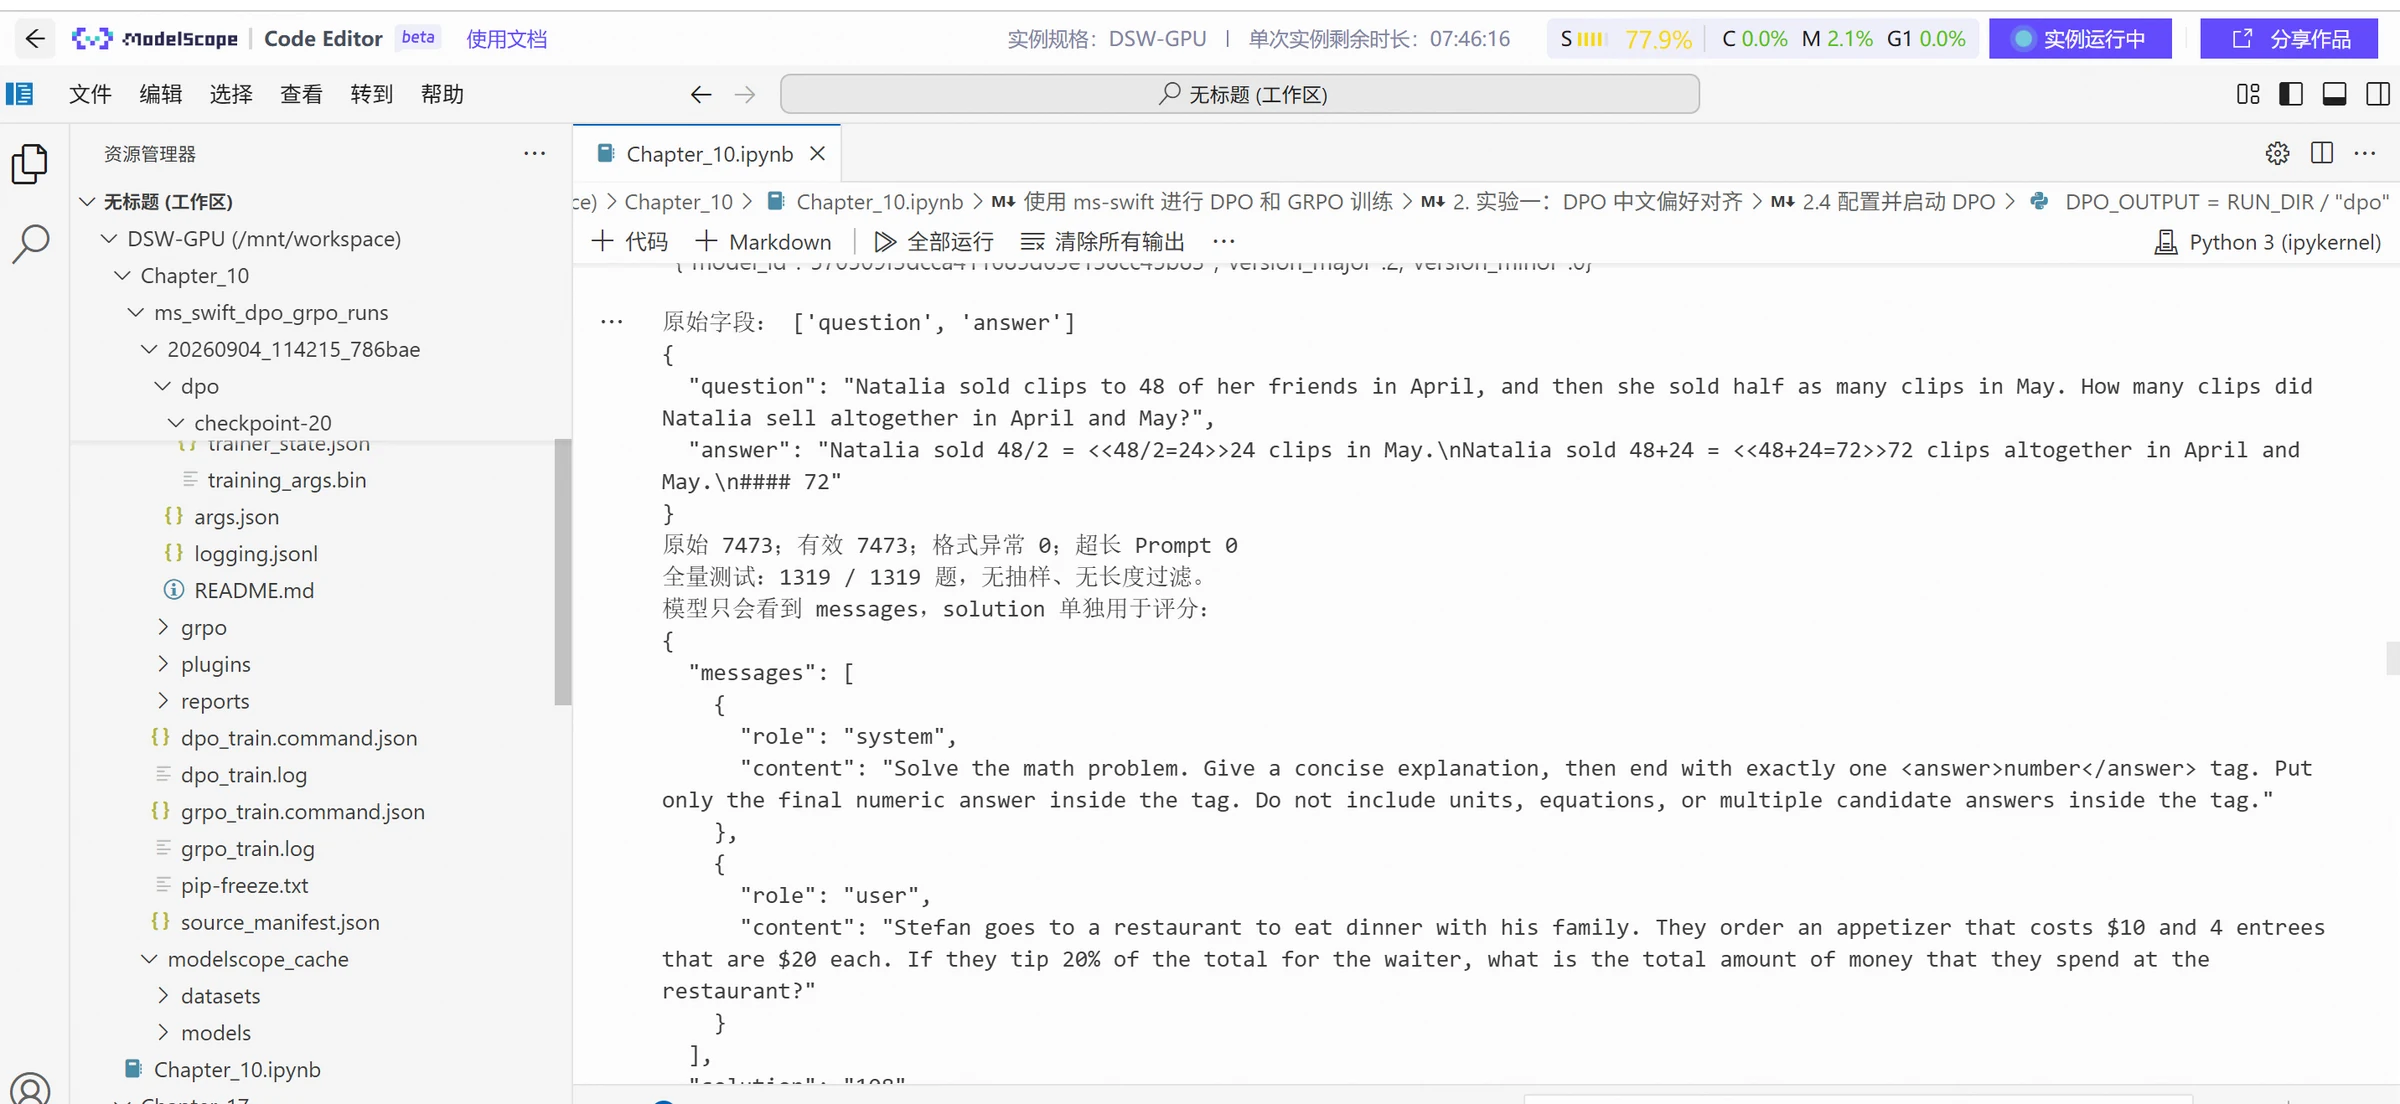
转换后的messages没有标准解题过程,也没有供模型模仿的assistant回答。solution作为附加数据列交给奖励函数,不拼接到Prompt中。这样训练时,模型需要自己生成答案,评分程序再把它与标准答案比较。本次从原始训练来源中清洗、去重并划分128道训练题和16道验证题。训练和验证Prompt的长度限制为512 Token。测试使用官方测试文件的全部1319道题,保留原始顺序,不按训练长度阈值删题,并检查它们与训练、验证数据是否重叠。相关执行结果如下:
正确性奖励要求模型输出符合指定标签格式,并且标签中的数字与solution相等,满足时为1,否则为0。格式奖励只检查标签是否唯一、是否位于回答末尾,以及内容能否解析为数字,满足时为1,否则为0。相关代码如下:
def extract_answer(completion):
    if not isinstance(completion, str):
        return None
    if completion.count("<answer>") != 1 or completion.count("</answer>") != 1:
        return None
    match = re.search(r"<answer>\s*([^<>]+?)\s*</answer>\s*\Z", completion)
    return parse_numeric(match.group(1) if match else None

class Chapter10Accuracy(ORM):
    def __call__(self, completions, solution, **kwargs):
        if len(completions) != len(solution):
            raise ValueError("候选回答与 solution 数量不匹配。")
        rewards = []
        for text, gold in zip(completions, solution):
            expected = parse_numeric(gold)
            if expected is None:
                raise ValueError(f"标准答案格式无效:{gold!r}")
            predicted = extract_answer(text)
            rewards.append(float(predicted is not None and predicted == expected)
        return rewards

class Chapter10Format(ORM):
    def __call__(self, completions, **kwargs):
        return [float(extract_answer(text) is not None) for text in completions]
其中,completions是一组模型生成的回答,solution是训练器传入的对应标准答案。extract_answer先检查标签数量,再确认标签位于回答末尾,最后提取其中的数字。这种奖励只检查最终结果,不验证解题过程。模型即使没有给出解释,只要输出正确的答案标签,也可以得到全部奖励。系统提示中的“简要解释”并没有被写入评分条件,因此不能把获得高分理解为模型已经学会完整、可靠的推理。
orms["chapter10_accuracy"] = Chapter10Accuracy
orms["chapter10_format"] = Chapter10Format
Notebook把完整插件保存为plugins/chapter10_rewards.py,后面通过external_plugins指定文件路径,并通过reward_funcs指定上述注册名称。插件应包含自己的导入和辅助函数,因为它会在训练子进程中独立加载。注册方法可参照ms-swift 4.4.2官方奖励插件示例 。
模型输出
标准答案
正确性奖励
格式奖励
总奖励
We obtain twelve. <answer>12</answer>
12
1
1
1.1
<answer>12.0</answer>
12
1
1
1.1
<answer>13</answer>
12
0
1
0.1
The answer is 12.
12
0
0
0
<answer>11</answer><answer>12</answer>
12
0
0
0
<answer>12</answer> or maybe 13
12
0
0
0
根据本次所采用的奖励函数计算方法,,普通文本The answer is 12.虽然包含正确数字,但没有满足格式要求,所以严格正确性奖励仍然为0。多个答案标签也不会通过检查,避免模型靠枚举答案获得奖励。
启动GRPO训练并观察日志 完成数据和奖励函数准备后,完成相关实验的设置和训练任务。
本实验对同一道题生成4个候选回答,生成批量也设置为4,因此一个生成批次对应1道题的4个候选。随后每个训练微批次处理1个候选,累计4个微批次更新一次参数。
下面是本次GRPO的实验配置。GRPO_PATHS、PLUGIN_PATH等相关配置及内容。
GRPO_OUTPUT = RUN_DIR / "grpo"
grpo_options = common_options() | {
    "rlhf_type": "grpo", "loss_type": "grpo",
    "dataset": str(GRPO_PATHS["train"]),
    "val_dataset": str(GRPO_PATHS["val"]),
    "output_dir": str(GRPO_OUTPUT),
    "external_plugins": str(PLUGIN_PATH),
    "reward_funcs": ["chapter10_accuracy", "chapter10_format"],
    "reward_weights": [1.0, 0.1], "remove_unused_columns": False,
    "num_generations": 4, "generation_batch_size": 4,
    "per_device_train_batch_size": 1,
    "gradient_accumulation_steps": 4,
    "per_device_eval_batch_size": 4, "num_generations_eval": 4,
    "max_length": 512, "max_completion_length": 256,
    "truncation_strategy": "left",
    "max_steps": 10, "learning_rate": 1e-5,
    "lr_scheduler_type": "constant", "warmup_ratio": 0.0,
    "beta": 0.04, "num_iterations": 1,
    "temperature": 0.9, "top_p": 0.95,
    "use_vllm": False, "log_completions": True,
    "eval_strategy": "steps", "eval_steps": 5,
    "save_strategy": "steps", "save_steps": 5,
}
train_swift(grpo_options, RUN_DIR / "grpo_train.log")
GRPO_ADAPTER = latest_adapter(GRPO_OUTPUT)
组大小与生成批量需要配合设置。生成批量必须能被组大小整除,也必须能被单卡训练微批量乘以GPU进程数的结果整除。本次是单卡单进程,生成批量4、组大小4、训练微批量1满足这些条件;验证时批量和组大小也都为4。如果调整组大小,应同时核对生成批量、训练梯度累积和验证配置。本次训练完成10步,保存了grpo/checkpoint-10。
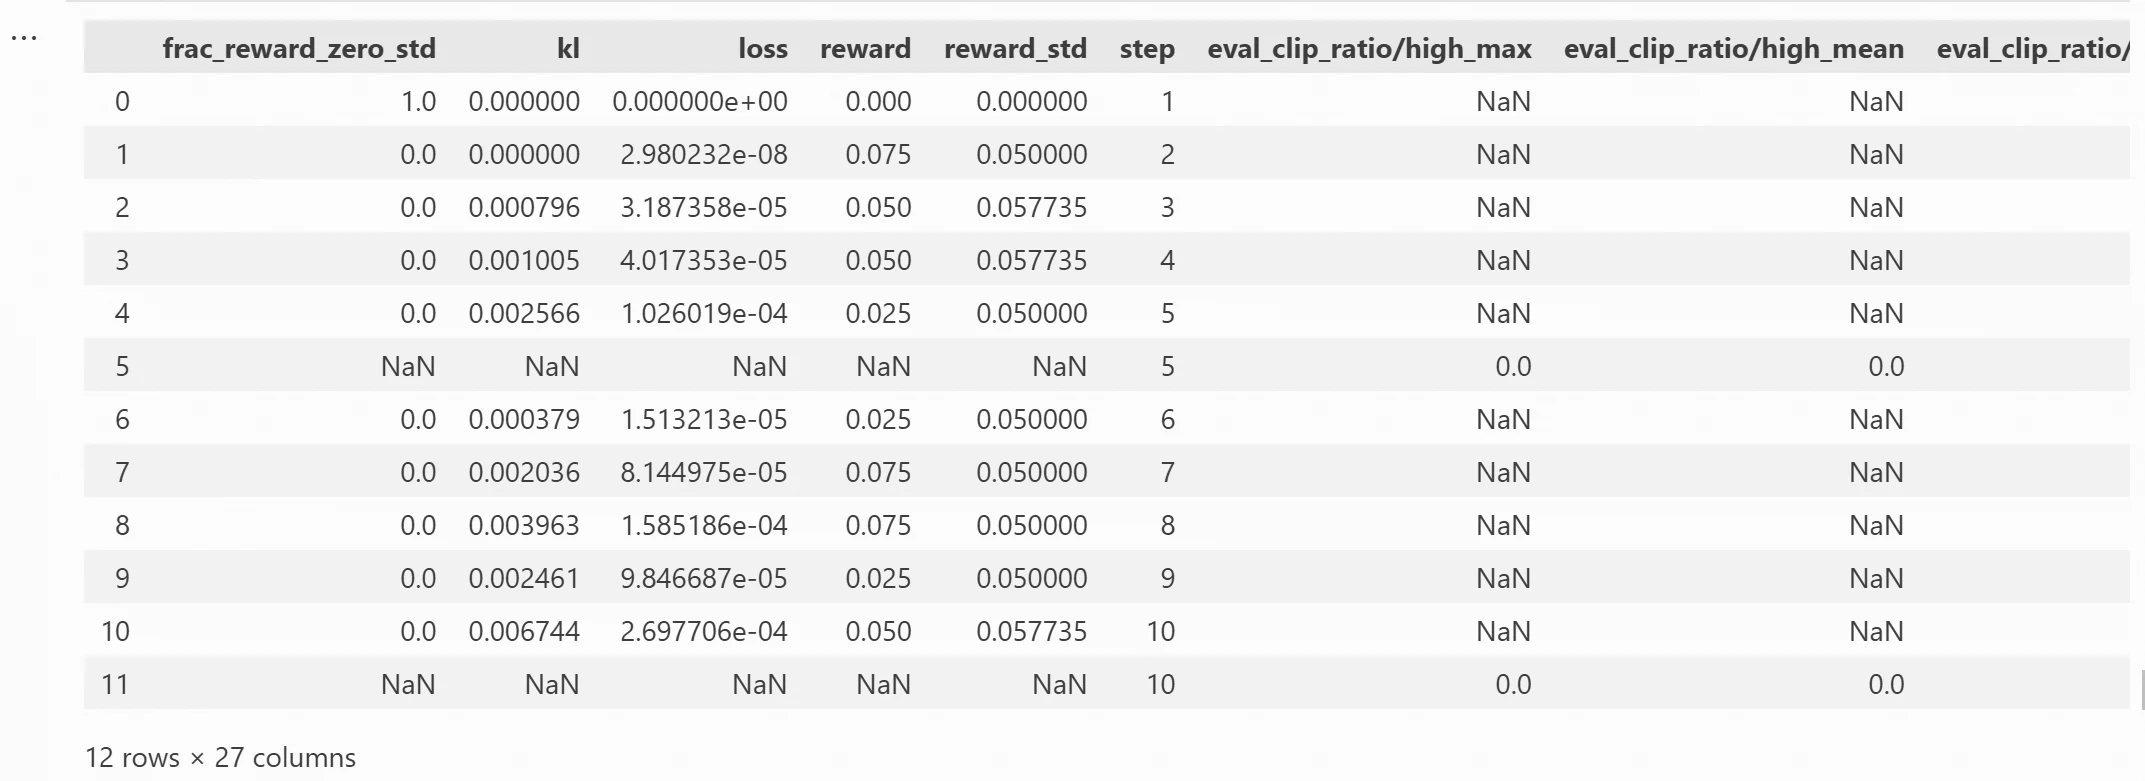
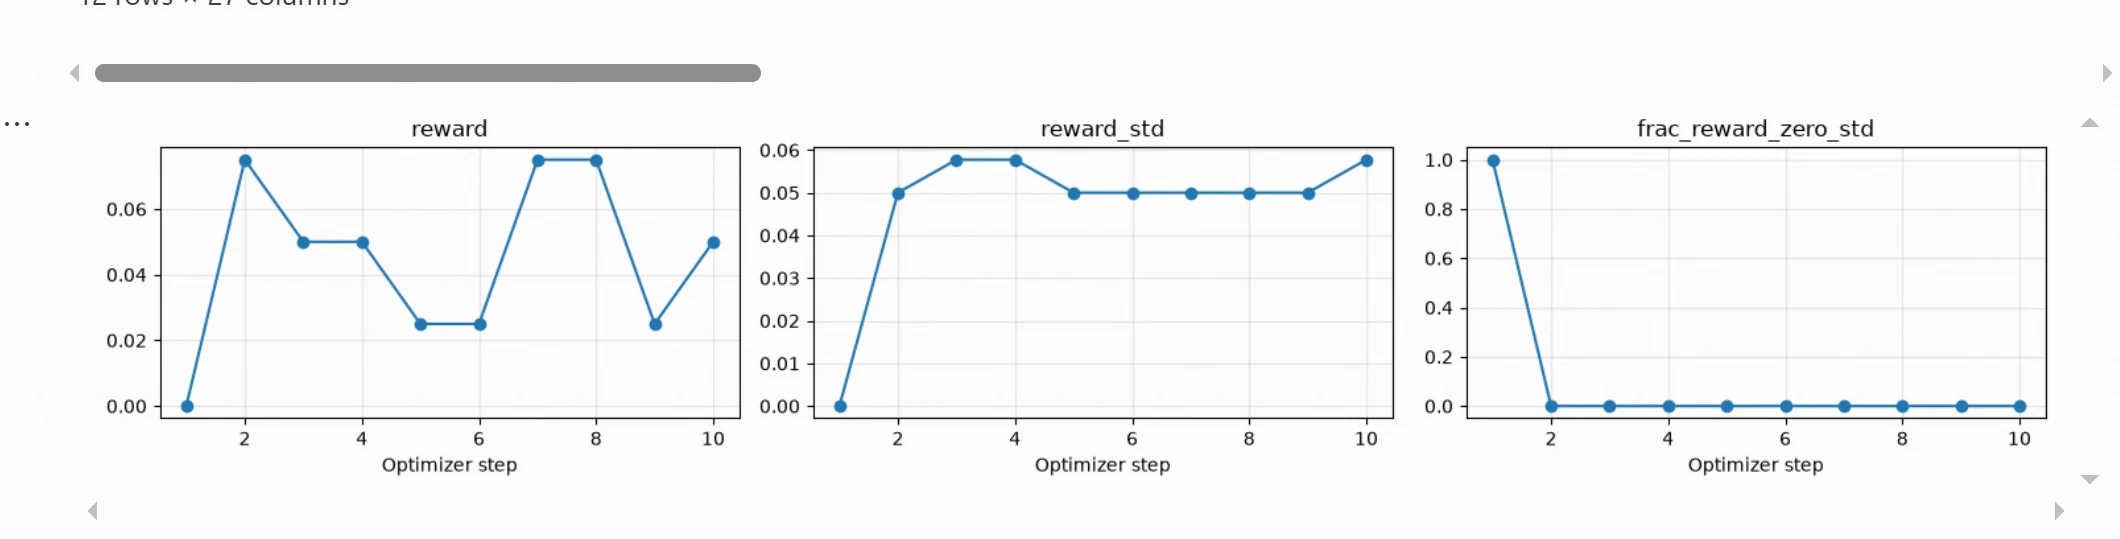
GRPO训练损失不是数学题正确率。观察训练时,应把总奖励、奖励分项和组内差异放在一起看。日志中的reward表示当前汇总的奖励,reward_std用于观察组内奖励差异,frac_reward_zero_std表示组内奖励标准差为零的组所占比例。相关训练统计结果可视化结果如下图所示:
从图中可以看到,训练从第2步开始出现非零的组内奖励差异,同分组比例降为0,说明奖励函数已经能够区分不同候选回答,为GRPO提供有效的优化信号。本次仅进行了10个训练步骤,正确性奖励较为稀疏,数学答案正确率尚未提高;后续可以增加训练轮数,让模型接触更多题目和候选回答,并结合验证集观察训练效果可能更为明显。
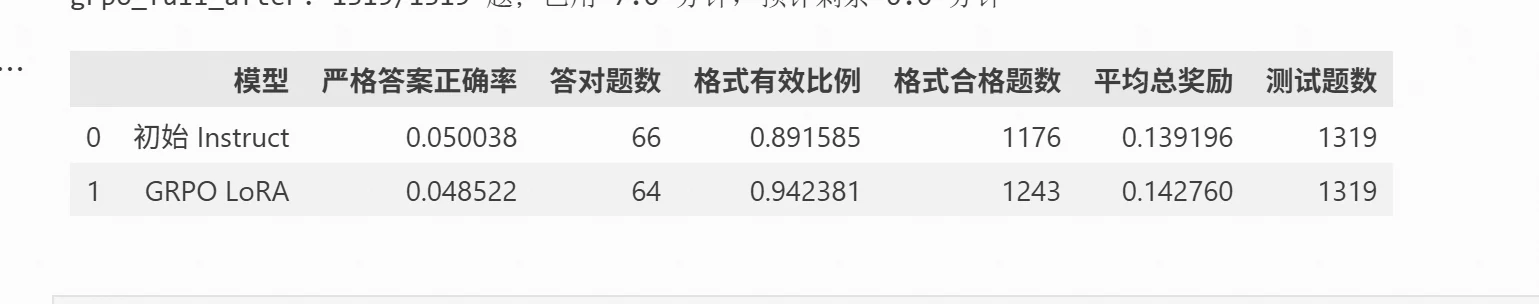
全量评测与结果分析 训练日志反映的是训练过程中采样到的候选,最终还需要用独立测试集比较模型表现。每道题只生成一个回答,不属于多次随机采样后选择最好答案的评测。
初始结果由训练前的grpo_evaluate()保存。训练结束后传入GRPO适配器,再汇总相同题目上的结果。下面摘录评测与汇总代码;Notebook还会检查样本编号、题目和标准答案是否一一对应。
grpo_after = grpo_evaluate(GRPO_ADAPTER)
grpo_summary = pd.DataFrame([
    {
        "模型": name,
        "严格答案正确率": np.mean([r["correct"] for r in rows]),
        "答对题数": int(sum(r["correct"] for r in rows),
        "格式有效比例": np.mean([r["format_ok"] for r in rows]),
        "格式合格题数": int(sum(r["format_ok"] for r in rows),
        "平均总奖励": np.mean([r["total_reward"] for r in rows]),
        "测试题数": len(rows),
    }
    for name, rows in [
        ("初始 Instruct", grpo_before), ("GRPO LoRA", grpo_after)
    ]
])
display(grpo_summary)
结合上述全量评测结果,模型的格式有效比例由89.16%提高到94.24%,体现了本次训练在规范输出格式方面的作用。后续的实验和训练,可以进一步调整题目难度或奖励设计,使后续结果能够获得更充分的答案正确性反馈。
本章节所有实验数据和代码,可参考:https://modelscope.cn/gallery/liucong/8a5fefc5-6f90-42df-9a09-bc9781ed3da8