AIUnlimited
🌳

KI-Grundlagen

🌱
AI Seeds

Starte bei null

🌿
AI Sprouts

Fundament aufbauen

🌳
AI Branches

In der Praxis anwenden

🏕️
AI Canopy

In die Tiefe gehen

🌲
AI Forest

KI meistern

🔨

KI-Meisterschaft

✏️
AI Sketch

Starte bei null

🪨
AI Chisel

Fundament aufbauen

⚒️
AI Craft

In der Praxis anwenden

💎
AI Polish

In die Tiefe gehen

🏆
AI Masterpiece

KI meistern

📘

KI-Praxis

📖
Open-Source-Modelle verstehen

Grundlagen und Ressourcen für Open-Source-Modelle

🎯
Vom Problem zur Modellaufgabe

Geschäftsprobleme in Modellaufgaben umwandeln

⚡
Ihr erstes Modell ausführen

Sehen Sie Ihre ersten Ergebnisse in 30 Minuten

🔧
Fine-Tuning und Evaluierung

Modelle feinjustieren und Leistung bewerten

🚀
Anwendungssysteme

Bauen Sie reale KI-Anwendungen

🎨
Generative KI

Erkunden Sie Open-Source-AIGC-Modelle

🤖
Agenten

Lernen Sie Agent-Frameworks und MCP-Werkzeuge

📐
Ergänzende Grundlagen

LLM-Grundlagen und Evaluierung

🎓

Claude Akademie

🤖
Claude 101

Learn AI basics with Claude

💻
Claude Code 101

Code with Claude as your pair programmer

🤝
Introduction to Claude Cowork

Collaborate with Claude on complex projects

⚙️
Claude Platform 101

Build apps with the Claude API

Labor

7 Experimente geladen
🧬Neuronales Netz Sandbox🤖KI oder Mensch?🥋Prompt Engineering Dojo🏁Algorithmus-Rennen🧠KI-Quizduell🏗️Systemdesign-Leinwand
🎯ProbeinterviewLabor betreten→
🚀

Karriereentwicklung

🚀
Interview-Startrampe

Starte deine Reise

🌟
Verhaltensinterview-Meisterschaft

Soft Skills meistern

💻
Technische Interviews

Die Coding-Runde bestehen

🤖
AI- & ML-Interviews

ML-Interview meistern

🏆
Angebot & Karriere

Das beste Angebot sichern

Loslegen
AIUnlimited

MIT-Lizenz

沪ICP备18025655号-11

Lernen

  • KI-Grundlagen
  • KI-Praxis
  • Claude Akademie
  • Labor
  • Karriereentwicklung

Community

  • Über uns
  • FAQ

Unterstützung

  • Nutzungsbedingungen
  • Datenschutzerklärung
  • Kontakt
KI & Engineering Programme›📖 Open-Source-Modelle verstehen›Lektionen›Data: The Foundation of Fine-Tuning
📊
Open-Source-Modelle verstehen • Anfänger⏱️ 12 Min. Lesezeit

Data: The Foundation of Fine-Tuning

Daten: Die Grundlage des Open-Source-Modell-Fine-Tunings

Sind Sie schon einmal auf ein Modell gestoßen, das hervorragend programmiert und Mathe löst, aber auf Alltagsfragen zufällig antwortet?

Wir wissen alle, dass man zur Verbesserung einer bestimmten Fähigkeit während des Trainings die entsprechenden Daten finden muss,

Aber viele Datensätze sind schwer direkt im Internet zu finden. Ein einheitlicher Download-Portal spart Trainern enorm viel Aufwand.

Unser open-source chinesisches DeepSeek-R1-Distillations-Datensatz hat einen Großteil seiner Rohdaten direkt von ModelScope heruntergeladen,
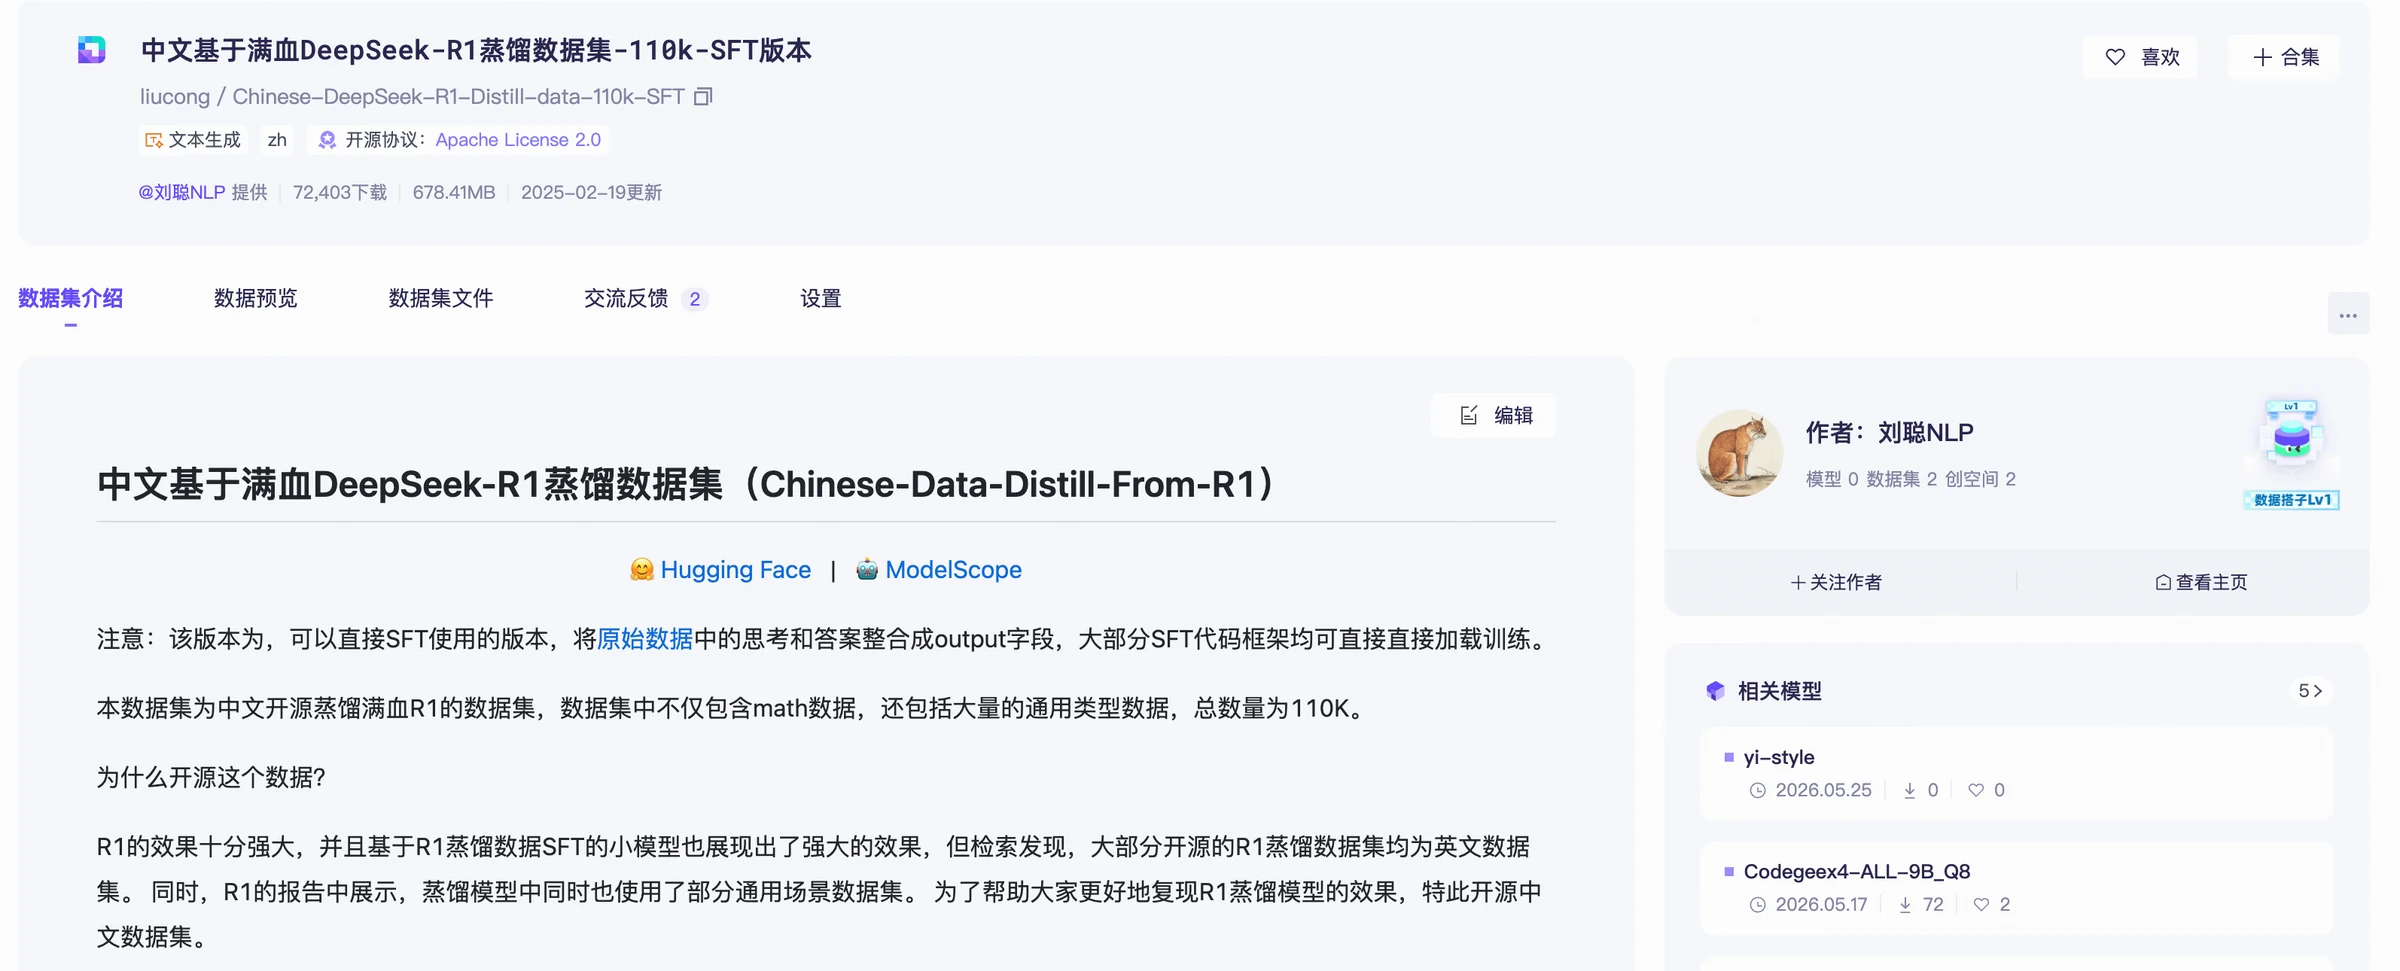
Illustration

Das Feintuning eines Modells kann mit einem vorhandenen Open-Source-Datensatz beginnen, sodass der gesamte Prozess schnell durchlaufen werden kann.

Datensätze Finden Erfordert zu Wissen, Was Man Vorhat

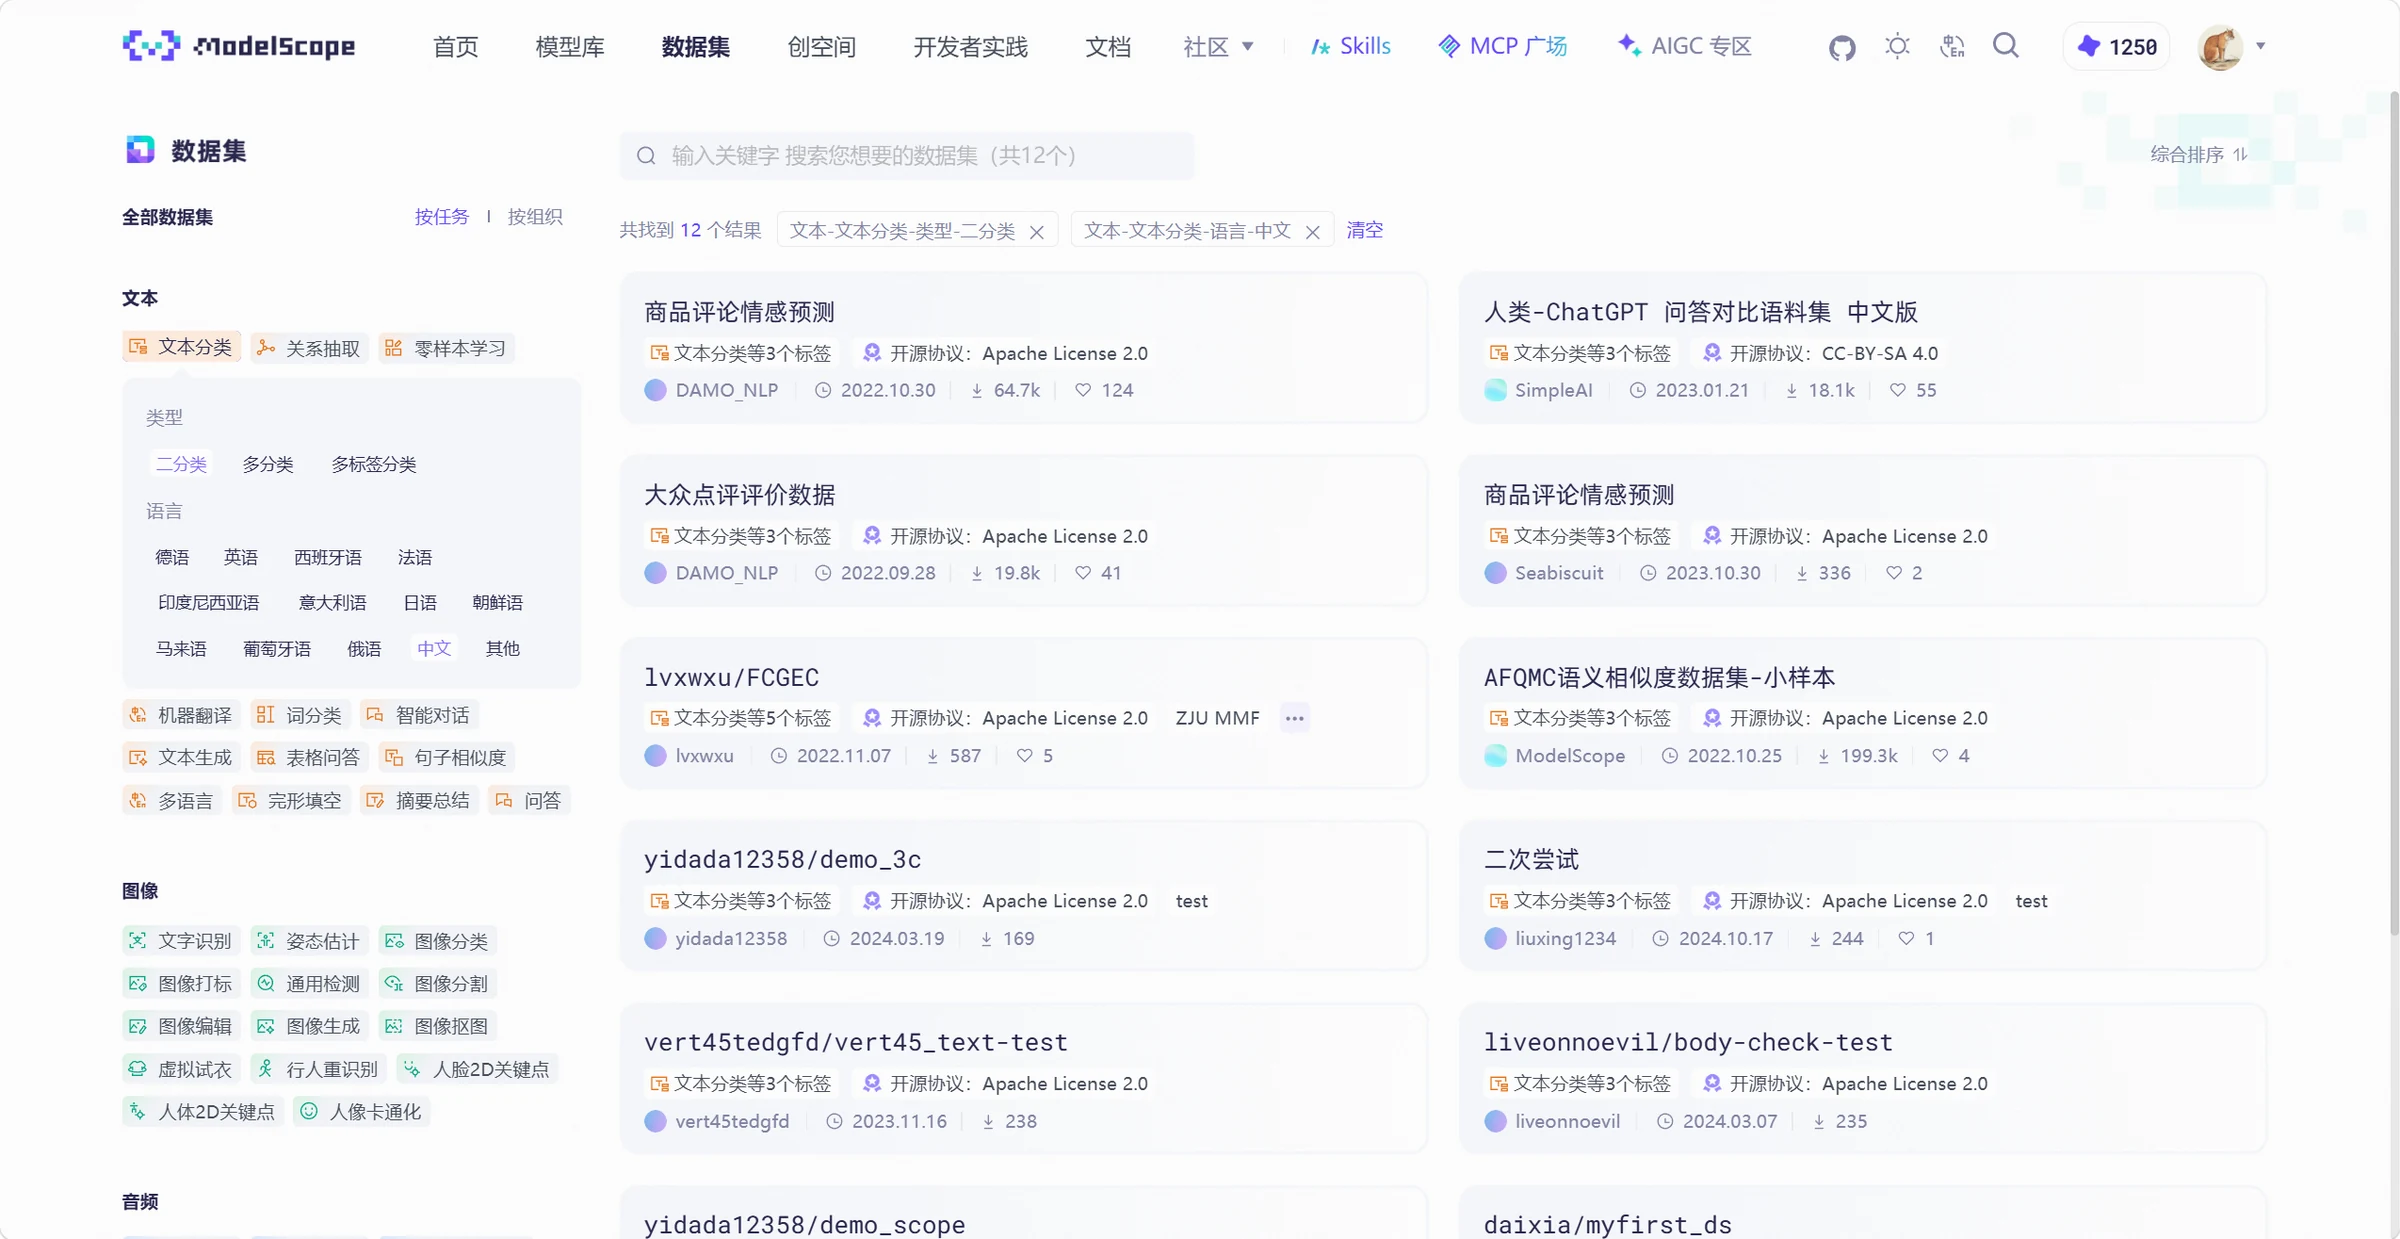
ModelScope bietet über 40.000 Open-Source-Datensätze mit Suche, Vorschau, Feldbeschreibungen und Versionen.

ModelScope unterstützt die Suche nach Stichwörtern und Aufgabenkategorien, z.B. chinesische binäre Textklassifikationsdaten,
Illustration

Vor dem Herunterladen, Proben Ansehen

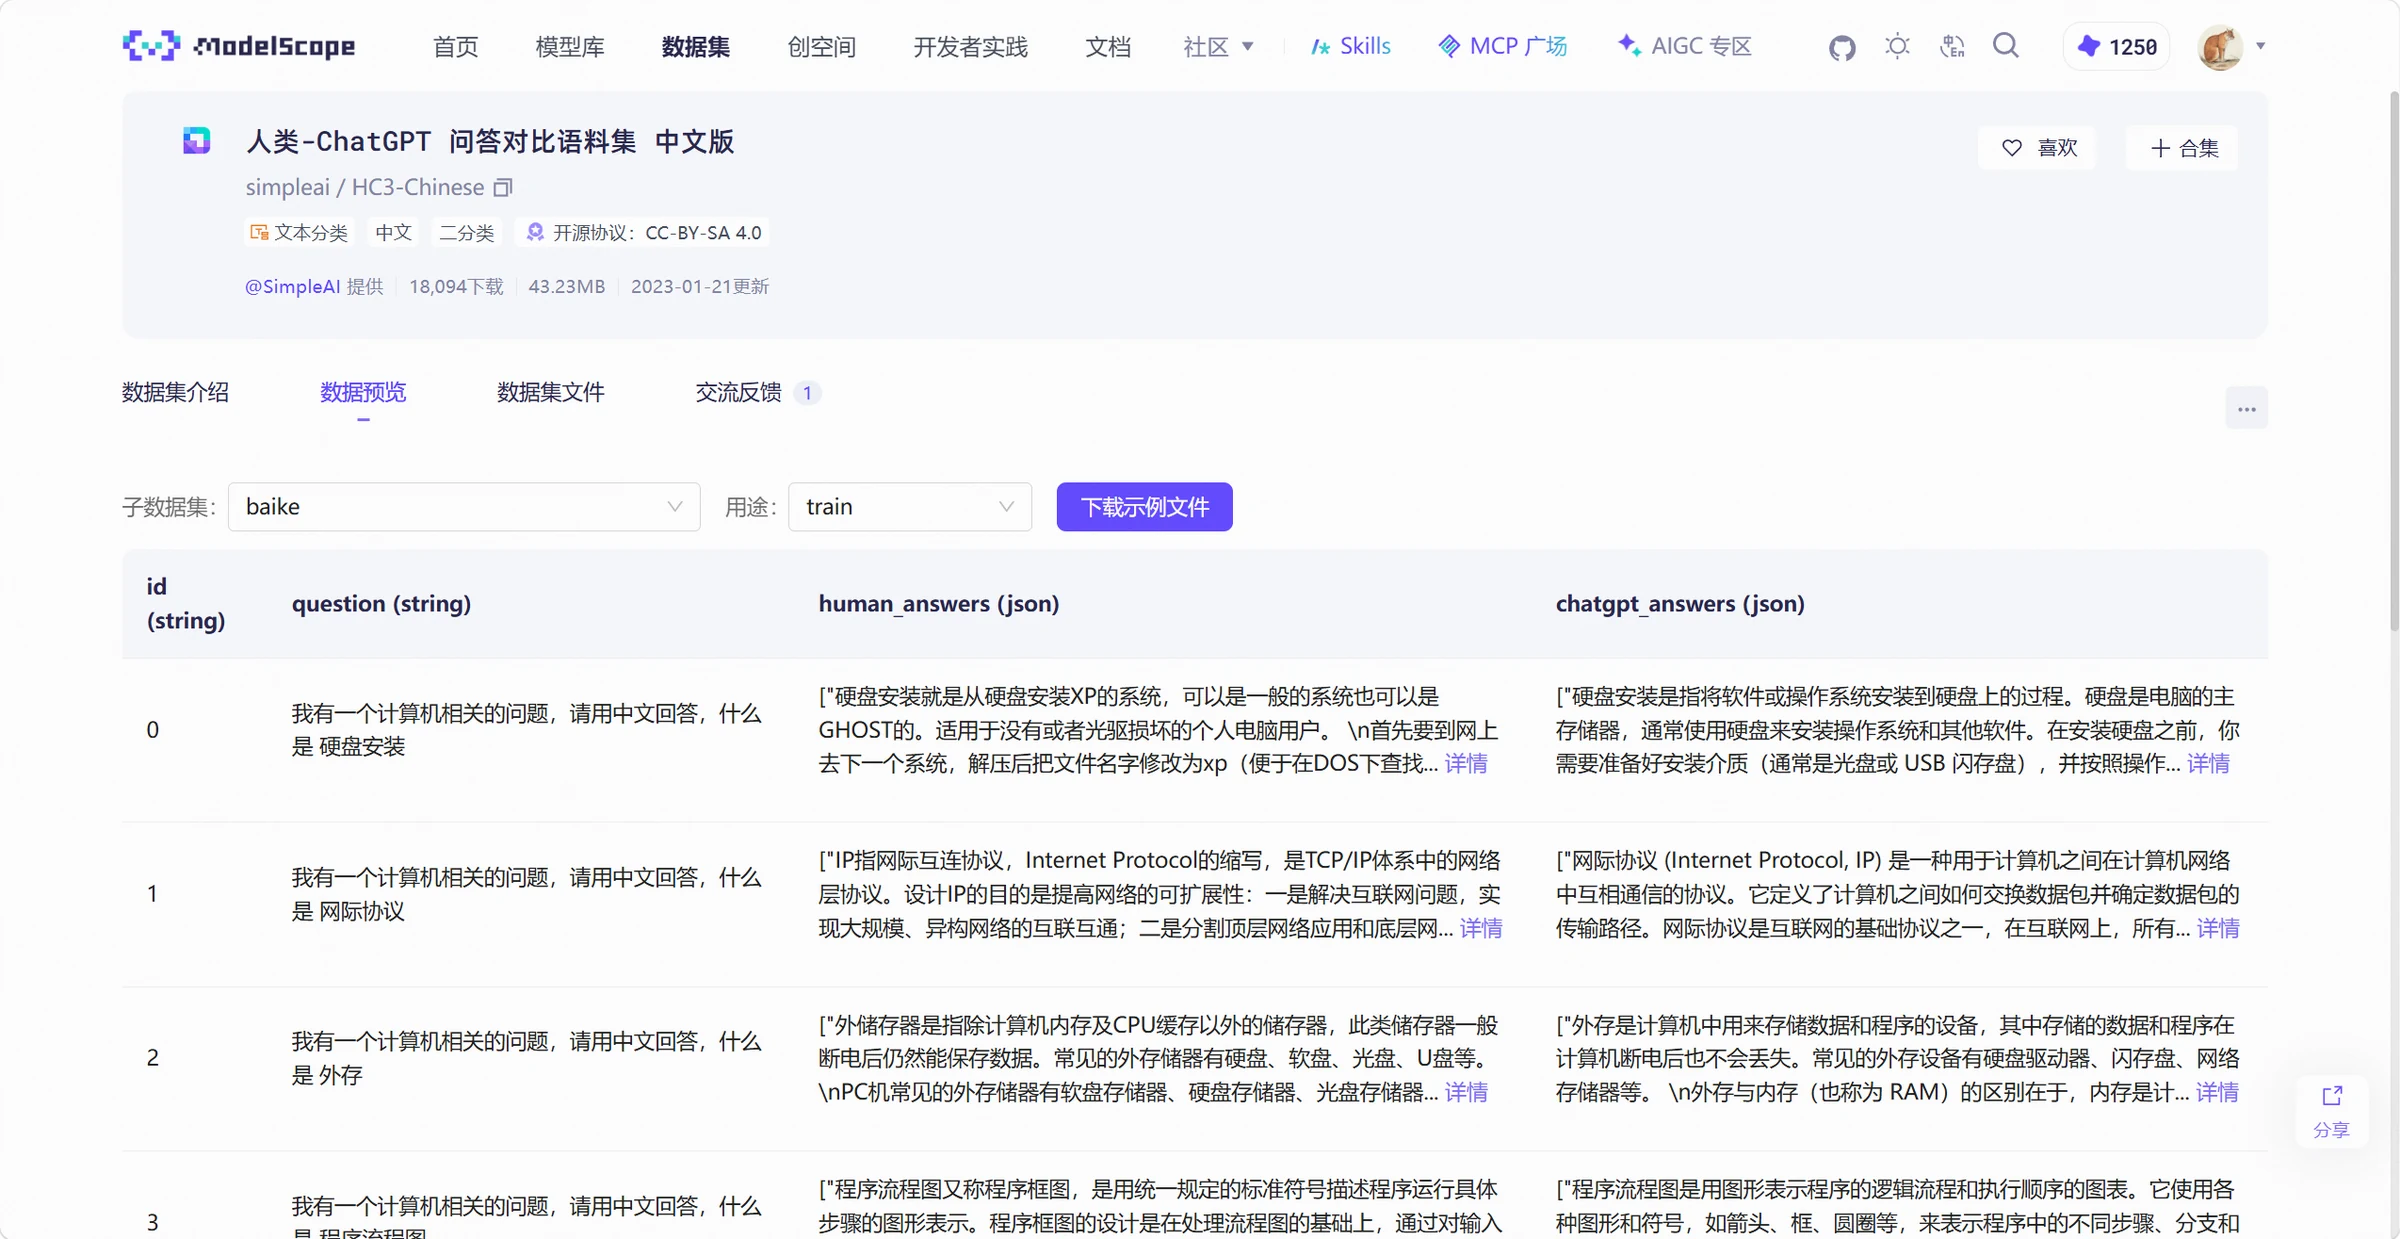
Nach dem Filtern wählen Sie einen Datensatz und klicken auf 'Datenvorschau', um Proben und Feldbeschreibungen online anzusehen, wie simpleai/HC3-Chinese.
Illustration

Welche Spalte die Frage, Antwort, Labels enthält und ob jeder Eintrag Text oder Dialog ist — all das kann vorab überprüft werden.

Bei QA-Daten können menschliche und Modellantworten in verschiedenen Feldern sein. Entscheiden Sie vor dem Training, welche Felder Sie lesen und wie Sie organisieren.

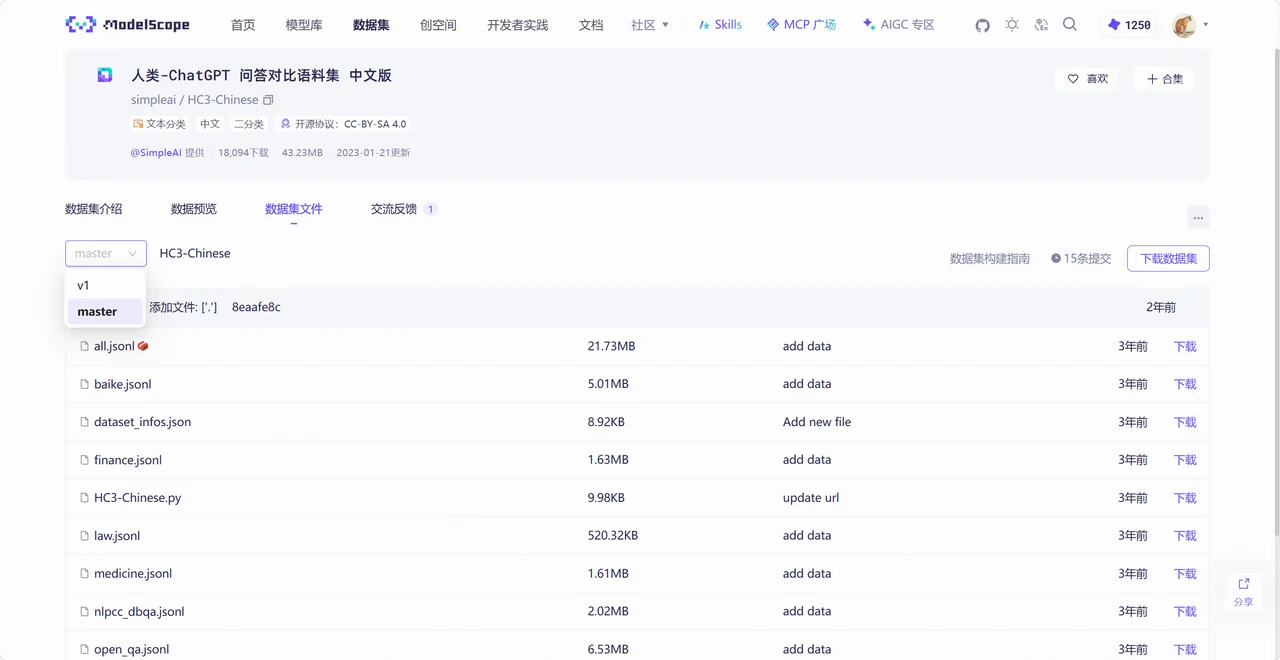
Überprüfen Sie Dateien und Versionen. Datensätze werden aktualisieren; notieren Sie die verwendete Version für Reproduzierbarkeit.
Illustration

Beschreibungen und Lizenzen sind einen Blick wert. Heruntergeladene Daten können unterschiedliche Anforderungen für Forschung, Training oder kommerzielle Nutzung haben.

Laden Sie Zuerst die Daten, dann Entscheiden Sie

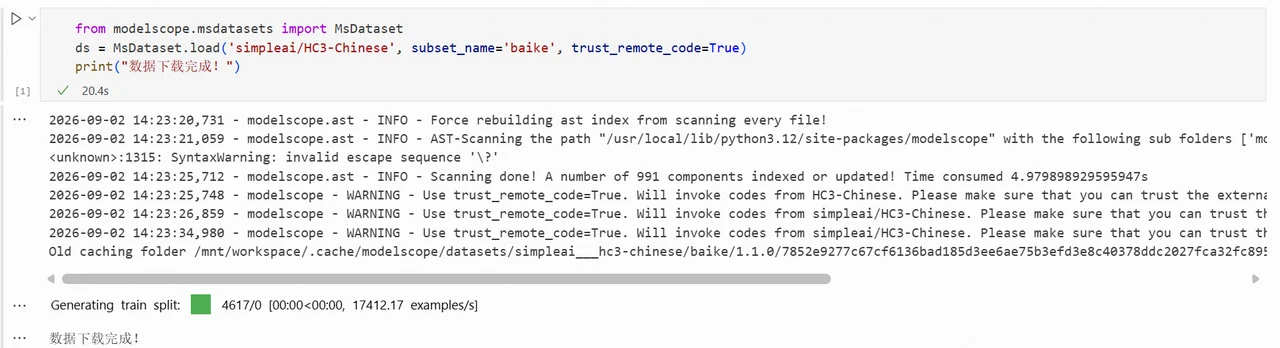
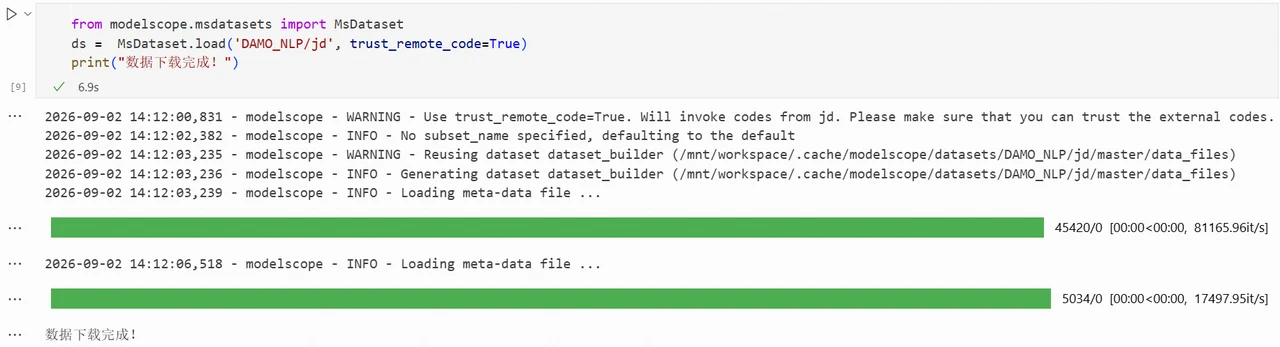
ModelScope bietet die MsDataset.load-Schnittstelle zum Laden von Datensätzen in Python. Nach der Installation folgen Sie den Anweisungen auf der Datensatzseite.

Laden Sie Zuerst Einen Vollständigen Datensatz

Mit DAMO_NLP/jd als Beispiel, so lesen Sie die Standardkonfiguration,

Lektion 3 von 40% abgeschlossen
←Model Discovery and Downloads

Diskussion

Anmelden an der Diskussion teilnehmen
from modelscope.msdatasets import MsDataset

ds = MsDataset.load(
    'DAMO_NLP/jd',
    trust_remote_code=True,
)
print(ds)
Illustration

Wenn Sie Nur Einen Untermenge Benötigen, Klären Sie Den Namen

Einige Datensätze trennen Daten nach Quelle, Bereich oder Zweck. Wenn Sie nur einen Teil benötigen, verwenden Sie subset_name.

Laden Sie z.B. die Untermenge baike aus HC3-Chinese.

from modelscope.msdatasets import MsDataset

ds = MsDataset.load(
    'simpleai/HC3-Chinese',
    subset_name='baike',
    trust_remote_code=True,
)
print(ds)
Illustration

Beim Wechsel des Datensatzes prüfen Sie die verfügbaren Untermengen. baike ist spezifisch für diesen Datensatz.

Trainings- und Testsets Können Getrennt Geladen Werden

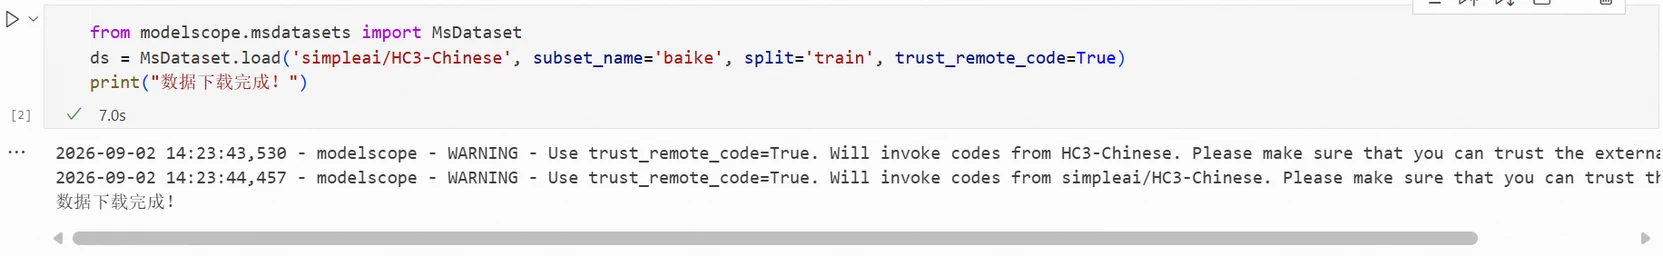
Die Untermenge wählt die Datenkategorie, während split die Datenpartition wählt. Häufige sind train, validation und test.

Um nur den Trainingsset von baike zu laden, fügen Sie einen Parameter hinzu.

from modelscope.msdatasets import MsDataset

ds = MsDataset.load(
    'simpleai/HC3-Chinese',
    subset_name='baike',
    split='train',
    trust_remote_code=True,
)
print(ds[0])
Illustration

Nicht alle Datensätze bieten alle drei Partitionen. Nach Erhalt des Trainingssets drucken Sie eine Probe zur Verifizierung.

Für Reproduzierbare Experimente, Notieren Sie Die Version

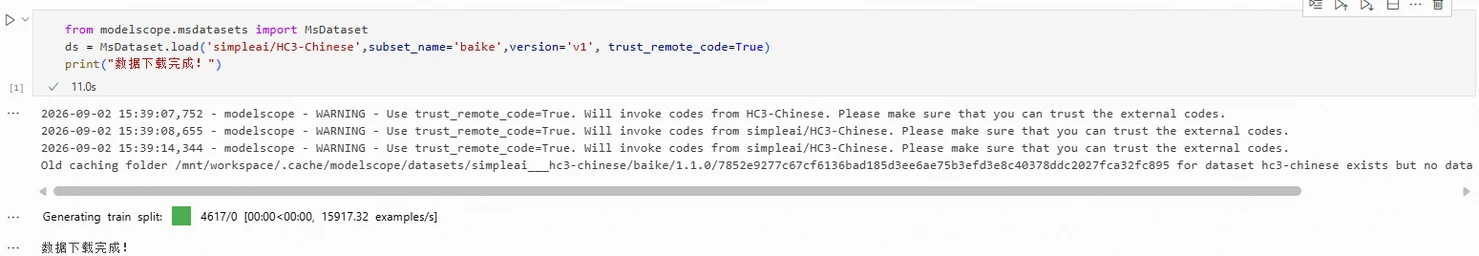
Nach Aktualisierungen kann derselbe Code unterschiedliche Inhalte lesen. Mit HC3-Chinese v1 als Beispiel, spezifizieren Sie über version.

from modelscope.msdatasets import MsDataset

ds = MsDataset.load(
    'simpleai/HC3-Chinese',
    subset_name='baike',
    version='v1',
    trust_remote_code=True,
)
print(ds)
Illustration

Prüfen Sie verfügbare Versionen auf der Datensatzseite. Wenn eine Version kontinuierlich aktualisiert wird, bewahren Sie die verwendeten Dateien oder Prüfsummen auf.

Daten Heruntergeladen? Drängen Sie Sie Nicht Gleich zum Modell

Prüfen Sie zuerst einige Proben auf Nullwerte, fehlerhafte Zeichen oder offensichtliche Fehler, dann bestätigen Sie, dass die Felder den Codeanforderungen entsprechen.

Trainings- und Testdaten müssen getrennt werden. Mischen Sie Testproben nicht in das Trainingsset.