Fine-Tuning und Evaluierung • Anfänger⏱️ 25 Min. Lesezeit
Fine-Tuning with ms-swift
Schnelle Feinabstimmung von Open-Source-Modellen mit ms-swift
Wenn ein allgemeines Modell spezifische Geschäftsanforderungen nicht direkt erfüllen kann, können Sie Ihre eigenen Geschäftsdaten zur Feinabstimmung des Modells verwenden, damit es spezifische Aufgaben und Ausgabemethoden besser lernt.
Nehmen wir die Erkennung von E-Commerce-Entities als Beispiel. Wir benötigen ein Modell, das Produktnamen, Marken und Modellnummern im Text erkennt und die entsprechende Kategorie und Position angibt. Das Modell mag sich gut mit diesen Produkten auskennen, aber bei der tatsächlichen Verwendung dürfen die extrahierten Informationen nicht unvollständig sein, die Felder müssen standardisiert und das Ausgabeformat muss stabil sein.
Wenn die Aufgabe und die Ausgabeanforderungen bereits klar sind und Sie organisierte Beispiele haben, können Sie versuchen, diese Daten für Feinabstimmung zu verwenden, damit das Modell die Arbeit lernt, die wir es ausführen lassen möchten. Ob alle Parameter aktualisiert werden sollen und ob die verfügbaren GPUs ausreichen, müssen Sie basierend auf Aufgabe und Ressourcen entscheiden.
Unten verwenden wir ms-swift, um einen LoRA-Feinabstimmungsprozess zu durchlaufen, einschließlich Datenvorbereitung, Training, Gewichtszusammenführung und Inferenz.
Was ändert Feinabstimmung tatsächlich am Modell?
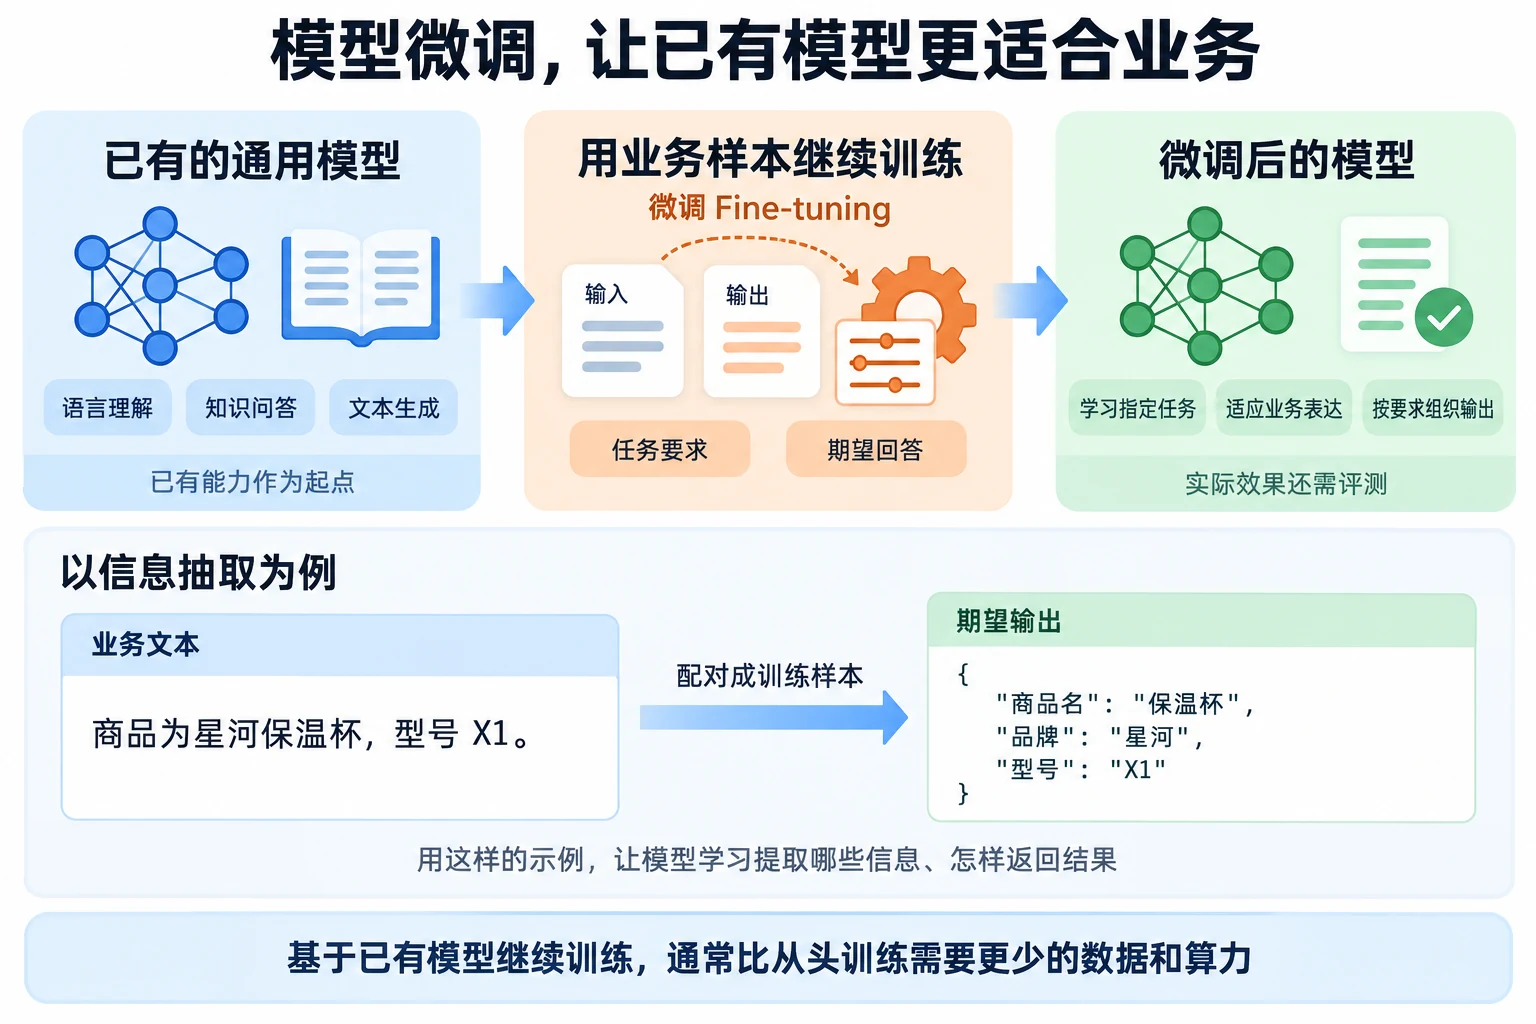
Allgemeine Large Language Models verfüg bereits über starke Fähigkeiten im Sprachverständnis, Wissens-Q&A, Textgenerierung und andere allgemeine Aufgaben. In tatsächlichen Geschäftsszenarien erfüllen die Leistungen allgemeiner Modelle jedoch möglicherweise nicht direkt spezifische Anforderungen.
Zum Beispiel möchten wir, dass das Modell bestimmte Informations extraktionsaufgaben genau ausführt, Ergebnisse in einem bestimmten Format ausgibt oder spezifische Fragen auf einheitliche Weise beantwortet. Für diese Anforderungen können wir spezifische Daten zur Schulung auf der Basis eines bestehenden Modells verwenden, damit das Modell die entsprechenden Aufgabenanforderungen und Antwortmethoden besser lernt. Dieser Prozess wird als Modell-Feinabstimmung bezeichnet.
Feinabstimmung ist kein Neutraining eines Modells von Grund auf, sondern eine weitere Anpassung auf der Basis seiner bestehenden Fähigkeiten, um es für spezifische Anwendungsszenarien besser geeignet zu machen. Im Vergleich zum Training eines Large Language Models von Grund auf erfordert Feinabstimmung in der Regel weniger Daten und Rechenressourcen.
Derzeit ist SFT (Supervised Fine-Tuning) die gängigste Methode in der Large Language Model Feinabstimmung. SFT verwendet Daten mit Standardantworten zum Training des Modells. Jeder Trainingseintrag enthält normalerweise eine Eingabe und die entsprechende Ausgabe, sodass das Modell lernt, welche Art von Ergebnissen es bei gegebener Eingabe erzeugen soll. Bei Informations extraktionsaufgaben kann beispielsweise ein Textsegment als Eingabe und die korrekten Feldekstraktionsergebnisse als Ausgabe verwendet werden. SFT ist geeignet für Aufgaben, für die klare Trainingsbeispiele vorbereitet werden können, wie Textklassifikation, Informations extraktion, Q&A und Festformat-Generierung.
Neben SFT kann das Training von Large Language Models auch Verstärkendes Lernen (Reinforcement Learning, RL) verwenden. Im Gegensatz zu SFT, das direkt Standardantworten liefert, bewertet verstärkendes Lernen hauptsächlich mit Belohnungssignalen die Qualität der modellgenerierten Ergebnisse und passt das Ausgabeverhalten des Modells basierend auf Belohnungsergebnissen kontinuierlich an. SFT und verstärkendes Lernen gehören beide zur Nachschulungsphase von Large Language Models. Nachschulung bezeichnet eine Reihe von Schulungen, die durchgeführt werden, nachdem das Modell die Großverarbeitungsvorabgeschult abgeschlossen hat, mit dem Ziel, die Instruction-Following-, Reasoning- und spezifische Aufgabenfähigkeiten weiter zu verbessern. Das Training von Large Language Models verwendet normalerweise zuerst SFT, um zu lernen, wie Aufgaben gemäß Anweisungen ausgeführt werden, und kombiniert dann verstärkendes Lernen und andere Methoden, um die Antwortqualität und das Verhaltensverhalten des Modells weiter zu optimieren.
Volle Parameter, LoRA und QLoRA — was ist der Unterschied?
Je nach Trainingsmethode und Hardware-Ressourcen können Sie zwischen LoRA, QLoRA oder Full-Parameter-Feinabstimmung wählen. Die verschiedenen Methoden unterscheiden sich in der Anzahl der Trainingsparameter, dem GPU-Speicherverbrauch und den Rechenkosten.
Full-Parameter-Feinabstimmung: Beim Training werden alle Parameter des Modells aktualisiert, sodas das Modell umfassendere Anpassungen vornehmen kann. Full-Parameter-Feinabstimmung erfordert deutlich mehr GPU-Speicher und Rechenressourcen, was zu höheren Trainingskosten führt.
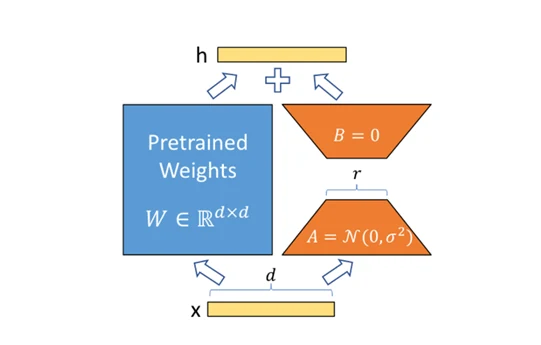
LoRA-Feinabstimmung (Low-Rank Adaptation): Um die Hardware-Ressourcenanforderungen für die Feinabstimmung von Large Language Models zu reduzieren, besteht LoRA's Kernidee darin, die Gewichte des vortrainierten Modells einzufrieren und trainierbare Rangzerlegungsmatrizen in jede Schicht der Transformer-Architektur zu injizieren, wodurch die Anzahl der trainierbaren Parameter für Downstream-Aufgaben erheblich reduziert wird. Beim Training müssen nur die ursprünglichen Modellparameter eingefroren werden, und die Dimensionsreduktionsmatrix A und Dimensionserhöhungsmatrix B werden trainiert. Ein schematisches Diagramm von LoRA ist unten zu sehen.
Genauer gesagt, angenommen die vortrainierte Matrix ist $W_0 \in \mathbb{R}^{d \times k}$, kann ihre Aktualisierung ausgedrückt werden als:
W = W_0 + \Delta W = W_0 + BA
Wobei $\Delta W$ die Gewichtsänderungen repräsentiert, die während der Feinabstimmung gelernt werden müssen:
B \in \mathbb{R}^{d \times r}, \quad
A \in \mathbb{R}^{r \times k}, \quad
r \ll \min(d,k)
A und B sind neue Parameter, die von LoRA hinzugefügt werden und am Training teilnehmen. Nach dem Modelltraining erhalten Sie eine separate LoRA-Adapter-Datei, die die Parameter dieser Feinabstimmung speichert. Bei der Verwendung müssen Sie sowohl das Basismodell als auch den entsprechenden Adapter laden.
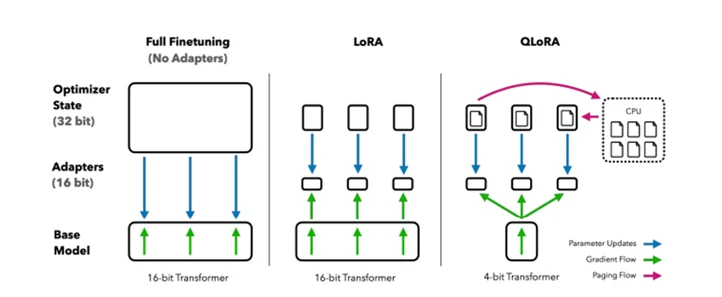
QLoRA-Feinabstimmung (Quantized LoRA): LoRA reduziert hauptsächlich den Ressourcenaufwand durch Trainingsparameter, aber das Basismodell selbst muss weiterhin in den GPU-Speicher geladen werden. Wenn das Modell groß ist, kann das Laden des Basismodells weiterhin viel GPU-Speicher verbrauchen. Um den GPU-Speicherbedarf weiter zu reduzieren, können Sie QLoRA-Feinabstimmung verwenden.
Die zugehörige Modellarchitektur ist unten dargestellt. Wie zu sehen ist, ist QLoRA eine Verbesserung von LoRA, und die Hauptidee der Verbesserung besteht darin, 4-Bit-Genauigkeit und paginierte Optimierung gemeinsam zu verwenden, um den GPU-Speicherverbrauch zu reduzieren.
QLoRA kann einfach als Kombination aus Quantisierung und LoRA verstanden werden. Es quantisiert das Basismodell mit geringerer Genauigkeit. QLoRA's Hauptinnovationen umfassen:
4-Bit NormalFloat (NF4): NF4 ist ein neuer Datentyp, der für normalverteilte Gewichte informationstheoretisch optimal ist;
Doppelquantisierung: Doppelquantisierung reduziert die durchschnittliche Speichernutzung durch Re-Quantisierung bereits quantisierter Konstanten;
Paginierte Optimierer: Paginierte Optimierer helfen, Speacherspitzen zu verwalten und Speicherfehler beim Gradienten-Checkpointing zu verhindern.
Wie wählt man eine Feinabstimmungsmethode: beginnen Sie mit Aufgabe und GPU
Die Wahl der Feinabstimmungsmethode erfordert hauptsächlich die Berücksichtigung der Modellskala, der Aufgabenanforderungen, der GPU-Ressourcen und der Trainingskosten. Verschiedene Methoden haben ihre eigenen Anwendungsszenarien — es stimmt nicht unbedingt, dass das Aktualisieren mehrerer Modellparameter zu besseren Feinabstimmungsergebnissen führt. Für die meisten Feinabstimmungsaufgaben können Sie zuerst LoRA ausprobieren. LoRA erfordert nur das Training einer kleinen Anzahl neuer Parameter, hat relativ geringe Anforderungen an GPU-Speicher und Rechenressourcen, und die resultierenden Adapter-Dateien sind ebenfalls relativ klein, was die Speicherung erleichtert.
Wenn das Basismodell groß ist, kann selbst bei LoRA-Verwendung nach dem Laden des Modells nicht genügend GPU-Speicher für das Training vorhanden sein. In diesem Fall können Sie QLoRA in Betracht ziehen. QLoRA reduziert den GPU-Speicherverbrauch des Basismodells durch Quantisierung, sodass größere Modelle mit begrenzten GPU-Ressourcen feinabgestimmt werden können. QLoRA ist besser für Szenarien mit großer Modellskala und begrenzten GPU-Ressourcen geeignet.
Wenn die GPU-Ressourcen relativ ausreichend sind und die Aufgabe umfassendere Modellanpassungen erfordert, können Sie Full-Parameter-Feinabstimmung in Betracht ziehen. Da alle Modellparameter während des Trainings aktualisiert werden müssen, hat Full-Parameter-Feinabstimmung höhere Anforderungen an GPU-Speicher, Rechenressourcen und Trainingsdaten, und die Kosten für das Training und Speichern von Modellen sind ebenfalls höher. Sie müssen daher basierend auf der tatsächlichen Aufgabe entscheiden, ob dies notwendig ist.
In tatsächlichen Projekten können wir zuerst die Wirkung zu geringeren Kosten überprüfen und dann basierend auf den tatsächlichen Bedürfnissen entscheiden, ob die Trainingskosten erhöht werden sollen. Wenn LoRA bereits die erwarteten Ergebnisse erzielen kann, ist es normalerweise nicht notwendig, Full-Parameter-Feinabstimmung nur zur Aktualisierung weiterer Parameter zu wählen.
ms-swift verwenden, um eine Feinabstimmung durchzuführen
Welche Arbeit kann ms-swift uns ersparen?
ms-swift (SWIFT, Scalable lightWeight Infrastructure for Fine-Tuning) ist ein Open-Source-Modelltrainings- und Bereitstellungsframework der ModelScope-Community. Es richtet sich hauptsächlich an Large Language Models und multimodale Large Language Models und bietet ein vollständiges Werkzeugset von Modelltraining und Feinabstimmung bis hin zu Inferenz, Bewertung und Bereitstellung.
Derzeit unterstützt es Mainstream-Large-Language-Models wie Qwen, DeepSeek, Llama, GLM und InternLM sowie multimodale Modelle wie Qwen-VL und InternVL. Es unterstützt auch das Training für Aufgaben wie Embedding, Reranker und Textklassifikation.
Weitere Verwendungsmethoden finden Sie unter ms-swift.
Neben dem Training bietet ms-swift auch einen relativ vollständigen Modellverwendungsablauf. Nach dem Training können Sie direkt swift infer zur Modellinferenz verwenden oder das Modell als OpenAI-kompatiblen API-Dienst über swift deploy bereitstellen. Für Inferenz und Bereitstellung können Sie auch Inferenzmaschinen wie vLLM, SGLang und LMDeploy zur Beschleunigung kombinieren.
Für Anfänger ist eines der Merkmale von ms-swift, dass es viele komplexe Konfigurationen im Large-Model-Trainingsprozess kapselt. Sie können eine Modellfeinabstimmung durchgeben des Basismodells, der Trainingsdaten, der Feinabstimmungsmethode und der Trainingsparameter über Kommandozeilenargumente abschließen. Im folgenden Experiment verwenden wir ms-swift, um einen vollständigen Modellfeinabstimmungsablauf durchzuführen, einschließlich der Vorbereitung der Trainingsdaten, des Starts des LoRA-Trainings, der Überprüfung der Trainingsergebnisse, der Zusammenführung der LoRA-Gewichte und des Ladens des feinabgestimmten Modells für Inferenz und Bereitstellung.
Praktisches Training mit einer Entity-Erkennungsaufgabe
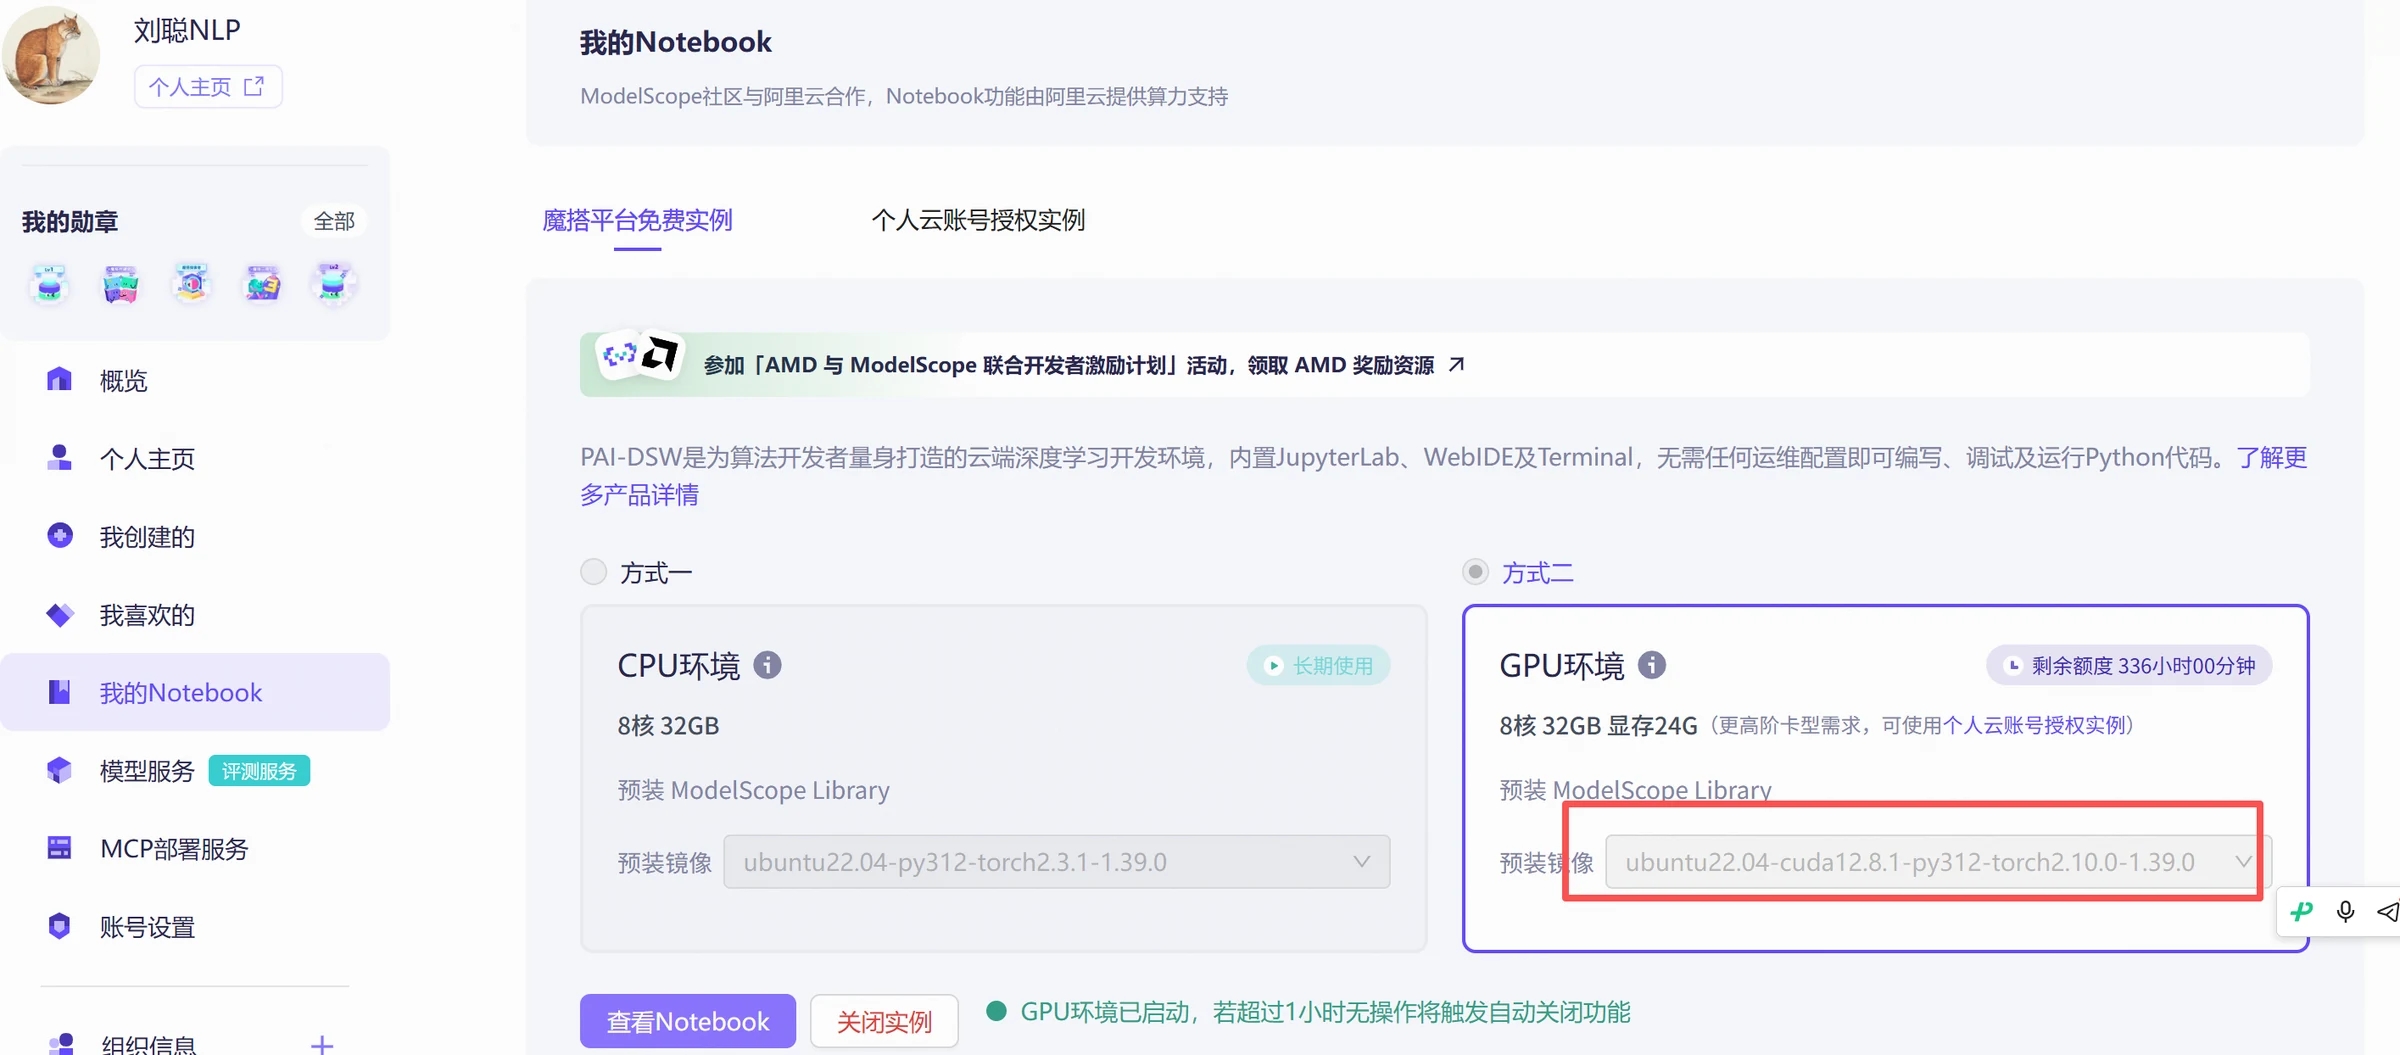
Nachfolgend verwenden wir eine Entity-Erkennungsaufgabe als Beispiel, um den vollständigen Modellfeinabstimmungsablauf in der ModelScope-Notebook-Ugebung zu demonstrieren, einschließlich Datenvorbereitung, Modelltraining und Inferenz nach der Feinabstimmung. Durch dieses Beispiel können Sie lernen, wie man ms-swift verwendet, um Large-Model-Feinabstimmung von Grund auf durchzuführen. Dieses Experiment verwendet weiterhin das ubuntu22.04-cuda12.8.1-py312-torch2.10.0-1.39.0-Image als Laufzeitumgebung.
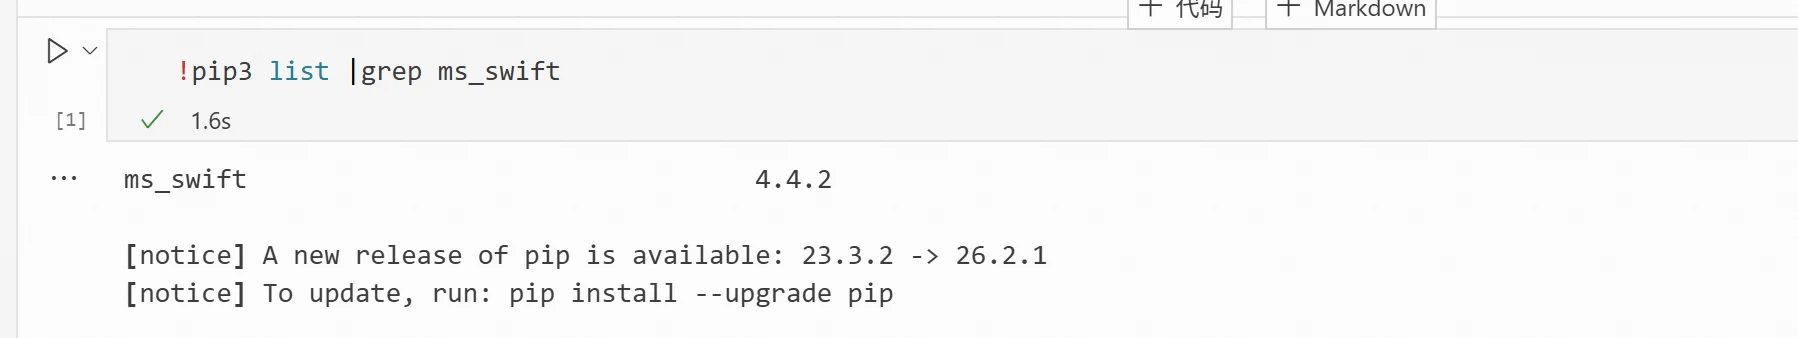
1) Überprüfen Sie, ob ms-swift bereits in der Umgebung installiert ist. Beachten Sie, dass der Paketname ms_swift lautet.
!pip3 list |grep ms_swift
Wenn Sie eine Ausgabe im folgenden Format sehen, ist ms-swift bereits installiert:
Wenn nicht installiert, führen Sie aus:
!pip3 install ms-swift
Datenvorbereitung. Dieses Experiment verwendet Open-Source-Daten zur Entity-Erkennung im E-Commerce. Der Datensatz enthält vier Entity-Typen: HCCX (Produktname), HPPX (Markenname), XH (Produktmodell) und MISC (andere Entities einschließlich Land, Größe/Kapazität, Person, Werk und Aktivitätsnamen).
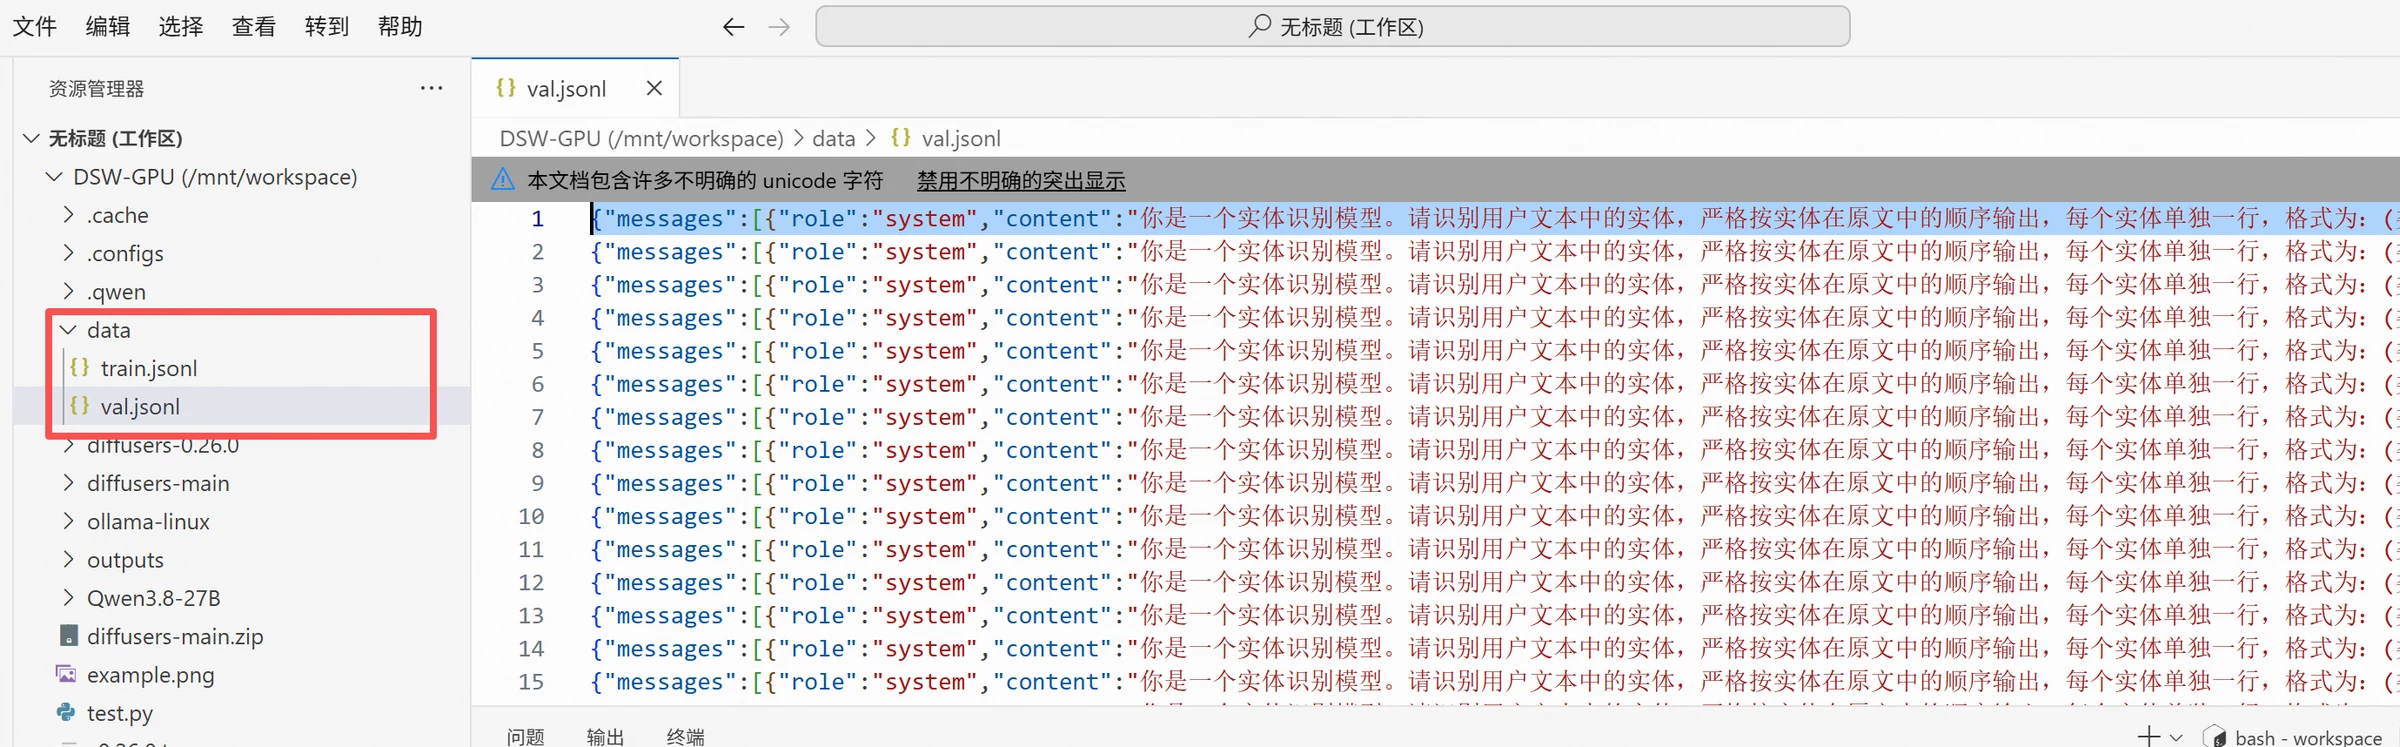
3) Erstellen Sie zunächst ein Verzeichnis mit dem Namen data, laden Sie dann die Daten per Rechtsklick in den Ordner hoch. Das Datenformat ist wie folgt. Diese Aufgabe erfordert nur, dass das Modell Entity-Kategorien, Entities und deren Startpositionen im Text ausgibt. Die Daten werden in Trainings- und Testsets aufgeteilt, wobei train.jsonl 5.400 Einträge und val.jsonl 600 Einträge enthält.
{"messages":[{"role":"system","content":"Sie sind ein Entity-Erkennungsmodell. Bitte identifizieren Sie Entities im Text des Benutzers. Geben Sie Entities streng in ihrer Reihenfolge des Auftretens im Originaltext aus, jede Entity auf einer separaten Zeile im Format: (Typ, Entity-Text, Startposition). Die Startposition beginnt bei 0; der Typ kann nur HCCX, HPPX, MISC oder XH sein. Wenn keine Entities vorhanden sind, geben Sie nur aus: Keine Entities. Geben Sie keine Erklärungen, Markdown oder anderen Inhalt aus."},{"role":"user","content":"Push bb skincare guasha l back therapy Olivenkoerper-Massageoel Kuel-Massageoel Massageoel-Massageoel Massage-00"},{"role":"assistant","content":"(HCCX,Olivenoel,10)\n(HCCX,Massageoel,20)\n(HCCX,Oel,24)\n(HCCX,Oel,27)"}]}
Verzeichnisstruktur wie folgt:
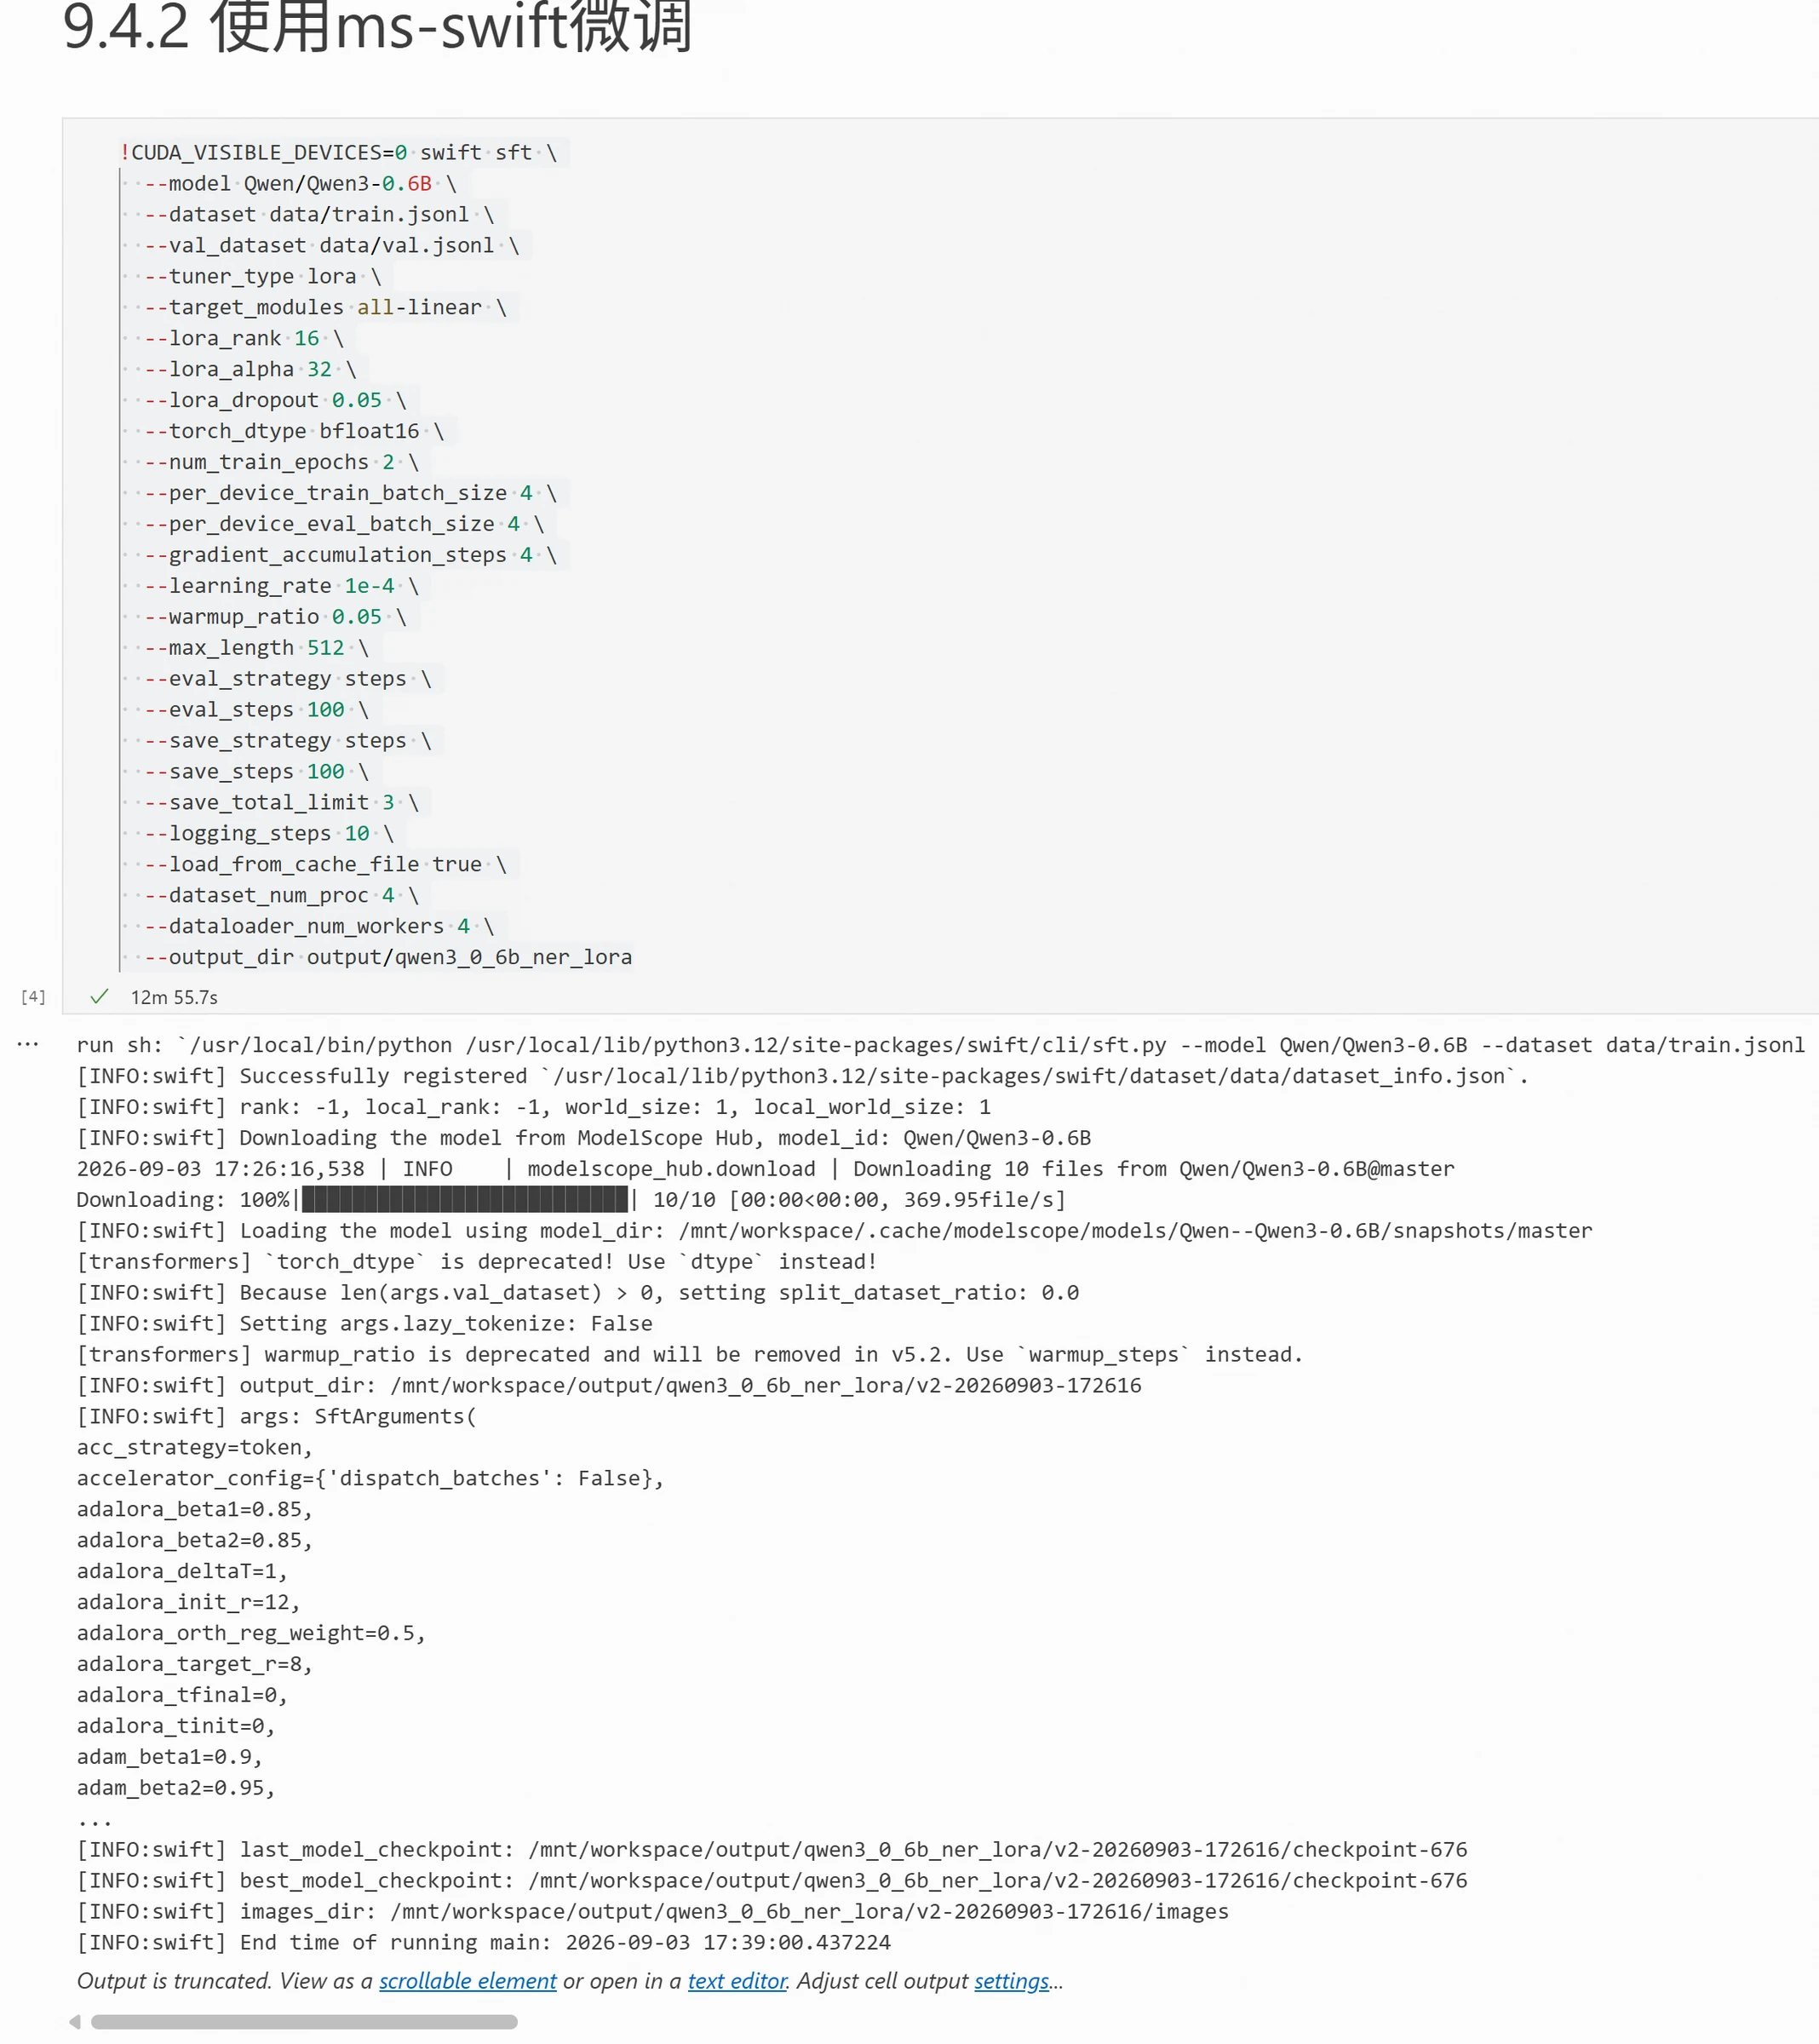
Modelltraining. Dieser Abschnitt verwendet Qwen/Qwen3-0.6B zur Feinabstimmung. Geben Sie den folgenden Befehl direkt im Terminal ein, um das Training zu starten:
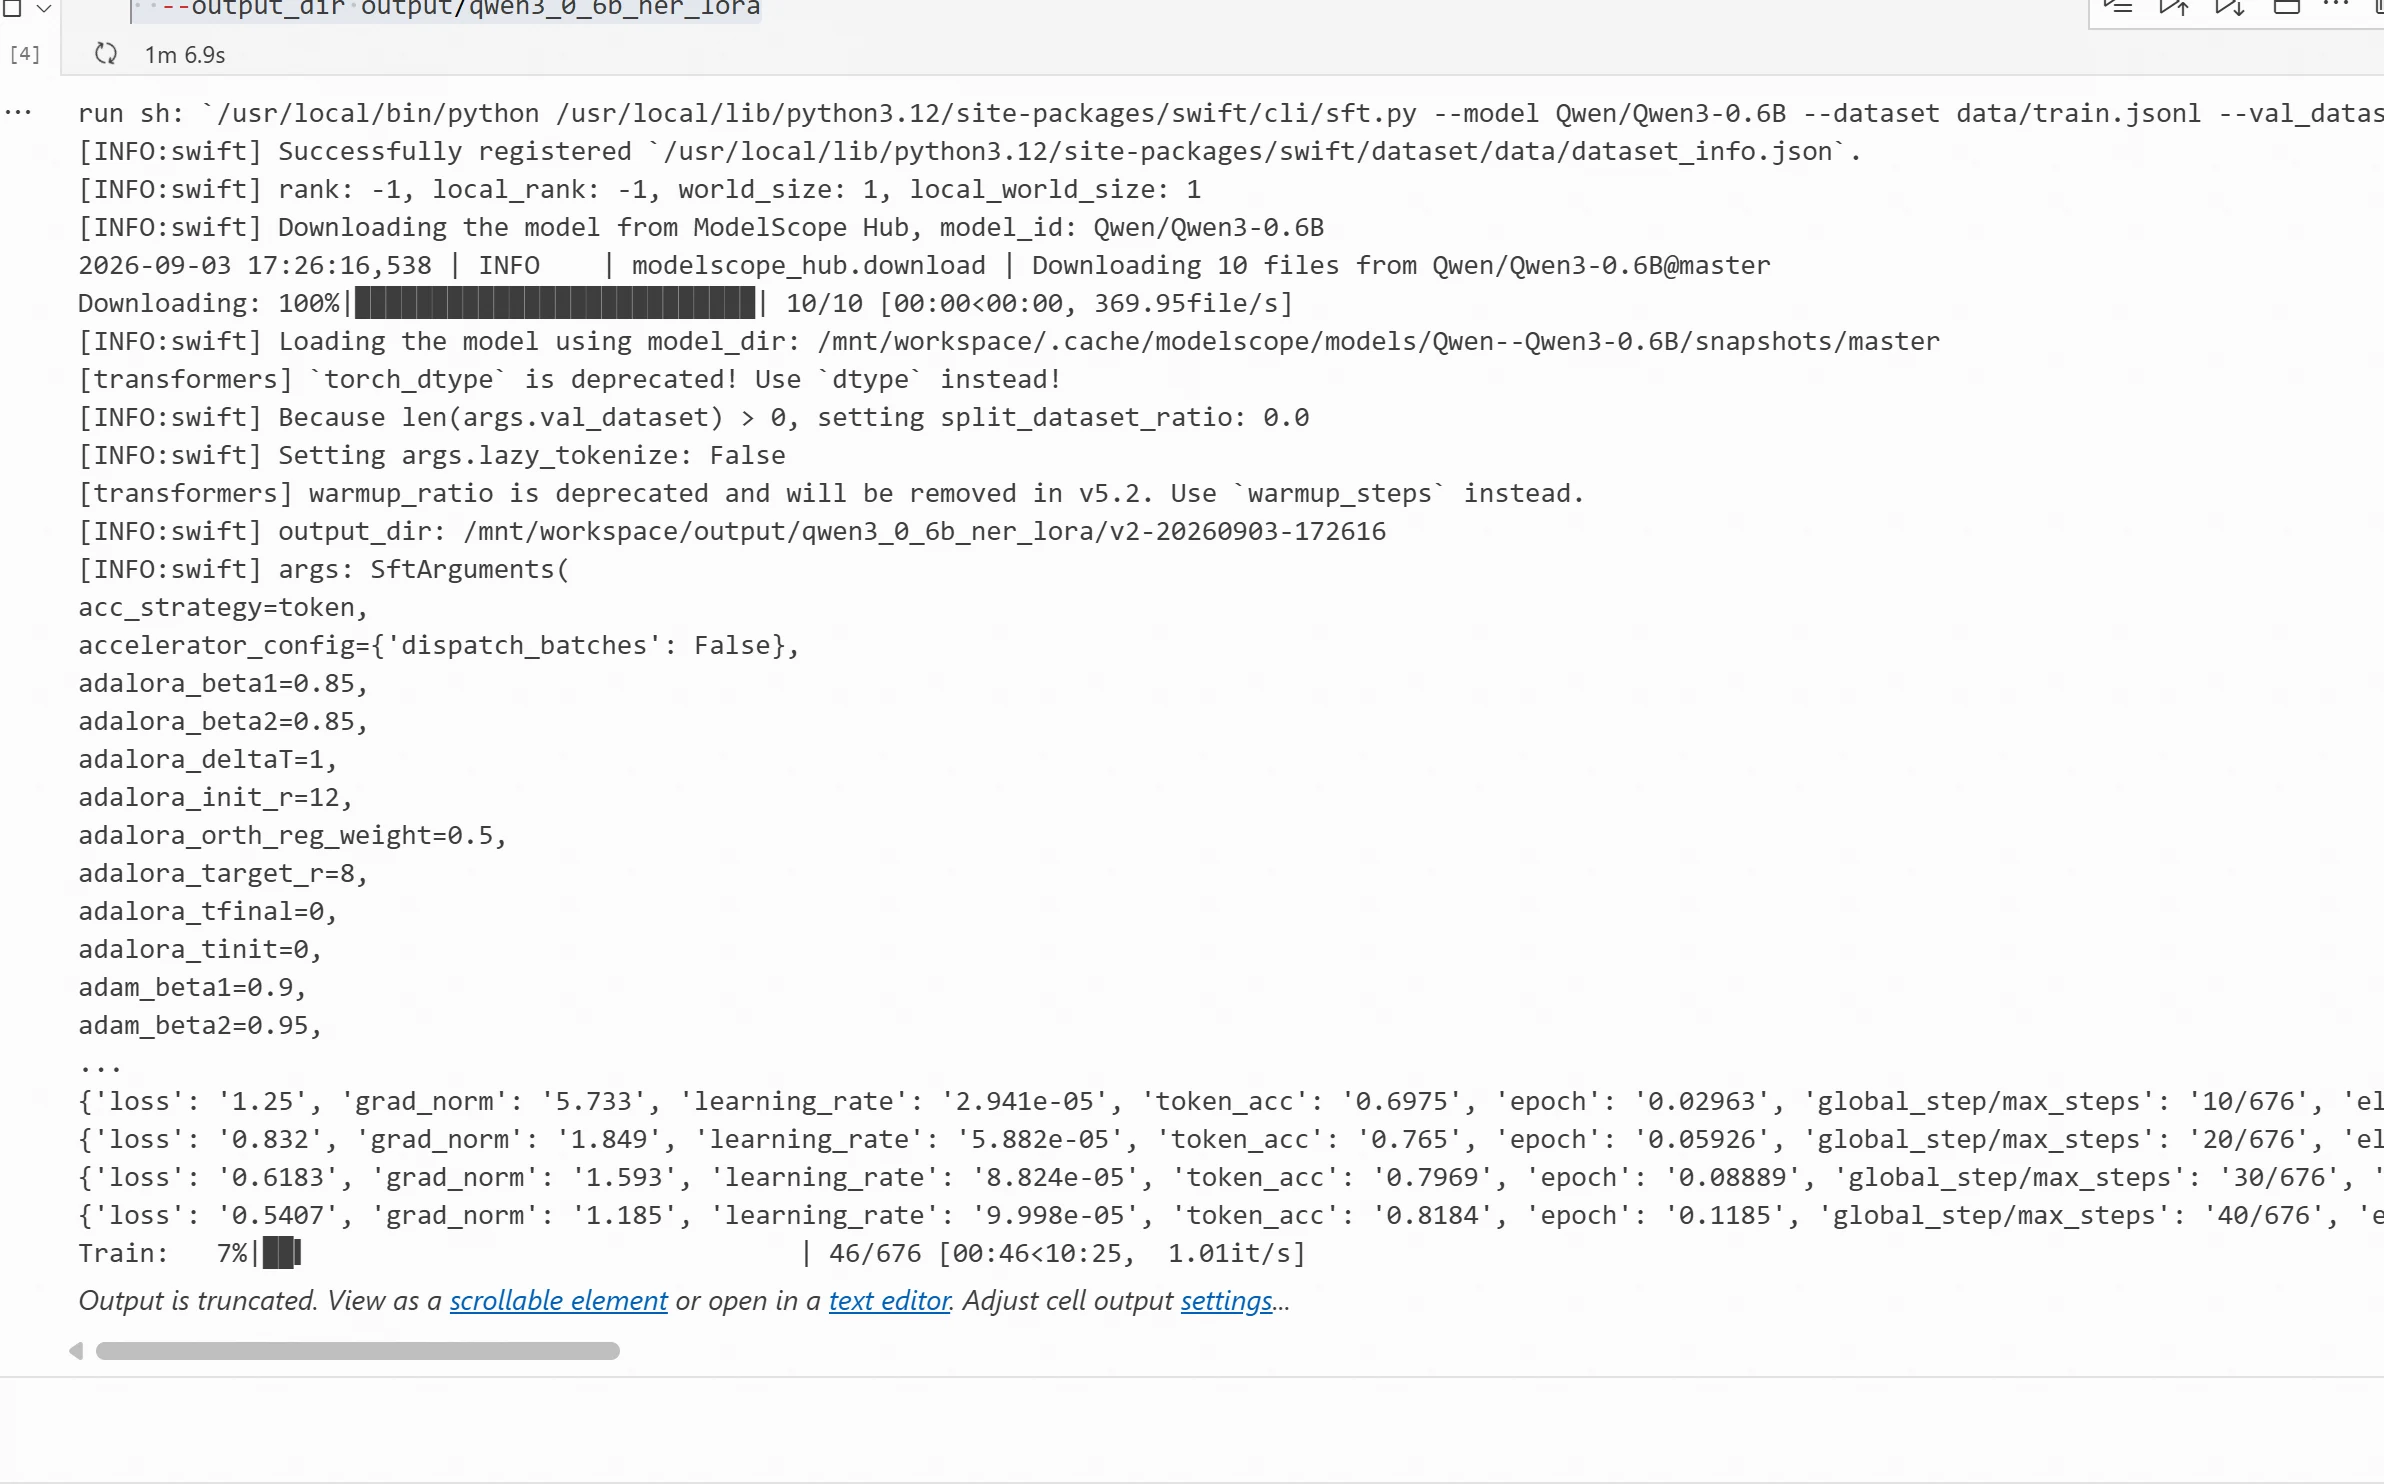
Nach dem Start des Trainings gibt ms-swift kontinuierlich die aktuellen Trainingsinformationen aus, wie unten gezeigt:
Das Training ist abgeschlossen — wie verwenden wir das Modell?
LoRA-Gewichte in das Basismodell zurückführen
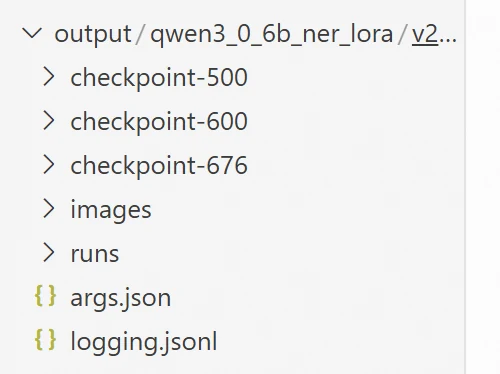
Nach Abschluss des LoRA-Trainings wird der entsprechende LoRA-Adapter gespeichert. Der Adapter ist kein vollständiges Large Language Model, daher müssen Sie weiterhin das ursprüngliche Basismodell laden, wenn Sie es verwenden. Über das output_dir im Trainingskrippel können Sie die Checkpoints und entsprechenden Adapter-Dateien im Verzeichnis sehen. Bei der tatsächlichen Bereitstellung können Sie den LoRA-Adapter in das Basismodell zusammenführen, um ein vollständiges Modell zu erzeugen, was für Offline-Bereitstellung oder Modellmigration bequemer ist. Die Verzeichnisstruktur nach dem Modelltraining lautet wie folgt:
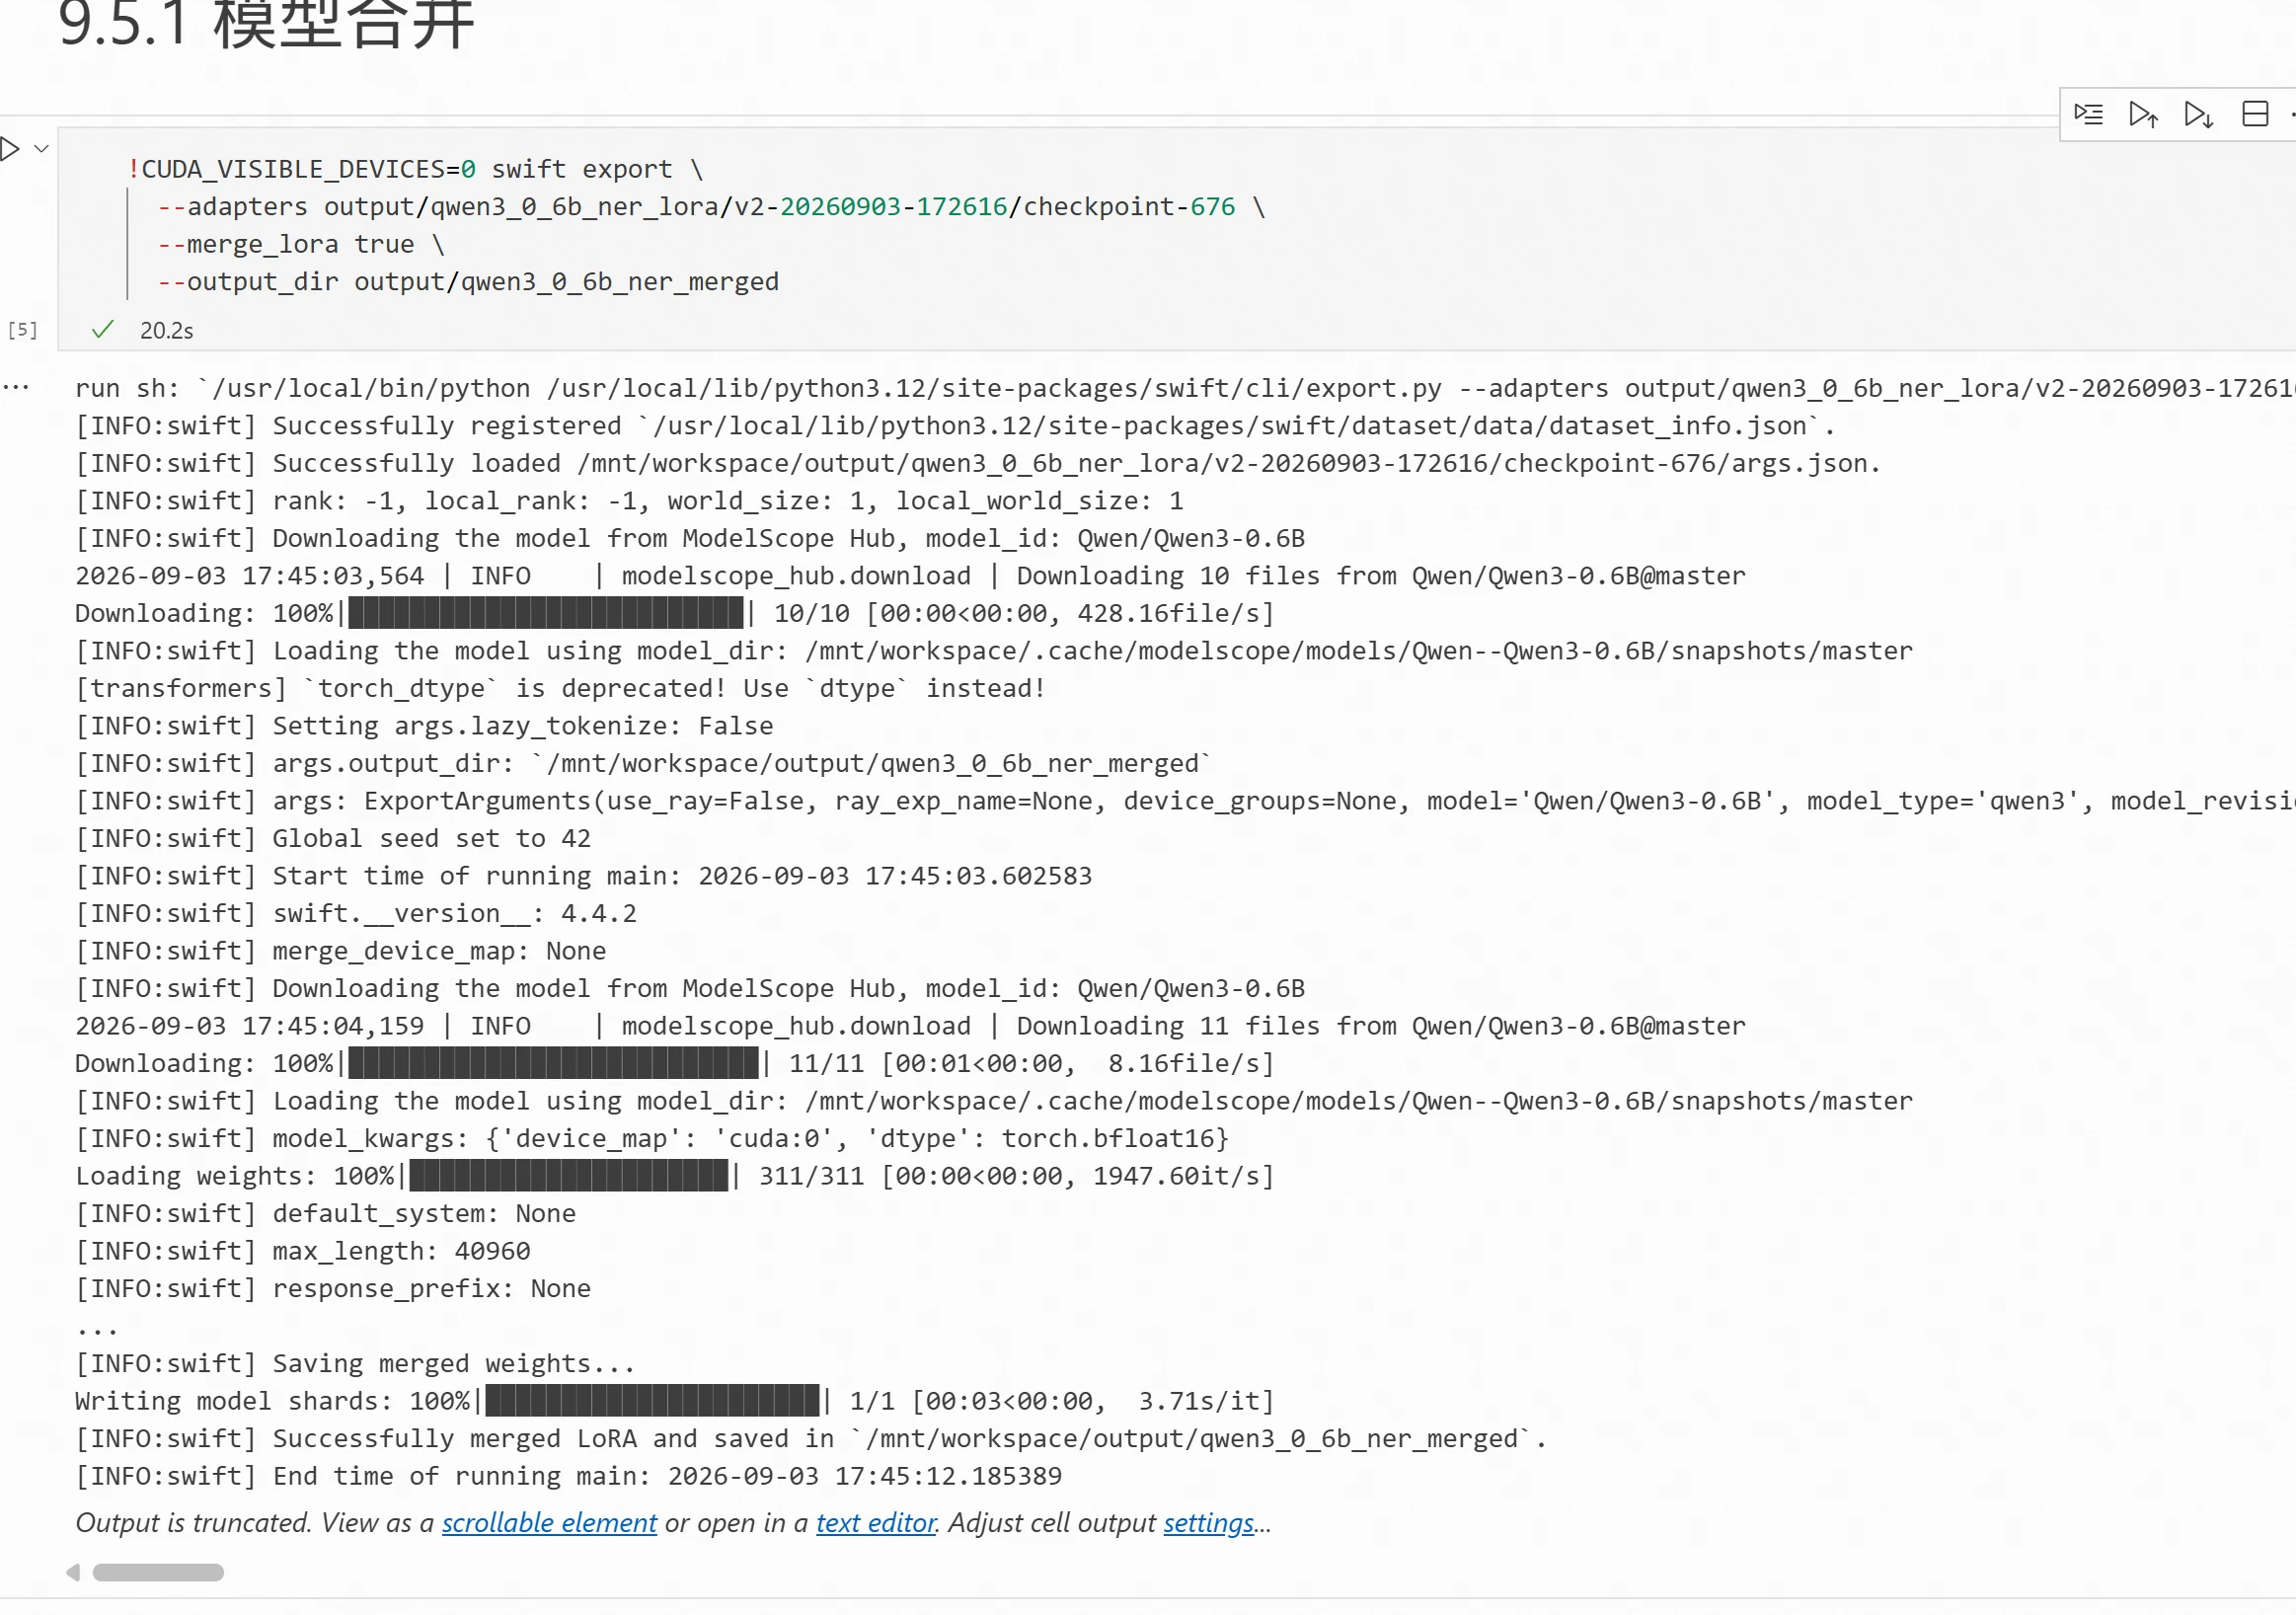
Wobei --adapters den Pfad zum trainierten LoRA-Checkpoint angibt, --merge_lora true die Zusammenführung der LoRA-Parameter in das Basismodell anzeigt und --output_dir das Speicherverzeichnis für das zusammengeführte Modell angibt.
Ausführungsergebnis:
Das feinabgestimmte Modell laden und den Effekt testen
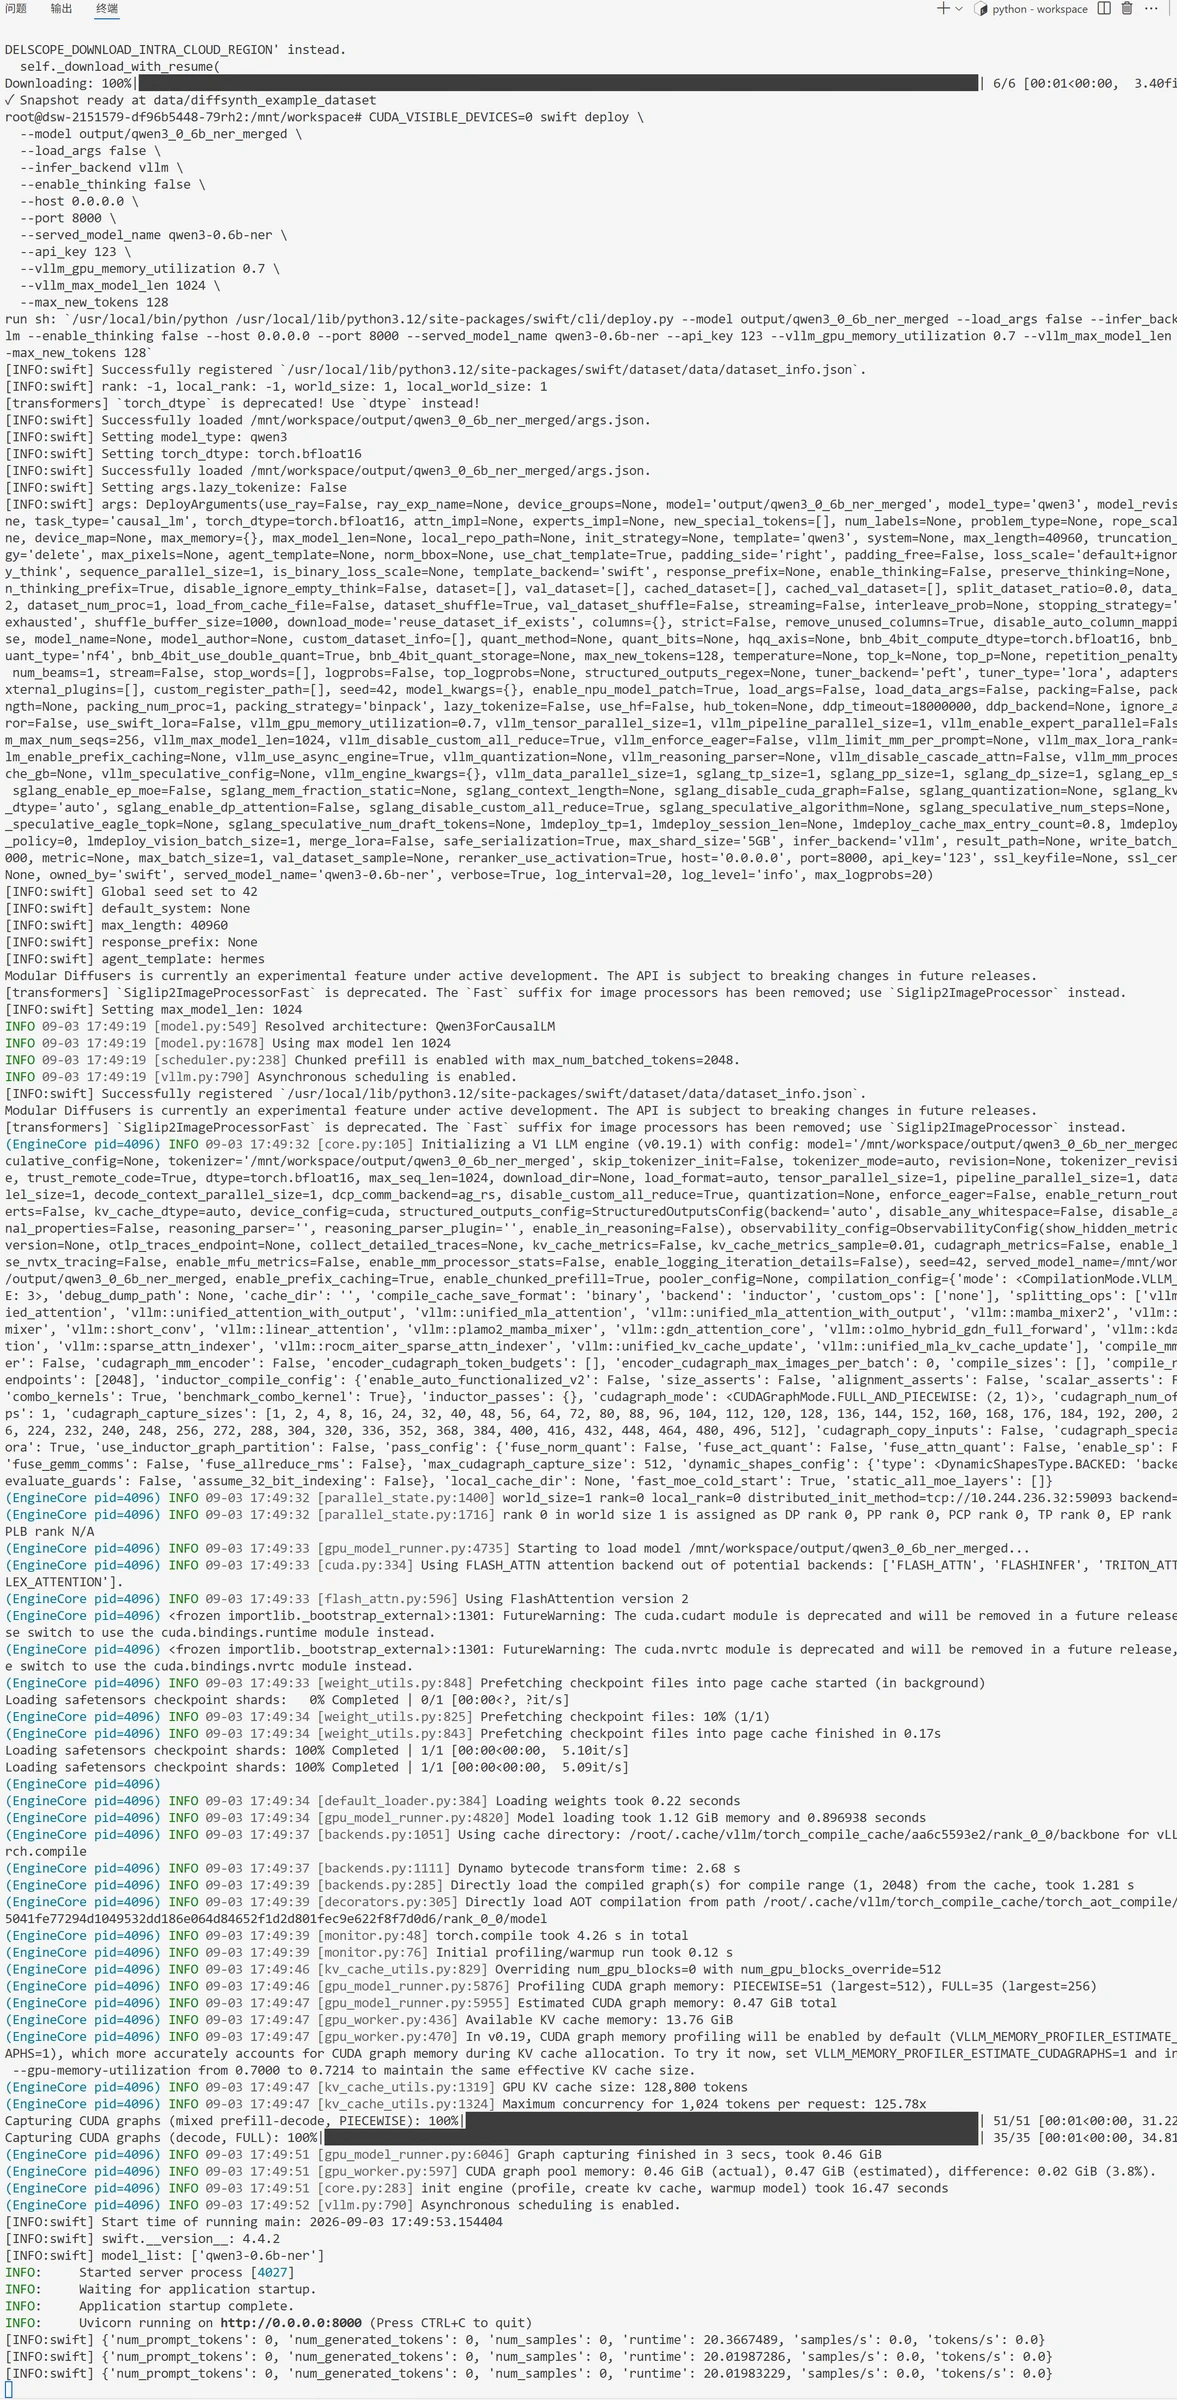
Nach der Zusammenführung können Sie das erzeugte vollständige Modell direkt für Inferenz laden. Zur Bequemlichkeit der Anwendungsaufrufe können Sie das Modell auch als OpenAI-kompatible Schnittstelle starten, auf die über API zugegriffen wird. Dies ist auch ein dauerhafter Dienst, der im Terminal gestartet werden muss. Sie können Kapitel 7 konsultieren, wie man Befehle im Terminal startet. Der Startbefehl lautet wie folgt:
Das zusammengeführte vollständige Modellverzeichnis angeben
--load_args
args.json-Parameter aus dem Modellverzeichnis nicht laden
--infer_backend
vLLM-Inferenzmaschine verwenden
--enable_thinking
Qwen3-Denkmodus deaktivieren
--host
Schnittstellen-IP
--port
Port
--served_model_name
Schnittstellenmodellnamen festlegen
--api_key
Schnittstellenschlüssel festlegen
--vllm_gpu_memory_utilization
Modell verwendet ca. 70% GPU-Speicher
--vllm_max_model_len
Maximale Gesamt-Token-Anzahl
--max_new_tokens
Maximale Ausgabelänge
Nach dem Start des Modells lautet das Ergebnis wie folgt:
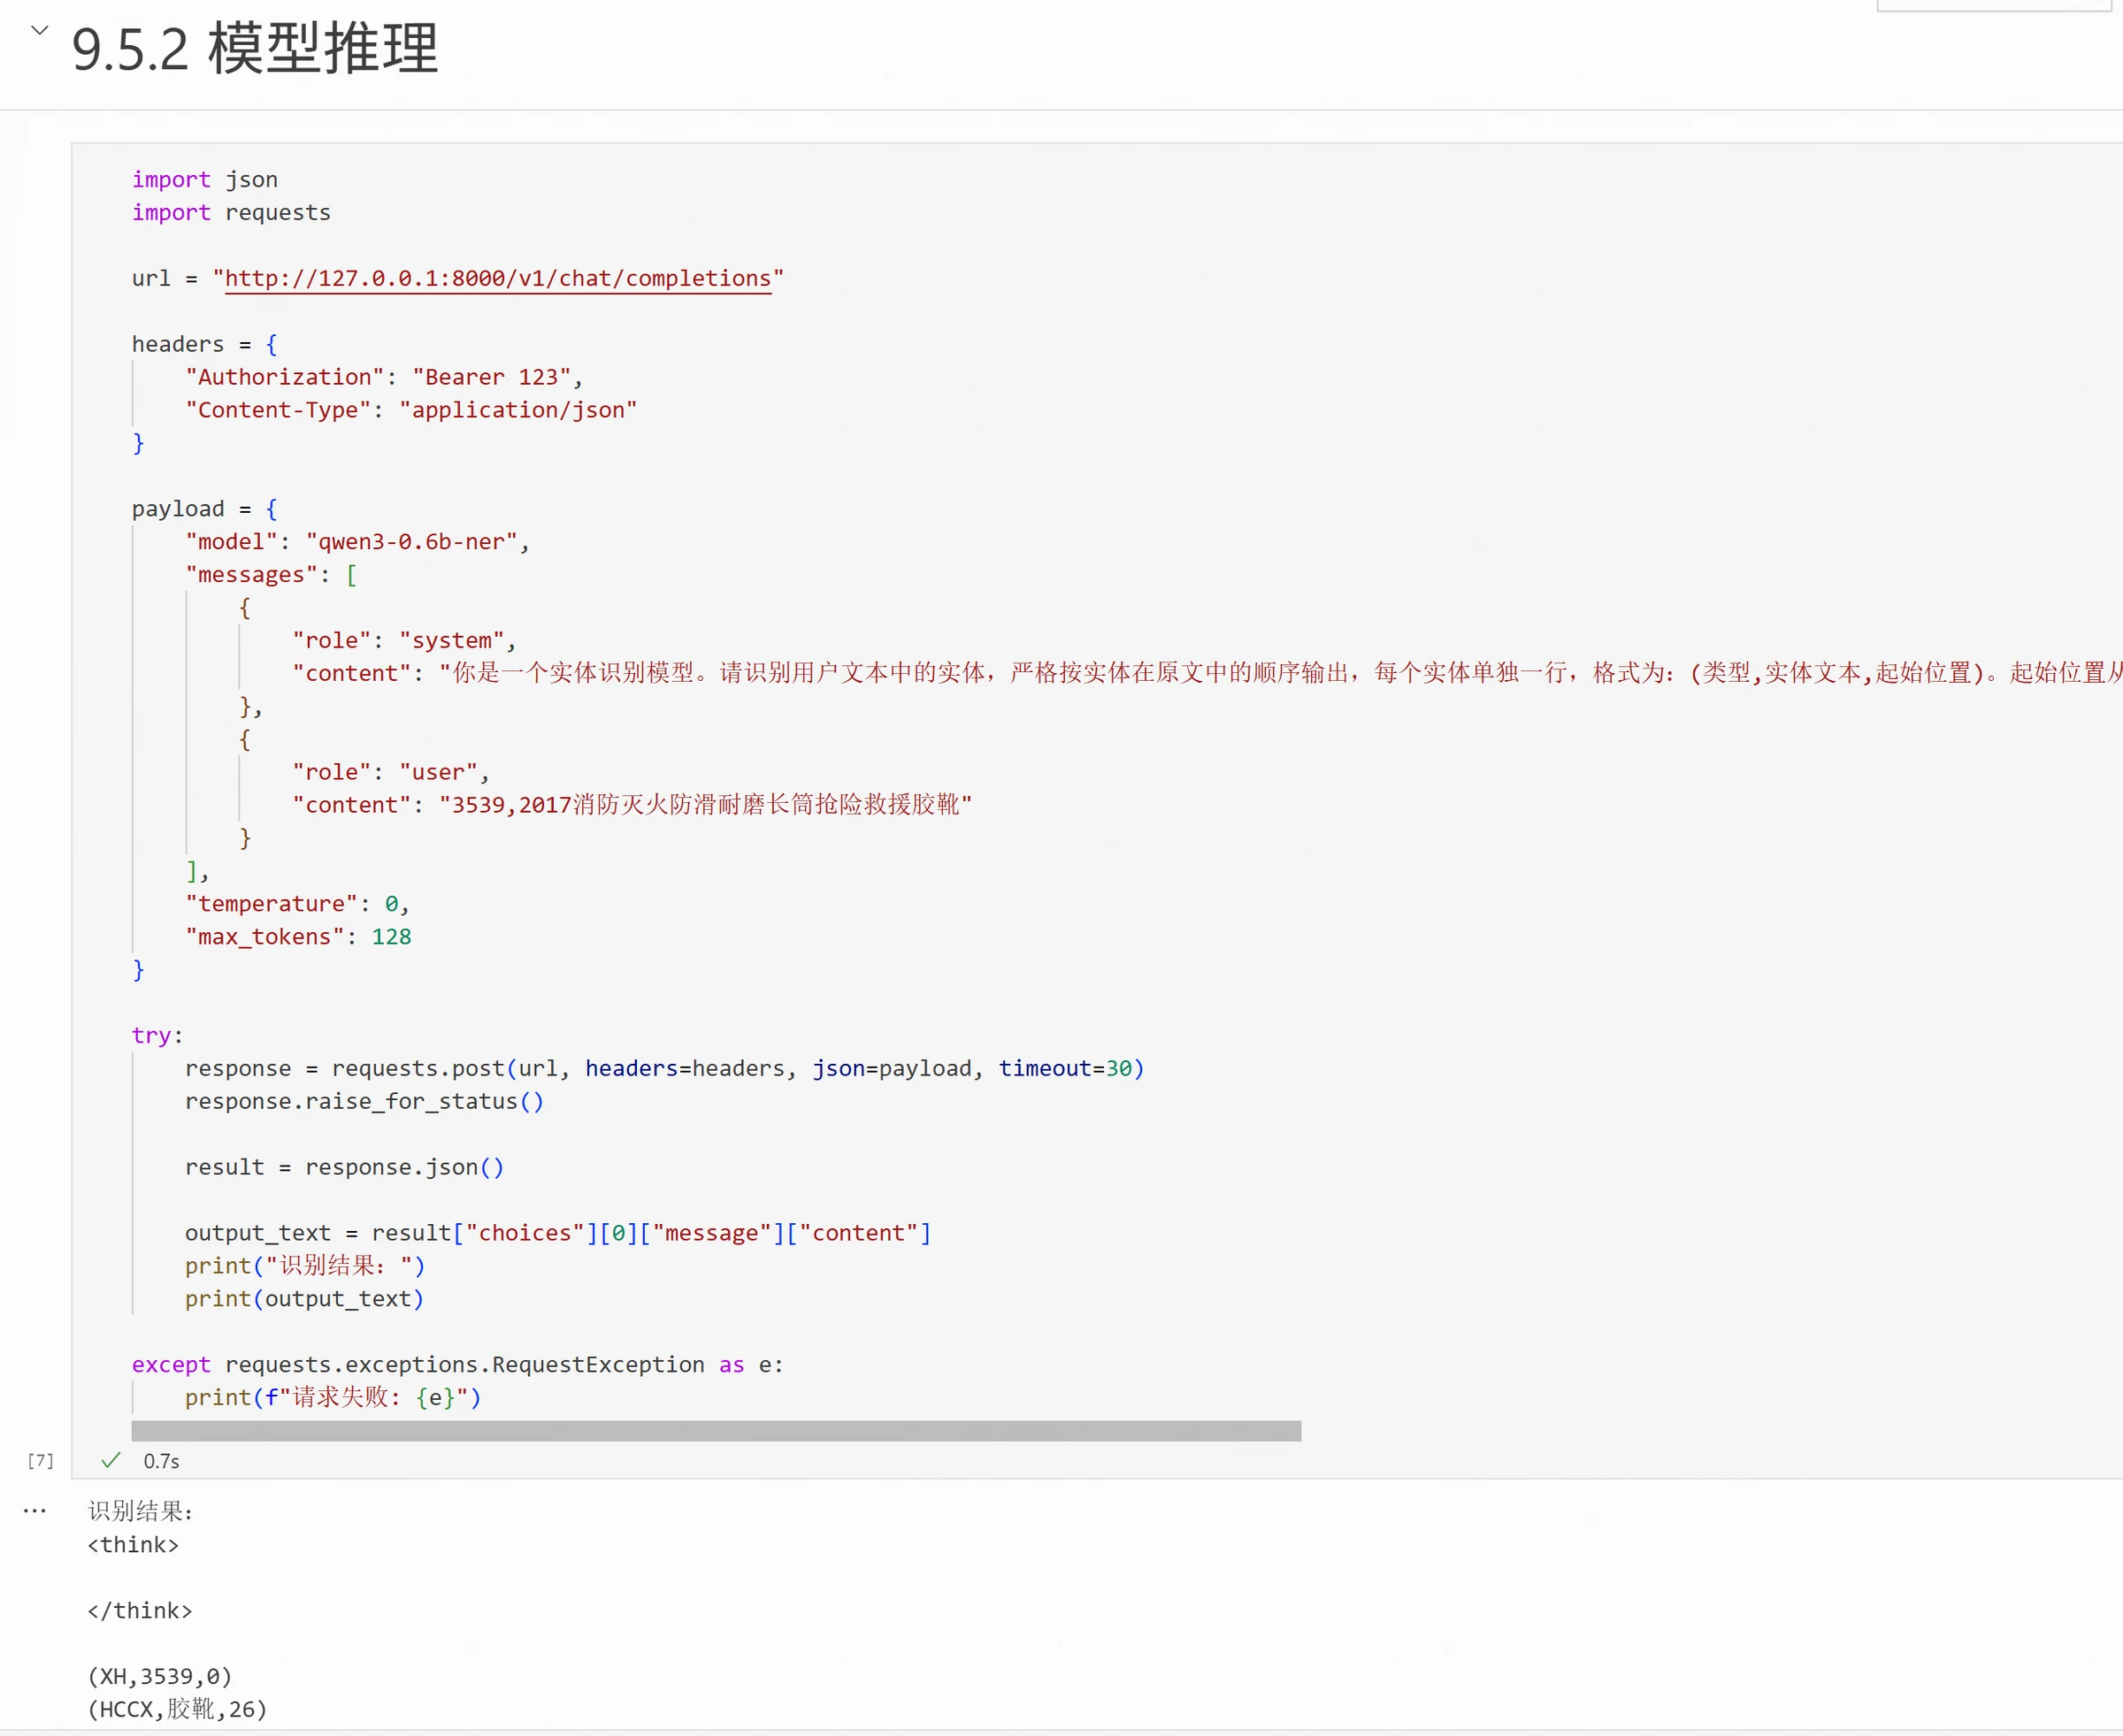
Nach dem Start des Modells können Sie die Konnektivität über die Schnittstelle testen. Code wie folgt:
import json
import requests

url = "http://127.0.0.1:8000/v1/chat/completions"

headers = {
    "Authorization": "Bearer 123",
    "Content-Type": "application/json"
}

payload = {
    "model": "qwen3-0.6b-ner",
    "messages": [
        {
            "role": "system",
            "content": "Sie sind ein Entity-Erkennungsmodell. Bitte identifizieren Sie Entities im Text des Benutzers. Geben Sie Entities streng in ihrer Reihenfolge des Auftretens im Originaltext aus, jede Entity auf einer separaten Zeile im Format: (Typ, Entity-Text, Startposition). Die Startposition beginnt bei 0; der Typ kann nur HCCX, HPPX, MISC oder XH sein. Wenn keine Entities vorhanden sind, geben Sie nur aus: Keine Entities. Geben Sie keine Erklärungen, Markdown, Think-Tags oder anderen Inhalt aus."
        },
        {
            "role": "user",
            "content": "3539,2017 Feuerloeschkugel rutschfeste verschleissfeste hohe Stiefel fuer Katastrophenhilfe und Rettung"
        }
    ],
    "temperature": 0,
    "max_tokens": 128
}

try:
    response = requests.post(url, headers=headers, json=payload, timeout=30)
    response.raise_for_status()

    result = response.json()

    output_text = result["choices"][0]["message"]["content"]
    print("Erkennungsergebnis:")
    print(output_text)

except requests.exceptions.RequestException as e:
    print(f"Anfrage fehlgeschlagen: {e}")
Modellausgabe. Wir können auch reguläre Ausdrücke verwenden, um die Think-Tags zu entfernen:
Alle Experimentdaten und Code dieses Kapitels finden Sie unter: https://modelscope.cn/gallery/liucong/ab458cbd-b47f-4830-91b6-314ea2036fc6