Mit zunehmender Komplexität von Agent-Anwendungen müssen Entwickler Probleme wie Tool-Aufrufe, Wissensintegration, Zustandsverwaltung und Multi-Agent-Zusammenarbeit bewältigen. Wenn all diese Funktionen von Grund auf entwickelt werden würden, wäre der Arbeitsaufwand nicht nur erheblich, sondern auch die Verbindung zwischen den einzelnen Modulen und die Steuerung der Ausführung wären komplex.
Agent-Frameworks kapseln diese häufig verwendeten Fähigkeiten und bieten einheitliche Implementierungsmethoden für die Agent-Entwicklung. Im Folgenden werden einige repräsentative Agent-Entwicklungsframeworks vorgestellt.
LangChain-Framework
LangChain wurde 2022 veröffentlicht und ist eines der früheren Open-Source-Frameworks zur Erstellung von Large-Language-Model-Anwendungen. LangChain diente anfänglich hauptsächlich zur Organisation von Large-Language-Modellen, Prompts und externen Daten und erweiterte sich schrittweise auf Tool-Aufrufe und Agenten. Derzeit hat LangChain Agenten als wichtigen Bestandteil des Frameworks integriert und bietet Modelle, Tools, Middleware und andere Komponenten, mit denen schnell Agenten mit Tool-Aufruf-Fähigkeiten erstellt werden können.
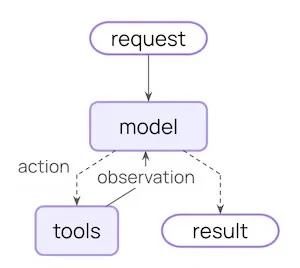
Die Kernbetriebsweise von LangChain besteht darin, Large-Language-Modelle und Tools in einer Schleife zu verbinden. Das Large-Language-Modell empfängt die Benutzeraufgabe und die verfügbaren Tools und entscheidet anhand der aktuellen Informationen, ob es direkt ein Ergebnis generieren oder ein Tool aufrufen soll. Wenn ein Tool-Aufruf gewählt wird, führt das Framework das entsprechende Tool aus und stellt das Ergebnis dem Large-Language-Modell zur Verfügung. Das Large-Language-Modell urteilt dann anhand der neuen Informationen weiter, bis keine Tool-Aufrufe mehr erforderlich sind und ein Endergebnis generiert wird. Der offizielle Name für diesen Prozess ist Agent Loop, wie nachfolgend dargestellt.
Beispielsweise kann man für einen Reiseassistenten Tools wie Wetterabfrage, Kartensuche und Websuche konfigurieren. Wenn ein Benutzer „Hilf mir, einen Tagesausflug nach Hangzhou für morgen zu planen" stellt, kann das Large-Language-Modell anhand der Aufgabe bestimmen, dass Wetter- und Sehenswürdigkeitsinformationen abgefragt werden müssen, die entsprechenden Tools aufrufen, um die Ergebnisse zu erhalten, und dann diese Ergebnisse kombinieren, um den Reiseplan zu erstellen.
Tools sind ein wichtiger Ansatz zur Realisierung externer Fähigkeiten. Im Kern sind sie aufrufbare Funktionen mit klaren Ein- und Ausgaben, die zum Abrufen von Echtzeitdaten, Ausführen von Code, Abfragen von Datenbanken oder Betreiben externer Systeme verwendet werden können. Wenn Entwickler die benötigten Agenten Tools bereitgestellt haben, kann das Large-Language-Modell anhand der aktuellen Aufgabe bestimmen, welches Tool wann aufgerufen werden soll und welche Parameter beim Aufruf bereitgestellt werden müssen.
Diese komponentenbasierte Methode ist ein wichtiges Merkmal von LangChain. LangChain bietet relativ einheitliche Schnittstellen für verschiedene Modelle und Tools, sodass Entwickler diese Komponenten innerhalb desselben Frameworks kombinieren können, ohne die Aufruflogik zwischen verschiedenen Modellen und externen Fähigkeiten separat zu behandeln. Daher eignet es sich besonders gut für den schnellen Aufbau von Agenten mit Tool-Aufruf-Funktion und ist für Anfänger geeignet, um den grundlegenden Agenten-Betriebsprozess zu verstehen.
LlamaIndex-Framework
LlamaIndex wurde 2022 veröffentlicht und diente anfänglich hauptsächlich zur Lösung von Verbindungsproblemen zwischen Large-Language-Modellen und externen Daten. Es bietet Datenlade-, Indizierungs-, Abruf- und Abfragefähigkeiten, mit denen externe Daten wie Unternehmensdokumente und Datenbanken in Large-Language-Model-Anwendungen integriert werden können. Auf dieser Basis hat LlamaIndex schrittweise Funktionen wie Agenten und Workflows hinzugefügt, sodass Agenten diese Daten nutzen können, um komplexere Aufgaben zu erledigen.
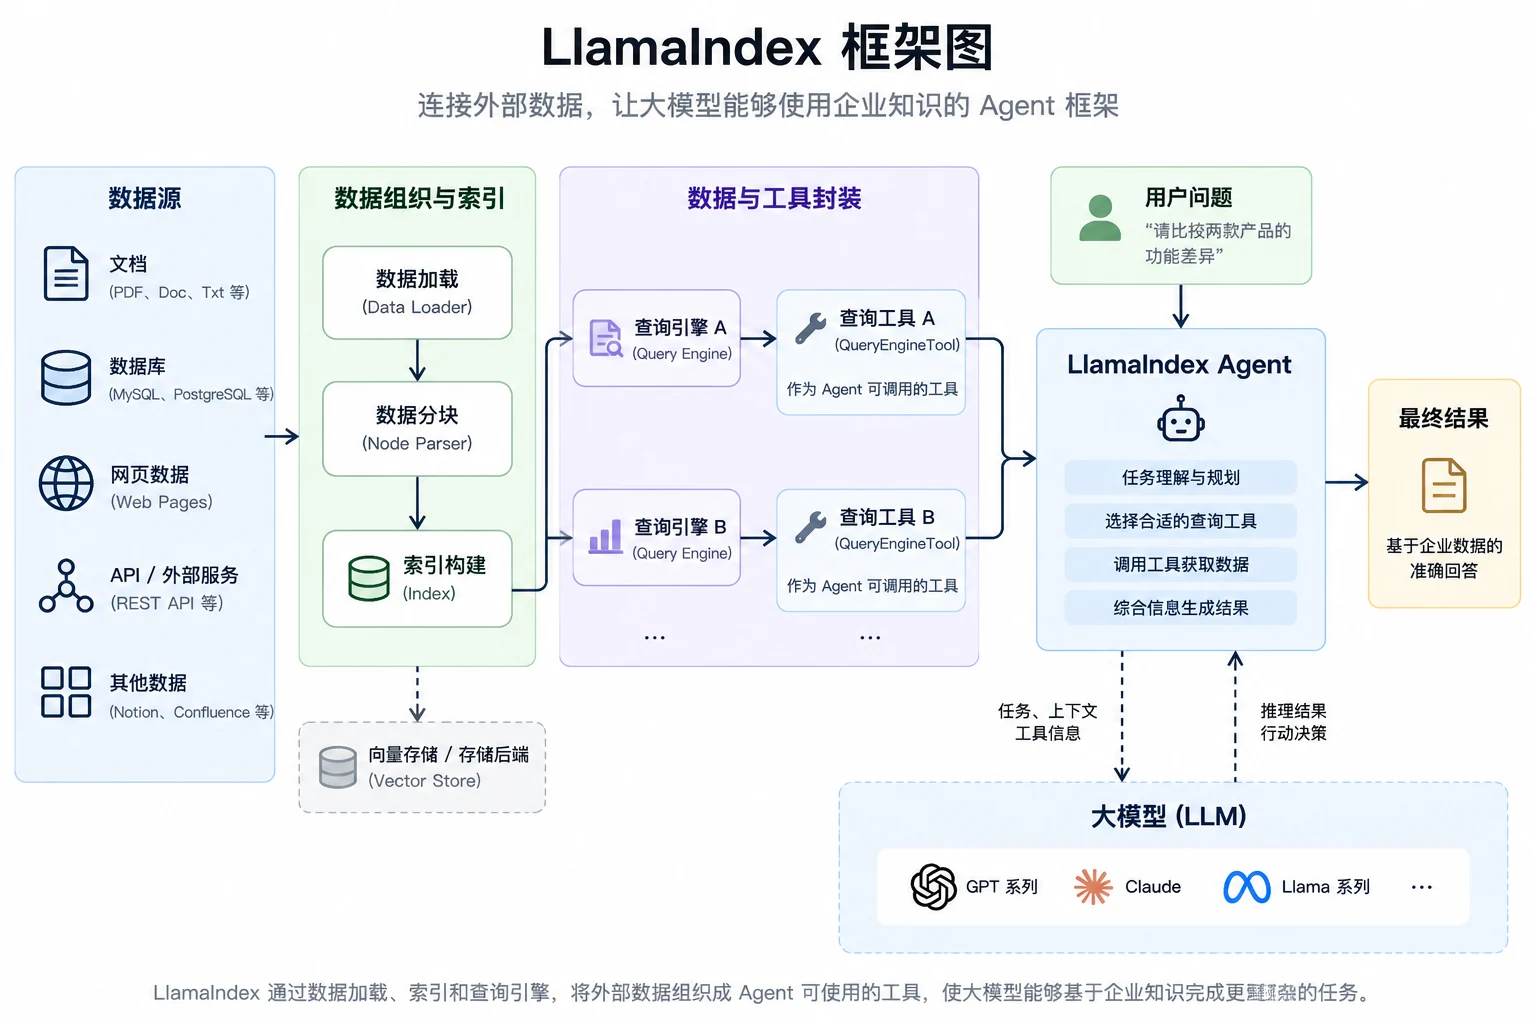
Large-Language-Modelle verstehen von sich aus keine externen Daten wie interne Produktunterlagen, Geschäftsdaten und Datenbanken des Unternehmens. Wenn ein Agent diese Daten zur Aufgabenerledigung verwenden muss, muss er zunächst relevante Informationen für die aktuelle Aufgabe finden. LlamaIndex kann externe Daten laden, organisieren und indizieren und dann über Komponenten wie Retriever und Query Engine recherche und abfragen. Die Query Engine kann natürlichsprachliche Fragen empfangen, relevante Daten im Index suchen und auch als Tool gekapselt werden, das von Agenten aufgerufen werden kann. Wie nachfolgend dargestellt, kann der Agent nach Empfang der Benutzeraufgabe bei Bedarf das entsprechende Abfragetool auswählen, um Informationen zu erhalten, und sie dann mit dem Large-Language-Modell analysieren, um das Endergebnis zu generieren. Auf diese Weise müssen nicht alle externen Daten direkt in den Kontext eingefügt werden, sondern können je nach Bedarf der Aufgabe abgefragt und verwendet werden.
Beispielsweise können für einen Agenten zur Geschäftsanalysierung Tools für Produktunterlagenabfrage und Geschäftsdatenabfrage konfiguriert werden. Wenn der Benutzer funktionale Unterschiede zwischen zwei Produkten vergleichen möchte, ruft der Agent das Abfragetool für die Produktunterlagen auf; wenn der Benutzer weitere Fragen zu den Verkäufen der beiden Produkte stellt, ruft er das Geschäftsdaten-Abfragetool auf. Für komplexere Fragen kann der Agent auch mehrere Daten-Abfragetools aufrufen und dann die Ergebnisse aus verschiedenen Datenquellen kombinieren, um die Aufgabe zu erledigen.
LlamaIndex wurde nicht ursprünglich für die Agent-Entwicklung konzipiert; seine Merkmale spiegeln sich hauptsächlich in der Daten- und Wissensverarbeitung wider. Es ermöglicht Large-Language-Modellen nicht nur, Dokumente zu recherchieren, sondern auch verschiedene Daten und Abfragefähigkeiten als Tools zu organisieren, die von Agenten ausgewählt und verwendet werden können. Es eignet sich besonders gut für Wissensdatenbank-Frag-Antwort-Anwendungen, Dokumentenanalyse, mehrquellen Datenabfragen und Agent-Anwendungen, die den Zugriff auf numerous Unternehmensdokumente, Wissensdatenbanken oder strukturierte Daten erfordern.
AutoGen-Framework
AutoGen wurde 2023 vom Microsoft Research-Team veröffentlicht und ist ein repräsentatives Open-Source-Framework im Bereich der Multi-Agent-Entwicklung. Mit Multi-Agent Conversation als Kernidee lassen mehrere Agenten durch Dialoge gemeinsam Aufgaben erledigen.
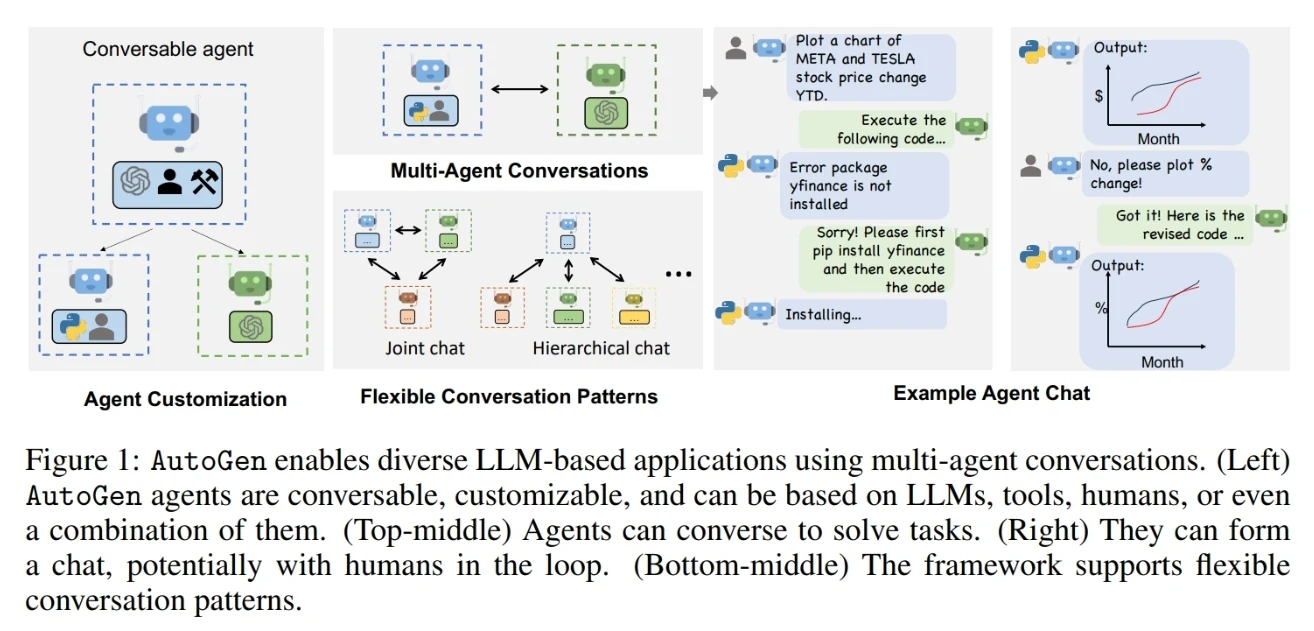
AutoGen entwirft Agenten als dialogfähige, anpassbare Entitäten. Ein Agent kann aus einem Large-Language-Modell, Tools, manueller Eingabe oder einer Kombination dieser Fähigkeiten bestehen. Entwickler können auch die Interaktionsweise zwischen Agenten definieren, sodass verschiedene Agenten unterschiedliche Dialogmodi bilden. Das Gesamtdesign ist nachfolgend dargestellt.
Dieses Diagramm spiegelt zwei wichtige Designkonzepte von AutoGen wider. Erstens können verschiedene Agenten unterschiedliche Fähigkeiten besitzen. Zweitens können mehrere Agenten durch verschiedene Conversation Pattern organisiert werden, um auf unterschiedliche Weise zu kommunizieren und zusammenzuarbeiten.
Beispielsweise kann bei einer Softwareentwicklungsaufgabe ein Agent die Anforderungen analysieren, ein Agent Code schreiben und ein weiterer Agent die Ergebnisse überprüfen. Nachdem der Programmier-Agent Code generiert hat, sendet er das Ergebnis an den Überprüfungs-Agent; wenn Probleme erkannt werden, kann der Überprüfungs-Agent Feedback an den Programmier-Agent geben, um weiterzuändern, bis die Aufgabenanforderungen erfüllt sind.
Derzeit bietet AutoGen hauptsächlich zwei Leistungsebenen: AgentChat und Core. AgentChat ist eine High-Level-Schnittstelle für die Erstellung von Single-Agent- und Multi-Agent-Anwendungen und bietet Komponenten wie Agent und Team. Entwickler können mehrere Agenten zu einem Team zusammenfassen und Zusammenarbeit durch Wechselauftritte, dynamische Auswahl des nächsten Agenten usw. organisieren. Core verwendet ereignisgesteuerte Methoden und bietet grundlegende Fähigkeiten für flexiblere und skalierbare Multi-Agent-Systeme.
Die Besonderheit von AutoGen besteht darin, die Kommunikation und Zusammenarbeit zwischen Agenten als Schwerpunkt des Framework-Designs zu setzen, was für komplexe Aufgaben geeignet ist, bei denen mehrere Agenten Aufgaben aufteilen müssen. Multi-Agent-Systeme erfordern zusätzliche Planung der Agentenverantwortlichkeiten und Zusammenarbeitsweisen; für einfache Aufgaben ist es in der Regel nicht notwendig, mehrere Agenten zu verwenden.
CrewAI-Framework
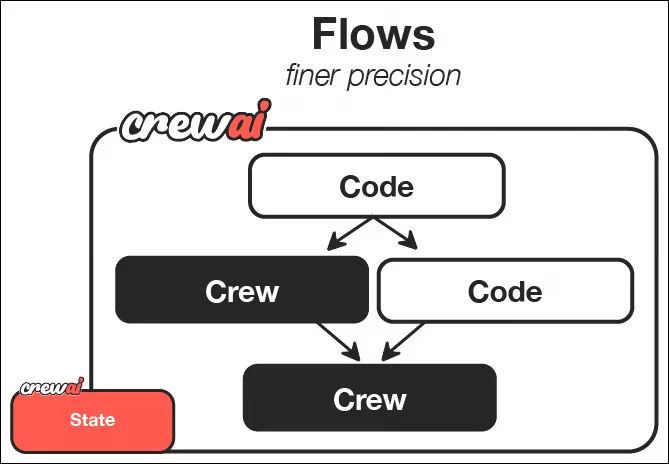
CrewAI konzentriert sich ebenfalls auf Multi-Agent-Zusammenarbeit, verwendet jedoch eine Organisation, die einem realen Team ähnlicher ist. Entwickler können für verschiedene Agenten Rollen, Ziele und Tools definieren und dann diese Agenten über Aufgaben und Workflows organisieren, um gemeinsam zu arbeiten. CrewAI bietet hauptsächlich zwei Organisationstypen: Crews betonen die autonome Zusammenarbeit zwischen mehreren Agenten, während Flows strukturierte Workflow-Kontrolle betonen.
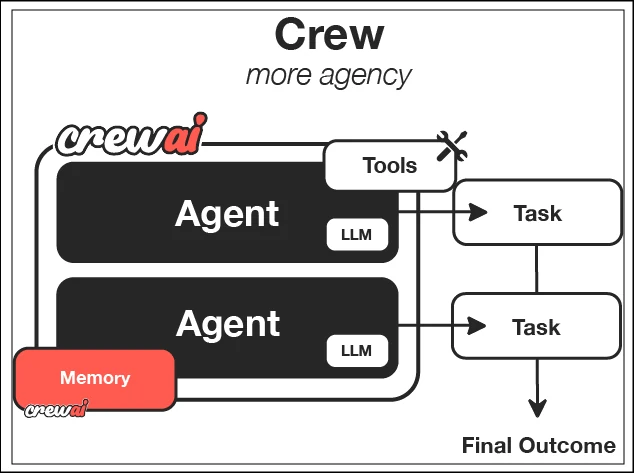
Die von CrewAI offiziell angegebene Framework-Struktur ist nachfolgend dargestellt.
In einem Crew können Agenten als Teammitglieder mit bestimmten Verantwortlichkeiten betrachtet werden, Tasks stellen die zu erledigenden konkreten Aufgaben dar, Process regelt die Ausführungsweise der Agenten und Aufgaben, und Crew organisiert diese Agenten und Aufgaben gemeinsam, um das Endziel zu erreichen.
Beispielsweise kann zur Erstellung eines Branchenforschungsberichts ein Recherche-Agent, ein Schreib-Agent und ein Überprüfungs-Agent erstellt werden. Der Recherche-Agent ist für das Finden und Organisieren von Material zuständig, der Schreib-Agent erstellt den Bericht anhand der Forschungsergebnisse, und der Überprüfungs-Agent ist für die Überprüfung von Problemen im Bericht verantwortlich. Verschiedene Agenten übernehmen unterschiedliche Verantwortlichkeiten und arbeiten gemeinsam durch die Verknüpfung von Aufgaben an der gesamten Arbeit.
Flows können Aufgaben gemäß einem vordefinierten Prozess organisieren und unterstützen Bedingungsprüfungen, Schleifen und Zustandsverwaltung. Crews und Flows können auch kombiniert werden; beispielsweise kann ein Flow den Gesamtgeschäftsprozess steuern und in einem komplexen Schritt einen Crew aufrufen, bei dem mehrere Agenten zusammenarbeiten, um die Aufgabe zu erledigen.
Die Besonderheit von CrewAI besteht darin, Multi-Agent-Zusammenarbeit über Rollen, Aufgaben und Teams zu organisieren. Das Gesamtdesign ähnelt der realen Teamarbeit. Es eignet sich besonders gut für Multi-Agent-Anwendungen mit klaren Rollen- und Aufgabengrenzen, wie Forschungsinhalte, Inhaltserstellung, Datenanalyse und Überprüfungszenarien.
LangGraph-Framework
LangGraph wurde 2024 vom LangChain-Team veröffentlicht und ist ein Orchestrierungs-Framework auf niedriger Ebene für die Erstellung und Verwaltung von lang laufenden, zustandsbehafteten Agenten. Im Gegensatz zur Verwendung vorgefertigter Agenten ermöglicht es Entwicklern, die Ausführungsstruktur von Agenten explizit zu definieren und eignet sich besonders für Agenten mit komplexen Workflows wie Zustand, Verzweigung, Schleife und menschlichem Eingriff.
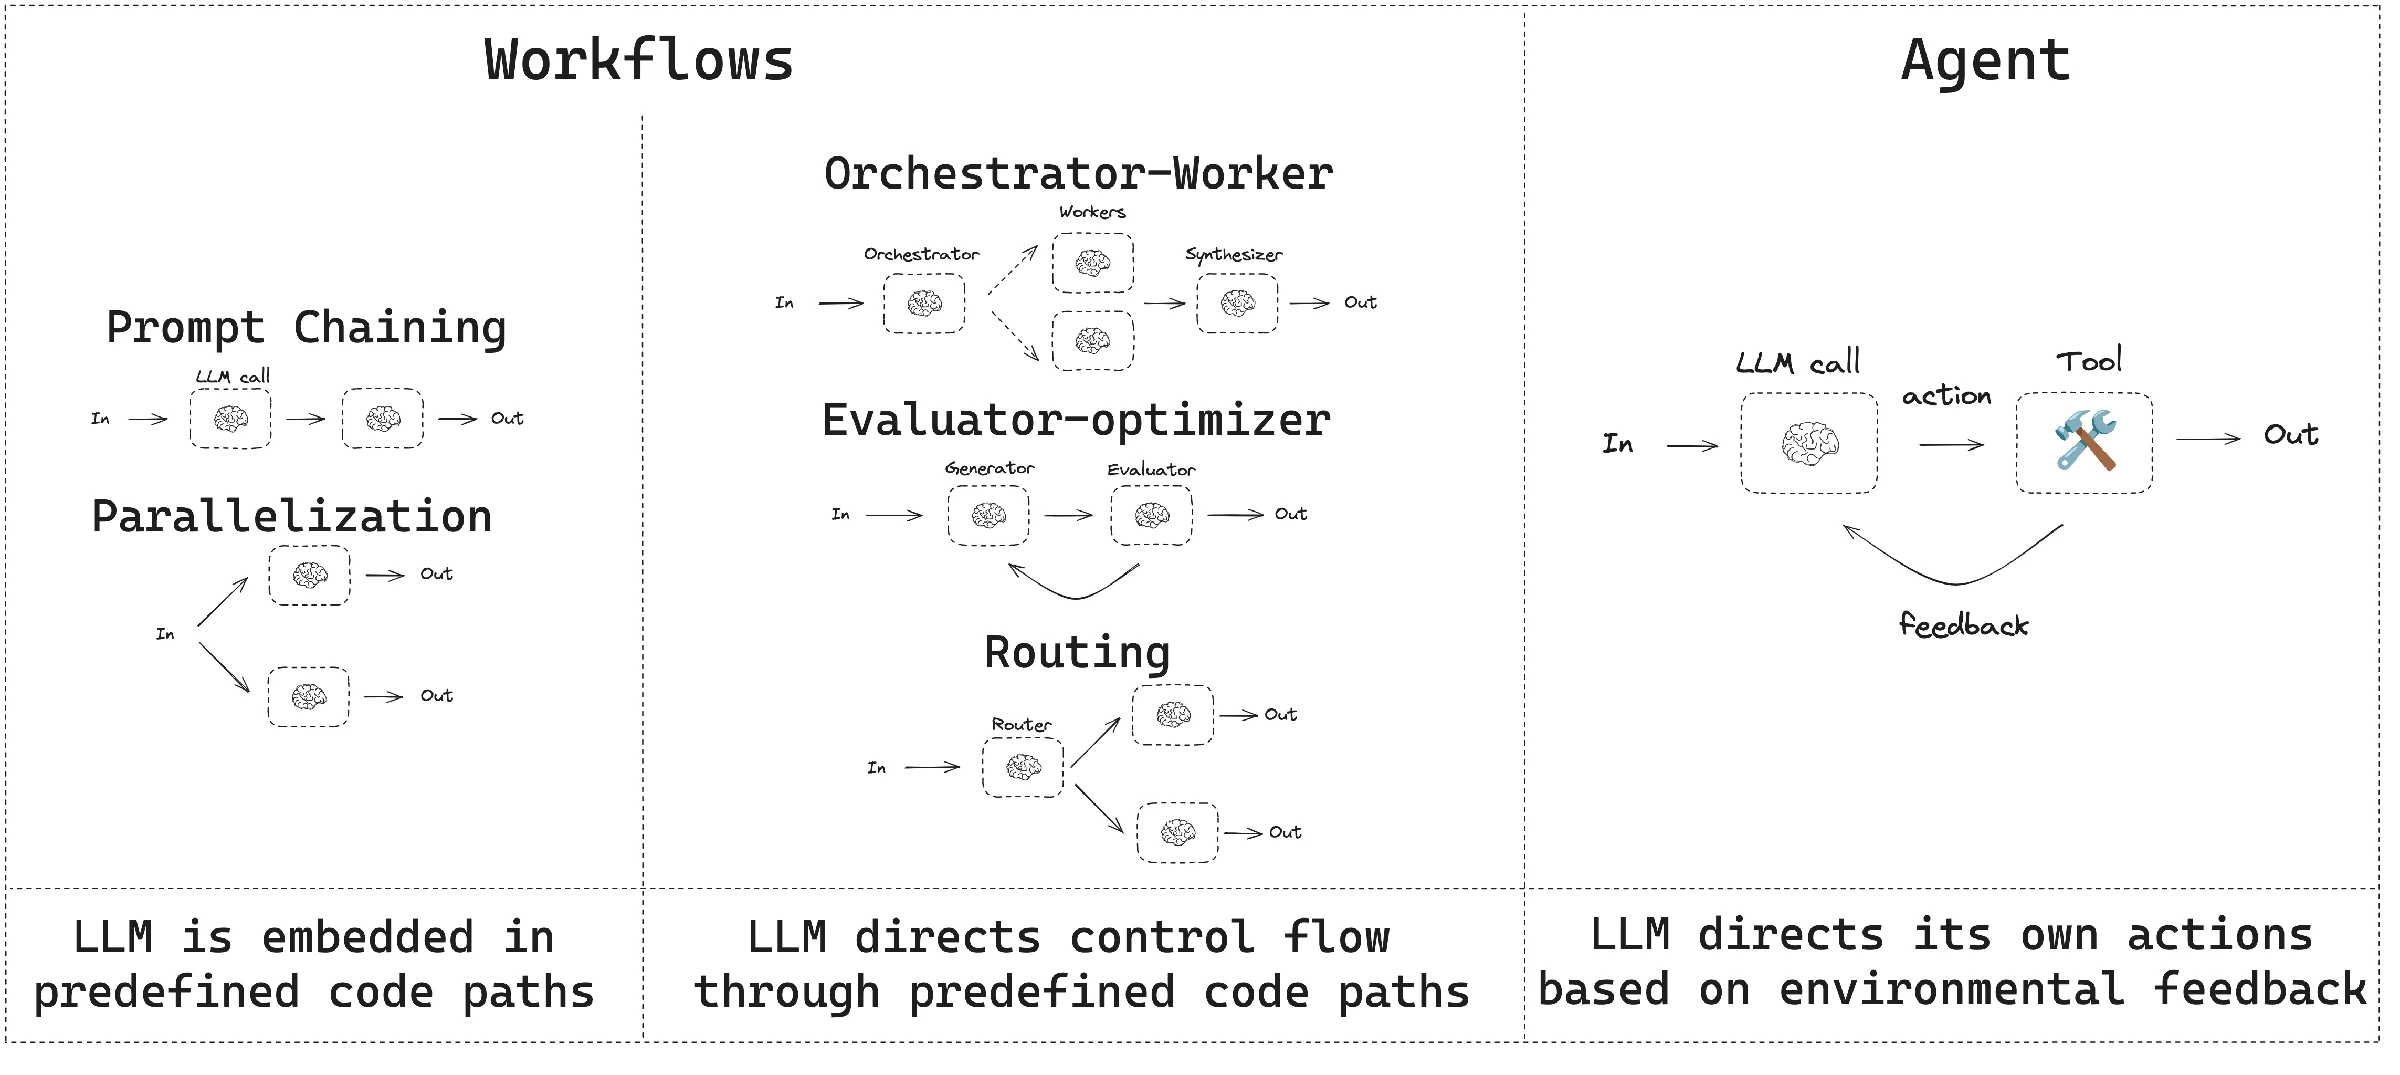
LangGraph kann sowohl Workflows mit relativ klaren Ausführungswegen als auch Agenten erstellen, bei denen das Large-Language-Modell dynamisch den nächsten Schritt bestimmt. Workflows können den Ausführungsweg von Aufgaben im Voraus definieren und verschiedene Schritte über sequenzielle, parallele, Routing- und Schleifenmethoden organisieren; Agenten können anhand des aktuellen Zustands und der Tool-Ergebnisse dynamisch den nächsten Schritt bestimmen. In der Praxis können Workflows und Agenten auch kombiniert werden, wobei der Workflow den Gesamtprozess bestimmt und der Agent die Bereiche verantwortet, die dynamische Entscheidungen erfordern.
Die von LangGraph unterstützten Workflow- und Agenten-Modi sind nachfolgend dargestellt.
Um diese verschiedenen Ausführungswege zu realisieren, verwendet LangGraph Graphen zur Beschreibung des Ausführungsprozesses, wobei drei Grundkonzepte State, Node und Edge sind. State dient zur Speicherung von Informationen, die während der Aufgabenausführung geteilt werden müssen; Node stellt einen konkreten Verarbeitungsschritt dar, wie beispielsweise Aufruf eines Large-Language-Modells, Wissensrecherche oder Ausführung eines Tools; Edge verbindet verschiedene Knoten und entscheidet, in welchen Knoten die Aufgabe als nächstes wechselt.
Beispielsweise kann ein Wissens-Frag-Antwort-Agent zuerst die Benutzerfrage analysieren, dann Wissen recherchieren, eine Antwort generieren und das Ergebnis überprüfen. Wenn die Antwort die Überprüfung nicht besteht, kann sie über eine bedingte Verzweigung erneut in den Recherche-Knoten eintreten; wenn die Überprüfung besteht, wechselt sie in den Endausgabe-Knoten. Im gesamten Prozess können Benutzerfragen, Rechercheergebnisse, Zwischenantworten usw. im State gespeichert und zwischen verschiedenen Knoten geteilt werden.
Dieses Design unterscheidet sich von der vollständigen Abhängigkeit vom Large-Language-Modell zur Bestimmung des nächsten Schritts. LangGraph ermöglicht es, die grobe Ausführungsstruktur von Aufgaben im Voraus vorzuschreiben und in Knoten, die eine Entscheidung erfordern, Large-Language-Modelle zur Entscheidungsfindung zu verwenden. Auf diese Weise bleibt die Fähigkeit des Agenten, anhand der tatsächlichen Umstände dynamisch zu urteilen, erhalten, und der kritische Ausführungsweg kann kontrolliert werden.
Neben Graphstruktur und Zustandsverwaltung bietet LangGraph auch Funktionen wie Durable Execution und Human-in-the-loop. Lang laufende Aufgaben können den Ausführungszustand speichern und nach Unterbrechung fortgesetzt werden; vor wichtigen Aktionen kann der Agent auch angehalten und auf menschliche Überprüfung oder Zustandsänderung gewartet werden, bevor die Ausführung fortgesetzt wird. Daher positioniert sich LangGraph offiziell als Orchestrierungs-Framework auf niedriger Ebene für lang laufende, zustandsbehaftete Agenten.
LangGraph kann den Zustand und den Ausführungsweg feingranular steuern, erfordert jedoch von Entwicklern mehr Workflow-Design. Für einfache Tool-Aufruf-Agenten ist es nicht notwendig, von Anfang an komplexe Graphen zu erstellen. LangGraph empfiehlt offiziell auch, dass Einsteiger, die Agenten erstmals lernen oder eine höhere Agenten-Abstraktion benötigen, zunächst mit LangChain-Agenten beginnen.
MS-Agent-Framework
MS-Agent ist ein leichtgewichtiges Agent-Entwicklungsframework der ModelScope-Community, das hauptsächlich auf Aufgaben ausgerichtet ist, die autonome Erkundung und mehrschrittige Ausführung erfordern, und Modellaufrufe, Tool-Integration und Multi-Agent-Zusammenarbeit bietet. Es kann zur Erstellung von Deep-Research-, Dokumentenanalyse- und Code-Generierungsanwendungen verwendet werden.
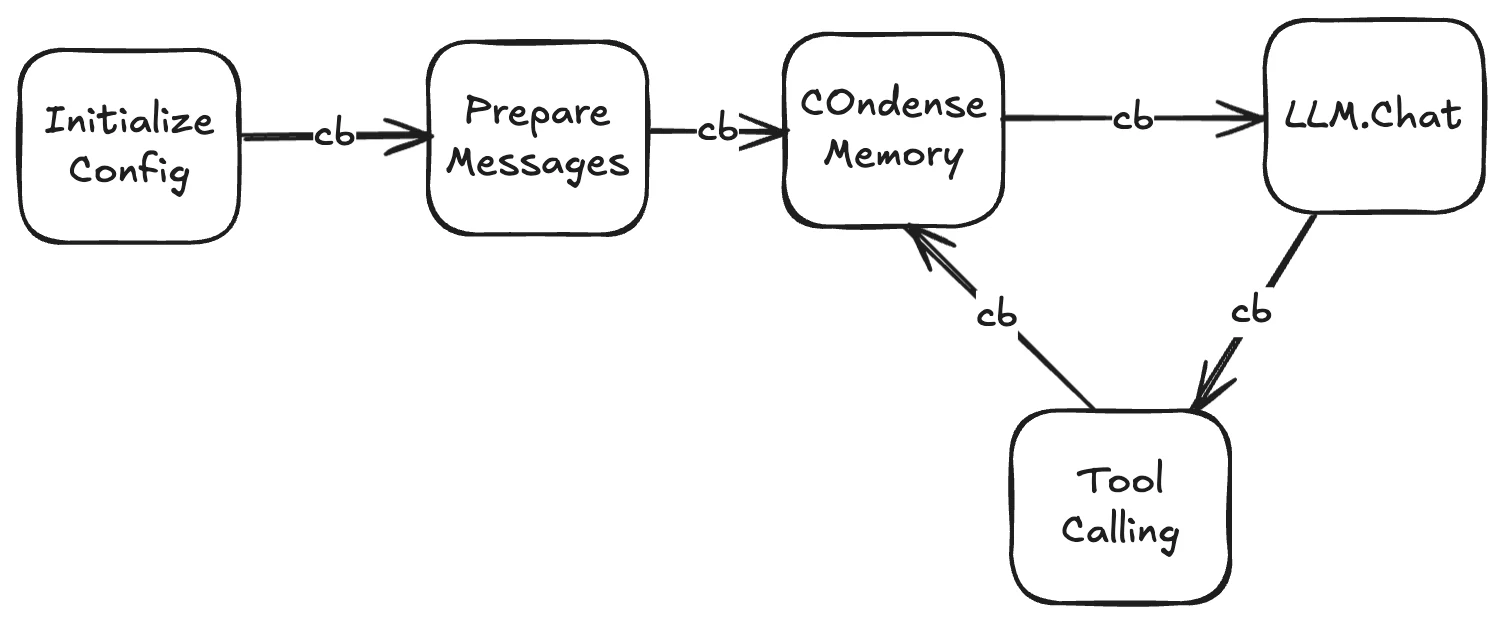
Die Grundkomponente von MS-Agent ist LLMAgent, der für die Organisation von Large-Language-Modell-Dialogen und Tool-Aufrufen verantwortlich ist. Entwickler können über Konfigurationsdateien das Modell, Prompts und Tools angeben. Nach Empfang der Benutzeraufgabe stellt LLMAgent dem Large-Language-Modell die Aufgabe und die verfügbaren Tools zur Verfügung, und das Modell entscheidet über den nächsten Schritt. Wenn ein Tool-Aufruf erforderlich ist, führt das Framework die entsprechende Aktion aus und gibt das Ergebnis an das Modell zur weiteren Verarbeitung zurück, bis das Modell eine Antwort generiert, die keine Tool-Aufrufe mehr enthält, oder die maximalen Ausführungsrunden erreicht sind.
Der grundlegende LLMAgent-Betriebsprozess ist nachfolgend dargestellt. Nach Abschluss der Konfigurationsinitialisierung und Nachrichtenvorbereitung zirkuliert der Agent zwischen Modellaufruf und Tool-Ausführung und komprimiert bei Bedarf den Kontext. Das cb im Diagramm steht für Callback; Entwickler können an den entsprechenden Stellen Protokollierung oder andere benutzerdefinierte Verarbeitung hinzufügen.
Tool-Integration ist eine wichtige Fähigkeit von MS-Agent. Das Framework bietet eingebaute Tools wie Dateilesen/schreiben, Code-Ausführung und Aufgabenaufteilung und unterstützt die Integration externer Tools über MCP (Model Context Protocol). Entwickler können vorhandene MCP-Dienste wiederverwenden oder benutzerdefinierte Tools schreiben, sodass Agenten auf die benötigten Daten und externen Systeme zugreifen können.
Für Aufgaben, die mehrere Schritte erfordern, unterstützt MS-Agent die Kombination verschiedener Agenten über Workflows. LLMAgent ist für Bereiche verantwortlich, die Large-Language-Modell-Entscheidungen und Generierung erfordern, während CodeAgent für deterministische Operationen gemäß Code-Ausführung verantwortlich ist. Entwickler können Datenanalyse, Datenverarbeitung und Ergebnisgenerierung zu einem Workflow organisieren und über Konfigurationsdateien die Ausführungsbeziehung der einzelnen Schritte festlegen.
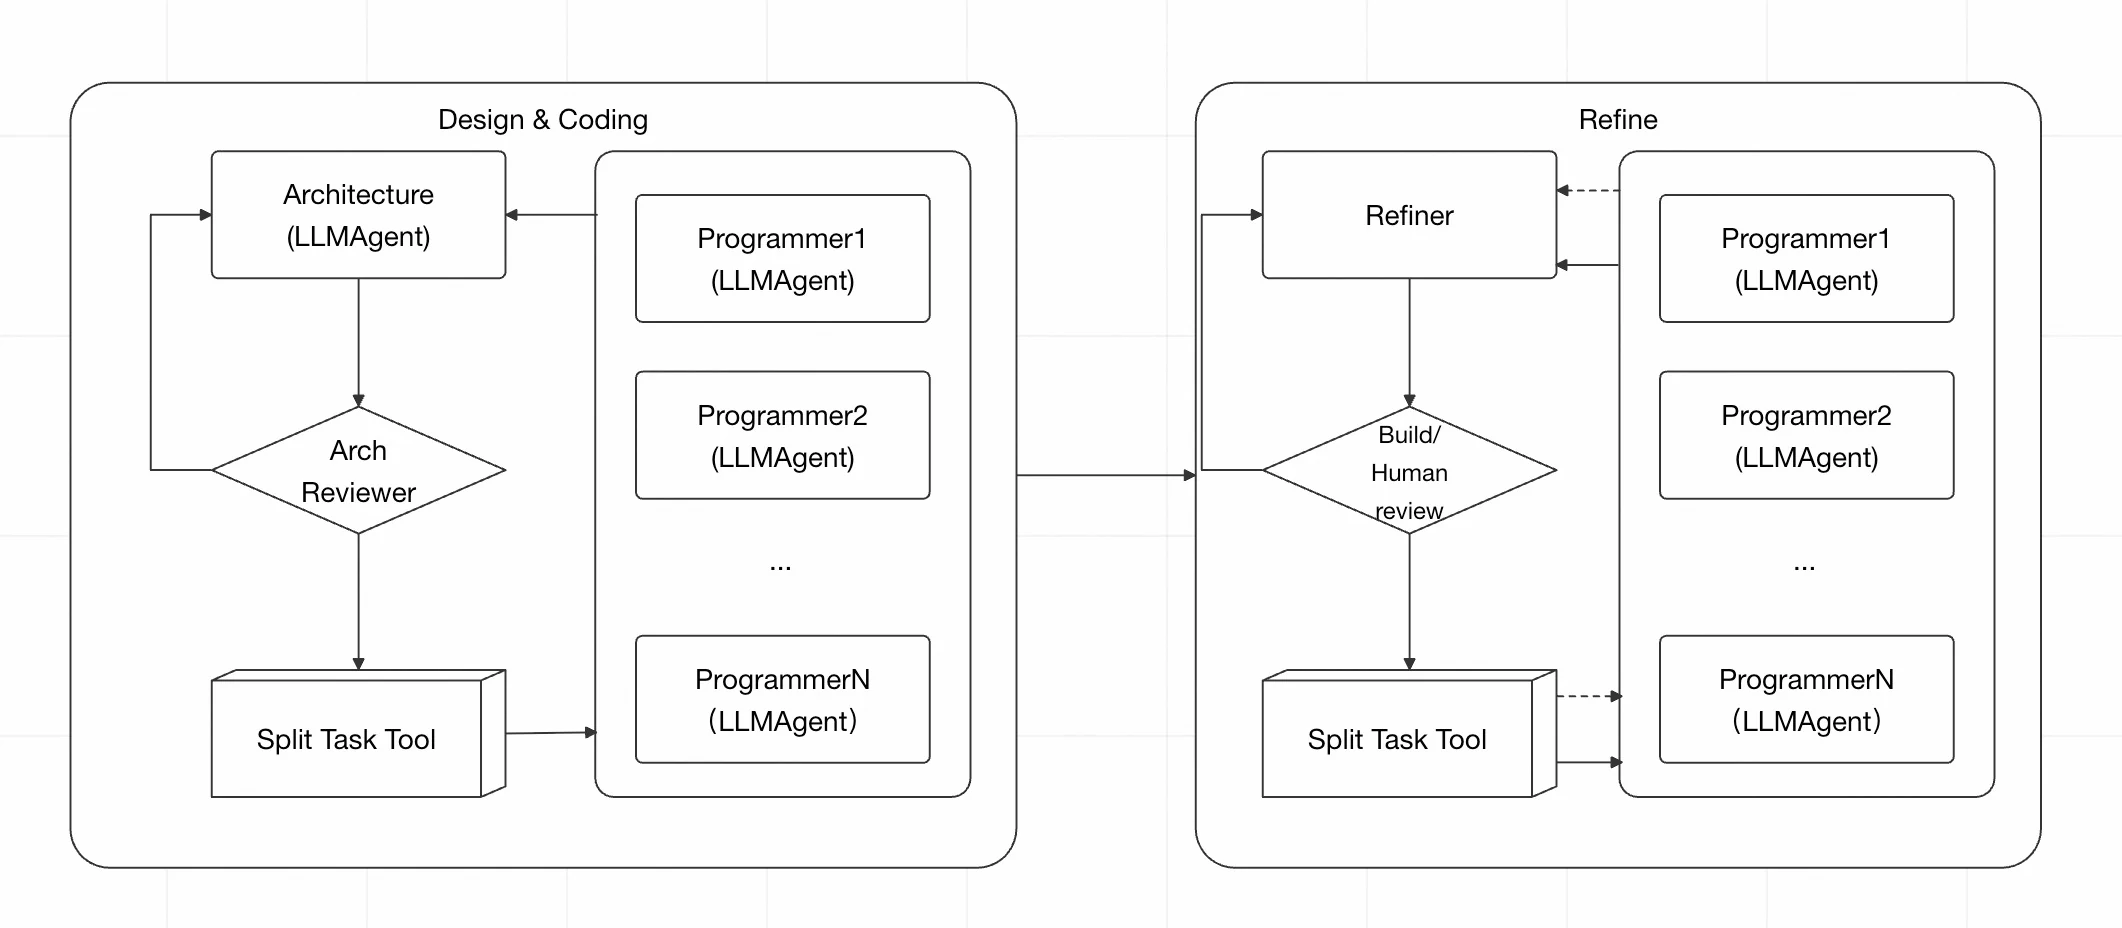
Beispielsweise bietet das MS-Agent-Projekt Code Genesis einen Multi-Agent-Zusammenarbeit-Beispiel für Code-Generierung, wobei der Prozess in Design und Codierung sowie Überprüfung und Optimierung unterteilt wird. Der Architektur-Agent ist für das Design verantwortlich, und das Aufgabenaufteilungstool verteilt die Arbeit an mehrere Programmier-Agenten; nach Übergang zur Optimierungsphase werden basierend auf Feedback von Build- oder manuellen Überprüfungen Änderungsaufgaben aufgeteilt und von Programmier-Agenten weiterverarbeitet.
Agent SDK
Neben der Verwendung von Agent-Entwicklungsframeworks bieten einige Modellanbieter auch Agent-Entwicklungsfähigkeiten in Form von SDKs (Software Development Kit), die Modellaufrufe, Tool-Aufrufe und Aufgabenausführung in Schnittstellen, Klassen und Komponenten kapseln, um Entwicklern zu helfen, Agenten in ihren Anwendungen zu erstellen und auszuführen. Sowohl Agent-Frameworks als auch Agent-SDKs können zur Erstellung von Agenten verwendet werden; bieten sich überschneidende Fähigkeiten, unterscheiden sich jedoch in der Organisation und den Schwerpunkten. Im Folgenden werden zwei repräsentative Agent-SDKs vorgestellt.
OpenAI Agents SDK
OpenAI veröffentlichte 2025 das OpenAI Agents SDK, das den Aufbau von Agent-Anwendungen mit wenigen Kernabstraktionen betont. Agenten dienen als grundlegende Ausführungseinheit, und rund um Agenten werden Tool-Aufrufe, Aufgabenübergabe, Ausführungseinschränkungen und Ausführungsverfolgung bereitgestellt. Tools dienen zum Abfragen von Daten, Ausführen von Code, Aufrufen von APIs oder Betreiben anderer externer Systeme; Handoffs ermöglichen es dem aktuellen Agenten, Aufgaben an einen anderen, für die Aufgabe besser geeigneten Agenten zu übergeben; Guardrails prüfen Eingaben, Ausgaben und teilweise Tool-Aufrufe von Agenten; und Tracing zeichnet Modelgenerierung, Tool-Aufrufe, Aufgabenübergaben und Guardrail-Ereignisse während der Agentenausführung auf.
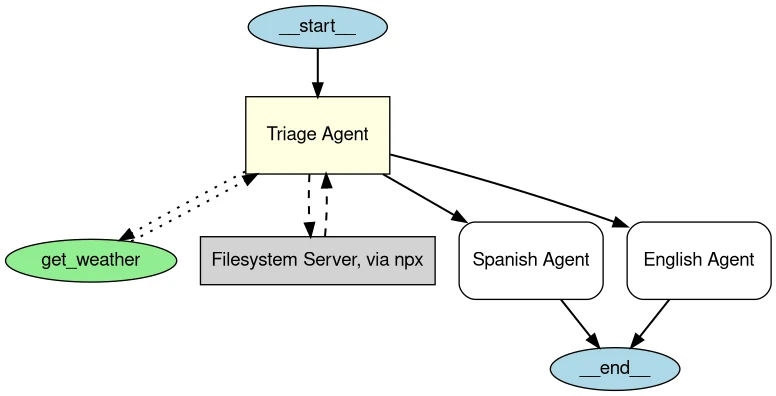
Das OpenAI Agents SDK bietet auch Agent Visualization, mit der Agenten und die damit verbundenen anderen Agenten, Tools und MCP-Server in einer Graphstruktur generiert werden können. Die gerichteten Verbindungen zwischen Agenten können Handoffs darstellen, während Verbindungen zwischen Tools und Agenten Tool-Aufrufe darstellen.
Beispielsweise kann in einem Kundenservice-System ein Eingangs-Agent eingerichtet werden, der Benutzerfragen identifiziert, und dann Aufgaben-, Rückerstattungs- und FAQ-Agenten, die verschiedene Geschäftstypen bearbeiten. Wenn ein Benutzer eine Rückerstattungsfrage stellt, kann der Eingangs-Agent die Aufgabe über Handoff an den Rückerstattungs-Agent übergeben; der Rückerstattungs-Agent ruft dann bei Bedarf Bestellabfrage-, Rückerstattungsantrag- und andere Tools auf, um die Aufgabe zu erledigen. Handoffs eignen sich besonders für Szenarien, in denen verschiedene Spezialisten-Agenten unterschiedliche Aufgaben bearbeiten.
Guardrails und Tracing berücksichtigen Einschränkungen und Beobachtungsprobleme während des tatsächlichen Agentenbetriebs. Guardrails können vor und nach Agent-Eingaben, endgültigen Ausgaben und benutzerdefinierten Funktions-Tool-Aufrufen prüfen; Tracing zeichnet Modelgenerierung, Tool-Aufrufe, Handoffs und Guardrail-Ereignisse während eines Agentenlaufs auf, um Entwicklern zu helfen, zu verstehen, welche Schritte der Agent durchlaufen hat und wo Probleme aufgetreten sind.
Die Besonderheit des OpenAI Agents SDK besteht darin, dass die Kernkonzepte relativ konzentriert sind. Entwickler können mit einem einzelnen Agenten und Tools beginnen und dann schrittweise Multi-Agent-Zusammenarbeit, Guardrails und Tracing hinzufügen. Im Vergleich zu LangGraph liegt der Schwerpunkt der beiden Designs unterschiedlich: LangGraph betont feingranulare Kontrolle über Zustand und Workflow; OpenAI Agents SDK konzentriert sich auf umfassende Fähigkeiten rund um den Agenten wie Tool-Aufrufe, Aufgabenübergabe, Ausführungseinschränkungen und Ausführungsverfolgung.
Claude Agent SDK
Claude Agent SDK ist ein von Anthropic veröffentlichtes Agent-Entwicklungs-SDK, ursprünglich als Claude Code SDK bezeichnet, später umbenannt in Claude Agent SDK. Es stellt die Agent-Fähigkeiten von Claude Code Entwicklern zur Verfügung, sodass Entwickler in ihren Anwendungen Agenten erstellen können, die Tools verwenden, auf die Laufsumgebung zugreifen und Aufgaben kontinuierlich ausführen können.
Im Vergleich zu den zuvor vorgestellten Agent-Entwicklungstools zeichnet sich Claude Agent SDK dadurch aus, dass es den Zugriff und die Operation des Agenten auf die tatsächliche Laufsumgebung stärker betont. Neben dem Aufruf externer Tools bietet es eingebaute Fähigkeiten wie Dateilesen, Dateiänderung und Befehlsausführung, sodass Agenten direkt Dateien verarbeiten, Programme ausführen und Befehle ausführen können. Über MCP können weitere externe Tools und Daten angeschlossen werden. Darüber hinaus bietet es Mechanismen wie Berechtigungskontrolle, Hooks und Subagents. Die Berechtigungskontrolle schränkt die Aktionen ein, die Agenten ausführen können; Hooks können benutzerdefinierte Verarbeitungslogik in kritischen Phasen wie Tool-Aufrufen einfügen; Subagents können Teilaufgaben an unabhängige Sub-Agenten übergeben.
Während des Betriebs entscheidet der Agent anhand der aktuellen Aufgabe und des Kontexts über den nächsten Schritt, wie beispielsweise Dateien lesen, Code ändern oder Befehle ausführen. Nach der Tool-Ausführung werden die Ergebnisse an den Agenten zurückgegeben, der dann anhand der neuen Informationen weiter entscheidet, bis die Aufgabe abgeschlossen ist. Claude Agent SDK organisiert diesen Ausführungsprozess und übernimmt dabei Tool-Aufrufe, Berechtigungsprüfungen und Kontextweitergabe.
Beispielsweise kann bei einer Softwareentwicklungsaufgabe der Agent aufgefordert werden, den Projektcode zu lesen, Dateien gemäß den Benutzeranforderungen zu ändern und dann Tests auszuführen. Wenn ein Test fehlschlägt, kann der Agent Fehlerinformationen lesen und weiter ändern, bis die Aufgabe abgeschlossen ist. In diesem Prozess ist das Large-Language-Modell für das Verstehen der Aufgabe und die Entscheidung über den nächsten Schritt verantwortlich, während Claude Agent SDK Laufsfähigkeiten wie Dateisystem, Terminal und Tools bereitstellt und die Berechtigung sowie den Aufgabenausführungsprozess verwaltet.
Claude Agent SDK eignet sich besonders gut für Agent-Anwendungen, die auf Dateien und Laufsumgebungen zugreifen, kontinuierlich Tools aufrufen und mehrstufige Aufgaben ausführen müssen, insbesondere für Szenarien wie Softwareentwicklung und Automatisierungsaufgaben.
In der tatsächlichen Agent-Entwicklung werden zunehmend Fähigkeiten wie Laufumgebung, Kontextverwaltung, Berechtigungskontrolle, Aufgabenstatus und Ausführungsfeedback geschätzt. Wie man diese Fähigkeiten rund um Large-Language-Modelle organisiert und den Aufgabenausführungsprozess verwaltet und kontrolliert, ist zu einem wichtigen Problem im Agent-Systemdesign geworden. Genau auf diese Probleme konzentriert sich Harness.
Harness
Was ist ein Harness?
Mit zunehmenden Large-Language-Modellfähigkeiten hat sich das Problem von Agenten allmählich von „Kann das Modell eine bestimmte Aufgabe ausführen?" zu „Kann das Modell eine reale Aufgabe kontinuierlich und zuverlässig ausführen?" verschoben. Bei einer einfachen Frage-Antwort muss das Large-Language-Modell nur anhand der Eingabe ein Ergebnis generieren; bei komplexen Aufgaben wie Softwareentwicklung, Datenanalyse und Geschäftsautomatisierung muss der Agent möglicherweise über längere Zeit kontinuierlich arbeiten, Fortschritte über mehrere Schritte hinweg speichern, verschiedene Tools aufrufen und basierend auf den tatsächlichen Ausführungsergebnissen nachfolgende Operationen kontinuierlich anpassen. In diesem Fall kann allein auf die Schlussfolgerungsfähigkeit des Modells nicht garantiert werden, dass die Aufgabe letztendlich korrekt abgeschlossen wird.
Beispielsweise kann ein Code-Agent die Anforderung „Ändere eine bestimmte Funktion" korrekt verstehen und auch Code von hoher Qualität generieren, aber während des tatsächlichen Ausführungsprozesses können verschiedene Probleme auftreten: Das Ändern von Code ohne vorheriges Lesen der Projektspezifikation, gleichzeitiges Ändern zu vieler Datei, Auslassen notwendiger Schritte, Verlieren früherer Aufgabenfortschritte während der Ausführung oder das Abschließen der Aufgabe, obwohl der Code die Tests noch nicht besteht. Diese Probleme stammen nicht vollständig aus den Fähigkeiten des Modells selbst, sondern stehen im Zusammenhang mit der Arbeitsumgebung des Modells und der Art und Weise der Aufgabenausführung.
Harness ist ein Arbeitsumfeld und ein Betriebsmechanismus, das um das Large-Language-Modell herum aufgebaut wurde, um festzulegen, welche Informationen das Modell erhalten kann, welche Aktionen es ausführen kann, wie der Aufgabenstatus gespeichert werden soll, wie bestimmt wird, ob die Aufgabe abgeschlossen ist, und wie bei Problemen weiter verarbeitet wird. Durch diese Mechanismen können die einmaligen unabhängigen Schlussfolgerungen und Operationen des Modells zu einem eingeschränkten, kontinuierlich laufenden und ergebnisüberprüfbaren Aufgabenausführungsprozess organisiert werden.
Der Schwerpunkt von Harness liegt nicht darauf, das Wissen oder die Schlussfolgerungsfähigkeit des Large-Language-Modells weiter zu verbessern, sondern sicherzustellen, dass die vorhandenen Fähigkeiten des Modells zuverlässiger auf reale Aufgaben angewendet werden können. Das Modell ist weiterhin für das Verstehen der Aufgabe, die Analyse von Problemen und die Entscheidung über den nächsten Schritt verantwortlich; Harness ist für die Schaffung der Arbeitsbedingungen verantwortlich, die das Modell zur Aufgabenerledigung benötigt, und übt Einschränkungen und Feedback über den gesamten Ausführungsprozess aus.
Aus der Betriebsperspektive bildet Harness einen kontinuierlichen Kreislauf für den Agenten: Der Agent urteilt anhand der aktuellen Aufgabe und des Zustands, führt die entsprechende Aktion aus und erhält neue Ergebnisse aus der Laufumgebung; diese Ergebnisse werden nach Aufzeichnung, Prüfung und Feedback erneut als Grundlage für die nächste Entscheidung herangezogen. Wenn die Ergebnisse die Anforderungen nicht erfüllen, ändert und führt der Agent weiter aus; erst wenn die vorab definierten Abschlussbedingungen erreicht sind, endet die Aufgabe wirklich.
Harness unterscheidet sich deutlich von einfachen Prompts oder Tool-Aufrufen. Prompt teilt dem Modell hauptsächlich über Anweisungen Aufgabenziele und Verhaltensanforderungen mit, Tools ermöglichen es dem Modell, konkrete Operationen auszuführen, und Harness betrachtet ferner, wie diese Anweisungen und Tools über den gesamten Aufgabenausführungsprozess organisiert und verwaltet werden. Es muss dem Agenten wissen lassen, wo er anfängt, wo er sich gerade befindet, welche Operationen ausgeführt werden können, wie Ergebnisse überprüft werden, wann er beendet werden kann und wie nach Aufgabenunterbrechung fortgefahren werden kann. Für Agenten, die über längere Zeit laufen und mehrschrittige Ausführungen erledigen, wirken sich diese Mechanismen direkt darauf aus, ob die Aufgabe stabil abgeschlossen werden kann.
Hauptkomponenten des Harness
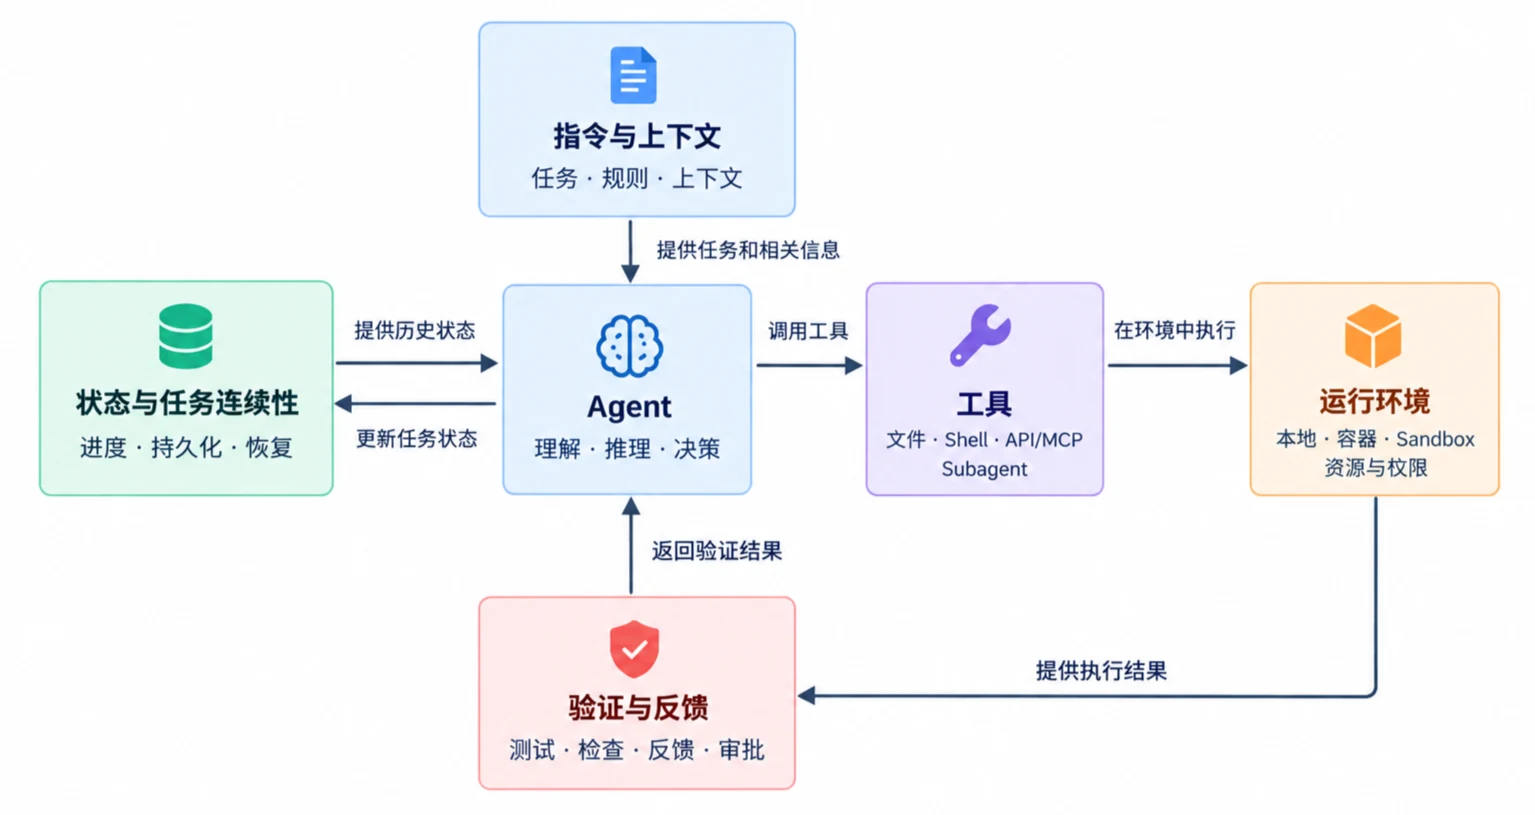
Harness hat keine einheitliche Implementierung; verschiedene Agent-Systeme bieten unterschiedliche Betriebsmechanismen je nach Aufgabentyp. Aus der Sicht der Probleme, die während des tatsächlichen Agentenbetriebs gelöst werden müssen, kann Harness in fünf zusammenarbeitende Teile zusammengefasst werden: Anweisungen und Kontext, Tools, Laufumgebung, Zustand und Aufgabenkontinuität sowie Validierung und Feedback.
(1) Anweisungen und Kontext
Anweisungen und Kontext bestimmen, was ein Agent in der aktuellen Aufgue „weiß" und „befolgen soll".
Anweisungen umfassen nicht nur die aktuelle Benutzereingabe, sondern auch System-Prompts, Projektregeln, Codestandards, Geschäftseinschränkungen, Aufgabengrenzen und Abschlussbedingungen. Beispielsweise kann ein Programmier-Agent über AGENTS.md, CLAUDE.md oder Projektdokumente die Verzeichnisstruktur, Entwicklungsstandards, Testmethoden und gesperrte Bereiche verstehen.
Kontext bezieht sich auf relevante Informationen, die während der Ausführung dem Modell bereitgestellt werden, einschließlich Benutzeranforderungen, bisheriger Operationen, Dateiinhalten, Tool-Ausführungsergebnissen und aktuellem Aufgabenstatus. Da das Modell-Kontextfenster begrenzt ist, muss Harness den Kontext häufig auswählen, komprimieren und neu organisieren, sodass das Modell die Informationen erhält, die für die aktuelle Aufgabe wirklich benötigt werden, anstatt einfach den gesamten bisherigen Inhalt kontinuierlich anzuhängen.
Für komplexe Aufgaben können hierarchische Anweisungen und schrittweise Kontextladung eingesetzt werden. Beispielsweise kann der Agent zunächst die Gesamtbeschreibung des Projekts lesen und nach Betreten eines Moduls die lokalen Regeln dieses Moduls laden; wenn die Aufgabenausführung lange dauert und der Kontext kontinuierlich zunimmt, können frühere Prozesse komprimiert und nur Schlussfolgerungen, Aufgabenstatus und für die Folgezeit noch benötigte Informationen beibehalten werden. Durch diese Mechanismen können im begrenzten Kontextfenster kontinuierlich relevante Informationen für den Agenten bereitgestellt und durch Anweisungen der Aufgabenbereich und die Verhaltensgrenzen des Agenten eingeschränkt werden.
(2) Tools
Large-Language-Modelle sind hauptsächlich für Verstehen, Schlussfolgerung und Entscheidungsgenerierung verantwortlich. Um tatsächlich externe Informationen zu lesen oder konkrete Operationen auszuführen, müssen Tools verwendet werden. Tools bestimmen daher, welche Aktionen ein Agent tatsächlich ausführen kann.
Für Programmier-Agenten gehören zu den gängigen Tools Dateilesen, Dateiänderung, Codesuche, Shell-Befehlsausführung, Git-Operationen und Testwerkzeuge; für Unternehmens-Agenten können Datenbankabfragen, Wissensdatenbank-Recherche, Browser, Geschäfts-APIs und über MCP angeschlossene externe Systeme gehören.
Harness muss auf dieser Ebene nicht nur eine Tool-Liste pflegen, sondern auch Tool-Beschreibungen, Parameterorganisation, Aufruf-Routing, Rückgabe von Ausführungsergebnissen und Ausnahmebehandlung verarbeiten. Beispielsweise muss Harness nach Entscheidung des Large-Language-Modells „Projekttests ausführen" das entsprechende Tool aufrufen, den Testbefehl in der angegebenen Umgebung ausführen und dann Standardausgabe, Fehlerinformationen und Exit-Status sortiert an das Modell zurückgeben, sodass der Agent anhand der Ausführungsergebnisse über den nächsten Schritt entscheiden kann.
Tool-Aufrufe müssen mit entsprechenden Sicherheits- und Berechtigungskontrollen koordiniert werden. Einige Tools können nur Dateien lesen, andere dürfen Inhalte ändern; beim Löschen von Dateien, Zugriff auf Netzwerk, Ausführen von Systembefehlen oder Betreiben von Produktionssystemen können je nach Risikostufe Einschränkungen vorgenommen und bei Bedarf manuelle Bestätigungen eingefordert werden. Hooks und andere Mechanismen können vor und nach Tool-Aufrufen eingefügt werden, um Parameter zu prüfen, Ausführungsprozesse aufzuzeichnen oder nicht regelkonforme Aktionen zu blockieren.
In Systemen, die Subagenten unterstützen, kann der Haupt-Agent auch Teilaufgaben an spezialisierte Subagenten übergeben. Beispielsweise können relativ unabhängige Arbeiten wie Codesuche, Testanalyse oder Materialorganisation an verschiedene Subagenten verteilt und deren Ergebnisse zusammengefasst werden. Auf diese Weise kann die Aufgabenverarbeitungskapazität eines einzelnen Agenten erweitert und der Druck komplexer Aufgaben in einem einzigen Ausführungskontext reduziert werden.
(3) Laufumgebung
Tools beantworten die Frage „Was kann ein Agent tun?"; die Laufumgebung bestimmt, „wo diese Operationen stattfinden".
Für Programmier-Agenten könnte die Laufumgebung ein lokales Projektverzeichnis, ein Container, eine virtuelle Maschine, eine Cloud-Sandbox oder ein eigenständiges Git-Worktree sein. Der Agent muss zum Lesen und Ändern von Dateien, Ausführen von Shell-Befehlen, Installieren von Abhängigkeiten und Ausführen von Tests eine konkrete Laufumgebung nutzen.
Harness muss die Laufumgebung vorbereiten und verwalten, wie Code-Repository-Initialisierung, Abhängigkeitsinstallation, Umgebungsvariablen-Setup, Start notwendiger Dienste und Prüfung, ob die aktuelle Umgebung die Aufgabenausführungsbedingungen erfüllt. Für lang laufende Aufgaben muss auch vermieden werden, dass während der Ausführung Abhängigkeitsmängel, Dienstanomalien oder Ressourcenstatusinkonsistenzen auftreten.
Umgebungsisolierung ist auch ein wichtiger Inhalt der Laufumgebungsverwaltung. Wenn mehrere Agenten oder mehrere Aufgaben gleichzeitig dasselbe Projekt bearbeiten, können direkte Operationen im selben Arbeitsverzeichnis zu Dateiüberschreibungen und Zustandskonflikten führen. Für verschiedene Aufgaben können eigenständige Sandboxes, Container oder Worktrees eingerichtet werden, sodass verschiedene Aufgaben in relativ isolierten Räumen laufen. Selbst wenn eine Aufgabe fehlschlägt, kann der Einfluss auf andere Aufgaben und die Gastumgebung reduziert werden.
Die Laufumgebung übernimmt auch die Kontrolle von Ressourcenzugriffsgrenzen. Beispielsweise kann eingeschränkt werden, dass der Agent nur auf bestimmte Verzeichnisse zugreifen, nur bestimmte Netzwerke verbinden, keine systemkritischen Dateien lesen oder für verschiedene Aufgaben unterschiedliche Zugriffsberechtigungen konfigurieren kann. Tools definieren, welche Fähigkeiten ein Agent verwenden kann; die Laufumgebung schränkt ein, auf welche Dateien, Prozesse, Netzwerke und Systemressourcen diese Fähigkeiten tatsächlich angewendet werden können.
(4) Zustand und Aufgabenkontinuität
Ein einzelner Large-Language-Modell-Aufruf hat von sich aus keinen langfristigen Aufgabenstatus, aber komplexe Agent-Aufgaben können Minuten, Stunden oder sogar mehrere Sitzungen dauern. Wenn Aufgabeninformationen nur im aktuellen Kontext existieren, kann der Agent nach Komprimierung des Kontexts, Unterbrechung des Prozesses oder Neustart der Sitzung möglicherweise nicht genau beurteilen, welche Arbeit bereits abgeschlossen wurde.
Harness muss den Aufgabenstatus pflegen, wie aktuelles Ziel, Aufgabenaufteilungsergebnis, abgeschlossene Schritte, gerade bearbeitete Schritte, geänderte Dateien, wichtige Tool-Ausführungsergebnisse und als Nächstes zu verarbeitende Inhalte.
Diese Zustände können im Speicher gespeichert oder in Aufgabendateien, Datenbanken, Git-History oder anderen externen Speichern abgelegt werden. Für lang laufende Agenten ist die persistente Zustandsspeicherung besonders wichtig. Neue Agenten-Sitzungen können die zuvor gespeicherten Aufgabenfortschritte und Schlüsselergebnisse lesen und von der letzten Unterbrechungsstelle aus fortführen, ohne die gesamte Aufgabe neu analysieren zu müssen.
Zustandsverwaltung durchdringt den gesamten Lebenszyklus der Aufgabe. Zu Beginn der Aufgabe wird ein Anfangszustand eingerichtet, während der Ausführung werden Fortschritte und Schlüsselergebnisse kontinuierlich aufgezeichnet, nach Abschluss der Aufgabe wird der Endzustand gespeichert; wenn die Aufgabe aufgrund von Anomalien, Timeouts oder Systemneustarts unterbrochen wird, kann über Checkpoint-Mechanismen zur vorherigen Ausführungsstelle zurückgekehrt werden. Für komplexe Aufgaben mit Subagenten können Abschlussstatus, Ausführungsergebnisse und Abhängigkeiten zwischen verschiedenen Teilaufgaben aufgezeichnet werden.
Der Schwerpunkt von Zustand und Aufgabenkontinuität besteht darin, einen kontinuierlich aktualisierbaren, persistenten und wiederherstellbaren Aufgabenausführungsprozess aufrechtzuerhalten, sodass der Agent bei lang laufender oder übergreifender Sitzungsausführung weiterhin weiß, wo die Aufgabe steht.
(5) Validierung und Feedback
Wenn ein Agent eine Aktion ausgeführt hat, bedeutet das nicht, dass die Aufgabe korrekt abgeschlossen wurde. Beispielsweise hat der Agent eine Datei erfolgreich geändert, aber der Code kompiliert möglicherweise nicht; ein Analysebericht wurde generiert, aber es fehlen möglicherweise wichtige Daten; ein Geschäftsaufruf war erfolgreich, könnte aber ein ergebnis erbringen, das den Geschäftsregeln nicht entspricht. Daher muss Harness einen Validierungs- und Feedback-Mechanismus aufbauen, der Ausführungsergebnisse prüft und die Prüfergebnisse dem Agenten erneut zur Verfügung stellt.
Die Validierungsmethode hängt von der konkreten Aufgabe ab. Für Softwareentwicklungsaufgaben können Unit-Tests, Lint, Typprüfung, Kompilierung und End-to-End-Tests verwendet werden; für Geschäftsaufgaben können Geschäftsregel-Prüfungen, Ergebnisvergleiche oder unabhängige Bewertungen eingesetzt werden. Der Kern der Validierung besteht darin, eine überprüfbare Grundlage für den Aufgabenabschluss bereitzustellen, anstatt sich nur auf das Urteil des Modells zu verlassen, dass die Aufgabe abgeschlossen sei.
Feedback stellt die Validierungsergebnisse dem Agenten erneut zur Verfügung. Beispielsweise kann Harness nach einem fehlgeschlagenen Test Fehlerinformationen und zugehörige Protokolle an das Modell zurückgeben; der Agent analysiert anhand dieser Informationen weiter die Ursache, ändert den Code und testet erneut, wodurch ein Kreislauf „Ausführung → Validierung → Feedback erhalten → Korrektur → erneute Validierung" entsteht. Solch ein Kreislauf ermöglicht es dem Agenten, anhand tatsächlicher Ausführungsergebnisse frühere Entscheidungen kontinuierlich zu korrigieren, anstatt nach einer einzelnen Operation die Aufgabe direkt zu beenden.
Harness kann in diesem Prozess auch Ausführungskontrollen einfügen. Beispielsweise darf Code nur eingereicht werden, wenn alle Tests bestanden sind; nach mehreren aufeinanderfolgenden Ausführungsfehlern wird die Aufgabe gestoppt oder an manuelle Verarbeitung übergeben; bei Änderungen an Produktionsumgebungen, Datenlöschungen und anderen hochriskanten Operationen wird die Aufgabe vor der tatsächlichen Ausführung angehalten und eine manuelle Genehmigung eingefordert. Nach Bestätigung wird die Ausführung fortgesetzt, ohne Bestätigung wird die Operation beendet oder angepasst.
Diese fünf Teile unterstützen gemeinsam den kontinuierlichen Betrieb des Agenten: Anweisungen und Kontext liefern Aufgabenziele, Regeln und notwendige Informationen; Tools bieten tatsächliche Handlungsfähigkeiten; Laufumgebung beherbergt diese Operationen und begrenzt Ressourcengrenzen; Zustand und Aufgabenkontinuität zeichnen Aufgabenfortschritte auf und unterstützen Wiederherstellung; Validierung und Feedback prüfen Ausführungsergebnisse und treiben den Agenten zur weiteren Korrektur oder zum Abschluss der Aufgabe voran. Durch diese Mechanismen organisiert Harness die einmaligen Modellaufrufe des Agenten zu einem vollständigen Aufgabenausführungsprozess, der kontinuierlich ausgeführt, eingeschränkt und ergebnisgeprüft werden kann.
Beziehung zwischen Harness und Agent
Agent und Harness sind keine zwei sich gegenseitig ersetzenden Konzepte, sondern befinden sich auf verschiedenen Ebenen. Während des Agentenbetriebs ist das Large-Language-Modell hauptsächlich für das Verstehen der Aufgabe, die Analyse aktueller Informationen und die Entscheidung über den nächsten Schritt verantwortlich; Harness stellt dem Agenten Anweisungen und Kontext, Tools, Laufumgebung, Zustandsverwaltung sowie Validierung und Feedback zur Verfügung, sodass die Entscheidungen des Agenten tatsächlich ausgeführt und während des Ausführungsprozesses eingeschränkt und überprüft werden.
Die Beziehung zwischen den beiden ist eine „Entscheidungs- und Ausführungsunterstützung". Der Agent beurteilt anhand der aktuellen Aufgabe und vorhandener Informationen, was als Nächstes getan werden soll; Harness ist verantwortlich für die Bereitstellung der Tools und der Umgebung zur Durchführung dieser Operation und zeichnet während des Ausführungsprozesses entstehende Zustände und Ergebnisse auf. Nach Abschluss der Ausführung kann Harness die Ergebnisse über Tests, Regelprüfungen usw. validieren und das Feedback dem Agenten geben. Der Agent urteilt anhand des neuen Zustands und des Feedbacks über den nächste Schritt, und so weiter, bis die Aufgabenabschlussbedingungen erfüllt sind.
Beispielsweise beurteilt ein Programmier-Agent, dass login.py geändert und Tests ausgeführt werden müssen. Die Analyse des Codes und die Entscheidung, wie geändert werden soll, basieren hauptsächlich auf den Verstehens- und Schlussfolgerungsfähigkeiten des Large-Language-Modells; ob login.py geändert werden darf, woher die Datei gelesen wird, über welches Tool sie geändert wird, in welchem Sandbox der Testbefehl ausgeführt wird, wie der Änderungsfortschritt gespeichert wird, wie das Testergebnis überprüft wird und wie nach einem Fehlschlag fortgefahren wird, erfordert jedoch Harness-Betriebsmechanismen. Nach einem Testfehlschlag werden Fehlerinformationen dem Agenten erneut zur Verfügung gestellt, der anhand dieser Informationen die Ursache analysiert und die nächste Änderungsplannung trifft.
Der Perfektionsgrad von Harness beeinflusst die Aufgabentypen, die ein Agent bearbeiten kann. Ein einfaches Harness bietet möglicherweise nur wenige Tools und einen grundlegenden Aufrufmechanismus und eignet sich für Aufgaben mit wenigen Schritten; ein umfassenderes Harness kann weiterhin Kontextverwaltung, Umgebungsisolierung, persistente Aufgabenstatus, Berechtigungskontrolle, automatische Validierung, Wiederherstellung bei Fehlern und manuelle Genehmigungsmechanismen bieten, sodass der Agent längere und komplexere Aufgaben kontinuierlich ausführen kann. Selbst bei Verwendung desselben Large-Language-Modells können die unterschiedlichen Betriebsbedingungen, die verschiedene Harness bieten, zu erheblichen Unterschieden in der Aufgabenverarbeitungsfähigkeit und Stabilität des Agenten bei komplexen Aufgaben führen.
Zwischen Harness und Agent-Frameworks gibt es gewisse Überschneidungen; beide betreffen Tool-Aufrufe, Kontextverwaltung, Zustandsverwaltung und Aufgabenausführungskontrolle, aber die Schwerpunkte unterscheiden sich. Agent-Frameworks konzentrieren sich stärker auf Entwicklungsfähigkeiten für Agent-Erstellung und Aufgabenorganisation wie Agent-Definition, Tool-Aufrufe, Zustandsverwaltung, Workflow-Orchestrierung und Multi-Agent-Zusammenarbeit; Harness konzentriert sich stärker auf Unterstützung und Kontrollmechanismen rund um den Agentenbetrieb, wie Kontextorganisation, Tool- und Laufumgebungsbereitstellung, Aufgabenkontinuität und Validierung von Ausführungsergebnissen. Mit der kontinuierlichen Entwicklung von Agent-Frameworks und Agent-SDKs werden einige Harness-Fähigkeiten zunehmend in Frameworks oder SDKs integriert, sodass es in der konkreten Implementierung keine absoluten Funktionsgrenzen zwischen beiden gibt.
Insgesamt lässt sich die Beziehung zwischen den drei wie folgt zusammenfassen: Large-Language-Modelle liefern Intelligenz, Agenten organisieren Entscheidungen, Harness gewährleistet Ausführung.
Mit zunehmender Komplexität der von Agenten ausgeführten Aufgaben wird die Rolle von Harness deutlicher.
DeepSeek Harness
Im Folgenden wird am Beispiel von DeepSeek Harness erläutert, wie Harness in tatsächlichen Agent-Systemen organisiert ist.
DeepSeek Harness ist ein von DeepSeek im Jahr 2026 veröffentlichtes Open-Source-Agent-Harness, dessen Besonderheit darin besteht, die für den Modellbetrieb benötigten Tools, Skills, Sitzungen, Sandboxes und Aufgabenausführungsfähigkeiten über eine plugin-basierte Architektur zu organisieren und Agenten erweiterbare Laufunterstützung zu bieten.
DeepSeek versteht einen lauffähigen Agenten als:
Agent = Model + Harness
Wobei Model für das Verstehen der Aufgaben und die Entscheidungsfindung verantwortlich ist und Harness die Tools, den Kontext und die Laufumgebung organisiert, die das Modell zur Aufgabenerledigung benötigt.
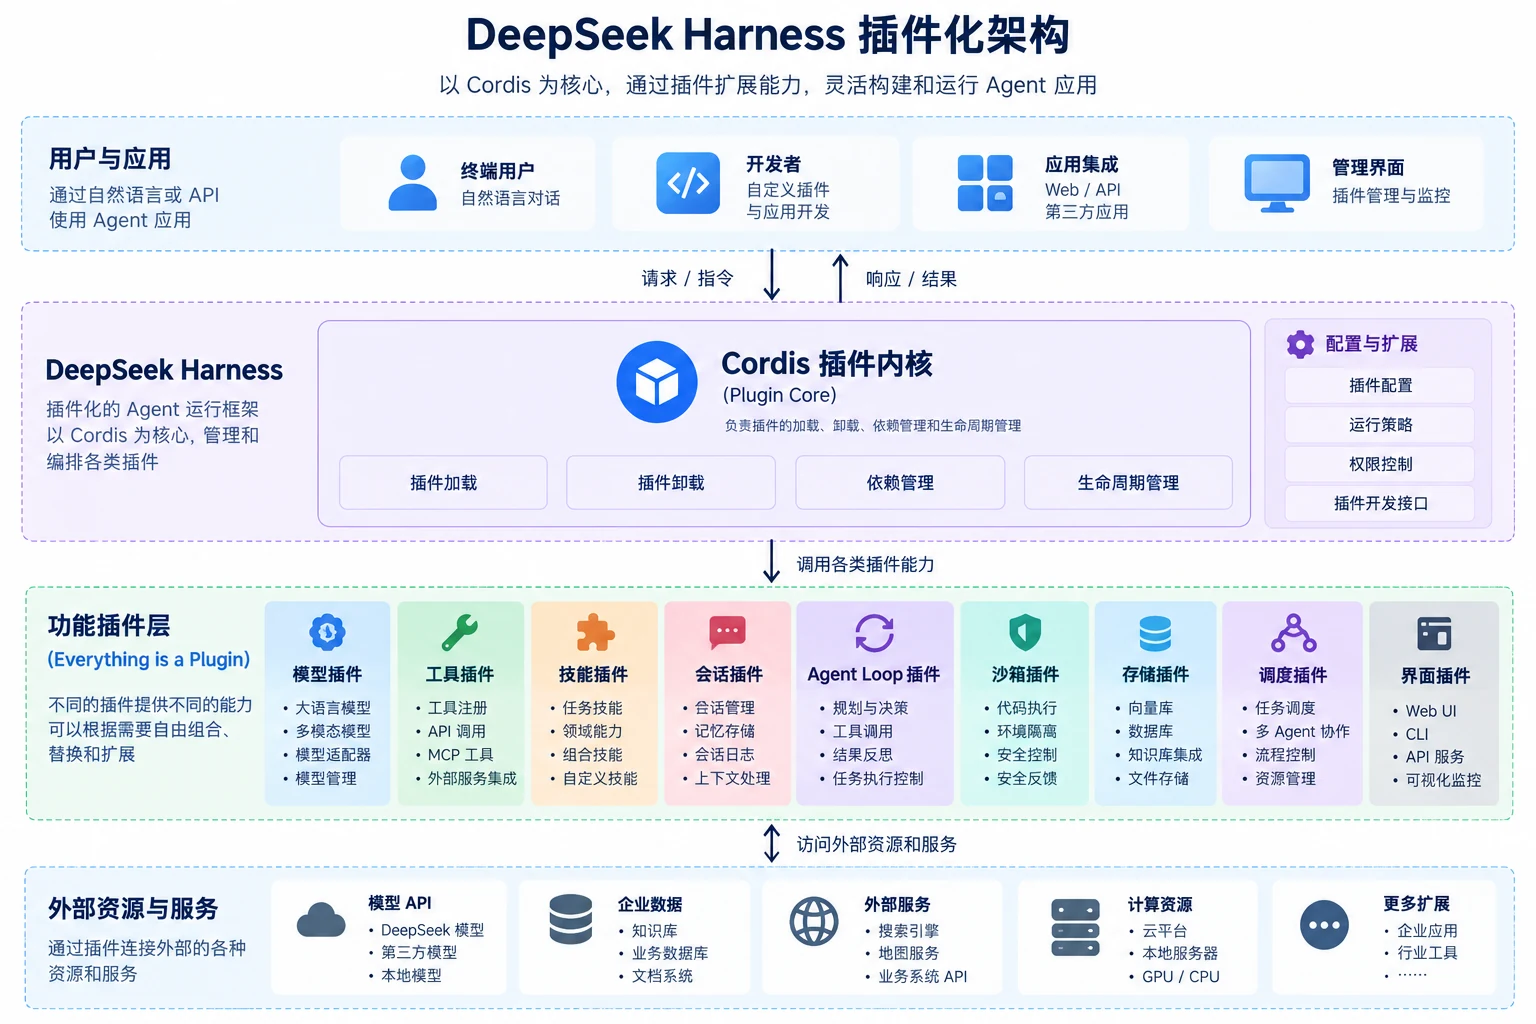
Das Kerndesign von DeepSeek Harness ist „Everything is a Plugin" (Alles ist ein Plugin). Fähigkeiten wie Modelle, Tools, Skills, Sitzungen, Sandboxes, Speicher, Ausführungsschleifen, Aufgabenplanung und Sub-Agenten können alle über Plugins bereitgestellt und vom zugrunde liegenden Cordis-Plugin-System organisiert werden. Cordis ist verantwortlich für das Laden, Entladen, Abhängigkeitsmanagement und Lebenszyklusmanagement von Plugins, während die spezifischen Agent-Fähigkeiten von verschiedenen Plugins bereitgestellt werden. Entwickler können je nach tatsächlichem Bedarf verschiedene Plugins kombinieren, ersetzen oder erweitern.
Die Gesamtplugin-Architektur ist nachfolgend dargestellt.
Beispielsweise kann mit DeepSeek Harness ein Datenanalyse-Agent erstellt werden. Der Agent liest vom Benutzer bereitgestellte Datendateien, ruft basierend auf der Aufgabe die entsprechenden Tools zur Datenverarbeitung und -analyse auf und kann auch Skills für bestimmte Datenanalyseaufgaben verwenden. Wenn die Aufgabe komplex ist, kann ein Teil der Arbeit an Sub-Agenten übergeben werden. Das Modell ist verantwortlich für die Bestimmung des nächsten Schritts, während Harness die Fähigkeiten bereitstellt und organisiert, die zur Durchführung dieser Operationen benötigt werden.
Neben dem plugin-basierten Design bietet DeepSeek Harness auch Mechanismen wie Sitzungs- und Betriebsprozessaufzeichnung. System-Prompts, Tool-Aufrufe und deren Ergebnisse, Sub-Agenten-Planung und Kontextinjektion, die das Modell sieht, können in Sitzungsprotokollen aufgezeichnet und über Trajectory eingesehen werden. Auf Basis dieser Aufzeichnungen können Aufgaben wiederhergestellt, verzweigt, abgerufen und abgespielt werden, was Entwicklern die Beobachtung und Debugging des Agent-Ausführungsprozesses erleichtert.
Derzeit befindet sich DeepSeek Harness noch in der Developer Preview-Phase, und seine Kernplugins und APIs werden kontinuierlich weiterentwickelt. Daher eignet es sich eher als repräsentatives Beispiel zum Verständnis der plugin-basierten Design- und Engineering-Implementierung von Harness, als die aktuellen Schnittstellen als bereits festgelegte Entwicklungsstandards zu betrachten.