Data: The Foundation of Fine-Tuning
Datos: La Base del Fine-Tuning de Modelos Open Source
¿Has encontrado alguna vez un modelo que escribe código y resuelve matemáticas perfectamente, pero responde al azar a preguntas cotidianas?
Sabemos que para mejorar una capacidad específica durante el entrenamiento, hay que encontrar ese tipo de datos,
Pero muchos conjuntos de datos son difíciles de encontrar por búsqueda directa. Un portal unificado ahorra un esfuerzo enorme.
Por ejemplo, nuestro conjunto de datos destilado DeepSeek-R1 en chino obtuvo gran parte de sus datos directamente de ModelScope,
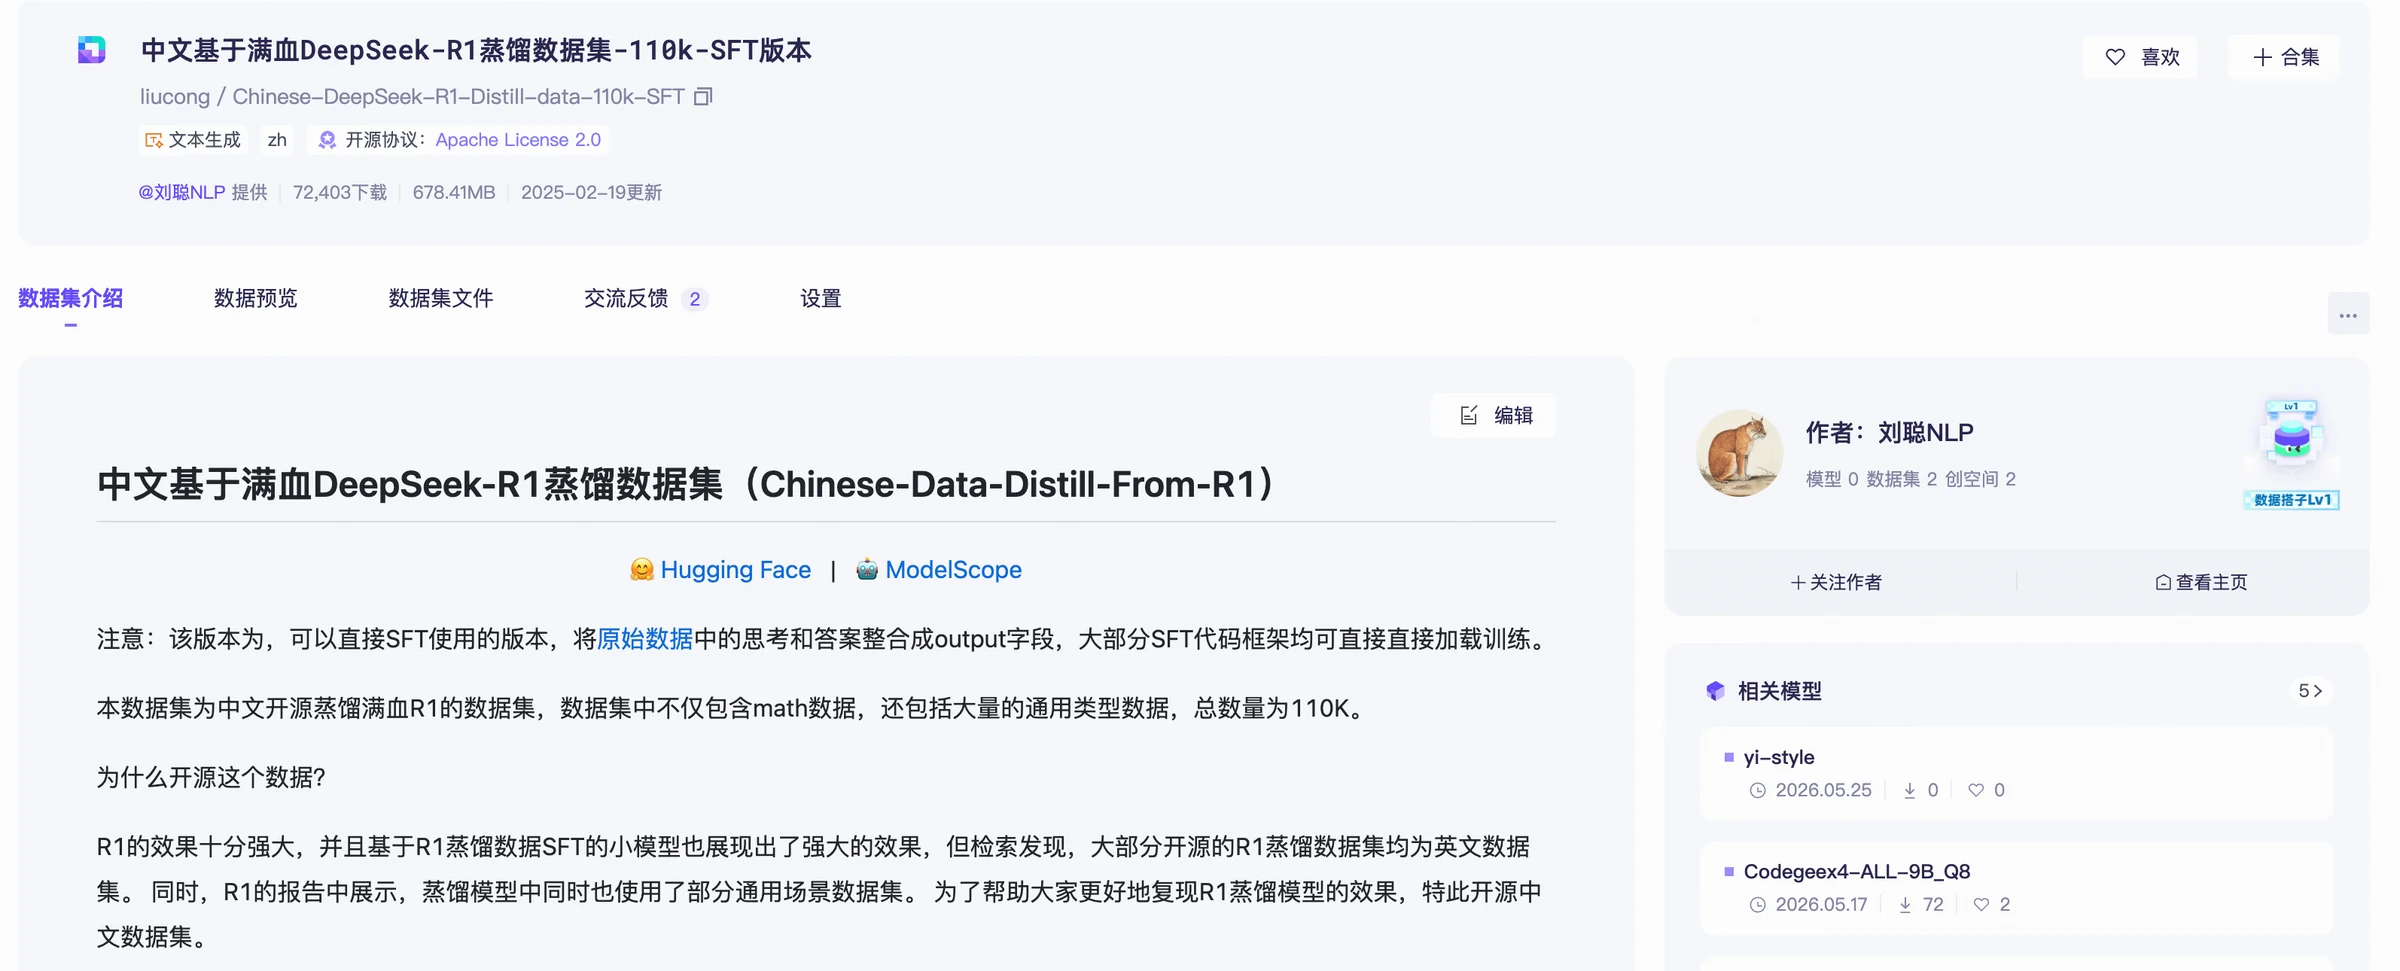
El fine-tuning de un modelo puede comenzar con un conjunto de datos open source existente, permitiendo ejecutar rápidamente todo el proceso.
Encontrar Datos Requiere Saber Qué Planeas Hacer
ModelScope tiene más de 40,000 conjuntos de datos open source, con búsqueda, vista previa, descripciones de campos y versiones.
ModelScope permite buscar por etiquetas y categorías de tareas, como clasificación binaria de texto en chino,
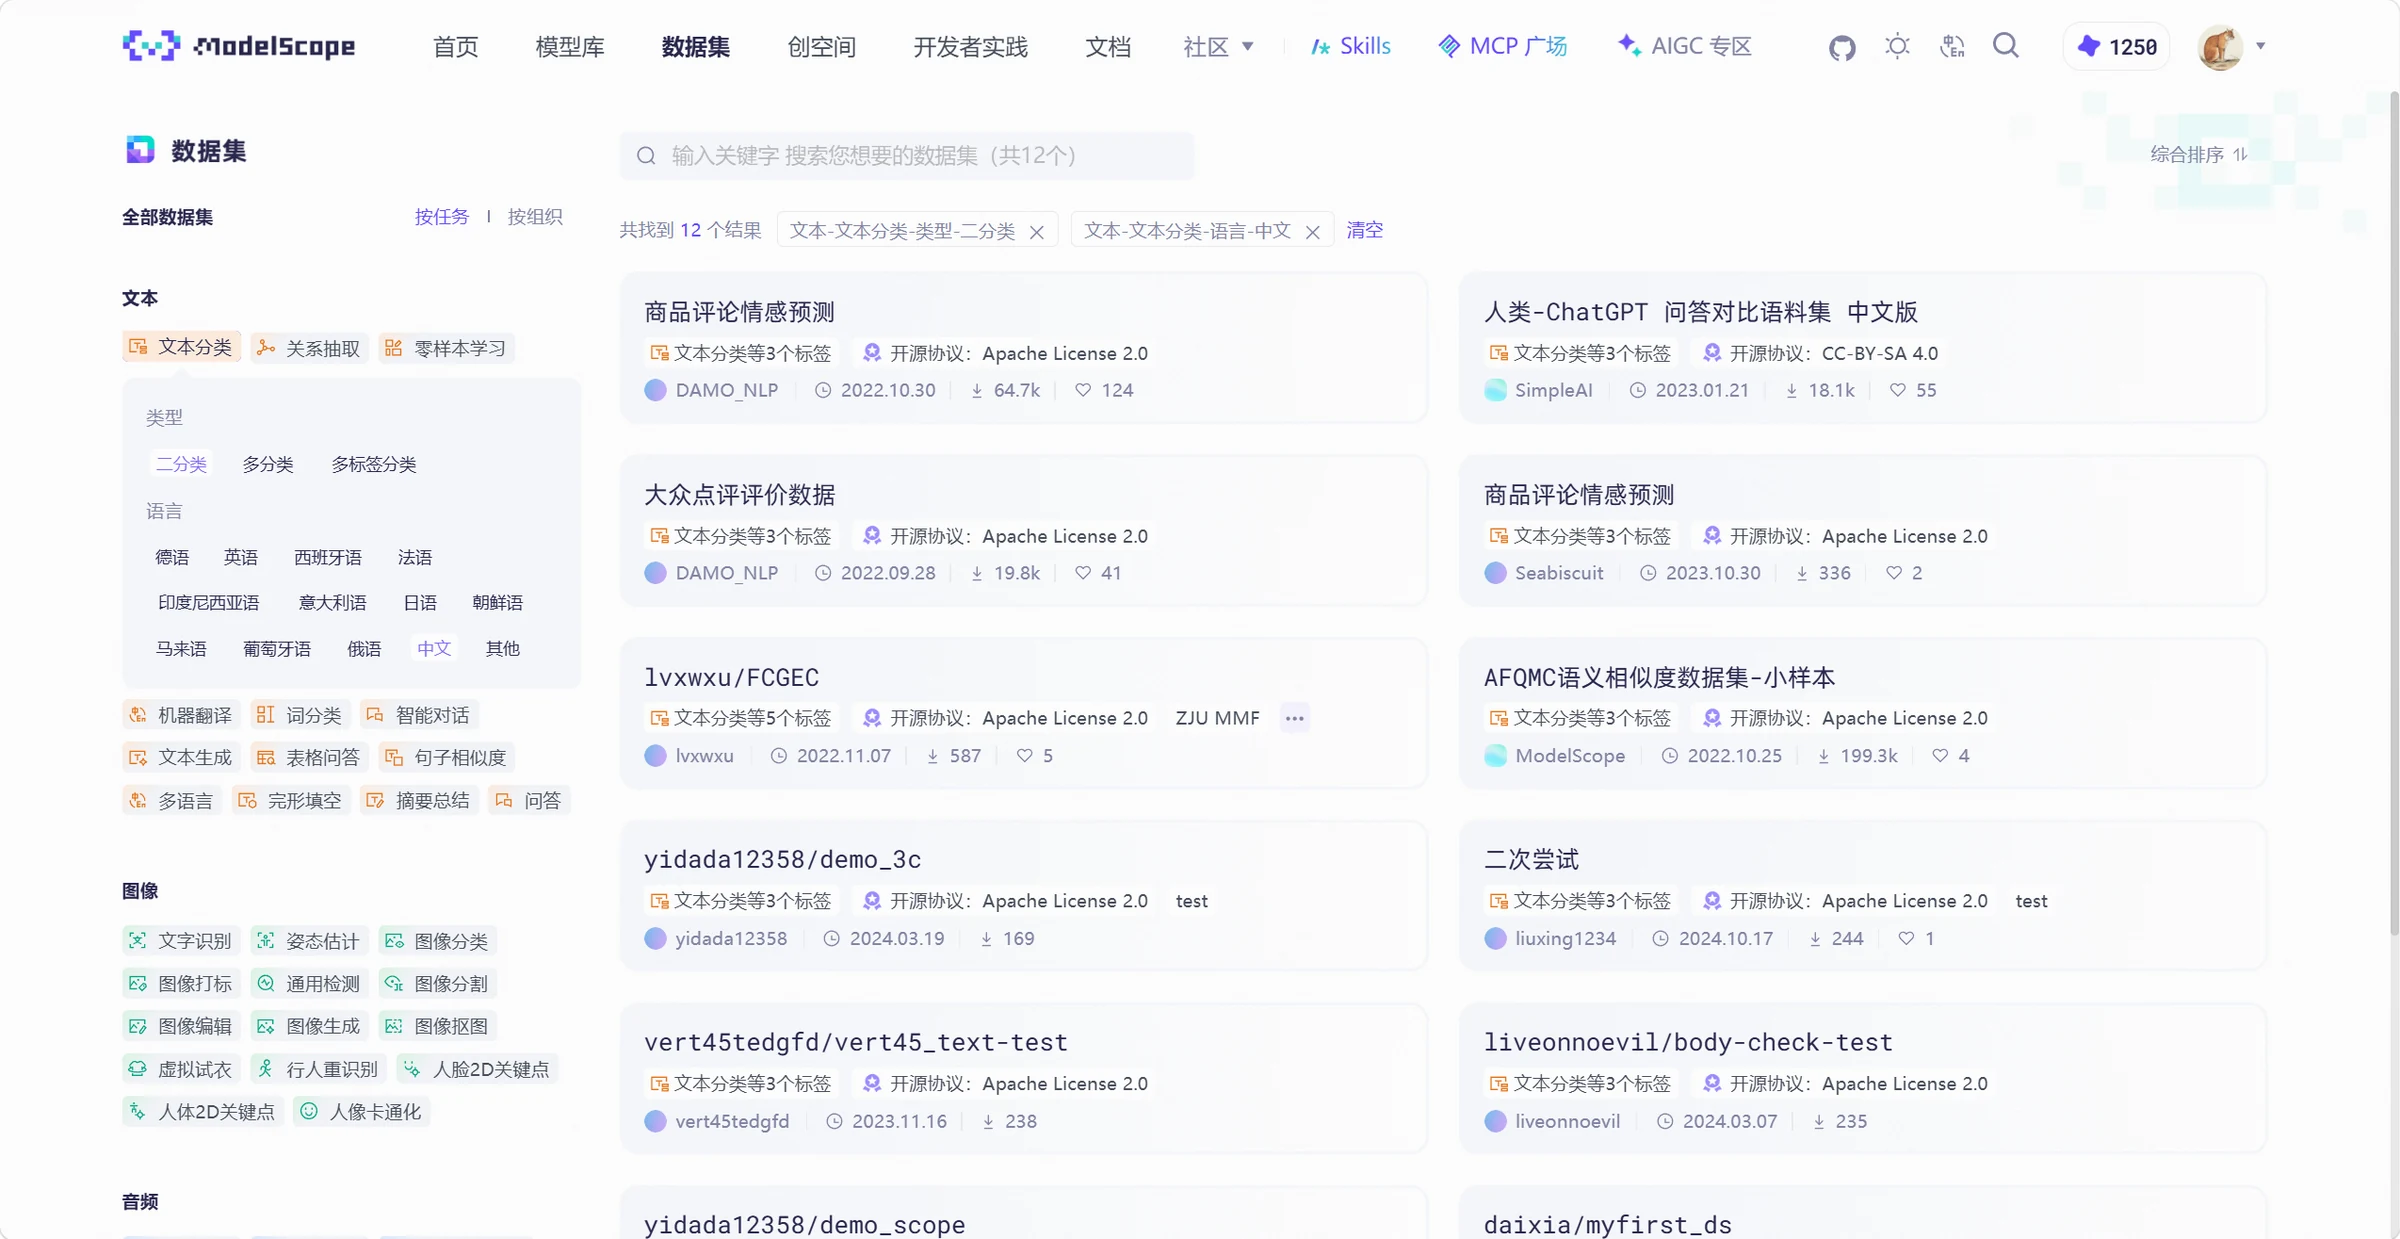
Antes de Descargar, Revisa Algunas Muestras
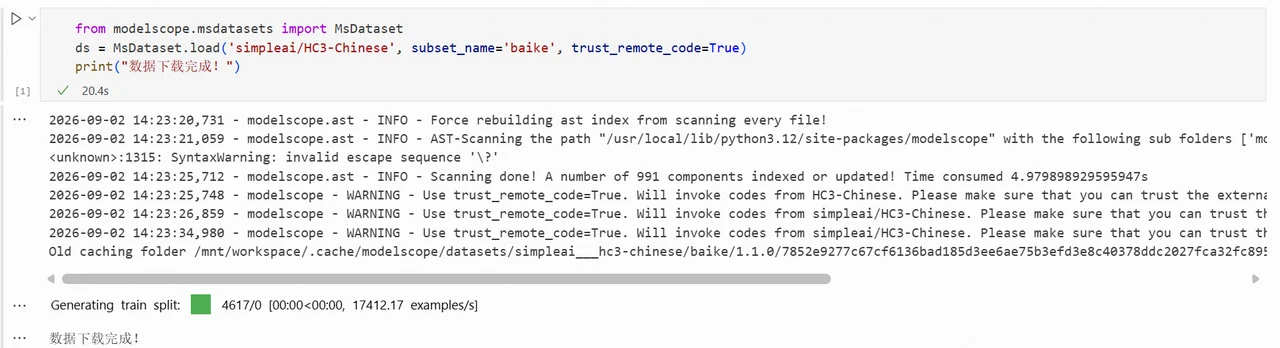
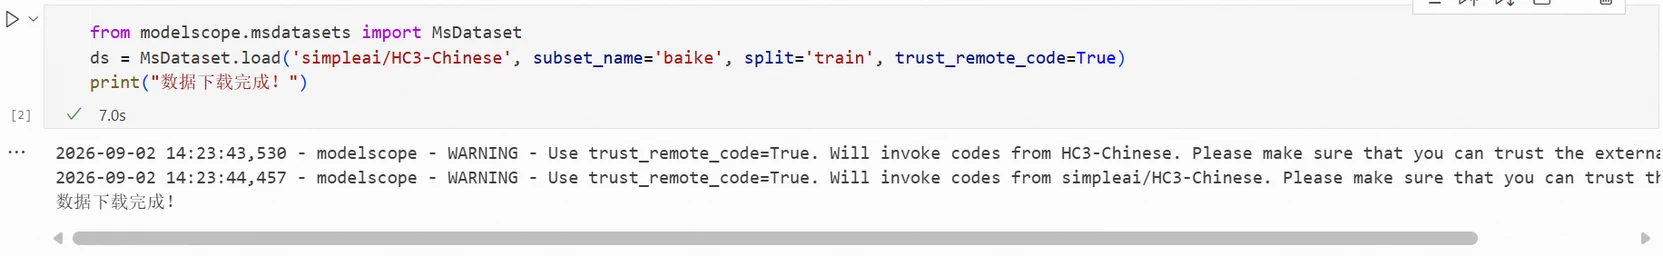
Después de filtrar, selecciona un conjunto de datos y haz clic en 'Vista Previa' para ver muestras y descripciones, como simpleai/HC3-Chinese.
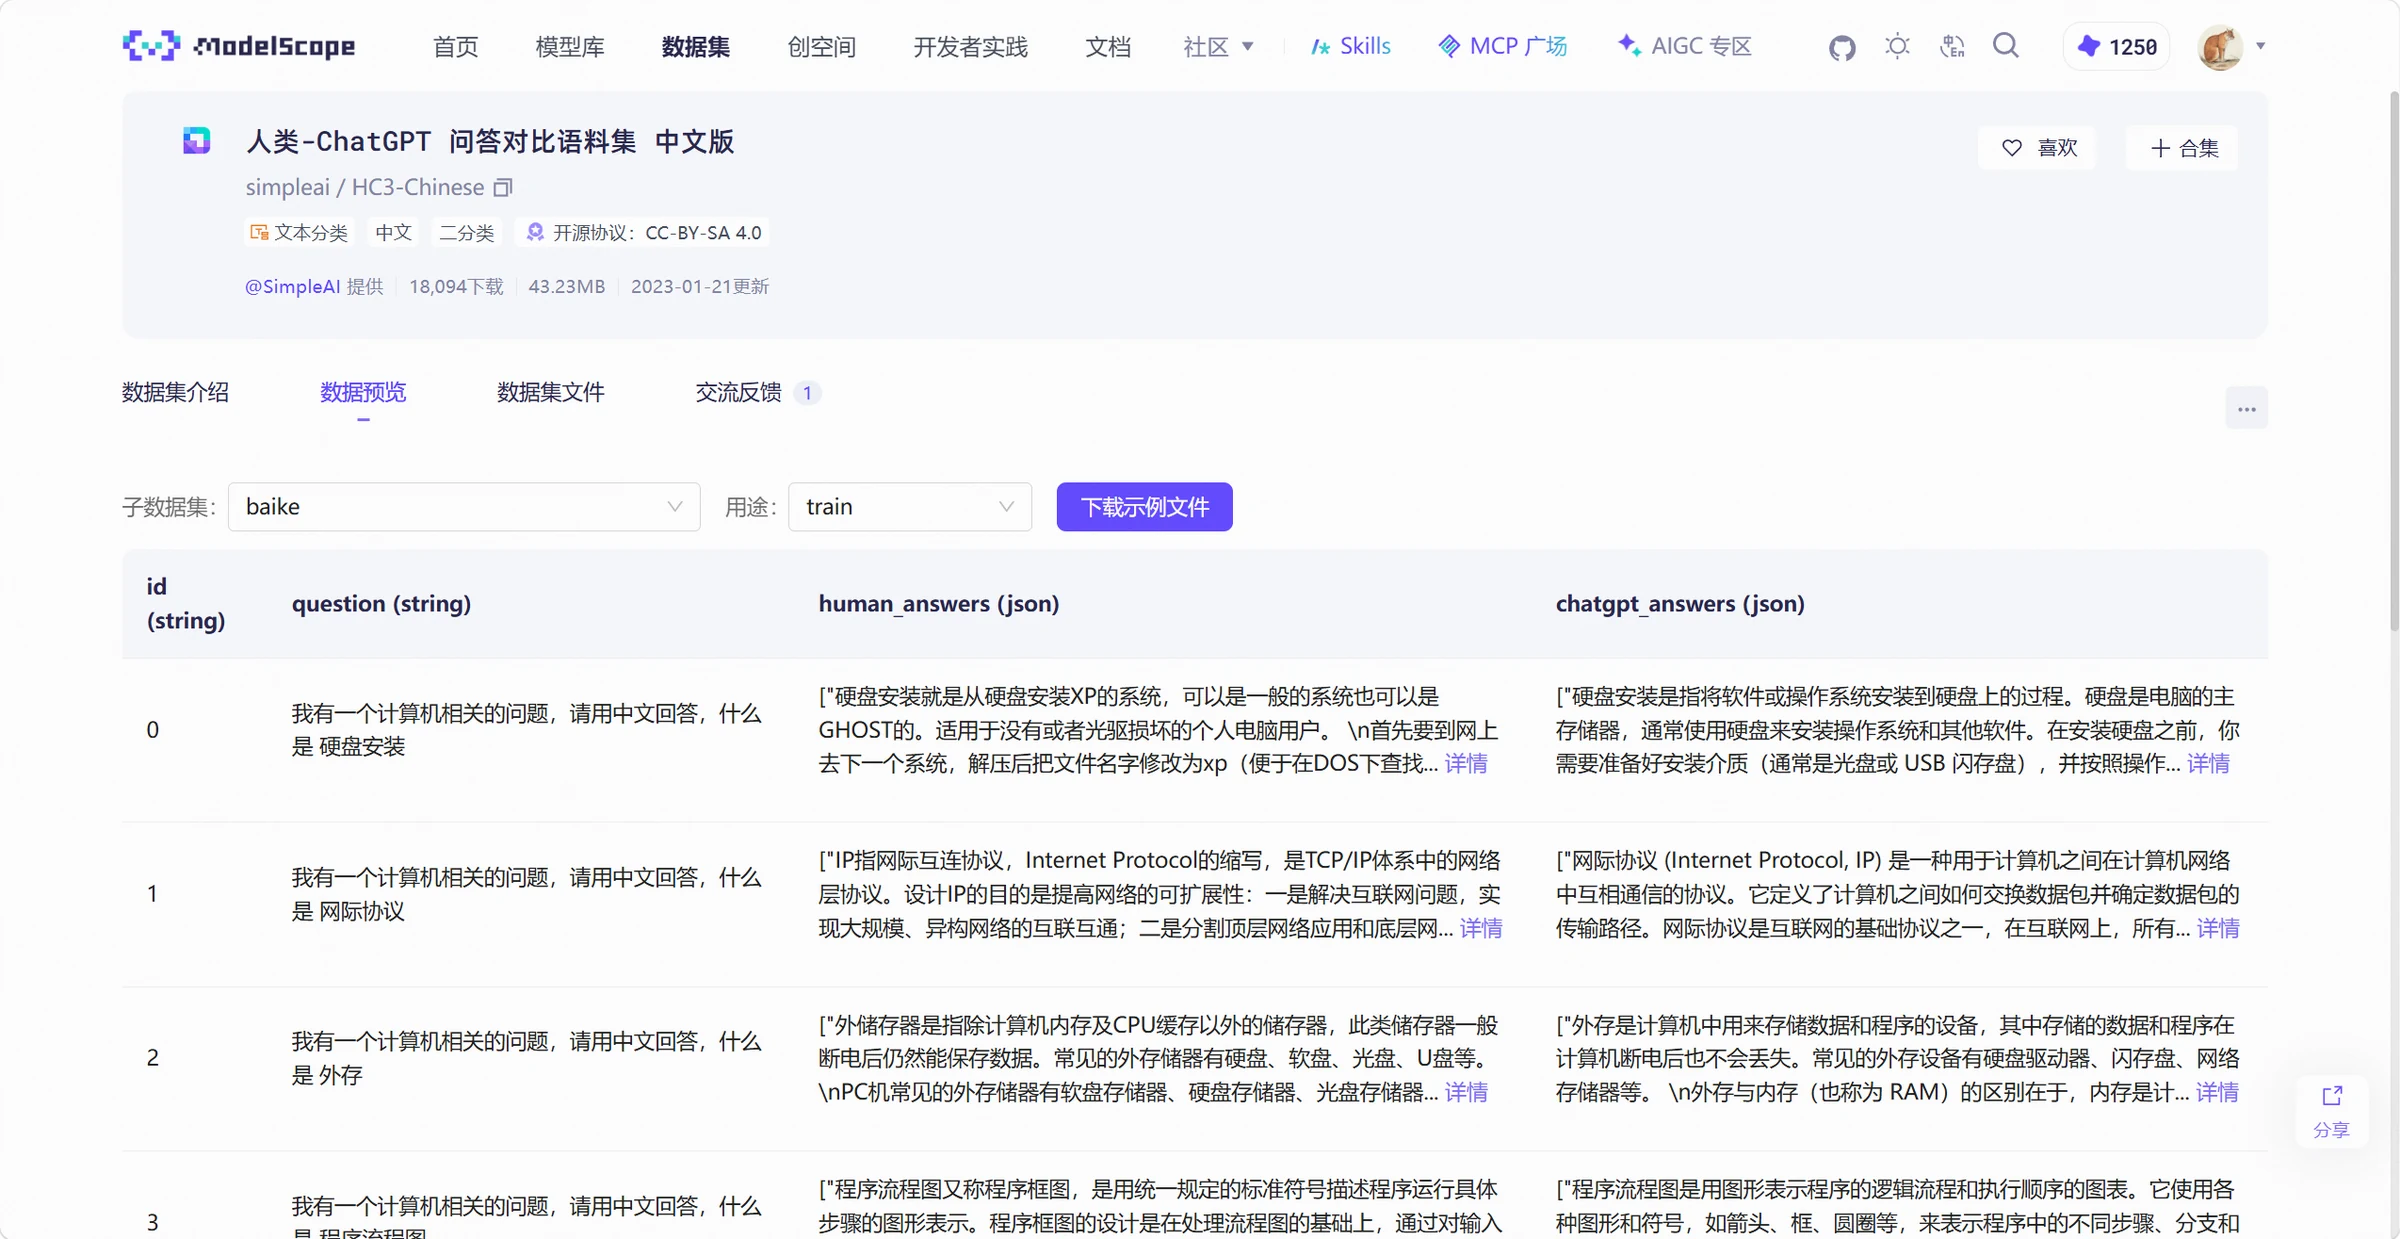
Qué columna contiene la pregunta, la respuesta, las etiquetas, y si cada registro es texto o diálogo — todo esto puede verificarse de antemano.
Para datos QA, las respuestas humanas y del modelo pueden estar en campos diferentes. Decide qué campos leer y cómo organizar antes de entrenar.
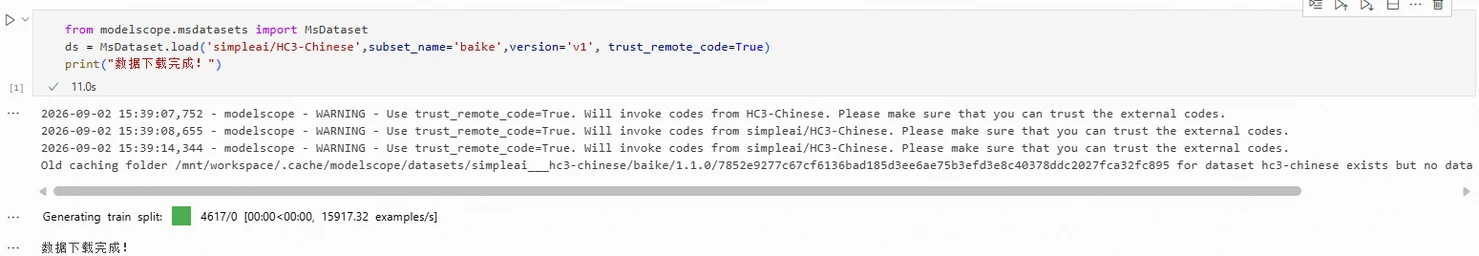
Revisa los archivos y versiones. Los conjuntos se actualizan; anota la versión usada para reproducibilidad.
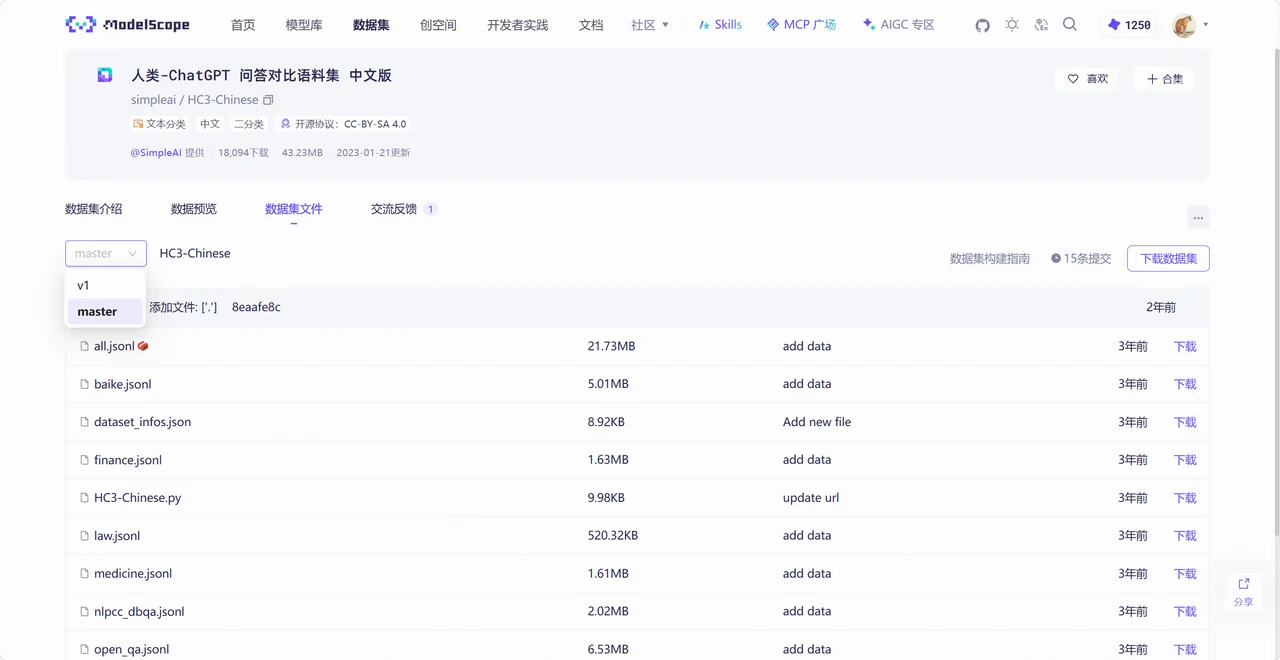
Las descripciones y licencias merecen ser revisadas. Los datos descargados pueden tener requisitos diferentes para investigación, entrenamiento o uso comercial.
Carga los Datos Primero, Luego Decide Qué Usar
ModelScope proporciona la interfaz MsDataset.load para cargar conjuntos de datos en Python. Después de instalar, sigue las instrucciones de la página.
Carga un Conjunto Completo Primero
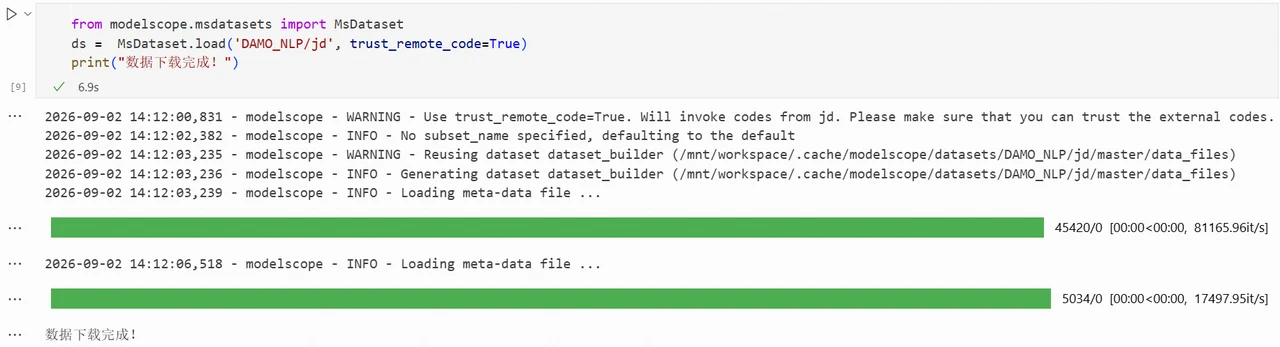
Usando DAMO_NLP/jd como ejemplo, así se lee la configuración por defecto,
from modelscope.msdatasets import MsDataset

ds = MsDataset.load(
    'DAMO_NLP/jd',
    trust_remote_code=True,
)
print(ds)
Discusión
Iniciar sesión unirse a la discusión