Fine-tuning y evaluación • Principiante⏱️ 25 min de lectura
Fine-Tuning with ms-swift
Uso rápido de ms-swift para fine-tuning de modelos de código abierto
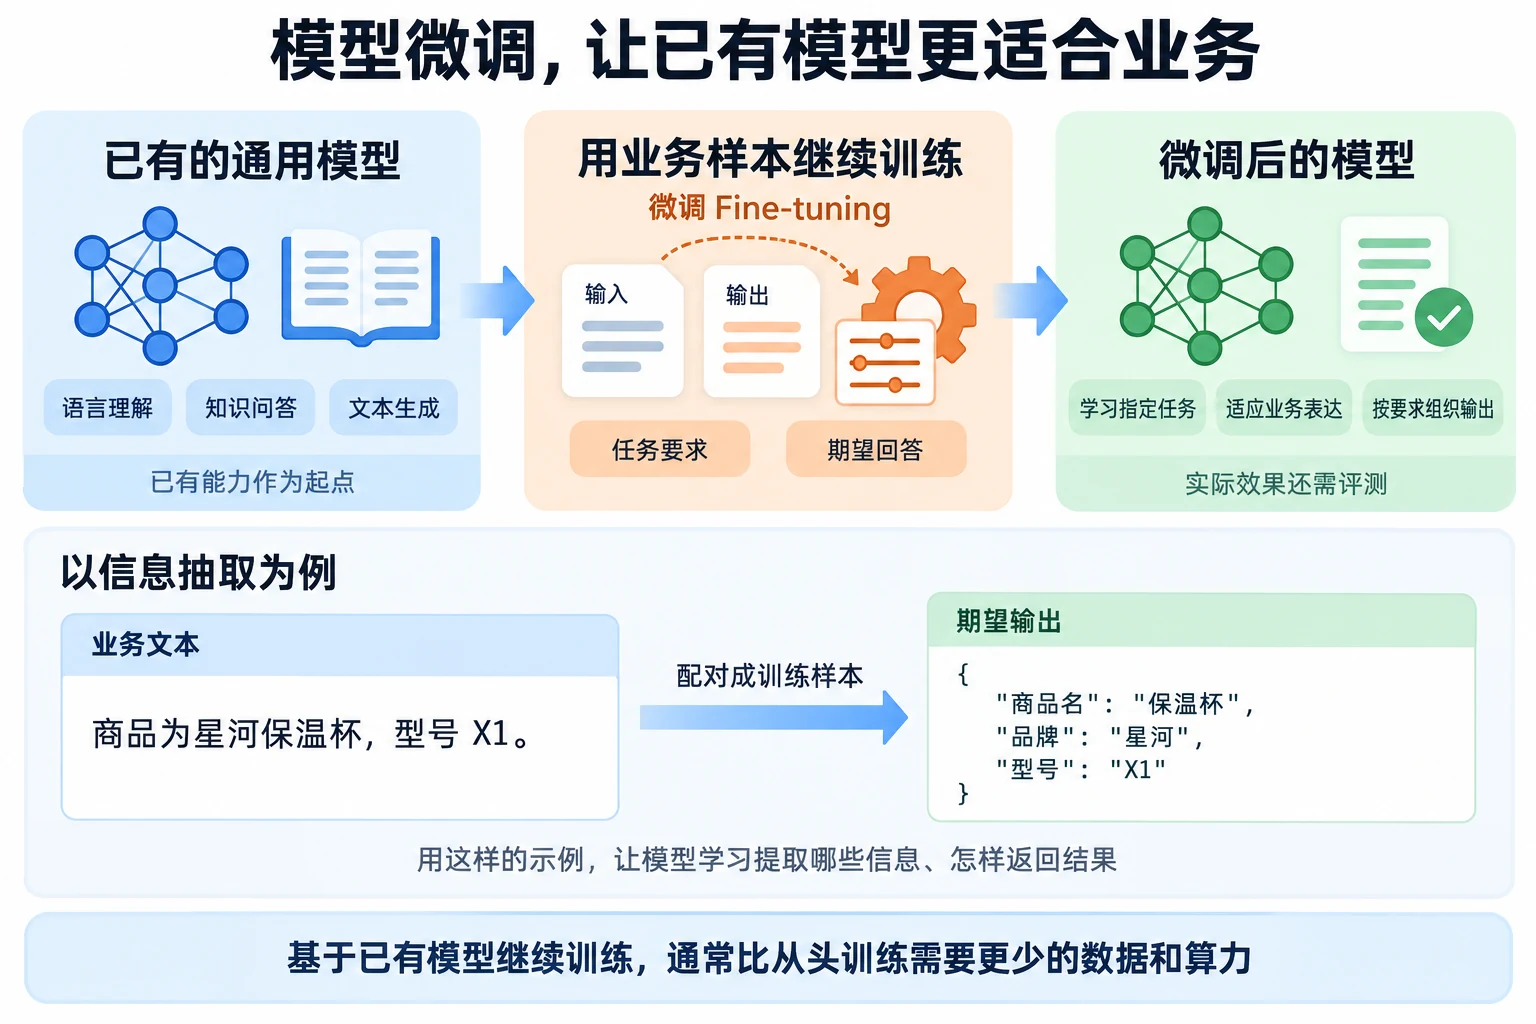
Cuando un modelo general no puede satisfacer directamente necesidades empresariales específicas, puedes usar tus propios datos empresariales para realizar fine-tuning del modelo, permitiéndole aprender más sobre tareas y métodos de salida específicos.
Tomemos el ejemplo del reconocimiento de entidades en comercio electrónico. Necesitamos que el modelo identifique nombres de productos, marcas y modelos en el texto, proporcionando la categoría y ubicación correspondientes. El modelo puede ser muy conocedor sobre estos productos, pero en el uso real, la información extraída no debe estar incompleta, los campos deben estandarizarse y el formato de salida debe ser estable.
Si la tarea y los requisitos de salida ya están claros y tienes ejemplos organizados, puedes intentar usar estos datos para fine-tuning, permitiendo al modelo aprender el trabajo que queremos que realice. En cuanto a si actualizar todos los parámetros y si las GPU disponibles son suficientes, debes elegir según la tarea y los recursos.
A continuación, usamos ms-swift para recorrer un proceso de fine-tuning LoRA, cubriendo preparación de datos, entrenamiento, fusión de pesos e inferencia.
¿Qué cambia realmente el fine-tuning en el modelo?
Los grandes modelos generales ya poseen sólidas capacidades de comprensión del lenguaje, preguntas y respuestas, generación de texto y otras tareas generales. Sin embargo, en escenarios empresariales reales, el rendimiento de los modelos generales puede no satisfacer directamente requisitos específicos.
Por ejemplo, queremos que el modelo complete con precisión ciertas tareas de extracción de información, produzca resultados en un formato especificado o responda preguntas específicas de manera unificada. Para estas necesidades, podemos usar datos específicos para entrenar sobre la base de un modelo existente, permitiendo al modelo aprender más sobre los requisitos de tareas y métodos de respuesta correspondientes. Este proceso se llama fine-tuning de modelo.
El fine-tuning no es reentrenar un modelo desde cero, sino un ajuste adicional sobre la base de sus capacidades existentes para hacerlo más adecuado para escenarios de aplicación específicos. Comparado con entrenar un grande modelo desde cero, el fine-tuning generalmente requiere menos datos y recursos de computación.
Actualmente, el método más común en el fine-tuning de grandes modelos es el SFT (Supervised Fine-Tuning). El SFT usa datos con respuestas estándar para entrenar el modelo. Cada dato de entrenamiento generalmente contiene una entrada y su salida correspondiente, permitiendo al modelo aprender qué tipo de resultados generar dada una entrada. Por ejemplo, en tareas de extracción de información, puedes usar un segmento de texto como entrada y los resultados correctos de extracción de campos como salida. El SFT es adecuado para tareas donde se pueden preparar muestras de entrenamiento claras, como clasificación de texto, extracción de información, preguntas y respuestas y generación de formato fijo.
Además del SFT, el entrenamiento de grandes modelos también puede usar Aprendizaje por Refuerzo (Reinforcement Learning, RL). A diferencia del SFT que proporciona directamente respuestas estándar, el aprendizaje por refuerzo usa principalmente señales de recompensa para evaluar la calidad de los resultados generados por el modelo y ajusta continuamente el comportamiento de salida del modelo según los resultados de recompensa. Tanto el SFT como el aprendizaje por refuerzo pertenecen a la fase de post-entrenamiento de los grandes modelos. El post-entrenamiento se refiere a una serie de entrenamientos realizados después de que el modelo completa el pre-entrenamiento a gran escala, destinados a mejorar aún más el seguimiento de instrucciones, razonamiento y capacidades de tareas específicas. El entrenamiento de grandes modelos generalmente primero usa el SFT para aprender cómo completar tareas según las instrucciones, luego combina el aprendizaje por refuerzo y otros métodos para optimizar aún más la calidad de respuestas y el rendimiento conductual del modelo.
Parámetros completos, LoRA y QLoRA: ¿cuál es la diferencia?
Según el método de entrenamiento y los recursos de hardware, puedes elegir entre LoRA, QLoRA o fine-tuning de parámetros completos. Los diferentes métodos presentan ciertas diferencias en el número de parámetros de entrenamiento, uso de memoria GPU y costos de cómputo.
Fine-Tuning de Parámetros Completos: Durante el entrenamiento, todos los parámetros del modelo se actualizan, permitiendo al modelo realizar ajustes más completos. El fine-tuning de parámetros completos requiere significativamente más memoria GPU y recursos de cómputo, resultando en costos de entrenamiento más altos.
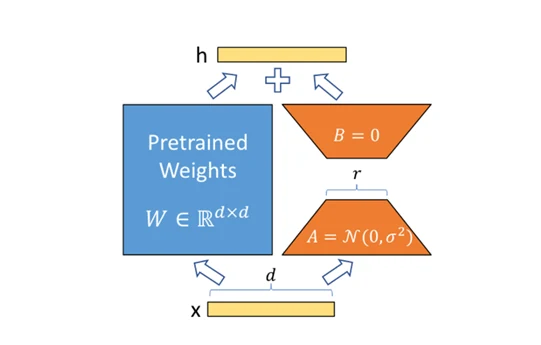
Fine-Tuning LoRA (Low-Rank Adaptation): Para reducir los requisitos de recursos de hardware para el fine-tuning de grandes modelos, la idea central de LoRA es congelar los pesos del modelo pre-entrenado e inyectar matrices de descomposición de rango entrenables en cada capa de la arquitectura Transformer, reduciendo así significativamente el número de parámetros entrenables para tareas aguas abajo (downstream). Durante el entrenamiento, solo se necesitan congelar los parámetros del modelo original, y las matrices de reducción A y aumento B se entrenan. Un diagrama esquemático de LoRA se muestra a continuación.
Específicamente, asumiendo que la matriz pre-entrenada es $W_0 \in \mathbb{R}^{d \times k}$, su actualización puede expresarse como:
W = W_0 + \Delta W = W_0 + BA
Donde $\Delta W$ representa los cambios de peso que se deben aprender durante el fine-tuning:
B \in \mathbb{R}^{d \times r}, \quad
A \in \mathbb{R}^{r \times k}, \quad
r \ll \min(d,k)
A y B son nuevos parámetros añadidos por LoRA que participan en el entrenamiento. Después del entrenamiento del modelo, obtienes un archivo LoRA Adapter separado que guarda los parámetros de este fine-tuning. Al usarlo, necesitas cargar tanto el modelo base como el Adapter correspondiente.
Fine-Tuning QLoRA (Quantized LoRA): LoRA reduce principalmente la sobrecarga de recursos de los parámetros de entrenamiento, pero el modelo base en sí aún necesita cargarse en la memoria GPU. Si el modelo es grande, cargar el modelo base aún puede consumir mucha memoria GPU. Para reducir aún más los requisitos de memoria GPU, puedes usar el fine-tuning QLa.
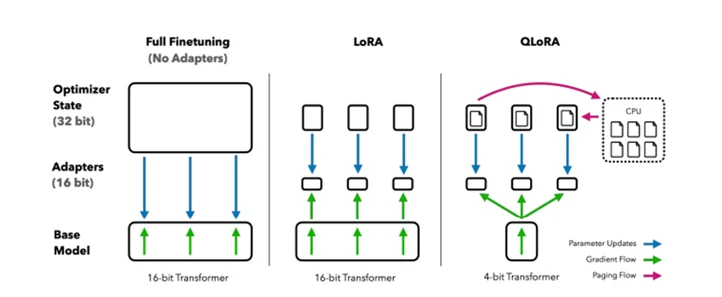
La arquitectura del modelo relacionado se muestra a continuación. Como se puede ver, QLoRA es una mejora de LoRA, y la mejora principal es usar precisión de 4 bits y optimización paginada juntas para reducir el consumo de memoria GPU.
QLoRA puede entenderse simplemente como una combinación de cuantización y LoRA. Cuantiza el modelo base a menor precisión. Las principales innovaciones de QLoRA incluyen:
NormalFloat de 4 bits (NF4): NF4 es un nuevo tipo de datos que es óptimo teóricamente para pesos distribuidos normalmente;
Cuantización Doble: La cuantización doble reduce el uso promedio de memoria por re-cuantizar constantes ya cuantificadas;
Optimizadores Paginados: Los optimizadores paginados ayudan a gestionar picos de memoria y prevenir errores de memoria insuficiente durante el checkpointing de gradiente.
Cómo elegir un método de fine-tuning: empieza por la tarea y la GPU
La elección del método de fine-tuning requiere principalmente considerar la escala del modelo, los requisitos de la tarea, los recursos GPU y los costos de entrenamiento. Los diferentes métodos tienen sus propios escenarios aplicables — no es necesariamente cierto que actualizar más parámetros del modelo lleve a mejores resultados de fine-tuning. Para la mayoría de las tareas de fine-tuning, puedes intentar LoRA primero. LoRA solo requiere entrenar un pequeño número de nuevos parámetros, tiene requisitos relativamente bajos de memoria GPU y recursos de cómputo, y los archivos Adapter resultantes también son relativamente pequeños, facilitando su guardado.
Si el modelo base es grande, incluso usando LoRA puede no quedar suficiente memoria GPU para el entrenamiento después de cargar el modelo. En este caso, puedes considerar QLoRA. QLoRA reduce el uso de memoria GPU del modelo base mediante la cuantización, permitiendo que modelos más grandes se fine-tuneen con recursos GPU limitados. QLoRA es más adecuado para escenarios con grandes escalas de modelos y recursos GPU limitados.
Si los recursos GPU son relativamente suficientes y la tarea requiere ajustes más completos del modelo, puedes considerar el fine-tuning de parámetros completos. Dado que todos los parámetros del modelo deben actualizarse durante el entrenamiento, el fine-tuning de parámetros completos tiene requisitos más altos de memoria GPU, recursos de cómputo y datos de entrenamiento, y el costo de entrenamiento y guardado de modelos también es mayor. Debes determinar si es necesario según la tarea real.
En proyectos reales, podemos primero verificar el efecto a un costo más bajo, luego elegir si aumentar los costos de entrenamiento según las necesidades reales. Si LoRA ya puede alcanzar los resultados esperados, generalmente no es necesario elegir el fine-tuning de parámetros completos solo para actualizar más parámetros.
Usar ms-swift para completar un fine-tuning
¿Qué trabajo puede ms-swift ahorrarnos?
ms-swift (SWIFT, Scalable lightWeight Infrastructure for Fine-Tuning) es un framework de entrenamiento y despliegue de modelos grandes de código abierto de la comunidad ModelScope. Se dirige principalmente a grandes modelos de lenguaje y grandes modelos multimodales, proporcionando un conjunto completo de herramientas desde entrenamiento y fine-tuning de modelos hasta inferencia, evaluación y despliegue.
Actualmente, soporta grandes modelos de lenguaje como Qwen, DeepSeek, Llama, GLM e InternLM, así como modelos multimodales como Qwen-VL e InternVL. También soporta entrenamiento para tareas como Embedding, Reranker y clasificación de texto.
Además del entrenamiento, ms-swift también proporciona un flujo de trabajo de uso de modelo relativamente completo. Después del entrenamiento, puedes usar directamente swift infer para inferencia del modelo, o desplegar el modelo como servicio API compatible con OpenAI a través de swift deploy. Para inferencia y despliegue, también puedes combinar motores de inferencia como vLLM, SGLang y LMDeploy para aceleración.
Para principiantes, una de las características de ms-swift es que encapsula muchas configuraciones complejas del proceso de entrenamiento de grandes modelos. Puedes completar un fine-tuning de modelo especificando el modelo base, datos de entrenamiento, método de fine-tuning y parámetros de entrenamiento a través de argumentos de línea de comandos. En el siguiente experimento, usaremos ms-swift para completar un flujo de trabajo completo de fine-tuning de modelo, incluyendo preparación de datos de entrenamiento, inicio de entrenamiento LoRA, visualización de resultados de entrenamiento, fusión de pesos LoRA y carga del modelo fine-tuneado para inferencia y despliegue.
Entrenamiento práctico con una tarea de reconocimiento de entidades
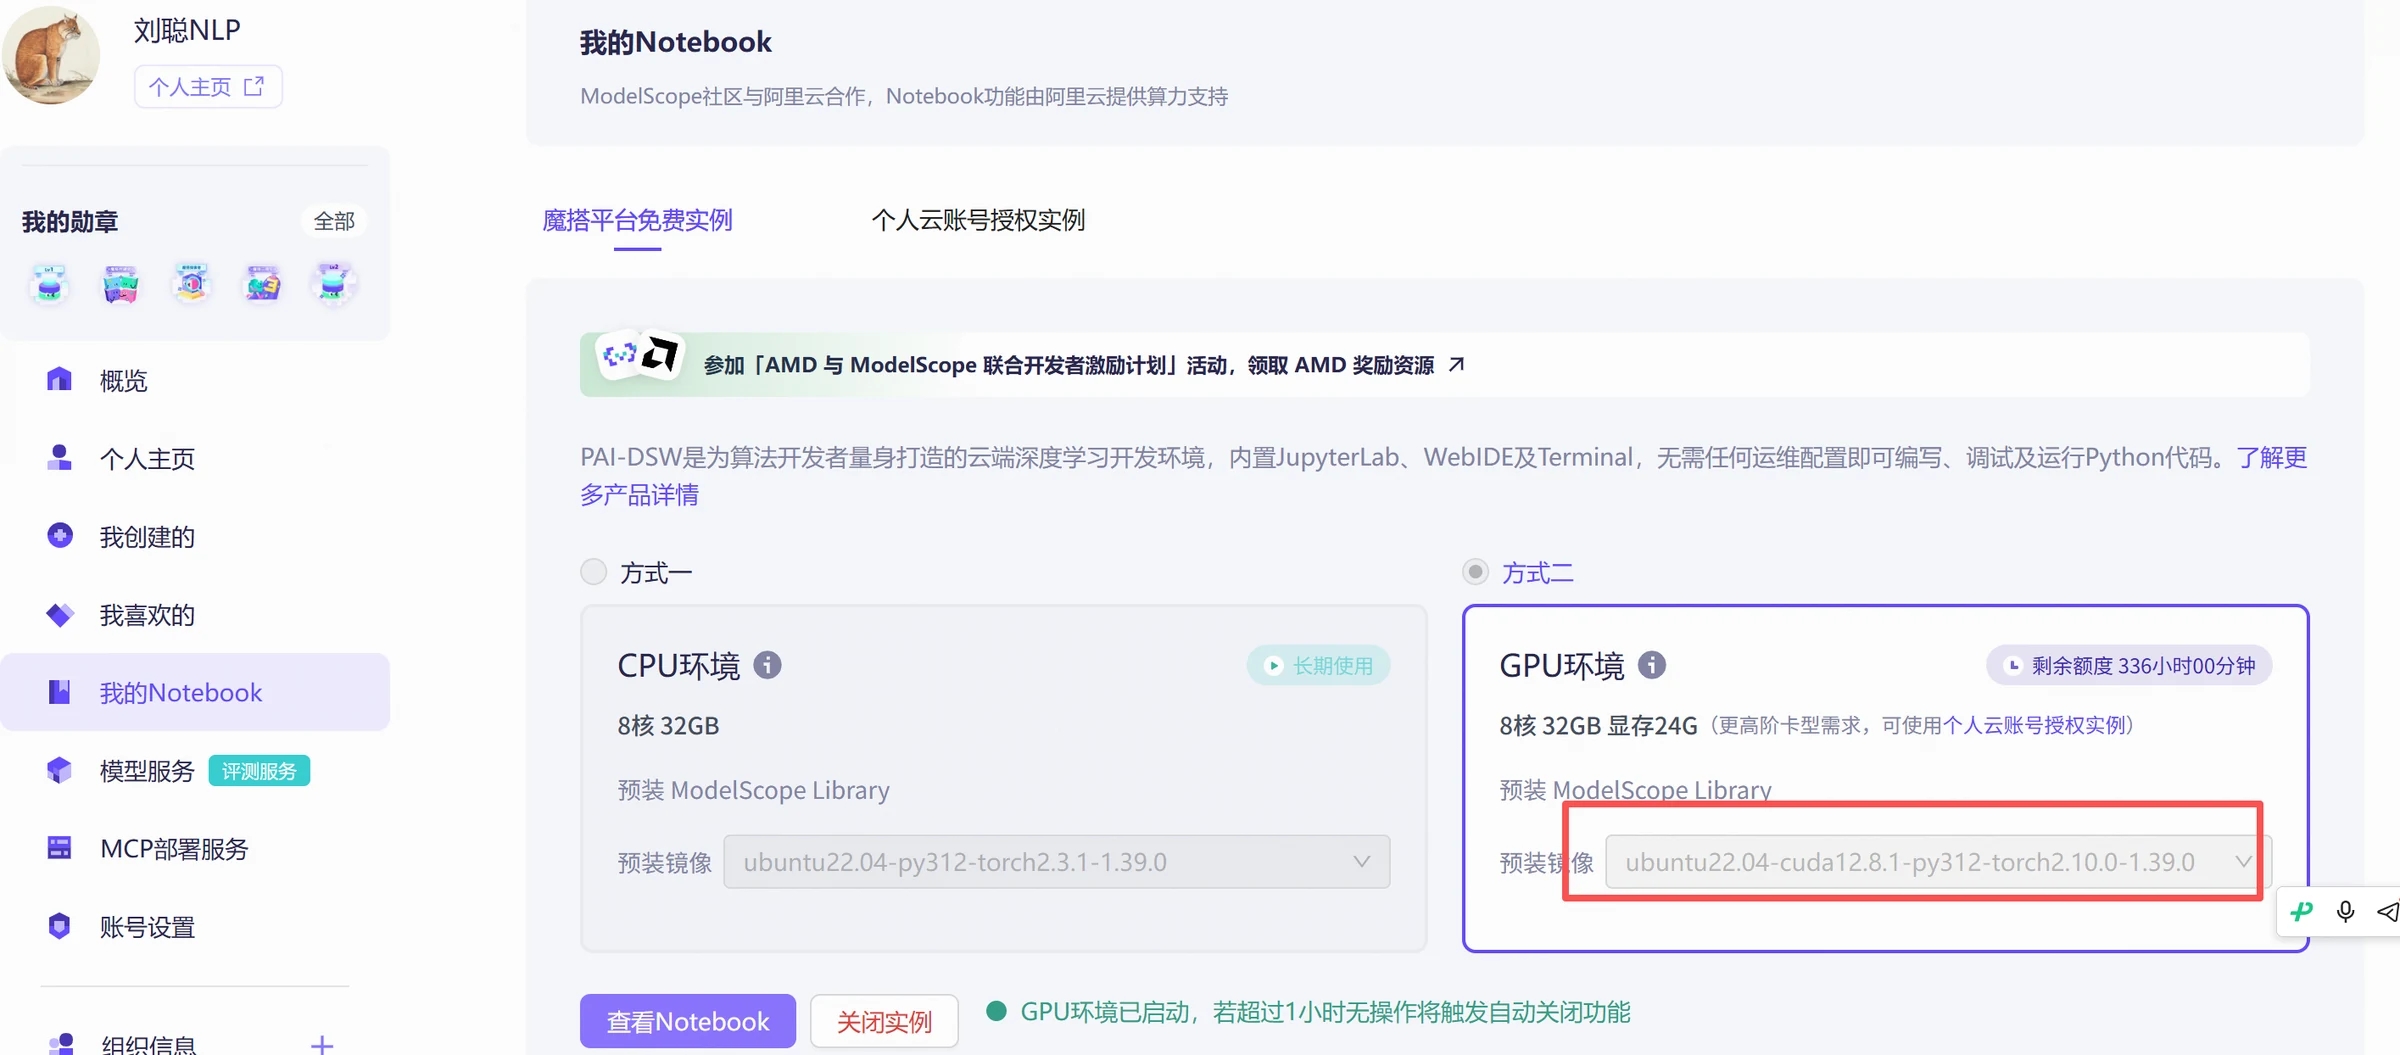
A continuación, usamos una tarea de reconocimiento de entidades como ejemplo para demostrar el flujo de trabajo completo de fine-tuning de modelo en el entorno ModelScope Notebook, incluyendo preparación de datos, entrenamiento del modelo e inferencia después del fine-tuning. A través de este ejemplo, puedes aprender cómo usar ms-swift para completar el fine-tuning de grandes modelos desde cero. Este experimento continúa usando la imagen ubuntu22.04-cuda12.8.1-py312-torch2.10.0-1.39.0 como entorno de ejecución.
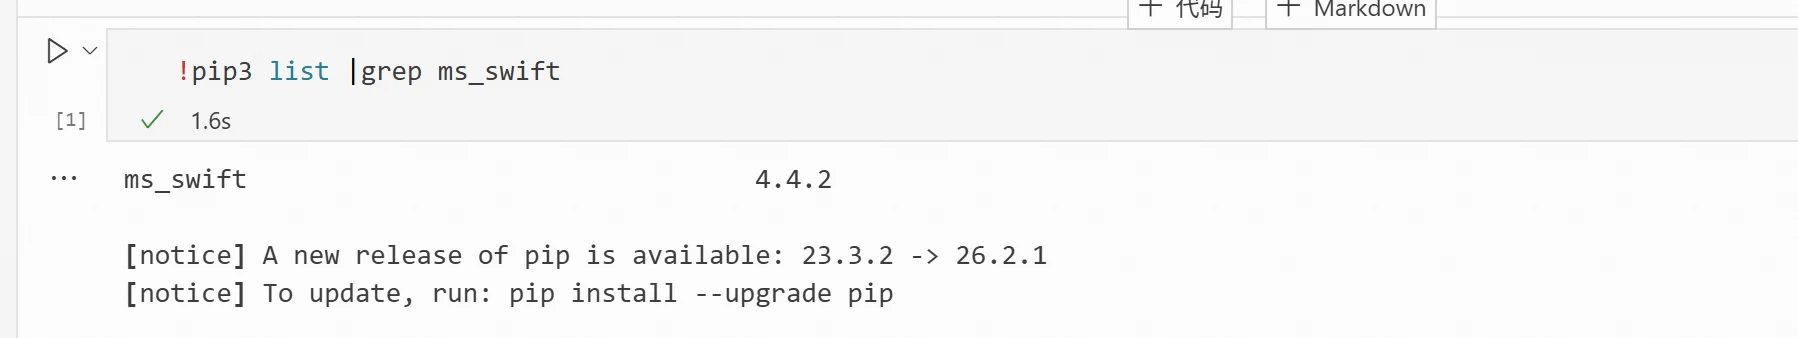
Verifica si ms-swift ya está instalado en el entorno. Observa que el nombre del paquete es ms_swift.
!pip3 list |grep ms_swift
Si ves una salida en el siguiente formato, ms-swift ya está instalado:
Si no está instalado, ejecuta:
!pip3 install ms-swift
Preparación de datos. Este experimento usa datos de código abierto para reconocimiento de entidades en comercio electrónico. El conjunto de datos contiene cuatro tipos de entidades: HCCX (nombre del producto), HPPX (nombre de la marca), XH (modelo del producto) y MISC (otras entidades incluyendo país, tamaño/capacidad, persona, obra y nombres de actividades).
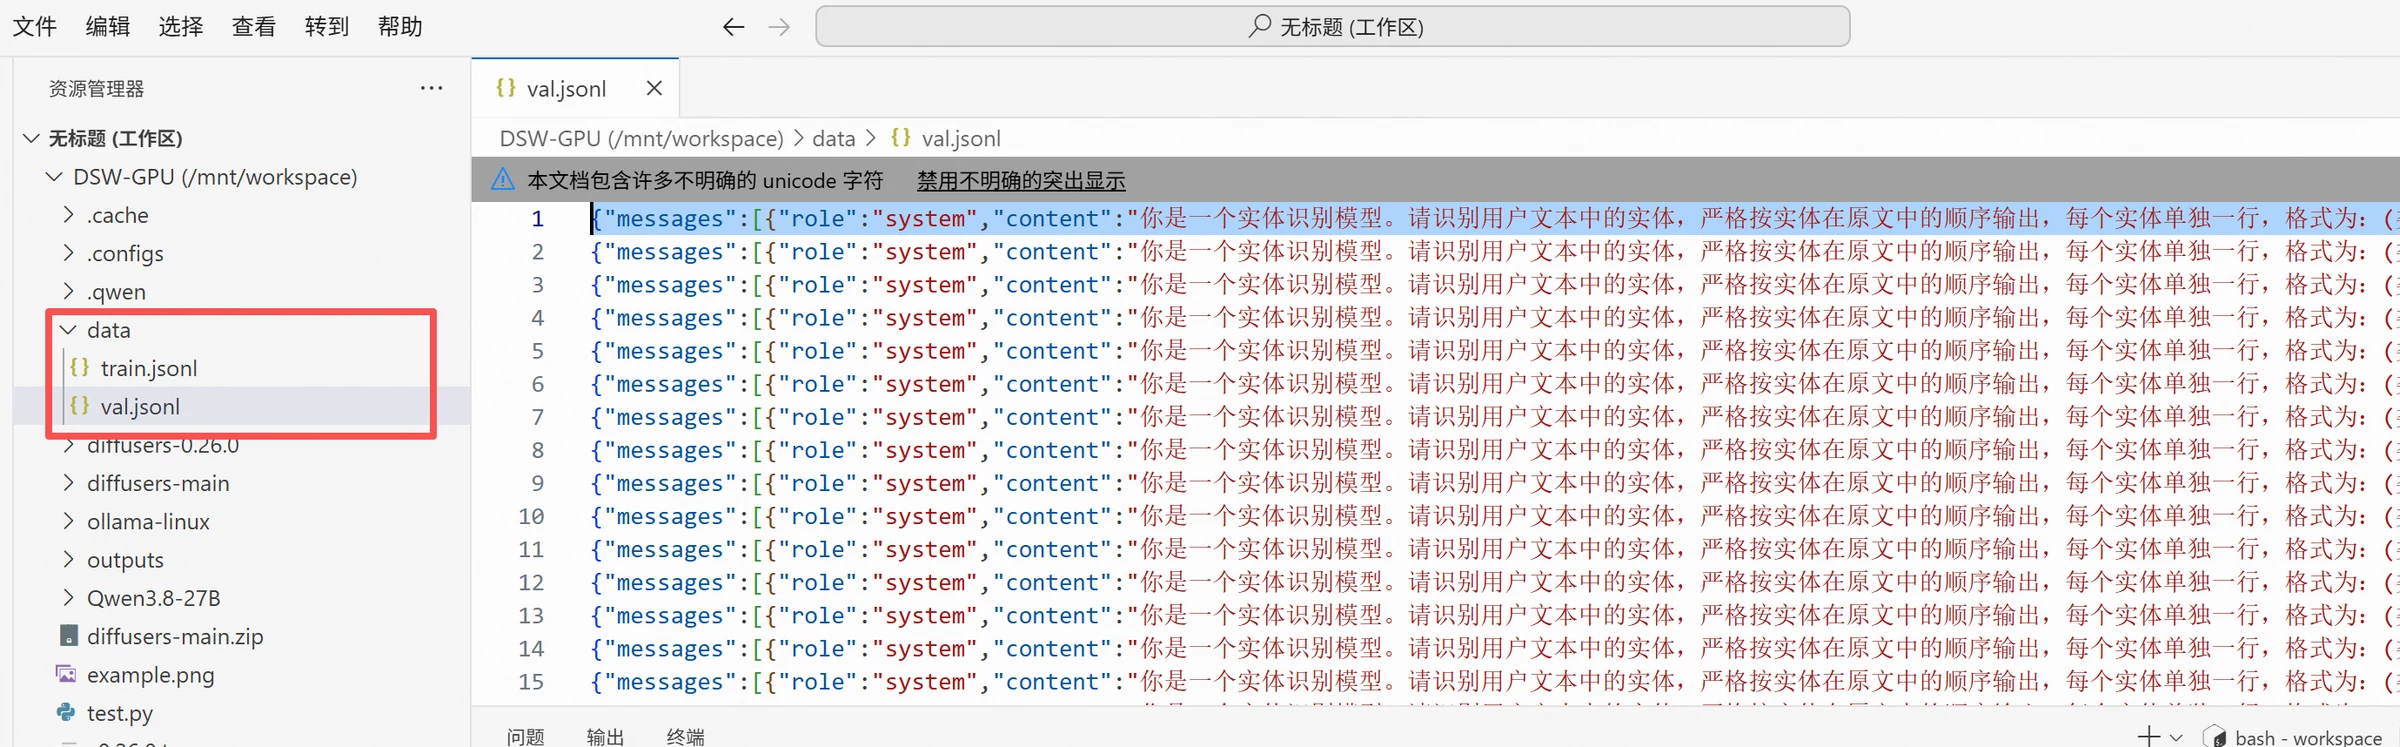
Primero crea un directorio llamado data, luego haz clic derecho para subir los datos a la carpeta. El formato de los datos es el siguiente. Esta tarea solo requiere que el modelo produzca categorías de entidades, entidades y sus posiciones de inicio en el texto. Los datos se dividen en conjuntos de entrenamiento y prueba, con train.jsonl conteniendo 5,400 entradas y val.jsonl conteniendo 600 entradas.
{"messages":[{"role":"system","content":"Eres un modelo de reconocimiento de entidades. Por favor identifica las entidades en el texto del usuario. Produce las entidades estrictamente en su orden de aparición en el texto original, cada entidad en una línea separada en el formato: (tipo, texto de la entidad, posición de inicio). La posición de inicio comienza en 0; el tipo solo puede ser HCCX, HPPX, MISC, XH. Cuando no haya entidades, produce solo: Sin entidades. No produces explicaciones, Markdown u otro contenido."},{"role":"user","content":"Aceite de oliva para masaje corporal completo y terapia de rasgado facial"},{"role":"assistant","content":"(HCCX,aceite de oliva,10)\n(HCCX,massage oil,20)\n(HCCX,oil,24)\n(HCCX,oil,27)"}]}
Estructura del directorio:
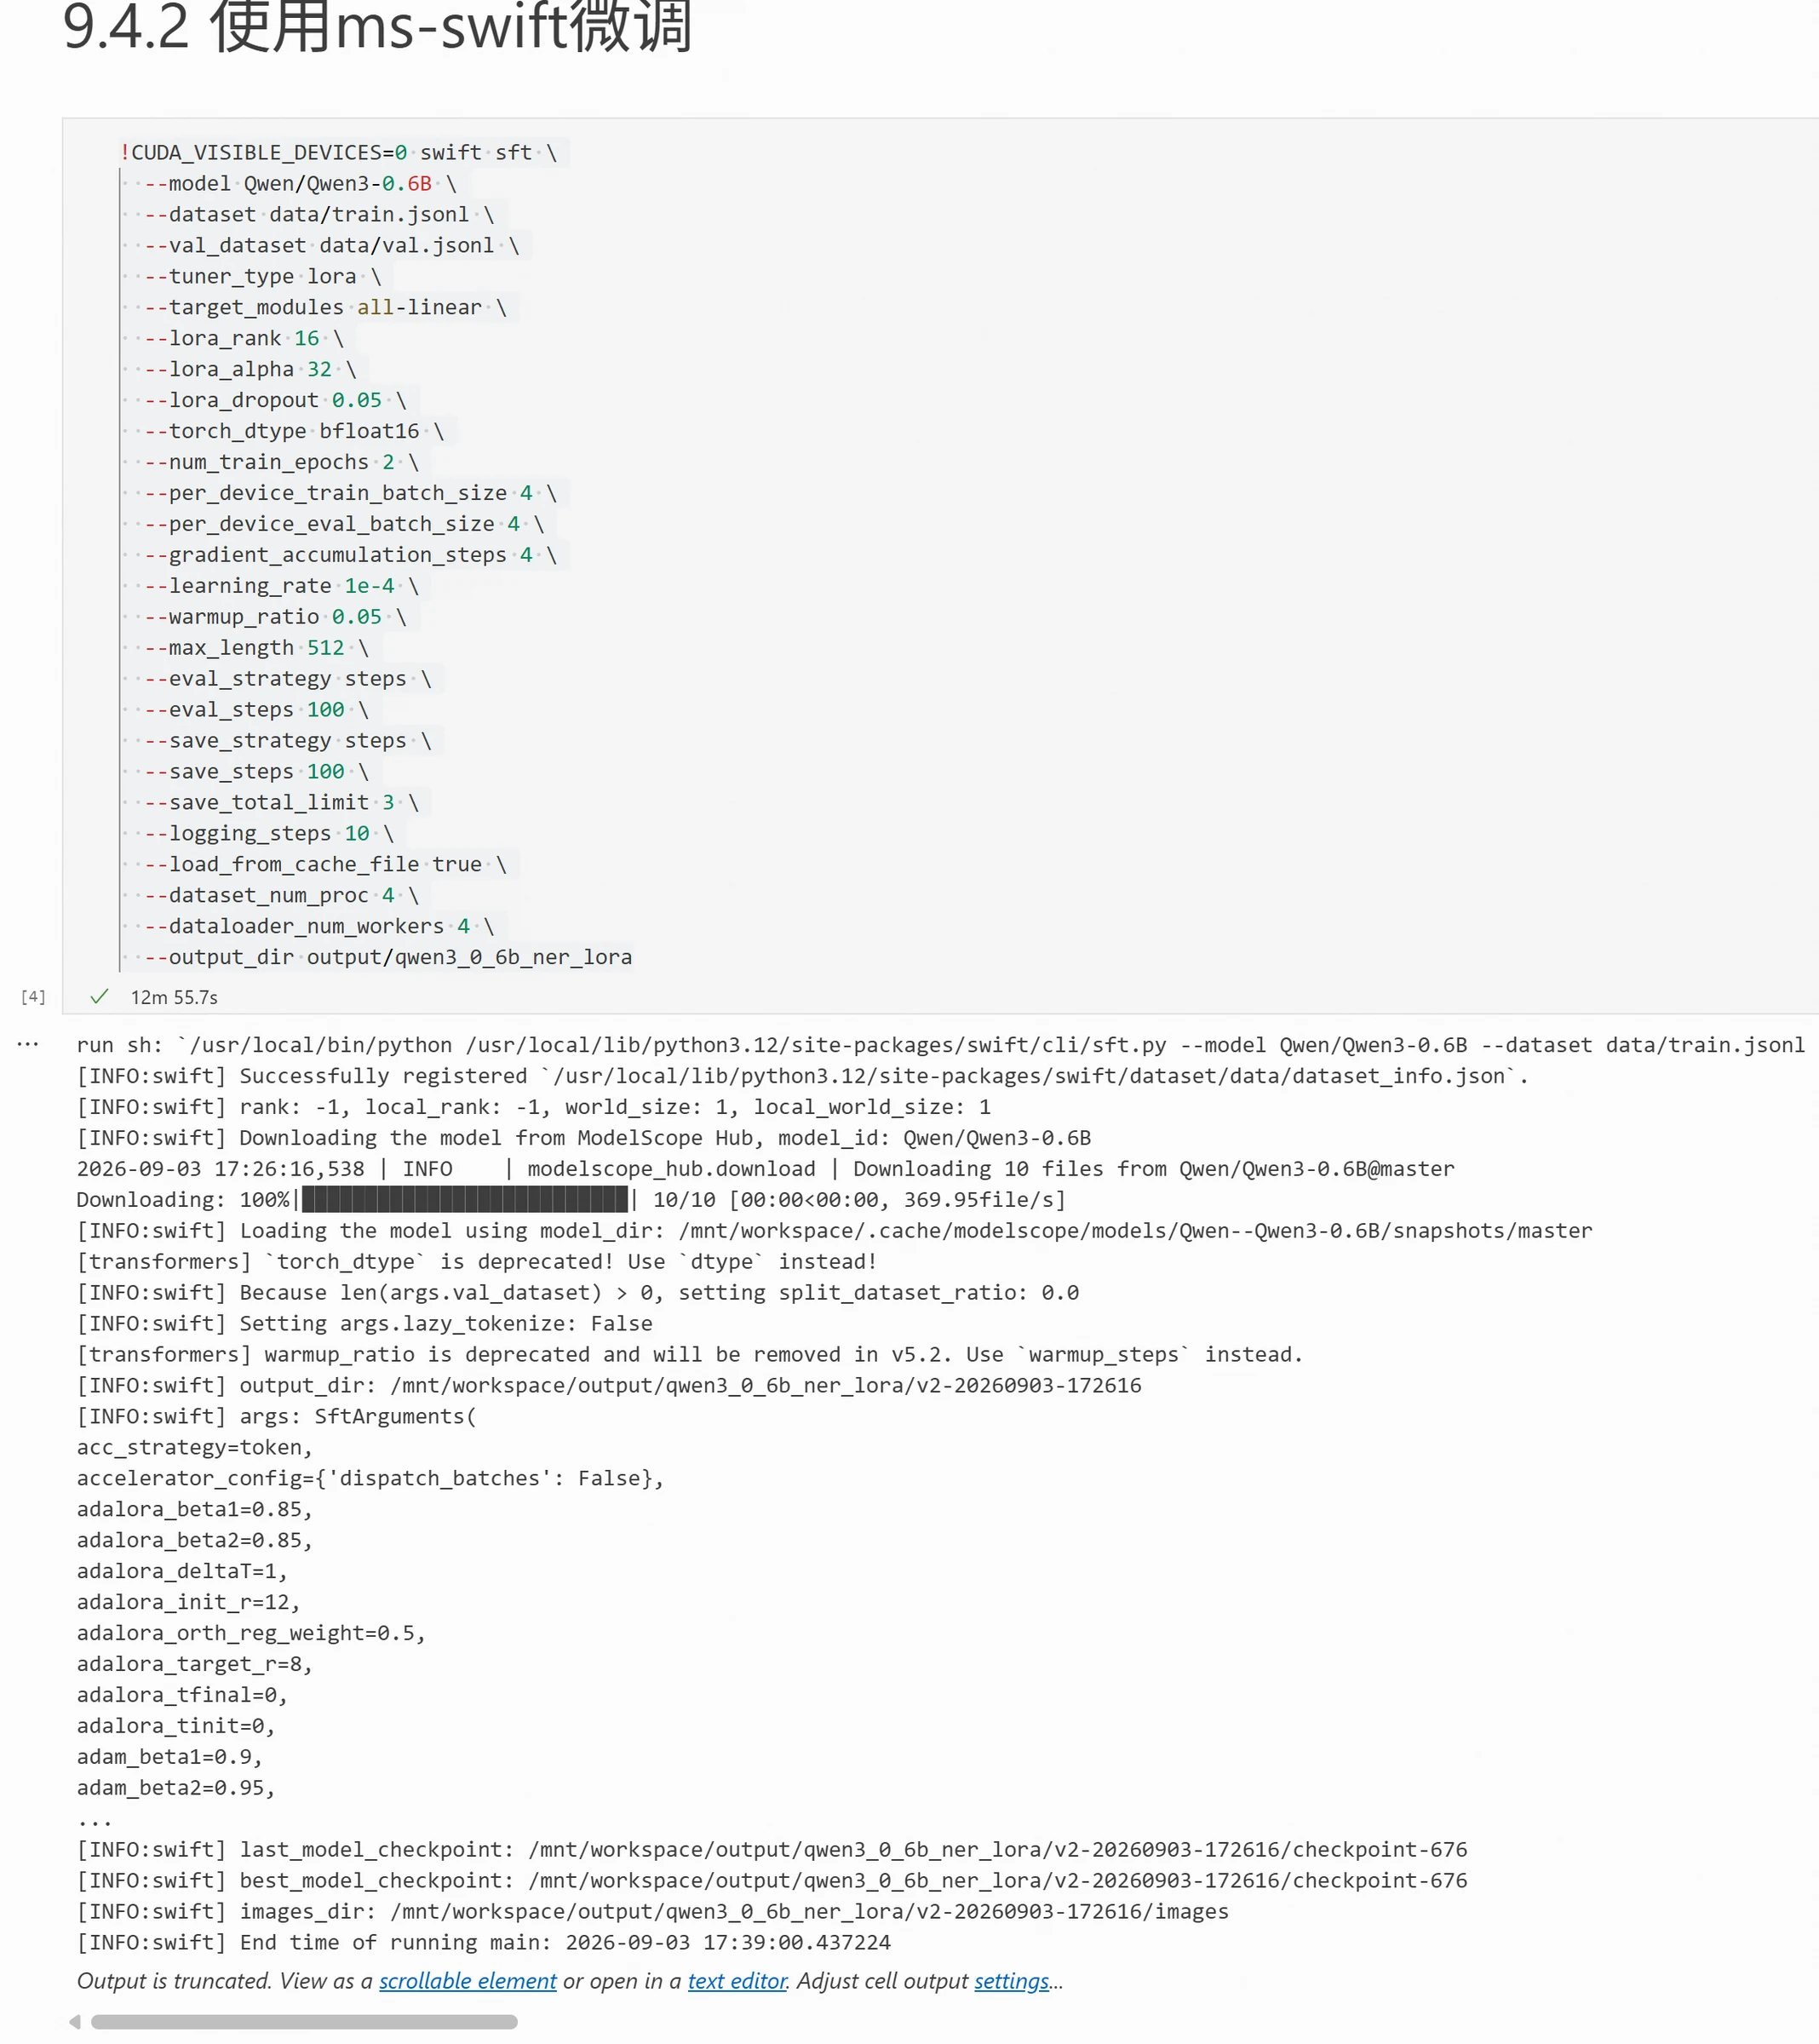
Entrenamiento del modelo. Esta sección usa Qwen/Qwen3-0.6B para fine-tuning. Ingresa directamente el siguiente comando en la terminal para iniciar el entrenamiento:
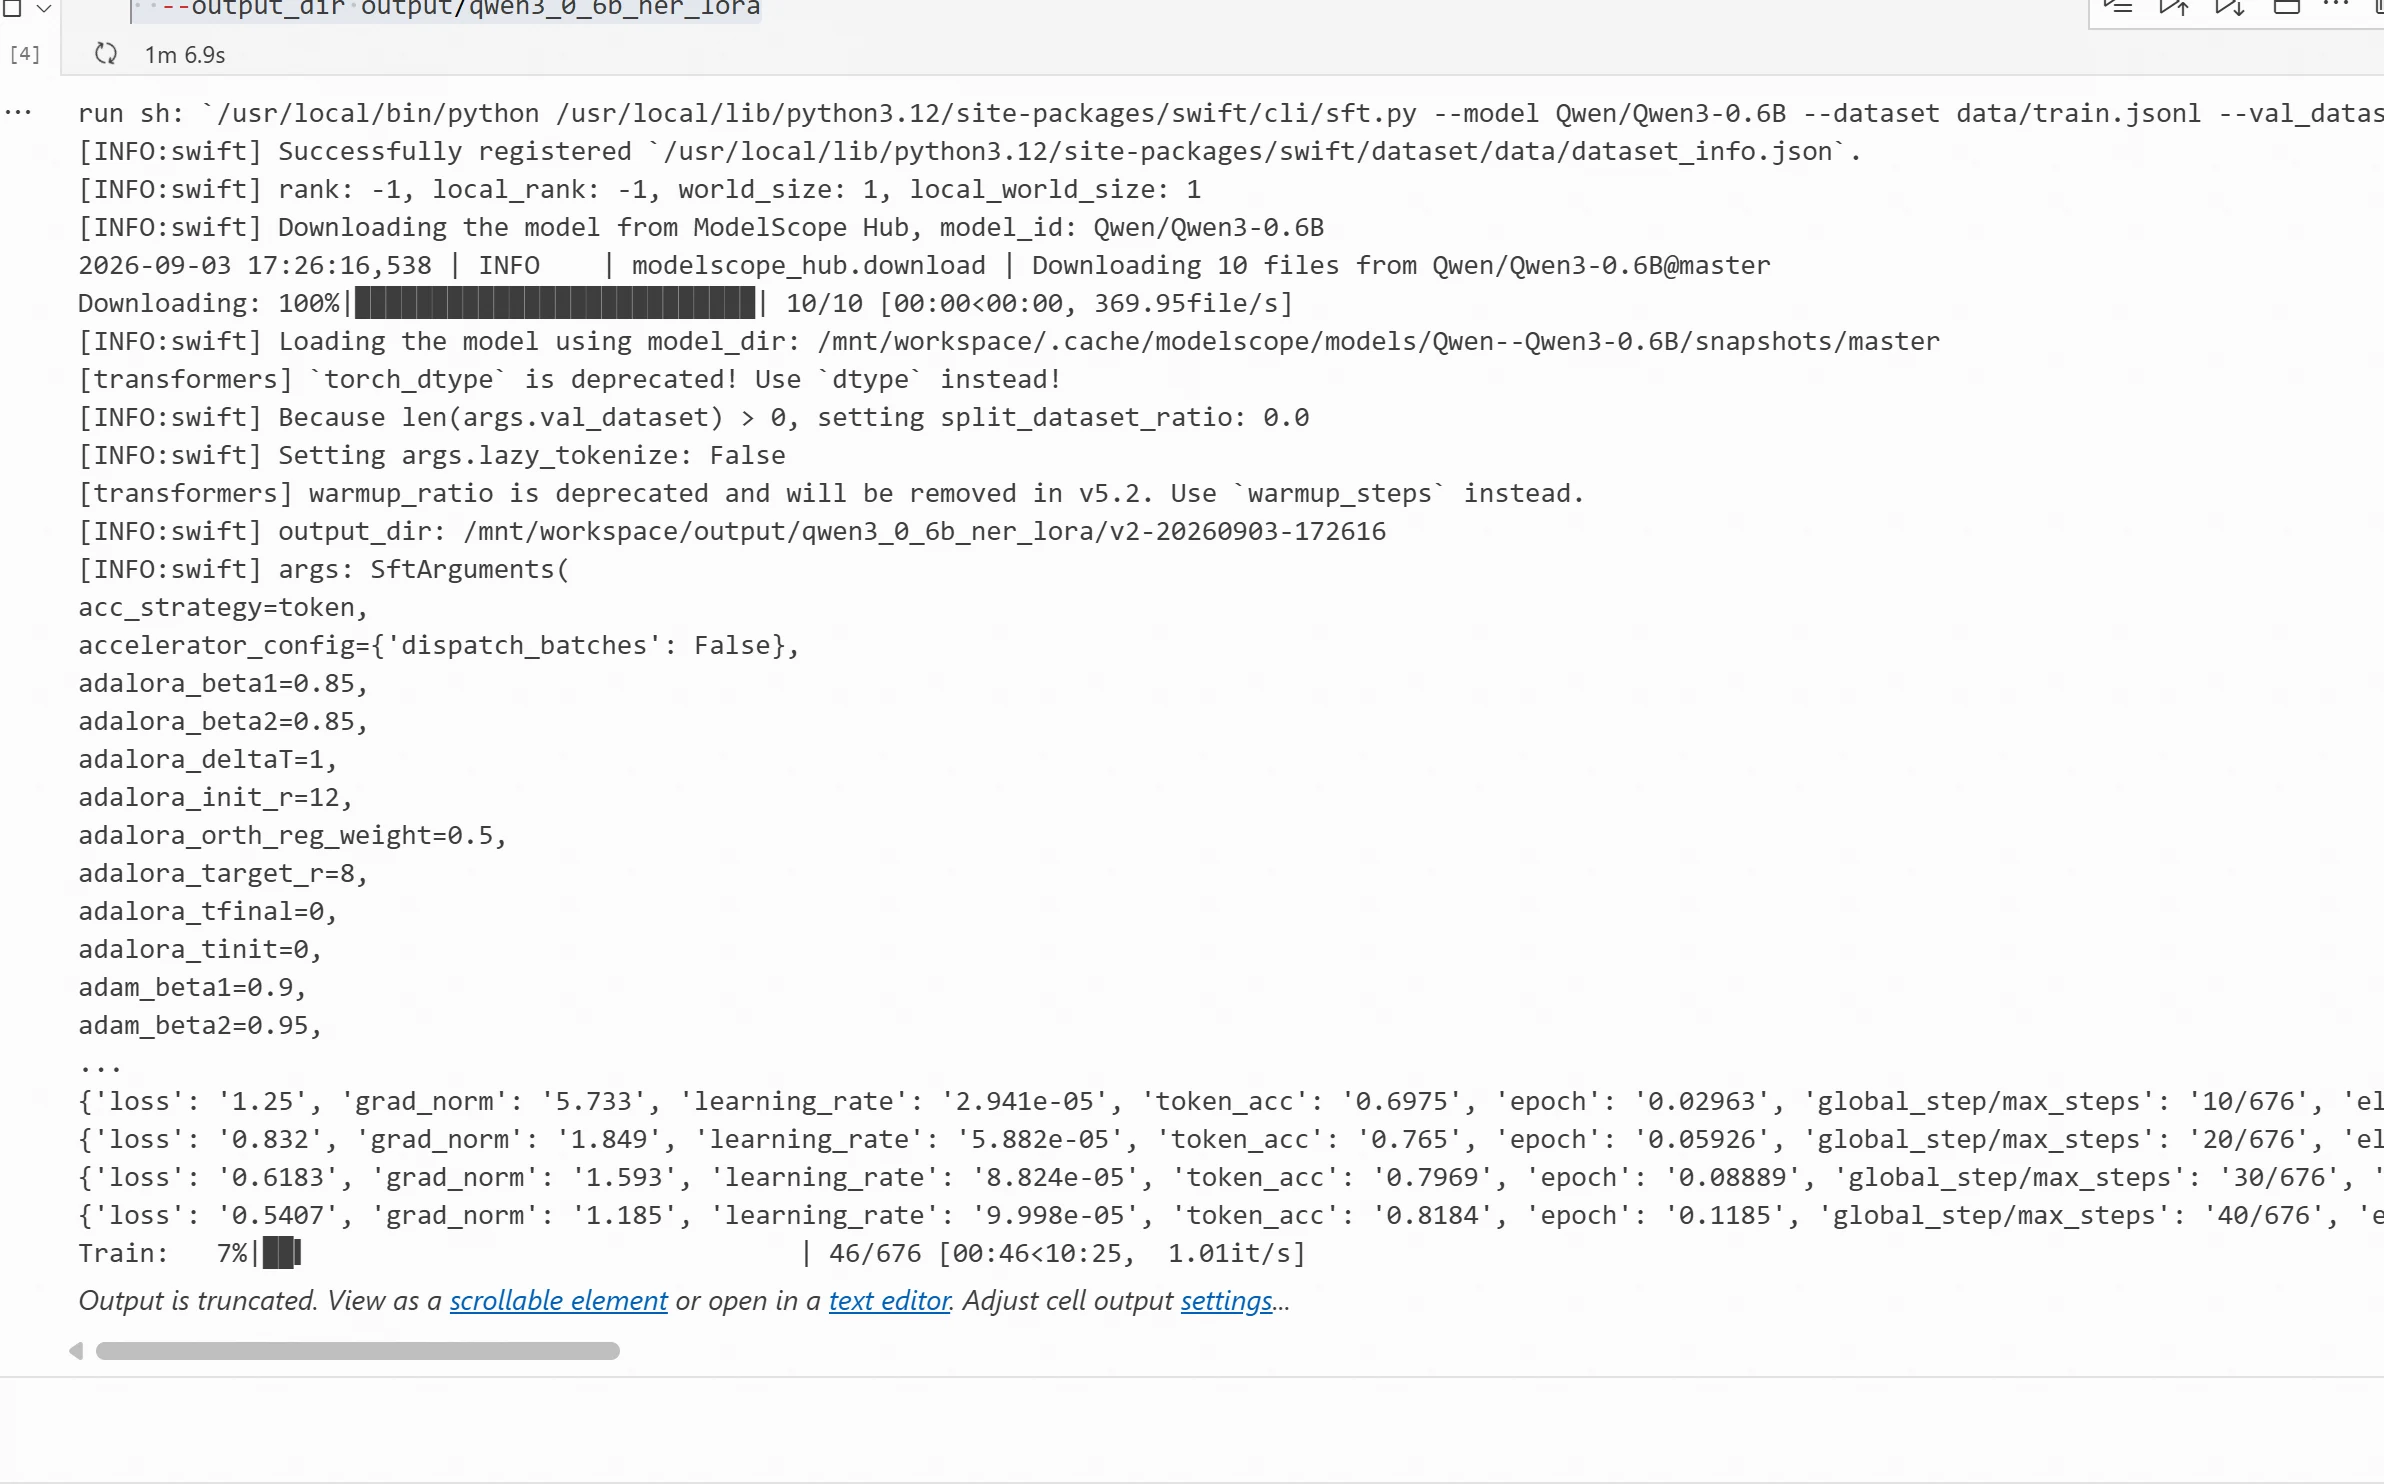
Después de iniciar el entrenamiento, ms-swift producirá continuamente la información actual del entrenamiento como se muestra a continuación:
El entrenamiento ha terminado — ¿cómo usamos el modelo?
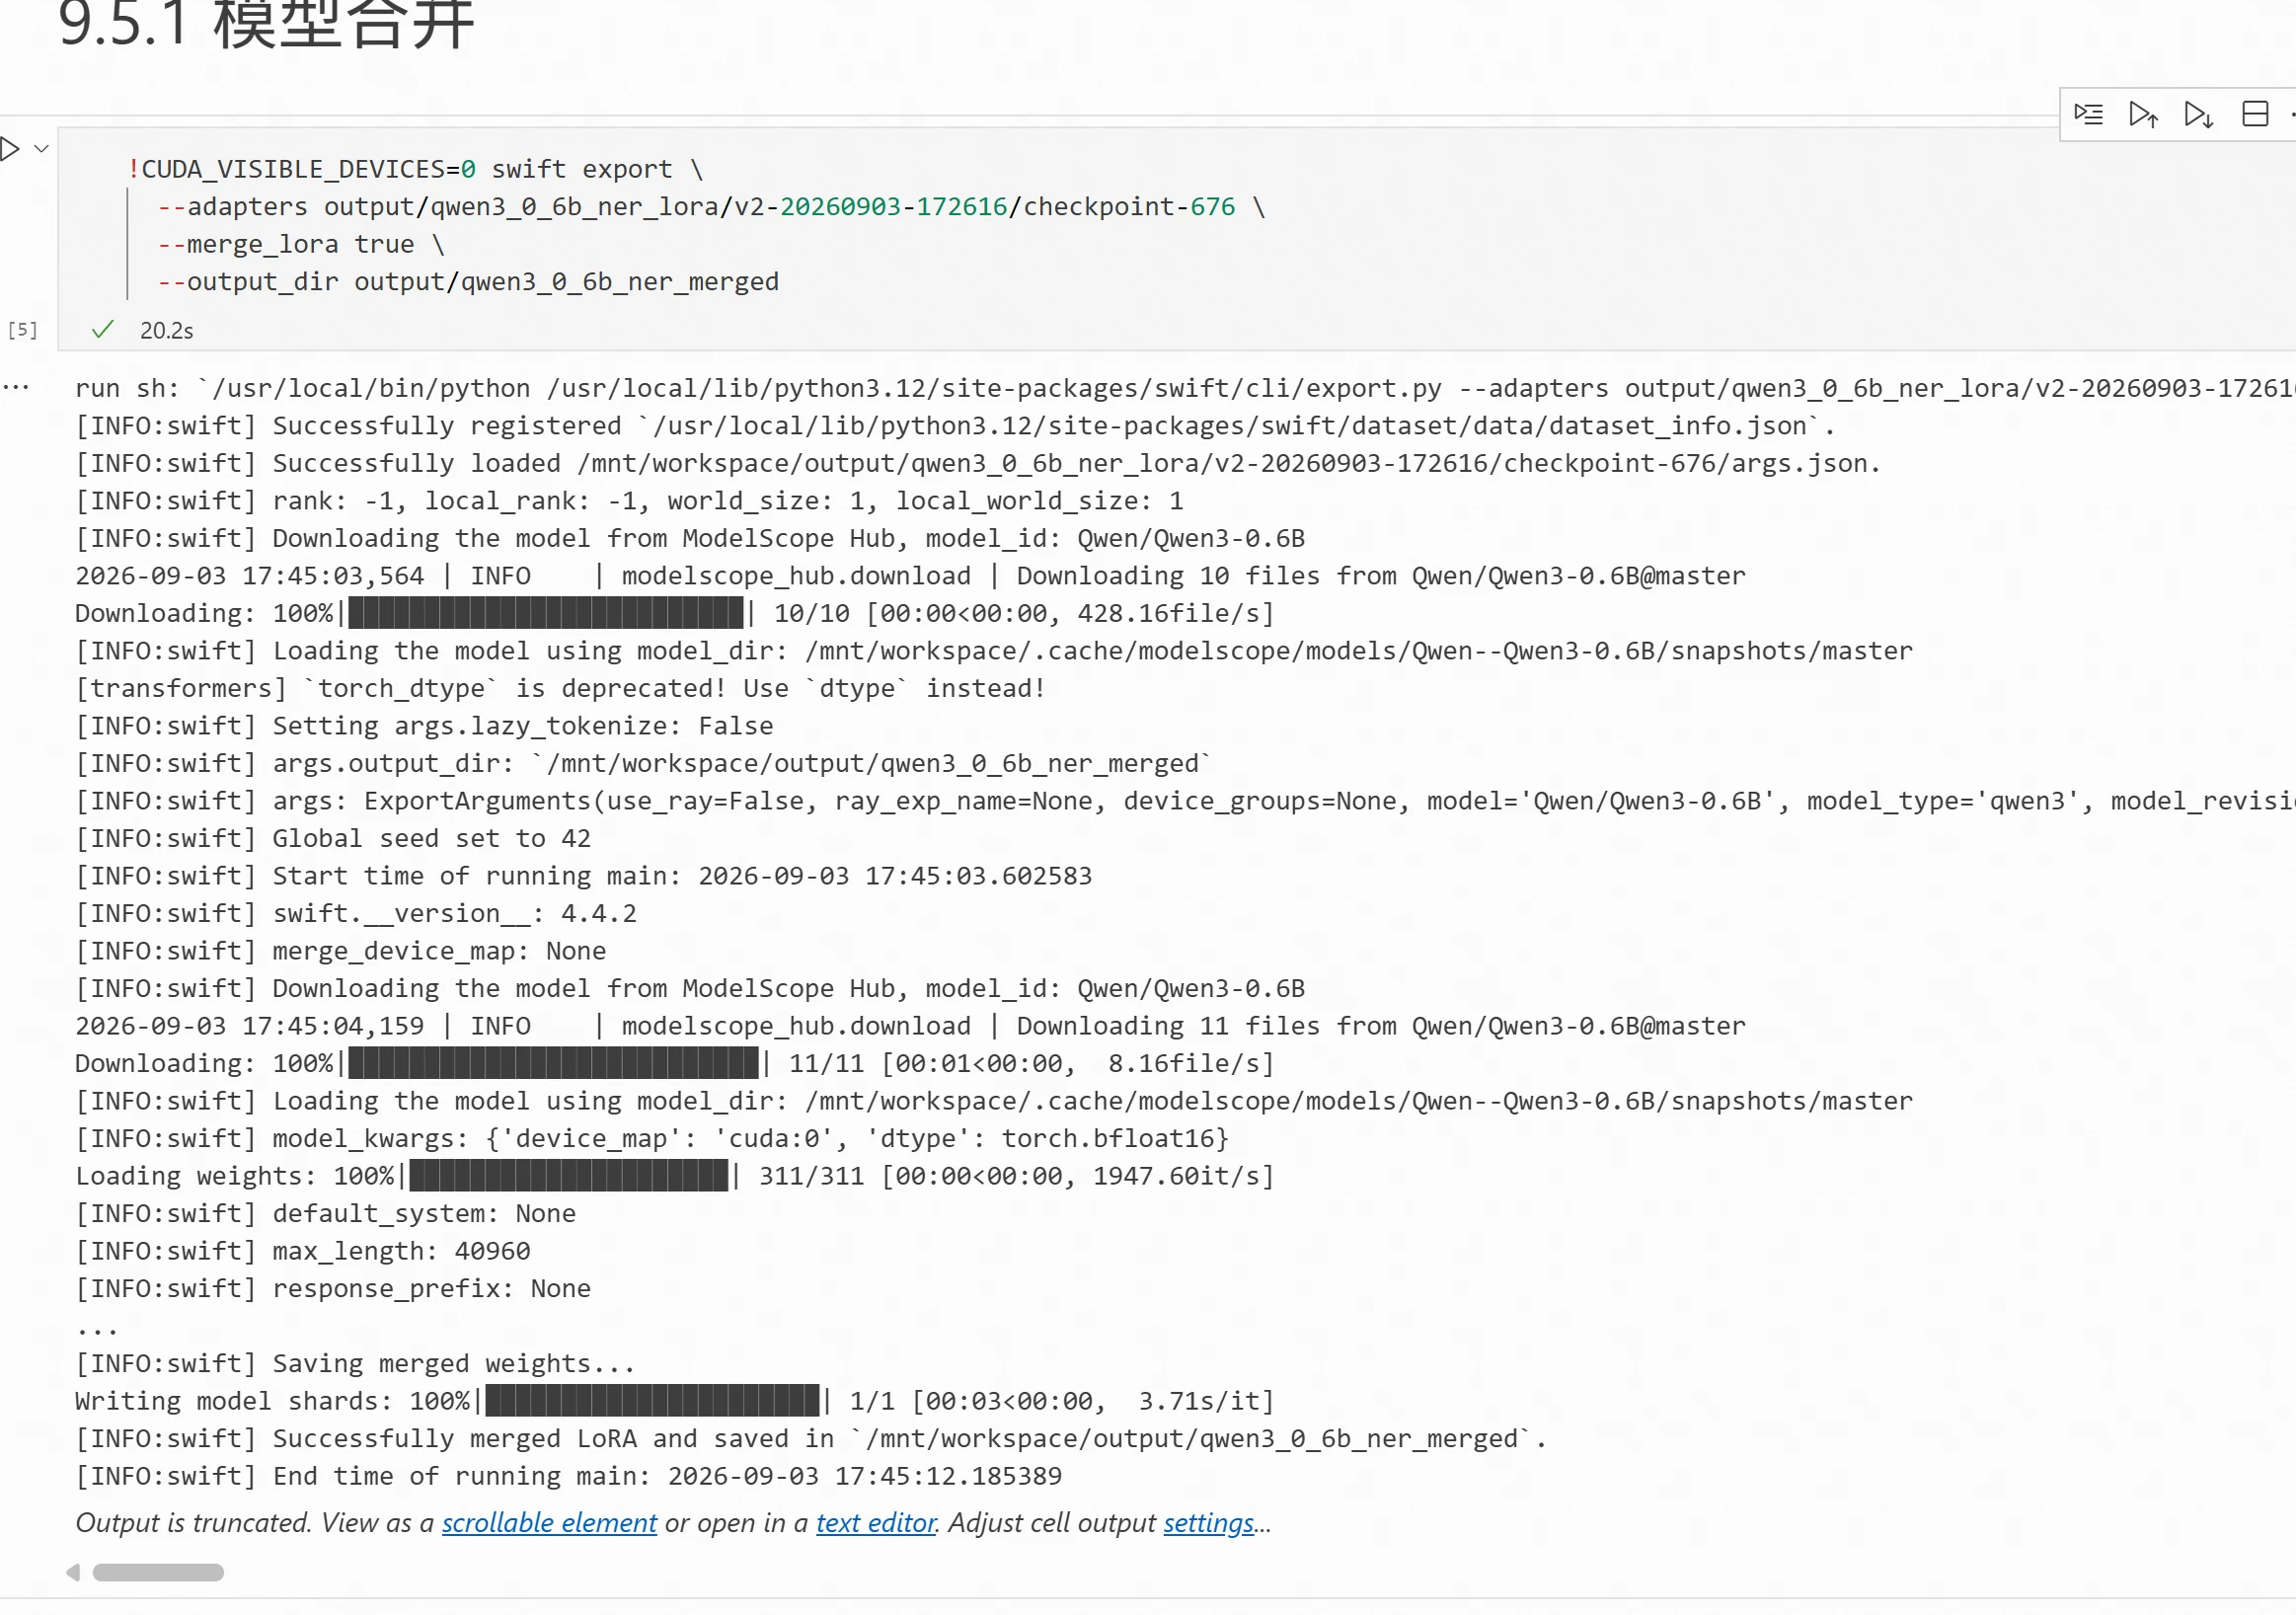
Fusionar los pesos LoRA en el modelo base
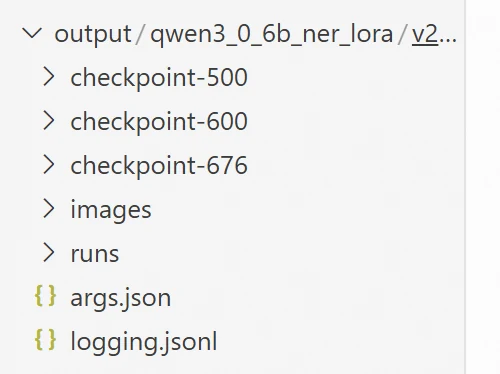
Después de que se complete el entrenamiento LoRA, se guarda el LoRA Adapter correspondiente. El Adapter no es un modelo grande completo, por lo que aún necesitas cargar el modelo base original al usarlo. A través del output_dir en el script de entrenamiento, puedes ver los checkpoints y archivos Adapter correspondientes en el directorio. En el despliegue real, puedes fusionar el LoRA Adapter en el modelo base para generar un modelo completo, lo cual es más conveniente para el despliegue sin conexión o la migración de modelos. La estructura del directorio después del entrenamiento del modelo es la siguiente:
Donde --adapters especifica la ruta al checkpoint LoRA entrenado, --merge_lora true indica fusionar los parámetros LoRA en el modelo base, y --output_dir especifica el directorio de guardado para el modelo fusionado.
Resultado de ejecución:
Cargar el modelo fine-tuneado y probar el efecto
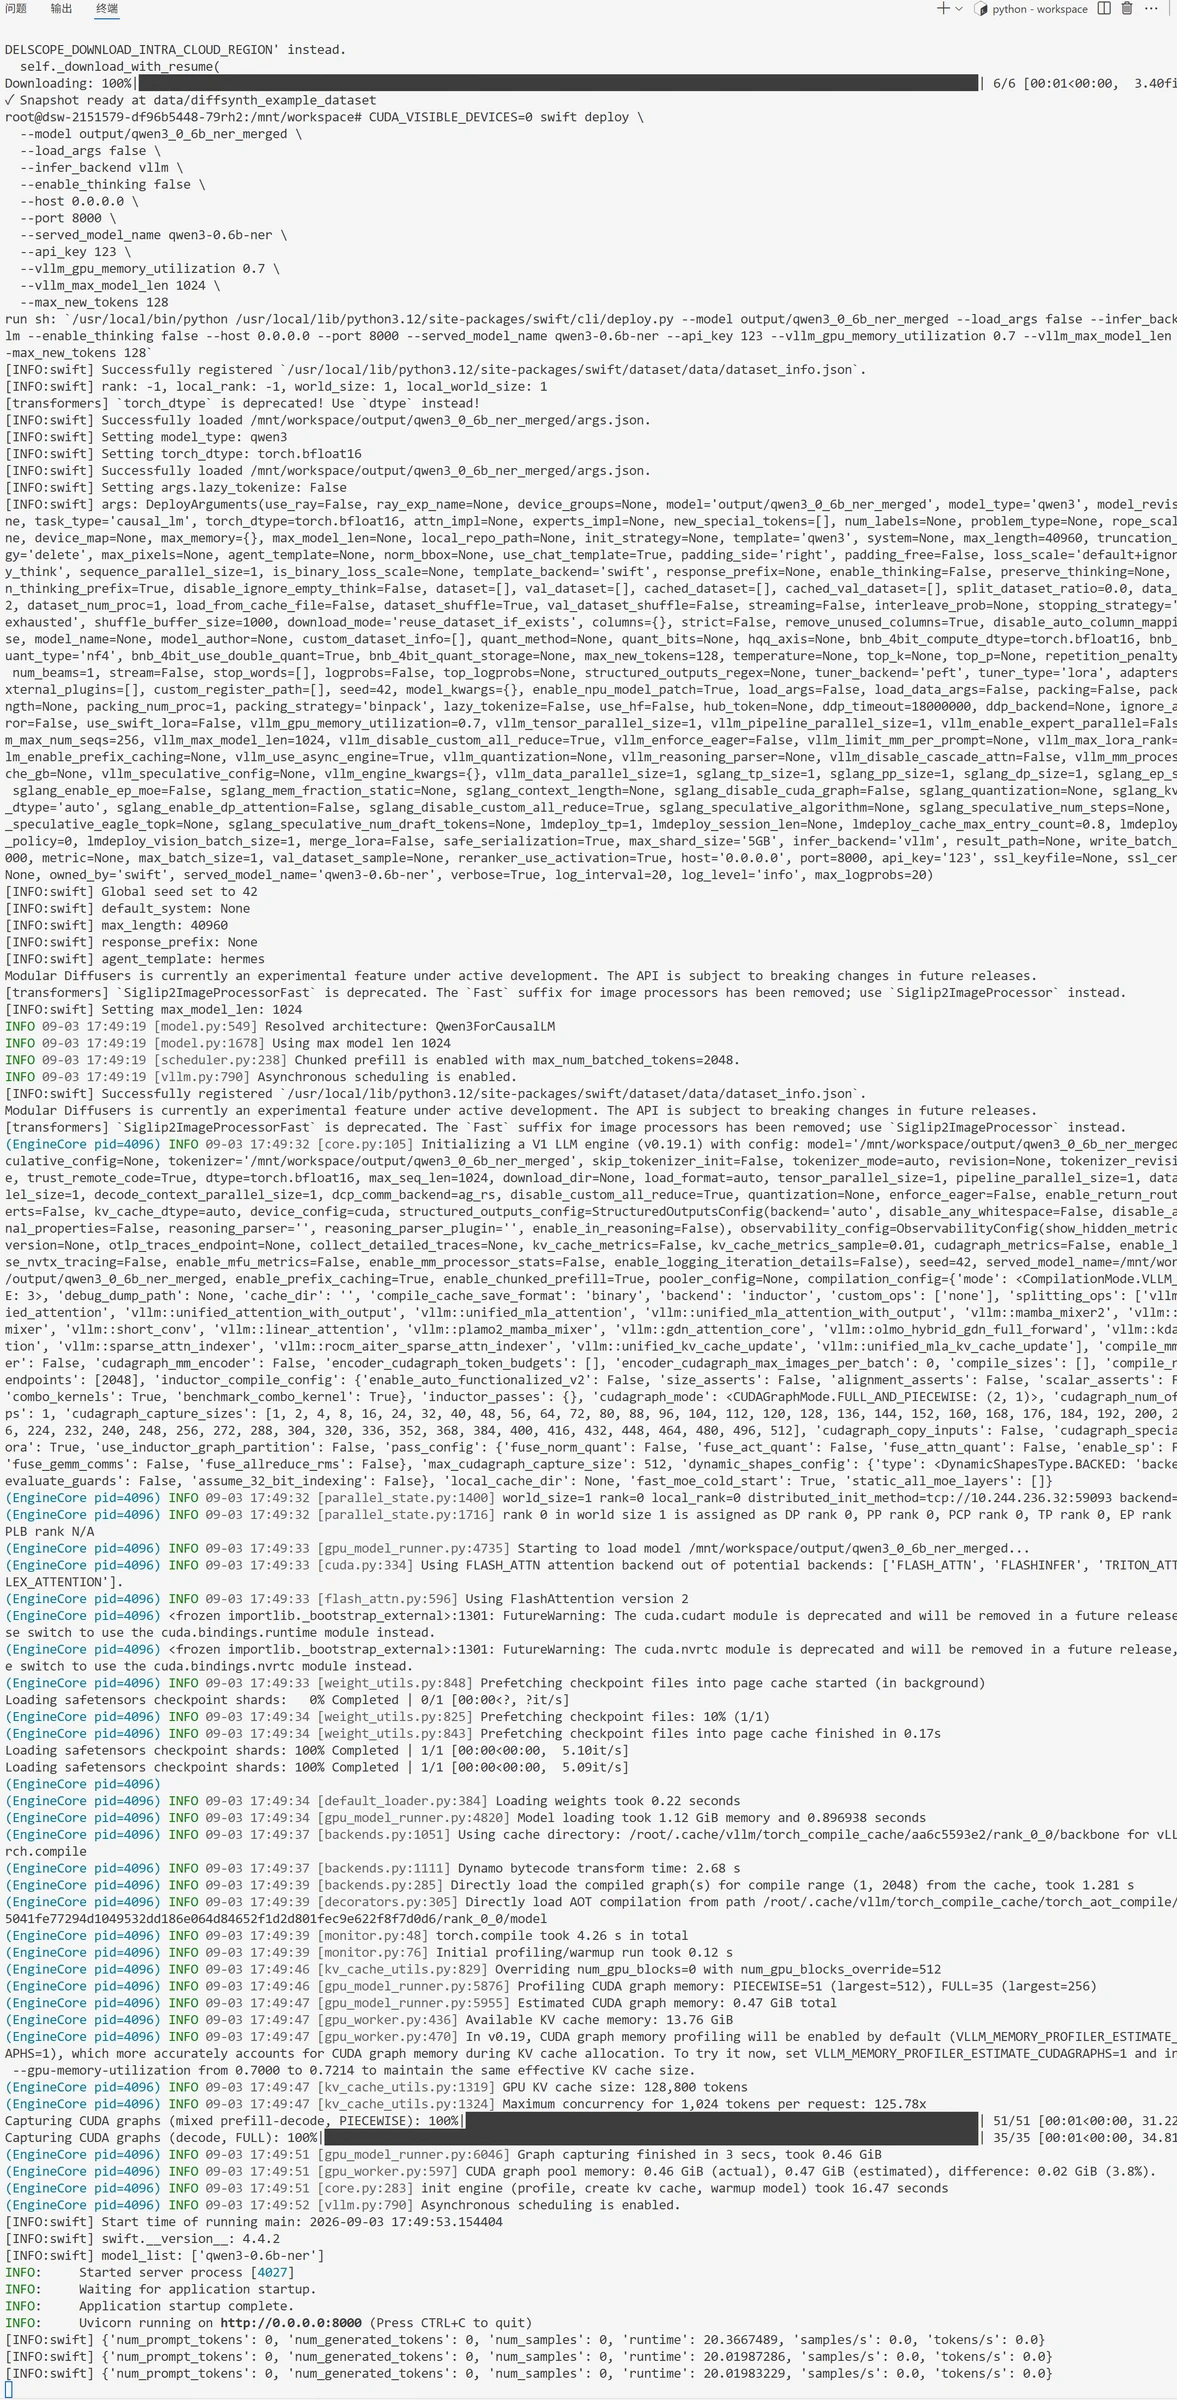
Después de la fusión, puedes cargar directamente el modelo completo generado para inferencia. Para facilitar las llamadas de aplicaciones, también puedes iniciar el modelo como interfaz compatible con OpenAI, accediendo al modelo fine-tuneado a través de API. Este también es un servicio persistente que debe iniciarse en la terminal. Puedes referirte al Capítulo 7 para saber cómo iniciar comandos en la terminal. El comando de inicio es el siguiente:
Iniciar el servicio compatible con OpenAI de ms-swift
--model
Especificar el directorio del modelo completo fusionado
--load_args
No cargar los parámetros args.json del directorio del modelo
--infer_backend
Usar el motor de inferencia vLLM
--enable_thinking
Deshabilitar el modo de pensamiento Qwen3
--host
IP de la interfaz
--port
Puerto
--served_model_name
Establecer el nombre del modelo de acceso a la interfaz
--api_key
Establecer la clave de acceso a la interfaz
--vllm_gpu_memory_utilization
El modelo usa aproximadamente 70% de la memoria GPU
--vllm_max_model_len
Número máximo total de tokens
--max_new_tokens
Longitud máxima de salida
Después de que el modelo inicie, el resultado es el siguiente:
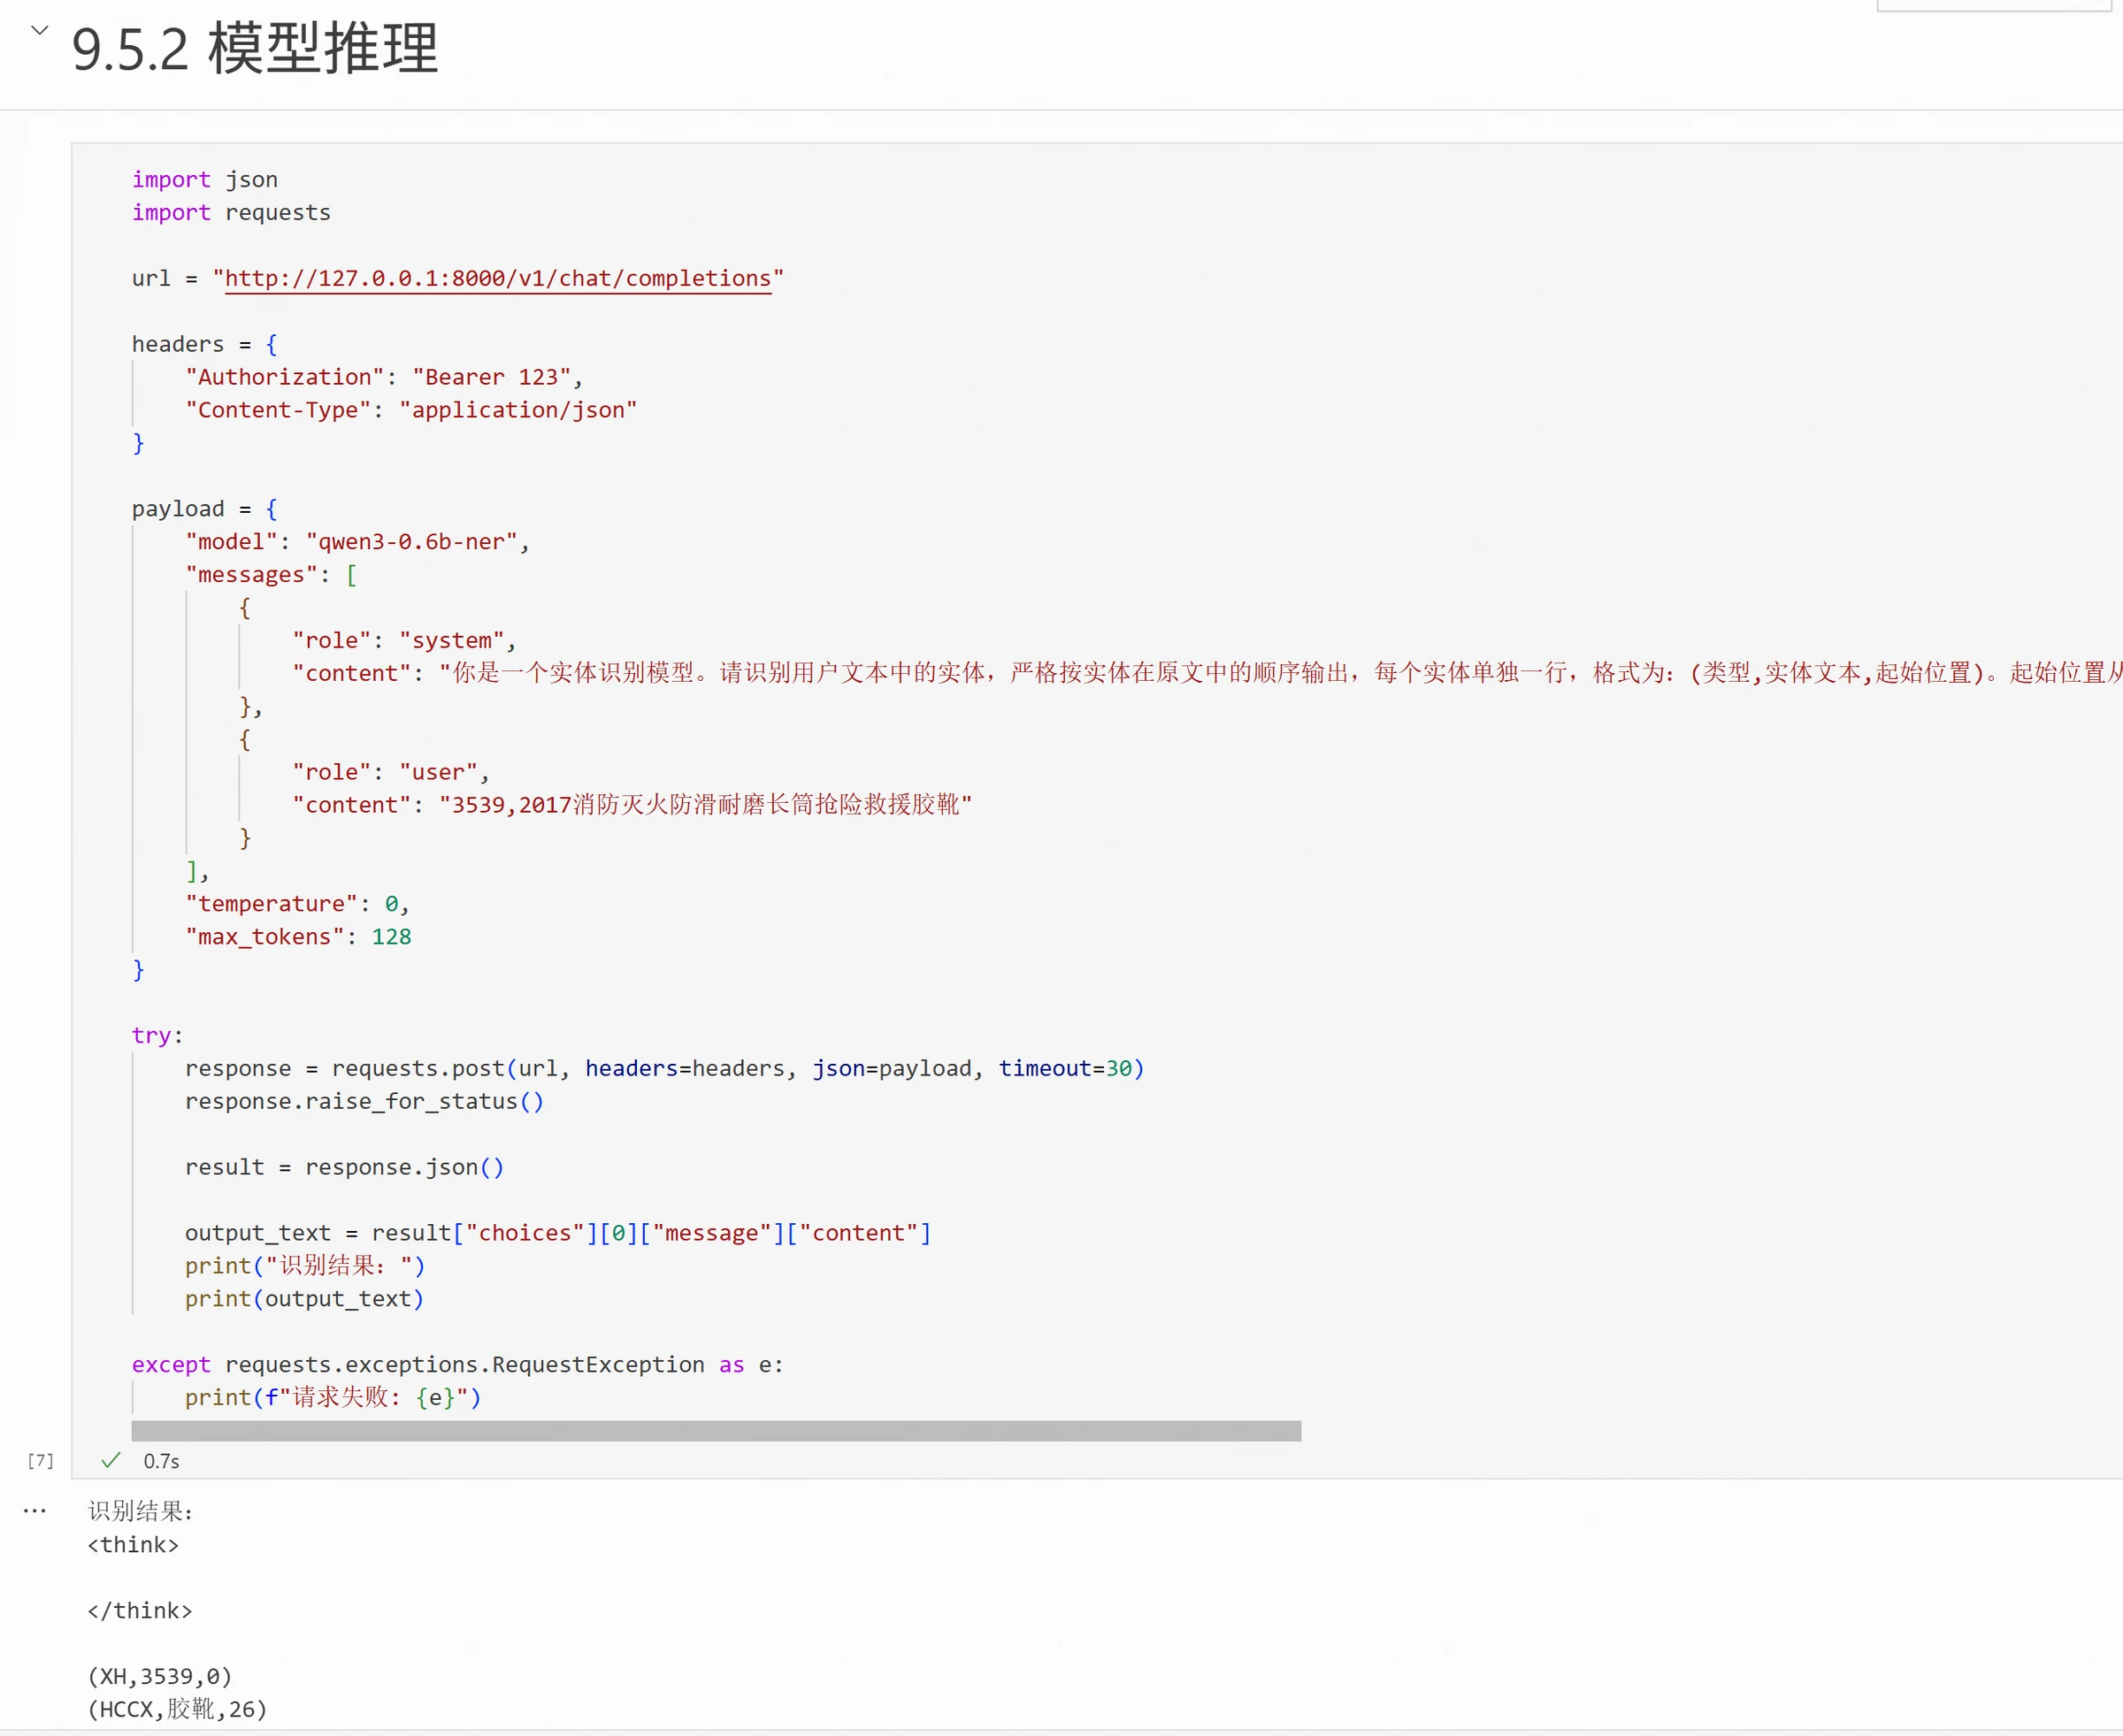
Después de que el modelo inicie, puedes probar la conectividad a través de la interfaz. Código como sigue:
import json
import requests

url = "http://127.0.0.1:8000/v1/chat/completions"

headers = {
    "Authorization": "Bearer 123",
    "Content-Type": "application/json"
}

payload = {
    "model": "qwen3-0.6b-ner",
    "messages": [
        {
            "role": "system",
            "content": "Eres un modelo de reconocimiento de entidades. Por favor identifica las entidades en el texto del usuario. Produce las entidades estrictamente en su orden de aparición en el texto original, cada entidad en una línea separada en el formato: (tipo, texto de la entidad, posición de inicio). La posición de inicio comienza en 0; el tipo solo puede ser HCCX, HPPX, MISC, XH. Cuando no haya entidades, produce solo: Sin entidades. No produces explicaciones, Markdown, etiquetas think u otro contenido."
        },
        {
            "role": "user",
            "content": "3539,2017 botas largas antideslizantes ignífugas de rescate resistentes al desgaste"
        }
    ],
    "temperature": 0,
    "max_tokens": 128
}

try:
    response = requests.post(url, headers=headers, json=payload, timeout=30)
    response.raise_for_status()

    result = response.json()

    output_text = result["choices"][0]["message"]["content"]
    print("Resultado del reconocimiento:")
    print(output_text)

except requests.exceptions.RequestException as e:
    print(f"Solicitud fallida: {e}")
Resultado de salida del modelo. También podemos usar expresiones regulares para eliminar las etiquetas think:
Todos los datos y código de experimentos de este capítulo se pueden encontrar en: https://modelscope.cn/gallery/liucong/ab458cbd-b47f-4830-91b6-314ea2036fc6