Una vez que el modelo ha sido fine-tuned y es capaz de responder según las indicaciones, al comparar varias respuestas entre sí, algunas serán mejores y otras peores, y algunas resultarán más agradables de leer que otras.
Tomemos como ejemplo una consulta sobre reembolsos. En ambos casos se indica al usuario dónde solicitar el reembolso, pero una respuesta solo ofrece el punto de acceso, mientras que la otra explica además que es necesario un proceso de revisión y que la posibilidad de reembolso depende del estado del pedido. Ambas respuestas tratan sobre el reembolso, pero la segunda explica con mayor claridad las situaciones que el usuario podría encontrarse, y reduce malentendidos.
Cuando realizamos SFT, organizamos este tipo de respuestas en ejemplos para que el modelo aprenda a partir de ellos. Ahora también podemos comparar diferentes respuestas a la misma pregunta, indicarle al modelo cuál preferimos y cuáles son los criterios de evaluación.
Esto es el alineamiento de preferencias, y es por aquí donde empezamos.
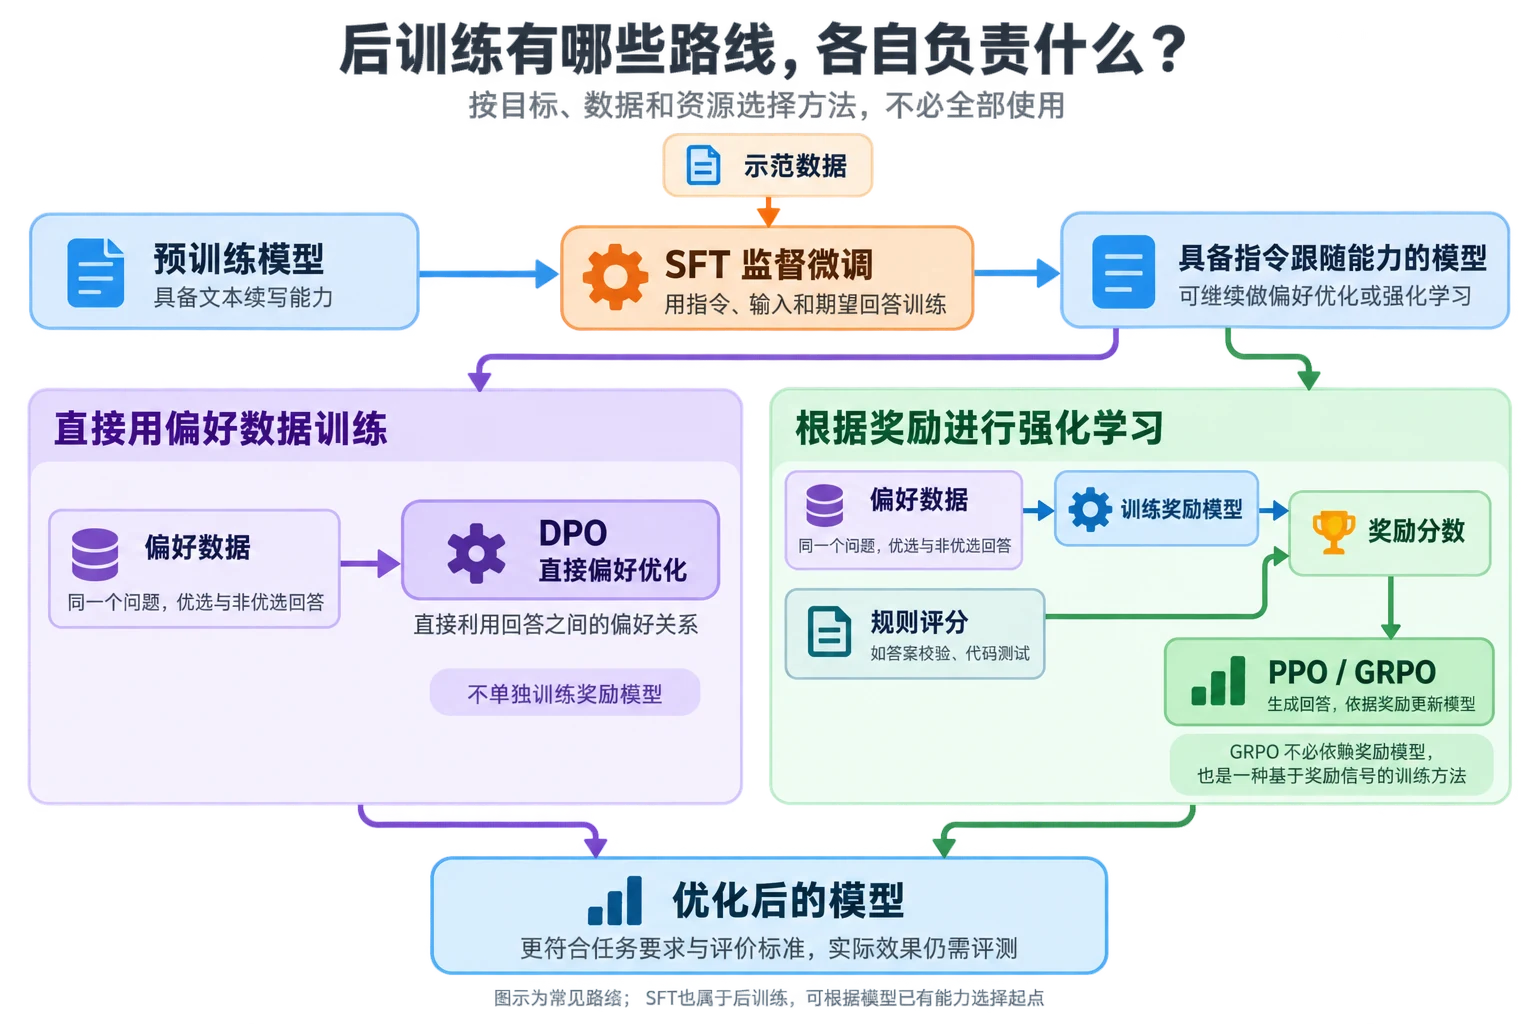
El propósito principal del post-entrenamiento de grandes modelos es ayudar a los modelos base, que ya poseen la capacidad de continuar texto, a transformarse gradualmente en modelos capaces de dialogar directamente, seguir instrucciones y completar tareas concretas de manera más eficaz. El post-entrenamiento no es un algoritmo fijo, sino un conjunto de métodos de entrenamiento. Los métodos más comunes incluyen SFT, optimización de preferencias, entrenamiento de modelos de recompensa y aprendizaje por refuerzo, entre otros. Diferentes modelos combinan estos métodos de distintas maneras según sus objetivos de entrenamiento, las condiciones de datos y los costos disponibles.
En particular, SFT utiliza datos en formato de "instrucción, entrada y respuesta esperada" para que el modelo aprenda a comprender tareas, seguir instrucciones y responder en el formato y estilo esperados. Sobre esta base, se pueden utilizar datos de preferencia para el alineamiento, por ejemplo, construyendo respuestas preferidas y no preferidas para la misma pregunta, de modo que el modelo aprenda los criterios de evaluación humanos o de negocio. Los datos de preferencia pueden usarse tanto para entrenar un modelo de recompensa, convirtiendo las preferencias humanas en puntuaciones de recompensa calculables que luego se combinan con métodos de aprendizaje por refuerzo como PPO o GRPO para optimizar continuamente la estrategia de generación del modelo, como también para aplicar directamente métodos como DPO, que incorporan la relación de preferencia entre respuestas preferidas y no preferidas directamente en la función de objetivo de entrenamiento, sin necesidad de entrenar un modelo de recompensa por separado.
Por lo tanto, el post-entrenamiento de grandes modelos no sigue un procedimiento fijo, y SFT, el modelo de recompensa, PPO, GRPO y DPO desempeñan funciones distintas. SFT se utiliza principalmente para establecer la capacidad básica de seguir instrucciones, el modelo de recompensa proporciona señales de evaluación cuantificables, PPO y GRPO optimizan la estrategia de generación basándose en las señales de recompensa, y DPO aprovecha directamente los datos de preferencia para lograr el alineamiento del modelo. En el proceso de entrenamiento real, no es necesario utilizar todos estos métodos ni combinarlos en un orden idéntico; se seleccionan de forma flexible según las capacidades del modelo, los objetivos de la tarea y los recursos de entrenamiento.
Iniciar sesión unirse a la discusión
SFT, o supervisado fine-tuning, utiliza datos ya preparados de entrada y salida esperada para continuar entrenando el modelo, de modo que al ver entradas similares, aumente la probabilidad de generar la respuesta esperada.
Un dato de SFT puede tener la siguiente forma:
{
  "instruction": "Genera una respuesta de servicio al cliente a partir de la consulta del usuario",
  "input": "Mi membresía se renovó automáticamente ayer y quiero solicitar un reembolso.",
  "output": "Primero ve a la página del pedido para confirmar el estado de la renovación. Si cumple las condiciones de reembolso, puedes solicitarlo en los detalles del pedido; si la página no tiene opción de reembolso, contacta al servicio humano para verificación."
}
Durante el entrenamiento, el tokenizador convierte la instrucción, la entrada y la respuesta en tokens. El modelo predice el siguiente token basándose en los tokens anteriores, y calcula la pérdida a partir de la diferencia entre la predicción y la respuesta esperada. El SFT de grandes modelos generalmente utiliza pérdida de entropía cruzada y entrenamiento con teacher forcing: al entrenar cada posición, el modelo ve el contexto correcto ya proporcionado en los datos, en lugar de sus propios contenidos generados erróneamente. Muchas implementaciones de fine-tuning por instrucción calculan la pérdida solo sobre la parte de la respuesta; la instrucción y la entrada del usuario sirven para proporcionar contexto, pero no se exige que el modelo las regenere.
Lo primero que SFT cambia es el formato de la tarea. El modelo llega a comprender que la entrada es una consulta del usuario y que la salida debe ser una respuesta de atención al cliente, no continuar escribiendo la pregunta del usuario. Para tareas de extracción de información, puede aprender a generar campos JSON fijos; para actas de reuniones, puede aprender a organizar el contenido por información de la reunión, conclusiones clave y acciones a realizar. En segundo lugar, SFT cambia el estilo de respuesta del modelo. El tono, la extensión, la estructura de párrafos, el nivel de explicación y la manera de rechazar responder que aparezcan en los datos de entrenamiento se convierten en patrones que el modelo imita. Si las respuestas esperadas son generalmente concisas, el modelo tenderá a ofrecer conclusiones directamente; si los ejemplos requieren explicar primero el fundamento y luego dar pasos, el modelo también aprenderá esa forma de organizar la información. SFT también puede exponer al modelo a ejemplos de dominio específico. Los datos de atención al cliente con estados de pedido, condiciones de reembolso y escalamiento a servicio humano, la estructura de cláusulas en datos legales, y los patrones de uso de interfaces en datos de código, influyen en la salida del modelo en las tareas correspondientes. Sin embargo, esto no significa que el modelo adquiera automáticamente todo el conocimiento de ese dominio. Solo los patrones cubiertos por los datos de SFT, los términos y formas de procesamiento que incluyan, tendrán la oportunidad de ser aprendidos durante la actualización de parámetros.
El objetivo de entrenamiento de SFT sigue siendo, en esencia, imitar la salida esperada. Puede hacer que el modelo sepa cómo responder habitualmente a este tipo de preguntas, pero no puede garantizar que los hechos en la respuesta hayan sido verificados, ni puede aprender con una sola demostración a comparar todas las respuestas posibles. La misma pregunta sobre reembolsos podría dar lugar a las siguientes dos respuestas:
Respuesta A: Solicita el reembolso en los detalles del pedido; si no puedes hacerlo, contacta al servicio humano.

Respuesta B: Primero puedes revisar el estado del pedido. Si cumple las condiciones de reembolso, puedes solicitarlo en los detalles del pedido; si no hay opción de reembolso, contacta al servicio humano para verificación. El resultado y el plazo del reembolso dependen de la revisión real.
Ambas respuestas están relacionadas con el reembolso, pero la respuesta B añade las condiciones de revisión y evita comprometer un resultado de reembolso determinado. Si el negocio da mayor importancia a la integridad de la información y a los límites de cumplimiento, la respuesta B es más adecuada. SFT puede utilizar la respuesta B como demostración para el modelo, mientras que los datos de preferencia pueden presentar tanto A como B, indicándole explícitamente por qué se prefiere B. Esta es la razón por la que se pasa del aprendizaje supervisado al alineamiento de preferencias.
El enfoque del alineamiento de preferencias no se centra en si el modelo "puede responder", sino en cuál de varias respuestas posibles debería generar preferentemente cuando se enfrenta a múltiples alternativas que podrían ser igualmente válidas. Suele lograrse comparando las ventajas y desventajas de diferentes respuestas ante la misma entrada, transformando requisitos de precisión, relevancia, utilidad, estilo expresivo y seguridad en señales de entrenamiento. En comparación con SFT, que se asemeja a enseñar al modelo "cómo responder" utilizando datos de una entrada correspondiente a una salida esperada para que aprenda el formato de la tarea, la estructura del contenido, la expresión del dominio y el estilo básico de respuesta; el alineamiento de preferencias, una vez que el modelo ya posee cierta capacidad de respuesta, le enseña aún más "cómo responder mejor".
Tomando como ejemplo el escenario de atención al cliente por reembolsos, si una respuesta omite las condiciones de revisión, promete un plazo fijo de acreditación o presenta un resultado incierto como definitivo, puede etiquetarse como una respuesta deficiente. Si otra respuesta es capaz de indicar claramente el procedimiento, mantener los límites necesarios de revisión y no inventar políticas, puede etiquetarse como una respuesta superior. Mediante una gran cantidad de este tipo de entrenamiento comparativo, el modelo aumentará gradualmente la probabilidad de generar respuestas preferidas, tendiendo en preguntas similares a producir resultados que cumplan con los requisitos del negocio. Es importante tener en cuenta que el alineamiento de preferencias no aprende un conjunto abstracto y universal de "valores humanos", sino que, combinado con la función de recompensa, define criterios de evaluación específicos para cada tarea. Diferentes tareas requieren construir patrones de datos de preferencia que se ajusten a la tarea en cuestión. Por lo tanto, antes de construir los datos de preferencia, es necesario definir primero "qué significa mejor", de lo contrario, diferentes anotadores podrían ofrecer selecciones contradictorias debido a diferentes interpretaciones.
Además, el alineamiento de preferencias tampoco puede sustituir la verificación de hechos. Una respuesta podría expresarse con fluidez y un tono amable, pero citar una política errónea; otra respuesta podría ser correcta en cuanto a hechos, pero no seguir el formato de salida requerido. Por lo tanto, el sistema de evaluación real generalmente necesita definir por separado criterios de corrección factual, cumplimiento de la tarea, estilo expresivo y seguridad y cumplimiento normativo. Para el contenido que pueda verificarse automáticamente, también se pueden combinar pruebas de código, verificación de respuestas, comprobación de formato y reglas de negocio para la evaluación, con el fin de reducir el sesgo derivado de depender completamente del juicio subjetivo humano.
Los datos de preferencia (Preference Data) son datos de entrenamiento que le indican al modelo "cuál de varias respuestas es mejor". Su principal diferencia con los datos de SFT radica en que SFT suele proporcionar una entrada y una respuesta esperada, mientras que los datos de preferencia generalmente preparan múltiples respuestas candidatas para el mismo prompt, y anotan la relación de superioridad entre ellas. Los datos de preferencia más comunes constan de una entrada, una respuesta preferida y una respuesta no preferida:
{
  "prompt": "Mi membresía se renovó automáticamente ayer y quiero solicitar un reembolso.",
  "chosen": "Primero revisa el estado del pedido. Si cumple las condiciones de reembolso, puedes solicitarlo en los detalles del pedido; si no hay opción de reembolso, contacta al servicio humano para verificación.",
  "rejected": "Sí, el reembolso se acreditará en tres días hábiles."
}
Donde chosen representa la respuesta más adecuada según los criterios de evaluación actuales, y rejected representa la respuesta menos adecuada. La respuesta no preferida no tiene por qué ser completamente incorrecta; puede que simplemente omita condiciones necesarias, sea excesivamente verbosa, use un tono inapropiado o incluya compromisos sin fundamento. Los datos de preferencia expresan una relación relativa, no una etiqueta permanente de correcto o incorrecto para cada respuesta.
Los datos de preferencia se construyen generalmente siguiendo el siguiente proceso:
Si para la misma entrada se generan cuatro respuestas (A, B, C y D) y el resultado de la anotación es que B es mejor que A, A mejor que D, y D mejor que C, esto puede convertirse en múltiples pares de preferencia. En la construcción real no es necesario enumerar todas las combinaciones posibles. Las respuestas con diferencias muy pequeñas son difíciles de anotar de manera estable, y las con diferencias excesivamente grandes pueden limitar el aprendizaje del modelo a evitar errores graves. Los datos más valiosos suelen provenir de respuestas que son igualmente legibles, pero que presentan diferencias claras en condiciones clave, límites factuales o grado de cumplimiento de la tarea.
Las anotaciones de preferencia son susceptibles a verse influenciadas por factores superficiales. Una respuesta más larga parece más completa, una redactada con más confianza parece más fiable, y un candidato colocado primero también puede ser preferido con mayor facilidad. Para reducir estos sesgos, se puede aleatorizar el orden de los candidatos, ocultar los nombres de los modelos, solicitar a los anotadores que verifican por separado los hechos, el cumplimiento de la tarea, el estilo y la seguridad, y asignar a varias personas la tarea de anotar de forma repetida en algunas muestras. Si en un mismo lote de datos los anotadores suelen tener opiniones opuestas, esto suele indicar que los criterios de evaluación no están lo suficientemente claros, y no se debe simplemente eliminar la opinión minoritaria.
Los datos de preferencia ya han representado la relación "cuál de varias respuestas ante el mismo prompt es mejor" como una relación relativa entre chosen y rejected. La función del modelo de recompensa (Reward Model, RM) es utilizar estos datos de preferencia para aprender una función de puntuación automática, convirtiendo los resultados de la comparación humana en señales de recompensa utilizables por los algoritmos de aprendizaje por refuerzo posteriores. Los modelos de recompensa más comunes se basan en un modelo de lenguaje, añadiendo en la última capa una capa de puntuación que produce un escalar. Durante el entrenamiento, el prompt y la respuesta se concatenan en una secuencia, pasan por el modelo para obtener estados ocultos, y la capa de puntuación produce un valor numérico.
El modelo de recompensa no necesita saber cuántos puntos debe obtener cada respuesta individualmente; solo necesita aprender una relación relativa: para este prompt, la puntuación de chosen debe ser superior a la de rejected. Por lo tanto, durante el entrenamiento suele concatenar el prompt con cada una de las dos respuestas candidatas por separado y pasarlas por el modelo de recompensa:
Prompt + chosen   → rchosen
Prompt + rejected → rrejected
Donde rchosen y rrejected son las dos puntuaciones escalares producidas por el modelo de recompensa. El objetivo del entrenamiento es que la puntuación de la respuesta preferida sea superior a la de la no preferida. La pérdida de clasificación por pares más común se puede expresar como:
\mathcal{L} = -\log \sigma\left(r_{\text{chosen}} - r_{\text{rejected}}\right)
Donde r_chosen y r_rejected representan las puntuaciones del modelo de recompensa para la respuesta preferida y la no preferida, respectivamente, y σ transforma la diferencia de puntuación en un valor entre 0 y 1. Cuanto mayor sea la puntuación de la respuesta preferida y menor la de la no preferida, menor será la pérdida. Tras un entrenamiento con un gran número de pares de preferencia, el modelo de recompensa puede realizar evaluaciones relativas sobre respuestas que no ha visto.
El modelo de recompensa se basa generalmente en un modelo de lenguaje y añade una capa de puntuación que produce un escalar. Su entrada sigue siendo el texto del prompt y la respuesta, pero su salida ya no es el siguiente token, sino una puntuación de recompensa que representa la calidad relativa. Esta puntuación no tiene un significado físico unificado y no puede interpretarse directamente como "porcentaje de aciertos" o "una calificación sobre 10". Lo verdaderamente significativo es la comparación de puntuaciones entre diferentes respuestas bajo el mismo modelo de recompensa. Por ejemplo, si una respuesta obtiene 6 puntos y otra 4, esto solo indica que, según el modelo de recompensa actual, la primera se ajusta más a los criterios de preferencia, no que objetivamente tenga "una calidad de 6 puntos".
Lo que el modelo de recompensa puede aprender depende en gran medida de los datos de preferencia construidos previamente. Si en los datos de preferencia los anotadores siempre tienden a elegir respuestas más largas, el modelo de recompensa puede confundir longitud con calidad; si los anotadores prestan demasiada atención a la fluidez del lenguaje, también puede otorgar puntuaciones elevadas a respuestas con una redacción pulida pero con errores factuales. Por lo tanto, el modelo de recompensa no comprende realmente cuál es la respuesta correcta, sino que imita los patrones de evaluación reflejados en los datos de preferencia. Esta es la razón por la que, una vez entrenado el modelo de recompensa, no basta con observar la pérdida de entrenamiento, sino que es necesario realizar una evaluación independiente.
Precisamente porque el modelo de recompensa solo se encarga de "evaluar" y no modifica directamente el modelo de lenguaje, en las fases posteriores de aprendizaje por refuerzo como PPO o GRPO, el modelo de lenguaje sigue generando nuevas respuestas, el modelo de recompensa las puntúa, y el algoritmo de aprendizaje por refuerzo actualiza los parámetros del modelo en función de los resultados de recompensa, haciendo que el modelo aumente gradualmente la probabilidad de generar respuestas con alta recompensa. Es importante tener en cuenta que, si el modelo de política descubre que ciertos patrones superficiales le permiten obtener puntuaciones elevadas de forma estable, puede explotar estos patrones repetidamente en lugar de mejorar realmente su capacidad en la tarea. Este fenómeno se conoce habitualmente como reward hacking. Por lo tanto, el modelo de recompensa no solo debe ser capaz de distinguir entre respuestas buenas y malas en los datos de entrenamiento, sino que también debe evitar en la medida de lo posible dejarse "engañar" por características superficiales como la longitud, frases prefijadas, plantillas de formato, etc.
RLHF (Reinforcement Learning from Human Feedback), o aprendizaje por refuerzo basado en retroalimentación humana, describe cómo la retroalimentación humana incorpora al entrenamiento por refuerzo. Es un marco de entrenamiento, no un algoritmo de optimización concreto ni una arquitectura de modelo fija.
El RLHF clásico generalmente incluye tres etapas:
La línea clásica de RLHF se divide en tres etapas consecutivas, como se muestra en la siguiente imagen. En la primera etapa, los anotadores redactan respuestas de demostración, y se utiliza SFT con estos datos. En la segunda etapa, el modelo genera múltiples respuestas para el mismo prompt, los anotadores las clasifican, y se utiliza la información comparativa para entrenar el modelo de recompensa. En la tercera etapa, el modelo de política genera nuevas respuestas, el modelo de recompensa calcula las puntuaciones y se utiliza PPO para actualizar la política. Los tres tipos de datos desempeñan funciones diferentes: los datos de demostración enseñan al modelo cómo responder, los datos comparativos enseñan al modelo de recompensa cómo evaluar, y los prompts y las señales de recompensa se utilizan para el aprendizaje por refuerzo.
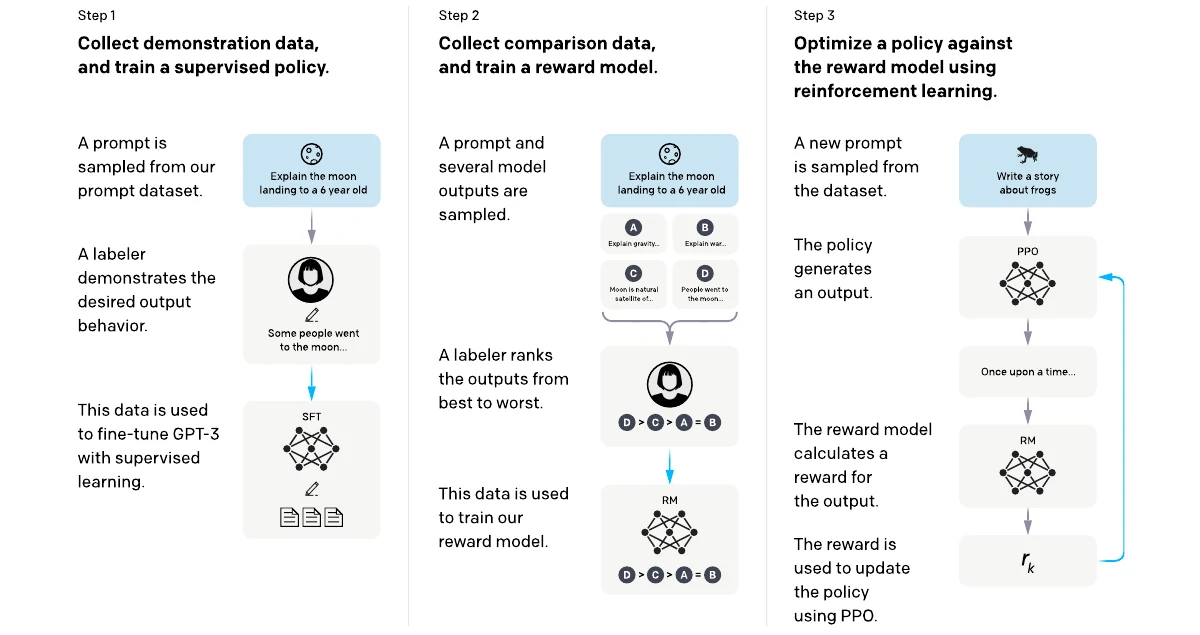
Situando este proceso en el marco del aprendizaje por refuerzo, el modelo de lenguaje es el modelo de política, el prompt y los tokens ya generados conforman el estado actual, la selección del siguiente token por parte del modelo equivale a realizar una acción, y desde el inicio de la respuesta hasta la generación del token de fin se completa una trayectoria completa.
En RLHF, el modelo de recompensa suele otorgar una puntuación global tras finalizar la respuesta, y el algoritmo de aprendizaje por refuerzo determina qué probabilidades de selección de tokens deben aumentarse. En el entrenamiento de RLHF también se suele conservar un modelo de referencia. El modelo de referencia es generalmente un modelo SFT congelado, que sirve para restringir que el modelo de política en entrenamiento se desvíe demasiado de su capacidad lingüística original.
PPO (Proximal Policy Optimization), u optimización de políticas cercanas, es un algoritmo de gradiente de política cuyo objetivo principal es, al mismo tiempo que aumenta la recompensa, limitar la magnitud de cada actualización de parámetros. Los grandes modelos tienen una gran cantidad de parámetros; si la política se modificara drásticamente porque un lote de respuestas obtenga puntuaciones altas, el modelo podría sesgarse rápidamente hacia un pequeño conjunto de patrones de recompensa, e incluso dañar su capacidad lingüística original. La palabra "proximal" en PPO enfatiza que la nueva política debe actualizarse de forma gradual alrededor de la política anterior. En el post-entrenamiento de grandes modelos, un ciclo de PPO suele incluir dos etapas. La primera es la de muestreo: se extrae un lote de entradas del conjunto de prompts, se genera una respuesta con el modelo de política actual, se guarda la probabilidad de cada token bajo la política anterior, y el modelo de recompensa otorga una puntuación. La segunda es la de actualización: se calculan las ventajas en función de las recompensas y las estimaciones de valor, y se utilizan estas muestras para actualizar el modelo de política y el modelo de valor. Tras completar varias actualizaciones por lotes pequeños, se regeneran los datos con la nueva política.
PPO necesita comparar la probabilidad que la nueva y la antigua política asignan al mismo token. La razón de probabilidades puede simplificarse como:
r_t(\theta)
=
\frac{\text{Probabilidad de que la nueva política seleccione el token actual}}
{\text{Probabilidad de que la antigua política seleccione el token actual}}
Donde rₜ representa el valor calculado,
θ representa el modelo que se optimiza.
Cuando rₜ está cerca de 1, indica que la diferencia entre la nueva y la antigua política es pequeña; cuando rₜ es significativamente mayor que 1, indica que la nueva política favorece el token actual; cuando rₜ es significativamente menor que 1, indica que la nueva política ha reducido su probabilidad. Solo la variación de la probabilidad no es suficiente; también se necesita la ventaja Aₜ para determinar si la selección de este token es mejor o peor que el nivel promedio actual. Cuando la ventaja es positiva, se debe aumentar la probabilidad de esa selección; cuando es negativa, se debe reducir.
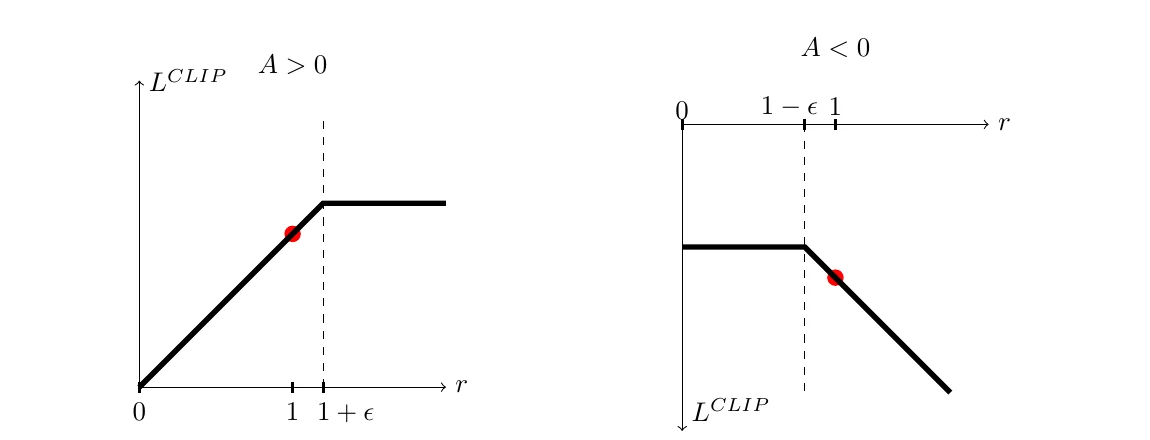
En la imagen anterior, el lado izquierdo representa el caso de ventaja positiva. A medida que la razón de probabilidades aumenta desde 1 hacia la derecha, el objetivo aumenta inicialmente; una vez que supera 1+ε, la curva se aplana y seguir aumentando la probabilidad de ese token ya no incrementa el objetivo. El lado derecho representa el caso de ventaja negativa. Cuando la razón de probabilidades cae por debajo de 1-ε, el objetivo también deja de mejorar. Ambas curvas ilustran que PPO permite ajustar la política en la dirección correcta, pero atenúa la ganancia adicional que podrían suponer actualizaciones demasiado grandes.
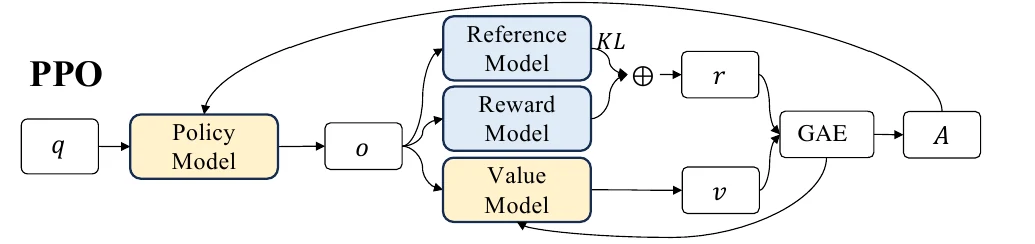
Un entrenamiento típico de PPO para grandes modelos requiere mantener simultáneamente varios componentes: el modelo de política, encargado de generar y recibir actualizaciones; la política anterior, que es una instantánea de los parámetros de la política durante el muestreo, utilizada para calcular la razón de probabilidades; el modelo de referencia, un modelo SFT congelado para calcular la restricción KL; el modelo de recompensa, que evalúa las respuestas completas; y el modelo de valor, que estima las recompensas futuras esperadas en cada posición generada. Debido a la diferencia entre la estimación del modelo de valor y la recompensa real, PPO utiliza métodos como GAE para transformar esas diferencias en ventajas para cada token. El flujo general de PPO se muestra en la siguiente imagen. El modelo de política genera una respuesta o a partir de la entrada q, el modelo de recompensa y el modelo de referencia conjuntamente forman la recompensa r, el modelo de valor proporciona la estimación de valor v, y luego se calcula la ventaja A mediante GAE. El modelo de política se actualiza en función de la ventaja y del objetivo recortado, mientras que el modelo de valor aprende estimaciones de recompensa más precisas a través de la pérdida de valor.
GRPO (Group Relative Policy Optimization), u optimización de políticas relativa por grupo, es una variante de PPO que mantiene ideas como el muestreo de políticas, el recorte de razones de probabilidades y la restricción KL, pero con el cambio principal de no entrenar un modelo de valor por separado, sino utilizar las puntuaciones relativas de múltiples respuestas bajo el mismo prompt para estimar las ventajas. El marco general de GRPO se muestra en la siguiente imagen. Para una misma entrada q, el modelo de política genera un grupo de respuestas o₁ a oG, y el modelo de recompensa o un sistema basado en reglas otorga r₁ a rG respectivamente.
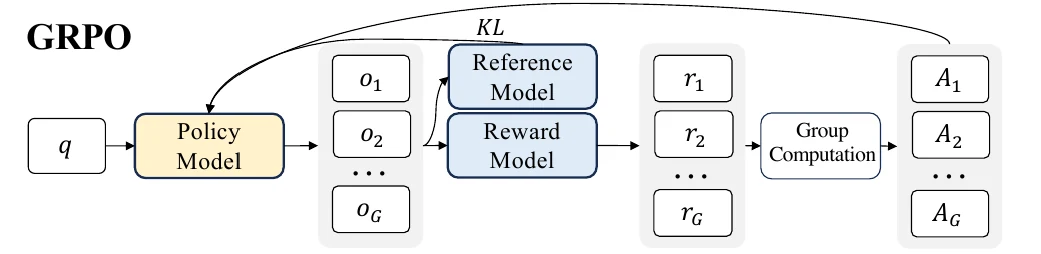
El sistema calcula primero la media y la desviación estándar de este grupo de recompensas, y luego convierte la puntuación de cada respuesta en una ventaja relativa dentro del grupo: las respuestas con una puntuación superior a la media del grupo obtienen ventaja positiva, y las que están por debajo obtienen ventaja negativa. Para tareas donde la recompensa solo se otorga al final de la respuesta, los tokens dentro de una misma respuesta comparten la ventaja obtenida por esa respuesta; si también se proporciona recompensa por proceso, se pueden formar retroalimentaciones más detalladas a nivel de token. A continuación, GRPO compara las probabilidades de la nueva y la antigua política como PPO, y actualiza el modelo de política mediante el objetivo recortado y la restricción KL.
En comparación con PPO, GRPO reduce los parámetros, la memoria de video y la carga computacional derivados del modelo de valor, pero esto no implica que el coste de entrenamiento sea necesariamente bajo. Cada prompt requiere generar múltiples respuestas, y el propio proceso de muestreo por inferencia consume una gran cantidad de recursos de cómputo. Si todas las respuestas del mismo grupo obtienen la misma puntuación, la desviación estándar se acerca a 0, y la comparación dentro del grupo dificulta proporcionar una dirección eficaz; la implementación real debe omitir, suavizar o remuestrear este tipo de datos. El tamaño del grupo, la temperatura de muestreo, la escala de recompensa y el coeficiente KL también afectan la estabilidad del entrenamiento. Por ejemplo, si un problema matemático genera cuatro soluciones, dos correctas, una con error de cálculo y una incompleta, el sistema puede utilizar reglas de verificación de respuestas para puntuarlas y luego compararlas dentro del grupo de cuatro. Las respuestas correctas y completas obtienen una ventaja alta, y las incorrectas o incompletas una ventaja baja, y el modelo aumenta la probabilidad de las mejores soluciones en consecuencia. Las tareas de código también pueden utilizar resultados de compilación y pruebas unitarias como recompensa, sin necesidad de entrenar previamente un modelo de recompensa dedicado.
DPO (Direct Preference Optimization), u optimización directa de preferencias, plantea en el título de su artículo que el modelo de preferencias puede que no sea necesario, y que el propio gran modelo de lenguaje que construimos podría ser el modelo de preferencias latente. Esta idea abandona directamente el modelado separado del modelo de preferencias y, partiendo del modelo original, añade una función de pérdida diseñada específicamente para el modelo de preferencias, de modo que la optimización de los resultados generados por el modelo se vea aún más mejorada. DPO entrena directamente el modelo de lenguaje utilizando las respuestas preferidas y no preferidas ya recopiladas, sin necesidad de entrenar explícitamente un modelo de recompensa ni de ejecutar un bucle de aprendizaje por refuerzo en línea como en PPO o GRPO.
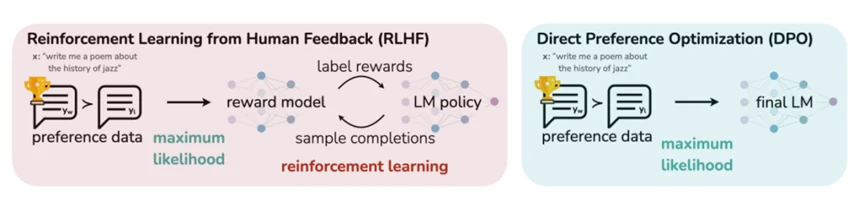
La imagen anterior compara la línea clásica de RLHF con DPO. En la línea clásica, los datos de preferencia se utilizan primero para entrenar el modelo de recompensa, el modelo de política genera nuevas respuestas, y se realiza aprendizaje por refuerzo basándose en las puntuaciones del modelo de recompensa. En la línea de DPO, los datos de preferencia se introducen directamente en el entrenamiento del modelo de lenguaje. Ambas líneas parten de la relación de superioridad entre respuestas, pero los pasos de entrenamiento y los requisitos de recursos son diferentes. El flujo general de DPO requiere solo dos etapas:
En la primera etapa, se construyen muestras de ejemplos positivos y negativos de preferencia. Este paso modifica el enfoque anterior de construcción de muestras de fine-tuning, transformando el conjunto de datos de "entrada (Input) - salida (Output)" en "entrada (Input) - respuesta positiva (Accept Response) - respuesta negativa (Negative Response)". Este método de aprendizaje con muestras no es una invención nueva; proviene del aprendizaje contrastivo que surgió en el ámbito del procesamiento de imágenes. Los investigadores de aprendizaje contrastivo descubrieron que cuando el modelo aprende simultáneamente con ejemplos positivos y negativos, puede converger rápidamente y mejorar su rendimiento general.
En la segunda etapa, basándose en la función de pérdida diseñada y utilizando métodos relacionados con el aprendizaje contrastivo, se optimizan los parámetros del modelo generativo original mediante la función de verosimilitud máxima. Este diseño elimina tanto el modelo de preferencias por recompensa como todo el proceso de entrenamiento por aprendizaje por refuerzo, aumentando la eficiencia y mejorando significativamente la precisión y la estabilidad en comparación con PPO. Mediante la optimización de la segunda etapa, los parámetros del modelo se ajustan progresivamente en la dirección de acercarse a los ejemplos positivos y alejarse de los negativos, logrando finalmente el alineamiento de preferencias del modelo hacia el contenido de los ejemplos positivos.
El formato de entrenamiento de DPO es similar al SFT normal. Los datos de entrenamiento ya contienen el prompt, la respuesta preferida y la no preferida; el modelo no necesita regenerar candidatos en cada paso ni ejecutar simultáneamente el modelo de recompensa y el modelo de valor. Por lo tanto, pertenece a la optimización de preferencias fuera de línea, con menos componentes y una complejidad de memoria de video e ingeniería generalmente inferior a la de PPO. Esta simplificación no elimina los requisitos de calidad de los datos. DPO solo puede aprender las diferencias ya presentes en los datos de preferencia. Si la respuesta preferida tiene errores factuales, la no preferida es demasiado deficiente, o los datos provienen principalmente de una distribución de generación muy diferente a la del modelo actual, el modelo podría aprender estilos superficiales en lugar de la capacidad objetivo. Tampoco explora continuamente nuevas respuestas como el aprendizaje por refuerzo en línea, ni obtiene retroalimentación sobre los nuevos problemas que surjan.
En las secciones anteriores se han presentado por separado los principios básicos y los métodos de entrenamiento de RLHF, PPO, GRPO y DPO. Para comprender con mayor claridad sus relaciones, se pueden comparar desde varios ángulos: la posición del método en el marco general, si el entrenamiento requiere generar respuestas en línea, y si depende de un modelo de recompensa y un modelo de valor. Mediante esta comparación transversal, se pueden observar de manera más directa las diferencias principales entre los diferentes métodos de post-entrenamiento en cuanto a ruta de implementación, coste de entrenamiento y forma de aplicación. La siguiente tabla muestra la comparación de los modelos relacionados.
Concepto | Pertenece a | ¿Se generan nuevas respuestas durante el entrenamiento? | ¿Se necesita un modelo de recompensa explícito? | ¿Se necesita un modelo de valor? | Características principales |
RLHF | Marco de retroalimentación y aprendizaje por refuerzo | Generalmente sí | En la línea clásica, sí | Depende del algoritmo de optimización utilizado | Establece cómo se conectan la retroalimentación humana, la recompensa y la actualización de la política |
PPO | Algoritmo de aprendizaje por refuerzo en línea | Sí | Generalmente sí en RLHF clásico | Sí | Estabiliza la actualización de la política mediante estimación de valor y recorte de razones de probabilidades |
GRPO | Algoritmo de aprendizaje por refuerzo en línea | Sí; para el mismo prompt se genera un grupo de respuestas | Puede usar un modelo de recompensa o recompensa basada en reglas | No | Estima las ventajas mediante recompensas relativas dentro del grupo |
DPO | Método de optimización de preferencias fuera de línea | Generalmente no se genera en línea | No requiere entrenamiento por separado | No | Aumenta directamente la probabilidad de la respuesta preferida respecto a la no preferida |
En conjunto, aunque RLHF, PPO, GRPO y DPO están todos relacionados con el alineamiento de preferencias de grandes modelos, no resuelven exactamente el mismo problema. RLHF se acerca más a un marco completo de retroalimentación y aprendizaje por refuerzo; PPO y GRPO son algoritmos de aprendizaje por refuerzo en línea utilizados en este tipo de marco para actualizar el modelo de política; y DPO aprovecha directamente los datos de preferencia disponibles para realizar la optimización fuera de línea. Desde la perspectiva del mecanismo de entrenamiento, PPO depende de un modelo de recompensa y un modelo de valor, lo que supone una cadena de ingeniería más completa, pero también implica un mayor coste de entrenamiento y complejidad de implementación; GRPO estima las ventajas mediante recompensas relativas dentro del grupo, prescindiendo del modelo de valor, lo que lo hace más adecuado para tareas con recompensa basada en reglas, verificación de respuestas u otros tipos de retroalimentación claramente definidos; DPO no requiere generar respuestas en línea ni entrenar por separado un modelo de recompensa y un modelo de valor, por lo que su implementación es relativamente sencilla y puede servir como una solución de alineamiento de bajo coste cuando se disponga de datos de preferencia suficientes.
En la práctica, la selección del método debe partir de las capacidades que el modelo carece en ese momento, en lugar de seguir simplemente un algoritmo de entrenamiento particular. Si el modelo aún no puede completar las tareas de manera estable, se debe priorizar el establecimiento de capacidades básicas mediante SFT; si el modelo ya puede completar las tareas pero la calidad de sus respuestas y su selección de preferencias son inestables, se pueden emplear DPO, PPO o GRPO de forma adicional. Si ya se dispone de datos de preferencia de alta calidad y se desea completar rápidamente la primera ronda de alineamiento, se puede priorizar DPO; si la tarea tiene recompensas verificables y se desea que el modelo explore activamente soluciones mejores, se puede considerar GRPO; y si se dispone de un modelo de recompensa, un modelo de valor y una infraestructura de aprendizaje por refuerzo consolidados, y se necesita un control fino de la actualización de la política en línea, se puede adoptar PPO. Independientemente del método elegido, no se puede evaluar su efectividad únicamente con la pérdida de entrenamiento, la puntuación de recompensa o la tasa de victoria de preferencias, sino que se debe volver a las tareas reales para evaluar continuamente la precisión, el cumplimiento de la tarea, la seguridad, los límites del negocio y las capacidades generales del modelo. El objetivo último del post-entrenamiento no es obtener una mayor recompensa, sino que el modelo sea capaz de completar las tareas objetivo de manera más estable y fiable en su entorno de uso real.
En las secciones anteriores se han presentado los principios básicos del alineamiento de preferencias y del aprendizaje por refuerzo. A continuación, se realizarán dos experimentos concretos utilizando ms-swift. El primer experimento utiliza datos de preferencia en chino para un entrenamiento DPO, observando cómo cambian las preferencias del modelo respecto a las respuestas preferidas y no preferidas; el segundo experimento utiliza problemas matemáticos para un entrenamiento GRPO, haciendo que el modelo genere respuestas candidatas que luego se evalúan según la respuesta correcta y el formato. Ambos experimentos utilizan como modelo inicial Qwen2.5-0.5B-Instruct, que ya posee capacidad de seguir instrucciones, y entrenan un adaptador LoRA independiente para cada caso.
Este experimento se realiza en un entorno de GPU de una sola tarjeta en el cuaderno de ModelScope, con el modelo y los archivos de datos originales descargados de la comunidad ModelScope. La configuración de ambos experimentos es la siguiente:
Elemento | DPO: Alineamiento de preferencias en chino | GRPO: Optimización de respuestas matemáticas |
Modelo inicial | Qwen/Qwen2.5-0.5B-Instruct | Los mismos pesos de Qwen2.5-0.5B-Instruct |
Conjunto de datos | AI-ModelScope/hh_rlhf_cn | AI-ModelScope/gsm8k |
Subconjunto utilizado | helpful_base_cn | main |
Conjunto de entrenamiento | 256 pares de preferencia | 128 ejercicios |
Conjunto de validación | 32 pares de preferencia | 16 ejercicios |
Conjunto de pruebas | 32 pares de preferencia | Las 1319 ejercicios del archivo de pruebas oficial |
Método de entrenamiento | LoRA, 20 pasos de actualización del optimizador | LoRA, 10 pasos de actualización del optimizador |
Retroalimentación durante el entrenamiento | Respuestas preferidas y no preferidas proporcionadas en los datos | El modelo genera respuestas y la recompensa se calcula mediante reglas |
La escala de entrenamiento aquí es pequeña y se utiliza principalmente para demostrar el flujo completo. Los pasos de entrenamiento representan el número de actualizaciones de parámetros del optimizador, no equivalen a épocas de entrenamiento ni indican que todos los datos de entrenamiento se hayan utilizado una vez. Esta parte práctica solo utiliza una pequeña porción de los datos y un número reducido de iteraciones; el experimento es solo referencial.
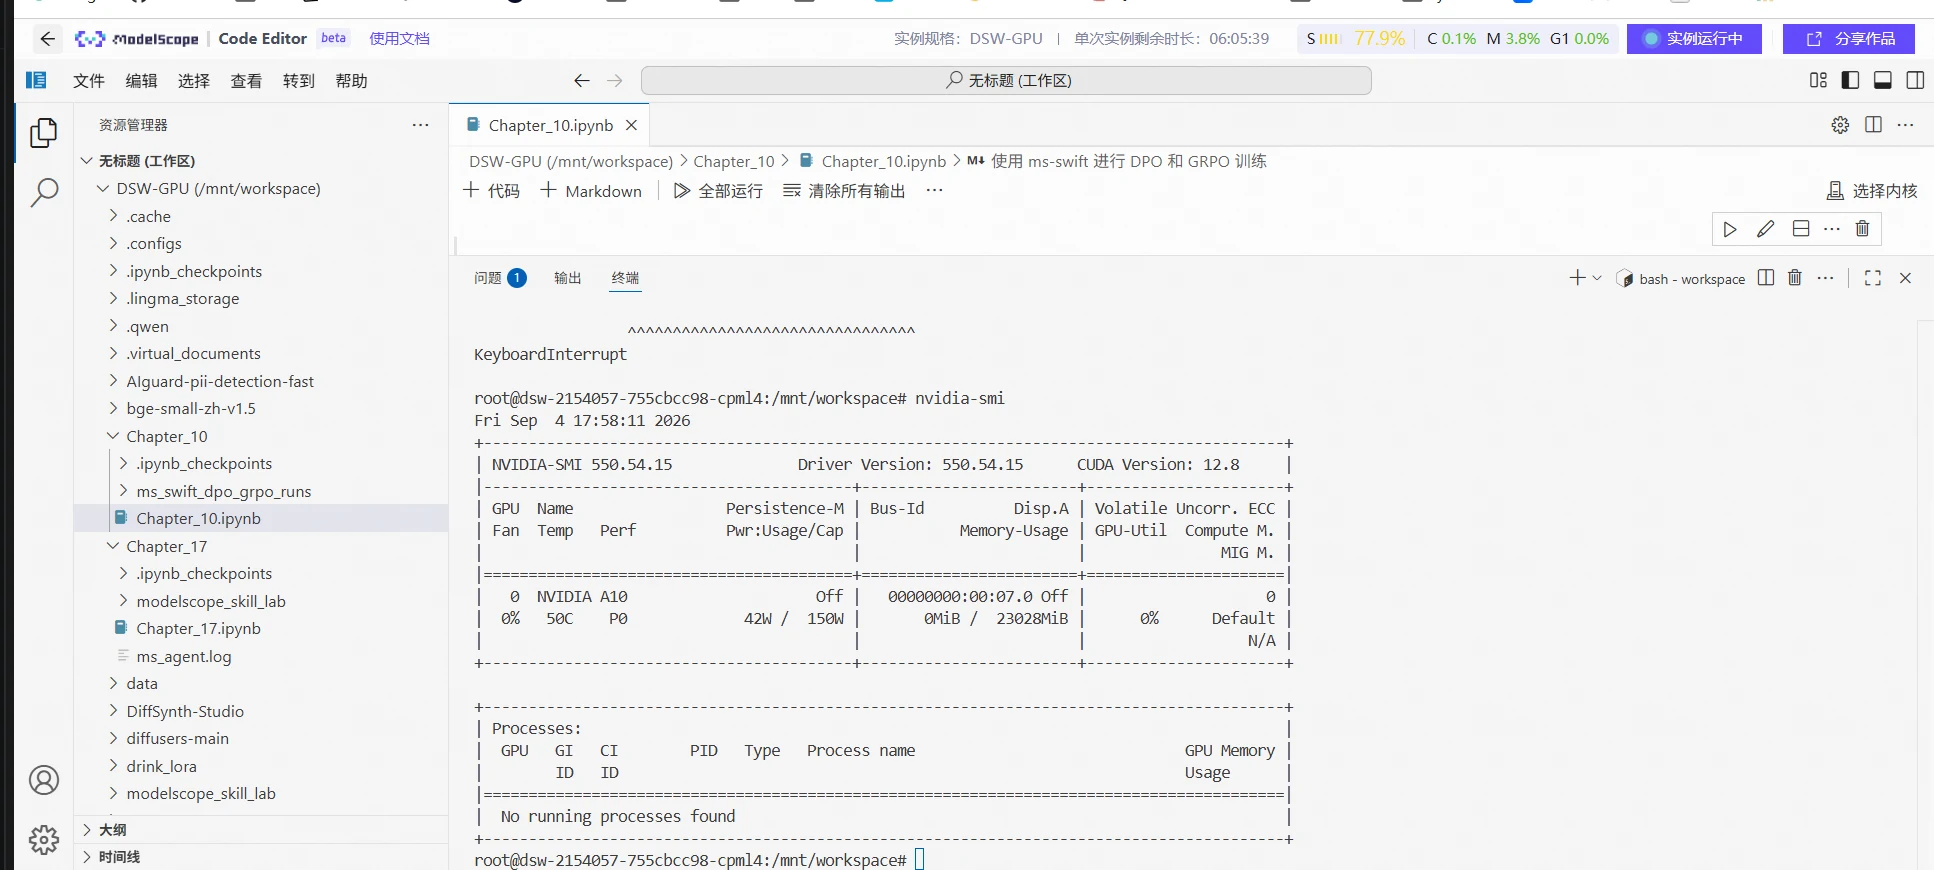
1)Revisar el entorno de ejecución.
Al abrir el cuaderno adjunto, primero se debe verificar si la GPU está disponible y las versiones de software reales que utiliza el kernel actual.
2)Preparar el modelo y los directorios de ejecución.
La preparación común establece un directorio de caché y el directorio de este experimento. El código principal de configuración del modelo es el siguiente:
MODEL_ID = "Qwen/Qwen2.5-0.5B-Instruct"
MODEL_REVISION = "master"
DPO_DATA_ID = "AI-ModelScope/hh_rlhf_cn"
GRPO_DATA_ID = "AI-ModelScope/gsm8k"
SEED = 42

MODEL_DIR = Path(snapshot_download(
    MODEL_ID,
    revision=MODEL_REVISION,
    cache_dir=str(CACHE_DIR / "models"),
    allow_file_pattern=[
        "*.json", "*.safetensors", "*.txt", "*.model", "*.tiktoken"
    ],
).resolve()
Donde snapshot_download proviene de ModelScope y CACHE_DIR se establece con el código de preparación común. Una vez completada la descarga, tanto el entrenamiento como la inferencia utilizan la instantánea local del modelo a la que apunta MODEL_DIR. El contenido de esta práctica se guardará en el directorio ms_swift_dpo_grpo_runs/. Al volver a ejecutar, el programa generará un nuevo número de experimento; los usuarios deben utilizar su propio directorio de ejecución para la variable RUN_DIR posterior. DPO
DPO requiere dos respuestas candidatas en el mismo contexto. El experimento utiliza el subconjunto helpful_base_cn del conjunto de datos HH-RLHF en chino, donde context almacena el historial de la conversación, chosen la respuesta preferida, y rejected la respuesta no preferida. Las etiquetas de preferida y no preferida provienen de las anotaciones del conjunto de datos y no implican que los hechos en las respuestas hayan sido verificados uno por uno.
1)Convertir al formato de datos utilizado por ms-swift.
La estructura de las muestras de preferencia que utiliza ms-swift es la siguiente. A continuación se muestra solo la relación de campos; el contenido real se lee del conjunto de datos:
{
  "messages": [
    {"role": "user", "content": "La misma pregunta"},
    {"role": "assistant", "content": "Respuesta preferida"}
  ],
  "rejected_response": "Respuesta no preferida"
}
En comparación con las muestras de SFT del tutorial "Uso rápido de ms-swift para fine-tuning ligero de modelos open-source", aquí se añade rejected_response. El último mensaje del asistente en messages almacena la respuesta preferida, y la respuesta no preferida se coloca en un campo separado. Los mensajes anteriores del asistente en diálogos de varias vueltas siguen formando parte del contexto y no deben confundirse con las respuestas de esta comparación. La función de conversión en el cuaderno es la siguiente:
def convert_dpo(row):
    role_map = {
        "human": "user", "user": "user",
        "assistant": "assistant", "system": "system"
    }
    context = [
        {"role": role_map[m["role"]], "content": m["text"].strip()}
        for m in row["context"]
    ]
    chosen = row["chosen"]["text"].strip()
    rejected = row["rejected"]["text"].strip()

    assert context and context[-1]["role"] == "user"
    assert chosen and rejected and chosen != rejected
    assert all(m["content"] for m in context)
    if context[0]["role"] != "system":
        context.insert(0, {"role": "system", "content": GENERAL_SYSTEM})

    return {
        "messages": context + [{"role": "assistant", "content": chosen}],
        "rejected_response": rejected,
    }
2)Limpiar y dividir los datos.
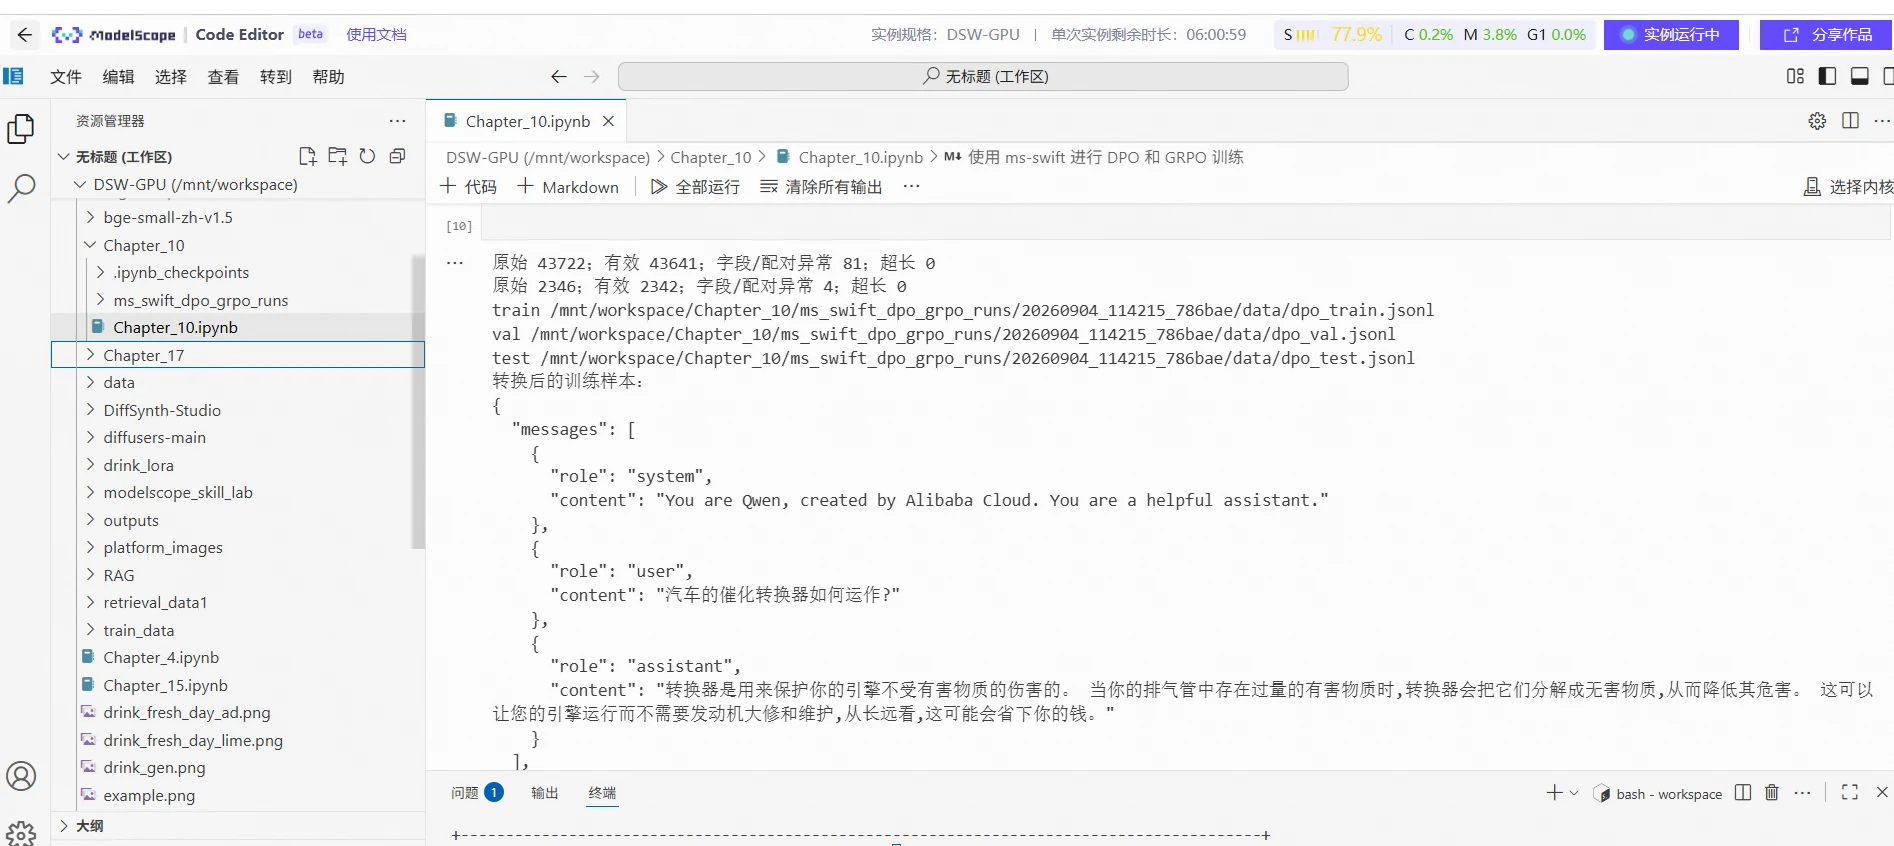
Se calcula la longitud de cada respuesta (preferida y no preferida) concatenada con el contexto, y solo se conservan las muestras en las que ambas no superen los 1024 tokens. Cuando alguna excede el límite, se descarta el par completo para evitar que el recorte elimine accidentalmente el contenido clave que determina la superioridad de la respuesta. A continuación, se deduplica por contexto y se dividen 256 datos de entrenamiento y 32 de validación a partir de la fuente de entrenamiento original. Los archivos resultantes son dpo_train.jsonl, dpo_val.jsonl y dpo_test.jsonl, almacenados en la carpeta data del directorio de ejecución. Los tres archivos desempeñan funciones distintas: el conjunto de entrenamiento se utiliza para actualizar los parámetros, el de validación para observar el proceso de entrenamiento y el de pruebas para una comparación independiente tras el entrenamiento. Los resultados de ejecución relevantes se muestran en la siguiente imagen.
Antes del entrenamiento, se registra el rendimiento del modelo inicial en el conjunto de pruebas. La función dpo_evaluate() del cuaderno calcula el logaritmo de la probabilidad de las respuestas para los 32 pares de candidatos fijos y genera respuestas para 4 contextos, para su comparación posterior al entrenamiento:
def dpo_evaluate(adapter=None):
    def action(model):
        rows = []
        for index, row in enumerate(dpo_test):
            context = row["messages"][:-1]
            lp_chosen = response_logp(model, context, row["messages"][-1]["content"])
            lp_rejected = response_logp(model, context, row["rejected_response"])
            rows.append({"sample_id": index, "chosen_logp": lp_chosen,
                         "rejected_logp": lp_rejected, "gap": lp_chosen - lp_rejected})
        # Solo se generan 4 respuestas para una lectura detallada; el resto de pares de candidatos siguen participando en el diagnóstico de probabilidades.
        generations = [{"sample_id": i, "context": dpo_test[i]["messages"][:-1],
                        "response": generate_one(model, dpo_test[i]["messages"][:-1])}
                       for i in range(min(4, len(dpo_test))]
        return rows, generations
    return with_local_model(action, adapter)

dpo_before, dpo_before_text = dpo_evaluate()
Los pasos relacionados para iniciar el entrenamiento DPO son los siguientes:
1)Establecer los parámetros de entrenamiento.
Ambos experimentos reutilizan la configuración común a través de common_options(), incluyendo la ruta local del modelo, la plantilla de diálogo Qwen, la semilla aleatoria, la precisión bfloat16 y la configuración LoRA. El rank de LoRA es 8, alpha es 16, y los módulos objetivo son all-linear. A continuación se muestra la configuración completa del experimento DPO; la función común debe ejecutarse primero en el cuaderno adjunto. La función common_options() combina los parámetros comunes con los de este experimento. train_swift convierte estos parámetros a formato de línea de comandos e invoca swift.cli.rlhf a través de Python en el kernel actual para entrenar el modelo.
DPO_OUTPUT = RUN_DIR / "dpo"
DPO_BETA = 0.1
dpo_options = common_options() | {
    "rlhf_type": "dpo", "loss_type": "sigmoid", "beta": DPO_BETA,
    "dataset": str(DPO_PATHS["train"]),
    "val_dataset": str(DPO_PATHS["val"]),
    "output_dir": str(DPO_OUTPUT), "max_length": 1024,
    "truncation_strategy": "delete", "max_steps": 20,
    "learning_rate": 5e-5, "lr_scheduler_type": "cosine",
    "warmup_ratio": 0.1,
    "per_device_train_batch_size": 1,
    "per_device_eval_batch_size": 1,
    "gradient_accumulation_steps": 8,
    "eval_strategy": "steps", "eval_steps": 10,
    "save_strategy": "steps", "save_steps": 10,
}
train_swift(dpo_options, RUN_DIR / "dpo_train.log")
DPO_ADAPTER = latest_adapter(DPO_OUTPUT)
El significado de los principales parámetros es el siguiente:
Parámetro | Valor en este experimento | Función |
rlhf_type / loss_type | dpo / sigmoid | Utiliza el objetivo DPO en formato estándar sigmoid |
beta | 0.1 | Controla la escala respecto a la política de referencia en el objetivo DPO |
learning_rate | 5e-5 | Controla la magnitud de cada actualización de parámetros |
max_length | 1024 | Limita la longitud total del contexto y las respuestas candidatas |
per_device_train_batch_size | 1 | Cada mini-lote de entrenamiento en una tarjeta procesa 1 par de preferencia |
gradient_accumulation_steps | 8 | Acumula 8 mini-lotes antes de actualizar los parámetros una vez |
max_steps | 20 | Finaliza el entrenamiento tras completar 20 actualizaciones del optimizador |
eval_steps / save_steps | 10 / 10 | Realiza validación y guarda puntos de control cada 10 pasos |
2)Revisar la salida del entrenamiento.
Una vez iniciado el entrenamiento, ms-swift muestra la pérdida, las recompensas implícitas, las métricas de validación y la ubicación de los puntos de control guardados. Tras finalizar el entrenamiento, el modelo se guardará en el directorio dpo/checkpoint. Los resultados del entrenamiento y guardado del modelo se muestran en la siguiente imagen.
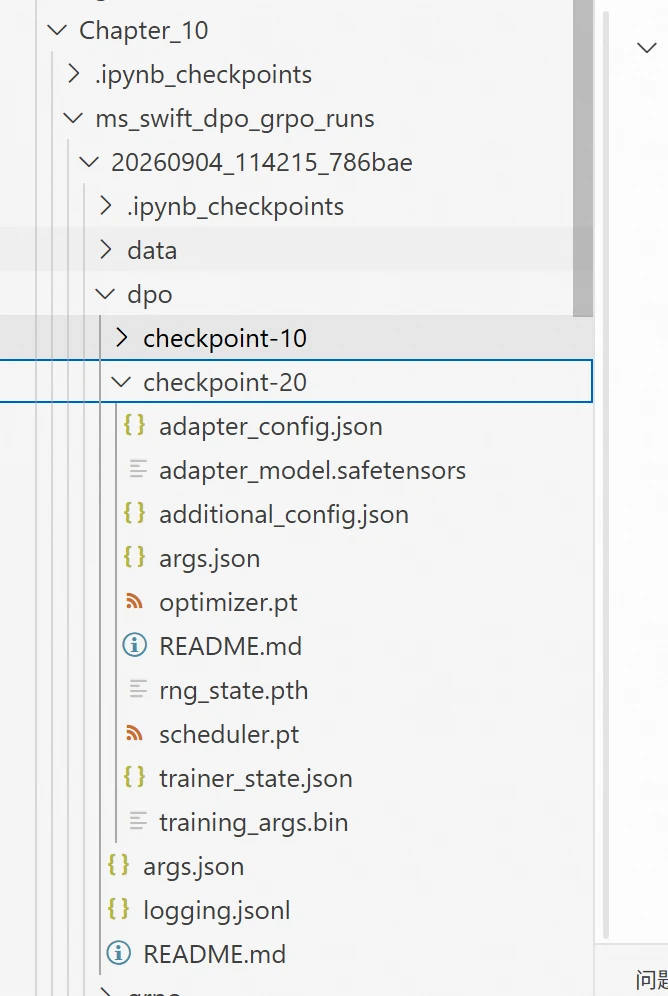
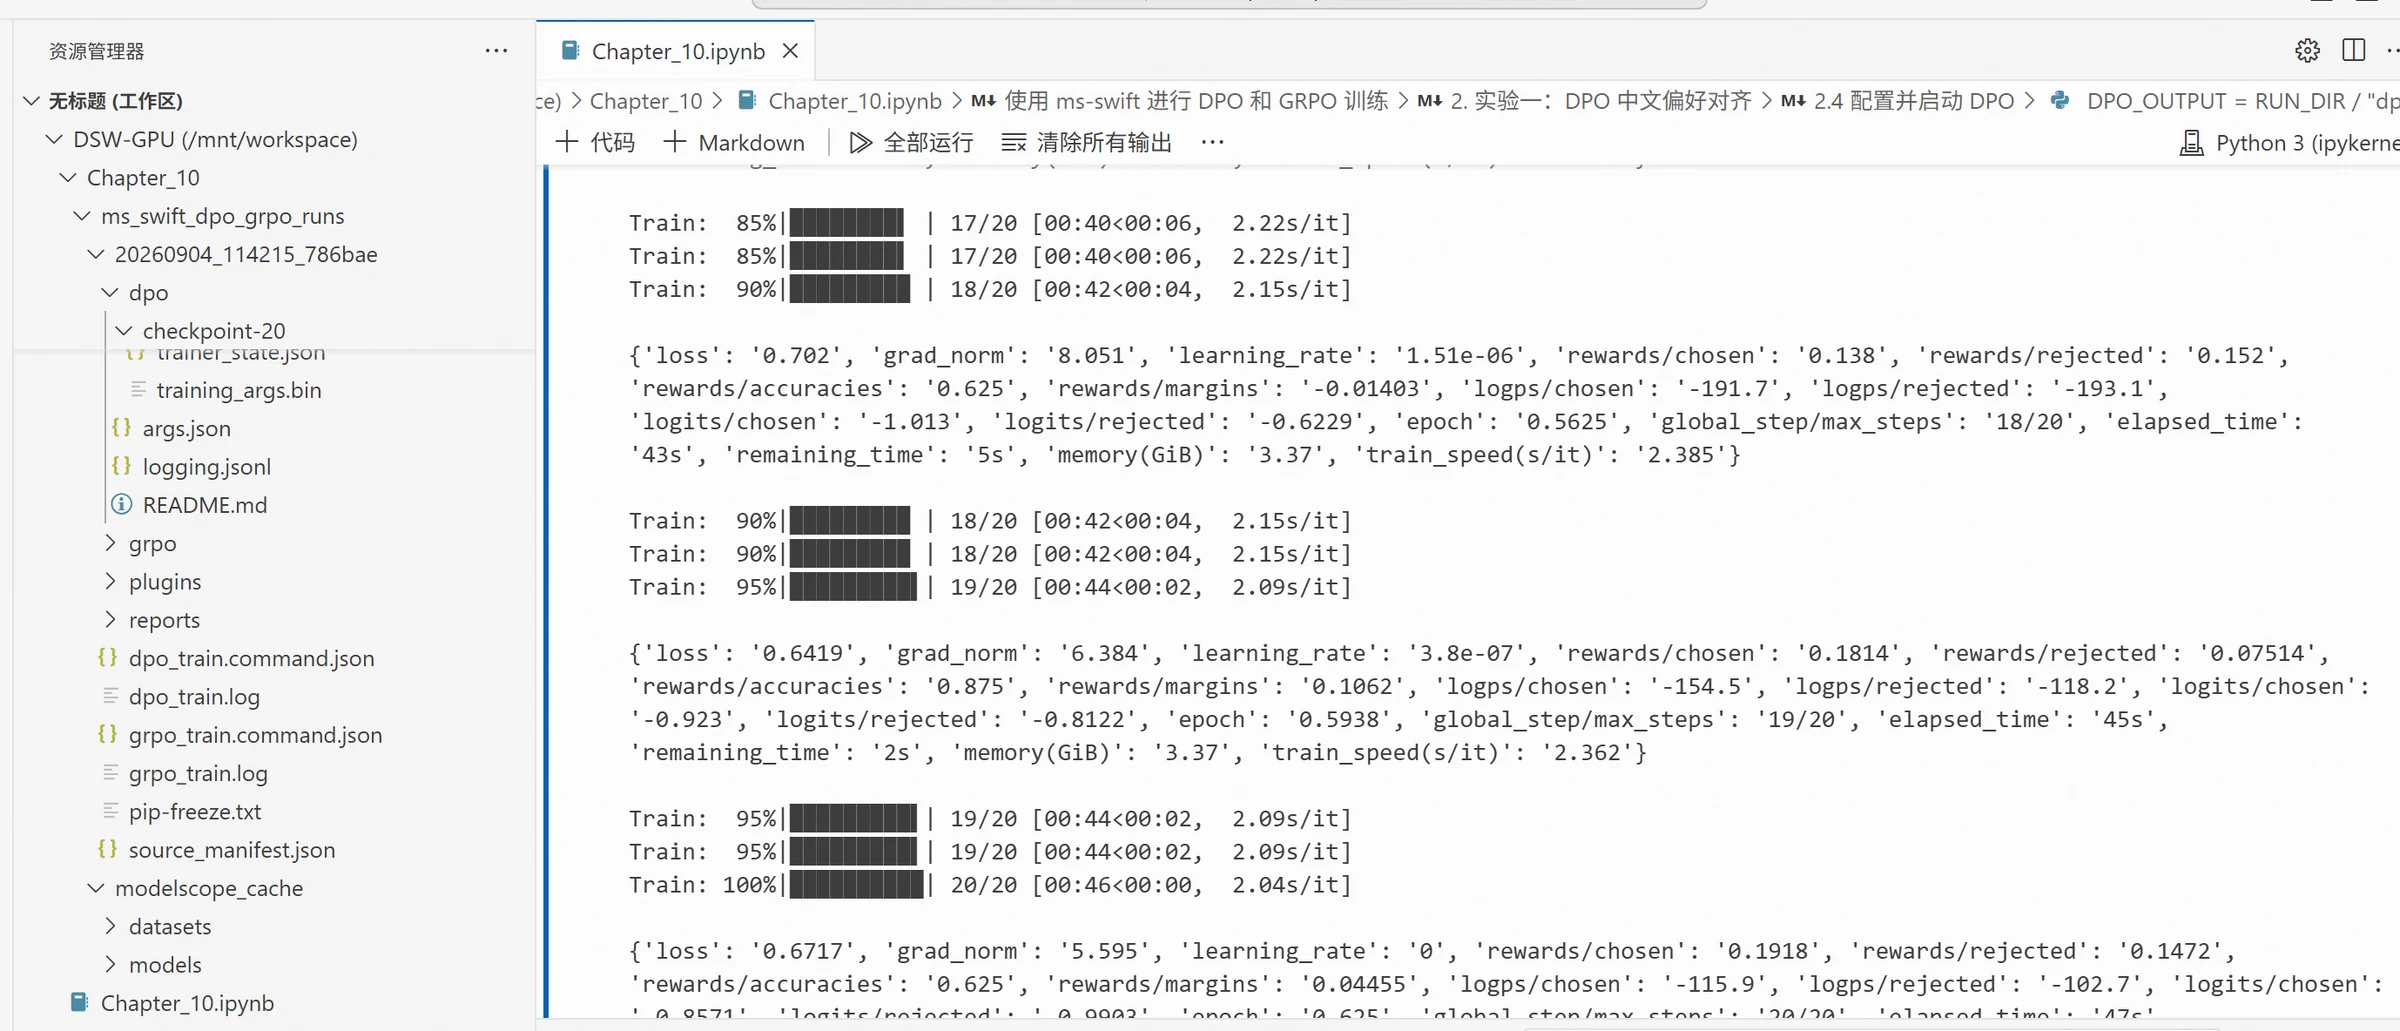
Las recompensas rewards/chosen y rewards/rejected en los registros son recompensas implícitas calculadas a partir de la diferencia de logaritmos de probabilidad entre la política y la política de referencia, no puntuaciones emitidas por un modelo de recompensa externo sobre la calidad de las respuestas. rewards/accuracies indica la proporción en que el orden de las recompensas implícitas coincide con las etiquetas de preferencia, y no debe interpretarse directamente como la tasa de aciertos del modelo al generar respuestas. Los resultados de ejecución relevantes de los registros se muestran en la siguiente imagen.
Se carga el adaptador DPO y se vuelve a evaluar con los mismos datos de prueba. En la comparación se mantienen constantes el indicador del sistema, la plantilla de diálogo y los parámetros de generación, para evitar confundir cambios en las indicaciones o en el método de decodificación con efectos del entrenamiento.
dpo_after, dpo_after_text = dpo_evaluate(DPO_ADAPTER)
before_df = pd.DataFrame(dpo_before).set_index("sample_id")
after_df = pd.DataFrame(dpo_after).set_index("sample_id")

comparison = pd.DataFrame({
    "before_gap": before_df["gap"],
    "after_gap": after_df["gap"],
    "relative_dpo_margin": DPO_BETA * (
        after_df["gap"] - before_df["gap"]
    ),
})
Donde gap es igual al logaritmo de probabilidad de la secuencia de la respuesta preferida menos el logaritmo de probabilidad de la secuencia de la respuesta no preferida. Un gap mayor que 0 indica que el modelo actual asigna una mayor probabilidad de secuencia a la respuesta preferida dada. Al calcular la proporción de muestras de prueba que cumplen esta condición, se obtiene la pair_preference_rate.
Los resultados de esta prueba se muestran en la siguiente imagen:
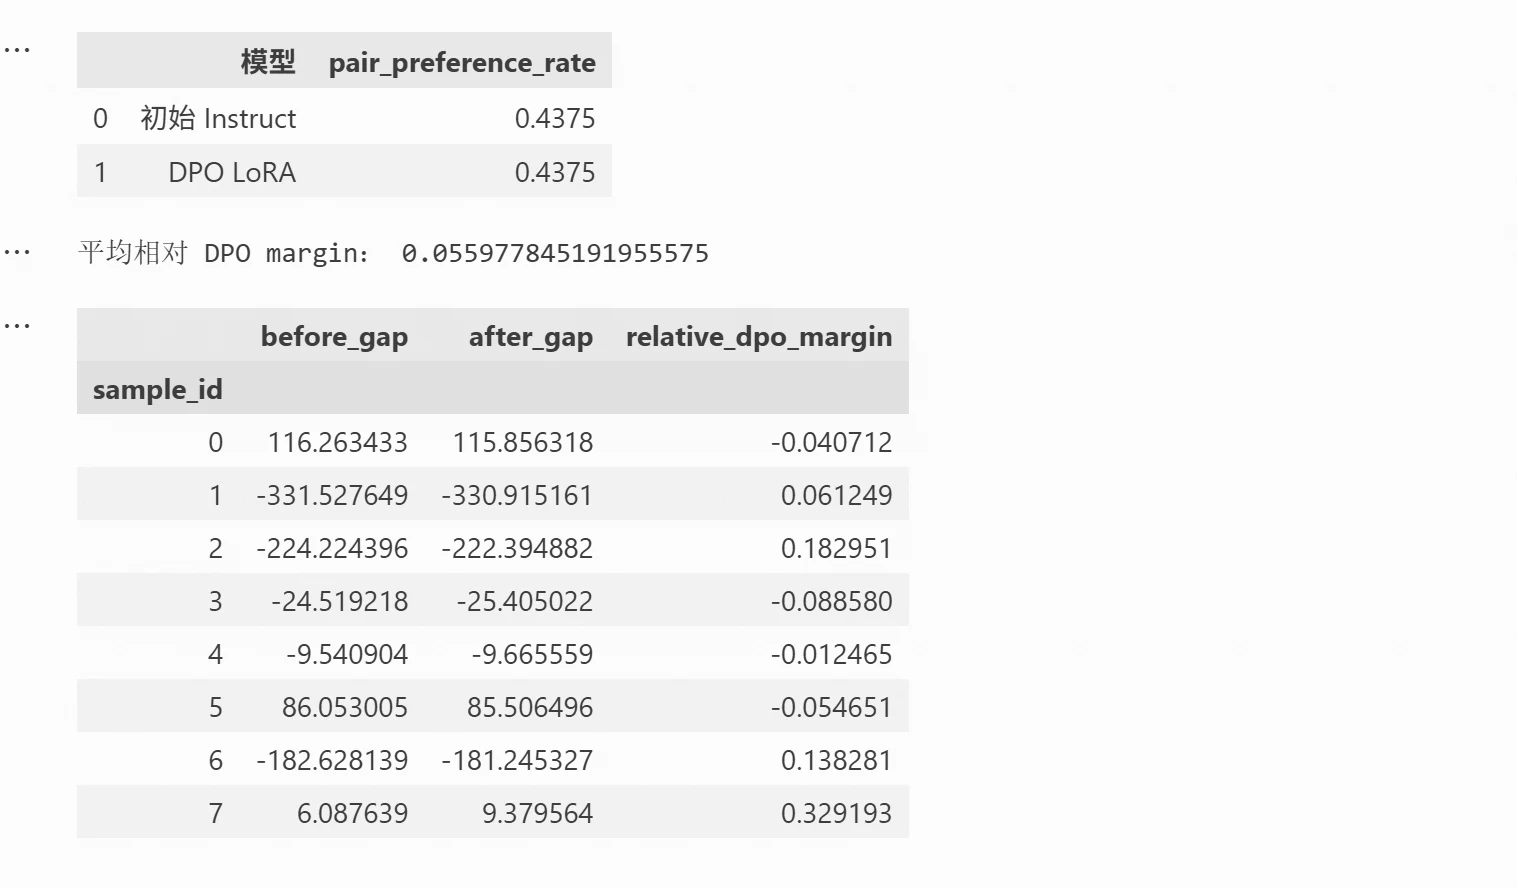
Debido al reducido número de épocas de entrenamiento, la diferencia de algunos ejemplos puede aumentar, pero aún no cambia de negativa a positiva; algunos ejemplos mejoran y otros empeoran. Por lo tanto, aunque el margin relativo medio sea positivo, la proporción de ejemplos en los que la respuesta preferida predomina no necesariamente aumenta. En este experimento, esta proporción es del 43.75% tanto antes como después del entrenamiento. Tomando como ejemplo un usuario que pregunta sobre la señal de la red doméstica en el conjunto de pruebas:
Usuario:¿Qué métodos puedo utilizar para reforzar la señal de mi red doméstica? ¡Mi portátil tiene dificultades para conectarse al router!
La respuesta del modelo inicial incluía el siguiente contenido, que se reproduce textualmente:
1. **Usa un router inalámbrico**:Si en tu hogar hay múltiples dispositivos que necesitan conectarse a Internet, puedes considerar instalar un router inalámbrico. Esto te permitirá conectarte a Internet a través de Wi-Fi.
La respuesta tras el entrenamiento DPO incluía:
3. **Reinicia el router**:A veces, un simple reinicio puede resolver algunos problemas de conexión de red. Sigue las instrucciones del router para realizar esta operación.
Observando la salida completa, la respuesta inicial sugería con mayor frecuencia cambiar o añadir dispositivos, mientras que tras el entrenamiento se organiza la respuesta en torno a la configuración de red, controladores y reinicio, lo que demuestra que el entrenamiento modificó el contenido generado. El entrenamiento DPO de este experimento modificó las probabilidades relativas de algunos candidatos fijos y algunas respuestas generadas, pero limitado por el alcance del entrenamiento y los datos, los lectores pueden reproducir el experimento con datos de mayor escala y más épocas de entrenamiento.
DPO utiliza las dos respuestas ya proporcionadas en los datos, mientras que GRPO necesita que el modelo genere respuestas candidatas durante el entrenamiento, que luego se evalúan con una función de recompensa. Este experimento utiliza problemas de matemáticas de GSM8K, tomando el número final y el formato de salida como retroalimentación verificable de forma automática, sin entrenar un modelo de recompensa por separado.
1)Separar las preguntas de las respuestas estándar.
Los datos originales de GSM8K contienen los campos question y answer. El campo answer incluye tanto el proceso de resolución como el número final situado después de ####. Durante la conversión, solo se entrega la pregunta al modelo y se extrae el número final al campo solution, con el código siguiente:
def convert_grpo(row):
    question = row["question"].strip()
    original_answer = row["answer"].strip()
    assert question and "####" in original_answer
    answer = parse_numeric(original_answer.rsplit("####", 1)[-1])
    assert answer is not None
    return {
        "messages": [
            {"role": "system", "content": MATH_SYSTEM},
            {"role": "user", "content": question},
        ],
        "solution": str(answer),
    }
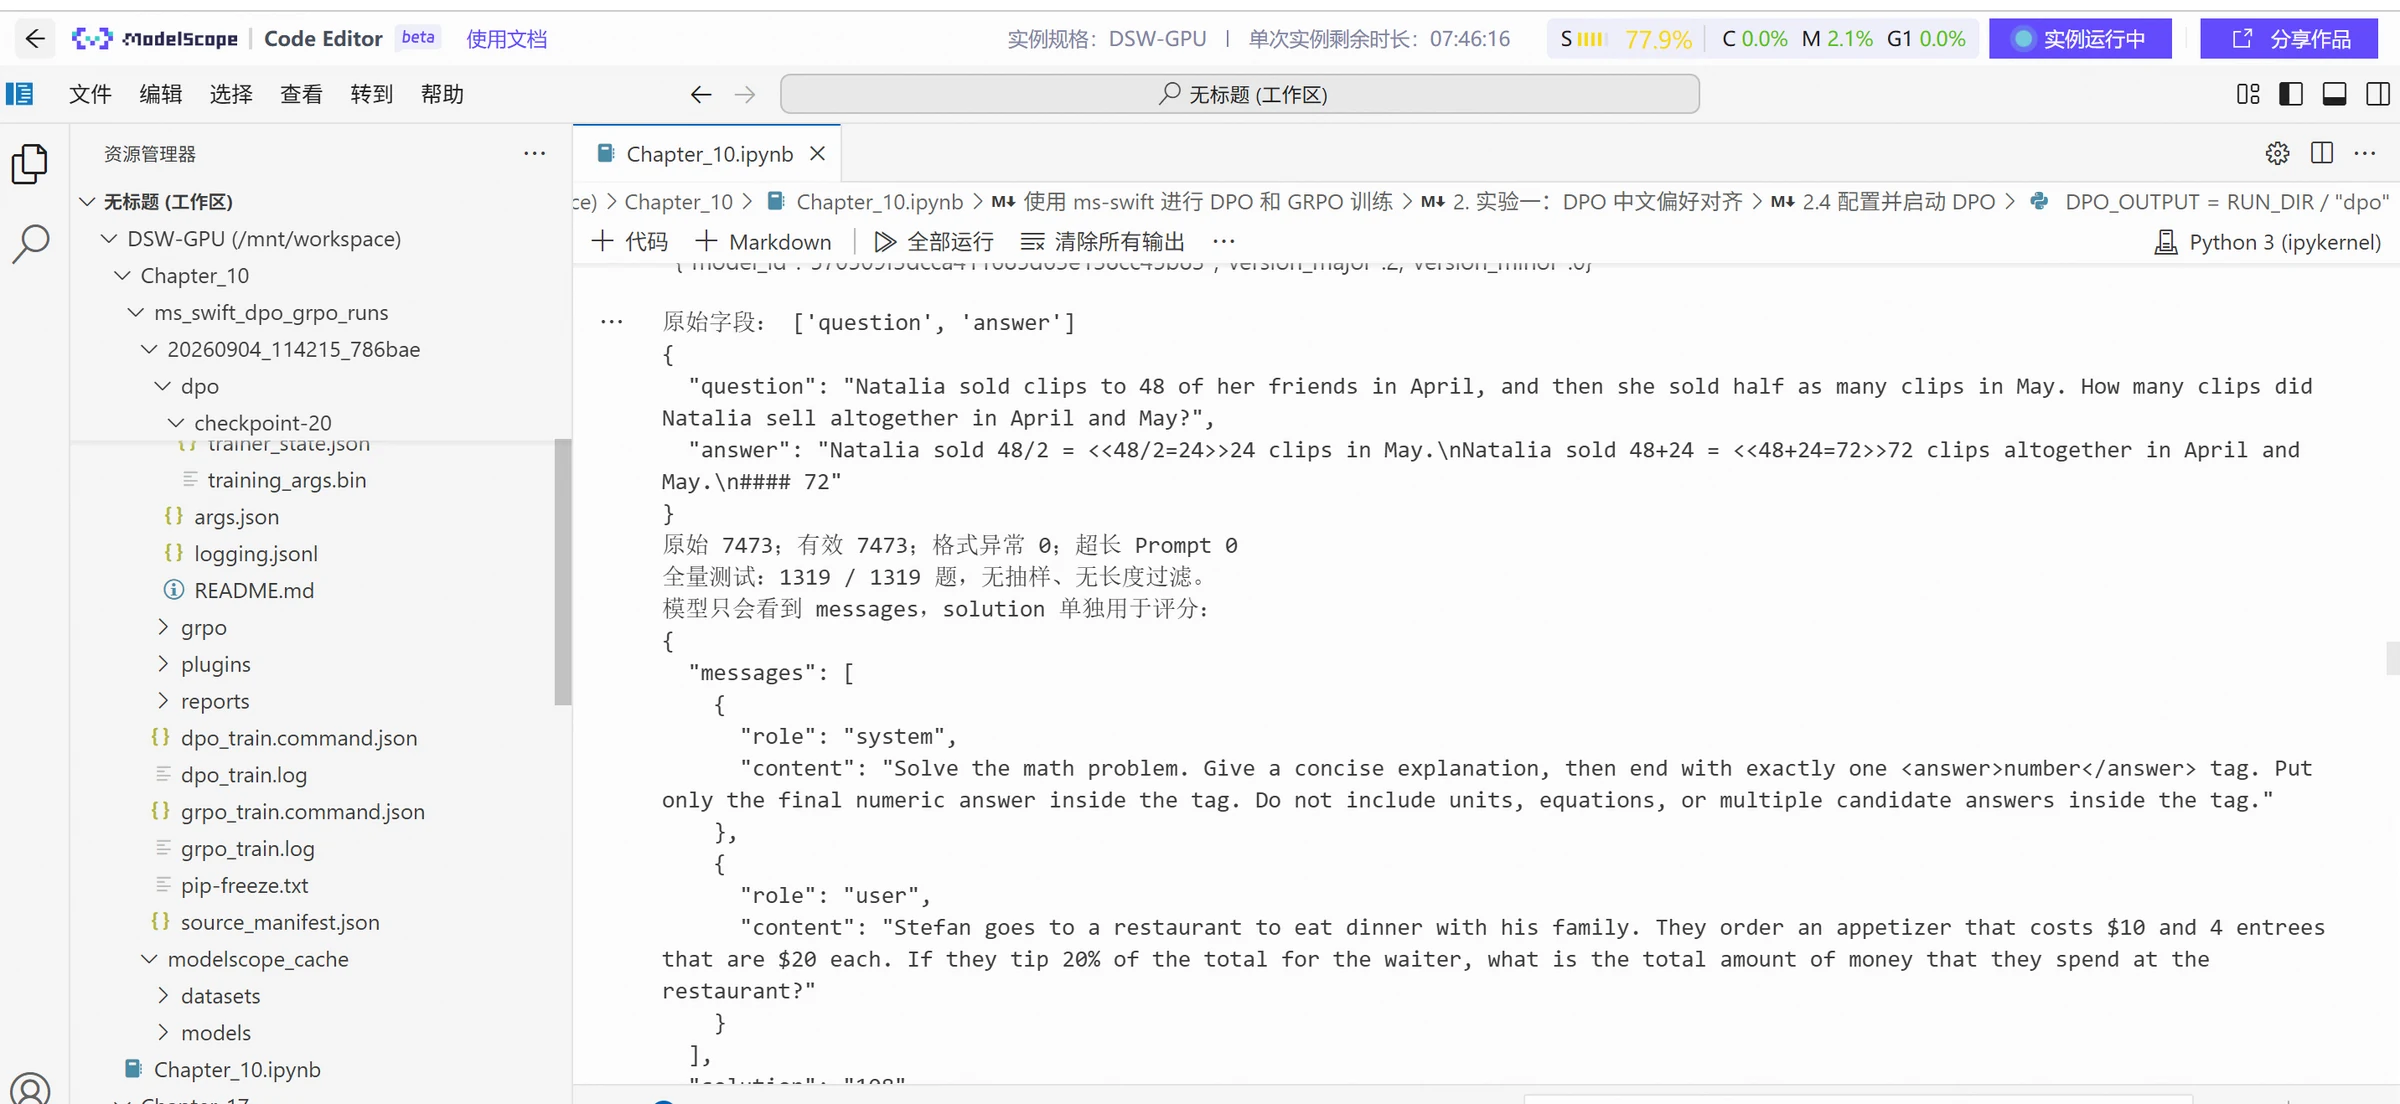
Los messages resultantes no contienen el proceso de resolución estándar ni una respuesta del asistente que el modelo pueda imitar. El campo solution se pasa como una columna de datos adicional a la función de recompensa y no se concatena al prompt. De esta manera, durante el entrenamiento, el modelo debe generar su propia respuesta y el programa de puntuación la compara con la respuesta estándar. A partir de la fuente de entrenamiento original se limpiaron, dedujeron y dividieron 128 ejercicios de entrenamiento y 16 de validación. La longitud máxima de los prompts de entrenamiento y validación es de 512 tokens. Las pruebas utilizan las 1319 ejercicios del archivo de pruebas oficial, manteniendo el orden original, sin eliminar ejercicios según el umbral de longitud de entrenamiento, y verificando si hay superposición con los datos de entrenamiento y validación. Los resultados de ejecución relevantes son los siguientes:
2)Definir la recompensa de corrección y la recompensa de formato.
La recompensa total de este experimento es:
Recompensa total = Recompensa de corrección + 0.1 × Recompensa de formato
La recompensa de corrección requiere que la salida del modelo cumpla con el formato de etiqueta especificado y que el número dentro de la etiqueta sea igual al contenido de solution; si se cumple, otorga 1, de lo contrario 0. La recompensa de formato solo verifica si la etiqueta es única, si se encuentra al final de la respuesta y si su contenido puede parsearse como un número; si se cumple, otorga 1, de lo contrario 0. El código relevante es el siguiente:
def extract_answer(completion):
    if not isinstance(completion, str):
        return None
    if completion.count("<answer>") != 1 or completion.count("</answer>") != 1:
        return None
    match = re.search(r"<answer>\s*([^<>]+?)\s*</answer>\s*\Z", completion)
    return parse_numeric(match.group(1) if match else None

class Chapter10Accuracy(ORM):
    def __call__(self, completions, solution, **kwargs):
        if len(completions) != len(solution):
            raise ValueError("El número de respuestas candidatas no coincide con solution.")
        rewards = []
        for text, gold in zip(completions, solution):
            expected = parse_numeric(gold)
            if expected is None:
                raise ValueError(f"El formato de la respuesta estándar no es válido: {gold!r}")
            predicted = extract_answer(text)
            rewards.append(float(predicted is not None and predicted == expected))
        return rewards

class Chapter10Format(ORM):
    def __call__(self, completions, **kwargs):
        return [float(extract_answer(text) is not None) for text in completions]
Donde completions es un grupo de respuestas generadas por el modelo, y solution son las respuestas estándar correspondientes proporcionadas por el entrenador. extract_answer primero verifica la cantidad de etiquetas, luego confirma que la etiqueta se encuentra al final de la respuesta y finalmente extrae el número. Esta recompensa solo verifica el resultado final y no valida el proceso de resolución. Incluso si el modelo no proporciona explicación, siempre que emita la etiqueta de respuesta correcta, puede obtener la recompensa completa. La indicación "explicación breve" en el indicador del sistema no se ha incorporado a las condiciones de puntuación, por lo que no se debe interpretar una puntuación alta como que el modelo ha aprendido un razonamiento completo y fiable.
Las clases de recompensa también necesitan registrarse. Los plugins de recompensa utilizados por el entrenador en este experimento son:
orms["chapter10_accuracy"] = Chapter10Accuracy
orms["chapter10_format"] = Chapter10Format
El cuaderno guarda el plugin completo en plugins/chapter10_rewards.py, que luego se especifica mediante external_plugins indicando la ruta del archivo, y se especifican los nombres registrados anteriormente mediante reward_funcs. El plugin debe incluir sus propias importaciones y funciones auxiliares, ya que se cargará de forma independiente en el subproceso de entrenamiento. Para el método de registro, se puede consultar el ejemplo oficial de plugins de recompensa de ms-swift 4.4.2.
3)Revisar la función de recompensa antes de iniciar el entrenamiento.
Los siguientes son los resultados del cálculo de recompensa para algunos casos:
Salida del modelo | Respuesta estándar | Recompensa de corrección | Recompensa de formato | Recompensa total |
| 12 | 1 | 1 | 1.1 |
| 12 | 1 | 1 | 1.1 |
| 12 | 0 | 1 | 0.1 |
| 12 | 0 | 0 | 0 |
| 12 | 0 | 0 | 0 |
| 12 | 0 | 0 | 0 |
Según el método de cálculo de la función de recompensa utilizado en este experimento, el texto normal The answer is 12., aunque contiene el número correcto, no cumple con el requisito de formato, por lo que la recompensa estricta de corrección sigue siendo 0. Múltiples etiquetas de respuesta tampoco pasan la verificación, evitando que el modelo obtenga recompensa mediante enumeración de respuestas.
Tras completar la preparación de datos y la función de recompensa, se procede con la configuración y las tareas de entrenamiento del experimento.
1)Establecer el grupo de generación y los parámetros de entrenamiento.
Este experimento genera 4 respuestas candidatas para cada ejercicio, y el lote de generación también se establece en 4, de modo que un lote de generación corresponde a 4 candidatos de 1 ejercicio. A continuación, cada mini-lote de entrenamiento procesa 1 candidato, y se acumulan 4 mini-lotes antes de actualizar los parámetros una vez.
La configuración del experimento GRPO es la siguiente. Las configuraciones y contenidos relevantes como GRPO_PATHS y PLUGIN_PATH son:
GRPO_OUTPUT = RUN_DIR / "grpo"
grpo_options = common_options() | {
    "rlhf_type": "grpo", "loss_type": "grpo",
    "dataset": str(GRPO_PATHS["train"]),
    "val_dataset": str(GRPO_PATHS["val"]),
    "output_dir": str(GRPO_OUTPUT),
    "external_plugins": str(PLUGIN_PATH),
    "reward_funcs": ["chapter10_accuracy", "chapter10_format"],
    "reward_weights": [1.0, 0.1], "remove_unused_columns": False,
    "num_generations": 4, "generation_batch_size": 4,
    "per_device_train_batch_size": 1,
    "gradient_accumulation_steps": 4,
    "per_device_eval_batch_size": 4, "num_generations_eval": 4,
    "max_length": 512, "max_completion_length": 256,
    "truncation_strategy": "left",
    "max_steps": 10, "learning_rate": 1e-5,
    "lr_scheduler_type": "constant", "warmup_ratio": 0.0,
    "beta": 0.04, "num_iterations": 1,
    "temperature": 0.9, "top_p": 0.95,
    "use_vllm": False, "log_completions": True,
    "eval_strategy": "steps", "eval_steps": 5,
    "save_strategy": "steps", "save_steps": 5,
}
train_swift(grpo_options, RUN_DIR / "grpo_train.log")
GRPO_ADAPTER = latest_adapter(GRPO_OUTPUT)
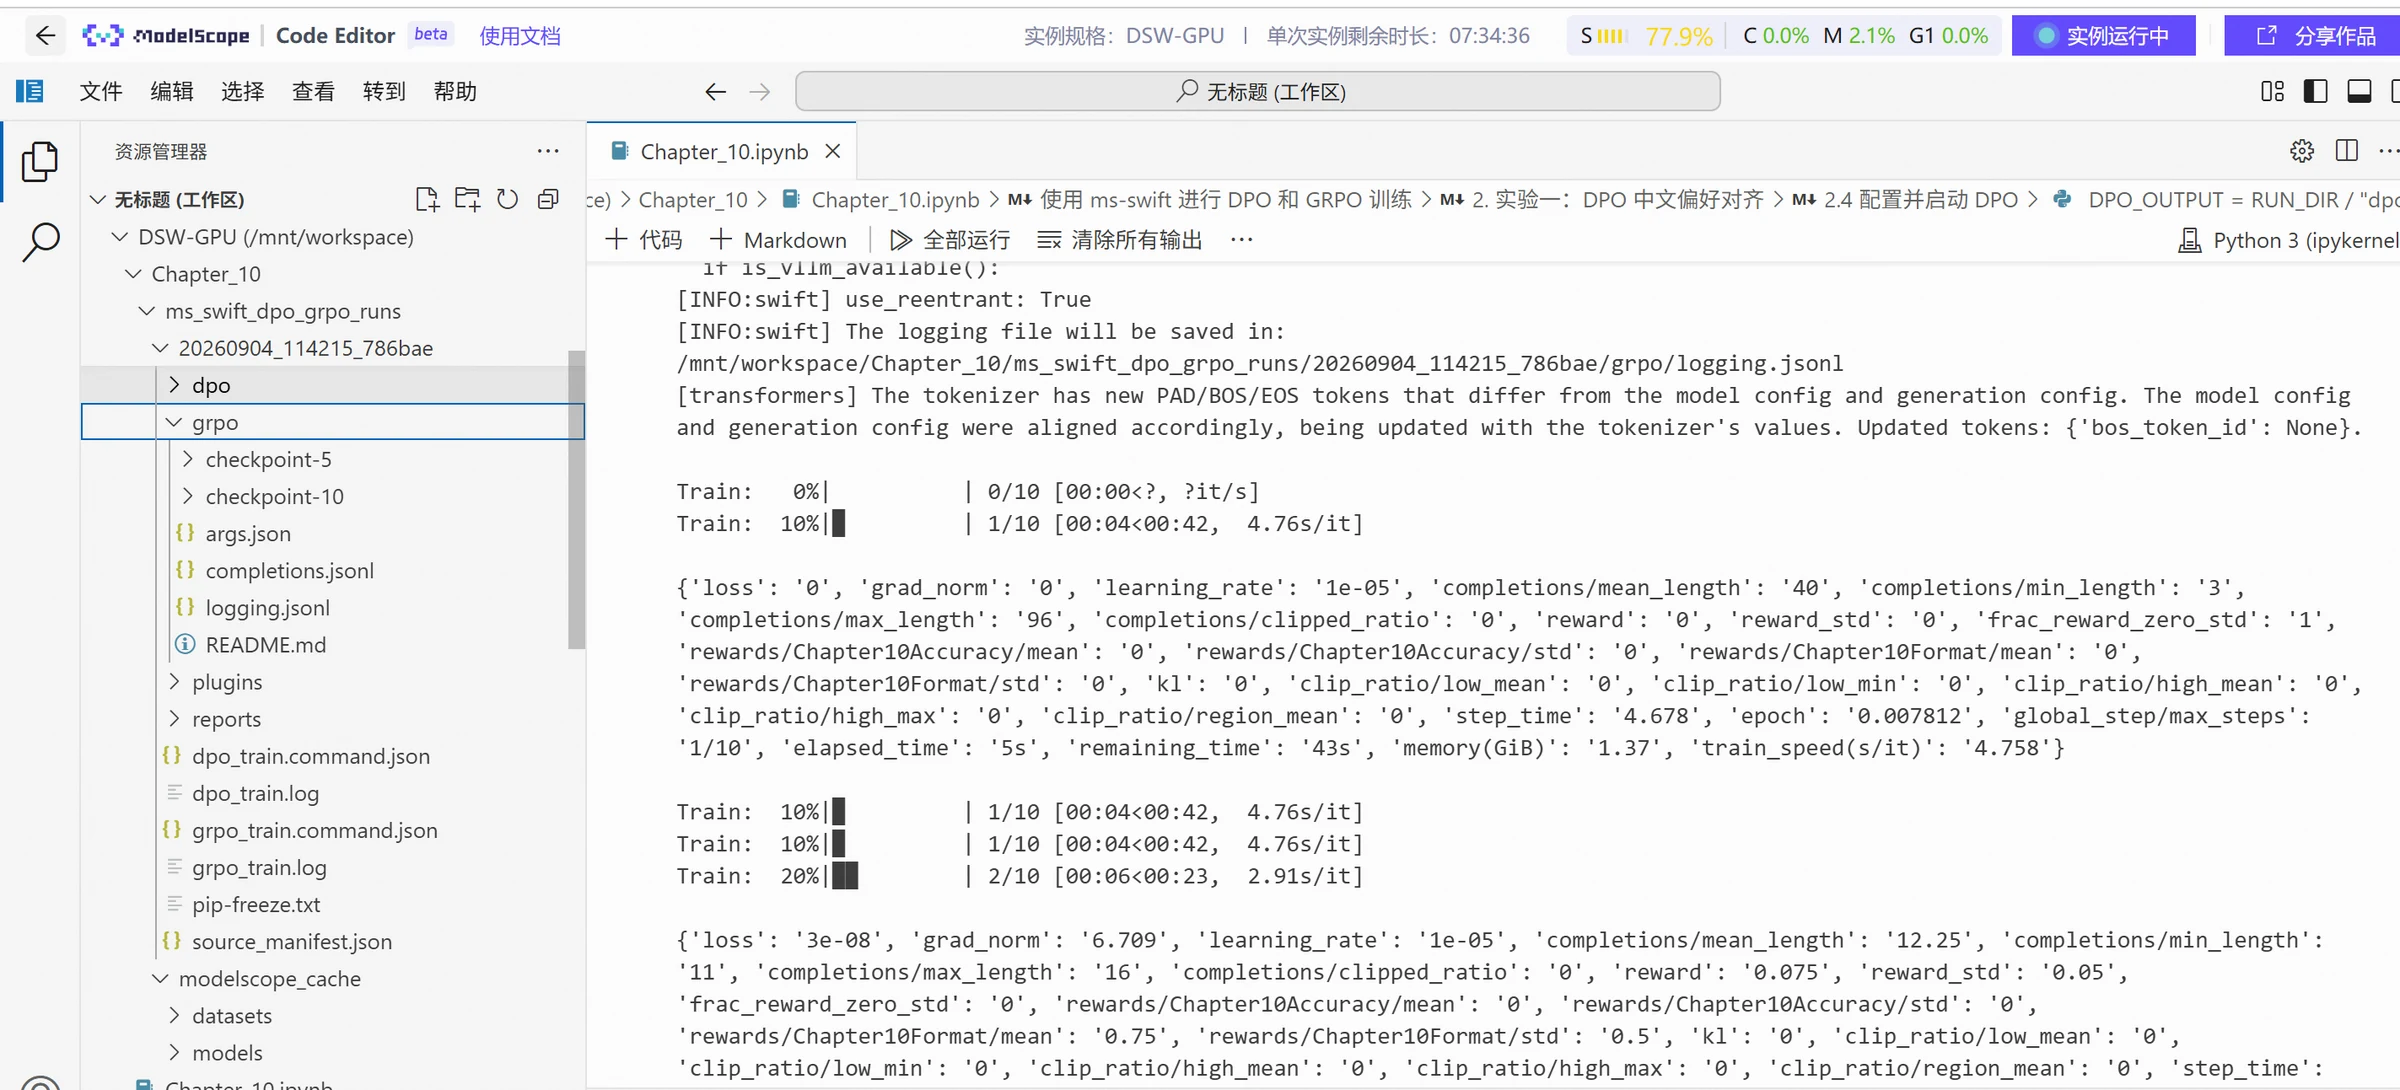
El tamaño del grupo y el lote de generación deben configurarse de manera compatible. El lote de generación debe ser divisible por el tamaño del grupo, y también divisible por el resultado del mini-lote de entrenamiento por tarjeta multiplicado por el número de procesos GPU. En este caso se utiliza una sola tarjeta y un solo proceso; un lote de generación de 4, tamaño de grupo de 4 y mini-lote de entrenamiento de 1 cumplen estas condiciones. Durante la validación, tanto el lote como el tamaño del grupo son 4. Si se modifica el tamaño del grupo, se debe verificar simultáneamente el lote de generación, la acumulación de gradientes de entrenamiento y la configuración de validación. Este entrenamiento completó 10 pasos y guardó grpo/checkpoint-10.
2)Leer los registros de entrenamiento.
La pérdida de entrenamiento de GRPO no es la tasa de aciertos en problemas matemáticos. Al observar el entrenamiento, se debe examinar conjuntamente la recompensa total, los componentes de recompensa y las diferencias dentro del grupo. El campo reward en los registros representa la recompensa acumulada actual, reward_std se utiliza para observar las diferencias de recompensa dentro del grupo, y frac_reward_zero_std indica la proporción de grupos cuya desviación estándar de recompensa es cero. La visualización de las estadísticas de entrenamiento relevantes se muestra en la siguiente imagen:
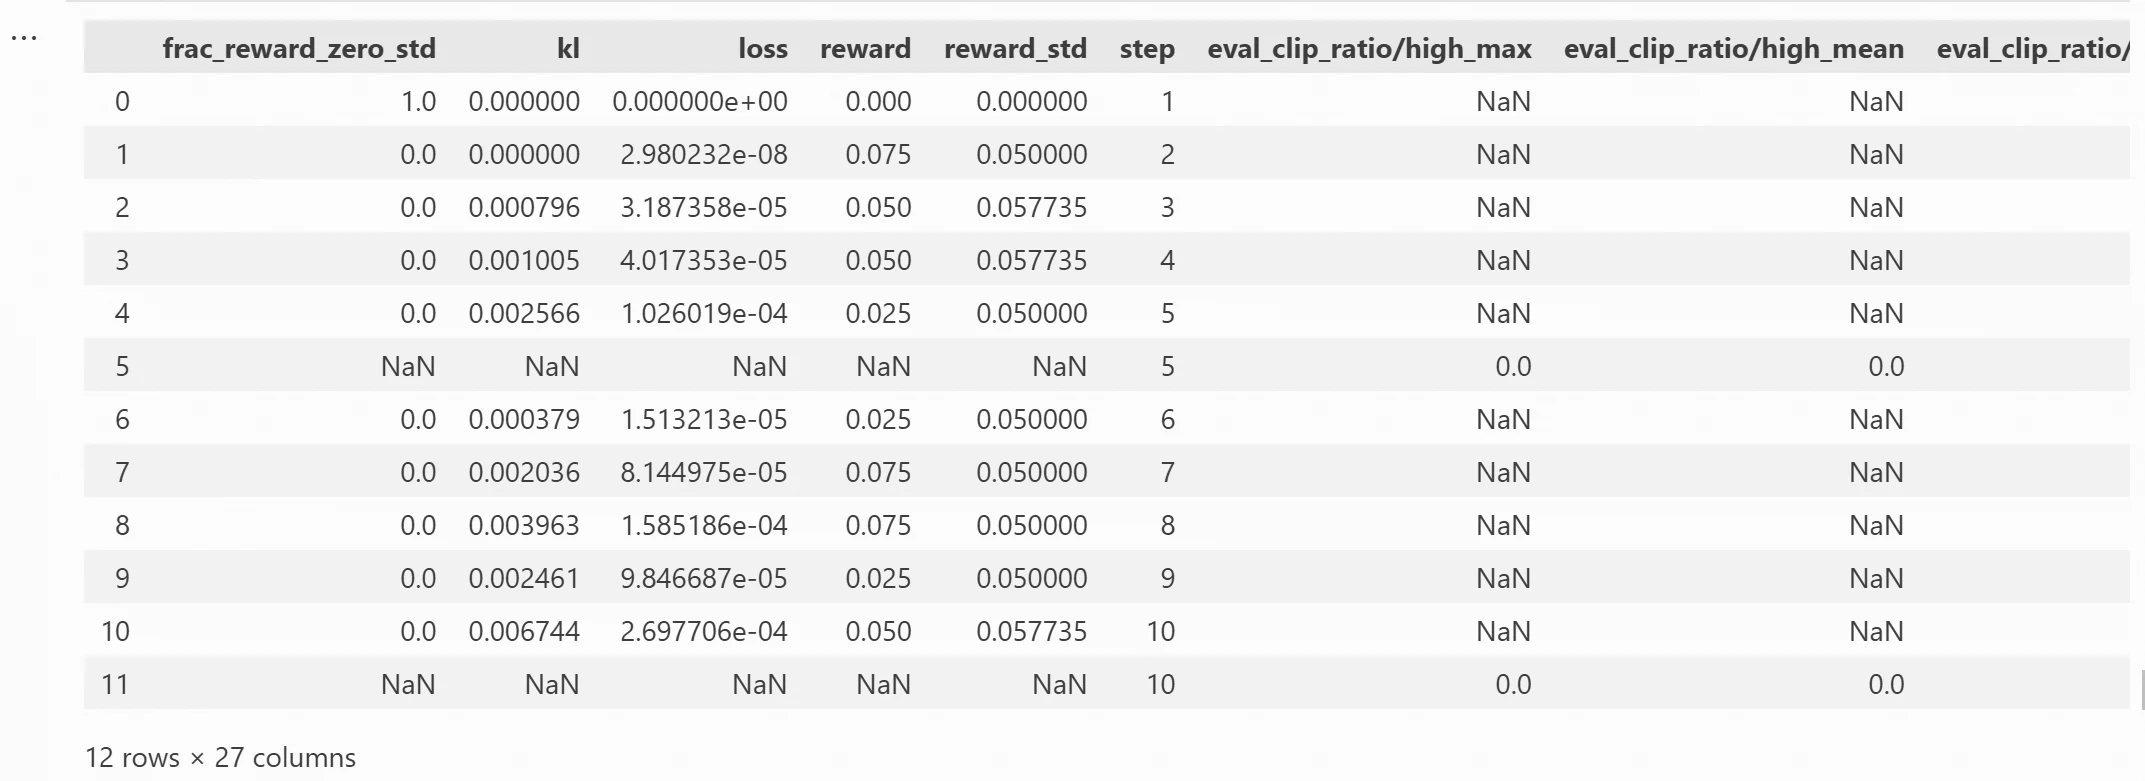
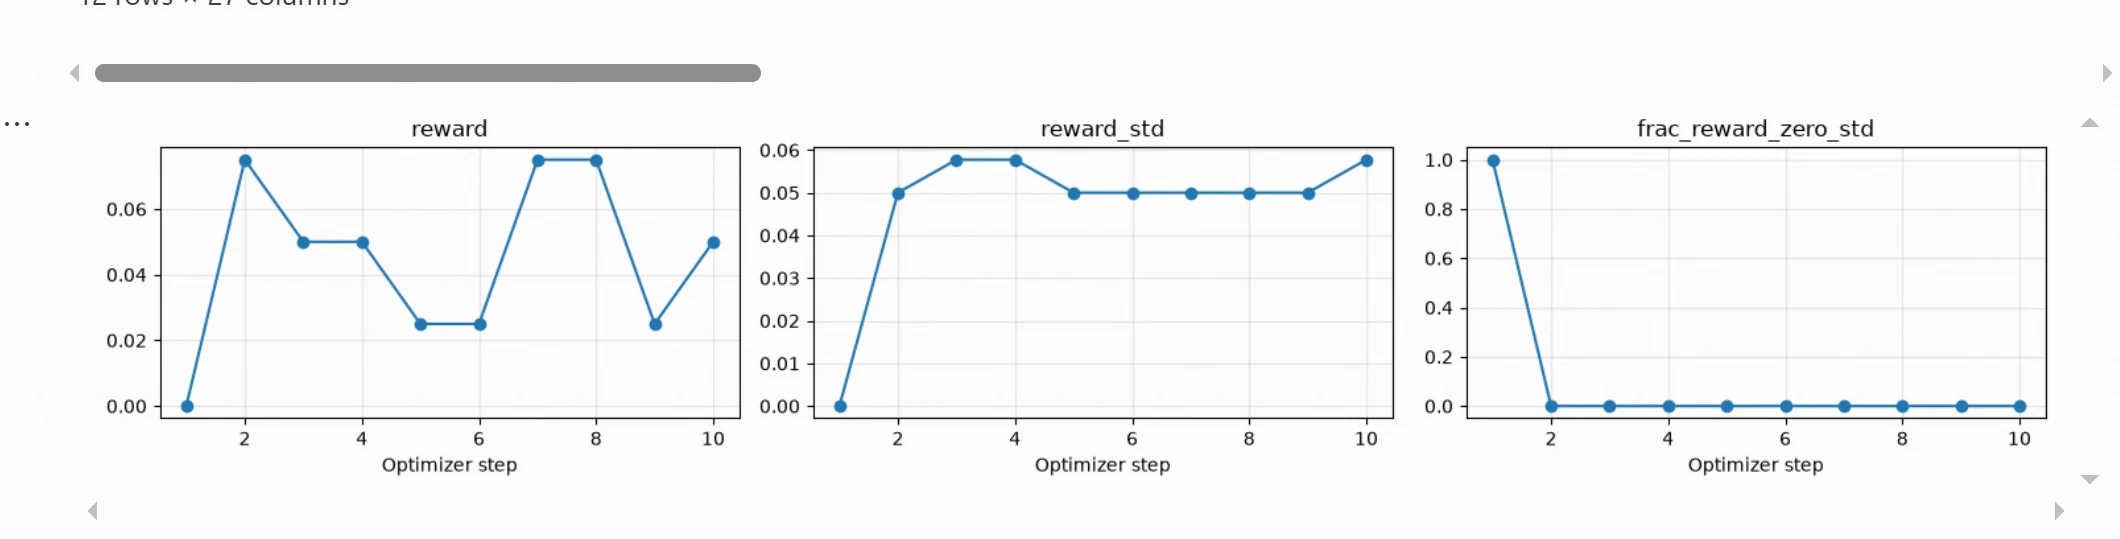
En la imagen se puede observar que, a partir del segundo paso del entrenamiento, aparecen diferencias de recompensa no nulas dentro del grupo, y la proporción de empates baja a 0, lo que indica que la función de recompensa ya es capaz de distinguir entre diferentes respuestas candidatas, proporcionando señales de optimización eficaces para GRPO. En este experimento solo se realizaron 10 pasos de entrenamiento, la recompensa de corrección es bastante dispersa y la tasa de aciertos en respuestas matemáticas aún no ha mejorado; en el futuro se pueden aumentar las épocas de entrenamiento para que el modelo se exponga a más ejercicios y respuestas candidatas, y combinar con el conjunto de validación para observar posibles mejoras más evidentes en el entrenamiento.
Los registros de entrenamiento reflejan las candidatas muestreadas durante el proceso de entrenamiento; finalmente, se necesita un conjunto de pruebas independiente para comparar el rendimiento del modelo. Cada ejercicio solo genera una respuesta, lo que no constituye una evaluación donde se selecciona la mejor respuesta tras múltiples muestreos aleatorios.
El resultado inicial se guardó con grpo_evaluate() antes del entrenamiento. Tras finalizar el entrenamiento, se pasa el adaptador GRPO y se agregan los resultados en los mismos ejercicios. A continuación se muestra el código de evaluación y agregación; el cuaderno también verifica si los números de muestra, ejercicios y respuestas estándar corresponden uno a uno.
grpo_after = grpo_evaluate(GRPO_ADAPTER)
grpo_summary = pd.DataFrame([
    {
        "Modelo": name,
        "Tasa de corrección estricta": np.mean([r["correct"] for r in rows]),
        "Ejercicios respondidos correctamente": int(sum(r["correct"] for r in rows)),
        "Proporción de formato válido": np.mean([r["format_ok"] for r in rows]),
        "Ejercicios con formato válido": int(sum(r["format_ok"] for r in rows)),
        "Recompensa total promedio": np.mean([r["total_reward"] for r in rows]),
        "Número de ejercicios de prueba": len(rows),
    }
    for name, rows in [
        ("Instruct inicial", grpo_before), ("GRPO LoRA", grpo_after)
    ]
])
display(grpo_summary)
Los resultados de la evaluación completa son los siguientes:
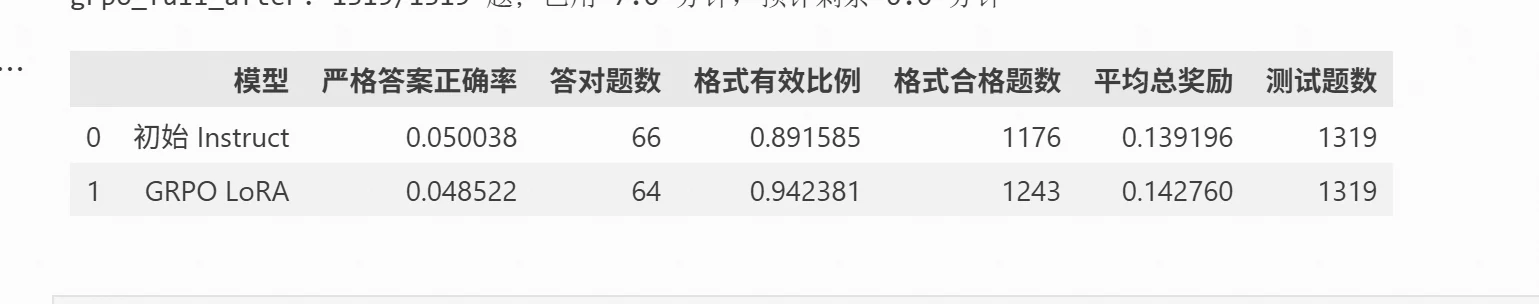
En combinación con los resultados de la evaluación completa anteriores, la proporción de formato válido del modelo pasó del 89.16% al 94.24%, lo que demuestra el efecto de este entrenamiento en la estandarización del formato de salida. En experimentos y entrenamientos posteriores, se pueden ajustar adicionalmente la dificultad de los ejercicios o el diseño de recompensas, de modo que los resultados futuros obtengan una retroalimentación más completa sobre la corrección de las respuestas.
Todos los datos y código de experimentos de este capítulo pueden consultarse en: https://modelscope.cn/gallery/liucong/8a5fefc5-6f90-42df-9a09-bc9781ed3da8