AIUnlimited
🌳

Fundamentos de IA

🌱
AI Seeds

Empieza desde cero

🌿
AI Sprouts

Construye bases

🌳
AI Branches

Aplica en la práctica

🏕️
AI Canopy

Profundiza

🌲
AI Forest

Domina la IA

🔨

Maestría en IA

✏️
AI Sketch

Empieza desde cero

🪨
AI Chisel

Construye bases

⚒️
AI Craft

Aplica en la práctica

💎
AI Polish

Profundiza

🏆
AI Masterpiece

Domina la IA

📘

Práctica de IA

📖
Entendiendo modelos open-source

Fundamentos y recursos para modelos open-source

🎯
Del problema a la tarea del modelo

Convertir problemas de negocio en tareas de modelos

⚡
Ejecutando tu primer modelo

Mira tus primeros resultados en 30 minutos

🔧
Fine-tuning y evaluación

Ajusta modelos y evalúa el rendimiento

🚀
Sistemas de aplicación

Construye aplicaciones IA del mundo real

🎨
IA generativa

Explora modelos AIGC open-source

🤖
Agentes

Aprende frameworks Agent y herramientas MCP

📐
Fundamentos complementarios

Fundamentos LLM y evaluación

🎓

Claude Academia

🤖
Claude 101

Learn AI basics with Claude

💻
Claude Code 101

Code with Claude as your pair programmer

🤝
Introduction to Claude Cowork

Collaborate with Claude on complex projects

⚙️
Claude Platform 101

Build apps with the Claude API

Laboratorio

7 experimentos cargados
🧬Sandbox de Red Neuronal🤖¿IA o Humano?🥋Dojo de Prompt Engineering🏁Carrera de Algoritmos🧠Trivia de IA🏗️Lienzo de diseño de sistemas
🎯Entrevista simuladaEntrar al Laboratorio→
🚀

Desarrollo profesional

🚀
Plataforma de Entrevistas

Comienza tu camino

🌟
Dominio Conductual

Domina las habilidades blandas

💻
Entrevistas Técnicas

Supera la ronda de código

🤖
Entrevistas de IA y ML

Dominio en entrevistas de ML

🏆
Oferta y Más Allá

Consigue la mejor oferta

Empezar
AIUnlimited

Licencia MIT

沪ICP备18025655号-11

Aprender

  • Fundamentos de IA
  • Práctica de IA
  • Claude Academia
  • Laboratorio
  • Desarrollo profesional

Comunidad

  • Acerca de
  • Preguntas Frecuentes

Soporte

  • Términos de Servicio
  • Política de Privacidad
  • Contacto
Académicos de IA e Ingeniería›🎨 IA generativa›Lecciones›Image LoRA with DiffSynth
🖼️
IA generativa • Principiante⏱️ 25 min de lectura

Image LoRA with DiffSynth

¿Personalización? Entrenar un LoRA de imagen con DiffSynth

En aplicaciones prácticas, los modelos generadores de imágenes generales no siempre pueden generar con precisión personajes específicos, productos o estilos de imagen. Si desea que el modelo genere características visuales específicas de un personaje, producto o estilo, puede usar LoRA para entrenarlo. En este capítulo, se presentan primero los conceptos básicos de los modelos generadores de imágenes y LoRA, y luego se completa un entrenamiento de LoRA de imagen con DiffSynth.

¿De una sola frase de texto, cómo se convierte en una imagen?

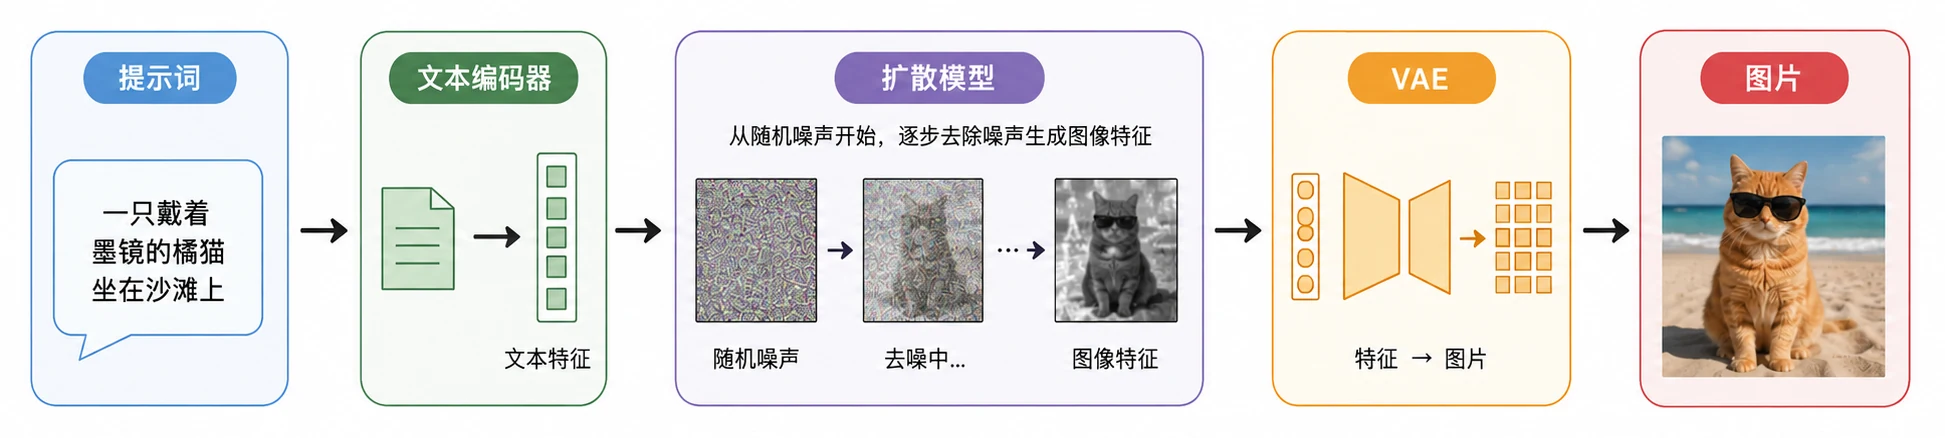
Actualmente, los modelos de generación de imágenes comunes están compuestos principalmente por componentes como codificadores de texto, modelos de difusión y VAE. Después de que el usuario ingrese una frase de texto, el modelo primero comprende el contenido del texto, luego genera gradualmente características de imagen, y finalmente convierte estas características en una imagen que se puede ver directamente.

El codificador de texto es responsable principalmente de comprender la frase de texto, convirtiendo el texto en características de texto que el modelo puede procesar. Por ejemplo, al ingresar "un gato naranja con gafas de sol sentado en la playa", el codificador de texto codificará contenido como "gato naranja", "gafas de sol" y "playa" para proporcionar condiciones para la generación de imágenes posterior.

El modelo de difusión es el componente principal de la generación de imágenes. Comienza con ruido aleatorio y, según las características de texto, elimina gradualmente el ruido mediante cálculos múltiples, formando los objetos, colores y estructuras de la imagen. Por ejemplo, al generar la imagen mencionada anteriormente, la imagen inicial es solo ruido aleatorio, y después de varios ciclos de procesamiento, el gato naranja, las gafas de sol y la playa se forman gradualmente.

El VAE (Variational Autoencoder, autoencoder variacional) es responsable de la conversión entre el espacio de imágenes y el espacio de características. Para reducir el consumo de recursos de cálculo, el modelo de difusión generalmente no realiza cálculos directamente en imágenes de alta resolución, sino que genera la imagen en un espacio de características comprimido. Después de la generación, el VAE convierte las características de imagen en la imagen final.

Al combinar estos componentes, el proceso básico de texto a imagen se muestra a continuación:
正文配图

Después de que el usuario ingrese una frase de texto, el modelo pasa por la codificación de texto, la generación de características de imagen y la reconversión de imagen, y finalmente obtiene la imagen. Los modelos de generación de imágenes diferentes pueden tener estructuras específicas, pero en general deben completar el proceso de conversión desde la entrada de texto a la salida de imagen.

¿Para que el modelo dibuje mejor, ¿qué puede hacer un LoRA de imagen?

Lección 2 de 50% completado
←10 AIGC Use Cases

Discusión

Iniciar sesión unirse a la discusión

Los modelos generadores de imágenes generales se entrenan con una gran cantidad de imágenes, lo que les permite generar contenido de varios tipos, pero para personajes específicos, productos o estilos de imagen, los resultados de generación pueden no ser lo suficientemente precisos.

Por ejemplo, si desea que el modelo genere un producto específico, incluso si describe en detalle el color, la forma y el aspecto del producto en la frase de texto, los resultados de generación pueden tener grandes diferencias con el producto real.

Puede entrenar al modelo para que aprenda estas nuevas características visuales, pero reentrenar todo el modelo requiere una gran cantidad de datos de entrenamiento y recursos de cálculo. Para el aprendizaje de estas características específicas, se puede usar el método de entrenamiento de entrenamiento de parámetros eficiente LoRA, su principio se puede ver en la sección 9.2 de este documento. Durante el entrenamiento, se congelan la mayoría de los parámetros del modelo original y solo se entrena una pequeña cantidad de parámetros nuevos, lo que hace que el modelo aprenda nuevas características.

Entrenar un LoRA de imagen solo requiere preparar un pequeño número de imágenes de destino, lo que permite que el modelo aprenda características visuales específicas de un personaje, producto, estilo u otras características. El archivo LoRA resultante es mucho más pequeño que el modelo completo. Al cargar el modelo original y luego el correspondiente LoRA,