En el pasado, crear un póster de marketing de producto generalmente requería pasar por varias etapas como la preparación de materiales, diseño de fondo, disposición del producto, adición de texto y ajuste de dimensiones. Si el mismo producto se necesita publicar en múltiples plataformas, los diseñadores a menudo tenían que ajustar la imagen para diferentes dimensiones.
Ahora, a través de tecnologías como generación de texto a imagen (Text-to-Image), imagen a imagen (Image-to-Image), edición local y micro-tunación de modelos, se puede conectar la generación de ideas creativas, diseño de productos, modificación de imágenes y adaptación de dimensiones, formando un proceso de producción de contenido de marketing relativamente completo.
Por ejemplo, para crear un póster de marketing de "Verano Fresco" para una bebida, se puede generar inicialmente una imagen de marketing a través de una descripción de texto, editarla con la imagen del producto (Image-to-Image), añadir el logo de marca y modificar elementos locales según las necesidades. Finalmente, se puede expandir la misma imagen de marketing a diferentes tamaños para usarla en redes sociales, videos cortos y anuncios web.
Este capítulo tomará como ejemplo el póster de marketing de bebida FRESH DAY para explicar cómo construir una línea de producción de contenido de marketing AIGC basada en modelos de generación de imágenes de código abierto de ModelScope. El experimento comienza con texto a imagen, y luego introduce imagen a imagen, preservación del sujeto del producto, edición local, adaptación de dimensiones y micro-tunación de estilo de marca LoRA.
La generación de texto a imagen (Text-to-Image) se refiere a la generación directa de imágenes a partir de una descripción de texto. Los usuarios no necesitan preparar materiales de diseño completos; solo necesitan describir el contenido deseado a través de un Prompt, por ejemplo, tema, sujeto, fondo, color, composición y estilo visual, y el modelo puede generar imágenes correspondientes según esta información.
Para la producción de contenido de marketing, el texto a imagen es más adecuado para la exploración de ideas creativas y la generación de esquemas visuales iniciales. Por ejemplo, antes de crear un póster de bebida de verano, se puede decirle al modelo "atmósfera de verano refrescante, cubos de hielo, espuma de agua, limón y hojas verdes, tonos azules-verdes claros, estilo de fotografía comercial", etc., para que el modelo genere rápidamente una imagen completa de marketing. En comparación con empezar a diseñar desde un lienzo en blanco, esta manera permite ver más rápidamente diferentes esquemas creativos.
Actualmente, la comunidad de código abierto ofrece varios modelos de generación de imágenes como Stable Diffusion, FLUX, Qwen-Image y Z-Image-Turbo. Existen diferencias entre los modelos en términos de calidad de imagen, comprensión de Prompt, capacidad de generación de texto y requisitos de recursos de hardware.
Iniciar sesión unirse a la discusión
En esta sección, se selecciona el modelo Z-Image-Turbo de ModelScope para el experimento de texto a imagen. La versión Turbo se enfoca en optimizar la eficiencia de generación, lo que permite completar la generación de imágenes con menos pasos de inferencia, por lo que es más adecuado para desarrolladores personales y entornos de experimentación con limitaciones de recursos de GPU.
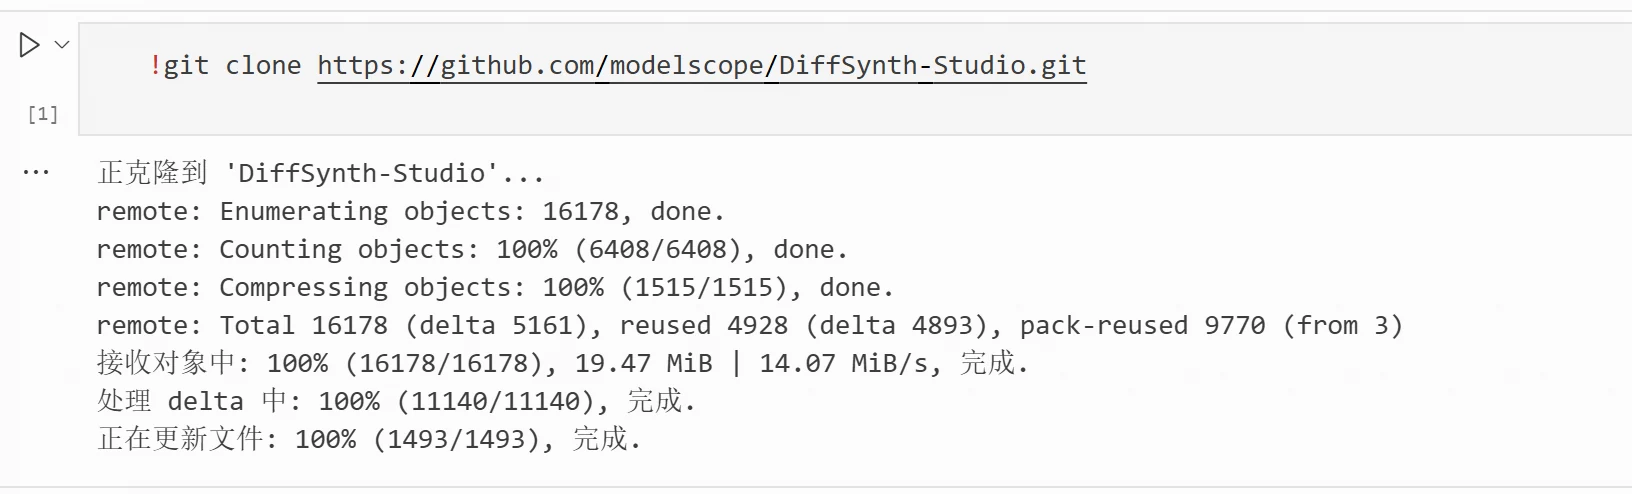
Usamos el framework DiffSynth-Studio para el texto a imagen, descarguemos DiffSynth-Studio
!git clone https://github.com/modelscope/DiffSynth-Studio.git
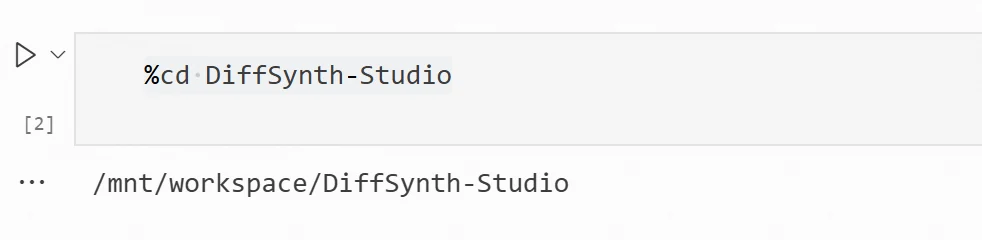
%cd DiffSynth-Studio
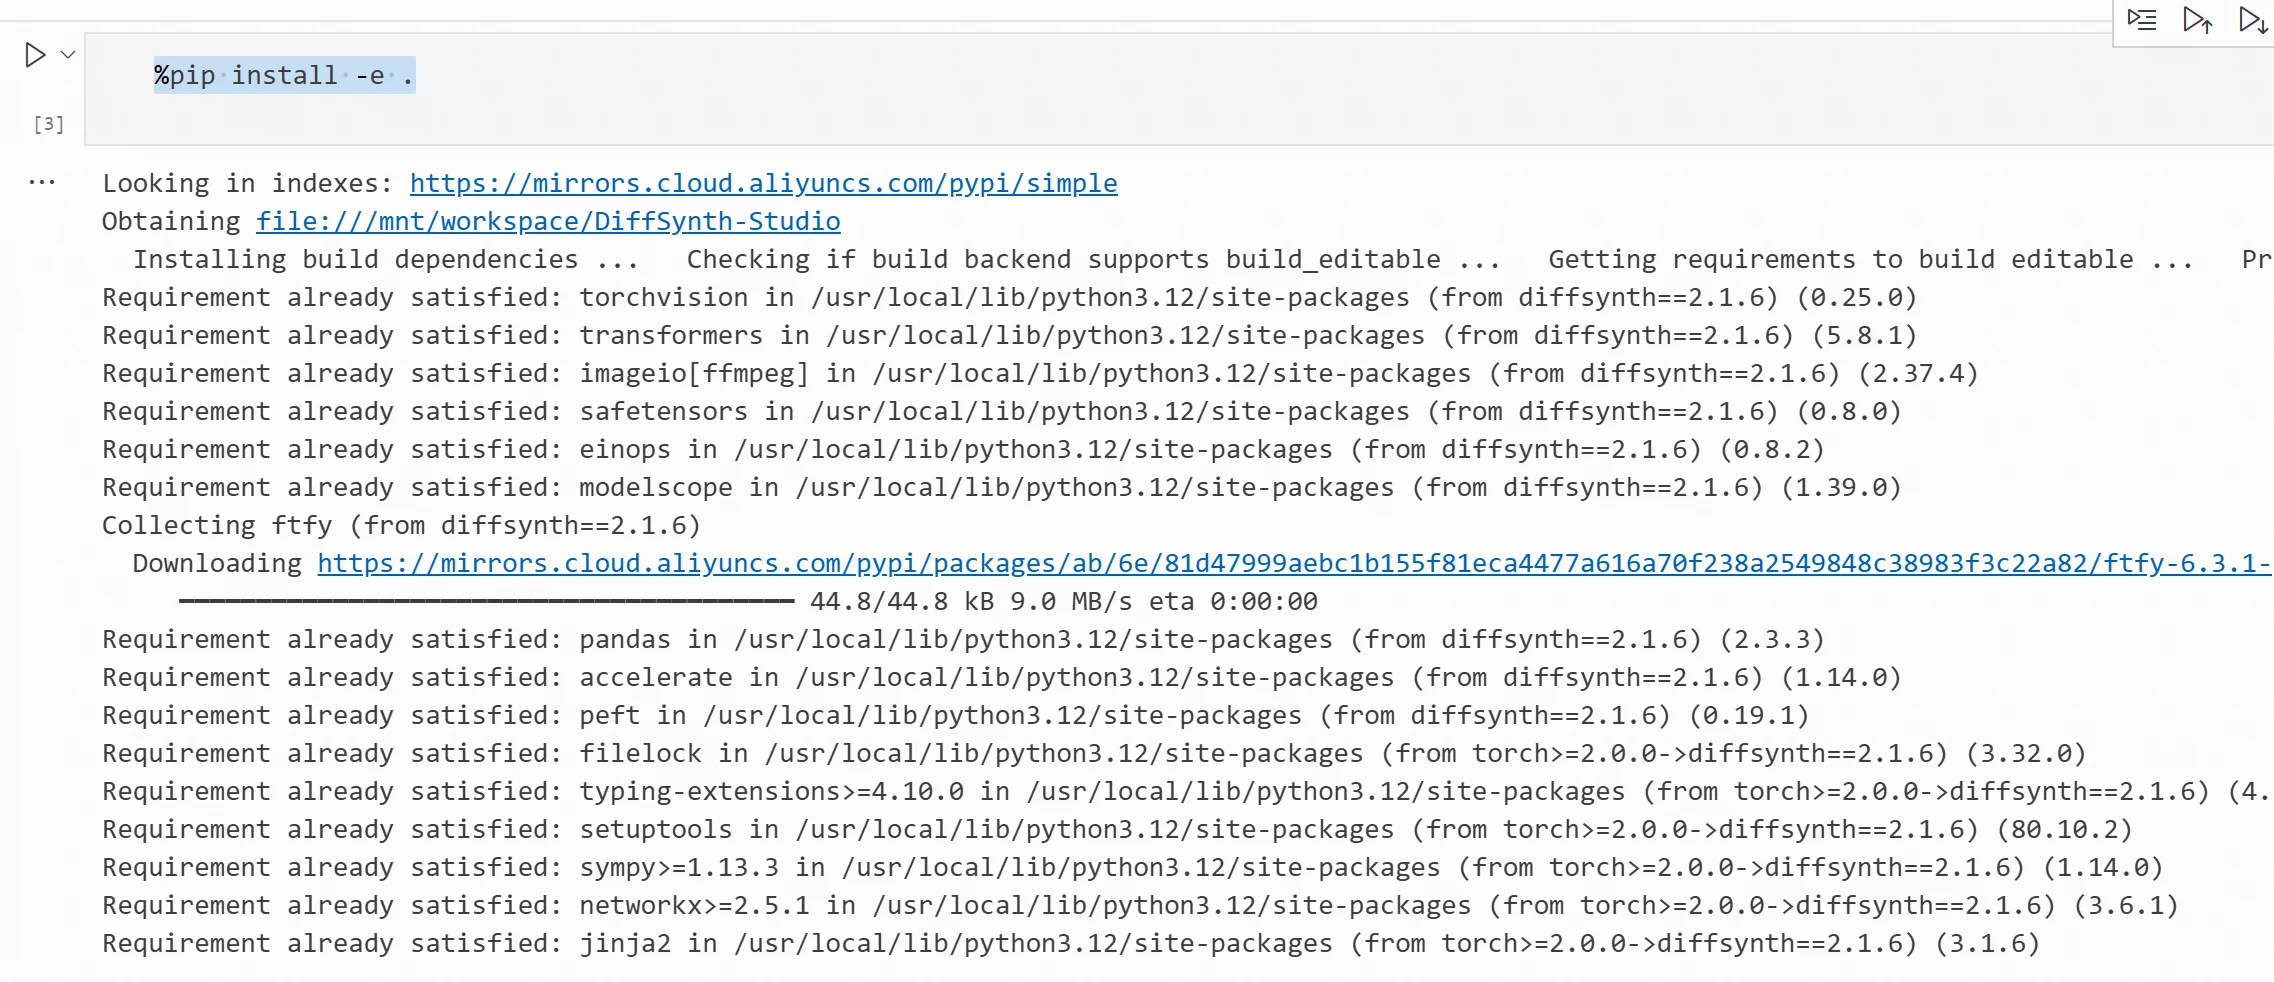
3) Instalación
%pip install -e .
4) En la celda de unidad, introduzca el siguiente código para la generación de texto a imagen.
import torch
from modelscope import ZImagePipeline
pipe = ZImagePipeline.from_pretrained(
    "Tongyi-MAI/Z-Image-Turbo",
    torch_dtype=torch.bfloat16,
    low_cpu_mem_usage=False,
)
pipe.to("cuda")
print(f"Dispositivo del modelo: {pipe.device}")

prompt = """ 夏日饮料商业宣传海报,
 清爽明亮的夏日氛围, 背景包含冰块、水花、柠檬和绿色树叶, 蓝绿色清爽色调, 商业广告摄影风格, 画面中央预留饮料商品展示区域, 背景简洁,光影自然, 高质量,细节清晰。 """
image = pipe(
    prompt=prompt,
    height=1024,
    width=1024,
    num_inference_steps=9,
    guidance_scale=0.0,
    generator=torch.Generator("cuda").manual_seed(42),
).images[0]

print("88888888888888888888888")
#display(image)
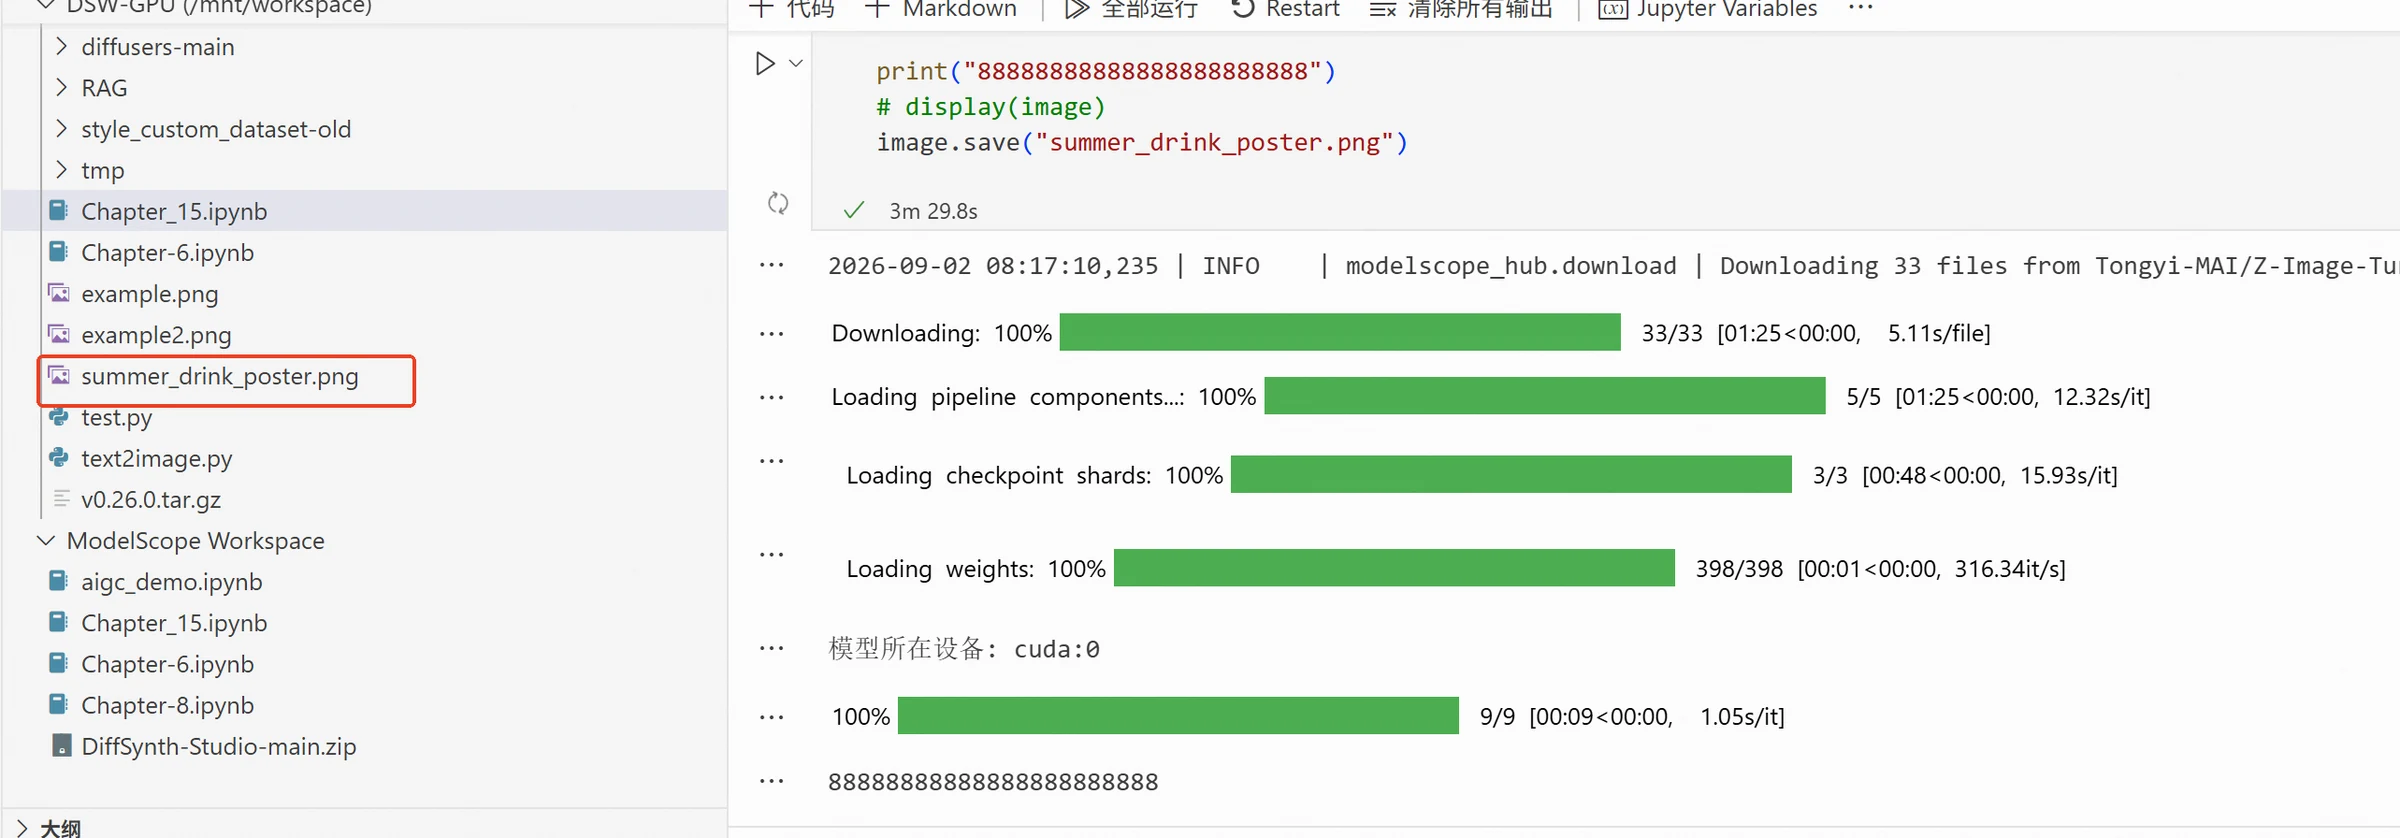
image.save("summer_drink_poster.png")
Después de la ejecución, se puede ver la imagen guardada en el espacio de trabajo.
El resultado de la imagen generada es el siguiente:
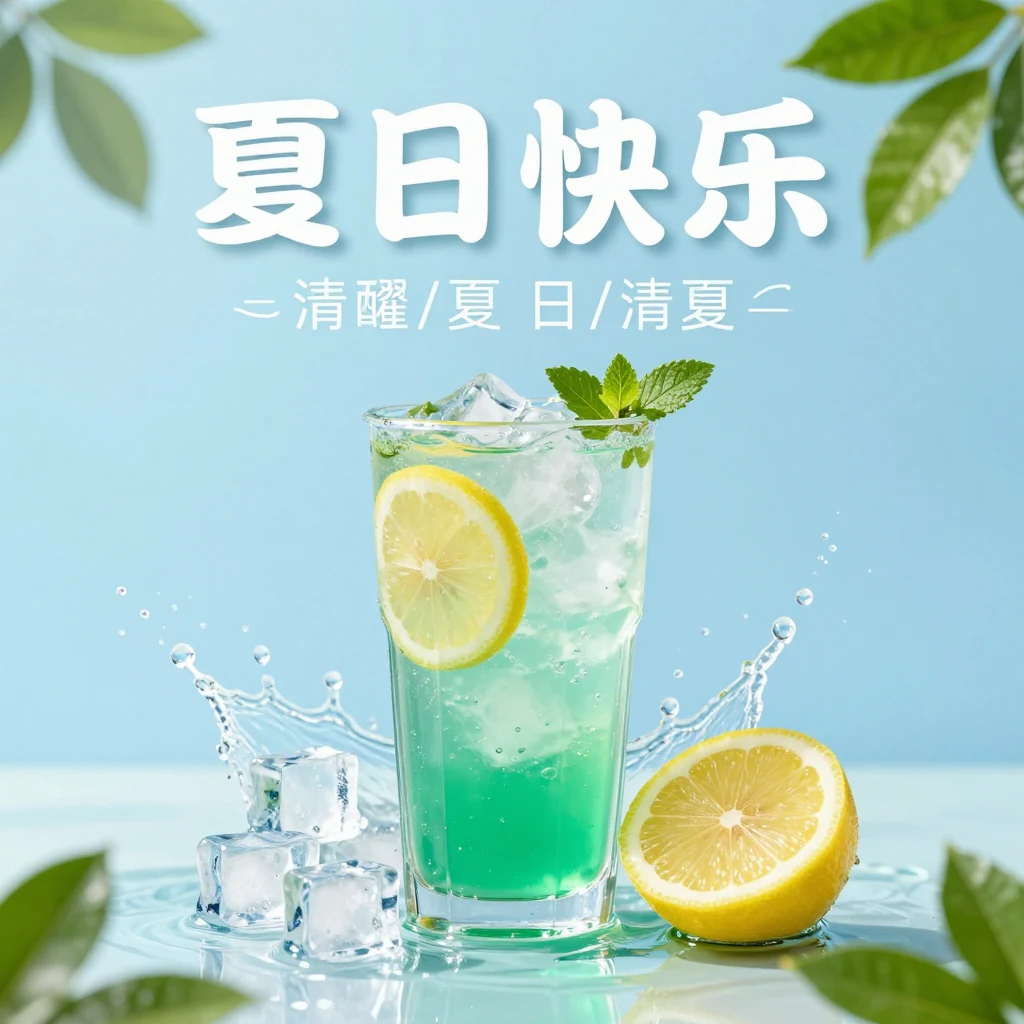
Para principiantes, no es necesario escribir un Prompt muy complejo al principio. Solo describa sus necesidades claramente y aumente los detalles según los resultados generados.
El texto a imagen es ideal para generar rápidamente ideas de marketing y esquemas de fondo, pero tiene un problema claro: si se pide directamente al modelo que genere un producto específico, el empaquetado, el logo y el texto pueden diferir del producto real, y en escenarios de marketing de productos oficiales, se necesita procesar aún más con imágenes del producto real.
El texto a imagen depende principalmente de la descripción de texto, mientras que el texto a imagen (Image-to-Image) toma al mismo tiempo una imagen de referencia y una descripción de texto. El modelo puede referirse al sujeto del producto, el empaquetado y la composición en la imagen original, y ajustar según el Prompt el fondo, la iluminación y los elementos de marketing.
En esta sección, se selecciona el modelo SenseNova-U1.5-8B-MoT como modelo de edición de imágenes. Este modelo soporta tareas como texto a imagen y edición de imágenes, puede entender al mismo tiempo la imagen de entrada y las instrucciones de texto, y ajustar según el Prompt los elementos especificados en la imagen original. En comparación con generar solo imágenes a partir de texto, SenseNova-U1.5-8B-MoT puede utilizar la información visual de la imagen de entrada, manteniendo el sujeto original y la estructura general, para modificar elementos como el empaquetado del producto, el fondo, el color y los elementos decorativos, por lo que es más adecuado para la generación y edición de imágenes de marketing de productos.
El experimento continúa usando la imagen generada en la sección anterior como entrada, editándola con el modelo de imagen a imagen. Se intenta mantener el frasco de bebida y la estructura general, añadiendo el logo de marca "FRESH DAY" y elementos de verano como cubos de hielo, espuma de agua y limones, generando así una imagen de marketing más completa. La carga predeterminada de SenseNova-U1.5-8B-MoT puede causar insuficiencia de memoria, por lo que se utiliza una configuración de bajo consumo de memoria en el código, reduciendo así el uso de memoria.
El código es el siguiente:
from diffsynth.pipelines.sensenova_u1_image import (
    SenseNovaU1ImagePipeline,
    ModelConfig
)
from PIL import Image
import torch
import os

MODEL_ID = "SenseNova/SenseNova-U1.5-8B-MoT"
INPUT_IMAGE = "/mnt/workspace/summer_drink_poster.png"
OUTPUT_IMAGE = "/mnt/workspace/drink_fresh_day_ad.png"

vram_config = {
    "offload_dtype": "disk",
    "offload_device": "disk",
    "onload_dtype": "disk",
    "onload_device": "disk",

    # Cargar en GPU solo cuando sea necesario para cálculos
    "preparing_dtype": torch.bfloat16,
    "preparing_device": "cuda",

    "computation_dtype": torch.bfloat16,
    "computation_device": "cuda",
}

print("Cargando SenseNova-U1.5-8B-MoT...")

pipe = SenseNovaU1ImagePipeline.from_pretrained(
    torch_dtype=torch.bfloat16,
    device="cuda",

    model_configs=[
        ModelConfig(
            model_id=MODEL_ID,
            origin_file_pattern="model*.safetensors",
            **vram_config
        ),
    ],

    tokenizer_config=ModelConfig(
        model_id=MODEL_ID,
        origin_file_pattern="./"
    ),
    vram_limit=(
        torch.cuda.mem_get_info("cuda")[1] / (1024 ** 3)
        - 0.5
    ),
)

print("Modelo cargado.")

if not os.path.exists(INPUT_IMAGE):
    raise FileNotFoundError(
        f"No se encontró la imagen de entrada: {INPUT_IMAGE}"
    )

edit_image = Image.open(INPUT_IMAGE).convert("RGB")

print(
    f"Tamaño de la imagen de entrada: "
    f"{edit_image.width} × {edit_image.height}"
)

prompt = """
Este es un ejercicio de edición de imágenes de producto de bebida.

Basado en la imagen del frasco de bebida, genere una imagen de marketing profesional y refrescante para una bebida de verano.

Se debe mantener el frasco de bebida como el sujeto principal de la imagen.
Mantener la forma del frasco, la tapa, la estructura del empaquetado, la proporción del frasco, el material y la apariencia general del producto. No generar o reemplazar por otro frasco de bebida.
El frasco debe mantenerse claro y completo, y ser el centro visual de la imagen.

En la zona del etiquetado frontal del frasco, añada un nuevo logo de marca para esta bebida:
"FRESH DAY".

"FRESH DAY" es el nombre de la marca de la bebida.
Diseñe el logo de marca de manera natural en el frontal del frasco, para que parezca impreso en el empaquetado real del producto, en lugar de un texto normal suspendido en la imagen.

El logo de marca debe tener un estilo visual simple, moderno y fresco.
Usar una tipografía clara y distintiva en inglés, y acompañarla de un pequeño diseño de hoja, para transmitir una sensación de naturaleza, salud, frescura y modernidad.

"FRESH DAY" debe mantenerse completo, claro y fácil de reconocer.
No generar nombres de marca adicionales, no añadir texto irrelevante, no repetir "FRESH DAY" fuera del cuerpo del frasco.

En la base de la imagen, optimizar el entorno de marketing manteniendo el frasco de bebida.

Añadir algunos cubos de hielo transparentes, espuma fresca y natural, gotas de condensación en el frasco y algunas rodajas de limón frescas,
para resaltar que la bebida es fría, refrescante y fresca.

Usar una luz de fotografía de producto comercial natural,
resaltar la transparencia del frasco, las gotas de condensación y la textura del producto.
El fondo debe mantenerse simple y limpio, no añadir elementos complejos.

El estilo general de la imagen debe ser moderno, limpio y de alta calidad, estilo de publicidad comercial de verano.
La composición debe ser clara y centrada, con la textura de una fotografía de producto comercial real.

El resultado final debe parecerse a un anuncio de marketing profesional de una marca de bebida real,
no a un dibujo, un cartoon o un diseño rediseñado de un producto de bebida.
"""

print("Comenzando la generación de la imagen de marketing de bebida de verano...")

image = pipe(
    prompt=prompt,

    # Imagen de producto original
    edit_image=edit_image,

    # Semilla fija para reproducibilidad del experimento
    seed=42,

    # Tamaño 3:4 vertical para marketing
    height=1536,
    width=1152,

    num_inference_steps=50,
    cfg_scale=4.0,
    shift=3.0,
)

image.save(OUTPUT_IMAGE)

print(
    f"Generación completada, la imagen se ha guardado en: {OUTPUT_IMAGE}"
)
El resultado de la ejecución es el siguiente:
La imagen generada final es:
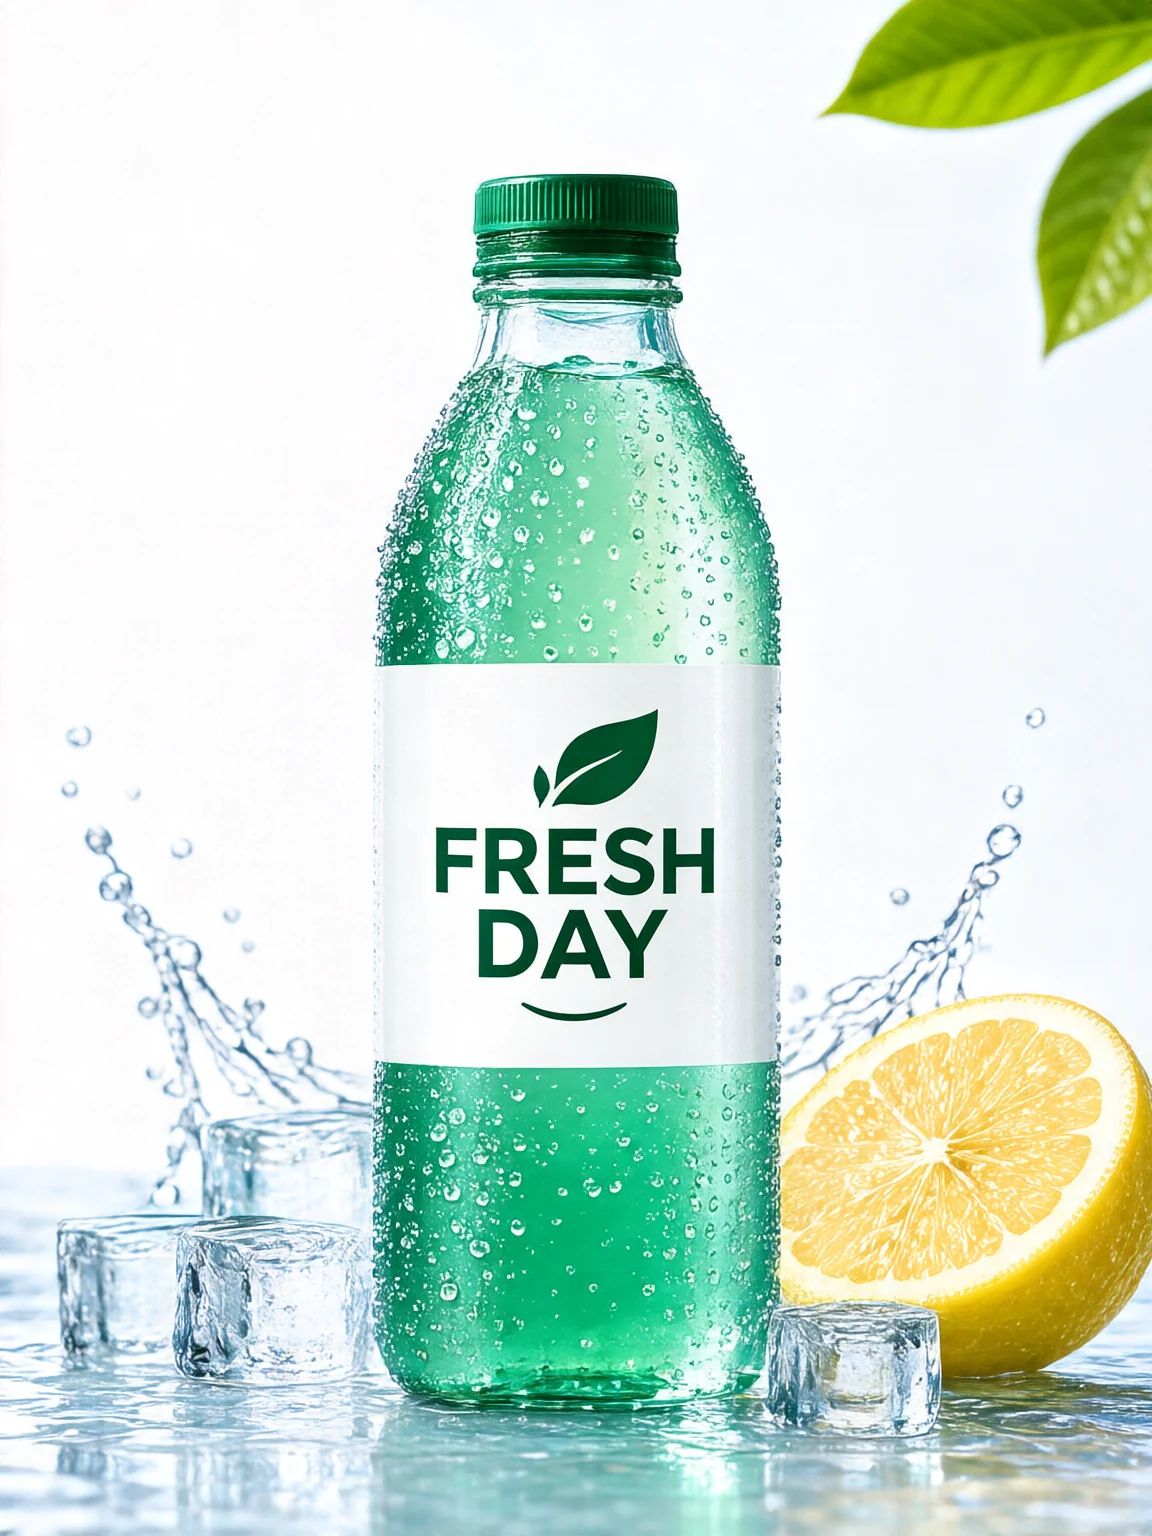
En comparación con la generación completa desde texto, el texto a imagen puede utilizar la información visual de la imagen original, lo que es más adecuado para escenarios donde se tiene el material del producto o un borrador de diseño. Como se puede ver en la imagen generada, aún existe una diferencia con el resultado deseado, incluso proporcionando la imagen real del producto, el modelo podría redibujar parte del producto. En escenarios prácticos, se necesita considerar más la preservación del sujeto del producto y la edición local.
En la aplicación práctica de imágenes de marketing de productos, además de la belleza de la imagen, también se necesita garantizar la precisión de la información del producto. La apariencia del frasco de bebida, la estructura del empaquetado, el logo de marca, etc., generalmente pertenecen a la información visual clave del producto, y si cambian significativamente durante el proceso de edición de imágenes, la imagen generada puede no coincidir con el producto real. Al usar modelos de generación de imágenes para la edición, se necesita distinguir claramente los elementos que se deben mantener y los que se pueden modificar. Por ejemplo, se puede solicitar al modelo que mantenga el frasco de bebida, el logo de marca y la composición general, solo ajustando el fondo, elementos decorativos o objetos locales. Al especificar estas restricciones en el Prompt, se puede reducir la generación de nuevo del sujeto del producto y hacer que los resultados de edición sean más controlables.
En esta sección, se continúa usando la imagen de marketing de FRESH DAY generada en la sección anterior para la edición local. Manteniendo el frasco de bebida, el logo de marca, los cubos de hielo, la espuma de agua y la composición general, se modificará el limón amarillo en la esquina inferior derecha a un limón verde. A través de este ejemplo, se puede comprender mejor cómo utilizar el Prompt para lograr una edición de imagen más controlada.
from diffsynth.pipelines.sensenova_u1_image import (
    SenseNovaU1ImagePipeline,
    ModelConfig
)
from PIL import Image
import torch
import os

MODEL_ID = "SenseNova/SenseNova-U1.5-8B-MoT"
INPUT_IMAGE = "/mnt/workspace/drink_fresh_day_ad.png"
OUTPUT_IMAGE = "/mnt/workspace/drink_fresh_day_lime.png"

vram_config = {
    "offload_dtype": "disk",
    "offload_device": "disk",
    "onload_dtype": "disk",
    "onload_device": "disk",

    "preparing_dtype": torch.bfloat16,
    "preparing_device": "cuda",

    "computation_dtype": torch.bfloat16,
    "computation_device": "cuda",
}

print("Cargando el modelo...")

pipe = SenseNovaU1ImagePipeline.from_pretrained(
    torch_dtype=torch.bfloat16,
    device="cuda",

    model_configs=[
        ModelConfig(
            model_id=MODEL_ID,
            origin_file_pattern