Data: The Foundation of Fine-Tuning
Les Données sont la Base de l'Affinement des Modèles Open Source
Avez-vous déjà rencontré un modèle qui excelle en codage et mathématiques, mais donne des réponses aléatoires aux questions du quotidien ?
On sait tous que pour améliorer une capacité spécifique lors de l'entraînement, il faut trouver le type de données correspondant,
Mais de nombreux jeux de données sont difficiles à trouver par recherche directe. Un portail unifié fait gagner un temps précieux aux formateurs.
Par exemple, notre jeu de données distillé DeepSeek-R1 en chinois a été en grande partie téléchargé depuis ModelScope,
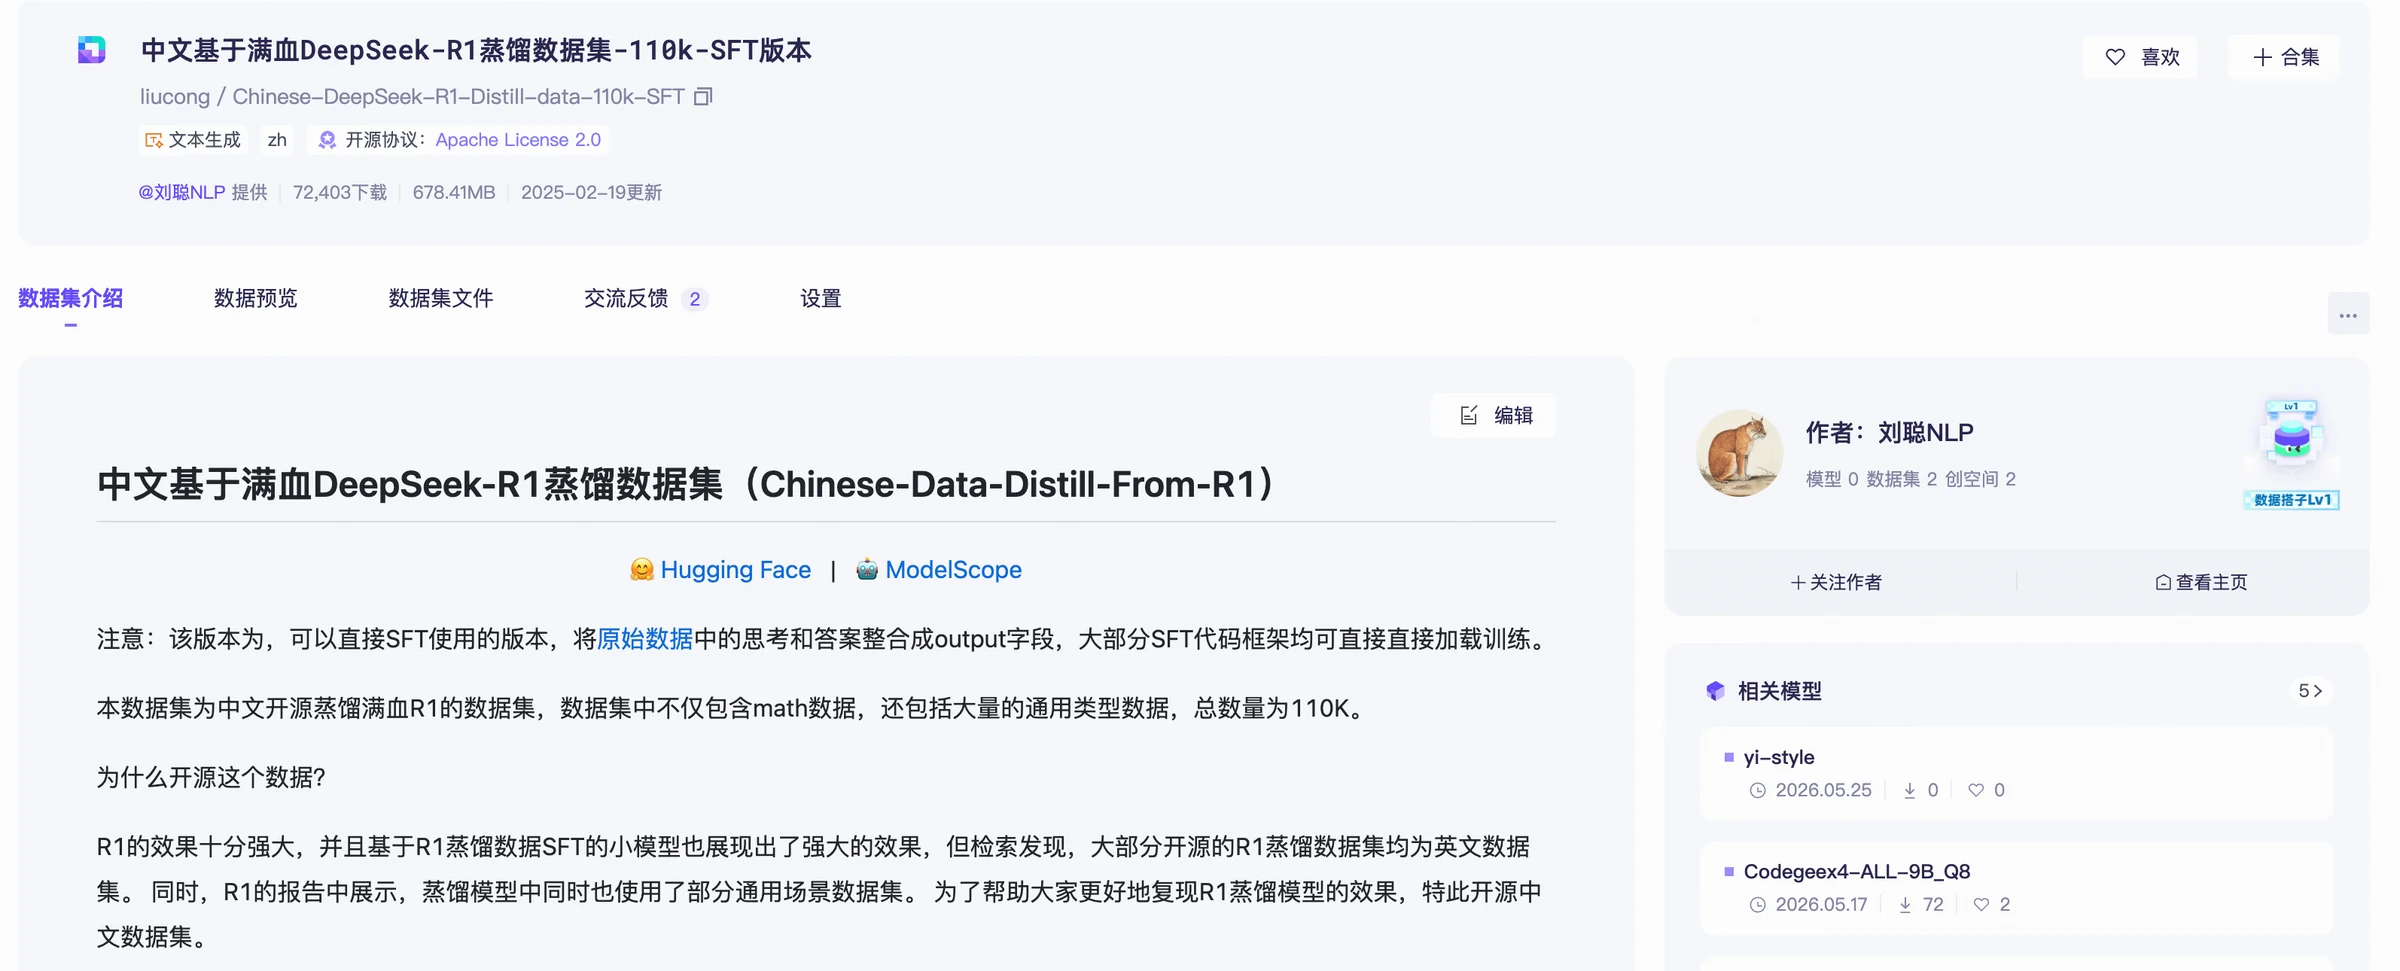
L'affinement d'un modèle peut commencer par un jeu de données open source existant, permettant de tester rapidement l'ensemble du processus.
Trouver des Données Commence par Savoir Ce que Vous Voulez Faire
ModelScope offre plus de 40 000 jeux de données open source, avec recherche, aperçu, descriptions de champs et versions.
ModelScope permet la recherche par mots-clés et catégories de tâches, comme les données de classification binaire en chinois,
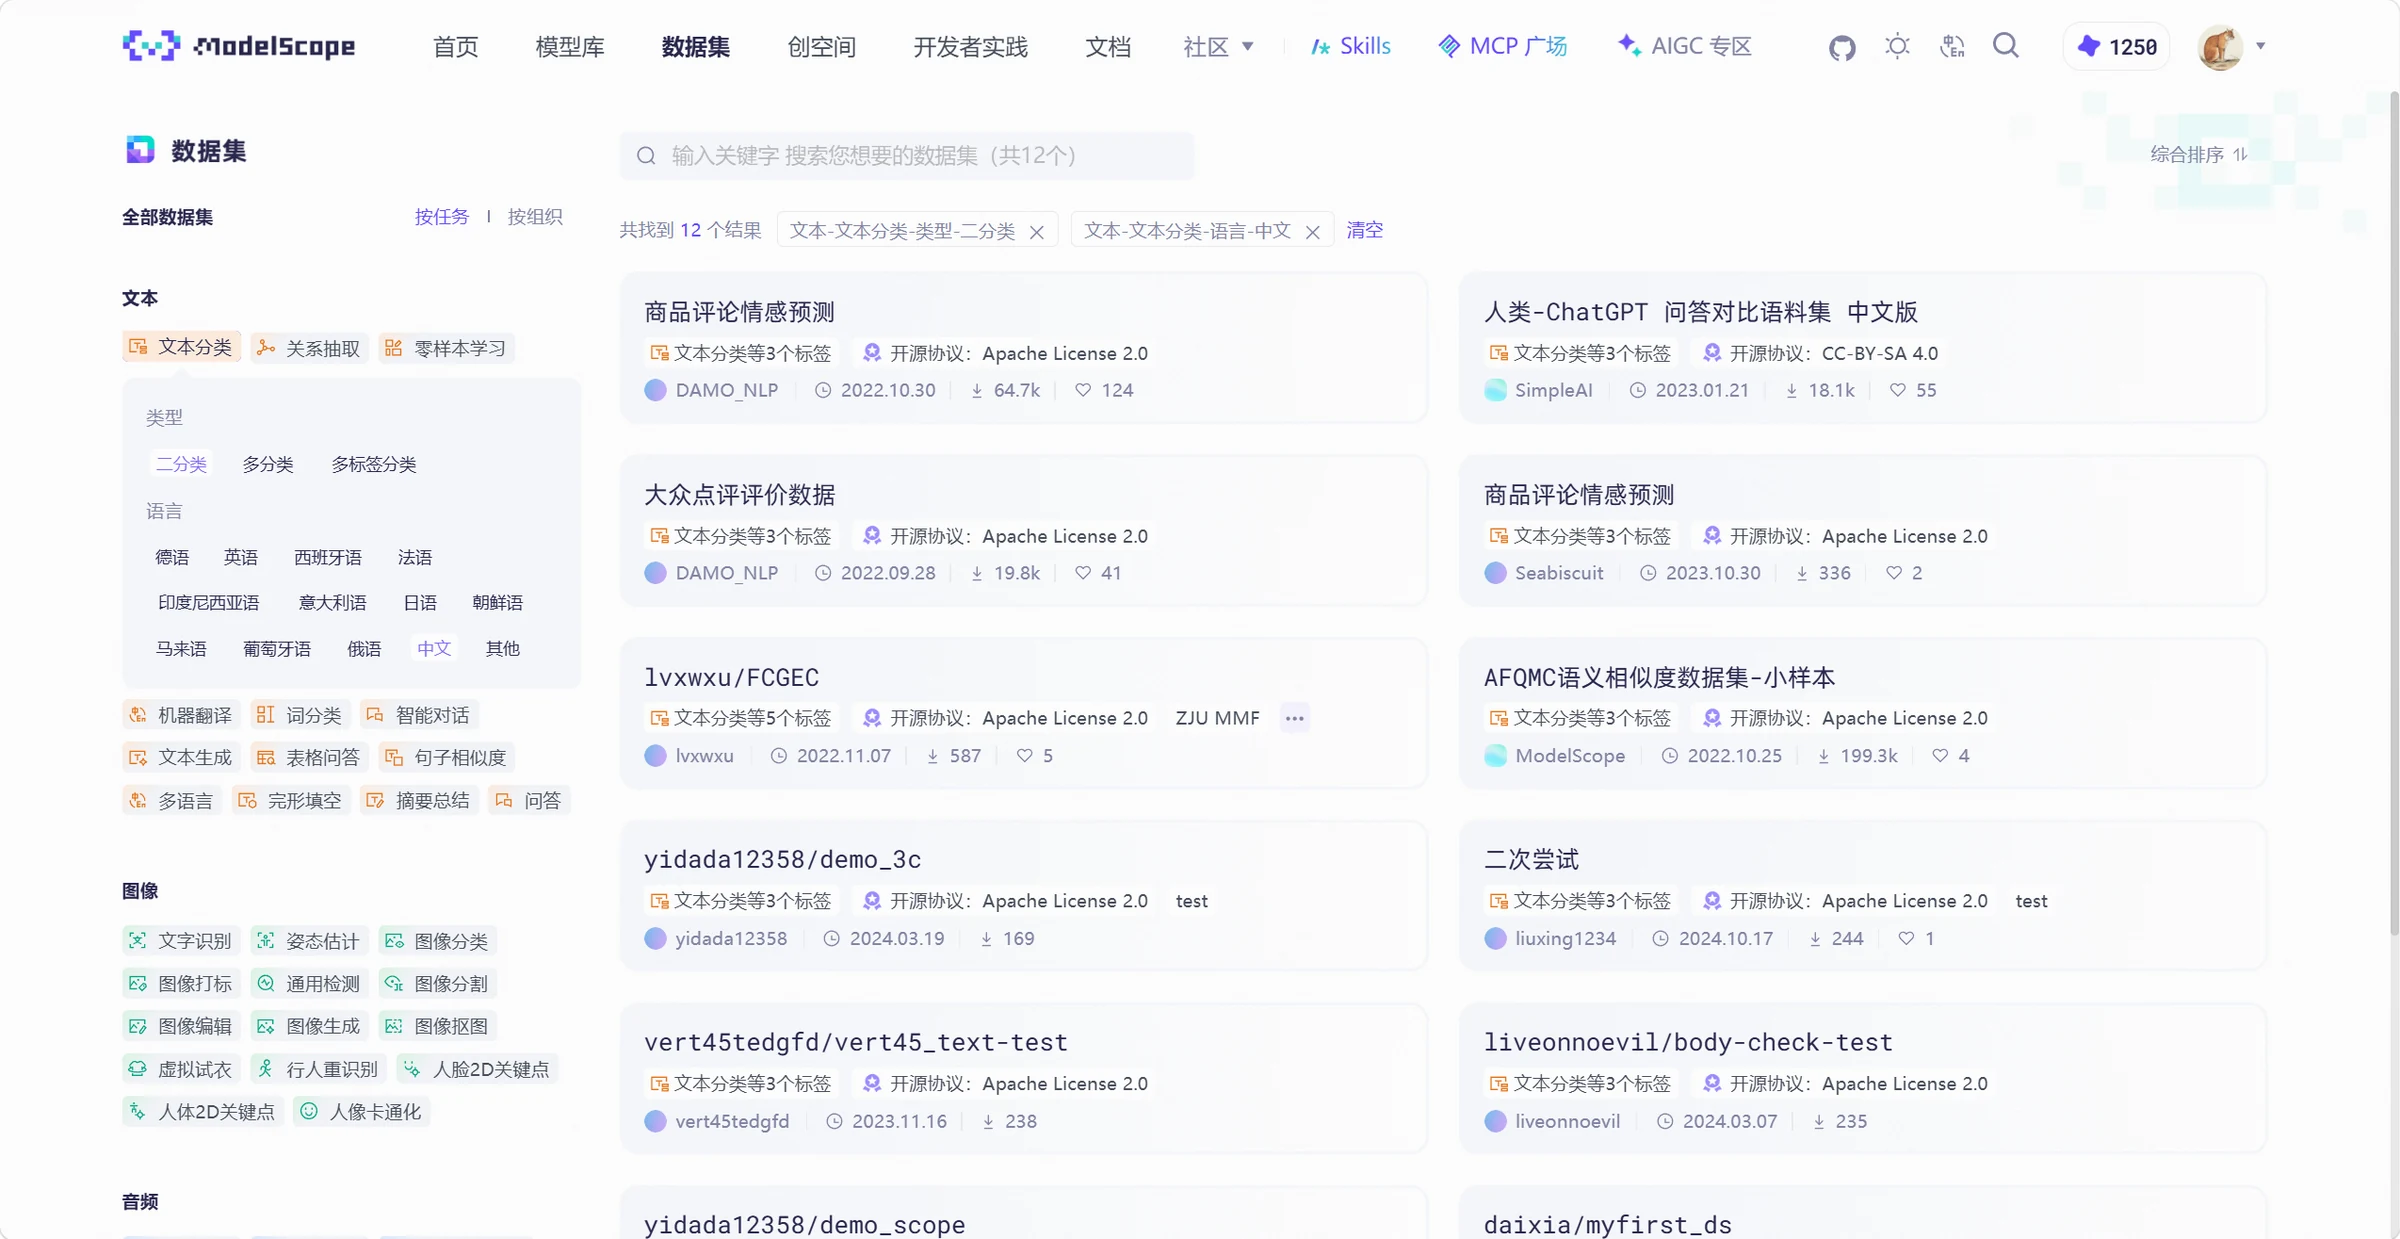
Avant de Télécharger, Consultez Quelques Échantillons
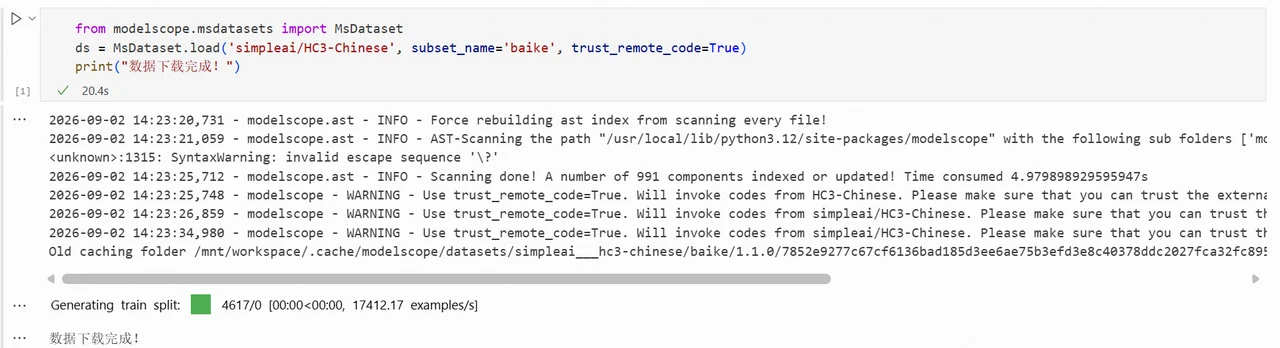
Après avoir filtré, sélectionnez un jeu de données et cliquez sur 'Aperçu' pour voir les échantillons, comme simpleai/HC3-Chinese.
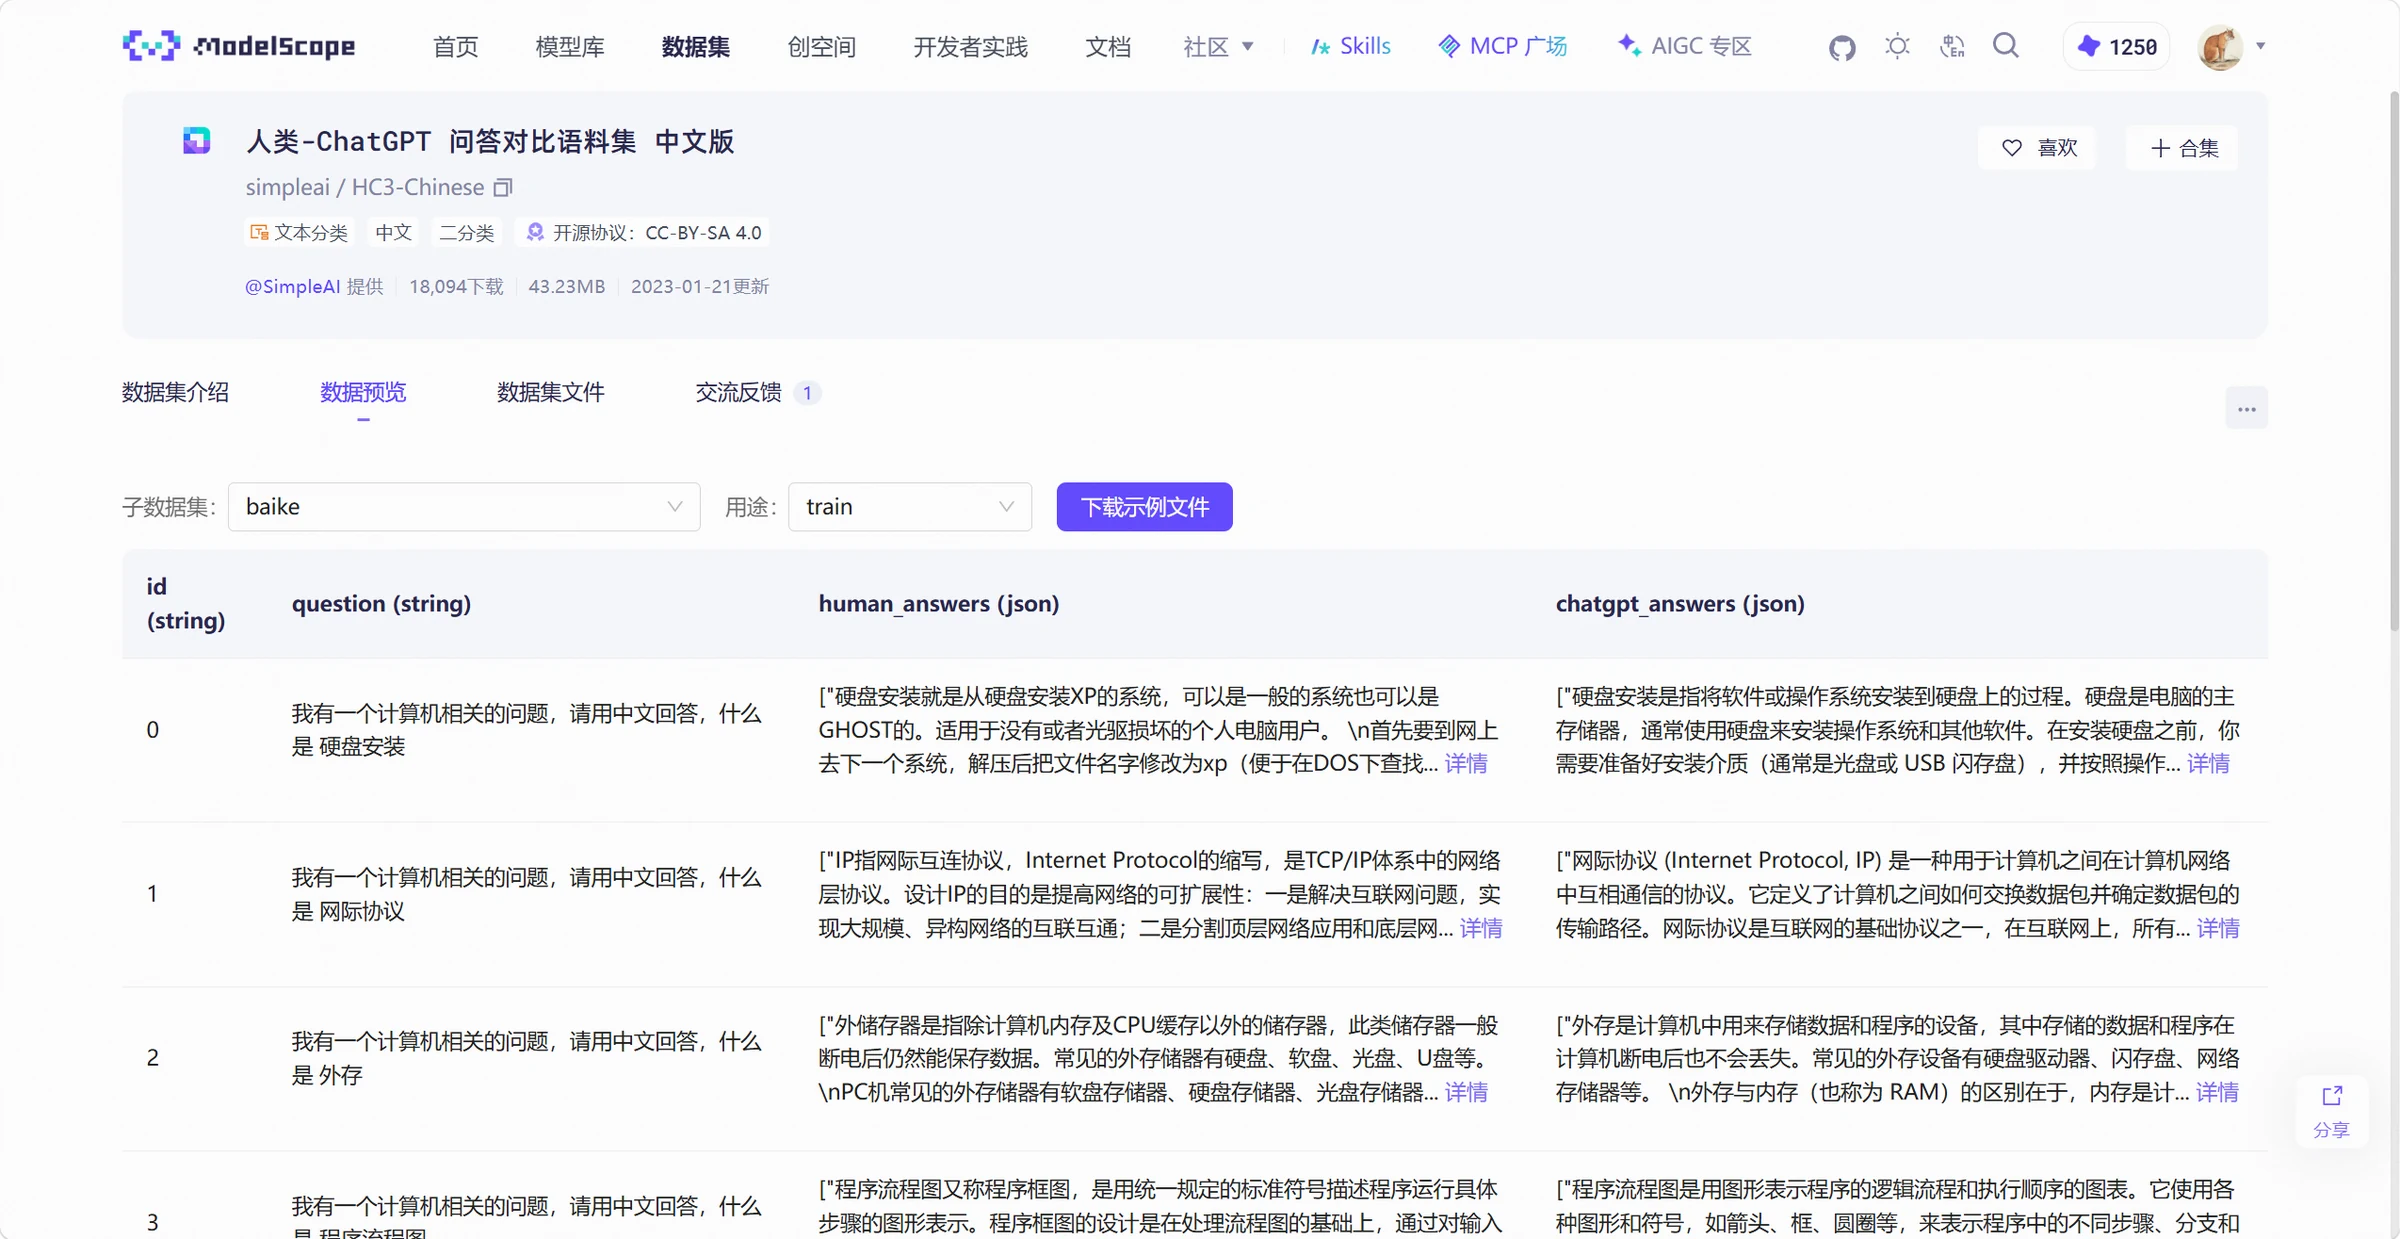
Quelle colonne contient la question, la réponse, les labels, et si chaque enregistrement est un texte ou un dialogue — tout cela peut être vérifié à l'avance.
Pour les données QA, les réponses humaines et modélisées peuvent être dans des champs différents. Décidez quels champs lire et comment organiser avant l'entraînement.
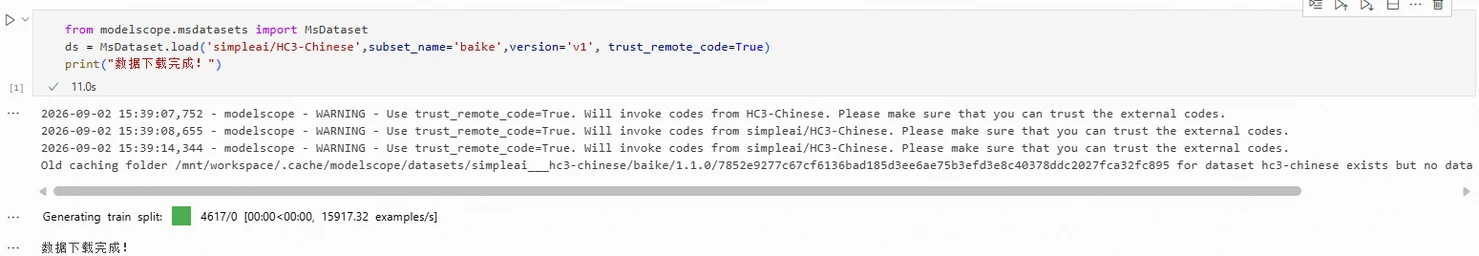
Vérifiez les fichiers et versions. Les jeux de données sont mis à jour ; notez la version utilisée pour la reproductibilité.
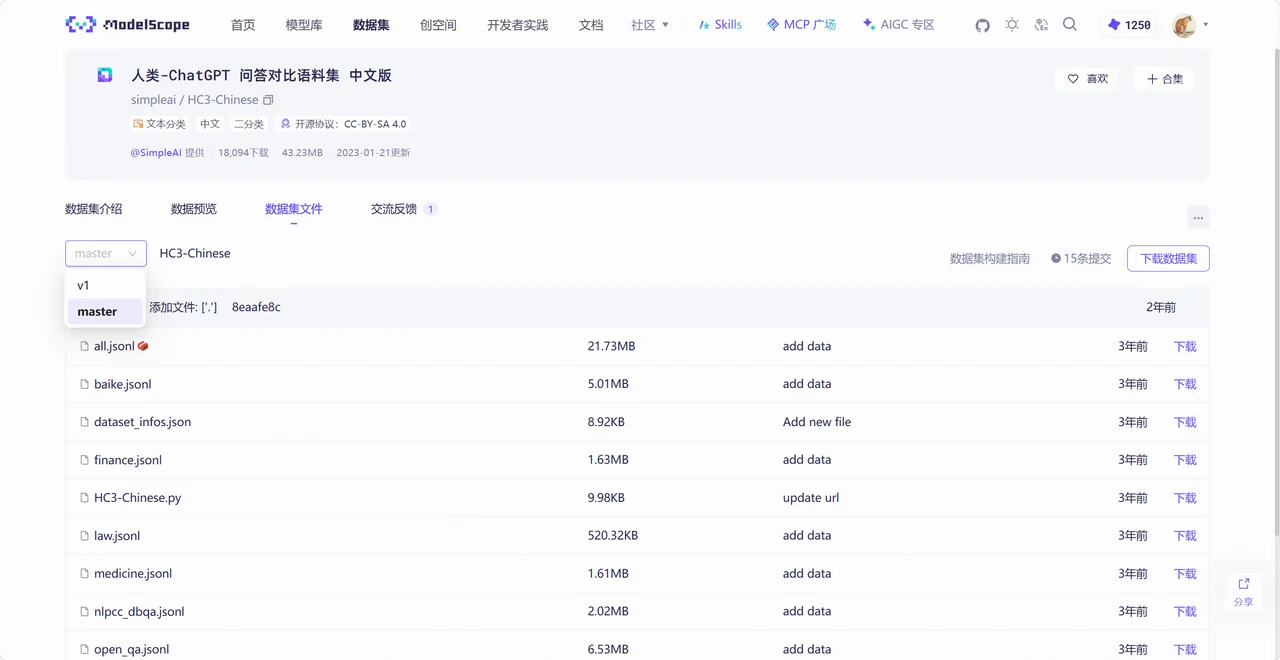
Les descriptions et licences valent la peine d'être consultées. Les données téléchargées peuvent avoir des exigences différentes pour la recherche, l'entraînement ou l'usage commercial.
Chargez les Données d'Abord, puis Décidez Quoi Utiliser
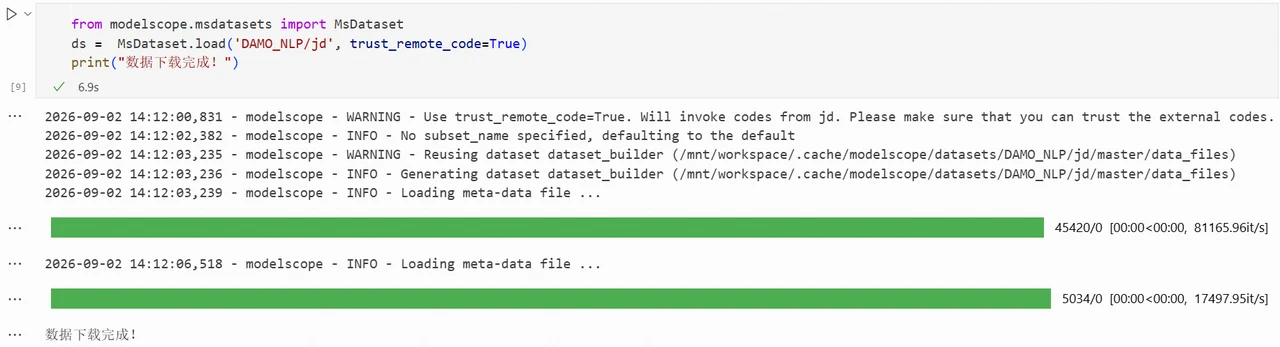
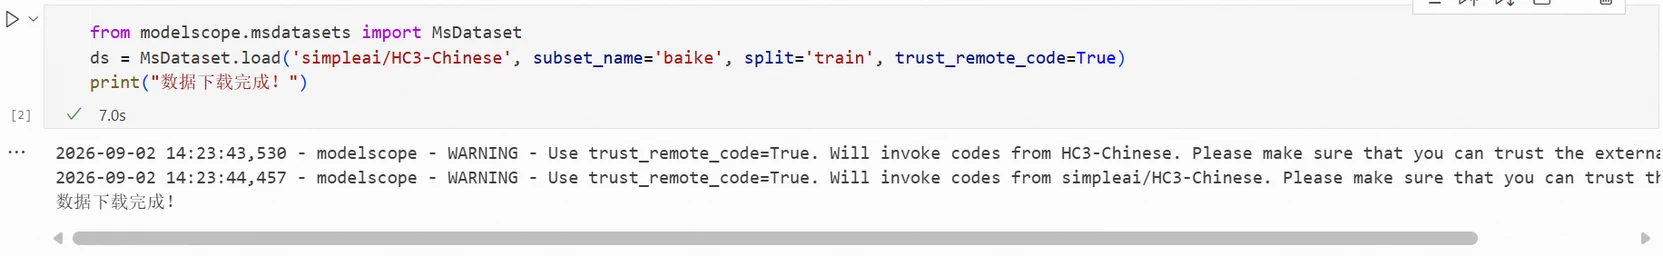
ModelScope fournit l'interface MsDataset.load pour charger des jeux de données en Python. Après installation, suivez les instructions de la page du jeu de données.
Chargez d'Abord un Jeu de Données Complet
Avec DAMO_NLP/jd comme exemple, voici comment lire la configuration par défaut,
Discussion
Se connecter pour rejoindre la discussion