Comprendre les modèles open-source • Débutant⏱️ 15 min de lecture
What Open-Source Models Are Changing
Qu'est-ce que les modèles open source changent ?
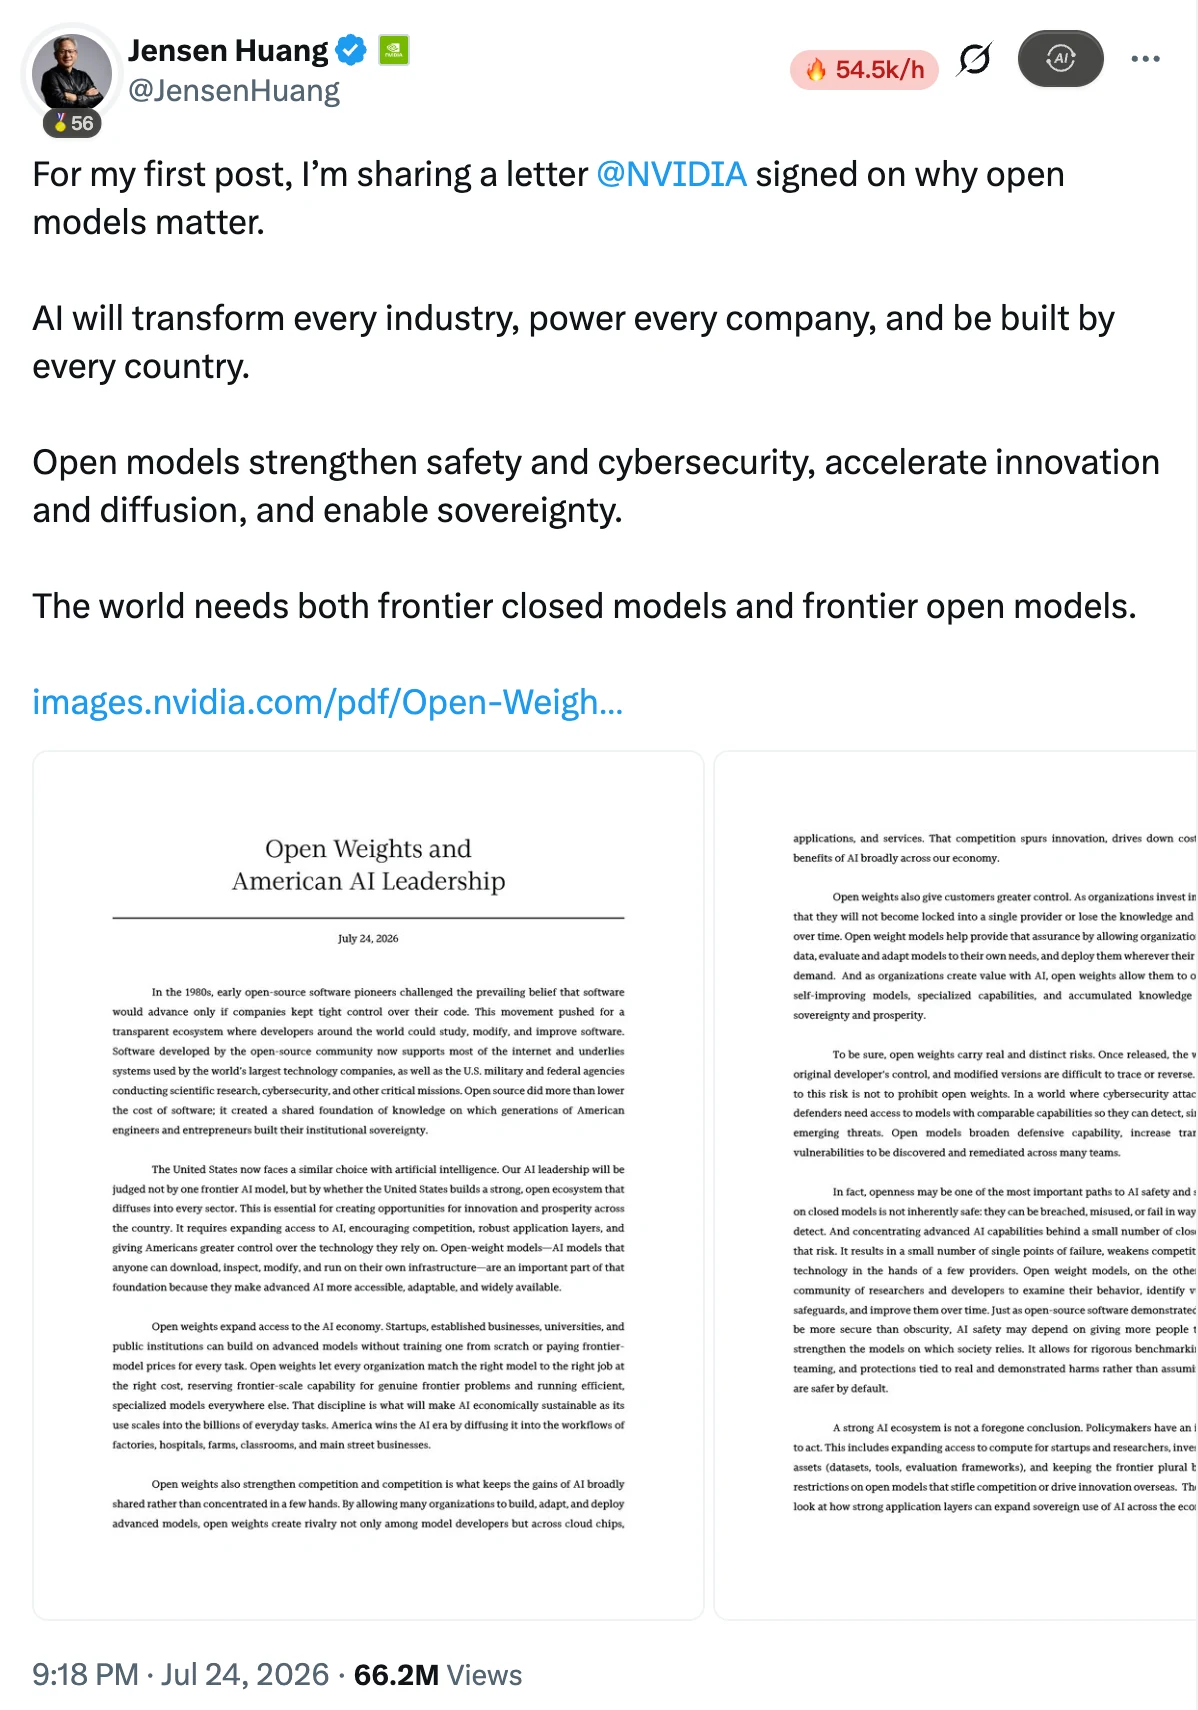
Vous ne l'auriez pas imaginé, mais le PDG de Nvidia, Jensen Huang, a publié son premier post sur X, et il était dédié à l'open source.
Le 24 juillet 2026, il a partagé une lettre ouverte signée par Nvidia, discutant de pourquoi les modèles ouverts sont importants :
Ce monde a besoin à la fois de modèles propriétaires de pointe et de modèles ouverts de pointe.
Beaucoup de gens se sont peut-être habitués à ouvrir une fenêtre de chat, envoyer une question et attendre que l'IA réponde. Mais lorsque vous commencez à utiliser l'IA pour traiter les données de l'entreprise sur le long terme ou à intégrer des systèmes internes, vous pourriez rencontrer les problèmes suivants : Les données sont-elles sécurisées lorsqu'elles sont envoyées ? Que se passe-t-il si le service impose soudainement des limites de débit ? Le modèle peut-il apprendre la façon dont votre entreprise traite les données ?
Les modèles open source offrent une autre solution à ces problèmes. Vous pouvez télécharger le modèle dans le cadre de la licence, le déployer dans votre propre environnement, continuer à l'affiner et laisser les utilisateurs décider comment l'utiliser.
Bien sûr, le débat entre open source et proprietary pour les grands modèles a toujours été un sujet de discussion sans fin. La lettre de Jensen Huang a de nouveau résonné avec nous, et nous avons décidé de nous associer à plusieurs co-créateurs pour lancer ce voyage pratique des applications de modèles open source dans un livre violet. Cette fois, nous vous apportons du contenu pratique sur les applications de modèles open source. Que les modèles open source prospèrent !
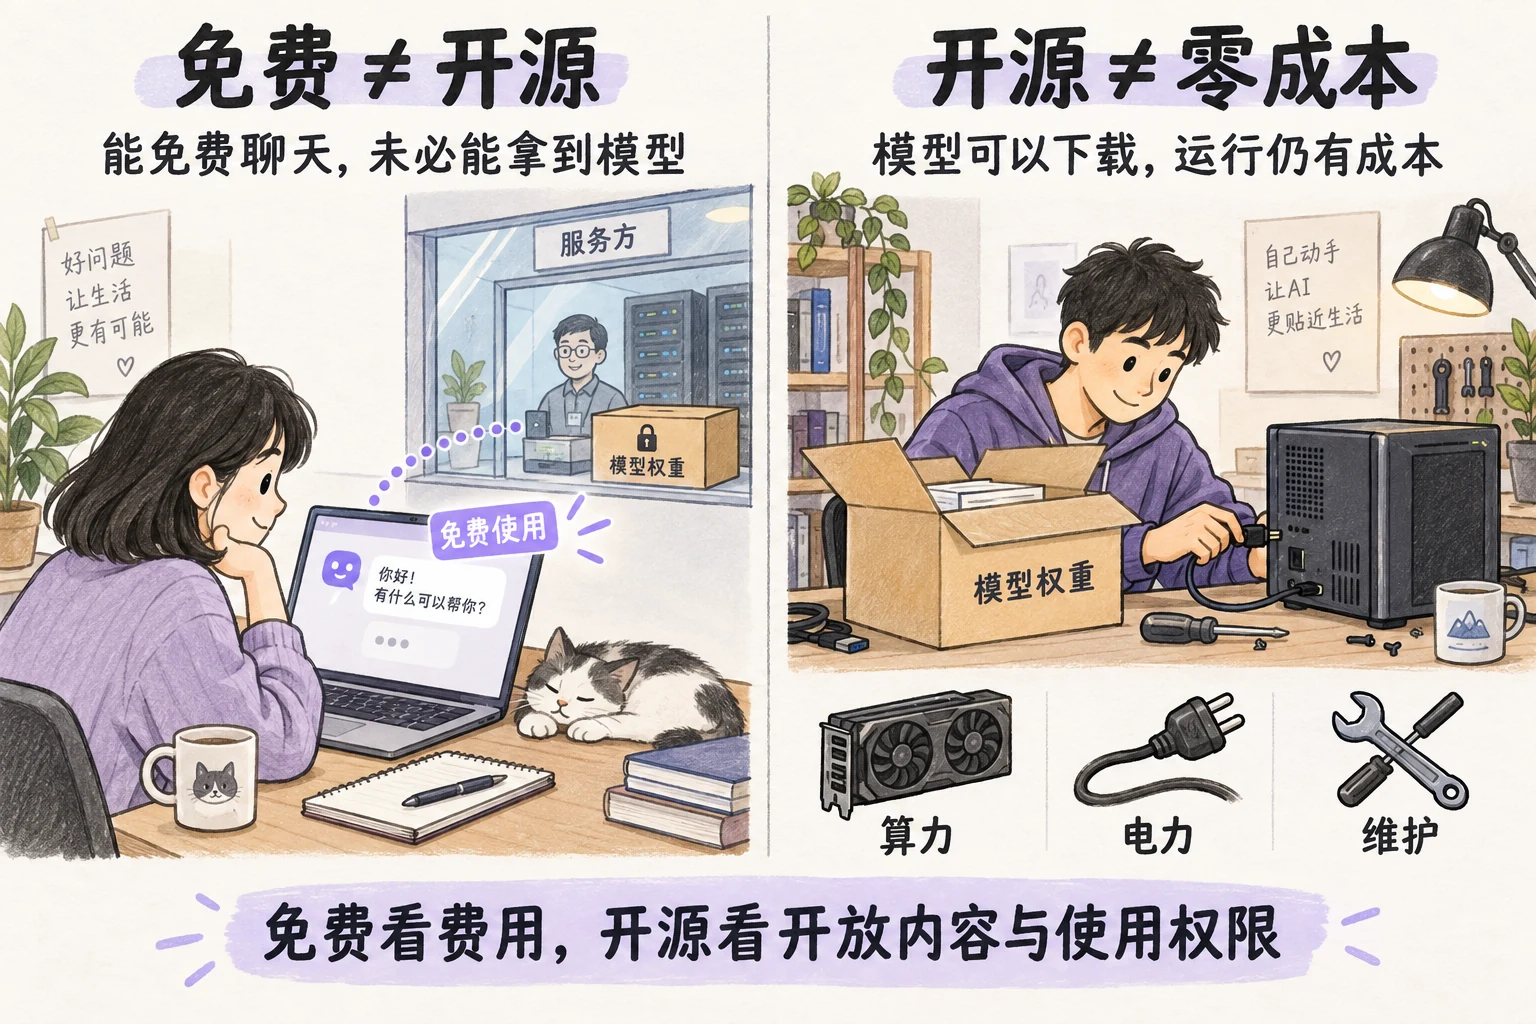
N'oubliez pas, gratuit ne signifie pas nécessairement open source, et open source ne signifie pas nécessairement gratuit ?
Lorsque vous discutez avec une IA sur un site web ou interrogez un modèle via une API, le modèle est généralement exécuté par le fournisseur du modèle. Vous soumettez des entrées, et le fournisseur renvoie les résultats. Vous n'avez généralement pas à vous soucier de la configuration du serveur ou de la maintenance du modèle.
Les modèles open source offrent une autre option, vous permettant d'obtenir les paramètres du modèle après l'entraînement, communément appelés poids. Avec des logiciels et du matériel appropriés, ces paramètres peuvent s'exécuter sur votre ordinateur, serveur ou cloud privé. Les questions qui devaient auparavant être envoyées à des services externes peuvent désormais être traitées dans votre propre environnement.
Il y a deux choses ici qui sont facilement confondues.
« Gratuit » fait référence à la question de savoir si vous devez payer ; « open source » fait référence à ce que vous pouvez obtenir et comment vous êtes autorisé à l'utiliser. Un produit de chat peut être gratuit sans fournir les poids du modèle. Un modèle qui est gratuit à télécharger nécessite toujours de la puissance de calcul et des coûts de maintenance pour fonctionner.
Une API est simplement un moyen d'accéder aux modèles. Les modèles open source peuvent être hébergés par des fournisseurs de services et vous être fournis via des API. Les modèles que vous déployez vous-même peuvent également être mis à disposition de vos collègues via des API internes. Par conséquent, « open source vs. propriétaire » et « appeler des API vs. auto-déploiement » doivent être considérés séparément.
Dans les discussions quotidiennes, les gens réfèrent souvent collectivement aux modèles dont les poids peuvent être téléchargés comme modèles open source. Nous suivrons également cette convention courante dans les chapitres suivants.
Cependant, lors de distinctions strictes, nous clarifierons que les poids ouverts n'équivalent pas à l'open source pour l'ensemble du processus d'entraînement du modèle. Les données d'entraînement, le code d'entraînement et les permissions d'utilisation doivent toujours être examinés séparément.
Tous appelés open source, mais ce qui est ouvert varie~
Après avoir obtenu un modèle, vous êtes probablement curieux de savoir comment il a été entraîné.
C'est là que les différences entre les différents modèles deviennent apparentes. Certains vous permettent de les télécharger et de les exécuter sans divulguer les matériaux d'entraînement complets. D'autres vont plus loin en fournissant du code d'entraînement et des descriptions de données, permettant aux développeurs externes d'étudier la trajectoire d'entraînement du modèle.
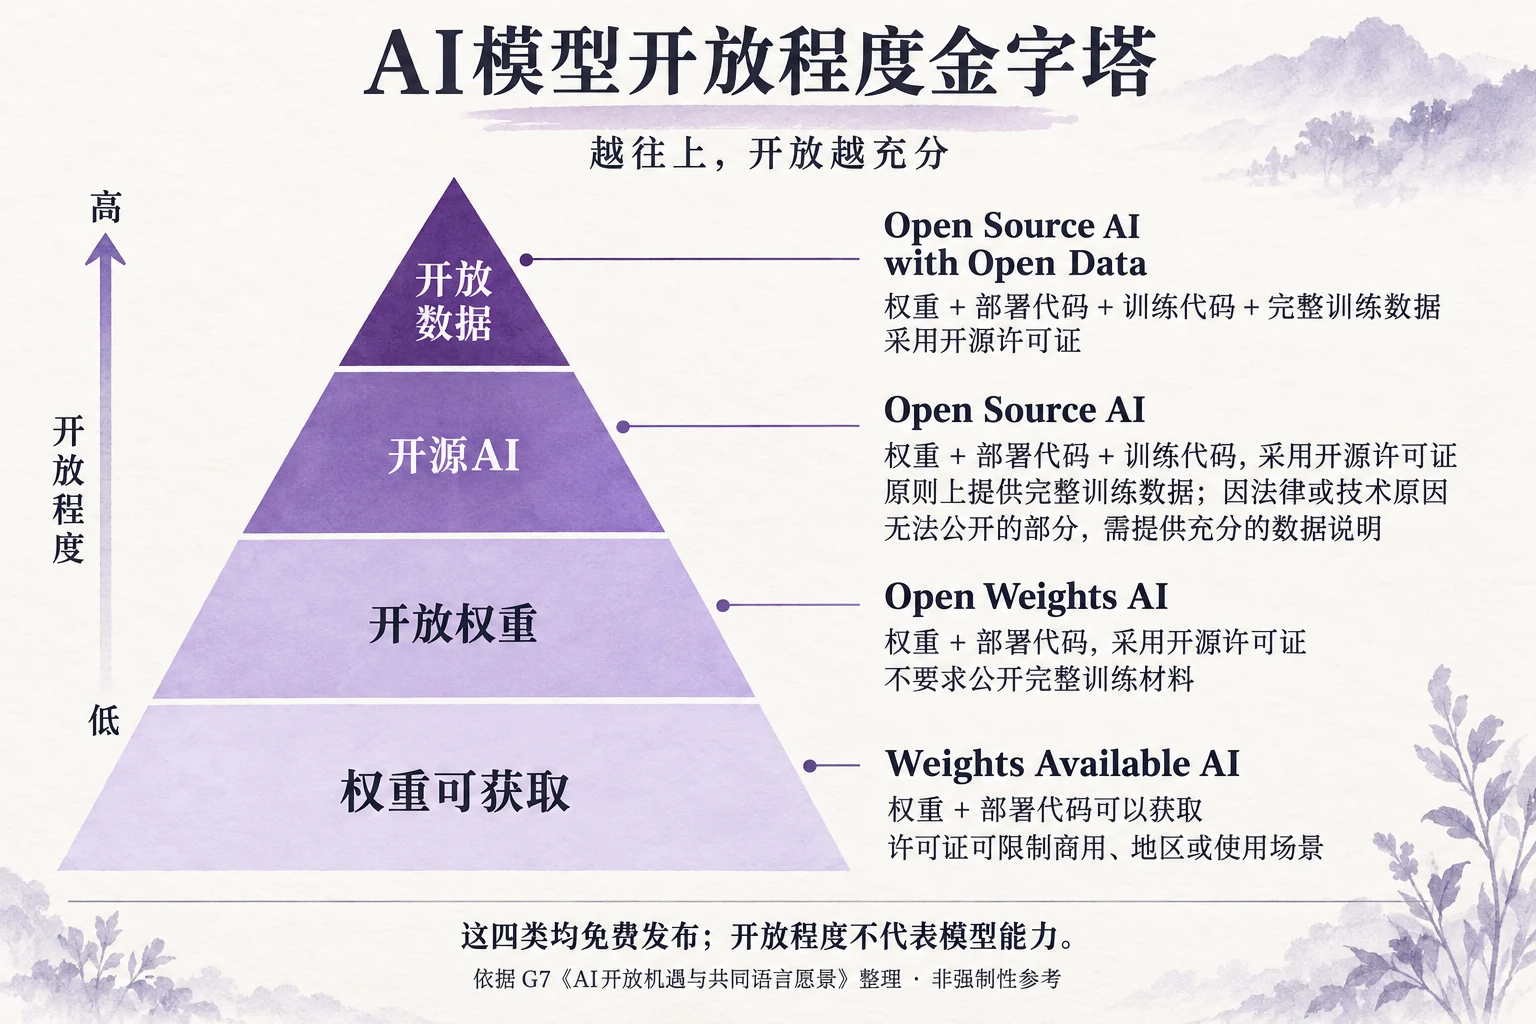
En mai 2026, le G7 a publié un document de référence commun sur l'ouverture de l'IA, catégorisant ces différences en quatre types, du plus haut au plus bas degré d'ouverture :
Même les données d'entraînement complètes sont publiques. Les poids du modèle, le code de déploiement, le code d'entraînement et les données d'entraînement complètes sont tous fournis sous des licences open source, correspondant à Open Source AI with Open Data.
Les poids et le code sont publics, avec des données restreintes expliquées en détail. Correspondant à Open Source AI. Les données d'entraînement complètes devraient en principe être fournies ; les parties qui ne peuvent pas être partagées pour des raisons légales ou techniques doivent être remplacées par une documentation adéquate.
Un modèle entraîné vous est remis pour exécution et modification. Correspondant à Open Weights AI, fournissant des poids et du code de déploiement sous des licences open source, mais ne divulguant pas nécessairement les matériaux d'entraînement complets.
Téléchargeable, mais avec des conditions supplémentaires lors de l'utilisation. Correspondant à Weights Available AI, où les poids et le code de déploiement peuvent être obtenus, mais les licences peuvent restreindre l'utilisation commerciale, les régions d'utilisation ou les scénarios spécifiques.
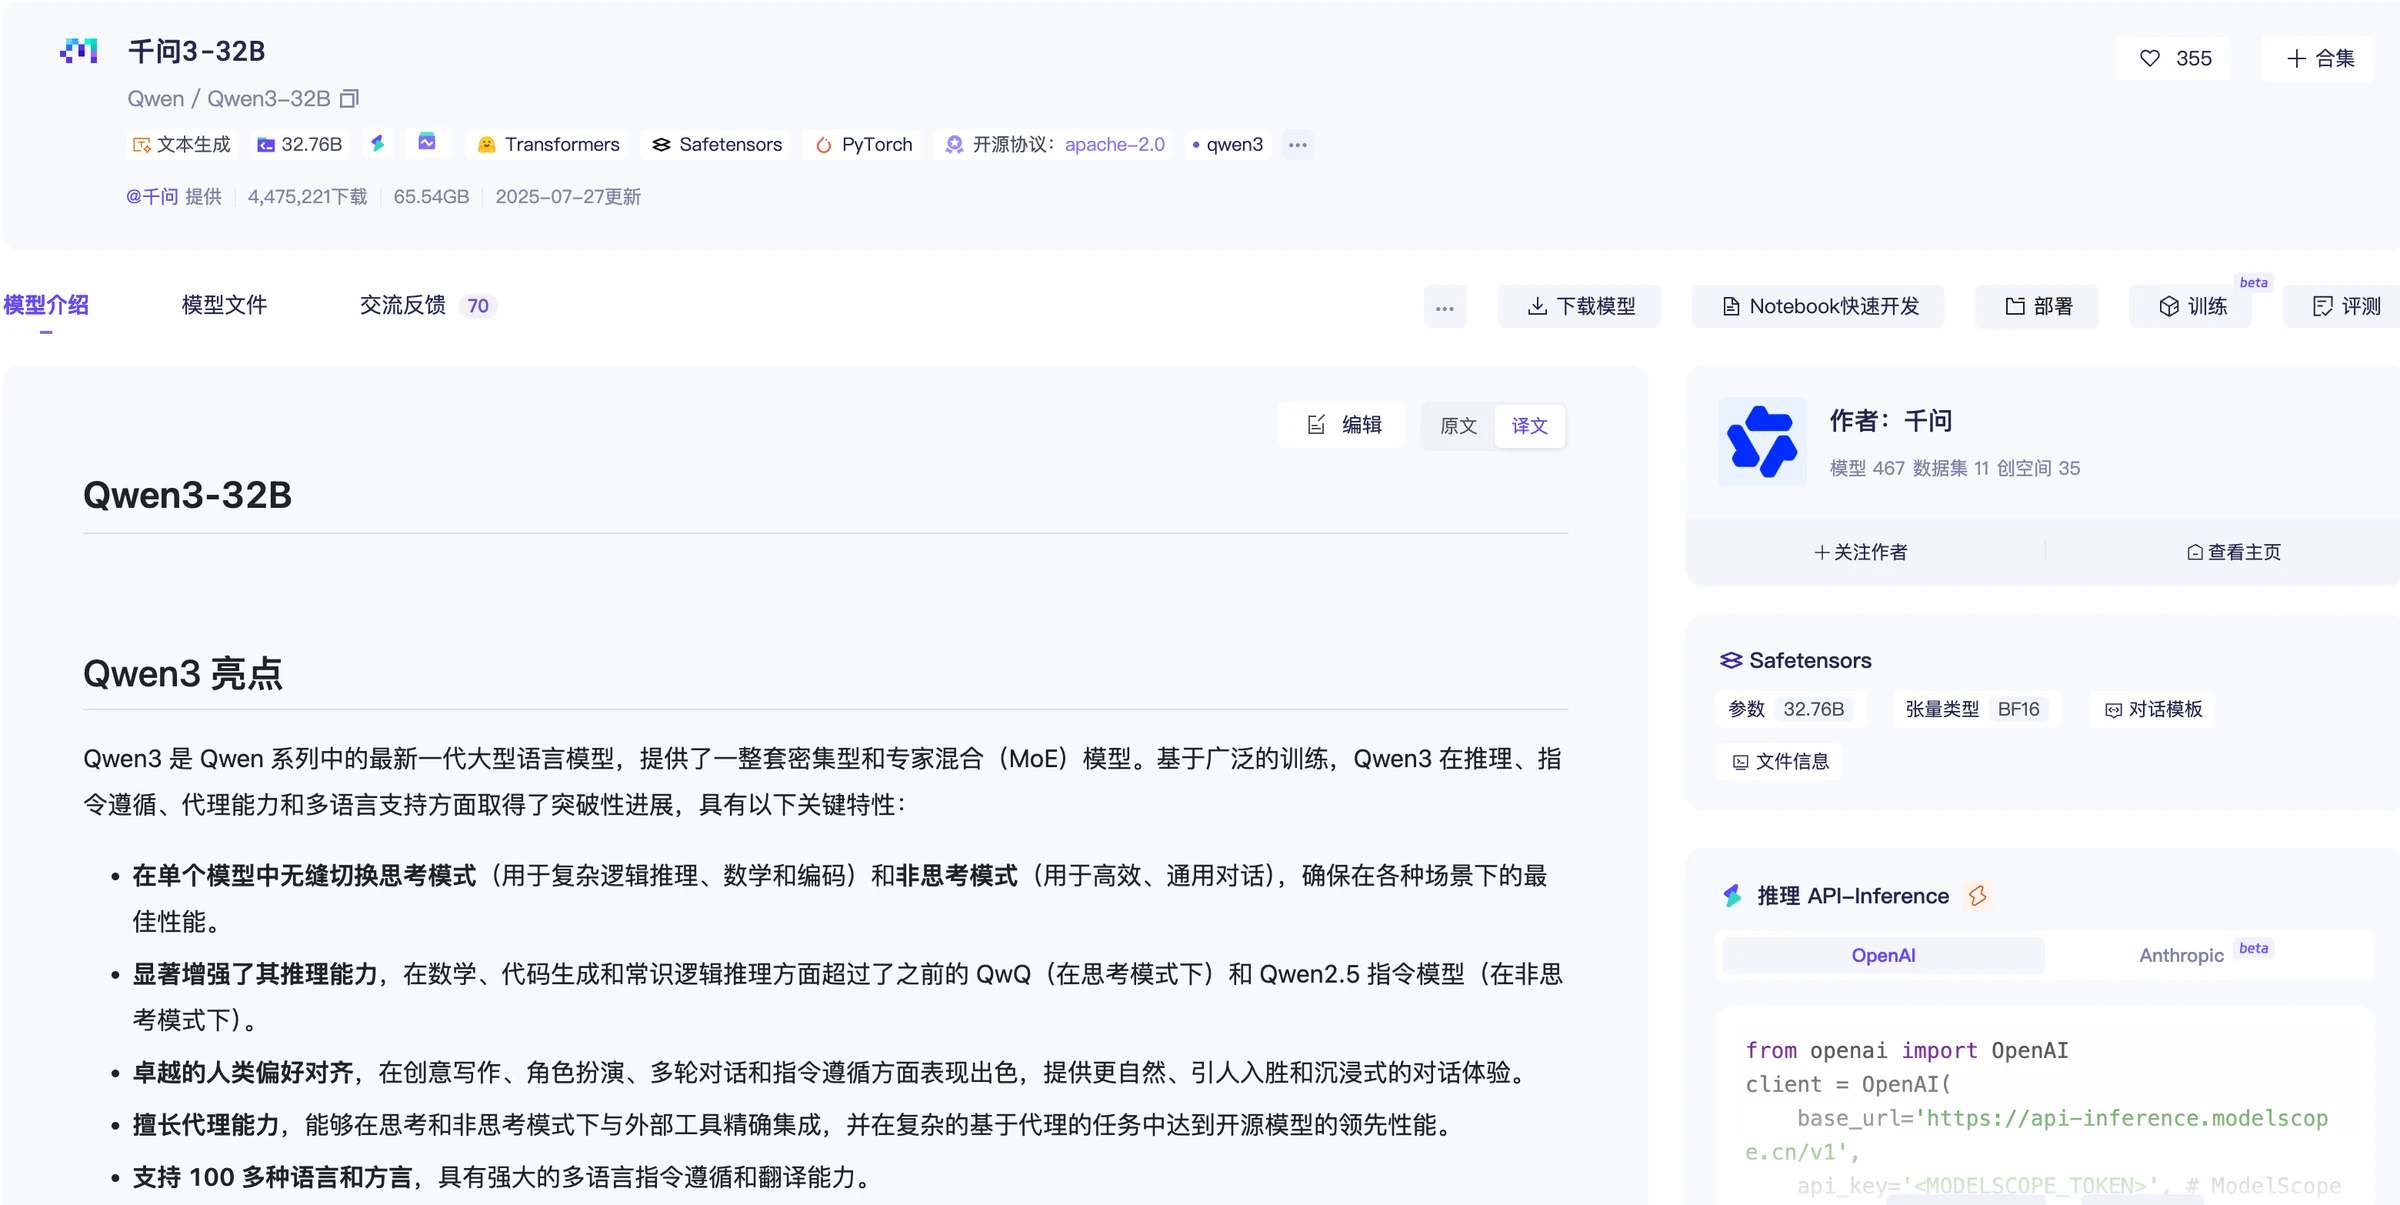
En prenant Qwen3 comme exemple, l'équipe officielle fournit des modèles à poids ouverts avec des instructions pour l'exécution locale, le déploiement, la quantification et l'affinage. Les développeurs peuvent utiliser des outils comme Transformers, vLLM, SGLang pour exécuter des modèles, et peuvent également utiliser des outils d'affinage pour continuer l'entraînement. Selon les distinctions ci-dessus, cela démontre la valeur pratique du niveau des poids ouverts.
La plupart des entreprises n'ont pas besoin de refaire le pré-entraînement de grands modèles — pouvoir exécuter des modèles existants, les adapter à vos propres appareils et les affiner avec des échantillons métier peut déjà résoudre de nombreux problèmes métier spécifiques.
Les modèles open source peuvent-ils vraiment rivaliser avec les modèles propriétaires ?
Pouvoir déployer des modèles vous-même c'est bien, mais si le modèle fait souvent des erreurs dans les scénarios métier, il est difficile de lui confier un travail réel.
Par le passé, les modèles open source donnaient à beaucoup de gens l'impression qu'ils étaient pratiques pour la recherche mais inférieurs aux modèles propriétaires les plus puissants. Avec la mise à jour continue des capacités des modèles, cette évaluation doit être revue.
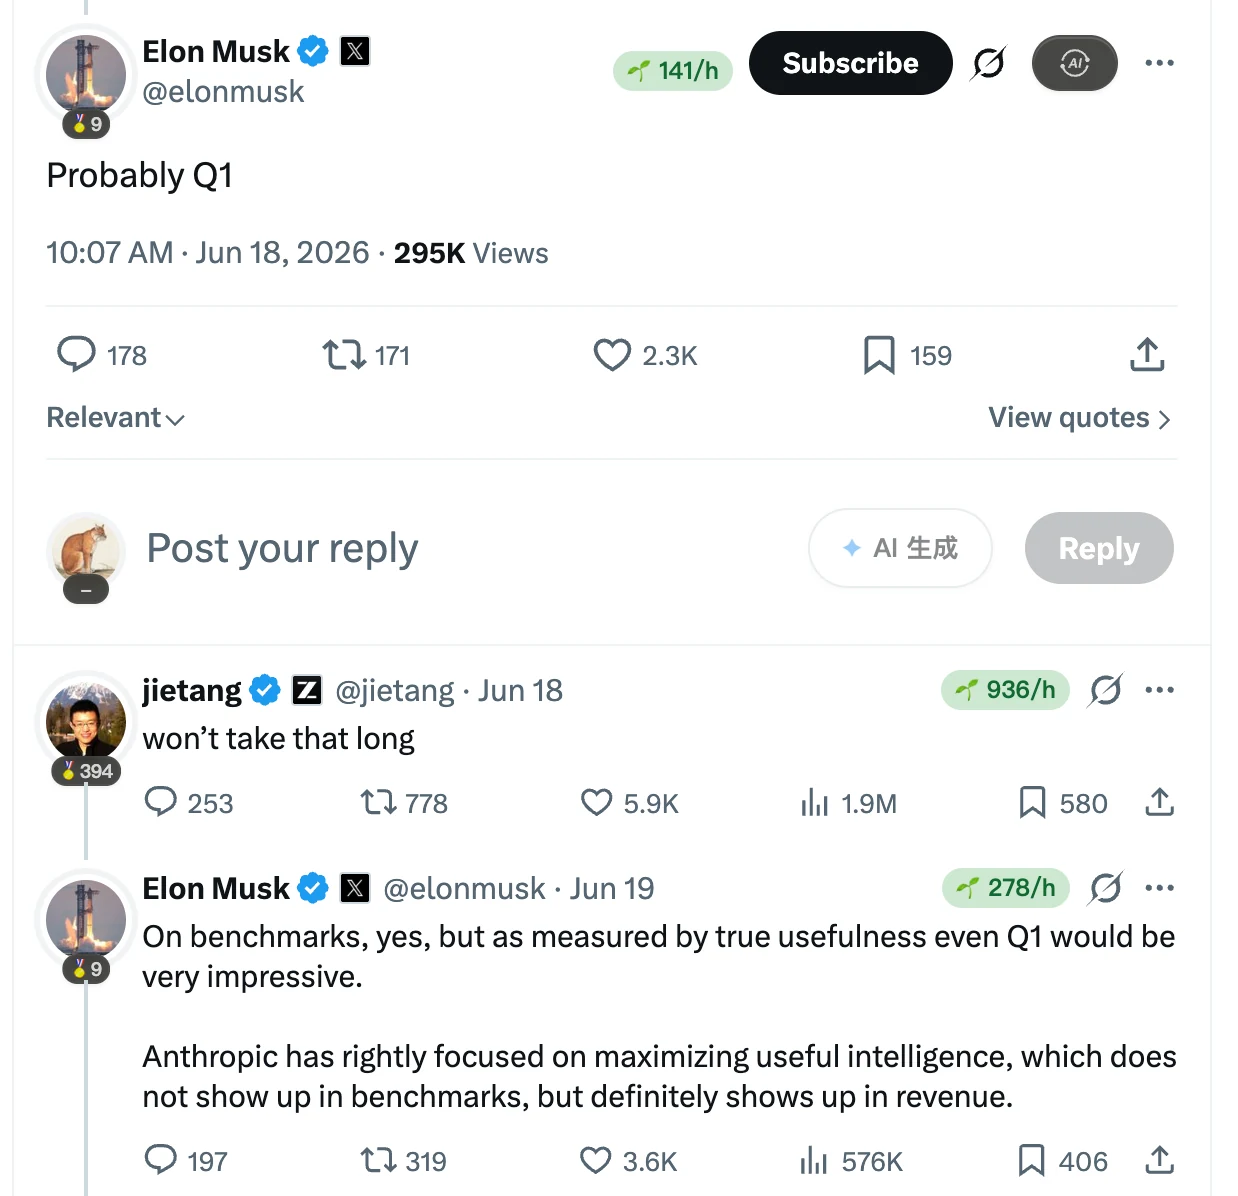
Le 18 juin 2026, il y a eu une interaction intéressante sur X. Les internautes discutaient de quand les modèles chinois pourraient atteindre le niveau des modèles frontier d'Anthropic, et Elon Musk a prédit que cela pourrait prendre jusqu'au premier trimestre 2027. Le co-fondateur de Zhipu, Tang Jie, a répondu en dessous avec « won't take that long ».
Si les prédictions des deux se réaliseront ou non reste à voir selon les performances futures des modèles. L'aspect fascinant de cette discussion est que les modèles open source se sont déjà hissés à l'avant-garde de l'ensemble du paysage des grands modèles.
Un incident de sécurité divulgué par Hugging Face en juillet 2026 a de nouveau démontré l'importance des modèles open source.
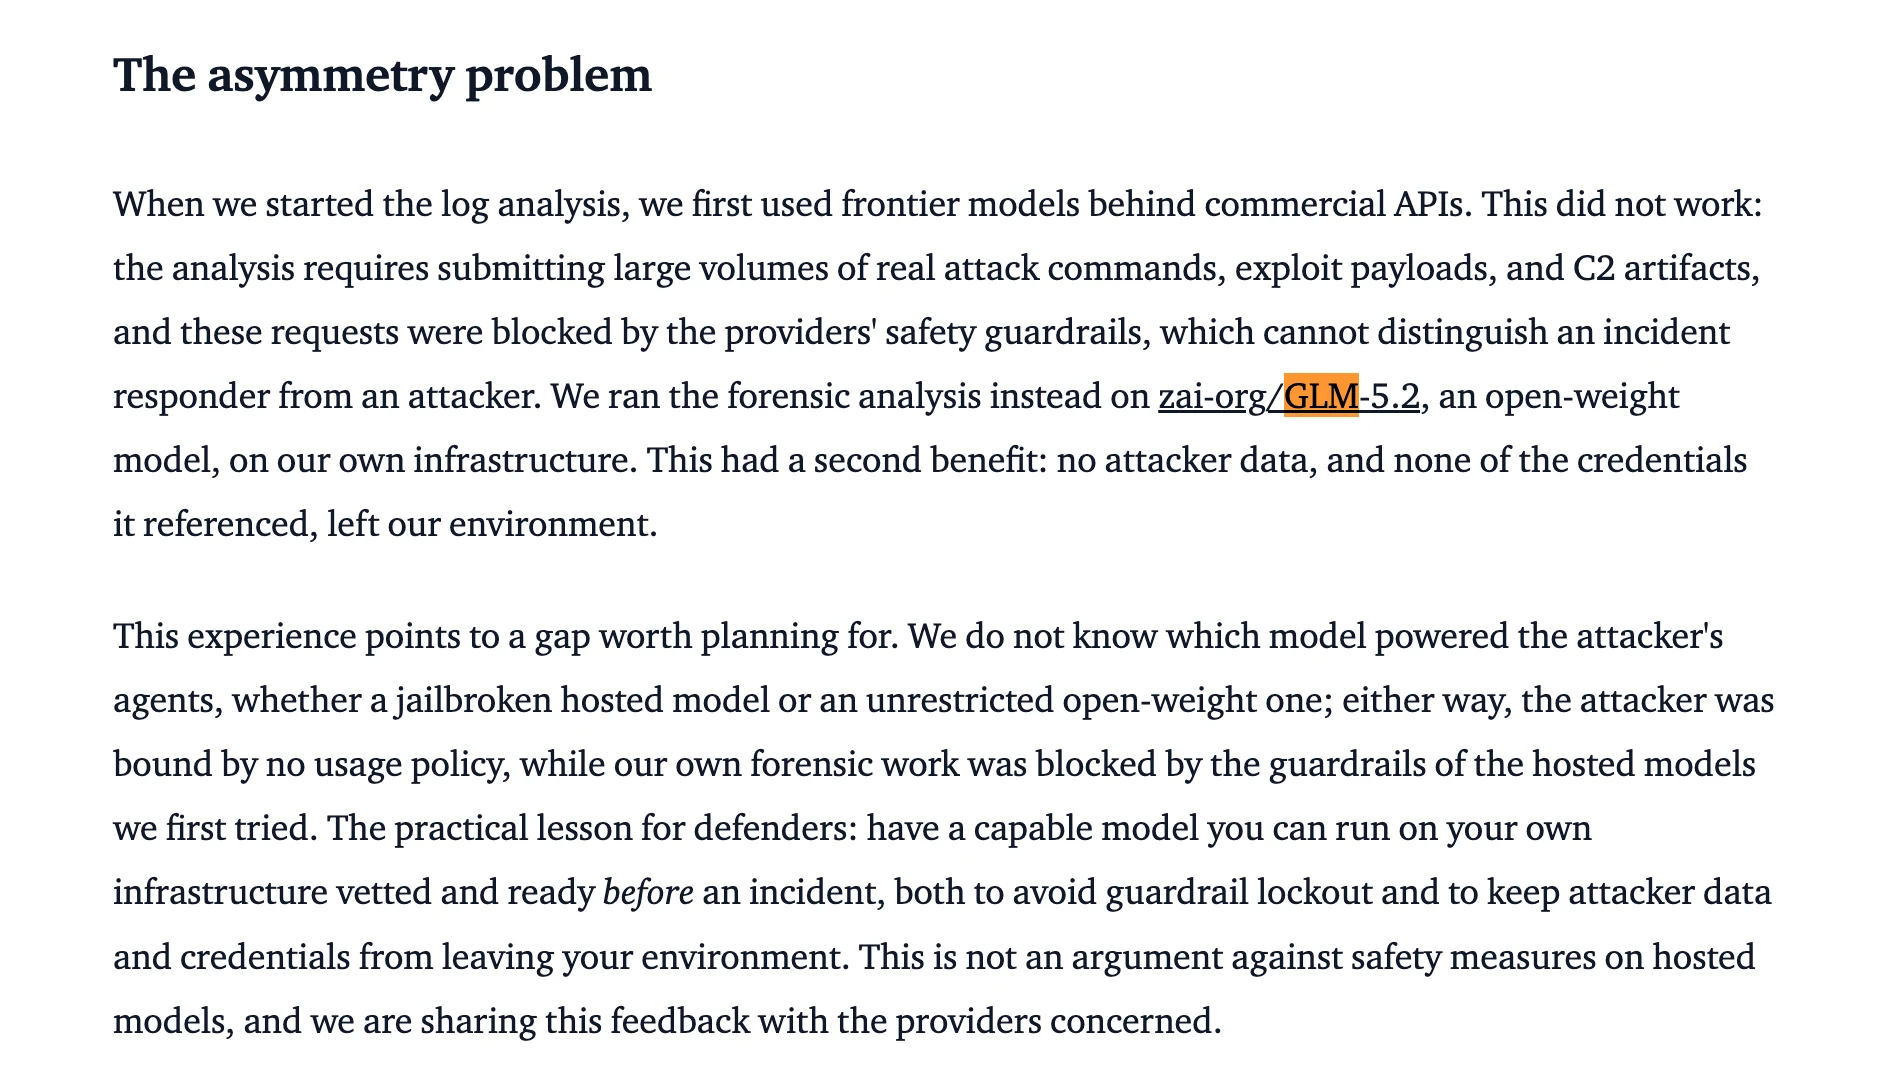
Une partie de l'infrastructure de production de Hugging Face a été compromise, et l'équipe de sécurité devait analyser un grand nombre d'enregistrements d'attaque pour comprendre ce que les attaquants avaient fait, quels identifiants ils avaient touchés et où l'impact s'étendait. L'équipe HF a d'abord essayé d'utiliser des modèles frontier via des API commerciales mais a rencontré un problème embarrassant. Les vraies commandes d'attaque et le contenu d'exploitation utilisés pour l'enquête ont déclenché les restrictions de sécurité du fournisseur de service, et les demandes d'analyse ont été bloquées.
Ensuite, l'équipe a utilisé le modèle à poids ouverts GLM-5.2 sur sa propre infrastructure pour mener une analyse forensique, permettant à l'enquête de continuer. Les données d'attaque et identifiants associés sont également restés dans l'environnement interne.
Dans la revue technique ultérieure, Hugging Face a de plus expliqué que l'équipe avait reconstitué environ 17 600 actions d'attaque et utilisé des modèles à poids ouverts dont GLM-5.2 pour interpréter les charges utiles d'attaque obfusquées et chiffrées.
Cet incident a démontré l'importance des modèles open source.
L'utilisation de modèles open source n'est pas soumise aux restrictions propriétaires. Nous pouvons conserver les données en local, les utiliser hors ligne et rendre l'exécution des tâches plus contrôlable.
Quels scénarios sont plus adaptés au déploiement local de modèles open source ?
Les domaines verticaux constituent également un direction d'application importante pour les modèles open source. Les grands modèles généraux apprennent à partir de vastes données publiques, mais leur compréhension des noms d'appareils internes à l'entreprise, des processus métier, de la terminologie de l'industrie et des connaissances spécialisées peut encore être limitée. En affinant sur des données de domaine vertical, le modèle peut davantage apprendre ces connaissances spécialisées.
Pour les tâches qui nécessitent le traitement de données sensibles, le déploiement local présente également des avantages. Les modèles peuvent effectuer l'inférence au sein du réseau interne de l'entreprise et se connecter aux bases de connaissances, bases de données et systèmes métier existants, réduisant ainsi la nécessité d'envoyer des données sensibles à des services externes.
Cependant, toutes les tâches ne nécessitent pas des modèles open source déployés localement.
Pour les tâches avec moins d'invoctions de modèles, des besoins métier à évolution rapide ou nécessitant une utilisation continue des dernières capacités du modèle général, l'appel d'API direct est généralement plus pratique. Pour certaines tâches métier à long terme, stables et exécutées de manière répétée, les modèles open source ont un plus grand potentiel d'application.
Par exemple, des tâches comme la classification de texte, la reconnaissance d'intention, l'extraction d'information, la résumé de documents et les Q&R de bases de connaissances ont généralement des formats d'entrée et de sortie relativement clairs. Les entreprises peuvent choisir des modèles de taille appropriée en complexité de la tâche et utiliser leurs propres données métier pour l'entraînement ou l'affinage. Pour ces tâches, l'utilisation des modèles avec le plus grand nombre de paramètres n'est pas nécessairement requise.
N'oubliez pas, pouvoir télécharger un modèle ne signifie pas que vous pouvez l'utiliser comme vous le souhaitez
Le modèle fonctionne et donne de bons résultats, mais si vous souhaitez l'utiliser dans des produits commerciaux ou partager votre version affinée, vous devez toujours vérifier la LICENCE, c'est-à-dire la licence.
Être téléchargeable, utilisable commercialement et modifiable pour redistribution sont des permissions différentes.
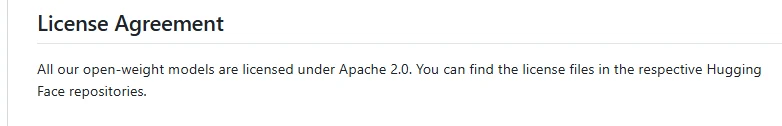
Généralement parlant, MIT et Apache License 2.0 sont des licences open source relativement permissives qui permettent l'utilisation commerciale et la modification, et ne nécessitent pas que tout le code dérivé soit rendu public. Un logiciel utilisant la licence MIT doit uniquement conserver les avis de copyright et de licence ; Apache 2.0 spécifie les exigences de documentation des modifications, la conservation des avis connexes et le traitement des NOTICES lors de la redistribution, et inclut des dispositions claires de attribution de brevets.
Par exemple, la série de modèles Qwen3 utilise Apache 2.0.
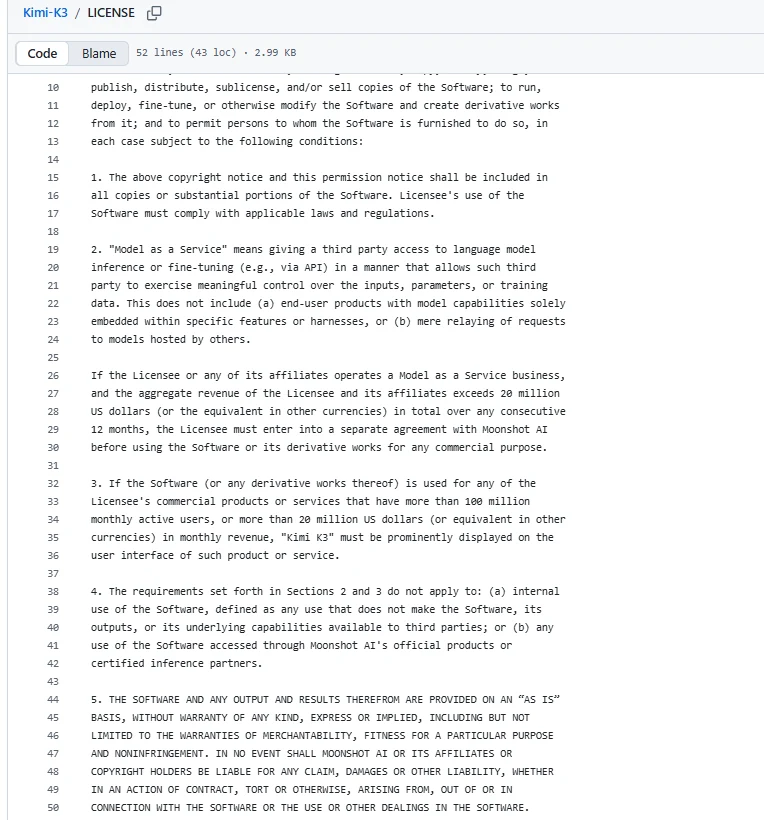
Kimi K3 a des accords séparés pour certaines utilisations commerciales, permettant le déploiement, l'affinage et la création de travaux dérivés, mais lorsque les services de modèle atteignent un seuil de revenus spécifié, un accord séparé est nécessaire.
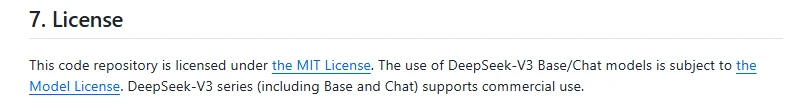
Le code de DeepSeek-V3 utilise la licence MIT.
Par conséquent, lors de l'utilisation de modèles, si vous souhaitez publier un modèle affiné ou le fournir à d'autres utilisateurs, vous devez revérifier la licence du modèle original pour voir si une telle utilisation est autorisée, et si vous devez conserver le nom du modèle, la licence et les informations source.
Si un nouveau modèle est obtenu en fusionnant plusieurs modèles, vous devez également vérifier séparément la licence de chaque modèle pour vous assurer que leurs exigences ne sont pas en conflit.