Lorsque vous voyez un nouveau modèle publié, votre premier réflexe est probablement de le télécharger et de l'essayer. Mais quand il s'agit de votre propre métier, les questions deviennent spécifiques : Peut-il gérer les problèmes métier de votre entreprise ? Peut-il déterminer ce que demandent les clients ? Avons-nous vraiment besoin d'un modèle aussi large ?
Donc, avant de choisir un modèle open-source, clarifiez d'abord ce que vous voulez accomplir.Qu'il s'agisse de classifier des contrats, d'extraire des montants et des dates, ou de générer des résumés, les capacités requises diffèrent. Une fois l'objectif clarifié, vous pouvez chercher dans la bibliothèque de modèles pour trouver les plus adaptés.
Lorsque les parties prenantes métier formulent des demandes, elles ne disent généralement pas directement « J'ai besoin d'un modèle de classification » ou « J'ai besoin d'un modèle d'extraction d'informations ». Elles décrivent généralement le problème du point de vue métier, par exemple « Aidez-moi à extraire les informations clés des contrats » ou « Répondez automatiquement aux questions des utilisateurs ».
La première étape de la sélection de modèle consiste à convertir ces exigences métier en tâches de modèle. Une fois la tâche définie, vous pouvez déterminer quel type de modèle est nécessaire.
Pour déterminer à quelle tâche de modèle une exigence appartient, vous pouvez commencer par deux aspects :
Selon l'objectif de travail du modèle, les tâches courantes peuvent être classées comme suit :
| Type de tâche | Définition principale | Compréhension simplifiée |
| Tâche de génération | Générer du nouveau texte, des images, de l'audio ou d'autres contenus à partir d'une entrée | « Écrire un nouveau contenu » |
| Tâche de classification | Déterminer la catégorie du contenu d'entrée | « Déterminer à quelle catégorie cela appartient » |
| Tâche d'extraction d'informations | Extraire les informations nécessaires des données brutes et les sortir dans un format spécifique | « Extraire les champs fixes » |
| Tâche de recherche et classement | Trouver le contenu pertinent parmi des candidats et les classer par pertinence | « Trouver les meilleures correspondances et les classer » |
| Tâche de prédiction | Prédire des résultats futurs ou inconnus à partir de données existantes | « Prédire une valeur ou une tendance » |
Différents types de données nécessitent différentes méthodes de traitement et structures internes, c'est pourquoi des modèles spécialisés sont nécessaires. Les types de données courants sont les suivants :
Se connecter pour rejoindre la discussion
| Type de données | Description | Exemples courants |
| Texte | Traiter le contenu textuel | Articles, contrats, historiques de discussion |
| Parole | Traiter l'audio | Enregistrements, conversations vocales |
| Image | Traiter des images individuelles | Photos, scans, images de produits |
| Vidéo | Traiter des informations visuelles et audio continues | Vidéos de surveillance, vidéos courtes |
Vous devez également vérifier si l'entrée et la sortie ne concernent qu'un seul type de données. Lorsque l'entrée et la sortie sont du même type de données, la tâche de modèle est classée par ce type de données.
Par exemple, si l'entrée et la sortie sont toutes deux des images, c'est une tâche d'image. Lorsque l'entrée et la sortie impliquent deux types de données ou plus, c'est une tâche multimodale. Les tâches multimodales courantes incluent : la transcription audio (entrée : parole, sortie : texte) ; la réponse aux questions basée sur des images (entrée : image et texte, sortie : texte).
En pratique, vous pouvez d'abord regarder l'objectif ultime du problème métier, puis vérifier les types de données d'entrée et de sortie. Exemples :
Exemple 1 : Classifier les avis utilisateurs comme positifs, négatifs ou neutres
L'objectif métier est de sortir une étiquette de catégorie. L'entrée est du texte, il s'agit donc d'une tâche de classification de texte.

Exemple 2 : Télécharger une image, trouver le produit le plus similaire dans la base de données et les classer
L'objectif métier est de faire correspondre les éléments les plus pertinents parmi les candidats et de les classer, ce qui est une tâche de recherche et classement. Le type de données traité est l'image, il s'agit donc d'une tâche de recherche et classement d'images.

Exemple 3 : Générer des images correspondantes à partir de descriptions textuelles
L'objectif métier est de générer des images, ce qui est une tâche de génération. L'entrée est du texte et la sortie est des images, les types de données d'entrée et de sortie sont donc différents. Il s'agit d'une tâche de génération multimodale, communément appelée génération de texte en image.
Après avoir identifié la tâche du modèle, vous entrez dans la phase de sélection. La plateforme ModelScope propose plusieurs méthodes de filtrage. Vous pouvez vous référer aux méthodes suivantes pour sélectionner des modèles.
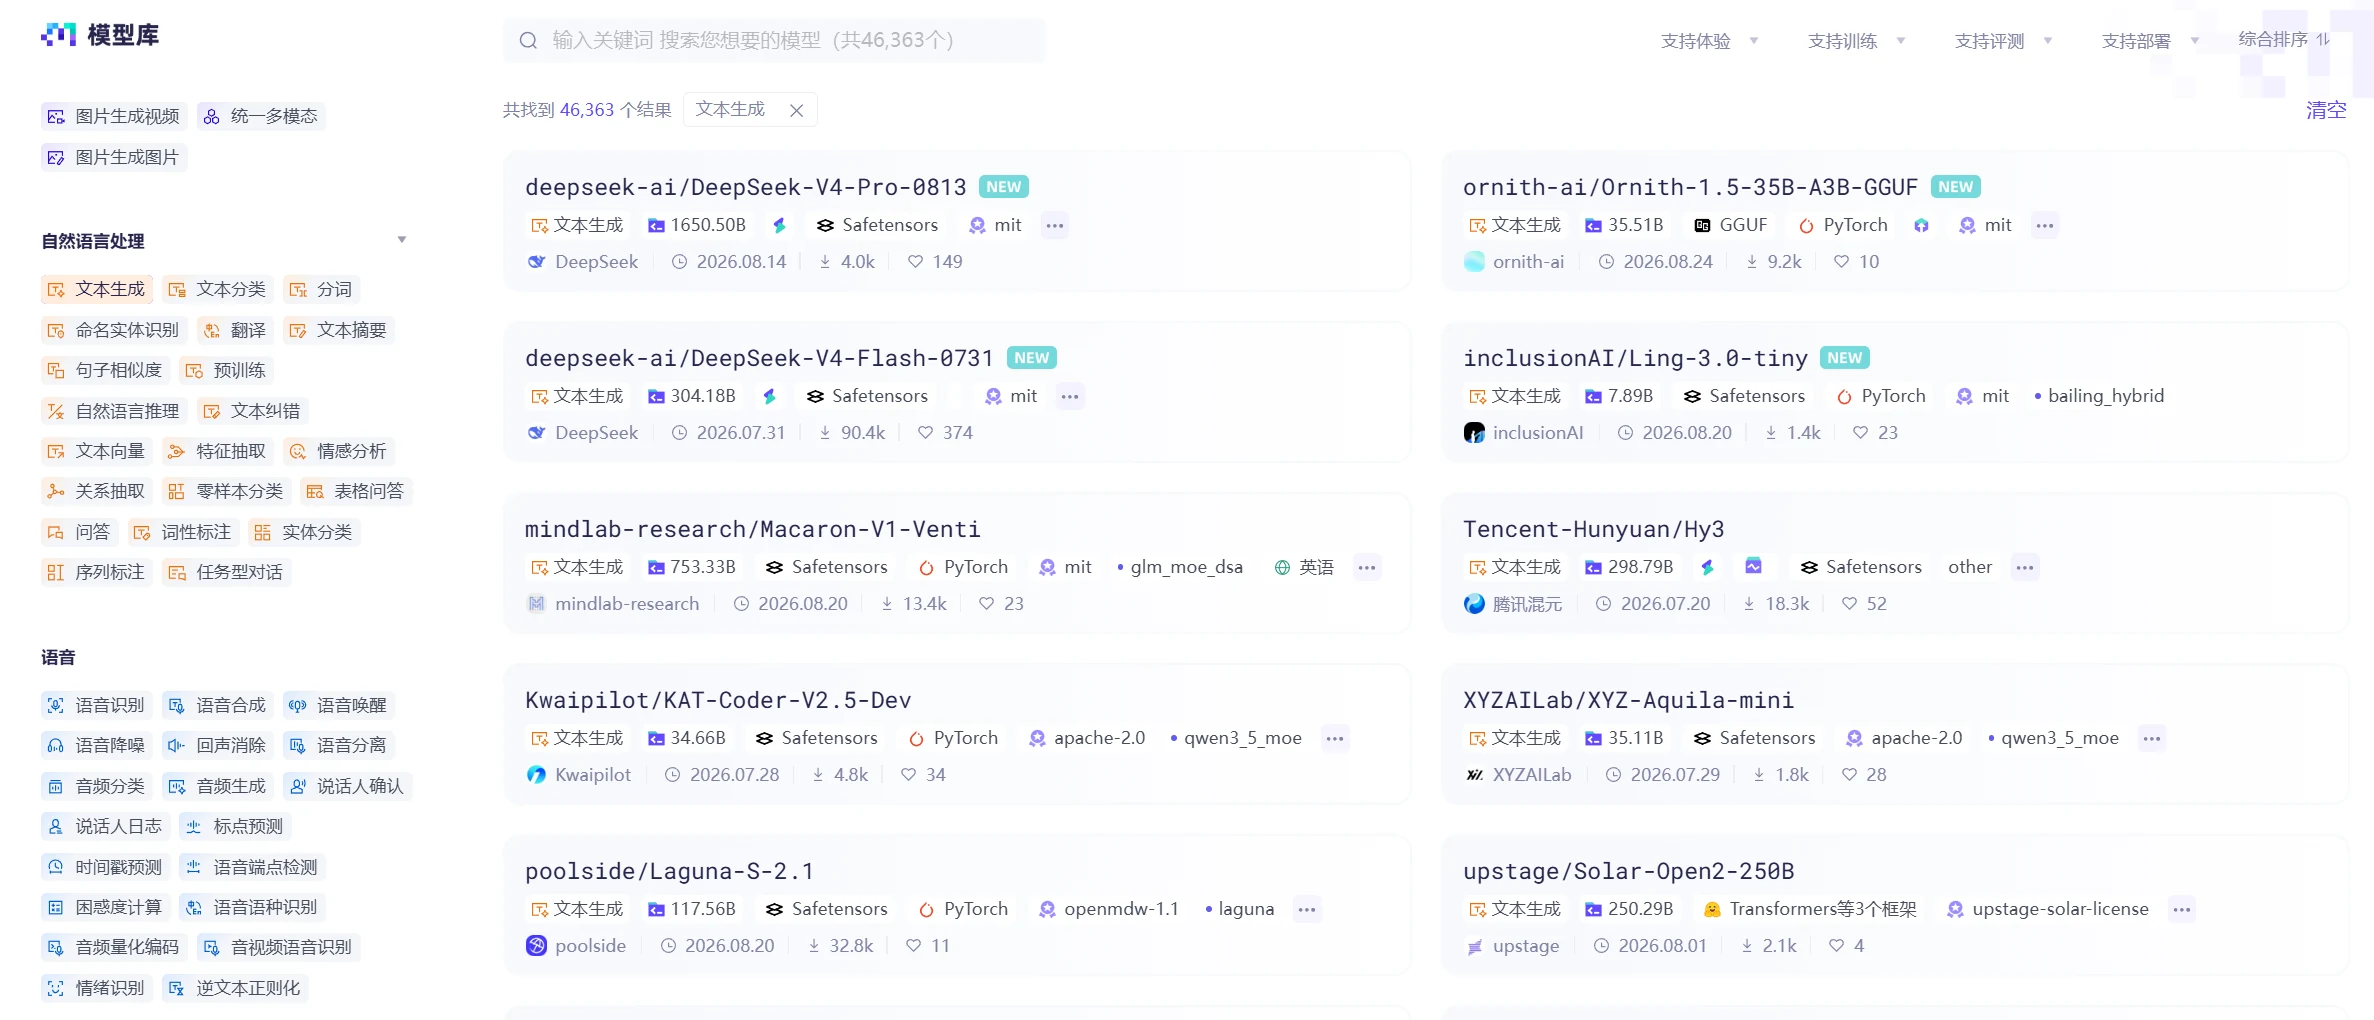
ModelScope étiquette chaque modèle avec des tags de type de tâche. Sur la page de la bibliothèque de modèles :
Sélectionnez « Bibliothèque de modèles » pour accéder à la page de navigation des modèles ;
Sélectionnez « Type de tâche » dans le panneau de filtrage à gauche ;
Sélectionnez la catégorie de tâche correspondante (par exemple « Classification de texte »).
La plateforme filtrera automatiquement la liste des modèles étiquetés avec ce tag de tâche. C'est la méthode de filtrage la plus directe, recommandée en priorité.
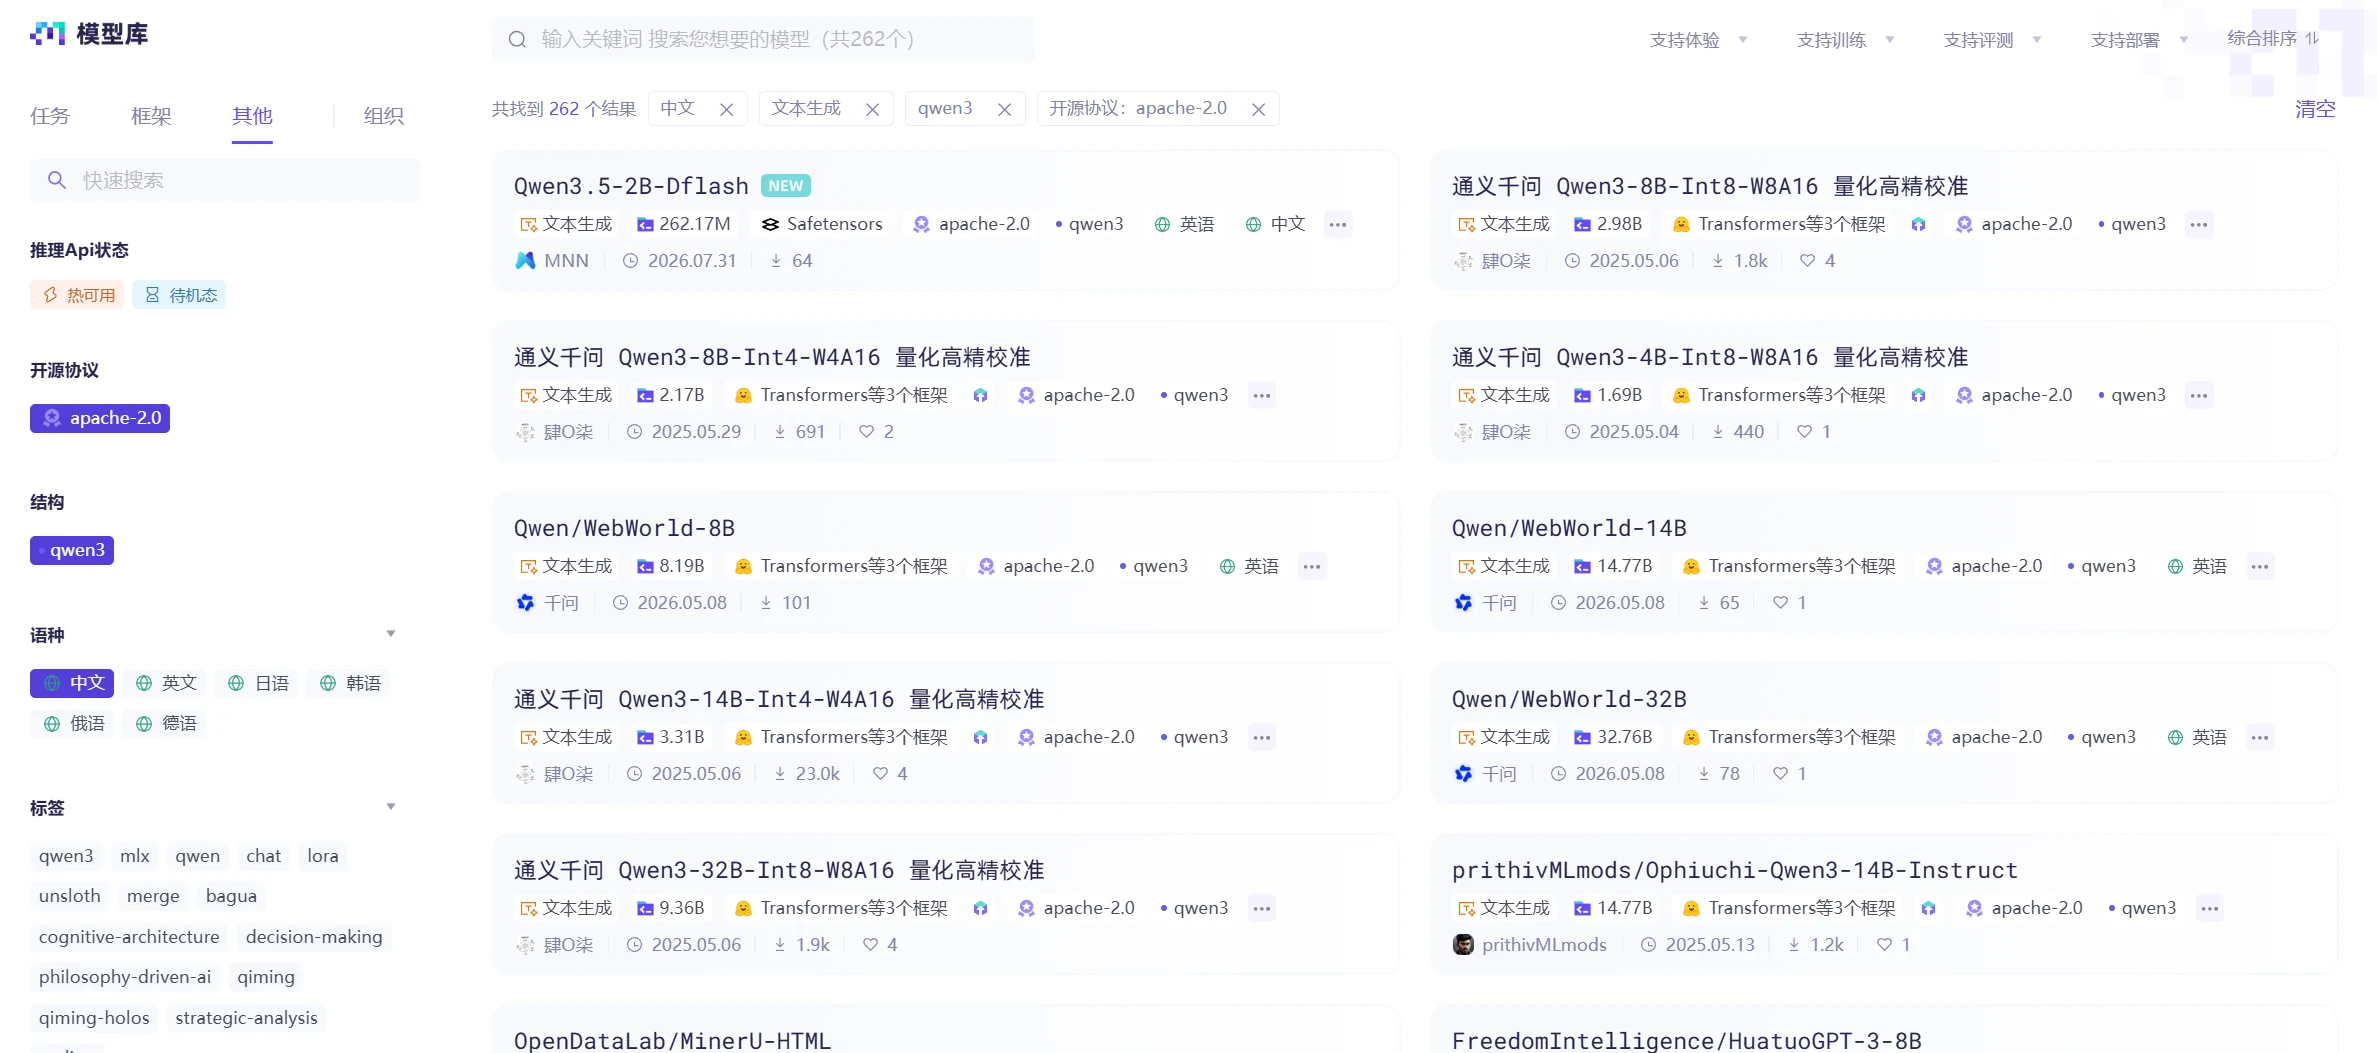
Lorsqu'il reste trop de modèles candidats après le filtrage par tag de tâche, vous pouvez ajouter des tags supplémentaires dans les colonnes « Framework » et « Autre » à gauche pour réduire la portée :
Framework : Filtrer les modèles par frameworks spécifiques comme PyTorch, TensorFlow, etc. ;
Licence open source : Filtrer par licences permissives comme Apache 2.0, MIT, etc. pour un usage commercial ;
Architecture : Filtrer par architectures comme llama, qwen3, deepseek_v2, etc. ;
Langue : Sélectionner les langues prises en charge par la tâche, comme le chinois, l'anglais, le japonais, le coréen, etc.
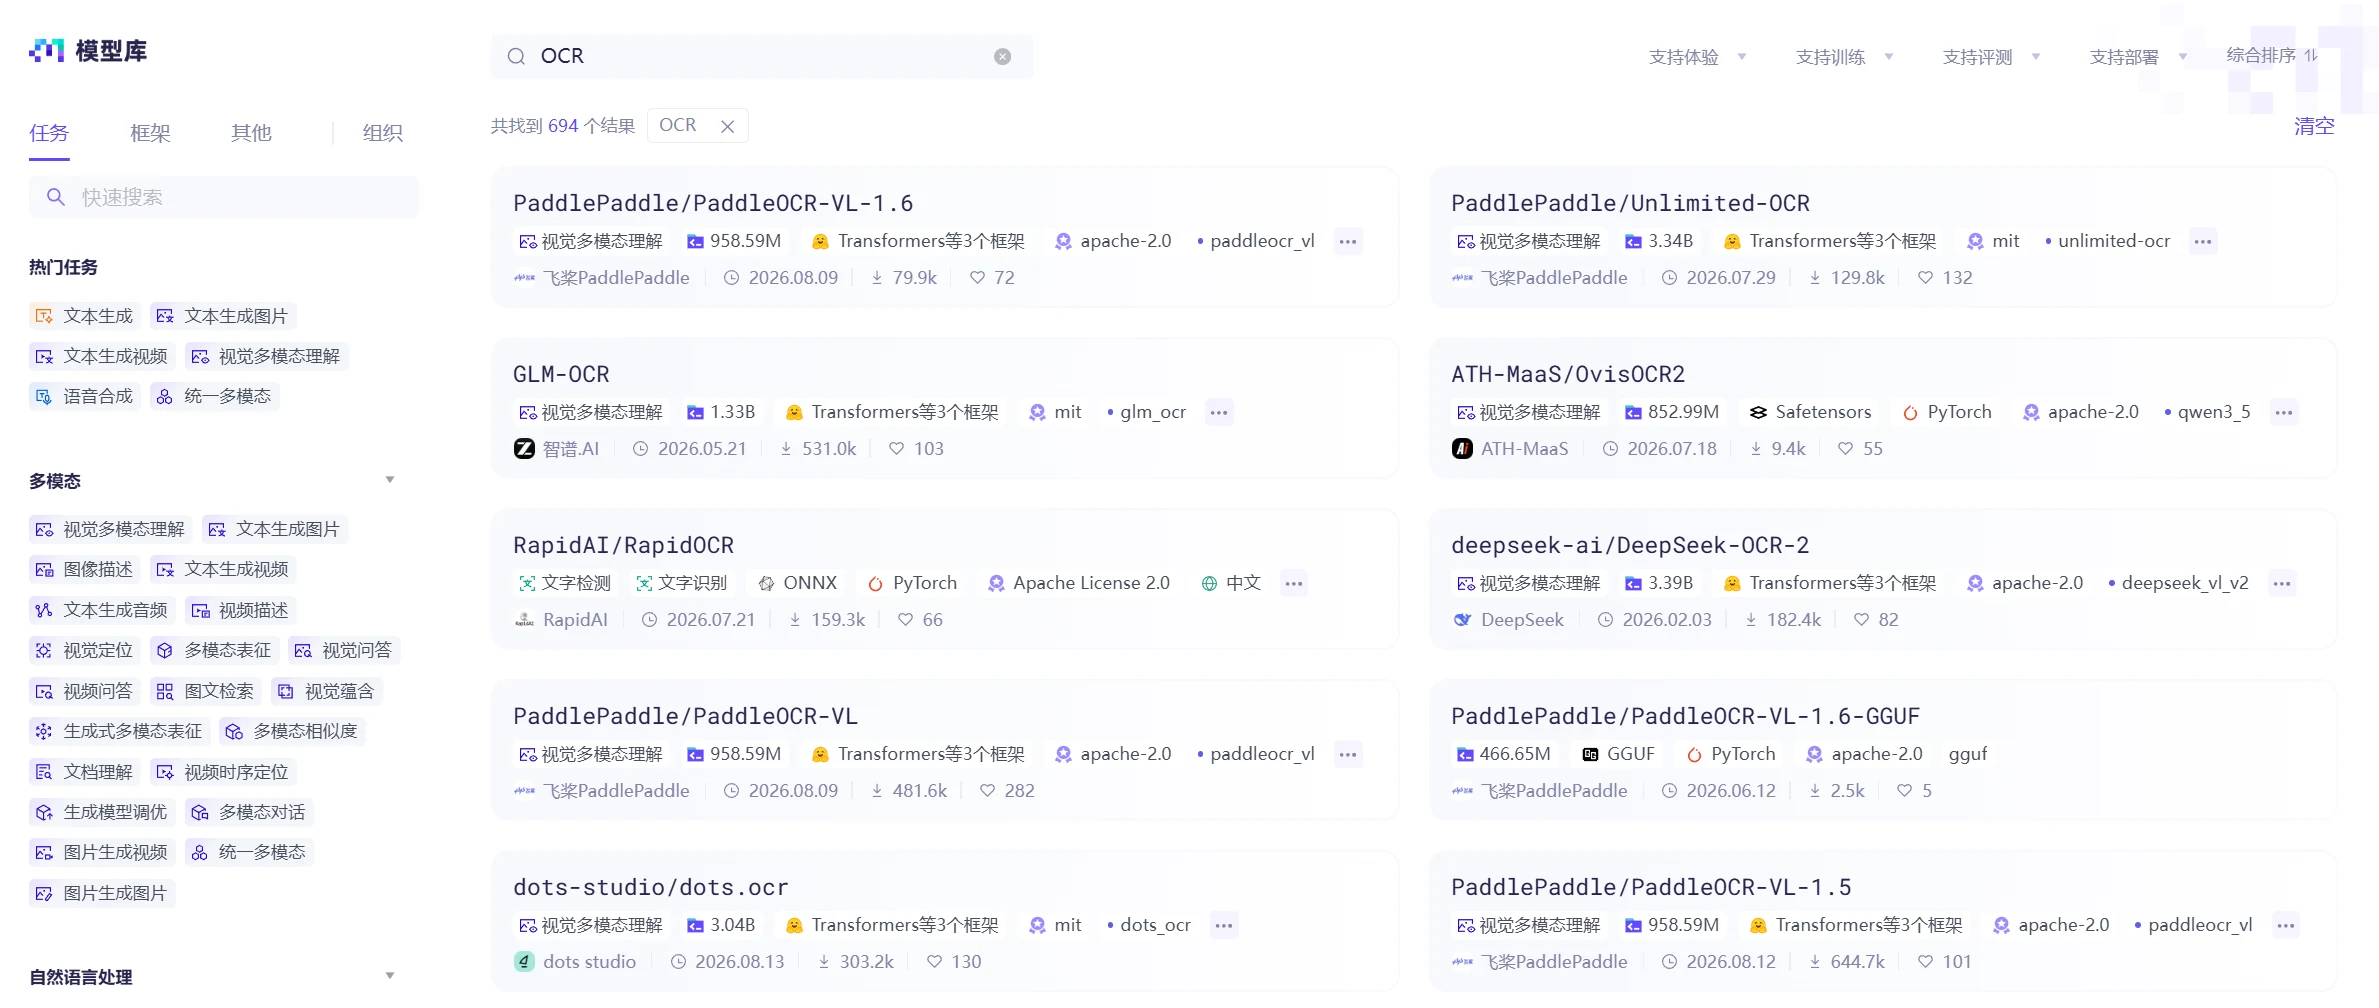
Si vous connaissez le nom de la tâche ou du modèle spécifique, vous pouvez entrer directement les mots-clés dans la barre de recherche, par exemple « OCR ».
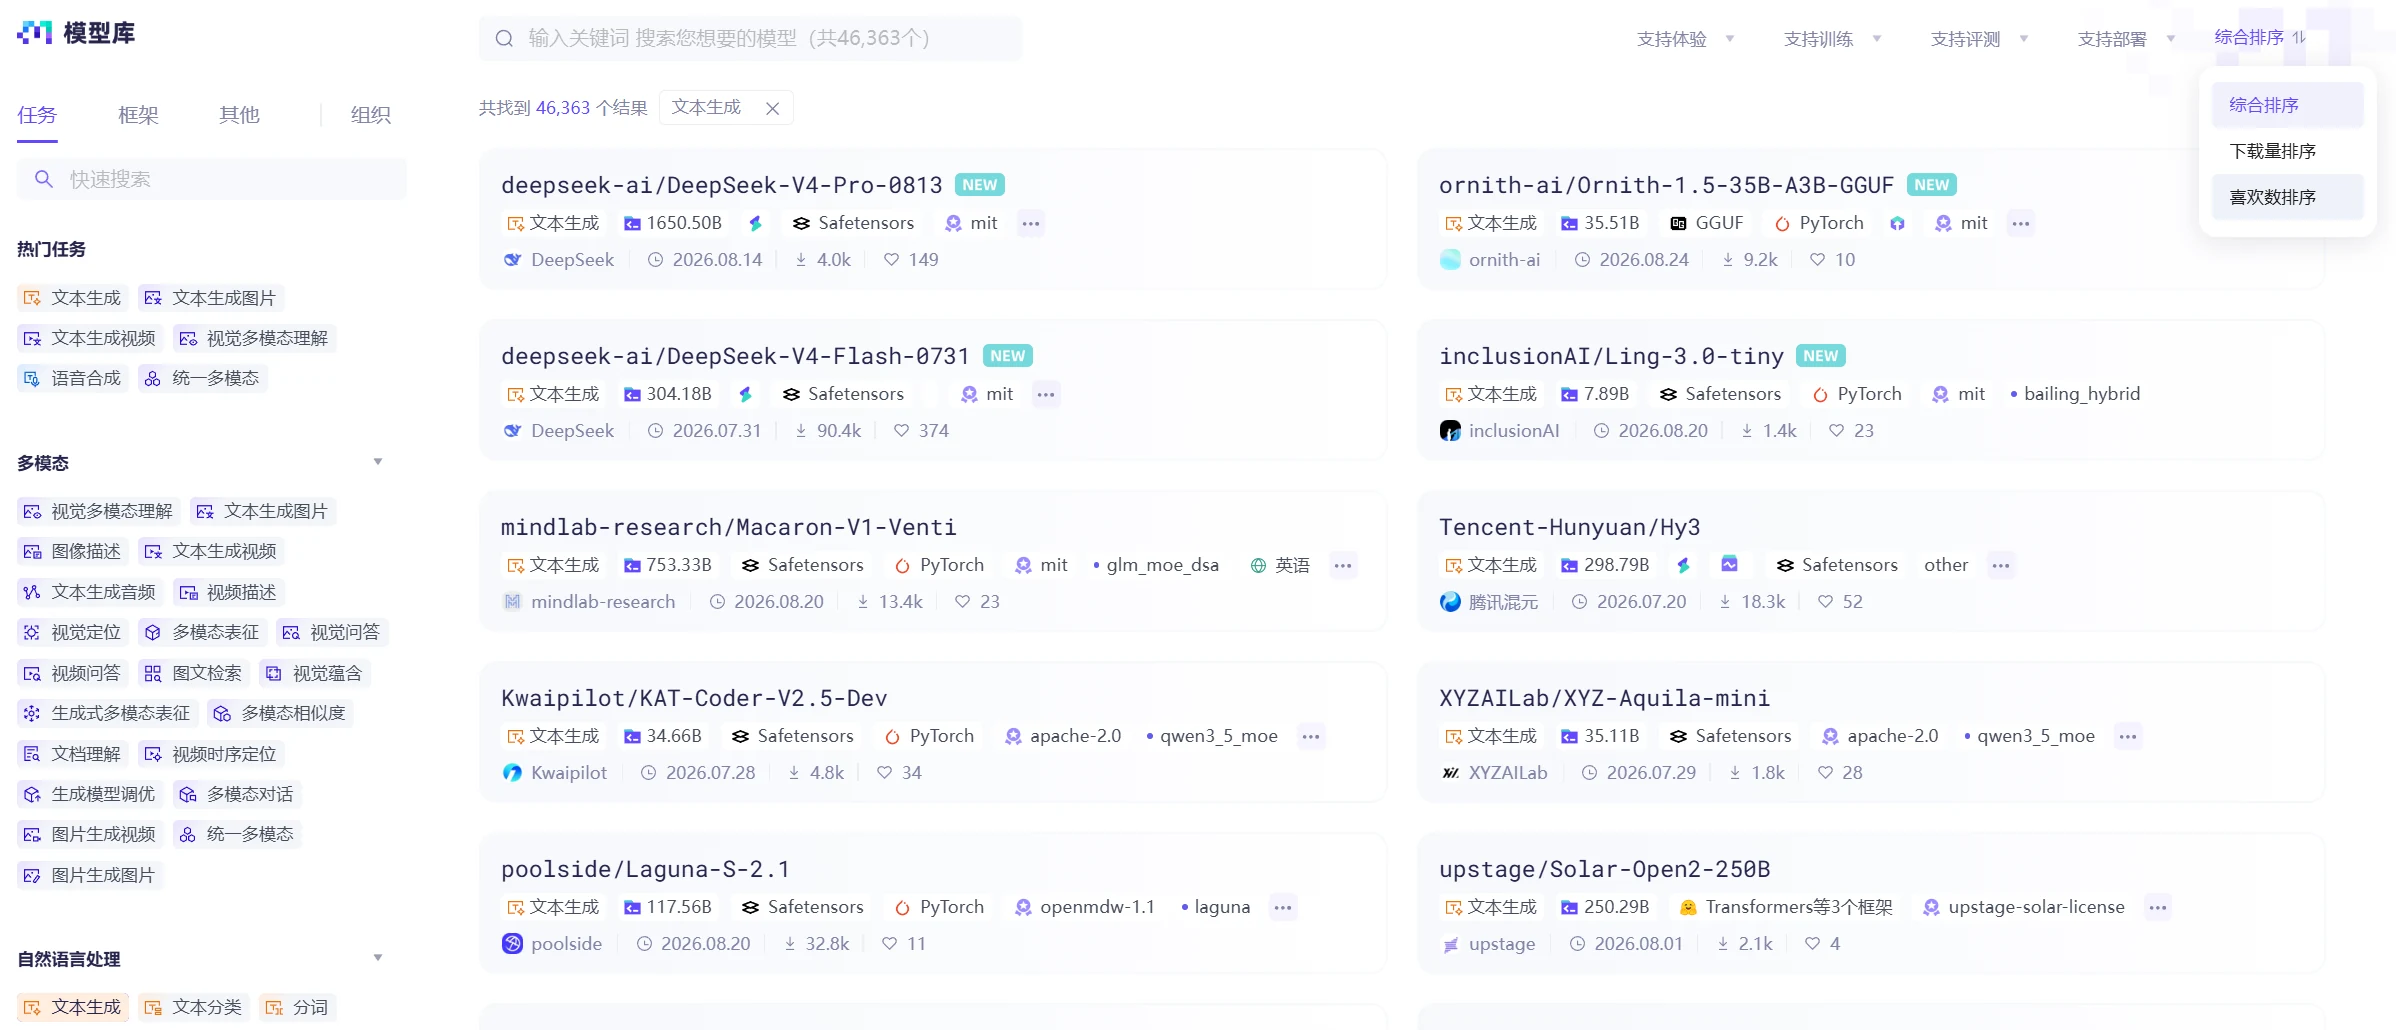
La plateforme ModelScope suit également la popularité des modèles. Les indicateurs de référence disponibles sont les suivants :
Indicateur | Sens et utilisation |
Téléchargements | Reflecte la fréquence d'utilisation globale du modèle. Un nombre de téléchargements plus élevé signifie généralement que le modèle a été validé dans plus de scénarios |
Nombre de likes | Reflecte la reconnaissance des utilisateurs envers le modèle. Un nombre élevé de likes indique une bonne qualité du modèle ou une bonne adéquation au scénario |
Date de mise à jour | Les modèles récemment mis à jour ont généralement de meilleures performances ou un support écosystème plus complet. Les modèles non mis à jour depuis longtemps peuvent avoir des problèmes de compatibilité |
Activité communautaire | La vitesse de réponse et l'activité de discussion dans les sections Issues et Discussions reflètent indirectement l'état de maintenance du modèle |
La plateforme permet de trier les modèles filtrés par nombre de téléchargements ou likes. Vous pouvez sélectionner les critères de tri dans le coin supérieur droit de la bibliothèque de modèles et également voir la date de mise à jour du modèle.
Pour vérifier l'activité communautaire, vous devez entrer dans la page de fiche du modèle pour consulter le nombre de retours et de discussions communautaires.
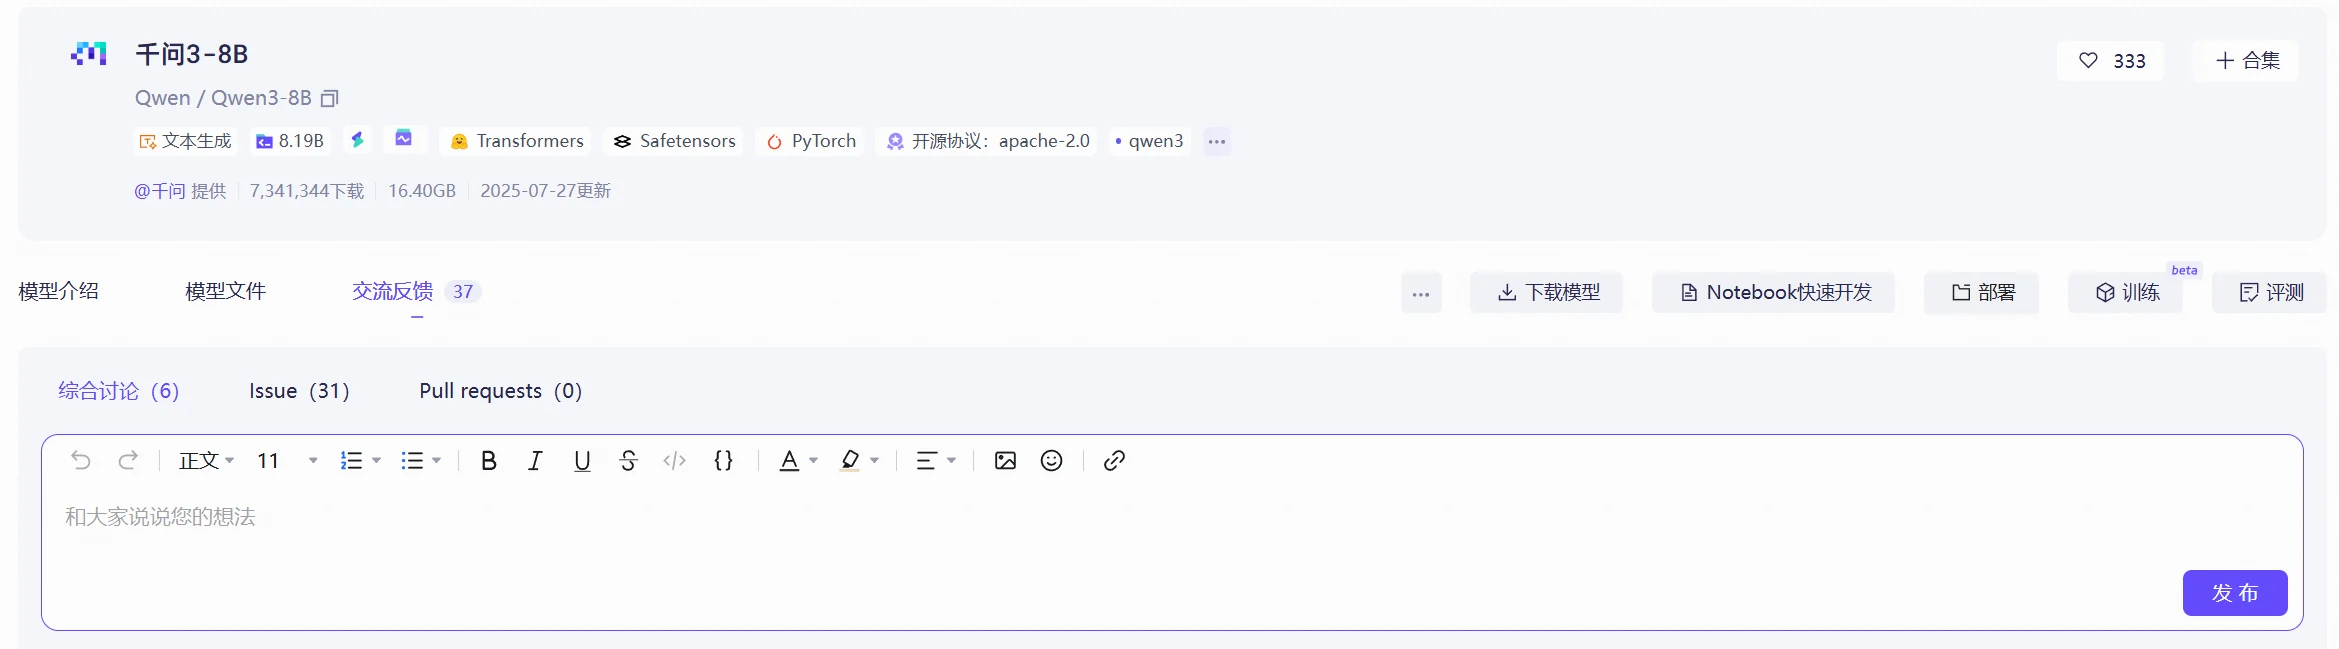
Les modèles généralistes ont généralement des téléchargements nettement supérieurs à ceux des modèles spécialisés dans un domaine vertical. La comparaison directe entre domaines n'est donc pas très significative. Il est recommandé de comparer dans la même catégorie de tâches.
Lors de l'utilisation de grands modèles en pratique, vous êtes souvent confronté à la question : faut-il choisir un grand modèle général ou un modèle spécialisé entraîné pour des tâches spécifiques ?
Chacun a ses propres caractéristiques, et le choix dépend principalement de facteurs tels que le type de tâche, le volume de données, la vitesse d'infrastructure et le coût de déploiement.
Les grands modèles généraux sont généralement pré-entraînés sur des données à grande échelle et multi-domaines et peuvent traiter divers types de tâches, tels que la classification de texte, la génération de contenu, l'extraction d'informations et les questions-réponses. Ils ne sont pas optimisés pour une tâche spécifique mais visent à être utilisables dans plus de scénarios.
Avantages : Un seul modèle peut gérer plusieurs tâches. Habituellement, il suffit d'ajuster le Prompt pour que le modèle accomplit différentes tâches. Pour les tâches avec peu de données, vous pouvez également essayer des approches few-shot ou zero-shot sans nécessairement préparer de grandes quantités de données annotées.
Inconvénients : Les grands modèles généraux ont généralement un grand nombre de paramètres, nécessitant plus de ressources computationnelles. Plus le modèle est grand, plus il consomme de mémoire GPU et de ressources computationnelles pendant l'inférence. Dans les scénarios à haute concurrence, vous devez également considérer la vitesse d'inférence et les coûts de déploiement. De plus, pour certaines tâches professionnelles bien définies, des modèles spécialement entraînés peuvent obtenir de meilleurs résultats.
Les grands modèles généraux sont plus adaptés lorsque vous avez de nombreux types de tâches, êtes encore en phase d'exploration, ou manquez temporairement de données suffisantes pour entraîner des modèles spécialisés. Si vous devez rapidement valider une nouvelle direction d'application, utiliser directement un grand modèle général est généralement le choix le plus pratique.
Les modèles spécialisés sont principalement entraînés et optimisés pour un type de tâche ou un domaine spécifique. Par exemple, les modèles utilisés pour la classification de texte, l'OCR, la reconnaissance vocale et la détection d'objets peuvent tous être considérés comme des modèles spécialisés.
Avantages : Comme le modèle est optimisé pour des tâches spécifiques, il n'a généralement pas besoin de traiter un grand nombre de tâches irrelevantes, ce qui lui donne des avantages en termes de vitesse d'inférence, d'utilisation des ressources et de performance des tâches. Pour les applications à tâches relativement fixes, vous pouvez entraîner davantage le modèle sur des données réelles pour l'adapter mieux à votre métier.
Inconvénients : Les modèles spécialisés ont un champ d'application relativement limité. Lors du passage à une autre tâche, ils peuvent ne pas être directement utilisables. Par exemple, un modèle utilisé pour la classification de texte ne peut pas être directement utilisé pour la génération de texte. Si les exigences métier changent, le modèle original peut nécessiter un ré-entraînement ou un ajustement. De même, si un système utilise de nombreux modèles spécialisés différents, la version et l'environnement de déploiement de chaque modèle doivent être gérés séparément.
Les modèles spécialisés sont plus adaptés lorsque les tâches sont bien définies, les exigences métier sont relativement stables et il y a des exigences en termes de vitesse d'inférence, d'utilisation des ressources ou de coût de déploiement. Si vous avez accumulé de bonnes données d'entraînement, l'utilisation de modèles spécialisés rend généralement plus facile l'optimisation pour des tâches spécifiques.
En pratique, vous n'êtes pas obligé de choisir entre les grands modèles généraux et les modèles spécialisés. Ils sont souvent utilisés ensemble.
Par exemple, dans un système de service client intelligent, vous pouvez d'abord utiliser un grand modèle général pour comprendre la question de l'utilisateur et déterminer ce que l'utilisateur veut accomplir. Une fois la tâche identifiée, transférez-la au modèle spécialisé correspondant pour le traitement.
Lors de la sélection réelle, vous pouvez partir de la tâche elle-même. Si la tâche est encore vague ou doit gérer plusieurs types de problèmes simultanément, vous pouvez donner la priorité aux grands modèles généraux. Si la tâche est déjà bien définie et a des exigences élevées en termes de vitesse, coût ou stabilité, vous pouvez envisager des modèles spécialisés.
Un système métier utilise généralement plus d'un modèle. Selon la complexité de la tâche spécifique, un modèle peut gérer tout le travail, ou différents modèles peuvent être combinés avec chaque modèle responsable d'une étape. Par exemple, dans un système de traitement intelligent de documents, de l'entrée du document à la sortie du résultat final, cela peut passer par plusieurs étapes telles que la classification de documents, l'OCR, l'analyse de mise en page, la reconnaissance de tableaux et l'extraction d'informations :
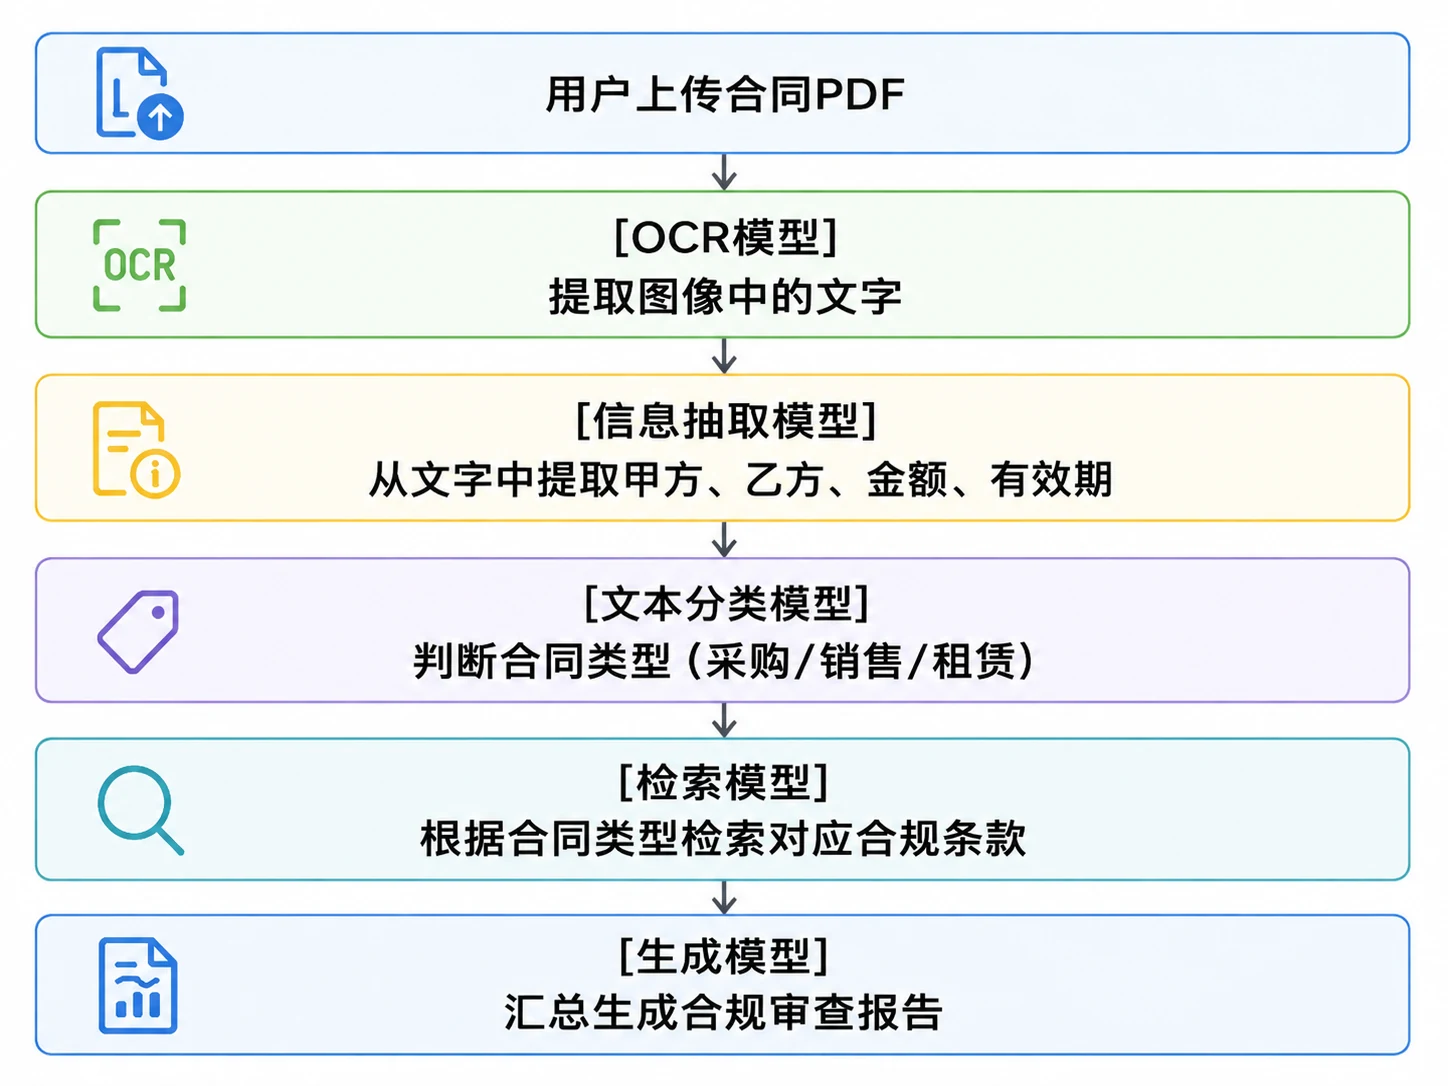
Dans ce système, chaque modèle gère une tâche différente. Les combinaisons multi-modèles ont généralement les caractéristiques suivantes :
Cependant, les combinaisons multi-modèles présentent également des problèmes d'intégration. Le format de sortie du modèle précédent doit être correctement interprété par le modèle suivant. Cela nécessite de considérer à l'avance les formats de données entre différents modèles lors de la conception du système. Par exemple, l'OCR produit des blocs de texte avec des informations de coordonnées, mais les modèles d'extraction d'informations sont mieux adaptés au traitement de texte brut. Cela nécessite d'ajouter une étape de conversion de données entre les deux pour convertir les résultats OCR au format cible.
Lors de la sélection de modèles, vous ne devez pas seulement regarder les performances d'un seul modèle, mais aussi considérer s'il s'intègre bien dans l'ensemble du processus de traitement. Un modèle qui performs bien lors de tests isolés peut ne pas fonctionner bien dans un système réel si son format de sortie est difficile à intégrer avec d'autres modèles.