Fine-tuning et évaluation • Débutant⏱️ 30 min de lecture
Training Data Preparation
Tant de matériaux métier, comment les transformer en données d'entraînement ?
Avant d'entraîner un modèle, nous rencontrons souvent un tel problème :
J'ai beaucoup de documents bruts, de manuels produits, de guides opérationnels, de normes métier, chacun avec son propre format, et le contenu est relativement dispersé,
Comment puis-je utiliser ces données ?
Et si j'utilise directement des données de domaine ou de scénario, le modèle entraîné aura-t-il encore la capacité de répondre aux connaissances générales ?
Par conséquent, le point clé est de savoir comment transformer tous les matériaux en données d'entraînement exploitables par le modèle.
En même temps, le nettoyage, la déduplication et le masquage des données sont également indispensables. On peut avoir distillé les données, mais il faut les adapter au résultat souhaité.
C'est comme entraîner un modèle : si les données de conscience de soi ne sont pas bien entraînées, il pourrait répondre qu'il est un modèle ChatGPT, un modèle Claude, etc.
Les données sont la base de tout. Dans ce chapitre, nous commençons par les sources de données pour voir comment ces documents dispersés peuvent être synthétisés, nettoyés, dédupliqués et masqués, puis transformés en données prêtes pour l'entraînement du modèle.
L'entreprise doit apprendre, mais les capacités générales doivent être préservées
La collecte et l'annotation de données d'entraînement depuis le début nécessitent un investissement important en temps et en coût. Pour les tâches courantes comme la classification de texte, les questions-réponses et la génération de texte, on peut trouver des ensembles de données publics appropriés à inclure dans l'entraînement.
Les ensembles de données publics courants comprennent :
Classification et raisonnement de texte : GLUE, SuperGLUE, CLUE, etc. ;
Compréhension en lecture et questions-réponses : SQuAD, CMRC, etc. ;
Résumé de texte : CNN/DailyMail, etc. ;
Dialogue et fine-tuning d'instructions : Alpaca, ShareGPT, OpenOrca, etc. ;
Tâches multimodales : COCO et autres ensembles de données image-texte.
En plus d'obtenir des données depuis les sites officiels des ensembles de données, on peut également rechercher et utiliser des ensembles de données open source via le Dataset Hub de ModelScope. Le Dataset Hub propose des fonctionnalités de recherche, de prévisualisation en ligne et de téléchargement de datasets. Certains ensembles de données peuvent également être chargés directement via le SDK ModelScope, facilitant le traitement et l'entraînement ultérieurs. Pour plus de détails sur le téléchargement des datasets, voir le chapitre « Les données, fondation du fine-tuning de modèles open source ».
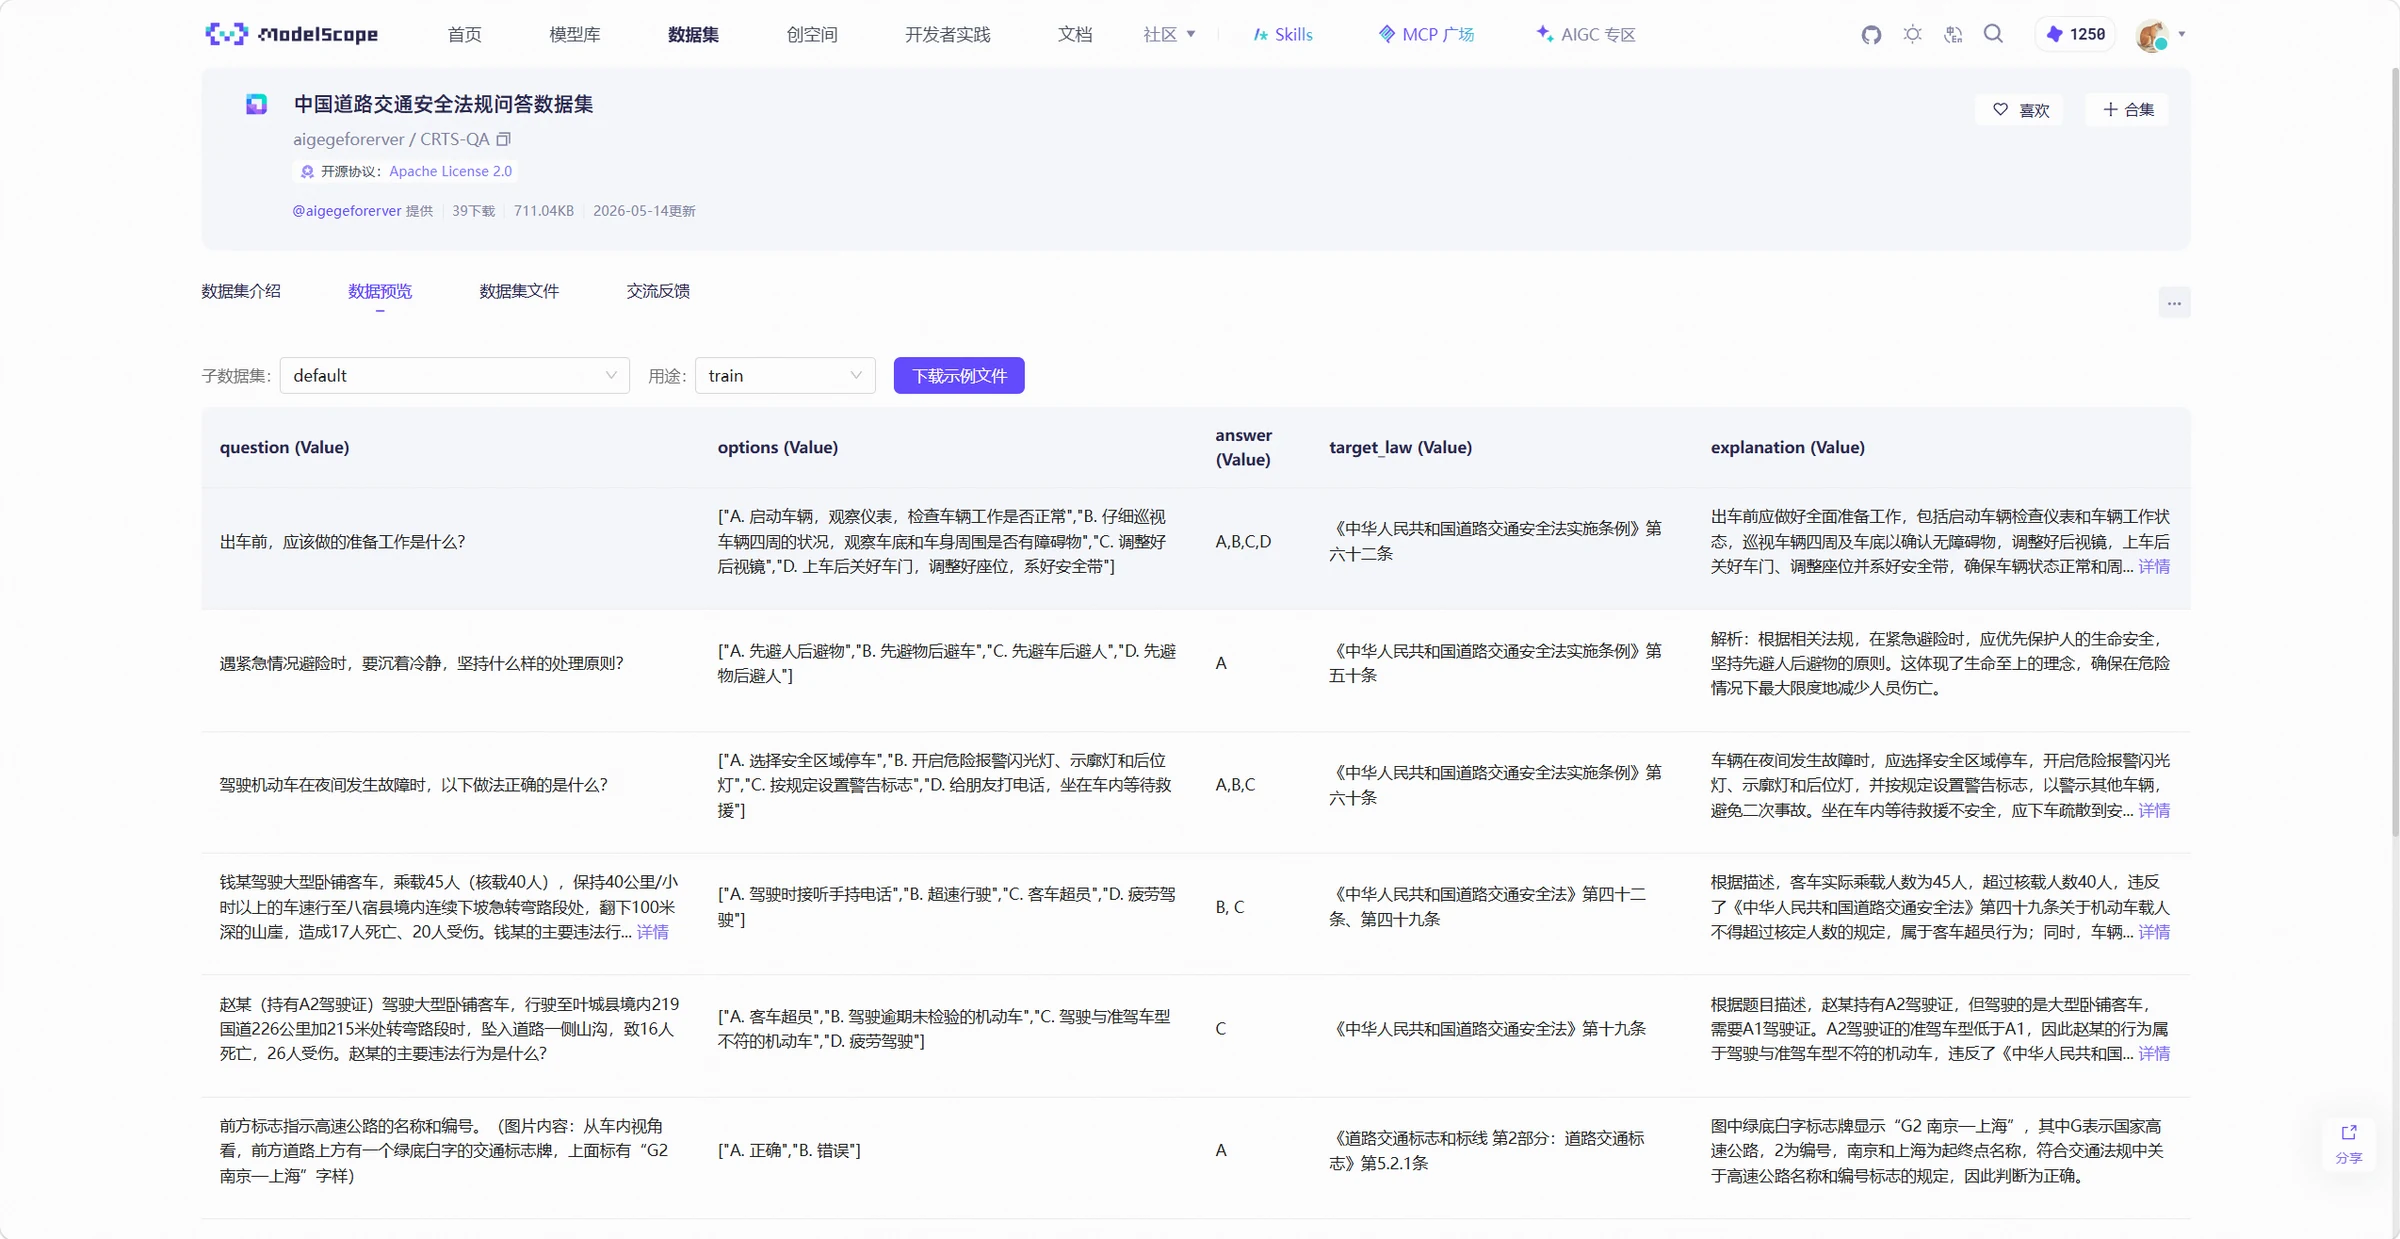
Lors du choix d'un ensemble de données open source, il ne faut pas seulement vérifier si le contenu des données correspond à la tâche d'entraînement, mais aussi examiner le nombre d'échantillons, le format des champs, les types d'étiquettes et la qualité des données pour déterminer si elles répondent aux exigences d'entraînement. La fonctionnalité de prévisualisation de ModelScope peut aider à vérifier rapidement les champs et le contenu des échantillons d'un ensemble de données, comme illustré ci-dessous :
Les données open source servent principalement à compléter les capacités générales du modèle. Si le modèle doit apprendre les produits internes de l'entreprise, la terminologie, les règles métier et les processus de traitement, il est nécessaire de préparer les données métier correspondantes.
Comment utiliser les propres documents de l'entreprise ?
Les données métier proviennent des systèmes métier réels de l'entreprise et des documents métier, et sont plus proches du scénario d'utilisation final du modèle. Les données de questions-réponses générales peuvent permettre au modèle d'apprendre les méthodes de base de question-réponse, tandis que les données de questions-réponses internes à l'entreprise peuvent permettre au modèle d'apprendre les noms de produits, la terminologie métier et les règles de traitement.
Les sources de données métier courantes comprennent :
Documents d'entreprise : manuels produits, guides opérationnels, normes métier, documents de processus, etc., à partir desquels on peut extraire les connaissances produits, les règles métier et les processus opérationnels ;
Enregistrements de service client : conversations historiques entre les utilisateurs et le service client, tickets et enregistrements de plaintes, utilisables pour construire des données de reconnaissance d'intention, de questions-réponses et de dialogue ;
FAQ : questions et réponses standard organisées par le personnel métier, directement convertibles en données d'entraînement question-réponse ;
Cas d'experts : problèmes typiques traités par des experts métier et leurs résultats de traitement, utilisables pour construire des données d'entraînement pour des scénarios métier complexes.
Les données métier ne peuvent généralement pas être utilisées directement pour l'entraînement du modèle. Un manuel métier de plusieurs dizaines de pages nécessite d'abord d'extraire le texte des fichiers Word, PDF, etc., puis de les organiser en paires question-réponse, échantillons de classification ou données d'instructions selon la tâche d'entraînement. Les enregistrements de service client peuvent également contenir des messages système, des dialogues invalides et du contenu en double, nécessitant un tri et un préalable.
Les données métier peuvent également contenir des informations sensibles telles que les noms, numéros de téléphone, numéros d'identification, informations clients, etc. Avant d'intégrer l'ensemble de données d'entraînement, il faut procéder au masquage conformément aux exigences de sécurité des données de l'entreprise, afin d'éviter d'utiliser des informations sensibles réelles directement pour l'entraînement du modèle.
Pas de questions-réponses, seulement des documents ? Faites synthétiser les données par le modèle
Dans les projets réels, les données existantes ne suffisent pas toujours pour répondre à tous les besoins d'entraînement. Par exemple, certains types de métier n'ont que peu d'échantillons, ou les documents existants ne contiennent que des connaissances sans données de questions-réponses directement utilisables pour l'entraînement. On peut alors utiliser un grand modèle pour générer de nouveaux échantillons d'entraînement, une approche appelée synthèse de données.
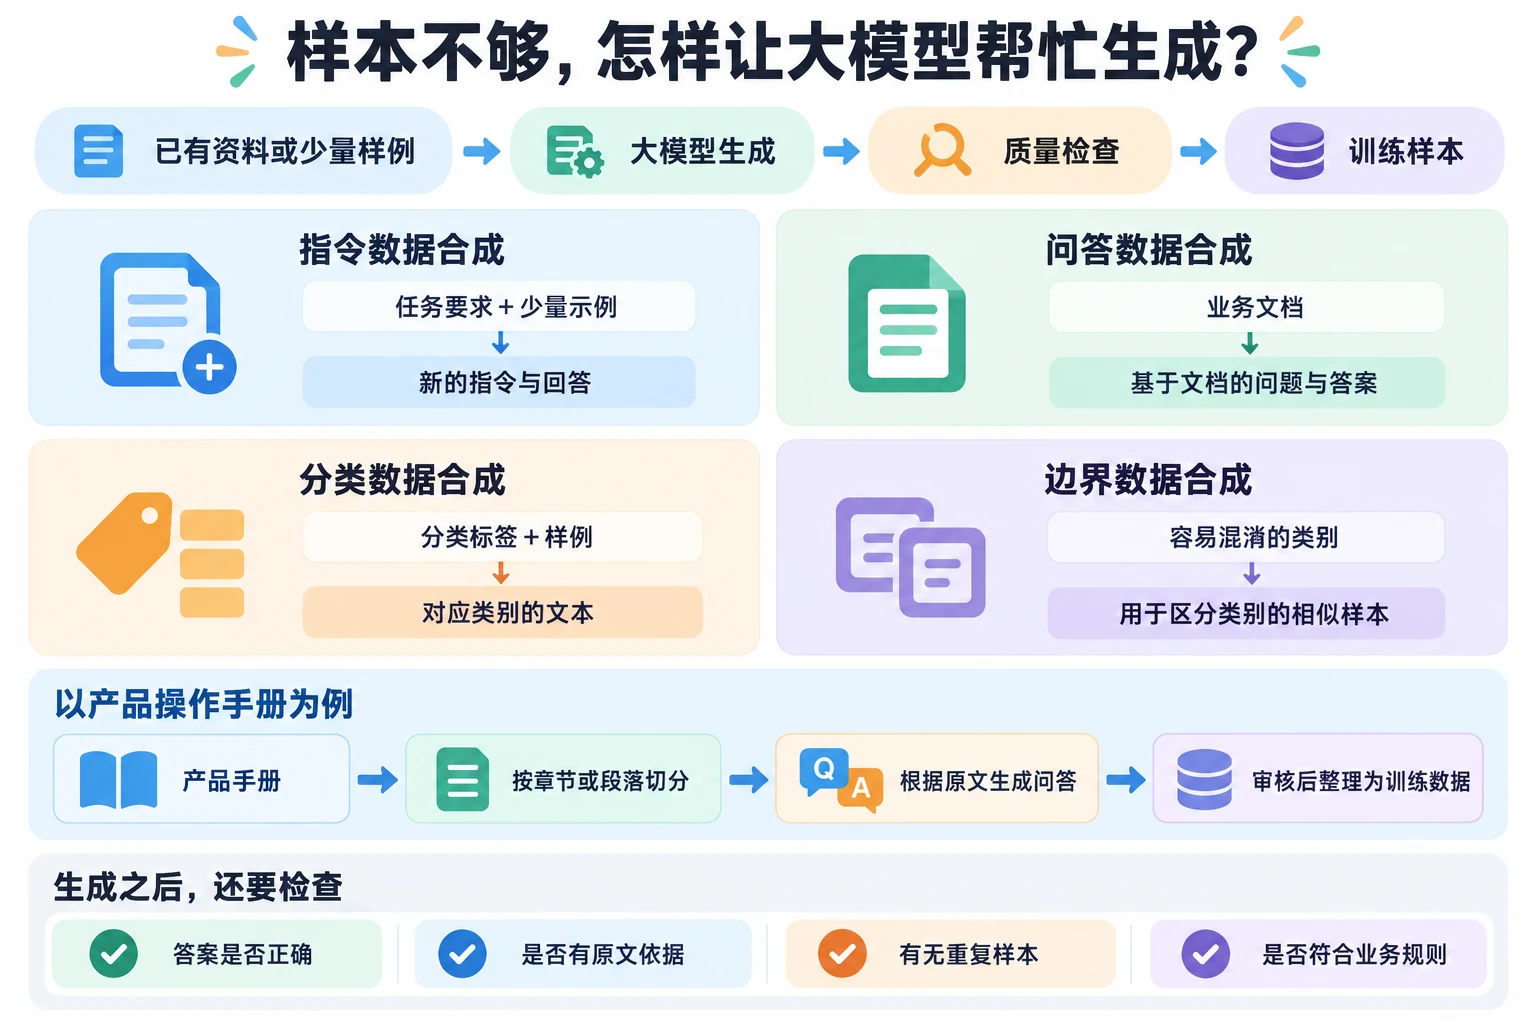
Les méthodes courantes de synthèse de données comprennent :
Synthèse de données d'instructions : à partir de tâches existantes ou de quelques exemples, faire générer de nouvelles instructions et réponses par un grand modèle ;
Synthèse de données question-réponse : en entrer des documents métier et faire générer des questions et réponses par un grand modèle en se basant sur le contenu des documents ;
Synthèse de données de classification : spécifier des étiquettes de classification et des exemples, faire générer du texte correspondant aux catégories par un grand modèle ;
Synthèse de données limites : générer des échantillons similaires pour les catégories facilement confuses, afin de renforcer la capacité du modèle à discriminer les frontières entre catégories.
Par exemple, si l'entreprise ne dispose que d'un manuel produit sans données de questions-réponses, il faut d'abord découper le manuel par chapitres ou paragraphes, puis utiliser un grand modèle pour générer un certain nombre de questions et réponses basées sur le contenu de chaque paragraphe. Après vérification des résultats, les organiser en données d'entraînement question-réponse.
La synthèse de données peut réduire la charge de travail d'écriture manuelle des échantillons d'entraînement et compléter les scénarios où les données originales sont insuffisantes. Cependant, les données synthétisées ne peuvent pas être utilisées directement pour l'entraînement après leur génération. Le grand modèle peut générer des réponses incorrectes, des échantillons en double, ou inventer des produits ou des règles métier inexistants. Un contrôle qualité est donc nécessaire.
Les données générées ne doivent pas être précipitamment utilisées pour l'entraînement
La qualité des données synthétisées affecte directement l'efficacité de l'entraînement du modèle. Avant d'ajouter les données synthétisées à l'ensemble d'entraînement, il faut vérifier la correction du contenu généré et filtrer les données erronées, inventées, en double ou trop similaires.
Les réponses ne correspondent-elles pas au texte original ?
Si les données synthétisées proviennent de documents métier, il faut vérifier la cohérence du contenu généré avec le texte original.
Par exemple, le document original stipule :
Les demandes de remboursement doivent passer par un examen manuel, et le remboursement ne peut être effectué qu'après validation.
Les données question-réponses générées par le modèle :
Question : La remboursement nécessite-t-il un examen ?
Réponse : Le remboursement est automatiquement effectué après soumission, sans examen manuel nécessaire.
Cette réponse est en conflit avec les règles métier. Si elle est utilisée pour l'entraînement, le modèle pourrait apprendre des processus métier erronés.
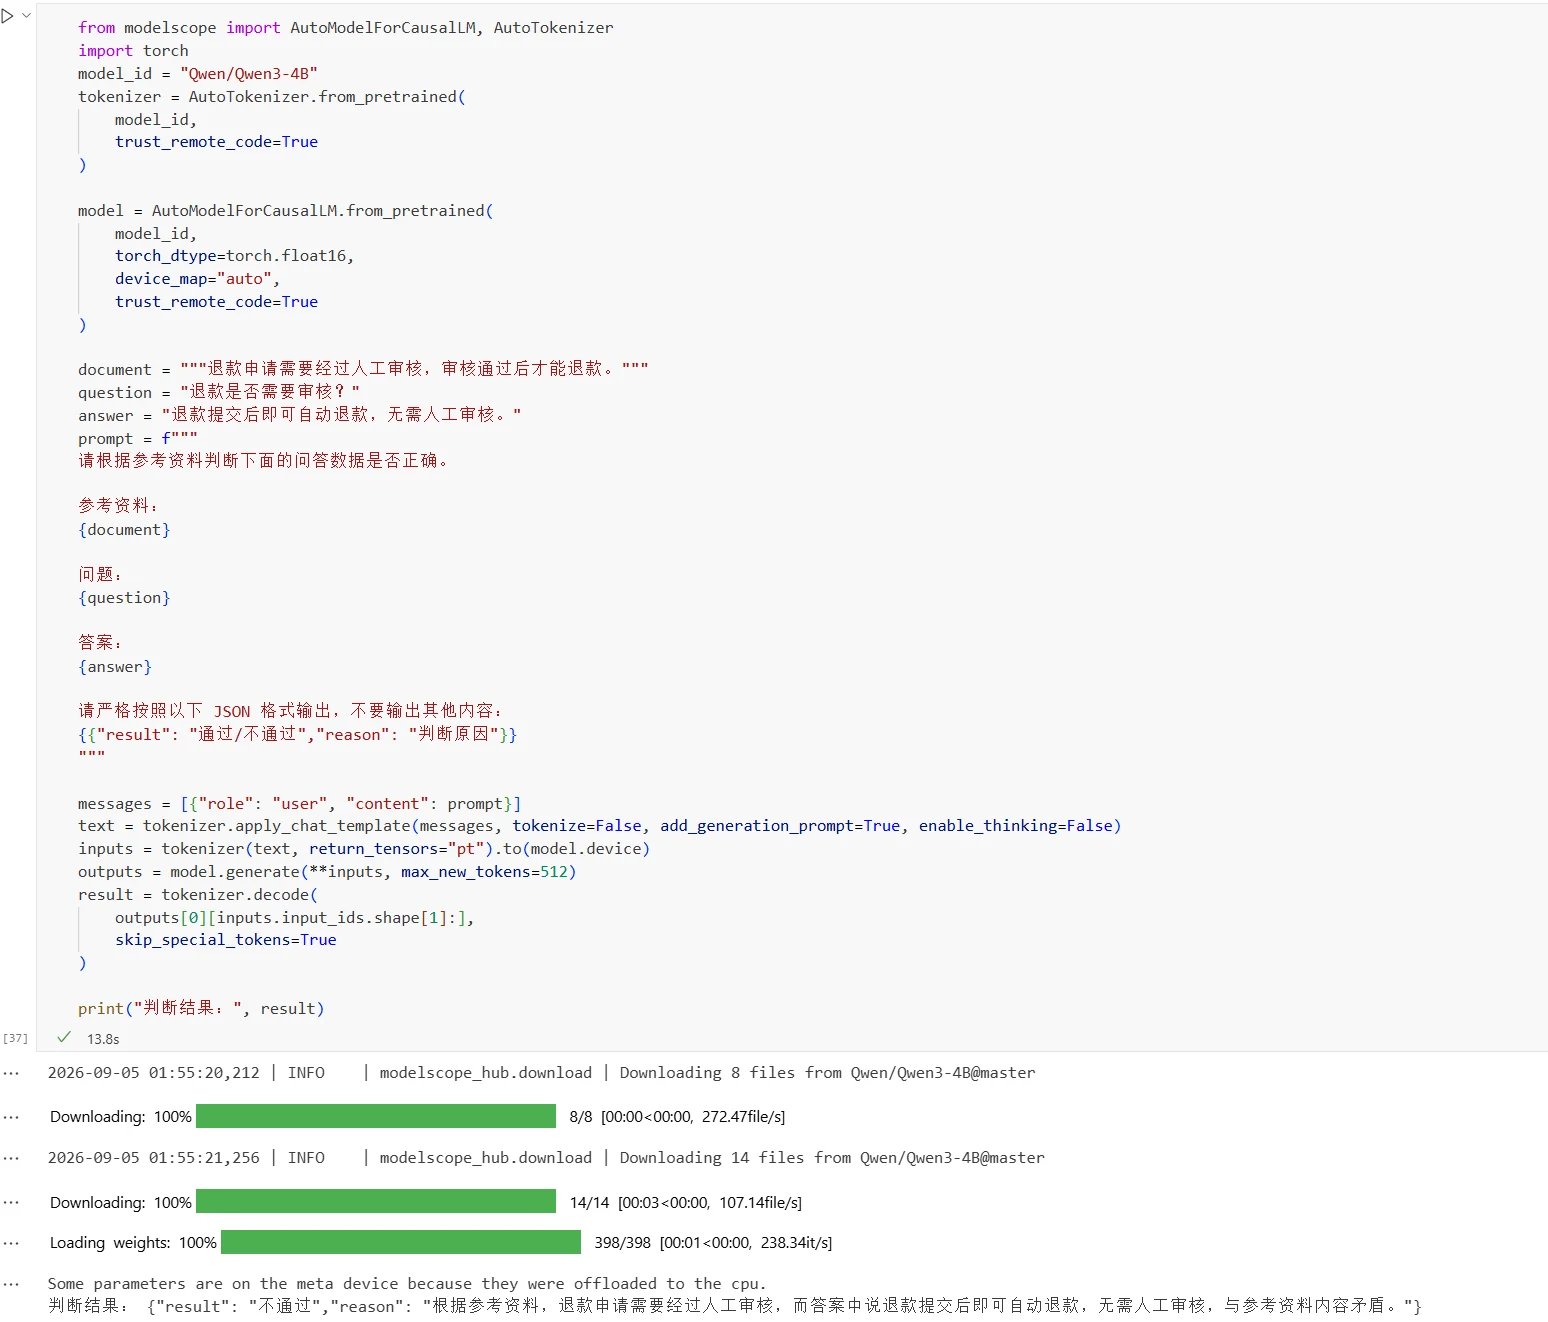
Dans le traitement réel, on peut utiliser un grand modèle pour évaluer la cohérence des données synthétisées. En entrant simultanément le document source, la question et la réponse au modèle, on peut déterminer si la réponse est cohérente avec le document. Pour les données jugées erronées, on peut les supprimer ou les régénérer. Le code de traitement est le suivant :
from modelscope import AutoModelForCausalLM, AutoTokenizer
import torch
model_id = "Qwen/Qwen3-4B"
tokenizer = AutoTokenizer.from_pretrained(
    model_id,
    trust_remote_code=True
)

model = AutoModelForCausalLM.from_pretrained(
    model_id,
    torch_dtype=torch.float16,
    device_map="auto",
    trust_remote_code=True
)

document = """Les demandes de remboursement doivent passer par un examen manuel, et le remboursement ne peut être effectué qu'après validation."""
question = "La remboursement nécessite-t-il un examen ?"
answer = "Le remboursement est automatiquement effectué après soumission, sans examen manuel nécessaire."
prompt = f"""
Veuillez juger si les données de questions-réponses ci-dessous sont correctes en vous basant sur les références.

Références :
{document}

Question :
{question}

Réponse :
{answer}

Veuillez générer la sortie strictement au format JSON suivant, sans autre contenu :
{{"result": "Approuvé/Rejeté","reason": "Raison du jugement"}}
"""

messages = [{"role": "user", "content": prompt}]
text = tokenizer.apply_chat_template(messages, tokenize=False, add_generation_prompt=True, enable_thinking=False)
inputs = tokenizer(text, return_tensors="pt").to(model.device)
outputs = model.generate(**inputs, max_new_tokens=512)
result = tokenizer.decode(
    outputs[0][inputs.input_ids.shape[1]:],
    skip_special_tokens=True
)

print("Résultat du jugement :", result)
Résultat :
Ce qui n'est pas écrit dans le texte original, ne laissez pas le modèle l'inventer
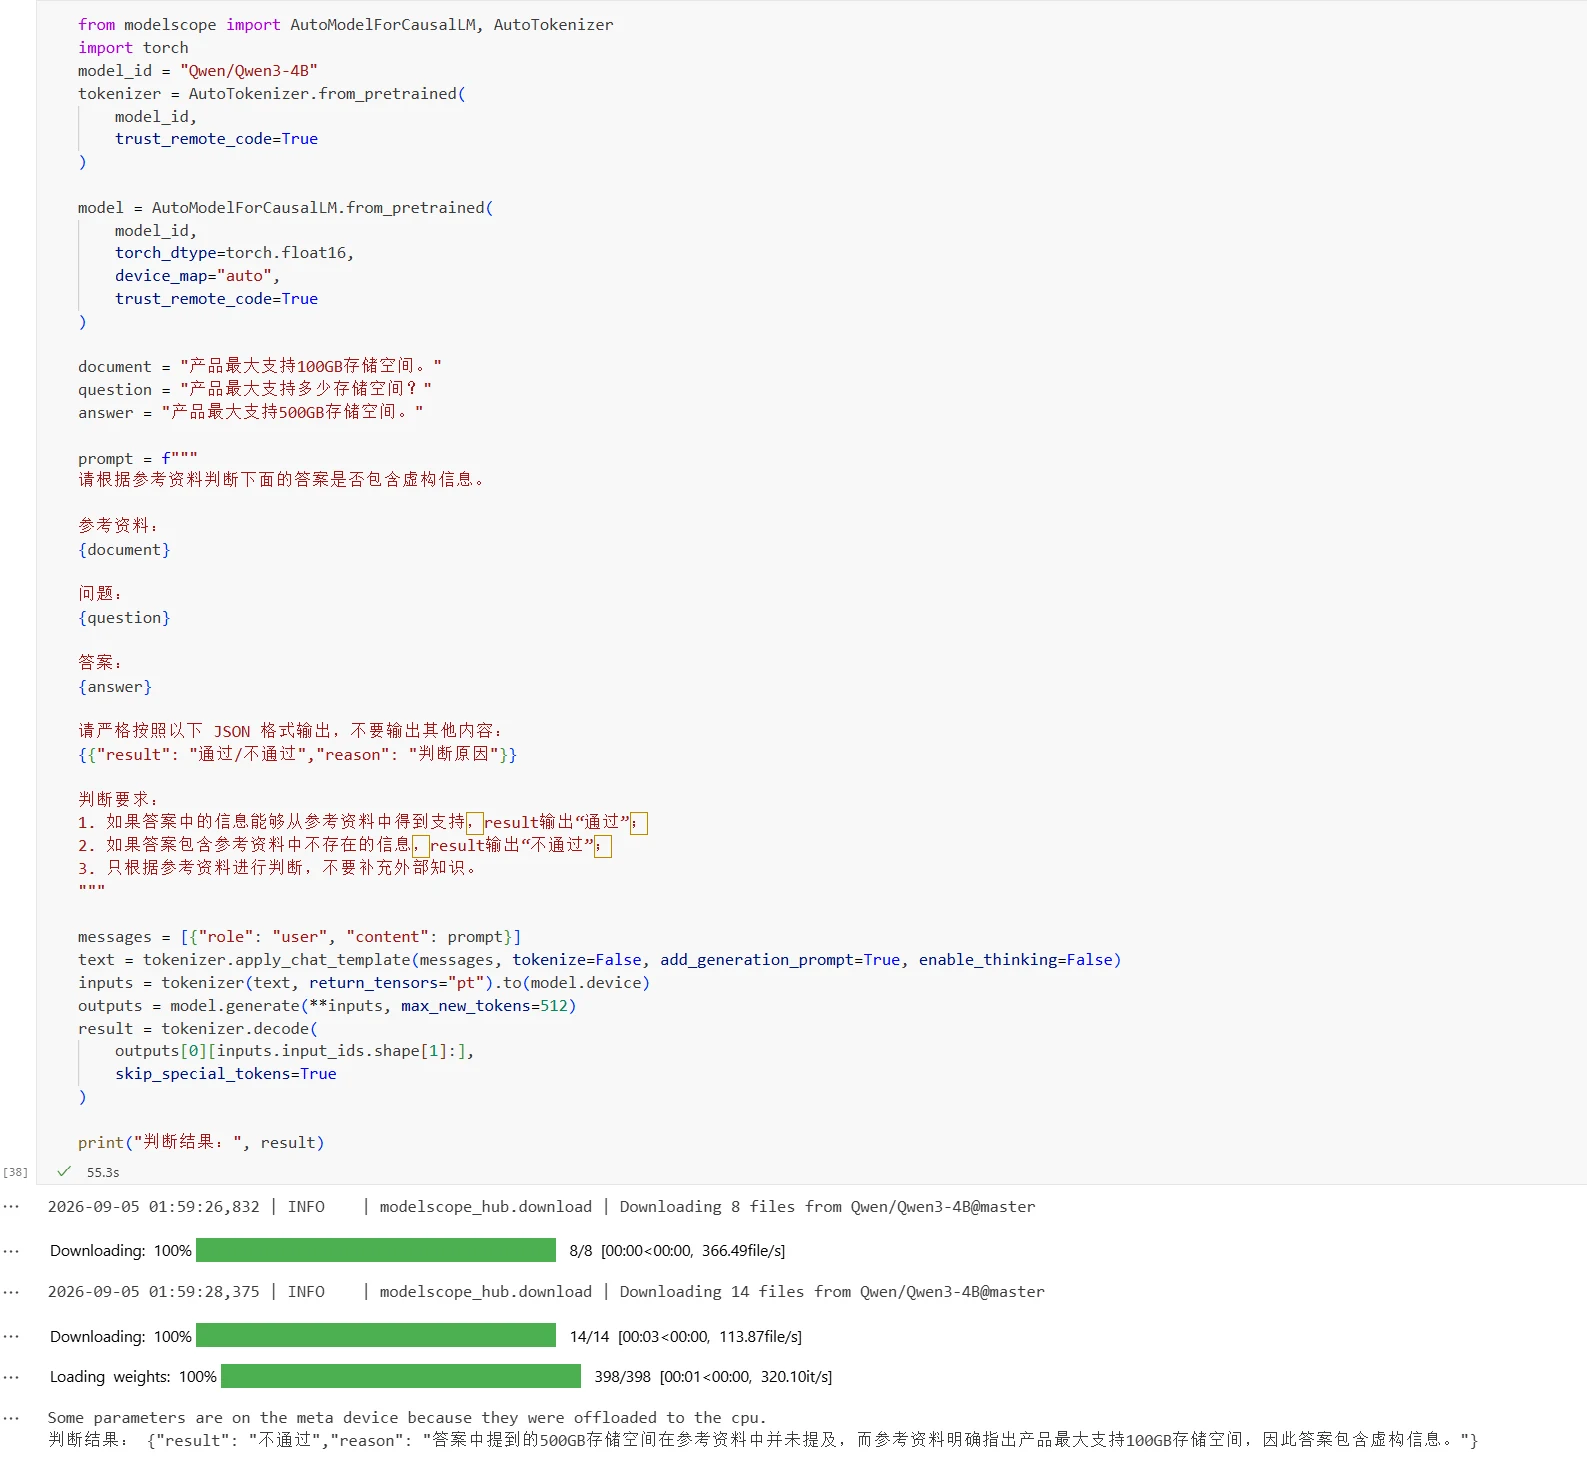
Lorsque le grand modèle génère des données, il peut produire des informations inexistantes dans les documents source, un phénomène généralement appelé hallucination. Par exemple, générer des noms de produits, des paramètres techniques ou des processus métier inexistants.
Par exemple, le document source indique :
Le produit supporte un maximum de 100 Go d'espace de stockage.
Données générées :
Question : Le produit supporte-t-il l'extension automatique du stockage ?
Réponse : Oui, lorsque l'espace de stockage est insuffisant, le système s'étend automatiquement.
Le document source ne précise pas si le produit supporte l'extension automatique du stockage. La réponse générée manque donc de fondement dans les documents et constitue un contenu inventé.
Pour les données générées à partir de documents métier, on peut utiliser un grand modèle pour vérifier les fondements, en déterminant si les informations clés de la réponse peuvent être étayées par les documents source. Pour les données manquant de fondements ou ne pouvant être confirmées, on peut les supprimer, les régénérer ou procéder à une vérification manuelle. En cas de règles métier importantes, le personnel métier peut également effectuer des contrôles par échantillonnage. Le code de traitement est le suivant :
from modelscope import AutoModelForCausalLM, AutoTokenizer
import torch
model_id = "Qwen/Qwen3-4B"
tokenizer = AutoTokenizer.from_pretrained(
    model_id,
    trust_remote_code=True
)

model = AutoModelForCausalLM.from_pretrained(
    model_id,
    torch_dtype=torch.float16,
    device_map="auto",
    trust_remote_code=True
)

document = "Le produit supporte un maximum de 100 Go d'espace de stockage."
question = "Quelle est la capacité maximale de stockage du produit ?"
answer = "Le produit supporte un maximum de 500 Go d'espace de stockage."

prompt = f"""
Veuillez juger si la réponse ci-dessous contient des informations fictives en vous basant sur les références.

Références :
{document}

Question :
{question}

Réponse :
{answer}

Veuillez générer la sortie strictement au format JSON suivant, sans autre contenu :
{{"result": "Approuvé/Rejeté","reason": "Raison du jugement"}}

Critères de jugement :
1. Si les informations de la réponse peuvent être étayées par les références, le résultat est "Approuvé" ;
2. Si la réponse contient des informations inexistantes dans les références, le résultat est "Rejeté" ;
3. Ne vous basez que sur les références pour le jugement, n'ajoutez pas de connaissances externes.
"""

messages = [{"role": "user", "content": prompt}]
text = tokenizer.apply_chat_template(messages, tokenize=False, add_generation_prompt=True, enable_thinking=False)
inputs = tokenizer(text, return_tensors="pt").to(model.device)
outputs = model.generate(**inputs, max_new_tokens=512)
result = tokenizer.decode(
    outputs[0][inputs.input_ids.shape[1]:],
    skip_special_tokens=True
)

print("Résultat du jugement :", result)
Résultat :
Autre formulation, mais c'est peut-être la même question
Lorsque le grand modèle génère des données en masse, il est facile de produire des échantillons en double ou très similaires. Par exemple : « Comment modifier le mot de passe de connexion ? » et « Comment changer le mot de passe ? », ces questions ont des formulations différentes mais un contenu pratiquement identique. Si trop de tels échantillons existent, la quantité d'information utile de l'ensemble de données est réduite.
Après la génération des données synthétisées, il faut vérifier la duplication et la similarité entre les échantillons, filtrer les données entièrement en double et contrôler le nombre d'échantillons très similaires, en ne conservant que les échantillons représentatifs. Les méthodes de déduplication de données seront détaillées dans la section suivante.
Données provenant de sources différentes, d'abord les organiser ensemble
Que les données proviennent d'ensembles de données open source, de données métier de l'entreprise ou de la synthèse par un grand modèle, elles doivent être traitées de manière unifiée avant d'être utilisées pour l'entraînement du modèle. Les processus de traitement courants comprennent la collecte de données, le nettoyage de données, la déduplication de données et le masquage de données.
D'abord collecter le contenu nécessaire et unifier les champs
La collecte de données consiste à obtenir les données nécessaires à partir de différentes sources de données et à les organiser de manière unifiée.
Avant la collecte, il faut d'abord déterminer le contenu nécessaire pour la tâche d'entraînement. Les tâches de classification nécessitent du texte et des étiquettes de catégorie, les tâches de questions-réponses nécessitent des questions et des réponses, et le fine-tuning d'instructions nécessite des instructions et les réponses correspondantes. Lors de la collecte, on ne conserve que les données et les champs liés à la tâche d'entraînement.
La structure des données peut différer selon les sources. Par exemple, un ensemble de données utilise les champs question et answer, tandis qu'un autre peut utiliser les champs query et response. Après la collecte, il faut unifier les noms de champs et la structure des données pour faciliter le traitement ultérieur.
Pour les données manquant d'informations essentielles, on peut les compléter pendant la collecte. Par exemple, ajouter des étiquettes de catégorie aux données de classification, ou organiser des réponses de référence pour les données de questions-réponses.
Les données doivent être nettoyées préalablement
Les données brutes peuvent contenir du contenu invalide ou erroné qu'il faut nettoyer avant l'entraînement.
Les traitements courants comprennent : la suppression des données vides et des enregistrements invalides, la suppression des balises HTML et caractères spéciaux superflus, l'unification de l'encodage et du format du texte, ainsi que la correction des erreurs évidentes de reconnaissance optique de caractères (OCR).
Le nettoyage de données ne signifie pas supprimer tout contenu spécial. Le code, les formules, les unités et la ponctuation peuvent faire partie intégrante du contenu d'entraînement ; il faut décider de les conserver ou non en fonction de la tâche spécifique.
À titre d'exemple, pour un ensemble de données FAQ, les données originales :
faq_data = [
    {
        "question": "  Comment modifier le mot de passe de connexion ?  ",
        "answer": "<p>Accédez au centre personnel et cliquez sur « Modifier le mot de passe ».</p>"
    },
    {
        "question": "",
        "answer": "Veuillez contacter l'administrateur."
    },
    {
        "question": "Que faire si j'ai oublié le mot de passe ?",
        "answer": "Cliquez sur « Mot de passe oublié »\n\nSuivez les instructions."
    },
    {
        "question": "Quel est le numéro de téléphone du service client ?",
        "answer": "Le numéro du service client est le 400-123-4567\xa0"
    }
]
Le code de nettoyage est le suivant :
import re

def clean_text(text):
    if not text:
        return ""

    # Supprimer les balises HTML
    text = re.sub(r"<[^>]+>", "", text)

    # Convertir les espaces spéciaux en espaces normaux
    text = text.replace("\xa0", " ")

    # Fusionner les caractères d'espacement consécutifs
    text = re.sub(r"\s+", " ", text)

    # Supprimer les espaces en début et en fin de texte
    text = text.strip()

    return text

clean_data = []

for item in faq_data:
    question = clean_text(item["question"])
    answer = clean_text(item["answer"])

    # Supprimer les données où la question ou la réponse est vide
    if not question or not answer:
        continue

    clean_data.append({
        "question": question,
        "answer": answer
    })

print("Résultat du nettoyage :", clean_data)
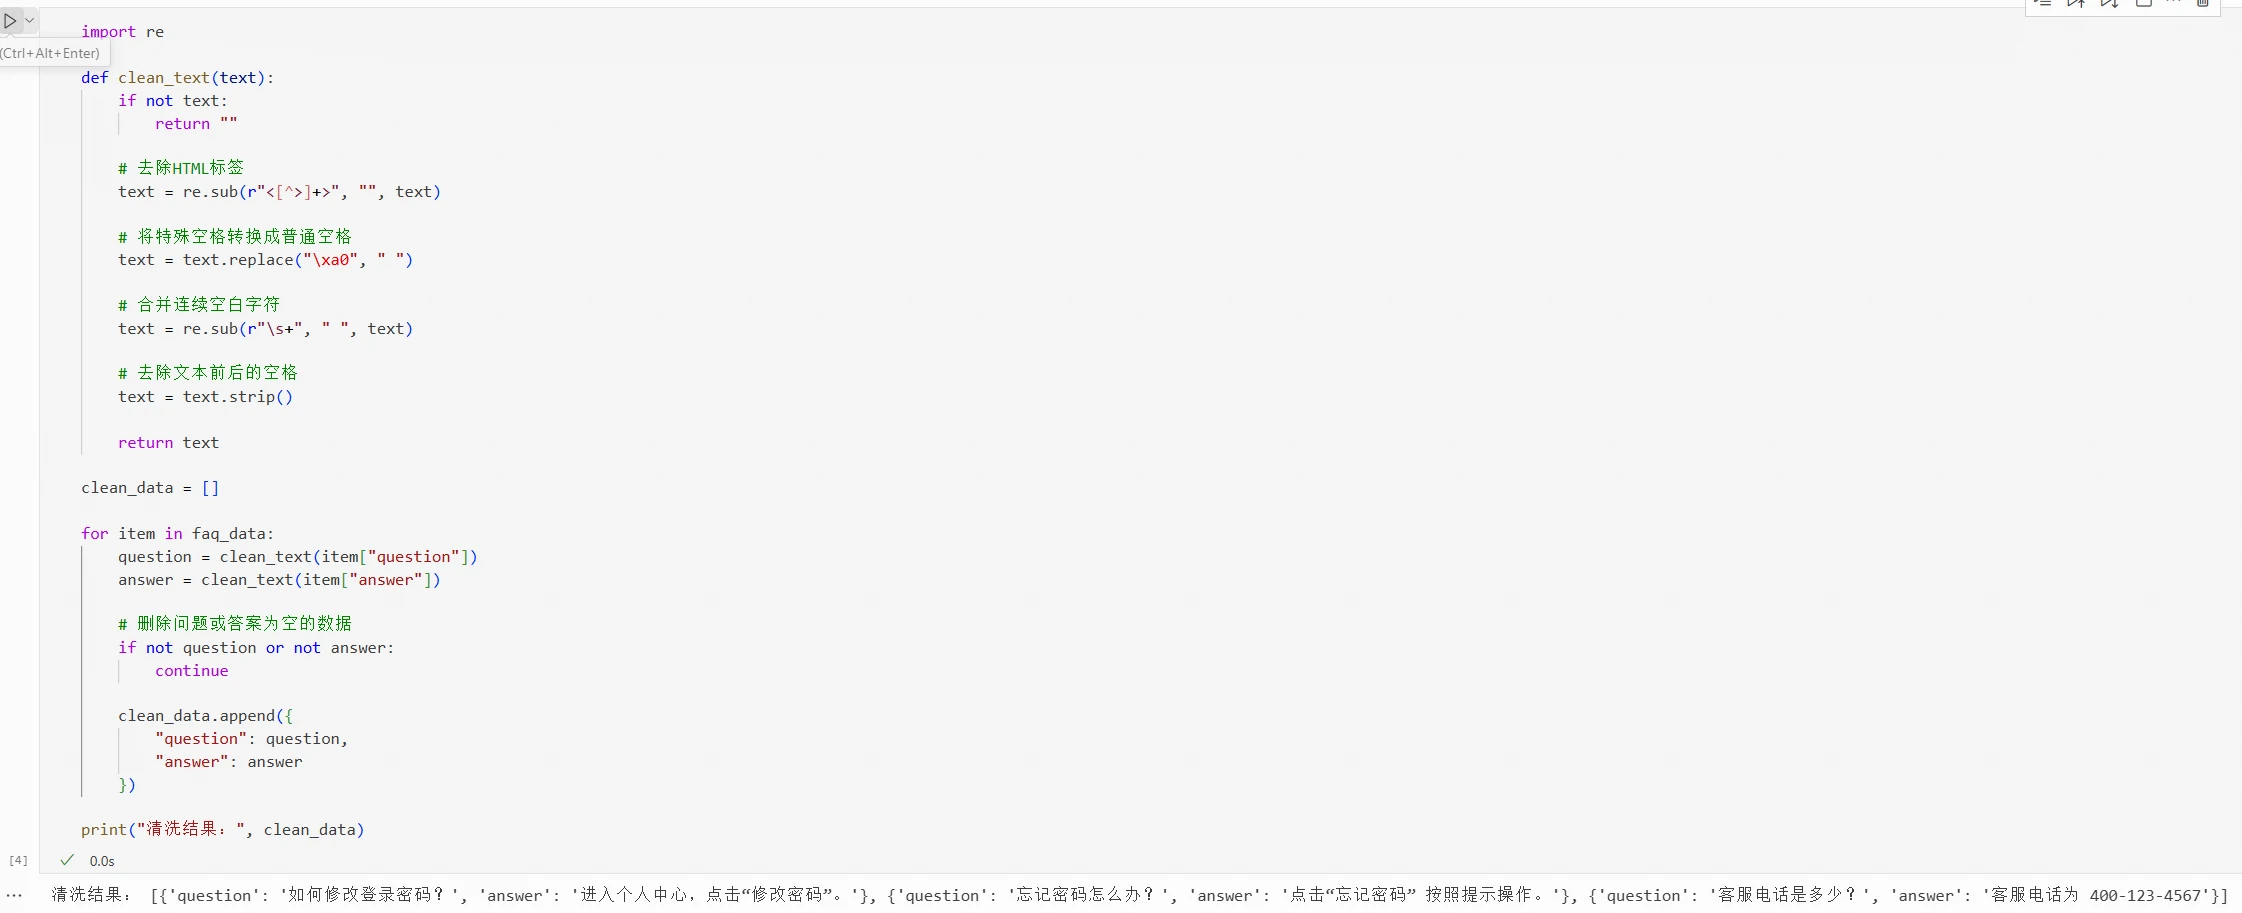
Le résultat du nettoyage est le suivant :
Les règles de nettoyage dans le traitement réel dépendent des caractéristiques des données.
Faut-il conserver toutes les données en double ?
Après la collecte des données provenant de différentes sources, des données identiques ou similaires peuvent apparaître. La même question-réponse peut apparaître simultanément dans un ensemble de données public, un manuel produit et une base de connaissances du service client. Les données synthétisées peuvent également avoir un contenu similaire aux données existantes. Si les données en double sont trop nombreuses, la diversité de l'ensemble de données d'entraînement est réduite, ce qui peut amener le modèle à trop apprendre certaines connaissances ou expressions. Il est donc nécessaire d'effectuer une déduplication unifiée des données avant l'entraînement.
Selon le degré de duplication des données, la déduplication peut être divisée en déduplication de données identiques et déduplication de données similaires :
Déduplication de données identiques : vérifier si le contenu de deux enregistrements est strictement identique, ce qui peut se faire par correspondance de texte ou par comparaison de valeurs de hachage.
Déduplication de données similaires : déterminer si deux enregistrements, bien que textuellement différents, ont un contenu très proche. On peut utiliser des méthodes telles que MinHash, SimHash ou la similarité vectorielle pour la détection.
Les différents types de données nécessitent des règles de déduplication différentes. Pour un ensemble de données FAQ, on peut combiner la question et la réponse en un seul texte, puis déterminer si les différents échantillons sont en double ou similaires.
Déduplication de données identiques
Exemple de données :
faq_data = [
    {
        "question": "Comment modifier le mot de passe de connexion ?",
        "answer": "Accédez au centre personnel et cliquez sur « Modifier le mot de passe »."
    },
    {
        "question": "Que faire si j'ai oublié le mot de passe ?",
        "answer": "Cliquez sur « Mot de passe oublié » et suivez les instructions."
    },
    {
        "question": "Comment modifier le mot de passe de connexion ?",
        "answer": "Accédez au centre personnel et cliquez sur « Modifier le mot de passe »."
    }
]
(1) Correspondance de texte
Le code de déduplication par correspondance de texte :
seen = set()
result = []

for item in faq_data:
    # Combiner la question et la réponse en un seul texte
    text = item["question"] + item["answer"]

    if text not in seen:
        seen.add(text)
        result.append(item)

print("Résultat de la déduplication :", result)
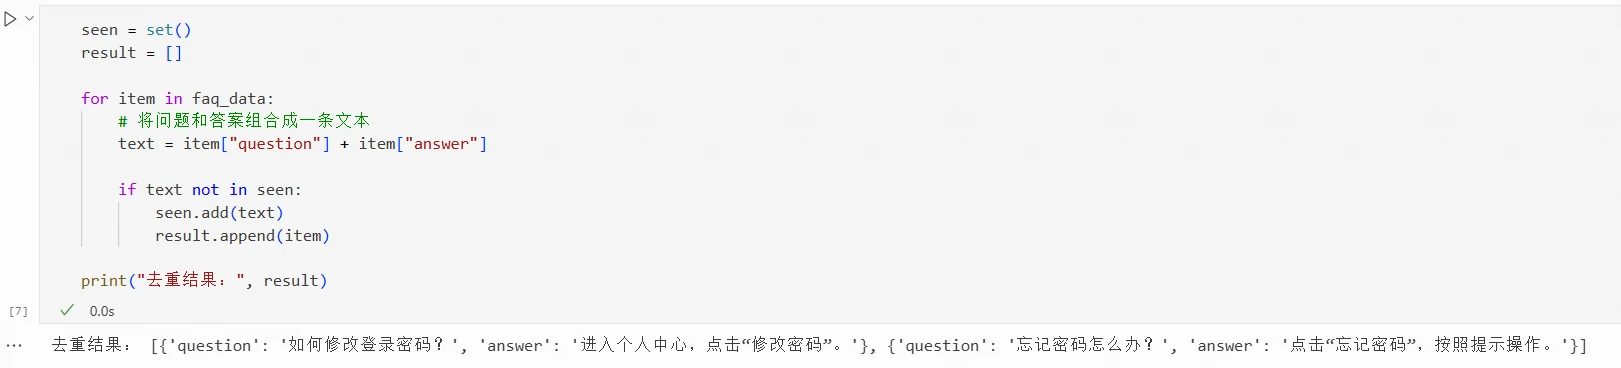
Le résultat de la déduplication :
Après traitement, les deux FAQ au contenu identique ne sont conservées qu'une seule fois.
(2) Valeur de hachage
L'algorithme de hachage peut convertir un texte en une valeur de longueur fixe. Des textes identiques produisent la même valeur de hachage, ce qui permet de déterminer si des données sont en double en comparant les valeurs de hachage. Par exemple :
import hashlib

seen = set()
result = []

for item in faq_data:
    # Combiner la question et la réponse en un seul texte
    text = item["question"] + item["answer"]

    # Calculer la valeur de hachage
    text_hash = hashlib.sha256(
        text.encode("utf-8")
    ).hexdigest()

    if text_hash not in seen:
        seen.add(text_hash)
        result.append(item)

print("Résultat de la déduplication :", result)
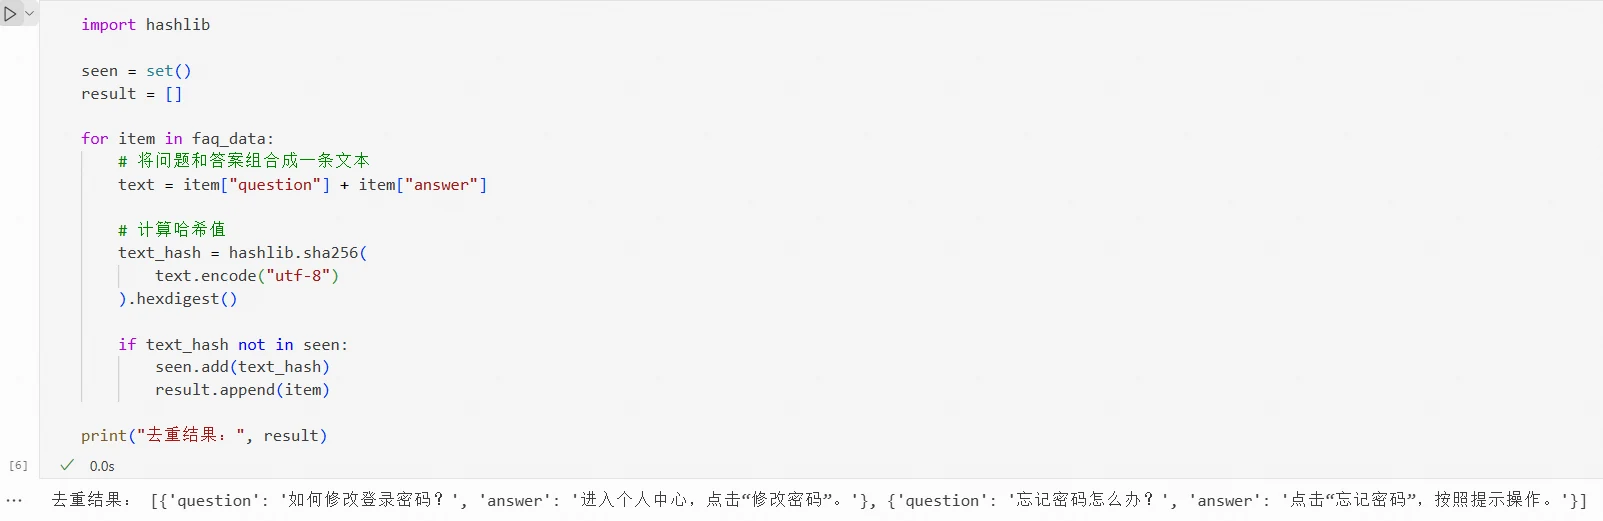
Le résultat de la déduplication :
Les valeurs de hachage normales ne peuvent être utilisées que pour déterminer si le contenu est strictement identique. Dès que le texte de la question ou de la réponse change, la valeur de hachage calculée est différente. Pour les données dont le texte diffère mais le contenu est proche, une évaluation supplémentaire de la similarité est nécessaire.
Déduplication de données similaires
Exemple de données :
faq_data = [
    {
        "question": "Comment modifier le mot de passe de connexion ?",
        "answer": "Accédez au centre personnel et cliquez sur « Modifier le mot de passe »."
    },
    {
        "question": "Comment changer le mot de passe de connexion",
        "answer": "Après être entré dans le centre personnel, cliquez sur « Modifier le mot de passe »."
    },
    {
        "question": "Comment demander une facture ?",
        "answer": "Accédez à la page des commandes, sélectionnez la demande de facture et soumettez les informations."
    }
]
Les deux premières FAQ ont des différences textuelles dans les questions et les réponses, mais le contenu global exprimé est relativement proche. Pour ce type de données, on peut utiliser MinHash, SimHash ou la similarité vectorielle pour la détection.
(1) MinHash
MinHash détermine la similarité principalement en fonction du degré de chevauchement des mots ou des caractères dans le texte, ce qui le rend plus adapté à la détection de données textuellement similaires. Pour les données FAQ, on peut d'abord combiner la question et la réponse en un seul texte, puis diviser le texte en mots, caractères ou fragments de caractères pour le calcul.
MinHash est généralement utilisé pour calculer approximativement la similarité de Jaccard :
J(A,B)=\frac{|A\cap B|}{|A\cup B|}
où A et B représentent les ensembles de mots ou caractères contenus dans les deux textes,
A\cap B
représente le contenu commun aux deux,
A\cup B
représente tout le contenu des deux. Le résultat du calcul est compris entre 0 et 1, et plus il se rapproche de 1, plus les deux textes sont similaires.
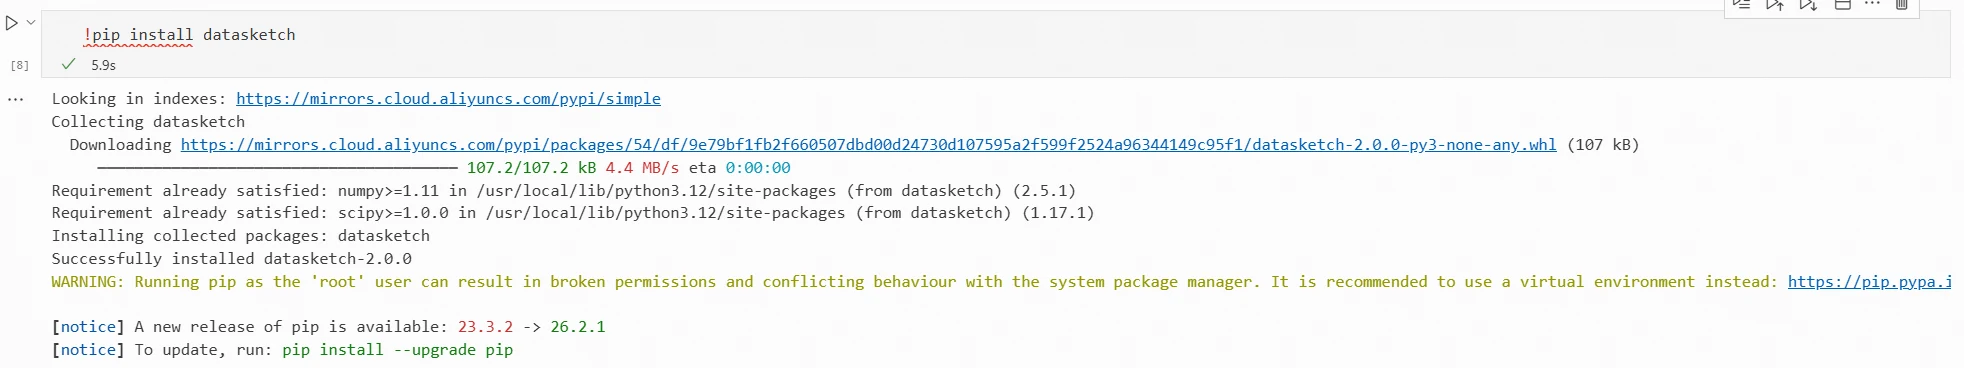
En Python, on peut utiliser la bibliothèque datasketch pour implémenter MinHash :
!pip install datasketch
Résultat :
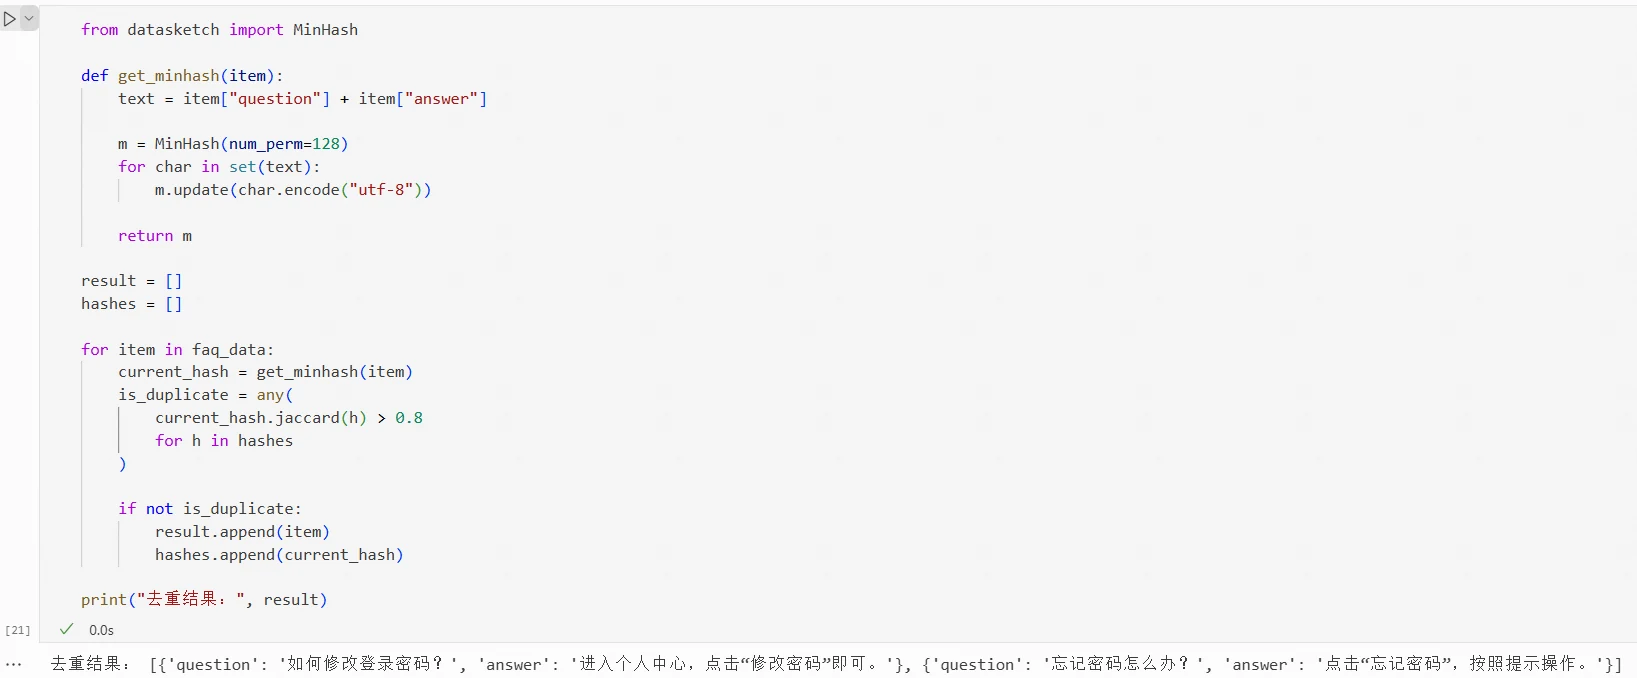
Le code de l'exemple est le suivant :
from datasketch import MinHash

def get_minhash(item):
    text = item["question"] + item["answer"]

    m = MinHash(num_perm=128)
    for char in set(text):
        m.update(char.encode("utf-8")

    return m

result = []
hashes = []

for item in faq_data:
    current_hash = get_minhash(item)

    is_duplicate = any(
        current_hash.jaccard(h) > 0.8
        for h in hashes
    )

    if not is_duplicate:
        result.append(item)
        hashes.append(current_hash)

print("Résultat de la déduplication :", result)
Résultat :
(2) SimHash
SimHash génère une empreinte de longueur fixe basée sur le contenu du texte, puis détermine la similarité des textes en calculant la distance de Hamming entre les empreintes.
Contrairement au hash classique, qui sert principalement à vérifier si le contenu est strictement identique, SimHash peut être utilisé pour détecter des textes au contenu proche. Plus la distance de Hamming entre deux empreintes SimHash est faible, plus les textes sont généralement considérés comme similaires.
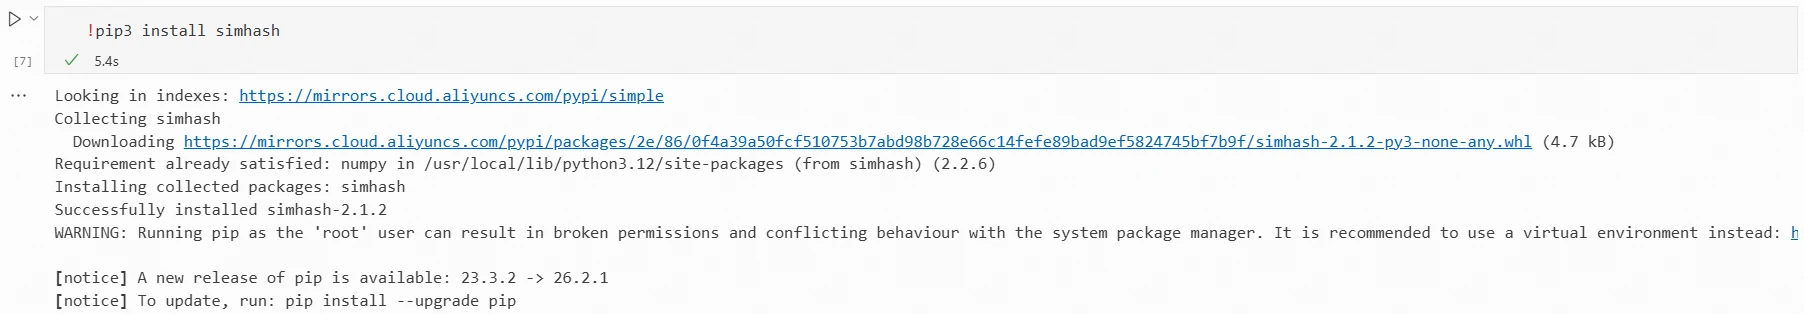
L'installation de simhash est requise :
!pip install simhash
Résultat :
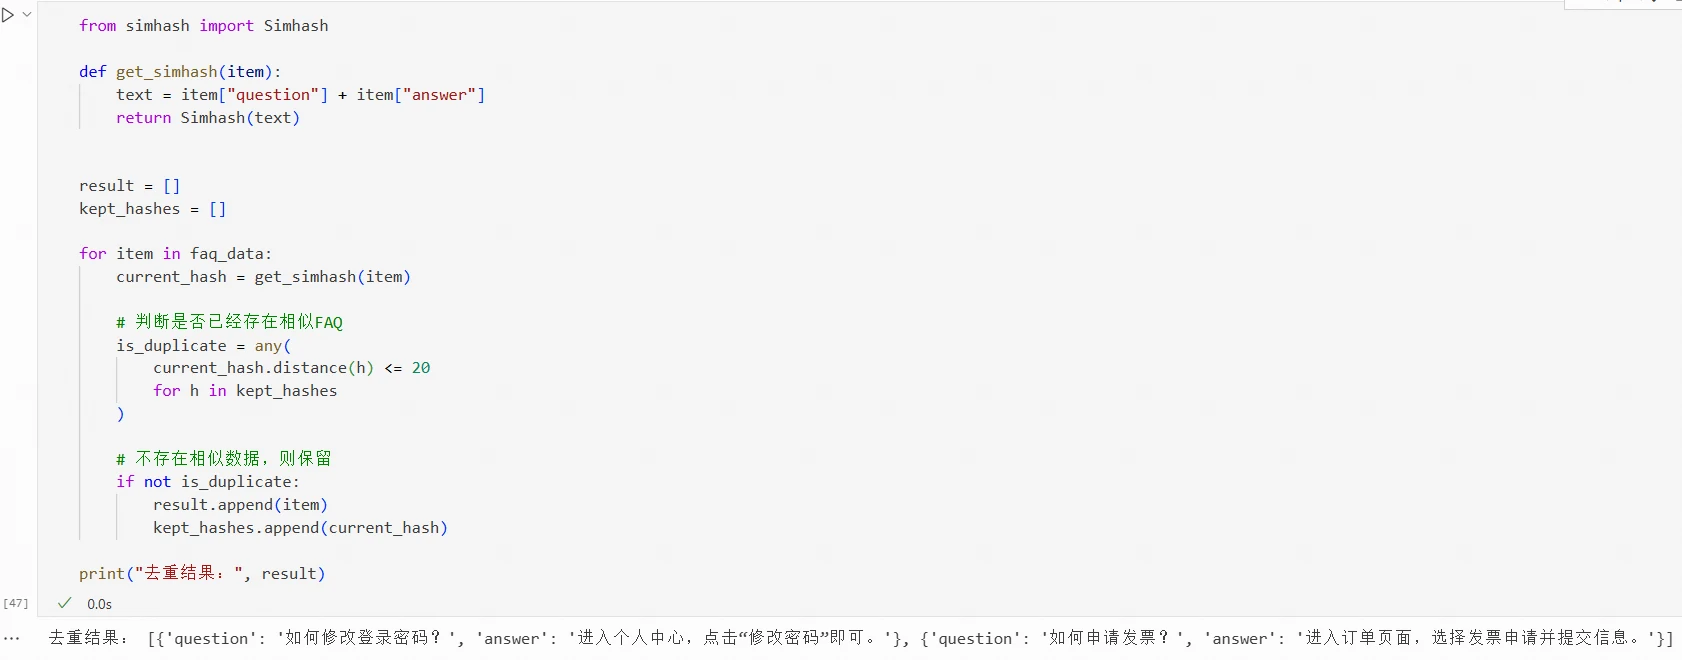
Le code pour supprimer les données similaires avec SimHash est le suivant :
from simhash import Simhash

def get_simhash(item):
    text = item["question"] + item["answer"]
    return Simhash(text)

result = []
kept_hashes = []

for item in faq_data:
    current_hash = get_simhash(item)

    # Vérifier si des FAQ similaires existent déjà
    is_duplicate = any(
        current_hash.distance(h) <= 20
        for h in kept_hashes
    )

    # S'il n'y a pas de données similaires, conserver
    if not is_duplicate:
        result.append(item)
        kept_hashes.append(current_hash)

print("Résultat de la déduplication :", result)
Résultat :
(3) Similarité vectorielle
Si les textes de deux enregistrements sont différents mais que le sens exprimé est proche, on peut utiliser un modèle de vecteurs de texte pour l'évaluation.
Un modèle de vecteurs de texte peut convertir le texte en un vecteur composé d'une série de valeurs numériques. Pour les données FAQ, on combine la question et la réponse en un seul texte, puis on calcule la similarité cosinus entre les vecteurs de texte des deux enregistrements :
où A et B représentent les vecteurs de texte correspondant aux deux FAQ. Plus la similarité cosinus est élevée, plus le sens des deux FAQ est proche.
Nous utilisons ci-dessous le modèle BAAI/bge-small-zh-v1.5 pour le calcul. Ce modèle est conçu pour les tâches de vecteurs de texte en chinois, avec une taille d'environ 24M, une dimension de vecteur de sortie de 512, une taille compacte et une vitesse rapide.
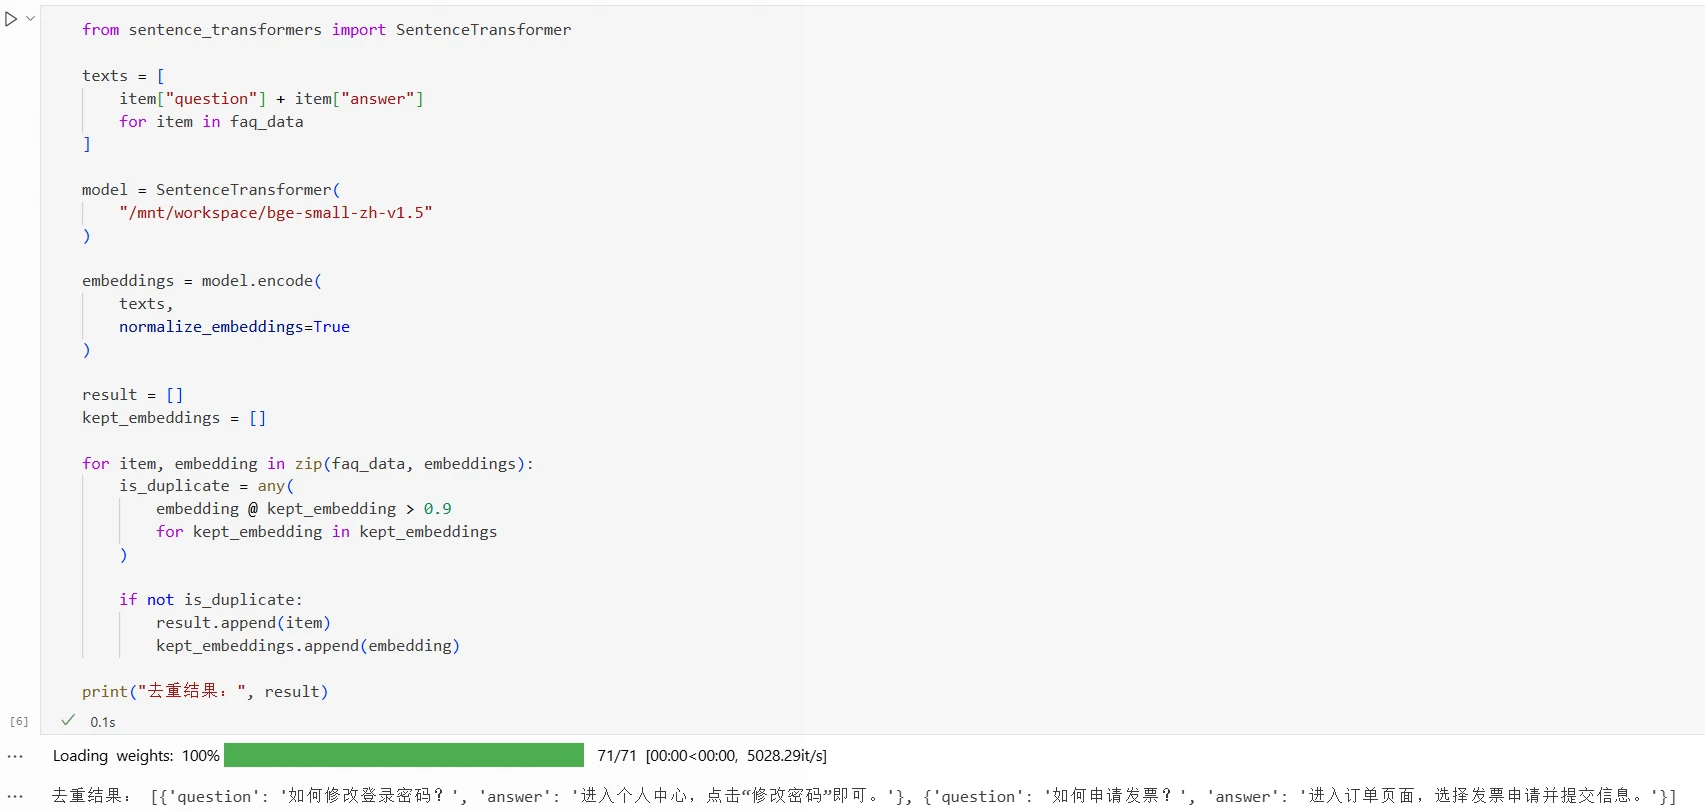
Le code pour calculer la similarité vectorielle et supprimer les données similaires est le suivant :
from sentence_transformers import SentenceTransformer

texts = [
    item["question"] + item["answer"]
    for item in faq_data
]

model = SentenceTransformer(
    "/mnt/workspace/bge-small-zh-v1.5"
)

embeddings = model.encode(
    texts,
    normalize_embeddings=True
)

result = []
kept_embeddings = []

for item, embedding in zip(faq_data, embeddings):
    is_duplicate = any(
        embedding @ kept_embedding > 0.9
        for kept_embedding in kept_embeddings
    )

    if not is_duplicate:
        result.append(item)
        kept_embeddings.append(embedding)

print("Résultat de la déduplication :", result)
Résultat :
Les différentes méthodes sont adaptées à différents types de déduplication de données :
Méthode
Critère de décision
Scénarios adaptés
Correspondance directe de texte
Le texte est strictement identique
Petites quantités de données identiques
Hash
Les valeurs de hachage du texte sont identiques
Grandes quantités de données identiques
MinHash
Degré de chevauchement des mots ou caractères dans le texte
Données au contenu textuel similaire
SimHash
Distance de Hamming entre les empreintes du texte
Données au contenu globalement similaire avec quelques modifications
Similarité vectorielle
Degré de similarité sémantique du texte
Données avec formulations différentes mais sens proches
Dans le traitement réel des données, on peut d'abord supprimer les données strictement identiques par correspondance de texte ou par hash, puis utiliser MinHash, SimHash ou la similarité vectorielle pour détecter les données similaires. Pour les données similaires détectées, il faut décider de les supprimer, fusionner ou conserver en fonction du seuil de similarité et des besoins métier, afin d'éviter la suppression erronée de données ayant de la valeur pour l'entraînement.
Informations réelles, masquées avant l'entraînement
Les données métier peuvent contenir des informations sensibles telles que les noms, numéros de téléphone, numéros d'identification, adresses, comptes, etc. Ces contenus doivent être masqués avant d'intégrer l'ensemble de données d'entraînement, conformément aux exigences de sécurité des données.
Le masquage nécessite d'abord l'identification des informations sensibles dans les données, puis le choix d'un traitement approprié selon le type d'information sensible.
Méthodes d'identification des informations sensibles
Avant de procéder au masquage, il faut d'abord déterminer quel contenu des données constitue une information sensible. Pour les données textuelles, on peut utiliser des expressions régulières ou un modèle d'identification d'informations sensibles.
(1) Utilisation d'expressions régulières
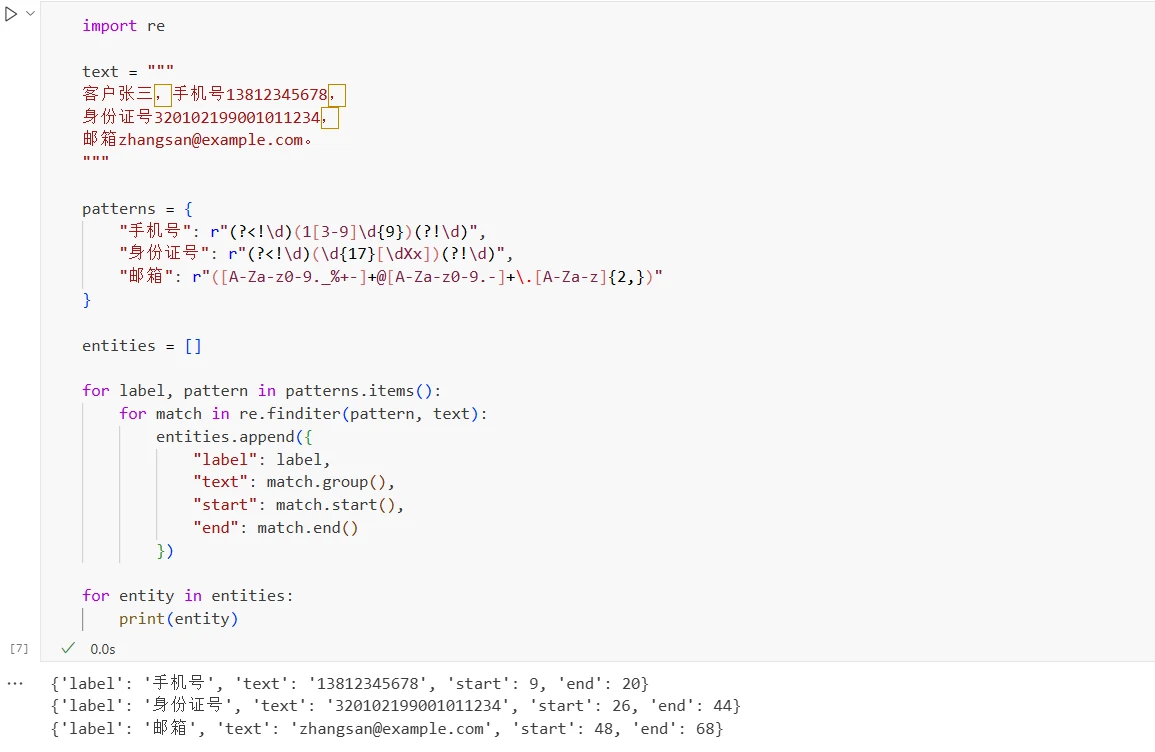
Les expressions régulières correspondent au texte selon des règles de format prédéfinies, adaptées à l'identification d'informations au format fixe, telles que les numéros de téléphone, les numéros d'identité, les numéros de carte bancaire et les adresses e-mail. Le code d'identification des informations sensibles par expressions régulières :
import re

text = """
Client Zhang San, numéro de téléphone 13812345678,
numéro d'identité 320102199001011234,
adresse e-mail zhangsan@example.com.
"""

patterns = {
    "Numéro de téléphone": r"(?<!\d)(1[3-9]\d{9})(?!\d)",
    "Numéro d'identité": r"(?<!\d)(\d{17}[\dXx])(?!\d)",
    "Adresse e-mail": r"([A-Za-z0-9._%+-]+@[A-Za-z0-9.-]+\.[A-Za-z]{2,})"
}

entities = []

for label, pattern in patterns.items():
    for match in re.finditer(pattern, text):
        entities.append({
            "label": label,
            "text": match.group(),
            "start": match.start(),
            "end": match.end()
        })

for entity in entities:
    print(entity)
Résultat d'exécution :
Les expressions régulières permettent d'obtenir le contenu, le type et la position des informations sensibles dans le texte source, ce qui permet de procéder au masquage ultérieur. Les expressions régulières reposent principalement sur les caractéristiques de format et sont efficaces pour les informations à structure fixe. Dans l'utilisation réelle, il faut formuler et tester les règles correspondantes en fonction du format des données métier. Pour les informations comme les noms et adresses nécessitant une compréhension du contexte, il est difficile de les identifier précisément uniquement avec des expressions régulières.
(2) Utilisation d'un modèle d'identification d'informations sensibles
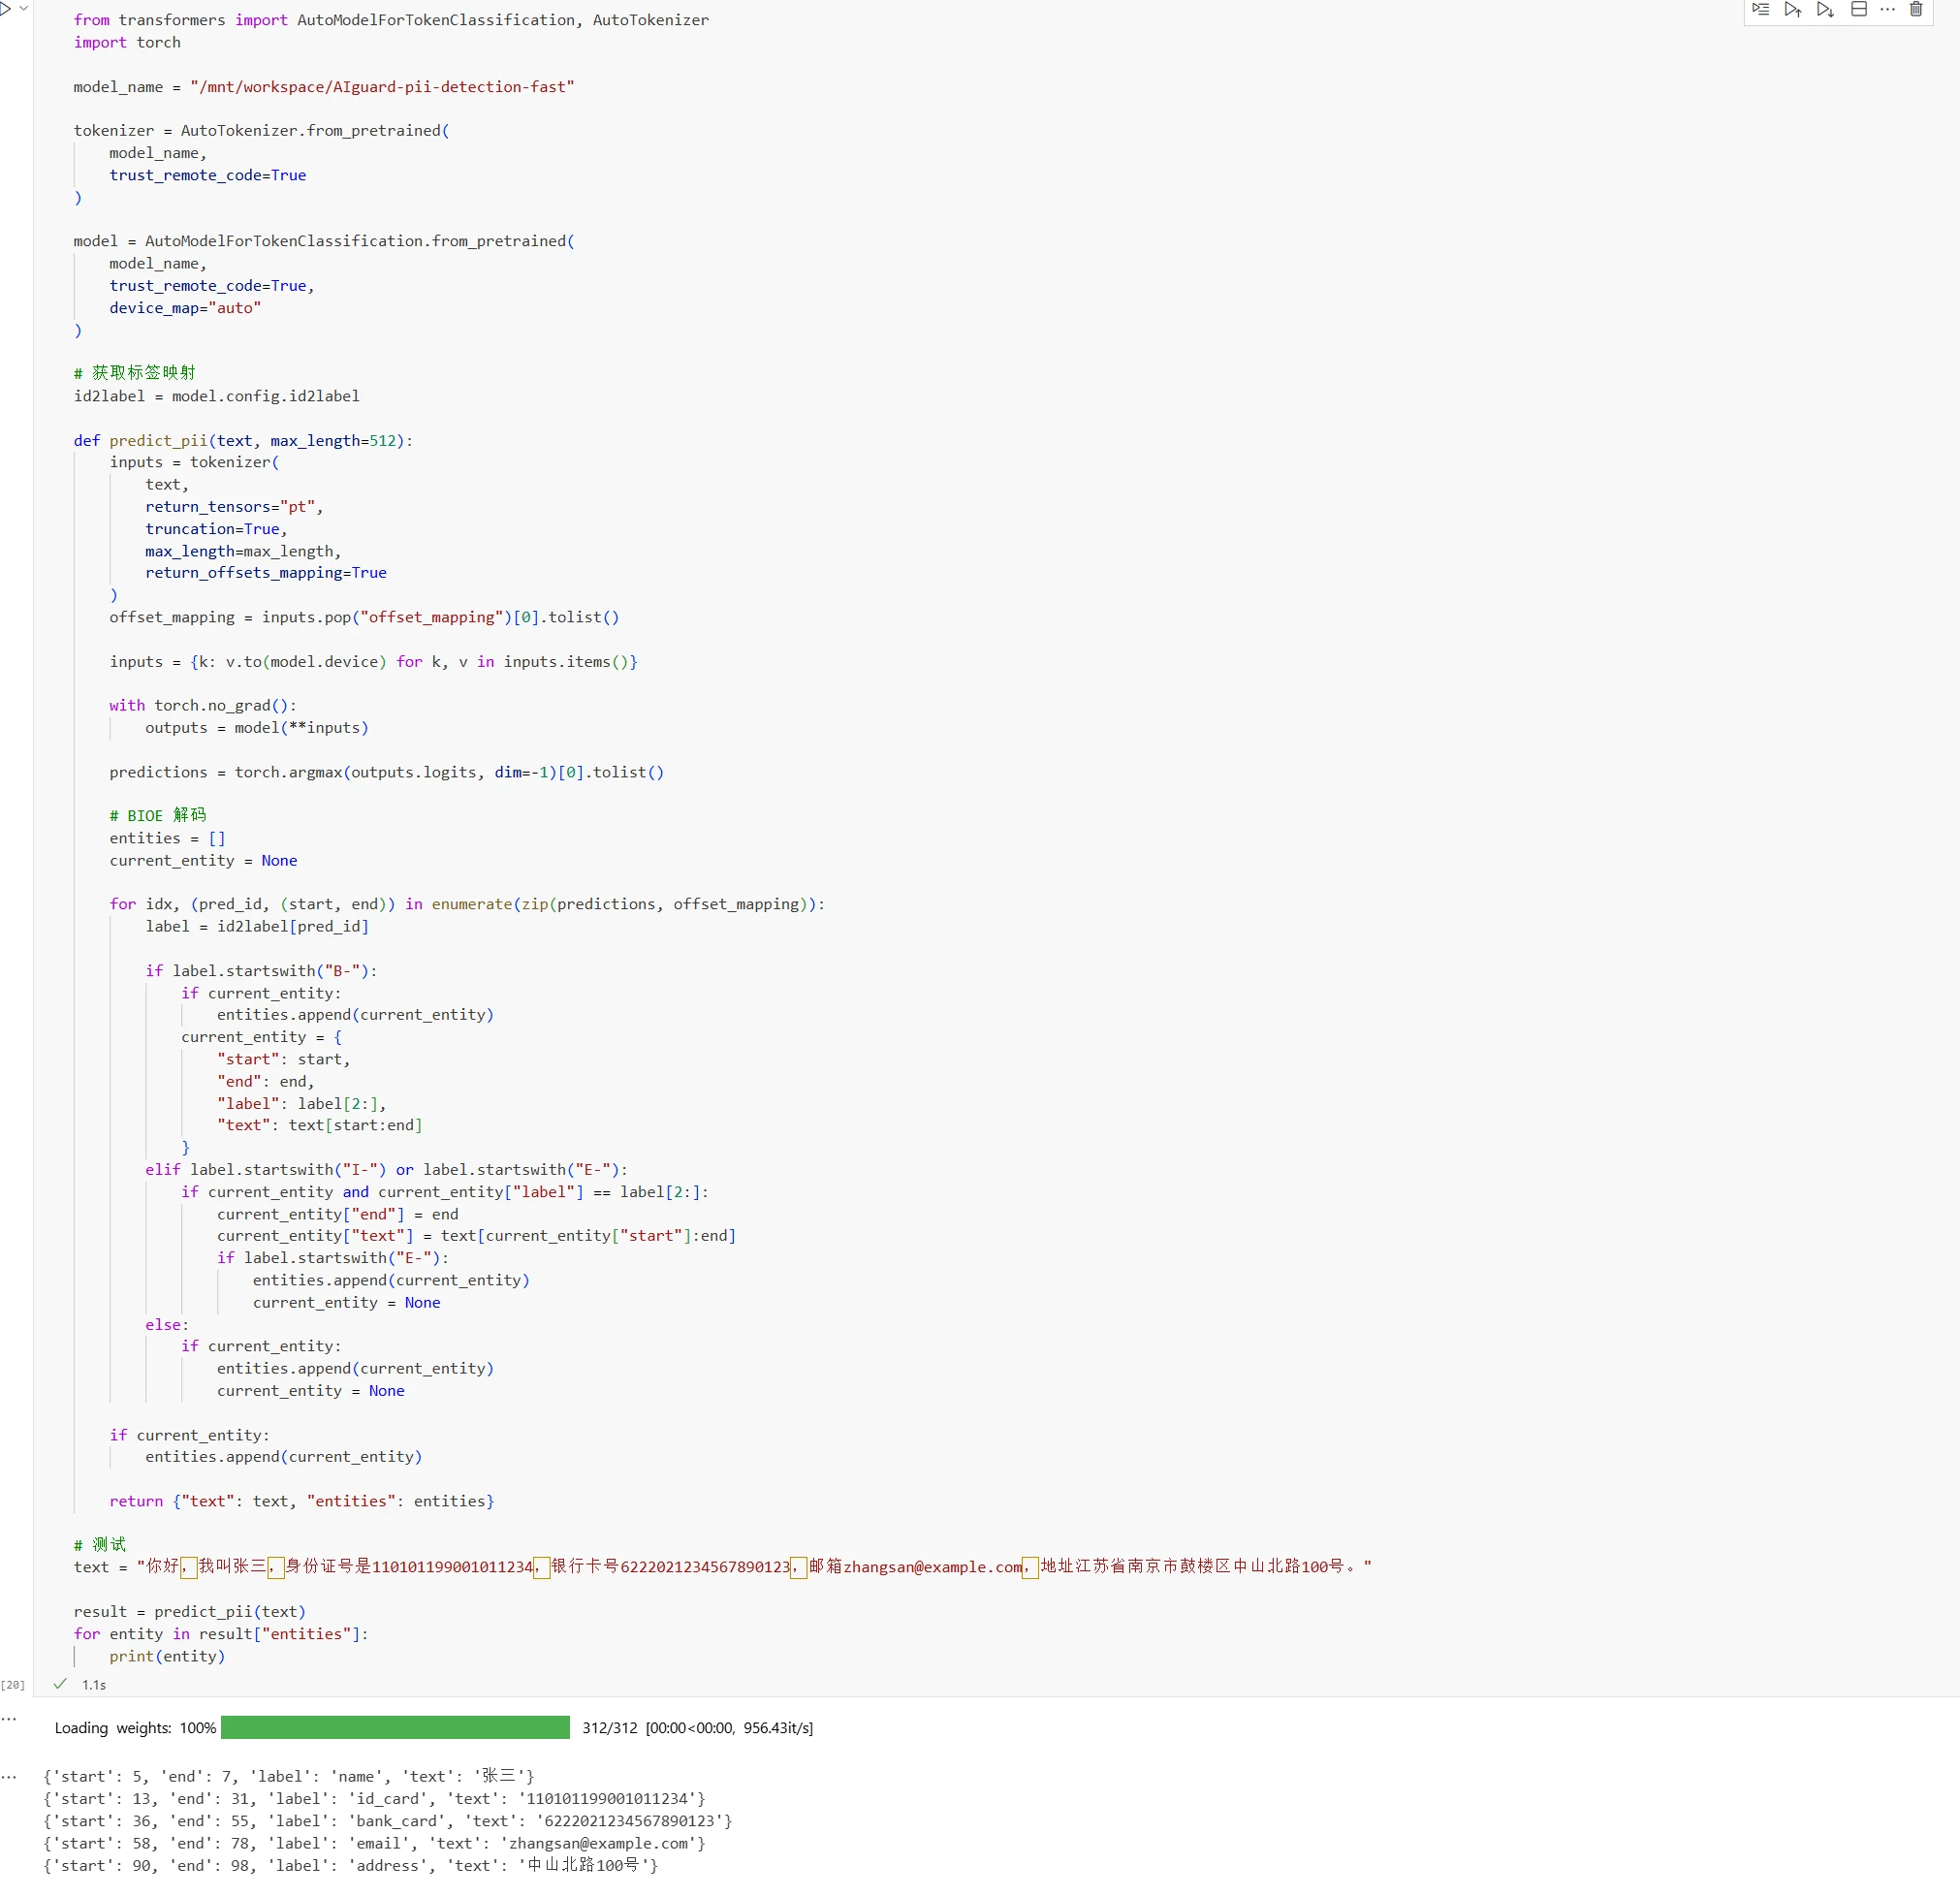
Pour les informations nécessitant une compréhension sémantique, telles que les noms, adresses et organisations, on peut utiliser un modèle d'identification d'informations sensibles.
Par exemple, le modèle open source ZJUICSR/AIguard-pii-detection-fast est un modèle dédié à l'identification des informations personnelles identifiantes (PII) en chinois, capable d'identifier les noms, numéros de téléphone, numéros d'identité, adresses, adresses e-mail et autres informations sensibles.
Le code d'utilisation de ce modèle pour identifier les informations sensibles :
from transformers import AutoModelForTokenClassification, AutoTokenizer
import torch

model_name = "/mnt/workspace/AIguard-pii-detection-fast"

tokenizer = AutoTokenizer.from_pretrained(
    model_name,
    trust_remote_code=True
)

model = AutoModelForTokenClassification.from_pretrained(
    model_name,
    trust_remote_code=True,
    device_map="auto"
)

# Obtenir le mapping des étiquettes
id2label = model.config.id2label

def predict_pii(text, max_length=512):
    inputs = tokenizer(
        text,
        return_tensors="pt",
        truncation=True,
        max_length=max_length,
        return_offsets_mapping=True
    )
    offset_mapping = inputs.pop("offset_mapping")[0].tolist()

    inputs = {k: v.to(model.device) for k, v in inputs.items()}

    with torch.no_grad():
        outputs = model(**inputs)

    predictions = torch.argmax(outputs.logits, dim=-1)[0].tolist()

    # Décodage BIOE
    entities = []
    current_entity = None

    for idx, (pred_id, (start, end) in enumerate(zip(predictions, offset_mapping):
        label = id2label[pred_id]

        if label.startswith("B-"):
            if current_entity:
                entities.append(current_entity)
            current_entity = {
                "start": start,
                "end": end,
                "label": label[2:],
                "text": text[start:end]
            }
        elif label.startswith("I-") or label.startswith("E-"):
            if current_entity and current_entity["label"] == label[2:]:
                current_entity["end"] = end
                current_entity["text"] = text[current_entity["start"]:end]
                if label.startswith("E-"):
                    entities.append(current_entity)
                    current_entity = None
        else:
            if current_entity:
                entities.append(current_entity)
                current_entity = None

    if current_entity:
        entities.append(current_entity)

    return {"text": text, "entities": entities}

# Test
text = "Bonjour, je m'appelle Zhang San, numéro d'identité 110101199001011234, numéro de carte bancaire 6222021234567890123, adresse e-mail zhangsan@example.com, adresse 100 Zhongshan North Road, Gulou District, Nanjing, Jiangsu."

result = predict_pii(text)
for entity in result["entities"]:
    print(entity)
Résultat :
Les résultats d'identification incluent le contenu, le type et la position des informations sensibles. Ces informations permettent de choisir la méthode de masquage correspondante.
Dans la pratique, les expressions régulières et les modèles d'identification d'informations sensibles sont souvent utilisés conjointement. Les expressions régulières sont responsables du traitement rapide des informations au format fixe, comme les numéros de téléphone et les adresses e-mail ; le modèle est responsable du traitement des informations nécessitant une compréhension sémantique, comme les noms et les adresses.
Méthodes de masquage
Après avoir identifié les informations sensibles, il faut choisir le traitement approprié en fonction du type d'information sensible et des exigences de la tâche d'entraînement.
Les méthodes de masquage courantes comprennent :
(1) Remplacement
Le remplacement consiste à remplacer les véritables informations sensibles par d'autres contenus. Le remplacement peut être divisé en remplacement fixe et remplacement aléatoire :
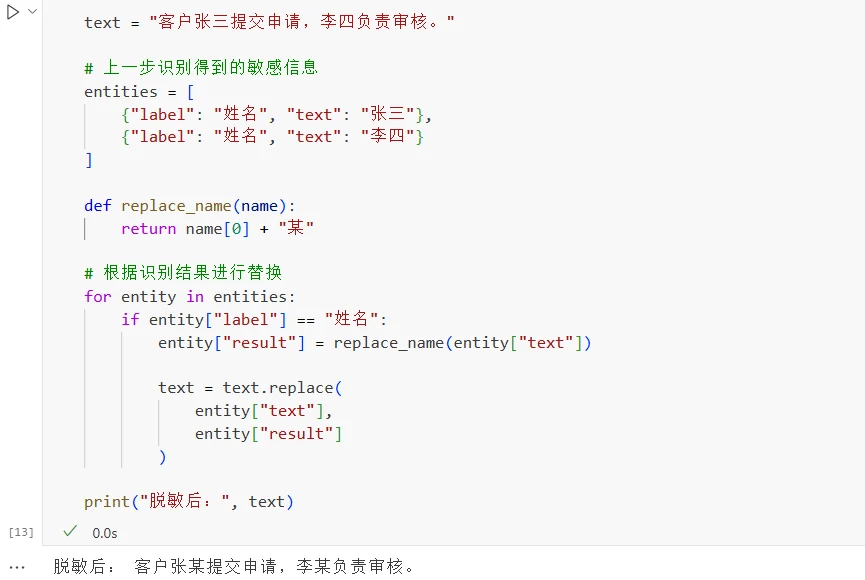
Remplacement fixe : générer le résultat du remplacement selon des règles fixes, par exemple remplacer systématiquement le prénom par « un certain », « Zhang San » par « Zhang un certain », « Li Si » par « Li un certain ». Les règles étant fixes, la même information produira toujours le même résultat à chaque fois, sans besoin de sauvegarder de table de correspondance supplémentaire. Le code de traitement est le suivant :
text = "Le client Zhang San soumet la demande, Li Si est responsable de l'examen."

# Informations sensibles identifiées à l'étape précédente
entities = [
    {"label": "Nom", "text": "Zhang San"},
    {"label": "Nom", "text": "Li Si"}
]

def replace_name(name):
    return name[0] + " un certain"

# Effectuer le remplacement selon les résultats d'identification
for entity in entities:
    if entity["label"] == "Nom":
        entity["result"] = replace_name(entity["text"])

        text = text.replace(
            entity["text"],
            entity["result"]
        )

print("Après masquage :", text)
Résultat :
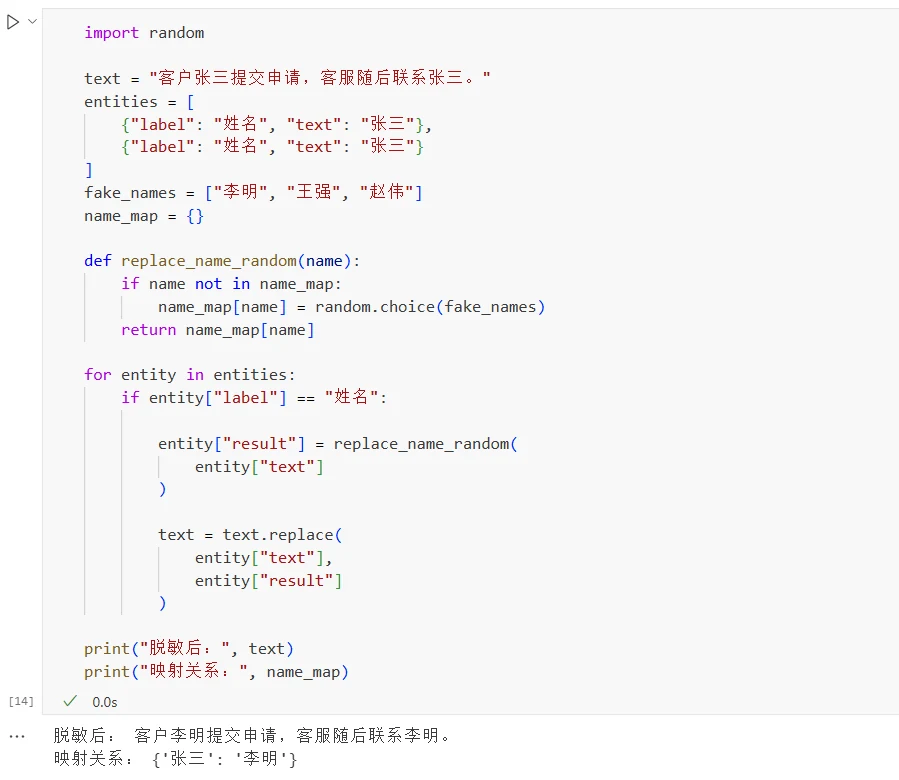
Remplacement aléatoire : sélectionner aléatoirement des informations fictives pour remplacer les informations réelles, par exemple remplacer « Zhang San » par « Li Ming ». Si le même « Zhang San » apparaît à plusieurs endroits, il faut garantir la cohérence du résultat de remplacement, sinon les données appartenant au même objet pourraient être remplacées par des identités différentes, rompant les relations de correspondance dans les données. Par conséquent, le remplacement aléatoire nécessite généralement l'établissement d'une table de correspondance : {"Zhang San":"Li Ming"}, pour que lorsqu'on rencontre à nouveau « Zhang San », on utilise directement « Li Ming ». Le code de traitement est le suivant :
import random

text = "Le client Zhang San soumet la demande, le service client contacte ensuite Zhang San."
entities = [
    {"label": "Nom", "text": "Zhang San"},
    {"label": "Nom", "text": "Zhang San"}
]
fake_names = ["Li Ming", "Wang Qiang", "Zhao Wei"]
name_map = {}

def replace_name_random(name):
    if name not in name_map:
        name_map[name] = random.choice(fake_names)
    return name_map[name]

for entity in entities:
    if entity["label"] == "Nom":

        entity["result"] = replace_name_random(
            entity["text"]
        )

        text = text.replace(
            entity["text"],
            entity["result"]
        )

print("Après masquage :", text)
print("Table de correspondance :", name_map)
Résultat :
(2) Masquage
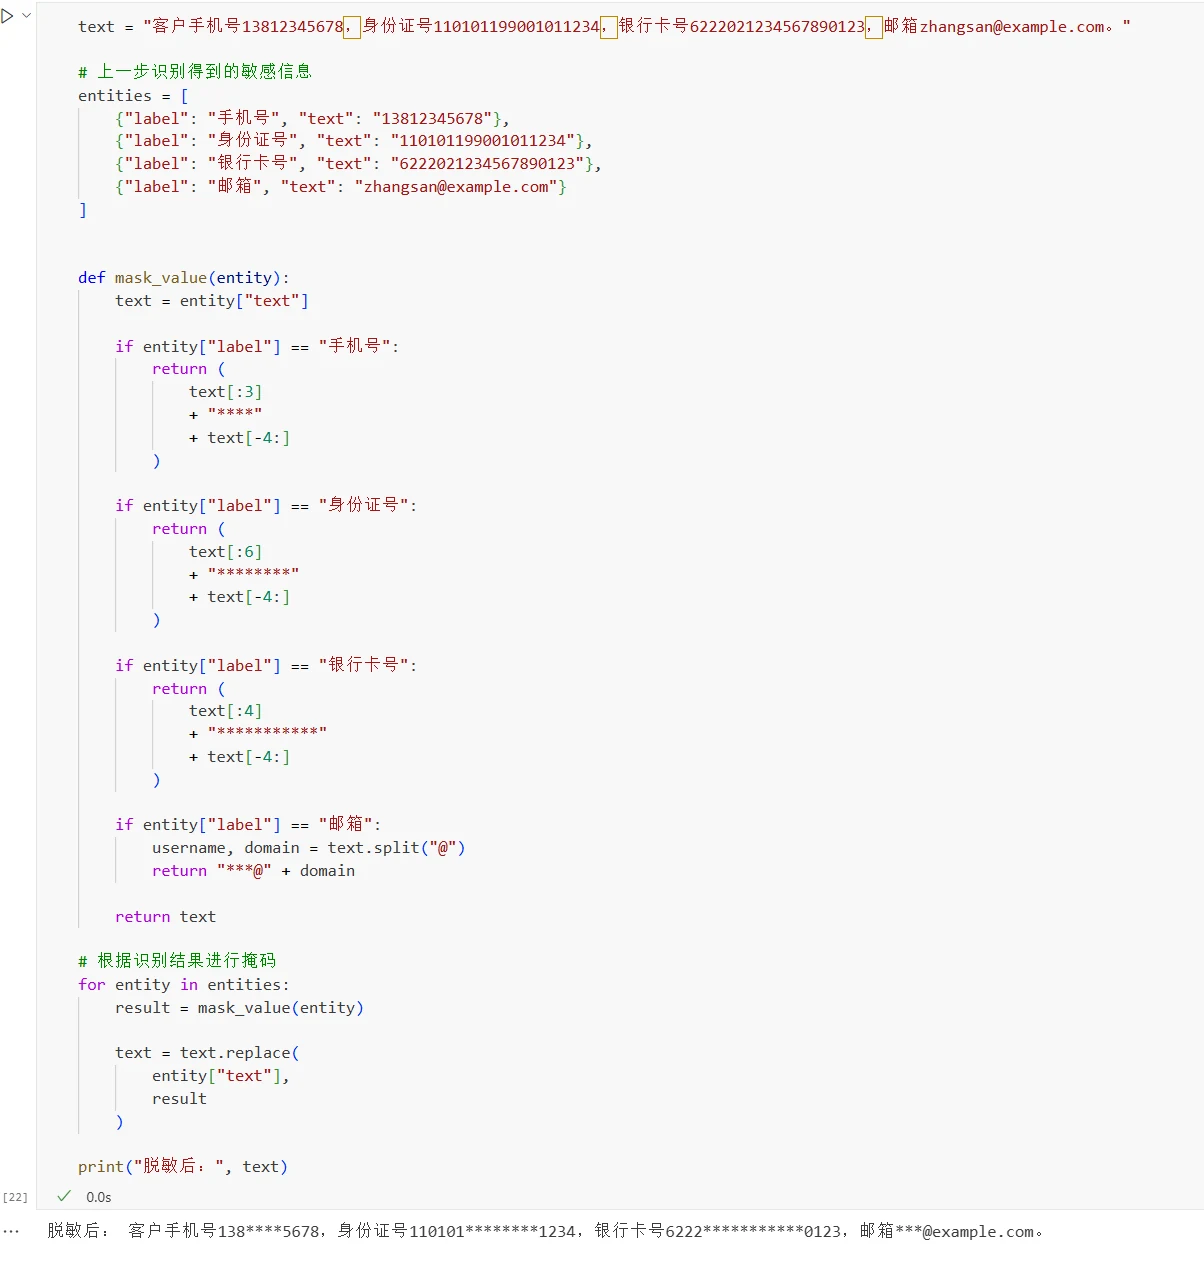
Le masquage consiste à masquer une partie du contenu sensible tout en conservant certaines informations, comme les numéros de téléphone, les pièces d'identité, les cartes bancaires et les adresses e-mail.
Le code de traitement :
text = "Numéro de téléphone du client 13812345678, numéro d'identité 110101199001011234, numéro de carte bancaire 6222021234567890123, adresse e-mail zhangsan@example.com."

# Informations sensibles identifiées à l'étape précédente
entities = [
    {"label": "Numéro de téléphone", "text": "13812345678"},
    {"label": "Numéro d'identité", "text": "110101199001011234"},
    {"label": "Numéro de carte bancaire", "text": "6222021234567890123"},
    {"label": "Adresse e-mail", "text": "zhangsan@example.com"}
]

def mask_value(entity):
    text = entity["text"]

    if entity["label"] == "Numéro de téléphone":
        return (
            text[:3]
            + "****"
            + text[-4:]
        )

    if entity["label"] == "Numéro d'identité":
        return (
            text[:6]
            + "********"
            + text[-4:]
        )

    if entity["label"] == "Numéro de carte bancaire":
        return (
            text[:4]
            + "***********"
            + text[-4:]
        )

    if entity["label"] == "Adresse e-mail":
        username, domain = text.split("@")
        return "***@" + domain

    return text

# Effectuer le masquage selon les résultats d'identification
for entity in entities:
    result = mask_value(entity)

    text = text.replace(
        entity["text"],
        result
    )

print("Après masquage :", text)
Résultat :
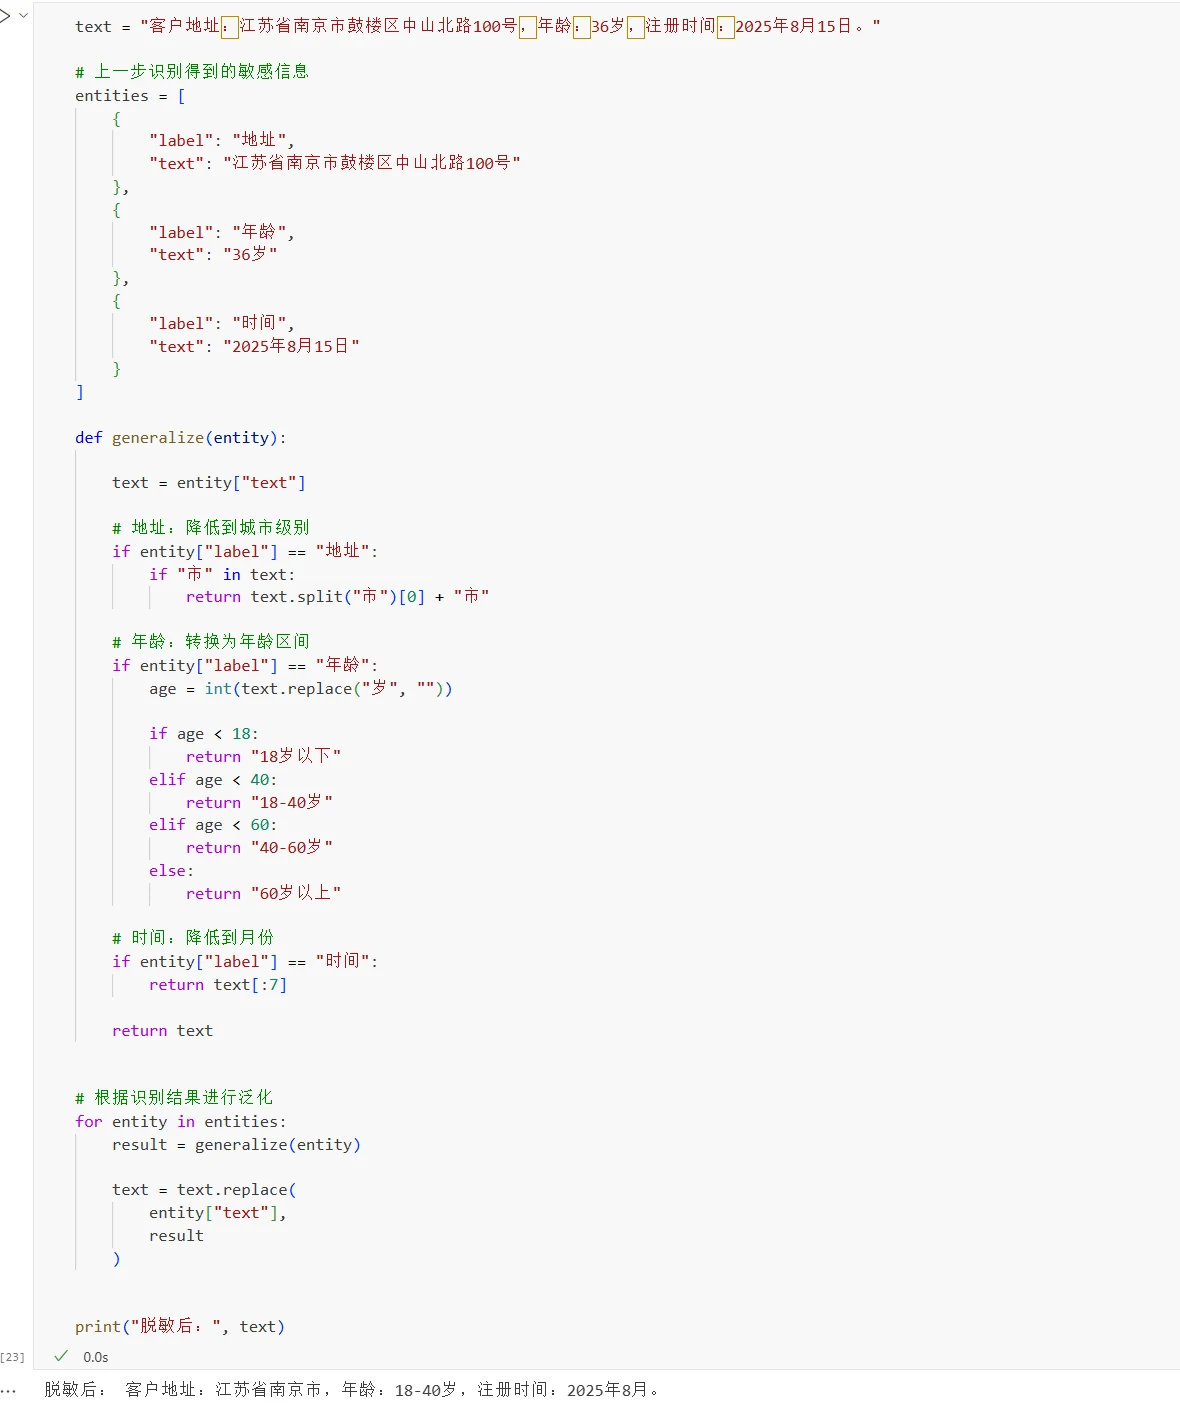
(3) Généralisation
La généralisation consiste à réduire la précision des informations, diminuant la capacité des données à identifier un objet spécifique. Elle est couramment utilisée pour les informations continues telles que les adresses, les âges et les heures.
Le code de traitement :
text = "Adresse du client : 100 Zhongshan North Road, Gulou District, Nanjing, Jiangsu, âge : 36 ans, date d'inscription : 15 août 2025."

# Informations sensibles identifiées à l'étape précédente
entities = [
    {
        "label": "Adresse",
        "text": "100 Zhongshan North Road, Gulou District, Nanjing, Jiangsu"
    },
    {
        "label": "Âge",
        "text": "36 ans"
    },
    {
        "label": "Heure",
        "text": "15 août 2025"
    }
]

def generalize(entity):

    text = entity["text"]

    # Adresse : réduire au niveau ville
    if entity["label"] == "Adresse":
        if "ville" in text.lower():
            return text.split("ville")[0] + "ville"

    # Âge : convertir en tranche d'âge
    if entity["label"] == "Âge":
        age = int(text.replace(" ans", ""))

        if age < 18:
            return "Moins de 18 ans"
        elif age < 40:
            return "18-40 ans"
        elif age < 60:
            return "40-60 ans"
        else:
            return "Plus de 60 ans"

    # Heure : réduire au mois
    if entity["label"] == "Heure":
        return text[:7]

    return text

# Effectuer la généralisation selon les résultats d'identification
for entity in entities:
    result = generalize(entity)

    text = text.replace(
        entity["text"],
        result
    )

print("Après masquage :", text)
Résultat :
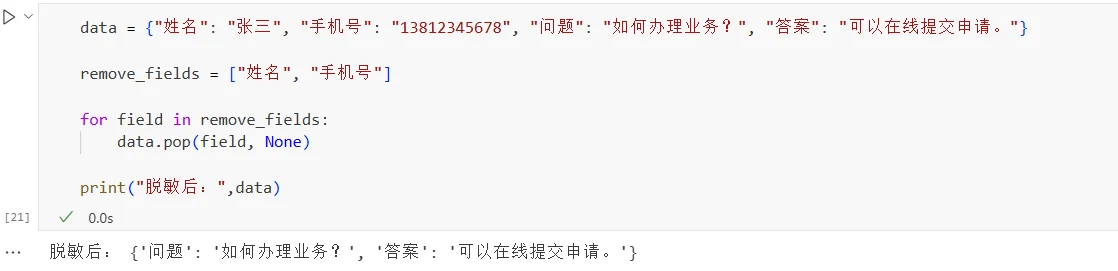
(4) Suppression
Pour les champs sensibles non pertinents pour la tâche d'entraînement, on peut les supprimer directement. Si la tâche d'entraînement ne nécessite que d'apprendre la relation question-réponse, on peut supprimer les noms et numéros de téléphone.
data = {"Nom": "Zhang San", "Numéro de téléphone": "13812345678", "Question": "Comment traiter une demande ?", "Réponse": "Vous pouvez soumettre la demande en ligne."}

remove_fields = ["Nom", "Numéro de téléphone"]

for field in remove_fields:
    data.pop(field, None)

print("Après masquage :",data)
Résultat :
Dans le traitement réel, le choix de la méthode de masquage dépend de la tâche d'entraînement et des caractéristiques des données. Pour conserver les relations de correspondance entre les différents échantillons, on peut utiliser un remplacement fixe ou un remplacement aléatoire avec table de correspondance. Pour conserver certaines caractéristiques d'information, on peut utiliser le masquage ou la généralisation. Pour les informations sensibles non pertinentes pour la tâche d'entraînement, on les supprime directement.
Les caractéristiques des données varient selon les scénarios métier, et les règles de masquage spécifiques doivent être ajustées en fonction des besoins réels. Le code de cette section sert uniquement à illustrer les méthodes de traitement de base.
Dernière étape, organiser au format requis pour l'entraînement
Après avoir terminé le traitement des données, il faut encore les organiser au format requis par le cadre d'entraînement.
Le fine-tuning d'instructions (Instruction Tuning) est une méthode de fine-tuning couramment utilisée pour les grands modèles de langage. Les données d'entraînement comprennent les instructions de l'utilisateur et les réponses attendues du modèle, permettant au modèle d'apprendre comment accomplir des tâches selon les instructions.
Les cadres d'entraînement différents peuvent utiliser des champs de données différents. Les formats de données d'instructions courants incluent principalement Alpaca, ShareGPT et Messages.
Format Alpaca
Le format Alpaca est simple en structure, utilisant généralement trois champs : instruction, input et output, adapté aux données d'instructions en un seul tour.
{
  "instruction": "Traduire le texte suivant du chinois en anglais",
  "input": "Il fait beau aujourd'hui.",
  "output": "The weather is very nice today."
}
où instruction représente la tâche à accomplir par le modèle ; input représente le contenu d'entrée nécessaire pour accomplir la tâche ; output représente la réponse attendue du modèle.
Si la tâche elle-même ne nécessite pas d'entrée supplémentaire, input peut être vide.
Par exemple :
{
  "instruction": "Présentez ce qu'est l'apprentissage automatique",
  "input": "",
  "output": "L'apprentissage automatique est une méthode qui permet aux ordinateurs d'apprendre des modèles à partir de données."
}
Ce format comporte peu de champs et une structure claire, adapté aux tâches d'entraînement en un seul tour telles que les questions-réponses, la classification et la génération de texte.
Format Messages
Un autre format courant utilise messages pour sauvegarder les conversations, chaque message contenant deux champs principaux : role et content.
Par exemple :
{
  "messages": [
    {
      "role": "system",
      "content": "Vous êtes un assistant de service client professionnel."
    },
    {
      "role": "user",
      "content": "Quand arrivera ma commande ?"
    },
    {
      "role": "assistant",
      "content": "Veuillez fournir le numéro de commande, je vais rechercher pour vous."
    }
  ]
}
où system sert à configurer le rôle du modèle, les exigences de la tâche ou les règles de réponse, user représente l'entrée de l'utilisateur, et assistant représente la réponse attendue du modèle.
Le format Messages prend également en charge les conversations multi-tours ; il suffit d'ajouter des messages user et assistant dans l'ordre réel de la conversation.
Par exemple :
{
  "messages": [
    {
      "role": "system",
      "content": "Vous êtes un assistant de service client professionnel."
    },
    {
      "role": "user",
      "content": "Comment modifier le mot de passe de connexion ?"
    },
    {
      "role": "assistant",
      "content": "Accédez à la page de paramètres du compte et sélectionnez « Modifier le mot de passe »."
    },
    {
      "role": "user",
      "content": "Que faire si j'ai oublié l'ancien mot de passe ?"
    },
    {
      "role": "assistant",
      "content": "Vous pouvez sélectionner « Mot de passe oublié » sur la page de connexion, compléter la vérification par numéro de téléphone ou adresse e-mail, puis réinitialiser le mot de passe."
    }
  ]
}
Format ShareGPT
ShareGPT est l'un des formats de données de conversation couramment utilisés dans l'entraînement de modèles open source. Il utilise généralement conversations pour sauvegarder les conversations complètes, et distingue l'utilisateur et le modèle à l'aide de human et gpt.
Par exemple :
{
  "conversations": [
    {
      "from": "human",
      "value": "Traduire le texte suivant du chinois en anglais : Il fait beau aujourd'hui."
    },
    {
      "from": "gpt",
      "value": "The weather is very nice today."
    }
  ]
}
Le format ShareGPT peut également sauvegarder les conversations multi-tours :
{
  "conversations": [
    {
      "from": "human",
      "value": "Aidez-moi à rédiger un e-mail de demande d'absence."
    },
    {
      "from": "gpt",
      "value": "Veuillez me communiquer la durée et le motif de votre absence."
    },
    {
      "from": "human",
      "value": "Je suis malade, je demande deux jours de congé maladie."
    },
    {
      "from": "gpt",
      "value": "D'accord, voici un e-mail de demande d'absence..."
    }
  ]
}
Comment choisir le format de données
Les formats Alpaca, Messages et ShareGPT décrivent tous l'entrée et la sortie attendue du modèle, ne différant que par l'organisation des champs.
Le choix peut se faire en fonction du type de tâche et du cadre d'entraînement :
Format de données
Caractéristiques principales
Scénarios adaptés
Alpaca
Utilise instruction, input et output pour organiser les données
Instructions en un seul tour, questions-réponses, classification
Messages
Utilise messages pour sauvegarder les conversations, distingue les rôles par role
Conversations en un ou plusieurs tours
ShareGPT
Utilise conversations pour sauvegarder les conversations, distingue les rôles par from
Conversations en un ou plusieurs tours
Les formats différents peuvent généralement être convertis entre eux. Par exemple, une donnée Alpaca peut être convertie en un ensemble de messages user et assistant, et human et gpt dans ShareGPT peuvent être respectivement convertis en user et assistant. Lors de l'entraînement réel, il faut d'abord confirmer le format de données et le template de modèle supportés par le cadre d'entraînement, puis organiser les données en conséquence.
Code et fichiers du modèle : https://www.modelscope.cn/gallery/liucong/b41e2395-f795-400f-bafd-e53ed7f5c8ca