Les grands modèles généralistes possèdent de fortes capacités de questions-réponses, mais dans les applications réelles d'entreprise, de nombreuses questions concernent les documents internes de l'entreprise, tels que les fiches produits, la documentation technique, les règles commerciales et les manuels d'opérations. Ces connaissances ne sont généralement pas incluses dans les données d'entraînement du modèle et continuent d'évoluer avec l'activité.
RAG (Retrieval-Augmented Generation, génération augmentée par la recherche) propose une solution : avant de répondre à une question, le modèle récupère d'abord le contenu pertinent dans la base de connaissances de l'entreprise, puis utilise ces résultats pour générer une réponse.
Le principe fondamental de RAG peut se résumer ainsi : chercher d'abord, puis répondre. Les systèmes traditionnels de Q&R reposent principalement sur les connaissances déjà apprises dans les paramètres du modèle. Par exemple, lorsqu'un utilisateur pose une question, le modèle génère directement une réponse en se basant sur les informations acquises pendant l'entraînement. RAG ajoute une étape de récupération de connaissances à ce processus. Lorsqu'un utilisateur pose une question, le système recherche d'abord le contenu pertinent dans une base de connaissances externe, puis envoie la question de l'utilisateur et les connaissances récupérées au grand modèle, qui génère la réponse finale en combinant ces informations.
Un flux RAG de base peut être représenté ainsi : question de l'utilisateur → récupération de connaissances → obtention du contenu pertinent → génération de la réponse par le LLM → retour du résultat. RAG ne demande pas au modèle de réapprendre ces connaissances, mais fournit temporairement au modèle les références nécessaires pour répondre à la question en cours.
RAG n'est pas obligatoire pour toutes les applications de grands modèles, mais il est très courant pour les scénarios tels que les Q&R d'entreprise, les services clients intelligents et les assistants documentaires.
Si les connaissances métier doivent être mises à jour en continu, RAG est généralement adapté. Par exemple, les descriptions de produits, les règles commerciales et les normes opérationnelles d'une entreprise peuvent être constamment ajustées. Si ces connaissances sont intégrées au modèle par l'entraînement, chaque mise à jour nécessiterait un réentraînement complet, ce qui est coûteux et difficile à maintenir.
RAG permet de mettre à jour directement la base de connaissances externe. Lorsque les documents changent, il suffit de retraiter les documents concernés et de mettre à jour l'index, sans avoir à réentraîner l'ensemble du grand modèle. Si les réponses doivent fournir des sources, RAG est également adapté. Puisque les réponses sont générées à partir des documents récupérés, on peut simultanément renvoyer le nom du document, le chapitre, le numéro de page ou des extraits du texte original, permettant à l'utilisateur de savoir d'où provient la réponse.
Se connecter pour rejoindre la discussion
RAG et l'affinement du modèle peuvent tous deux améliorer les performances des grands modèles dans les activités réelles, mais ils abordent les problèmes différemment. RAG résout principalement le problème du « manque de connaissances pertinentes dans le modèle », tandis que l'affinement du modèle résout le problème de « l'incapacité du modèle à accomplir les tâches conformément aux exigences ».
RAG ne modifie pas les paramètres du modèle lui-même. Avant de répondre à une question, il récupère d'abord le contenu pertinent dans une base de connaissances externe, puis fournit ces informations au modèle comme base de réponse.
L'affinement du modèle fonctionne différemment. L'affinement nécessite d'utiliser des données d'entraînement spécifiques pour entraîner davantage le modèle, en ajustant ses paramètres au cours de l'entraînement pour qu'il apprenne progressivement à traiter des tâches spécifiques. Par exemple, la tâche de reconnaissance d'entités mentionnée au chapitre 9 nécessite que le modèle produise des réponses dans un format fixe. Lorsque les exigences de la tâche changent de manière significative, il est généralement nécessaire de préparer de nouvelles données d'entraînement et de procéder à un nouvel affinement.
Dans les applications pratiques, on peut choisir différentes méthodes selon le problème à résoudre : pour compléter ou mettre à jour les connaissances, RAG est plus adapté ; pour ajuster les capacités du modèle, le format de sortie ou la manière de se comporter, l'affinement du modèle est plus adapté. RAG et l'affinement du modèle peuvent être combinés. Par exemple, on peut affiner le modèle pour qu'il maîtrise les capacités de Q&R ou de suivi d'instructions, puis utiliser RAG pour lui fournir des connaissances dans un domaine spécifique, permettant ainsi au modèle d'accomplir les tâches selon les exigences métier tout en générant des réponses basées sur les connaissances les plus récentes du domaine.
Un système RAG complet peut généralement être divisé en deux phases principales : la construction de la base de connaissances et la Q&R en ligne. La construction de la base de connaissances consiste à traiter les documents sources tels que PDF, Word, Markdown et pages web pour les transformer en connaissances récupérables. La Q&R en ligne consiste à rechercher le contenu pertinent dans la base de connaissances établie après qu'un utilisateur a posé une question. Cette expérimentation utilise le « Règlement d'application de la loi sur la sécurité routière de la République populaire de Chine » public disponible en ligne comme source de la base documentaire pour construire un système RAG de Q&R sur la sécurité routière.
Les connaissances d'entreprise sont généralement réparties dans différents types de fichiers tels que PDF, Word, Excel, Markdown et pages web. Comme les formats et structures internes de ces fichiers varient considérablement, avant de construire une base de connaissances RAG, il est généralement nécessaire de convertir ces documents en texte unifié et traitable ou en données structurées. Ce processus est appelé analyse de documents. Pour un système RAG, un bon outil d'analyse de documents ne doit pas seulement reconnaître le texte, mais aussi identifier et préserver autant que possible les informations structurelles du document original, telles que : titres, paragraphes, tableaux, images, formules, etc.
Il existe aujourd'hui de nombreux outils open source pour l'analyse de documents, parmi lesquels les plus courants incluent :
1) MinerU est un outil d'analyse open source pour les documents complexes, capable de convertir des PDF, images, Word, PPT, Excel et autres documents en formats lisibles par les machines tels que Markdown et JSON. Il peut identifier les titres, le texte principal, les tableaux, les images, les formules, etc., et reconstituer la structure du document dans l'ordre de lecture humain autant que possible, ce qui le rend adapté comme outil de prétraitement des documents dans un système RAG. opendatalab/MinerU
2) MonkeyOCR est un projet d'analyse de documents basé sur des modèles multimodaux, qui analyse les documents par reconnaissance structurelle, reconnaissance de contenu et modélisation des relations. Il peut traiter du texte, des tableaux, des formules et autres contenus complexes, et prend en charge les documents en chinois et en anglais. Pour les PDF avec des mises en page complexes où les outils traditionnels d'extraction de texte ne donnent pas de bons résultats, on peut envisager d'utiliser des méthodes d'analyse basées sur des modèles visuels. Yuliang-Liu/MonkeyOCR
3) Dolphin est un modèle d'analyse d'images de documents open source de ByteDance, qui traite les documents en « analysant d'abord, puis interprétant ». Il peut d'abord identifier la mise en page et l'ordre de lecture, puis analyser les différents éléments du document tels que texte, tableaux, formules et code. Il convient au traitement de PDF avec des mises en page complexes ou de documents scannés. ByteDance/Dolphin
4) PaddleOCR est un outil OCR et d'analyse de documents open source de PaddlePaddle. En plus de la reconnaissance de texte courante, il offre des capacités d'analyse de mise en page, de reconnaissance de tableaux et d'analyse structurée de documents, permettant de convertir le contenu des PDF et des images en données structurées plus adaptées au traitement par des systèmes d'IA ultérieurs. Pour les PDF scannés, les documents image et les documents contenant une grande quantité de texte en chinois, PaddleOCR est un choix courant. PaddlePaddle/PaddleOCR
Les différents outils d'analyse de documents ont chacun leurs caractéristiques et il n'existe pas un outil unique adapté à tous les documents. Lors de la construction d'un système RAG en pratique, on peut choisir l'outil d'analyse approprié en fonction du type de document, de la complexité de la mise en page, du taux de précision de l'analyse et des coûts de déploiement.
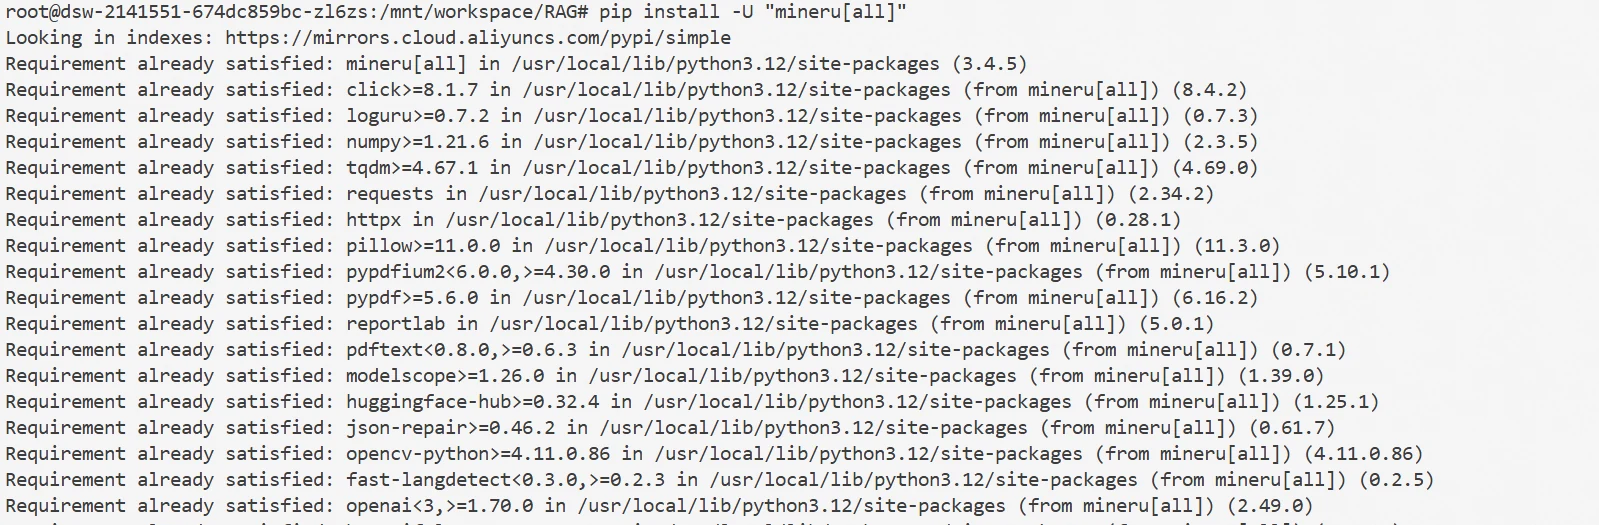
Cette expérimentation utilise MinerU pour l'analyse des documents. Installer d'abord MinerU dans l'environnement Notebook de ModelScope, en exécutant la commande suivante :
pip install -U "mineru[all]"
Après l'installation, on peut analyser directement les documents en indiquant le chemin du fichier à analyser, en exécutant la commande suivante :
mineru -p /mnt/workspace/RAG/data -o /mnt/workspace/RAG/output
Où -p est le chemin du fichier d'entrée et -o est le chemin du fichier de sortie du modèle, c'est-à-dire le texte analysé.
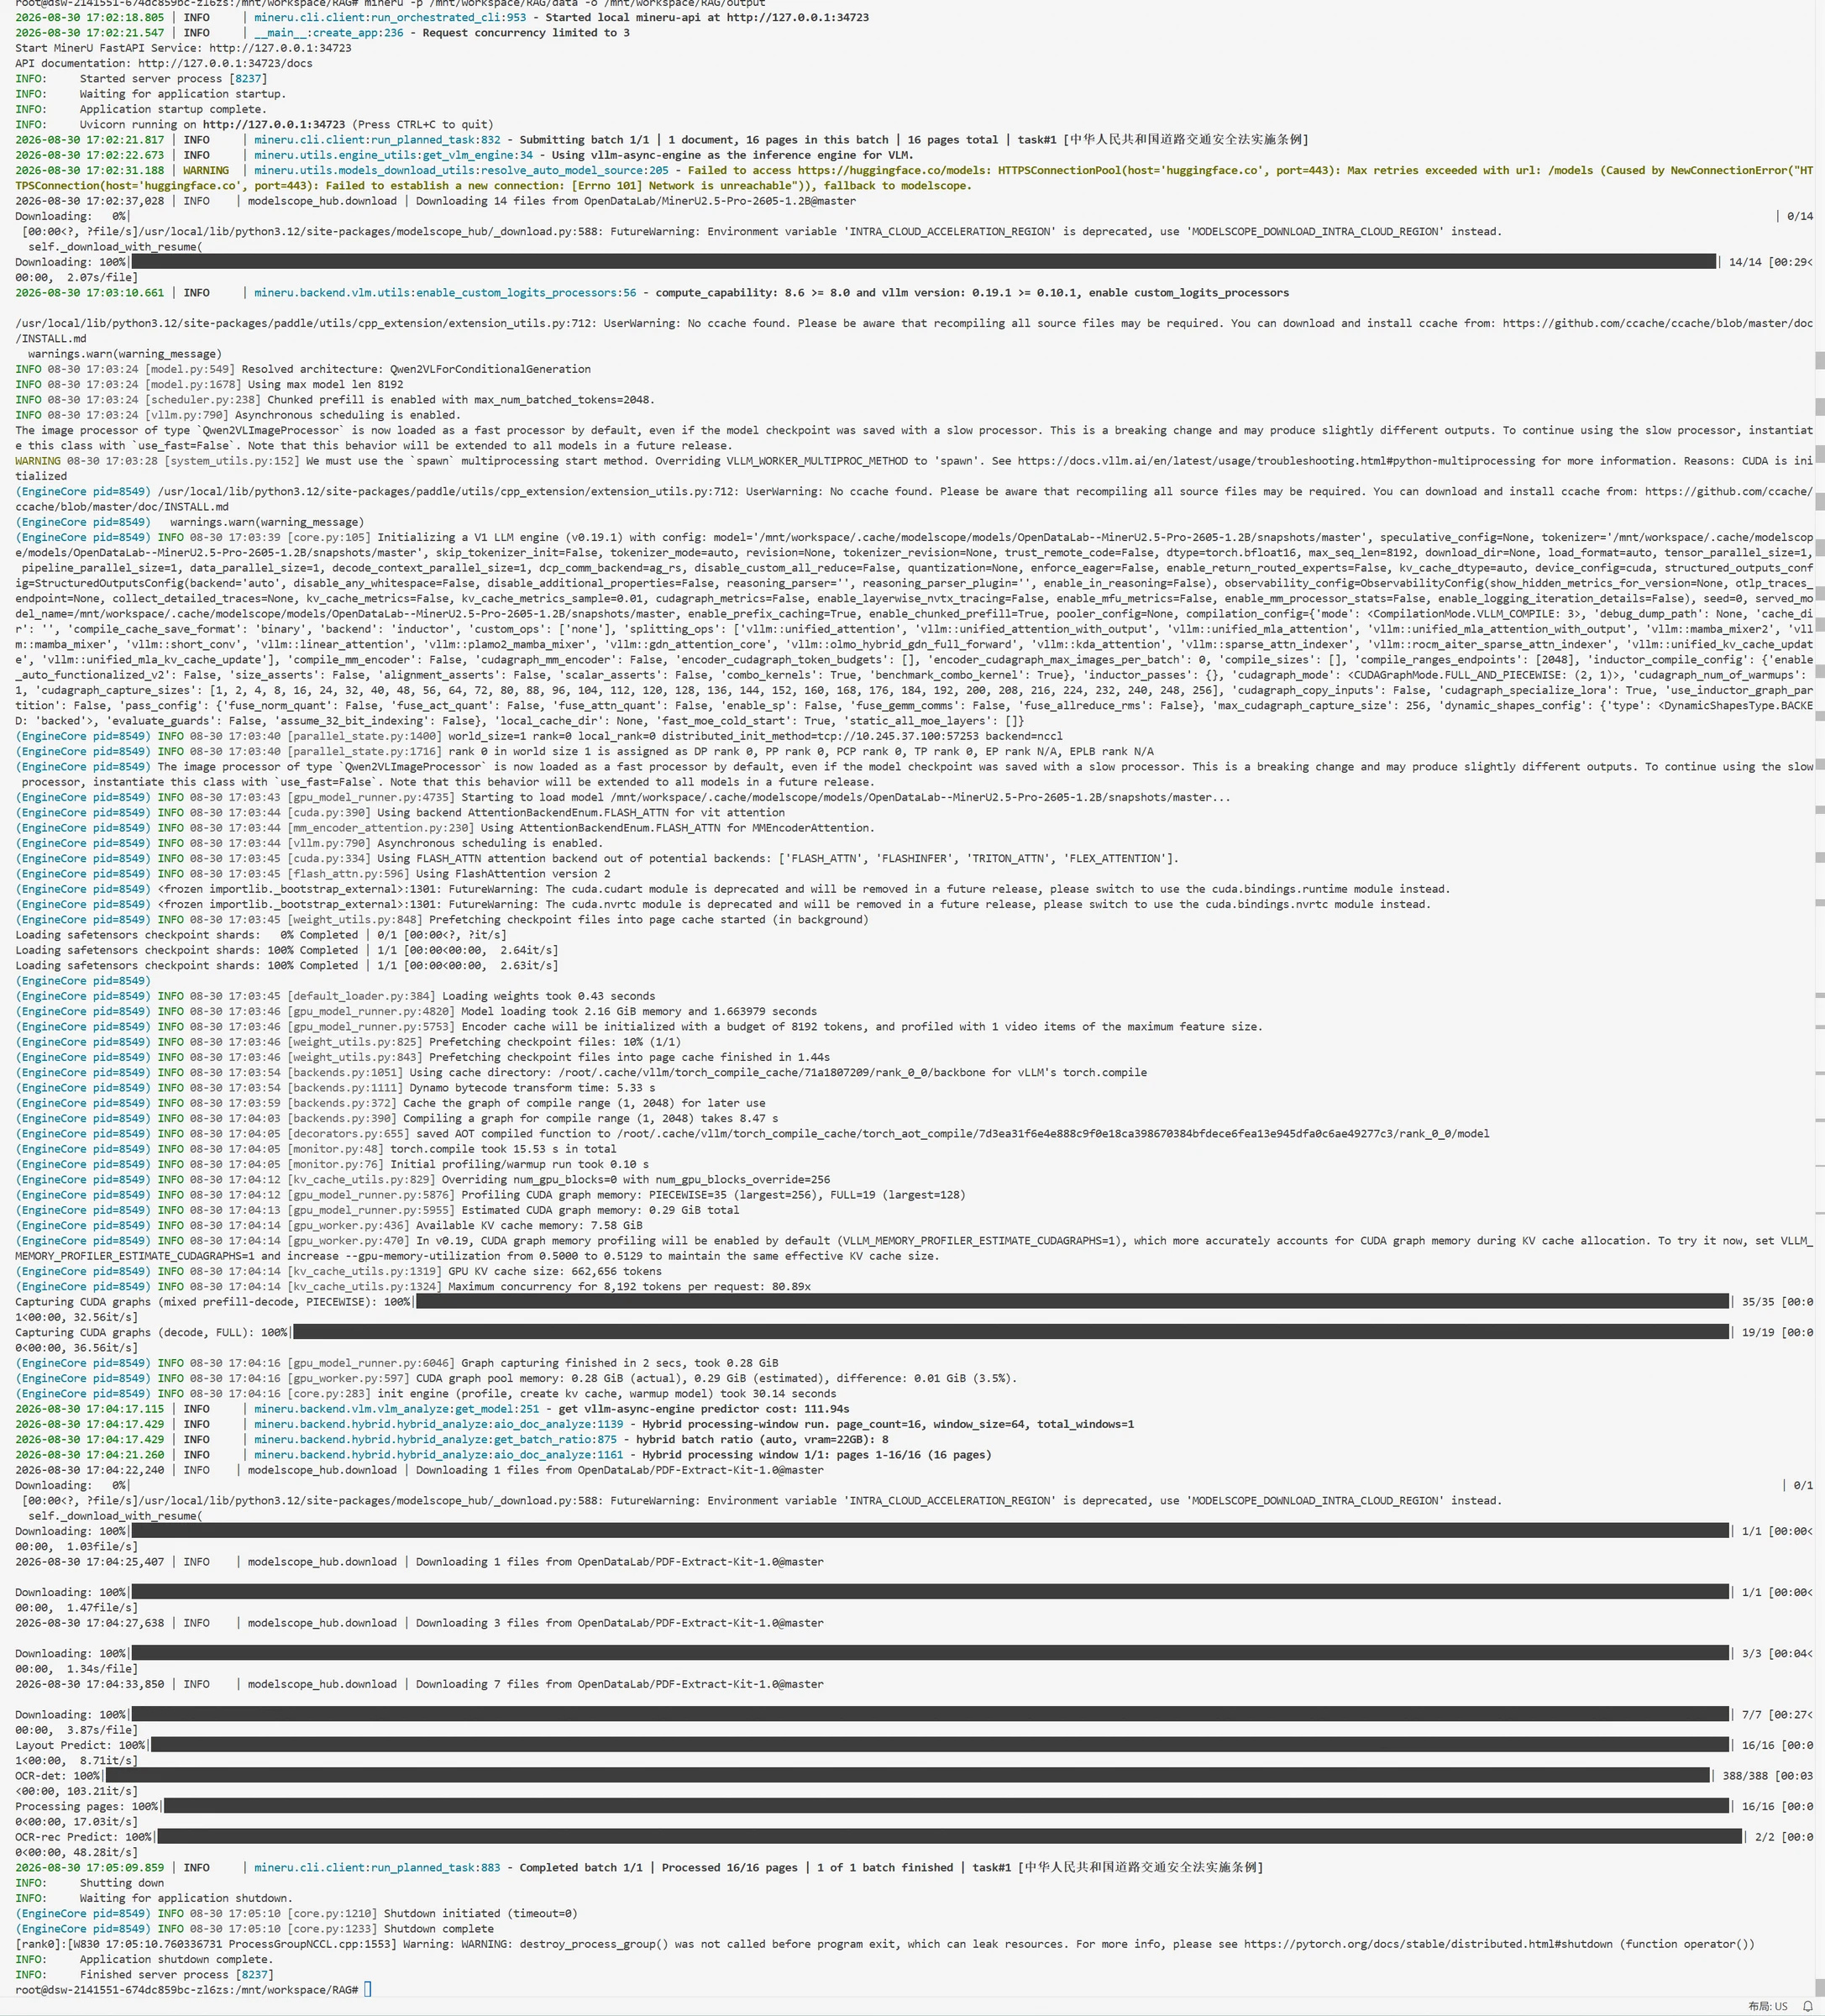
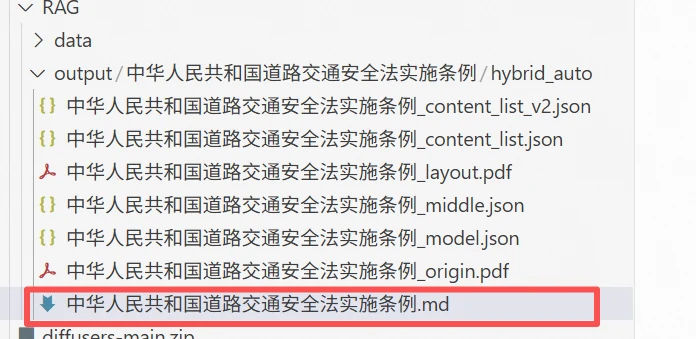
Les fichiers analysés sont présentés ci-dessous, contenant de nombreux fichiers intermédiaires parmi lesquels on peut choisir selon les besoins. Pour cette expérimentation, nous avons choisi le fichier md comme source documentaire, qui contient les informations de format de paragraphes du texte.
Après l'analyse du document, il faut diviser les documents longs en plusieurs segments de texte plus petits, appelés communément Chunks. Dans un système RAG, l'Embedding et la recherche utilisent généralement le Chunk comme unité de base, raison pour laquelle un découpage documentaire raisonnable aide à améliorer la précision de la recherche ultérieure.
Pour les documents Markdown analysés, on peut d'abord diviser le contenu en paragraphes selon les lignes vides, puis fusionner les paragraphes adjacents selon le chunk_size défini. Lorsque le contenu dépasse la longueur spécifiée, un nouveau Chunk est généré.
Pour éviter la perte d'informations contextuelles au niveau des coupures, on peut également configurer le chunk_overlap pour conserver un petit contenu dupliqué entre les Chunks adjacents. Par exemple : chunk_size = 500, chunk_overlap = 50, ce qui signifie que chaque Chunk est d'environ 500 caractères et que les Chunks adjacents conservent environ 50 caractères de chevauchement. Après le découpage, on peut enregistrer les informations telles que id, content et file pour chaque Chunk, afin de faciliter la vectorisation, la recherche et la localisation des sources de réponse ultérieures.
Voici le code pour découper les chunks :
import os
import json
def load_markdown(file_path):
    with open(file_path, "r", encoding="utf-8") as f:
        return f.read()

def split_markdown(text, chunk_size=500, chunk_overlap=50):
    """
    Découper le texte Markdown en plusieurs Chunks
    chunk_size: nombre approximatif de caractères par Chunk
    chunk_overlap: nombre de caractères dupliqués entre Chunks adjacents
    """
    paragraphs = text.split("\n\n")

    chunks = []
    current_chunk = ""

    for paragraph in paragraphs:
        paragraph = paragraph.strip()
        if not paragraph:
            continue
        if len(current_chunk) + len(paragraph) <= chunk_size:
            if current_chunk:
                current_chunk += "\n\n" + paragraph
            else:
                current_chunk = paragraph

        else:

            if current_chunk:
                chunks.append(current_chunk)
            overlap_text = current_chunk[-chunk_overlap:] if current_chunk else ""

            current_chunk = overlap_text + "\n\n" + paragraph
    if current_chunk:
        chunks.append(current_chunk)

    return chunks

def save_chunks(chunks, source_file, output_file):
    """
    Enregistrer les Chunks dans un fichier JSONL
    """
    file_name = os.path.basename(source_file)

    with open(output_file, "w", encoding="utf-8") as f:
        for i, chunk in enumerate(chunks):
            data = {"id": i,"content": chunk,"file": file_name
            }

            f.write(
                json.dumps(data, ensure_ascii=False) + "\n"
            )

if __name__ == "__main__":

    file_path = "./output/中华人民共和国道路交通安全法实施条例/hybrid_auto/中华人民共和国道路交通安全法实施条例.md"

    text = load_markdown(file_path)
    chunks = split_markdown(
        text,
        chunk_size=500,
        chunk_overlap=50
    )
    print("Nombre de Chunks :", len(chunks)
    save_chunks(
        chunks,
        source_file=file_path,
        output_file="output/chunks.jsonl"
    )
Après exécution, on peut voir que le fichier md analysé a été découpé en 39 chunks.

Après le découpage des documents, il faut construire une bibliothèque de documents récupérables. Comme l'ordinateur ne peut pas rechercher directement en se basant sur la sémantique du langage naturel, il est nécessaire d'utiliser un modèle d'Embedding pour convertir chaque Chunk en représentation vectorielle. Le modèle d'Embedding peut projeter le texte dans un espace vectoriel à haute dimension : plus les textes sont sémantiquement proches, plus leurs vecteurs sont proches dans l'espace. Par conséquent, après qu'un utilisateur pose une question, on peut convertir la question en vecteur, puis la comparer aux vecteurs des Chunks de la bibliothèque pour récupérer le contenu sémantiquement le plus pertinent.
La communauté open source propose aujourd'hui plusieurs modèles d'Embedding, tels que BGE-M3 et Qwen3-Embedding. BGE-M3 est un modèle d'Embedding multilingue proposé par BAAI, prenant en charge plus de 100 langues et des entrées textuelles jusqu'à 8192 tokens. Contrairement aux modèles d'Embedding Dense classiques, BGE-M3 prend en charge simultanément la recherche dense, la recherche sparse et la recherche Multi-Vector, ce qui le rend utilisable aussi bien pour la recherche sémantique vectorielle courante que pour des scénarios de recherche hybride. FlagEmbedding
Qwen3-Embedding est une famille de modèles vectoriels textuels proposée par l'équipe Qwen, construite sur l'architecture Qwen3, destinée principalement à des tâches telles que la recherche textuelle, le clustering de texte, la classification de texte et la recherche de code. Qwen3-Embedding propose différentes tailles de paramètres, notamment 0.6B, 4B et 8B, permettant de choisir en fonction de l'efficacité du modèle et des ressources de calcul, tout en offrant d'excellentes capacités de traitement multilingue et de longs textes. Qwen3-Embedding
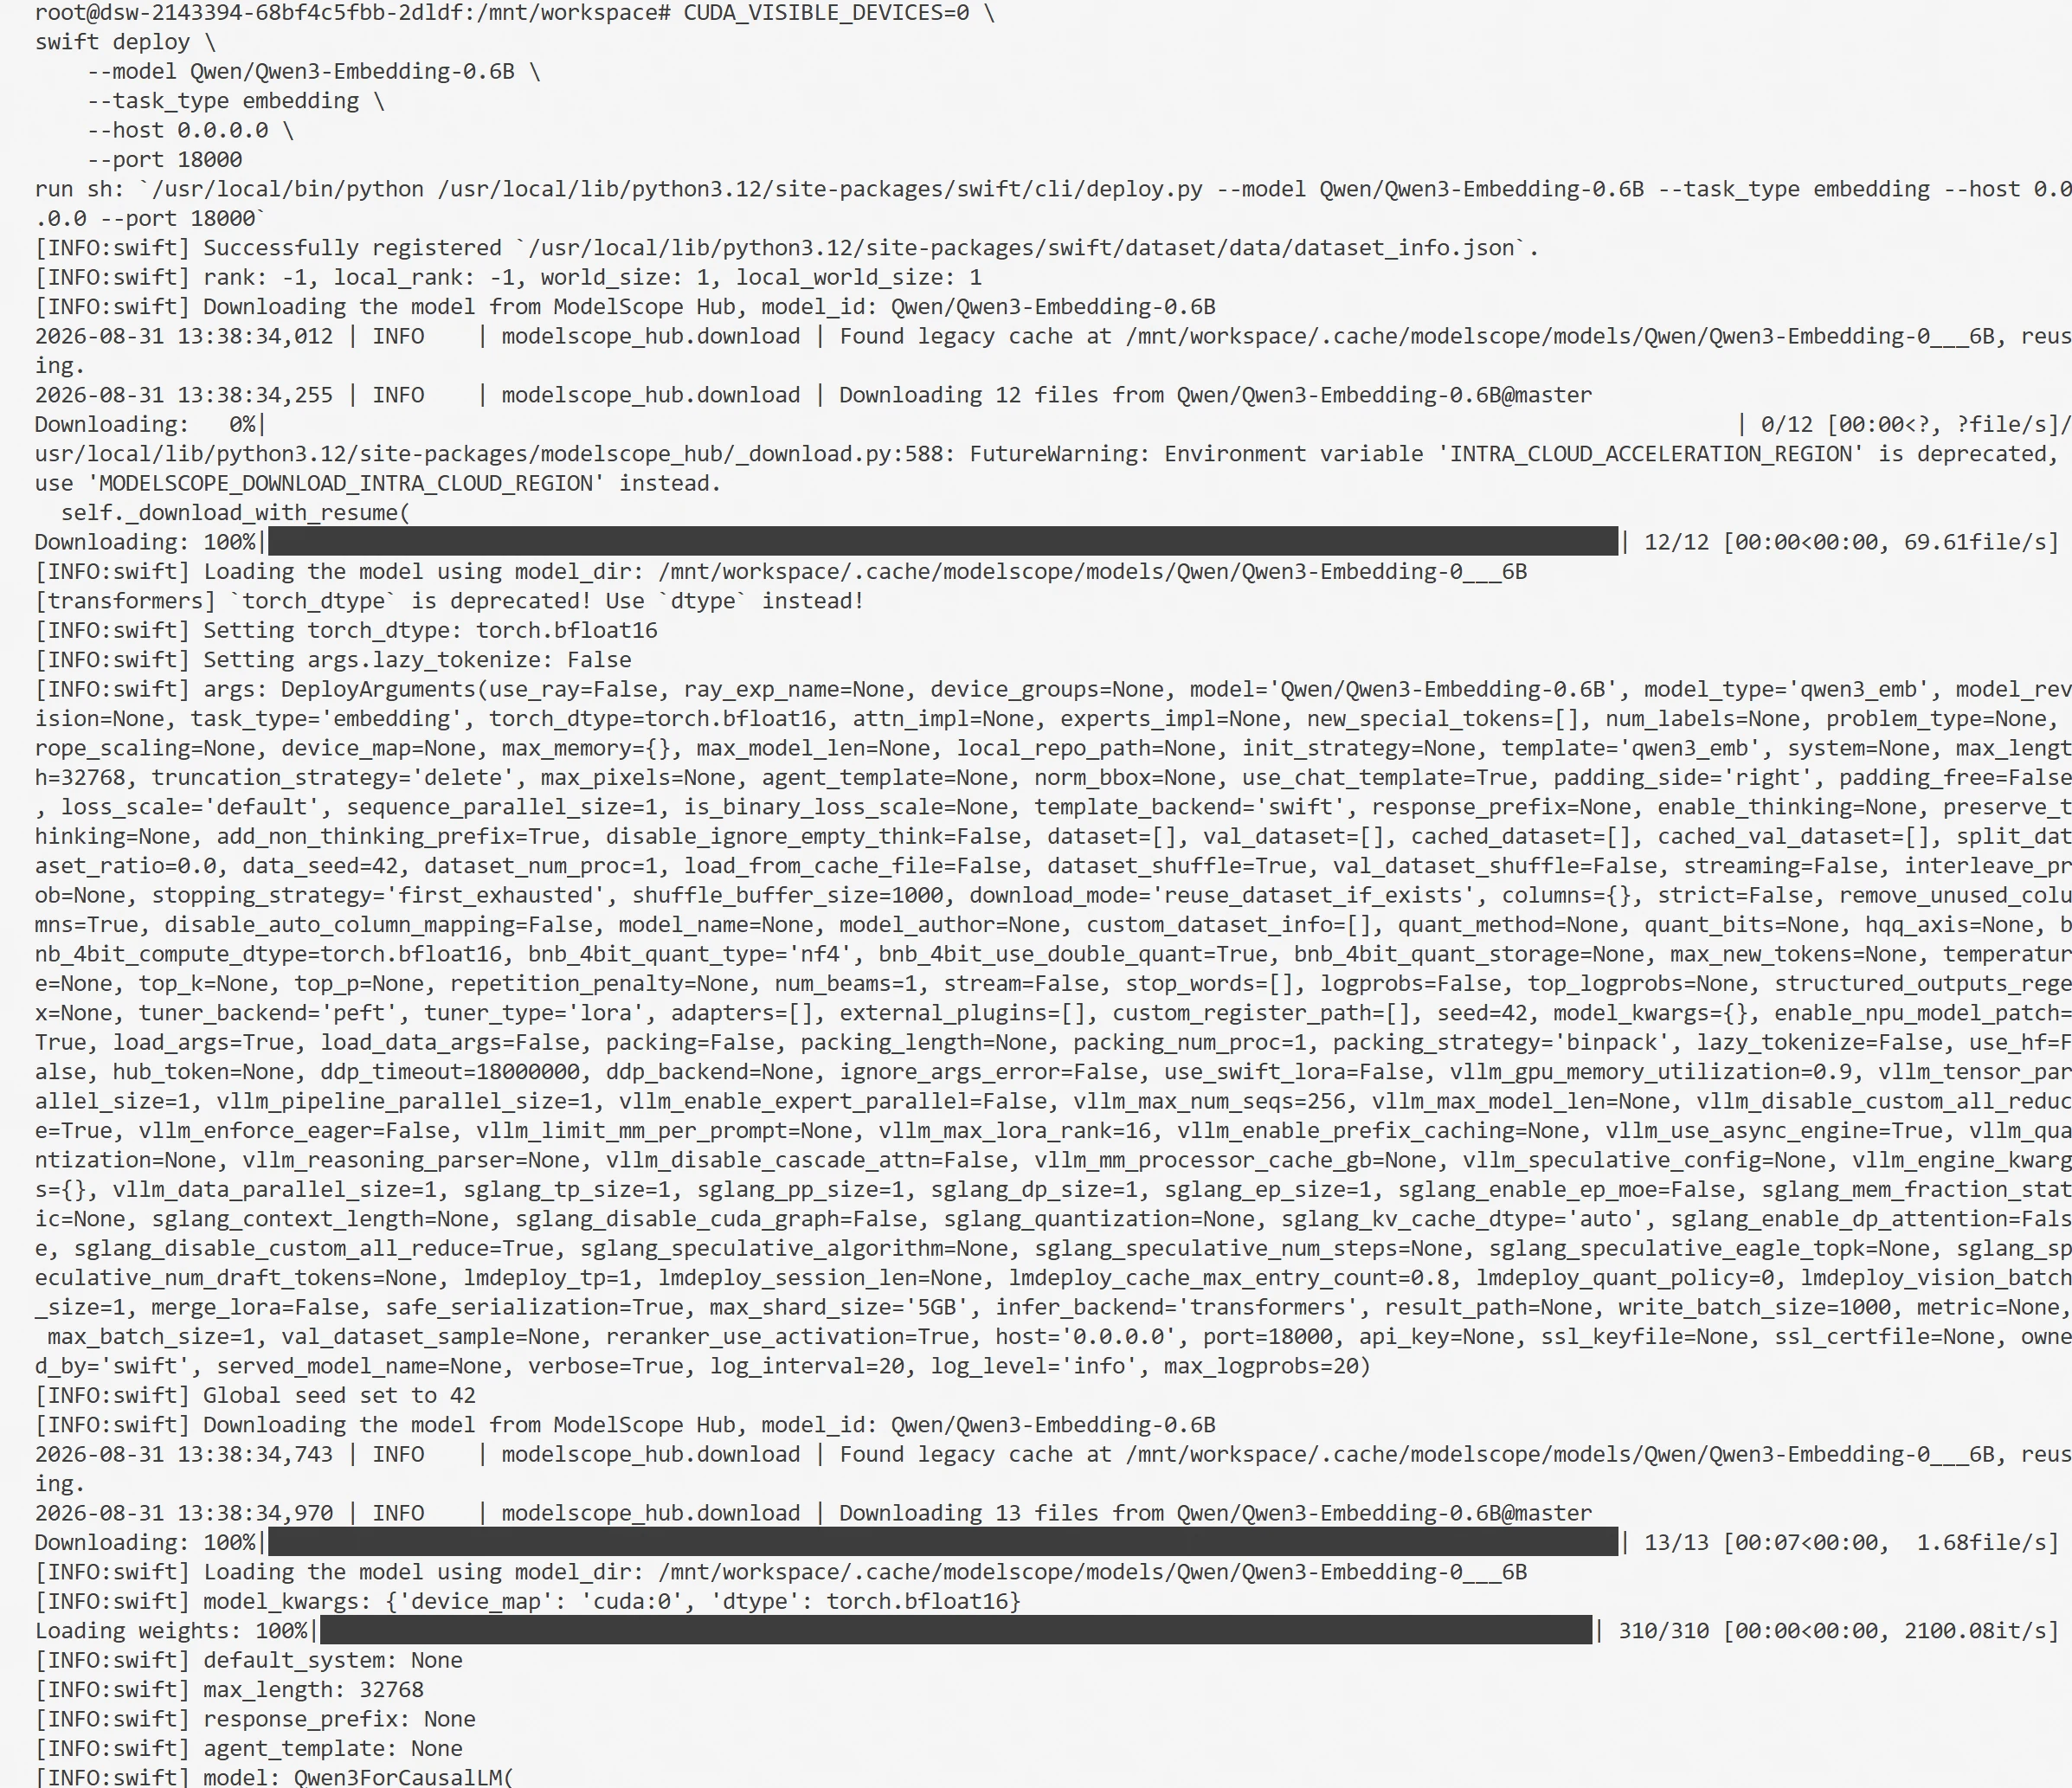
Cette section utilise Qwen3-Embedding-0.6B comme modèle d'Embedding pour l'expérimentation. Le chapitre 9 a déjà présenté ms-swift, qui en plus de l'entraînement et de l'affinement des grands modèles, prend également en charge l'entraînement et l'inférence de la série Qwen3-Embedding. Par conséquent, cette section continue d'utiliser ms-swift pour démarrer Qwen3-Embedding-0.6B et effectuer la vectorisation des Chunks de documents et des questions d'utilisateurs via une interface.
On peut utiliser la commande suivante pour démarrer le service Embedding :
CUDA_VISIBLE_DEVICES=0 \
swift deploy \
    --model Qwen/Qwen3-Embedding-0.6B \
    --task_type embedding \
    --vllm_gpu_memory_utilization 0.2 \
    --vllm_max_model_len 512 \
    --host 0.0.0.0 \
    --port 18000
Après le démarrage du service, les informations suivantes s'affichent :
Les outils de recherche vectorielle couramment utilisés aujourd'hui incluent Faiss et Milvus. Faiss est une bibliothèque de recherche de similarité vectorielle open source de Meta, principalement utilisée pour l'indexation vectorielle et la recherche de voisins les plus proches de manière efficace. Il est simple à déployer, ne nécessite pas de démarrer un service de base de données séparé et peut être utilisé directement dans des programmes Python, ce qui le rend adapté à l'apprentissage, aux expérimentations et aux systèmes RAG de petite et moyenne envergure. Milvus est une base de données vectorielle conçue pour les données vectorielles à grande échelle. En plus de la recherche vectorielle, elle offre la persistance des données, le stockage distribué, la gestion des index et diverses capacités de requête, ce qui la rend plus adaptée aux scénarios nécessitant un traitement à grande échelle, un fonctionnement à long terme et un déploiement industriel. Comparé à Faiss, Milvus est plus complet en termes de fonctionnalités, mais son processus de déploiement et d'utilisation est également plus complexe.
Cette expérimentation utilise Faiss pour le stockage vectoriel et la recherche de similarité. Installer d'abord la bibliothèque faiss, en exécutant la commande suivante :
pip install faiss-cpu
Après l'installation, on peut envoyer les Chunks générés à la section précédente à l'interface Embedding pour obtenir les vecteurs correspondants, puis établir une correspondance entre les vecteurs et les informations id, content, file des Chunks, afin de faciliter les calculs de similarité et la recherche de connaissances ultérieures.
Voici le code de création d'index build_index.py :
import json
import requests
import numpy as np
import faiss

EMBEDDING_URL = "http://localhost:18000/v1/embeddings"
MODEL_NAME = "Qwen3-Embedding-0.6B"

def get_embedding(text):
    payload = {"model": MODEL_NAME,"input": text}
    response = requests.post(
        EMBEDDING_URL,
        json=payload,
        timeout=60
    )
    response.raise_for_status()
    data = response.json()
    embedding = data["data"][0]["embedding"]
    return np.array(embedding, dtype="float32")

def load_chunks(file_path):
    chunks = []
    with open(file_path, "r", encoding="utf-8") as f:
        for line in f:
            chunks.append(json.loads(line)
    return chunks
def build_faiss_index(chunks,index_path="faiss.index", metadata_path="metadata.json"):

    embeddings = []
    for i, chunk in enumerate(chunks):
        text = chunk["content"]
        embedding = get_embedding(text)
        embeddings.append(embedding)
        print(f"Traités {i + 1}/{len(chunks)}")
    embeddings = np.array(embeddings, dtype="float32")
    faiss.normalize_L2(embeddings)
    dimension = embeddings.shape[1]
    index = faiss.IndexFlatIP(dimension)
    index.add(embeddings)
    print("Nombre de vecteurs :", index.ntotal)
    print("Dimension des vecteurs :", dimension)
    faiss.write_index(index, index_path)
    with open(metadata_path, "w", encoding="utf-8") as f:
        json.dump(chunks,f,ensure_ascii=False,indent=2
        )
    print(f"Index Faiss enregistré dans : {index_path}")
    print(f"Informations Chunk enregistrées dans : {metadata_path}")

if __name__ == "__main__":

    chunks = load_chunks("output/chunks.jsonl")

    build_faiss_index(
        chunks,
        index_path="output/faiss.index",
        metadata_path="output/metadata.json"
    )
Après exécution, les fichiers d'index et les vecteurs correspondants sont générés.
Le modèle d'Embedding peut convertir la question de l'utilisateur et les Chunks de documents en vecteurs séparément, puis effectuer la recherche en se basant sur la distance ou la similarité entre les vecteurs. L'avantage de cette approche est que les vecteurs de documents peuvent être calculés et stockés à l'avance ; lorsqu'un utilisateur pose une question, il suffit de calculer une seule fois le vecteur de la question pour récupérer rapidement le contenu pertinent parmi un grand nombre de documents. Cependant, cette méthode de recherche efficace présente certaines limites. Le modèle d'Embedding encode la requête et les Chunks séparément et calcule la similarité de deux vecteurs dans l'espace vectoriel. Le modèle Reranker utilise un appariement interactif. En envoyant simultanément la requête et les Chunks candidats au modèle, il permet au modèle d'analyser directement la relation de pertinence entre les deux textes, offrant ainsi une correspondance sémantique plus fine.
Par conséquent, dans un système RAG, on utilise couramment une recherche en deux étapes : rappel par Embedding + reclassement par Reranker. On utilise d'abord l'Embedding pour filtrer rapidement un ensemble de résultats candidats parmi un grand nombre de Chunks, puis on utilise le Reranker pour effectuer un jugement de pertinence plus précis et un reclassement sur un petit nombre de résultats candidats. Cela permet à la fois de garantir l'efficacité de la recherche et d'améliorer davantage la qualité du contexte fourni au grand modèle de langage.
Cette section utilise Qwen3-Reranker-0.6B comme modèle de reclassement, que l'on peut démarrer avec ms-swift :
CUDA_VISIBLE_DEVICES=0 \
swift deploy \
    --model Qwen/Qwen3-Reranker-0.6B \
    --task_type generative_reranker \
    --infer_backend transformers \
    --host 0.0.0.0 \
    --port 18001
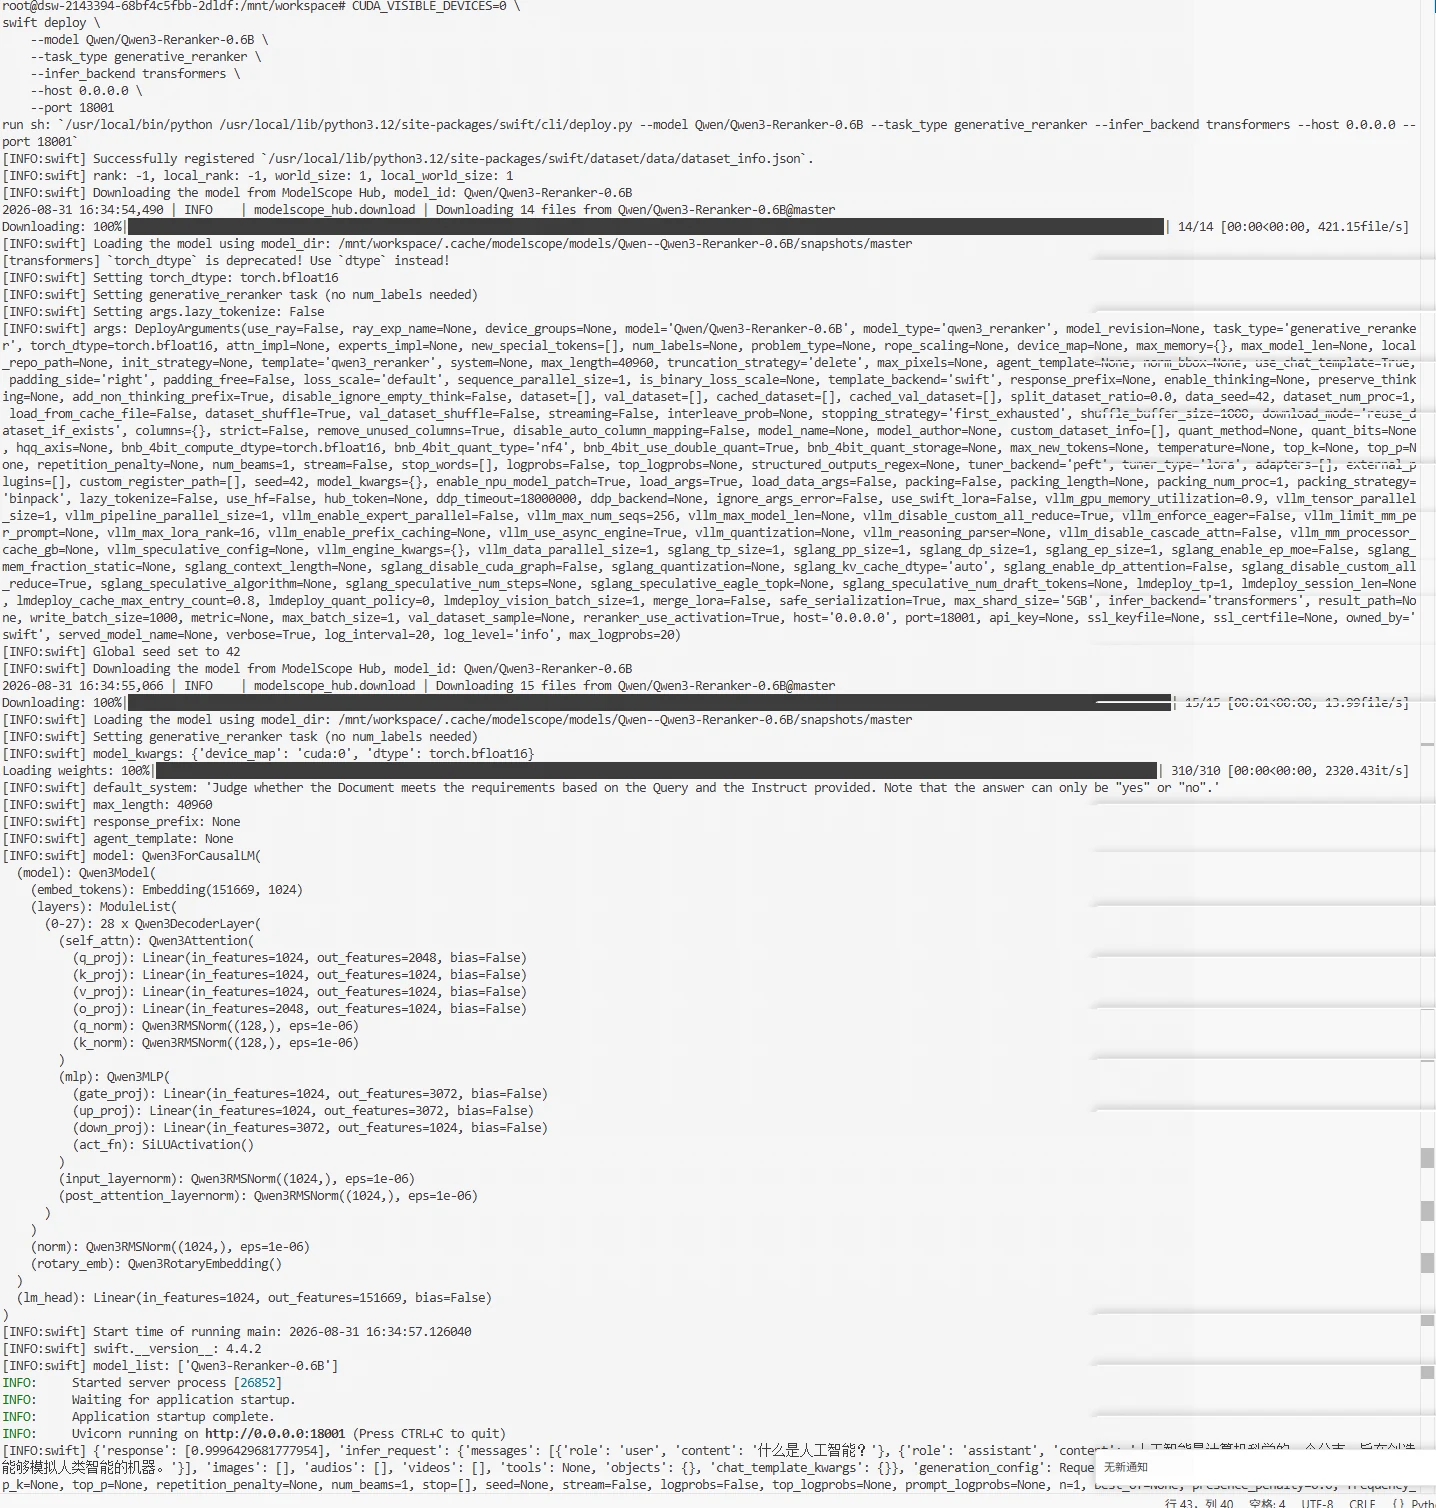
Après le démarrage du service, on peut envoyer la question de l'utilisateur et les Chunks candidats obtenus par la recherche Embedding au Reranker, reclassement selon le score de pertinence calculé par le modèle, et sélectionner les Chunks classés en tête comme contenu de référence pour la génération de réponse par le grand modèle de langage.
Nous avons précédemment finalisé la construction du service Embedding, du service Reranker et de l'index vectoriel Faiss. Sur cette base, nous sélectionnons les Chunks candidats en utilisant la recherche en deux étapes rappel par Embedding + reclassement par Reranker.
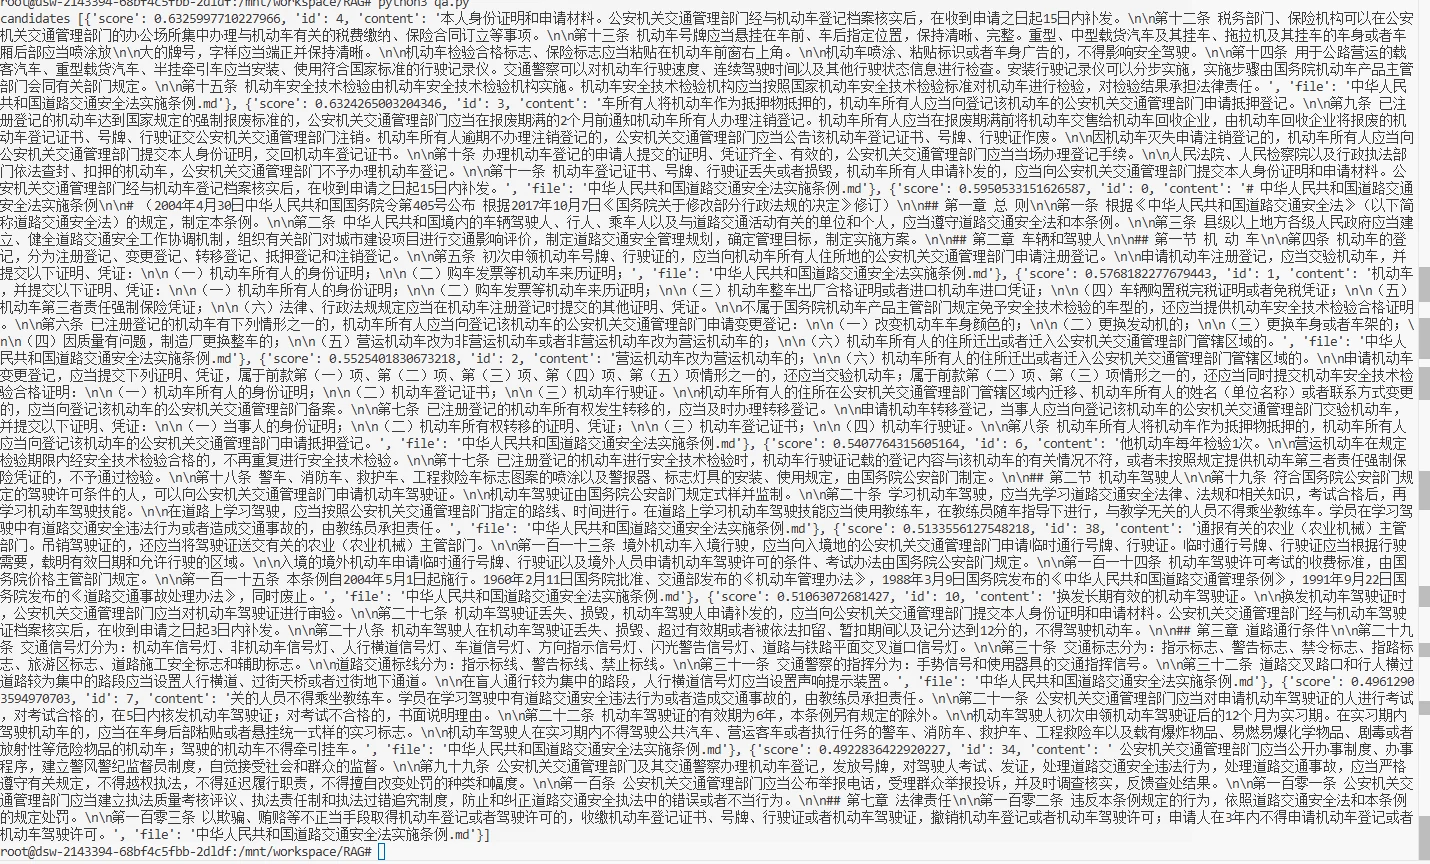
La première étape utilise Faiss pour effectuer une recherche vectorielle dans la base de connaissances, en obtenant d'abord les 10 Chunks candidats les plus similaires. Voici les 10 meilleurs résultats de la recherche vectorielle pour la question : « Quel service doit-on solliciter pour l'enregistrement lors de la première demande de plaque d'immatriculation et de certificat d'immatriculation pour véhicule à moteur ? »
import json
import faiss
from build_index import get_embedding
def load_faiss_index(index_path="faiss.index",
                     metadata_path="metadata.json"):

    index = faiss.read_index(index_path)

    with open(metadata_path, "r", encoding="utf-8") as f:
        metadata = json.load(f)

    return index, metadata
def search(query,index,metadata,top_k=10):

    query_embedding = get_embedding(query)
    query_embedding = query_embedding.reshape(1, -1)
    faiss.normalize_L2(query_embedding)
    scores, indices = index.search(query_embedding,top_k)
    results = []
    for score, idx in zip(scores[0], indices[0]):
        if idx == -1:
            continue
        chunk = metadata[idx]
        results.append({
            "score": float(score),
            "id": chunk.get("id"),
            "content": chunk.get("content"),
            "file": chunk.get("file")
        })

    return results
index, metadata = load_faiss_index(
        "output/faiss.index",
        "output/metadata.json"
    )
query="Quel service doit-on solliciter pour l'enregistrement lors de la première demande de plaque d'immatriculation ?"
candidates = search(
    query=query,
    index=index,
    metadata=metadata,
    top_k=10
)

print("candidates",candidates)
La deuxième étape utilise le Reranker pour reclassement des résultats candidats. On soumet la question de l'utilisateur et les Chunks candidats rappelés au Reranker, on recalcule le score de pertinence entre les deux, puis on trie par score décroissant.
def rerank(query, candidates):
    results = []
    for candidate in candidates:
        response = rerank_client.chat.completions.create(
            model="Qwen3-Reranker-0.6B",
            messages=[
                {
                    "role": "user",
                    "content": query
                },
                {
                    "role": "assistant",
                    "content": candidate["content"]
                }
            ]
        )

        score = response.choices[0].message.content[0]
        item = candidate.copy()
        item["rerank_score"] = float(score)
        results.append(item)
    results.sort(
        key=lambda x: x["rerank_score"],
        reverse=True
    )
    for rank, item in enumerate(results, start=1):
        item["rerank_rank"] = rank

    return results
Voici les résultats après reclassement par le modèle Reranker pour la question : « Quel service doit-on solliciter pour l'enregistrement lors de la première demande de plaque d'immatriculation et de certificat d'immatriculation pour véhicule à moteur ? »
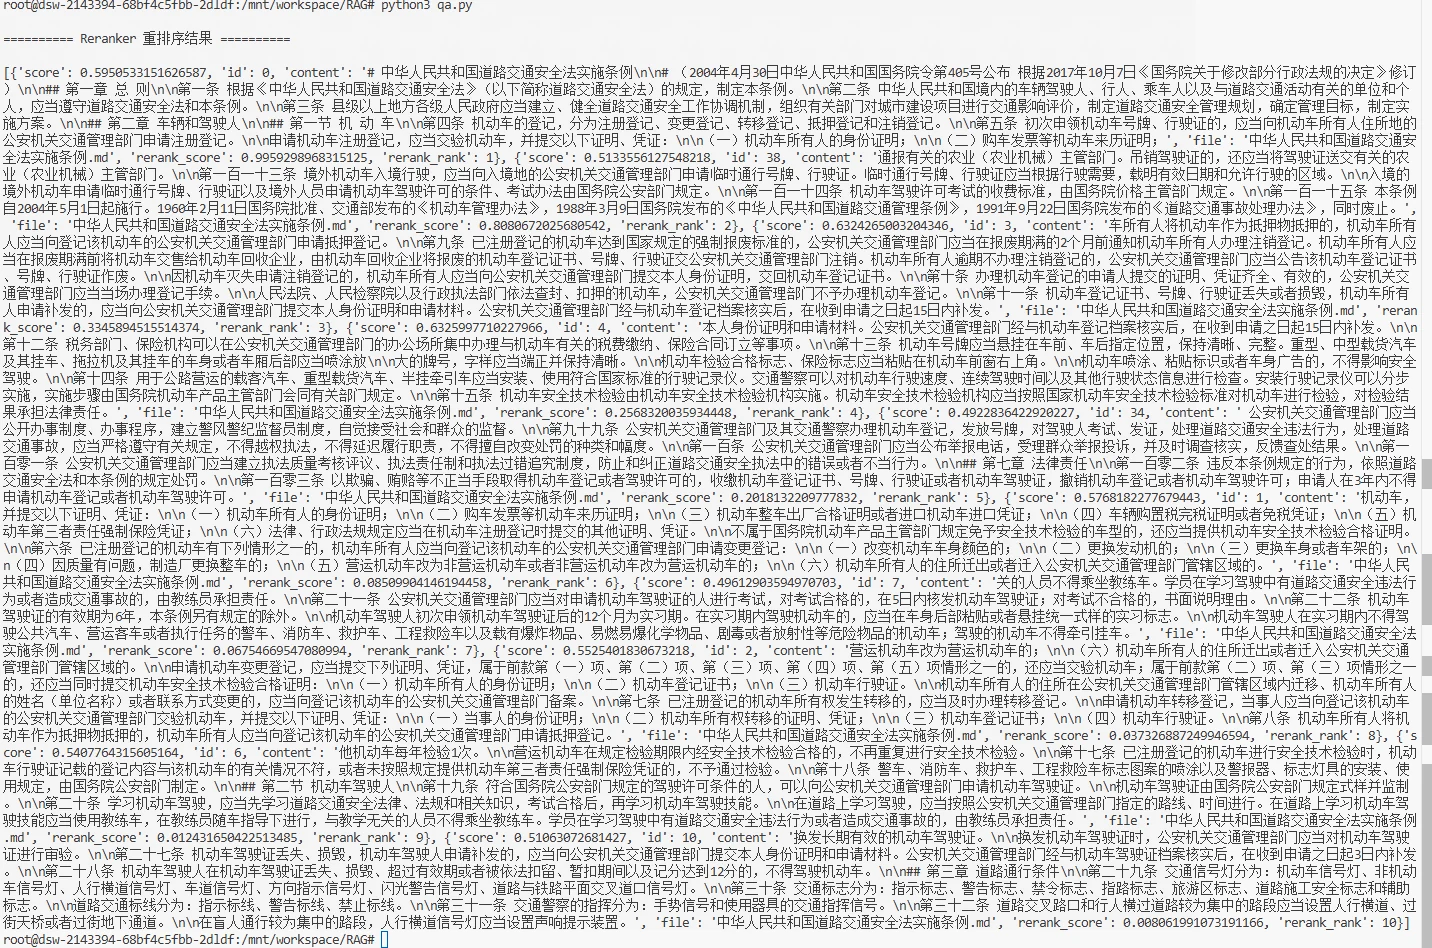
En comparant les deux résultats ci-dessus, on constate que l'ordre des Chunks a changé de manière significative après le reclassement. Dans les projets réels, on peut ajuster en fonction de la taille de la base de connaissances, de la longueur des Chunks, de la complexité des questions et de l'efficacité réelle de la recherche. Par exemple, pour les questions dont la réponse est répartie dans plusieurs segments de documents, on peut augmenter le nombre de Chunks conservés finalement ; on peut également définir un seuil de pertinence en fonction du score du Reranker pour filtrer davantage les contenus peu pertinents. En plus de cette méthode, les systèmes RAG réels peuvent utiliser la recherche hybride (Hybrid Search), combinant la recherche vectorielle avec des méthodes de recherche par mots-clés telles que BM25, puis effectuer un reclassement après la fusion des résultats de multiples rappels.
Après la recherche et le reclassement, nous avons obtenu plusieurs Chunks fortement pertinents par rapport à la question de l'utilisateur. Il faut ensuite soumettre ces informations de référence, ainsi que la question de l'utilisateur, au LLM. Si la pertinence est satisfaisante, on envoie le contenu récupéré au grand modèle de langage pour générer la réponse ; si la base de connaissances ne contient pas de contenu suffisamment pertinent, on retourne directement un résultat de refus de réponse, évitant ainsi que le modèle ne génère des réponses sans fondement.
D'abord, démarrer le service du grand modèle dans le Notebook. Cette expérimentation utilise le modèle Qwen3-4B, dont le démarrage est le suivant :
CUDA_VISIBLE_DEVICES=0 swift deploy \
  --model Qwen/Qwen3-4B \
  --load_args false \
  --infer_backend vllm \
  --enable_thinking false \
  --host 0.0.0.0 \
  --port 18002 \
  --api_key 123 \
  --vllm_gpu_memory_utilization 0.8 \
  --vllm_max_model_len 8000 \
  --max_new_tokens 2000
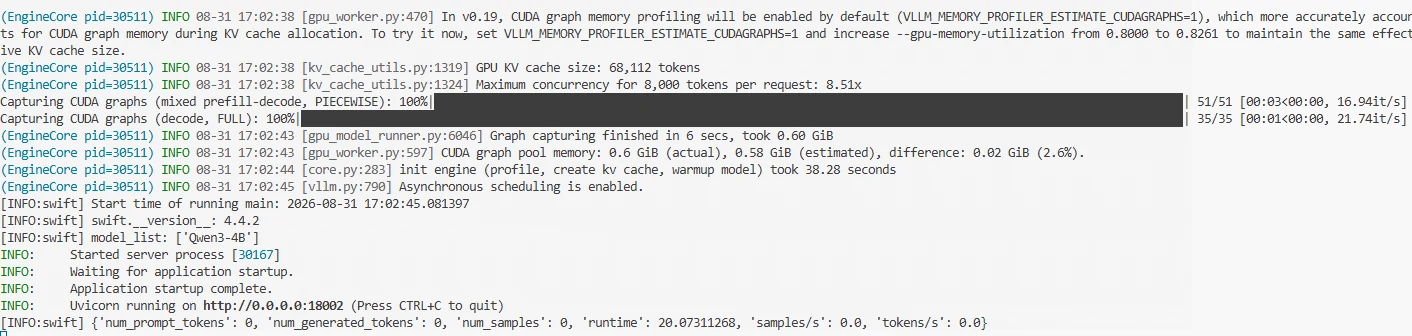
Après le démarrage, l'affichage suivant indique que le modèle a démarré avec succès. Une fois le service démarré, on peut appeler Qwen3-4B via le port 18002.
Le Reranker réajuste l'ordre en fonction du degré de pertinence entre la question de l'utilisateur et les Chunks candidats. Cette expérimentation sélectionne directement les 5 premiers Chunks comme références pour le LLM. Pour que le modèle réponde autant que possible en se basant sur le contenu de la base de connaissances, on peut définir explicitement la portée de la réponse dans le Prompt. En même temps, lorsque les références fournies ne permettent pas de répondre à la question de l'utilisateur, on demande au modèle de refuser directement de répondre, plutôt que d'utiliser ses propres connaissances pour compléter la réponse. Le prompt est le suivant :
prompt = f"""
Veuillez répondre à la question de l'utilisateur en vous basant sur les références ci-dessous.

Références :
{context}

Question de l'utilisateur :
{query}

Exigences :
1. Répondre uniquement en se basant sur les références ;
2. Réponse précise et concise ;
3. Ne pas ajouter d'informations absentes des références ;
4. Si les références ne permettent pas de répondre à cette question, veuillez répondre :
   « La base de connaissances actuelle ne permet pas de répondre à cette question pour le moment. »
"""
Après que le grand modèle a généré la réponse, en plus de renvoyer la réponse finale à l'utilisateur, on peut simultanément renvoyer les sources documentaires utilisées pour cette réponse. Dans le scénario des Q&R d'entreprise, les informations de source aident l'utilisateur à comprendre de quels documents de la base de connaissances provient la réponse. Si une vérification supplémentaire est nécessaire, on peut revenir aux documents originaux pour consulter le contenu pertinent. Les informations de source n'ont pas besoin d'être générées par le grand modèle, mais sont directement extraites des métadonnées des résultats de recherche. Lors de la construction de la base de connaissances précédemment, chaque Chunk a conservé le champ file correspondant, ce qui permet d'extraire les noms de fichiers des 5 premiers Chunks du classement Reranker et de dédoublonner les fichiers en double.
Voici le code principal pour appeler le grand modèle et réaliser la Q&R :
llm_client = OpenAI(
    api_key="123",
    base_url="http://127.0.0.1:18002/v1"
)
LLM_MODEL = "Qwen3-4B"

def generate_answer(query, top_chunks):

    context = "\n\n".join(
        [
            f"[Référence {i + 1}]\n{item['content']}"
            for i, item in enumerate(top_chunks)
        ]
    )
    prompt = f"""
Veuillez répondre à la question de l'utilisateur en vous basant sur les références fournies ci-dessous.

Références :
{context}

Question de l'utilisateur :
{query}

Exigences :
1. Répondre uniquement en se basant sur le contenu des références ;
2. La réponse doit être précise et concise, ne pas ajouter d'informations absentes des références ;
3. Si les références ne contiennent pas de réponse pertinente à la question, veuillez répondre :
   « La base de connaissances actuelle ne permet pas de répondre à cette question pour le moment. »
"""
    response = llm_client.chat.completions.create(
        model=LLM_MODEL,
        messages=[{"role": "user","content": prompt }],
        temperature=0.1,
        max_tokens=512
    )

    return response.choices[0].message.content
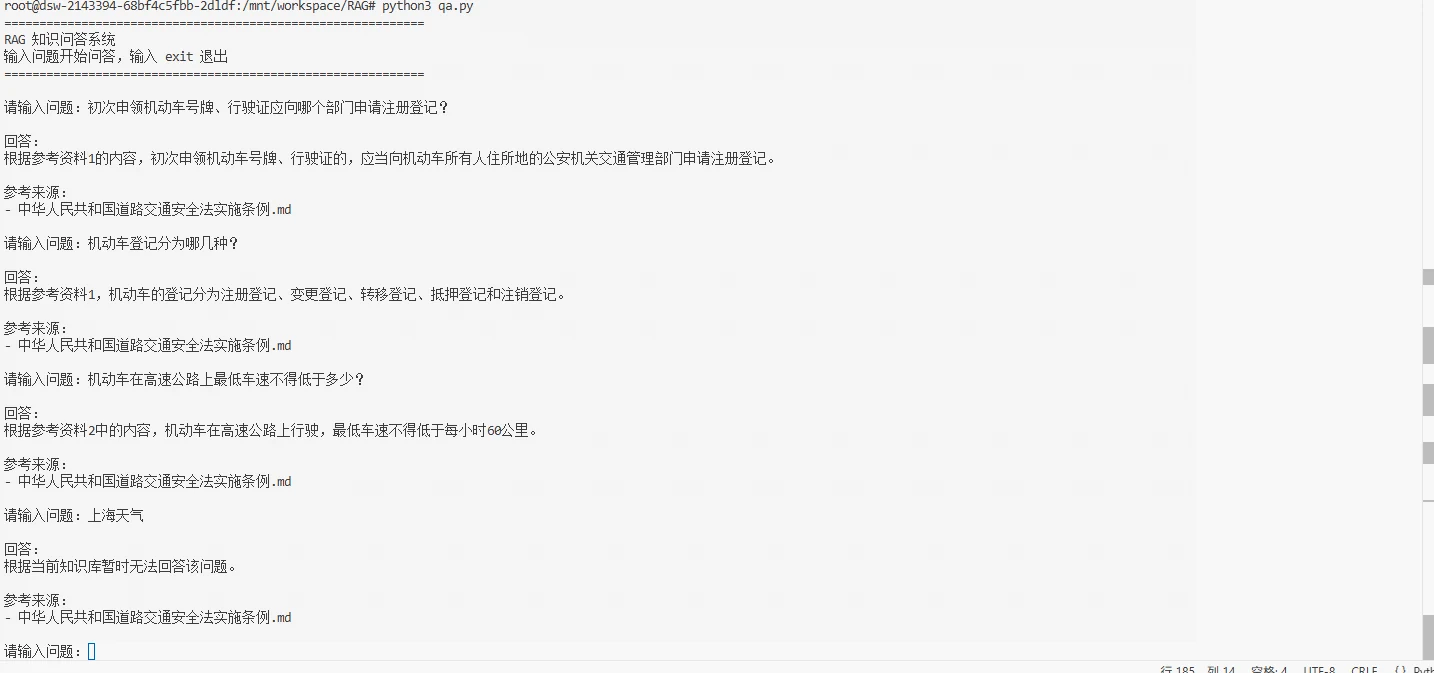
À ce stade, un assistant de Q&R d'entreprise est opérationnel. Nous pouvons effectuer des tests simples dans le terminal. Les résultats du test sont présentés ci-dessous :
Après avoir terminé le système RAG, il est nécessaire d'évaluer l'efficacité de l'ensemble du processus de Q&R. Contrairement aux Q&R classiques par grand modèle, les résultats de RAG sont simultanément influencés par deux étapes : la récupération de connaissances et la génération de réponses. Par conséquent, l'évaluation de RAG doit généralement être effectuée séparément sur ces deux aspects.
Le critère d'évaluation de la phase de recherche est de savoir si la réponse peut être trouvée dans les Chunks rappelés. L'indicateur couramment utilisé est Recall@K. Recall@K est un indicateur intuitif qui mesure la proportion de documents pertinents couverts par les K premiers résultats de recherche :
Recall@K : le document correct apparaît-il dans les K premiers résultats de recherche ?
Recall@K =
\frac{\text{Nombre de documents pertinents récupérés dans le Top K}}
{\text{Nombre total de documents pertinents}}
Par exemple, si une question correspond à 2 segments de connaissances corrects et que les 2 sont trouvés dans les 5 meilleurs résultats de recherche, alors Recall@5 est de 100%.
La récupération de connaissances pertinentes ne garantit pas que la réponse finale sera correcte. Il est également nécessaire d'évaluer les résultats de génération du LLM. La phase de génération peut se concentrer sur la précision, l'exhaustivité, la pertinence, l'exactitude des citations et les hallucinations. Cette partie peut être référencée aux indicateurs d'évaluation des tâches de génération de la section 12.3 du chapitre 12. Grâce à ces indicateurs, on peut déterminer si le modèle est capable d'utiliser avec précision les connaissances récupérées pour générer des réponses, et découvrir les problèmes tels que les omissions de réponses, les déviations de contenu ou les générations sans fondement. Dans les applications pratiques, si les résultats de recherche sont déjà assez précis mais que la qualité de génération ne répond toujours pas aux exigences, on peut envisager de choisir un modèle plus performant avec un plus grand nombre de paramètres comme modèle de génération pour le RAG, afin d'améliorer la compréhension et les capacités de réponse aux questions complexes.
Les données expérimentales et le code expérimental de ce chapitre sont disponibles à l'adresse : https://modelscope.cn/gallery/liucong/a895ace8-420c-4421-ba43-4e3194392a95