L'Intelligence Artificielle Générative de Contenu (AIGC) constitue un axe de développement important du domaine de l'intelligence artificielle ces dernières années. Contrairement aux tâches traditionnelles de classification, de prédiction et de recherche, les modèles génératifs visent à apprendre la distribution de probabilité des données et à générer de nouveaux contenus sous la guidance de conditions telles que le texte et les images.
Des premiers réseaux antagonistes génératifs (GAN) et auto-encodeurs variationnels (VAE), aux modèles de diffusion (Diffusion Model) et Diffusion Transformer (DiT) largement utilisés ces dernières années, les modèles génératifs n'ont cessé de s'améliorer en termes de qualité de génération, de stabilité d'entraînement, de capacité de compréhension sémantique et d'efficacité d'inférence. Sur cette base, les modèles de texte vers image tels que Stable Diffusion, FLUX, Qwen-Image et Z-Image ont further fait avancer les applications de l'AIGC dans la création de contenu, la conception publicitaire et la production de matériaux marketing.
L'objectif principal des modèles génératifs est d'apprendre la distribution de probabilité sous-jacente et les schémas inhérents aux données d'entraînement, puis de générer de nouveaux échantillons conformes à cette distribution sous des conditions données. Contrairement aux tâches de classification et de recherche, les modèles génératifs ne sélectionnent pas une réponse parmi des résultats candidats prédéfinis ; ils utilisent plutôt les schémas de données appris pour générer de nouveaux contenus textuels, visuels, audio ou vidéo.
Du point de vue de la modélisation probabiliste, les tâches de génération conditionnelle peuvent être représentées comme suit : $p(x \mid c)$ représente la distribution de probabilité conditionnelle du modèle pour générer le contenu x étant donnée la condition c. Par exemple, le Prompt saisi par l'utilisateur, le contexte, l'image de référence ou autres informations de contrôle ; x représente le contenu cible à générer. Le processus d'entraînement du modèle consiste essentiellement à apprendre la probabilité de différents résultats possibles sous différentes conditions ; le processus d'inférence du modèle produit ensuite des résultats concrets basés sur cette distribution de probabilité.
Bien que les grands modèles de langage, les modèles de génération d'images et les modèles de génération de vidéo appartiennent tous aux modèles génératifs, les méthodes spécifiques par lesquelles ils réalisent la génération ne sont pas entièrement identiques.
En prenant l'exemple des grands modèles de langage, les modèles dominants actuels utilisent généralement la génération autorégressive pour produire du texte. Étant donné le contexte existant, le modèle prédit la distribution de probabilité du Token suivant, sélectionne ou échantillonne le Token suivant en fonction de cette distribution, ajoute le Token nouvellement généré au contexte et continue de prédire les Tokens suivants. En répétant continuellement ce processus, un contenu textuel complet est finalement formé.
Se connecter pour rejoindre la discussion
Les modèles de génération d'images utilisent des mécanismes de génération différents. En prenant l'exemple des modèles de diffusion, le processus de génération commence généralement par du bruit aléatoire et procède à une débruitage progressif sous la guidance de conditions telles que les prompts textuels, permettant au bruit aléatoire de former progressivement des images avec une structure et une sémantique claires. Que ce soit par génération autorégressive, diffusion ou autres mécanismes de génération, leur objectif commun est d'apprendre les schémas de distribution des données réelles et de générer de nouveaux contenus conformes à ces schémas en fonction des conditions données.
Les modèles génératifs peuvent générer de nouveaux contenus, et une raison importante est que le modèle n'apprend pas un texte ou une image spécifique en soi, mais les relations statistiques et les schémas de caractéristiques qui existent entre une grande quantité de données d'entraînement.
Par exemple, après avoir appris à partir d'un grand nombre d'images publicitaires de boissons, le modèle peut établir progressivement des associations entre des concepts visuels tels que les bouteilles de boissons, les glaçons, les éclaboussures d'eau, les fruits, les couleurs d'arrière-plan, l'éclairage et les styles de photographie commerciale. Lorsqu'on saisit « publicité commerciale de boisson au citron vert estivale », le modèle peut réorganiser différents éléments visuels en fonction de ces schémas appris pour former de nouvelles images. La « génération » des modèles génératifs n'équivaut pas à trouver une entrée de données existante dans l'ensemble d'entraînement ; elle consiste à modéliser et combiner différentes caractéristiques et concepts en fonction des distributions de données apprises.
Une autre caractéristique importante des modèles génératifs est que les résultats de génération sont diversifiés. Par exemple, pour le même prompt « un chat assis près d'une fenêtre », le modèle peut générer des chats de différentes races, postures et couleurs de pelage, et peut également adopter différents éclairages, arrière-plans et compositions d'image. Ces résultats sont sémantiquement cohérents avec les conditions d'entrée, mais le contenu spécifique n'est pas entièrement identique. Ce phénomène s'explique par le fait que le Prompt n'impose généralement que certaines contraintes conditionnelles sur le contenu généré plutôt que de spécifier complètement le résultat final. Dans les conditions données, il existe généralement plusieurs résultats raisonnables dans la distribution de probabilité apprise par le modèle. Dans le processus de génération réel, des facteurs tels que les stratégies d'échantillonnage et les graines aléatoires influenceront davantage la sortie finale. Contrairement aux tâches traditionnelles avec des réponses déterministes, les tâches de génération n'ont généralement pas de sortie optimale unique ; les mêmes conditions d'entrée peuvent correspondre à plusieurs résultats de génération raisonnables.
La technologie de génération de texte joue un rôle fondamental dans le développement de l'IA générative moderne. D'une part, les grands modèles de langage ont favorisé la popularisation rapide de la technologie AIGC ; d'autre part, des concepts tels que le Tokenizer, l'Embedding, le Transformer, la distribution de probabilité et l'échantillonnage ne s'appliquent pas seulement à la génération de texte mais réapparaîtront également dans les tâches ultérieures de génération texte vers image et multimodale. Surtout dans les systèmes AIGC actuels, les Prompts textuels sont devenus un moyen important pour les utilisateurs de contrôler le contenu généré. Qu'il s'agisse de générer un texte, une image ou une vidéo, les modèles doivent généralement d'abord comprendre le langage naturel saisi par l'utilisateur.
Le langage naturel ne peut pas participer directement aux calculs des réseaux de neurones. Avant que le texte ne soit saisi dans le modèle, il doit d'abord être segmenté par un Tokenizer et converti en Token IDs correspondants. Les Tokens sont les unités de base pour les modèles de langage pour traiter le texte ; ils peuvent être un caractère chinois, un mot complet ou une partie d'un mot. La méthode de segmentation spécifique est déterminée par l'algorithme de tokenisation et le vocabulaire adoptés par le modèle. Les Token IDs sont essentiellement les numéros d'index des Tokens dans le vocabulaire ; leurs valeurs numériques ne représentent pas les relations sémantiques entre les Tokens. Par exemple, deux Tokens avec des index proches ne sont pas nécessairement sémantiquement similaires. Par conséquent, avant d'entrer dans le réseau de neurones pour le calcul, les Token IDs discrets doivent être projetés vers des vecteurs continus de grande dimension via une couche d'Embedding. Cette idée d'utiliser des vecteurs continus pour représenter le langage constitue un fondement important du traitement du langage naturel moderne. En 2013, Mikolov et al. ont proposé Word2Vec, qui apprend les représentations vectorielles distribuées des mots à partir de corpus à grande échelle via des réseaux de neurones. L'idée de base provient de l'hypothèse de distribution en langage naturel, selon laquelle les mots apparaissant dans des contextes similaires ont généralement des caractéristiques sémantiques ou grammaticales similaires.
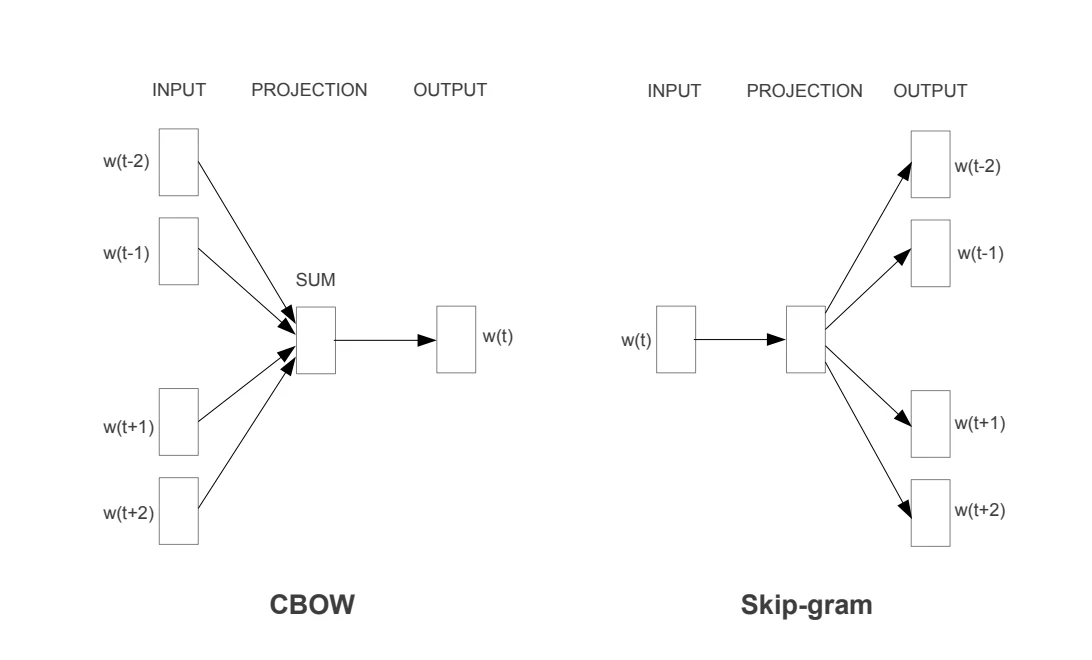
Word2Vec comprend principalement deux structures d'entraînement : CBOW (Continuous Bag-of-Words) et Skip-gram. Les deux apprennent les vecteurs de mots à travers la relation entre les mots centraux et les mots de contexte, mais leurs directions de prédiction sont différentes.
CBOW prédit le mot central en fonction des mots de contexte. Pour une séquence composée de mots, un mot central est d'abord sélectionné, et les mots dans une certaine fenêtre autour de lui sont utilisés comme contexte. Le modèle utilise les représentations vectorielles de ces mots de contexte pour prédire le mot central. Par exemple, avec « manger » comme mot central, en sélectionnant « aimer » et « frais » de son environnement comme contexte.
Skip-gram, quant à lui, prédit les mots de contexte en fonction du mot central. Comparé à CBOW, sa direction de prédiction est inverse. Pour la même séquence de mots, lorsque « manger » est le mot central, l'objectif d'entraînement de Skip-gram est de prédire les autres mots pouvant apparaître dans une certaine fenêtre en fonction de la représentation vectorielle de « manger », tels que « aimer », « frais », etc. La principale différence entre CBOW et Skip-gram réside dans leurs objectifs d'entraînement : CBOW utilise plusieurs mots de contexte pour prédire un mot central ; Skip-gram utilise un mot central pour prédire plusieurs mots de contexte. Malgré leurs directions de prédiction différentes, leur objectif ultime est d'apprendre les vecteurs de mots à travers une grande quantité de relations de co-occurrence entre les mots. Une fois l'entraînement terminé, chaque mot peut être représenté comme un vecteur continu de dimensions fixes.
La proposition de Word2Vec a promu le développement des représentations vectorielles distribuées des mots, mais sa méthode de représentation présente encore certaines limites. Word2Vec apprend des embeddings de mots statiques typiques, où un mot correspond généralement à un vecteur fixe après l'entraînement et ne change pas avec le contexte spécifique. Les modèles de langage modernes adoptent davantage des représentations contextuelles. Les Tokens obtiennent d'abord des vecteurs initiaux via la couche d'Embedding, puis passent par plusieurs couches de réseaux de neurones, mettant continuellement à jour leurs représentations en fonction des informations d'autres Tokens dans la séquence. Par conséquent, le même Token peut former des états cachés différents dans différents contextes, exprimant ainsi la sémantique liée au contexte actuel. L'importance de Word2Vec ne réside pas seulement dans la proposition d'une méthode spécifique d'entraînement de vecteurs de mots, mais aussi dans la promotion de l'application répandue des représentations distribuées dans le traitement du langage naturel. Le langage n'est plus représenté uniquement par des symboles discrets ou des indices, mais est également projeté dans des espaces vectoriels continus, permettant aux réseaux de neurones d'apprendre davantage les relations sémantiques et grammaticales entre les mots. Les technologies ultérieures de traitement du langage naturel se concentrent davantage sur la façon d'utiliser le contexte pour ajuster dynamiquement les représentations des mots.
En 2017, l'architecture Transformer a été proposée. Le Transformer modélise les relations entre différentes positions d'une séquence grâce au mécanisme d'attention et est progressivement devenu l'infrastructure centrale des grands modèles de langage. L'un des mécanismes les plus importants dans le Transformer est l'auto-attention (Self-Attention), comme illustré dans la figure suivante :
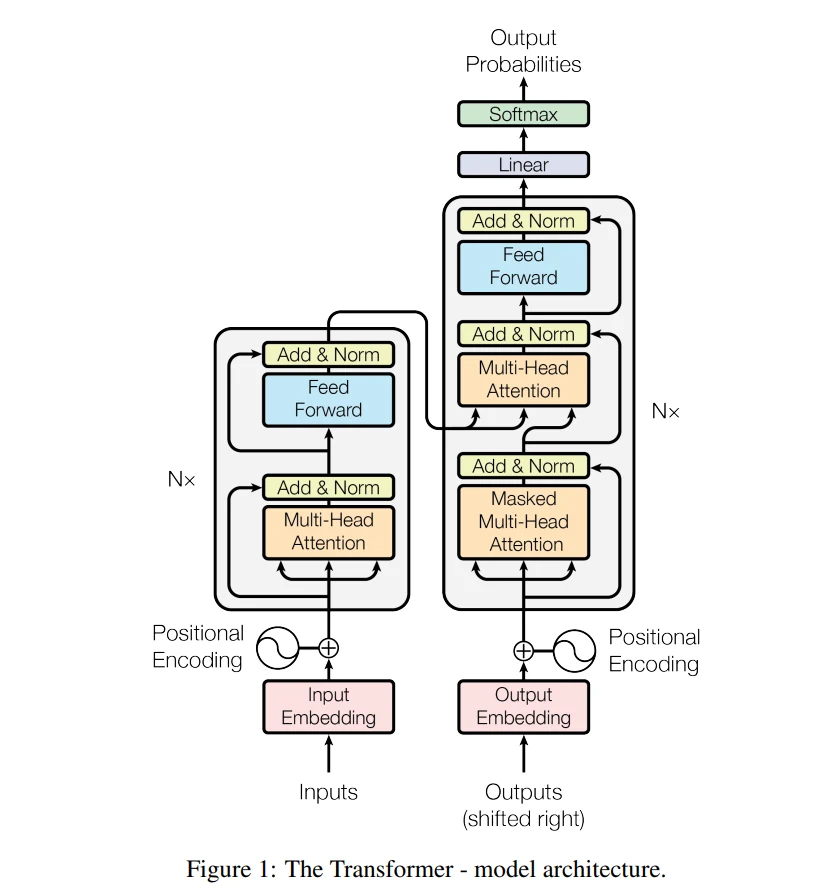
La fonction principale du mécanisme d'auto-attention est de permettre au modèle, lorsqu'il traite un Token, de considérer simultanément les informations contenues dans d'autres Tokens de la séquence et d'attribuer dynamiquement différents poids d'attention en fonction du degré d'association entre eux. Plus spécifiquement, la représentation de chaque Token est projetée en Query (Q), Key (K) et Value (V). Le modèle calcule les poids d'attention via le degré de correspondance entre Query et différentes Keys, puis utilise ces poids pour effectuer une combinaison pondérée des Values correspondantes, obtenant ainsi une nouvelle représentation intégrant les informations contextuelles.
Le Transformer est généralement composé de plusieurs couches de réseau empilées. Dans différentes couches, le modèle met continuellement à jour la représentation de chaque Token, incorporant progressivement des informations contextuelles plus riches. Après traitement par plusieurs couches de Transformer, le même Token peut former des représentations contextuelles différentes dans différents contextes, soutenant ainsi la modélisation des significations de mots, des structures syntaxiques et des relations sémantiques plus complexes par le modèle. L'importance du Transformer ne réside pas seulement dans l'introduction d'une nouvelle architecture réseau, mais aussi dans la fourniture d'un mécanisme pouvant modéliser efficacement les relations contextuelles. Les grands modèles de langage modernes améliorent continuellement les capacités de compréhension et de génération du langage en élargissant l'échelle du modèle, l'échelle des données d'entraînement et la longueur du contexte, le tout sur la base du Transformer.
Après que le Transformer a effectué la modélisation contextuelle de la séquence d'entrée, le modèle de langage a obtenu les représentations de Tokens intégrant les informations contextuelles. Sur cette base, les modèles de langage génératifs doivent prédire le contenu ultérieur. Les modèles de langage génératifs dominants tels que GPT utilisent généralement la génération autorégressive, qui prédit et génère progressivement les Tokens suivants en fonction des Tokens actuellement saisis ou générés.
Pour une séquence composée de plusieurs Tokens, sa probabilité de génération peut être décomposée en une série de probabilités conditionnelles :
p(x_1, x_2, \ldots, x_T) = \prod_{t=1}^{T} p(x_t \mid x_1, x_2, \ldots, x_{t-1})
Où $x_t$ représente le $t$-ième Token à générer actuellement, $x_1,x_2,\ldots,x_{t-1}$ représente les Tokens précédemment saisis ou générés. Cette formule indique que le processus de génération d'une séquence textuelle complète peut être décomposé en plusieurs processus consécutifs de prédiction du Token suivant.
Après que le modèle calcule la distribution de probabilité du Token suivant, il doit déterminer le Token effectivement sorti via des stratégies de décodage. Différentes stratégies de décodage affectent directement la stabilité, la diversité et la créativité de la génération de texte.
La méthode la plus directe est le décodage glouton (Greedy Decoding), qui sélectionne le Token avec la probabilité la plus élevée à chaque étape. Cette méthode a un fort déterminisme, mais la sélection consécutive de Tokens localement les plus probables n'obtient pas nécessairement un texte de qualité optimale globale, et le contenu généré tend à être monotone. Pour améliorer la diversité des résultats de génération, les modèles de langage génératifs peuvent également utiliser l'échantillonnage aléatoire, sélectionnant le Token suivant selon la distribution de probabilité prédite par le modèle. Les Tokens ayant des probabilités plus élevées sont plus susceptibles d'être sélectionnés, mais d'autres Tokens candidats raisonnables ont également une chance d'être sélectionnés. En pratique, des méthodes telles que Temperature, Top-k et Top-p sont généralement combinées pour ajuster davantage le processus d'échantillonnage.
Temperature est utilisé pour ajuster la douceur de la distribution de probabilité et peut être représenté comme suit :
p_i =
\frac{\exp(z_i / T)}
{\sum_j \exp(z_j / T)}
Où $z_i$ représente le Logit du $i$-ième Token, $T$ représente Temperature.
Lorsque $T$ est petit, l'avantage des Tokens à haute probabilité est renforcé, le modèle tend à sélectionner des résultats à probabilités plus élevées, et le contenu généré est généralement plus stable ; lorsque $T$ est grand, la distribution de probabilité est relativement plus plate, les Tokens à faible probabilité obtiennent davantage d'opportunités d'être sélectionnés, et les résultats de génération ont généralement une diversité plus élevée.
Top-k ne conserve que les $k$ Tokens candidats ayant la probabilité la plus élevée à chaque étape de génération, et rééchantillonne après renormalisation des probabilités parmi ces Tokens candidats. Cette méthode peut filtrer un grand nombre de Tokens à faible probabilité, réduisant la possibilité que des contenus clairement déraisonnables soient sélectionnés.
Top-p ne fixe pas le nombre de Tokens candidats ; il classe plutôt les probabilités de la plus haute à la plus basse et sélectionne le plus petit ensemble de candidats dont la probabilité cumulée atteint le seuil $p$, puis échantillonne à partir de cet ensemble. Par conséquent, Top-p peut ajuster dynamiquement la plage de Tokens candidats en fonction de la distribution de probabilité actuelle.
Par exemple, lorsque la prédiction du modèle pour le Token suivant est relativement certaine, la probabilité cumulée d'un petit nombre de Tokens peut atteindre le seuil défini ; en revanche, lorsque le modèle a plusieurs résultats candidats raisonnables, davantage de Tokens sont conservés pour l'échantillonnage. La génération de texte comprend en réalité deux processus étroitement liés : d'abord, le modèle de langage calcule la distribution de probabilité du Token suivant en fonction du contexte, puis les stratégies de décodage et d'échantillonnage déterminent le Token effectivement généré en fonction de cette distribution de probabilité.
Le modèle est responsable d'apprendre quels Tokens sont plus susceptibles d'apparaître dans le contexte actuel, tandis que la stratégie de décodage est responsable de décider comment sélectionner des résultats spécifiques parmi ces Tokens candidats. Ensemble, ils déterminent l'exactitude, la stabilité et la diversité du texte final.
Dans le développement des modèles génératifs d'apprentissage profond, les réseaux antagonistes génératifs (Generative Adversarial Network, GAN) représentent une classe de techniques représentatives. En 2014, Goodfellow et al. ont proposé le GAN, qui apprend les schémas de distribution des données réelles via un entraînement antagoniste entre deux réseaux de neurones. Contrairement à l'apprentissage supervisé traditionnel, le GAN ne spécifie pas directement le type d'images que le générateur doit produire ; il introduit également un discriminateur pour évaluer les résultats de génération et utilise les résultats de discrimination pour améliorer continuellement le générateur. Après sa proposition, le GAN a été rapidement appliqué à des tâches telles que la génération d'images, la génération de visages, le transfert de style d'image, la super-résolution et l'édition d'images, formant une série de modèles représentatifs tels que CycleGAN, StyleGAN et ESRGAN.
Le GAN apprend la distribution des données réelles via un entraînement antagoniste entre deux réseaux de neurones : le Générateur et le Discriminateur. Comme illustré dans la figure, pendant l'entraînement, le Discriminateur reçoit simultanément des échantillons réels de l'ensemble d'entraînement et des échantillons générés par le Générateur, et distingue entre les deux types d'échantillons ; le Générateur ajuste continuellement ses propres paramètres en fonction des retours du Discriminateur, améliorant la similarité entre les échantillons générés et les échantillons réels.
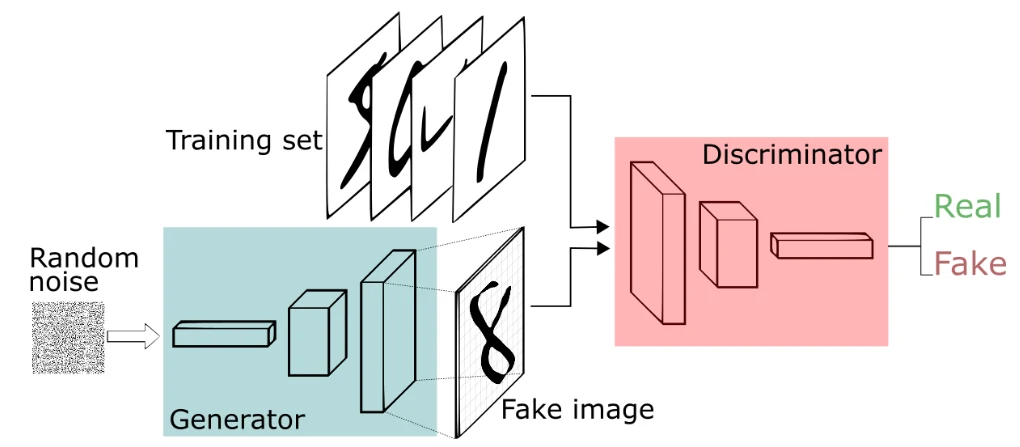
Le Générateur est noté G. Son entrée est typiquement une variable aléatoire z échantillonnée à partir d'une distribution de probabilité simple, telle qu'une distribution gaussienne ou uniforme. Après le mapping non linéaire du Générateur, la variable aléatoire est transformée en un échantillon généré :
\hat{x}=G(z), \qquad z\sim p_z(z)
Dans les tâches de génération d'images, l'objectif du Générateur est de projeter progressivement des représentations aléatoires de faible ou grande dimension en des images avec des structures visuelles spécifiques.
Le Discriminateur est noté D. Son entrée comprend les échantillons réels x de l'ensemble d'entraînement et les échantillons générés G(z) du Générateur. En apprenant les différences de caractéristiques entre les deux types de données, le Discriminateur sort la probabilité que l'échantillon d'entrée provienne de la distribution de données réelles :
D(x)\in[0,1]
Pour les échantillons réels, le Discriminateur espère que la sortie est proche de 1 ; pour les échantillons générés, le Discriminateur espère que la sortie est proche de 0. Le Générateur et le Discriminateur ont des objectifs d'optimisation opposés. Le Discriminateur doit améliorer continuellement sa capacité à distinguer les échantillons réels des échantillons générés, tandis que le Générateur doit améliorer continuellement l'authenticité des échantillons générés, les rendant plus similaires aux échantillons réels en termes de caractéristiques de données. Les deux réseaux forment une relation antagoniste pendant le processus d'optimisation alternée. L'article original définit l'objectif d'entraînement du GAN comme un jeu en minimax :
\min_G \max_D V(D,G)
=
\mathbb{E}_{x\sim p_{\mathrm{data}}(x)}
[\log D(x)]
+
\mathbb{E}_{z\sim p_z(z)}
[\log(1-D(G(z)]
Où $p_{\mathrm{data}}$ représente la distribution de données réelles, $p_z$ représente la distribution a priori de la variable aléatoire. Le Discriminateur $D$ améliore sa capacité à distinguer les échantillons réels des échantillons générés en maximisant la fonction objective ; le Générateur $G$ se rapproche progressivement de la distribution de données réelles en optimisant ses propres paramètres.
L'entraînement du GAN adopte généralement une approche d'optimisation alternée. D'abord, les échantillons réels et générés sont utilisés pour mettre à jour le Discriminateur $D$, lui permettant d'apprendre les différences entre les deux types de données ; puis, les informations de gradient du Discriminateur sont utilisées pour mettre à jour le Générateur $G$, permettant au Générateur d'améliorer progressivement les résultats de génération. À mesure que l'entraînement se poursuit, les capacités du Générateur et du Discriminateur changent simultanément, formant un processus d'apprentissage antagoniste dynamique.
Le Générateur et le Discriminateur remplissent différentes fonctions dans le GAN. Le Discriminateur est principalement utilisé dans la phase d'entraînement, fournissant des signaux d'optimisation pour le Générateur grâce à la classification vrai/faux ; une fois l'entraînement du modèle terminé, si la tâche est uniquement de générer de nouvelles images, seul le Générateur est nécessaire pour l'inférence :
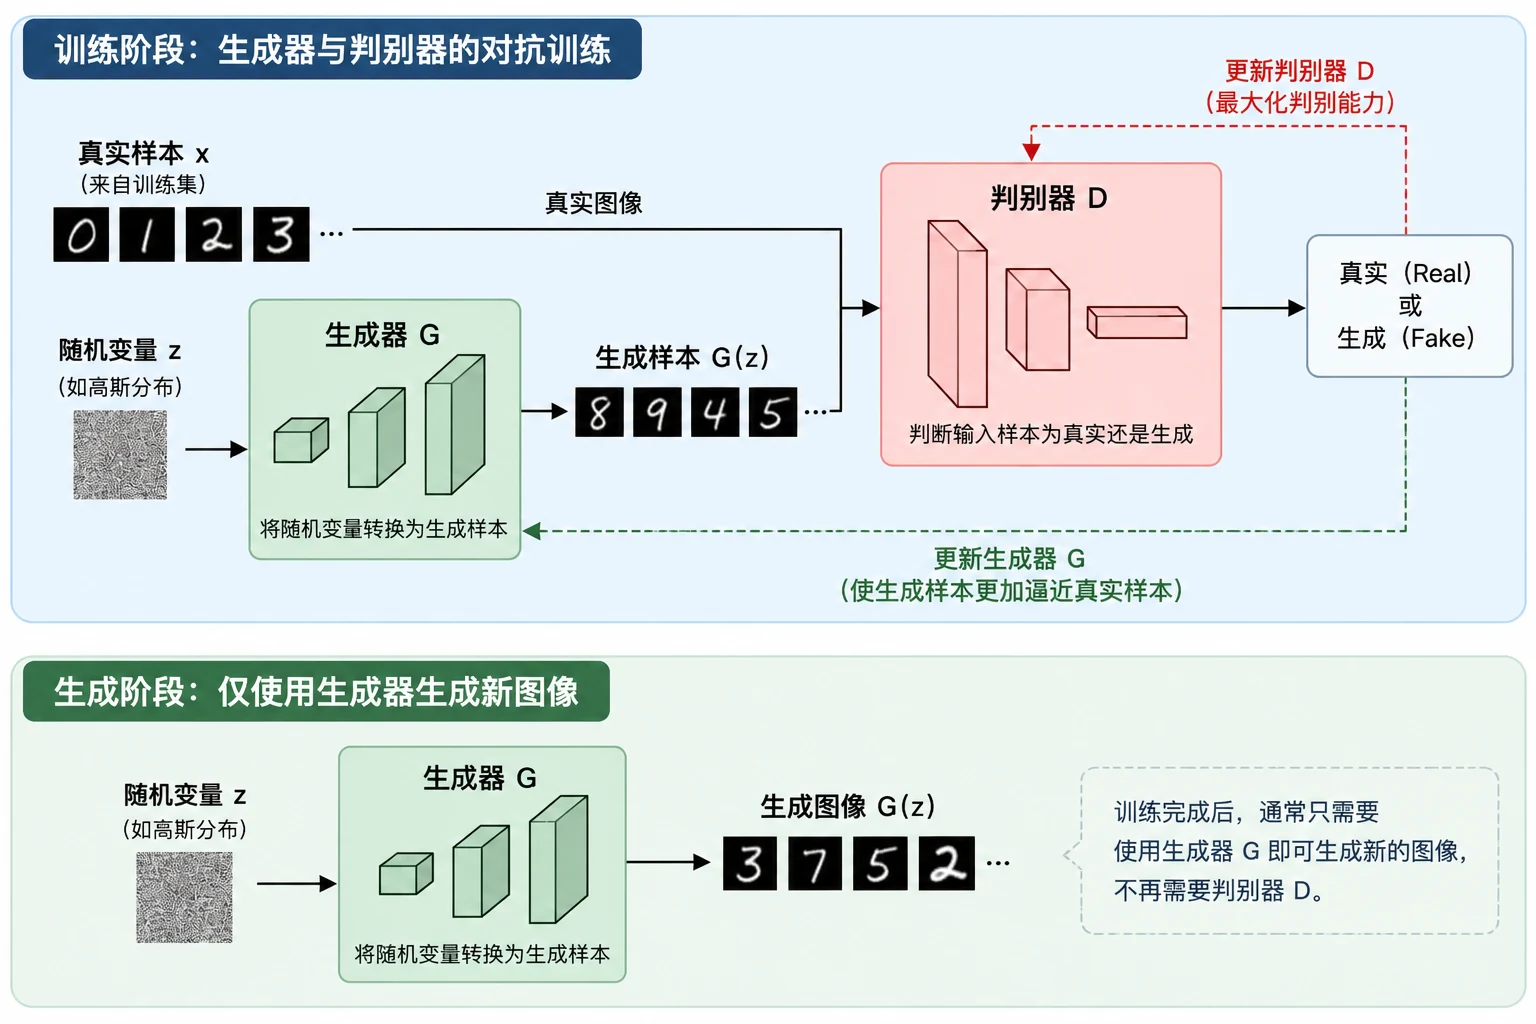
Le GAN a reçu une attention considérable dans le domaine de la génération d'images, et une raison importante est que son processus de génération est relativement direct. Une fois l'entraînement du modèle terminé, il suffit d'entrer des variables aléatoires dans le Générateur pour obtenir un résultat de génération via un seul calcul direct. Comparé aux modèles nécessitant une génération itérative multi-étapes, le GAN a généralement une efficacité de génération plus élevée, il est donc largement utilisé dans des tâches telles que la génération d'images, la super-résolution, l'amélioration vidéo et le traitement interactif d'images. Les avantages du GAN se manifestent principalement dans la phase de génération, tandis que son processus d'entraînement est relativement complexe, avec les problèmes suivants principaux.
Le GAN nécessite d'entraîner simultanément le Générateur et le Discriminateur, et les deux réseaux ont des objectifs d'optimisation mutuellement antagonistes. Lorsque les paramètres du Générateur changent, les données générées face au Discriminateur changent également ; lorsque les paramètres du Discriminateur changent, le signal d'optimisation reçu par le Générateur change également. Par conséquent, contrairement à l'apprentissage supervisé ordinaire qui optimise sous une fonction objective relativement fixe, l'entraînement du GAN est en réalité un processus de jeu dynamique en constante évolution. Si le Discriminateur est trop fort, les échantillons générés peuvent être facilement identifiés et le Générateur ne peut pas obtenir de signaux d'optimisation efficaces ; si le Discriminateur est trop faible, il ne peut pas refléter avec précision les différences entre les échantillons réels et les échantillons générés, et ne peut pas non plus fournir de retours d'entraînement efficaces au Générateur. Par conséquent, maintenir un état d'entraînement relativement stable entre le Générateur et le Discriminateur est un problème important dans l'entraînement des modèles GAN.
L'effondrement de mode est un autre problème typique de l'entraînement du GAN. Idéalement, le Générateur ne doit pas seulement générer des échantillons avec une haute qualité visuelle, mais doit également être capable de couvrir différents types et caractéristiques des données réelles. Par exemple, en supposant que les données d'entraînement contiennent des visages de différents âges, expressions et caractéristiques d'apparence, le Générateur doit être capable de produire des images de visages avec une diversité correspondante. Cependant, dans l'entraînement réel, le Générateur peut tendre à générer un petit nombre de catégories d'échantillons plus faciles à recevoir des évaluations plus élevées du Discriminateur, et à produire continuellement des résultats similaires. À ce stade, les images générées individuelles peuvent avoir une haute qualité visuelle, mais les différences entre un grand nombre de résultats générés sont faibles, incapables de couvrir pleinement la diversité des données réelles. L'effondrement de mode reflète un problème important des modèles génératifs : une haute qualité de génération d'échantillons uniques ne signifie pas que le modèle a complètement appris la distribution des données réelles.
Concernant les problèmes tels que l'instabilité de l'entraînement, l'effondrement de mode et la qualité de génération, les chercheurs ont amélioré le GAN sous plusieurs aspects, notamment la structure réseau, les fonctions de perte et les stratégies d'entraînement, formant un grand nombre de modèles dérivés. Ces études ont non seulement amélioré les capacités de génération du GAN, mais l'ont également fait évoluer progressivement de la génération d'images de base à différentes tâches telles que la traduction d'images, l'édition d'images contrôlable et la super-résolution d'images. Ci-dessous, à travers plusieurs modèles représentatifs, nous présentons les applications typiques du GAN dans ces domaines.
Avec le développement de la technologie GAN, son domaine d'application s'est progressivement élargi de la génération d'images aléatoires à des tâches telles que la traduction d'images, l'édition d'images et l'amélioration d'images. Différents modèles redésignent généralement les générateurs, discriminateurs, fonctions de perte ou méthodes d'entraînement pour des tâches spécifiques, formant des modèles dérivés GAN avec différentes fonctions. Parmi eux, CycleGAN, DragGAN, ESRGAN et Real-ESRGAN représentent respectivement les applications typiques du GAN dans la traduction d'images non appariées, l'édition d'images interactive et la super-résolution d'images.
En 2017, Zhu et al. ont proposé CycleGAN, principalement utilisé pour résoudre les problèmes de traduction d'images non appariées (Unpaired Image-to-Image Translation). Contrairement aux méthodes de traduction d'images nécessitant des échantillons d'entraînement appariés, CycleGAN ne nécessite pas de correspondance un à un entre les images source et cible ; il suffit de fournir séparément les données de deux domaines d'images pour apprendre la relation de traduction entre eux. Par exemple, dans la tâche de traduction cheval → zèbre, les méthodes traditionnelles nécessitent généralement de préparer des images de chevaux et de zèbres correspondantes, tandis que CycleGAN nécessite seulement de préparer séparément un ensemble d'images de chevaux et un ensemble d'images de zèbres, sans établir de correspondance entre les deux ensembles d'images. Comme illustré ci-dessous, CycleGAN est composé de deux générateurs et deux discriminateurs, apprenant simultanément la traduction d'images dans les deux directions. En supposant que les images de chevaux appartiennent au domaine d'images $X$, les images de zèbres appartiennent au domaine d'images $Y$, le Générateur $G$ est responsable de la traduction de $X$ à $Y$, et le Générateur $F$ est responsable de la traduction de $Y$ à $X$ :
G:X\rightarrow Y,\qquad F:Y\rightarrow X
Où le Discriminateur $D_Y$ est utilisé pour juger si les images de zèbres générées correspondent à la distribution des images de zèbres réelles, et le Discriminateur $D_X$ est utilisé pour juger si les images de chevaux générées correspondent à la distribution des images de chevaux réelles. Par conséquent, CycleGAN contient en réalité deux processus d'apprentissage antagoniste directionnels :
G + D_Y:Cheval → Zèbre
F + D_X:Zèbre → Cheval
L'entraînement antagoniste dans les deux directions seul ne peut pas garantir que les images traduites maintiennent la correspondance avec l'entrée originale. Par exemple, lors de la traduction d'une image de cheval en zèbre, bien que le résultat généré puisse avoir des textures de zèbre réalistes, la posture, la position ou la structure de l'arrière-plan du cheval peuvent changer considérablement. C'est-à-dire que la cohérence du contenu avant et après la traduction ne peut pas être entièrement garantie.
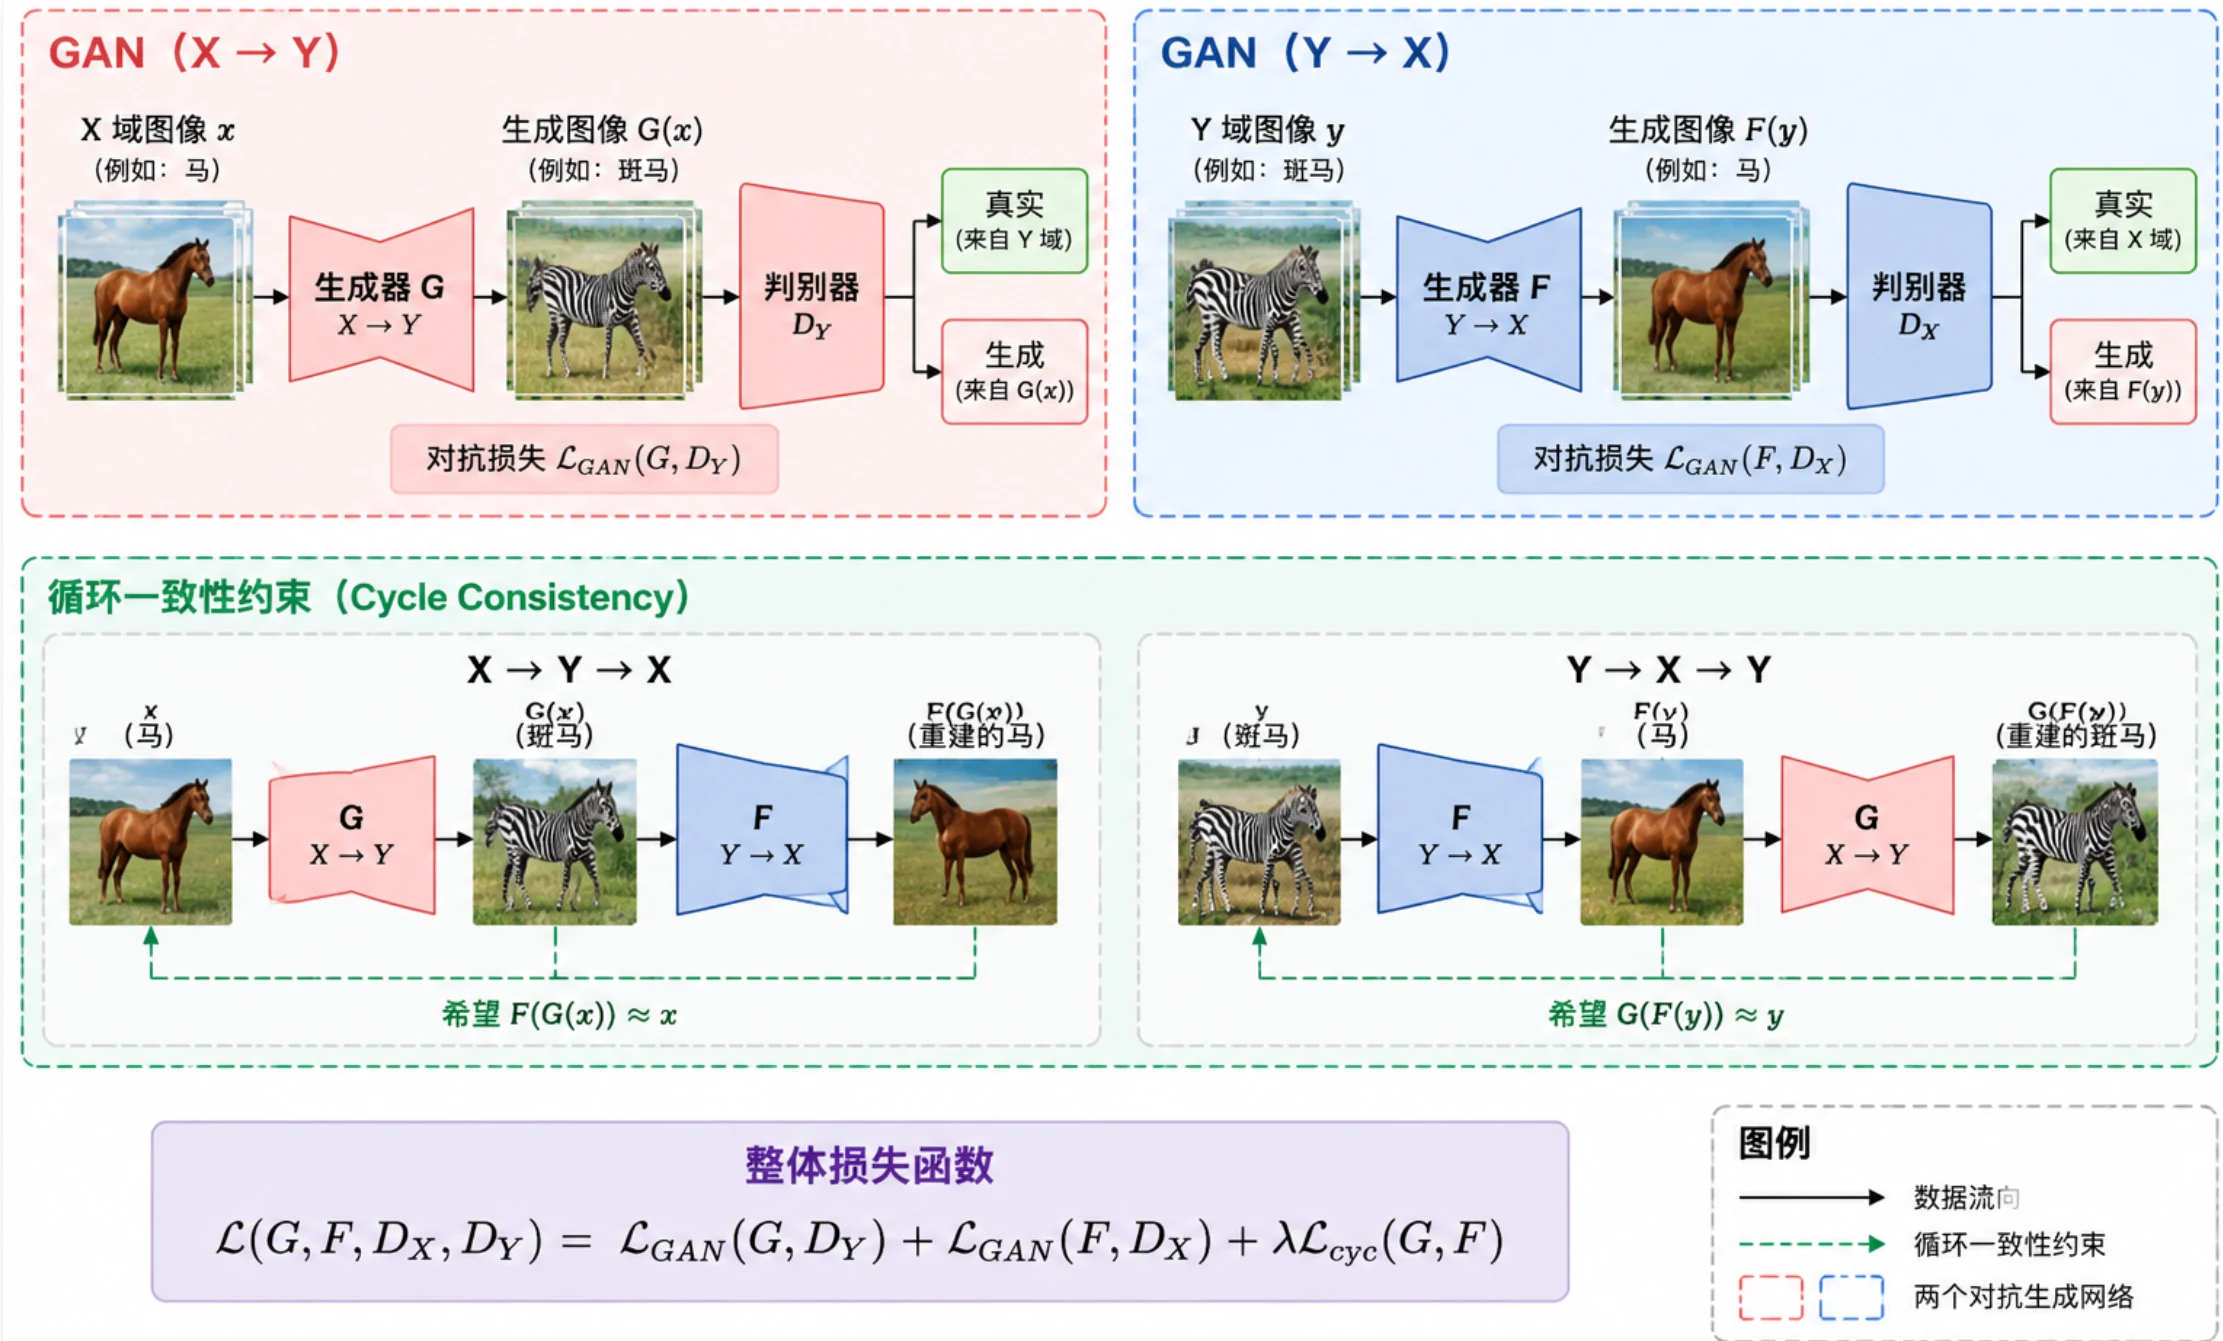
Pour cette raison, CycleGAN introduit davantage des contraintes de cohérence cyclique (Cycle Consistency). Comme illustré dans la partie inférieure de la figure, pour l'image de cheval $x$ dans le domaine d'images $X$, elle est d'abord traduite en image de zèbre $G(x)$ via le Générateur $G$, puis retraduite en image de cheval via le Générateur $F$ :
x\rightarrow G(x)\rightarrow F(G(x)
Après une traduction complète aller-retour, le résultat final doit être aussi proche que possible de l'image originale :
F(G(x)\approx x
De même, pour l'image de zèbre $y$ dans le domaine d'images $Y$, elle doit satisfaire :
G(F(y)\approx y
Par conséquent, le modèle forme deux cycles de traduction complets : Cheval → Zèbre → Cheval, Zèbre → Cheval → Zèbre. CycleGAN introduit une perte de cohérence cyclique pour contraindre les deux cycles :
\mathcal{L}_{\mathrm{cyc}}(G,F)
=
\mathbb{E}_{x\sim p_{\mathrm{data}}(x)}
\left[\|F(G(x)-x\|_1\right]
+
\mathbb{E}_{y\sim p_{\mathrm{data}}(y)}
\left[\|G(F(y)-y\|_1\right]
Où le premier terme contraint le résultat de reconstruction Cheval → Zèbre → Cheval, et le deuxième terme contraint le résultat de reconstruction Zèbre → Cheval → Zèbre. Plus la perte de cohérence cyclique est faible, plus l'image est proche de l'image originale en termes de contenu et de structure après traduction bidirectionnelle. L'entraînement de CycleGAN comprend principalement deux parties : l'apprentissage antagoniste et les contraintes de cohérence cyclique, qui agissent ensemble pour permettre à CycleGAN d'apprendre la relation de correspondance entre deux domaines d'images sans données d'entraînement appariées, réalisant ainsi des tâches telles que la traduction cheval-zèbre et le transfert de style d'image.
En 2023, Pan et al. ont proposé DragGAN, qui réalise l'ajustement interactif de la position, de la posture et de la forme des objets dans les images générées en définissant des points de contrôle et des points cibles dans l'image. Contrairement à l'édition traditionnelle au niveau des pixels, DragGAN ne déplace pas directement les pixels de l'image ; il ajuste plutôt la représentation latente du GAN, faisant changer l'image générée dans la direction spécifiée par l'utilisateur.
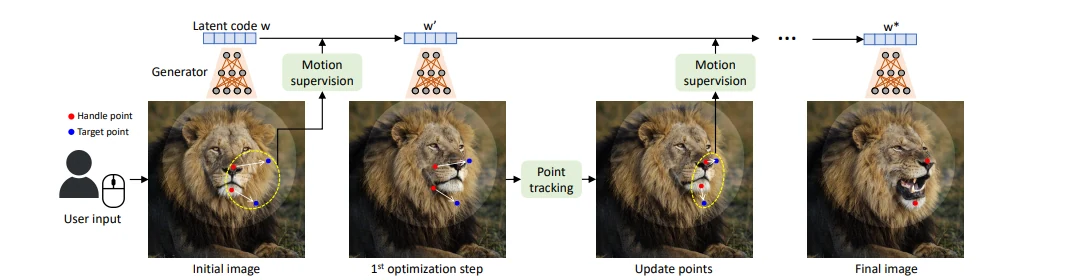
Le processus central de DragGAN comprend principalement la supervision du mouvement et le suivi des points. L'utilisateur sélectionne d'abord le point de contrôle à ajuster dans l'image et spécifie la position cible vers laquelle il souhaite se déplacer. Par exemple, dans la figure, en définissant des points de contrôle et des points cibles près de la gueule du lion, la gueule du lion s'ouvre progressivement.
Pendant le processus d'édition, DragGAN maintient les paramètres du Générateur pré-entraîné inchangés et optimise continuellement le code latent $w$ entré dans le Générateur. L'image initiale peut être représentée comme suit :
I = G(w)
Où $G$ représente le Générateur GAN pré-entraîné, $w$ représente le code latent correspondant à l'image. En ajustant $w$, le contenu et la structure de l'image générée $I$ peuvent être modifiés. La supervision du mouvement est utilisée pour pousser les caractéristiques de l'image près du point de contrôle vers la position cible. Après une optimisation, le code latent est mis à jour de $w$ à $w'$, et l'image générée change en conséquence. Comme la position originale du point de contrôle peut avoir changé après la modification de l'image, DragGAN doit également redéterminer la position du point de contrôle dans la nouvelle image via le suivi des points, puis continuer avec le prochain cycle d'optimisation, à savoir : définir le point de contrôle et le point cible → supervision du mouvement → optimiser le code latent → générer une nouvelle image → suivi des points et mise à jour du point de contrôle → continuer l'optimisation jusqu'à approcher la position cible. Après plusieurs itérations, le point de contrôle se déplace progressivement vers la position cible spécifiée par l'utilisateur, aboutissant finalement à l'image éditée. Comme ce processus est optimisé dans l'espace de génération appris par le GAN, le modèle ne modifie pas uniquement la position spécifiée, mais peut également effectuer des ajustements correspondants aux structures environnantes associées.
La clé de DragGAN n'est pas simplement de traîner des pixels ; elle convertit l'opération de traînage de l'utilisateur en une optimisation itérative de la représentation latente du GAN, et grâce à la supervision du mouvement et au suivi des points, contrôle la structure sémantique dans l'image pour se déplacer vers la position spécifiée. Cette méthode démontre la capacité d'application du GAN dans l'édition d'images contrôlable, permettant aux utilisateurs d'ajuster intuitivement la posture, l'expression et la forme des objets par des opérations basées sur des points.
La super-résolution d'images est l'une des directions d'application typiques du GAN, dont l'objectif est de générer des images avec une résolution plus élevée et des détails visuels plus riches à partir d'images basse résolution. Contrairement à un simple redimensionnement par interpolation, les modèles de super-résolution doivent reconstruire les textures haute fréquence et les structures locales manquantes en fonction du contenu de l'image existant. En 2018, Wang et al. ont proposé ESRGAN[ESRGAN], améliorant davantage la structure réseau, la perte antagoniste et la perte perceptuelle par rapport aux recherches existantes pour améliorer les performances de texture et la qualité visuelle des images de super-résolution.
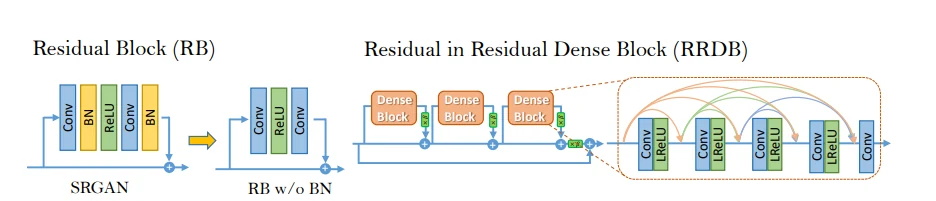
Une amélioration importante dans la structure réseau d'ESRGAN est l'introduction de la structure Residual-in-Residual Dense Block (RRDB). Le Générateur de SRGAN utilise principalement des blocs résiduels ordinaires (Residual Block, RB), qui comprennent des couches de convolution, la normalisation par lots (Batch Normalization, BN) et des fonctions d'activation. ESRGAN supprime d'abord la couche BN des blocs résiduels et combine davantage plusieurs modules de connexion dense en RRDB.
Comme on peut le voir dans la figure, le RRDB est internement composé de plusieurs Dense Blocks et combine les connexions denses avec les connexions résiduelles. À l'intérieur des Dense Blocks, différentes couches de convolution utilisent des connexions denses, les couches ultérieures pouvant recevoir et utiliser les caractéristiques extraites par les couches précédentes ; entre plusieurs Dense Blocks et à l'extérieur du RRDB, les caractéristiques sont transmises davantage via des connexions résiduelles. Cette structure peut renforcer la transmission d'informations et la réutilisation des caractéristiques entre différentes couches, améliorant la capacité de modélisation du réseau pour les textures et les caractéristiques détaillées des images. En plus des améliorations de la structure réseau, ESRGAN optimise également l'objectif d'entraînement. Les méthodes traditionnelles de super-résolution, si principalement entraînées avec une erreur au niveau des pixels, tendent à générer des résultats relativement lisses ; bien que l'erreur pixel soit plus faible, certaines textures haute fréquence et les bords ont tendance à devenir flous. ESRGAN combine davantage la perte perceptuelle et l'entraînement antagoniste, permettant aux résultats de génération d'obtenir des détails de texture plus clairs et plus naturels tout en maintenant le contenu global.
La super-résolution génératrice n'équivaut pas à récupérer les informations originales perdues. Lorsque certaines informations haute fréquence dans les images basse résolution ont été perdues, les pixels existants seuls ne peuvent généralement pas déterminer uniquement les détails originaux. ESRGAN combine en réalité l'image d'entrée avec les connaissances préalables sur les images acquises pendant l'entraînement pour générer des textures visuellement raisonnables. Les résultats générés peuvent être plus clairs, mais certains détails ne sont pas nécessairement entièrement cohérents avec l'image haute résolution originale. Cette caractéristique rend ESRGAN plus adapté aux tâches d'amélioration d'images mettant l'accent sur la qualité visuelle. Dans les scénarios nécessitant une grande authenticité de l'information tels que l'imagerie médicale, la police archivistique et les images de recherche scientifique, les résultats de super-résolution génératrice doivent être utilisés avec précaution.
Le GAN apprend la distribution des données réelles via un entraînement antagoniste entre le Générateur et le Discriminateur, tandis que l'auto-encodeur variationnel (Variational Autoencoder, VAE) adopte une approche de génération différente : encoder d'abord les données d'entrée dans un espace latent continu, puis échantillonner à partir de l'espace latent et générer ou reconstruire les données via un décodeur. En 2013, Kingma et Welling ont proposé la méthode Auto-Encoding Variational Bayes (AEVB) et ont fourni le cadre d'entraînement VAE subsequently largement utilisé. Le VAE combine les réseaux de neurones avec l'inférence variationnelle, permettant au modèle d'apprendre des représentations latentes avec une structure probabiliste via un entraînement de bout en bout.
La structure de base du VAE est composée d'un encodeur et d'un décodeur. L'encodeur est responsable de compresser les données d'entrée dans un espace latent de dimension inférieure, tandis que le décodeur restaure les données d'entrée en fonction des représentations latentes. Les auto-encodeurs ordinaires encodent généralement l'entrée $x$ directement en un vecteur latent déterministe $z$, puis utilisent le décodeur pour la reconstruction. La plus grande différence entre le VAE et les auto-encodeurs ordinaires est que l'encodeur ne sort pas directement un vecteur latent déterministe ; il sort plutôt les paramètres de la distribution de probabilité de la variable latente.
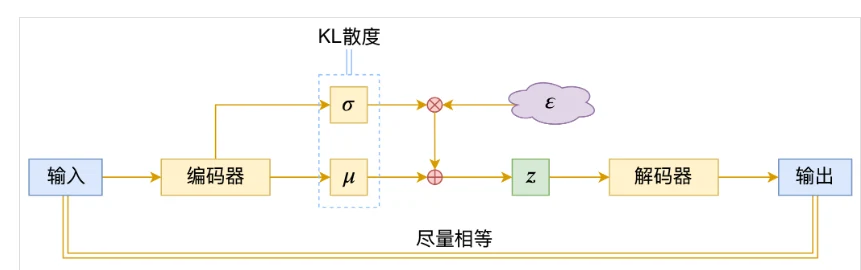
Dans la figure ci-dessus, l'encodeur du VAE ne convertit pas directement les données d'entrée $x$ en un vecteur latent fixe ; il sort également deux paramètres : la moyenne $\mu$ et l'écart-type $\sigma$. Ces deux paramètres déterminent ensemble la distribution de probabilité de la variable latente $z$. $\mu$ détermine approximativement où se trouve la variable latente, et $\sigma$ indique l'étendue de variation possible autour de cette position.
Le VAE modélise la variable latente comme une distribution gaussienne :
q_{\phi}(z\mid x)
=
\mathcal{N}
\left(
z;\mu_{\phi}(x),
\operatorname{diag}\left(\sigma_{\phi}^{2}(x)\right)
\right)
Où $q_{\phi}(z\mid x)$ représente la distribution de variable latente obtenue par l'encodeur en fonction de l'entrée $x$. Contrairement aux auto-encodeurs ordinaires qui obtiennent directement un $z$ déterministe, le VAE obtient une distribution pouvant être échantillonnée, de sorte que la même entrée peut donner différentes représentations latentes dans une certaine plage. Ensuite, le modèle doit obtenir une variable latente spécifique $z$ à partir de cette distribution et l'envoyer au décodeur. Pour introduire de l'aléatoire tout en garantissant que le modèle peut effectuer normalement la rétropropagation, le VAE utilise l'astuce de reparamétrisation. Le modèle échantillonne d'abord une variable aléatoire $\epsilon$ à partir d'une distribution normale standard, puis combine $\mu$ et $\sigma$ obtenus par l'encodeur pour calculer la variable latente $z$ :
z=\mu+\sigma\odot\epsilon
On peut comprendre que $\mu$ détermine la position, $\sigma$ détermine l'étendue de variation, et $\epsilon$ fournit l'aléatoire ; ensemble, ils produisent la variable latente finale $z$. Cette approche sépare l'échantillonnage aléatoire du processus de calcul des paramètres réseau, permettant aux gradients de toujours se propager via $z$ jusqu'à l'encodeur, permettant ainsi l'entraînement de bout en bout du VAE complet. Après avoir obtenu la variable latente $z$, le décodeur génère le résultat de reconstruction $\hat{x}$ en fonction de $z$. L'ensemble du processus du VAE peut être résumé comme suit : données d'entrée → encodeur → distribution latente → échantillonnage pour obtenir $z$ → décodeur → données reconstruites.
Le VAE doit également considérer simultanément deux objectifs pendant l'entraînement : d'une part, il espère que les résultats générés par le décodeur sont aussi proches que possible de l'entrée originale ; d'autre part, il espère que les distributions latentes correspondant à différentes entrées ne sont pas trop désordonnées mais forment un espace latent relativement continu et régulier. Par conséquent, l'objectif d'entraînement du VAE est composé à la fois du terme de reconstruction et du terme de divergence KL, généralement représenté par la borne inférieure de la preuve (Evidence Lower Bound, ELBO) :
\mathcal{L}_{\mathrm{ELBO}}
=
\mathbb{E}_{q_{\phi}(z\mid x)}
\left[
\log p_{\theta}(x\mid z)
\right]
-
D_{\mathrm{KL}}
\left(
q_{\phi}(z\mid x)
\parallel
p(z)
\right)
Où le premier terme peut être compris comme la qualité de la reconstruction, mesurant si le décodeur peut restaurer les données d'entrée en fonction de $z$ ; le deuxième terme peut être compris comme la régularité de l'espace latent, contraignant la distribution latente obtenue par l'encodeur via la divergence KL pour la rendre proche de la distribution a priori prédéfinie. Ces deux objectifs doivent fonctionner ensemble. Si on se concentre uniquement sur la qualité de reconstruction, bien que le modèle puisse bien restaurer l'entrée, l'espace latent peut être assez dispersé, rendant inconvenient l'échantillonnage direct ; après avoir ajouté les contraintes de divergence KL, les représentations latentes de différents échantillons sont contraintes par une distribution a priori unifiée, rendant l'espace latent plus régulier et plus adapté à l'échantillonnage et à la génération.
Du point de vue du processus de génération, le VAE possède déjà des capacités de génération complètes. Après l'entraînement, au lieu de saisir l'image originale, on peut directement échantillonner la variable latente $z$ à partir d'une distribution normale standard et la saisir dans le décodeur pour générer de nouvelles images. Théoriquement, ce processus peut fonctionner car pendant l'entraînement, la distribution latente générée par l'encodeur est continuellement contrainte via la divergence KL pour se rapprocher de la distribution normale standard prédéfinie. Cependant, dans l'entraînement réel, la distribution latente générée par l'encodeur ne peut généralement pas correspondre exactement à la distribution normale standard. Si la contrainte est trop forte, bien que l'espace latent soit plus régulier, certaines informations de l'image peuvent être perdues ; si la contrainte est trop faible, la distribution de l'espace latent peut ne pas être assez régulière, faisant que le $z$ obtenu par échantillonnage direct à partir de la distribution normale standard tombe dans des régions non familières du modèle, affectant ainsi les résultats de décodage.
Parallèlement, le VAE doit trouver un équilibre entre la qualité de reconstruction et la régularité de l'espace latent. L'objectif d'entraînement du VAE classique met davantage l'accent sur la modélisation de la distribution globale des données et de l'espace latent, tendant à perdre certaines textures haute fréquence et détails locaux lors de la génération d'images, les résultats générés étant souvent relativement lisses. C'est également une distinction évidente entre le VAE et le GAN en termes d'efficacité de génération d'images. Le GAN contraint directement l'authenticité des images générées via le discriminateur, produisant généralement des textures plus nettes ; le VAE se concentre davantage sur la continuité et la structure probabiliste de l'espace latent, avec certaines limitations dans la génération directe d'images de haute qualité.
Avec le développement des modèles génératifs, le rôle du VAE a progressivement évolué de la génération directe d'images finales à un outil d'encodage et de décodage entre l'espace image et l'espace latente. Une application représentative est le modèle de diffusion latente (Latent Diffusion Model, LDM). Les premiers modèles de diffusion effectuaient directement l'ajout de bruit et le débruitage dans l'espace pixel. Lorsque la résolution de l'image est élevée, le modèle doit traiter à plusieurs reprises un grand nombre de pixels, entraînant des coûts de calcul élevés. Le modèle de diffusion latente proposé par Rombach et al. transfère le processus de diffusion dans un espace latent compressé, réduisant ainsi les dimensions de données que le modèle de diffusion doit traiter. Dans cette structure, l'encodeur compresse d'abord l'image originale en une représentation latente : image originale → encodeur → représentation latente. Ces représentations latentes ne sauvegardent plus directement chaque pixel, mais retiennent la structure principale et les informations visuelles de l'image sous une forme plus compacte. Ensuite, le modèle de diffusion effectue l'ajout de bruit et le débruitage dans cet espace latent au lieu de traiter directement l'image haute résolution originale. Lorsque le modèle de diffusion termine la génération, le décodeur restaure la représentation latente générée dans l'espace pixel : représentation latente générée → décodeur → image finale. Le VAE est responsable de la compression et de la restauration des images, tandis que le modèle de diffusion est responsable de la génération du contenu de l'image dans l'espace latente. Cette approche exploite pleinement la capacité de représentation latente du VAE. Le modèle de diffusion ne traite plus les pixels originaux haute dimension, mais les caractéristiques d'image compressées, réduisant ainsi considérablement le coût de calcul des processus ultérieurs de diffusion et de débruitage.
Le VAE lui-même présente certaines limites dans la génération directe d'images de haute qualité, mais son encodeur, son espace latent et sa structure de décodeur sont devenus des composants importants des modèles de diffusion latente modernes. Cela reflète également l'évolution du rôle du VAE : progressivement d'un modèle génératif indépendant à un module de représentation latente dans les systèmes de génération d'images de haute qualité.
Le GAN utilise typiquement le générateur pour compléter la génération d'images via un seul calcul direct, et le VAE peut également partir de variables latentes pour obtenir directement les résultats de génération via le décodeur. Pour des images haute dimension complexes, faire en sorte que le modèle termine le mapping des variables aléatoires aux images complètes en une étape n'est pas facile. Les modèles de diffusion adoptent une approche différente, divisant la tâche complexe de génération d'images en plusieurs étapes relativement simples, chaque étape n'effectuant qu'un petit ajustement au résultat actuel, obtenant progressivement l'image complète après plusieurs itérations. Le modèle n'est pas tenu de générer le résultat final en une étape ; il complète progressivement la génération par plusieurs étapes de débruitage.
Les modèles de diffusion contiennent principalement deux processus dans des directions opposées : la diffusion vers l'avant et le débruitage vers l'arrière. La diffusion vers l'avant commence par les données réelles $x_0$ et ajoute continuellement de petites quantités de bruit aléatoire. À mesure que le pas de temps $t$ augmente, l'information originale dans l'image diminue progressivement et le bruit augmente, s'approchant finalement du bruit gaussien aléatoire. Dans le DDPM classique, des données bruitées à n'importe quel pas de temps peuvent être directement construites à partir des données originales $x_0$ :
x_t
=
\sqrt{\bar{\alpha}_t}x_0
+
\sqrt{1-\bar{\alpha}_t}\epsilon
Où :
\epsilon\sim\mathcal{N}(0,I)
,
x_0
représente les données originales, $\epsilon$ représente le bruit gaussien aléatoire, $\bar{\alpha}_t$ est utilisé pour contrôler la proportion de données originales et de bruit au pas de temps actuel. Plus le pas de temps est avancé, moins il y a d'information originale et plus il y a de bruit. Différents pas de temps correspondent à différents niveaux de bruit, et la façon dont ces niveaux de bruit évoluent est déterminée par la stratégie de planification du bruit.
La diffusion vers l'avant elle-même n'a pas besoin d'apprentissage du modèle. Pendant l'entraînement, des données avec différents niveaux de bruit peuvent être directement construites selon des règles prédéfinies. Ce que le modèle doit réellement apprendre est le processus opposé, c'est-à-dire comment récupérer progressivement des données plus claires à partir de données bruitées. Pendant la génération, le modèle part du bruit aléatoire, effectuant un certain degré de débruitage à chaque étape : bruit aléatoire → structure préliminaire → contour devenant progressivement clair → texture se formant progressivement → image finale. Ce mécanisme divise une tâche de génération complexe qui serait accomplie en une seule étape en plusieurs tâches de correction locale relativement simples. Le modèle n'a pas besoin de prédire l'image complète en une fois ; il doit s'ajuster en continu en fonction de l'état actuel, ce qui est l'une des raisons importantes pour lesquelles les modèles de diffusion peuvent réaliser une génération de haute qualité.
Dans le DDPM classique, deux processus dans des directions opposées sont établis : le processus de diffusion vers l'avant ajoute continuellement du bruit aux données réelles, tandis que le processus de génération vers l'arrière apprend comment éliminer progressivement le bruit, permettant au bruit aléatoire de finalement revenir à des images avec des caractéristiques de données réelles.
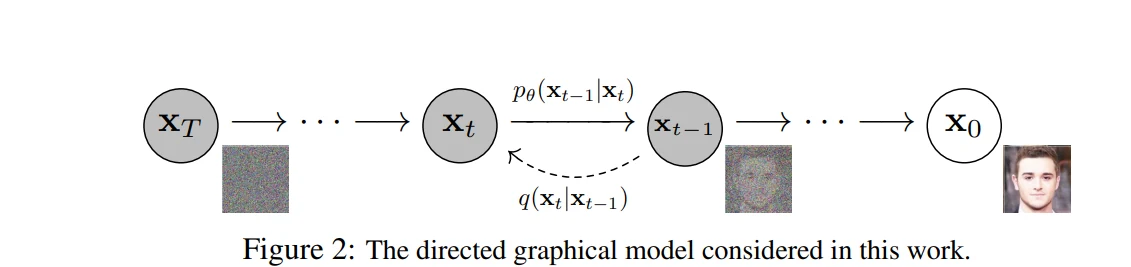
$x_0$ représente l'image réelle. À mesure que la diffusion vers l'avant ajoute continuellement du bruit gaussien, les données passent par $x_1,x_2,\ldots,x_T$ en séquence, et finalement $x_T$ s'approche du bruit gaussien aléatoire. La ligne pointillée $q(x_t\mid x_{t-1})$ dans la figure représente le processus de diffusion vers l'avant, tandis que $p_\theta(x_{t-1}\mid x_t)$ représente le processus de génération vers l'arrière que le modèle doit apprendre. Le processus vers l'avant peut être compris comme : image réelle x₀ → x₁ → x₂ → …… → xₜ → …… → bruit aléatoire xT, tandis que la génération réelle d'images procède dans la direction opposée : bruit aléatoire xT → …… → xₜ → xₜ₋₁ → …… → image finale x₀. La question clé du DDPM est de savoir comment faire en sorte que le modèle apprenne à obtenir $x_{t-1}$ avec moins de bruit à partir du $x_t$ actuel.
Dans le DDPM, le processus vers l'arrière est paramétré par un réseau de neurones. Une approche importante et couramment utilisée est de faire en sorte que le réseau de neurones prédise le bruit ajouté à $x_t$. Pendant l'entraînement, à partir de l'image réelle $x_0$, un pas de temps $t$ aléatoire est sélectionné et du bruit gaussien
\epsilon\sim\mathcal{N}(0,I)
est échantillonné. Selon le processus de diffusion vers l'avant, l'image bruitée correspondant au pas de temps $t$ peut être directement construite :
x_t
=
\sqrt{\bar{\alpha}_t}x_0
+
\sqrt{1-\bar{\alpha}_t}\epsilon
Ensuite, l'image bruitée $x_t$ et le pas de temps $t$ sont entrés dans le réseau de neurones, et le modèle prédit le bruit
\epsilon_\theta(x_t,t)
, où $\theta$ représente les paramètres du réseau de neurones. Étant donné que le bruit réel $\epsilon$ ajouté pendant l'entraînement est connu, la différence entre le bruit prédit par le modèle et le bruit réel peut être directement comparée. Le processus d'entraînement du DDPM peut être compris comme : d'abord ajouter activement différents niveaux de bruit aux images réelles, puis entraîner le modèle à identifier quel bruit a été ajouté. Après un entraînement approfondi, le modèle peut traiter les données à différents pas de temps et différents niveaux de bruit, et utiliser les résultats de prédiction de bruit pour construire le processus vers l'arrière $p_\theta(x_{t-1}\mid x_t)$ illustré dans la figure. Pendant la phase de génération, les images réelles ne sont plus nécessaires ; à la place, en partant directement du bruit gaussien, le modèle obtient d'abord $x_{T-1}$ avec moins de bruit à partir de $x_T$, puis obtient $x_{T-2}$ à partir de $x_{T-1}$, et ainsi de suite :
x_T
\rightarrow
x_{T-1}
\rightarrow
x_{T-2}
\rightarrow
\cdots
\rightarrow
x_1
\rightarrow
x_0
.
À mesure que le processus vers l'arrière se poursuit, la structure globale, le contour et la texture de l'image émergent progressivement du bruit aléatoire, aboutissant finalement à l'image générée complète. Le DDPM ne fait pas prédire au modèle l'image complète à partir du bruit en une seule fois ; il apprend plutôt les capacités de débruitage à différents niveaux de bruit, puis complète progressivement la génération par plusieurs itérations vers l'arrière. Cette approche réduit la difficulté des tâches de génération en une seule étape et évite l'entraînement antagoniste entre le générateur et le discriminateur dans le GAN. Cependant, l'échantillonnage multi-étapes signifie que générer une image nécessite plusieurs exécutions d'inférence de réseau de neurones, la lenteur de l'inférence est donc également devenue l'une des principales limitations du DDPM classique.
Le DDPM décrit la génération d'images comme un processus de débruitage étape par étape, ajoutant du bruit aux données réelles pendant l'entraînement et faisant en sorte que le modèle apprenne à prédire le bruit ; pendant la génération, en partant du bruit aléatoire, l'image est progressivement obtenue par plusieurs étapes de débruitage vers l'arrière. Le Flow Matching adopte une approche descriptive différente. Il construit un chemin de probabilité continu entre la distribution de bruit aléatoire et la distribution de données réelles, et entraîne le modèle à apprendre la direction de changement le long de ce chemin, permettant au bruit aléatoire de se transformer progressivement en données réelles selon la direction apprise.
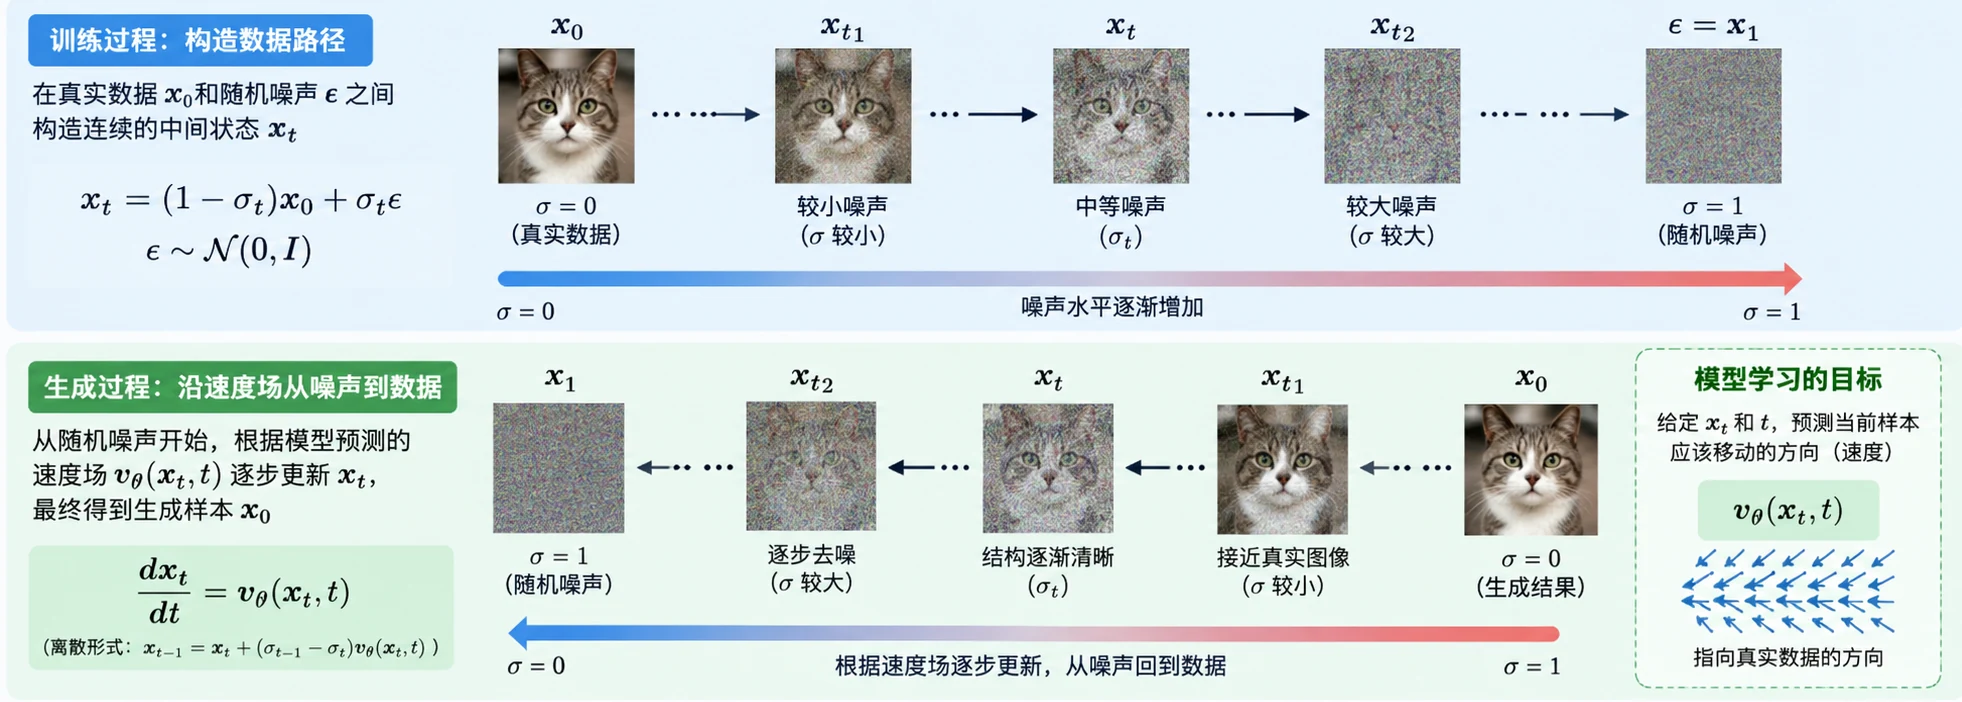
Du point de vue du processus d'implémentation, le Flow Matching comprend principalement trois étapes : la construction du chemin, l'apprentissage du champ de vitesse et l'échantillonnage de génération.
Pendant l'entraînement, un échantillon $x_0$ est d'abord échantillonné à partir de la distribution de données réelles, et du bruit aléatoire $\epsilon$ est échantillonné à partir d'une distribution gaussienne standard. Pour établir une connexion entre les données réelles et le bruit aléatoire, une série d'états intermédiaires continus peut être construite entre eux. Une approche relativement intuitive est d'utiliser l'interpolation linéaire :
x_t=(1-\sigma_t)x_0+\sigma_t\epsilon
, où $\sigma_t$ contrôle la proportion de données réelles et de bruit aléatoire dans l'état actuel. Pour faciliter l'illustration, posons :
\sigma_0=0,\qquad \sigma_1=1
, lorsque $\sigma_t=0$ :
x_t=x_0
Cela correspond aux données réelles ; lorsque $\sigma_t=1$ :
x_t=\epsilon
Cela correspond au bruit aléatoire.
À mesure que $\sigma_t$ augmente progressivement de 0 à 1, $x_t$ peut représenter une série d'états intermédiaires continus entre les données réelles et le bruit aléatoire : données réelles → léger bruit → bruit modéré → fort bruit → bruit aléatoire. Pendant l'entraînement, en sélectionnant aléatoirement différents $t$, des états intermédiaires à différentes positions peuvent être obtenus, fournissant des échantillons d'entraînement pour que le modèle apprenne les schémas de changement le long du chemin complet. Comparé au processus d'ajout de bruit étape par étape prédéfini dans le DDPM, le Flow Matching s'intéresse davantage à la façon de définir le chemin continu reliant deux distributions et à la façon dont les données doivent changer le long de ce chemin.
Après avoir construit le chemin continu, l'étape suivante consiste à déterminer la direction et la vitesse des changements de données sur le chemin. Le Flow Matching utilise un réseau de neurones pour apprendre un champ de vitesse (Velocity Field)
v_\theta(x_t,t)
, où $x_t$ représente l'état intermédiaire actuel, $\sigma_t$ représente la position temporelle actuelle, et $v_\theta(x_t,t)$ représente la vitesse de changement prédite par le modèle à la position actuelle. Pour le chemin linéaire ci-dessus :
x_t=(1-\sigma_t)x_0+\sigma_t\epsilon
Pendant l'entraînement, la vitesse cible peut être obtenue à partir des données réelles $x_0$ et du bruit aléatoire $\epsilon$ connus, et le réseau de neurones peut être entraîné à prédire la vitesse correspondante en fonction de l'état actuel $x_t$ et du temps $\sigma_t$. L'objectif d'entraînement du Flow Matching est d'entraîner le modèle à prédire la vitesse de changement des données correspondant à une position, étant donné l'état intermédiaire $x_t$ et le temps $\sigma_t$ sur le chemin. Après que le modèle a appris sur un grand nombre d'échantillons d'entraînement, les vitesses à différentes positions forment ensemble un champ de vitesse. Ce champ de vitesse décrit comment les données doivent changer à différentes positions dans l'espace de données, fournissant ainsi une direction pour la génération ultérieure de données à partir de bruit aléatoire.
La phase d'entraînement établit le chemin entre les données réelles et le bruit aléatoire et apprend le champ de vitesse sur le chemin. La phase de génération part du bruit aléatoire et utilise le champ de vitesse appris pour se déplacer progressivement vers la distribution de données réelles. Ce processus peut être représenté comme suit : bruit aléatoire → état intermédiaire → structure de données se formant progressivement → données générées finales,
x_{t-1}
=
x_t+
(\sigma_{t-1}-\sigma_t)
v_\theta(x_t,t)
Le modèle recalcule la vitesse à chaque pas de temps en fonction de l'état actuel et met à jour $x_t$. Après plusieurs itérations, le bruit aléatoire initial se transforme progressivement en données générées avec une structure et des informations sémantiques complètes.
Du point de vue de la modélisation, le DDPM et le Flow Matching utilisent tous deux des distributions aléatoires simples comme point de départ de la génération, mais leur description du processus de génération diffère. Le DDPM décrit principalement les changements de données par la diffusion vers l'avant et le débruitage vers l'arrière, apprenant typiquement la prédiction de bruit ; le Flow Matching construit un chemin continu reliant le bruit et les données réelles, apprend le champ de vitesse sur le chemin, puis part du bruit aléatoire et génère progressivement des données le long du champ de vitesse.
Le texte vers image (Text-to-Image) consiste à générer automatiquement des images correspondantes à partir de descriptions en langage naturel. Contrairement à la génération d'images ordinaire, le texte vers image nécessite non seulement que le modèle génère des images avec une haute qualité visuelle, mais aussi qu'il comprenne correctement le sujet, les attributs, la quantité, la position, le style dans le texte et les relations entre différents objets. Pendant le développement du texte vers image, l'accent technique s'est également progressivement déplacé de « peut-on générer des images à partir de texte » à « peut-on comprendre avec précision des instructions complexes et compléter la génération avec une qualité plus élevée, une efficacité plus élevée et une contrôlabilité plus forte ».
Les premières recherches sur le texte vers image étaient principalement basées sur des modèles génératifs tels que le GAN. La méthode de base était d'abord d'encoder le texte en vecteurs, puis d'utiliser les caractéristiques du texte comme entrée conditionnelle au générateur,使得 les résultats de génération soient cohérents avec les descriptions textuelles. Cette étape a démontré la faisabilité du texte vers image, mais les premiers GAN présentaient encore des limites évidentes dans la génération de scènes complexes, la compréhension sémantique du texte et la stabilité de l'entraînement. Surtout lorsque les prompts contenaient plusieurs sujets, des relations spatiales complexes ou des descriptions textuelles plus longues, le modèle avait du mal à restaurer avec précision toutes les sémantiques. En 2021, OpenAI a publié DALL·E, utilisant une approche autorégressive basée sur le Transformer pour traiter les Tokens texte et image, permettant aux modèles texte vers image de réaliser des progrès significatifs dans les combinaisons de concepts complexes, le contrôle des attributs, etc., et poussant également le développement des modèles texte vers image à grande échelle. En même temps, les modèles de diffusion ont commencé à entrer dans le domaine du texte vers image. GLIDE a combiné les conditions textuelles avec les modèles de diffusion et a étudié le CLIP Guidance et le Classifier-Free Guidance, démontrant que les modèles de diffusion pouvaient générer des images avec une haute qualité visuelle sous contrôle textuel. En 2022, Imagen de Google a further combiné les capacités de compréhension textuelle des grands modèles de langage avec les capacités de génération d'images des modèles de diffusion. Imagen utilisait le T5 pré-entraîné comme encodeur de texte, convertissant les Prompts en représentations sémantiques textuelles, puis les utilisait comme entrée conditionnelle au modèle de diffusion. Les recherches ont montré que renforcer la capacité de compréhension sémantique de l'encodeur de texte pouvait further améliorer la cohérence entre les images générées et les descriptions textuelles. Avec le développement de modèles tels que DALL·E, GLIDE et Imagen, le texte vers image a progressivement formé un flux technique relativement clair : encodeur de texte → représentation sémantique textuelle → modèle de génération par diffusion → débruitage progressif → image générée ; les modèles de diffusion, avec leur bonne qualité de génération et stabilité d'entraînement, sont progressivement devenus une route technique importante dans le domaine du texte vers image.
Les premiers modèles de diffusion effectuaient typiquement plusieurs ajouts de bruit et débruitages directement dans l'espace pixel. À mesure que la résolution de l'image augmentait, le traitement direct d'un grand nombre de pixels entraînait des coûts d'entraînement et d'inférence élevés. En 2022, Rombach et al. ont proposé le modèle de diffusion latente (Latent Diffusion Model, LDM), transférant le processus de diffusion de l'espace pixel à un espace latent compressé (voir l'introduction du LDM dans 14.4.3). L'importance de Stable Diffusion ne réside pas seulement dans l'amélioration de la qualité du texte vers image, mais aussi dans la promotion du développement d'un écosystème texte vers image à poids ouverts. Autour de son architecture de diffusion latente, un grand nombre de technologies d'extension se sont progressivement formées, notamment LoRA, ControlNet, l'image vers image et le redraw local, faisant évoluer le texte vers image d'un simple outil de génération d'images à un système complet de production de contenu visuel.
Les premiers modèles de diffusion utilisaient typiquement U-Net comme réseau de débruitage. U-Net, grâce à l'extraction de caractéristiques multi-échelles et aux connexies de franchissement, pouvait relativement bien préserver la structure spatiale des images, il était donc longtemps utilisé comme réseau dorsal important pour les modèles de diffusion. Avec l'expansion continue de l'échelle des modèles génératifs, les chercheurs ont commencé à explorer l'utilisation de Transformers pour remplacer U-Net afin d'obtenir une meilleure scalabilité du modèle. En 2022, Peebles et Xie ont proposé le Diffusion Transformer (DiT), utilisant des Transformers pour remplacer le réseau dorsal U-Net couramment utilisé dans les modèles de diffusion. Le modèle divise d'abord la représentation de l'image dans l'espace latent en plusieurs Patches et les convertit en séquences de Tokens, puis utilise les Transformers pour modéliser ces Tokens. L'architecture DiT est illustrée ci-dessous :
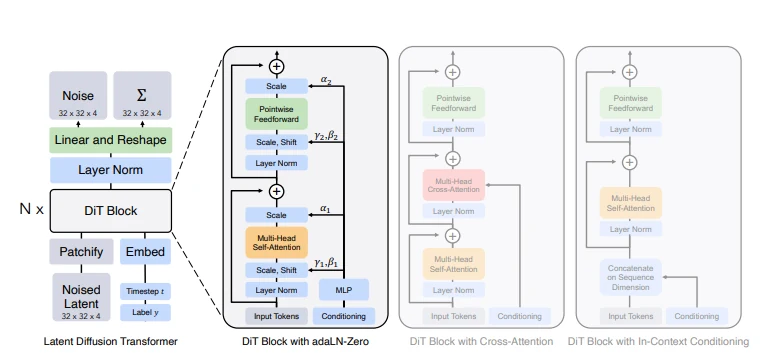
La recherche DiT a further montré que l'échelle de calcul du modèle pouvait être élargie en augmentant la profondeur, la largeur et le nombre de Tokens d'entrée du Transformer. Dans les expériences de l'article original, à mesure que le volume de calcul du modèle augmentait, la qualité de génération présentait généralement une tendance d'amélioration continue, démontrant que l'architecture Transformer possède une bonne scalabilité dans les modèles de diffusion. L'importance de DiT ne réside pas seulement dans le remplacement de U-Net par des Transformers, mais plus important encore dans la fourniture d'une nouvelle infrastructure pour les modèles de génération d'images à grande échelle ultérieurs. Depuis, les Transformers sont progressivement devenus une route technique importante pour les modèles texte vers image, et se sont davantage développés en architectures multimodales de Transformers traitant simultanément les Tokens texte et image, jetant les bases des modèles texte vers image de nouvelle génération tels que Stable Diffusion 3 et FLUX.1.
Avec les Transformers devenant progressivement un réseau dorsal important pour les modèles texte vers image, le processus de génération d'images lui-même évolue continuellement. Le DDPM précédemment introduit décrit principalement la génération de données par « ajout de bruit vers l'avant — apprentissage du processus vers l'arrière — débruitage progressif », tandis que le Flow Matching décrit le processus de transformation des distributions simples vers les distributions de données réelles du point de vue des chemins de probabilité continus et des champs de vitesse. En 2024, la recherche liée à Stable Diffusion 3 a further combiné le Rectified Flow avec les Transformers pour le texte vers image haute résolution. Ce travail a proposé une nouvelle architecture Multimodal Diffusion Transformer (MMDiT).
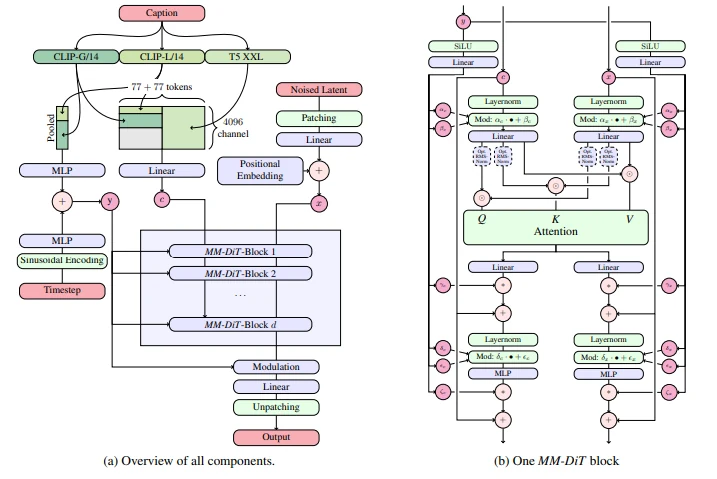
Contrairement aux premiers DiT qui traitaient principalement les Tokens latents d'image, le MMDiT traite les représentations texte et image en utilisant des paramètres indépendants, tout en réalisant l'interaction d'informations entre les deux modalités via une attention conjointe, améliorant ainsi la capacité du modèle à comprendre le contenu textuel, le rendu de texte et les prompts complexes. Le FLUX.1 publié la même année a continué la route technique combinant Transformers et Flow Matching. Les modèles de la série FLUX.1 adoptent une architecture hybride composée de blocs Transformer multimodaux et de blocs Diffusion Transformer parallèles, et sont entraînés sur la base du Flow Matching. Le modèle FLUX.1 public atteint une échelle de 12B paramètres, reflétant further la tendance des modèles de génération d'images Transformer vers le développement à grande échelle. À partir de cette étape, l'accent technique des modèles texte vers image ne se limite plus à l'amélioration de la qualité visuelle des images, mais s'est progressivement étendu à des directions telles que la compréhension de prompts complexes, la génération de texte dans les images, la génération haute résolution, l'échantillonnage en quelques étapes et l'édition d'images. Le texte et l'image sont également entrés de plus en plus sous forme de Tokens dans les Transformers, réalisant l'interaction d'informations inter-modales via les mécanismes d'attention. Ce changement a également jeté les bases de modèles de génération multimodale plus efficaces et unifiés.
Avec l'amélioration continue de l'échelle et de la qualité de génération des modèles texte vers image, les applications pratiques des modèles commencent à faire face à de nouveaux problèmes. D'une part, les modèles de génération à grande échelle nécessitent généralement des ressources de calcul élevées et de nombreuses étapes d'échantillonnage ; d'autre part, les applications AIGC pratiques ne se plus limitées aux tâches simples de texte vers image, mais doivent également supporter simultanément la compréhension d'images, la génération d'images, l'édition d'images et la génération d'images de référence. Par conséquent, la réduction des coûts de génération et l'unification des capacités multimodales sont progressivement devenues des directions de développement importantes pour les modèles texte vers image.
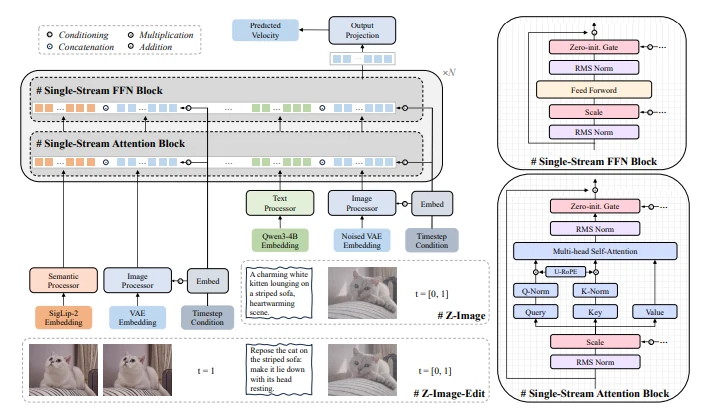
La série Z-Image adopte l'architecture Scalable Single-Stream Diffusion Transformer (S3-DiT) avec une échelle de modèle de 6B paramètres. Une caractéristique importante du S3-DiT est son architecture à flux unique, qui concatène les Tokens texte, les Tokens sémantiques visuels et les Tokens VAE d'image dans la dimension de séquence, puis les entre dans un Transformer unifié pour traitement. Comparé aux structures à flux double traitant différentes modalités séparément, cette approche peut compléter les interactions entre différents types d'informations dans un flux de données unifié. Le Z-Image-Turbo démontre une direction de développement importante des modèles texte vers image modernes : tout en maintenant de fortes capacités de génération, réduisant les coûts d'inférence par distillation de modèle et échantillonnage en quelques étapes, rendant les modèles de génération d'images Transformer à grande échelle plus adaptés au déploiement pratique.
Le SenseNova-U1.5-8B-MoT passant du texte vers image au multimodal unifié, en plus d'améliorer l'efficacité de génération, un autre axe important est d'unifier les capacités auparavant relativement indépendantes de compréhension multimodale et de génération multimodale. Le SenseNova-U1 publié en 2026 a proposé l'architecture NEO-unify, tentant de réaliser simultanément la compréhension et la génération multimodales dans un modèle unifié. Sur cette base, le SenseNova-U1.5-8B-MoT a further amélioré les capacités de génération et d'édition d'images. Selon les informations officielles de publication, la version officielle du SenseNova-U1.5-8B-MoT a été publiée en août 2026, améliorant further le suivi des instructions, la génération de texte et de mise en page, la génération d'images 4K natives, l'édition d'images et le contrôle visuel.
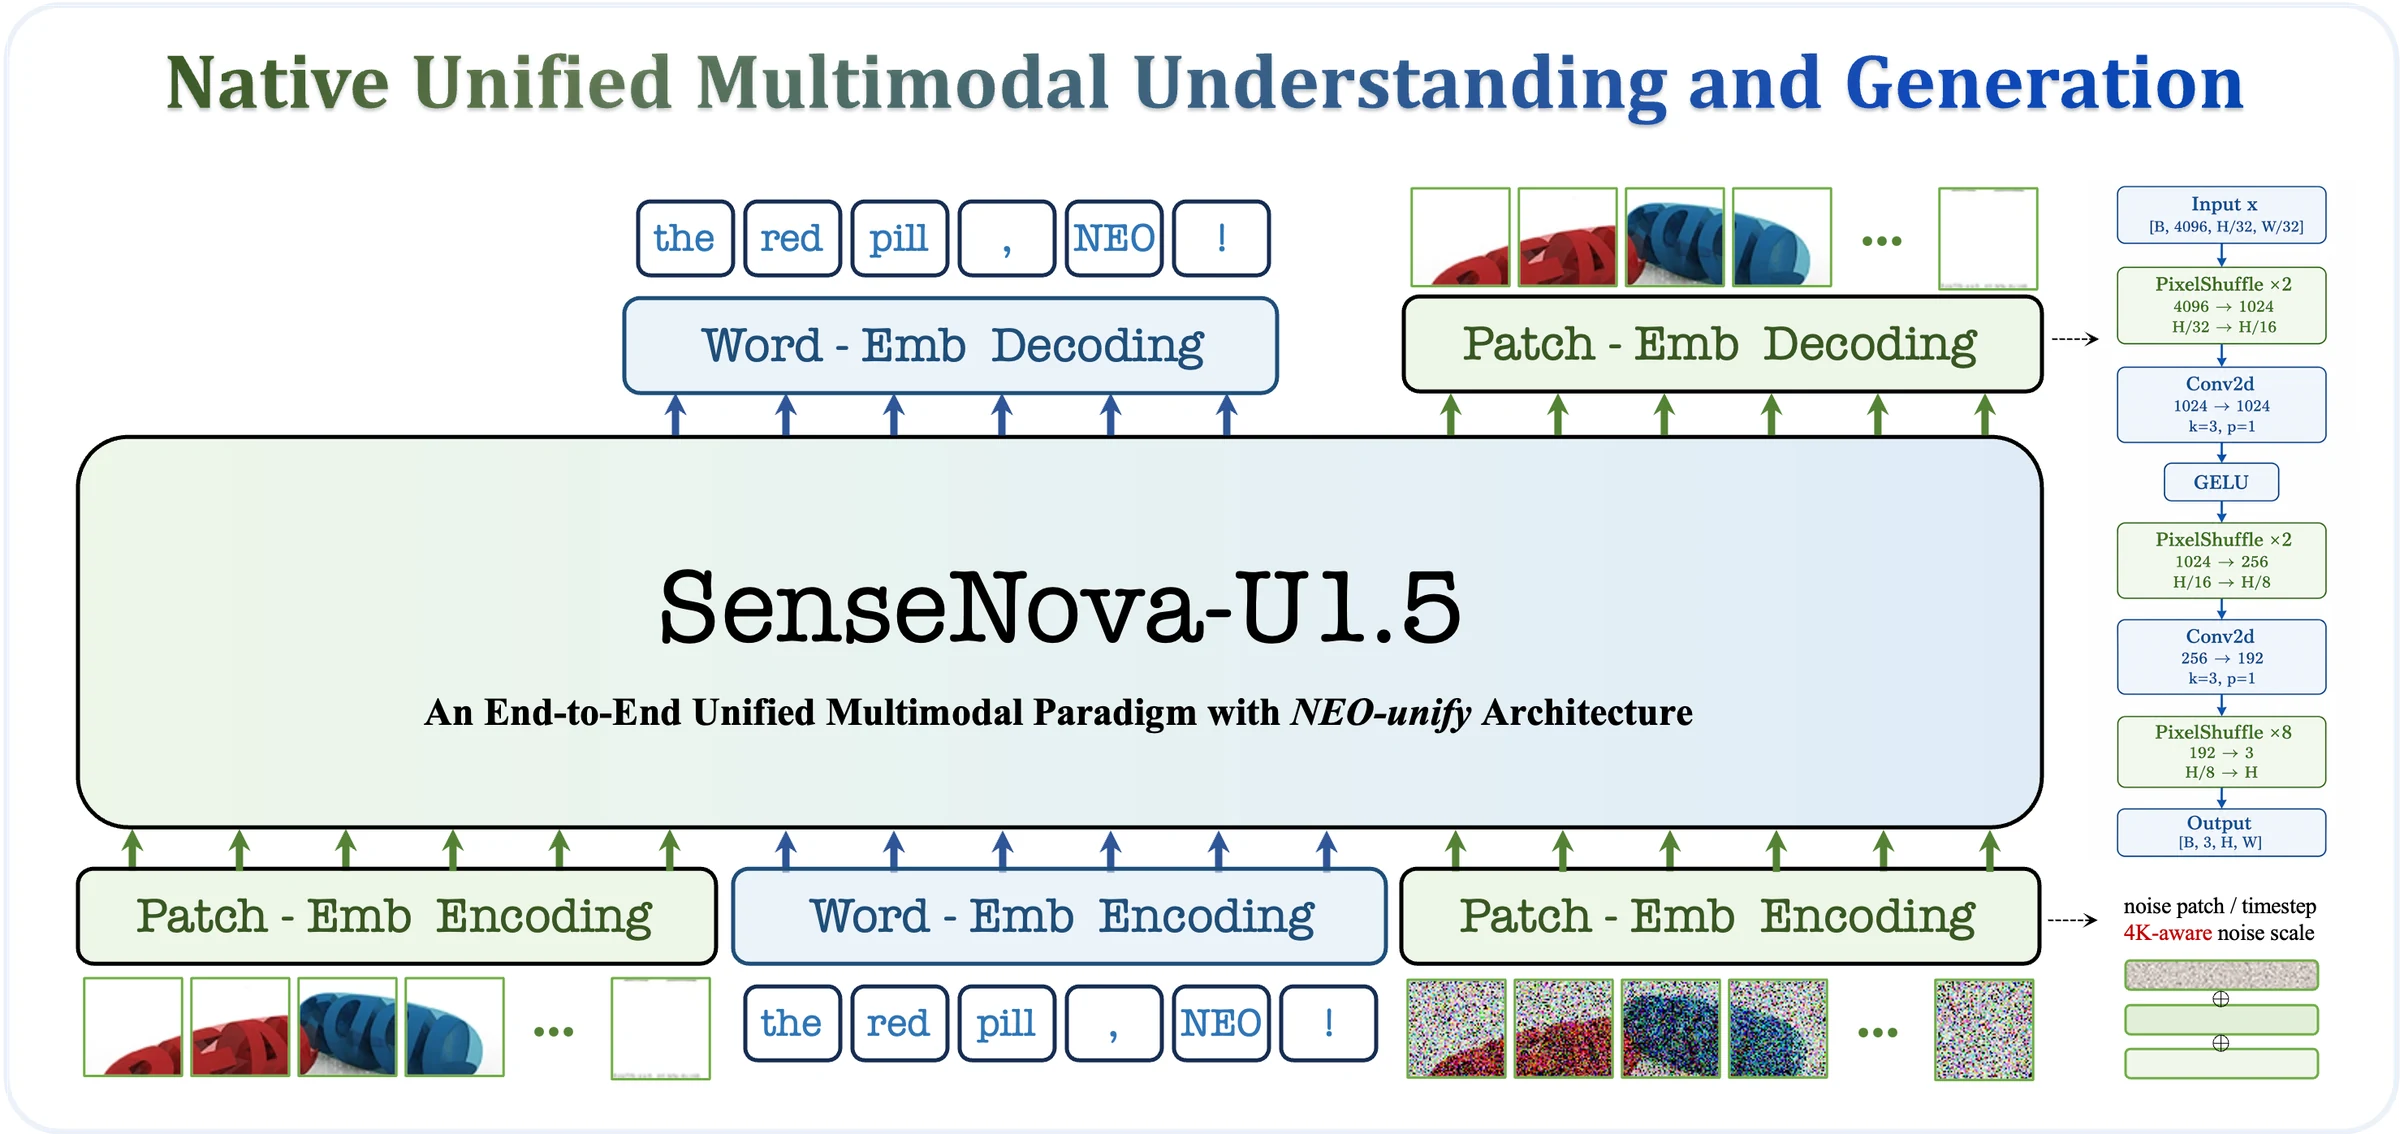
Le SenseNova-U1.5 est construit sur l'architecture unifiée multimodale NEO-unify et adopte un nouveau mécanisme d'encodage et de décodage de Patch d'image. Le modèle peut non seulement générer des images en fonction de descriptions textuelles, mais aussi combiner des images d'entrée avec des instructions en langage naturel pour compléter des tâches d'image à image, d'édition d'images et de contrôle visuel. Cela signifie que les modèles texte vers image évoluent progressivement d'outils simples de génération de contenu vers des modèles multimodaux unifiés capables de traiter simultanément des tâches de compréhension et de génération.