10 cas d'utilisation : que peuvent les modèles open-source d'AIGC ?
Les modèles les plus puissants de génération d'images et de vidéos actuellement sont probablement GPT Images 2.5 et Seedance 2.5, repoussant encore les limites de la génération.
Si on les considère comme la première catégorie de modèles fermés, à quel niveau en sont les modèles open-source aujourd'hui ? Sont-ils de simples jouets ? Peuvent-ils vraiment apporter une productivité réelle ?
Cet article examine directement ce que les experts parviennent à faire avec les modèles open-source, en utilisant Z-Image d'Alibaba pour la génération d'images et MiniMax H3 pour la génération de vidéos.
Présentation de ces deux modèles
Z-Image est un modèle de génération d'images de 6B paramètres, distribué sous licence Apache 2.0. Le Z-Image complet est un modèle de base non distillé, supportant CFG, les prompts négatifs et le fine-tuning ; la communauté utilise plus communément Z-Image-Turbo, qui n'utilise que 8 étapes et privilégie la vitesse.
MiniMax H3 est un modèle de génération audio-vidéo de 33B paramètres, capable de produire des vidéos de 4 à 15 secondes, à 24 fps, avec audio stéréo. Strictement parlant, c'est un modèle à poids ouverts utilisant la MiniMax H3 Community License. Le H3-Base open-sourcé peut générer de l'audio-vidéo en 768p en local, mais le module Context-IR officiel chargé de la compréhension des entrées complexes et le pipeline de régénération 2K n'ont pas été entièrement open-source.
Z-Image : bien au-delà de simplement dessiner de beaux visages
Beaucoup de modèles de génération d'images peuvent aujourd'hui générer de beaux visages. Regarder un seul visage retouché n'est pas vraiment impressionnant. Les véritables défis sont : le texte est-il écrit correctement ? Le comptage est-il juste ? Un même produit peut-il garder sa cohérence sous différents angles ? Les relations spatiales complexes sont-elles bien comprises ?
Commençons par regarder un ensemble de tests locaux par @witcheer.
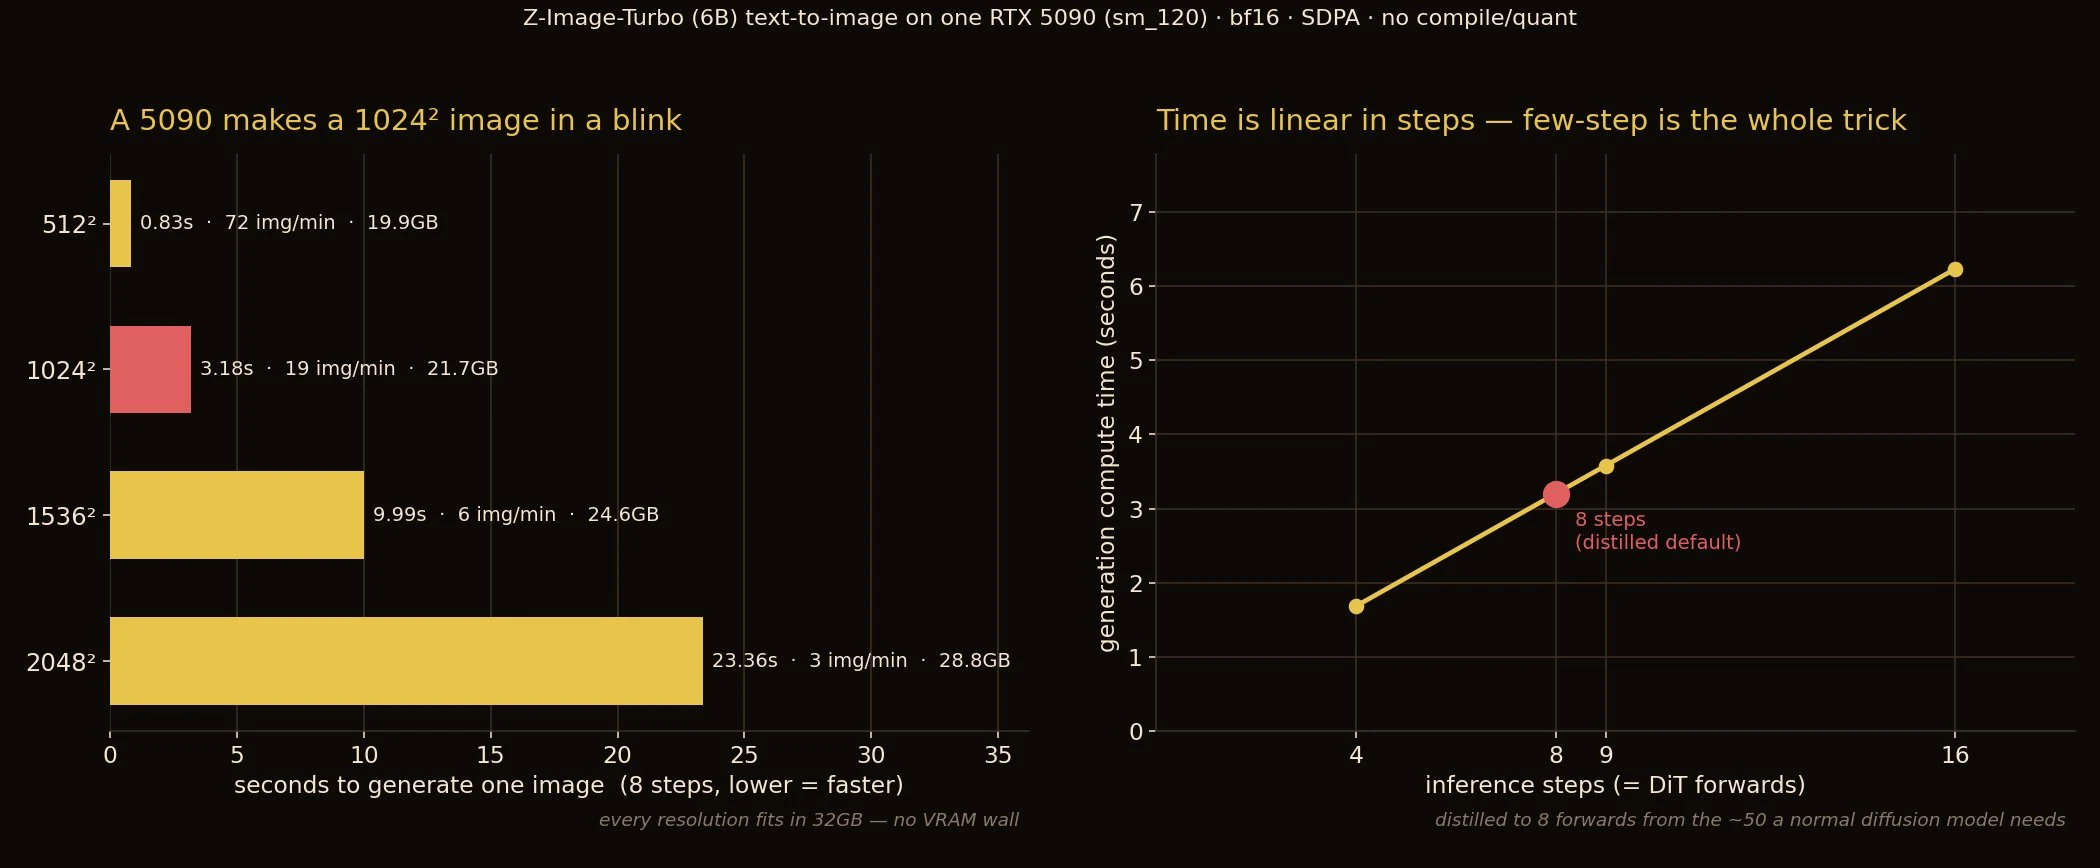
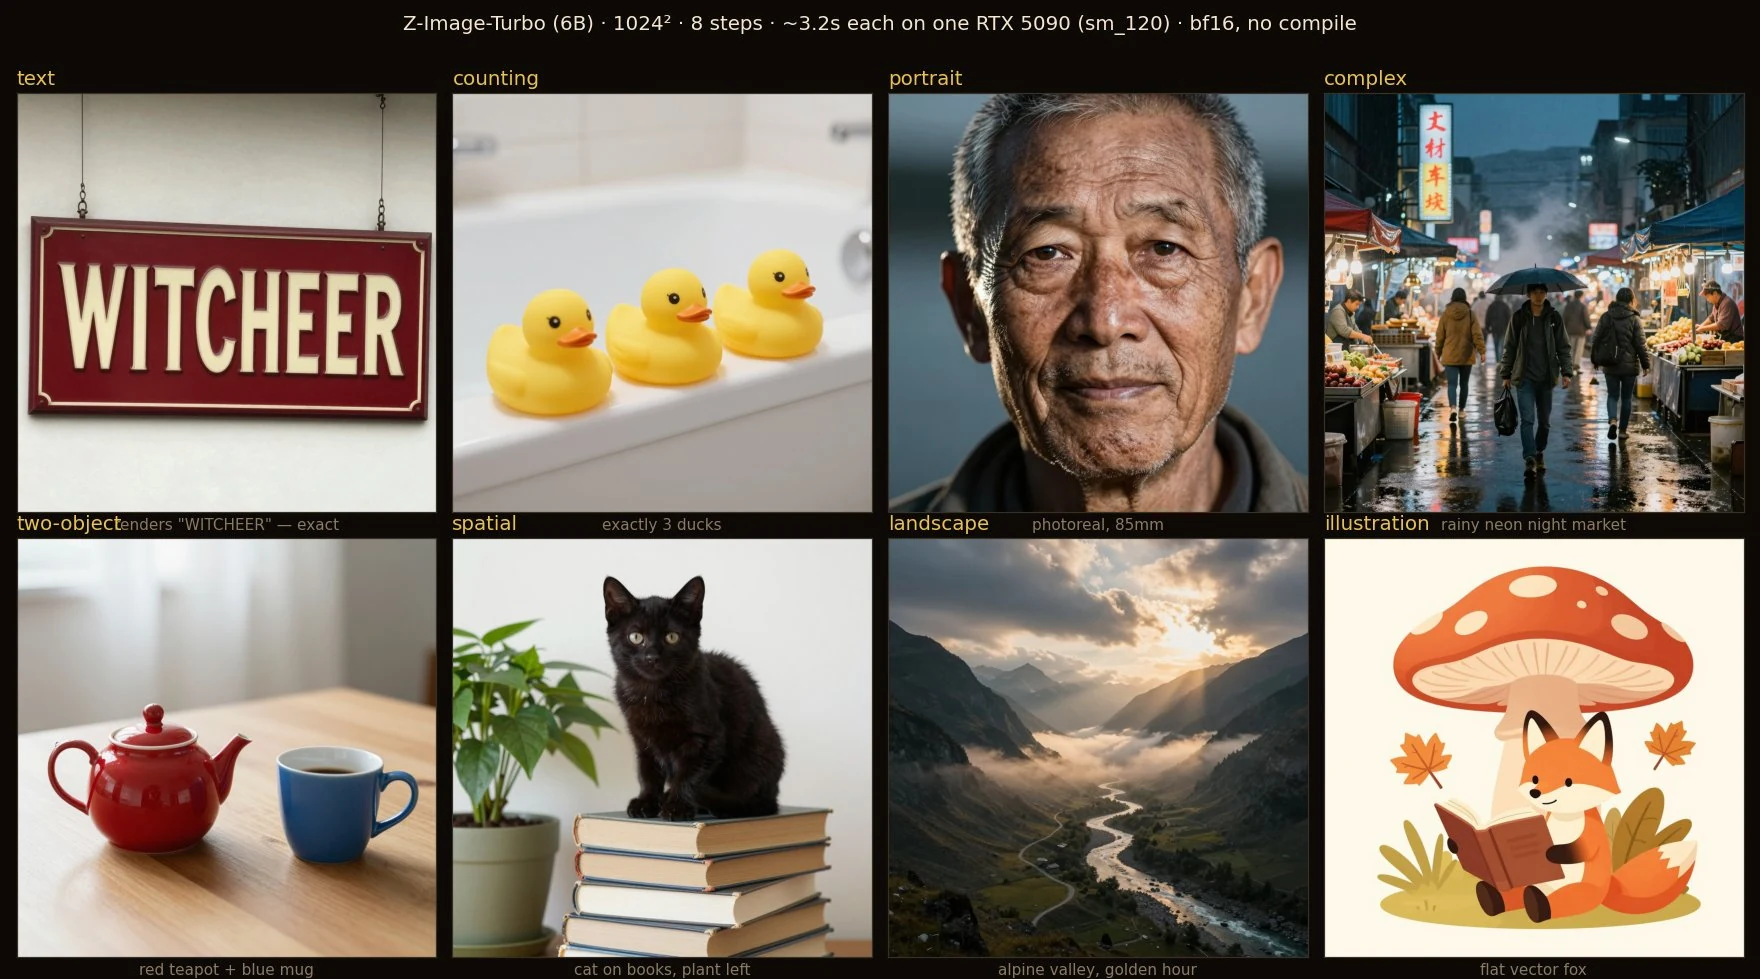
Il a fait tourner Z-Image-Turbo sur un RTX 5090, générant des images de 1024px en environ 3,2 secondes chacune. Le prompt demandait une enseigne de magasin avec des mots spécifiés, plus « exactement trois canards », et à la fois le texte et le nombre étaient corrects.
Ces deux tâches paraissent simples, mais elles ont en réalité été des défis persistants pour les modèles de diffusion. Les lettres ont tendance à se flouter, et trois canards deviennent souvent mystérieusement quatre ou cinq.
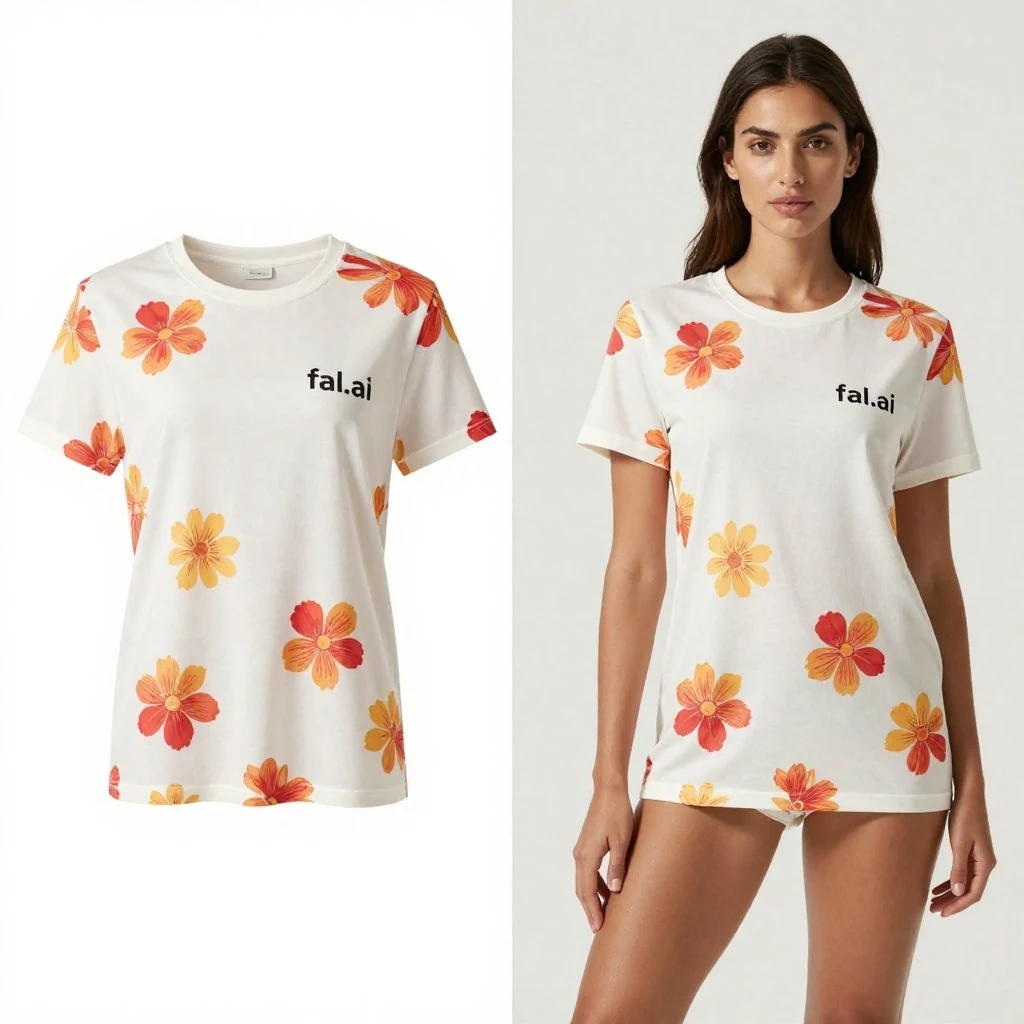
@rizavelioglu a demandé au modèle de générer une image en colonnes divisées : à gauche, un seul T-shirt blanc à motifs, à droite, un vrai modèle portant le même vêtement. Le prompt demandait également de préserver l'impression, le texte, le tissu, les coutures et la coupe.
Le résultat final montrait que les vêtements des deux côtés n'étaient pas générés indépendamment — les motifs et le style correspondaient bien. Pour les équipes e-commerce, c'est bien plus précieux qu'une simple « jolie photo de mannequin ». Les images produit, les images portées et les images marketing peuvent toutes continuer à partir du même design.
Bien sûr, c'est juste un échantillon réussi, et il reste un écart avant la production en lot stable. Mais cela prouve au moins que la direction fonctionne.
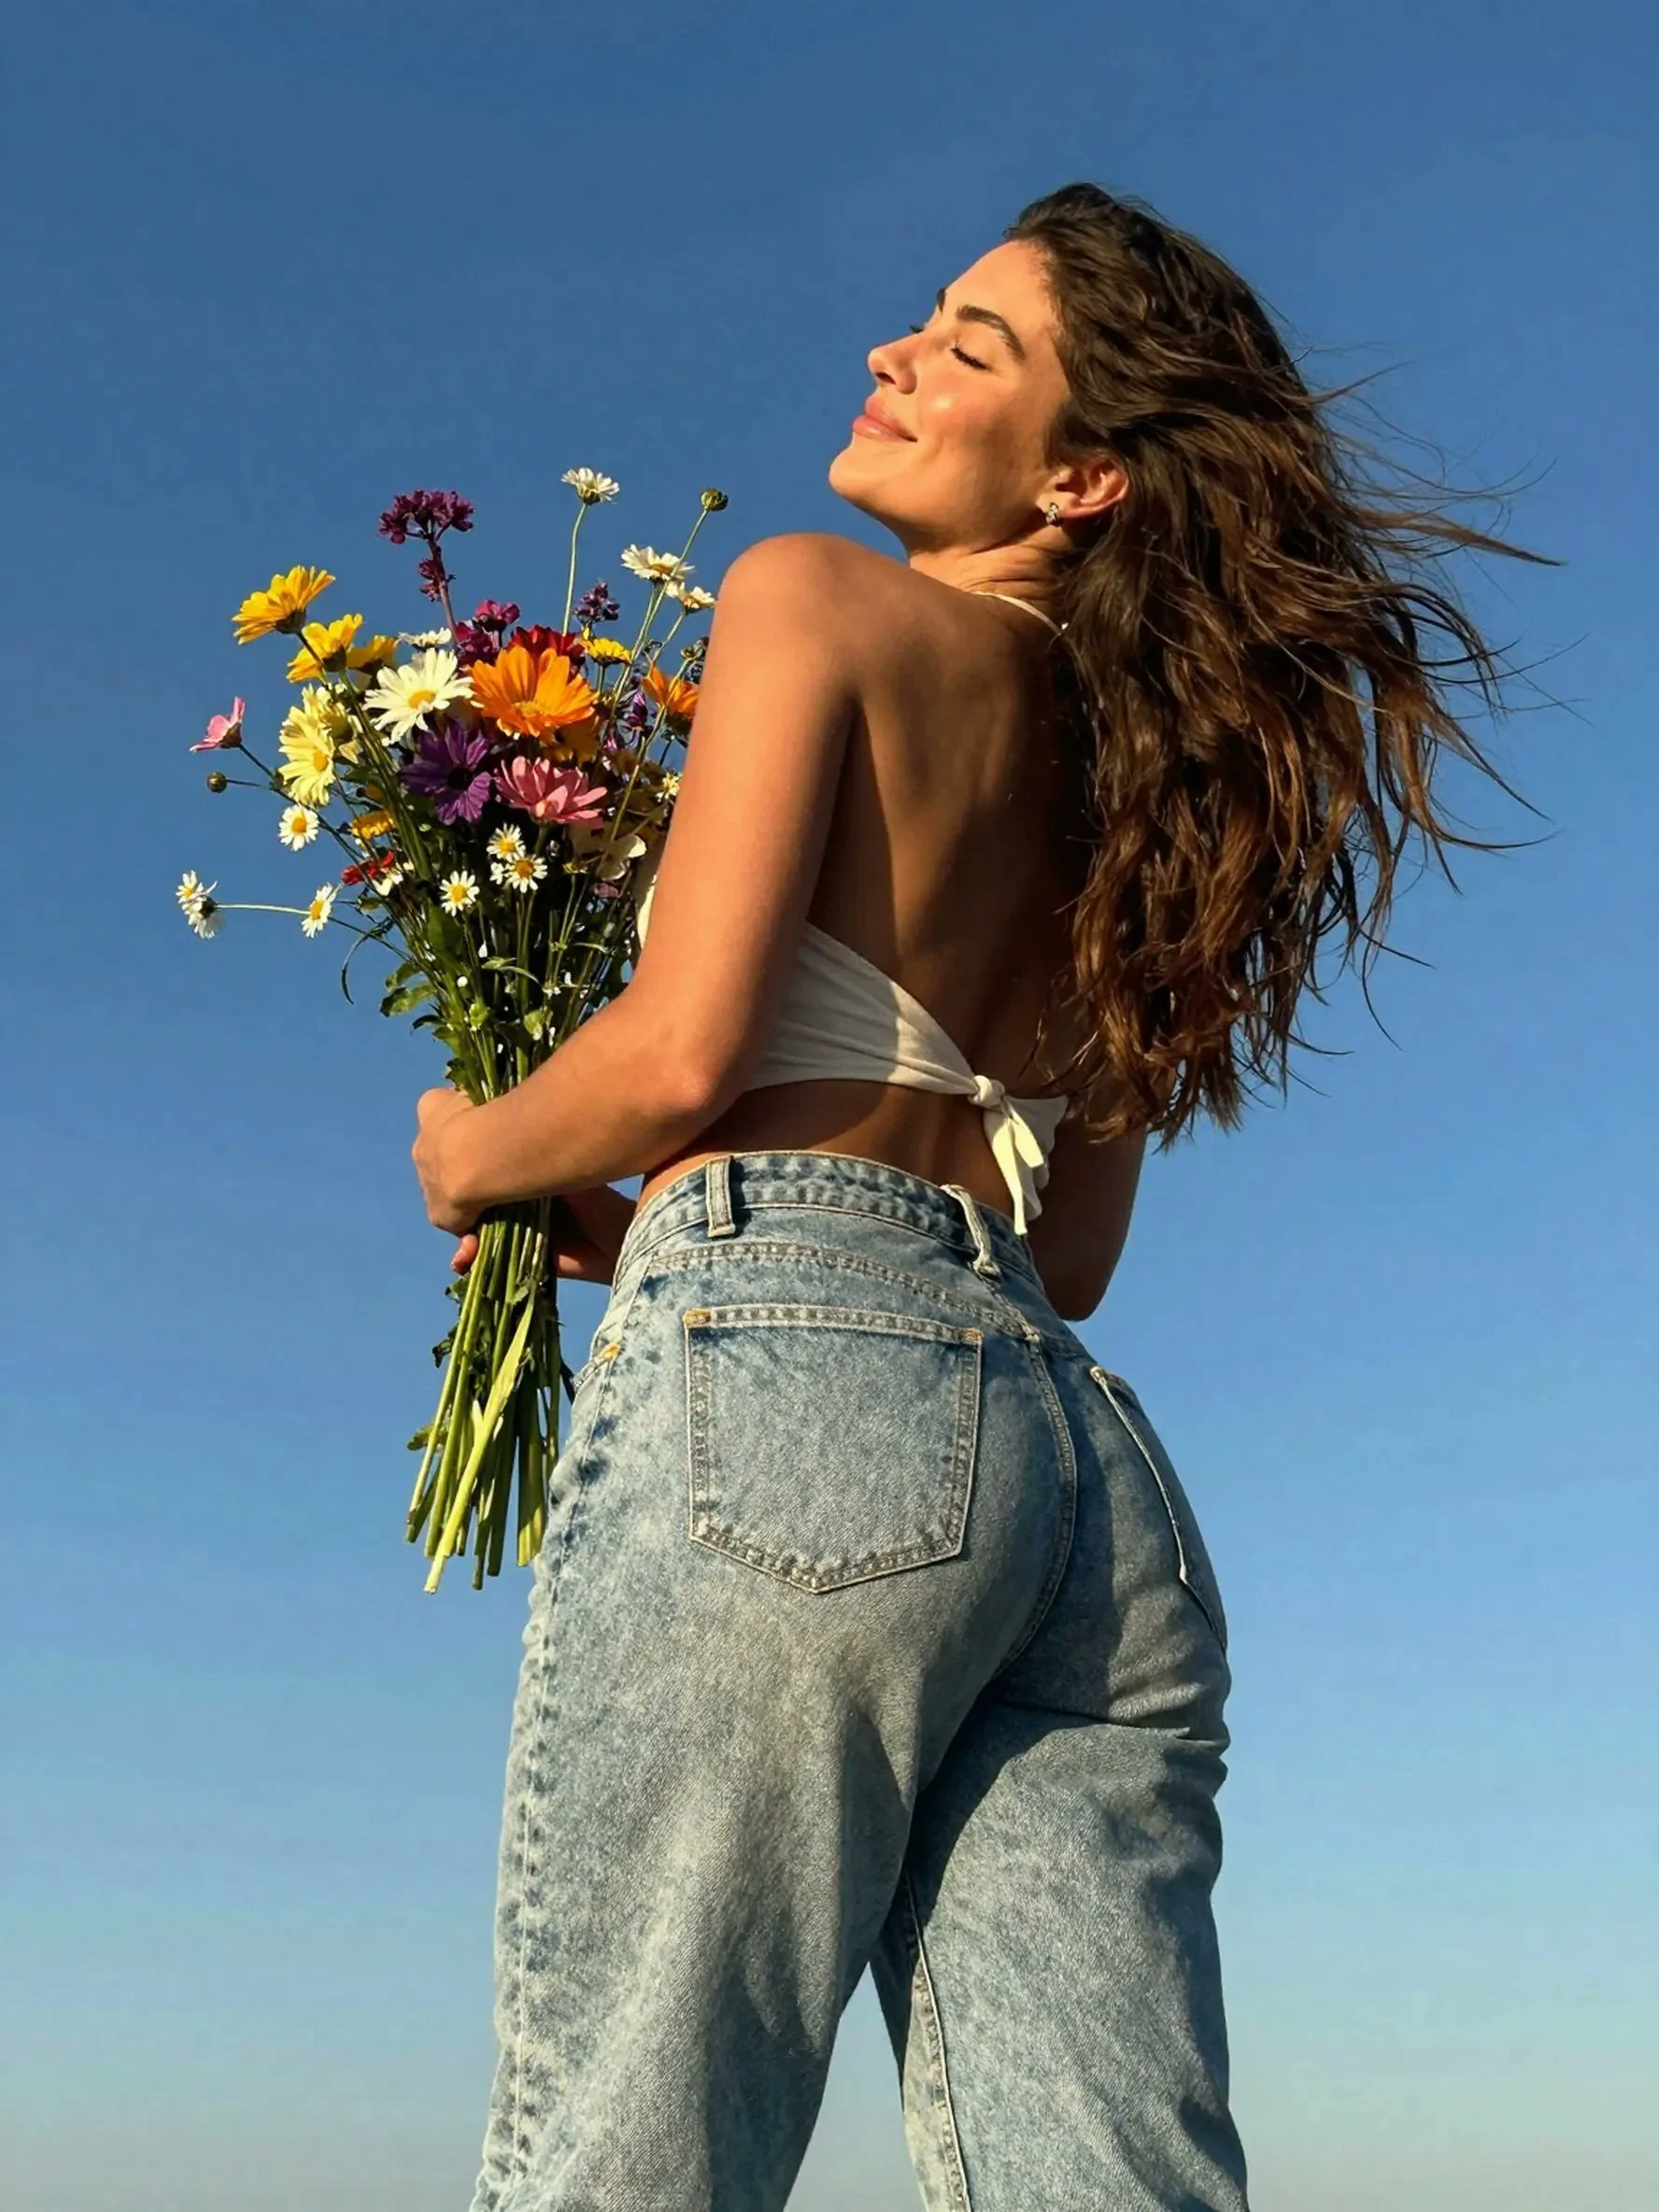
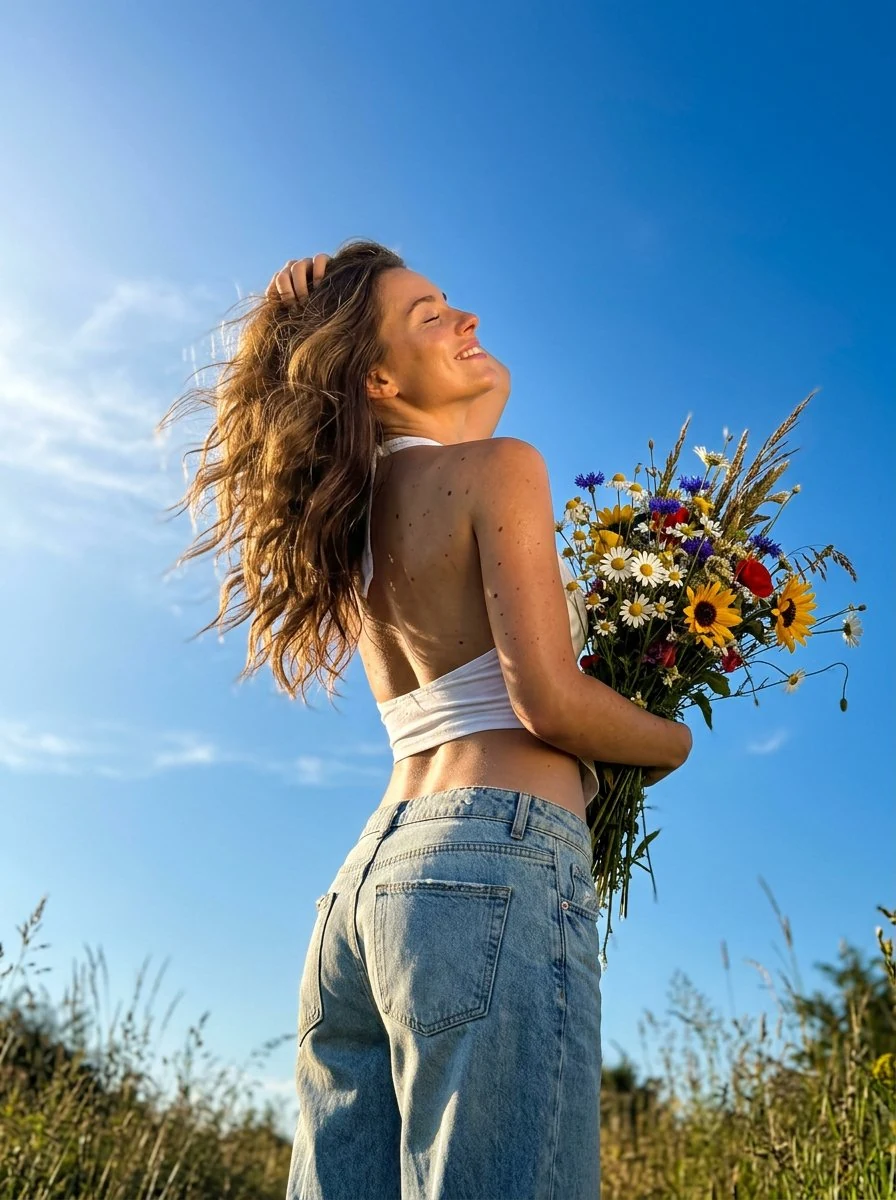
Pour les portraits réalistes, @dreamydigiarts a créé une comparaison avec le même prompt.
Il a demandé à Z-Image-Turbo et Nano Banana 2 de générer tous les deux une photo en angle bas depuis un téléphone : ciel bleu, contre-jour, personne penchée en arrière, tenant un gros bouquet de fleurs sauvages, cheveux soufflés par le vent, tout en préservant la légère granulosité des photos de téléphone.
Le résultat de Z-Image avait déjà une forte ambiance de photo candid. Le jean, la peau et le contre-jour ne se mélangeaient pas en une couche plastique, et la composition en angle bas était solide. Pour les photos d'ambiance de personnages et les images de réseaux sociaux, c'est déjà bien au-delà du niveau jouet.
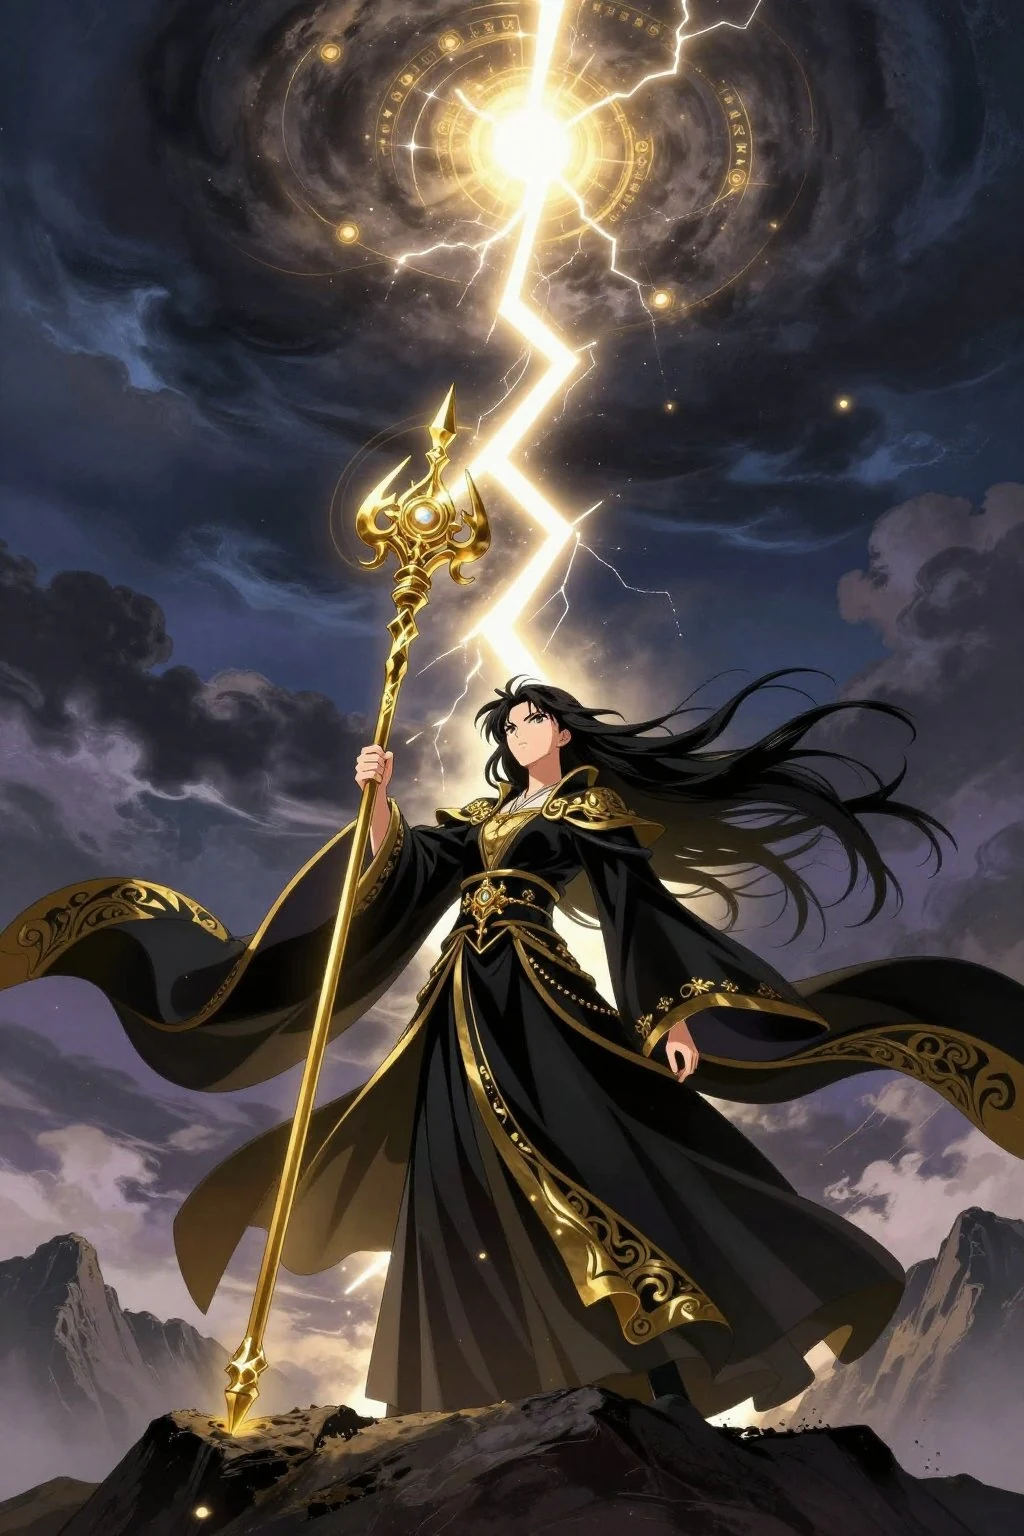
Z-Image ne se limite pas au réalisme non plus. @tisch_eins a testé Boogu, Flux 2 Klein et Z-Image-Turbo avec le même prompt. La scène demandait une mage aux cheveux noirs debout sur un sommet montagneux en pleine tempête, avec un bâton doré entièrement visible de la main au sommet, un éclair jaillissant de la pointe du bâton vers les nuages, plus une composition en angle bas, plein corps, cape, runes, arcs électriques et fort éclairage doré de rim.
Ce type de prompt est facilement négligé : le bâton est coupé, l'éclair se connecte au mauvais endroit, et le personnage pourrait ne montrer qu'une grosse tête. Le résultat de Z-Image a maintenu toutes les relations clés, montrant un fort contrôle des compositions d'illustration complexes.
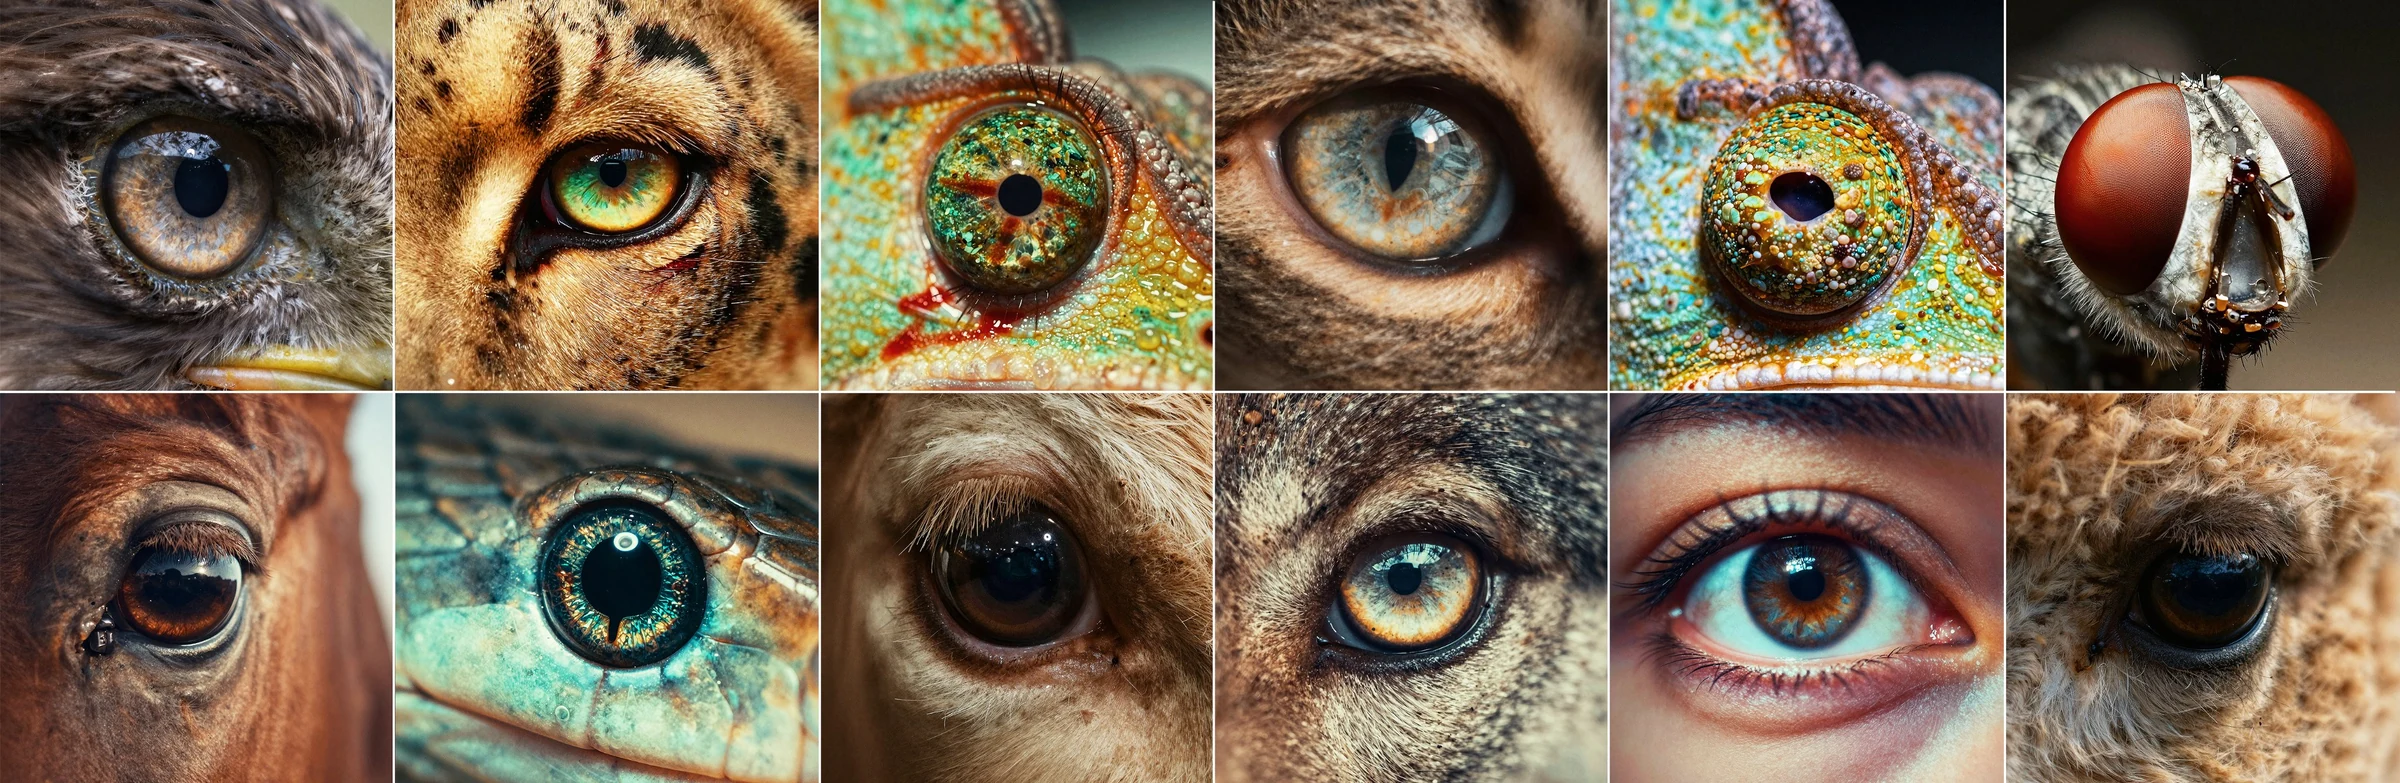
Le dernier est un macro extrême. Le prompt de @aisthetiic était très court : la pupille d'un animal remplissant le cadre principal, avec un éclairage dramatique venant du coin supérieur gauche révélant la texture de l'iris, et un fond en dégradé du foncé au bokeh clair.
Ce qui est encore plus intéressant, c'est que l'image ne s'est pas effondrée. Le regard est fermement verrouillé sur la pupille, avec la lumière, l'ombre et le fond servant tous le même sujet. Pour créer des visuels de posters ou des couvertures émotionnelles, ce type de conformité compositionnelle est plus utile que d'empiler dix mille mots-clés « 8K, chef-d'œuvre, ultra-détaillé ».
En regardant ces 5 cas ensemble, les avantages de Z-Image sont assez clairs :
Le modèle est petit, rapide, capable en réalisme, et peut comprendre des prompts en langage naturel relativement longs. Le modèle de base complet peut aussi être utilisé pour LoRA, ControlNet et le fine-tuning sectoriel.
MiniMax H3 : la vidéo open-source commence à avoir un côté cinématique
La génération de vidéo est beaucoup plus difficile que la génération d'image. Un seul doigt mal dessiné dans une image peut parfois être recadré. Mais dans une vidéo, si le visage du personnage change en 15 secondes, la caméra ne suit pas la chronologie, les dialogues se mélangent entre les personnages, ou les effets sonores ne correspondent pas aux actions — un seul dérapage et toute la pièce est ratée.
Dans les cas de H3, la première chose à examiner est la cohérence des personnages doubles.
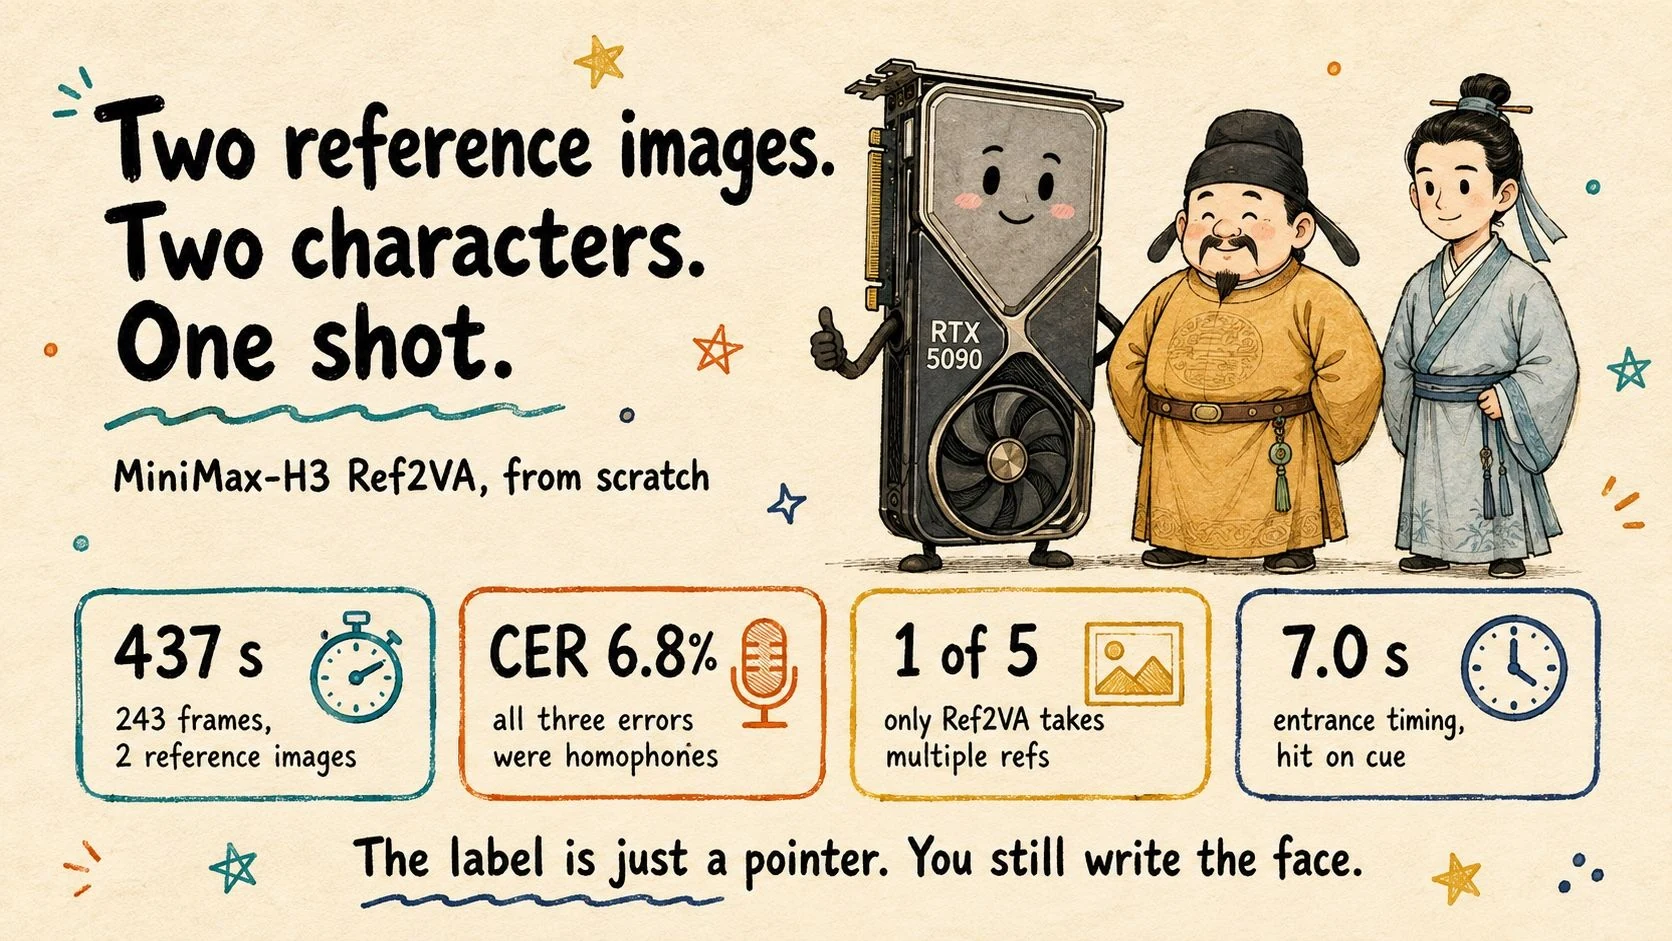
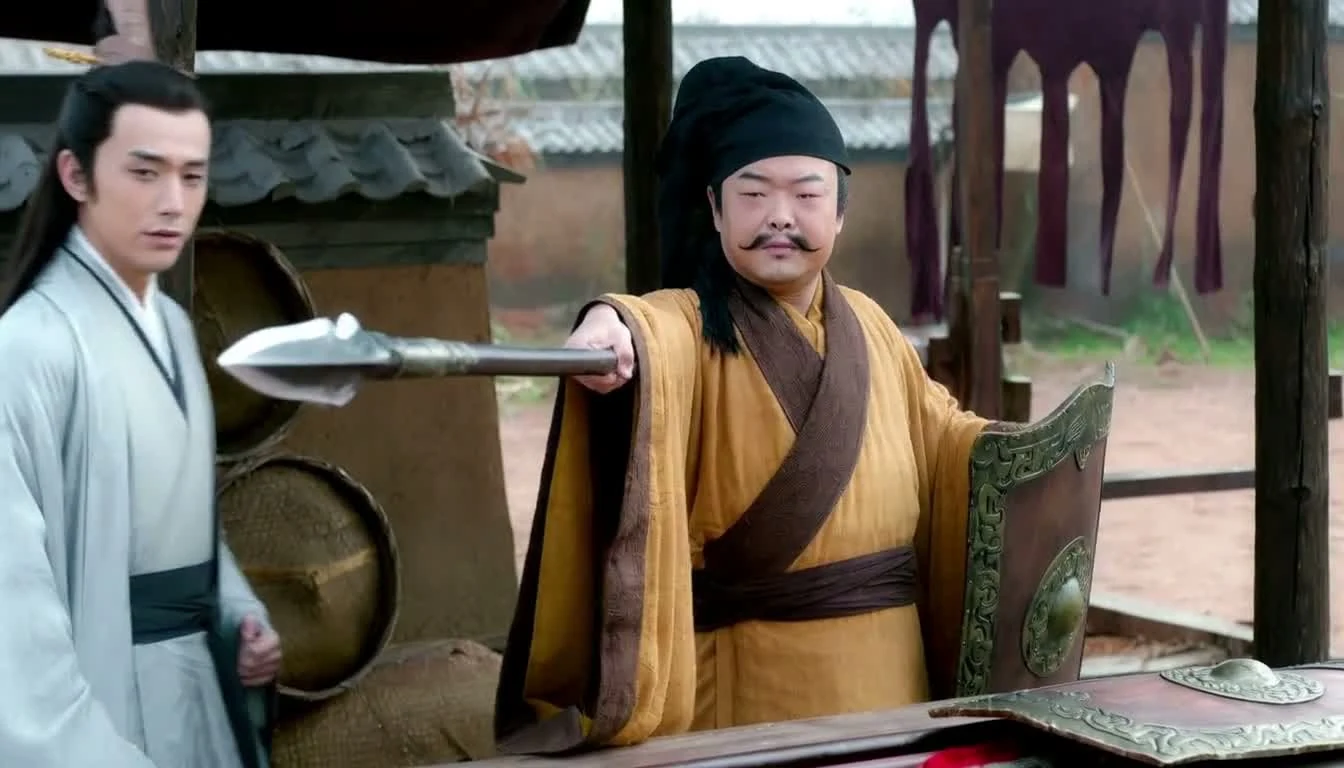
@coolthor a nourri deux images de design de personnages générées par Z-Image dans le mode Ref2VA de H3. L'un porte une robe ocre, l'autre des vêtements bleu-gris, avec des appearances volontairement différentes. Le prompt安排ait l'entrée d'un personnage entre les secondes 6 et 8 et incluait trois lignes de dialogue chinois.
Dans la vidéo de 10,125 secondes, les deux personnages n'ont ni échangé de visages ni de vêtements. Le personnage prévu pour entrer n'apparaît pas dans la première moitié et n'arrive qu'autour de la 7e seconde. L'auteur a ensuite utilisé l'ASR pour vérifier 44 caractères chinois, atteignant un taux d'erreur de 6,8%, avec des erreurs qui étaient des homophones.
Cela a été exécuté sur un seul RTX 5090, prenant 437 secondes pour 243 images. La vitesse n'est pas extrêmement rapide, mais pouvoir contrôler simultanément le personnage, le timing et le dialogue est déjà très impressionnant.
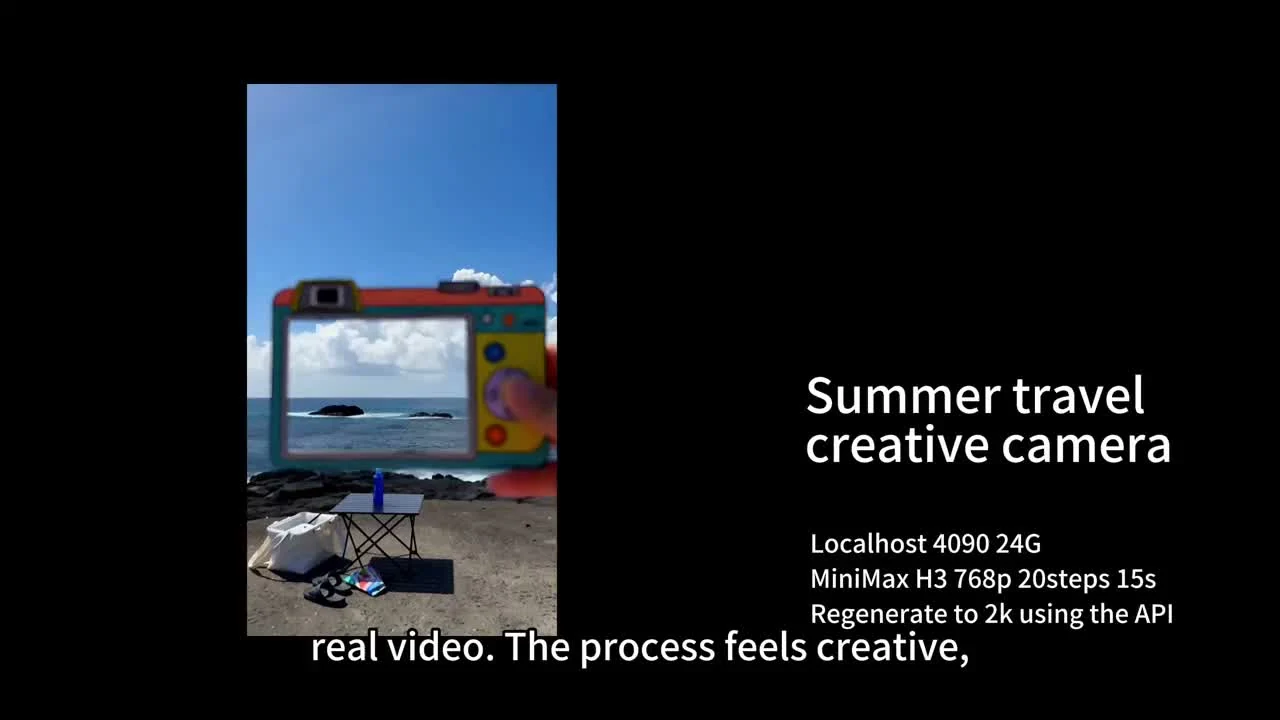
Avec un RTX 4090 et ComfyUI, il a fait trois tentatives : un court-métrage de voyage en quatre scènes, un clip musical qui change de scène au rythme des tambours, et une histoire maritime avec 4 plans et sons ambiants. L'idée initiale a d'abord été envoyée au Prompt Writing Skill officiel de MiniMax pour créer des prompts structurés avec plans, chronologie, actions et sons, puis transmis à H3.
L'aspect le plus utile de ce cas est qu'il n'a pas simplement produit de « jolies images ». Quand le beat de tambour arrive, la scène change réellement ; dans le clip maritime, les quatre plans, l'atmosphère et le son de fond sont tous sortis ensemble en un tour.
Ses données de benchmark : le 4090 prend plus de 200 secondes pour une vidéo de 15 secondes en basse résolution à 20 étapes ; passer en 768p prend plus de 1000 secondes. L'open source permet d'itérer en boucle, mais gratuit ne signifie pas sans coût — électricité, VRAM et temps d'attente sont aussi des coûts.
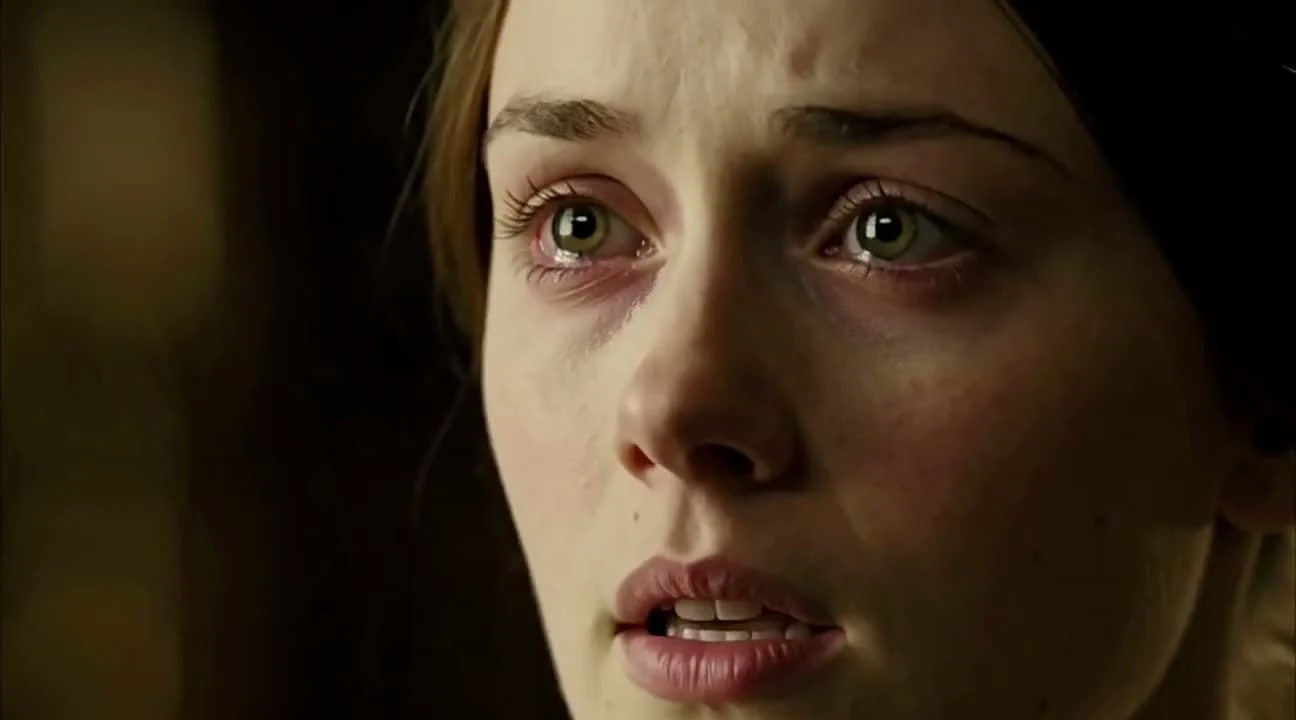
Le segment de 30 secondes de style « Jane Eyre » dans un manoir britannique par @PixelAigc est encore plus impressionnant.
Son prompt a directement découpé les 30 secondes en 4 plans. Chaque segment spécifiait la focale, l'angle de caméra, le positionnement des personnages, les micro-expressions, les dialogues, la respiration, les sons ambiants et les éléments interdits. Les émotions des personnages progressaient de l'hésitation à la réplique jusqu'à l'émotion, avec des contraintes vocales séparées pour voix masculine et féminine.
Ce morceau a utilisé ComfyUI local avec H3 Turbo LoRA, générant d'abord en 480p, puis montant en 1080p avec Topaz. L'auteur a indiqué que 25 secondes prennent environ 13 à 15 minutes. Cela ne représente pas les performances brutes du modèle officiel, mais cela représente l'aspect le plus intéressant de l'écosystème open-source : un mois après la sortie du modèle, la communauté modifie déjà la vitesse, crée des vidéos longues et intègre le super-résolution automatique.
La limite officielle de H3 pour un segment unique est de 15 secondes. Alors comment faire des vidéos plus longues ?
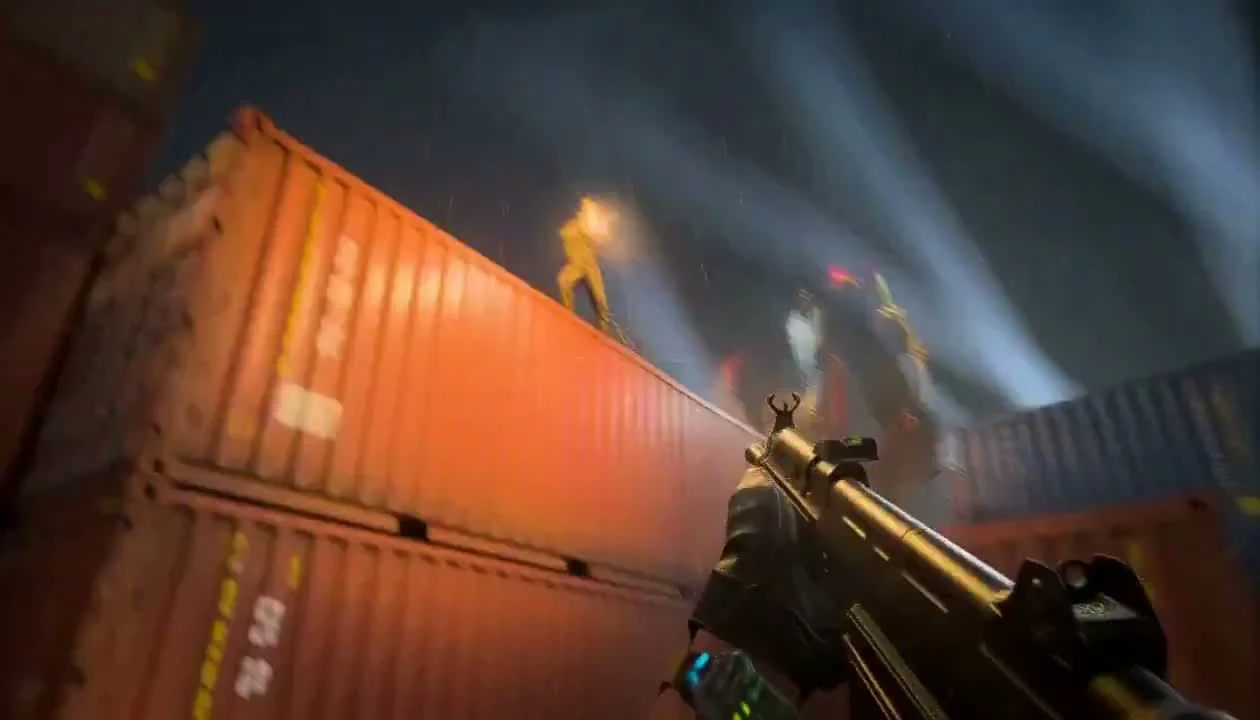
@superalesha a utilisé 4 RTX 3090 pour exécuter un film d'action en first-person de 30 secondes. Il a chaîné deux segments de 15 secondes, arrêtant délibérément le premier sur une image stable, continuant la génération depuis la même image dans le second segment, coupant les images dupliquées, et laissant l'audio continuer.
La jointure est cachée à la 15e seconde, presque invisible lors du visionnage normal. L'ensemble a pris 44 minutes de la génération à l'achèvement. La valeur de ce cas n'est pas que H3 a soudainement franchi la limite de durée, mais que quelqu'un a compris la limite et l'a contournée avec un workflow.
Il y a aussi un cas particulièrement utile pour étudier « comment réellement rédiger des prompts vidéo ».
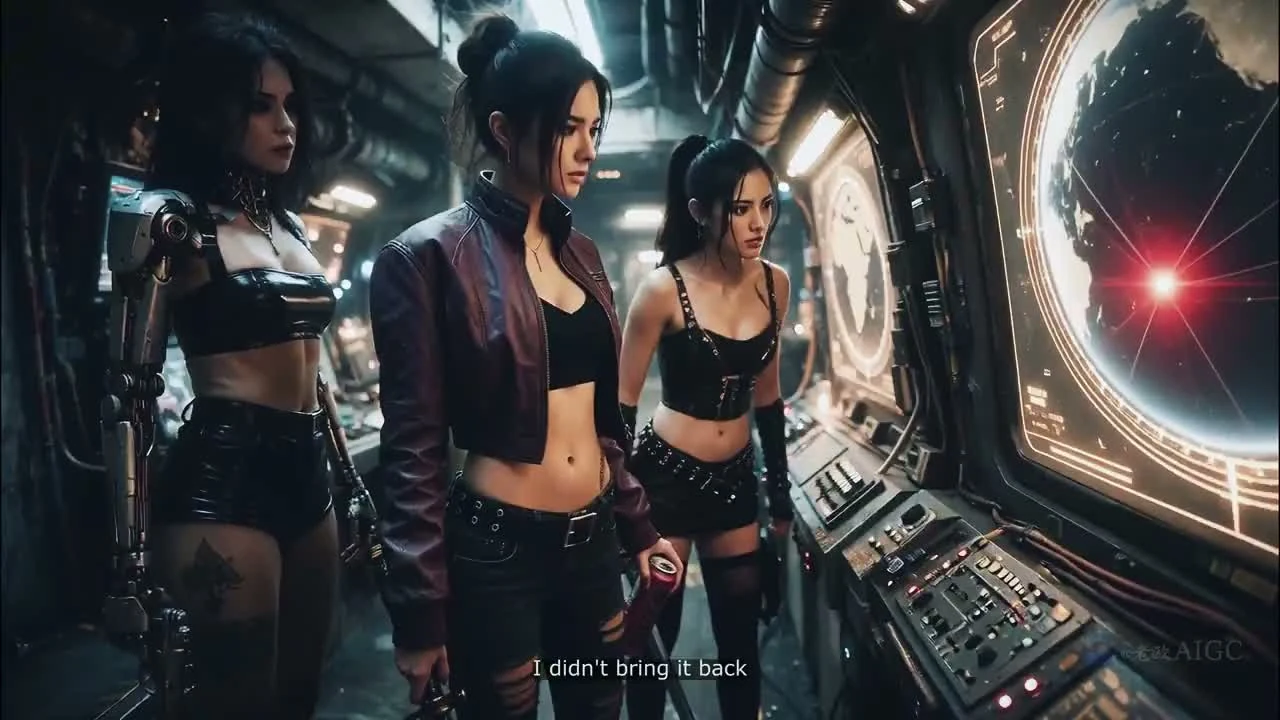
@ou_zhen599 a utilisé ComfyUI local pour créer un court-métrage de vaisseau cyber de 15 secondes. La scène comporte trois personnages féminins : l'une assise à gauche, l'autre debout au centre avec un couteau, et la troisième debout à droite devant tenant une canette de soda. Le prompt ne décrivait pas seulement l'intrigue — il spécifiait qui parle à quelle seconde, que les personnages silencieux ne doivent pas bouger les lèvres, que la canette de soda doit rester dans la main droite tout au long, quand le point de suivi rouge apparaît à l'écran, et enfin quand l'ombre à l'extérieur du hublot se rapproche.
La partie la plus difficile de ce type de cas est de maintenir l'espace stable, de ne pas perdre d'objets, de ne pas mélanger les dialogues, et de faire en sorte que les personnages silencieux restent vraiment silencieux. H3 est déjà parvenu à caser toutes ces contraintes dans un court-métrage de 15 secondes. Le jeu de la vidéo open-source a clairement changé.
Si vous voulez simplement produire rapidement une vidéo terminée, les modèles fermés restent les plus simples.
Mais si vous voulez itérer en boucle, générer en lot, entraîner votre propre style, ou intégrer des capacités dans un workflow local, Z-Image et H3 méritent une étude sérieuse. Utilisez les modèles open-source pour prototyper rapidement les plans et les séquences d'abord, puis n'appelez les modèles fermés que lorsque vous êtes vraiment bloqué — les coûts seront bien plus faibles.
Les modèles open-source avaient autrefois la réputation d'être une consolation pour ceux qui attendaient. Maintenant, ils peuvent véritablement participer à un travail créatif réel.
Pour les personnes qui doivent créer des images et des vidéos quotidiennement, le meilleur changement est que dorénavant, à chaque fois qu'une idée surgit, vous n'avez plus besoin de calculer combien de crédits cette session va brûler.