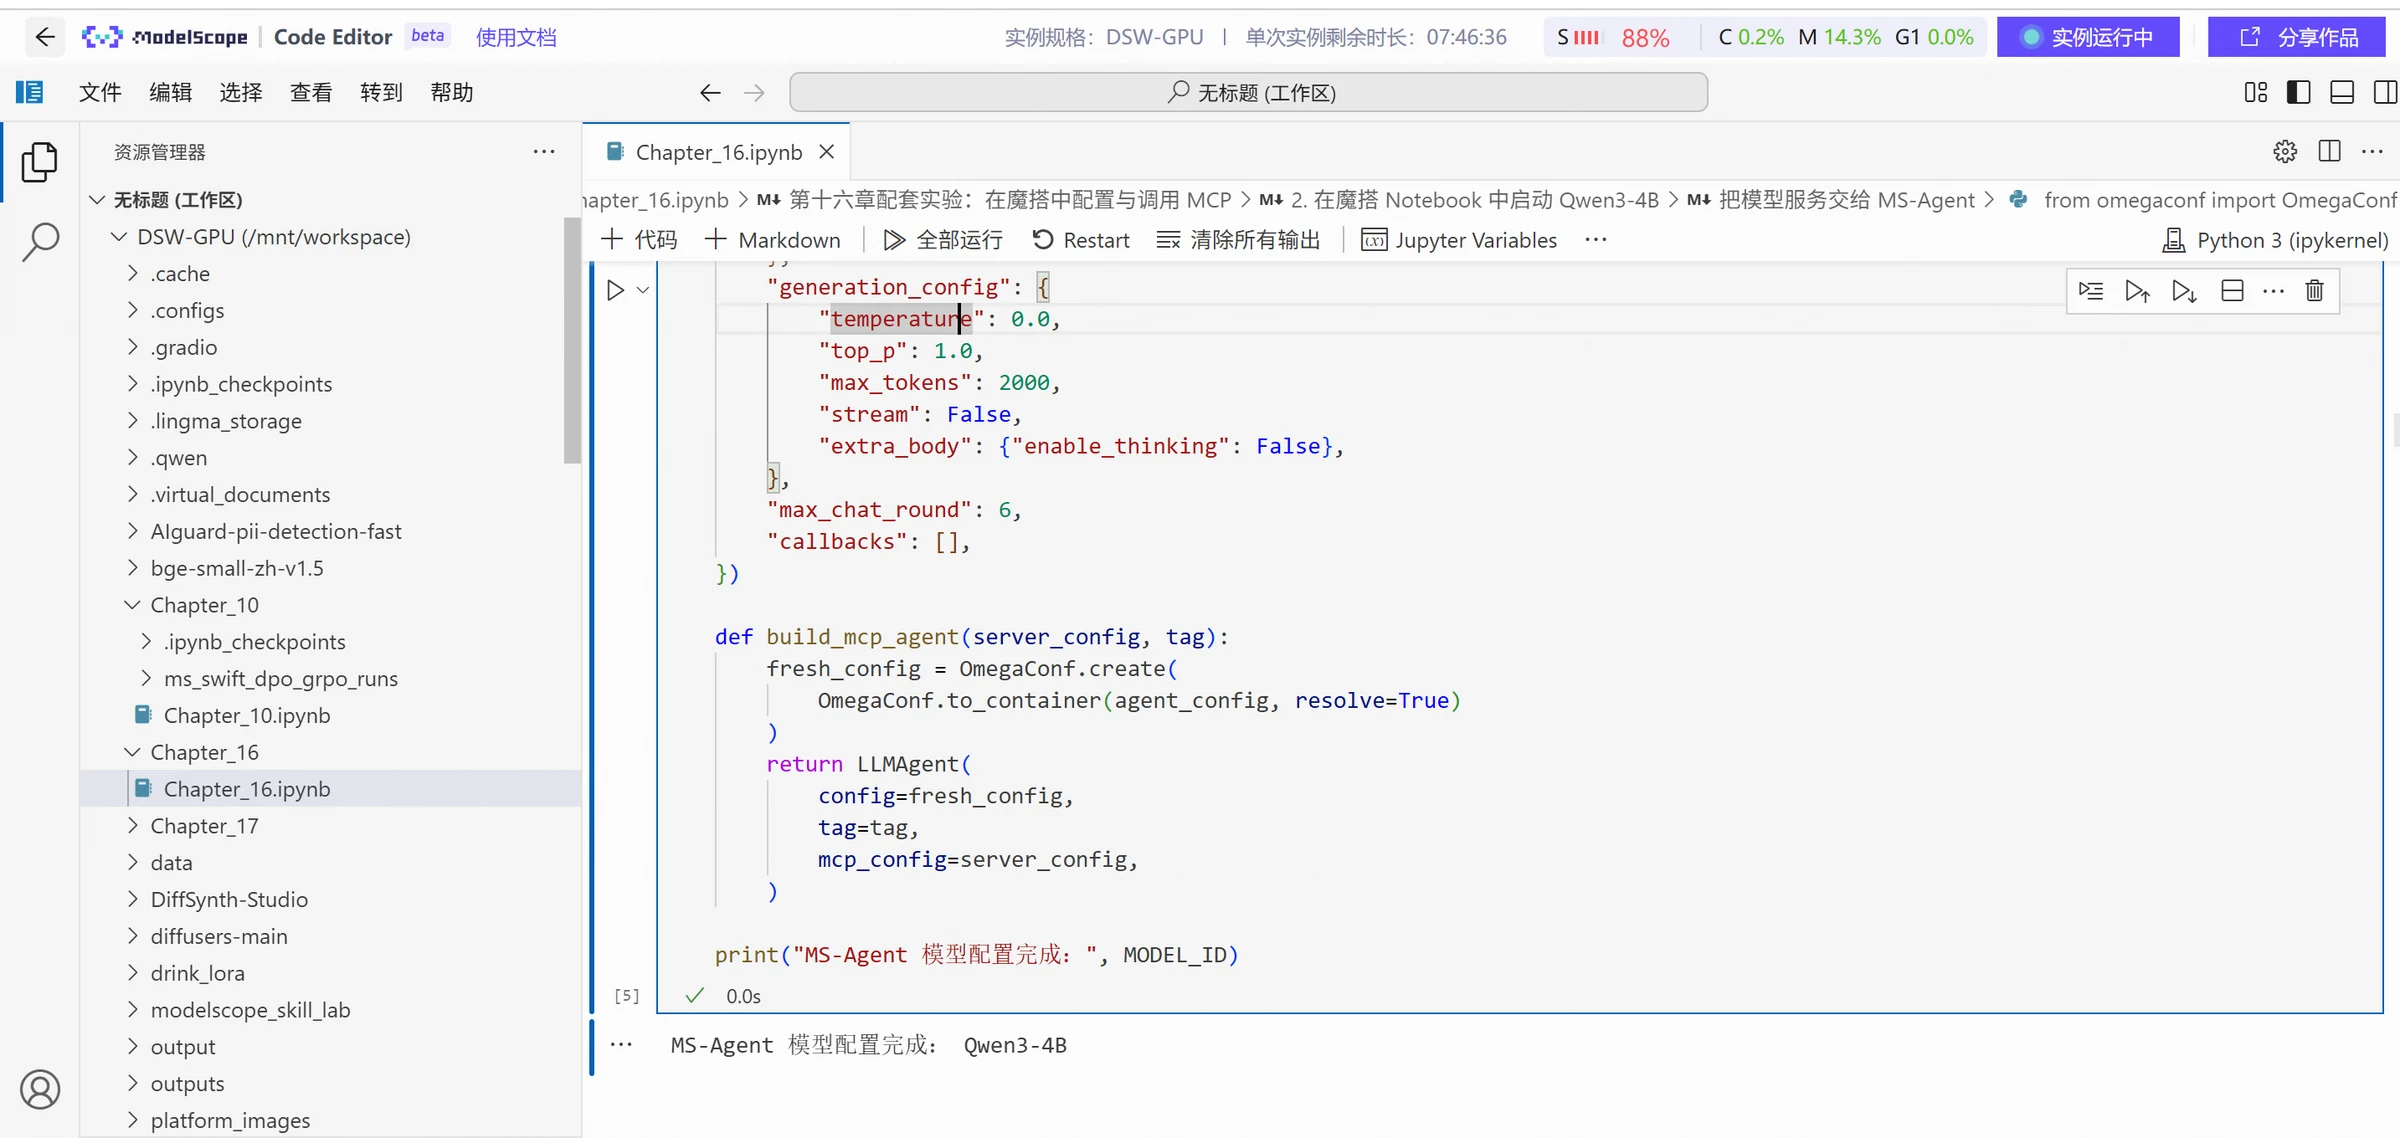
get_weather est l'identifiant affiché après que MS-Agent combine le nom de connexion du Serveur et le nom de l'outil. area et target_date ne sont pas des paramètres d'appel pré-écrits en dur, mais des paramètres structurés générés par Qwen3-4B basés sur « Hangzhou demain ». Les résultats d'enregistrement correspondants sont illustrés ci-dessous.
Traitement du retour d'outil et réponse finale
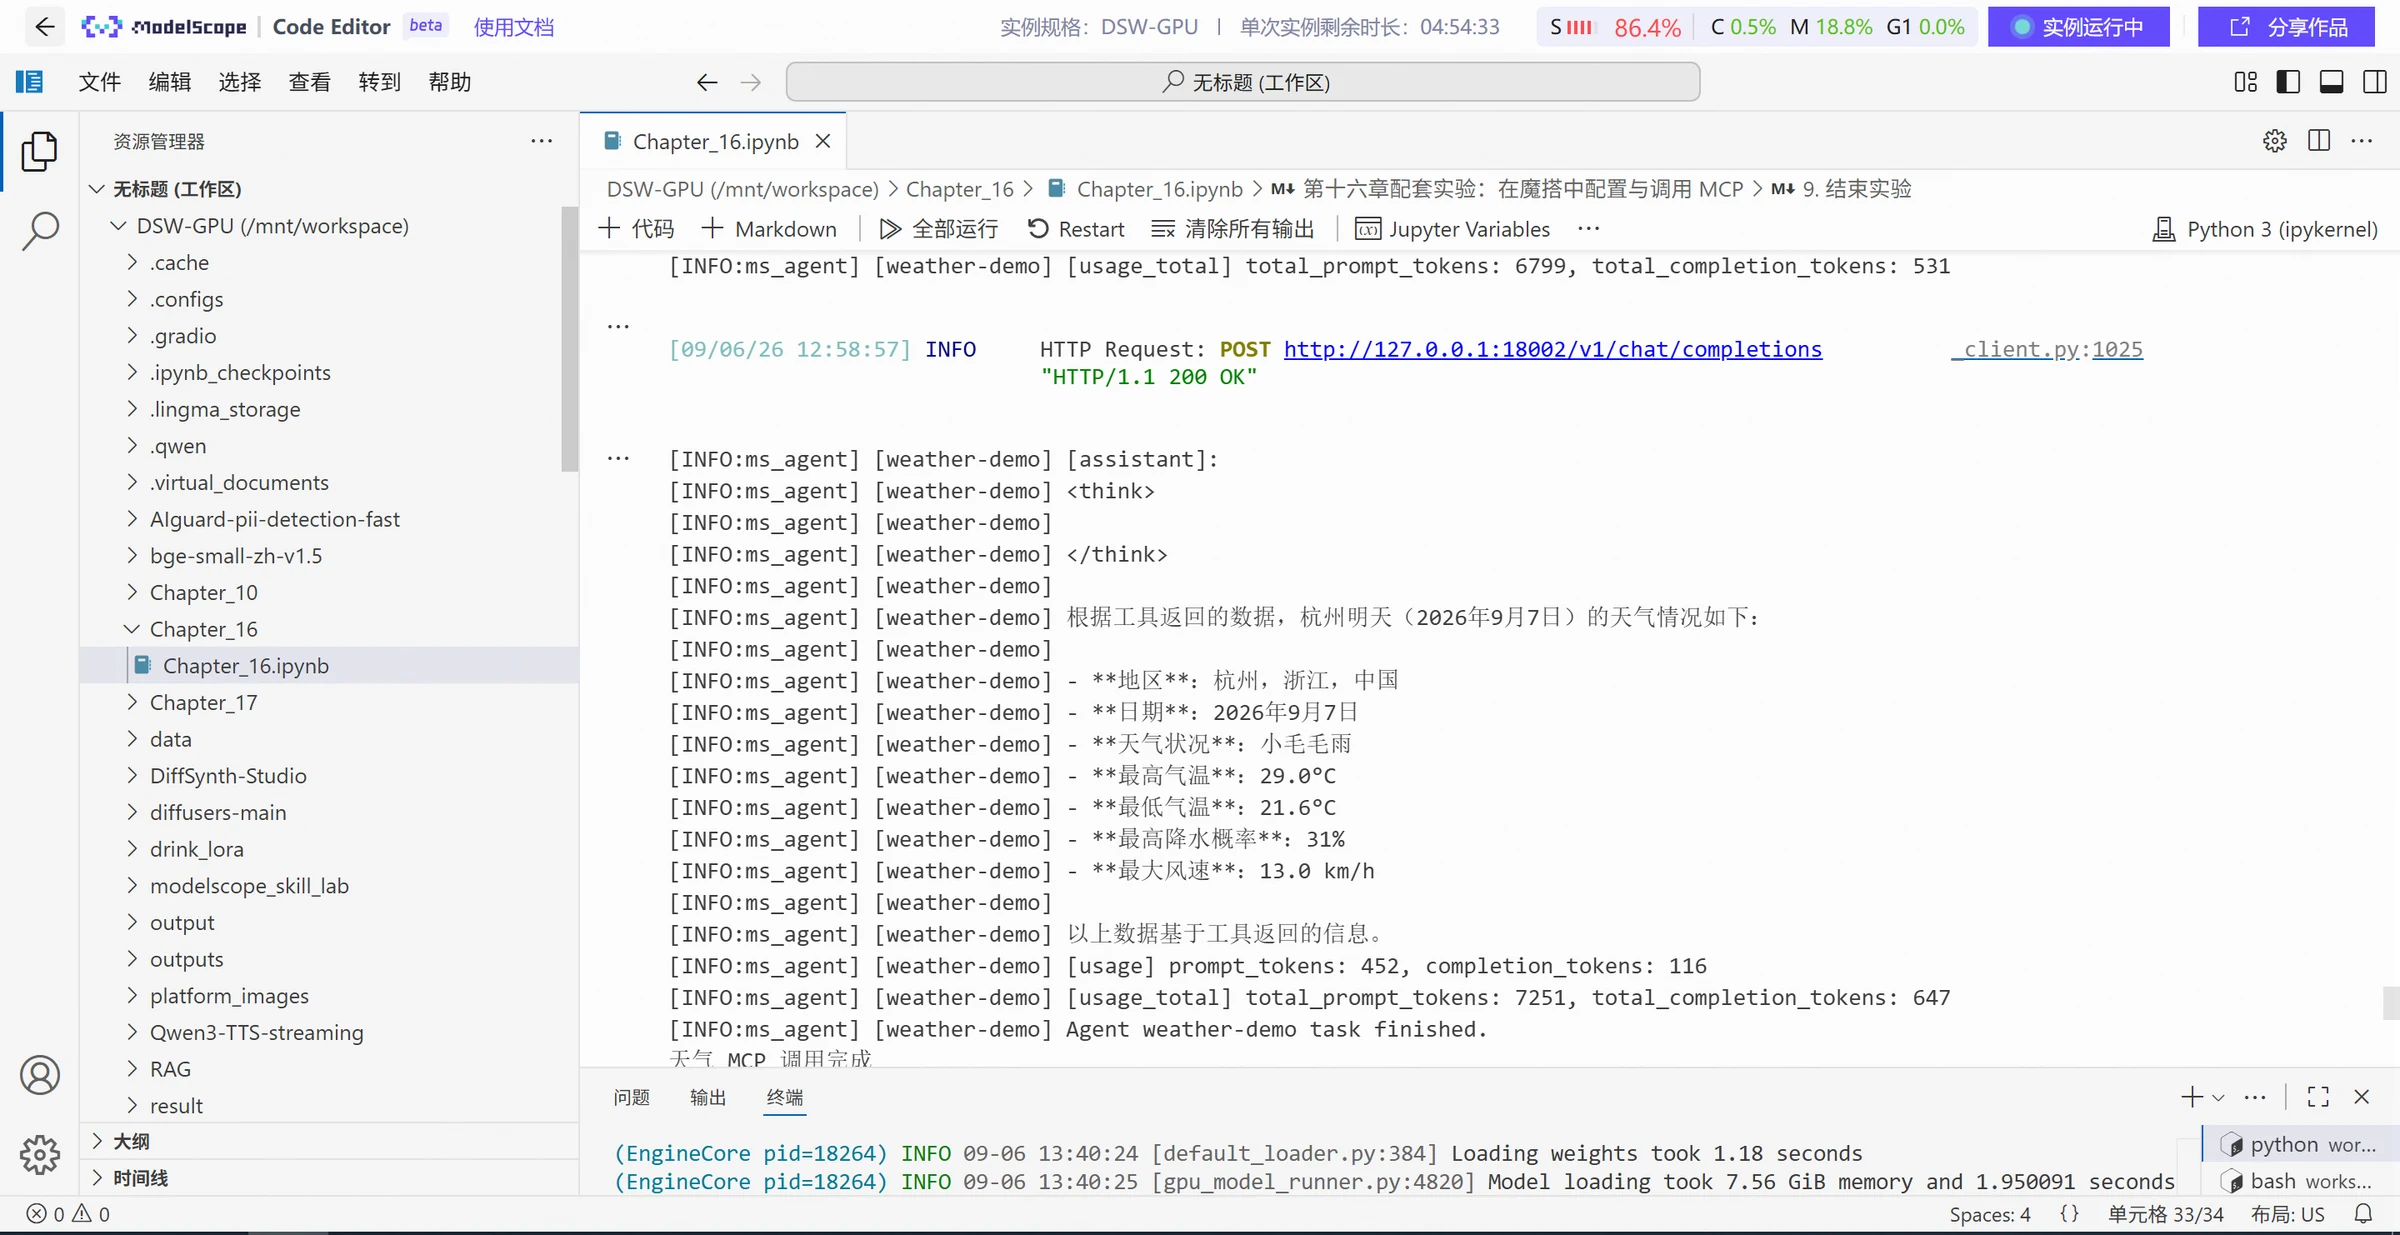
Le MCP météo reçoit les paramètres, analyse « Hangzhou » en « Hangzhou, Zhejiang, Chine », convertit tomorrow en 7 septembre 2026 selon le fuseau horaire local, et retourne :
Qwen3-4B génère ensuite une réponse en langage naturel basée sur ces résultats, listant la région réellement correspondante, la date, les conditions météorologiques, les températures maximales et minimales, la probabilité de précipitations et la vitesse maximale du vent. La chaîne d'appels « comprendre la question — sélectionner l'outil — générer les paramètres — exécuter l'outil — traiter les résultats » est ainsi terminée. Les résultats combinés du grand modèle sont illustrés ci-dessous :
Appel du service fetch dans la place MCP
Après l'hébergement et la configuration, connectez-vous d'abord directement au service et vérifiez la liste des outils. L'exemple de test utilise le site web https://example.com.
async def direct_fetch_check():
    async with streamable_http_client(MCP_SERVER_URL) as streams:
        read_stream, write_stream, _ = streams
        async with ClientSession(read_stream, write_stream) as session:
            await session.initialize()
            tools = await session.list_tools()
            print("Outils retournés par le serveur :", [tool.name for tool in tools.tools])
            result = await session.call_tool(
                "fetch",
                arguments={
                    "url": "https://example.com",
                    "max_length": 1000,
                    "start_index": 0,
                    "raw": False,
                },
            )
            if result.isError:
                raise RuntimeError(str(result.content)
            for block in result.content:
                if getattr(block, "type", None) == "text":
                    print(block.text)

await direct_fetch_check()
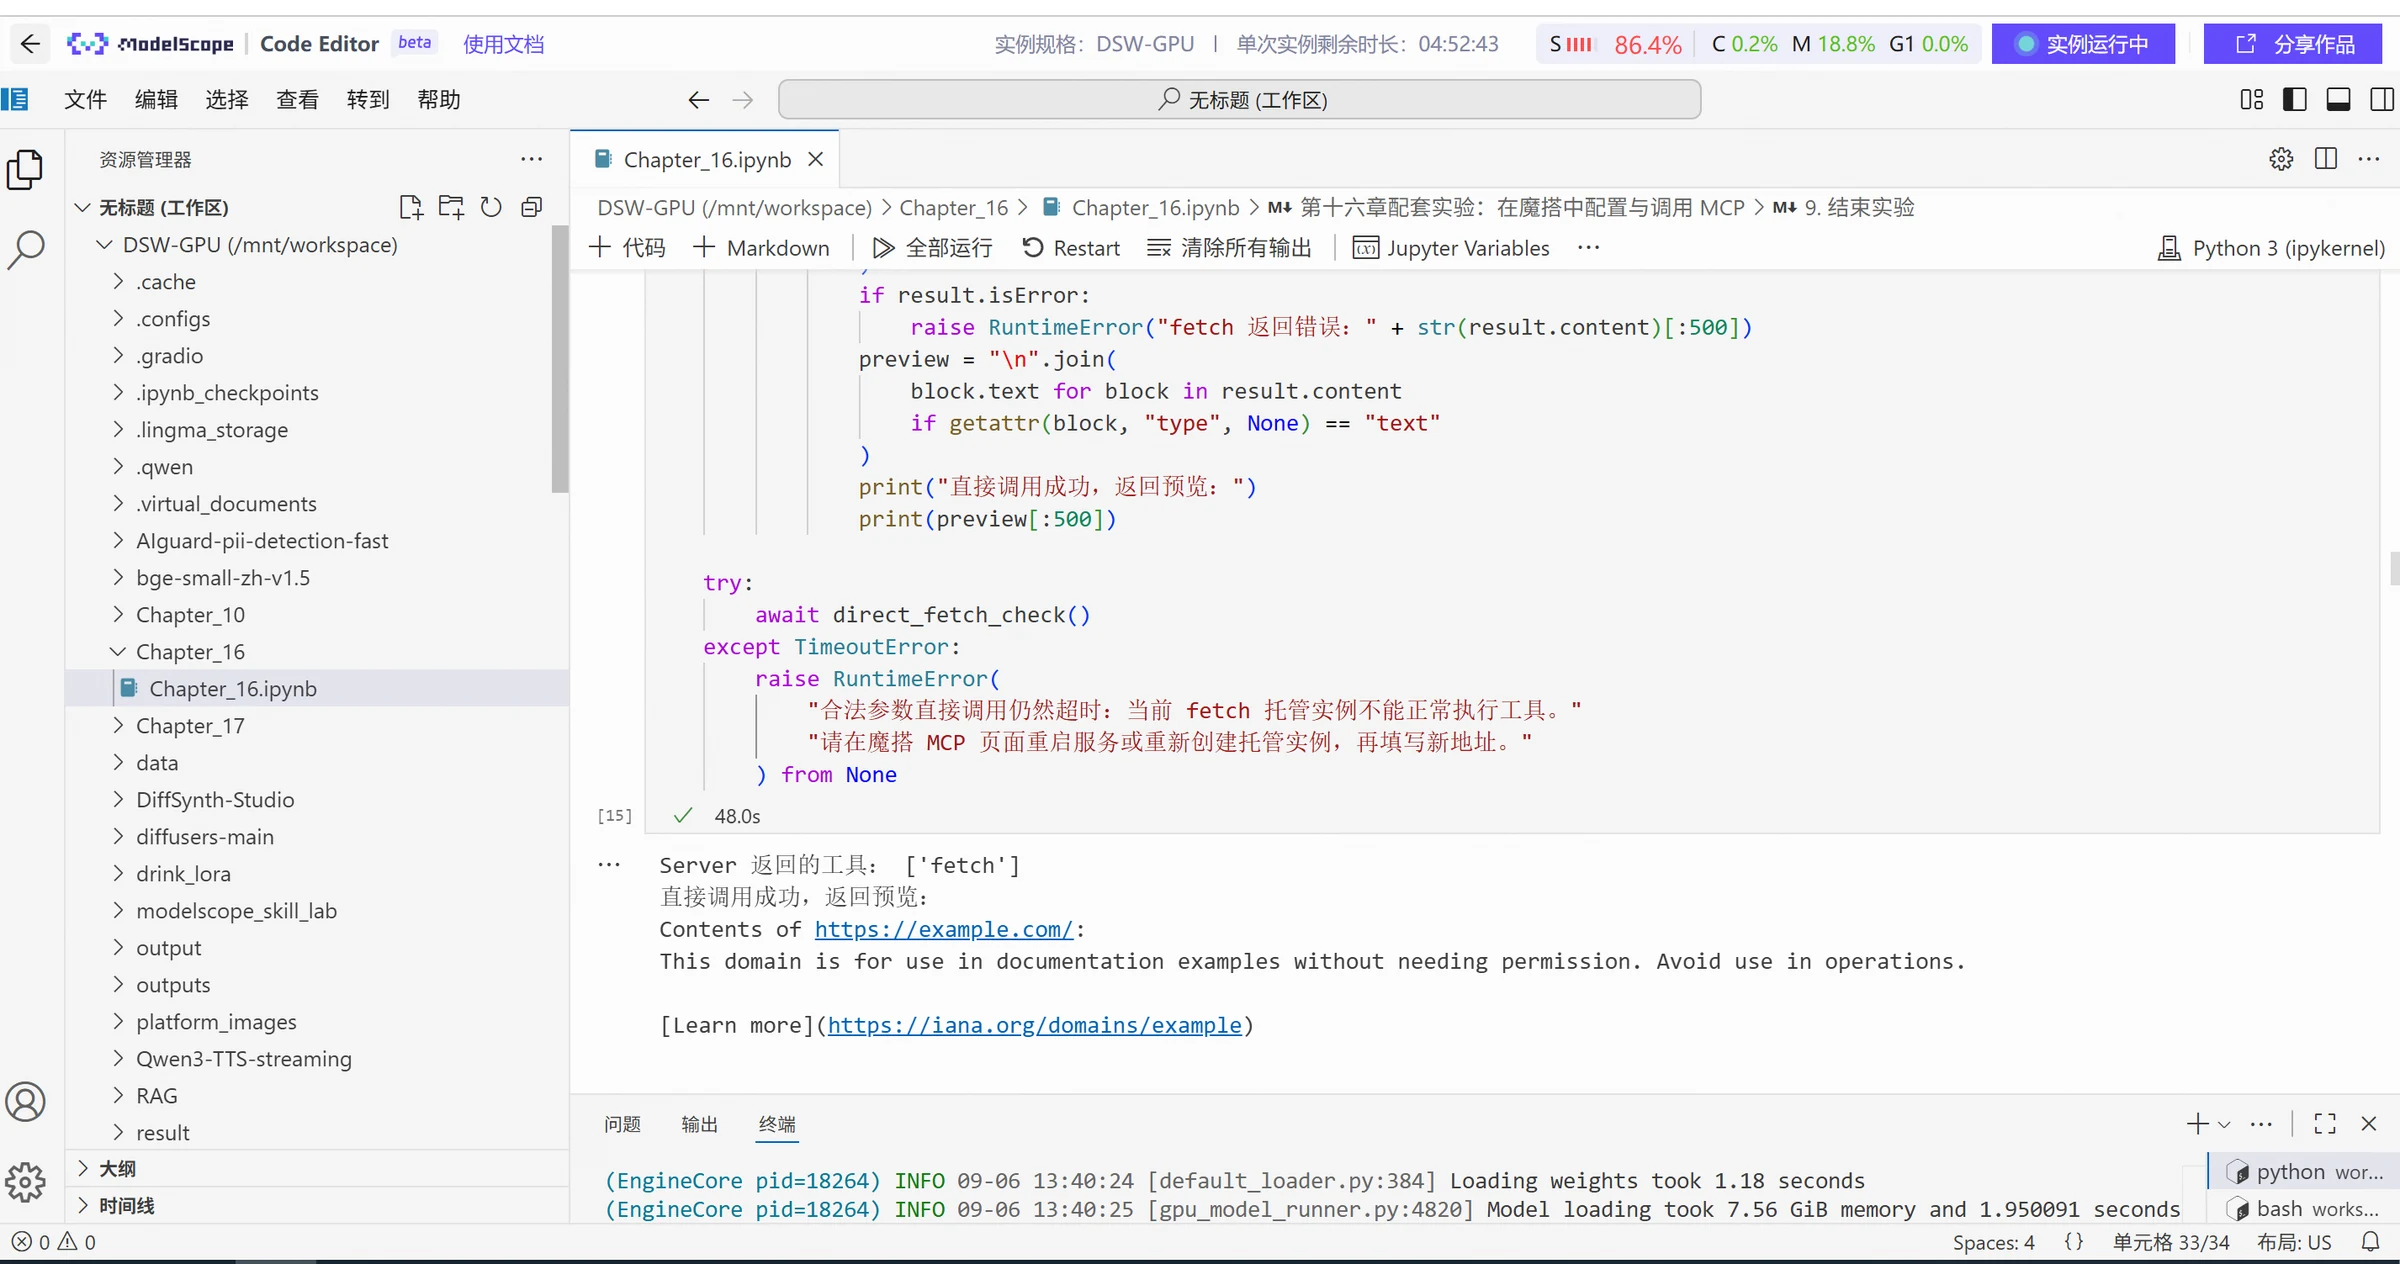
Lors de l'exécution réelle, le serveur expose l'outil fetch et retourne les extraits de contenu et les liens de la page web cible. Cela confirme que le service d'hébergement ModelScope, la connexion HTTP Streamable et l'outil de web scraping fonctionnent tous. La connexion directe au service fetch hébergé par ModelScope, la découverte des outils et le retour du contenu web sont illustrés ci-dessous.
Après l'appel direct réussi, réutilisez Qwen3-4B configuré précédemment pour laisser le modèle sélectionner l'outil de manière autonome :
Les journaux d'expérimentation montrent que MS-Agent s'est connecté avec succès au serveur nommé fetch, que Qwen3-4B a sélectionné fetch---fetch et généré les paramètres suivants :
Après le retour du contenu web par l'outil, le modèle explique que ce nom de domaine est utilisé pour des exemples de documentation et fournit le premier lien retourné par l'outil. Lors de la vérification de ces résultats, les paramètres générés par le modèle, le retour brut de l'outil et la réponse finale doivent être vérifiés séparément. Les résultats de l'exécution de Qwen3-4B pour la génération des paramètres d'appel de l'outil fetch, le contenu retourné par l'outil et la réponse finale sont illustrés ci-dessous :
L'utilisation directe des services d'application de la place MCP ModelScope par rapport à un MCP météo personnalisé réside dans le fait que l'implémentation et l'environnement d'exécution du serveur sont gérés par la capacité d'hébergement ModelScope, tandis que le Notebook n'a besoin que de sauvegarder la configuration de connexion et de lancer les appels. Qu'il s'agisse de services existants ou de services personnalisés, l'ordre de vérification est le même : vérifier l'état du service, découvrir les outils, tester directement, puis laisser le modèle appeler de manière autonome.
Gestion des autorisations MCP
La gestion des autorisations MCP ne doit pas se limiter à « ce serveur peut-il se connecter ou non », mais doit clarifier trois questions : quelles ressources l'utilisateur actuel peut-il accéder, quels outils le modèle peut-il appeler, et quel impact chaque appel aura sur les systèmes externes. Par conséquent, le contrôle d'accès doit être implémenté couche par couche du Host au Serveur MCP puis aux systèmes métier backend, en suivant toujours le principe du moindre privilège. Même les outils en lecture seule ne doivent pas être considérés comme sans risque par défaut, car ils peuvent toujours lire des informations sensibles telles que les informations clients, le code source et les jetons d'accès. Il est donc nécessaire de limiter les répertoires, tables, champs et étendues de retour accessibles, et de vérifier avec l'implémentation réelle du serveur s'il existe des enregistrements de données, une mise en cache ou des comportements de transfert supplémentaires.
Pour les opérations modifiant l'état externe, le contrôle d'accès doit être renforcé progressivement en fonction du risque. Les opérations d'écriture telles que la création de fichiers, la modification d'enregistrements, l'envoi d'e-mails et l'ajout d'événements doivent idéalement afficher l'objet cible et les paramètres clés à l'utilisateur avant l'exécution, et permettre la génération de brouillons ou l'affichage des différences pour confirmation. Il faut également éviter les écritures en double dues aux timeouts réseau et aux tentatives automatiques, en utilisant des clés d'idempotence, des contraintes uniques ou des vérifications d'état. Pour les opérations à haut risque telles que la suppression de données, les virements, les envois en masse, les publications publiques, la modification des autorisations, l'exécution de commandes et les modifications de production, l'exécution automatique doit être restreinte par défaut, avec une confirmation manuelle explicite, une approbation secondaire et un audit complet.
Outre les autorisations des outils themselves, les informations d'identification et les comptes doivent être contrôlés séparément. Les informations sensibles telles que les clés API et les jetons d'accès ne doivent pas apparaître dans les Prompts, les historiques de chat, les dépôts de code ou les journaux ordinaires. Lorsque le Serveur MCP accède aux systèmes backend, il doit utiliser des comptes et informations d'identification dédiés à portée limitée, plutôt que d'hériter directement de permissions excessives. Pour les systèmes sensibles, les capacités de requête et de modification peuvent être séparées dans différents serveurs, différents comptes ou même différentes zones réseau. En résumé, le principe fondamental de la gestion des autorisations MCP est : le fait qu'un outil puisse être découvert ne signifie pas qu'il peut être exécuté directement ; une seule autorisation ne signifie pas que toutes les opérations futures sont automatiquement autorisées.
Risques de sécurité MCP
MCP permet au modèle non seulement de générer du contenu, mais aussi de lire des fichiers, d'interroger des bases de données, d'appeler des services réseau et même de modifier des systèmes externes. Les risques de sécurité qu'il introduce sont donc plus complexes que ceux d'un simple modèle de chat. Les sources de risque incluent non seulement les entrées utilisateur, mais aussi les pages web, les documents, les enregistrements de bases de données, les résultats retournés par les outils, le code du serveur et les dépendances tierces. Le plus typique est l'injection de Prompt : des instructions malveillantes peuvent être cachées dans le contenu externe, incitant le modèle à continuer d'appeler des outils de fichiers, réseau ou messagerie, formant une chaîne d'opérations inter-systèmes dangereuse. Pour cela, on ne doit pas se fier uniquement à la capacité du modèle à « identifier les prompts malveillants », mais considérer tout le contenu externe comme des données non fiables, distinguer strictement les objectifs utilisateur, les règles système et les résultats des outils, et limiter la portée des outils que le contenu externe peut déclencher.
Un autre risque majeur est l'accès non autorisé et la fuite d'informations sensibles. Les paramètres générés par le modèle ne doivent pas être considérés comme une base d'autorisation. Le Host peut contrôler quels outils exposer au modèle, mais le Serveur doit toujours vérifier l'appartenance des ressources et les droits d'accès à chaque appel en fonction de l'identité réelle de l'utilisateur, pas seulement lors de l'établissement de la connexion. Il faut également contrôler la circulation des données entre les différents systèmes, ne transmettre au Serveur que les champs nécessaires à l'accomplissement de la tâche actuelle, masquer ou bloquer les informations sensibles telles que les clés, les numéros de carte d'identité et les numéros de téléphone, utiliser HTTPS pour les connexions distantes, et éviter de stocker les informations d'identification complètes et le contenu sensible dans les journaux.
MCP présente également des risques liés aux outils malveillants et à la chaîne d'approvisionnement. L'environnement de production ne doit pas se concentrer uniquement sur les appels individuels, mais doit mettre en place un mécanisme de sécurité multicouche complet. Avant de se connecter à un Serveur, vérifiez la source, le code, les dépendances et les autorisations requises ; lors de la connexion, utilisez des comptes restreints, des informations d'identification à portée limitée et un réseau contrôlé ; après la découverte des outils, classez-les en lecture seule, écriture et haut risque, et n'ouvrez au modèle que les capacités réellement nécessaires ; avant l'exécution, validez les paramètres et exigez une confirmation manuelle pour les opérations sensibles telles que la suppression, l'envoi, le téléchargement et la modification des autorisations ; pendant l'exécution, limitez le timeout, la concurrence, le volume de retour et la portée réseau ; après l'exécution, vérifiez le contenu retourné par les outils et conservez les journaux d'audit nécessaires. Pour l'environnement de production, il est préférable de maintenir une liste blanche de serveurs audités et un inventaire de versions, de réévaluer les autorisations après changement d'outil ou de version, et de pouvoir désactiver rapidement le serveur, révoquer les jetons et tracer les enregistrements d'opérations en cas d'anomalie.
Scénarios adaptés à MCP
MCP est plus adapté aux scénarios où il y a de nombreux outils et sources de données externes, où l'on souhaite que ces capacités puissent être réutilisées par différents modèles ou Agents, et où l'on souhaite que le modèle décide dynamiquement quels outils appeler en fonction de la tâche actuelle. Les applications courantes incluent l'accès aux fichiers, les requêtes de bases de données et la recherche d'informations. Par exemple, un Serveur MCP de type fichiers peut permettre au modèle de parcourir, lire et rechercher des fichiers de projet ; un Serveur de type base de données peut interroger les stocks, les commandes et les données opérationnelles ; un Serveur de type recherche peut se connecter à Internet, à des bases de connaissances d'entreprise ou à des bibliothèques spécialisées. Lors de l'utilisation, limitez autant que possible la portée des données nécessaires à l'accomplissement de la tâche, privilégiez l'accès en lecture seule pour les fichiers, utilisez des comptes en lecture seule ou des requêtes contrôlées pour les bases de données, et limitez la portée des requêtes, les champs retournés et le nombre de résultats.
MCP est également adapté à la connexion d'e-mails, de calendriers, de disques en ligne, de systèmes de gestion de projet et des API métier existantes de l'entreprise, permettant au modèle d'étendre ses capacités de « recherche d'informations » à « accomplissement d'opérations ». Par exemple, le modèle peut interroger les horaires de réunion, organiser les progrès du projet, générer des brouillons d'e-mails, ou appeler des capacités métier telles que le service client, la logistique, l'approbation, les tickets et la gestion des équipements. Lors de la conception de ces outils, il est préférable de décomposer les capacités en actions métier aux limites claires, par exemple en fournissant séparément « interroger un ticket », « ajouter une note à un ticket » et « fermer un ticket », plutôt qu'un outil universel permettant d'appeler n'importe quelle interface. Les opérations de requête et de modification doivent également séparer les autorisations autant que possible, et les opérations modifiant l'état externe telles que l'envoi d'e-mails, la modification des autorisations partagées, la fermeture de tickets et les mises à jour en masse doivent conserver une confirmation manuelle et des enregistrements d'audit nécessaires.
Cependant, toutes les interfaces n'ont pas besoin d'être transformées en MCP. Si le flux métier est fixe, les relations d'appel claires, les exigences de latence élevées et qu'il n'est pas nécessaire que le modèle détermine « quel outil utiliser à l'étape suivante », l'appel direct à une API classique est souvent plus simple et fiable. Pour les tâches à haut risque telles que la suppression de données, les opérations financières et les modifications de production, si les mécanismes de contrôle d'accord, d'approbation manuelle, d'audit et de retour en arrière ne sont pas encore matures, l'automatisation ne doit pas être mise en œuvre simplement parce que MCP peut s'y connecter. En résumé, la valeur de MCP réside principalement dans la capacité du modèle à sélectionner et combiner de manière flexible plusieurs capacités externes, tandis que les appels système fixes et déterminés peuvent continuer à utiliser les API traditionnelles.
Toutes les données expérimentales et le code de ce chapitre sont disponibles à :