La première fois que vous vous préparez à télécharger un grand modèle, les indications 7B, 32B, 128K et INT4 sur la page du modèle peuvent être déroutantes : 7B indique la taille du modèle, 128K semble pouvoir contenir un livre entier, et INT4 peut réduire l'utilisation de la VRAM. Comment cela fonctionne-t-il ?
Après avoir commencé à utiliser les modèles, vous rencontrerez des problèmes supplémentaires : des comptes rendus de réunion qui ne tiennent pas, des conversations longues où le contexte antérieur est oublié, des réponses du modèle sans fondement, et le même modèle se comportant différemment avec différentes méthodes de quantification.
Pour déterminer si un modèle est adapté à une tâche donnée, vous devez comprendre comment le texte entre dans le modèle, comment les capacités du modèle sont formées, et pourquoi le modèle consomme de la mémoire et de la VRAM pendant l'inférence.
Ces connaissances peuvent être organisées le long de trois fils conducteurs. Le premier part de l'architecture globale du Transformer, puis couvre les Tokens, l'Embedding et l'Attention pour expliquer comment un texte entre dans le modèle et est traité. Le second couvre le pré-entraînement, l'ajustement par instruction et le post-entraînement pour expliquer comment les capacités du modèle se forment. Le troisième couvre la longueur du contexte, le KV Cache, la quantification et le matériel, qui déterminent si un modèle peut fonctionner de manière stable sur les appareils cibles.
Ce chapitre distille les connaissances fondamentales des chapitres précédents. Pour l'inférence des modèles, vous pouvez vous référer aux chapitres 6 et 7. Pour le SFT des modèles, vous pouvez vous référer à la présentation du framework d'ajustement ms-swift intégré au chapitre 9. Pour le contenu du post-entraînement, vous pouvez également vous référer au chapitre 10 sur l'alignement de préférence et l'apprentissage par renforcement. Pour les applications de modèles de domaine et les problèmes d'hallucination, vous pouvez également vous référer à la présentation des méthodes RAG au chapitre 13, qui utilisent des connaissances externes pour améliorer les questions-réponses de domaine et réduire davantage les hallucinations du modèle.
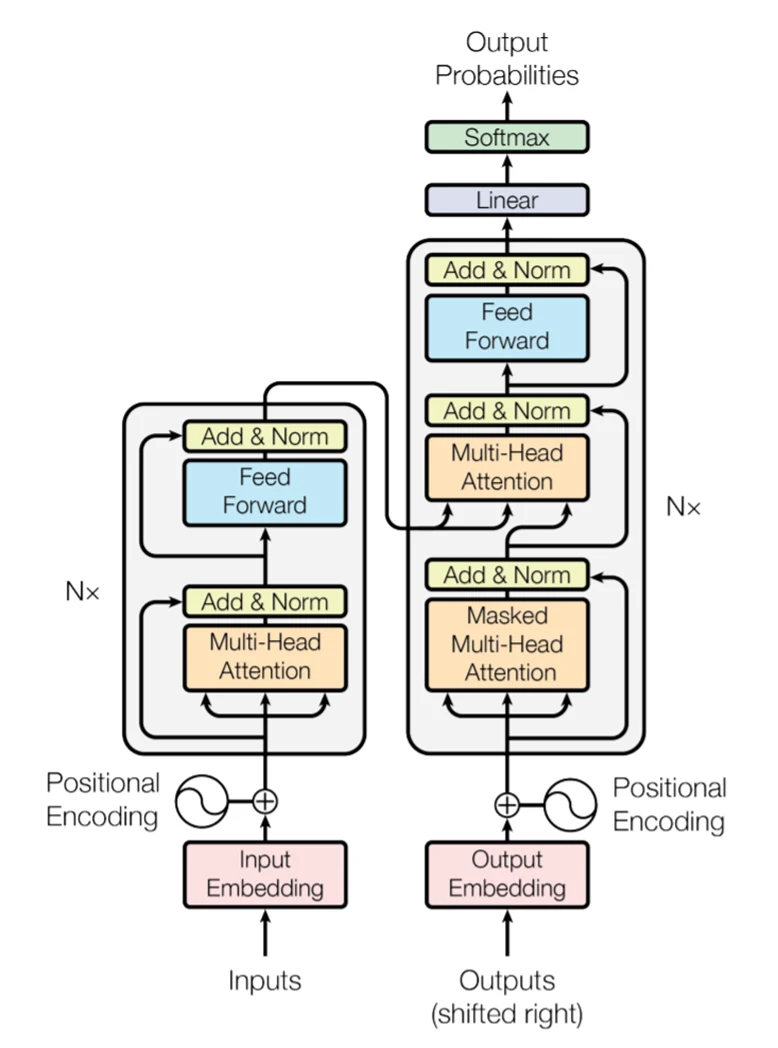
Le Transformer est l'architecture fondamentale utilisée par la plupart des grands modèles de langage aujourd'hui. Contrairement aux réseaux neuronaux récurrents précédents qui traitent le texte de manière séquentielle, le Transformer peut calculer plusieurs positions en parallèle pendant l'entraînement et le traitement des entrées, et établit des connexions entre différentes positions grâce à l'Attention. Un Transformer classique se compose d'un Encodeur et d'un Décodeur. Chaque couche du Transformer contient généralement de l'Attention et un réseau feed-forward. Le réseau feed-forward, également appelé FFN ou MLP, applique des transformations non linéaires aux vecteurs à chaque position. Des connexions résiduelles et une normalisation par couche sont également utilisées dans les couches pour aider l'information à circuler de manière stable à travers les réseaux profonds. Lorsque de nombreuses couches similaires sont empilées, le modèle développe progressivement des capacités complexes de représentation et de génération de texte. L'architecture globale du Transformer est illustrée dans la figure ci-dessous : le côté gauche est l'Encodeur et le côté droit est le Décodeur. Le dans la figure indique que des modules similaires sont empilés plusieurs fois ; le nombre réel de couches varie selon l'architecture du modèle et l'échelle des paramètres.
Se connecter pour rejoindre la discussion
N×Pendant l'inférence du modèle, lorsqu'un utilisateur saisit un texte, le modèle subit le traitement suivant : d'abord, le Tokenizer divise le texte brut en Tokens individuels et les convertit en Token IDs correspondants. Ensuite, la couche Embedding mappe ces Token IDs discrets en représentations vectorielles continues, tout en ajoutant des informations de position pour que le modèle connaisse l'ordre de chaque Token dans la phrase. Ensuite, ces vecteurs passent à travers plusieurs couches du Transformer pour un traitement répété, où le mécanisme d'Attention permet à différents Tokens de s'attirer mutuellement et d'échanger des informations contextuelles, et le réseau feed-forward traite davantage les caractéristiques à chaque position. Après plusieurs couches de calcul, le modèle obtient une représentation complète du contexte actuel, calcule la distribution de probabilité pour le Token suivant, sélectionne ou échantillonne le Token suivant, et l'ajoute au contexte pour répéter ce processus jusqu'à la génération du contenu complet.
Les trois composants du Transformer original ont chacun des rôles différents :
- Structure Encodeur seul : Principalement responsable de la compréhension de l'entrée ; il peut référencer simultanément différentes positions dans la séquence d'entrée, adapté aux tâches telles que la classification, l'extraction et la représentation sémantique ;
- Structure Décodeur seul : Principalement responsable de la génération de sortie ; lors de la génération de la position actuelle, il ne peut consulter que le contenu déjà apparu ;
- Structure Encodeur-Décodeur : Comprend d'abord l'entrée, puis génère progressivement la sortie, couramment utilisée dans les tâches de séquence à séquence telles que la traduction et la résumé.
Les grands modèles modernes n'utilisent pas nécessairement un Encodeur et un Décodeur complets simultanément. Sur cette base, diverses architectures dérivées du Transformer ont émergé. Par exemple, les modèles génératifs de type GPT utilisent généralement la structure Décodeur seul, les modèles de type BERT utilisent principalement l'Encodeur seul, et les modèles de type T5 conservent la structure Encodeur-Décodeur.
Un Token est l'unité de base utilisée lorsque le modèle lit et génère du texte. Il peut être un caractère, un mot, une partie d'un mot, une ponctuation, ou même un espace ou un marqueur de contrôle spécial. Par exemple, la même phrase peut produire des résultats différents avec différents Tokenizers :
Original : Les grands modèles de langage transforment la façon de travailler.

Tokenizer A : Les / grands / modèles / de / langage / transforment / la / façon / de / travailler / .
Tokenizer B : Les / grand / s / modèl / es / de / langag / e / transform / ent / la / faço / n / de / travailler / .
Les deux résultats expriment la même phrase, mais le nombre de Tokens diffère. Ce que le modèle reçoit réellement sont les identifiants numériques correspondant à chaque Token, connus sous le nom de Token ID. En prenant les comptes rendus de réunion comme exemple, ce que le modèle voit n'est pas un compte rendu complet mais une séquence de Token IDs. Le nom de la réunion, le contenu des interventions, l'heure, la ponctuation et les exigences de sortie consomment tous des Tokens ; le résumé, les conclusions et les éléments d'action générés par le modèle continuent également à consommer des Tokens. Par conséquent, plus la sortie demandée est détaillée pour un même matériel, moins il reste d'espace pour l'enregistrement original.
Si la tokenisation se fait entièrement par caractère, le vocabulaire peut être relativement petit mais les séquences deviennent plus longues. Si elle se fait entièrement par mots complets, le vocabulaire devient très large et rencontrera constamment de nouveaux mots, abréviations et variations d'orthographe. Les grands modèles utilisent généralement la tokenisation par sous-mots, trouvant un équilibre entre caractéres et mots complets. BPE, WordPiece, Unigram et SentencePiece sont des méthodes courantes.
Généralement, le modèle ne peut pas effectuer directement des opérations matricielles sur du texte ou des images ; il doit d'abord convertir le contenu en vecteurs numériques. Ce processus est appelé Embedding ou représentation vectorielle. Pour le texte, le Tokenizer convertit d'abord le texte en Token IDs, puis la couche Embedding recherche les vecteurs correspondants en fonction des IDs. Un seul nombre dans un vecteur n'a généralement pas de sens intuitif, mais le vecteur entier peut représenter les caractéristiques de ce Token dans le modèle. En prenant le Token « réunion » comme exemple, le Token ID correspondant pourrait être un entier spécifique tel que « 15872 », et la représentation de ce Token, c'est-à-dire son Embedding, pourrait être un vecteur comme [0.12, -0.37, 0.08, ...]. Les Embeddings sont continuellement ajustés pendant l'entraînement, et les Tokens qui apparaissent dans des contextes similaires tendent à former des caractéristiques similaires dans leurs vecteurs. En raison de différences dans l'architecture du modèle et l'entraînement, le même mot traité à travers plusieurs couches du Transformer formera également des représentations différentes selon le contexte.
Lorsque le modèle acquiert des informations sémantiques à partir du texte d'entrée, il doit savoir non seulement ce qu'est le Token, mais aussi où il se trouve. Avec uniquement l'Embedding de Token, par exemple, « réunion reportée » et « report de réunion » contiennent des Tokens similaires mais expriment des significations différentes en raison des différences d'ordre des mots. Par conséquent, le modèle a également besoin d'un encodage de position ou d'une représentation de position. La figure ci-dessous utilise la couche d'entrée de BERT comme exemple.
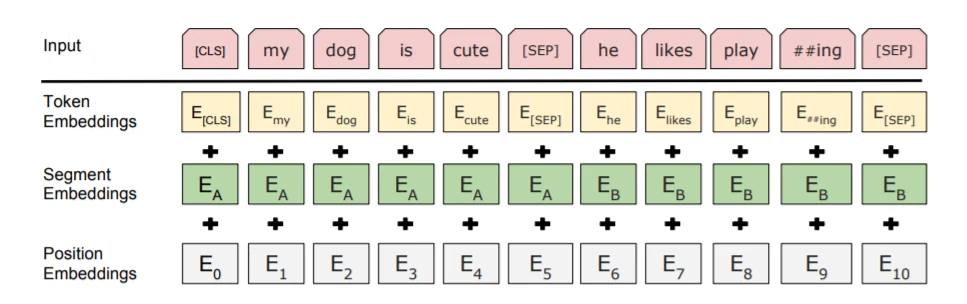
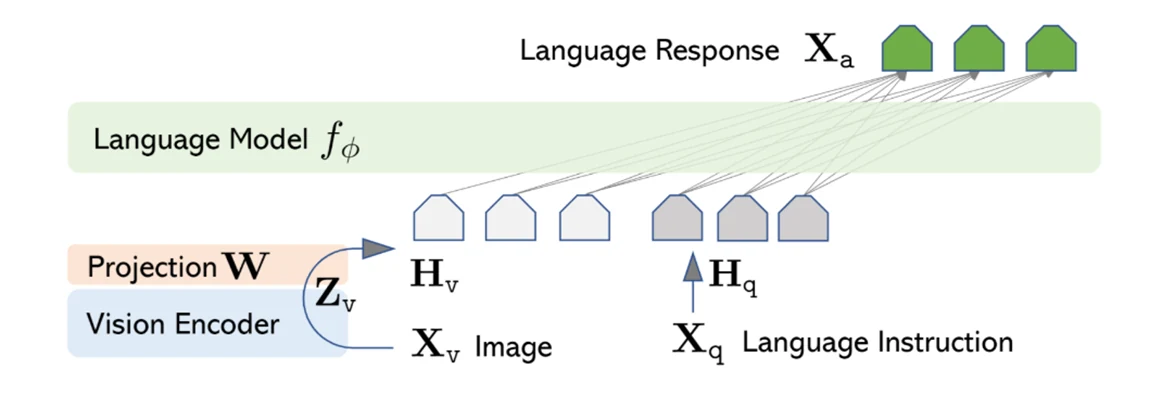
Comme le montre la méthode de représentation utilisée dans BERT ci-dessus, la figure démontre la combinaison de l'Embedding de Token, de l'Embedding de Segment et de l'Embedding de Position. Bien sûr, différentes architectures de modèles et approches de conception utilisent des méthodes spécifiques différentes. Pour les grands modèles multimodaux, les images, l'audio et d'autres contenu doivent également être convertis en vecteurs. Les images sont généralement divisées en patches, les encodeurs visuels extrayant les caractéristiques ; l'audio est d'abord converti en caractéristiques acoustiques, puis traité par des encodeurs audio. Les caractéristiques de différentes modalités doivent passer par un module de Projection avant d'entrer dans l'espace vectoriel que le grand modèle peut traiter. Comme le montre la figure ci-dessous, le module de Projection fusionne les informations d'image avec les informations sémantiques.
L'Attention détermine sur quelles parties de l'entrée la position actuelle doit se concentrer. Elle calcule la pertinence en se basant sur les représentations vectorielles existantes du modèle, plutôt que simplement en faisant correspondre des mots identiques. Par exemple, dans la phrase « Le projet a été retardé, et le rapport a expliqué pourquoi il n'a pas été terminé à temps », lorsque le modèle traite le pronom « il », il doit combiner le contexte pour déterminer s'il fait plus probablement référence au « projet » ou au « rapport ». Lors de l'extraction des personnes responsables à partir des comptes rendus de réunion, le modèle doit également relier les descriptions de tâches, les noms des personnes et les phrases indiquant la répartition des tâches.
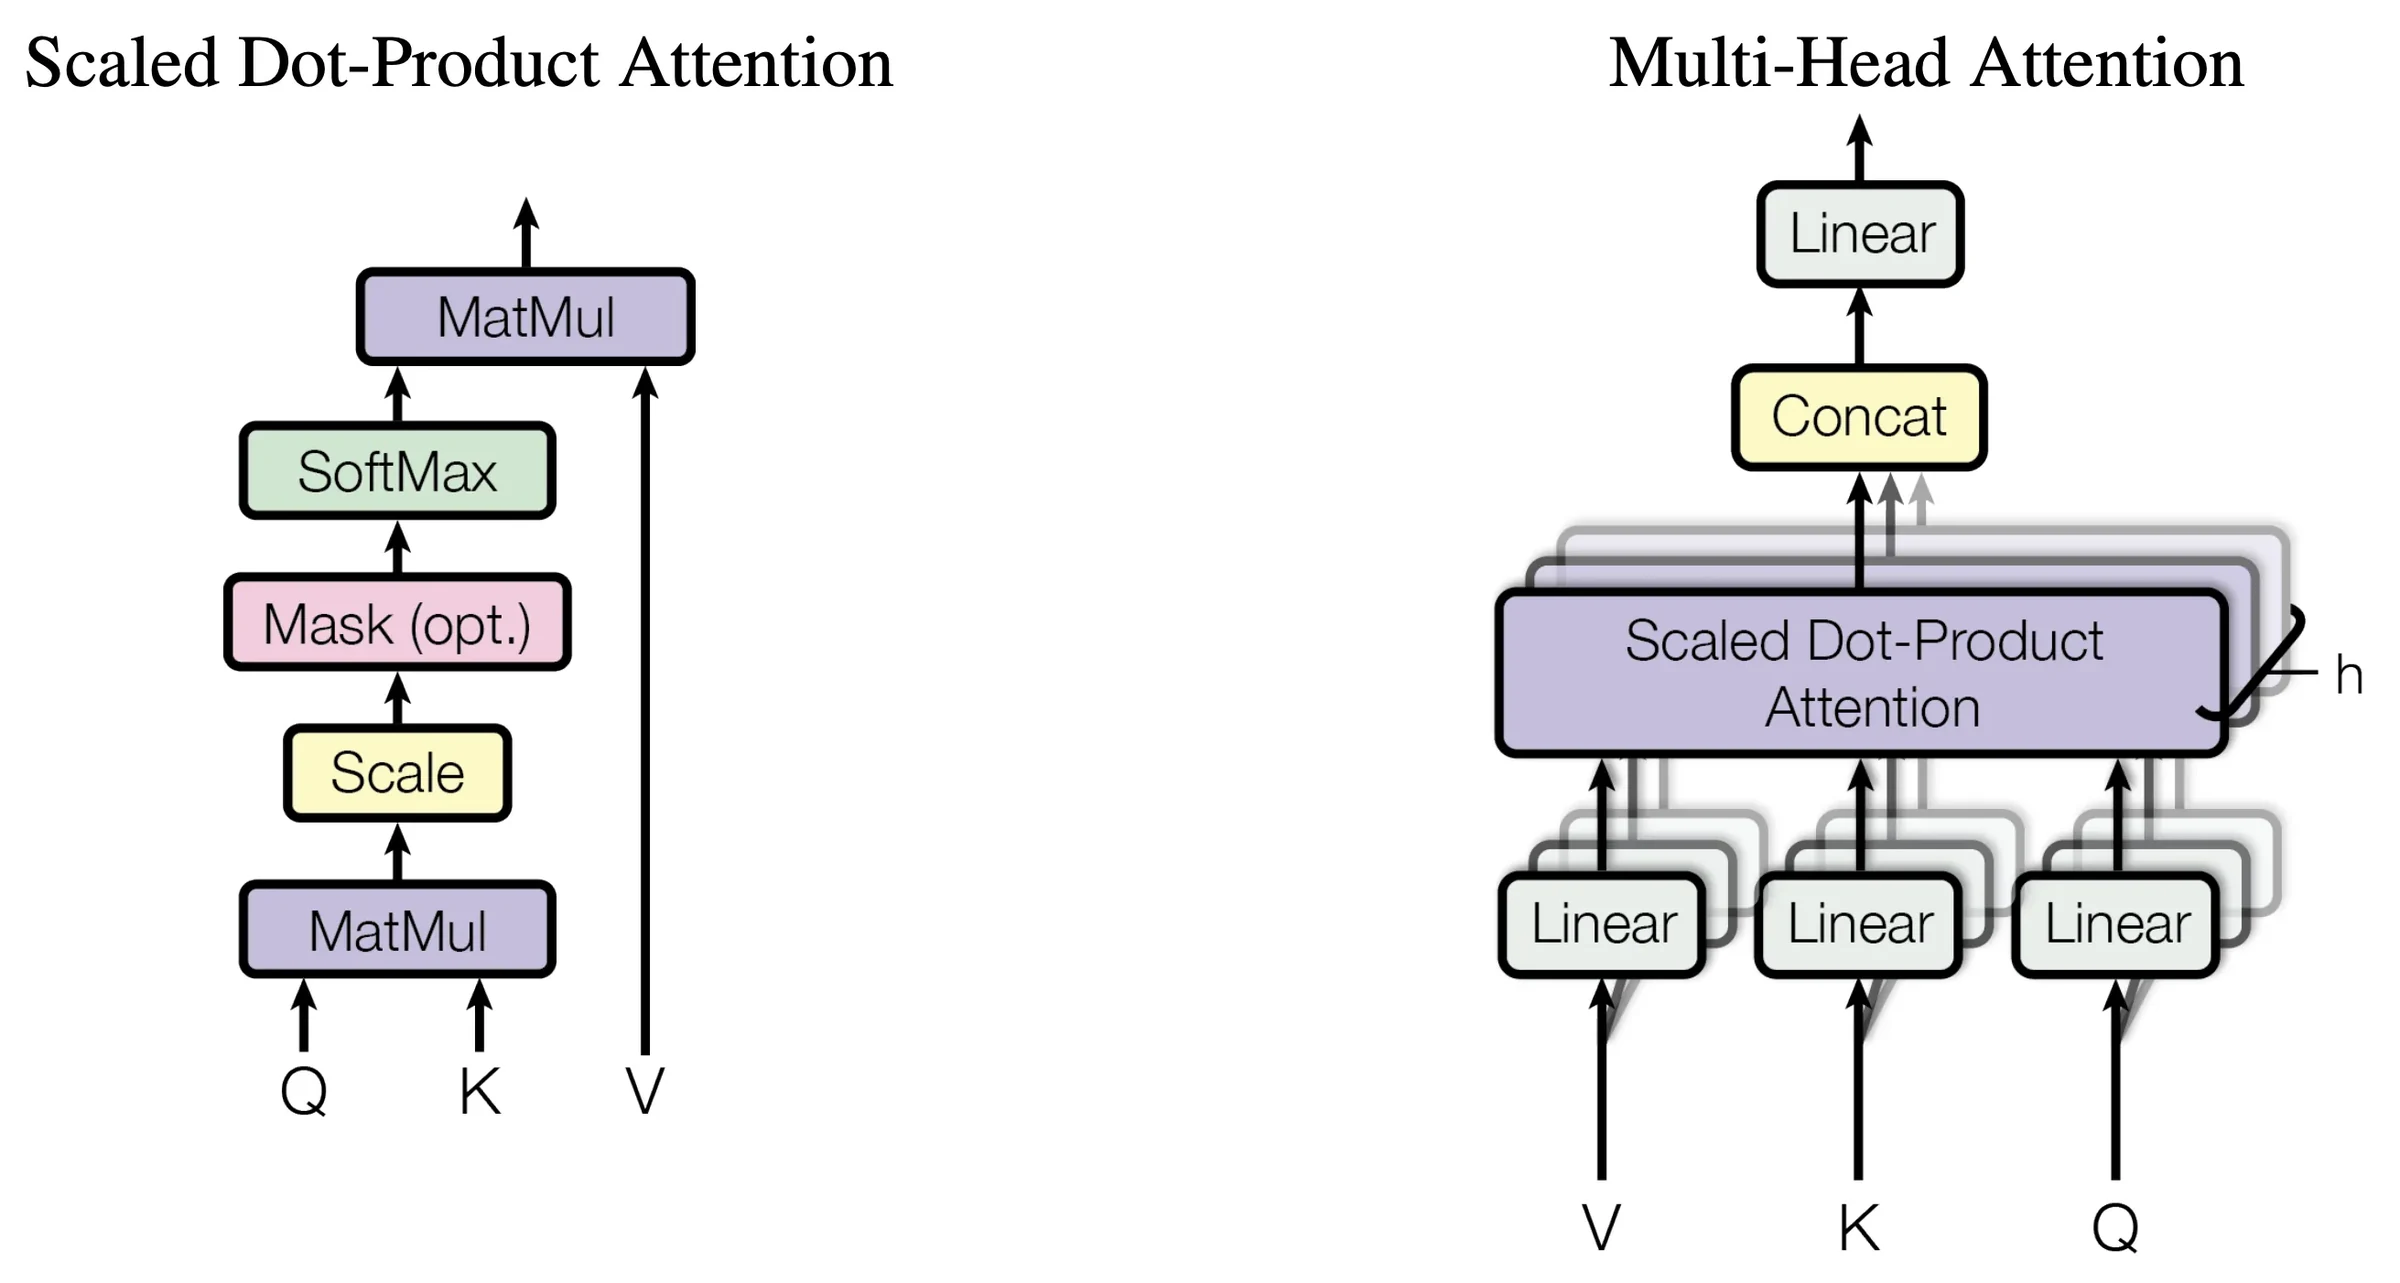
Chaque vecteur d'entrée subit des transformations différentes pour former Query, Key et Value, communément abrégés en Q, K et V. La formule de l'Attention peut être simplifiée comme suit :
$\mathrm{Attention}(Q, K, V)=\mathrm{softmax}\left(\frac{QK^{\mathrm{T}}}{\sqrt{d_k}}\right)V$
Ici, Q représente les informations que la position actuelle recherche, K représente les caractéristiques par lesquelles chaque position peut être appariée, et V représente le contenu à récupérer après l'appariement. Le modèle compare d'abord Q et K pour obtenir les scores de pertinence entre la position actuelle et les autres positions, puis convertit les scores en poids via softmax, et effectue une agrégation pondérée de V selon les poids. Le $d_k$ dans la formule est la dimension du vecteur Key ; la division par $\sqrt{d_k}$ ajuste l'échelle des scores pour rendre le calcul plus stable.
Si Q, K et V proviennent tous de la même séquence, on parle d'Auto-Attention (Self-Attention), utilisée pour établir des connexions au sein d'une séquence. Si Q provient d'une séquence tandis que K et V proviennent d'une autre, on parle d'Attention croisée (Cross-Attention). Par exemple, un modèle de traduction Encodeur-Décodeur peut permettre au Décodeur de lire les informations du texte source depuis l'Encodeur grâce à l'Attention croisée.
Pour les grands modèles génératifs, la position actuelle ne peut référencer que le contenu déjà apparu, l'Attention doit donc inclure un masque causale pour bloquer les positions suivantes. Même avec les futurs Tokens masqués, le nombre de relations traitées par l'attention causale complète croît encore approximativement de manière quadratique avec la longueur de la séquence. Pendant la phase de génération, les K et V historiques des Tokens doivent également être stockés, formant le KV Cache décrit plus tard. À mesure que le contexte s'allonge, le calcul de l'Attention et la surcharge du cache deviennent de plus en plus importants. Les différentes structures introduites ci-dessous ont évolué spécifiquement pour résoudre ces problèmes.
L'Attention Multi-Tête (MHA) a été proposée dans l'article Transformer de 2017 « Attention Is All You Need » et ensuite appliquée à BERT et à des modèles comme Llama 2 7B et 13B. Elle ajoute plusieurs têtes d'attention parallèles à un seul ensemble de calculs d'attention, permettant au modèle d'extraire des relations contextuelles de différents espaces de représentation.
Dans la MHA, chaque tête a ses propres paramètres de projection pour générer Q, K et V, calcule l'attention séparément, puis concatène les résultats de toutes les têtes et les fait passer à travers une couche linéaire pour former la sortie. Comme le montre la figure ci-dessous, le côté gauche montre le processus de calcul pour un ensemble d'attention par produit scalaire mis à l'échelle, tandis que le côté droit exécute ce processus plusieurs fois en parallèle puis fusionne les résultats. Les schémas d'attention des différentes têtes sont formés pendant l'entraînement et peuvent soutenir conjointement des tâches telles que la résolution de coréférence, l'association sémantique et les dépendances à longue distance.
La MHA améliore la capacité du modèle à agréger différents types d'informations et facilite le calcul parallèle pendant l'entraînement. Cependant, lors de la génération Token par Token, chaque tête doit lire ses propres K et V historiques. À mesure que le nombre de couches, de têtes et la longueur du contexte du modèle augmentent, ce cache et cette lecture de données consomment des ressources importantes. Par conséquent, les améliorations suivantes ont d'abord envisagé si plusieurs têtes Query pouvaient être conservées tout en réduisant le nombre de têtes Key et Value à stocker.
L'Attention Multi-Requête (MQA) a été proposée par Noam Shazeer dans l'article de 2019 « Fast Transformer Decoding: One Write-Head is All You Need » et ensuite appliquée à de grands modèles comme Falcon-7B. Elle traite principalement le problème de la bande passante mémoire pendant le décodage : lorsque le modèle génère chaque nouveau Token, il doit lire le KV Cache existant. Lorsque le volume de lecture est trop important, la vitesse de génération est limitée même si les unités de calcul ont encore de la capacité.
La MQA conserve plusieurs têtes Query mais leur permet de partager un seul ensemble de Key et Value. Ainsi, les différentes têtes peuvent toujours générer différentes requêtes, mais les positions historiques n'ont besoin de stocker qu'une copie de K et V pour que toutes les têtes la partagent. La figure ci-dessous montre une méthode d'initialisation pour convertir un modèle MHA existant en MQA : faire la moyenne de plusieurs matrices de projection Key pour obtenir une projection partagée, avec la projection Value traitée de la même manière. Après la conversion, un entraînement supplémentaire est nécessaire pour adapter le modèle à la nouvelle structure partagée.
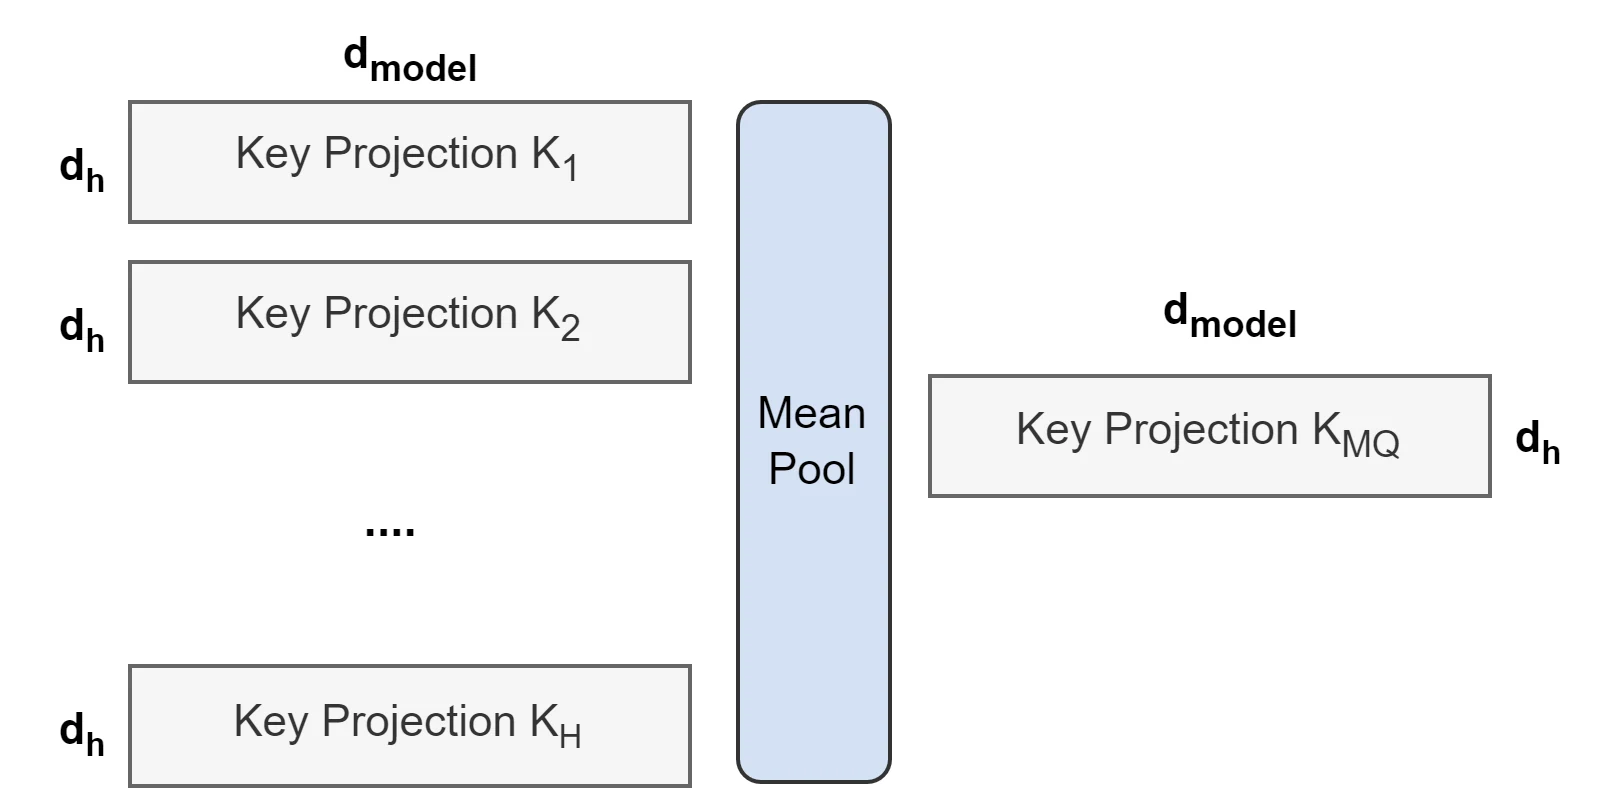
Avec cette structure, la MQA peut réduire significativement le KV Cache et le volume de lecture de données par étape de décodage, libérant de l'espace pour des entrées plus longues ou des requêtes concurrentes plus nombreuses. Par exemple, Falcon-7B est configuré avec 71 têtes Query mais seulement 1 tête KV. Comparé à une structure KV à 71 groupes avec la même dimension de tête et la même précision, son cache KV théorique n'est d'environ 1/71. Cependant, le partage restreint également la capacité de représentation de K et V, un entraînement et une évaluation sont donc nécessaires pour confirmer l'impact de ce gain d'efficacité sur la qualité des tâches.
L'Attention Groupée par Requête (GQA) a été systématiquement proposée par l'équipe Google Research dans l'article GQA de 2023 et appliquée à de grands modèles comme Llama 2 70B et Mistral 7B. Elle vise à équilibrer la capacité de représentation multi-groupe de la MHA avec la faible surcharge de cache de la MQA, évitant la situation où toutes les têtes Query doivent utiliser le même ensemble de K et V.
La GQA divise les têtes Query en plusieurs groupes, chaque groupe partageant un seul ensemble de Key et Value, tandis que différents groupes conservent des représentations K et V différentes. Comme le montre la figure ci-dessous, la MHA configure un ensemble correspondant de K et V pour chaque tête Query, la MQA laisse toutes les têtes Query partager un seul ensemble de K et V, et la GQA partage au sein des groupes. Lorsque le nombre de groupes est égal au nombre de têtes Query, la GQA est équivalente à la MHA ; lorsqu'il n'y a qu'un seul groupe, elle est équivalente à la MQA.
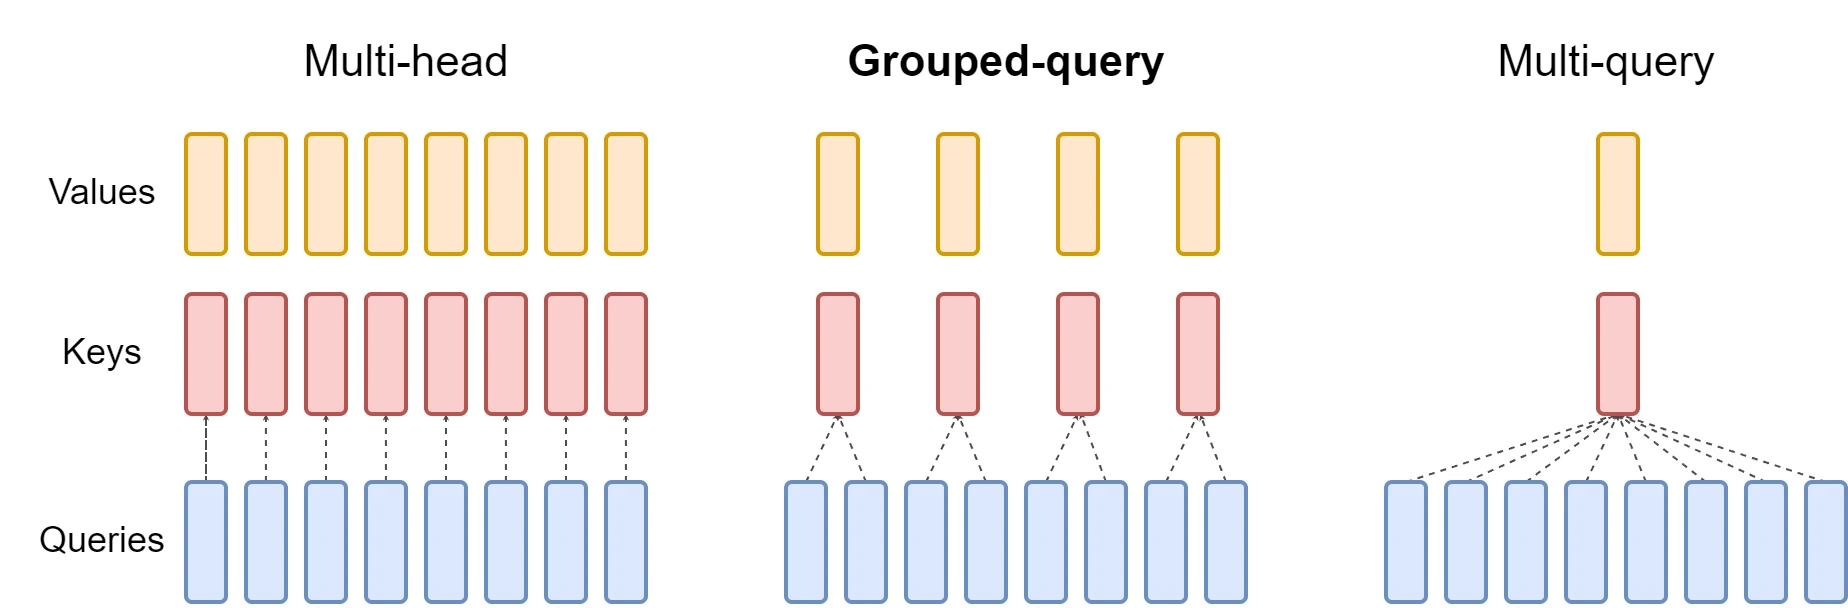
En prenant Mistral 7B v0.1 comme exemple, il a 32 têtes Query et 8 têtes KV, avec 4 têtes Query partageant un ensemble de K et V. Avec la même dimension de tête et la même précision, ce cache est d'environ 1/4 de celui de la MHA. Pour le déploiement pratique, réduire le cache et le volume de lecture aide généralement à améliorer la concurrence et l'efficacité du décodage. Puisque les différents groupes conservent toujours leurs propres K et V, la GQA conserve également plus d'espace de représentation que la MQA totalement partagée. Ce qui est réduit ici est le nombre de têtes KV ; le modèle peut toujours calculer l'attention pour toutes les positions historiques auxquelles il a le droit d'accéder.
L'Attention à Fenêtre Glissante (SWA) provient de l'approche d'attention locale dans la modélisation de séquences longues. Mistral 7B v0.1 l'utilise en combinaison avec la GQA. La GQA réduit le nombre de têtes KV à stocker par position, tandis que la SWA limite davantage la plage historique à laquelle chaque position se réduit directement, réduisant la pression de calcul et de cache pour les longs textes.
La SWA définit une fenêtre de taille fixe pour chaque Token, ne calculant l'attention que pour les positions récentes dans la fenêtre. La figure ci-dessous montre l'attention causale complète à gauche, l'Attention à Fenêtre Glissante au milieu, et à droite, comment l'information passe à travers plusieurs couches du réseau vers l'arrière. Bien qu'une seule couche ne lise que la plage locale, la représentation du Token de la couche précédente contient déjà des informations contextuelles antérieures, donc après traitement à travers plusieurs couches, le modèle peut indirectement utiliser le contenu au-delà de la fenêtre.
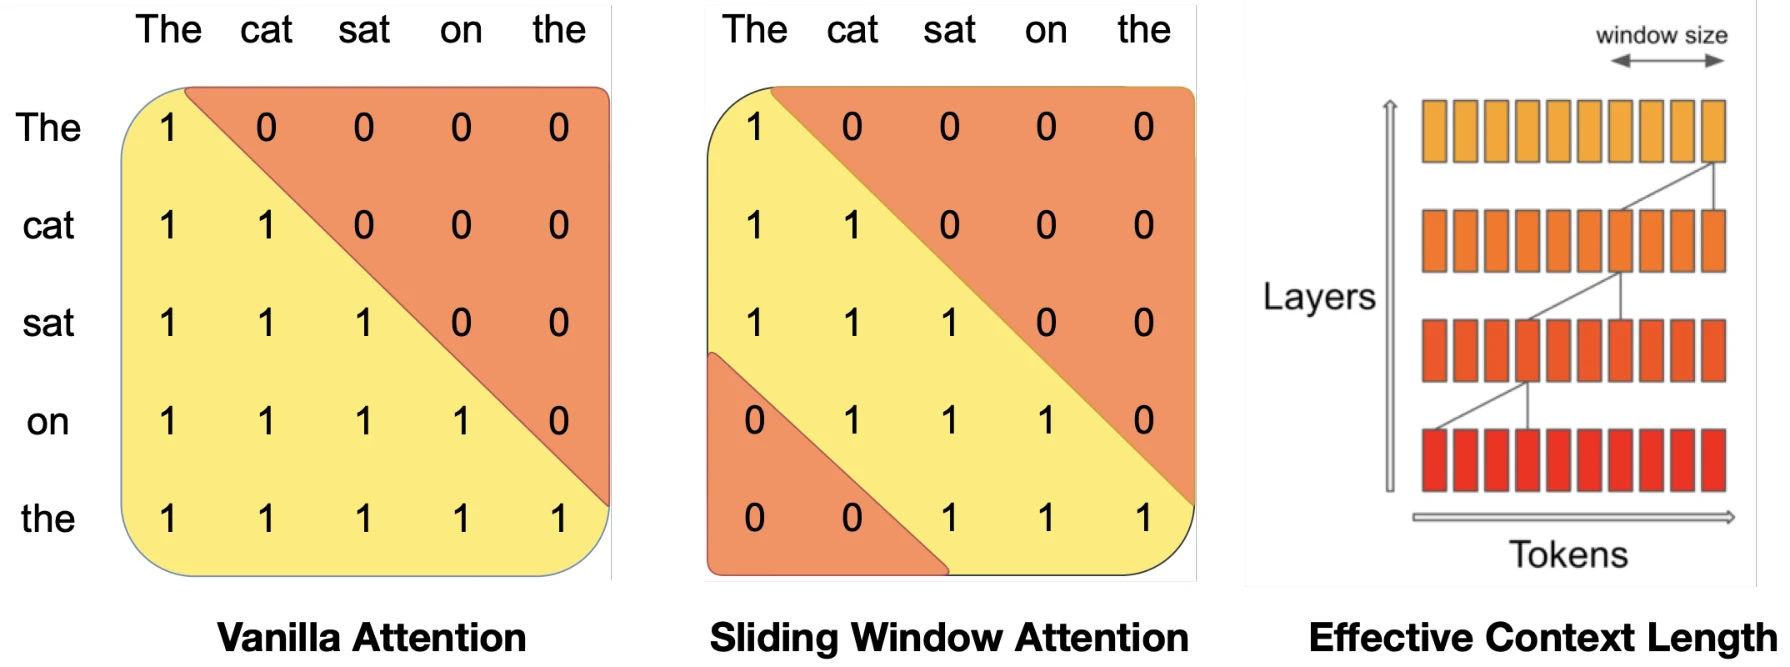
Mistral 7B v0.1 utilise une fenêtre de 4096 Tokens et emploie un cache rotatif pour couvrir les anciens K et V qui ont quitté la fenêtre, permettant à chaque couche de maintenir son cache dans une plage fixe. Dans les tests de l'article avec une séquence de 16K et une fenêtre de 4096, avec l'optimisation de noyau correspondante, la vitesse était d'environ 2 fois celle de la ligne de base d'attention complète. Cette structure peut contrôler la croissance des ressources pour les longs textes, mais les détails originaux éloignés doivent passer par des représentations intermédiaires, la taille de la fenêtre locale ne peut donc pas être directement équivalente à la longueur de contexte que le modèle peut récupérer avec précision.
L'Attention Latente Multi-Tête (MLA) a été proposée par l'équipe DeepSeek dans DeepSeek-V2 et ensuite utilisée dans DeepSeek-V3. Elle traite également le problème d'un KV Cache excessif mais modifie davantage le format de stockage : en apprenant une représentation jointe compacte, elle réduit la quantité de données à stocker par Token tout en supportant plusieurs têtes d'attention utilisant ces informations.
Plus spécifiquement, l'MLA utilise d'abord une projection de rang réduit pour représenter conjointement K et V en vecteurs latents de dimension inférieure. Pendant l'inférence, uniquement ce vecteur et la composante Key qui porte indépendamment les informations de position rotative sont mis en cache. Plusieurs têtes Query peuvent utiliser cette représentation partagée pour l'appariement et l'agrégation d'informations, et certaines matrices de projection peuvent être fusionnées pendant l'inférence, réduisant le besoin d'étendre explicitement les K et V complets. Les zones hachées dans la figure ci-dessous indiquent le contenu à mettre en cache, montrant comment l'MLA transfère le cache multi-tête K et V vers la représentation latente plus petite à droite.
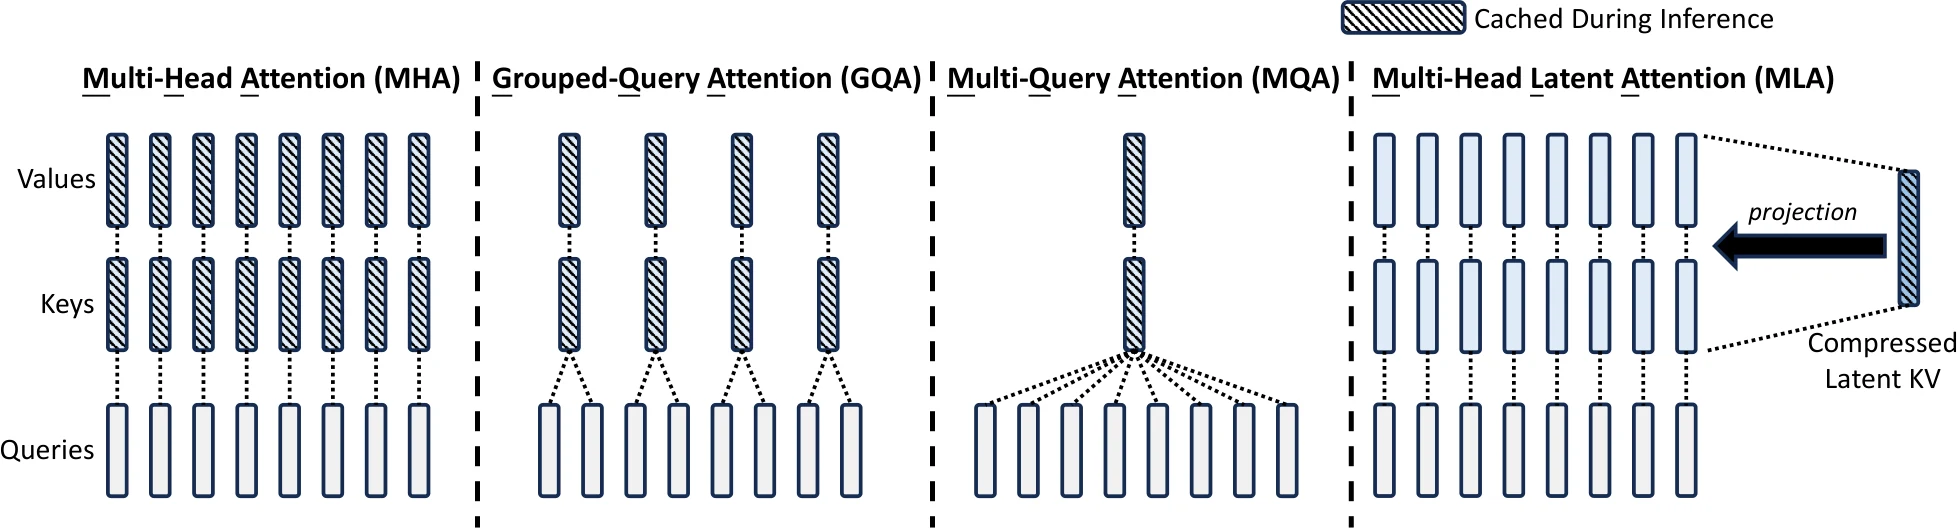
Cette conception permet à DeepSeek-V2 et V3 de maintenir la capacité expressive multi-tête tout en réduisant la pression de cache lors de la génération de longs contextes. Dans le rapport DeepSeek-V2, la taille du cache KV par Token de l'MLA est équivalente à seulement 2,25 groupes de têtes KV en GQA. Elle comprime la dimension de représentation à chaque position ; les positions historiques elles-mêmes sont toujours conservées, donc en mode d'attention complète, le modèle doit toujours lire et appariement toutes les entrées historiques. Pour réduire davantage le nombre d'entrées participant au calcul à chaque fois, l'attention creuse doit être introduite.
L'Attention Creuse DeepSeek (DSA) a été proposée par l'équipe DeepSeek et appliquée à DeepSeek-V3.2-Exp et DeepSeek-V3.2. S'ajoutant à l'MLA, elle ajoute un mécanisme de sélection dynamique pour résoudre le problème où, même lorsque les entrées KV individuelles sont déjà petites, la lecture et le calcul de toutes les entrées historiques dans les longs contextes restent coûteux.
La DSA utilise d'abord un indexeur léger appelé Lightning Indexer pour calculer les scores de pertinence entre la Query actuelle et les Tokens historiques, puis sélectionne les positions Top-k avec les scores les plus élevées pour que l'Attention principale les traite. La zone verte dans la figure ci-dessous est le nouveau processus d'indexage, où le sélecteur Top-k choisit les positions, et l'Attention principale ci-dessus lit le cache MLA correspondant aux positions sélectionnées. L'indexeur utilise des représentations plus petites et moins de têtes pour effectuer le filtrage, avec des coûts de calcul inférieurs à l'exécution directe de l'Attention principale complète.
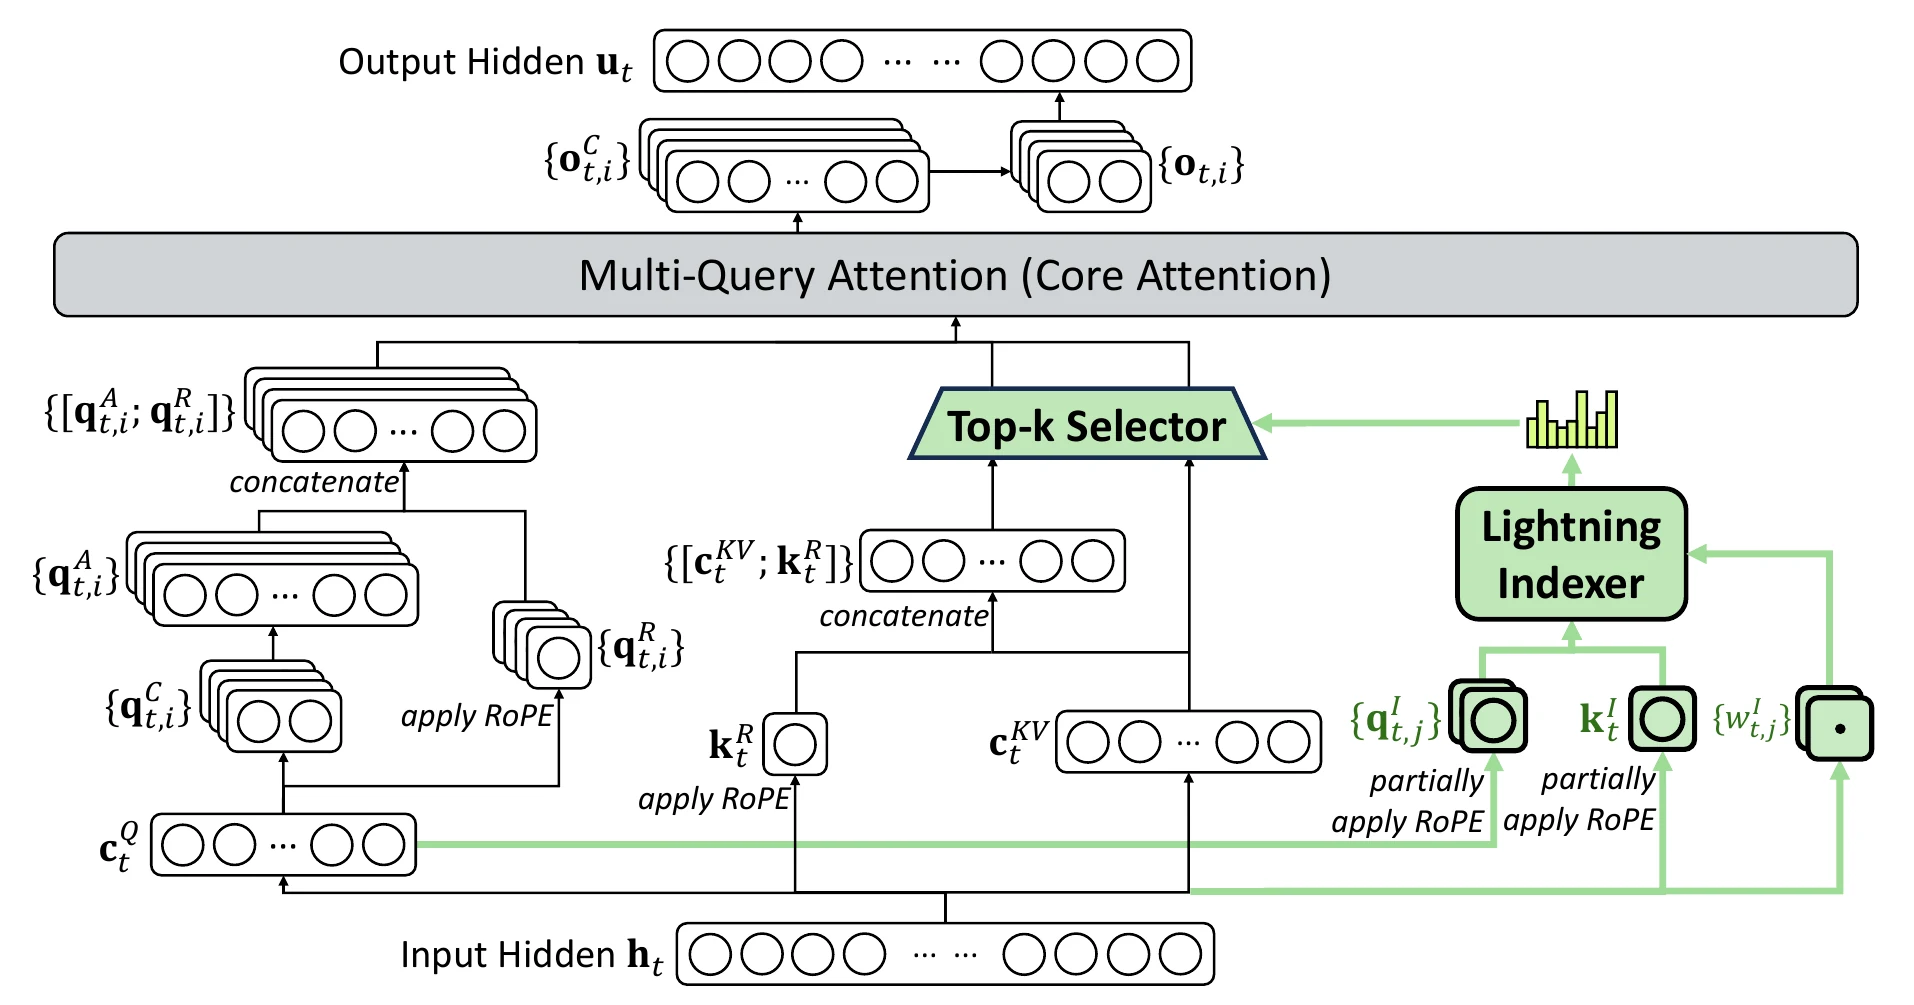
Dans le rapport DeepSeek-V3.2, la configuration est que chaque Query peut sélectionner jusqu'à 2048 entrées KV. À mesure que le contexte grandit, l'Attention principale peut toujours se concentrer sur cette plage limitée, réduisant significativement le coût du traitement de longues entrées et de la génération ultérieure. Les entrées historiques non sélectionnées dans ce tour restent disponibles pour les recherches des Queries suivantes, la sélection creuse réduit donc principalement le volume de lecture et de calcul cette fois, plutôt que de supprimer tout le cache dans la même proportion. L'indexeur lui-même doit toujours traiter les candidats historiques, et le coût réel est également affecté par la longueur du contexte.
L'Attention Creuse MiniMax (MSA) a été proposée par l'équipe MiniMax et appliquée à MiniMax-M3. Elle traite les problèmes d'efficacité dans les contextes d'un million de Tokens, en considérant particulièrement comment rendre l'attention creuse adaptée au calcul par lots GPU, plutôt que de simplement réduire théoriquement le nombre de Tokens participant au calcul.
La MSA s'appuie sur la GQA et comprend une branche d'indexation et une branche principale. La branche d'indexation calcule d'abord les scores de pertinence au niveau des Tokens, puis prend le score le plus élevé dans chaque bloc comme score de bloc, sélectionnant séparément les Top-k blocs historiques pour différents groupes GQA. La branche principale lit ensuite les K et V au niveau des Tokens dans les blocs sélectionnés qui satisfont les conditions causales, tout en retenant le bloc local actuel. Comme le montre la figure ci-dessous, les deux groupes Query à droite peuvent former des plages de sélection différentes, tandis que les têtes Query au sein du même groupe partagent les résultats de sélection.
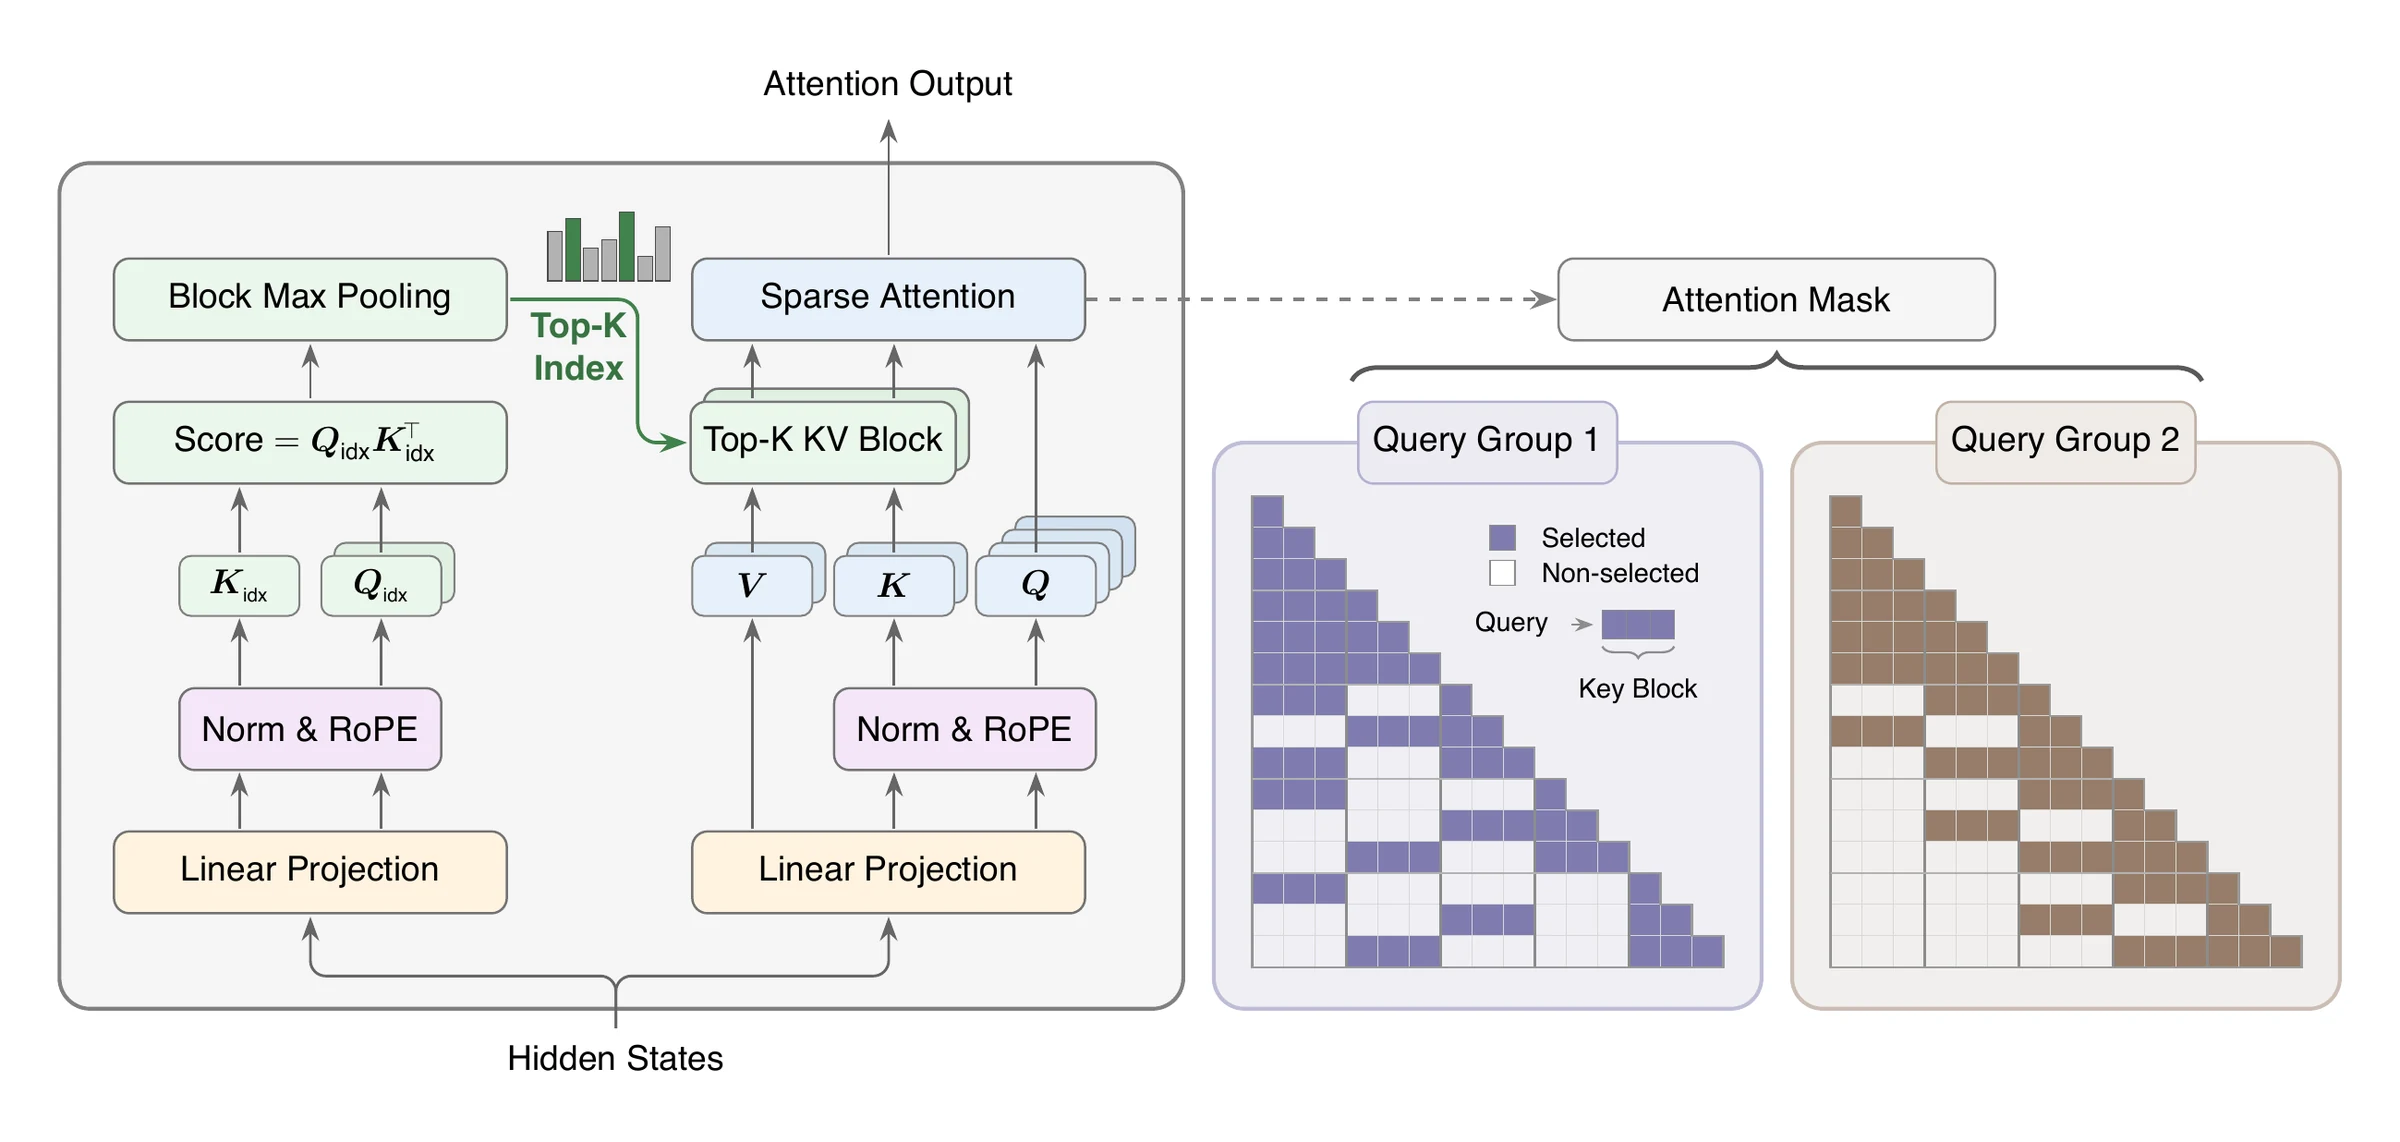
Organiser l'accès par blocs améliore la régularité du traitement des données par le GPU, et la sélection groupée permet à différents groupes de conserver différents schémas de récupération. Dans le test de contexte 1M du modèle expérimental à 109 milliards de paramètres, l'article rapporte que le calcul d'attention par Token de la MSA est d'environ 1/28,4 de celui de la GQA. Avec des noyaux spécialisés, la phase Prefill pour le traitement des entrées et la phase Decode pour la génération token par token sur H800 ont obtenu des améliorations de vitesse d'environ 14,2x et 7,6x respectivement. Cela démontre que les algorithmes creux et les noyaux de calcul doivent être co-conçus ; réduire le volume de calcul ne peut être entièrement converti en bénéfices de vitesse réels que par une telle optimisation conjointe.
L'Attention Creuse Qwen (QSA) a été proposée par l'équipe Qwen et appliquée à Qwen3.8-Flash-Next. Ce modèle utilise une structure hybride de trois couches de Gated DeltaNet combinées avec une couche de QSA : la première traite efficacement les séquences par des mises à jour d'état, tandis que la seconde conserve la récupération directe des Tokens historiques. Le problème clé que la QSA traite est que les indexeurs eux-mêmes génèrent une surcharge importante dans les longs contextes.
À cette fin, la QSA compresse d'abord les clés d'indexage de Tokens consécutifs en représentations de micro-blocs par pooling moyen, calcule les scores de pertinence sur la séquence de micro-blocs plus courte et sélectionne les Top-k blocs. Après sélection, elle développe les blocs aux positions de Token originales, permettant à l'Attention principale de lire les K et V correspondants. Les Tokens de queue qui n'ont pas formé de blocs complets sont également conservés. Le côté gauche de la figure ci-dessous montre le processus d'indexation compressé, et le côté droit montre l'Attention creuse de micro-blocs basée sur les résultats de sélection, avec les indices de position transmis entre les deux parties.
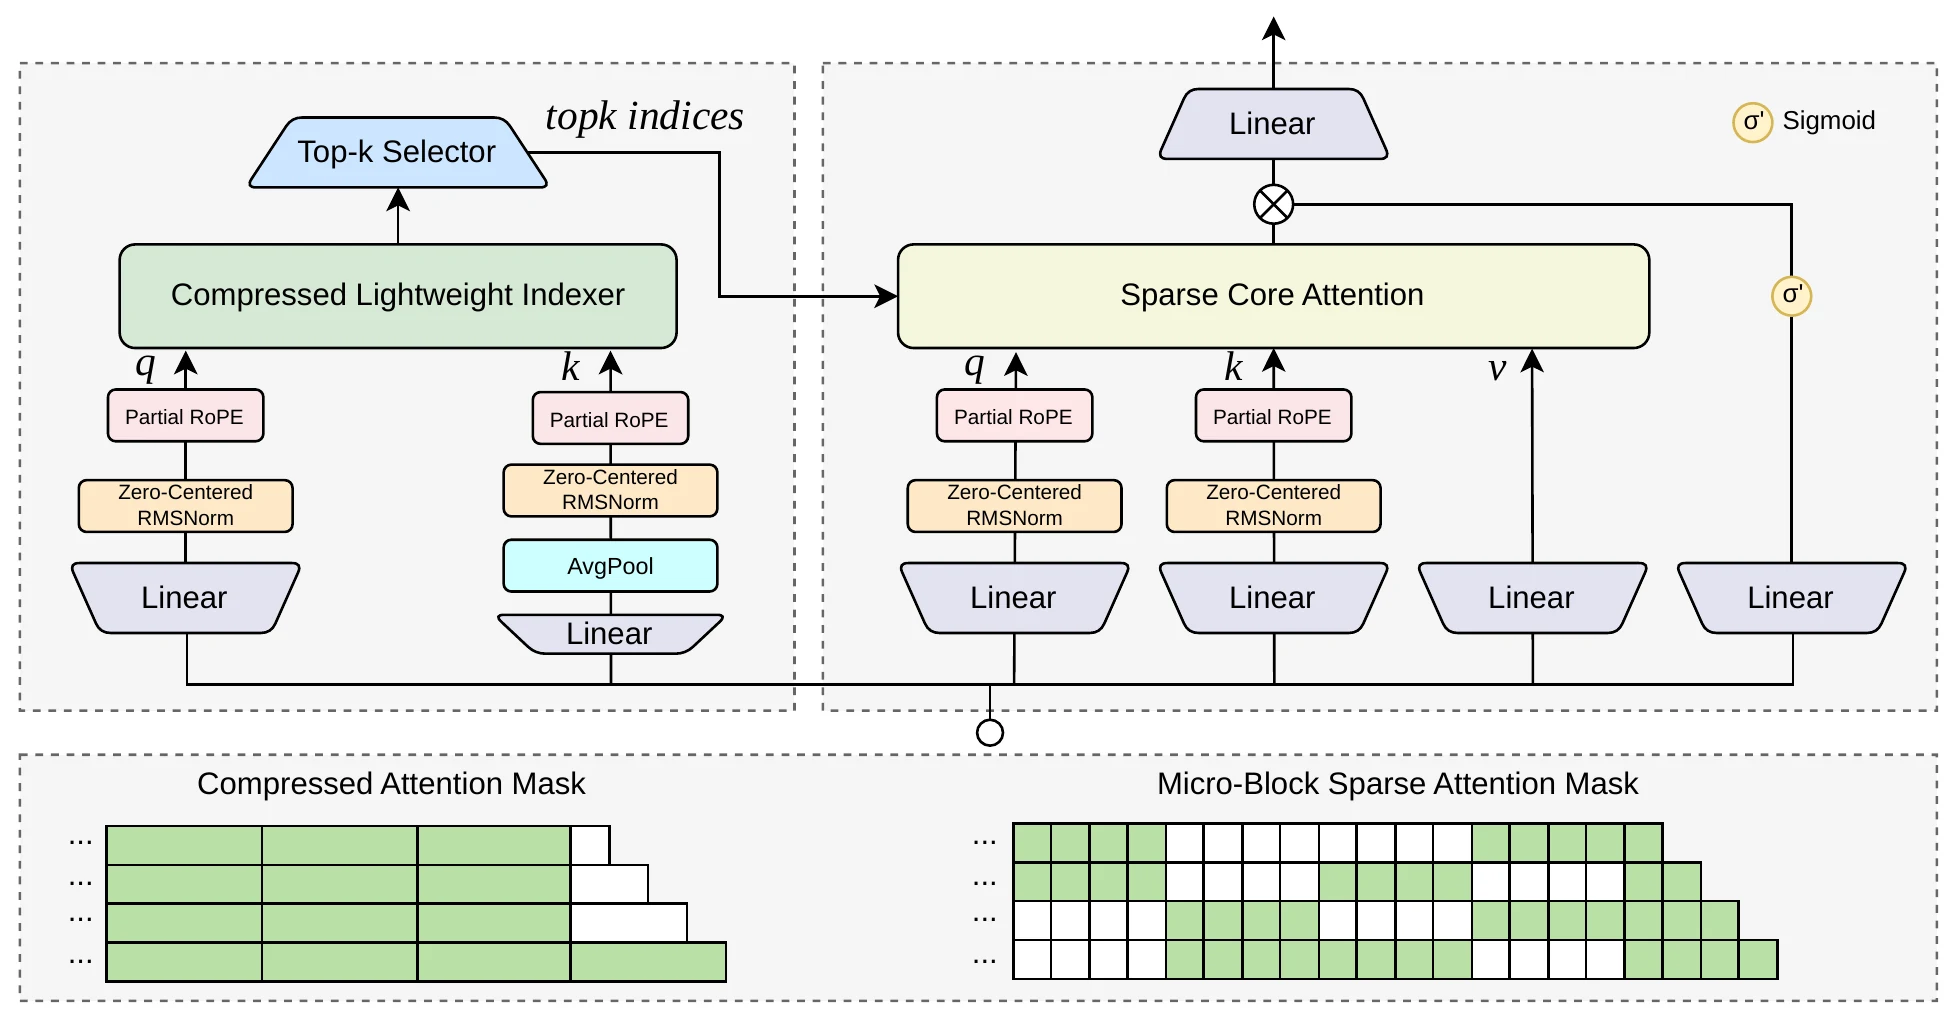
Cela réduit à la fois les positions que l'Attention principale accède et raccourcit la séquence que l'indexeur doit scanner. Le rapport Qwen3.8-Flash-Next montre que dans les tests de noyau avec 1M de contexte, la QSA a obtenu des améliorations de vitesse d'environ 7,6x et 4,9x en Prefill et Decode respectivement par rapport à l'attention dense. Pour comprendre cette structure, il est important de distinguer entre la représentation d'index et le cache de l'Attention principale : la QSA compresse la première pour réduire les coûts de filtrage, mais après sélection lit toujours les KV au niveau des Token, les informations fines de la région sélectionnée peuvent donc être préservées.
La Kimi Delta Attention (KDA) a été proposée par l'équipe Moonshot AI dans Kimi Linear et est appliquée dans le modèle Kimi Linear avec 48 milliards de paramètres totaux et 3 milliards de paramètres activés. Elle adopte une approche d'attention linéaire, écrivant continuellement les informations historiques dans un état de taille fixe, réduisant la surcharge de lecture répétée de séquences historiques longues à chaque étape de génération.
La KDA s'appuie sur Gated DeltaNet et introduit un contrôle plus fin. Lorsqu'un nouveau Token arrive, le modèle contrôle d'abord le degré de rétention d'information pour différents canaux dans l'ancien état, puis corrige les associations clé-valeur existantes via la règle Delta. Cette mise à jour peut être comprise comme l'utilisation de la différence entre la nouvelle entrée et le contenu prédit par l'état actuel pour ajuster les informations stockées dans l'état. Comme la porte de décroissance varie par canal, différentes parties peuvent utiliser des taux de rétention différents. Pendant le calcul, des blocs de Tokens peuvent également être traités en parallèle pour améliorer l'efficacité du GPU.
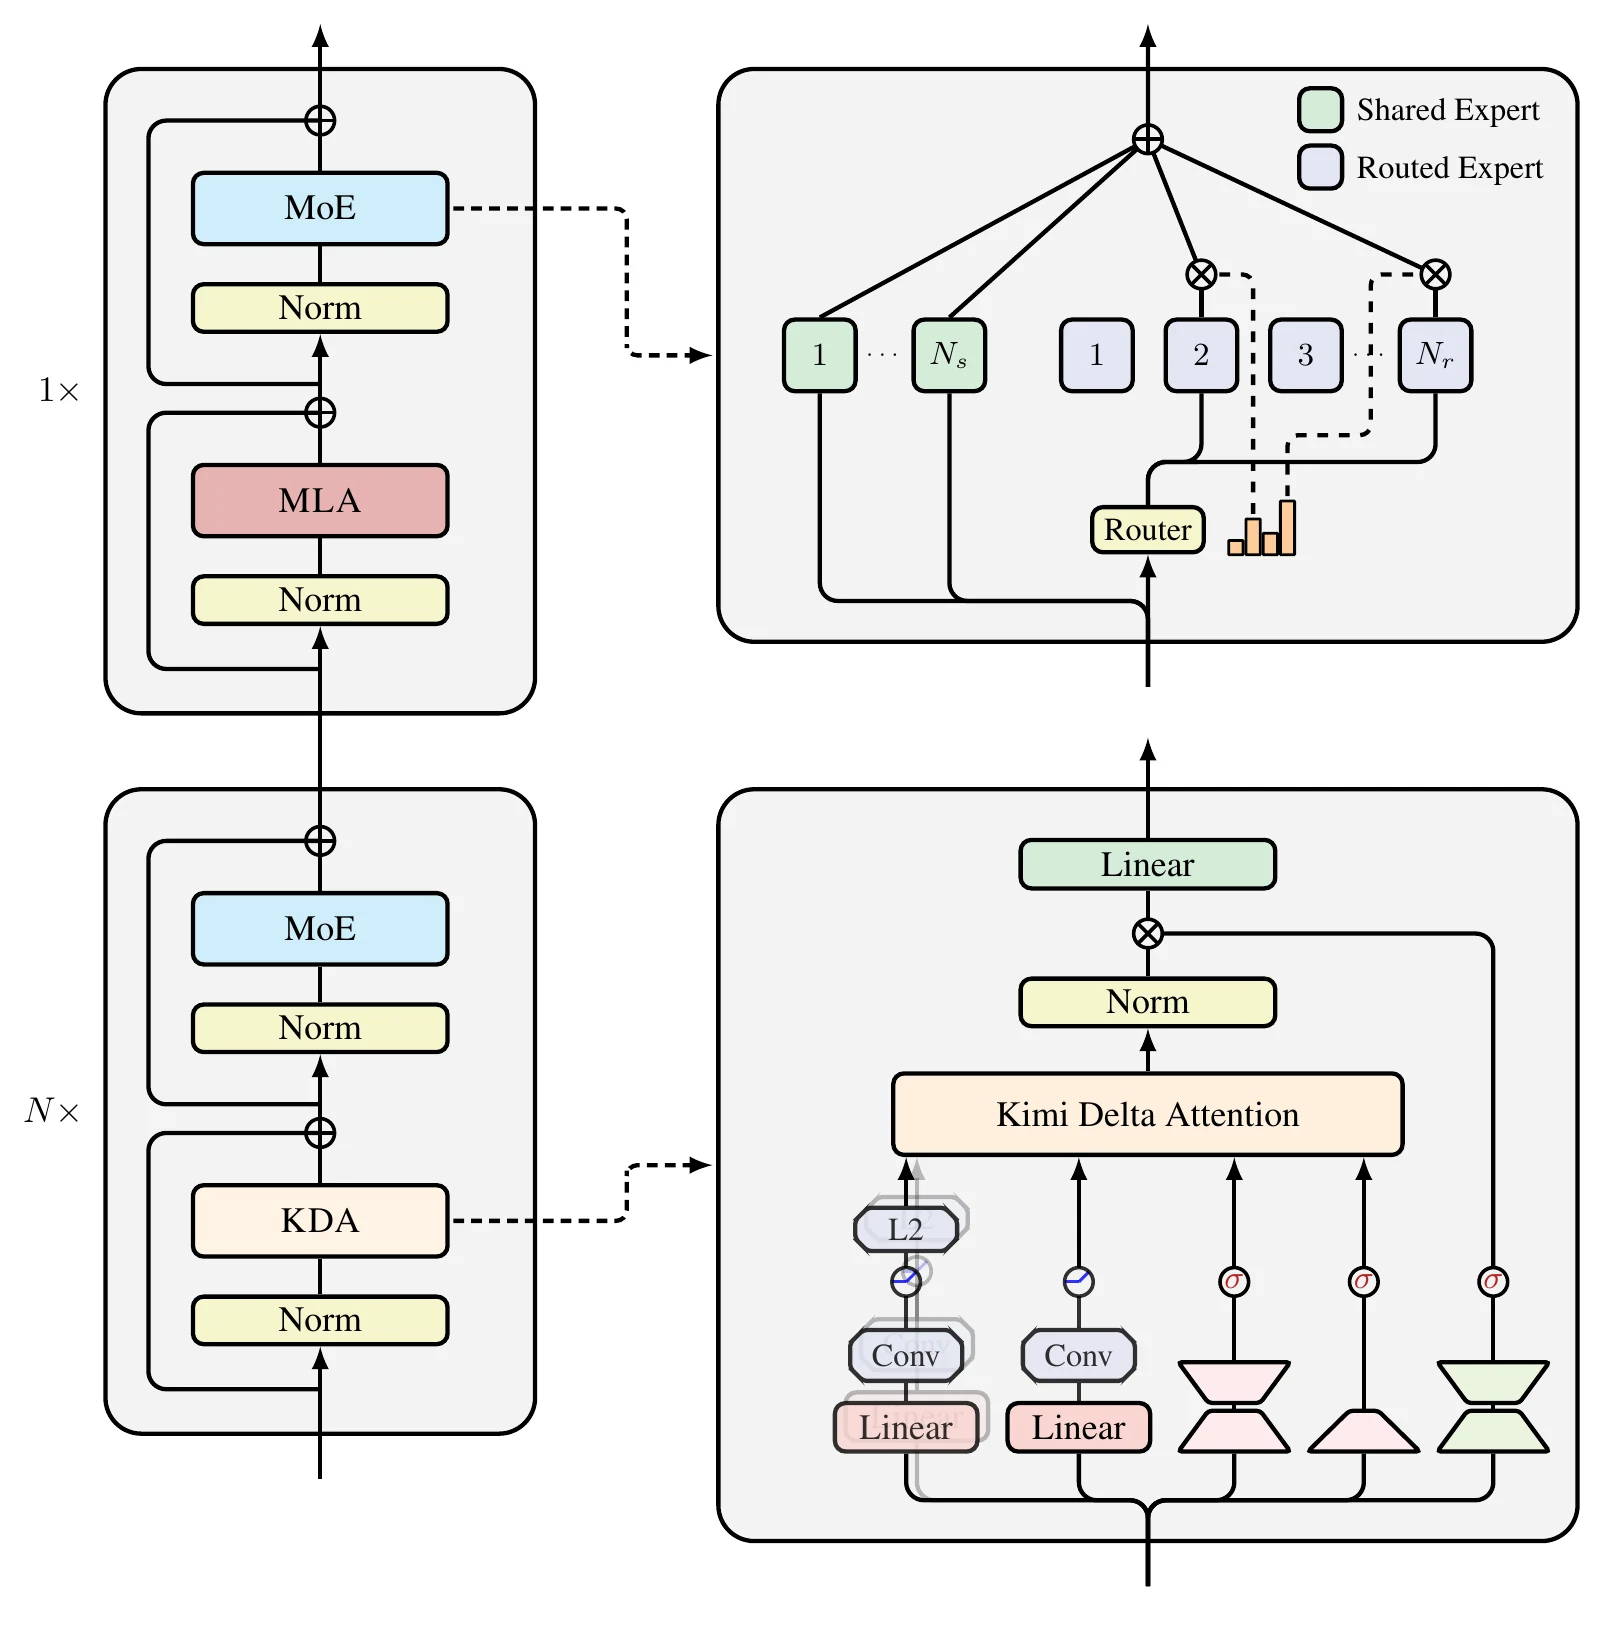
La figure ci-dessus montre comment Kimi Linear alterne trois couches de KDA avec une couche d'MLA. La couche KDA utilise un état de taille fixe pour réduire les coûts des longues séquences, tandis que la couche MLA complète la récupération directe de positions historiques spécifiques, atténuant la capacité limitée de l'état fixe. Dans les comparaisons utilisant le même schéma d'entraînement, ce modèle hybride a réduit le KV Cache de jusqu'à 75% par rapport à la ligne de base MLA complète et a atteint un débit de décodage jusqu'à environ 6 fois supérieur à 1M de contexte. Ces résultats correspondent à l'architecture hybride de Kimi Linear plutôt qu'à une configuration uniforme de tous les modèles Kimi.
L'Attention Creuse Compressée (CSA) a été proposée par l'équipe DeepSeek dans DeepSeek-V4 et appliquée à DeepSeek-V4-Pro et DeepSeek-V4-Flash. Tandis que la MLA précédente comprime principalement la représentation KV de chaque Token, la CSA réduit davantage le nombre d'entrées le long de la dimension de séquence, agrégeant les informations de plusieurs Tokens en un nombre réduit d'entrées KV, puis effectuant une sélection creuse.
La CSA traite d'abord les Tokens consécutifs avec un compresseur Token-level apprenable, combinant les informations de chevauchement des blocs adjacents pour former un KV compressé. Ensuite, l'indexeur Lightning évalue ces entrées compressées et sélectionne les entrées Top-k pour l'Attention principale. Dans la figure ci-dessous, le compresseur est positionné avant l'indexage et la sélection, et l'Attention principale lit directement le KV compressé. Sur la gauche, une branche d'attention à fenêtre glissante envoie également les Tokens récents non compressés dans le calcul, préservant les détails locaux.
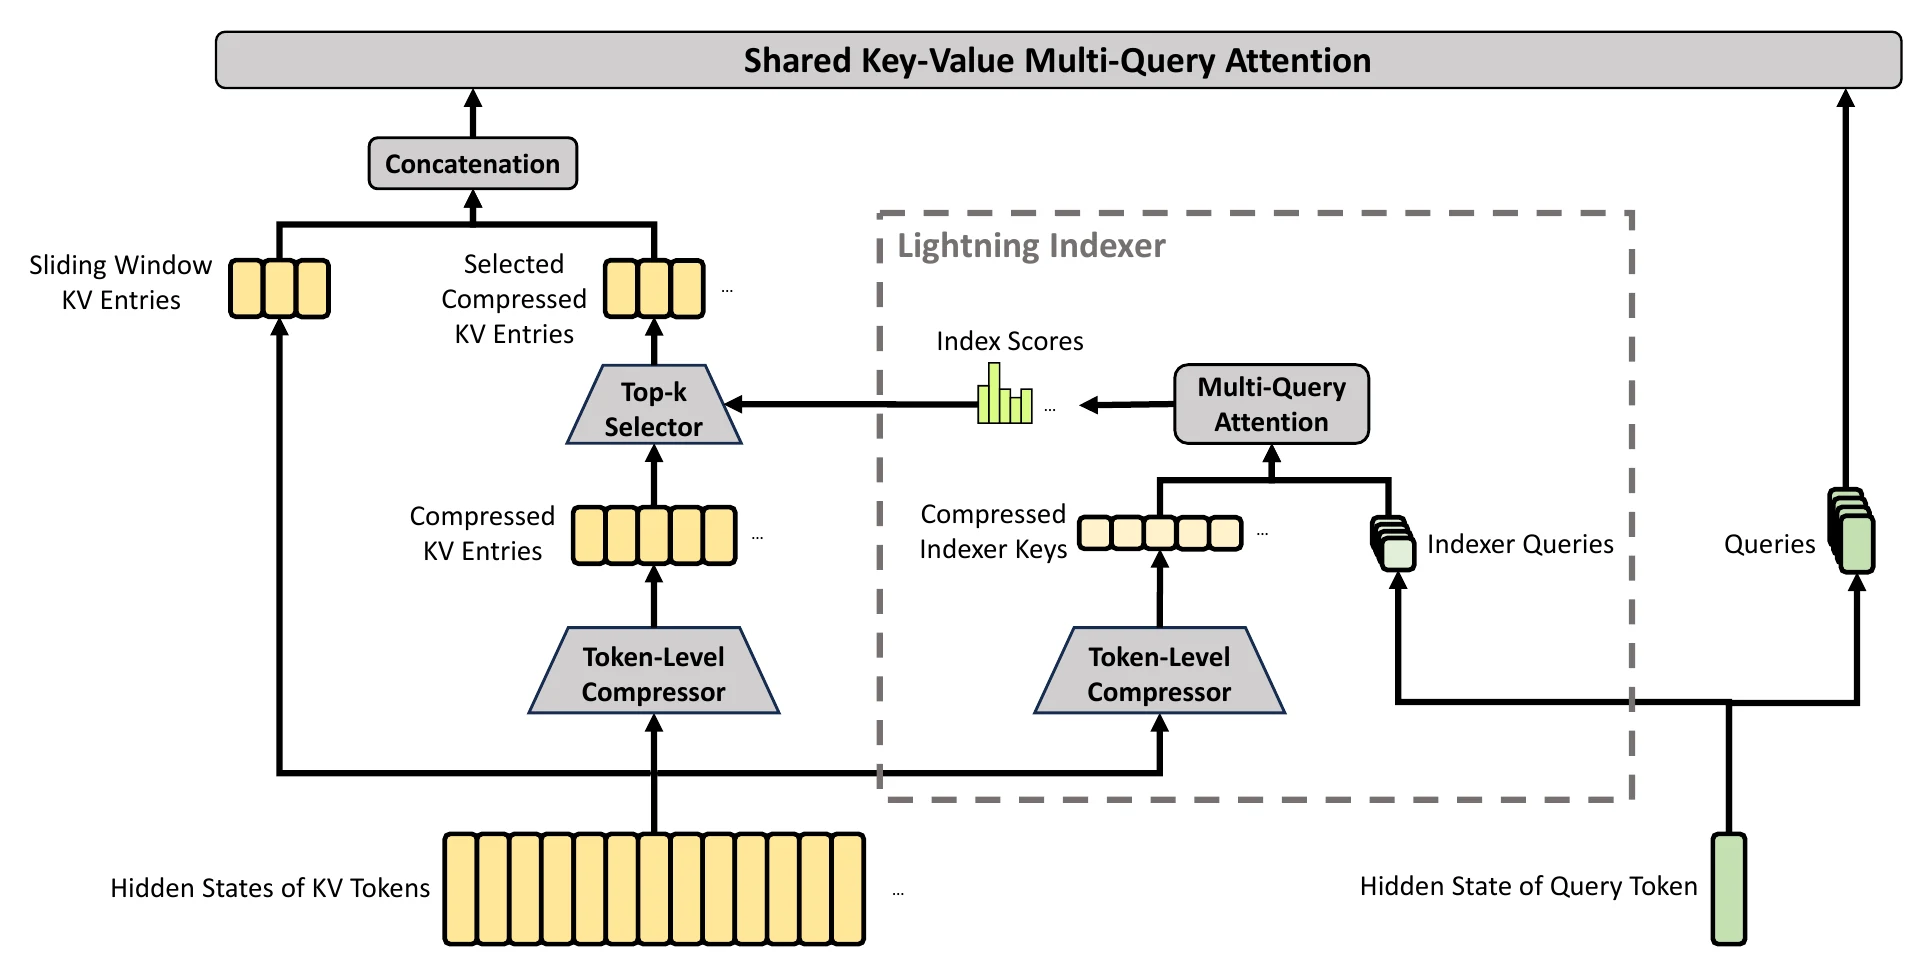
Dans le rapport DeepSeek-V4, la CSA a un taux de compression de 4, signifiant que les entrées KV historiques sont réduites d'environ un quart, avec un sous-ensemble sélectionné pour le calcul de l'Attention principale. Ainsi, la CSA réduit à la fois le volume de cache à long terme et diminue le contenu historique lu et calculé à chaque fois. La QSA compresse l'index mais retourne ensuite aux Tokens originaux, tandis que la CSA effectue directement l'agrégation d'informations sur les entrées compressées, comprimant donc également le KV historique lui-même. Cette conception nécessite que le compresseur préserve les caractéristiques utiles, complété par la fenêtre locale pour les détails récents.
L'Attention Fortement Compressée (HCA) a également été proposée par l'équipe DeepSeek dans DeepSeek-V4 et est utilisée en alternance avec la CSA dans la structure multicouche de DeepSeek-V4-Pro et Flash. Elle utilise une compression de séquence plus forte, permettant au modèle de conserver une couverture d'informations historiques à grande échelle avec moins de cache, complétant la lecture sélective de la CSA.
Le taux de compression de la HCA est fixé à 128 dans le rapport, bien supérieur à celui de la CSA (4). Après l'agrégation de plusieurs Tokens en une seule entrée compressée par sommation pondérée apprenable, la Query actuelle effectue l'Attention sur toute l'historique compressée causalement visible sans sélection Top-k. Comme le montre la figure ci-dessous, la HCA conserve la branche compressée et la branche d'attention à fenêtre glissante locale mais omet l'indexeur et le sélecteur de la CSA. La fenêtre fournit les détails des Tokens récents, tandis que l'historique compressée fournit des informations contextuelles plus larges.
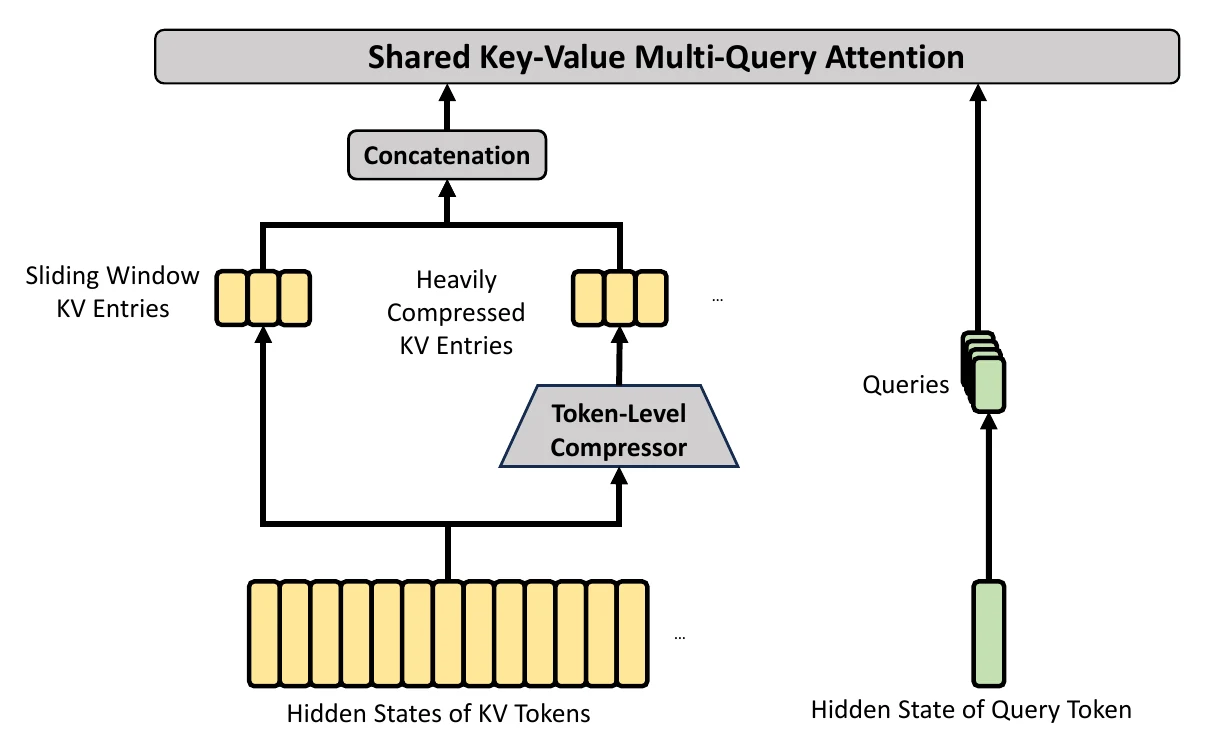
La configuration alternée de la CSA et de la HCA permet à DeepSeek-V4 d'utiliser simultanément des représentations historiques à différentes granularités. Selon le rapport, à 1M de contexte, les FLOPs d'inférence par Token et le KV Cache du DeepSeek-V4-Pro sont respectivement d'environ 27% et 10% de ceux du DeepSeek-V3.2. C'est l'effet combiné de la structure hybride d'Attention avec le calcul et le stockage de basse précision. Pour les utilisateurs, la signification de ce type de structure est qu'elle rend les contextes ultra-longs plus faciles à exécuter sur du matériel limité. La capacité d'un modèle spécifique à extraire précisément les détails de longs matériaux dépend toujours de la méthode de compression, du processus d'entraînement et de la tâche réelle.
À partir de ces conceptions de modèles, on peut voir que les améliorations de l'Attention ne se limitent pas à une seule direction. La MHA, la MQA et la GQA modifient principalement la relation de partage entre les têtes ; l'MLA comprime la représentation KV à chaque position ; la DSA, la MSA et la QSA réduisent les positions accessibles par l'Attention principale ; la KDA traite l'historique par des mises à jour d'état ; et la CSA et la HCA compriment davantage les entrées historiques. Les modèles peuvent combiner plusieurs de ces méthodes, donc lors de l'analyse des besoins en ressources, il est nécessaire de considérer le nombre de couches et le format de cache pour chaque structure. Quelle que soit la structure utilisée, l'Attention ne se charge que de l'agrégation des informations contextuelles ; la capacité globale du modèle est conjointement formée par l'Attention ensemble avec l'Embedding, le réseau feed-forward et le processus d'entraînement.
L'architecture du modèle détermine comment l'information est calculée, tandis que le processus d'entraînement détermine ce que le modèle apprend finalement. L'entraînement des grands modèles est généralement divisé en plusieurs étapes. D'abord, lors de l'étape de pré-entraînement, le modèle apprend les schémas de langage, les structures de connaissances et les modèles de raisonnement de base à partir de texte massif, de code et d'autres données, acquérant des capacités générales. Ensuite, il entre dans l'étape d'Ajustement par Instruction (SFT), où à travers de nombreux exemples « instruction-réponse », le modèle apprend à comprendre les exigences des utilisateurs et à répondre selon le format de tâche spécifié. Sur cette base, une optimisation de préférence ou un apprentissage par renforcement supplémentaire est effectué, ajustant le comportement du modèle en fonction des retours humains ou de règles pour mieux aligner les réponses avec les attentes en termes d'utilité, d'exactitude, de style d'expression, de sécurité et de limites comportementales.
Le pré-entraînement est l'étape où le modèle forme ses capacités fondamentales. Le modèle est entraîné de manière répétée sur du texte, du code ou des données multimodales à grande échelle. Pour les modèles de langage Décodeur seul (comme la série GPT), la tâche d'entraînement courante est de prédire le Token suivant en se basant sur le contenu précédant, en ajustant les paramètres du modèle lorsque les prédictions sont erronées. Après le traitement répété d'échantillons massifs, le modèle apprend progressivement la structure du langage, les schémas d'expression et les relations statistiques entre différents concepts, et développe les capacités de représentation et de génération fondamentales nécessaires pour des tâches telles que les questions-réponses, la résumé, la traduction et la génération de code.
Les connaissances acquises lors du pré-entraînement sont distribuées sur un très grand nombre de paramètres, pas dans une base de données interrogeable élément par élément. Le modèle peut combiner des schémas appris pour générer du contenu qui n'apparaît pas textuellement dans les données d'entraînement, et peut également combiner des informations liées mais pas entièrement correspondantes pour former des réponses apparemment plausibles mais incorrectes. Bien sûr, plus de données d'entraînement n'est pas toujours mieux. Le contenu dupliqué, les pages web de basse qualité, les connaissances erronées, les données de confidentialité et le contenu nocif affectent tous le modèle. Avant le pré-entraînement, l'analyse de format, la déduplication, le filtrage par qualité, le filtrage de sécurité et la proportionnalité des données sont généralement requis. L'échelle des données détermine la quantité de contenu à laquelle le modèle peut accéder, tandis que la qualité des données affecte directement ce que le modèle peut en apprendre.
Après avoir terminé le pré-entraînement, le modèle peut déjà continuer du texte, mais il ne-termine pas nécessairement de manière fiable les tâches selon les exigences des utilisateurs. Par exemple, si l'utilisateur demande de lister trois éléments d'action, le modèle de base pourrait continuer à développer la question ou ignorer le format spécifié. L'ajustement par instruction utilise des exemples composés d'instructions et de réponses attendues pour continuer à entraîner le modèle. Voici un exemple d'ajustement par instruction :
Instruction : Organisez les comptes rendus de réunion suivants en éléments d'action.
Entrée : Texte du compte rendu de réunion.
Sortie : Un tableau contenant les tâches, les personnes responsables et les délais.
Après un entraînement sur différents types d'exemples incluant les questions-réponses, la résumé, l'extraction d'informations, le code, l'appel d'outils et le refus de sécurité, le modèle apprend progressivement à reconnaître l'intention de l'utilisateur et à suivre les exigences de sortie. L'ajustement par instruction enseigne principalement au modèle comment utiliser ses capacités existantes. Il peut compléter certaines connaissances mais n'est pas adapté à la résolution de tous les problèmes de mise à jour des connaissances. Le contenu nécessitant des mises à jour fréquentes ou devant fournir des sources est mieux servi par des bases de connaissances, la récupération ou des outils externes au moment de l'exécution.
Le post-entraînement est le terme collectif pour une série de travaux d'entraînement et d'alignement effectués après que le modèle termine le pré-entraînement. L'ajustement par instruction fait généralement partie du post-entraînement, et un ajustement par instruction (SFT), une optimisation de préférence et un apprentissage par renforcement supplémentaires peuvent également apparaître à ce stade. Par conséquent, l'ajustement par instruction et le post-entraînement ne sont pas deux étapes indépendantes ; le premier est une catégorie de méthodes spécifique, tandis que le second est une étape englobant plusieurs méthodes. Plusieurs approches d'entraînement peuvent d'abord être comprises selon la relation suivante :
Étape ou Méthode | Données principales utilisées | Problème principal résolu |
Pré-entraînement | Texte, code et données multimodales à grande échelle | Apprendre au modèle les schémas fondamentaux comme le langage et les connaissances |
Ajustement par Instruction / SFT | Instructions et réponses attendues | Apprendre au modèle à produire selon les exigences de la tâche |
Optimisation de préférence | Réponses meilleures et inférieures à la même question | Amener le modèle à préférer les réponses alignées avec les préférences |
Apprentissage par renforcement | Invites, réponses du modèle et signaux de récompense | Continuer à ajuster la stratégie de génération en fonction des récompenses |
En référence au cadre Reinforcement Learning from Human Feedback (RLHF) utilisé dans InstructGPT, un pipeline classique de post-entraînement a été établi. Le RLHF utilise généralement des données de démonstration humaine pour terminer le SFT à la première étape, utilise des données de classement de réponses pour entraîner un modèle de récompense à la deuxième étape, et utilise le PPO pour optimiser la stratégie de génération du modèle de langage en se basant sur les scores du modèle de récompense à la troisième étape. Le processus spécifique est illustré dans la figure ci-dessous.
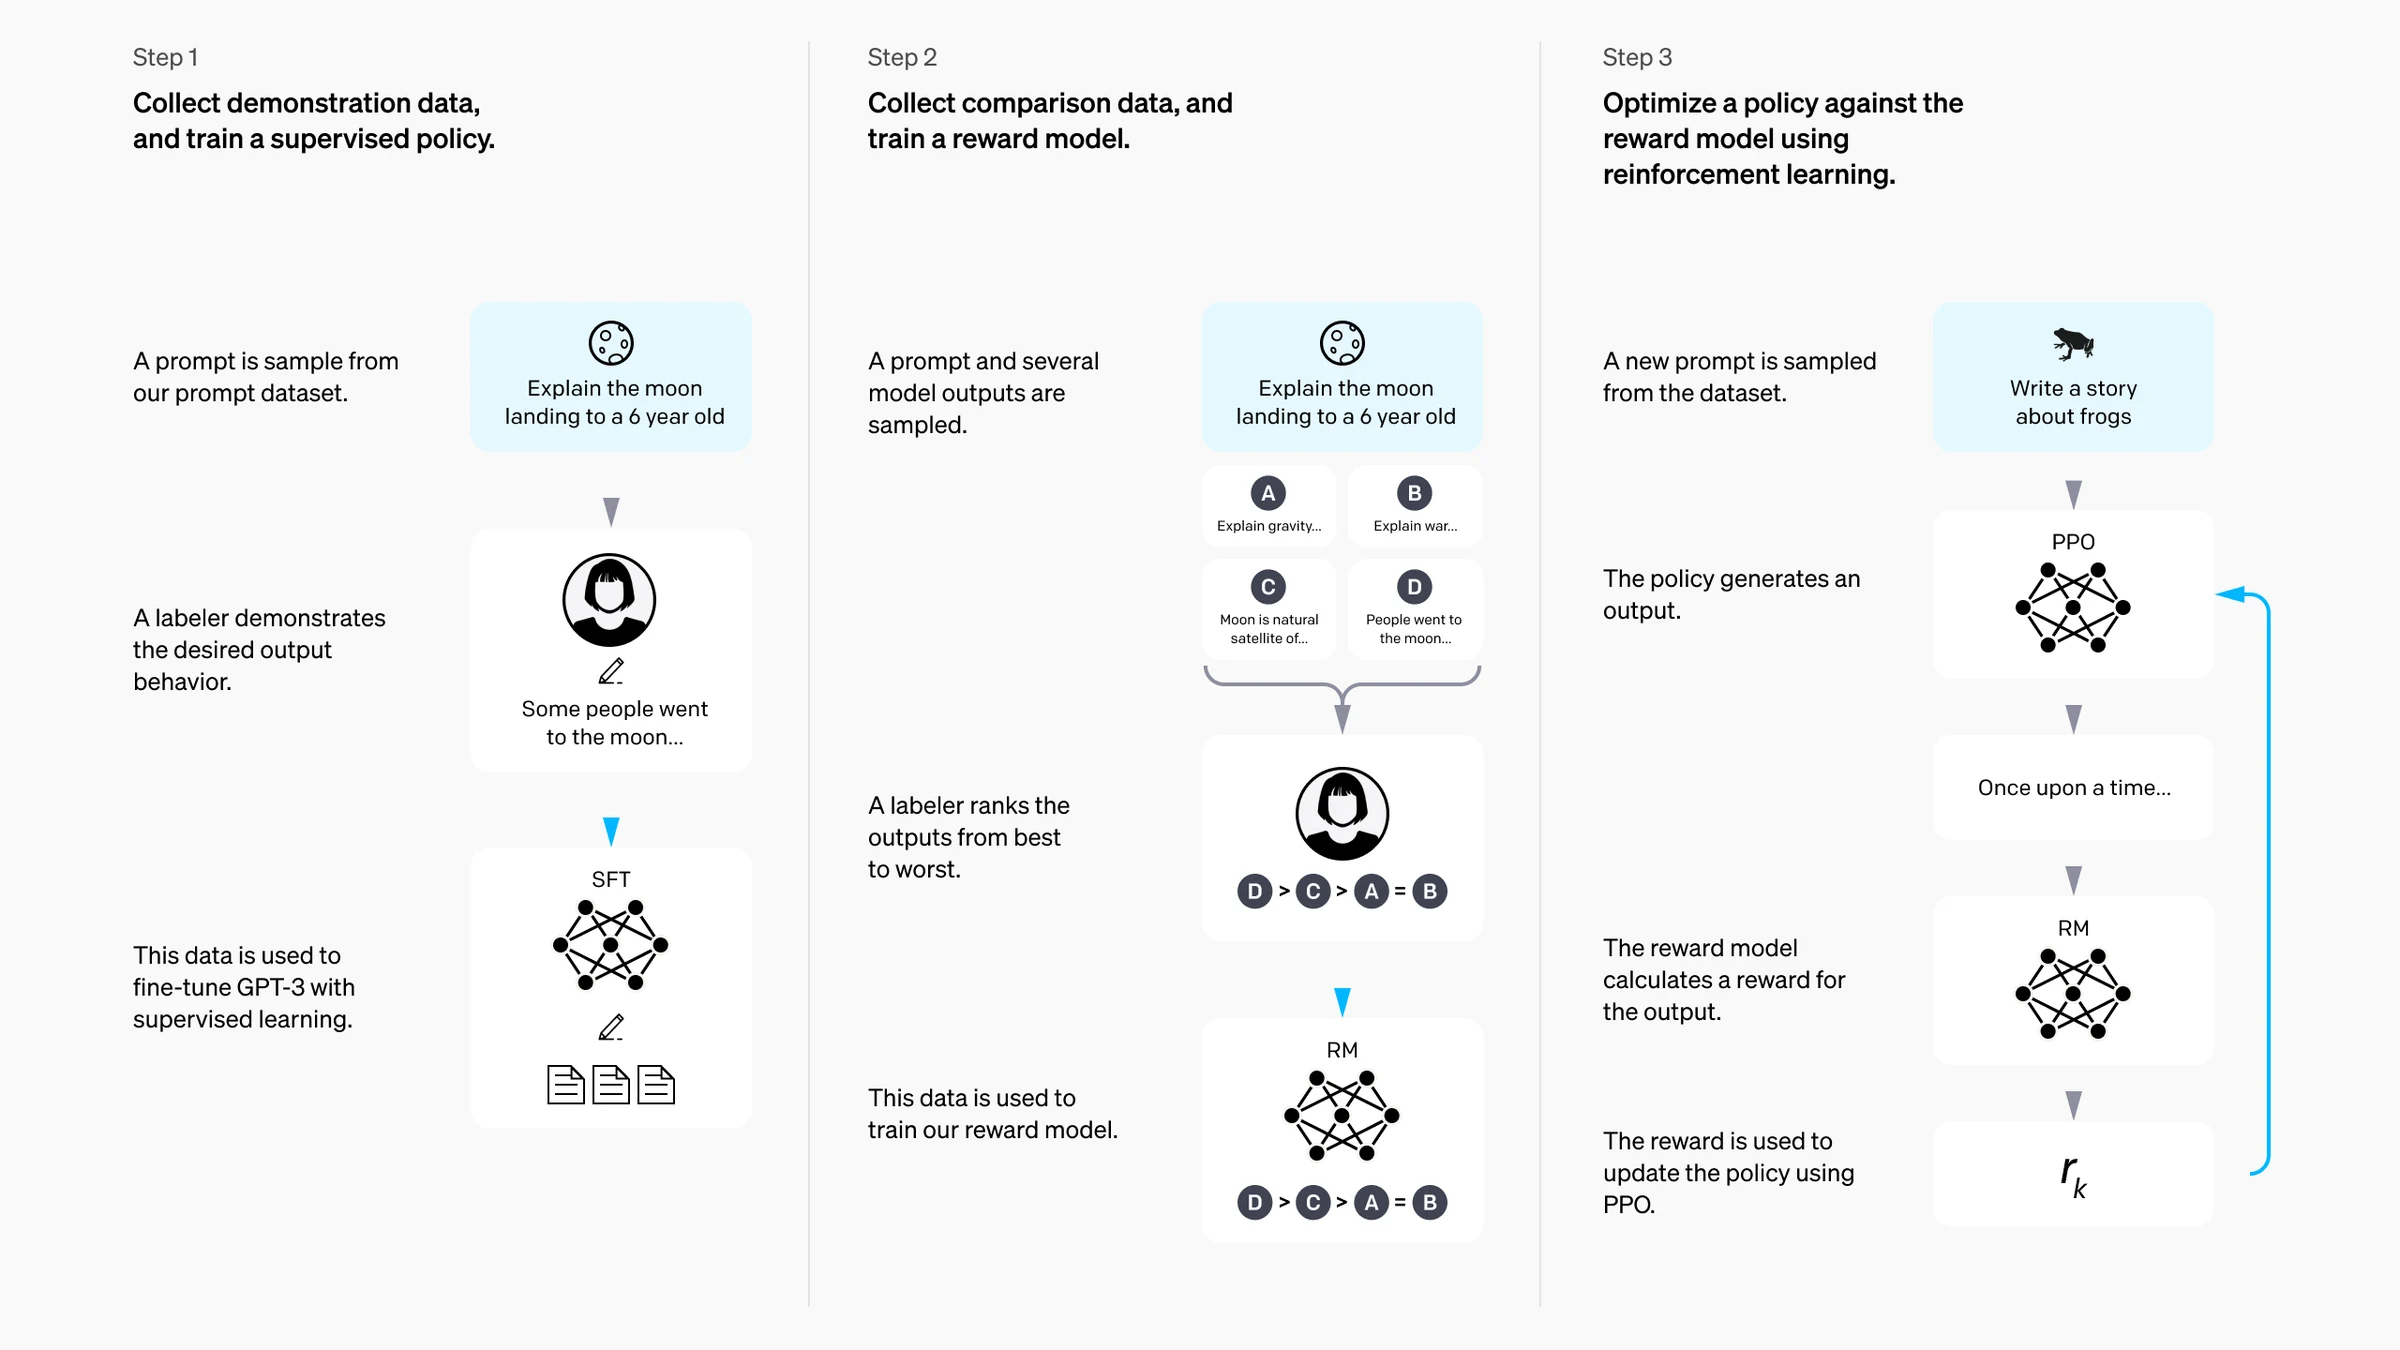
Les scores donnés par le modèle de récompense représentent une préférence, pas une vérité objective. Si la couverture des données de préférence est insuffisante ou si la conception des règles de récompense est déraisonnable, le modèle peut simplement apprendre à se conformer à la méthode de notation.
Les modèles réels ne suivent pas nécessairement exactement le même pipeline. Certains modèles utilisent SFT plus DPO, d'autres utilisent SFT avec un modèle de récompense et PPO, et d'autres encore intègrent des retours d'IA, l'alignement de sécurité, l'entraînement à l'utilisation d'outils et des données de dialogue multi-tours. Le pré-entraînement, l'ajustement par instruction et le post-entraînement précédents ont expliqué comment les capacités du modèle se forment. Après l'entraînement du modèle, les problèmes que les utilisateurs rencontrent le plus fréquemment sont la quantité de contenu pouvant être saisie à la fois, la quantité de VRAM nécessaire au moment de l'exécution et la précision à choisir pour un matériel limité.
Après que le modèle termine l'entraînement, il entre dans le stade réel d'inférence et de déploiement. La longueur du contexte détermine le nombre de Tokens qu'une seule requête peut contenir ; plus le contexte est long, plus le modèle peut lire de matériel, mais le calcul de l'Attention et l'utilisation du KV Cache augmentent également, affectant la vitesse d'inférence et les besoins en VRAM. Le contexte dit ici fait référence au système de démonstration, à l'historique des conversations, à l'entrée actuelle, au contenu du fichier, aux descriptions d'outils, aux résultats de retour des outils et au contenu déjà généré par le modèle dans une seule requête, qui peut être exprimé comme : Utilisation du contexte = Instructions système + Historique des conversations + Entrée actuelle + Contenu des pièces jointes + Informations sur les outils + Sortie du modèle.
Comme mentionné précédemment, l'utilisation du contexte d'un grand modèle n'est pas seulement l'entrée actuelle de l'utilisateur mais est composée de plusieurs parties, incluant les instructions système, l'historique des conversations antérieures, l'entrée actuelle de l'utilisateur, le contenu pertinent dans les pièces jointes, les informations nécessaires aux appels d'outils et la sortie déjà générée par le modèle. Tout cela consomme la fenêtre de contexte du modèle, donc à mesure que les conversations s'allongent, les pièces jointes augmentent ou les informations sur les outils deviennent plus complexes, l'espace de contexte disponible pour les entrées et générations suivantes diminue progressivement. Par exemple, si un modèle indique prendre en charge une longueur de contexte de 128K, cela représente généralement l'ordre de grandeur total des Tokens pouvant être traités dans une seule requête. Si la sortie est incluse, quelle est la sortie maximale unique, dépend des limites du modèle et de l'interface de service. Typiquement, lorsque le contexte est dépassé, la plateforme peut rejeter les requêtes, tronquer des parties du contenu ou compresser automatiquement les enregistrements historiques.
Pour améliorer l'efficacité d'inférence et la qualité de réponse du modèle dans les scénarios de documents longs, le contenu devrait être autant que possible organisé avant de saisir les matériaux, en supprimant les informations non pertinentes pour la tâche, en doublon ou de faible valeur, et en indiquant clairement au modèle sur quels sections, champs ou zones de questions se concentrer, empêchant le modèle de disperser son attention sur de grandes quantités de contexte non pertinent. Pour les matériaux particulièrement longs difficiles à traiter complètement en une fois, ils peuvent être segmentés par chapitre, sujet ou longueur fixe d'abord, laissant le modèle effectuer séparément l'extraction d'informations, la résumé ou l'analyse, puis unifiant et évaluant de manière globale les résultats de chaque partie. Pour les conclusions clés, les données importantes ou le contenu nécessitant une vérification supplémentaire, le modèle devrait également être amené à indiquer l'emplacement original, le chapitre ou le numéro de page correspondant, facilitant l'inspection manuelle et le traçage des résultats ultérieurs, améliorant ainsi la précision globale du traitement, l'interprétabilité et la fiabilité.
Les modèles génératifs basés sur l'architecture du Transformer génèrent généralement des Tokens un à la fois. Pendant la génération, si les informations d'attention pour tous les Tokens précédents étaient recalculées pour chaque nouveau Token, cela produirait des quantités massives de travail redondant. Par conséquent, l'introduction d'un mécanisme de mise en cache connu sous le nom de KV Cache est bénéfique. Le KV Cache stocke les Key et Value qui ont déjà été calculées à chaque couche, donc lors de la génération du Token suivant, seules les nouvelles parties doivent être calculées, améliorant la vitesse de génération. Pour chaque Token supplémentaire, chaque couche du Transformer doit sauvegarder le K et V correspondant. Par conséquent, le KV Cache croît avec la longueur du contexte, la longueur de sortie, la concurrence et le nombre de couches du modèle.
Pour les modèles Décodeur seul courants, l'utilisation du cache pour une seule séquence peut être comprise en utilisant la formule simplifiée suivante :
Utilisation du KV Cache
\approx
2 \times Nombre de couches
\times Nombre de Tokens
\times Nombre de têtes KV
\times Dimension par tête
\times Octets par nombre
Après le chargement des poids du modèle, leur utilisation est relativement fixe, mais le KV Cache change avec les requêtes. Par conséquent, le même modèle quantifié peut fonctionner sans problème dans des questions-réponses courtes mais manquer de VRAM lors du traitement de documents longs ou de plusieurs utilisateurs simultanés. Par exemple, le même serveur peut fonctionner normalement lors du traitement d'un seul court compte rendu de réunion, mais si dix utilisateurs téléchargent simultanément des enregistrements longs, le modèle doit stocker le KV Cache séparément pour plusieurs séquences, et la pression sur la VRAM augmente considérablement. Cela explique également pourquoi, même si le fichier du modèle tient dans la VRAM, la consommation de ressources de calcul change à mesure que la longueur du texte et la concurrence augmentent. Par conséquent, lors du déploiement réel, la pression du KV Cache peut être réduite et l'efficacité du service de calcul améliorée en raccourcissant le contexte non pertinent, en limitant la longueur maximale de génération, en réduisant la concurrence, en utilisant un cache paginé ou en choisissant des modèles utilisant des structures GQA ou MQA.
Les fichiers du modèle stockent essentiellement la structure actuelle du modèle et ses paramètres associés, qui sont fondamentalement un ensemble de nombres. En s'inspirant des principes de l'architecture informatique, ces paramètres sont généralement exprimés sous forme de combinaisons de 0 et de 1. En utilisant différentes largeurs de bits pour représenter la même valeur, on définit à la fois la plage numérique et la précision. Pendant l'entraînement du modèle, des formats à virgule flottante tels que FP32, FP16 ou BF16 sont généralement utilisés pour le calcul, représentant un nombre avec 32 bits ou 16 bits de 0 et de 1. Bien que plus de bits augmentent à la fois la plage numérique et la précision, la consommation réelle de ressources est également considérable. Par conséquent, des méthodes de quantification ont été proposées pour réduire davantage la consommation de ressources. La quantification convertit ces valeurs à virgule flottante multi-bits en représentations de précision inférieure telles que INT8 à 8 bits ou INT4 à 4 bits, réduisant la taille du fichier du modèle et l'utilisation des ressources au moment de l'exécution. Le tableau suivant montre les caractéristiques correspondant aux différentes précisions de virgule flottante :
Précision | Octets théoriques par paramètre | Caractéristiques typiques |
FP32 | 4 | Précision plus élevée, consommation de ressources plus importante |
FP16 / BF16 | 2 | Format courant d'entraînement et d'inférence haute précision |
INT8 | 1 | Poids théoriques utilisant environ la moitié de 16 bits |
INT4 | 0,5 | Poids théoriques utilisant environ un quart de 16 bits |
La quantification réelle ne simple pas arrondir tous les décimaux ; elle projette un groupe de valeurs à virgule flottante sur une plage finie tout en stockant les facteurs d'échelle, les points zéro ou les informations de groupe. Les approches courantes incluent la compression uniquement des poids du modèle, la quantification à la fois des poids et des activations, et la quantification post-entraînement après que l'entraînement du modèle est terminé. Nous n'avons pas à nous inquiéter excessivement des changements numériques causés par la quantification, car pendant la génération, le modèle prédit la probabilité de chaque Token candidat comme prochain mot, et pendant la sélection, il concerne principalement le classement et les scores normalisés. Par conséquent, bien que la quantification perde effectivement de la précision, sous des contrôles stricts, elle peut effectivement équilibrer la qualité de génération du modèle.
Lors de la sélection des modèles, il est souvent nécessaire de déterminer si la VRAM est suffisante. Les 7B, 14B et 70B dans les noms de modèles représentent généralement respectivement environ 7 milliards, 14 milliards et 70 milliards de paramètres. Les paramètres sont les valeurs numériques apprises pendant l'entraînement du modèle, distribuées dans des modules tels que l'Attention, les réseaux feed-forward et l'Embedding.
Le nombre de paramètres ne peut pas être directement équivalent à la taille du fichier du modèle ; la précision utilisée pour chaque paramètre doit également être considérée. Lors du calcul uniquement des poids du modèle, la formule suivante peut être utilisée :
Utilisation des poids ≈ Nombre de paramètres × Octets par paramètre
Échelle des paramètres | FP16 / BF16 | INT8 | INT4 |
7B | ~14GB | ~7GB | ~3,5GB |
14B | ~28GB | ~14GB | ~7GB |
32B | ~64GB | ~32GB | ~16GB |
70B | ~140GB | ~70GB | ~35GB |
Les chiffres du tableau ne représentent que la limite inférieure théorique des poids du modèle. Les modèles quantifiés doivent également stocker les facteurs d'échelle et d'autres informations, et l'inférence réelle nécessite également le KV Cache, les résultats de calcul intermédiaires, les espaces de travail du framework d'inférence et les caches de requêtes concurrentes.
Par exemple, les poids INT4 d'un modèle 14B sont théoriquement d'environ 7GB, mais sur une carte graphique 8GB il reste presque pas d'espace pour le KV Cache et les tampons d'exécution. Il peut fonctionner avec un contexte court et des requêtes uniques, mais est sujet à un manque de VRAM lors du traitement de documents longs. L'utilisation de 12GB ou 16GB de VRAM est plus confortable. Les poids INT4 de 70B sont d'environ 35GB, nécessitant généralement plus de 48GB de VRAM. Lors du déploiement, les options incluent l'utilisation de cartes graphiques avec plus de VRAM, des configurations multi-cartes ou l'utilisation de la mémoire CPU pour l'inférence mixte.
Les grands modèles généraux doivent couvrir de vastes connaissances et tâches. Dans les scénarios spécialisés tels que la santé, la finance, le droit et le code, ils peuvent ne pas être familiarisés avec la terminologie de l'industrie, les processus métier et les limites de risque. Les modèles de domaine sont généralement entraînés ou adaptés sur un modèle de base général en utilisant des données et des tâches professionnelles, rendant le modèle plus adapté à un domaine particulier. Ils n'ont pas nécessairement besoin d'être entraînés from scratch, ni simplement transformés en experts du domaine par des prompts. Les méthodes courantes d'entraînement et d'adaptation incluent :
Il est important de distinguer entre les modèles de domaine et les applications de domaine. Les modèles de domaine ont été entraînés avec des données professionnelles, et les capacités professionnelles sont déjà intégrées aux paramètres du modèle. Les applications de domaine peuvent directement utiliser des modèles généraux, puis se connecter à des bases de connaissances professionnelles, des règles et des outils. Les systèmes réels combinent souvent les deux approches.
Le système de questions-réponses juridiques illustré dans la figure ci-dessous extrait d'abord les mots-clés, puis récupère les articles de référence à partir de la base vectorielle juridique, et enfin, le grand modèle juridique génère des réponses en combinant les preuves. Cela démontre que la capacité professionnelle ne repose pas nécessairement uniquement sur les paramètres du modèle ; les matériaux externes sont également un composant important des applications de domaine.
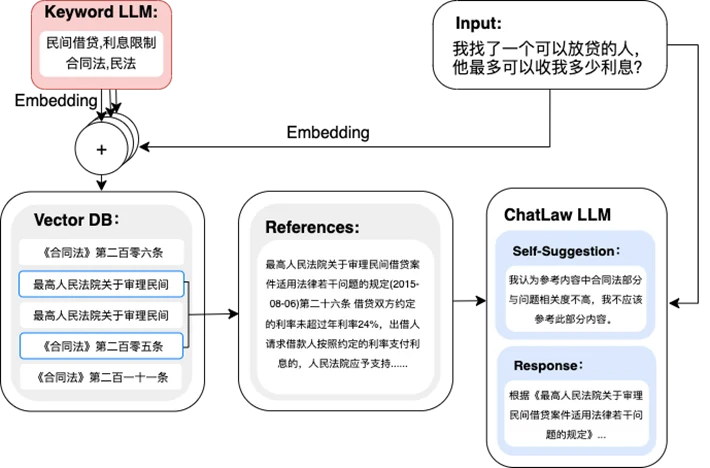
Les données professionnelles n'équivalent pas à la fiabilité professionnelle. Les modèles médicaux doivent toujours vérifier les preuves médicales et les limites de sécurité, les modèles juridiques doivent vérifier les articles de loi et les citations, les modèles financiers doivent vérifier l'actualité des données et les résultats de calcul, et les modèles de code doivent être vérifiés par exécution et test. Les tâches à haut risque en santé, droit et finance devraient également conserver une approbation par des professionnels.
Lors de l'utilisation d'un modèle pour organiser des comptes rendus de réunion, si le texte original ne spécifie pas de responsable mais que le modèle invente un nom ; lors de l'utilisation d'un modèle pour extraire des informations de contrats, si le texte original ne contient pas de montant mais que le modèle génère un chiffre spécifique — ce sont tous des exemples d'hallucination du modèle. L'hallucination du modèle fait référence à la génération par un grand modèle de contenu qui est linguistiquement fluide et structurellement complet mais incompatible avec les faits, les matériaux d'entrée ou les sources vérifiables. Elle peut également se manifester par la fabrication de politiques, d'articles ou d'URL inexistants, l'identification erronée de personnes et de dates, ou la présentation de discussions non confirmées comme des conclusions établies.
La tâche centrale des grands modèles est de prédire le Token suivant en se basant sur le contexte ; pendant la génération, le modèle ne peut pas vérifier si chaque phrase est vraie. Il existe de nombreuses causes d'hallucination du modèle. Par exemple, les données de pré-entraînement peuvent contenir des erreurs ou des informations obsolètes ; les questions des utilisateurs peuvent manquer de conditions clés ; et les preuves dans les longs textes peuvent être négligées ou tronquées. Si le post-entraînement conçoit des fonctions de récompense qui favorisent les réponses complètes et fluides, cela peut également amener le modèle à continuer à générer même sans base suffisante.
Les hallucinations produites par les modèles sont également diverses et peuvent généralement être classées comme hallucination factuelle, hallucination d'attribution, hallucination de raisonnement, etc. Les classifications détaillées et les manifestations typiques sont présentées dans le tableau suivant :
Type | Manifestation typique |
Hallucination factuelle | Noms, dates, chiffres et événements incompatibles avec la réalité |
Hallucination d'attribution | Articles, dispositions légales, liens ou sources fabriqués |
Hallucination d'entrée | Génération de conclusions et de champs absents du matériel original |
Hallucination de raisonnement | Erreurs dans le raisonnement intermédiaire, mais la réponse exprimée avec certitude |
Hallucination d'outil | Affirmation avoir lu un fichier ou appelé une interface sans y être réellement parvenu |
En plus des modèles généraux, les modèles de domaine entraînés avec des données professionnelles peuvent également produire des hallucinations. Généralement, les données professionnelles peuvent améliorer les performances de domaine mais ne peuvent pas garantir que chaque réponse est exacte. La récupération de bases de connaissances ne peut pas non plus résoudre complètement tous les problèmes d'hallucination. Si les matériaux récupérés ne sont pas pertinents, périmés ou contiennent eux-mêmes des erreurs, le modèle peut toujours aboutir à des conclusions incorrectes, conduisant davantage à des hallucinations.
L'hallucination du modèle est un problème relativement courant dans les applications actuelles. Simplement ajouter une phrase comme « ne fabriquez pas » ou « veuillez garantir l'exactitude » à l'invite ne peut généralement pas éliminer fondamentalement ce risque. Le modèle est fondamentalement toujours en train de prédire le contenu le plus probable en se basant sur le contexte, et lorsque les informations d'entrée sont insuffisantes, les matériaux contiennent des conflits, ou la question elle-même dépasse la plage de connaissances fiables du modèle, il peut toujours générer des réponses qui semblent plausibles mais sont en réalité inexactes. Par conséquent, la réduction du risque d'hallucination repose davantage sur un ensemble complet de contraintes d'entrée, de vérification externe et de mécanismes de revue humaine.
D'abord, les modèles devraient recevoir des matériaux clairs, pertinents et internement cohérents autant que possible, en réduisant l'interférence des informations non pertinentes et conflictuelles dans le processus de jugement. Pour le contenu clé tel que les faits, les chiffres, les dispositions réglementaires et les résultats expérimentaux, le modèle peut être amené à indiquer simultanément les sources, sections, numéros de page ou emplacements originaux correspondants, rendant les réponses traçables pour une vérification ultérieure. Pour les connaissances fréquemment mises à jour telles que les actualités, les politiques, les prix, les réglementations et les paramètres de produits, on ne devrait pas s'appuyer uniquement sur la mémoire interne du modèle mais obtenir les dernières informations via des moteurs de recherche, des bases de connaissances, des bases de données, des API ou d'autres outils externes, puis laisser le modèle analyser sur la base de ces matériaux fiables.
Deuxièmement, lorsque le matériel original manque réellement de certaines informations, le modèle devrait être explicitement amené à les marquer en utilisant des expressions comme « à confirmer », « non fourni dans l'original » ou « ne peut être déterminé sur la base des matériaux existants », plutôt que de les compléter en se basant sur l'expérience. Pour le contenu adapté à la vérification structurée — tel que les dates, montants, numéros d'identification, données statistiques, formules et résultats d'exécution de code — des programmes peuvent être introduits pour une vérification automatique, par exemple en vérifiant les plages de valeurs, les formats de champs, les résultats de calcul et si le code peut réellement s'exécuter, évitant ainsi au modèle de générer des résultats basés uniquement sur la génération de langue.
De plus, pour les conclusions importantes — en particulier celles qui affectent les décisions commerciales, l'acceptation de projet ou les droits des utilisateurs — une étape de revue humaine devrait être conservée. L'expression fluide de la langue et la logique apparemment complète ne signifient pas nécessairement que les faits sont corrects, donc « cela ressemble à la vérité » ne devrait pas être directement équivalent à « c'est réellement vrai ». Dans les scénarios à haut risque tels que la santé, le droit, la finance et la sécurité de production, il devrait être clair que le modèle est simplement un outil auxiliaire, et les conclusions finales doivent être examinées et confirmées par des professionnels qualifiés ayant l'expérience appropriée.
Par conséquent, l'approche centrale pour réduire l'hallucination n'est pas d'exiger que le modèle « réponde toujours » mais d'apprendre au modèle à s'arrêter rationnellement lorsqu'il manque de base fiable. Lorsque les informations existantes sont insuffisantes pour soutenir une conclusion, le comportement le plus approprié peut être d'indiquer clairement « quelles clés materials sont actuellement manquantes » et « quelles conclusions ne peuvent pas être confirmées à ce stade », et d'informer davantage l'utilisateur quelles données, documents ou preuves doivent être fournis. Comparé à la poursuite de la génération d'une réponse qui semble complète mais manque de base, cette approche est généralement plus fiable et plus adaptée aux applications commerciales réelles.