AIUnlimited
🌳

AI基礎

🌱
AI Seeds(種)

ゼロから始める

🌿
AI Sprouts(芽)

基礎を築く

🌳
AI Branches(枝)

実践に活かす

🏕️
AI Canopy(樹冠)

深く学ぶ

🌲
AI Forest(森)

AIをマスターする

🔨

AIマスタリー

✏️
AI Sketch(スケッチ)

ゼロから始める

🪨
AI Chisel(鑿)

基礎を築く

⚒️
AI Craft(制作)

実践に活かす

💎
AI Polish(磨き上げ)

深く学ぶ

🏆
AI Masterpiece(傑作)

AIをマスターする

📘

AI実践

📖
オープンソースモデルを理解する

オープンソースモデルの基礎とリソース

🎯
問題からモデルタスクへ

ビジネス問題をモデルタスクに変換

⚡
最初のモデルを実行する

30分で最初の結果を見る

🔧
ファインチューニングと評価

モデルをファインチューニングし、パフォーマンスを評価

🚀
アプリケーションシステム

実際のAIアプリケーションを構築

🎨
生成AI

オープンソースAIGCモデルを探索

🤖
エージェント

エージェントフレームワークとMCPツールを学ぶ

📐
補足基礎

LLMの基礎と評価

🎓

Claude アカデミー

🤖
Claude 101

Learn AI basics with Claude

💻
Claude Code 101

Code with Claude as your pair programmer

🤝
Introduction to Claude Cowork

Collaborate with Claude on complex projects

⚙️
Claude Platform 101

Build apps with the Claude API

ラボ

7つの実験がロード済み
🧬ニューラルネットワークサンドボックス🤖AI か人間か?🥋プロンプトエンジニアリング道場🏁アルゴリズムレース🧠AIトリビアチャレンジ🏗️システム設計キャンバス
🎯模擬面接ラボへ入る→
🚀

キャリア発展

🚀
面接ローンチパッド

旅を始めよう

🌟
行動面接マスター

ソフトスキルをマスター

💻
技術面接

コーディング面接を突破

🤖
AI・ML面接

ML面接をマスター

🏆
オファーとその先

最高のオファーを獲得

始める
AIUnlimited

MITライセンス

沪ICP备18025655号-11

学ぶ

  • AI基礎
  • AI実践
  • Claude アカデミー
  • ラボ
  • キャリア発展

コミュニティ

  • 概要
  • よくある質問

サポート

  • footer.terms
  • footer.privacy
  • footer.contact
AI & エンジニアリング アカデミックス›📖 オープンソースモデルを理解する›レッスン›Data: The Foundation of Fine-Tuning
📊
オープンソースモデルを理解する • 初級⏱️ 12 分で読める

Data: The Foundation of Fine-Tuning

データ:オープンソースモデルファインチューニングの基盤

コーディングや数学では優秀だが、日常的な質問には適当に答えるモデルに遭遇したことはありますか?

トレーニング中に特定の能力を向上させるには、その種のデータを探す必要があることは周知の事実です。

しかし多くのデータセットは直接のインターネット検索では見つかりにくいです。統一されたダウンロードポータルはトレーナーの労力を大幅に節約します。

例えば、当社の中国語DeepSeek-R1蒸留データセットの生データの多くはModelScopeから直接ダウンロードされました。
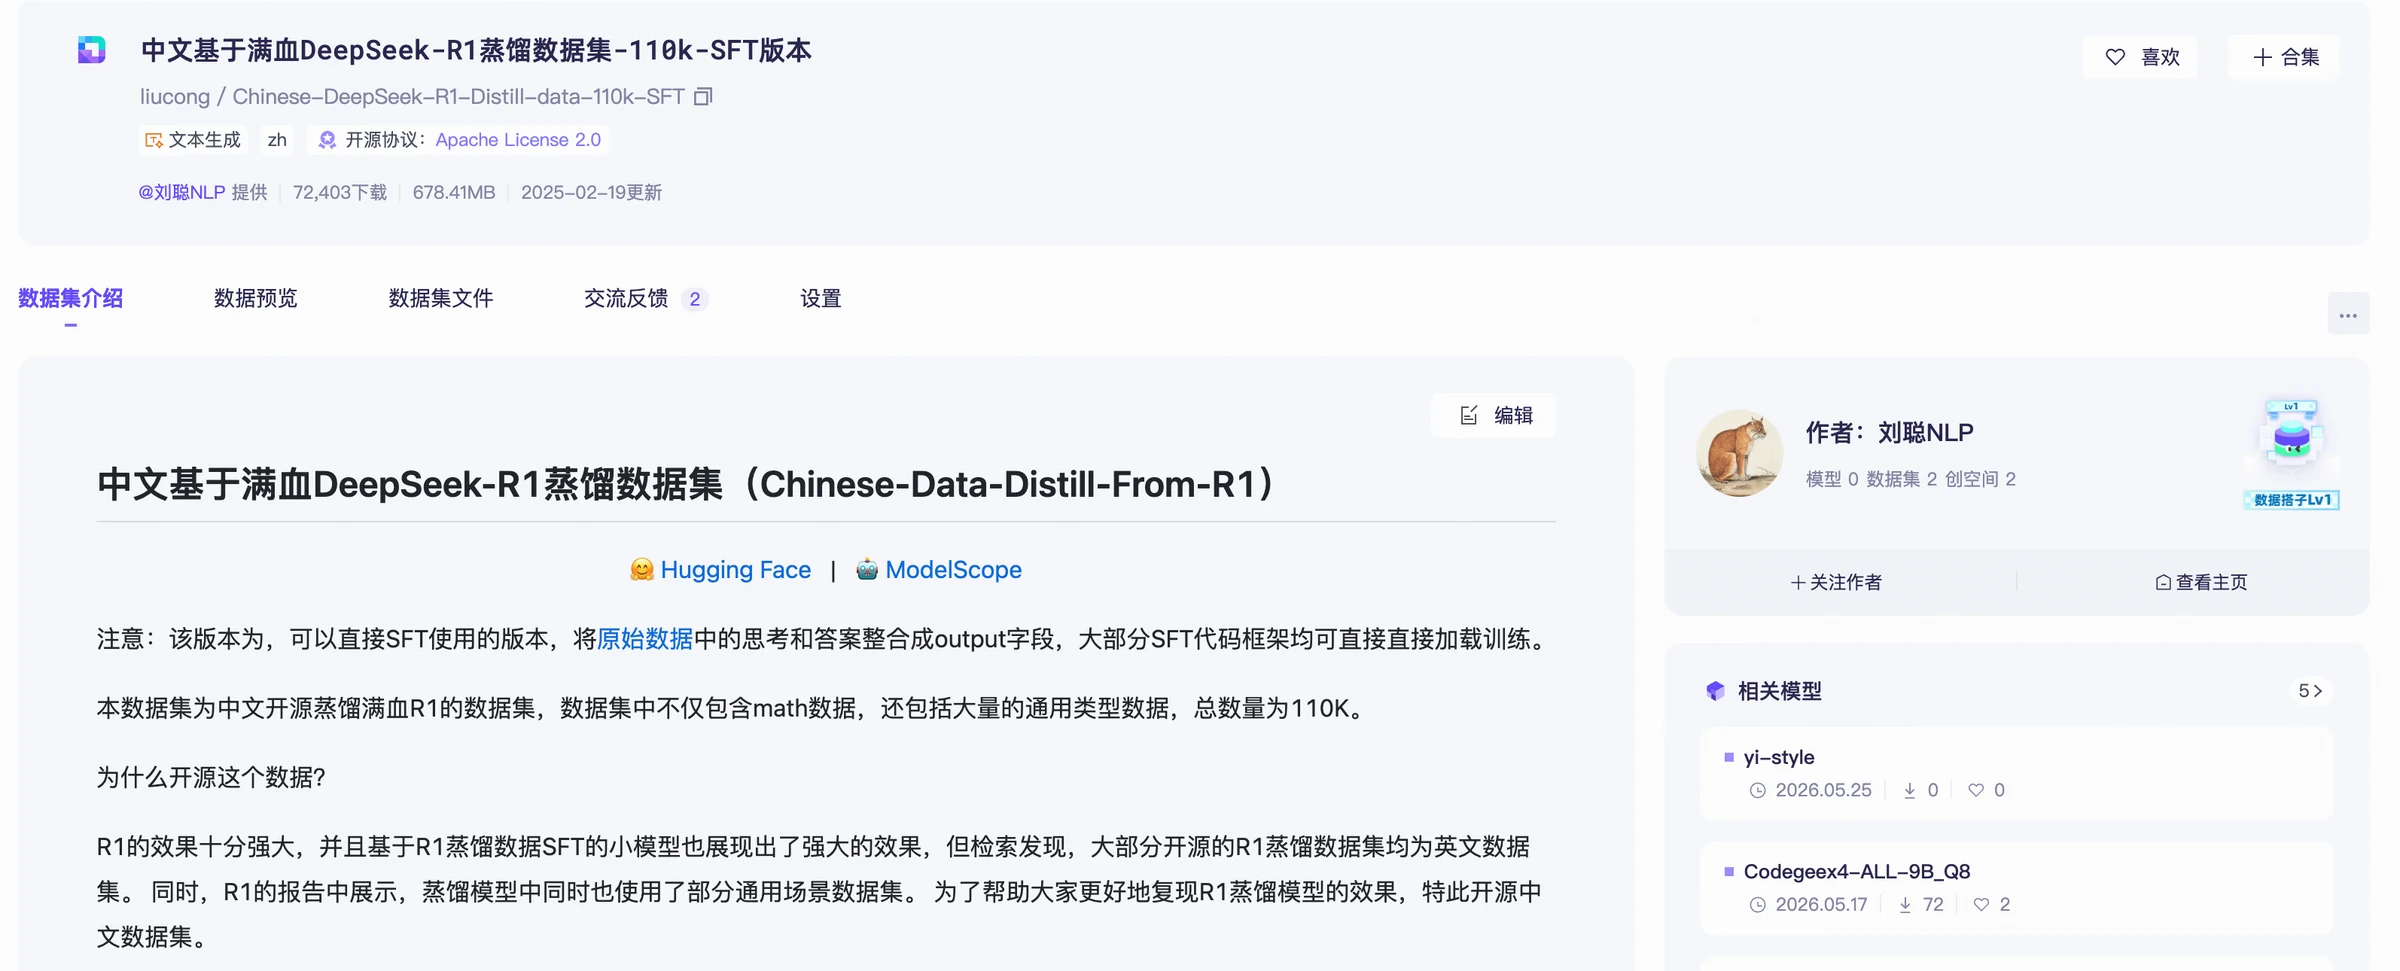
図解

モデルのファインチューニングは既存のオープンソースデータセットから始めれば、全体のプロセスを迅速に実行できます。

データを見つけるには、まず何をするかを知る必要がある

ModelScopeは4万以上のオープンソースデータセットを統合し、検索・プレビュー・フィールド説明・バージョンを提供しています。

ModelScopeはキーワードタグやタスクカテゴリによる検索をサポートしており、中国語の二値テキスト分類データの検索が可能です。
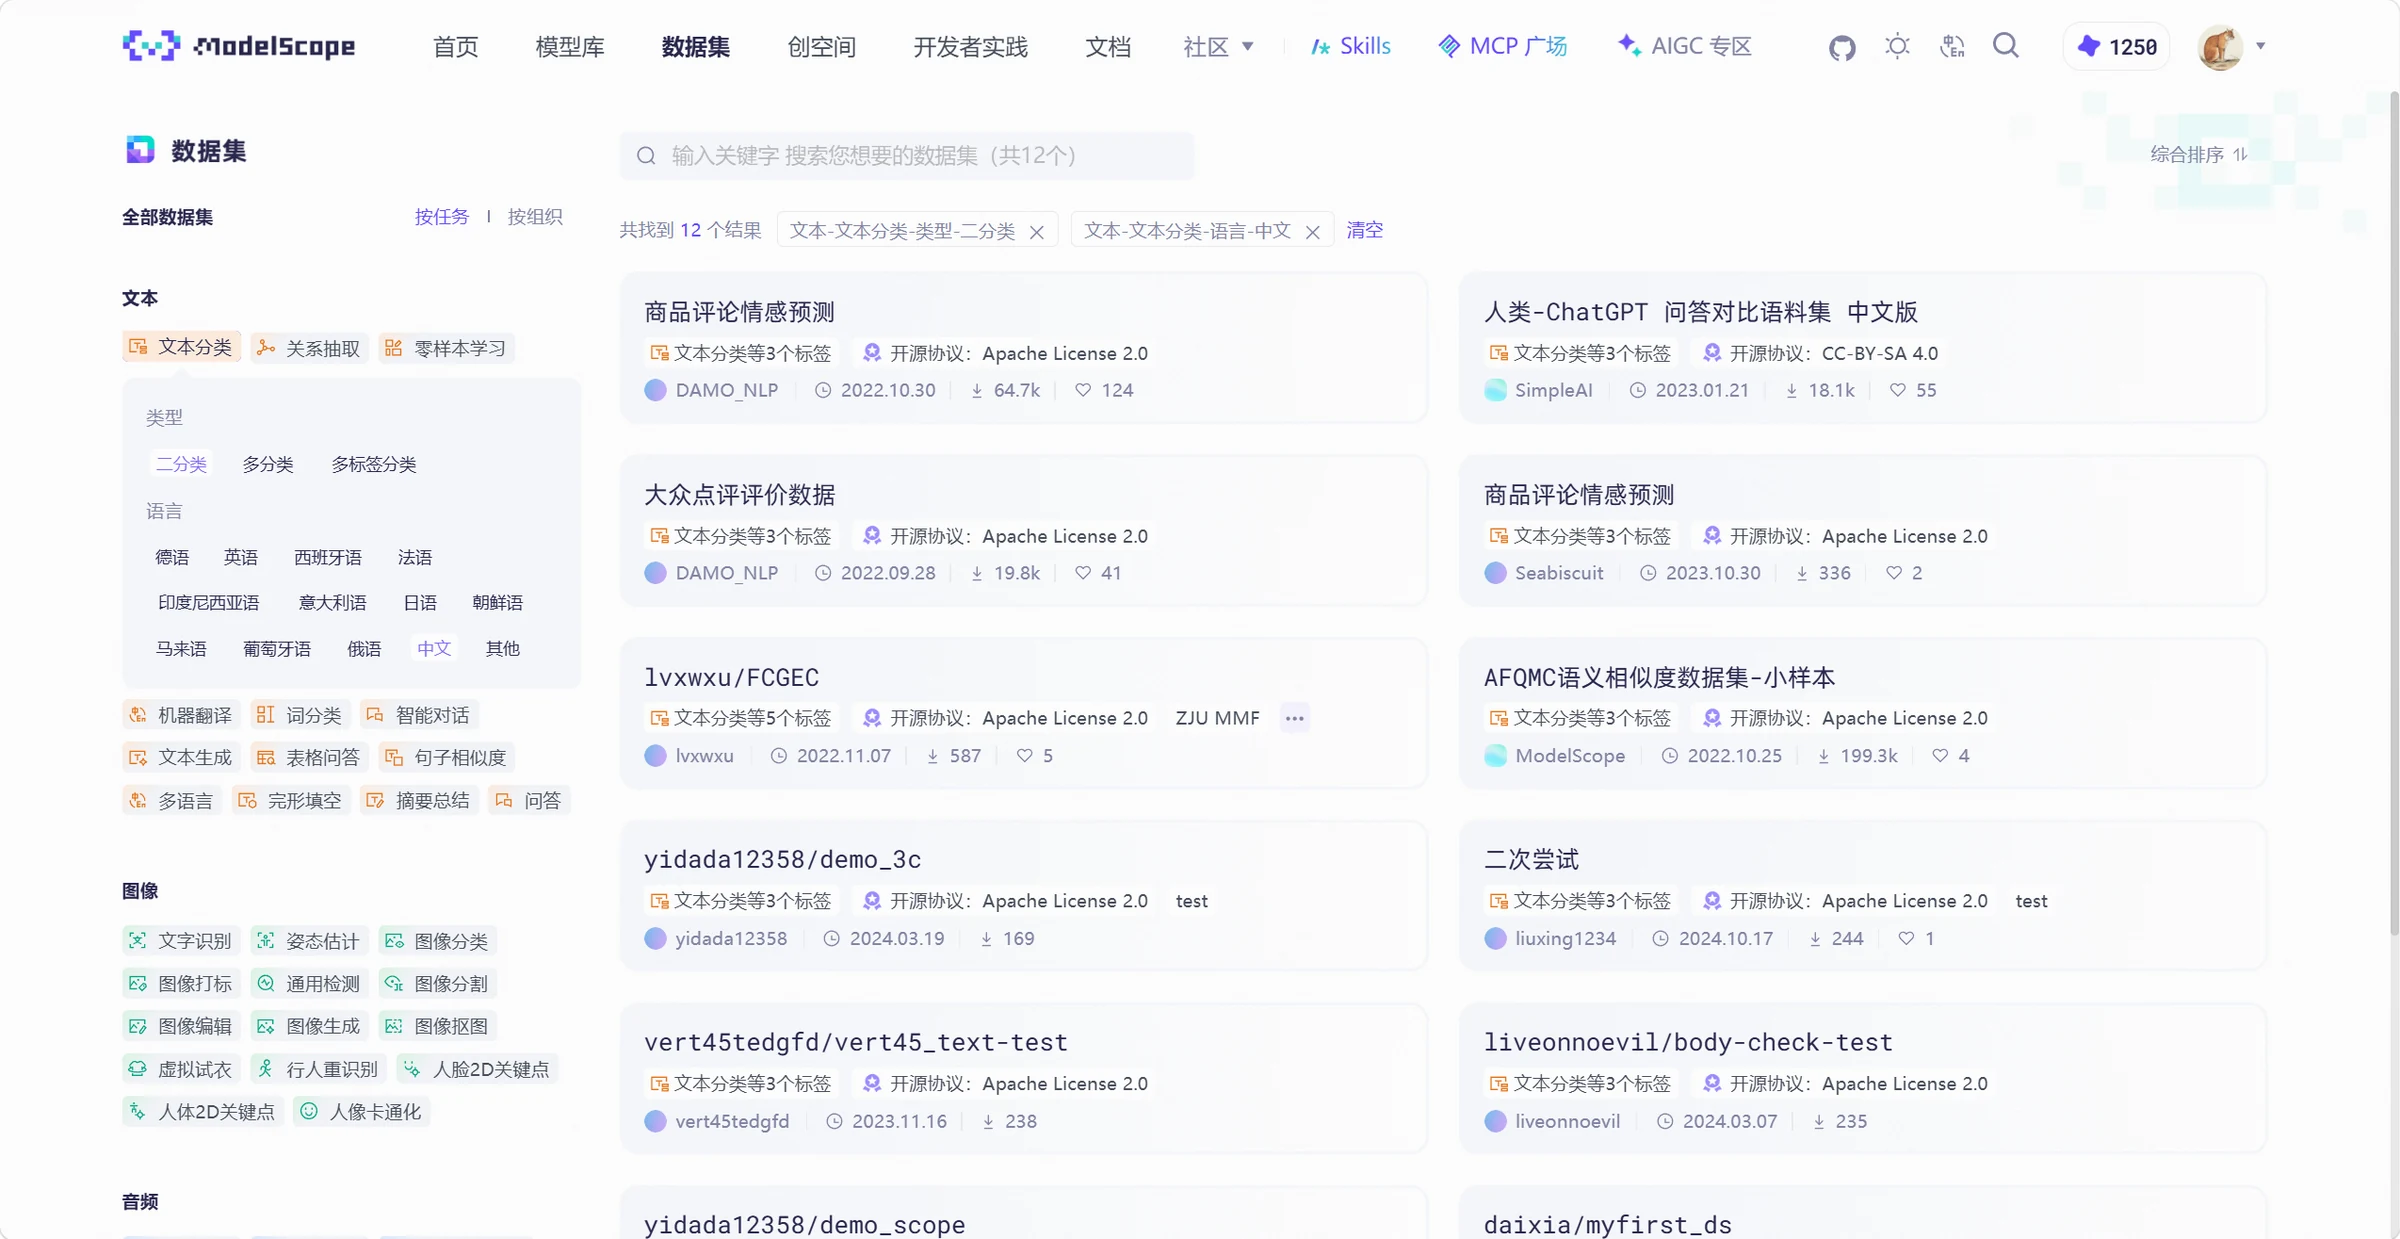
図解

ダウンロード前に、いくつかのサンプルを確認

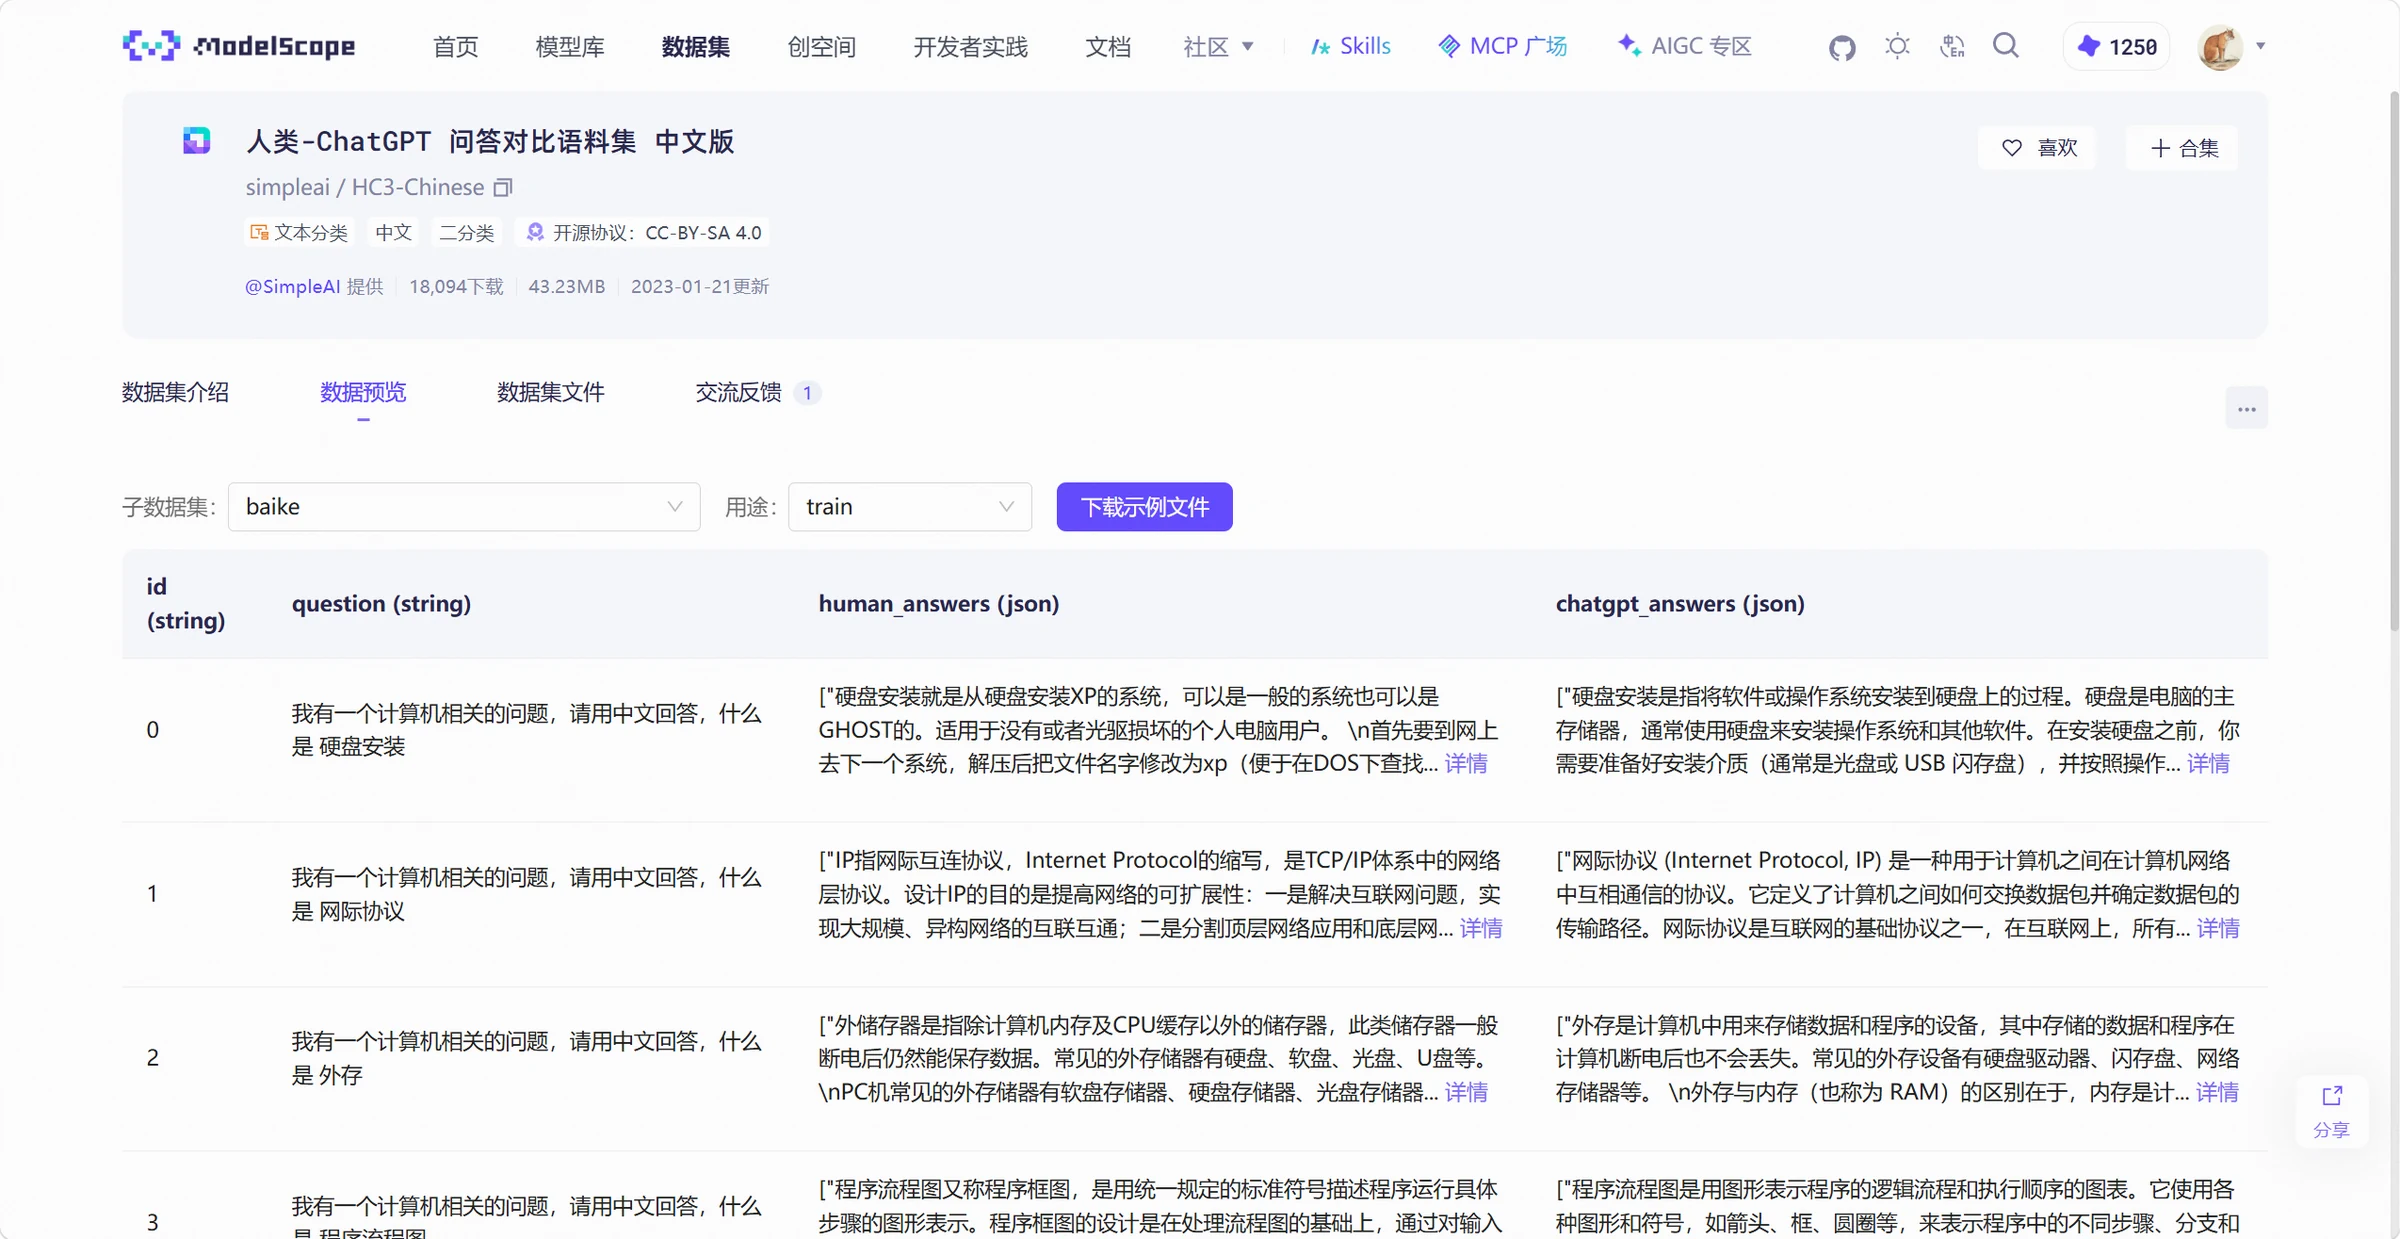
フィルタリング後、興味のあるデータセットを選んで「データプレビュー」をクリックすると、サンプル内容とフィールド説明をオンラインで確認できます。simpleai/HC3-Chineseなど。
図解

どの列に質問、回答、ラベルがあるか、各レコードがテキストか対話かなど、すべて事前に確認できます。

QAデータの場合、人間の回答とモデルの回答が異なるフィールドにある場合があります。タスクに応じてどのフィールドを読み、どう整理するかを決定してから訓練してください。

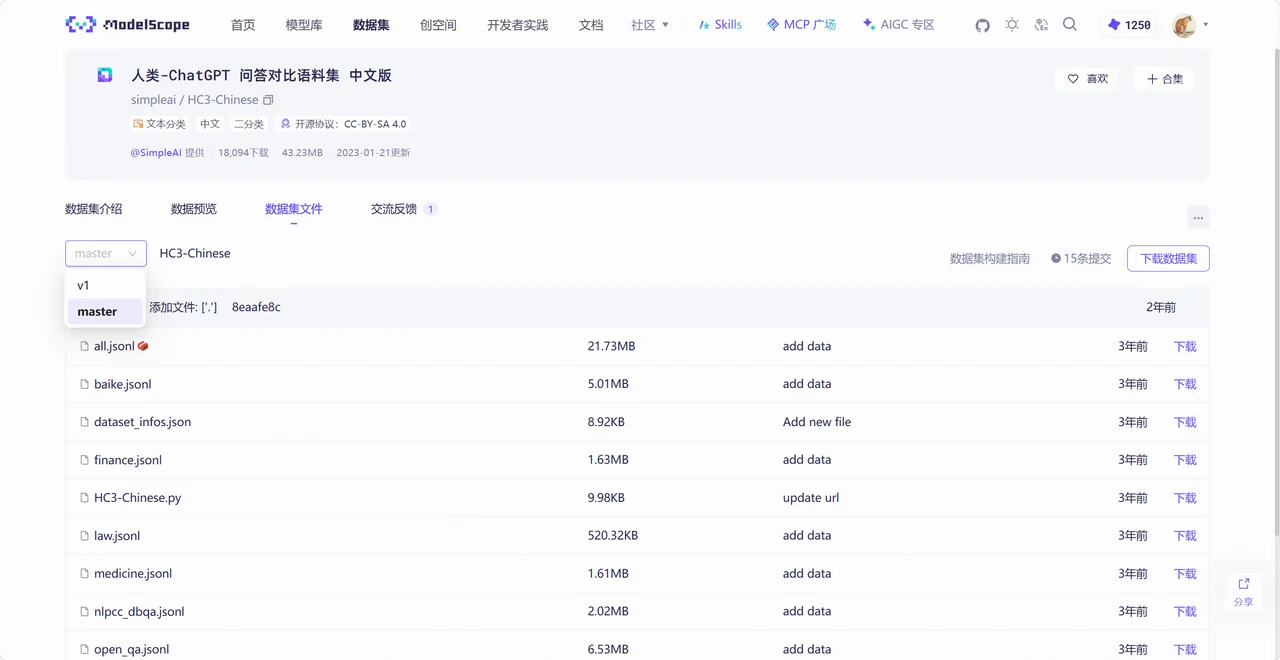
データセットファイルとバージョンを確認します。データセットは更新される場合があり、使用したバージョンを記録すれば再現性が高まります。
図解

データセットの説明とライセンスも確認する価値があります。ダウンロードしたデータは研究、訓練、商用製品で異なる要件がある場合があります。

まずデータを読み込み、使用する部分を決定

ModelScopeはMsDataset.loadインターフェースを提供し、Pythonでデータセットを読み込めます。インストール後、データセットページの指示に従ってください。

まず完全なデータセットを読み込む

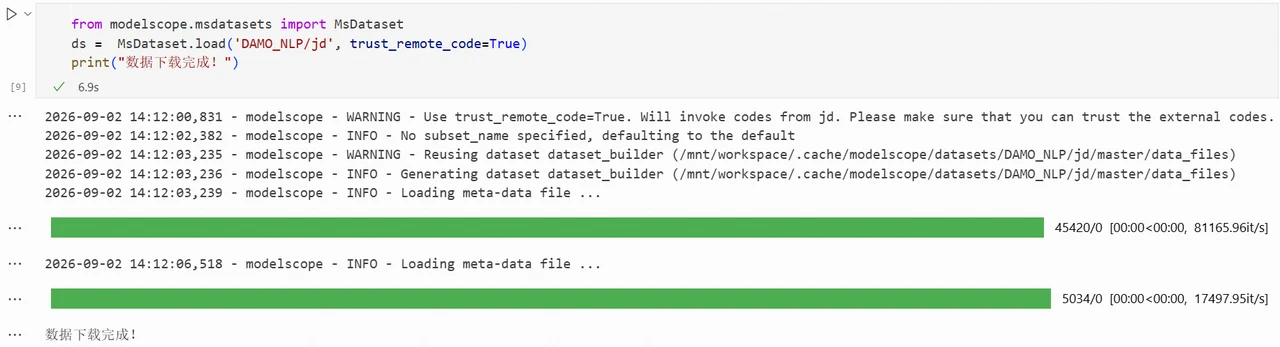
DAMO_NLP/jdを例に、デフォルト設定のデータは次のように読みます。

from modelscope.msdatasets import MsDataset

ds = MsDataset.load(
    'DAMO_NLP/jd',
    trust_remote_code=True,
)
print(ds)
図解

サブセットのみ必要な場合、名前を明確に

一部のデータセットはソース、ドメイン、用途別にデータを分けて保存しています。一部のみ必要な場合はsubset_nameで指定します。

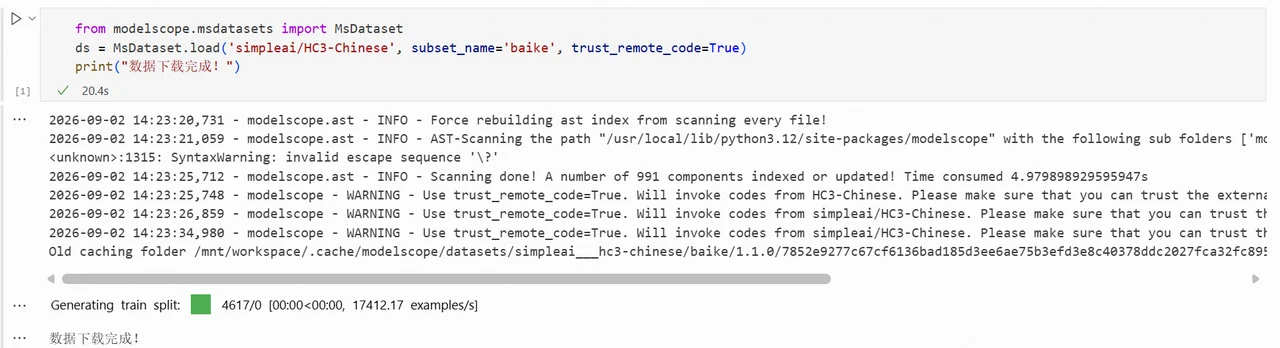
例えば、HC3-Chineseのbaikeサブセットを読み込みます。

from modelscope.msdatasets import MsDataset

ds = MsDataset.load(
    'simpleai/HC3-Chinese',
    subset_name='baike',
    trust_remote_code=True,
)
print(ds)
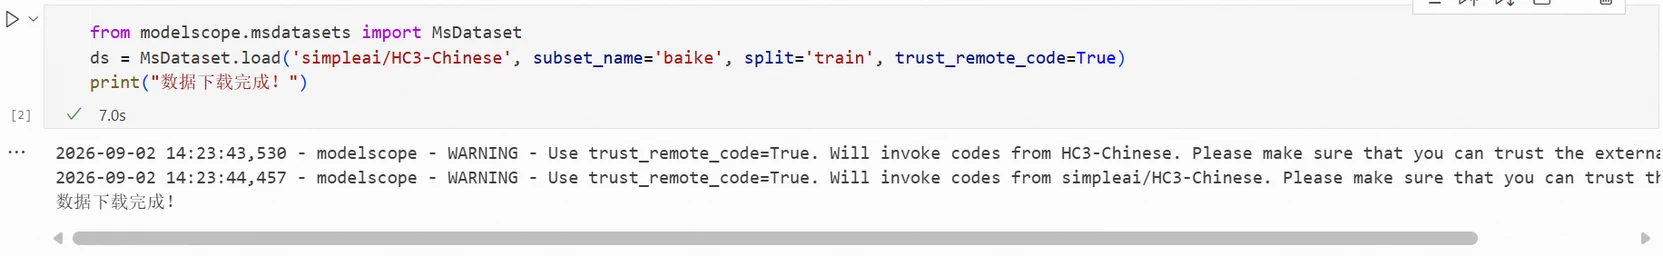
図解

データセットを変更する際は、利用可能なサブセットを確認してください。baikeはこのデータセット固有の名前です。

レッスン 3 / 40%完了
←Model Discovery and Downloads

ディスカッション

ログイン ディスカッションに参加

トレーニングセットとテストセットは別途読み込み可能

サブセットはデータカテゴリを、splitはデータパーティションを選びます。一般的なのはtrain、validation、testです。

baikeサブセットのトレーニングセットのみを読み込むには、パラメータを追加します。

from modelscope.msdatasets import MsDataset

ds = MsDataset.load(
    'simpleai/HC3-Chinese',
    subset_name='baike',
    split='train',
    trust_remote_code=True,
)
print(ds[0])
図解

すべてのデータセットが3つのパーティションを提供するわけではありません。トレーニングセットを取得したら、まずサンプルを印刷して確認してください。

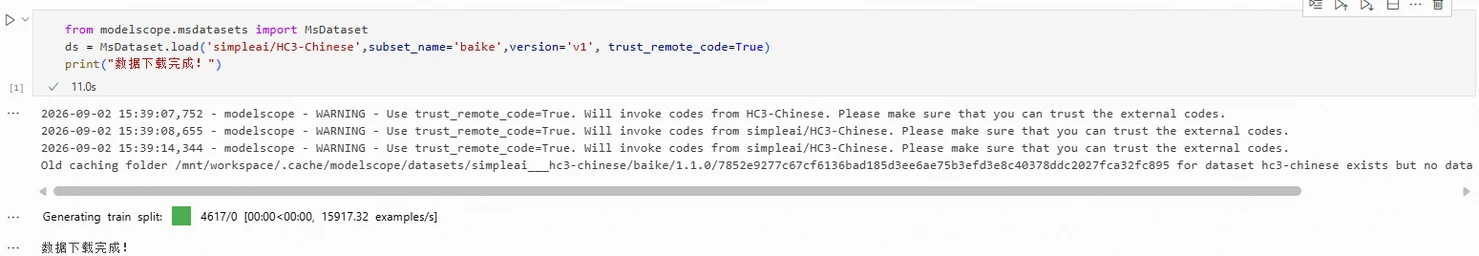
実験を再現するには、バージョンも記録

データ更新後、同じコードで異なる内容が読み込まれる場合があります。HC3-Chineseのv1バージョンを例に、versionで明示的に指定できます。

from modelscope.msdatasets import MsDataset

ds = MsDataset.load(
    'simpleai/HC3-Chinese',
    subset_name='baike',
    version='v1',
    trust_remote_code=True,
)
print(ds)
図解

実際の操作では、データセットページで利用可能なバージョンを確認してください。バージョンが継続的に更新される場合は、使用したデータファイルやチェックサムを保存してください。

ダータをダウンロードしましたが、すぐにモデルに渡さないで

まずサンプルをいくつか確認して、null値、文字化け、明らかなエラーがないか確認し、フィールドがコードの要件を満たしているか確認してください。

トレーニングデータとテストデータは分離してください。テストサンプルをトレーニングセットに混ぜると、スコアは良見えしますが新しい問題でのパフォーマンスが判断できません。