AIUnlimited
🌳

AI基礎

🌱
AI Seeds(種)

ゼロから始める

🌿
AI Sprouts(芽)

基礎を築く

🌳
AI Branches(枝)

実践に活かす

🏕️
AI Canopy(樹冠)

深く学ぶ

🌲
AI Forest(森)

AIをマスターする

🔨

AIマスタリー

✏️
AI Sketch(スケッチ)

ゼロから始める

🪨
AI Chisel(鑿)

基礎を築く

⚒️
AI Craft(制作)

実践に活かす

💎
AI Polish(磨き上げ)

深く学ぶ

🏆
AI Masterpiece(傑作)

AIをマスターする

📘

AI実践

📖
オープンソースモデルを理解する

オープンソースモデルの基礎とリソース

🎯
問題からモデルタスクへ

ビジネス問題をモデルタスクに変換

⚡
最初のモデルを実行する

30分で最初の結果を見る

🔧
ファインチューニングと評価

モデルをファインチューニングし、パフォーマンスを評価

🚀
アプリケーションシステム

実際のAIアプリケーションを構築

🎨
生成AI

オープンソースAIGCモデルを探索

🤖
エージェント

エージェントフレームワークとMCPツールを学ぶ

📐
補足基礎

LLMの基礎と評価

🎓

Claude アカデミー

🤖
Claude 101

Learn AI basics with Claude

💻
Claude Code 101

Code with Claude as your pair programmer

🤝
Introduction to Claude Cowork

Collaborate with Claude on complex projects

⚙️
Claude Platform 101

Build apps with the Claude API

ラボ

7つの実験がロード済み
🧬ニューラルネットワークサンドボックス🤖AI か人間か?🥋プロンプトエンジニアリング道場🏁アルゴリズムレース🧠AIトリビアチャレンジ🏗️システム設計キャンバス
🎯模擬面接ラボへ入る→
🚀

キャリア発展

🚀
面接ローンチパッド

旅を始めよう

🌟
行動面接マスター

ソフトスキルをマスター

💻
技術面接

コーディング面接を突破

🤖
AI・ML面接

ML面接をマスター

🏆
オファーとその先

最高のオファーを獲得

始める
AIUnlimited

MITライセンス

沪ICP备18025655号-11

学ぶ

  • AI基礎
  • AI実践
  • Claude アカデミー
  • ラボ
  • キャリア発展

コミュニティ

  • 概要
  • よくある質問

サポート

  • footer.terms
  • footer.privacy
  • footer.contact
AI & エンジニアリング アカデミックス›🔧 ファインチューニングと評価›レッスン›Preference Alignment
🎯
ファインチューニングと評価 • 初級⏱️ 20 分で読める

Preference Alignment

モデルが回答できるようになったのに、なぜさらに優先度調整(Preference Alignment)が必要なのか?

モデルを微調整(Fine-tuning)すると、指定されたように回答できるようになります。しかし、複数の回答を並べて見ると、良い回答と悪い回答があり、またある回答の方がより自然に感じることもあります。

例えば、返金に関する相談で、同じようにユーザーに返金申請の場所を教えると、一つの回答は操作エントリのみを提供し、もう一つの回答は審査が必要である、返金が許可されるかどうかは注文状況によるなど、返金に関する情報をより明確に伝え、誤解を少なくしています。これらの回答はどちらも返金に関する内容ですが、後者はユーザーが次に遭遇する可能性のある状況を説明し、より情報が充実しているため、業務上より適切です。

前のSFT(Supervised Fine-Tuning)の段階では、このような回答を例として整理し、モデルに学ばせていました。現在は、同じ問題の異なる回答を一緒に表示し、モデルにどの回答をより認めるべきか、そして評価の基準は何かを教えることができます。

これが優先度調整(Preference Alignment)です。ここから始めましょう。

先に整理し、後トレーニングの手法は?

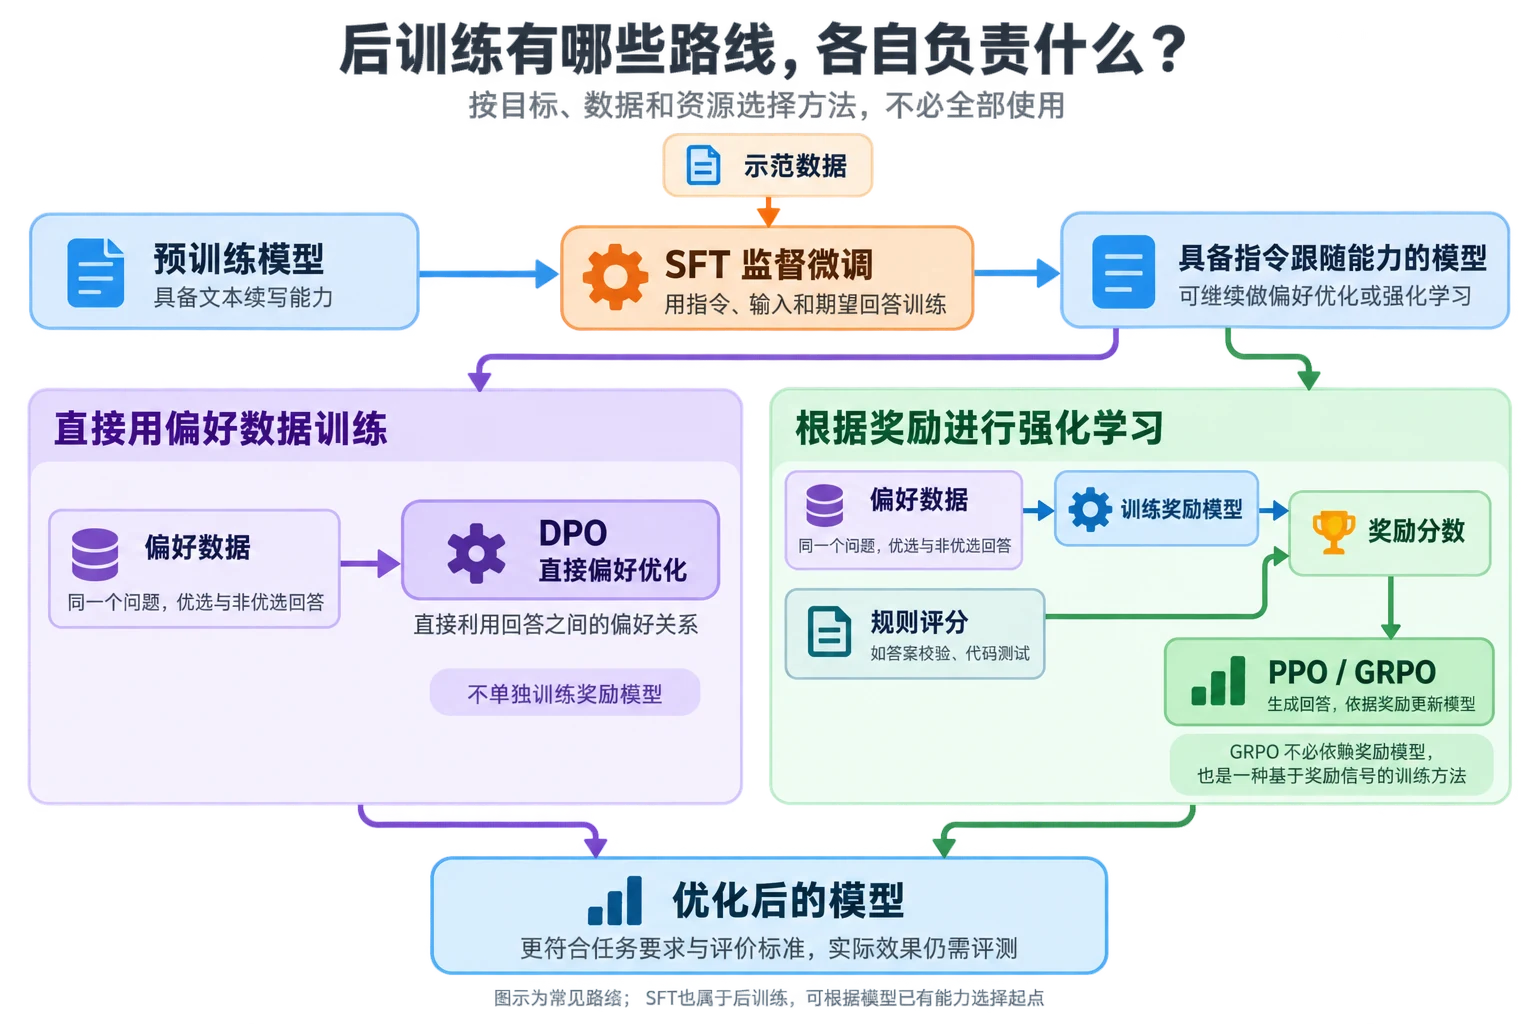
大規模言語モデル(LLM)の後トレーニング(Post-Training)の主な目的は、既にテキストの継続能力を持つ基礎モデルを、より良い対話性、指示の遵守、特定のタスクの完了といった具体的なタスクに適応させることです。後トレーニングは固定されたアルゴリズムではなく、SFT(Supervised Fine-Tuning)、優先度最適化、報酬モデル(Reward Model)の訓練、強化学習(Reinforcement Learning)などの一連の訓練手法の総称です。モデルは訓練目標、データ条件、コストに応じて異なる組み合わせを選択します。

その中で、SFTは「指示、入力、期待回答」形式のデータを使用し、モデルがタスクを理解し、指示に従い、期待された形式や方法で回答する方法を学ばせます。この基礎上、さらに優先度データを用いた対齊(Alignment)を行うことも可能です。例えば、同じ問題に対して選好回答(Chosen)と非選好回答(Rejected)を構成し、モデルに人間や業務評価基準を学ばせます。優先度データは、人工的な優先度を計算可能な報酬スコア(Reward Score)に変換するための報酬モデル(Reward Model)を訓練するのに使うこともでき、PPO(Proximal Policy Optimization)、GRPO(Group Relative Policy Optimization)などの強化学習方法と組み合わせて生成戦略を継続的に最適化することもできます。また、DPO(Direct Preference Optimization)などの手法で、選好回答と非選好回答の間の優先度関係を訓練目標に直接反映させ、報酬モデルを別途訓練しないようにすることも可能です。

したがって、大規模言語モデルの後トレーニングには固定されたプロセスは存在しません。SFT、報酬モデル、PPO、GRPO、DPOもそれぞれ異なる役割を担っています。SFTは基本的な指示フォローケースを構築するための主要な手法であり、報酬モデルは定量的な評価信号を提供し、PPOやGRPOは報酬信号に基づいて生成戦略をさらに最適化します。DPOは優先度データを直接利用してモデルを対齊します。実際の訓練プロセスでは、これらの手法はすべて使用する必要はなく、完全に同じ順序で組み合わせる必要もありません。モデルの能力、タスク目標、訓練リソースに応じて柔軟に選択します。
正文配图

モデルに例を見せて、SFTは何を教えるか?

SFT(Supervised Fine-Tuning)は監督微調整(Supervised Fine-Tuning)の略称で、既に整理された入力と期待される出力を使ってモデルをさらに訓練し、モデルが類似した入力を見たときに、期待される回答を生成する確率を高めるようにします。

1つのSFTデータは以下のような形式で書けます:

{
  "instruction": "ユーザーの質問に基づいてカスタマーサポートの回答を作成",
  "input": "会員は昨日自動で更新されました。返金を申し出たいです。",
  "output": "まず、注文ページで更新された注文の状態を確認してください。返金条件が満たされると、注文詳細ページで申請を提出できます;ページに返金エントリがない場合は、人工カスタマーサポートに連絡して確認してください。"
}

訓練時、トークナイザ(Tokenizer)は指示、入力、回答をトークン(Token)に変換します。モデルは前のトークンに基づいて次のトークンを予測し、予測結果と期待回答との差を用いて損失を計算します。大規模言語モデルのSFTでは、交差エントロピー損失(Cross-Entropy Loss)と教師強制(Teacher Forcing)が一般的です。訓練の各位置では、モデルがデータ中に既に与えられた正しい前文を見るのではなく、自分が生成した誤った内容を見ることはありません。多くの指示微調整(Instruction Fine-Tuning)の実装では、回答部分のみ損失を計算し、指示とユーザー入力はコンテキストを提供するため、再生成する必要はありません。

SFTが最初に変えるのはタスク形式です。モデルは徐々に理解するようになります:入力はユーザーの相談、出力はカスタマーサポートの回答であり、ユーザーの質問を継続するのではなく、このように回答するべきであると。情報抽出(Information Extraction)の場合、固定されたJSONフィールドを出力することを学べます;会議記録の場合、会議情報、重要な結論、アクション項目に基づいて内容を構成することを学べます。次に、SFTはモデルの回答方法を変えます。訓練データ中のニュアンス(トーン)、長さ、段落構造、説明の程度、拒否の方法などがモデルが模倣する対象となります。例えば、期待回答が普遍的に簡潔である場合は、モデルは結論を直接提示する傾向になります。例えば、示された例が根拠を先に説明し、次に手順を示すことを求めている場合は、モデルもその構成方法を学びます。SFTはモデルに分野の例を接する機会を与えます。カスタマーサポートデータ中の注文状況、返金条件、人工サービスのアップグレード、法律データ中の条項構造、コードデータ中のインターフェースの使い方などが、モデルの対応するタスクでの出力に影響を与えます。しかし、これはモデルがその分野の全ての知識を自動的に習得したことを意味するわけではありません。SFTデータがどのタスク、どの用語、どの処理方法をカバーするかによって、モデルがパラメータ更新でこれらのパターンを学ぶ機会があります。

レッスン 3 / 40%完了
←Fine-Tuning with ms-swift

ディスカッション

ログイン ディスカッションに参加

SFTの訓練目標は本質的に期待された出力を模倣することにあります。モデルにこのような問題は通常どのように回答するかを知らせることができるが、回答中の事実が検証済みであることを保証できず、また一つの例だけでは全ての可能な回答を比較することもできません。同じ返金問題では以下のような回答が得られる可能性があります:

回答A:注文詳細ページで返金を申し出てください。操作できない場合は、人工カスタマーサポートに連絡してください。

回答B:まず注文状態を確認してください。返金条件が満たされると、注文詳細ページで申請を提出できます;ページに返金エントリがない場合は、人工カスタマーサポートに連絡して確認してください。返金結果と到着時間は実際の審査に準じます。

両回答とも返金に関連していますが、回答Bは審査条件を補足し、確定した返金結果を約束しないことで、業務上より適切です。業務が情報の充実度や規制境界を重視する場合、回答Bがより適切です。SFTは回答Bを例としてモデルに教えることができますが、優先度データは同時にAとBを与え、なぜBをより好むかを明確に教えることができます。これが監督学習(Supervised Learning)から優先度調整(Preference Alignment)へ移行する理由です。

同じ問題で、どのような回答がより適切か?

優先度調整(Preference Alignment)の焦点は、モデルが「回答できるかどうか」ではなく、複数の可能な回答のうち、どれをより好むべきかです。通常、同じ入力に対する異なる回答の優劣比較を通じて、正確性、関連性、有用性、表現方法、安全性などといった要求を訓練信号に変換します。SFTと比較すると、SFTはモデルに「どう答えるか」を教えるものであり、通常1つの入力に対応する1つの期待出力を使い、モデルにタスク形式、内容構造、分野表現、基本的回答方法を学ばせます。一方、優先度調整はモデルが既に一定の回答能力を持った後、より良い回答を生成するように進めていくものです。

返金カスタマーサポートのシナリオで例をあげると、回答が審査条件を省略し、固定の返金到着時間を約束し、または不確定事項を確定した結果と表現した場合、これを悪い回答としてマークできます。もう一方の回答が、手続き方法を明確に説明し、必要な審査境界を保持し、政策を虚構しない場合は、より良い回答としてマークできます。大量のこのような比較訓練を通じて、モデルは選好回答の生成確率を徐々に向上させ、類似問題で業務要件に合った結果を出力するようになります。注意すべき点は、優先度調整で学習されるのは抽象的で統一的な「人間の価値」ではなく、報酬関数と結びつけ、具体的なタスクで定義された評価基準です。異なるタスクにはタスクに合わせた優先度データの構造が必要です。したがって、優先度データを作成する前に、「何がより良いか」を明確にすること、そうしないと異なるアノテータが理解の違いから矛盾した選択をすることがあります。

さらに、優先度調整は事実検証を置き換えることはできません。回答は表現が滑らかで親切であり、誤った政策を引用しても、もう一方の回答は事実が正しくても、必要な出力形式に従っていない可能性もあります。実際の評価体系では、事実の正確性、タスクの完了度、表現スタイル、安全・規制など、それぞれの基準を定義する必要があります。自動で検証可能な内容については、コードテスト、回答検証、フォーマットチェック、業務ルールなどと組み合わせて評価し、完全に主観的な判断に依存する偏りを減らすことができます。

優先度データはどのように構成するか

優先度データ(Preference Data)とは、モデルに「複数の回答のうちどれがより良いか」を教える訓練データです。SFTデータとの最大の違いは、SFTは通常1つの入力と1つの期待回答を提供するのに対し、優先度データは同じプロンプト(Prompt)に対して複数の候補回答を準備し、それらの間の優劣関係を記録することです。最も一般的な優先度データは入力、選好回答(Chosen)、非選好回答(Rejected)の3つから構成されます:

{
  "prompt": "会員は昨日自動で更新されました。返金を申し出たいです。",
  "chosen": "まず注文状態を確認してください。返金条件が満たされると、注文詳細ページで申請を提出できます;ページに返金エントリがない場合は、人工カスタマーサポートに連絡して確認してください。",
  "rejected": "返金は3営業日以内に到着します。"
}

ここで、chosenは現在の評価基準下でより適切な回答を示し、rejectedは相対的に不適切な回答を示します。非選好回答は必ずしも完全に間違っているわけではなく、必要な条件を省略し、表現が冗長、ニュアンスが要求に合わない、根拠のない約束を含む場合もあります。優先度データは相対的な関係を表しており、各回答に永遠の正しさや誤りというタグを貼るものではありません。

優先度データは以下のプロセスで構成されます:

  1. 真の業務またはテストセットから、タスクの分布を代表するプロンプト(Prompt)を準備します。
  2. 現在のモデル、異なるバージョンのモデル、または異なるサンプリングパラメータを使い、同じプロンプトに対して複数の候補回答を生成します。
  3. 一貫した評価基準で、アノテータ(Annotator)に回答を2対1比較または完全な順序で評価させます。
  4. この順序結果を選好回答と非選好回答の組み合わせに変換します。
  5. 不可能な判断、事実根拠不足、意見が衝突するサンプルをレビューア(Reviewer)に処理させるために、アノテーション(Annotation)の整合性を抽查します。

同じ入力でA、B、C、Dの4つの回答が生成された場合、アノテーション結果がBがAより優れている、AがDより優れている、DがCより優れているとすると、複数の優先度対(Preference Pair)に変換できます。実際の構成では、全ての組み合わせを網羅する必要はなく、差異が小さい回答は安定したアノテーションが難しいため、差異が大きすぎる回答はモデルが低級な間違いを避けるだけに学ぶ可能性が高いため、より価値のあるデータは、分かりやすいが、重要な条件、事実境界、タスクの完了度に明確な差異がある回答から得られます。

優先度アノテーションはいくつかの表面的要因に影響されがちです。長い回答はより充実しているように見える、口語表現が自信に満ちている回答はより信頼できるように見える、上位の候補はより選択されやすいなど。これらの偏りを低減するため、候補の順序をランダムに調整し、モデル名を隠し、アノテータに事実、タスクの完了度、スタイル、安全性を別々にチェックさせ、一部のサンプルでは複数のアノテータで再アノテーションを行います。もし同じデータセット内でアノテータが頻繁に意見が反対する場合は、評価基準が明確でないことを示している可能性が高く、単に少数の意見を削除するだけではありません。

報酬モデル(Reward Model)はどのように回答にスコアを与えるのか?

優先度データは「同じプロンプト(Prompt)の下でどの回答がより良いか」をchosenとrejectedの間の相対関係として表現しています。報酬モデル(Reward Model, RM)の役割は、これらの優先度データを使って自動評価関数(Automated Scoring Function)を学習し、人工的な比較結果を強化学習アルゴリズムが利用できる報酬信号に変換することです。一般的な報酬モデルは言語モデル(Language Model)をベースに、最後にスコアを出力する評価層(Scoring Head)を追加します。訓練時、プロンプトと回答を連結したシーケンスをモデルに入力し、隠れ状態(Hidden State)を得た後、評価層からスコアを出力します。

報酬モデルは、2つの回答がそれぞれ何点得るべきかを知る必要はなく、chosenのスコアがrejectedのスコアより高いという相対的な関係を学習するだけで十分です。したがって、訓練時は通常プロンプトと2つの候補回答をそれぞれ連結して報酬モデルに入力します:

プロンプト + 選好回答   → rchosen
プロンプト + 非選好回答 → rrejected

ここで、rchosenとrrejectedは報酬モデルが出力する2つのスカラー(Scalar)スコアです。訓練目標は選好回答のスコアが非選好回答のスコアより高いことを最大化することです。一般的な成对ソート損失(Pairwise Ranking Loss)は以下のように書けます:

\mathcal{L} = -\log \sigma\left(r_{\text{chosen}} - r_{\text{rejected}}\right)

ここで、r_chosenとr_rejectedは報酬モデルが選好回答と非選好回答に対して出力したスコア、σはスコア差を0から1の間にマッピングする関数です。選好回答のスコアが高く、非選好回答のスコアが低いほど損失は小さくなります。大量の優先度対訓練を通じて、報酬モデルは未知の回答に対しても相対評価を行うことができます。

報酬モデルは言語モデルをベースに、出力スカラー(Scalar)スコアを出力する評価層を追加します。入力はプロンプトと回答テキストですが、出力は次のトークンではなく、相対的な質量を示す報酬スコアです。このスコアには統一された物理的意味はなく、直接的に「正解率」や「満点10点中の何点」を意味することはできません。より重要なのは同じ報酬モデル下で、異なる回答のスコアの高い順です。例えば、ある回答が6点、もう一方が4点得た場合、前者が現在の報酬モデルではより優先度基準に合致していることを示すだけで、客観的な意味では「6点質量」であるわけではありません。

報酬モデルが学習できる内容は、構成した優先度データに大きく依存します。優先度データのアノテータが常により長い回答を選好する場合、報酬モデルは長さを質量と誤って学習する可能性があります。アノテータが言語の流暢性を過度に重視する場合、誤った政策を根拠に正しい回答に高いスコアを与える可能性もあります。したがって、報酬モデルは本当に正しい回答を理解するわけではなく、優先度データ中に示された評価パターンを模倣しているだけです。これがなぜ報酬モデルの訓練が完了した後、訓練損失だけでなく、評価も必要な理由です。

報酬モデルが直接言語モデルを修正しないため、後続のPPO(Proximal Policy Optimization)、GRPO(Group Relative Policy Optimization)などの強化学習段階では、言語モデルが新しい回答を継続的に生成し、報酬モデルがそれらを評価し、強化学習アルゴリズムが報酬結果に基づいてモデルパラメータを更新し、モデルが高報酬回答の生成確率を徐々に向上させるようにします。注意すべき点は、戦略モデル(Strategy Model)が表面のパターンが安定した高スコアを得られることを発見すると、これらのパターンを繰り返し利用してしまうことがあり、実際のタスク能力を向上させるのではなく、この現象を「報酬投機(Reward Hacking)」と呼びます。したがって、報酬モデルは訓練データ中の優劣回答を区別できるだけでなく、単純な長さ、固定表現、フォーマットテンプレートなどの表面特徴を「騙す」ことなく、学習する必要があります。

RLHF(Reinforcement Learning from Human Feedback)、人間のフィードバックはどのように訓練に参加するか?

RLHF(Reinforcement Learning from Human Feedback)は「人間からのフィードバックに基づく強化学習(Reinforcement Learning from Human Feedback)」と通常呼ばれます。これは人間のフィードバックが強化学習訓練にどのように組み込まれるかを表す訓練フレームワークであり、具体的な最適化アルゴリズムや固定されたモデル構造ではありません。

古典的なRLHFは通常3つの段階で構成されます:

  1. 人間のデモンストレーションデータを収集し、SFT(Supervised Fine-Tuning)によって指示に従う初期戦略モデル(Initial Strategy Model)を得ます。
  2. 同一プロンプト(Prompt)に対する複数の回答を人間に並べ替えさせ、これらの優先度データを使って報酬モデル(Reward Model)を訓練します。
  3. 策略モデル(Strategy Model)が新しい回答を生成し、報酬モデルがスコアを計算し、PPO(Proximal Policy Optimization)などの強化学習アルゴリズムを使ってモデルパラメータを更新します。

古典的なRLHFの道は3つの連続した段階で示されます。第1段階ではアノテータが示範回答を記述し、これらのデータでSFTを実行します。第2段階ではモデルが同じプロンプトに対して複数の回答を生成し、アノテータが並べ替え、比較データで報酬モデルを訓練します。第3段階では戦略モデルが新しい回答を生成し、報酬モデルがスコアを計算し、PPOを用いてモデルを更新します。これらのデータは異なる役割を担います:示範データはモデルに「どう回答するか」を教え、比較データは報酬モデルに「どう評価するか」を教え、プロンプトと報酬信号は強化学習に使われます。

このプロセスを強化学習の概念に置き換えると、言語モデルは戦略モデル(Strategy Model)、プロンプトと既に生成されたトークンが現在の状態(Current State)、モデルが次のトークンを選択するのはアクション(Action)であり、回答の開始から終了マーカーまでが1回の完全な軌跡(Trajectory)を構成します。

RLHFにおける報酬モデルは通常回答の終わりで1つの総合スコアを与えます。強化学習アルゴリズムはそれを用いてどのトークンの選択の確率を向上させるべきか判断します。RLHFの訓練では、参考モデル(Reference Model)を残すことも多いです。参考モデルは一般的に凍結されたSFTモデルであり、訓練中の戦略モデルが既存の言語能力から大きく外れるのを防ぐために使われます。

PPO(Proximal Policy Optimization)、報酬に基づいてモデルを調整する

近端戦略最適化(Proximal Policy Optimization, PPO)は戦略勾配(Policy Gradient)アルゴリズムの一種で、報酬を向上させつつ、各パラメータ更新の幅を制限することを目的とします。大規模モデルには多くのパラメータがあり、一つだけ回答が高スコアを得ただけで大幅に戦略を変更すると、モデルは少数の報酬パターンに早く偏り、既存の言語能力を破壊する可能性があります。PPOの「近端(Proximal)」は、新戦略が旧戦略の近くで更新されることを強調します。大規模モデルの後トレーニングでは、1回のPPOは通常2つの段階を含みます。第1段階はサンプリング(Sampling)で、プロンプトデータセットから入力を抽出し、現在の戦略モデルが回答を生成し、旧戦略下での各トークンの確率を保存し、報酬モデルがスコアを与えます。第2段階は更新(Update)で、報酬と価値推定(Value Estimation)から利得(Advantage)を計算し、これらのサンプルを使って戦略モデルと価値モデル(Value Model)を更新します。いくつかの小規模なバッチ(Mini-batch)の更新が完了した後、新しい戦略で再生成を行います。

PPOは新戦略と旧戦略が同じトークンに対して与える確率を比較します。確率比(Probability Ratio)は以下のように簡略化できます:


r_t(\theta)
=
\frac{\text{新戦略が現在のトークンを選択する確率}}
{\text{旧戦略が現在のトークンを選択する確率}}

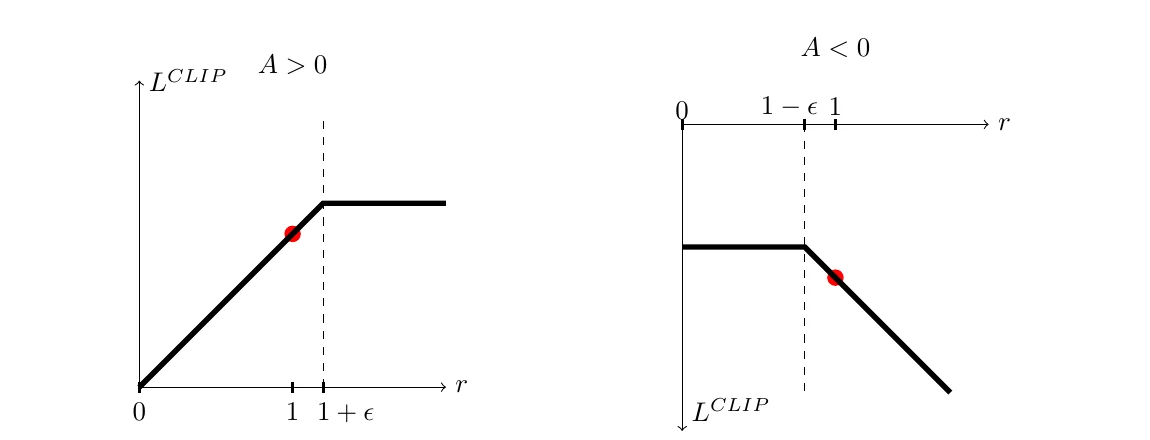
ここで、rₜは計算される得点(Score)、θは最適化するモデルパラメータです。rₜが1に近い場合は、新旧戦略の差が小さいことを示します。rₜが明らかに1より大きい場合は、新戦略が現在のトークンを選好する傾向を示します。rₜが明らかに1より小さい場合は、新戦略がその確率を低くしています。確率の変化はまだ十分ではありませんが、利得(Advantage)Aₜがこのトークンの選択が平均的には良いか悪いかを判断する必要があります。利得が正のときは、その選択の確率を適切に向上させ、負のときは低下させます。

正文配图

上図の左側は利得が正の状況を示します。確率比が1から右に増加するにつれて、目標は上昇します。1+εを超えると曲線は平坦になり、そのトークンの確率をさらに高めることで目標は改善しなくなります。右側は利得が負の状況を示します。確率比が1-ε以下に下がると、目標も同様に改善を停止します。両曲線は、PPOが戦略を正しい方向に調整し、過大な更新による追加的な利益を弱めることを示しています。

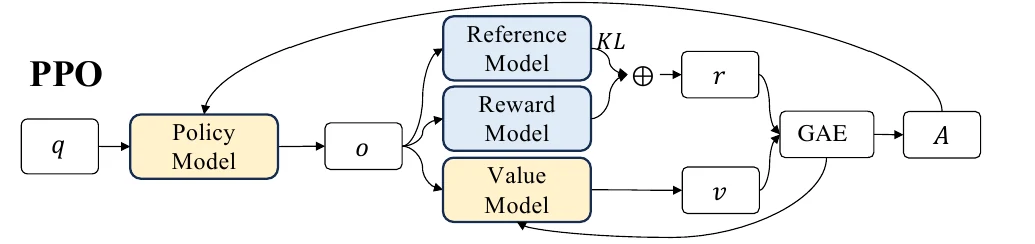
典型的な大規模モデルのPPO訓練では、いくつかのコンポーネントを同時に維持する必要があります:戦略モデルは生成し、更新を受け入れます。旧戦略はサンプリング時の戦略パラメータのスナップショット(Snapshot)であり、確率比を計算するために使われます。参考モデル(Reference Model)は凍結されたSFTモデルであり、KL制約(KL Constraint)を計算するために使われます。報酬モデルは回答を評価し、価値モデル(Value Model)は生成位置ごとに後続で得られる収益(Return)を推定します。価値モデルの推定と実際の報酬との間には差があるため、PPOはGAE(Generalized Advantage Estimation)などの方法を使ってこれらの差を各トークンの利得(Advantage)に整理します。PPOの全体プロセスは以下の図のように示されます。戦略モデルは入力qから回答oを生成し、報酬モデルと参考モデルが共に報酬rを形成し、価値モデルが価値推定vを出力し、GAEで利得Aを計算します。戦略モデルは利得とカットオフ(Clipping)目標に基づいて更新され、価値モデルは価値損失(Value Loss)でより正確な収益推定を学習します。

正文配图

GRPO(Group Relative Policy Optimization)、同じ問題を何度も回答して、スコアを比較する

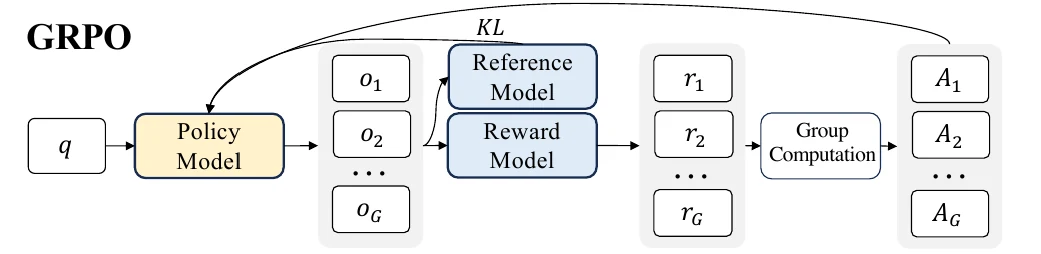
グループ相対戦略最適化(Group Relative Policy Optimization, GRPO)はPPOの変種で、戦略サンプリング(Strategy Sampling)、確率比カットオフ(Probability Ratio Clipping)、KL制約(KL Constraint)などの考え方を維持し、主な変更点は価値モデル(Value Model)を単独で訓練しないことです。代わりに、同じプロンプト(Prompt)下の複数の回答の相対的なスコアを用いて利得(Advantage)を推定します。GRPOの全体フレームワークは以下の図のように示されます。同じ入力qに対し、戦略モデルは一括で回答o₁からoGを生成し、報酬モデルやルールシステム(Rule System)がそれぞれr₁からrGを出力します。

正文配图

システムはまずこのグループの報酬の平均値と標準偏差を計算し、各回答のスコアをグループ内の相対利得(Relative Advantage)に変換します。得