Data: The Foundation of Fine-Tuning
Dados: A Base do Fine-Tuning de Modelos Open Source
Você já encontrou um modelo que escreve código e resolve matemática perfeitamente, mas responde aleatoriamente a perguntas do dia a dia?
Sabemos que para melhorar uma capacidade específica durante o treinamento, é preciso encontrar esse tipo de dados,
Mas muitos conjuntos de dados são difíceis de encontrar por busca direta. Um portal unificado economiza muito esforço.
Por exemplo, nosso conjunto de dados destilado DeepSeek-R1 em chinês obteve grande parte dos dados brutos diretamente do ModelScope,
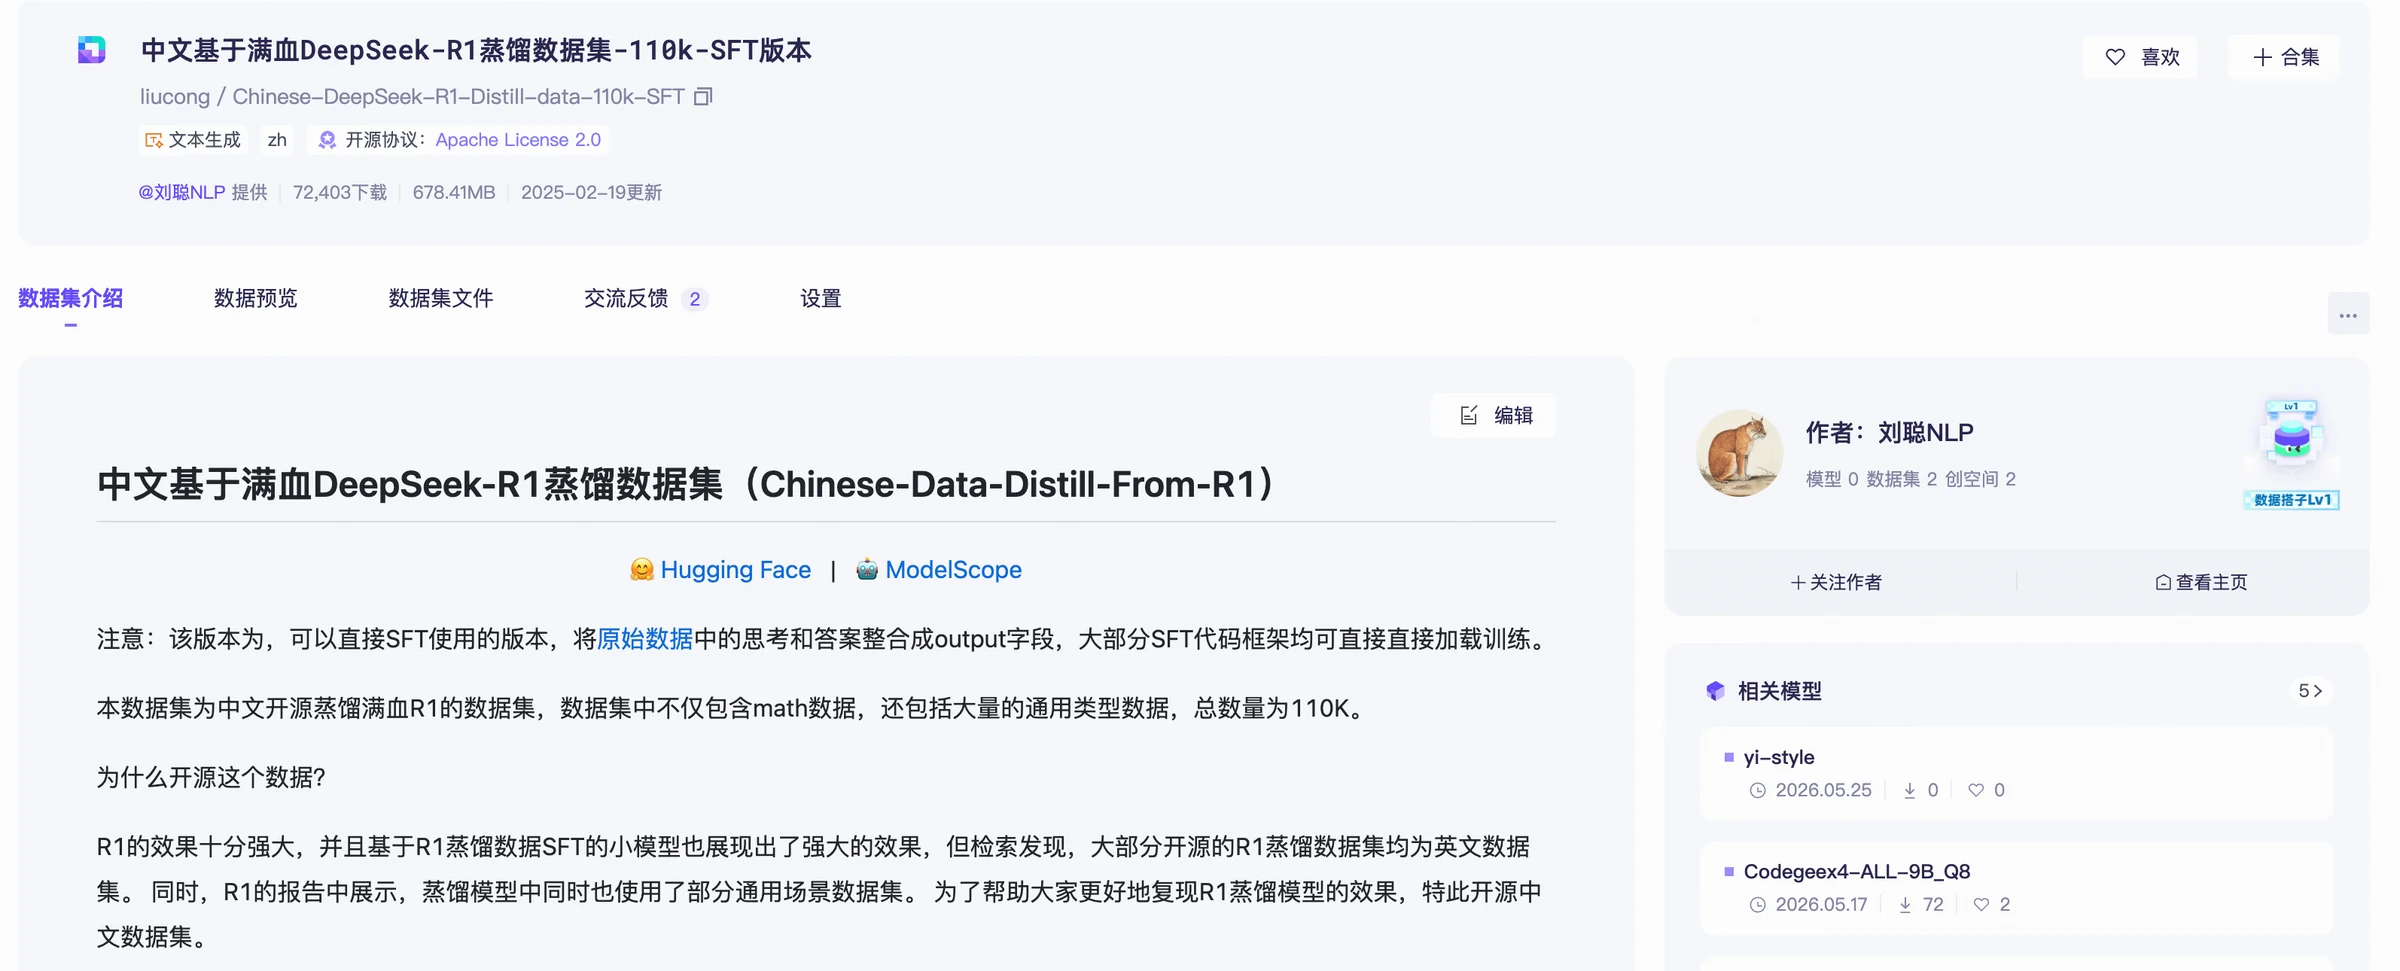
O fine-tuning do nosso modelo pode começar a partir de um conjunto de dados open source pronto, o que permite percorrer todo o fluxo rapidamente.
Encontrar Dados Requer Saber o Que Você Planeja Fazer
ModelScope tem mais de 40.000 conjuntos de dados open source, com pesquisa, visualização, descrições de campos e versões.
ModelScope permite pesquisa por palavras-chave e categorias de tarefas, como classificação binária de texto em chinês,
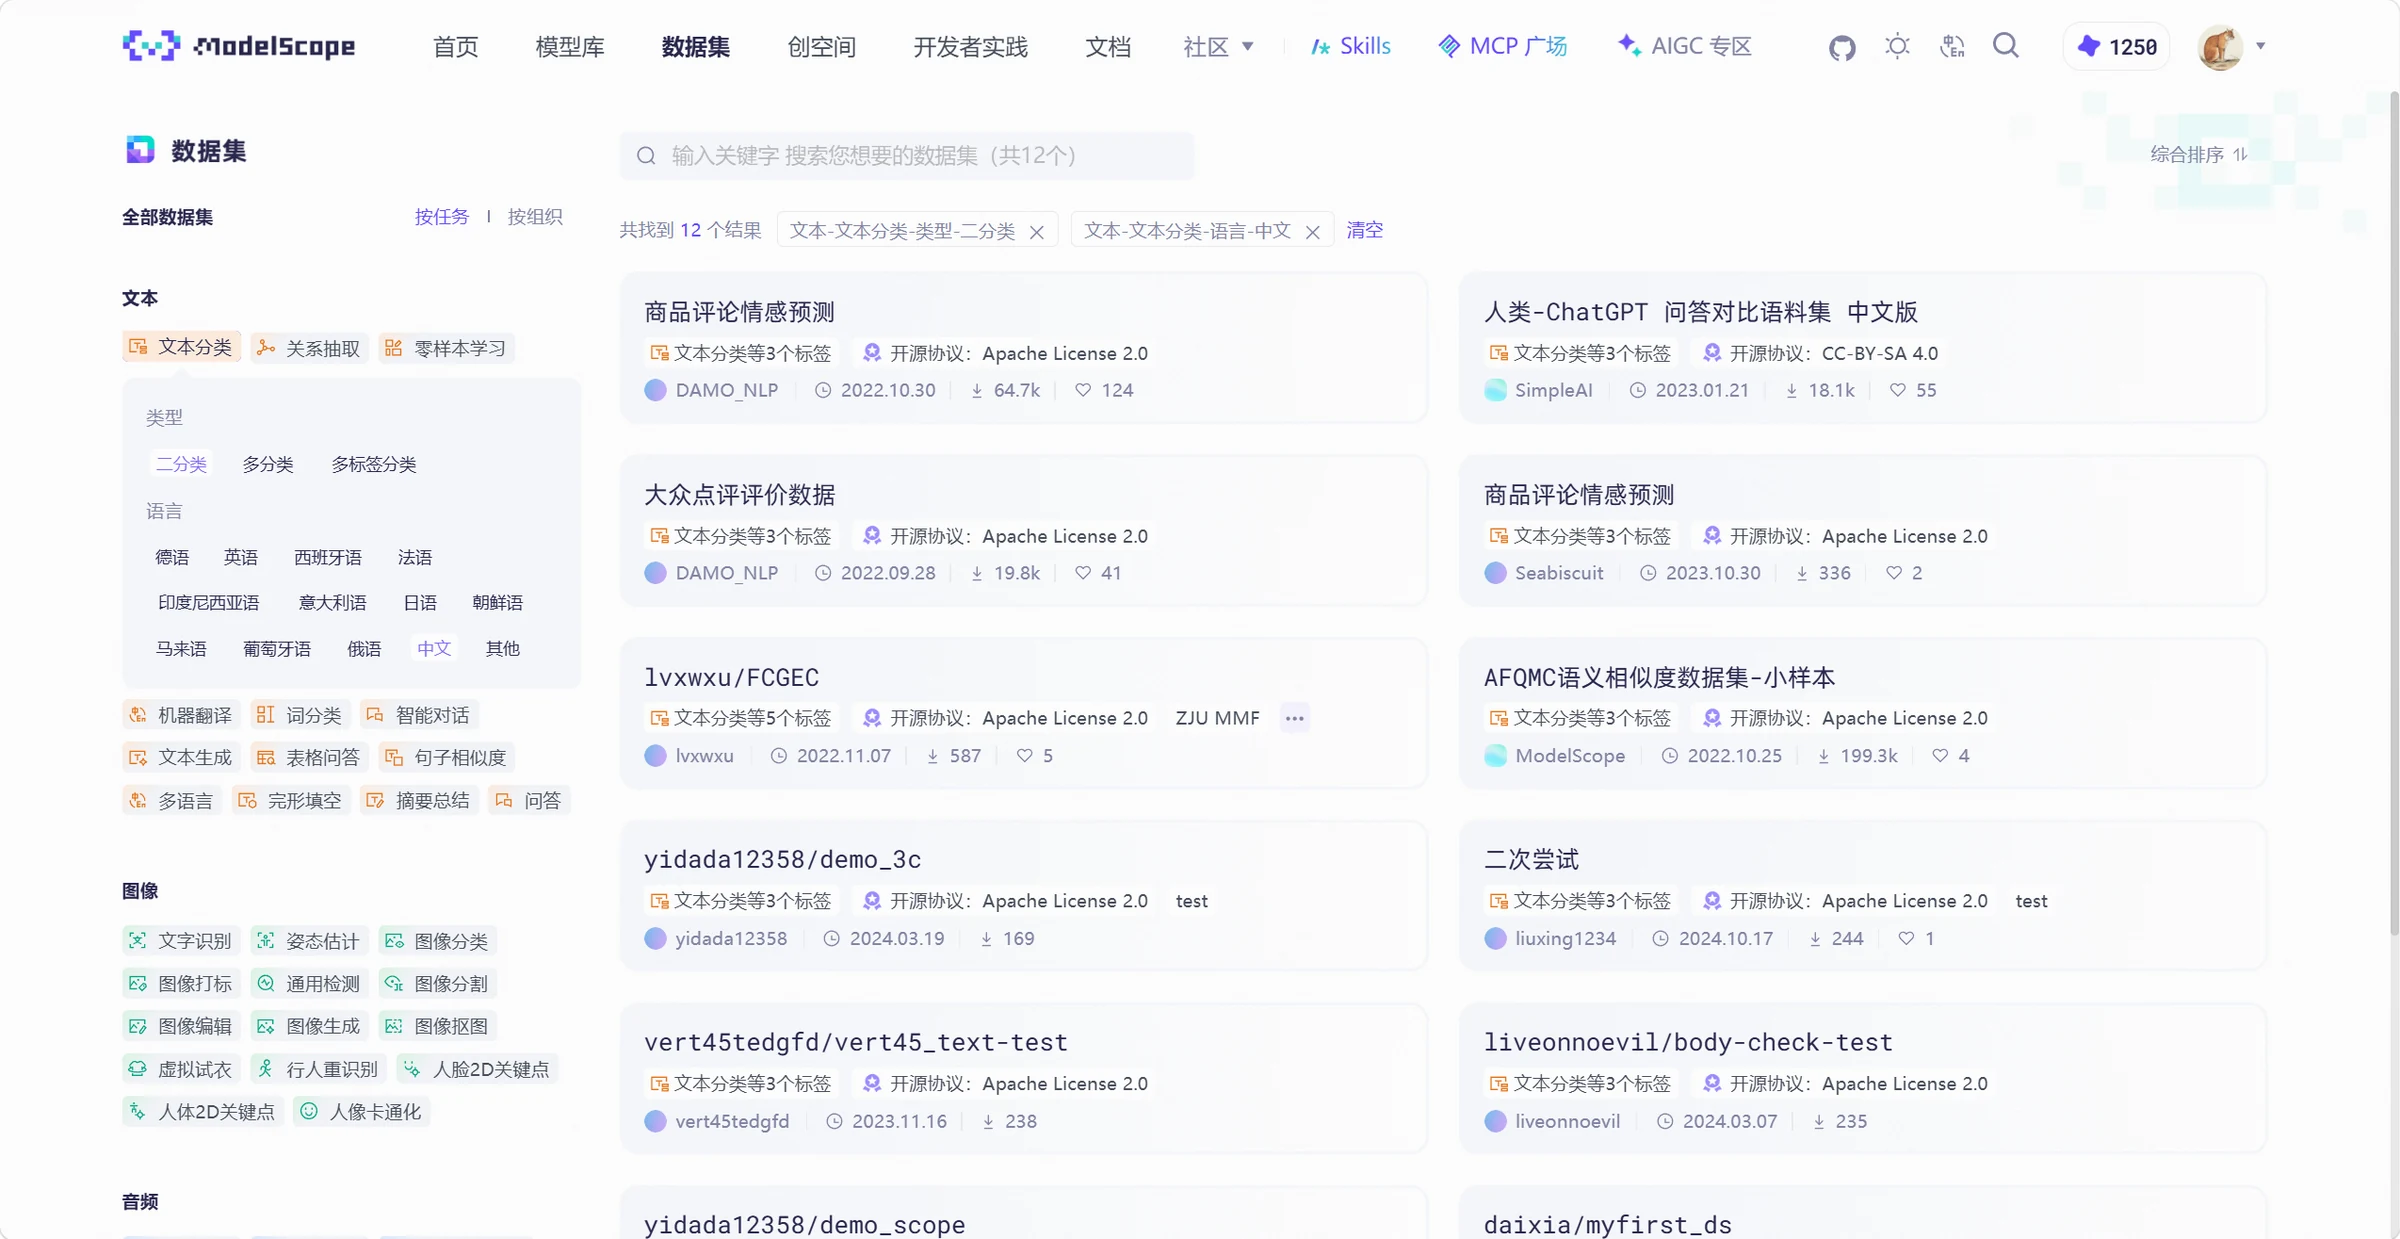
Antes de Baixar, Confira Algumas Amostras
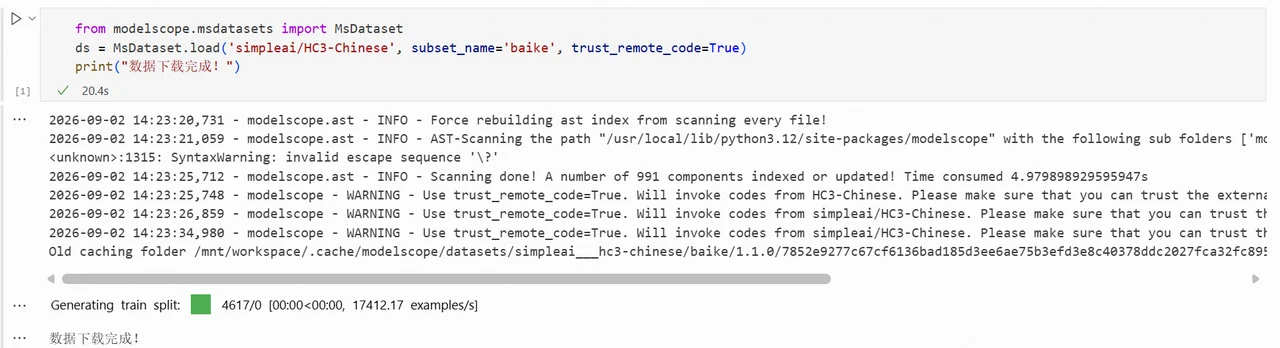
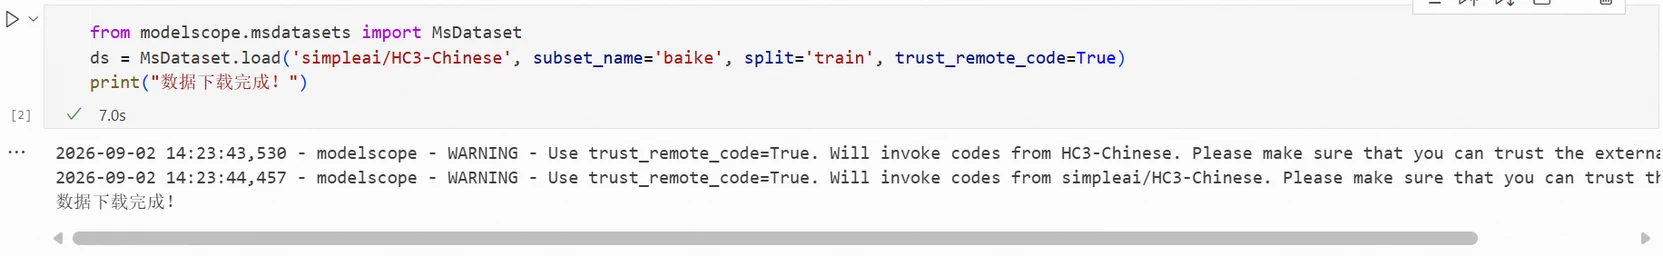
Após filtrar, selecione um conjunto de dados e clique em 'Visualização' para ver amostras e descrições, como simpleai/HC3-Chinese.
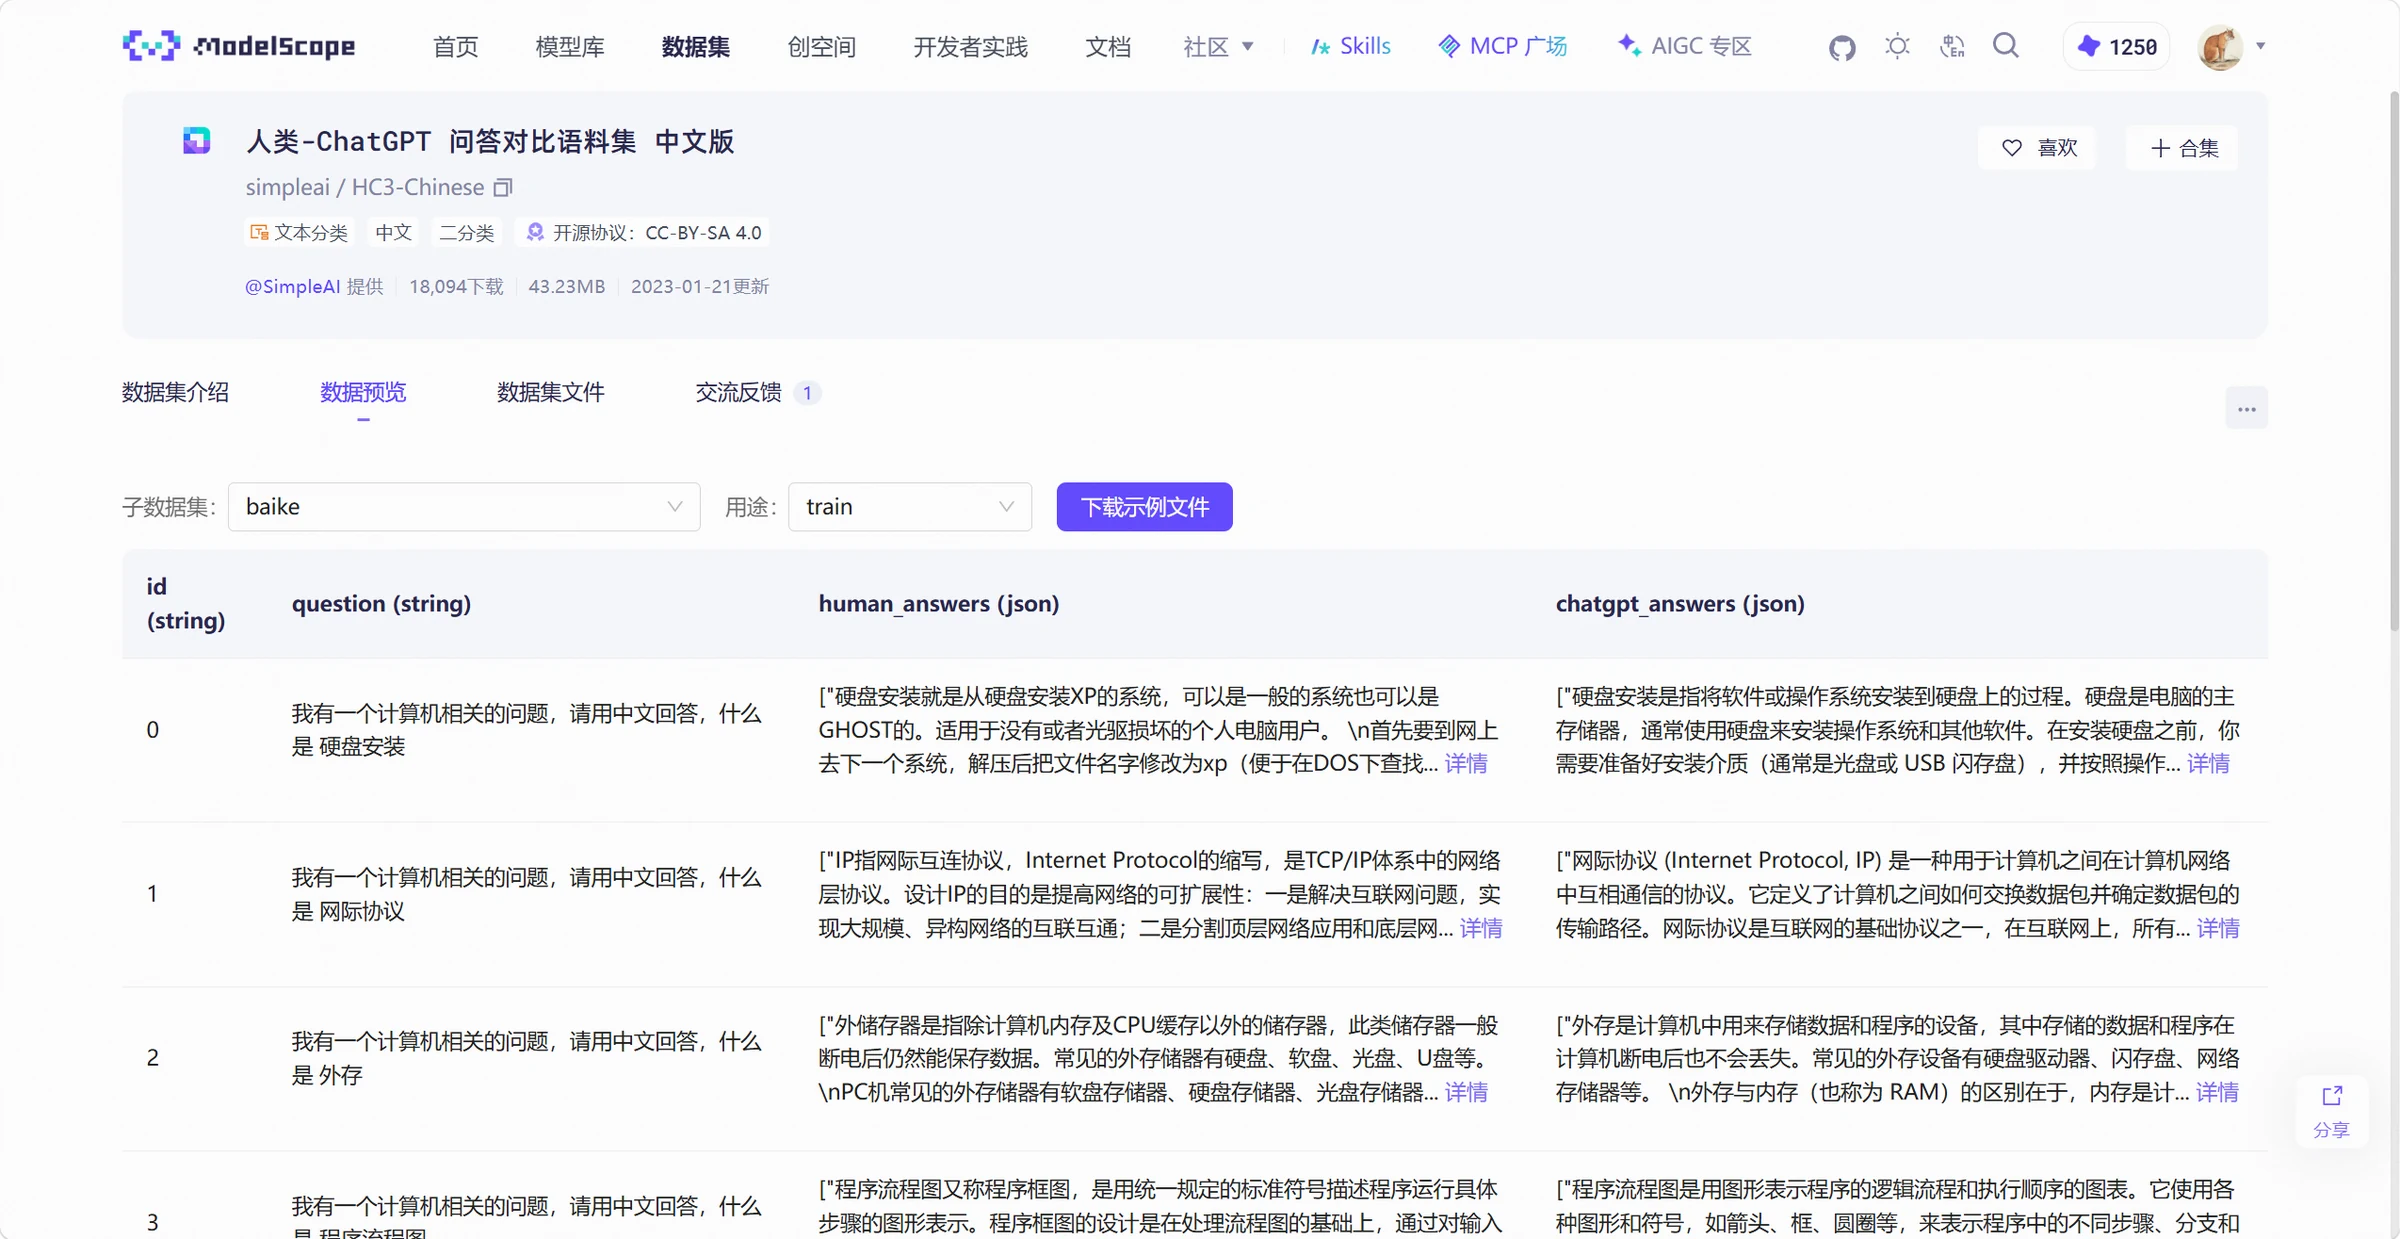
Qual coluna contém a pergunta, resposta, rótulos, e se cada registro é texto ou diálogo — tudo pode ser verificado antecipadamente.
Para dados QA, respostas humanas e do modelo podem estar em campos diferentes. Decida quais campos ler e como organizar antes de treinar.
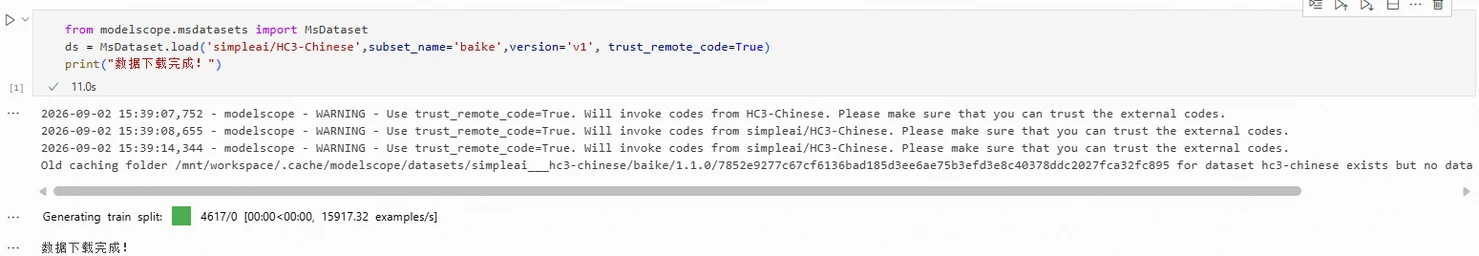
Verifique arquivos e versões. Conjuntos são atualizados; anote a versão usada para reprodutibilidade.
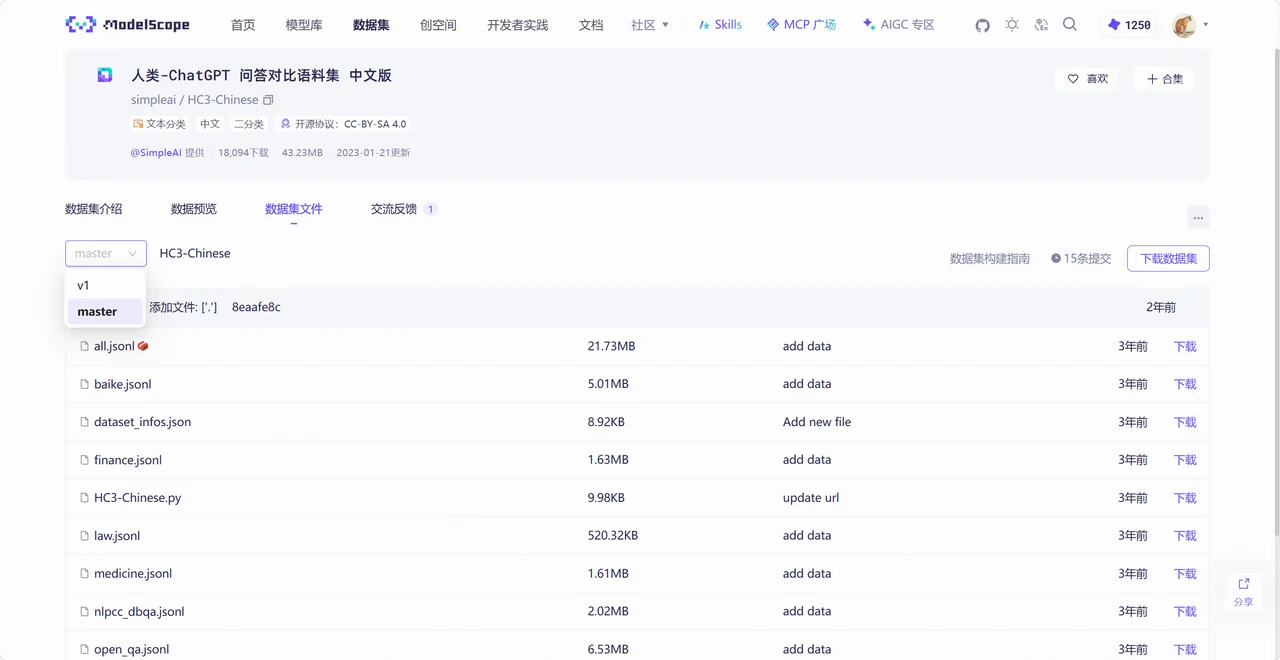
Descrições e licenças valem a pena conferir. Dados baixados podem ter requisitos diferentes para pesquisa, treinamento ou uso comercial.
Carregue os Dados Primeiro, Depois Decida O Que Usar
ModelScope fornece a interface MsDataset.load para carregar conjuntos de dados em Python. Após instalar, siga as instruções da página.
Carregue um Conjunto Completo Primeiro
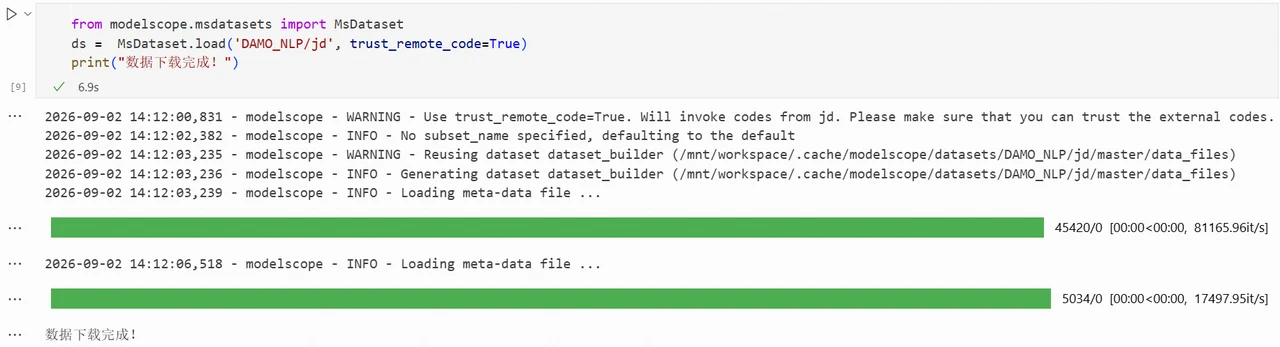
Usando DAMO_NLP/jd como exemplo, assim leia a configuração padrão,
from modelscope.msdatasets import MsDataset

ds = MsDataset.load(
    'DAMO_NLP/jd',
    trust_remote_code=True,
)
print(ds)
Discussão
Entrar participar da discussão