Fine-tuning e avaliação • Iniciante⏱️ 25 min de leitura
Fine-Tuning with ms-swift
Uso rápido do ms-swift para fine-tuning de modelos de código aberto
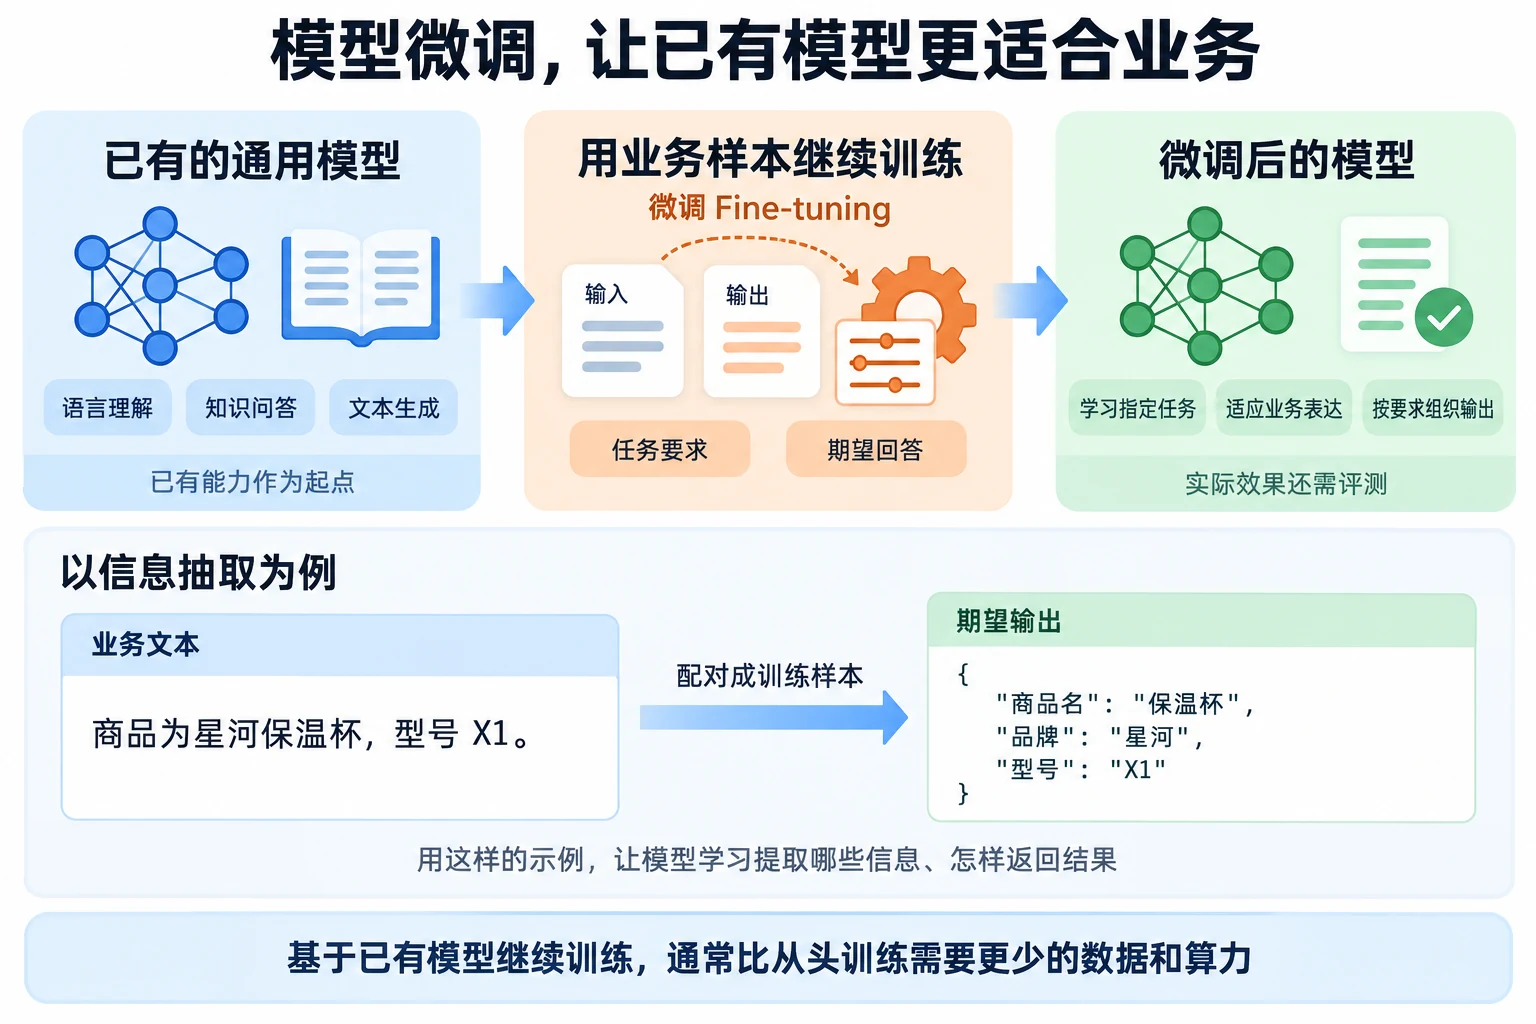
Quando um modelo geral não consegue atender diretamente a necessidades de negócios específicas, você pode usar seus próprios dados de negócios para fazer fine-tuning do modelo, permitindo que ele aprenda mais sobre tarefas e métodos de saída específicos.
Pegue o reconhecimento de entidades de e-commerce como exemplo. Precisamos que o modelo identifique nomes de produtos, marcas e modelos no texto, fornecendo a categoria e a posição correspondentes. O modelo pode ser muito knowledgeable sobre esses produtos, mas no uso real, as informações extraídas não podem estar incompletas, os campos devem ser padronizados e o formato de saída deve ser estável.
Se a tarefa e os requisitos de saída já estão claros e você tem exemplos organizados, você pode tentar usar esses dados para fine-tuning, permitindo que o modelo aprenda o trabalho que queremos que ele faça. Quanto a atualizar todos os parámetros e se as GPU disponíveis são suficientes, você precisa escolher com base na tarefa e nos recursos.
Abaixo, usamos ms-swift para percorrer um processo de fine-tuning LoRA, cobrindo preparação de dados, treinamento, fusão de pesos e inferência.
O que o fine-tuning realmente muda no modelo?
Os grandes modelos de linguagem gerais já possuem fortes capacidades de compreensão de linguagem, perguntas e respostas, geração de texto e outras tarefas gerais. No entanto, em cenários de negócios reais, o desempenho de modelos gerais pode não atender diretamente a requisitos específicos.
Por exemplo, queremos que o modelo complete com precisão certas tarefas de extração de informações, produza resultados em um formato especificado ou responda a perguntas específicas de maneira unificada. Para essas necessidades, podemos usar dados específicos para treinar sobre a base de um modelo existente, permitindo que o modelo aprenda mais sobre os requisitos de tarefas e métodos de resposta correspondentes. Esse processo é chamado de fine-tuning de modelo.
Fine-tuning não é retreinar um modelo do zero, mas um ajuste adicional sobre a base de suas capacidades existentes, tornando-o mais adequado para cenários de aplicação específicos. Comparado a treinar um grande modelo do zero, o fine-tuning geralmente requer menos dados e recursos de computação.
Atualmente, o método mais comum no fine-tuning de grandes modelos é o SFT (Supervised Fine-Tuning). O SFT usa dados com respostas padrão para treinar o modelo. Cada entrada de treinamento geralmente contém uma entrada e sua saída correspondente, permitindo que o modelo aprenda que tipo de resultados gerar dada uma entrada. Por exemplo, em tarefas de extração de informações, você pode usar um segmento de texto como entrada e os resultados corretos de extração de campos como saída. O SFT é adequado para tarefas para as quais amostras de treinamento claras podem ser preparadas, como classificação de texto, extração de informações, perguntas e respostas e geração de formato fixo.
Além do SFT, o treinamento de grandes modelos também pode usar Aprendizado por Reforço (Reinforcement Learning, RL). Ao contrário do SFT que fornece diretamente respostas padrão, o aprendizado por reforço usa principalmente sinais de recompensa para avaliar a qualidade dos resultados gerados pelo modelo e ajusta continuamente o comportamento de saída do modelo com base nos resultados de recompensa. Tanto o SFT quanto o aprendizado por reforço pertencem à fase de pós-treinamento dos grandes modelos. Pós-treinamento refere-se a uma série de treinamentos conduzidos após o modelo completar o pré-treinamento em larga escala, visando melhorar ainda mais o seguimento de instruções, raciocínio e capacidades de tarefas específicas. O treinamento de grandes modelos geralmente primeiro usa o SFT para aprender como completar tarefas de acordo com as instruções, depois combina o aprendizado por reforço e outros métodos para otimizar ainda mais a qualidade das respostas e o desempenho comportamental do modelo.
Parâmetros completos, LoRA e QLoRA — qual é a diferença?
Dependendo do método de treinamento e dos recursos de hardware, você pode escolher entre LoRA, QLoRA ou fine-tuning de parâmetros completos. Os diferentes métodos apresentam certas diferenças no número de parâmetros de treinamento, uso de memória GPU e custos de computação.
Fine-Tuning de Parâmetros Completos: Durante o treinamento, todos os parâmetros do modelo são atualizados, permitindo que o modelo faça ajustes mais completos. O fine-tuning de parâmetros completos requer significativamente mais memória GPU e recursos de computação, resultando em custos de treinamento mais altos.
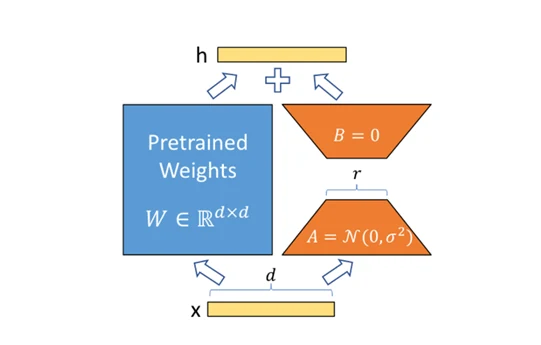
Fine-Tuning LoRA (Low-Rank Adaptation): Para reduzir os requisitos de recursos de hardware para o fine-tuning de grandes modelos, a ideia central do LoRA é congelar os pesos do modelo pré-treinado e injetar matrizes de decomposição de rank treináveis em cada camada da arquitetura Transformer, reduzindo assim significativamente o número de parâmetros treináveis para tarefas downstream. Durante o treinamento, apenas os parâmetros do modelo original precisam ser congelados, e as matrizes de redução A e aumento B são treinadas. Um diagrama esquemático do LoRA é mostrado abaixo.
Especificamente, assumindo que a matriz pré-treinada é $W_0 \in \mathbb{R}^{d \times k}$, sua atualização pode ser expressa como:
W = W_0 + \Delta W = W_0 + BA
Onde $\Delta W$ representa as mudanças de peso que precisam ser aprendidas durante o fine-tuning:
B \in \mathbb{R}^{d \times r}, \quad
A \in \mathbb{R}^{r \times k}, \quad
r \ll \min(d,k)
A e B são novos parâmetros adicionados pelo LoRA que participam do treinamento. Após o treinamento do modelo, você obtém um arquivo LoRA Adapter separado que salva os parâmetros deste fine-tuning. Ao usá-lo, você precisa carregar tanto o modelo base quanto o Adapter correspondente.
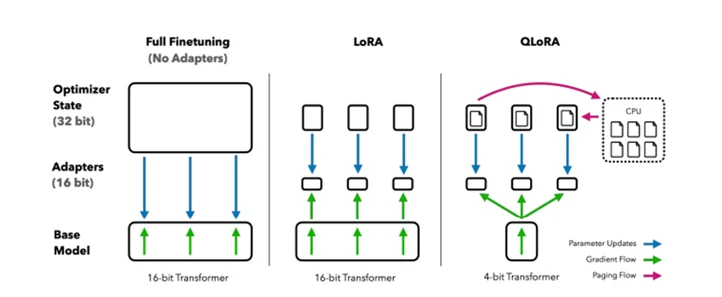
Fine-Tuning QLoRA (Quantized LoRA): O LoRA reduz principalmente a sobrecarga de recursos dos parâmetros de treinamento, mas o modelo base em si ainda precisa ser carregado na memória GPU. Se o modelo for grande, carregar o modelo base ainda pode consumir muita memória GPU. Para reduzir ainda mais os requisitos de memória GPU, você pode usar o fine-tuning QLoRA.
A arquitetura do modelo relacionado é mostrada abaixo. Como pode ser visto, o QLoRA é uma melhoria do LoRA, e a principal melhoria é usar precisão de 4 bits e otimização paginada juntos para reduzir o consumo de memória GPU.
QLoRA pode ser simplesmente entendido como uma combinação de quantização e LoRA. Ele quantiza o modelo base com precisão menor. As principais inovações do QLoRA incluem:
NormalFloat de 4 bits (NF4): NF4 é um novo tipo de dados que é teoricamente ótimo para pesos distribuídos normalmente;
Quantização Dupla: A quantização dupla reduz o uso médio de memória por requantizar constantes já quantificadas;
Otimizadores Paginados: Os otimizadores paginados ajudam a gerenciar picos de memória e prevenir erros de memória insuficiente durante o checkpointing de gradiente.
Como escolher um método de fine-tuning: comece pela tarefa e GPU
A escolha do método de fine-tuning requer principalmente considerar a escala do modelo, os requisitos da tarefa, os recursos GPU e os custos de treinamento. Os diferentes métodos têm seus próprios cenários aplicáveis — não é necessariamente verdade que atualizar mais parâmetros do modelo leva a melhores resultados de fine-tuning. Para a maioria das tarefas de fine-tuning, você pode tentar LoRA primeiro. LoRA requer treinar apenas um pequeno número de novos parâmetros, tem requisitos relativamente baixos de memória GPU e recursos de computação, e os arquivos Adapter resultantes também são relativamente pequenos, facilitando o salvamento.
Se o modelo base for grande, mesmo usando LoRA pode não sobrar memória GPU suficiente para o treinamento após carregar o modelo. Nesse caso, você pode considerar o QLoRA. O QLoRA reduz o uso de memória GPU do modelo base por meio de quantização, permitindo que modelos maiores sejam fine-tuned com recursos GPU limitados. QLoRA é mais adequado para cenários com grandes escalas de modelos e recursos GPU limitados.
Se os recursos GPU são relativamente suficientes e a tarefa requer ajustes mais completos do modelo, você pode considerar o fine-tuning de parâmetros completos. Como todos os parâmetros do modelo precisam ser atualizados durante o treinamento, o fine-tuning de parâmetros completos tem requisitos mais altos de memória GPU, recursos de computação e dados de treinamento, e o custo de treinamento e salvamento de modelos também é maior. Você precisa determinar se é necessário com base na tarefa real.
Em projetos reais, podemos primeiro verificar o efeito a um custo mais baixo, depois escolher se aumentar os custos de treinamento com base nas necessidades reais. Se o LoRA já pode alcançar os resultados esperados, geralmente não é necessário escolher o fine-tuning de parâmetros completos apenas para atualizar mais parâmetros.
Usar ms-swift para completar um fine-tuning
Que trabalho o ms-swift pode nos poupar?
ms-swift (SWIFT, Scalable lightWeight Infrastructure for Fine-Tuning) é um framework de treinamento e implantação de modelos grandes de código aberto da comunidade ModelScope. Ele se destina principalmente a grandes modelos de linguagem e grandes modelos multimodais, fornecendo um conjunto completo de ferramentas desde treinamento e fine-tuning de modelos até inferência, avaliação e implantação.
Atualmente, ele suporta grandes modelos de linguagem como Qwen, DeepSeek, Llama, GLM e InternLM, bem como modelos multimodais como Qwen-VL e InternVL. Também suporta treinamento para tarefas como Embedding, Reranker e classificação de texto.
Você pode encontrar mais métodos de uso no ms-swift.
Além do treinamento, o ms-swift também fornece um fluxo de trabalho de uso de modelo relativamente completo. Após o treinamento, você pode usar diretamente swift infer para inferência do modelo, ou implantar o modelo como um serviço API compatível com OpenAI através de swift deploy. Para inferência e implantação, você também pode combinar motores de inferência como vLLM, SGLang e LMDeploy para aceleração.
Para iniciantes, uma das características do ms-swift é que ele encapsula muitas configurações complexas no processo de treinamento de grandes modelos. Você pode completar um fine-tuning de modelo especificando o modelo base, dados de treinamento, método de fine-tuning e parâmetros de treinamento através de argumentos de linha de comando. No experimento abaixo, usaremos o ms-swift para completar um fluxo de trabalho completo de fine-tuning de modelo, incluindo preparação de dados de treinamento, início do treinamento LoRA, visualização dos resultados do treinamento, fusão dos pesos LoRA e carregamento do modelo fine-tuned para inferência e implantação.
Treinamento prático com uma tarefa de reconhecimento de entidades
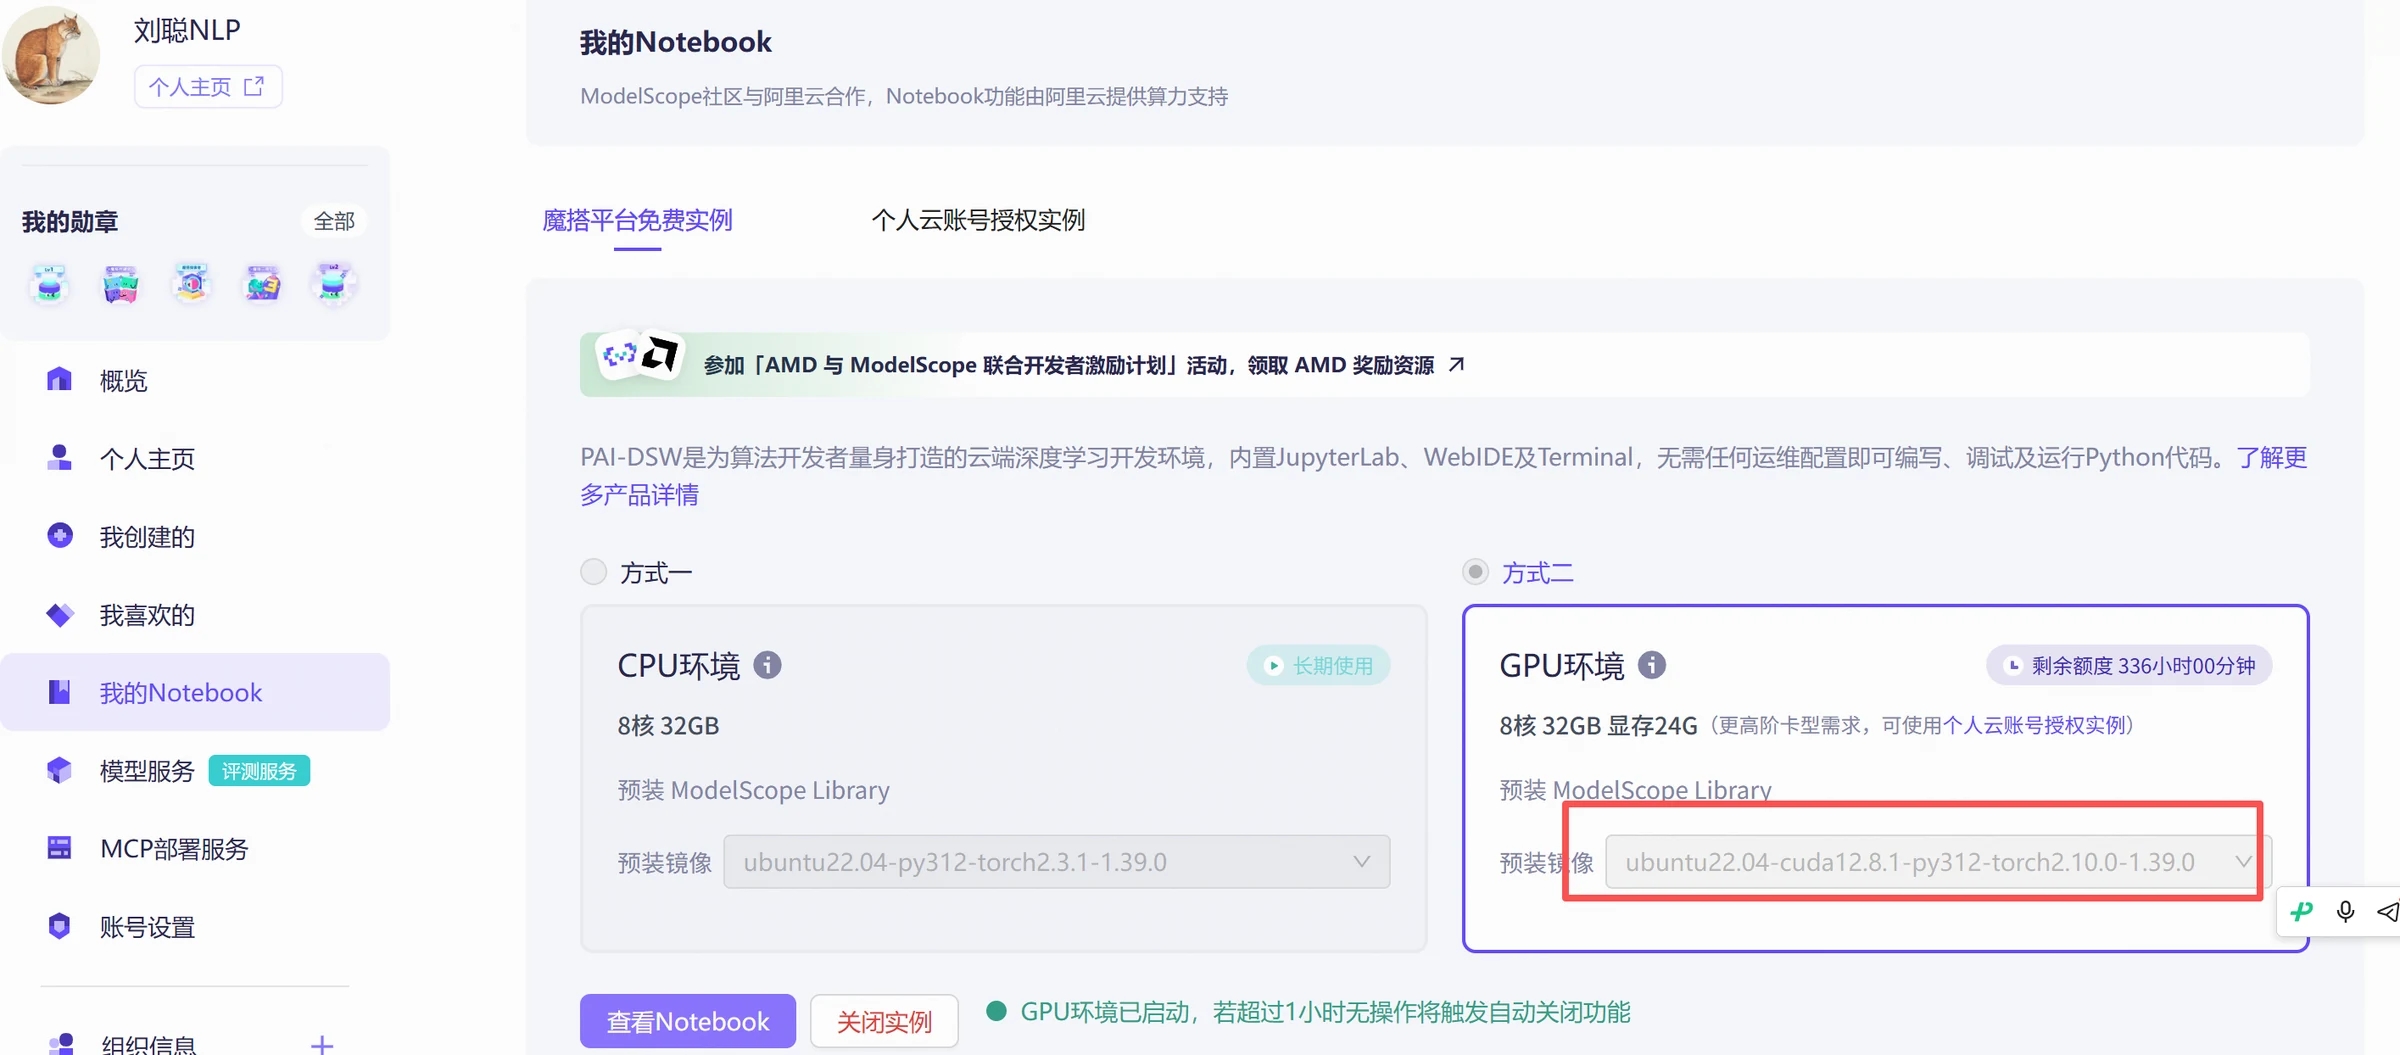
Abaixo, usamos uma tarefa de reconhecimento de entidades como exemplo para demonstrar o fluxo de trabalho completo de fine-tuning de modelo no ambiente ModelScope Notebook, incluindo preparação de dados, treinamento do modelo e inferência após o fine-tuning. Através deste exemplo, você pode aprender como usar o ms-swift para completar o fine-tuning de grandes modelos do zero. Este experimento continua usando a imagem ubuntu22.04-cuda12.8.1-py312-torch2.10.0-1.39.0 como ambiente de execução.
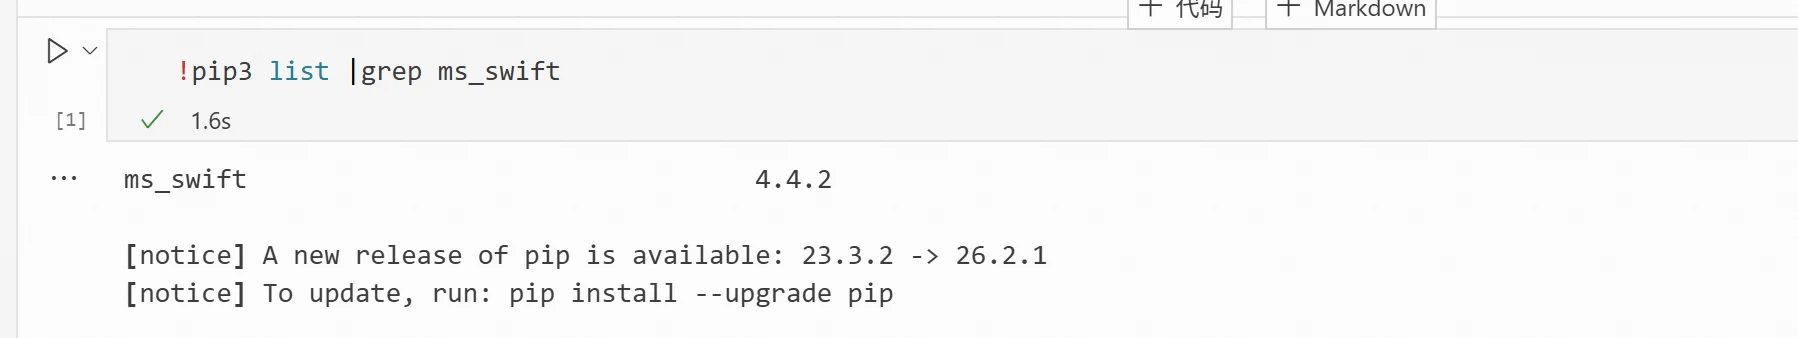
1) Verifique se o ms-swift já está instalado no ambiente. Observe que o nome do pacote é ms_swift.
!pip3 list |grep ms_swift
Se você vir uma saída no formato abaixo, o ms-swift já está instalado:
Se não estiver instalado, execute:
!pip3 install ms-swift
Preparação de dados. Este experimento usa dados de código aberto para reconhecimento de entidades de e-commerce. O conjunto de dados contém quatro tipos de entidade: HCCX (nome do produto), HPPX (nome da marca), XH (modelo do produto) e MISC (outras entidades incluindo país, tamanho/capacidade, pessoa, obra e nomes de atividades).
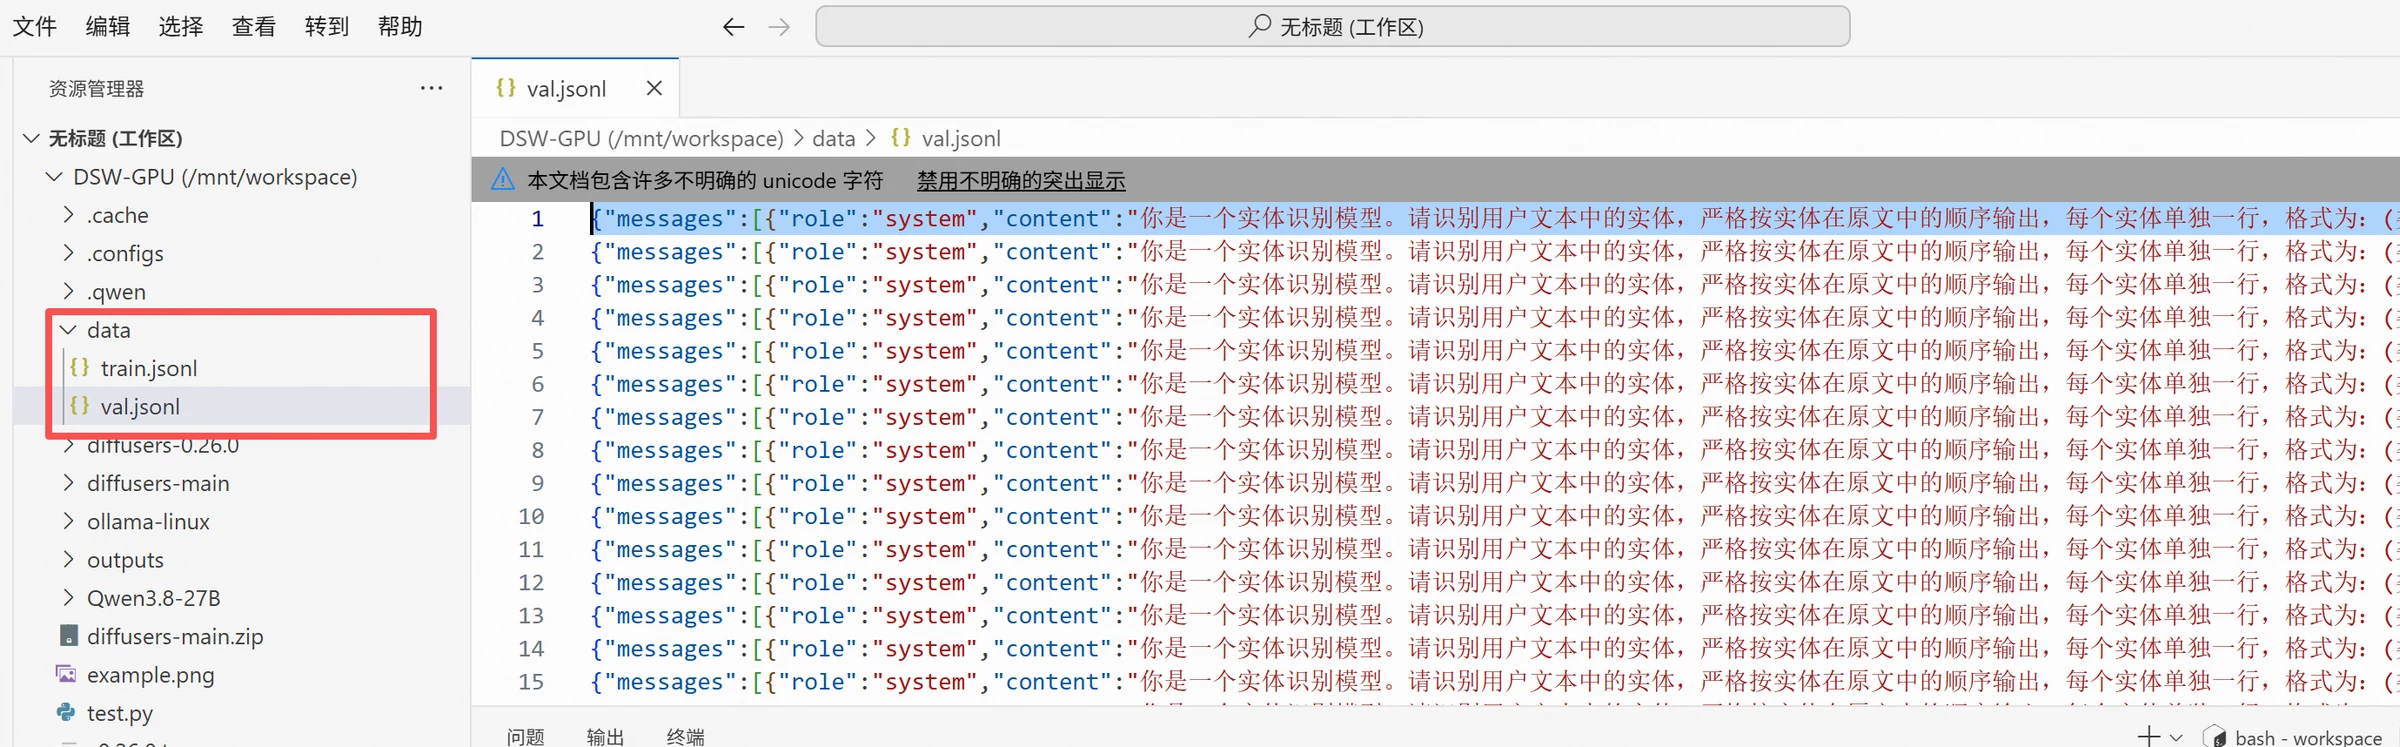
3) Primeiro crie um diretório chamado data, depois faça upload dos dados com botão direito para a pasta. O formato dos dados é o seguinte. Esta tarefa requer apenas que o modelo produza categorias de entidade, entidades e suas posições iniciais no texto. Os dados são divididos em conjuntos de treinamento e teste, com train.jsonl contendo 5.400 entradas e val.jsonl contendo 600 entradas.
{"messages":[{"role":"system","content":"Você é um modelo de reconhecimento de entidades. Por favor identifique as entidades no texto do usuário. Produza as entidades estritamente em sua ordem de aparição no texto original, cada entidade em uma linha separada no formato: (tipo, texto da entidade, posição inicial). A posição inicial começa em 0; o tipo pode ser apenas HCCX, HPPX, MISC ou XH. Quando não houver entidades, produza apenas: Sem entidades. Não produza explicações, Markdown ou outro conteúdo."},{"role":"user","content":"推bb护肤刮痧l背疗橄榄油全身按开背足体按油身m油5摩油摩精00"},{"role":"assistant","content":"(HCCX,óleo de oliva,10)\n(HCCX,óleo de massagem,20)\n(HCCX,óleo,24)\n(HCCX,óleo,27)"}]}
Estrutura do diretório:
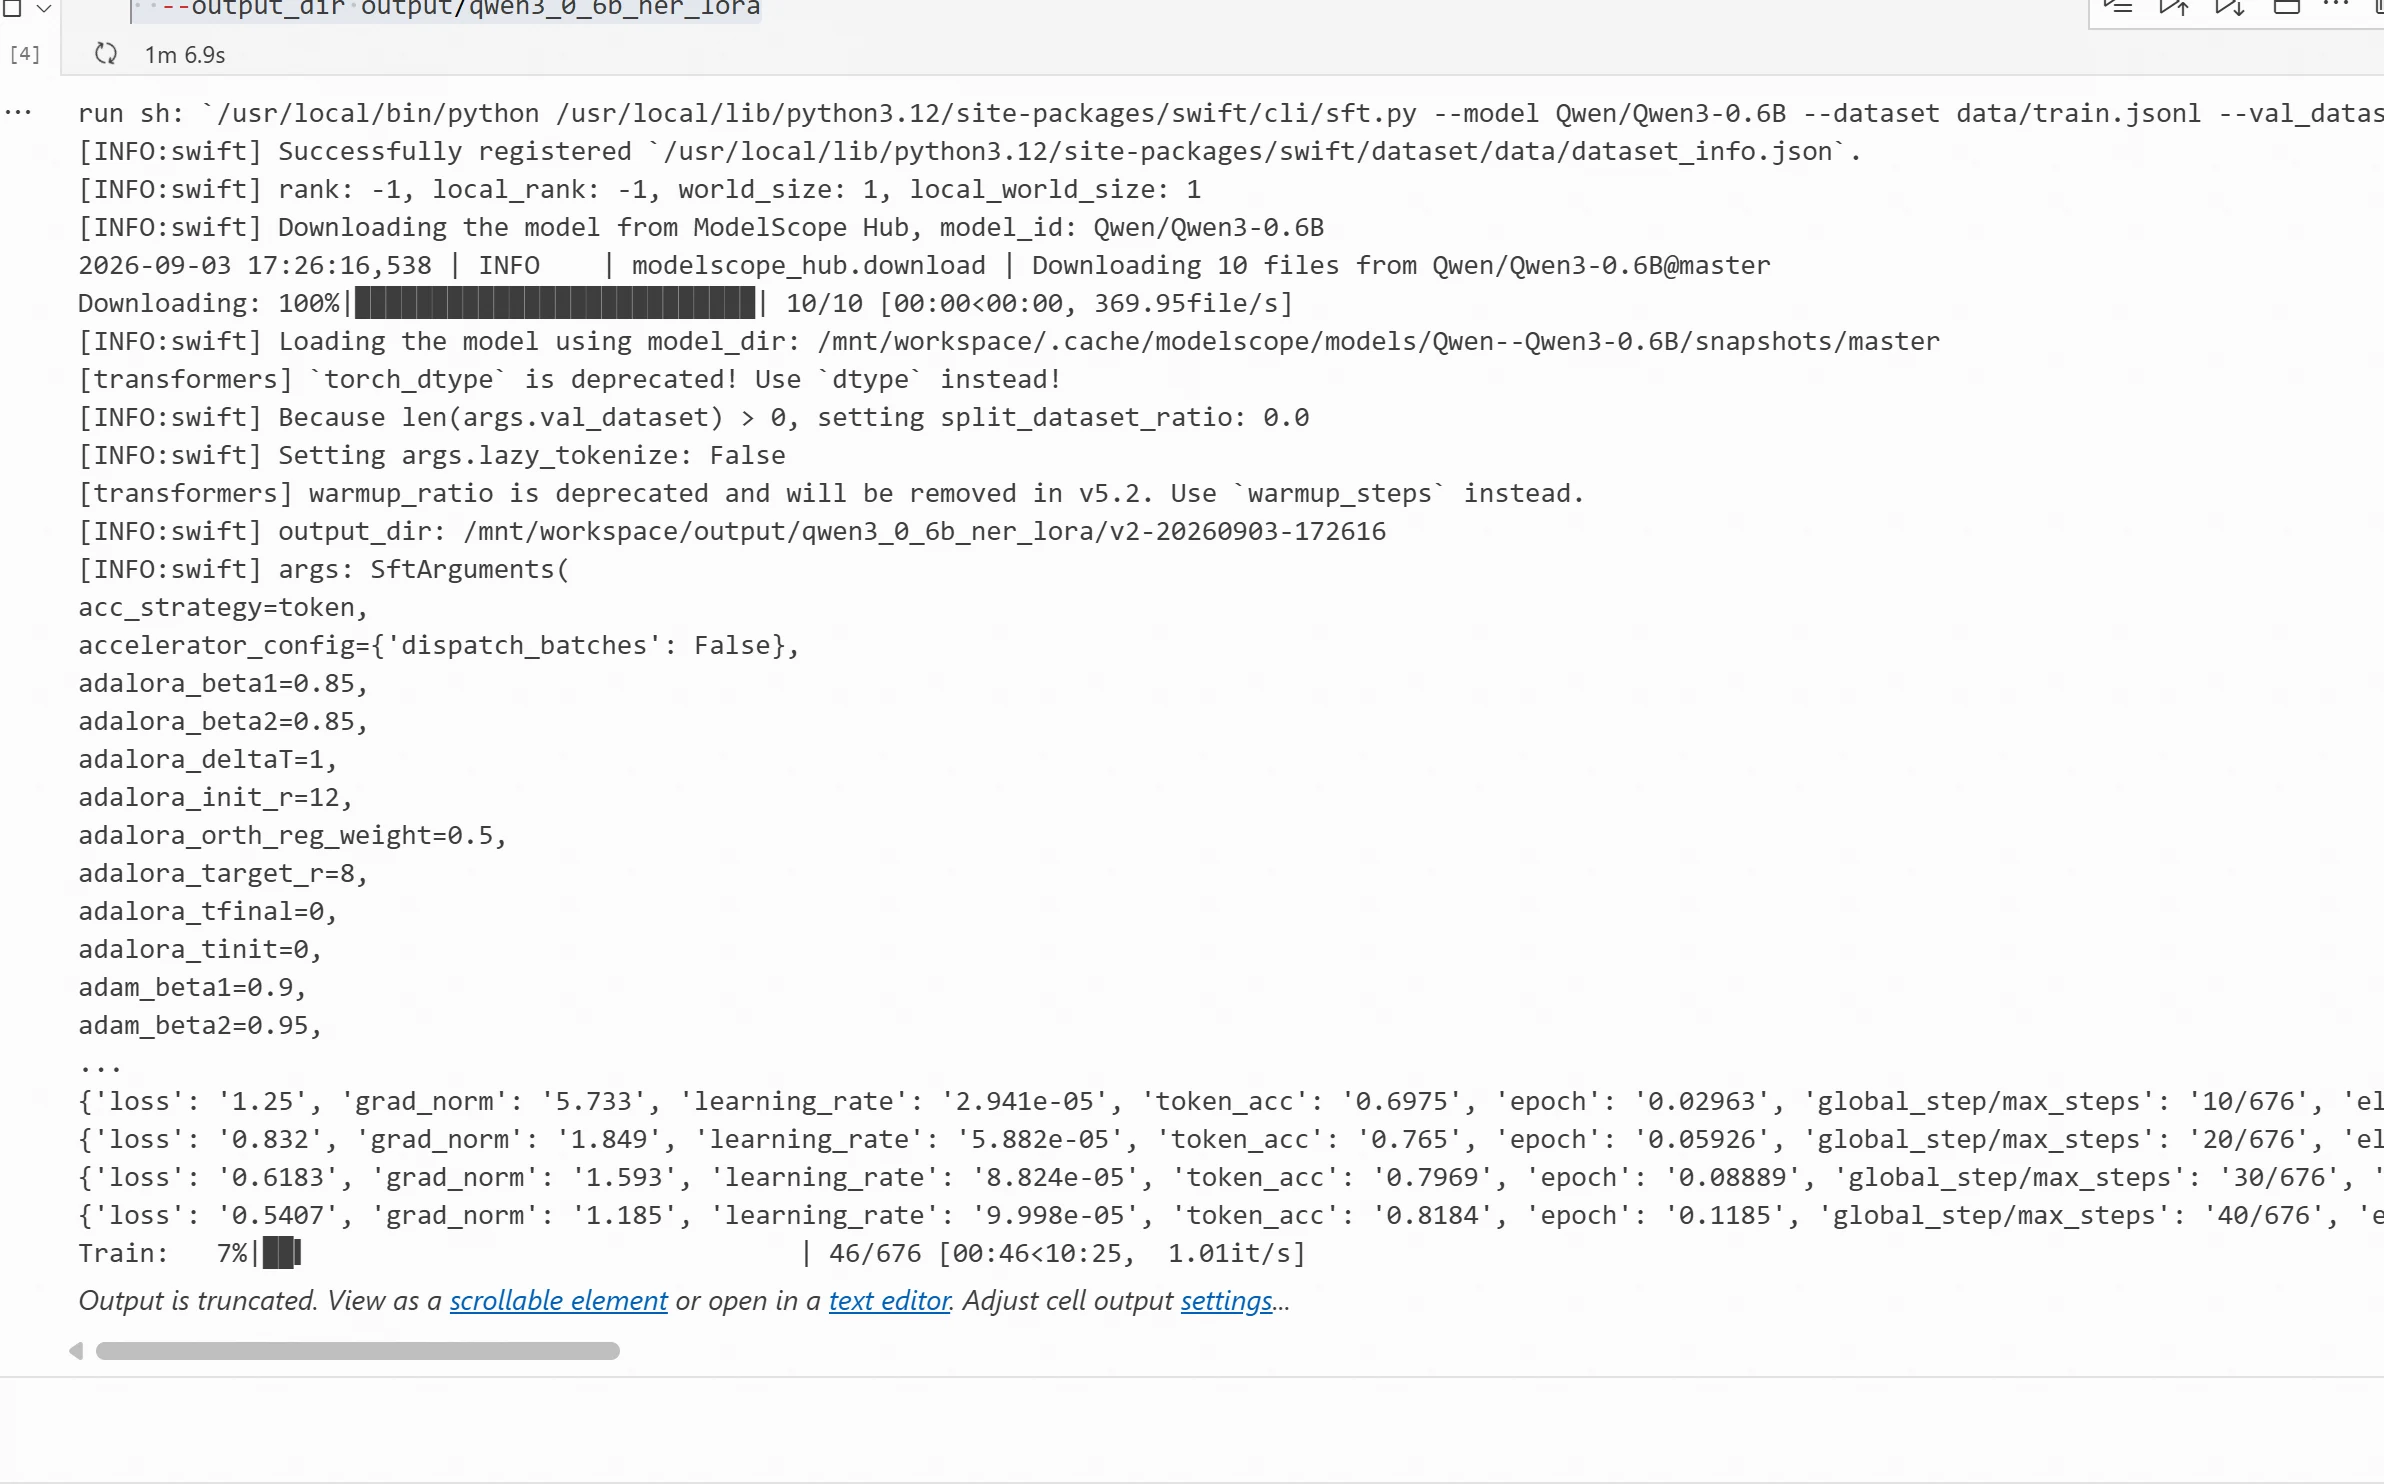
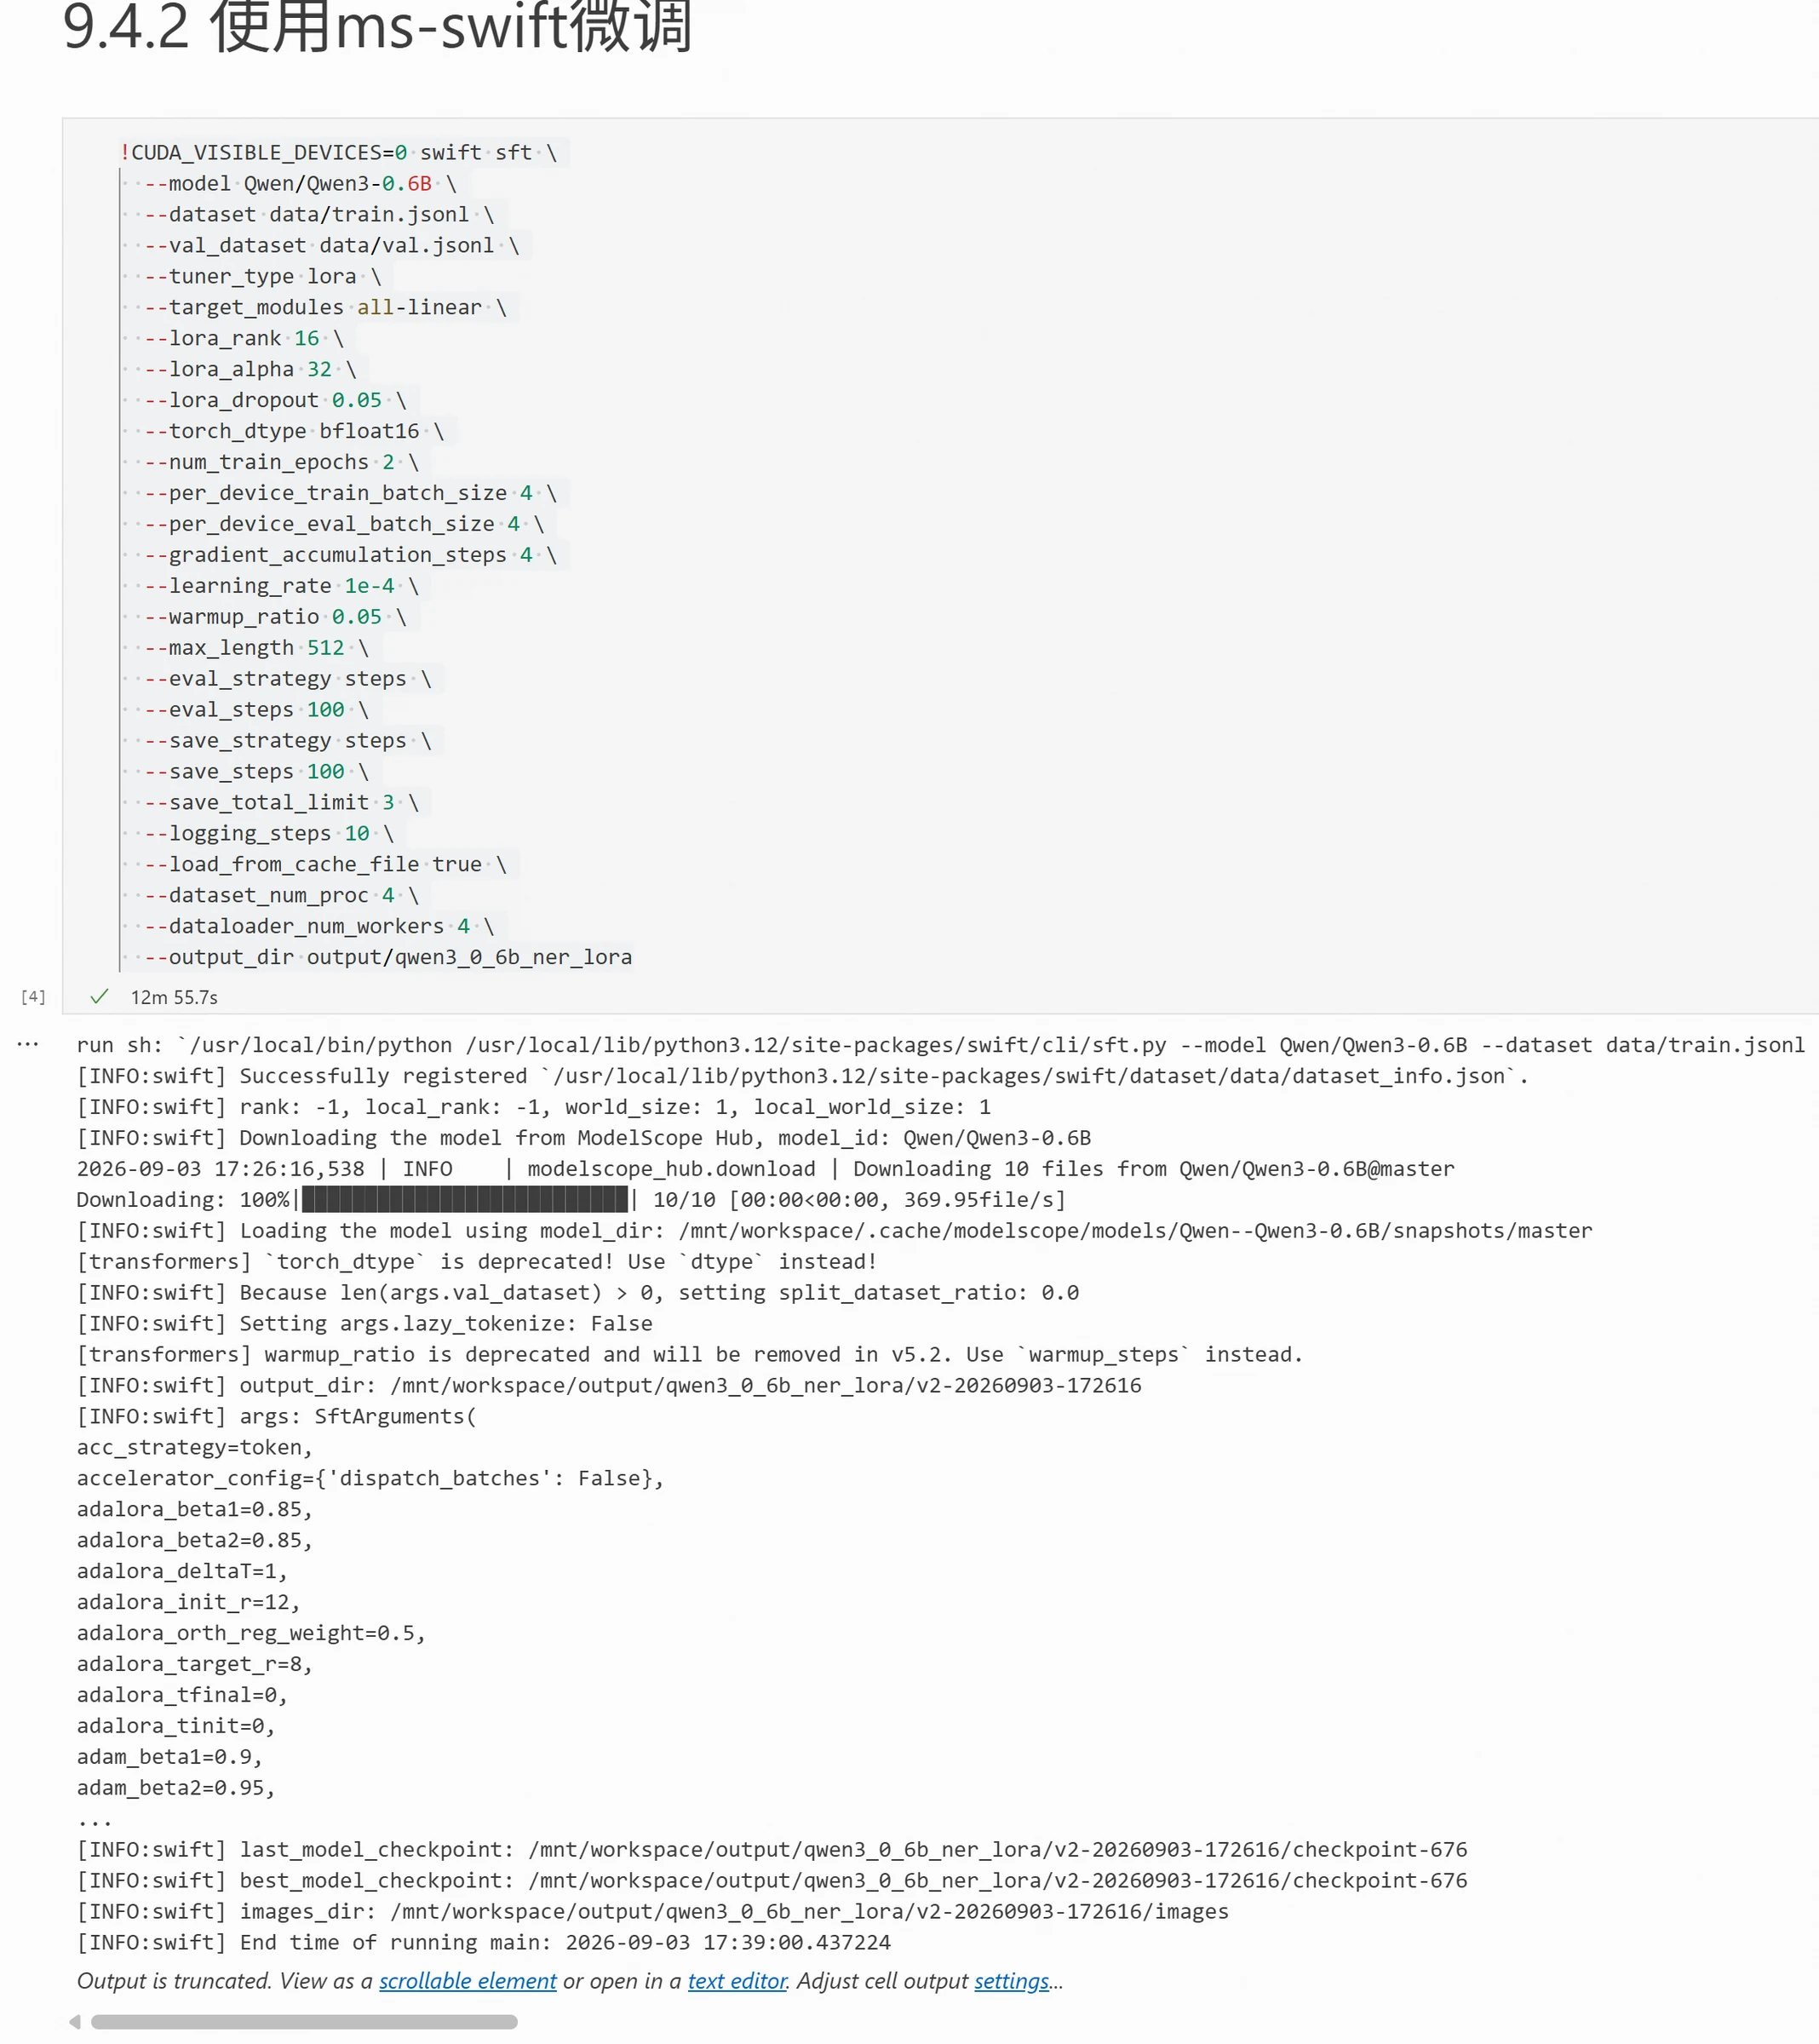
Treinamento do modelo. Esta seção usa Qwen/Qwen3-0.6B para fine-tuning. Digite o comando abaixo diretamente no terminal para iniciar o treinamento:
Após iniciar o treinamento, o ms-swift produzirá continuamente as informações atuais do treinamento conforme mostrado abaixo:
O treinamento terminou — como usamos o modelo?
Fusionar os pesos LoRA de volta ao modelo base
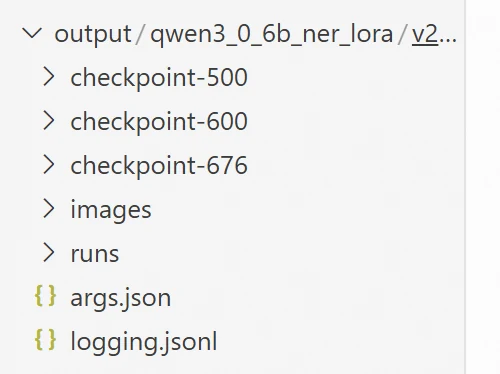
Após a conclusão do treinamento LoRA, o LoRA Adapter correspondente é salvo. O Adapter não é um modelo grande completo, portanto você ainda precisa carregar o modelo base original ao usá-lo. Através do output_dir no script de treinamento, você pode ver os checkpoints e arquivos Adapter correspondentes no diretório. Na implantação real, você pode fundir o LoRA Adapter no modelo base para gerar um modelo completo, o que é mais conveniente para implantação offline ou migração de modelos. A estrutura do diretório após o treinamento do modelo é a seguinte:
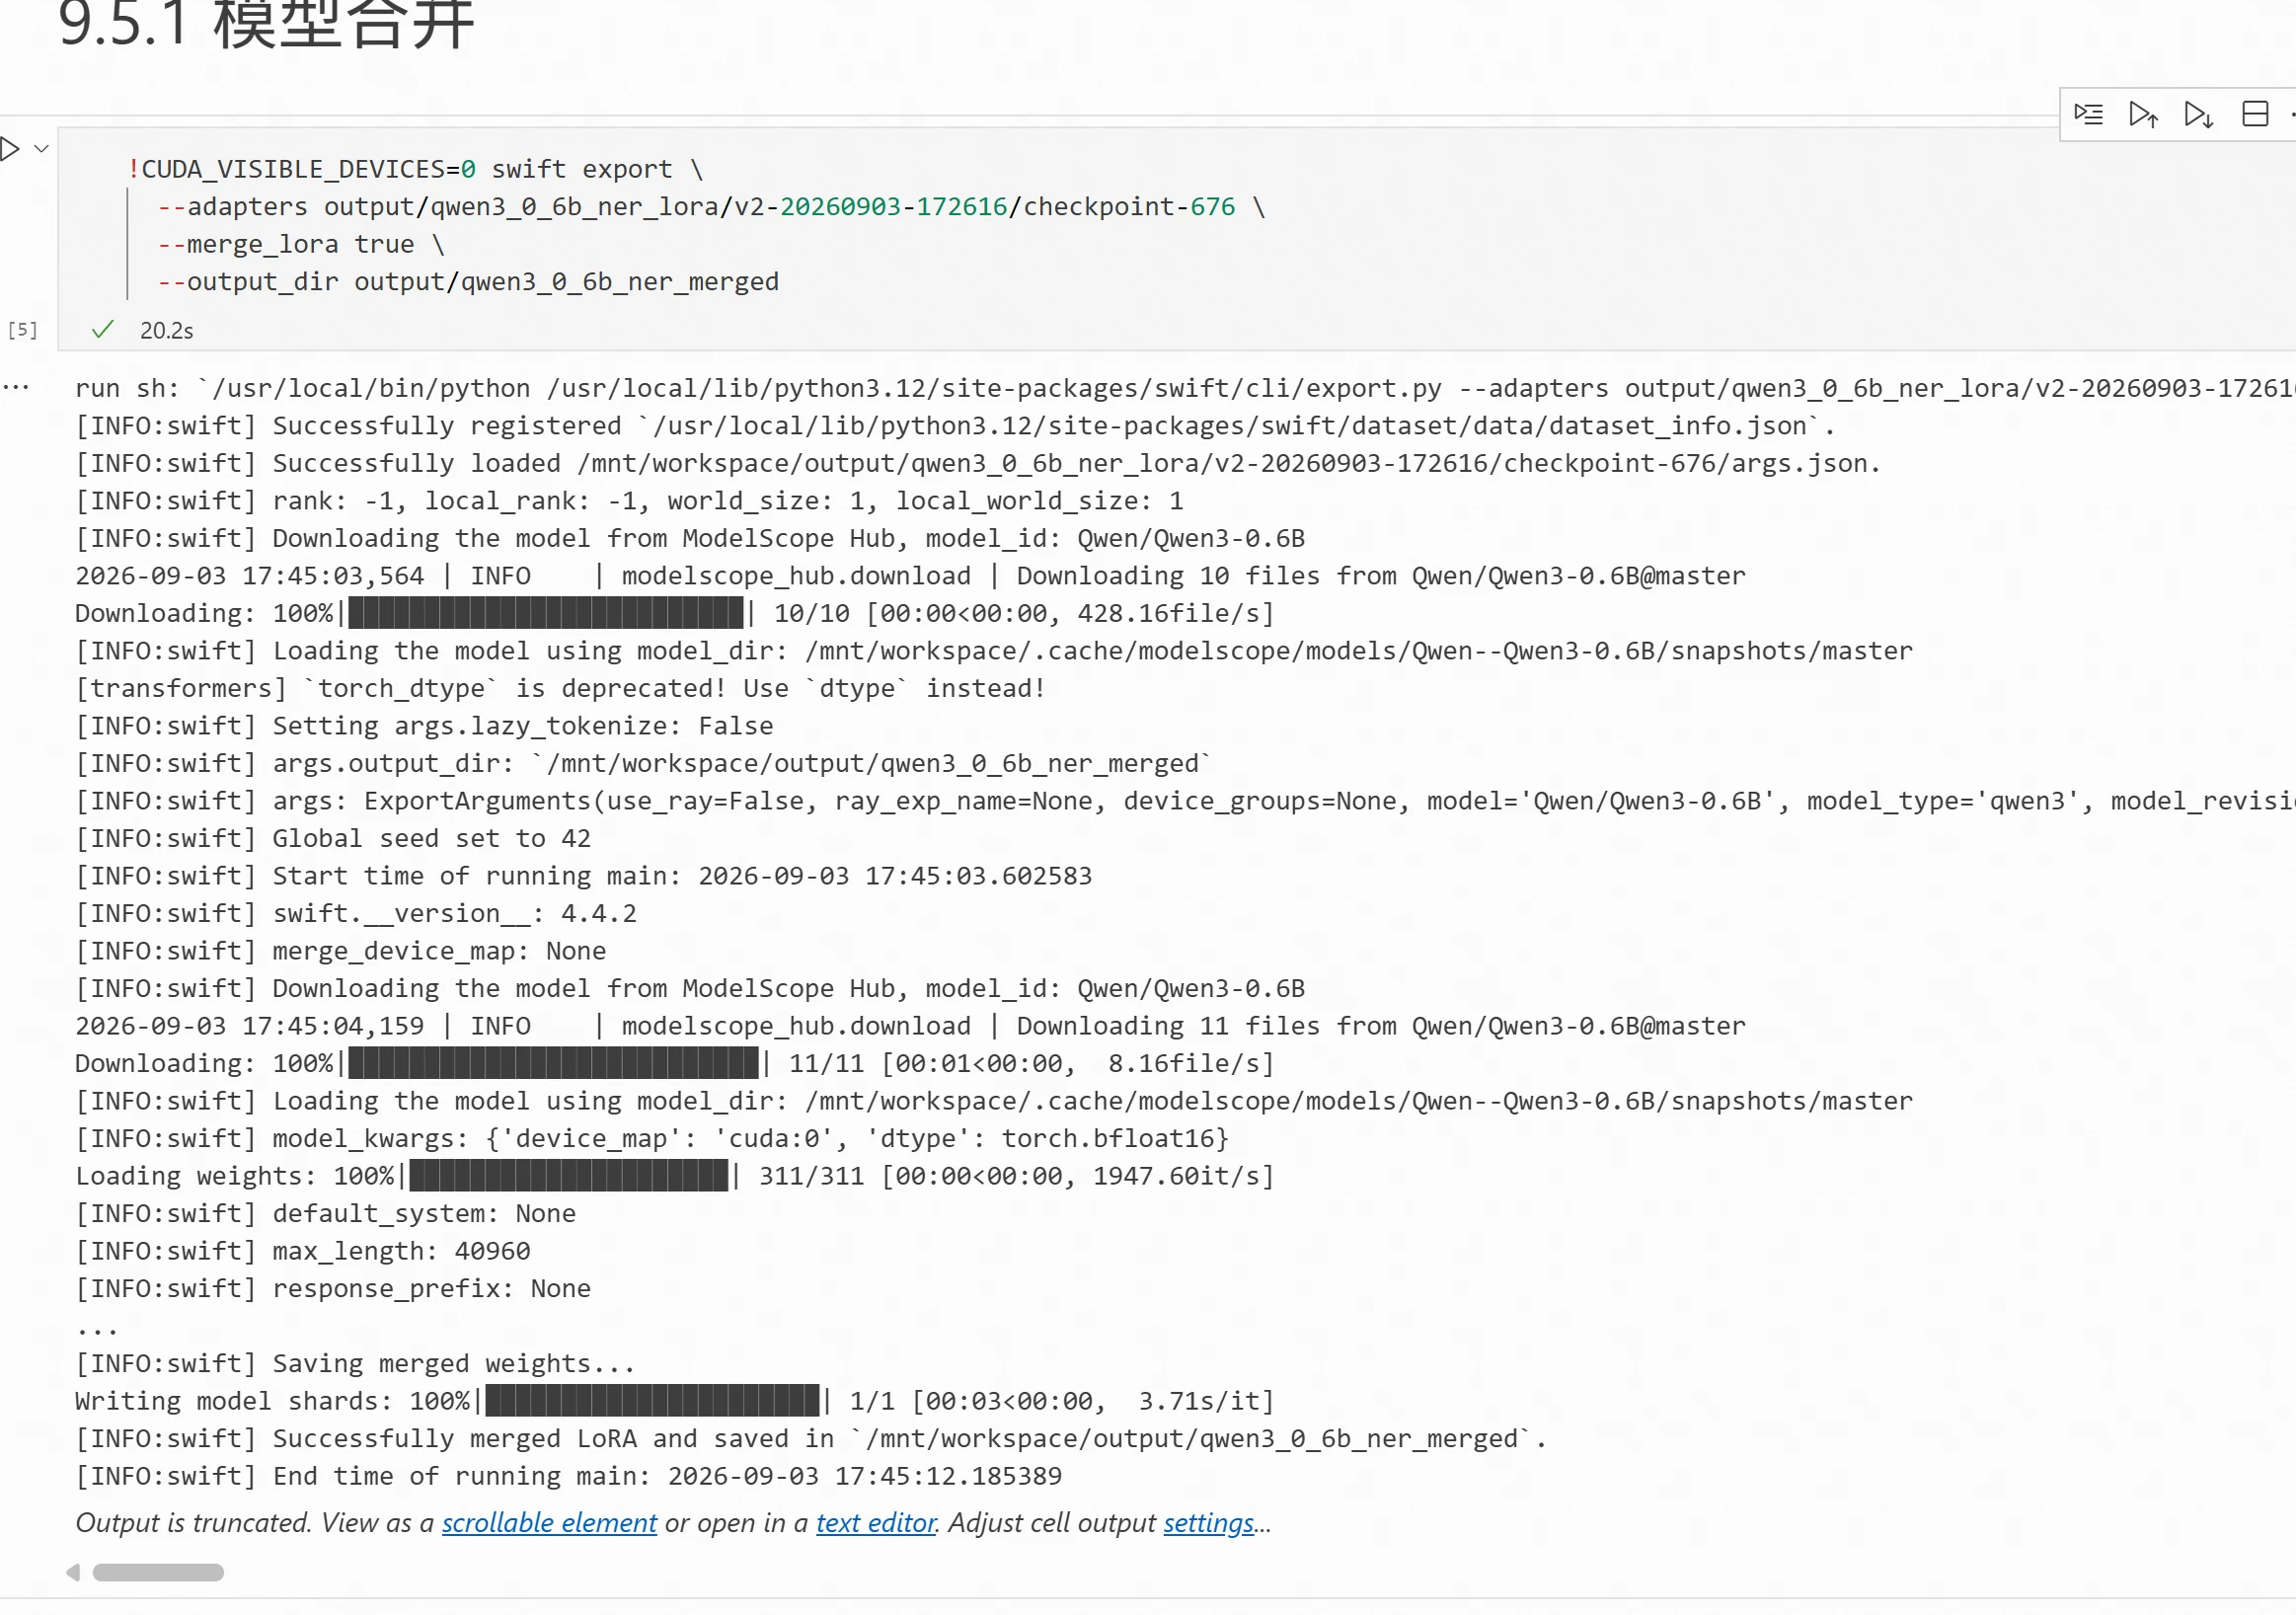
Onde --adapters especifica o caminho para o checkpoint LoRA treinado, --merge_lora true indica a fusão dos parâmetros LoRA no modelo base, e --output_dir especifica o diretório de salvamento para o modelo fundido.
Resultado da execução:
Carregar o modelo fine-tuned e testar o efeito
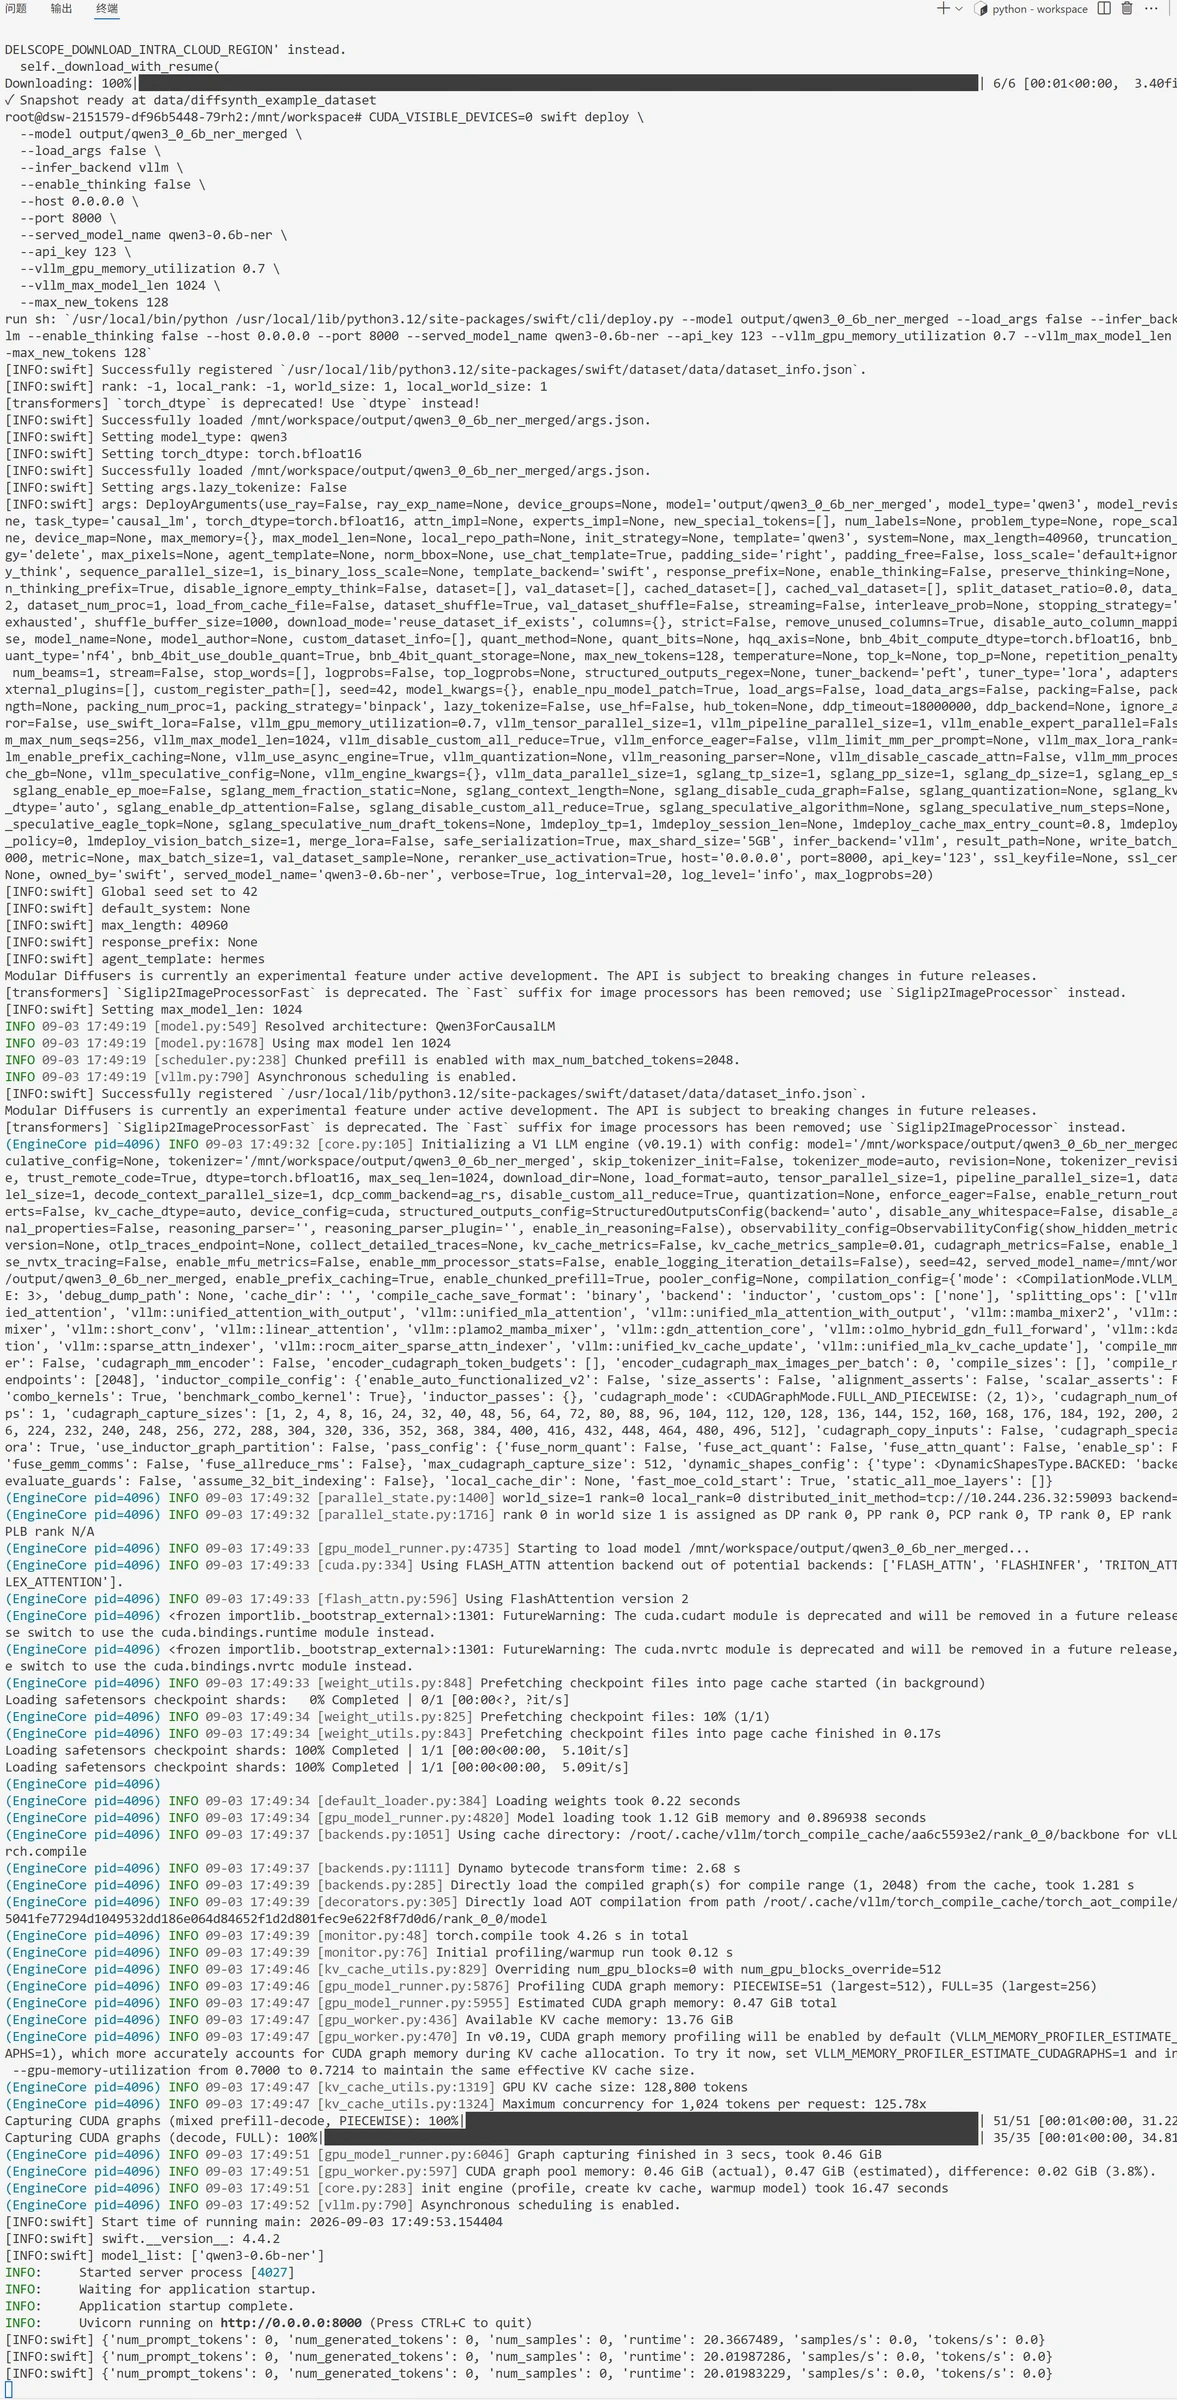
Após a fusão, você pode carregar diretamente o modelo completo gerado para inferência. Para facilitar as chamadas de aplicações, você também pode iniciar o modelo como uma interface compatível com OpenAI, acessando o modelo fine-tuned através de API. Este também é um serviço persistente que precisa ser iniciado no terminal. Você pode consultar o Capítulo 7 para saber como iniciar comandos no terminal. O comando de inicialização é o seguinte:
Iniciar o serviço compatível com OpenAI do ms-swift
--model
Especificar o diretório do modelo completo fundido
--load_args
Não carregar os parâmetros args.json do diretório do modelo
--infer_backend
Usar o motor de inferência vLLM
--enable_thinking
Desabilitar o modo de pensamento Qwen3
--host
IP da interface
--port
Porta
--served_model_name
Definir o nome do modelo de acesso à interface
--api_key
Definir a chave de acesso à interface
--vllm_gpu_memory_utilization
O modelo usa aproximadamente 70% da memória GPU
--vllm_max_model_len
Número máximo total de tokens
--max_new_tokens
Comprimento máximo de saída
Após o modelo iniciar, o resultado é o seguinte:
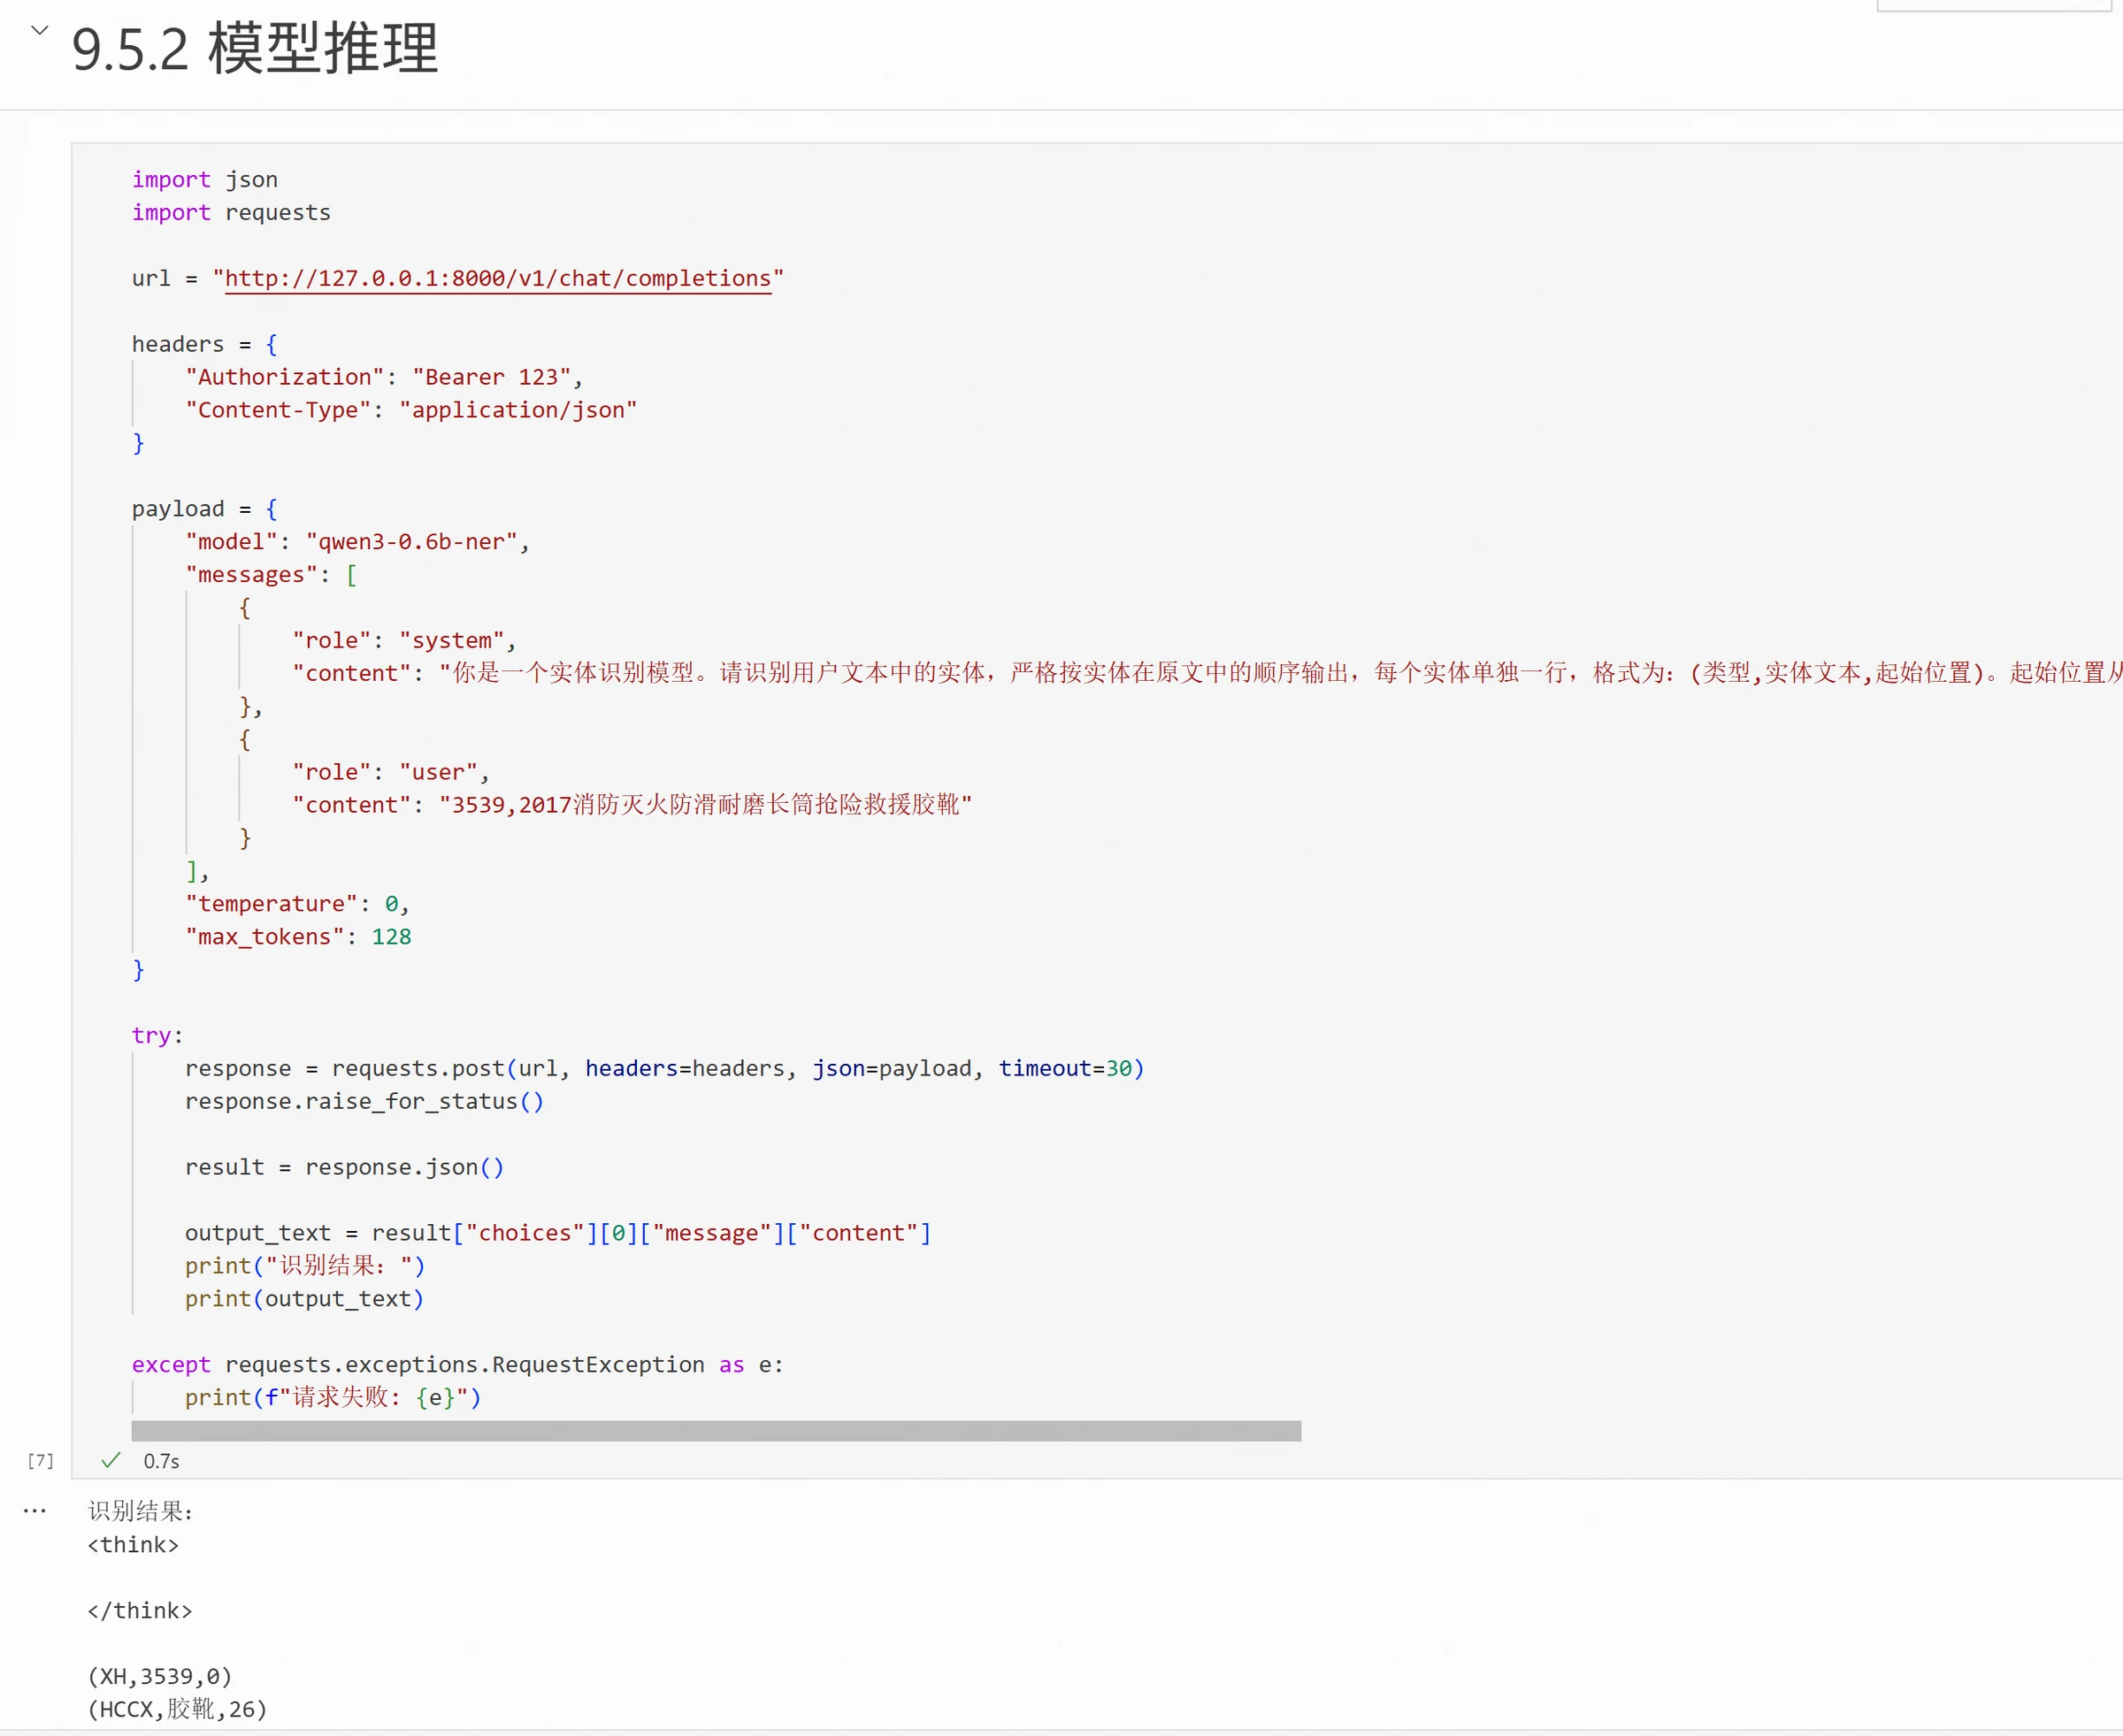
Após o modelo iniciar, você pode testar a conectividade através da interface. Código como segue:
import json
import requests

url = "http://127.0.0.1:8000/v1/chat/completions"

headers = {
    "Authorization": "Bearer 123",
    "Content-Type": "application/json"
}

payload = {
    "model": "qwen3-0.6b-ner",
    "messages": [
        {
            "role": "system",
            "content": "Você é um modelo de reconhecimento de entidades. Por favor identifique as entidades no texto do usuário. Produza as entidades estritamente em sua ordem de aparição no texto original, cada entidade em uma linha separada no formato: (tipo, texto da entidade, posição inicial). A posição inicial começa em 0; o tipo pode ser apenas HCCX, HPPX, MISC ou XH. Quando não houver entidades, produza apenas: Sem entidades. Não produza explicações, Markdown, tags think ou outro conteúdo."
        },
        {
            "role": "user",
            "content": "3539,2017botas de borracha altas antiderrapantes e resistentes ao desgaste para combate a incêndio e resgate"
        }
    ],
    "temperature": 0,
    "max_tokens": 128
}

try:
    response = requests.post(url, headers=headers, json=payload, timeout=30)
    response.raise_for_status()

    result = response.json()

    output_text = result["choices"][0]["message"]["content"]
    print("Resultado do reconhecimento:")
    print(output_text)

except requests.exceptions.RequestException as e:
    print(f"Falha na requisição: {e}")
Resultado de saída do modelo. Também podemos usar expressões regulares para remover as tags think:
Todos os dados e código de experimentos deste capítulo podem ser encontrados em: https://modelscope.cn/gallery/liucong/ab458cbd-b47f-4830-91b6-314ea2036fc6