Fine-tuning e avaliação • Iniciante⏱️ 20 min de leitura
Preference Alignment
Por que fazer alinhamento de preferências se o modelo já sabe responder?
Depois do fine-tuning, o modelo consegue responder às perguntas conforme solicitado, mas quando colocamos várias respostas lado a lado, há boas e ruins, e algumas parecem mais confortáveis de ler.
Pegue o exemplo de uma consulta sobre reembolso: ambos informam ao usuário onde solicitar, mas uma resposta apenas dá o link de operação, enquanto a outra também explica que é necessário verificação e que o reembolso depende do pedido. Ambas mencionam reembolso, mas a segunda esclarece melhor as situações que o usuário pode encontrar, reduzindo mal-entendidos.
Quando fazemos SFT, organizamos respostas assim como exemplos para o modelo aprender. Agora podemos colocar diferentes respostas para a mesma pergunta lado a lado, dizer ao modelo qual preferimos e quais são os critérios de avaliação.
Este é o alinhamento de preferências, e vamos começar por aqui.
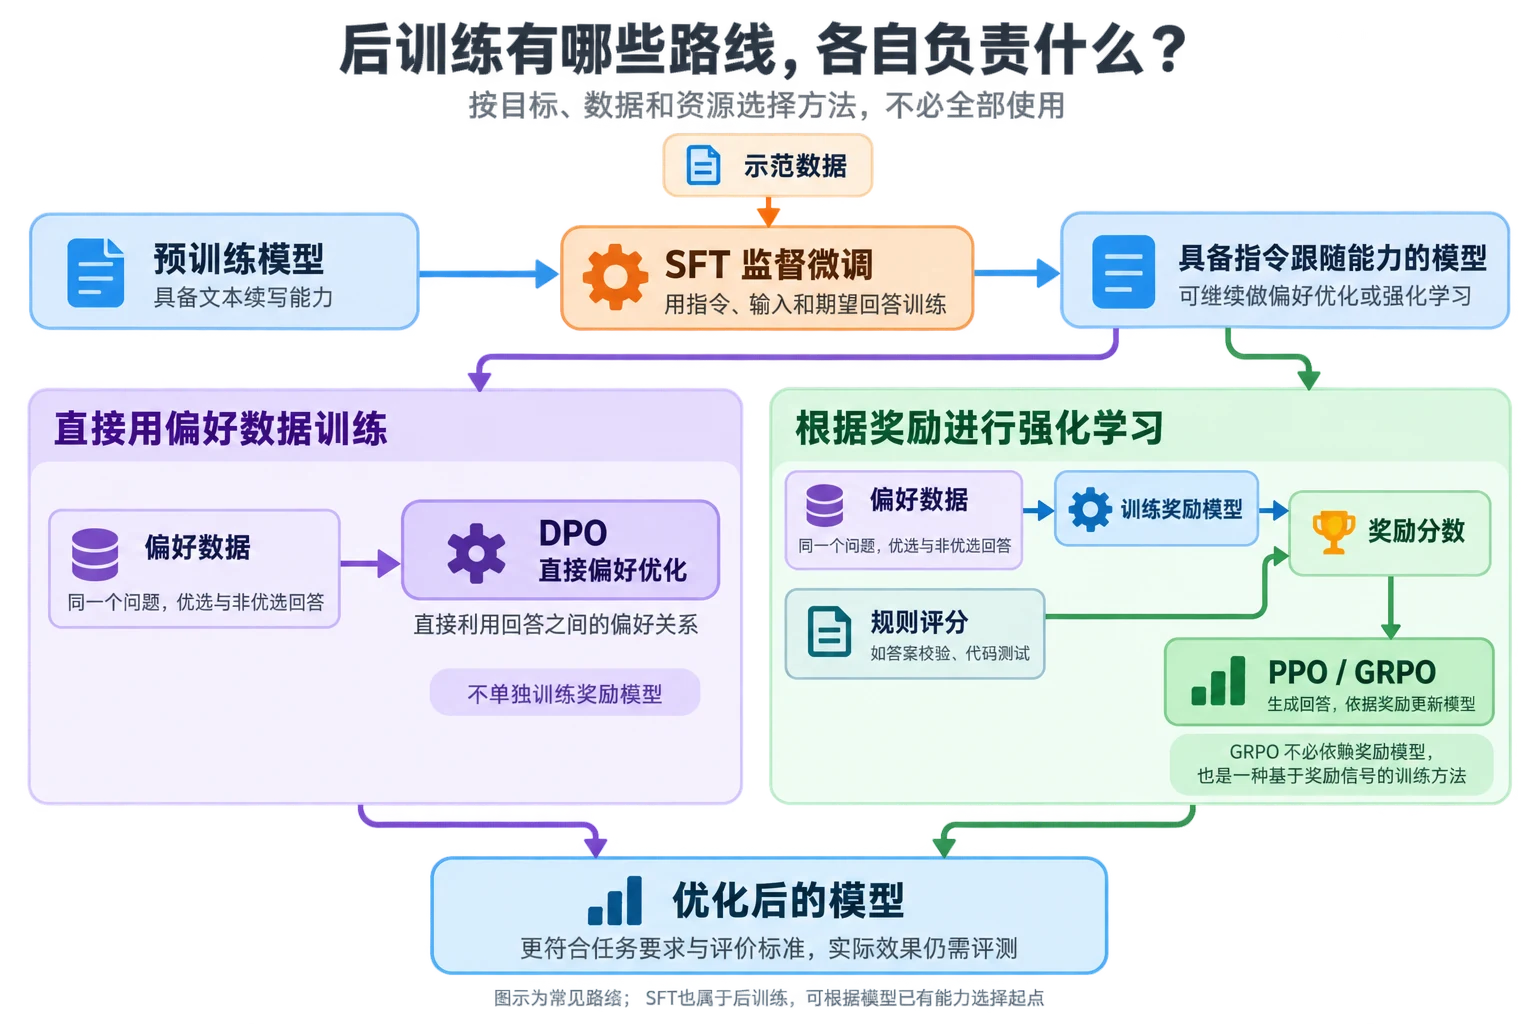
Vamos resumir: quais são as práticas de pós-treinamento?
O principal objetivo do pós-treinamento de grandes modelos é ajudar os modelos base que já possuem capacidade de continuar texto a se tornarem progressivamente capazes de dialogar melhor, seguir instruções e completar tarefas específicas. O pós-treinamento não é um algoritmo fixo, mas sim um conjunto de métodos de treinamento, incluindo SFT, otimização de preferências, treinamento de modelos de recompensa e aprendizado por reforço, entre outros. Diferentes modelos combinam esses métodos de acordo com seus objetivos de treinamento, condições de dados e custos.
Entre eles, o SFT utiliza principalmente dados no formato "instrução, entrada e resposta esperada", permitindo que o modelo aprenda a entender tarefas, seguir instruções e responder no formato e estilo esperados.
Portanto, não existe um fluxo fixo para o pós-treinamento de grandes modelos. SFT, modelos de recompensa, PPO, GRPO e DPO desempenham funções diferentes. O SFT é usado principalmente para estabelecer a capacidade básica de seguir instruções; o modelo de recompensa fornece sinais de avaliação quantificáveis; PPO e GRPO otimizam a estratégia de geração com base nos sinais de recompensa; e o DPO utiliza dados de preferências diretamente para concluir o alinhamento do modelo. No processo real de treinamento, nem todos esses métodos são necessariamente usados, nem necessariamente na mesma ordem — a seleção é flexível de acordo com as capacidades do modelo, objetivos da tarefa e recursos de treinamento.
Mostrando demonstrações ao modelo: o que o SFT pode ensinar?
SFT significa Supervised Fine-Tuning (Ajuste Fino Supervisionado). Ele usa entradas e saídas esperadas já organizadas para continuar treinando o modelo, aumentando a probabilidade de gerar respostas esperadas quando vê entradas semelhantes.
Durante o treinamento, o Tokenizer converte instruções, entradas e respostas em Tokens. O modelo prevê o próximo Token baseado nos anteriores e calcula a perda usando a diferença entre a previsão e a resposta esperada. O SFT de grandes modelos normalmente usa perda de entropia cruzada e teacher forcing: ao treinar cada posição, o modelo vê o contexto correto já fornecido nos dados, e não os erros que acabou de gerar. Muitas implementações de ajuste fino de instruções calculam a perda apenas para a parte da resposta — instruções e entradas do usuário fornecem contexto, mas não é necessário que o modelo as regenere.
O SFT primeiro muda o formato da tarefa. O modelo gradualmente entende que a entrada é uma consulta do usuário e a saída deve ser uma resposta de atendimento ao cliente, e não continuar escrevendo a pergunta do usuário. Para extração de informações, pode aprender a sair com campos JSON fixos; para atas de reunião, pode aprender a organizar conteúdo por informações da reunião, conclusões-chave e itens de ação. Em segundo lugar, o SFT muda o estilo de resposta do modelo. O tom, extensão, estrutura de parágrafos, nível de explicação e estilo de recusa nos dados de treinamento tornam-se objetos de imitação do modelo. Se as respostas esperadas são geralmente concisas, o modelo tenderá a dar conclusões diretas; se os exemplos pedem para explicar o raciocínio antes dos passos, o modelo também aprenderá essa organização. O SFT também pode expor o modelo a exemplos de domínio. Os status de pedidos, condições de reembolso e escalamento para atendimento humano nos dados de atendimento ao cliente, as estruturas de cláusulas nos dados jurídicos e os padrões de uso de API nos dados de código influenciam a saída do modelo nas tarefas correspondentes. No entanto, isso não significa que o modelo domina automaticamente todo o conhecimento desse domínio. O modelo só tem a oportunidade de aprender esses padrões nas atualizações de parâmetros quando os dados de SFT cobrem aquelas tarefas, contêm aqueles termos e processamento.
O objetivo de treinamento do SFT é, em essência, imitar a saída esperada. Ele permite que o modelo saiba como responder geralmente a esse tipo de pergunta, mas não garante que os fatos na resposta foram verificados, nem que o modelo possa comparar todas as respostas possíveis com apenas uma demonstração. O mesmo problema de reembolso pode gerar duas respostas como estas:
Resposta A: Aplique para reembolso nos detalhes do pedido. Se não conseguir, entre em contato com o atendimento humano.

Resposta B: Você pode verificar o status do pedido primeiro. Quando atender às condições de reembolso, envie a solicitação nos detalhes do pedido; se não houver opção de reembolso, entre em contato com o atendimento humano para verificação. O resultado do reembolso e o tempo de chegada dependem da revisão real.
Ambas as respostas são sobre reembolso, mas a Resposta B adiciona as condições de revisão e evita prometer um resultado definitivo de reembolso. Se o negócio valoriza mais a completude das informações e os limites de conformidade, a Resposta B é mais adequada. O SFT pode usar a Resposta B como demonstração para o modelo, enquanto os dados de preferências podem fornecer A e B ao mesmo tempo e dizer explicitamente ao modelo por que prefere B. Esta é a razão pela qual passamos do aprendizado supervisionado para o alinhamento de preferências.
Para a mesma pergunta, qual resposta é mais adequada?
O foco do alinhamento de preferência não é se o modelo "pode responder", mas sim qual tipo de resposta deve ser mais preferido quando múltiplas respostas possíveis são apresentadas.
Usando o cenário de atendimento ao cliente de reembolso como exemplo, se uma resposta omite condições de revisão, promete um horário fixo de chegada ou declara resultados incertos como resultados definitivos, pode ser marcada como uma resposta inferior.
Além disso, o alinhamento de preferências também não pode substituir a verificação factual. Uma resposta pode ser fluentemente expressa com tom amigável, mas citar uma política incorreta; outra resposta pode ser factualmente correta, mas não seguir o formato de saída solicitado. Portanto, o sistema de avaliação real geralmente precisa definir separadamente critérios para acurácia factual, conclusão da tarefa, estilo de expressão e conformidade de segurança. Para conteúdos que podem ser verificados automaticamente, também é possível combinar testes de código, verificação de respostas, verificação de formato e regras de negócio para avaliação, reduzindo o viés causado pela dependência total de julgamento subjetivo humano.
Como os dados de preferências devem ser construídos
Dados de preferência (Preference Data) são dados de treinamento usados para dizer ao modelo "qual das múltiplas respostas é melhor".
Aqui, chosen indica a resposta mais adequada sob os critérios de avaliação atuais, e rejected indica a resposta relativamente inadequada. A resposta não preferida não está necessariamente completamente errada — pode apenas omitir condições necessárias, ser excessivamente verbosa, ter um tom inadequado ou conter promessas sem fundamento. Os dados de preferências expressam relações relativas, e não etiquetas permanentes de correto ou incorreto para cada resposta.
Os dados de preferências são geralmente construídos seguindo o processo abaixo:
Preparar Prompts a partir de negócios reais ou conjuntos de teste que representem a distribuição da tarefa;
Usar o modelo atual, diferentes versões do modelo ou diferentes parâmetros de amostragem para gerar múltiplas respostas candidatas para o mesmo Prompt;
De acordo com critérios de avaliação unificados, fazer com que os anotadores comparem as respostas duas a duas ou façam uma ordenação completa;
Converter os resultados da ordenação em pares de dados compostos por respostas preferidas e não preferidas;
Verificar a consistência das anotações e entregar amostras que não podem ser julgadas, que têm fundamento factual insuficiente ou que têm conflitos de opinião aos revisores.
Se a mesma entrada gerar quatro respostas A, B, C e D, e a anotação resultar em B melhor que A, A melhor que D e D melhor que C, isso pode ser convertido em múltiplos pares de preferências. Na construção real, não é necessário enumerar todas as combinações. Respostas com diferenças muito pequenas são difíceis de anotar de forma estável, enquanto respostas com diferenças muito grandes podem apenas ensinar o modelo a evitar erros grosseiros. Dados mais valiosos geralmente vêm de respostas que são todas legíveis, mas apresentam diferenças claras em condições-chave, limites factuais ou grau de conclusão da tarefa.
A anotação de preferências é facilmente influenciada por fatores superficiais. Respostas mais longas parecem mais completas, respostas com redação mais confiável parecem mais confiáveis e candidatos posicionados primeiro também podem ser mais facilmente escolhidos. Para reduzir esses vieses, pode-se randomizar a ordem dos candidatos, ocultar o nome do modelo, exigir que os anotadores verifiquem separadamente fatos, conclusão da tarefa, estilo e segurança, e organizar anotações repetidas por múltiplas pessoas em algumas amostras. Se os anotadores frequentemente discordam no mesmo lote de dados, isso geralmente indica que os critérios de avaliação ainda não estão claros, em vez de simplesmente excluir as opiniões minoritárias.
Como o modelo de recompensa aprende a pontuar respostas?
Os dados de preferência já representam "qual resposta é melhor sob o mesmo Prompt" como um relacionamento relativo entre e .
O modelo de recompensa não precisa saber quantos pontos cada uma das duas respostas deveria receber — ele só precisa aprender uma relação relativa: sob este Prompt, a pontuação de chosen deve ser maior que a de rejected. Portanto, durante o treinamento, o Prompt é geralmente concatenado com cada uma das duas respostas candidatas separadamente e inserido no modelo de recompensa:
Aqui, rchosen e rrejected são as duas pontuações escalares de saída do modelo de recompensa. O objetivo do treinamento é fazer com que a pontuação da resposta preferida seja maior que a da resposta não preferida. A perda de ordenação pareada comum pode ser escrita como:
Aqui, r_chosen e r_rejected representam respectivamente as pontuações do modelo de recompensa para as respostas preferida e não preferida, e σ representa o mapeamento da diferença de pontuação para o intervalo de 0 a 1. Quanto maior a pontuação da resposta preferida e menor a pontuação da resposta não preferida, menor a perda. Após treinamento com um grande número de pares de preferências, o modelo de recompensa pode fazer avaliações relativas de respostas que não viu antes.
O modelo de recompensa geralmente usa um modelo de linguagem como base e adiciona um cabeçalho de pontuação para saída de pontuação escalar.
O que o modelo de recompensa pode aprender depende em grande parte dos dados de preferências construídos anteriormente. Se os anotadores nos dados de preferências sempre tenderem a escolher respostas mais longas, o modelo de recompensa pode confundir comprimento com qualidade; se os anotadores se concentrarem excessivamente na fluência da língua, ele também pode dar pontuações mais altas a respostas com redação bonita mas fatos incorretos. Portanto, o modelo de recompensa não realmente compreende o que é uma resposta correta — ele está imitando os padrões de avaliação refletidos nos dados de preferências. É por isso que, após o treinamento do modelo de recompensa, não basta olhar apenas a perda de treinamento — é necessário realizar avaliações separadas.
É precisamente porque o modelo de recompensa é responsável apenas pela "avaliação" e não modifica diretamente o modelo de linguagem.
RLHF: como o feedback humano participa do treinamento?
RLHF (Reinforcement Learning from Human Feedback) é geralmente chamado de aprendizado por reforço baseado em feedback humano. Ele descreve como o feedback humano entra no treinamento de aprendizado por reforço — é um framework de treinamento, não um algoritmo de otimização específico nem uma estrutura de modelo fixa.
O RLHF clássico geralmente inclui três estágios:
Coletar dados de demonstração humana e obter um modelo de política inicial capaz de seguir instruções através de SFT;
Ordenar humanamente múltiplas respostas sob o mesmo Prompt e usar esses dados de preferências para treinar o modelo de recompensa;
Fazer com que o modelo de política gere novas respostas, que são pontuadas pelo modelo de recompensa, e então usar algoritmos de aprendizado por reforço como PPO para atualizar o modelo de política.
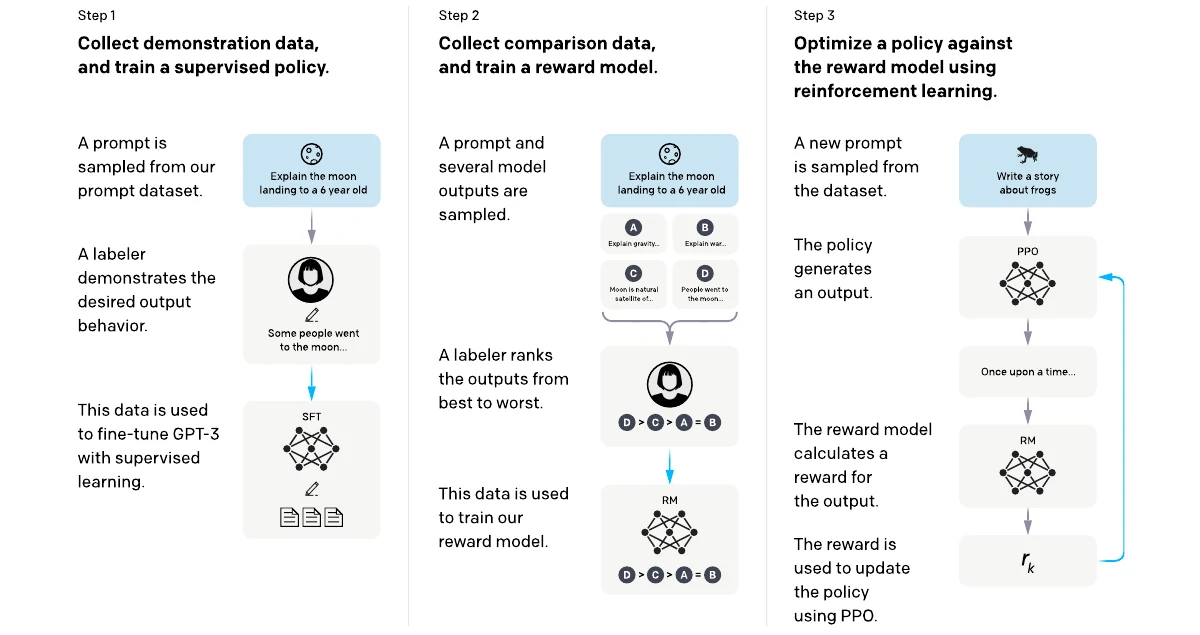
A linha do RLHF clássico é dividida em três estágios consecutivos conforme mostrado na figura abaixo. No primeiro estágio, os anotadores escrevem respostas de demonstração e usam esses dados para completar o SFT; no segundo estágio, o modelo gera múltiplas respostas para o mesmo Prompt, que são ordenadas pelos anotadores, e os dados de comparação são usados para treinar o modelo de recompensa; no terceiro estágio, o modelo de política gera novas respostas, o modelo de recompensa calcula as pontuações e o PPO é usado para atualizar a política. Os três tipos de dados desempenham funções diferentes: dados de demonstração ensinam o modelo como responder, dados de comparação ensinam o modelo de recompensa como avaliar, e Prompt e sinais de recompensa são usados para o aprendizado por reforço.
Colocando este processo no conceito de aprendizado por reforço, o modelo de idioma é o modelo de política, o Prompt e os Tokens já gerados compõem o estado atual, o modelo selecionar o próximo Token equivale a tomar uma ação, e do início da resposta até a geração da marca de fim constitui uma trajetória completa.
No RLHF, o modelo de recompensa geralmente fornece uma pontuação geral após o término da resposta, e o algoritmo de aprendizado por reforço determina quais probabilidades de seleção de Token devem ser aumentadas. O treinamento RLHF geralmente também mantém um modelo de referência. O modelo de referência é geralmente um modelo SFT congelado, usado para restringir o modelo de política em treinamento para não se desviar muito da capacidade linguística original.
PPO: fazendo o modelo ajustar-se gradualmente com base na recompensa
Proximal Policy Optimization (PPO) é um algoritmo de gradiente de política cujo objetivo central é aumentar a recompensa ao mesmo tempo em que limita a magnitude de cada atualização de parâmetros. Grandes modelos têm muitos parâmetros — se a estratégia for drasticamente alterada apenas porque um lote de respostas recebeu pontuações altas, o modelo pode rapidamente se inclinar para poucos padrões de recompensa, até mesmo destruindo a capacidade linguística original. O "proximal" no PPO enfatiza que a nova política deve ser atualizada gradualmente perto da política antiga. No pós-treinamento de grandes modelos, uma rodada de PPO geralmente inclui dois estágios. O primeiro estágio é a amostragem: extrair um lote de entradas do conjunto de dados de Prompt, fazer com que o modelo de política atual gere respostas, salvar simultaneamente a probabilidade de cada Token sob a política antiga, e então o modelo de recompensa fornece pontuações. O segundo estágio é a atualização: calcular as vantagens com base na recompensa e na estimativa de valor, e usar essas amostras para atualizar o modelo de política e o modelo de valor. Após várias atualizações em mini-lote, os dados são regenerados com a nova política.
O PPO precisa comparar a probabilidade dada pela nova política e pela política antiga para o mesmo Token. A razão de probabilidade pode ser simplificada como:
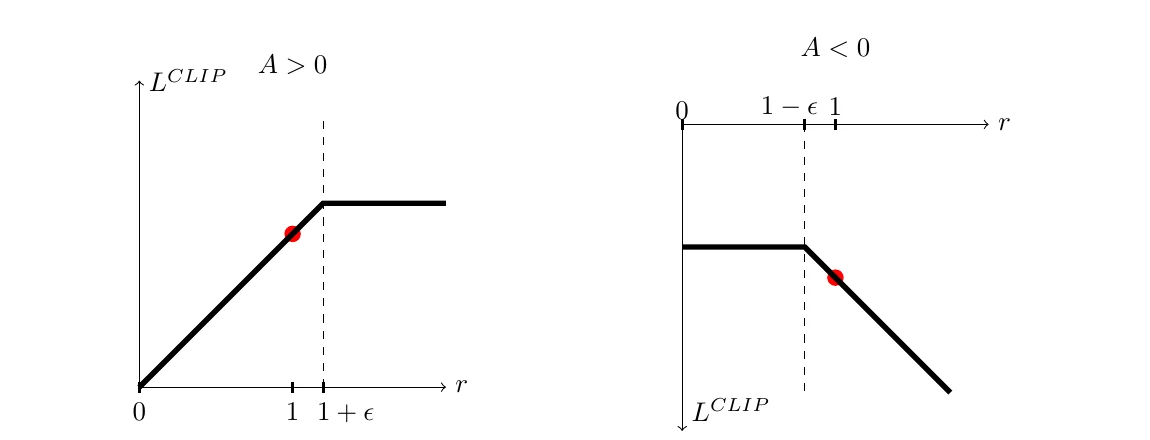
Quando rₜ se aproxima de 1, a diferença entre as políticas nova e antiga é pequena; quando rₜ é significativamente maior que 1, a nova política favorece o Token atual; quando rₜ é significativamente menor que 1, a nova política reduziu sua probabilidade. Apenas a mudança de probabilidade não é suficiente — é necessário também a vantagem Aₜ para determinar se a seleção deste Token é melhor ou pior que a média atual. Quando a vantagem é positiva, a probabilidade dessa seleção deve ser aumentada adequadamente; quando a vantagem é negativa, a probabilidade deve ser reduzida.
O lado esquerdo da figura acima representa a situação em que a vantagem é positiva. À medida que a razão de probabilidade aumenta à direita a partir de 1, o objetivo aumenta inicialmente com ela; após ultrapassar 1+ε, a curva se estabiliza e aumentar ainda mais a probabilidade desse Token não aumenta mais o objetivo. O lado direito representa a situação em que a vantagem é negativa. Quando a razão de probabilidade cai abaixo de 1-ε, o objetivo também para de melhorar. As duas curvas demonstram conjuntamente que o PPO permite ajustes da política na direção correta, mas atenua os ganhos extras provenientes de atualizações excessivamente grandes.
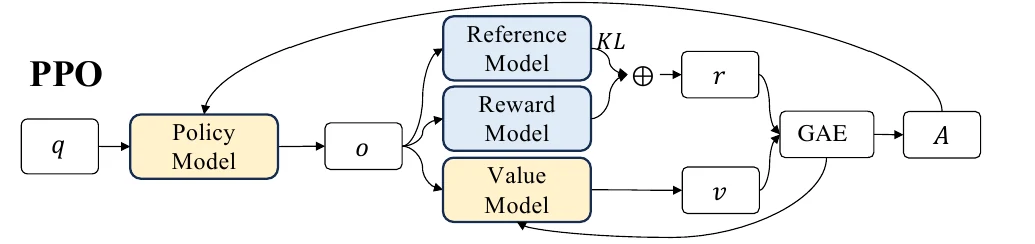
Um treinamento PPO típico de grandes modelos requer a manutenção simultânea de vários componentes: o modelo de política é responsável por gerar e receber atualizações; a política antiga é um snapshot dos parâmetros da política durante a amostragem, usado para calcular a razão de probabilidade; o modelo de referência é um modelo SFT congelado, usado para calcular a restrição KL; o modelo de recompensa é responsável por avaliar respostas completas; o modelo de valor é responsável por estimar o retorno potencial após cada posição de geração. Há uma diferença entre as estimativas do modelo de valor e as recompensas reais, e o PPO geralmente usa métodos como GAE para organizar essas diferenças em vantagens para cada Token. O fluxo geral do PPO é mostrado na figura abaixo. O modelo de política gera a resposta o com base na entrada q, o modelo de recompensa e o modelo de referência juntos formam a recompensa r, o modelo de valor fornece a estimativa de valor v, e então a vantagem A é calculada através de GAE. O modelo de política é atualizado com base na vantagem e no objetivo recortado, enquanto o modelo de valor aprende estimativas de retorno mais precisas através da perda de valor.
GRPO: respondendo a mesma pergunta várias vezes e comparando as pontuações
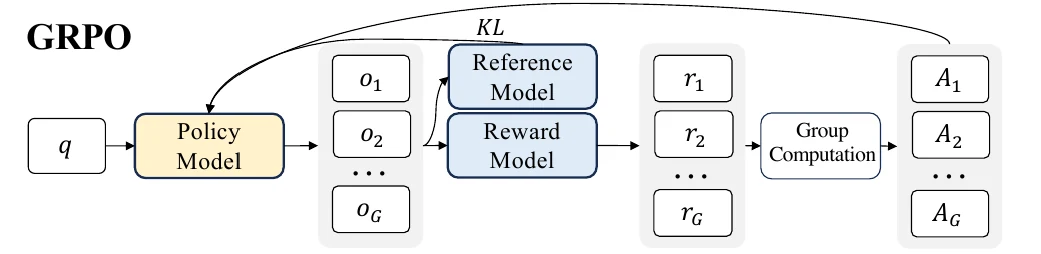
Group Relative Policy Optimization (GRPO) é uma variante do PPO que preserva conceitos como amostragem de política, recorte de razão de probabilidade e restrição KL. A mudança principal é que não treina mais um modelo de valor separadamente, mas sim usa as pontuações relativas de múltiplas respostas sob o mesmo Prompt para estimar vantagens. O framework geral do GRPO é mostrado na figura abaixo. Para a mesma entrada q, o modelo de política gera um grupo de respostas de o₁ a oG de uma vez, e o modelo de recompensa ou sistema de regras fornece r₁ a rG respectivamente.
O sistema primeiro calcula a média e o desvio padrão deste grupo de recompensas, e então converte a pontuação de cada resposta em vantagem relativa dentro do grupo — respostas com pontuação acima da média do grupo obtêm vantagem positiva, enquanto respostas abaixo da média obtêm vantagem negativa. Para tarefas que fornecem uma recompensa geral apenas no final da resposta, os Tokens na mesma resposta geralmente compartilham a vantagem relativa obtida por essa resposta; se também houver recompensas de processo, pode-se formar feedback mais refinado no nível de Token. Em seguida, o GRPO compara as probabilidades da política nova e antiga como o PPO, e atualiza o modelo de política através do objetivo recortado e da restrição KL.
Em comparação com o PPO, o GRPO reduz os parâmetros, uso de memória e custos de treinamento trazidos pelo modelo de valor, mas isso não significa que o custo de treinamento necessariamente seja baixo. Cada Prompt requer a geração de múltiplas respostas, e a amostragem de inferência em si consome muitos recursos computacionais. Se as pontuações de todas as respostas no mesmo grupo forem idênticas e o desvio padrão for próximo de 0, a comparação dentro do grupo dificilmente fornecerá uma direção eficaz — na implementação real, é necessário pular, suavizar ou reamostrar esses dados. O tamanho do grupo, a temperatura de amostragem, a escala de recompensa e o coeficiente KL também afetam a estabilidade do treinamento. Por exemplo, um problema matemático gera quatro soluções, das quais duas estão corretas, uma tem erro de cálculo e uma não foi concluída. O sistema pode usar regras de verificação de respostas para pontuá-las e então comparar internamente os quatro resultados. Respostas corretas e com processo completo obtêm maior vantagem, enquanto respostas incorretas ou incompletas obtêm menor vantagem — o modelo aumenta então a probabilidade de gerar soluções melhores. Tarefas de código também podem usar resultados de compilação e testes unitários como recompensa, sem necessidade de treinar primeiro um modelo de recompensa专门.
DPO: aprendendo diretamente das vantagens e desvantagens das respostas
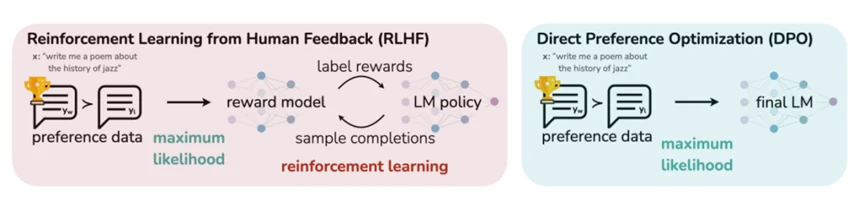
Direct Preference Optimization (DPO). No título de seu artigo, os autores afirmam explicitamente que o modelo de preferências pode não ser necessário — o próprio grande modelo de linguagem que construímos pode ser o modelo de preferências latente. Esta ideia abandona diretamente a modelagem separada do modelo de preferências e parte do modelo original para adicionar uma função de perda projetada especificamente para o modelo de preferências, melhorando a otimização dos resultados gerados. O DPO treina o modelo de linguagem diretamente usando respostas preferidas e não preferidas já coletadas, sem necessidade de treinar explicitamente um modelo de recompensa ou executar ciclos de aprendizado por reforço online como PPO ou GRPO.
A figura acima compara a linha clássica do RLHF com o DPO. Os dados de preferências são primeiro usados para treinar o modelo de recompensa, o modelo de política gera novas respostas, e o aprendizado por reforço é realizado com base nas pontuações do modelo de recompensa. Na linha DPO, os dados de preferências vão diretamente para o treinamento do modelo de linguagem. Ambas as linhas partem da relação de superioridade entre respostas, mas diferem nos estágios de treinamento e requisitos de recursos. O fluxo geral do DPO requer apenas dois estágios:
Primeira etapa, construir amostras positivas e negativas de preferência.
No segundo estágio, com base na função de perda projetada, utilizar métodos relacionados ao aprendizado por contraste e maximização de verossimilhança para otimizar os parâmetros do modelo de geração original. Este design elimina todo o processo de treinamento do modelo de recompensa de preferências e do aprendizado por reforço, melhorando a eficiência e também proporcionando melhorias significativas na precisão e estabilidade em comparação com o PPO. Através da otimização e ajuste no segundo estágio, os parâmetros do modelo são continuamente otimizados na direção de se aproximar dos exemplos positivos e se afastar dos negativos, finalmente realizando o alinhamento de preferências da geração do modelo em relação ao conteúdo positivo.
A forma de treinamento do DPO se aproxima do SFT normal. Os dados de treinamento já contêm Prompt, respostas preferidas e não preferidas — o modelo não precisa regenerar candidatos a cada passo, nem executar simultaneamente o modelo de recompensa e o modelo de valor. Portanto, pertence à otimização offline de preferências, com poucos componentes e complexidade de memória e engenharia geralmente inferior ao PPO. Esta simplificação não elimina os requisitos de qualidade dos dados. O DPO só pode aprender diferenças que já existem nos dados de preferências. Se a resposta preferida contiver erros factuais, a resposta não preferida for muito inferior, ou os dados vierem principalmente de uma distribuição de geração muito diferente do modelo atual, o modelo pode aprender estilos superficiais em vez da capacidade alvo. O DPO também não explora continuamente novas respostas como o aprendizado por reforço online, nem obtém feedback sobre problemas recém- Surgidos.
RLHF, PPO, GRPO e DPO: como distinguir e escolher?
O texto anterior já introduziu os princípios básicos e métodos de treinamento do RLHF, PPO, GRPO e DPO separadamente. Para entender melhor suas relações, podemos compará-los de várias dimensões: posicionamento do método, necessidade de geração online de respostas durante o treinamento, dependência de modelo de recompensa e modelo de valor, etc. Através desta comparação horizontal, podemos ver mais intuitivamente as principais diferenças entre os diferentes métodos de pós-treinamento em termos de caminho de implementação, custo de treinamento e método de aplicação. A tabela a seguir mostra a comparação dos modelos relevantes.
Conceito
Pertence a
Gera novas respostas durante treinamento
Precisa de modelo de recompensa explícito
Precisa de modelo de valor
RLHF
Framework
Sim
Sim
Sim (PPO)
PPO
Algoritmo
Sim
Sim
Sim
GRPO
Algoritmo
Sim
Sim
Não
DPO
Algoritmo
Não
Não
Não
Em suma, embora RLHF, PPO, GRPO e DPO estejam todos relacionados ao alinhamento de preferências de grandes modelos, os problemas que resolvem não são completamente idênticos. O RLHF é mais um framework completo de feedback e aprendizado por reforço; PPO e GRPO são algoritmos de aprendizado por reforço online usados para atualizar o modelo de política dentro desse tipo de framework; e o DPO utiliza diretamente dados de preferências existentes para concluir a otimização offline. Do ponto de vista do mecanismo de treinamento, o PPO depende do modelo de recompensa e do modelo de valor, com uma cadeia de engenharia mais completa, mas também com custos de treinamento e complexidade de implementação maiores; o GRPO estima vantagens através de recompensas relativas dentro do grupo, eliminando o modelo de valor, sendo mais adequado para tarefas com recompensas de regras e verificação de respostas como feedback claro; o DPO não requer geração online de respostas, nem treinamento separado de modelos de recompensa e valor, portanto sua implementação é relativamente simples, sendo uma solução de baixo custo adequada quando os dados de preferências são suficientes.
Na aplicação real, a escolha do método deve partir das capacidades que o modelo atualmente carece, em vez de simplesmente seguir um algoritmo de treinamento. Quando o modelo ainda não consegue completar tarefas de forma estável, deve-se priorizar o estabelecimento de capacidades básicas através de SFT; quando o modelo já consegue completar tarefas, mas a qualidade da resposta e a seleção de preferências são instáveis, pode-se adotar DPO, PPO ou GRPO. Quando já existem dados de preferências de alta qualidade e deseja-se concluir rapidamente a primeira rodada de alinhamento, pode-se priorizar o DPO; quando a tarefa tem recompensas verificáveis e deseja que o modelo explore ativamente soluções melhores, pode-se considerar o GRPO; quando se dispõe de modelo de recompensa maduro, modelo de valor e infraestrutura de aprendizado por reforço, e é necessário controle refinado da atualização online da política, pode-se adotar o PPO. Independentemente do método escolhido, não se deve julgar o efeito apenas pela perda de treinamento, pontuação de recompensa ou taxa de vitória de preferências — deve-se retornar à tarefa real para avaliar continuamente a acurácia, conclusão da tarefa, segurança, limites de negócio e capacidades gerais do modelo. O objetivo final do pós-treinamento não é obter recompensas mais altas, mas sim fazer com que o modelo complete as tarefas-alvo de forma mais estável e confiável no ambiente de uso real.
Usando ms-swift para experimentar DPO e GRPO
O texto anterior introduziu os princípios básicos do alinhamento de preferências e do aprendizado por reforço. Agora, usaremos o ms-swift para realizar dois experimentos específicos. O primeiro experimento usa dados de preferências em chinês para treinamento DPO, observando como as preferências do modelo por respostas preferidas e não preferidas mudam; o segundo experimento usa problemas matemáticos para treinamento GRPO, fazendo com que o modelo gere respostas candidatas que recebem recompensas com base na resposta e no formato. Ambos os experimentos usam o Qwen2.5-0.5B-Instruct, que já possui capacidade de seguir instruções, como modelo inicial, e treinam um adaptador LoRA independente separadamente.
Preparação do experimento
Este experimento foi concluído em um ambiente GPU de placa única no ModelScope Notebook, com o modelo e os arquivos de dados originais baixados da comunidade ModelScope. A configuração dos dois experimentos é a seguinte:
Item
Alinhamento de Preferência Chinês DPO
Otimização de Resposta Matemática GRPO
Modelo Inicial
Qwen2.5-0.5B-Instruct
Qwen2.5-0.5B-Instruct
Passos de Treinamento
320
10
Taxa de Aprendizado
1e-5
1e-6
LoRA rank/alpha
8/16
8/16
A escala de treinamento aqui é pequena, usada principalmente para demonstrar o fluxo completo. Os passos de treinamento representam o número de vezes que o otimizador atualiza os parâmetros, não equivalem ao número de épocas e não indicam que todos os dados de treinamento foram usados. A parte prática deste experimento usou apenas uma pequena porção dos dados e um número reduzido de etapas de iteração — o experimento é apenas para referência.
Verificar o ambiente de execução.
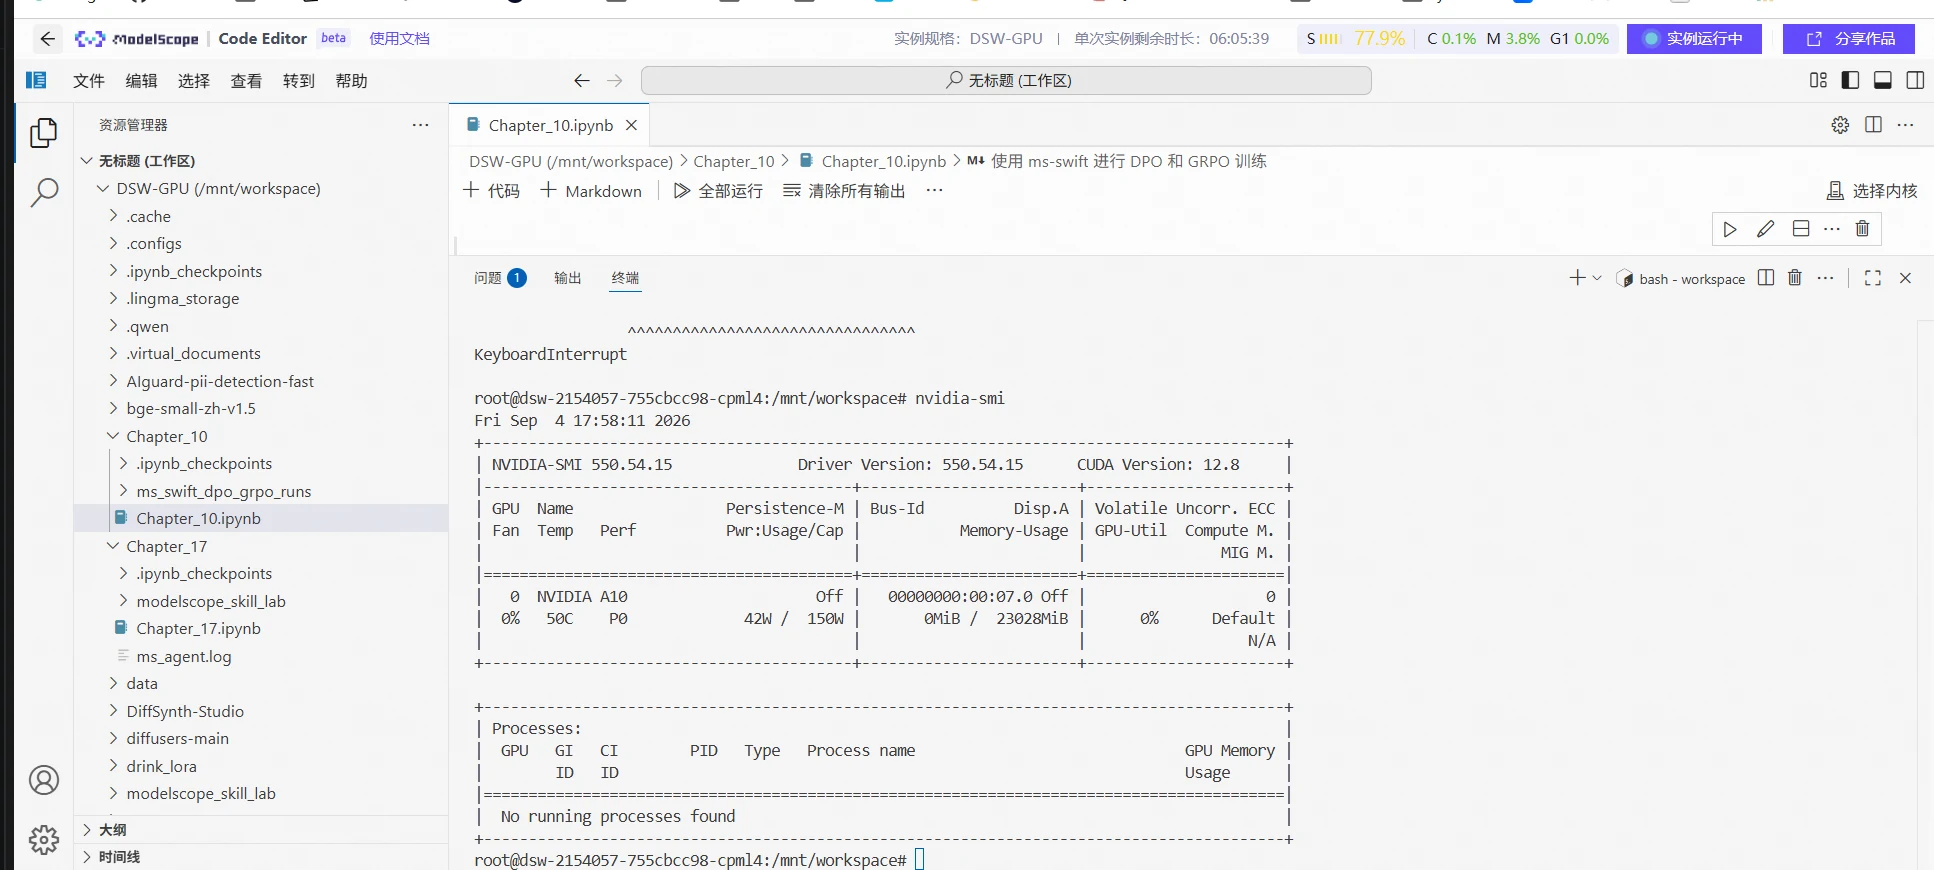
Após abrir o Notebook correspondente, primeiro verifique se a GPU está disponível e qual a versão do software que o kernel atual está usando.
Preparar o modelo e o diretório de execução.
A parte de preparação comum criará o diretório de cache e o diretório deste experimento. O código principal da configuração do modelo é o seguinte:
Aqui, snapshot_download vem do ModelScope e CACHE_DIR é estabelecido pelo código de preparação comum. Após o download, tanto o treinamento quanto a inferência usam o snapshot do modelo local apontado por MODEL_DIR. O conteúdo prático deste experimento será salvo no diretório ms_swift_dpo_grpo_runs/. Quando os leitores re-executarem, o programa gerará novos números de experimento, e o RUN_DIR posterior deve usar seu próprio diretório de execução. DPO
Preparando dados de preferências DPO
O DPO requer duas respostas candidatas sob o mesmo contexto. O experimento usa o subconjunto helpful_base_cn do conjunto de dados HH-RLHF em chinês, onde context armazena o histórico de conversas, chosen armazena a resposta preferida e rejected armazena a resposta não preferida. As designações de preferida e não preferida vêm das etiquetas do conjunto de dados e não indicam que os fatos nas respostas foram verificados individualmente.
Converter para o formato de dados usado pelo ms-swift.
A estrutura de amostras de preferências usada pelo ms-swift é a seguinte. Abaixo são mostrados apenas os relacionamentos dos campos — o conteúdo real é lido do conjunto de dados:
Comparado com as amostras SFT de 【Uso rápido do ms-swift para concluir o ajuste fino leve de modelos open-source】, aqui foi adicionado rejected_response. A última mensagem do assistente em messages armazena a resposta preferida, e a resposta não preferida fica em um campo separado. As mensagens históricas do assistente em conversas multi-turno ainda pertencem ao contexto e não devem ser confundidas com as respostas desta comparação. A função de conversão no Notebook é a seguinte:
def convert_dpo(row):
    role_map = {
        "human": "user", "user": "user",
        "assistant": "assistant", "system": "system"
    }
    context = [
        {"role": role_map[m["role"]], "content": m["text"].strip()}
        for m in row["context"]
    ]
    chosen = row["chosen"]["text"].strip()
    rejected = row["rejected"]["text"].strip()

    assert context and context[-1]["role"] == "user"
    assert chosen and rejected and chosen != rejected
    assert all(m["content"] for m in context)
    if context[0]["role"] != "system":
        context.insert(0, {"role": "system", "content": GENERAL_SYSTEM})

    return {
        "messages": context + [{"role": "assistant", "content": chosen}],
        "rejected_response": rejected,
    }
Limpar e dividir os dados.
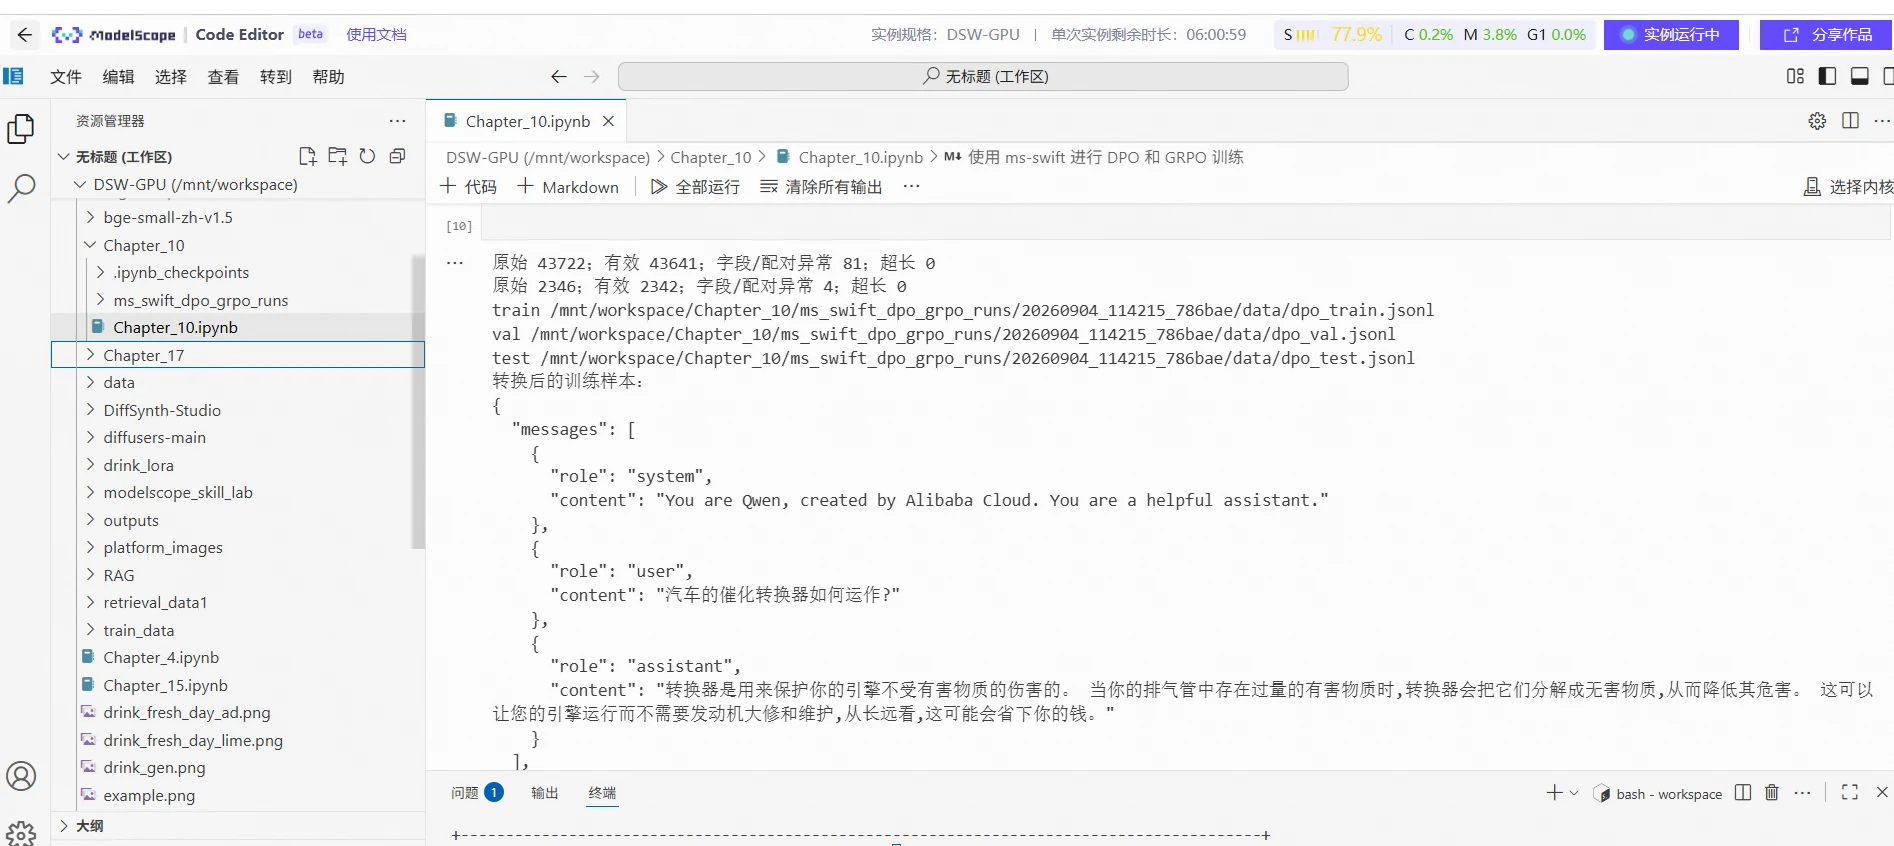
Neste experimento, calculamos separadamente o comprimento das respostas preferida e não preferidas após concatenação com o contexto, mantendo apenas as amostras onde ambas não excedem 1024 Tokens. Quando excedem, o par inteiro é descartado para evitar que o truncamento remova acidentalmente o conteúdo-chave que determina a superioridade da resposta. Em seguida, deduplicamos por contexto e dividimos 256 dados de treinamento e 32 dados de validação a partir da fonte de treinamento original. Os arquivos processados são dpo_train.jsonl, dpo_val.jsonl e dpo_test.jsonl, salvos na pasta data do diretório de execução. Os três arquivos desempenham funções diferentes: o conjunto de treinamento é usado para atualizar parâmetros, o conjunto de validação para observar o processo de treinamento, e o conjunto de teste para comparação independente após o treinamento. Os resultados de execução relevantes são mostrados na figura abaixo.
Iniciando o treinamento DPO
Antes do treinamento, primeiro registre o desempenho no conjunto de teste usando o modelo inicial. O dpo_evaluate() no Notebook calculará a log-probabilidade das respostas para 32 pares de candidatos fixos e gerará respostas para 4 deles, para comparação após o treinamento:
def dpo_evaluate(adapter=None):
    def action(model):
        rows = []
        for index, row in enumerate(dpo_test):
            context = row["messages"][:-1]
            lp_chosen = response_logp(model, context, row["messages"][-1]["content"])
            lp_rejected = response_logp(model, context, row["rejected_response"])
            rows.append({"sample_id": index, "chosen_logp": lp_chosen,
                         "rejected_logp": lp_rejected, "gap": lp_chosen - lp_rejected})
        # Apenas 4 são geradas para leitura detalhada, os demais pares de candidatos ainda participam do diagnóstico de probabilidade.
        generations = [{"sample_id": i, "context": dpo_test[i]["messages"][:-1],
                        "response": generate_one(model, dpo_test[i]["messages"][:-1])}
                       for i in range(min(4, len(dpo_test)]
        return rows, generations
    return with_local_model(action, adapter)

dpo_before, dpo_before_text = dpo_evaluate()
Os passos para iniciar o treinamento DPO são os seguintes:
Configurar parâmetros de treinamento.
Os dois experimentos reutilizam a configuração comum através de common_options(), incluindo o caminho local do modelo, template de conversação Qwen, semente aleatória, precisão bfloat16 e configuração LoRA. O LoRA rank é 8, alpha é 16 e o módulo alvo é all-linear. Abaixo está a configuração completa do experimento DPO — a função comum precisa ser executada primeiro no Notebook correspondente. A função common_options() combina os parâmetros comuns com os parâmetros deste experimento. train_swift converte esses parâmetros em formato de linha de comando e realiza o treinamento do modelo através de swift.cli.rlhf via Python do kernel atual.
O significado dos principais parâmetros é o seguinte:
Parâmetro
Valor
Descrição
rlhf_type / loss_type
dpo
Tipo de algoritmo de treinamento
learning_rate
1e-5
Taxa de aprendizado
num_train_epochs
3
Número de épocas de treinamento
per_device_train_batch_size
4
Tamanho do batch por dispositivo
lora_rank
8
Rank do LoRA
lora_alpha
16
Alpha do LoRA
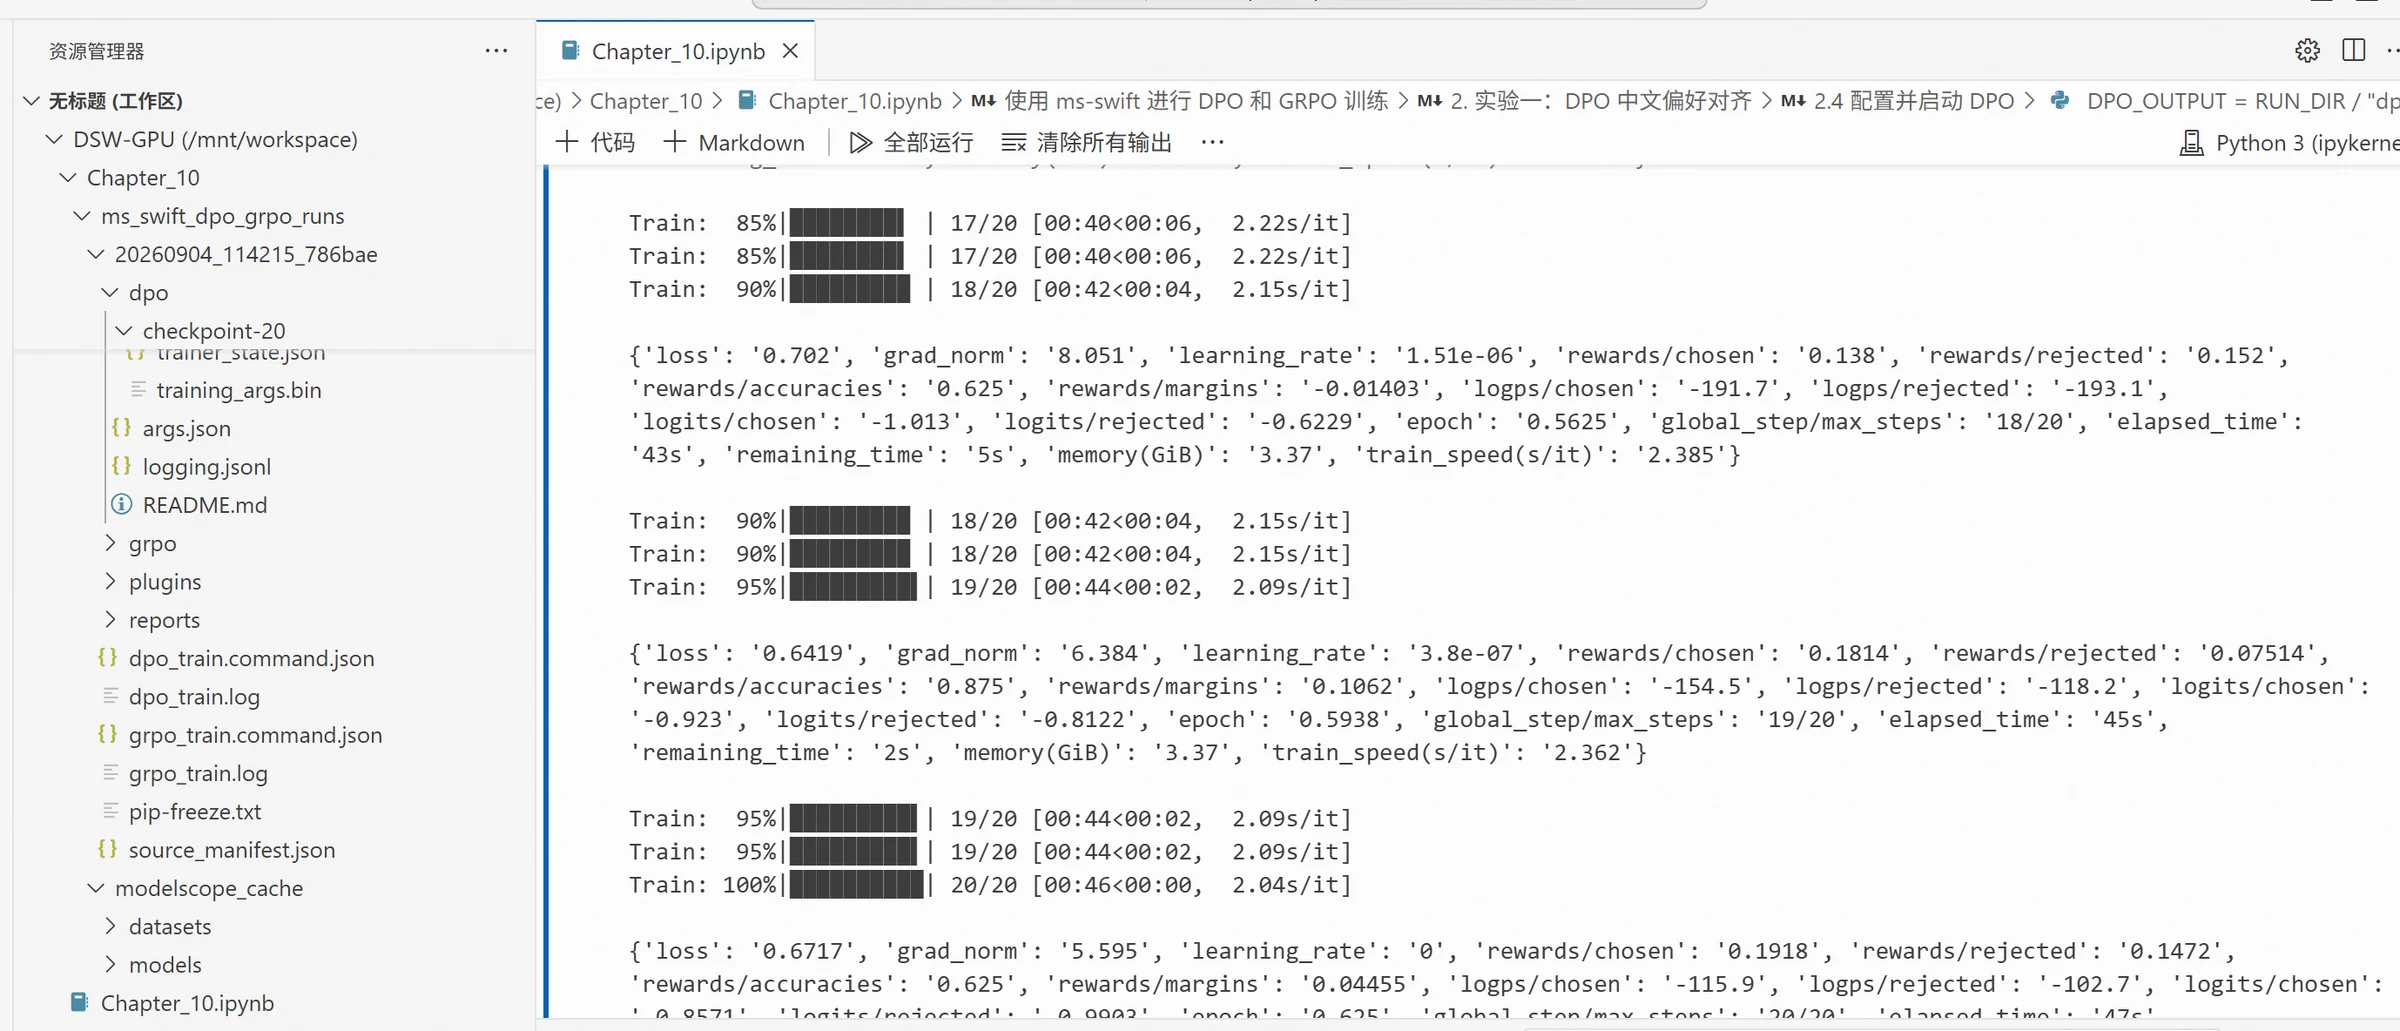
Verificar a saída do treinamento.
Após o início do treinamento, o ms-swift sairá as perdas, recompensas implícitas, métricas de validação e o local de salvamento do checkpoint.
As rewards/chosen e rewards/rejected no log são recompensas implícitas calculadas com base na diferença de log-probabilidade entre a política e a política de referência — não são pontuações de qualidade de resposta dadas por algum modelo de recompensa externo. rewards/accuracies indica a proporção da ordenação de recompensas implícitas que corresponde às etiquetas de preferências, e não pode ser interpretada diretamente como a taxa de acerto das respostas geradas pelo modelo. Os resultados de execução do log relevantes são mostrados na figura abaixo.
Comparando resultados antes e depois do treinamento DPO
Após carregar o adaptador DPO, avalie novamente usando os mesmos dados de teste. Ao comparar, mantenha o prompt do sistema, template de conversação e parâmetros de geração consistentes, evitando confundir mudanças no prompt ou método de decodificação com efeitos de treinamento.
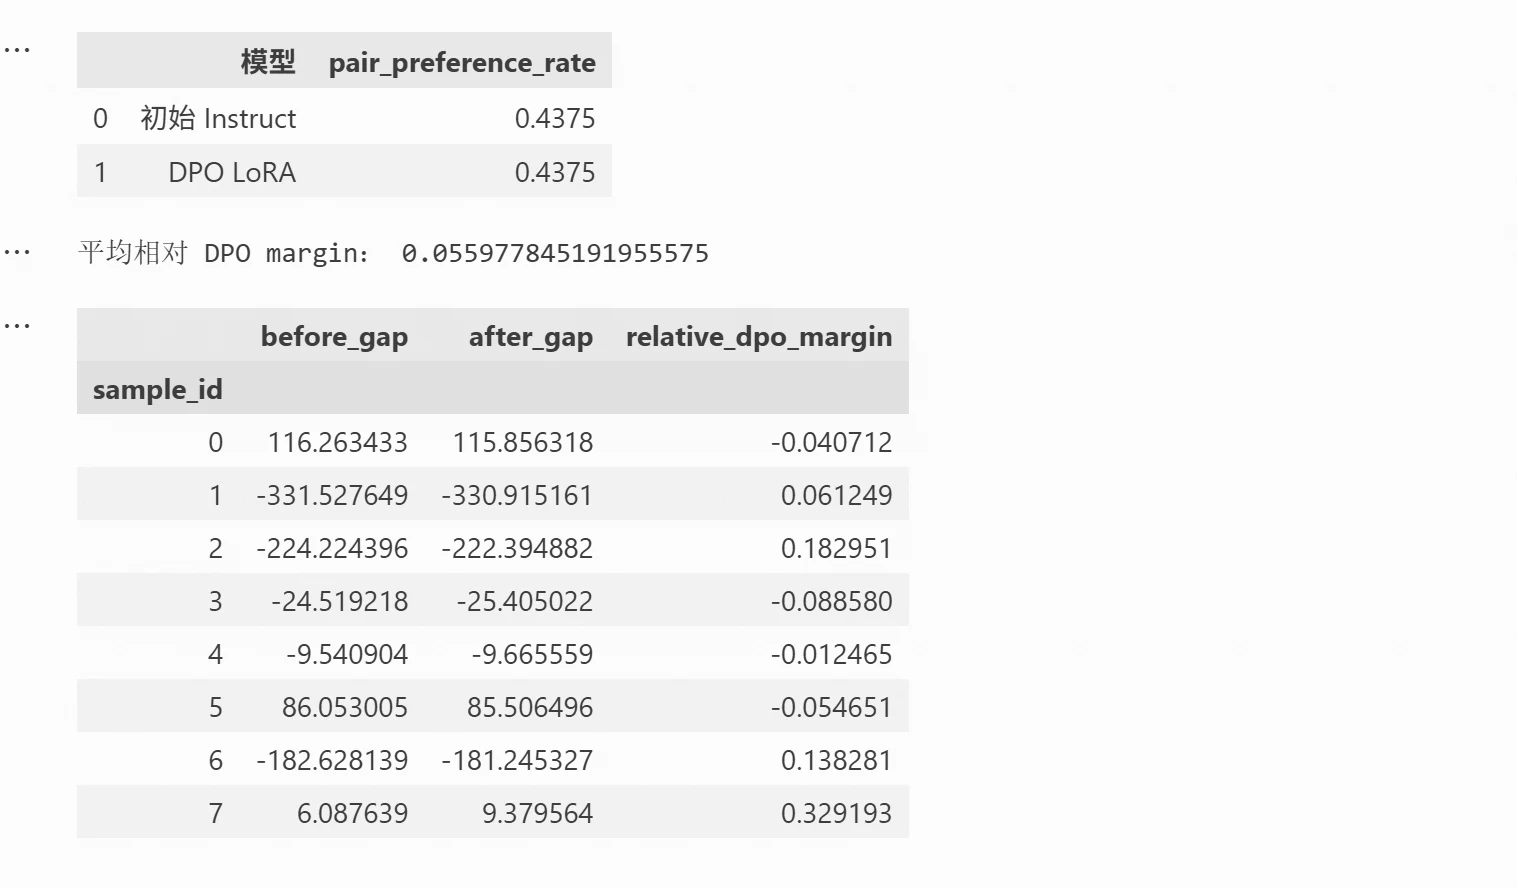
Aqui, gap é igual à log-probabilidade da sequência da resposta preferida menos a log-probabilidade da sequência da resposta não preferida. Um gap maior que 0 indica que o modelo atual tem maior probabilidade de sequência para a resposta preferida dada. A proporção de amostras de teste que satisfazem esta condição resulta no pair_preference_rate.
Os resultados deste teste são mostrados na figura abaixo:
Devido ao número reduzido de épocas de treinamento, a diferença de algumas amostras pode aumentar, mas ainda não mudou de negativa para positiva — algumas amostras melhoraram e outras pioraram. Portanto, uma margem relativa média positiva nem sempre aumenta a proporção de amostras onde a resposta preferida é superior. Neste experimento, essa proporção foi de 43.75% antes e depois do treinamento. Usando como exemplo um usuário do conjunto de teste perguntando sobre o sinal da rede doméstica:
Usuário: Que métodos posso usar para reforçar o sinal da minha rede doméstica? Meu notebook tem dificuldade para conectar ao roteador de rede!
A resposta do modelo inicial contém o seguinte conteúdo, reproduzido originalmente:
Da saída completa, a resposta inicial sugere mais a troca ou adição de dispositivos, enquanto após o treinamento as respostas são mais organizadas em torno de configurações de rede, drivers e reinicialização, indicando que o treinamento alterou o conteúdo gerado. O treinamento DPO deste experimento alterou as probabilidades relativas de alguns candidatos fixos e parte das respostas geradas, mas limitado pelo escopo de treinamento e dados, os leitores podem usar dados em escala maior e mais épocas de treinamento para replicar o experimento.
Preparando dados e função de recompensa para GRPO
O DPO usa duas respostas já fornecidas nos dados, enquanto o GRPO requer que o modelo gere respostas candidatas durante o treinamento, que são então avaliadas pela função de recompensa. Este experimento usa problemas matemáticos do GSM8K, com o número final e o formato de saída como feedback verificável automaticamente, sem treinar um modelo de recompensa separadamente.
Separar as perguntas das respostas padrão.
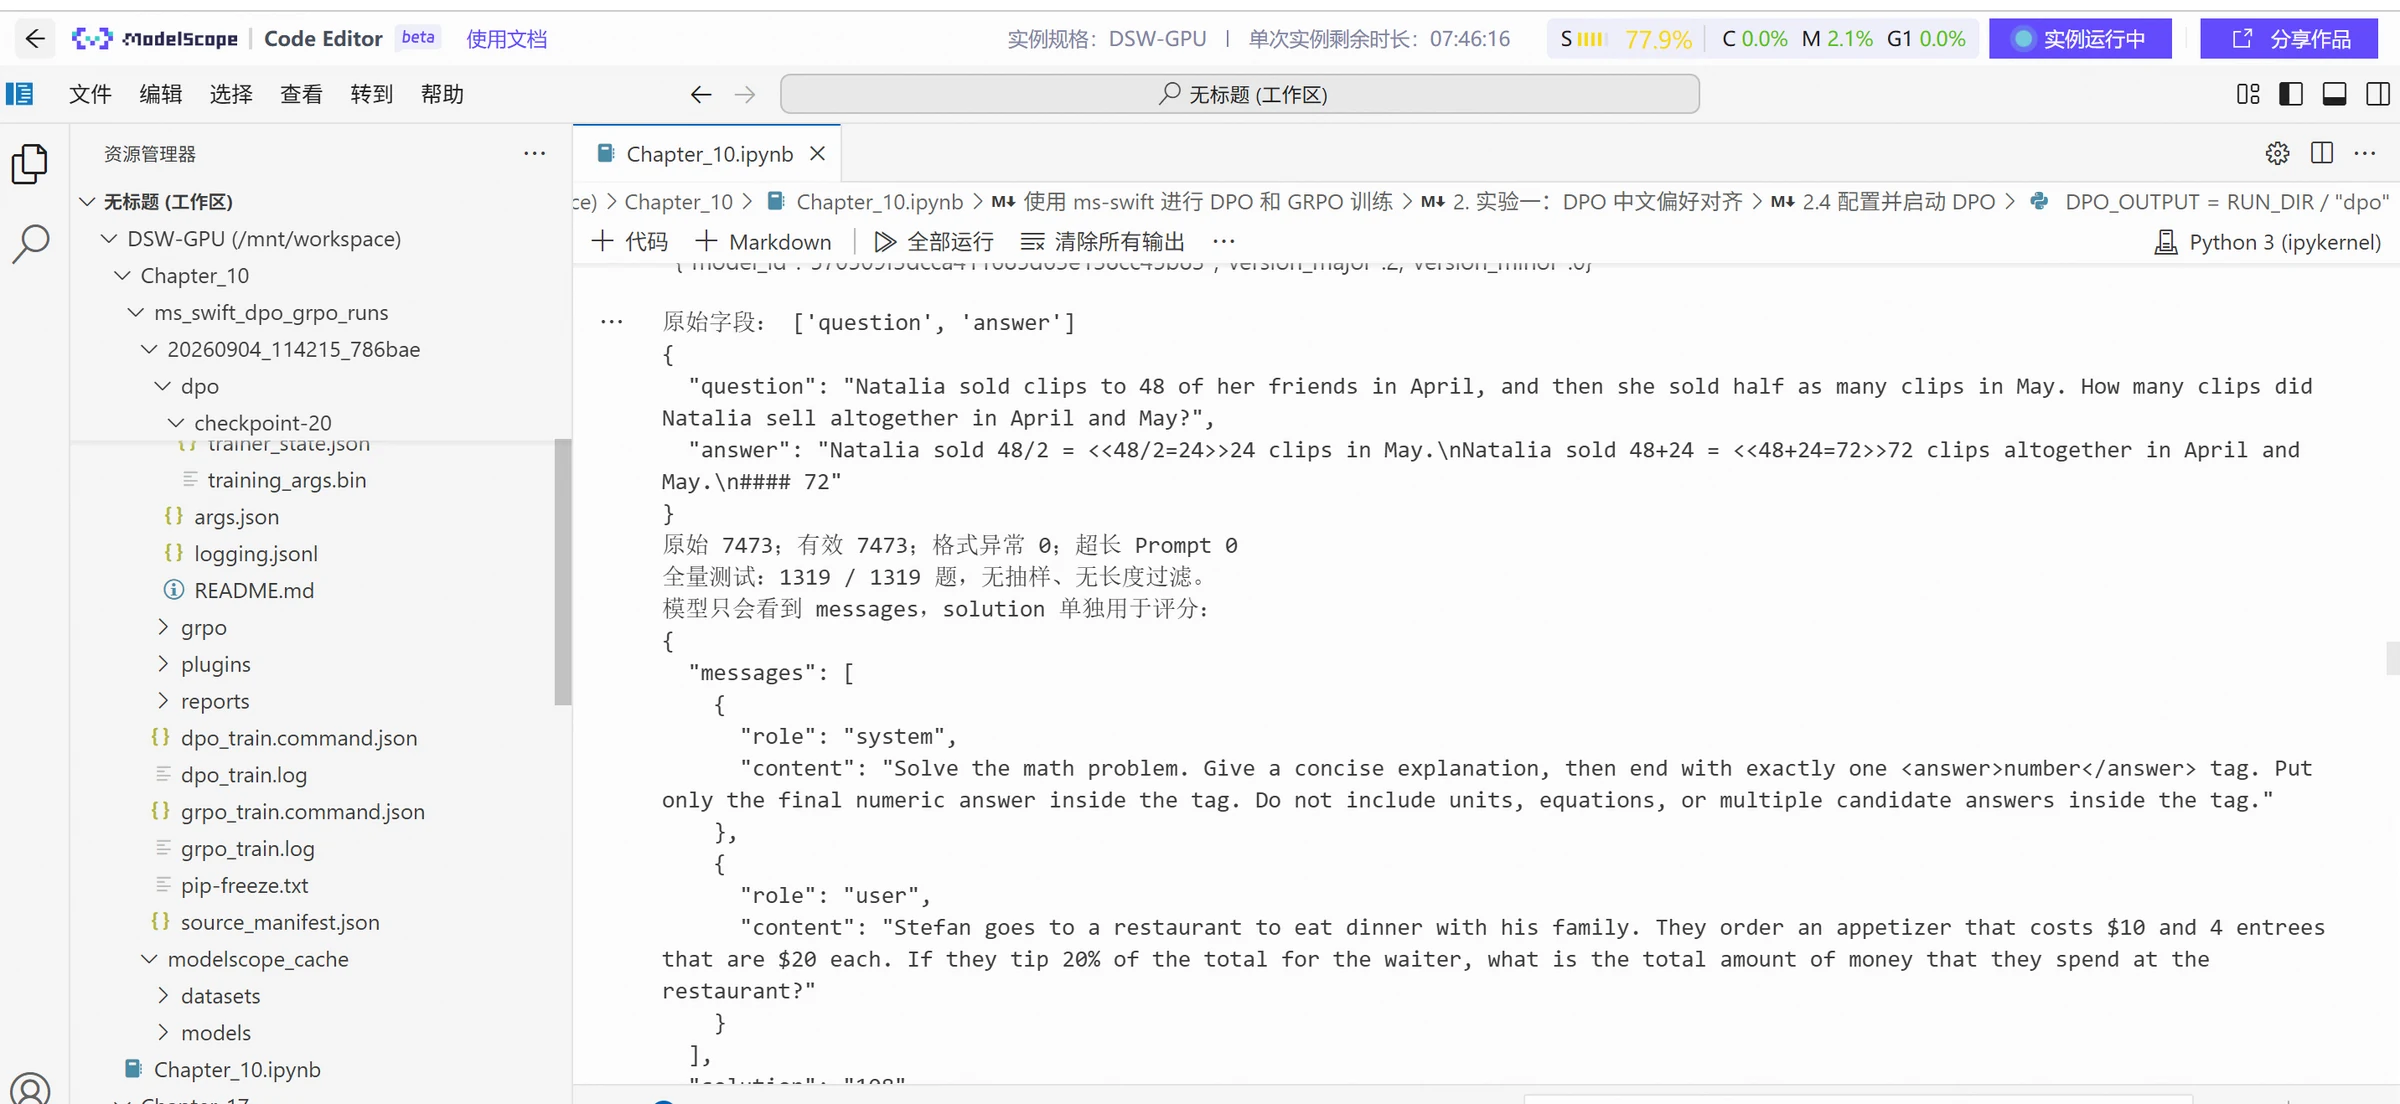
Os dados originais do GSM8K contêm dois campos: question e answer. O answer contém tanto o processo de resolução quanto o número final localizado após ####. Durante a conversão, apenas a pergunta é fornecida ao modelo e o número final é extraído para o campo solution. O código relevante é o seguinte:
def convert_grpo(row):
    question = row["question"].strip()
    original_answer = row["answer"].strip()
    assert question and "####" in original_answer
    answer = parse_numeric(original_answer.rsplit("####", 1)[-1])
    assert answer is not None
    return {
        "messages": [
            {"role": "system", "content": MATH_SYSTEM},
            {"role": "user", "content": question},
        ],
        "solution": str(answer),
    }
As messages convertidas não contêm o processo de resolução padrão nem respostas do assistente para o modelo imitar. O solution é fornecido como coluna de dados adicional à função de recompensa, sem ser concatenado ao Prompt. Assim, durante o treinamento, o modelo precisa gerar as respostas por conta própria, e o programa de pontuação as compara com as respostas padrão. Neste experimento, limpamos, dedivisamos e dividimos 128 perguntas de treinamento e 16 de validação a partir da fonte original. O limite de comprimento para Prompts de treinamento e validação é 512 Tokens. O teste usa todas as 1319 perguntas do arquivo de teste oficial, mantendo a ordem original, sem excluir perguntas com base no limite de comprimento de treinamento, e verificando se há sobreposição com os dados de treinamento e validação. Os resultados de execução relevantes são os seguintes:
Definir recompensas de acurácia e formato.
A recompensa total deste experimento é:
Recompensa Total = Recompensa de Acurácia + 0.1 × Recompensa de Formato
A recompensa de acurácia exige que a saída do modelo esteja no formato de etiqueta especificado e que o número na etiqueta seja igual ao solution — quando atendido, vale 1, caso contrário, 0. A recompensa de formato verifica apenas se a etiqueta é única, se está localizada no final da resposta e se o conteúdo pode ser analisado como um número — quando atendido, vale 1, caso contrário, 0. O código relevante é o seguinte:
def extract_answer(completion):
    if not isinstance(completion, str):
        return None
    if completion.count("<answer>") != 1 or completion.count("</answer>") != 1:
        return None
    match = re.search(r"<answer>\s*([^<>]+?)\s*</answer>\s*\Z", completion)
    return parse_numeric(match.group(1) if match else None

class Chapter10Accuracy(ORM):
    def __call__(self, completions, solution, **kwargs):
        if len(completions) != len(solution):
            raise ValueError("候选回答与 solution 数量不匹配。")
        rewards = []
        for text, gold in zip(completions, solution):
            expected = parse_numeric(gold)
            if expected is None:
                raise ValueError(f"标准答案格式无效:{gold!r}")
            predicted = extract_answer(text)
            rewards.append(float(predicted is not None and predicted == expected)
        return rewards

class Chapter10Format(ORM):
    def __call__(self, completions, **kwargs):
        return [float(extract_answer(text) is not None) for text in completions]
Entre eles, é um grupo de respostas geradas pelo modelo, é a resposta padrão correspondente fornecida pelo treinador.
As classes de recompensa também precisam ser registradas. Os plugins de recompensa usados pelo treinador neste experimento são:
O Notebook salva o plugin completo como plugins/chapter10_rewards.py, que depois é especificado através de external_plugins, e os nomes de registro acima são especificados através de reward_funcs. O plugin deve conter suas próprias importações e funções auxiliares, pois será carregado independentemente no subprocesso de treinamento. O método de registro pode ser consultado no exemplo oficial de plugin de recompensa do ms-swift 4.4.2.
Primeiro verifique a função de recompensa e depois inicie o treinamento.
A seguir estão os resultados do cálculo de recompensa para alguns exemplos:
Saída do Modelo
Resposta Padrão
Recompensa de Corretude
Recompensa de Formato
Recompensa Total
The answer is 12.
12
0
0
0
<answer>12</answer>
12
1
1
1.1
<answer>15</answer>
12
0
1
0.1
De acordo com o método de cálculo da função de recompensa adotado neste experimento, o texto comum The answer is 12. embora contenha o número correto, não atende ao requisito de formato, portanto a recompensa estrita de acurácia continua sendo 0. Múltiplas etiquetas de resposta também não passam na verificação, evitando que o modelo obtenha recompensa por enumerar respostas.
Iniciando o treinamento GRPO e observando os logs
Após concluir a preparação dos dados e da função de recompensa, realize a configuração e as tarefas de treinamento do experimento correspondente.
Configurar o grupo de geração e parâmetros de treinamento.
Este experimento gera 4 respostas candidatas para a mesma pergunta, com o lote de geração também definido como 4, portanto um lote de geração corresponde aos 4 candidatos de 1 pergunta. Em seguida, cada mini-lote de treinamento processa 1 candidato, acumulando 4 mini-lotes para atualizar os parâmetros uma vez.
A seguir está a configuração do experimento GRPO. As configurações relevantes GRPO_PATHS, PLUGIN_PATH e seu conteúdo.
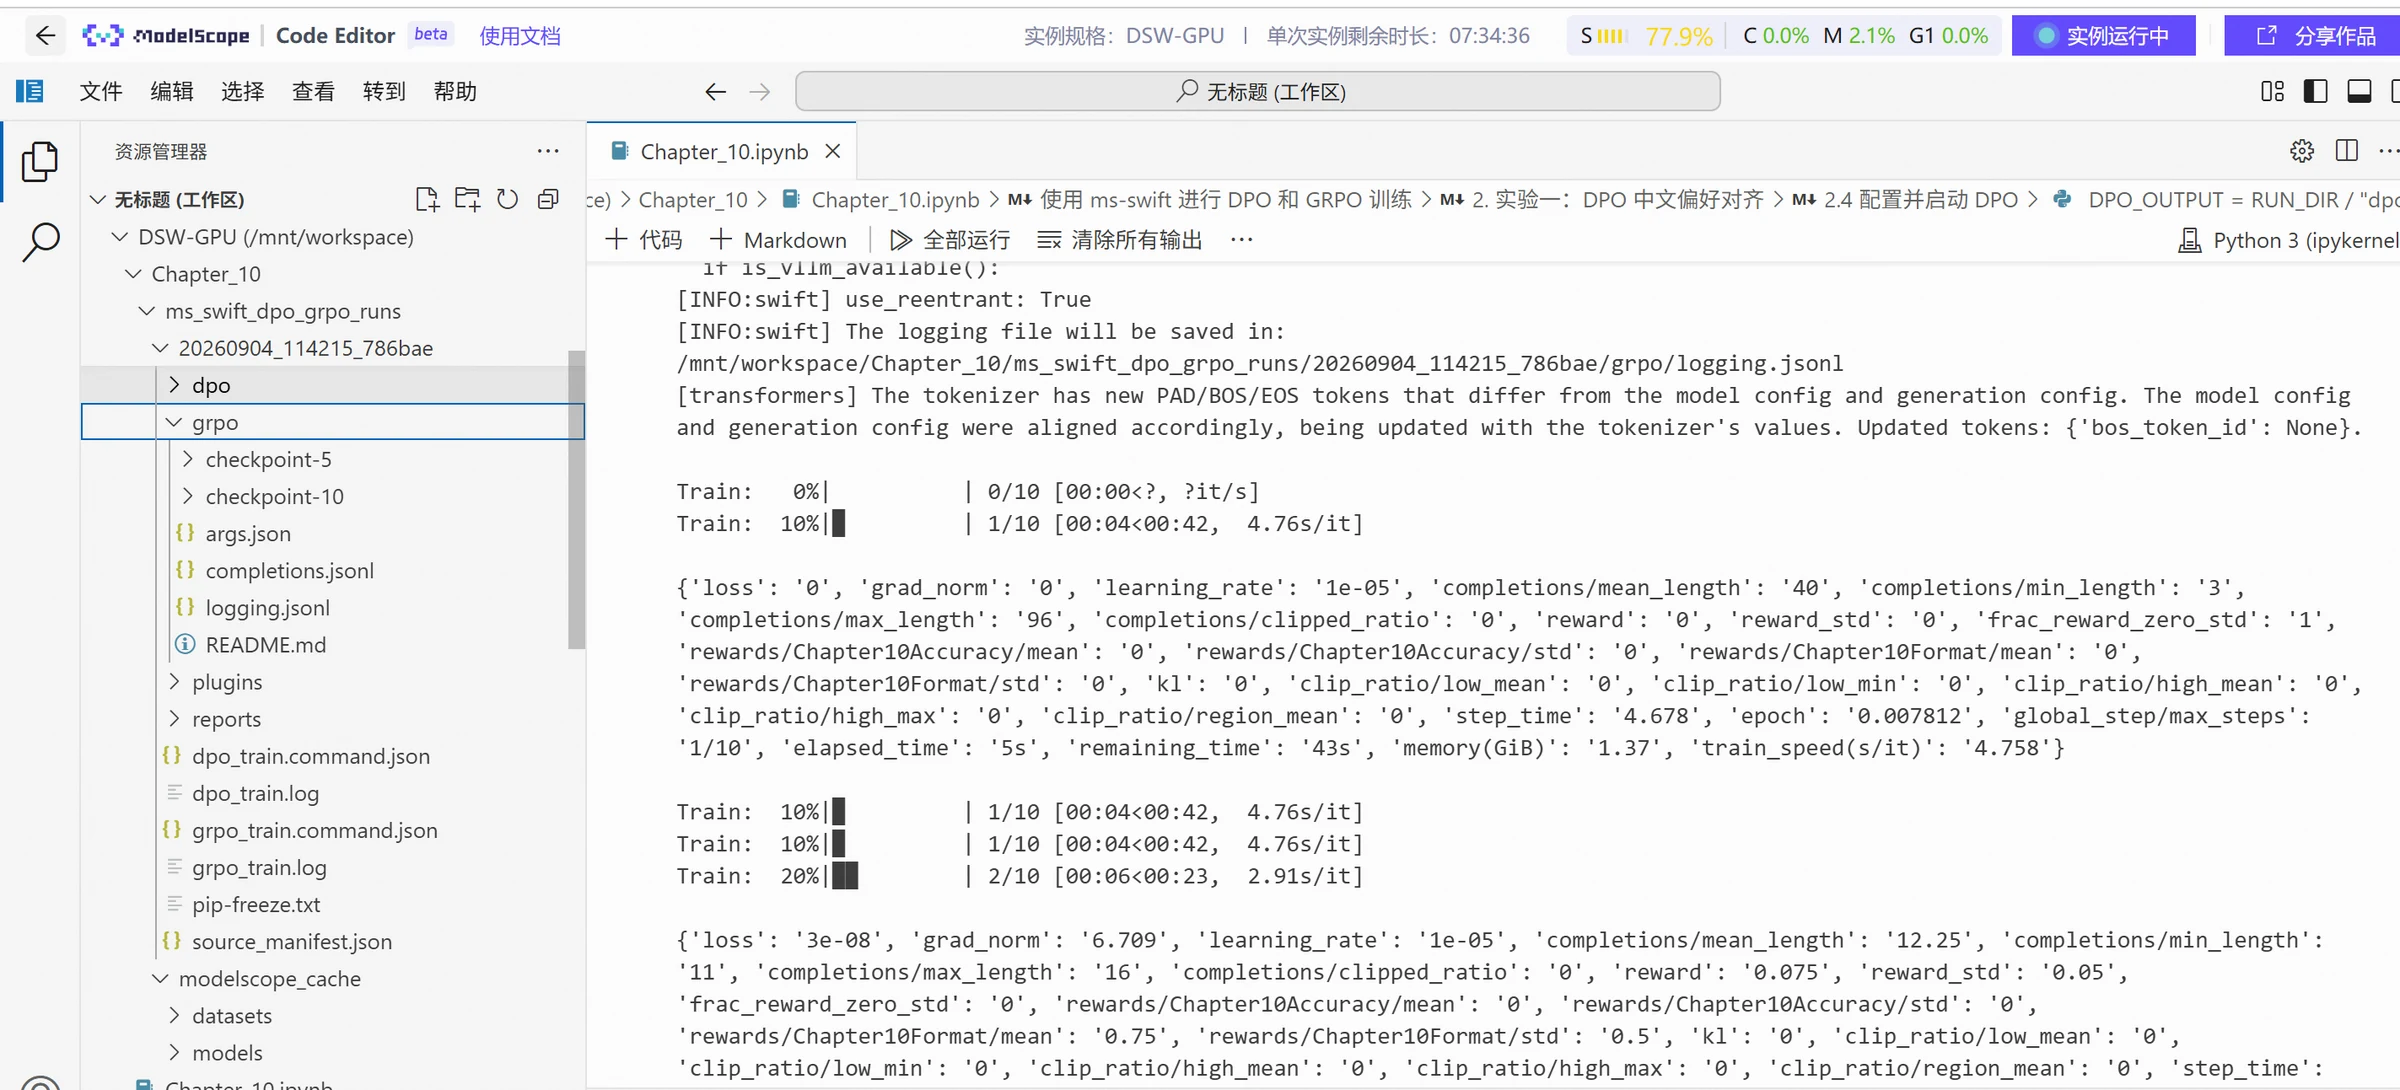
O tamanho do grupo e o lote de geração precisam ser configurados em conjunto. O lote de geração deve ser divisível pelo tamanho do grupo e também deve ser divisível pelo resultado do mini-lote de treinamento por placa vezes o número de processos GPU. Neste caso, é placa única com processo único — lote de geração 4, tamanho do grupo 4 e mini-lote de treinamento 1 satisfazem essas condições; durante a validação, o lote e o tamanho do grupo também são 4. Se o tamanho do grupo for ajustado, deve-se verificar simultaneamente o lote de geração, a acumulação de gradiente de treinamento e a configuração de validação. Este treinamento completou 10 passos e salvou grpo/checkpoint-10.
Ler os logs de treinamento.
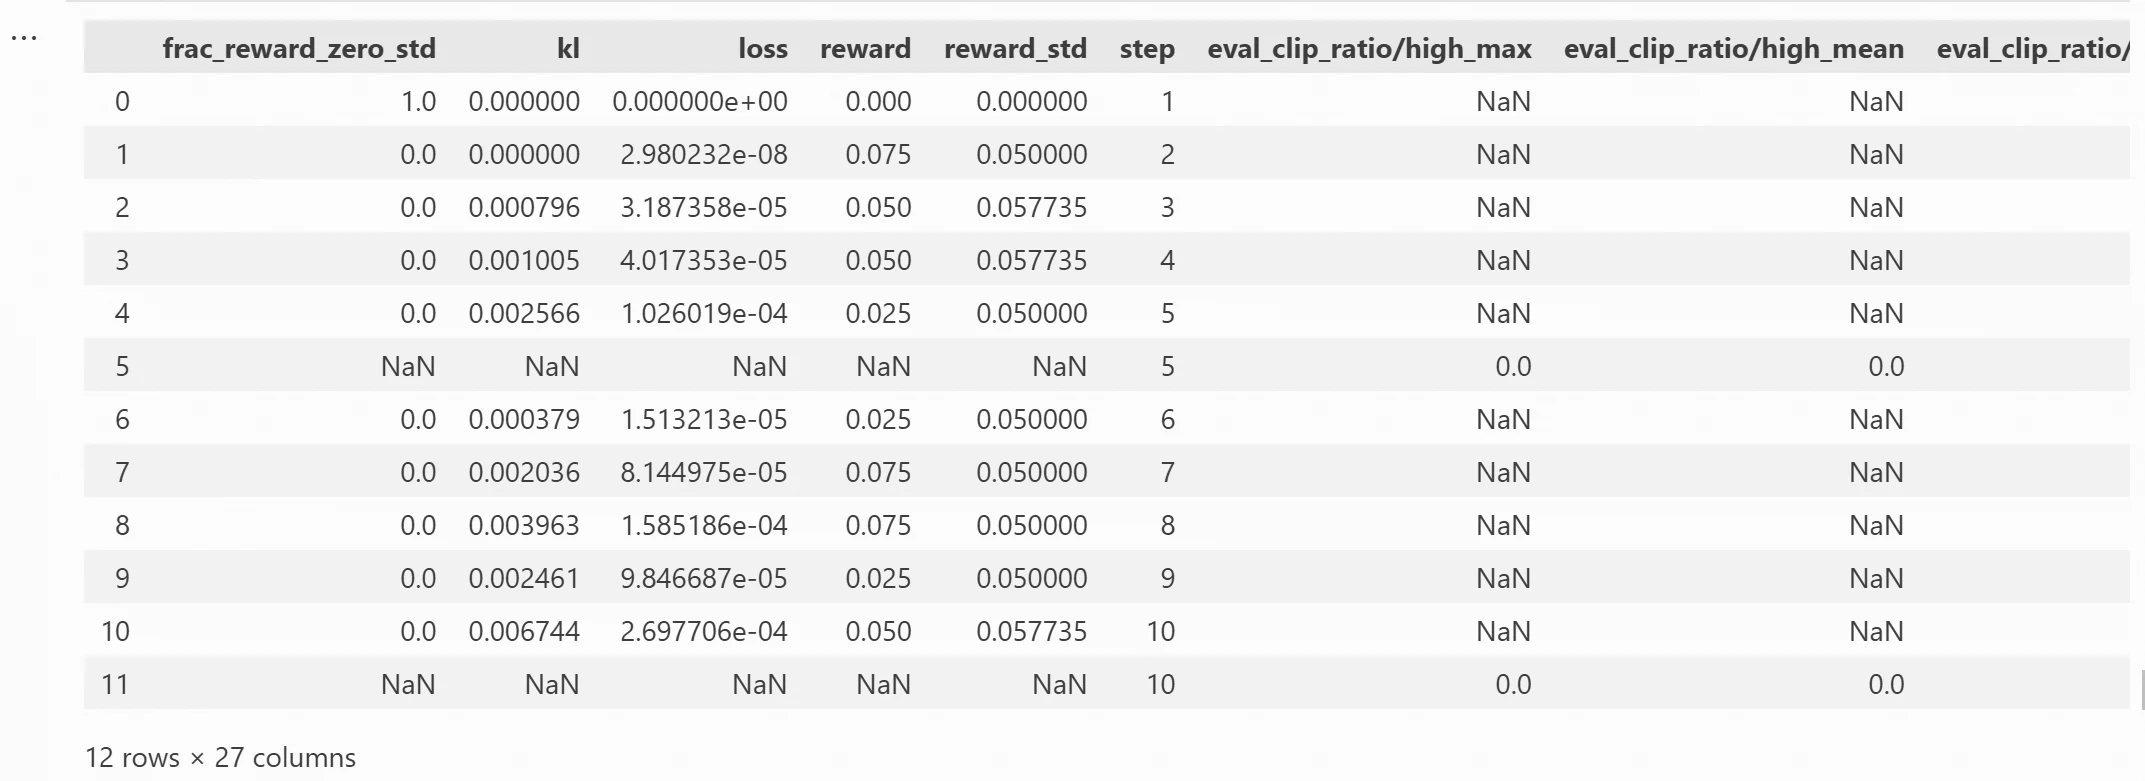
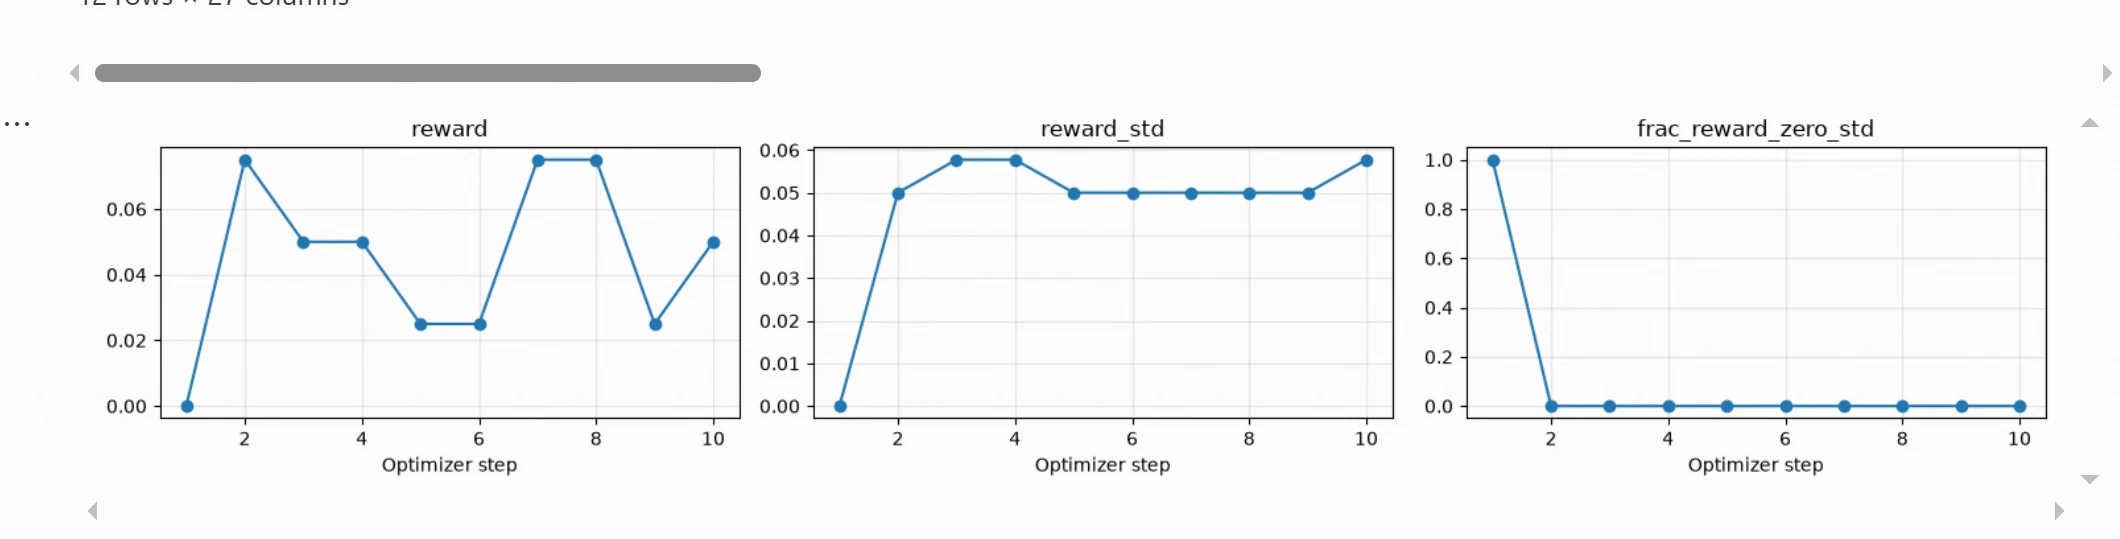
A perda de treinamento do GRPO não é a taxa de acerto em problemas matemáticos. Ao observar o treinamento, a recompensa total, os componentes de recompensa e as diferenças dentro do grupo devem ser analisados juntos. O reward no log representa a recompensa agregada atual, reward_std é usado para observar as diferenças de recompensa dentro do grupo e frac_reward_zero_std representa a proporção de grupos cujo desvio padrão da recompensa dentro do grupo é zero. A visualização dos resultados estatísticos de treinamento relevantes é mostrada na figura abaixo:
Na figura, pode-se ver que diferenças não-zero de recompensa dentro do grupo começam a aparecer a partir do 2º passo de treinamento, e a proporção de empates cai para 0, indicando que a função de recompensa já é capaz de distinguir diferentes respostas candidatas, fornecendo sinais de otimização eficazes para o GRPO. Este experimento realizou apenas 10 passos de treinamento, a recompensa de acurácia é relativamente dispersa e a taxa de acerto em matemática ainda não aumentou — subsequentemente, pode-se aumentar as épocas de treinamento para que o modelo tenha contato com mais perguntas e respostas candidatas, e observar o efeito do treinamento em conjunto com o conjunto de validação pode ser mais evidente.
Avaliação completa e análise de resultados
Os logs de treinamento refletem os candidatos amostrados durante o processo de treinamento — no final, ainda é necessário comparar o desempenho do modelo com um conjunto de teste independente. Cada pergunta gera apenas uma resposta, o que não constitui uma avaliação onde múltiplas amostragens aleatórias são feitas para escolher a melhor resposta.
Os resultados iniciais são salvos pelo grpo_evaluate() antes do treinamento. Após o treinamento, o adaptador GRPO é passado e os resultados nas mesmas perguntas são agregados. Abaixo estão trechos do código de avaliação e agregação — o Notebook também verifica se os números das amostras, perguntas e respostas padrão correspondem um a um.
grpo_after = grpo_evaluate(GRPO_ADAPTER)
grpo_summary = pd.DataFrame([
    {
        "模型": name,
        "严格答案正确率": np.mean([r["correct"] for r in rows]),
        "答对题数": int(sum(r["correct"] for r in rows),
        "格式有效比例": np.mean([r["format_ok"] for r in rows]),
        "格式合格题数": int(sum(r["format_ok"] for r in rows),
        "平均总奖励": np.mean([r["total_reward"] for r in rows]),
        "测试题数": len(rows),
    }
    for name, rows in [
        ("初始 Instruct", grpo_before), ("GRPO LoRA", grpo_after)
    ]
])
display(grpo_summary)
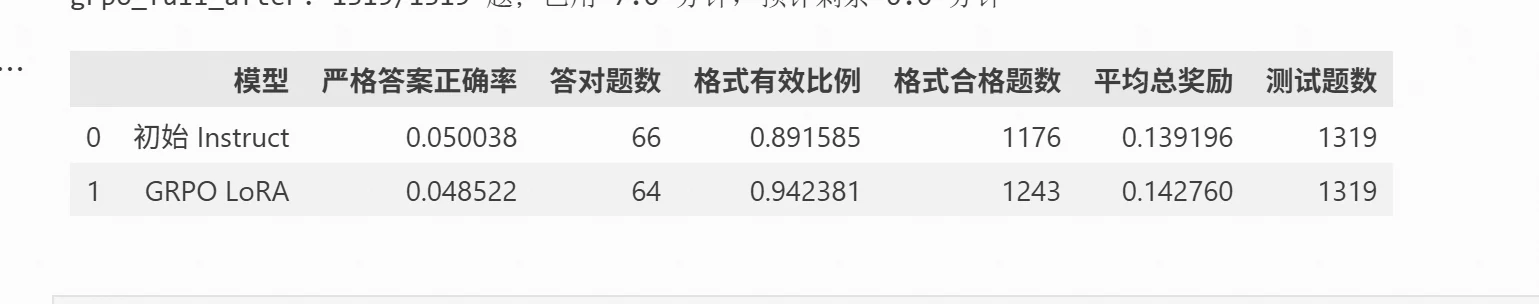
Os resultados da avaliação completa deste experimento são os seguintes:
Combinando os resultados da avaliação completa acima, a proporção de formato válido do modelo aumentou de 89.16% para 94.24%, refletindo o papel deste treinamento na padronização do formato de saída. Experimentos e treinamentos subsequentes podem ajustar ainda mais a dificuldade das perguntas ou o design da recompensa, para que os resultados futuros possam obter feedback mais completo de acurácia das respostas.
Todos os dados experimentais e código deste capítulo podem ser consultados em: https://modelscope.cn/gallery/liucong/8a5fefc5-6f90-42df-9a09-bc9781ed3da8