AIUnlimited
🌳

AI పునాదులు

🌱
AI Seeds

సున్నా నుండి ప్రారంభించండి

🌿
AI Sprouts

పునాదులు నిర్మించండి

🌳
AI Branches

ఆచరణలో అన్వయించండి

🏕️
AI Canopy

లోతుగా వెళ్ళండి

🌲
AI Forest

AI లో నిపుణత సాధించండి

🔨

AI నైపుణ్యం

✏️
AI Sketch

సున్నా నుండి ప్రారంభించండి

🪨
AI Chisel

పునాదులు నిర్మించండి

⚒️
AI Craft

ఆచరణలో అన్వయించండి

💎
AI Polish

లోతుగా వెళ్ళండి

🏆
AI Masterpiece

AI లో నిపుణత సాధించండి

📘

AI ఆచరణ

📖
ఓపెన్-సోర్స్ మోడల్స్ అర్థం చేసుకోవడం

ఓపెన్-సోర్స్ మోడల్స్ ప్రాథమికాలు మరియు వనరులు

🎯
సమస్య నుండి మోడల్ టాస్క్‌కు

వ్యాపార సమస్యలను మోడల్ టాస్క్‌లుగా మార్చడం

⚡
మీ మొదటి మోడల్ నడపడం

30 నిమిషాల్లో మీ మొదటి ఫలితాలను చూడండి

🔧
ఫైన్-ట్యూనింగ్ మరియు మూల్యాంకనం

మోడల్స్ ఫైన్-ట్యూన్ చేసి పనితీరును మూల్యాంకనం చేయండి

🚀
అప్లికేషన్ సిస్టమ్‌లు

వాస్తవ AI అనువర్తనాలను నిర్మించండి

🎨
జనరేటివ్ AI

ఓపెన్-సోర్స్ AIGC మోడల్స్ అన్వేషించండి

🤖
ఏజెంట్లు

ఏజెంట్ ఫ్రేమ్‌వర్క్‌లు మరియు MCP టూల్స్ నేర్చుకోండి

📐
సప్లిమెంటరీ ప్రాథమికాలు

LLM ప్రాథమికాలు మరియు మూల్యాంకనం

🎓

Claude Academy

🤖
Claude 101

Learn AI basics with Claude

💻
Claude Code 101

Code with Claude as your pair programmer

🤝
Introduction to Claude Cowork

Collaborate with Claude on complex projects

⚙️
Claude Platform 101

Build apps with the Claude API

ల్యాబ్

7 ప్రయోగాలు లోడ్ అయ్యాయి
🧬Neural Network Playground🤖AI లేదా మనిషి?🥋Prompt Engineering Dojo🏁Algorithm Race🧠AI ట్రివియా ఛాలెంజ్🏗️సిస్టమ్ డిజైన్ క్యాన్వాస్
🎯మాక్ ఇంటర్వ్యూల్యాబ్‌లోకి వెళ్ళండి→
🚀

కెరీర్ అభివృద్ధి

🚀
ఇంటర్వ్యూ లాంచ్‌ప్యాడ్

మీ ప్రయాణం ప్రారంభించండి

🌟
ప్రవర్తనా ఇంటర్వ్యూ నైపుణ్యం

సాఫ్ట్ స్కిల్స్ నేర్చుకోండి

💻
సాంకేతిక ఇంటర్వ్యూలు

కోడింగ్ రౌండ్ విజయం సాధించండి

🤖
AI & ML ఇంటర్వ్యూలు

ML ఇంటర్వ్యూ నైపుణ్యం

🏆
ఆఫర్ & అంతకు మించి

అత్యుత్తమ ఆఫర్ పొందండి

నేర్చుకోవడం ప్రారంభించండి
AIUnlimited

MIT లైసెన్స్

沪ICP备18025655号-11

నేర్చుకోండి

  • AI ప్రాథమికాలు
  • AI ఆచరణ
  • Claude Academy
  • ల్యాబ్
  • కెరీర్ అభివృద్ధి

సంఘం

  • మా గురించి
  • తరచుగా అడిగే ప్రశ్నలు

మద్దతు

  • footer.terms
  • footer.privacy
  • footer.contact
AI & ఇంజనీరింగ్ ప్రోగ్రామ్‌లు›📖 ఓపెన్-సోర్స్ మోడల్స్ అర్థం చేసుకోవడం›పాఠాలు›Data: The Foundation of Fine-Tuning
📊
ఓపెన్-సోర్స్ మోడల్స్ అర్థం చేసుకోవడం • ప్రారంభకుడు⏱️ 12 నిమిషాల పఠన సమయం

Data: The Foundation of Fine-Tuning

డేటా: ఓపెన్ సోర్స్ మోడల్ ఫైన్-ట్యూనింగ్ యొక్క పునాది

కోడింగ్ మరియు గణితంలో అద్భుతంగా పనిచేసే, కానీ ప్రతిరోజూ ప్రశ్నలకు యాదృచ్ఛికంగా సమాధానం ఇచ్చే మోడల్‌ను ఎదుర్కొన్నారా?

మనందరికీ తెలుసు, శిక్షణ సమయంలో నిర్దిష్ట సామర్థ్యాన్ని మెరుగుపరచాలంటే ఆ రకమైన డేటాను కనుగొనాలి,

కానీ చాలా డేటాసెట్లు నేరుగా ఇంటర్నెట్ శోధనలో కనుగొనడం కష్టం. ఏకీకృత డౌన్‌లోడ్ పోర్టల్ శిక్షణదారులకు చాలా శ్రమను ఆదా చేస్తుంది.

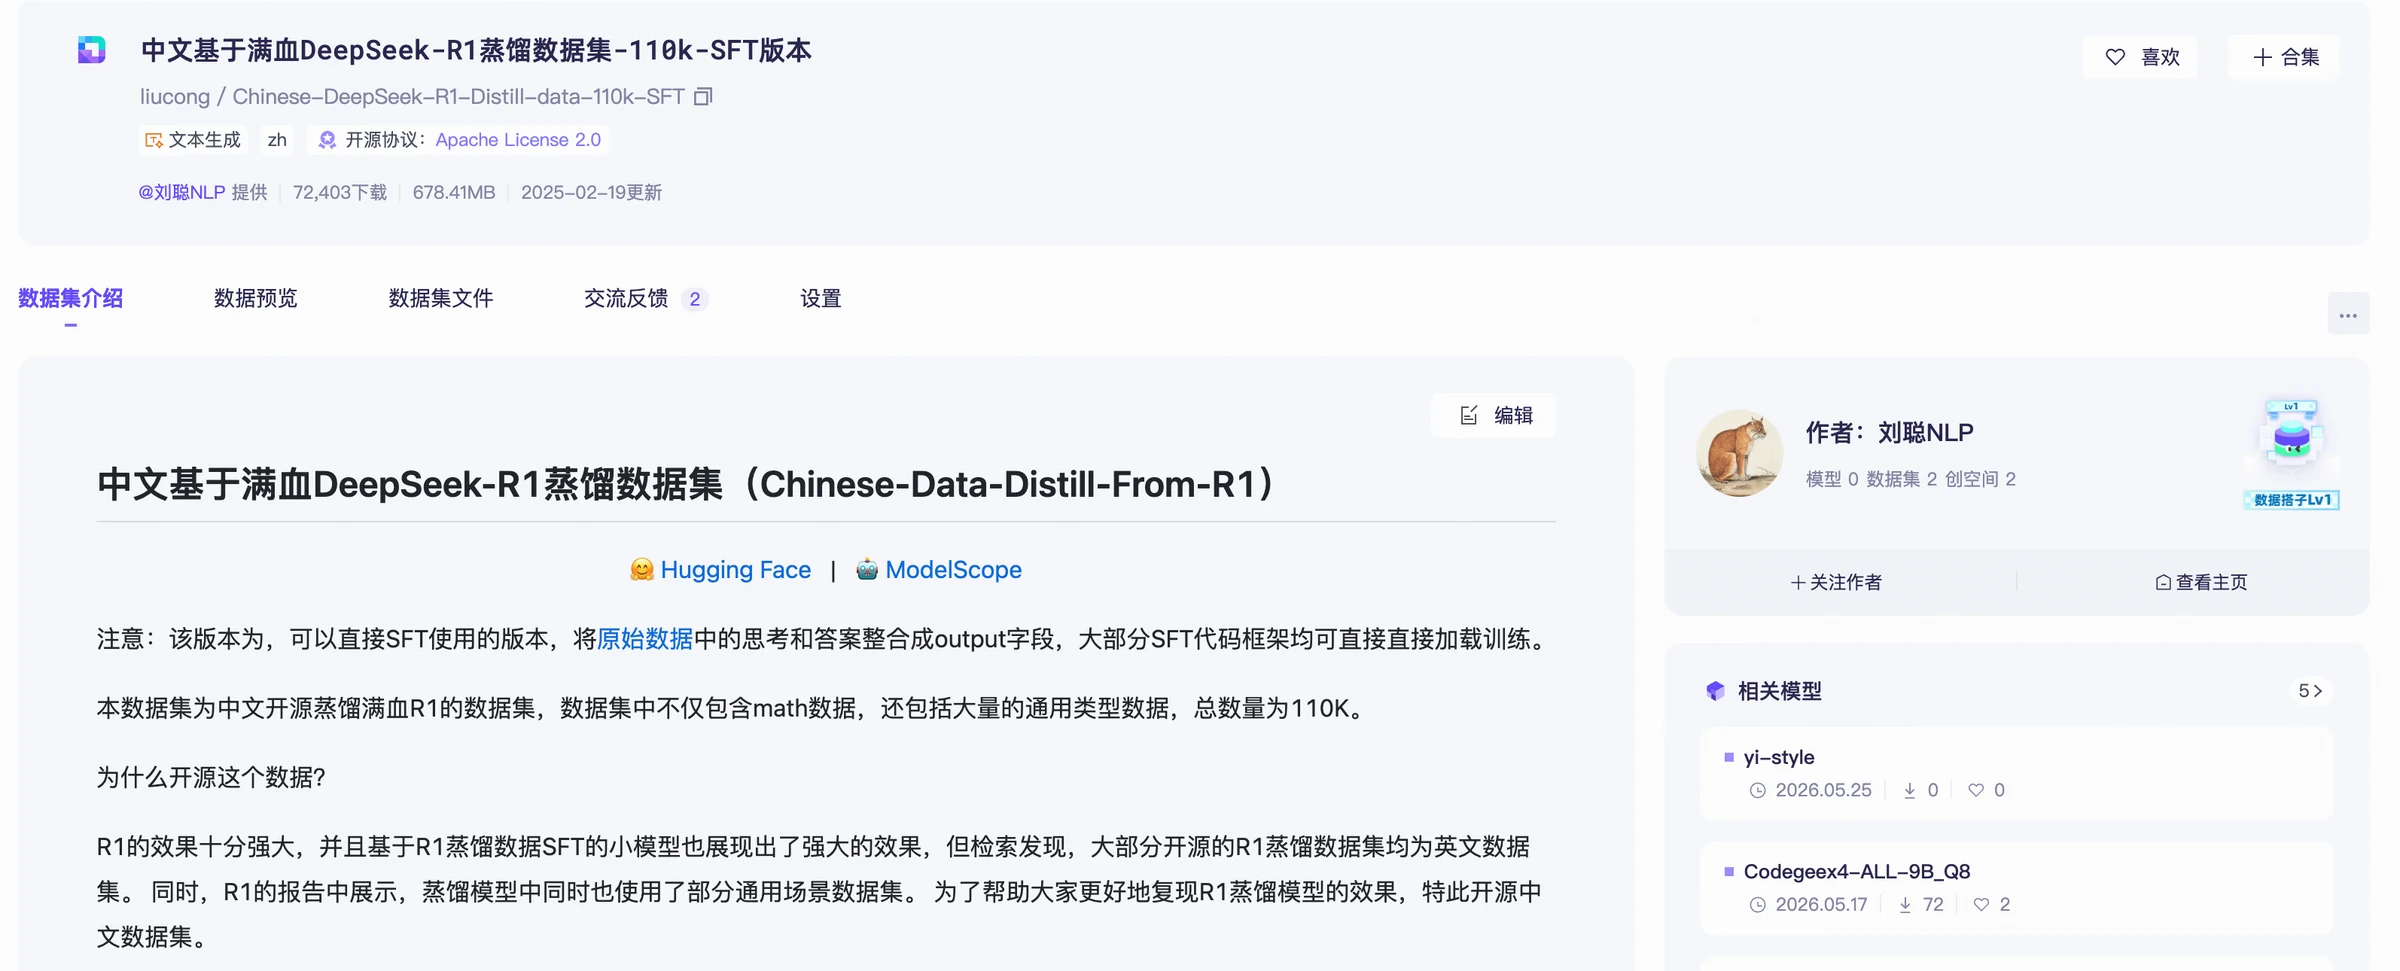
ఉదాహరణకు, మా చైనీస్ DeepSeek-R1 డిస్టిల్డ్ డేటాసెట్ ముడి డేటాలో చాలా భాగం ModelScope నుండి నేరుగా డౌన్‌లోడ్ చేయబడింది,

చిత్రం

మోడల్ ఫైన్-ట్యూనింగ్ ఉన్న ఓపెన్ సోర్స్ డేటాసెట్ నుండి ప్రారంభించవచ్చు, పూర్తి ప్రక్రియను వేగంగా నడపవచ్చు.

డేటా కనుగొనడం, ముందుగా మీరు ఏమి చేయాలని ప్లాన్ చేస్తున్నారో తెలుసుకోండి

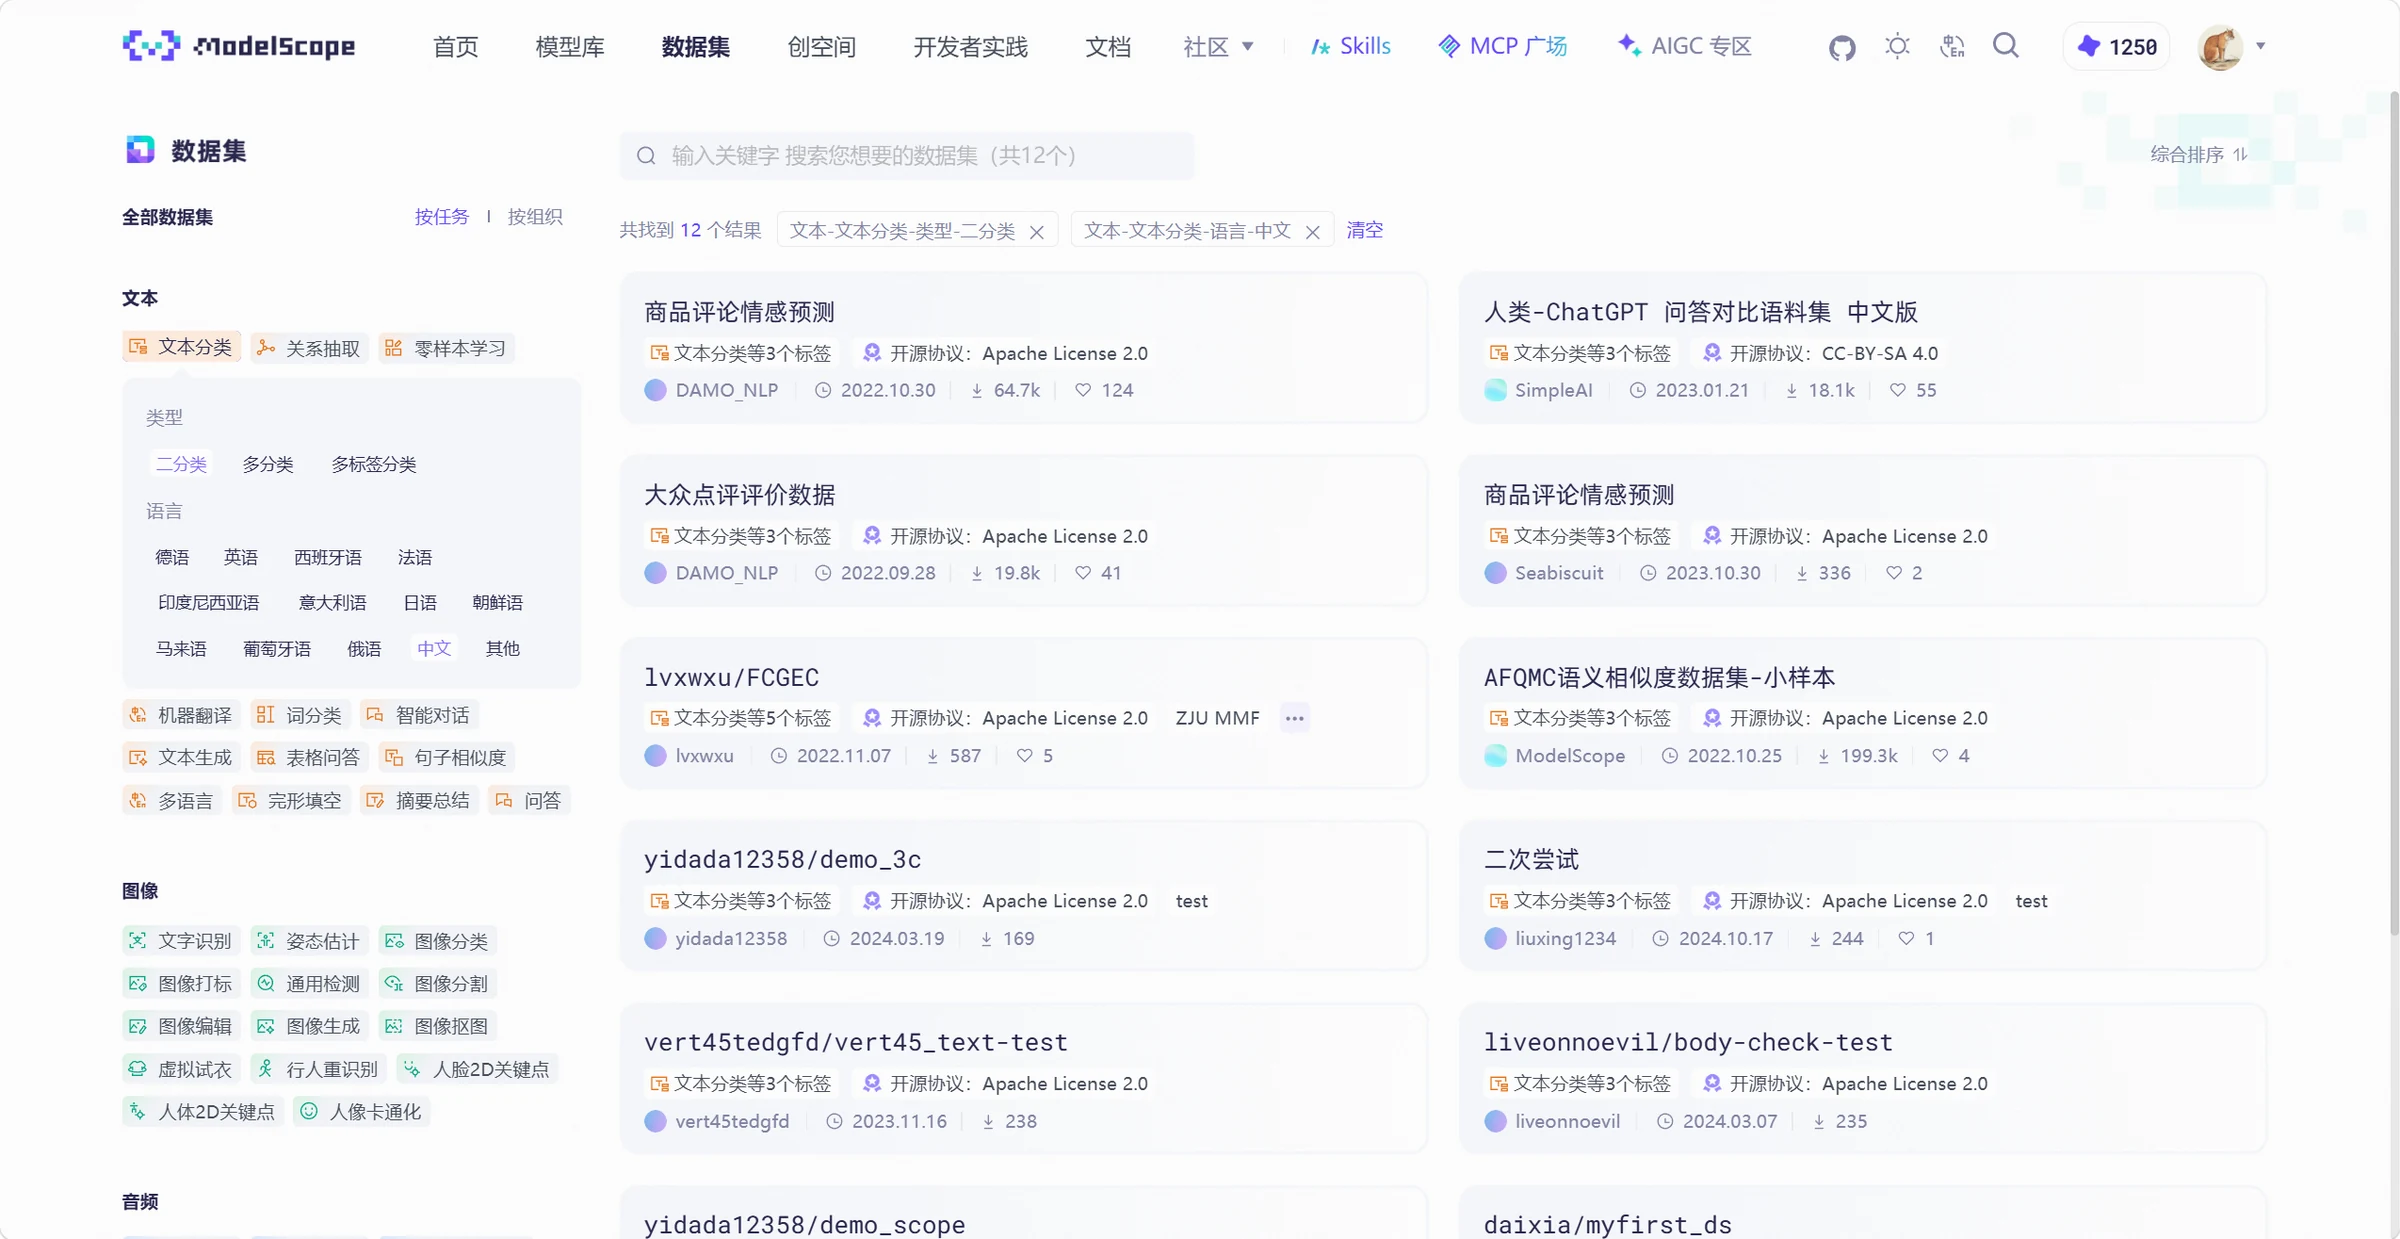
ModelScope 40,000 కంటే ఎక్కువ ఓపెన్ సోర్స్ డేటాసెట్లను అందిస్తుంది, శోధన, ప్రివ్యూ, ఫీల్డ్ వివరణలు మరియు వెర్షన్లతో.

ModelScope కీవర్డ్ ట్యాగ్లు మరియు పని వర్గాల ప్రకారం శోధనను మద్దతు ఇస్తుంది, చైనీస్ బైనరీ టెక్స్ట్ క్లాసిఫికేషన్ డేటా వంటివి.
చిత్రం

డౌన్‌లోడ్ చేయడానికి ముందు, కొన్ని నమూనాలు చూడండి

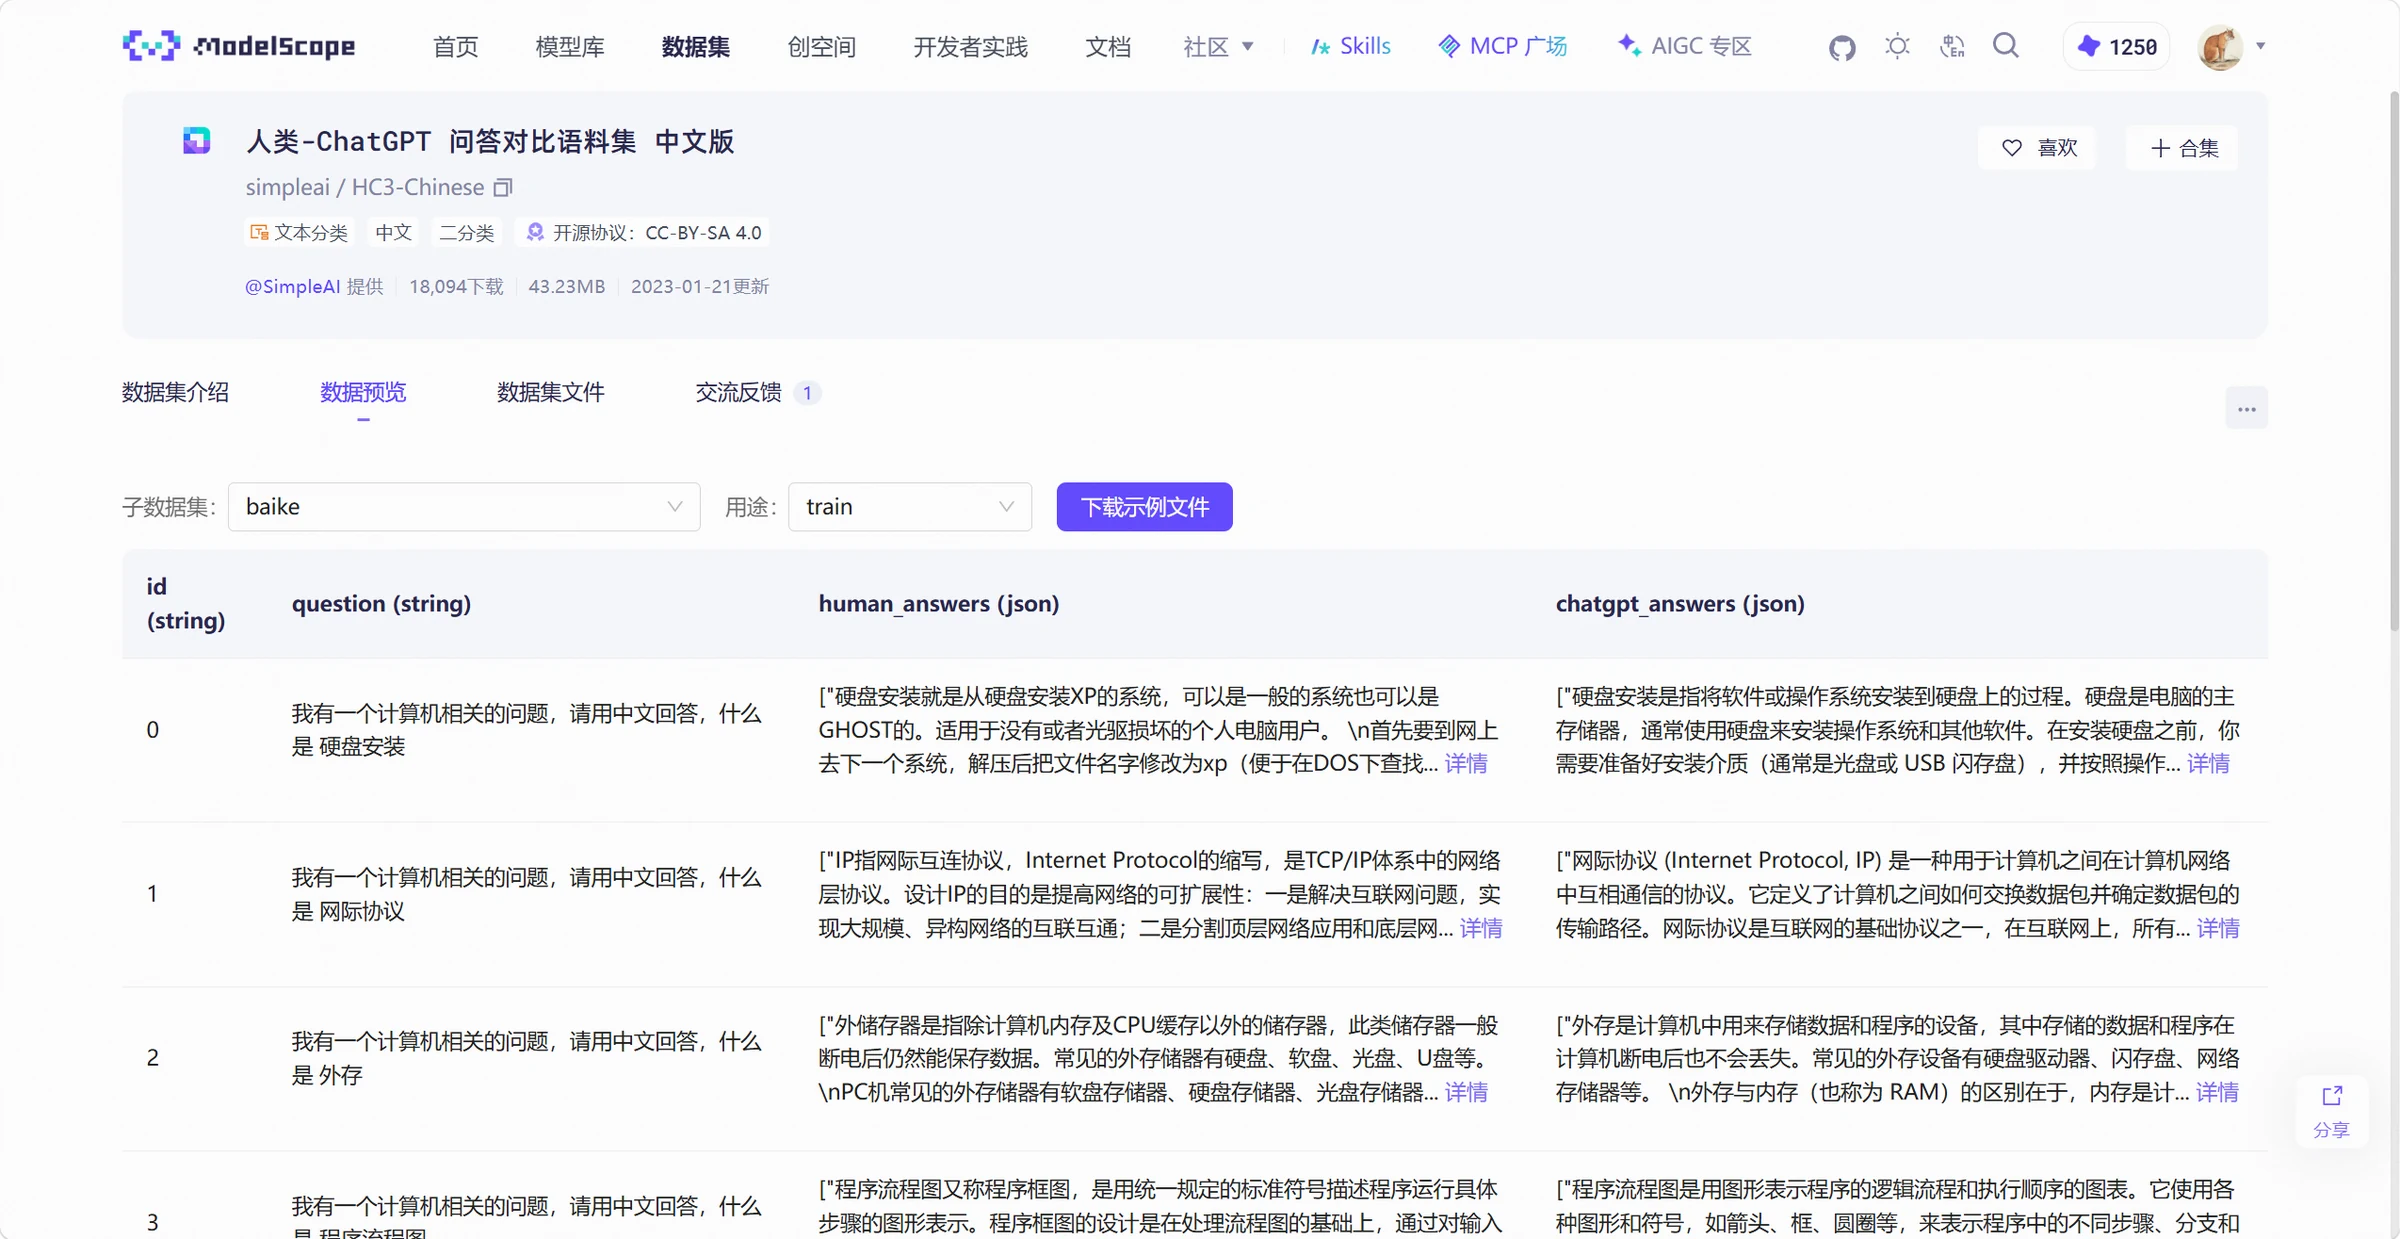
ఫిల్టర్ చేసిన తర్వాత, ఒక డేటాసెట్ ఎంచుకుని 'డేటా ప్రివ్యూ' క్లిక్ చేయండి. simpleai/HC3-Chinese వంటివి.
చిత్రం

ఏ కాలమ్ ప్రశ్న, సమాధానం, లేబుల్స్ కలిగి ఉంటుంది, మరియు ప్రతి రికార్డ్ టెక్స్ట్ లేదా సంభాషణ — ఇది ముందుగానే తనిఖీ చేయవచ్చు.

QA డేటా కోసం, మానవ మరియు మోడల్ సమాధానాలు వేర్వేరు ఫీల్డ్‌లలో ఉండవచ్చు. శిక్షణ ముందు ఏ ఫీల్డ్‌లు చదవాలో నిర్ణయించండి.

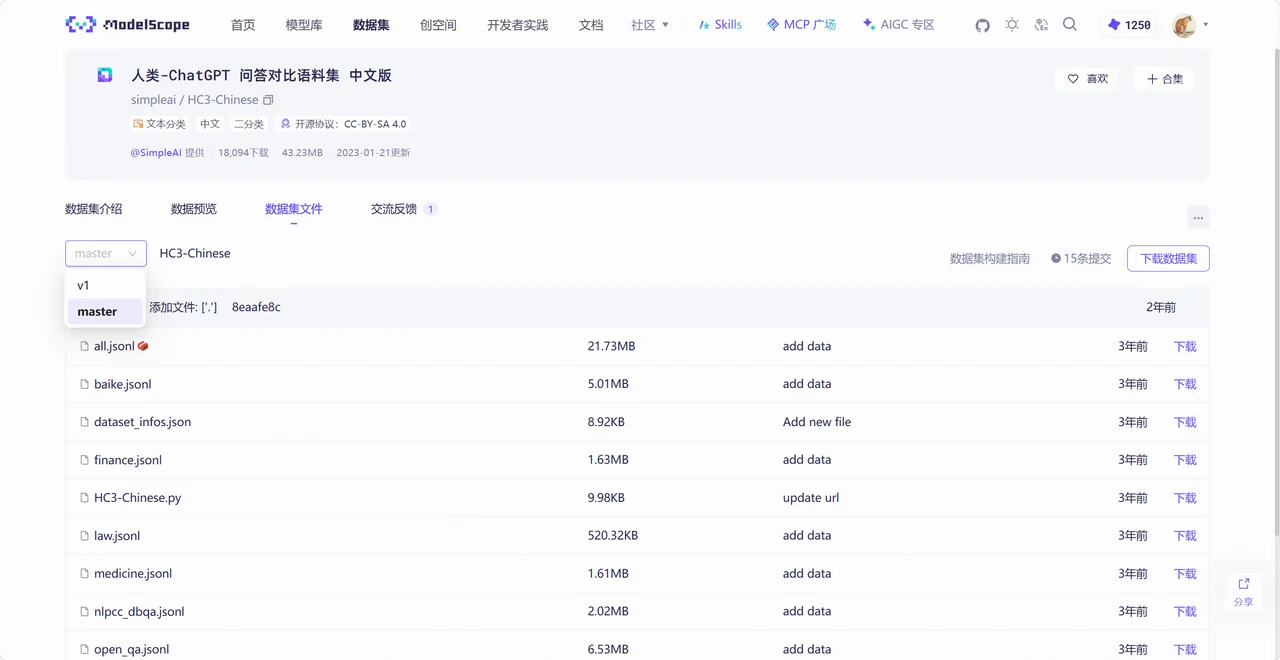
డేటాసెట్ ఫైల్స్ మరియు వెర్షన్లు చూడండి. డేటాసెట్లు అప్‌డేట్ అవుతాయి; పునరుత్పత్తి కోసం ఉపయోగించిన వెర్షన్ నోట్ చేయండి.
చిత్రం

డేటాసెట్ వివరణలు మరియు లైసెన్స్ కూడా చూడదగినవి. డౌన్‌లోడ్ చేసిన డేటా పరిశోధన, శిక్షణ లేదా వాణిజ్య ఉపయోగం కోసం వేర్వేరు అవసరాలు కలిగి ఉండవచ్చు.

మొదట డేటాను లోడ్ చేయండి, తర్వాత ఏది ఉపయోగించాలో నిర్ణయించండి

ModelScope MsDataset.load ఇంటర్‌ఫేస్ అందిస్తుంది, Python లో డేటాసెట్‌లను లోడ్ చేయవచ్చు. ఇన్‌స్టాల్ తర్వాత, డేటాసెట్ పేజీ సూచనలను అనుసరించండి.

మొదట పూర్తి డేటాసెట్ లోడ్ చేయండి

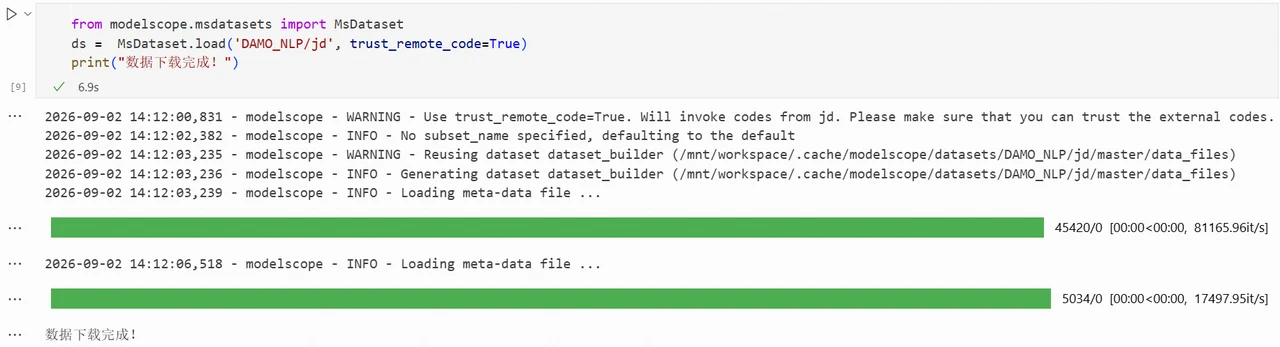
DAMO_NLP/jd ఉదాహరణగా, డిఫాల్ట్ కాన్ఫిగరేషన్ ఇలా చదవవచ్చు,

from modelscope.msdatasets import MsDataset

ds = MsDataset.load(
    'DAMO_NLP/jd',
    trust_remote_code=True,
)
print(ds)
చిత్రం
పాఠం 3 / 40% పూర్తి
←Model Discovery and Downloads

చర్చ

సైన్ ఇన్ చర్చలో చేరండి

మీకు ఒక సబ్‌సెట్ మాత్రమే కావాలంటే, పేరు స్పష్టంగా రాయండి

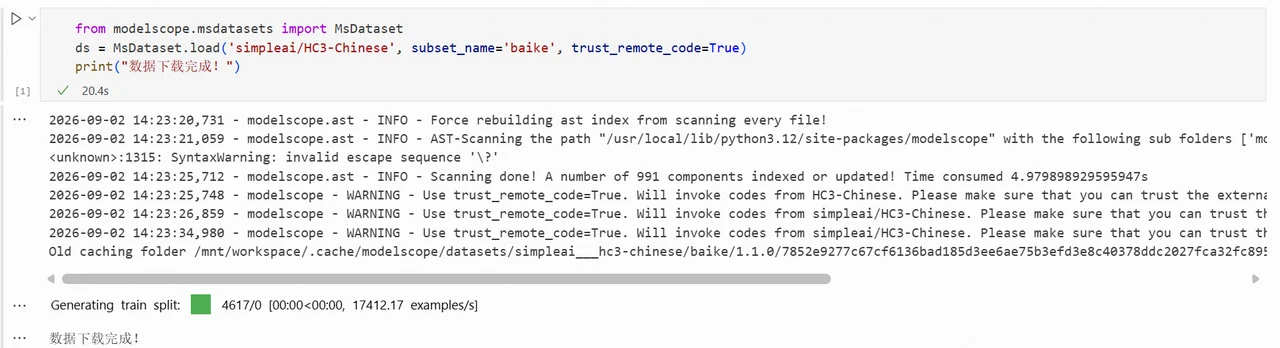
కొన్ని డేటాసెట్లు మూలం, రంగం లేదా ఉపయోగం ప్రకారం డేటాను వేరు చేస్తాయి. మీకు ఒక భాగం మాత్రమే కావాలంటే, subset_name ఉపయోగించండి.

ఉదాహరణకు, HC3-Chinese నుండి baike సబ్‌సెట్ లోడ్ చేయండి.

from modelscope.msdatasets import MsDataset

ds = MsDataset.load(
    'simpleai/HC3-Chinese',
    subset_name='baike',
    trust_remote_code=True,
)
print(ds)
చిత్రం

డేటాసెట్ మార్చేటప్పుడు, అందుబాటులో ఉన్న సబ్‌సెట్లను తనిఖీ చేయండి. baike ఈ డేటాసెట్ యొక్క ప్రత్యేక పేరు.

శిక్షణ మరియు పరీక్షా సెట్లు వేరుగా లోడ్ చేయవచ్చు

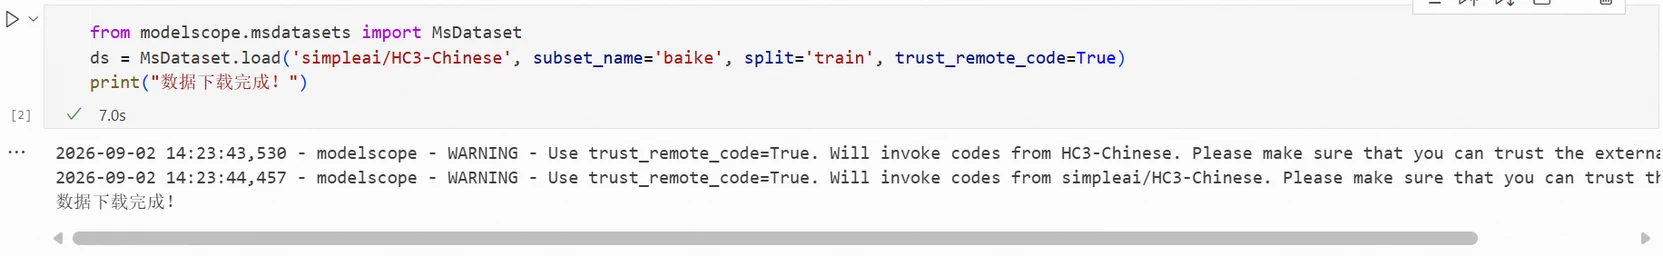
సబ్‌సెట్ డేటా వర్గాన్ని ఎంచుకుంటుంది, split డేటా విభజనను ఎంచుకుంటుంది. సాధారణంగా train, validation, మరియు test.

baike సబ్‌సెట్ నుండి శిక్షణ సెట్ మాత్రమే లోడ్ చేయాలంటే, మరొక పారామీటర్ జోడించండి.

from modelscope.msdatasets import MsDataset

ds = MsDataset.load(
    'simpleai/HC3-Chinese',
    subset_name='baike',
    split='train',
    trust_remote_code=True,
)
print(ds[0])
చిత్రం

ప్రతి డేటా కూడా ఈ మూడు విభజనలను ఏకకాలంలో అందించదు; ఖచ్చితమైన పేర్లు డేటాసెట్ వివరణలో చూడాలి. శిక్షణ సెట్ పొందిన తర్వాత, ముందుగా ఒక నమూనా ప్రింట్ చేసి, ఫీల్డ్‌లు మరియు కంటెంట్ అంచనాలకు అనుగుణంగా ఉన్నాయో లేదో నిర్ధారించండి, తర్వాత తదుపరి ప్రాసెసింగ్ కోడ్‌ను జోడించండి.

ప్రయోగాలు పునరుత్పత్తి చేయాలంటే, వెర్షన్ కూడా నోట్ చేయండి

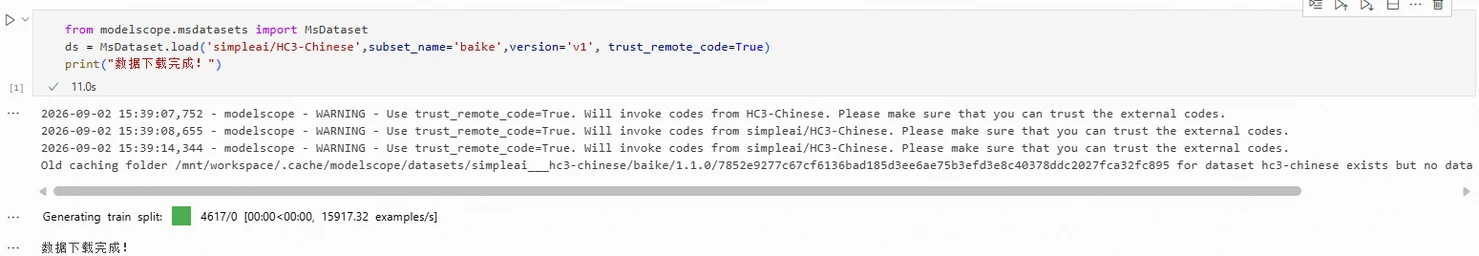
అప్‌డేట్ల తర్వాత, అదే కోడ్ వేరే కంటెంట్ చదవగలదు. HC3-Chinese v1 ఉదాహరణగా, version ద్వారా నిర్దిష్టం చేయండి.

from modelscope.msdatasets import MsDataset

ds = MsDataset.load(
    'simpleai/HC3-Chinese',
    subset_name='baike',
    version='v1',
    trust_remote_code=True,
)
print(ds)
చిత్రం

వాస్తవ ఆపరేషన్‌లో, డేటాసెట్ పేజీలో అందుబాటులో ఉన్న వెర్షన్లను తనిఖీ చేయండి. వెర్షన్ నిరంతరంగా అప్‌డేట్ అవుతుంటే, ఉపయోగించిన ఫైల్స్ లేదా చెక్‌సమ్‌లను సేవ్ చేయండి.

డేటా డౌన్‌లోడ్ అయిందా? వెంటనే మోడల్‌కు ఇవ్వకండి

మొదట కొన్ని నమూనాలను ఖాళీ విలువలు, టూటిన అక్షరాలు లేదా స్పష్టమైన తప్పుల కోసం తనిఖీ చేయండి, తర్వాత ఫీల్డ్‌లు కోడ్ అవసరాలను తీరుస్తాయని నిర్ధారించండి.

శిక్షణ మరియు పరీక్షా డేటాను వేరుగా ఉంచండి. పరీక్షా నమూనాలను శిక్షణ సెట్‌లో కలపవద్దు.