ఫైన్-ట్యూనింగ్ మరియు మూల్యాంకనం • ప్రారంభకుడు⏱️ 20 నిమిషాల పఠన సమయం
Preference Alignment
మోడల్ ఇప్పటికే సమాధానం ఇవ్వగలదు, ప్రాధాన్యత సమన్వయం ఎందుకు?
మోడల్ ఫైన్-ట్యూనింగ్ పూర్తయిన తర్వాత, అది ప్రశ్నలకు అనుసరించి సమాధానం ఇవ్వగలదు, కానీ సమాధానాలను పక్కపక్కన చూస్తే, కొన్ని మంచిగా, కొన్ని చెడ్డగా ఉంటాయి.
రీఫండ్ సంప్రదింపు ఉదాహరణగా, రెండూ వినియోగదారునికి ఎక్కడ దరఖాస్తు చేయాలో చెబుతున్నాయి.
SFT చేసేటప్పుడు, మేము అటువంటి సమాధానాలను ఉదాహరణలుగా నిర్వహిస్తాము.
ఇది ప్రాధాన్యత సమన్వయం, మేము ఇక్కడి నుండి ప్రారంభిద్దాం.
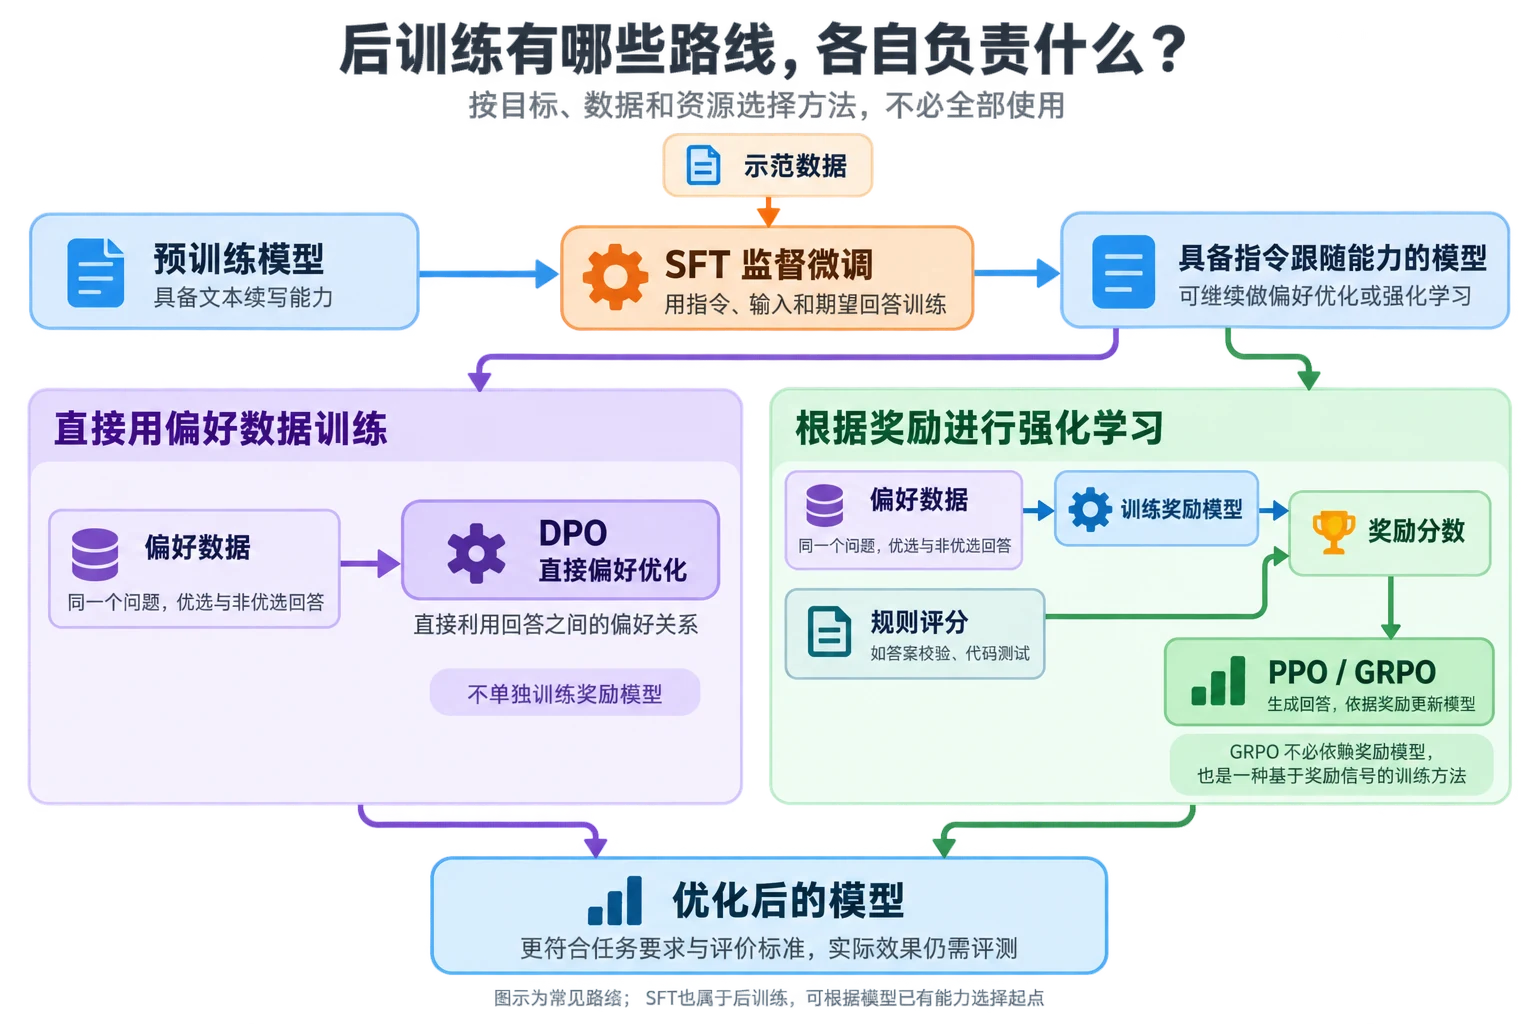
పోస్ట్-ట్రైనింగ్ పద్ధతులు
పెద్ద మోడళ్ల పోస్ట్-ట్రైనింగ్ ప్రధాన ఉద్దేశ్యం, ఇప్పటికే వచనం కొనసాగించే సామర్థ్యం కలిగిన ప్రాథమిక మోడళ్లను సహాయం చేసి, నేరుగా సంభాషించడంలో మెరుగ్గా సామర్థ్యం పొందేలా చేయడం.
SFT ప్రధానంగా సూచనలు, ఇన్పుట్లు మరియు అంచనా ప్రతిస్పందనల రూపంలో డేటాను ఉపయోగిస్తుంది.
కాబట్టి, పెద్ద మోడళ్ల పోస్ట్-ట్రైనింగ్లో నిర్ధారిత ప్రక్రియ లేదు.
సూచన సమాధానాలు ఎలా ఉంటాయి?
SFT అంటే Supervised Fine-Tuning. ఇది సిద్ధం చేయబడిన ఇన్పుట్లు మరియు అంచనా అవుట్పుట్లను ఉపయోగించి మోడల్ను శిక్షణ ఇస్తుంది.
ఒక SFT డేటా ఈ క్రింది విధంగా రాయవచ్చు:
{
  "instruction": "Generate a customer service reply based on the user's question",
  "input": "My membership auto-renewed yesterday; I want to request a refund.",
  "output": "Please first go to the order page to confirm the renewal order status. If it meets the refund conditions, you can submit a request in the order details; if there is no refund entry on the page, please contact human customer service for verification."
}
శిక్షణ సమయంలో, టోకెనైజర్ సూచనలు, ఇన్పుట్లు మరియు సమాధానాలను టోకెన్లుగా మారుస్తుంది.
SFT మొదట మార్చేది పని ఫార్మాట్. మోడల్ క్రమంగా అర్థం చేసుకుంటుంది.
SFT యొక్క శిక్షణ లక్ష్యం సారాంశంలో అంచనా అవుట్పుట్ను అనుకరించడం.
Answer A: Please apply for a refund in the order details; if you cannot operate, contact human customer service.

Answer B: You can first check the order status. If it meets the refund conditions, you can submit a request in the order details; if there is no refund entry, please contact human customer service for verification. The refund result and arrival time are subject to the actual review.
రెండు సమాధానాలు రీఫండ్తో సంబంధం కలిగి ఉన్నాయి, కానీ సమాధానం B సమీక్ష షరతులను జోడించింది.
ఒకే ప్రశ్న, ఏ సమాధానం మరింత అనుకూలం?
ప్రాధాన్యత సమన్వయం దృష్టి పెట్టేది మోడల్ సమాధానం ఇవ్వగలదా అనేది కాదు, కానీ అనేక సంభావ్య సమాధానాలలో ఏది మెరుగు అనేది.
రీఫండ్ కస్టమర్ సేవా దృశ్యాన్ని ఉదాహరణగా తీసుకుంటే.
అంతేకాకుండా, ప్రాధాన్యత సమన్వయం వాస్తవ ధృవీకరణను కూడా భర్తీ చేయలేదు.
ప్రాధాన్యత డేటా ఎలా నిర్మించాలి
ప్రాధాన్యత డేటా అనేది అనేక సమాధానాలలో ఏది మెరుగు అని మోడల్కు చెప్పడానికి శిక్షణ డేటా.
{
  "prompt": "My membership auto-renewed yesterday; I want to request a refund.",
  "chosen": "Please first check the order status. If it meets the refund conditions, you can submit a request in the order details; if there is no refund entry, please contact human customer service for verification.",
  "rejected": "Sure, the refund will arrive within three business days."
}
ఇక్కడ, chosen ప్రస్తుత మూల్యాంకన ప్రమాణాల కింద మరింత అనుకూలమైన సమాధానాన్ని సూచిస్తుంది.
ప్రాధాన్యత డేటా సాధారణంగా ఈ క్రింది ప్రక్రియ ప్రకారం నిర్మించబడుతుంది:
నిజమైన వ్యాపారాలు లేదా పరీక్ష సమూహాల నుండి Promptsను సిద్ధం చేయడం;
ప్రస్తుత మోడల్, విభిన్న సంస్కరణల మోడల్ లేదా విభిన్న నమూనా పారామితులను ఉపయోగించి ఒకే Prompt కోసం అనేక అభ్యర్థి సమాధానాలను జనరేట్ చేయడం;
ఏకీకృత మూల్యాంకన ప్రమాణాల ప్రకారం, లేబులర్లు సమాధానాలను జతలుగా పోల్చడం లేదా పూర్తి క్రమం ఇవ్వడం;
క్రమ ఫలితాలను ప్రాధాన్య మరియు అప్రాధాన్య సమాధానాలతో కూడిన డేటా జతలుగా మార్చడం;
లేబులింగ్ స్థిరత్వాన్ని తనిఖీ చేసి, నిర్ణయించలేని నమూనాలను సమీక్షకులకు అప్పగించడం.
ఒకే ఇన్పుట్ A, B, C మరియు D నాలుగు సమాధానాలను జనరేట్ చేస్తే, అనేక ప్రాధాన్యత జతలుగా మార్చవచ్చు.
ప్రాధాన్యత లేబులింగ్ కొన్ని ఉపరితల కారకాలచే ప్రభావితమవుతుంది.
రివార్డ్ మోడల్ సమాధానాలకు స్కోర్ ఎలా ఇవ్వడం నేర్చుకుంటుంది?
ప్రాధాన్యత డేటా ఒకే Prompt కింద ఏ సమాధానం మెరుగు అనేదాన్ని chosen మరియు rejected మధ్య సాపేక్ష సంబంధంగా సూచిస్తుంది. రివార్డ్ మోడల్ పాత్ర ఏమిటంటే, ఈ ప్రాధాన్యత డేటాను ఉపయోగించి స్వయంచాలక స్కోరింగ్ ఫలనాన్ని నేర్చుకోవడం.
రివార్డ్ మోడల్ రెండు సమాధానాలకు విడిగా ఎన్ని పాయింట్లు రావాలో తెలుసుకోవాల్సిన అవసరం లేదు.
ఇక్కడ, rchosen మరియు rrejected రివార్డ్ మోడల్ అవుట్పుట్ చేసిన రెండు స్కేలర్ స్కోర్లు. శిక్షణ లక్ష్యం ప్రాధాన్య సమాధానం స్కోర్ అప్రాధాన్య సమాధానం కంటే ఎక్కువగా ఉండటం.
ఇక్కడ, r_chosen మరియు r_rejected ప్రాధాన్య మరియు అప్రాధాన్య సమాధానాలపై రివార్డ్ మోడల్ మూల్యాంకనాలను సూచిస్తాయి.
రివార్డ్ మోడల్ సాధారణంగా భాషా మోడల్ను పునాదిగా ఉపయోగించి, స్కేలర్ స్కోర్ అవుట్పుట్ స్కోరింగ్ హెడ్ను జోడిస్తుంది.
రివార్డ్ మోడల్ ఏమి నేర్చుకుంటుందో ముందుగా నిర్మించిన ప్రాధాన్యత డేటాపై చాలా వరకు ఆధారపడి ఉంటుంది.
రివార్డ్ మోడల్ స్వయంగా మూల్యాంకనం మాత్రమే చేస్తుంది, భాషా మోడల్ను నేరుగా సవరించదు.
RLHF, మానవ ప్రతిస్పందన శిక్షణలో ఎలా పాల్గొంటుంది?
RLHF (Reinforcement Learning from Human Feedback) సాధారణంగా మానవ ప్రతిస్పందన ఆధారంగా రీన్ఫోర్స్మెంట్ లెర్నింగ్ అని పిలుస్తారు.
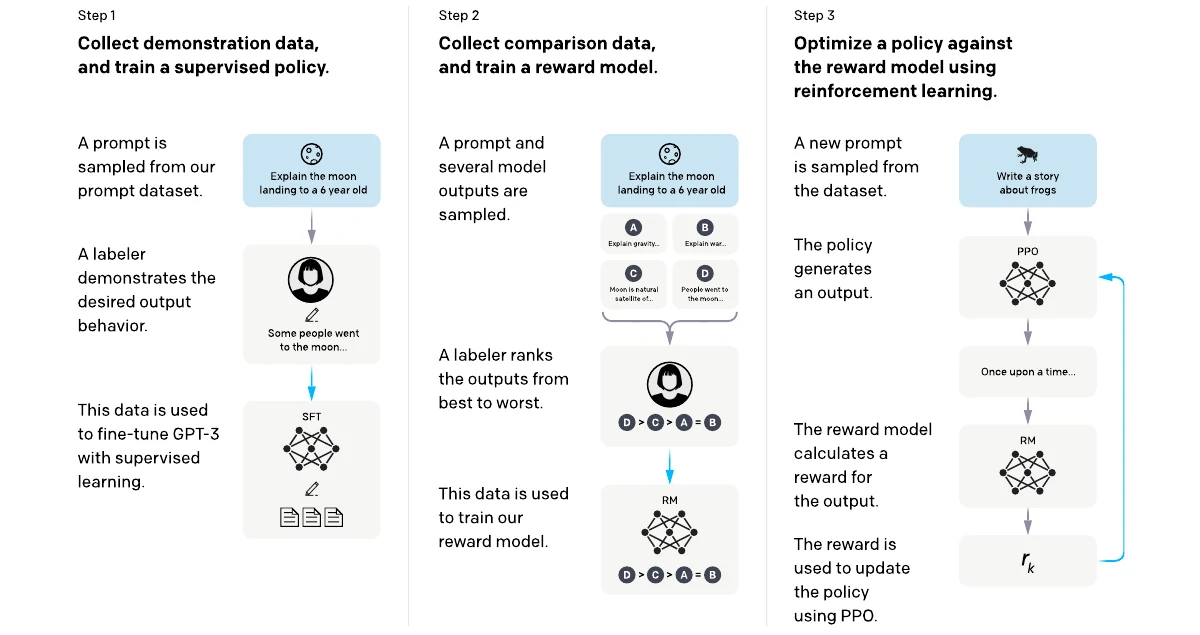
క్లాసిక్ RLHF సాధారణంగా మూడు దశలను కలిగి ఉంటుంది:
మానవ ప్రదర్శన డేటాను సేకరించి, SFT ద్వారా సూచనలను అనుసరించగల ప్రారంభ విధాన మోడల్ను పొందడం;
ఒకే Prompt కింద అనేక సమాధానాలకు మానవ క్రమం ఇవ్వడం, ఈ ప్రాధాన్యత డేటాను ఉపయోగించి రివార్డ్ మోడల్ను శిక్షణ ఇవ్వడం;
విధాన మోడల్ కొత్త సమాధానాలను జనరేట్ చేయనివ్వడం, రివార్డ్ మోడల్ స్కోర్ ఇవ్వడం, ఆపై PPO వంటి రీన్ఫోర్స్మెంట్ లెర్నింగ్ అల్గారిథమ్లతో విధాన మోడల్ను నవీకరించడం.
క్లాసిక్ RLHF మార్గం మూడు వరుస దశలుగా విభజించబడింది. మొదటి దశలో లేబులర్లు ప్రదర్శన సమాధానాలను రాసి, ఈ డేటాతో SFT పూర్తి చేస్తారు.
ఈ ప్రక్రియను రీన్ఫోర్స్మెంట్ లెర్నింగ్ భావనలో ఉంచితే, భాషా మోడల్ విధాన మోడల్.
RLHF లో, రివార్డ్ మోడల్ సాధారణంగా సమాధానం ముగిసిన తర్వాత మొత్తం స్కోర్ ఇస్తుంది.
PPO, మోడల్ను రివార్డ్ ఆధారంగా సవరించడం
PPO (Proximal Policy Optimization) ఒక సాధారణ రీన్ఫోర్స్మెంట్ లెర్నింగ్ అల్గారిథమ్. ఇది ప్రతి పారామితి నవీకరణ యొక్క పరిమాణాన్ని పరిమితం చేస్తూ రివార్డ్ను పెంచే లక్ష్యంతో పాటు పనిచేస్తుంది.
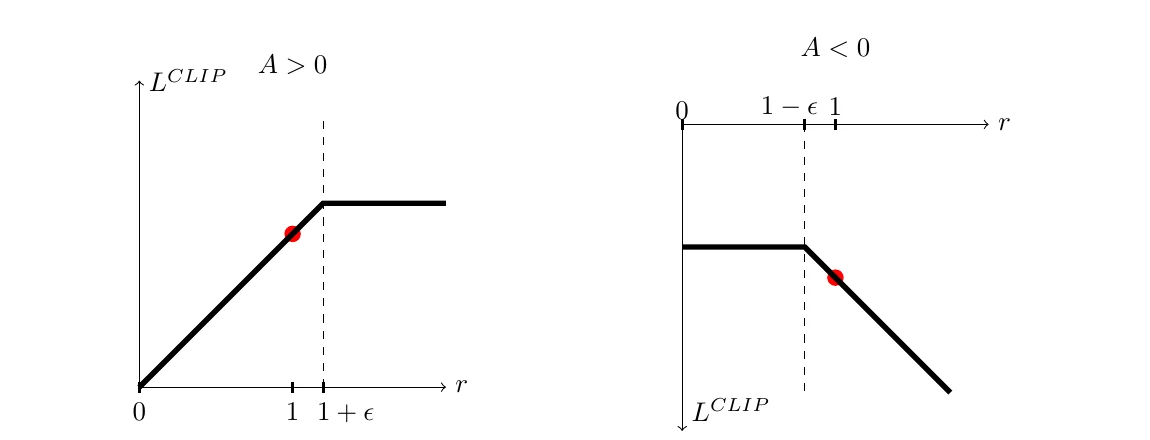
PPO కొత్త విధానం మరియు పాత విధానం ఒకే టోకెన్కు ఇచ్చే సంభావ్యతను పోల్చాలి.
r_t(\theta)
=
\frac{\text{Probability of the new policy selecting the current token}}
{\text{Probability of the old policy selecting the current token}}
ఇక్కడ, rₜ లెక్కించిన స్కోర్ను సూచిస్తుంది,
θ సవరించాల్సిన మోడల్ను సూచిస్తుంది.
rₜ 1 కు సమీపంలో ఉంటే, కొత్త మరియు పాత విధానాల మధ్య తేడా తక్కువగా ఉంటుంది.
ఎడమ వైపు ప్రయోజనం ధనాత్మకంగా ఉన్న సందర్భాన్ని సూచిస్తుంది.
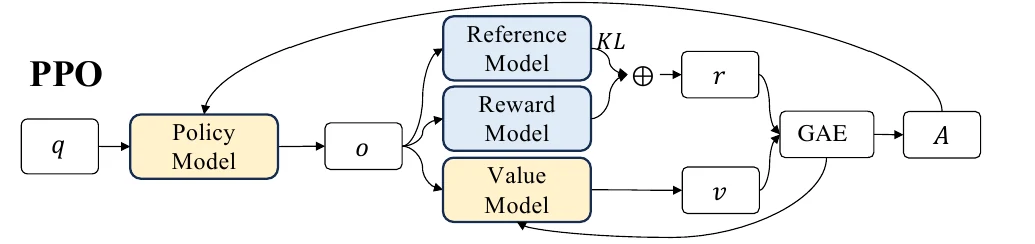
ఒక సాధారణ పెద్ద మోడల్ PPO శిక్షణకు అనేక భాగాలను ఏకకాలంలో నిర్వహించాలి.
GRPO, ఒకే ప్రశ్నకు అనేకసార్లు సమాధానం ఇవ్వండి, ఆపై స్కోర్లను పోల్చండి
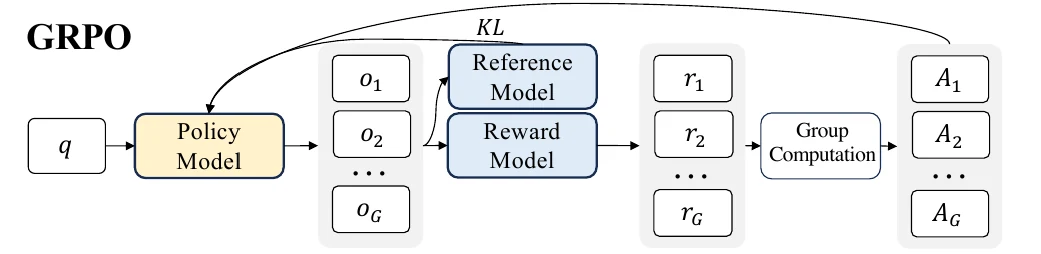
GRPO (Group Relative Policy Optimization) PPO యొక్క వేరియేషన్. ఇది విలువ మోడల్ను విడిగా శిక్షణ ఇవ్వకుండా, ఒకే Prompt కింద అనేక సమాధానాల సాపేక్ష పోలిక ద్వారా ఆదాయాన్ని అంచనా వేస్తుంది.
వ్యవస్థ ముందుగా ఈ సమూహం యొక్క ఆదాయాల సగటు మరియు ప్రామాణిక విచలనాన్ని లెక్కిస్తుంది.
PPO తో పోల్చినప్పుడు, GRPO విలువ మోడల్ శిక్షణ ఖర్చులను తగ్గిస్తుంది.
DPO, ప్రాధాన్యతలను నష్ట ఫలనంలో వ్రాయడం
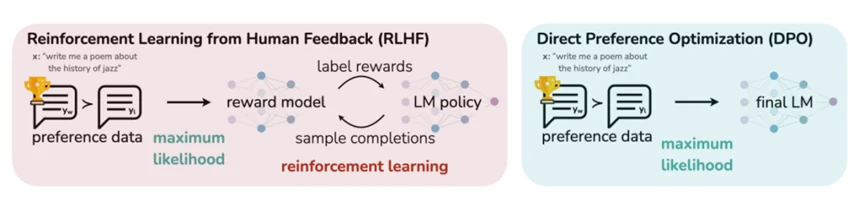
DPO (Direct Preference Optimization) మరొక సాధారణ ప్రాధాన్యత సమన్వయ పద్ధతి. దీని పేపర్ శీర్షికలో, రచయితలు స్పష్టంగా చెప్పారు, ప్రాధాన్యత మోడల్ అవసరం లేకపోవచ్చు.
పై చిత్రం క్లాసిక్ RLHF మార్గం మరియు DPO ను పోల్చింది.
మొదటి దశ, ప్రాధాన్యత ధనాత్మక మరియు ఋణాత్మక ఉదాహరణల నమూనాలను రూపొందించడం.
రెండవ దశ, రూపొందించిన నష్ట ఫలనం ఆధారంగా, పోల్చడం నేర్చుకునే సంబంధిత పద్ధతులను ఉపయోగించి.
DPO శిక్షణ రూపం సాధారణ SFT కు సమీపంగా ఉంటుంది.
RLHF, PPO, GRPO మరియు DPO, చివరికి ఎలా వేరు చేయాలి మరియు ఎంచుకోవాలి?
ముందుగా RLHF, PPO, GRPO మరియు DPO యొక్క ప్రాథమిక సూత్రాలు మరియు శిక్షణ పద్ధతులను వివరించాము.
Concept
Belongs to
Generates new answers during training
Requires explicit reward model
Requires value model
RLHF
Framework
Yes
Yes
Yes (PPO)
PPO
Algorithm
Yes
Yes
Yes
GRPO
Algorithm
Yes
Yes
No
DPO
Algorithm
No
No
No
సమగ్రంగా చూస్తే, RLHF, PPO, GRPO మరియు DPO అన్నీ పెద్ద మోడల్ ప్రాధాన్యత సమన్వయంతో సంబంధం కలిగి ఉన్నాయి, కానీ అవి పరిష్కరించే సమస్యలు పూర్తిగా ఒకేలా ఉండవు.
వాస్తవ అనువర్తనంలో, పద్ధతి ఎంపిక మోడల్ ప్రస్తుతం లోపించిన సామర్థ్యం నుండి ప్రారంభించాలి.
ms-swift తో DPO మరియు GRPO ప్రయత్నించండి
ముందుగా ప్రాధాన్యత సమన్వయం మరియు రీన్ఫోర్స్మెంట్ లెర్నింగ్ ప్రాథమిక సూత్రాలను వివరించాము, ఇప్పుడు ms-swift తో రెండు నిర్దిష్ట ప్రయోగాలను పూర్తి చేద్దాం.
ప్రయోగ సిద్ధాంతం
ఈ ప్రయోగం ModelScope Notebook యొక్క ఏకైక GPU వాతావరణంలో పూర్తయింది.
Item
DPO Chinese Preference Alignment
GRPO Math Answer Optimization
Initial Model
Qwen2.5-0.5B-Instruct
Qwen2.5-0.5B-Instruct
Training Steps
320
10
Learning Rate
1e-5
1e-6
LoRA rank/alpha
8/16
8/16
ఇక్కడి శిక్షణ పరిమాణం చిన్నది, ఇది పూర్తి ప్రక్రియను ప్రదర్శించడానికి మాత్రమే ఉద్దేశించబడింది.
రన్నింగ్ వాతావరణాన్ని తనిఖీ చేయండి.
అనుబంధ Notebook తెరిచిన తర్వాత, GPU అందుబాటులో ఉందా మరియు ప్రస్తుత కెర్నల్ ఉపయోగిస్తున్న సాఫ్ట్వేర్ వెర్షన్లను తనిఖీ చేయండి.
మోడల్ మరియు రన్నింగ్ డైరెక్టరీలను సిద్ధం చేయండి.
పబ్లిక్ సిద్ధాంత భాగం కాష్ డైరెక్టరీ మరియు ఈ ప్రయోగ డైరెక్టరీని సృష్టిస్తుంది.
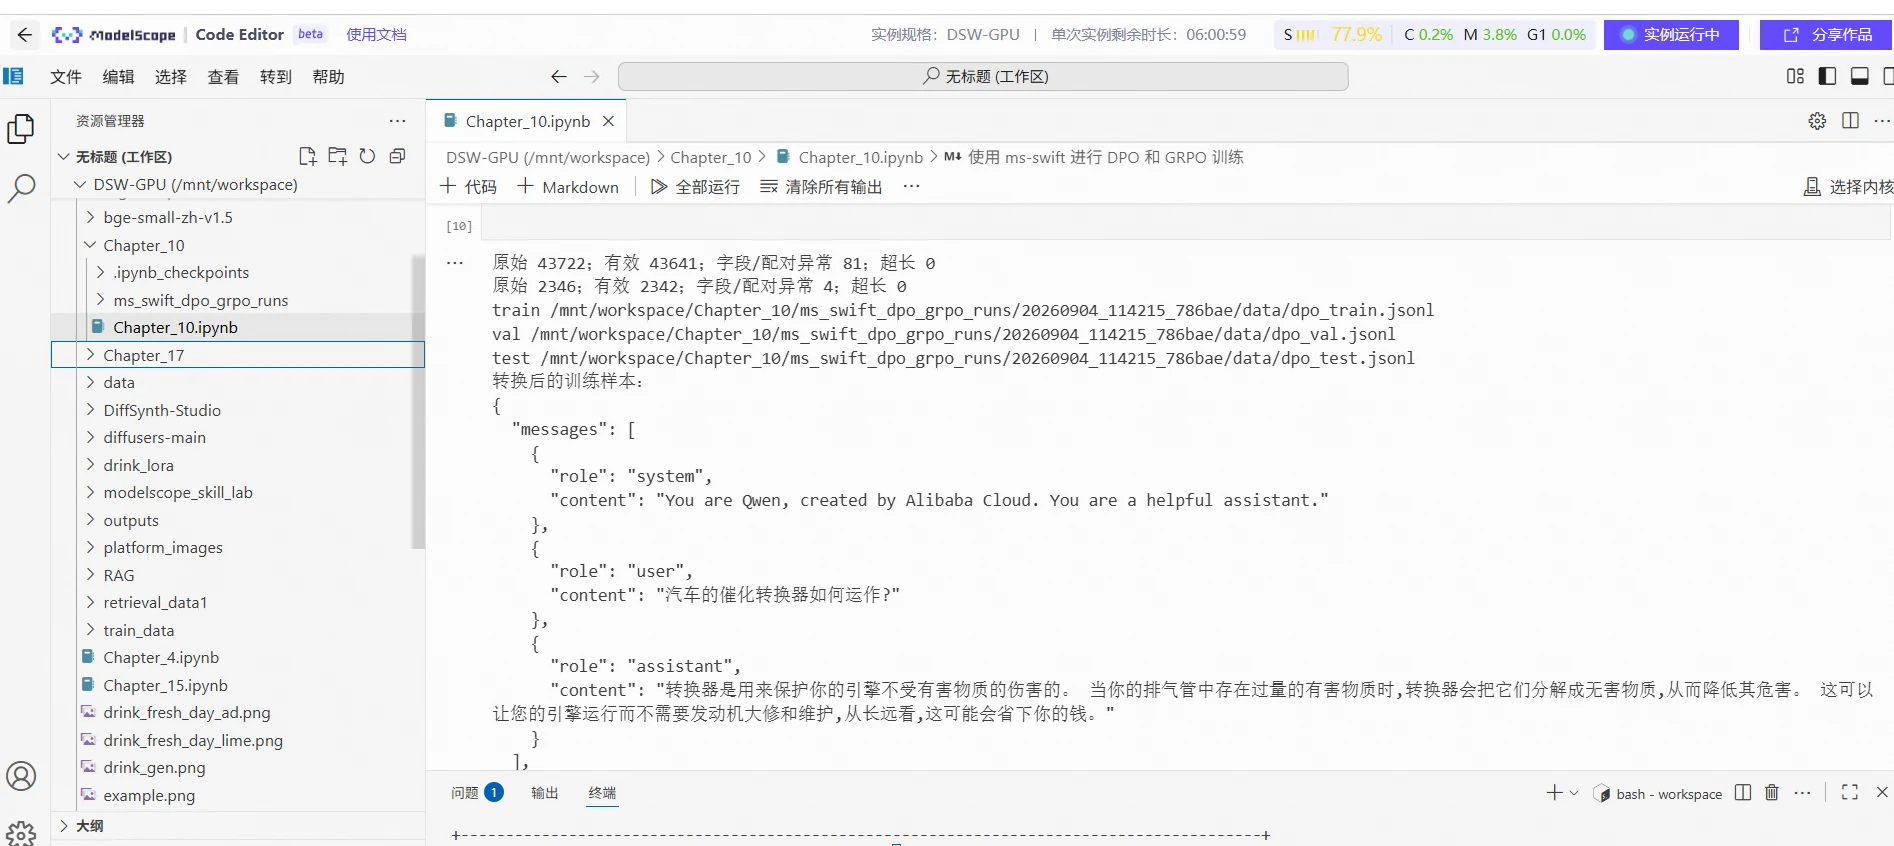
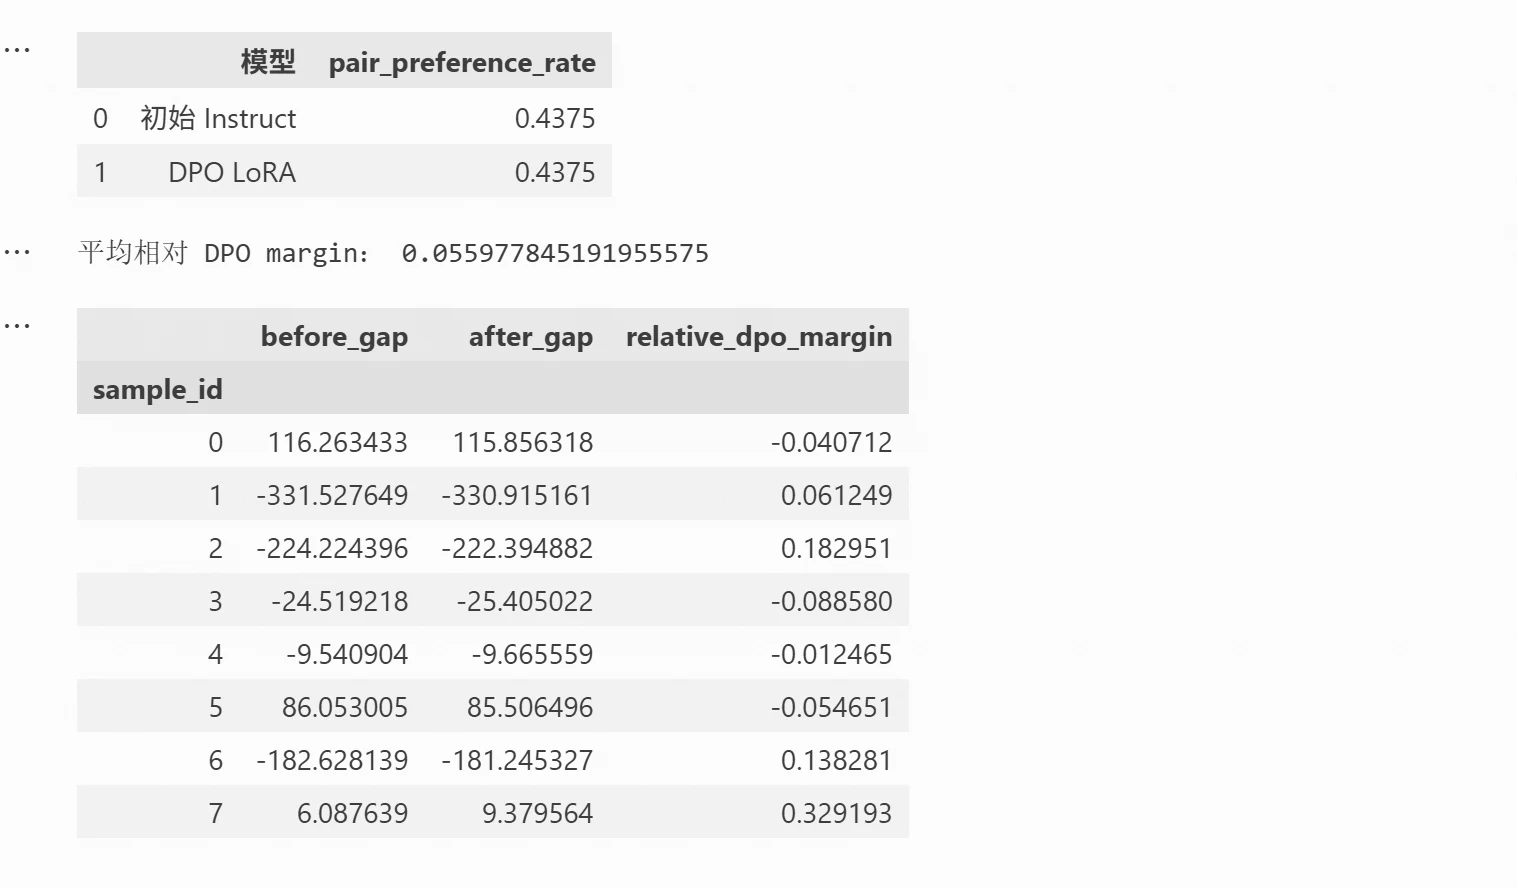
ఇక్కడ, gap ప్రాధాన్య సమాధానం యొక్క క్రమ లాగ్ సంభావ్యత మైనస్ అప్రాధాన్య సమాధానం యొక్క క్రమ లాగ్ సంభావ్యతకు సమానం.
ఈ ప్రయోగ ఫలితాలు ఈ క్రింది చిత్రంలో చూపబడ్డాయి:
శిక్షణ రౌండ్లు తక్కువగా ఉన్నందున, కొన్ని నమూనాల తేడా పెద్దది కావచ్చు, కానీ ఋణాత్మకం నుండి ధనాత్మకంగా మారలేదు.
User: What methods can I use to strengthen my home network signal? My laptop has trouble connecting to the network router!
ప్రారంభ మోడల్ సమాధానం ఈ క్రింది కంటెంట్ను కలిగి ఉంటుంది, మూలాన్ని ఉటంకించి నిల్వ చేస్తుంది:
1. **Use a wireless router**: If you have multiple devices at home that need internet access, consider installing a wireless router. This will let you connect to the internet via Wi-Fi.
DPO శిక్షణ తర్వాత సమాధానం ఈ క్రింది వాటిని కలిగి ఉంటుంది:
3. **Restart the router**: Sometimes a simple restart can resolve some network connection issues. Please follow the router's instructions.
పూర్తి అవుట్పుట్ నుండి, ప్రారంభ సమాధానం ఎక్కువగా పరికరాలను మార్చడం లేదా జోడించడాన్ని సూచిస్తుంది, శిక్షణ తర్వాత నెట్వర్క్ సెట్టింగ్లు, డ్రైవర్లు మరియు రీస్టార్ట్ చుట్టూ సమాధానాలను సంఘటిస్తుంది.
GRPO డేటా మరియు రివార్డ్ ఫలనాన్ని సిద్ధం చేయడం
DPO డేటాలో ఇప్పటికే ఇచ్చిన రెండు సమాధానాలను ఉపయోగిస్తుంది, GRPO కు శిక్షణ సమయంలో అభ్యర్థి సమాధానాలను జనరేట్ చేయాలి.
ప్రశ్న మరియు ప్రామాణిక సమాధానాన్ని వేరు చేయండి.
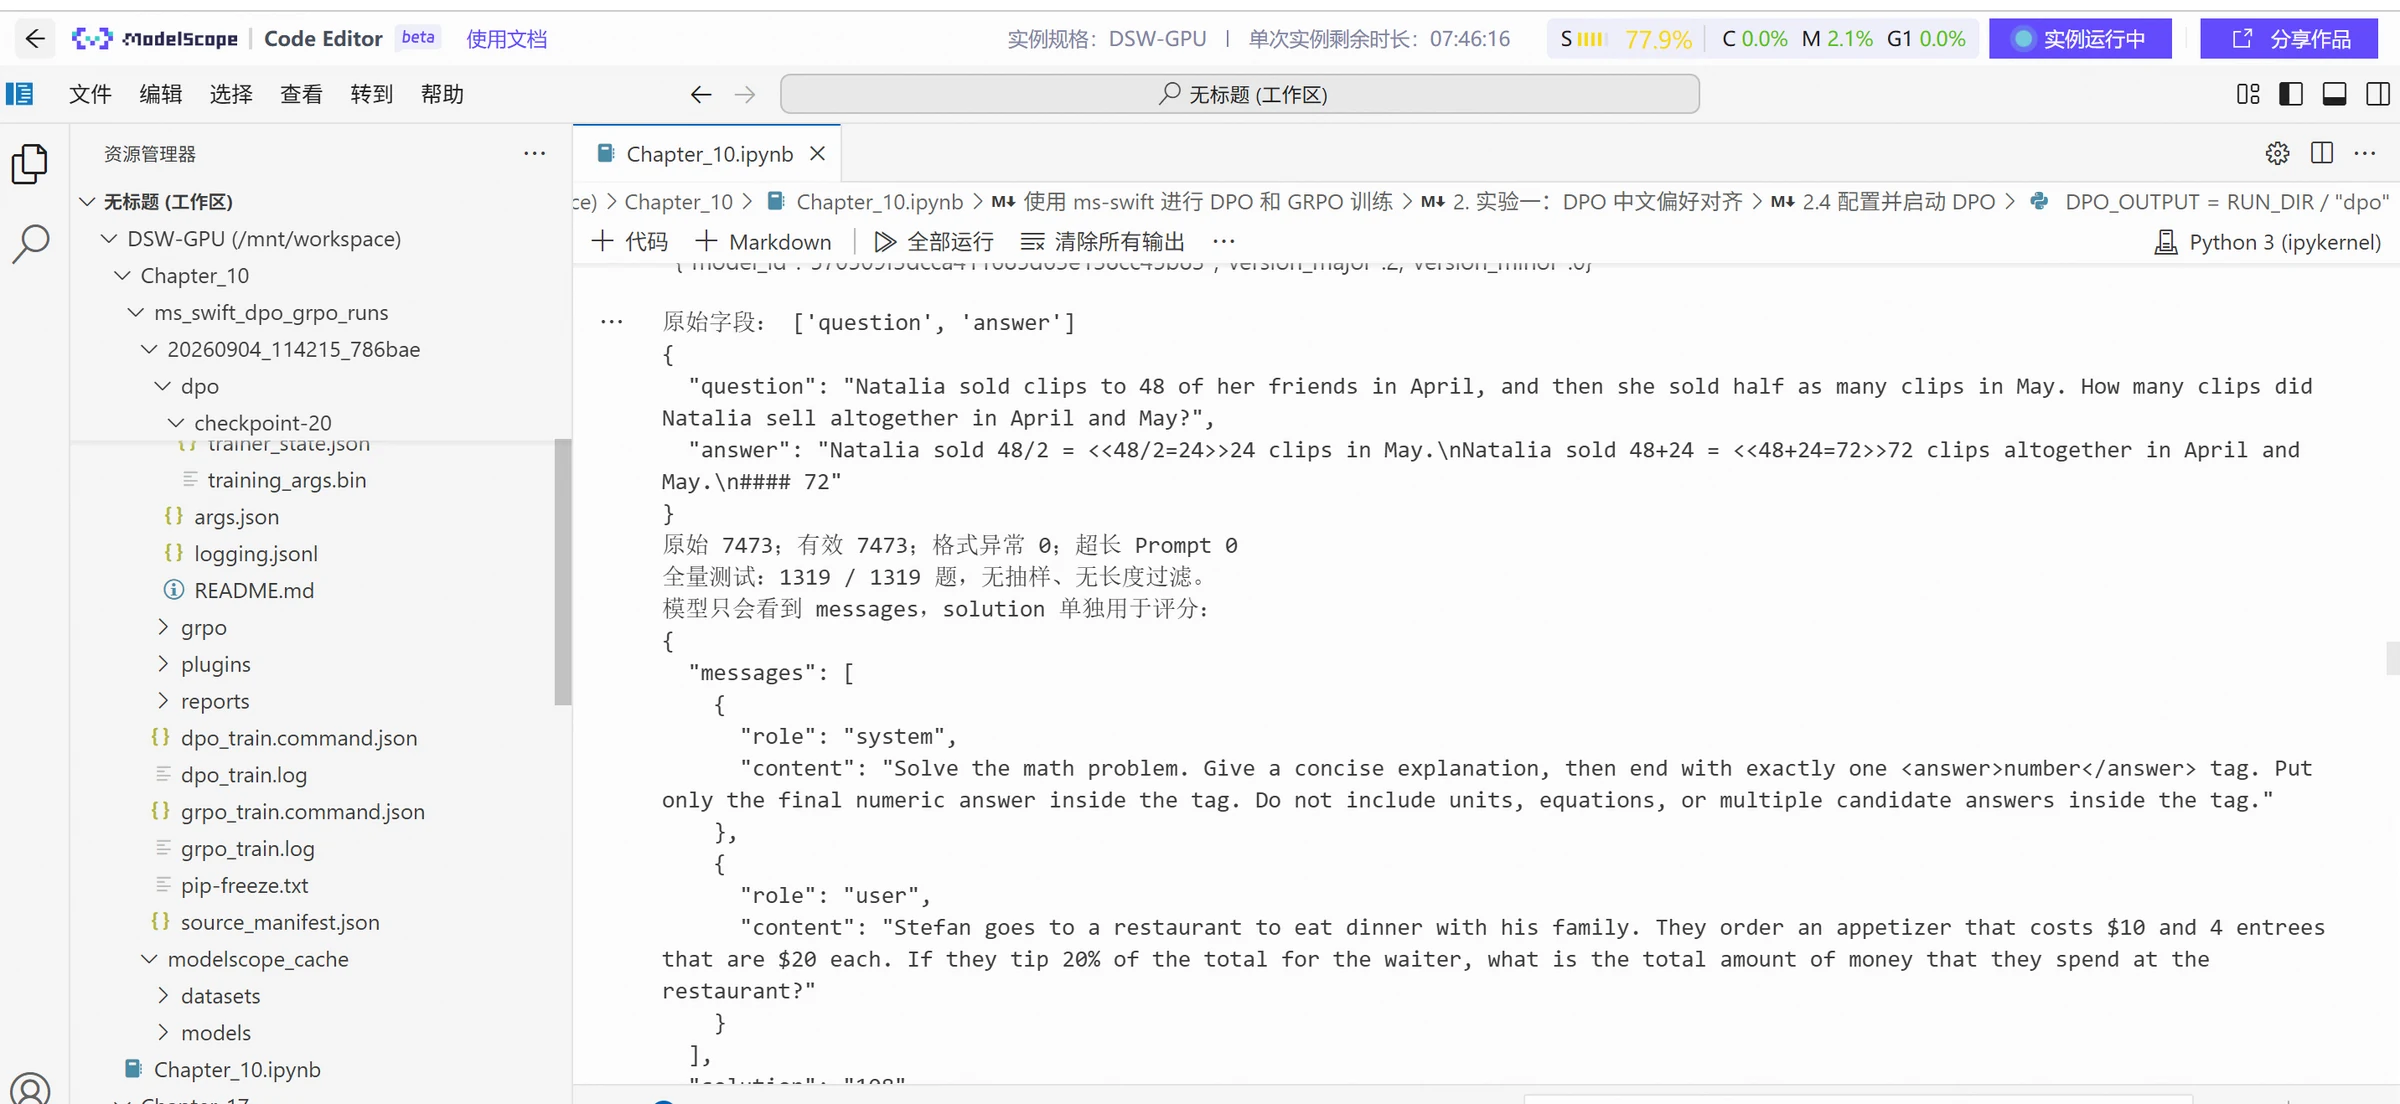
అసలు GSM8K డేటా question మరియు answer అనే రెండు ఫీల్డ్లను కలిగి ఉంటుంది.
def convert_grpo(row):
    question = row["question"].strip()
    original_answer = row["answer"].strip()
    assert question and "####" in original_answer
    answer = parse_numeric(original_answer.rsplit("####", 1)[-1])
    assert answer is not None
    return {
        "messages": [
            {"role": "system", "content": MATH_SYSTEM},
            {"role": "user", "content": question},
        ],
        "solution": str(answer),
    }
మార్చిన messages లో ప్రామాణిక పరిష్కార ప్రక్రియ లేదు, మోడల్ అనుకరించడానికి assistant సమాధానం కూడా లేదు.
సరైనత రివార్డ్ మరియు ఫార్మాట్ రివార్డ్ను నిర్వచించండి.
ఈ ప్రయోగం యొక్క మొత్తం రివార్డ్ ఈ క్రింది విధంగా ఉంటుంది:
Total reward = correctness reward + 0.1 × format reward
సరైనత రివార్డ్ మోడల్ అవుట్పుట్ నిర్దిష్ట లేబుల్ ఫార్మాట్ను అనుసరించాలని, మరియు లేబుల్లోని సంఖ్య solution కు సమానంగా ఉండాలని అవసరం పెడుతుంది.
def extract_answer(completion):
    if not isinstance(completion, str):
        return None
    if completion.count("<answer>") != 1 or completion.count("</answer>") != 1:
        return None
    match = re.search(r"<answer>\s*([^<>]+?)\s*</answer>\s*\Z", completion)
    return parse_numeric(match.group(1) if match else None

class Chapter10Accuracy(ORM):
    def __call__(self, completions, solution, **kwargs):
        if len(completions) != len(solution):
            raise ValueError("Number of candidate answers does not match solutions.")
        rewards = []
        for text, gold in zip(completions, solution):
            expected = parse_numeric(gold)
            if expected is None:
                raise ValueError(f"Invalid gold answer format: {gold!r}")
            predicted = extract_answer(text)
            rewards.append(float(predicted is not None and predicted == expected)
        return rewards

class Chapter10Format(ORM):
    def __call__(self, completions, **kwargs):
        return [float(extract_answer(text) is not None) for text in completions]
ఇక్కడ, completions అనేది మోడల్ జనరేట్ చేసిన సమాధానాల సమూహం, solution ట్రైనర్ అందించిన అనుగుణమైన ప్రామాణిక సమాధానం.
రివార్డ్ క్లాస్ నమోదు చేయాలి, ఈ శిక్షణ ట్రైనర్ ఉపయోగించే రివార్డ్ ప్లగిన్ ఈ క్రింది విధంగా ఉంటుంది:
Notebook పూర్తి ప్లగిన్ను plugins/chapter10_rewards.py గా సేవ్ చేస్తుంది.
ముందుగా రివార్డ్ ఫలనాన్ని తనిఖీ చేసి, ఆపై శిక్షణ ప్రారంభించండి.
ఇవి కొన్ని ఫలితాల రివార్డ్ లెక్కింపు ఫలితాలు:
Model Output
Standard Answer
Correctness Reward
Format Reward
Total Reward
The answer is 12.
12
0
0
0
<answer>12</answer>
12
1
1
1.1
<answer>15</answer>
12
0
1
0.1
ఈ ప్రయోగంలో ఉపయోగించిన రివార్డ్ ఫలనం లెక్కింపు పద్ధతి ప్రకారం, సాధారణ వచనం The answer is 12. సరైన సంఖ్యను కలిగి ఉన్నప్పటికీ, ఫార్మాట్ అవసరాలను నెరవేర్చలేదు.
GRPO శిక్షణను ప్రారంభించి లాగ్ను గమనించండి
డేటా మరియు రివార్డ్ ఫలనం సిద్ధాంతం తర్వాత, సంబంధిత ప్రయోగాల సెట్టింగ్ మరియు శిక్షణ పనులను పూర్తి చేయండి.
జనరేషన్ సమూహం మరియు శిక్షణ పారామితులను సెట్ చేయండి.
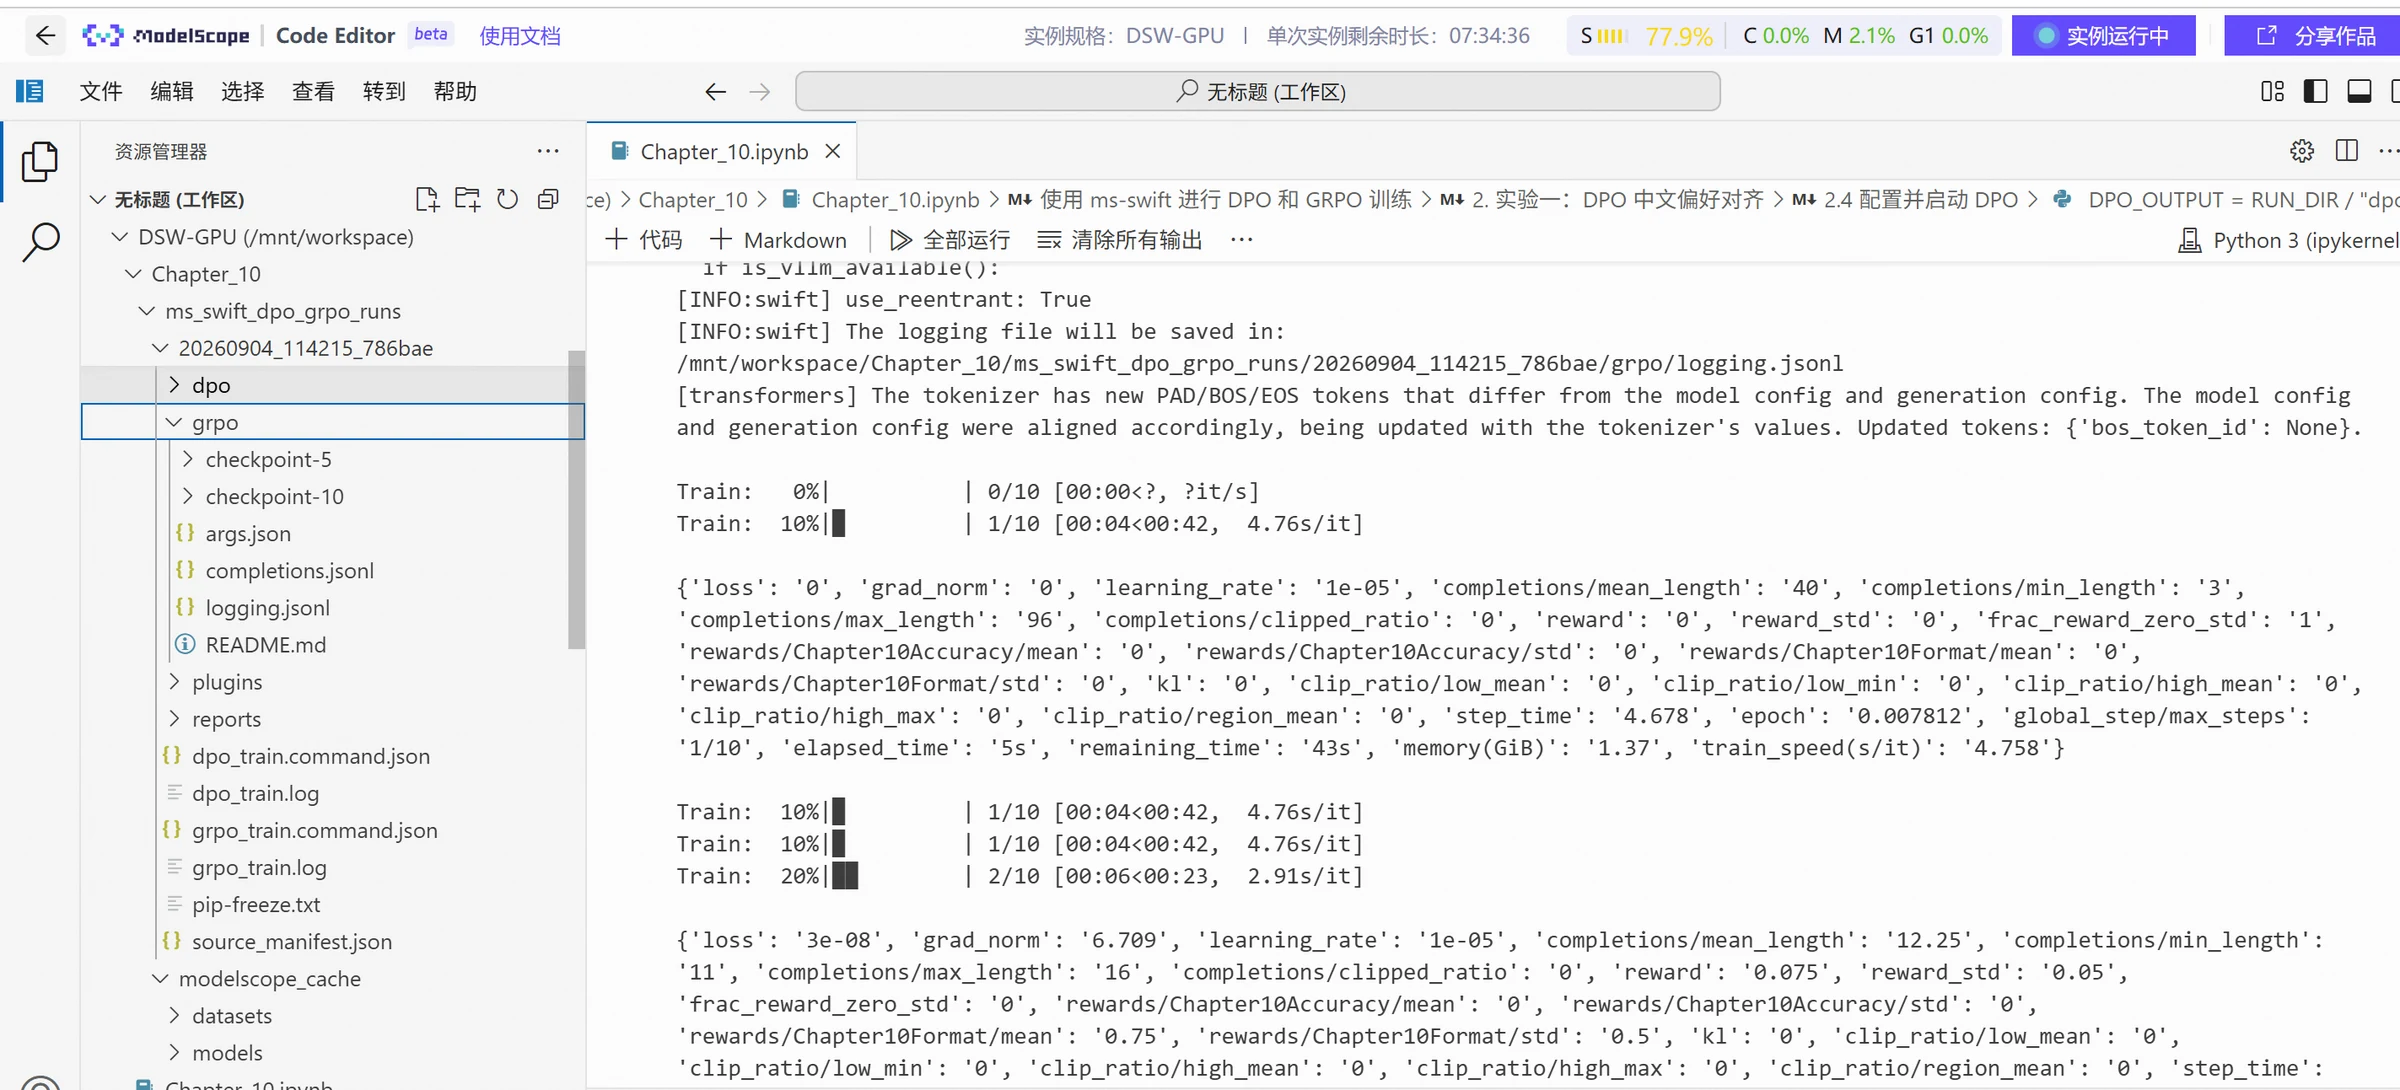
ఈ ప్రయోగం ఒకే ప్రశ్నకు 4 అభ్యర్థి సమాధానాలను జనరేట్ చేస్తుంది.
ఈ క్రింది GRPO ప్రయోగ కాన్ఫిగరేషన్. GRPO_PATHS, PLUGIN_PATH మరియు సంబంధిత కాన్ఫిగరేషన్ మరియు కంటెంట్.
సమూహ పరిమాణం మరియు జనరేషన్ బ్యాచ్ సహకరించే విధంగా సెట్ చేయాలి.
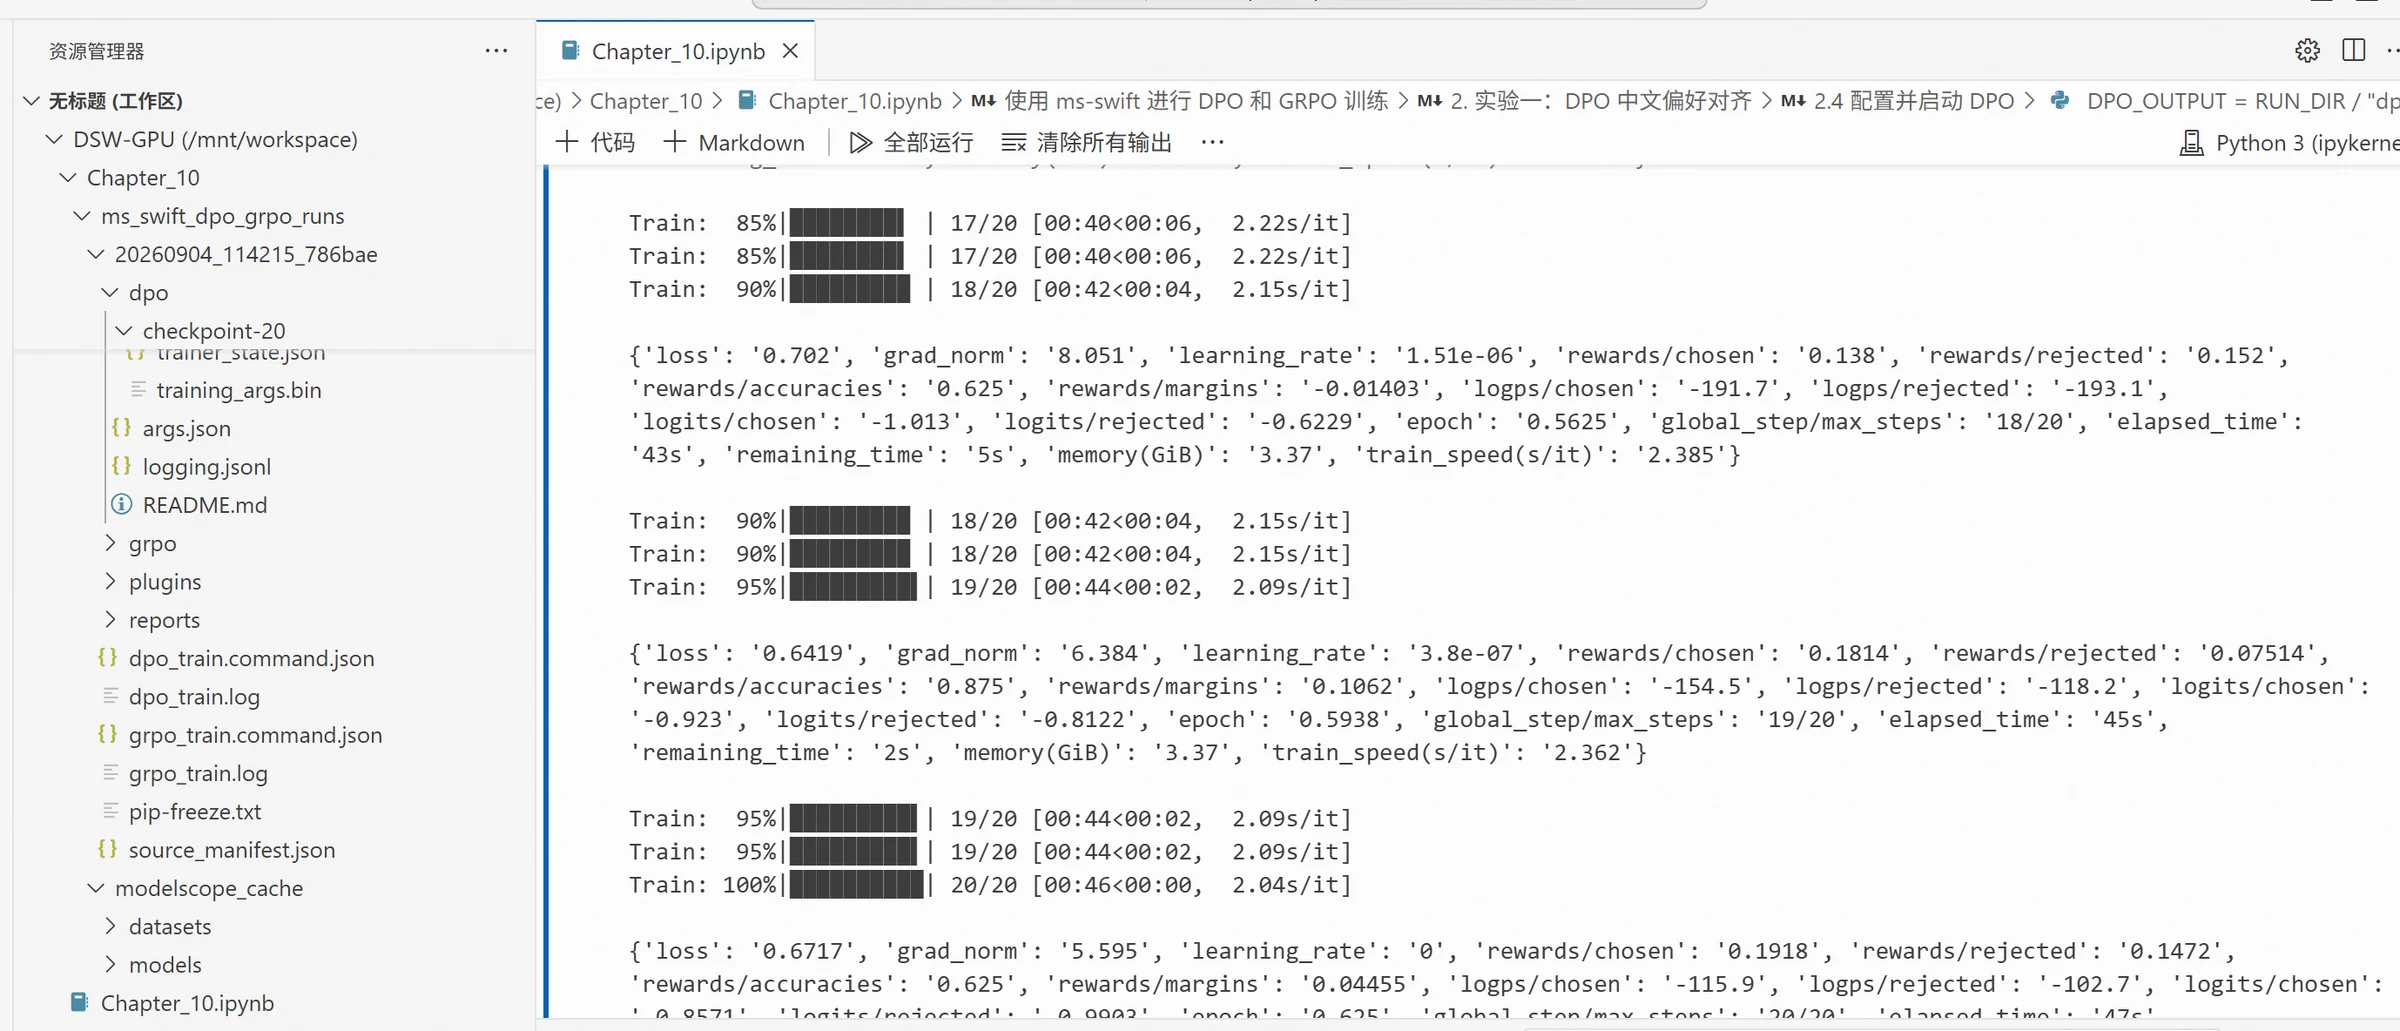
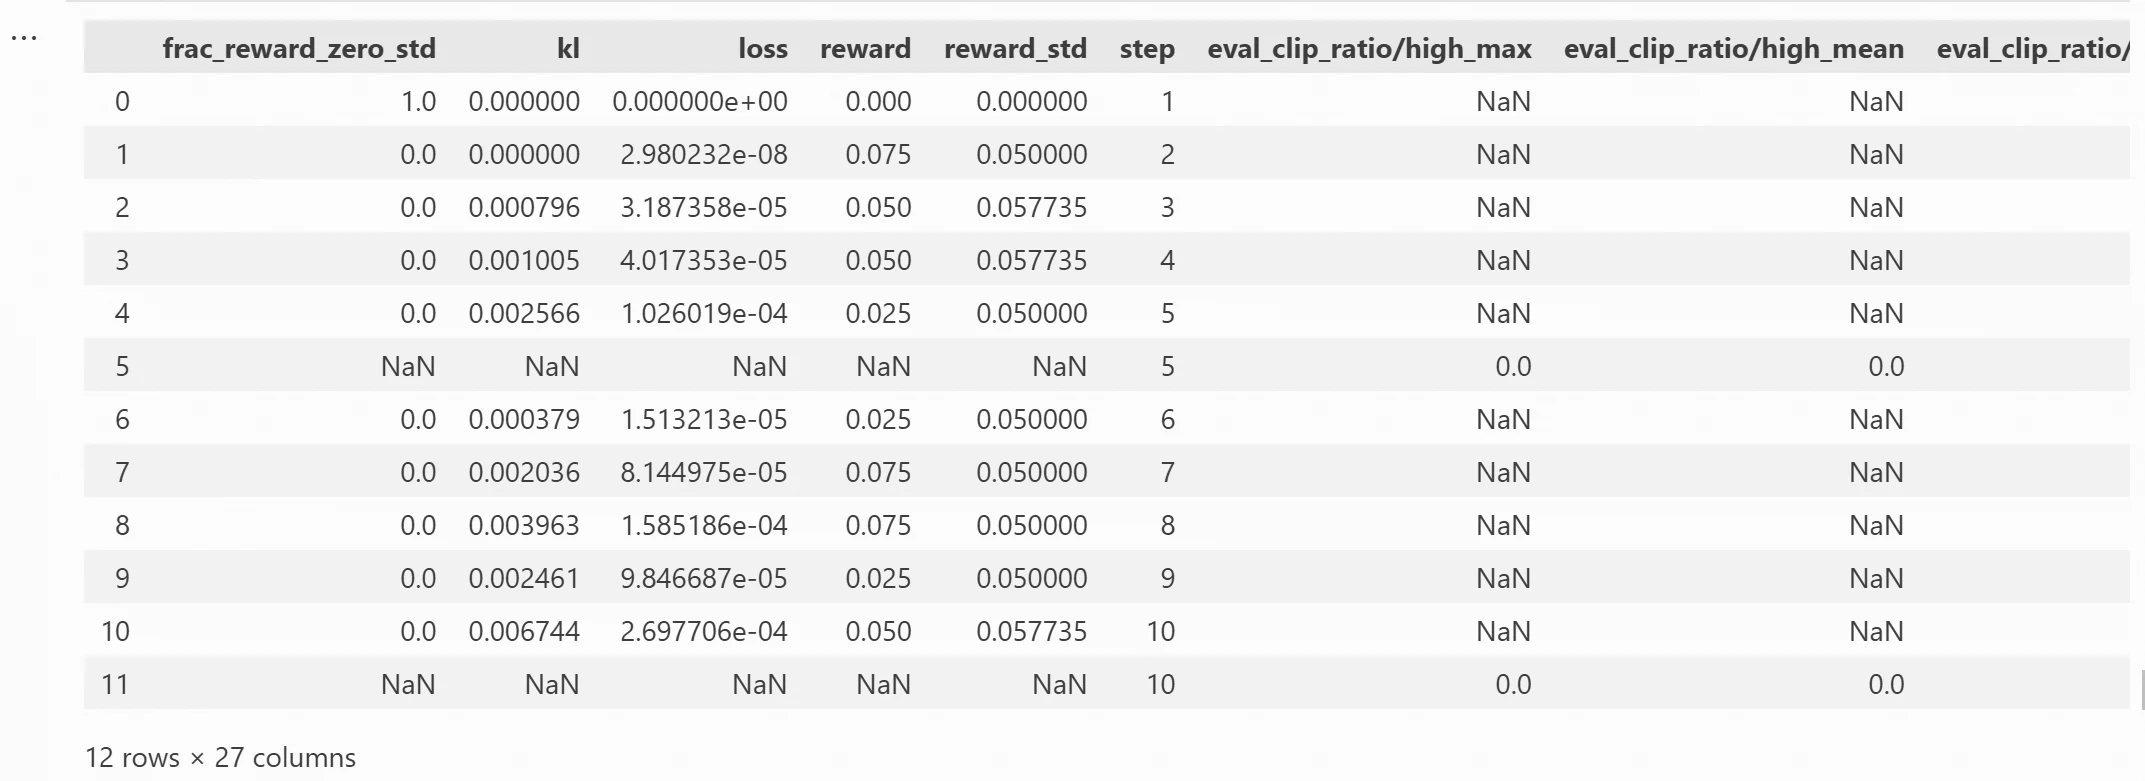
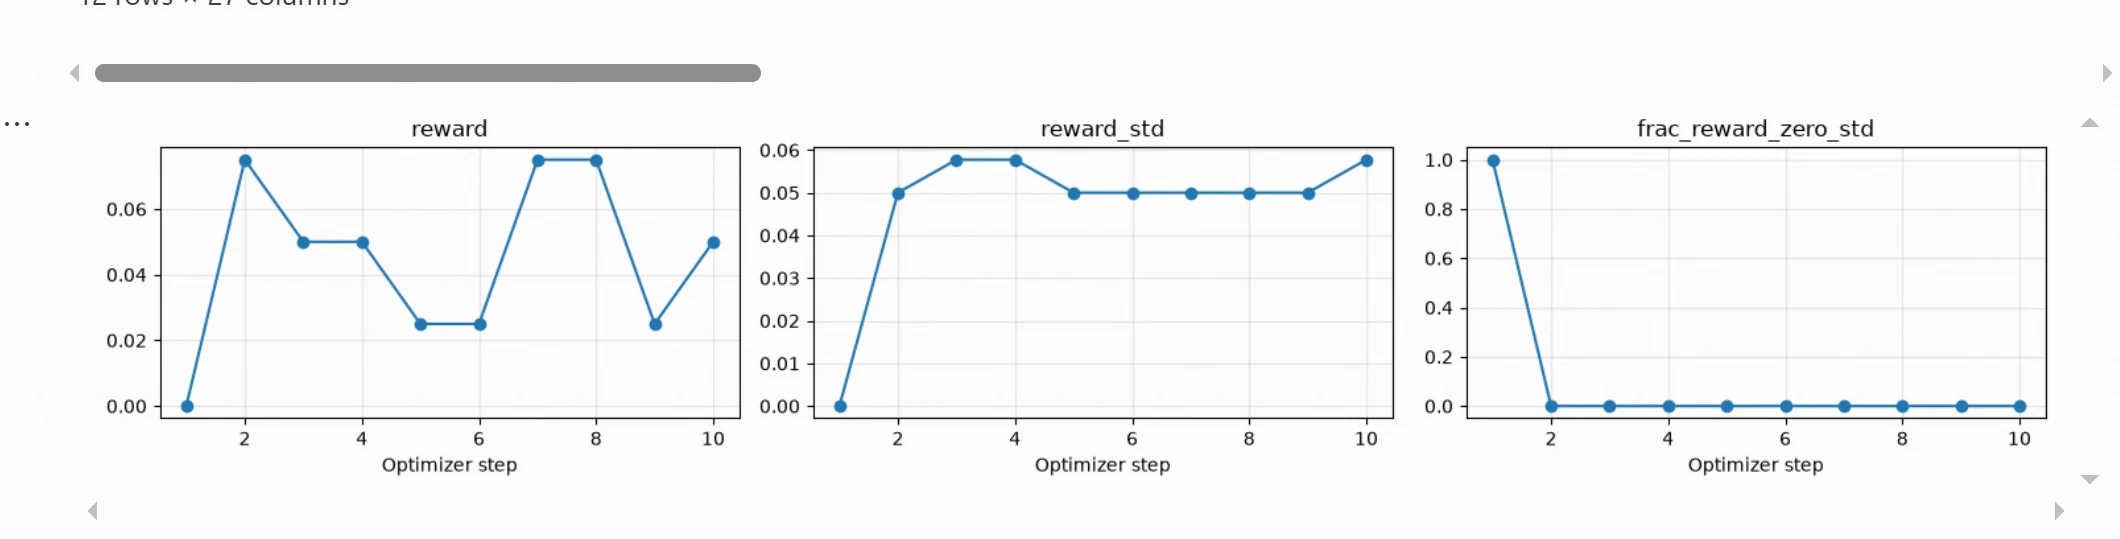
శిక్షణ లాగ్ను చదవండి.
GRPO శిక్షణ నష్టం గణిత ప్రశ్న సరైన రేటు కాదు.
చిత్రం నుండి, శిక్షణ 2వ దశ నుండి సున్నా కాని సమూహం లోపల ఆదాయ తేడాలను ప్రదర్శిస్తుంది.
పూర్తి మూల్యాంకనం మరియు ఫలితాల విశ్లేషణ
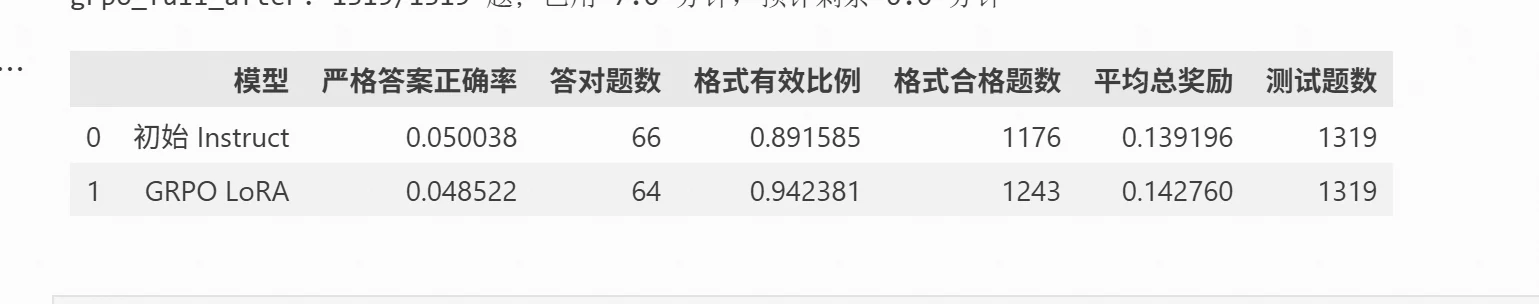
శిక్షణ లాగ్ శిక్షణ ప్రక్రియలో నమూనా చేయబడిన అభ్యర్థులను ప్రతిబింబిస్తుంది, చివరికి స్వతంత్ర టెస్ట్ సెట్తో మోడల్ పనితీరును పోల్చాలి.
ప్రారంభ ఫలితాలు శిక్షణ ముందు grpo_evaluate() ద్వారా సేవ్ చేయబడతాయి.
grpo_after = grpo_evaluate(GRPO_ADAPTER)
grpo_summary = pd.DataFrame([
    {
        "Model": name,
        "Strict answer accuracy": np.mean([r["correct"] for r in rows]),
        "Correct question count": int(sum(r["correct"] for r in rows),
        "Valid format ratio": np.mean([r["format_ok"] for r in rows]),
        "Format-passing question count": int(sum(r["format_ok"] for r in rows),
        "Average total reward": np.mean([r["total_reward"] for r in rows]),
        "Test question count": len(rows),
    }
    for name, rows in [
        ("Initial Instruct", grpo_before), ("GRPO LoRA", grpo_after)
    ]
])
display(grpo_summary)
ఈ పూర్తి మూల్యాంకన ఫలితాలు ఈ క్రింది విధంగా ఉన్నాయి:
పై పూర్తి మూల్యాంకన ఫలితాల ఆధారంగా, మోడల్ ఫార్మాట్ చెల్లుబాటు అయ్యే నిష్పత్తి 89.16% నుండి 94.24%కి పెరిగింది.
ఈ అధ్యాయంలోని అన్ని ప్రయోగ డేటా మరియు కోడ్, https://modelscope.cn/gallery/liucong/8a5fefc5-6f90-42df-9a09-bc9781ed3da8 లో చూడవచ్చు.