Du problème à la tâche modèles • Débutant⏱️ 20 min de lecture
Model Selection with EvalScope
Évaluer d'abord, puis sélectionner : Créer votre premier rapport sur les modèles open-source avec EvalScope
C'est une leçon réelle et douloureuse.
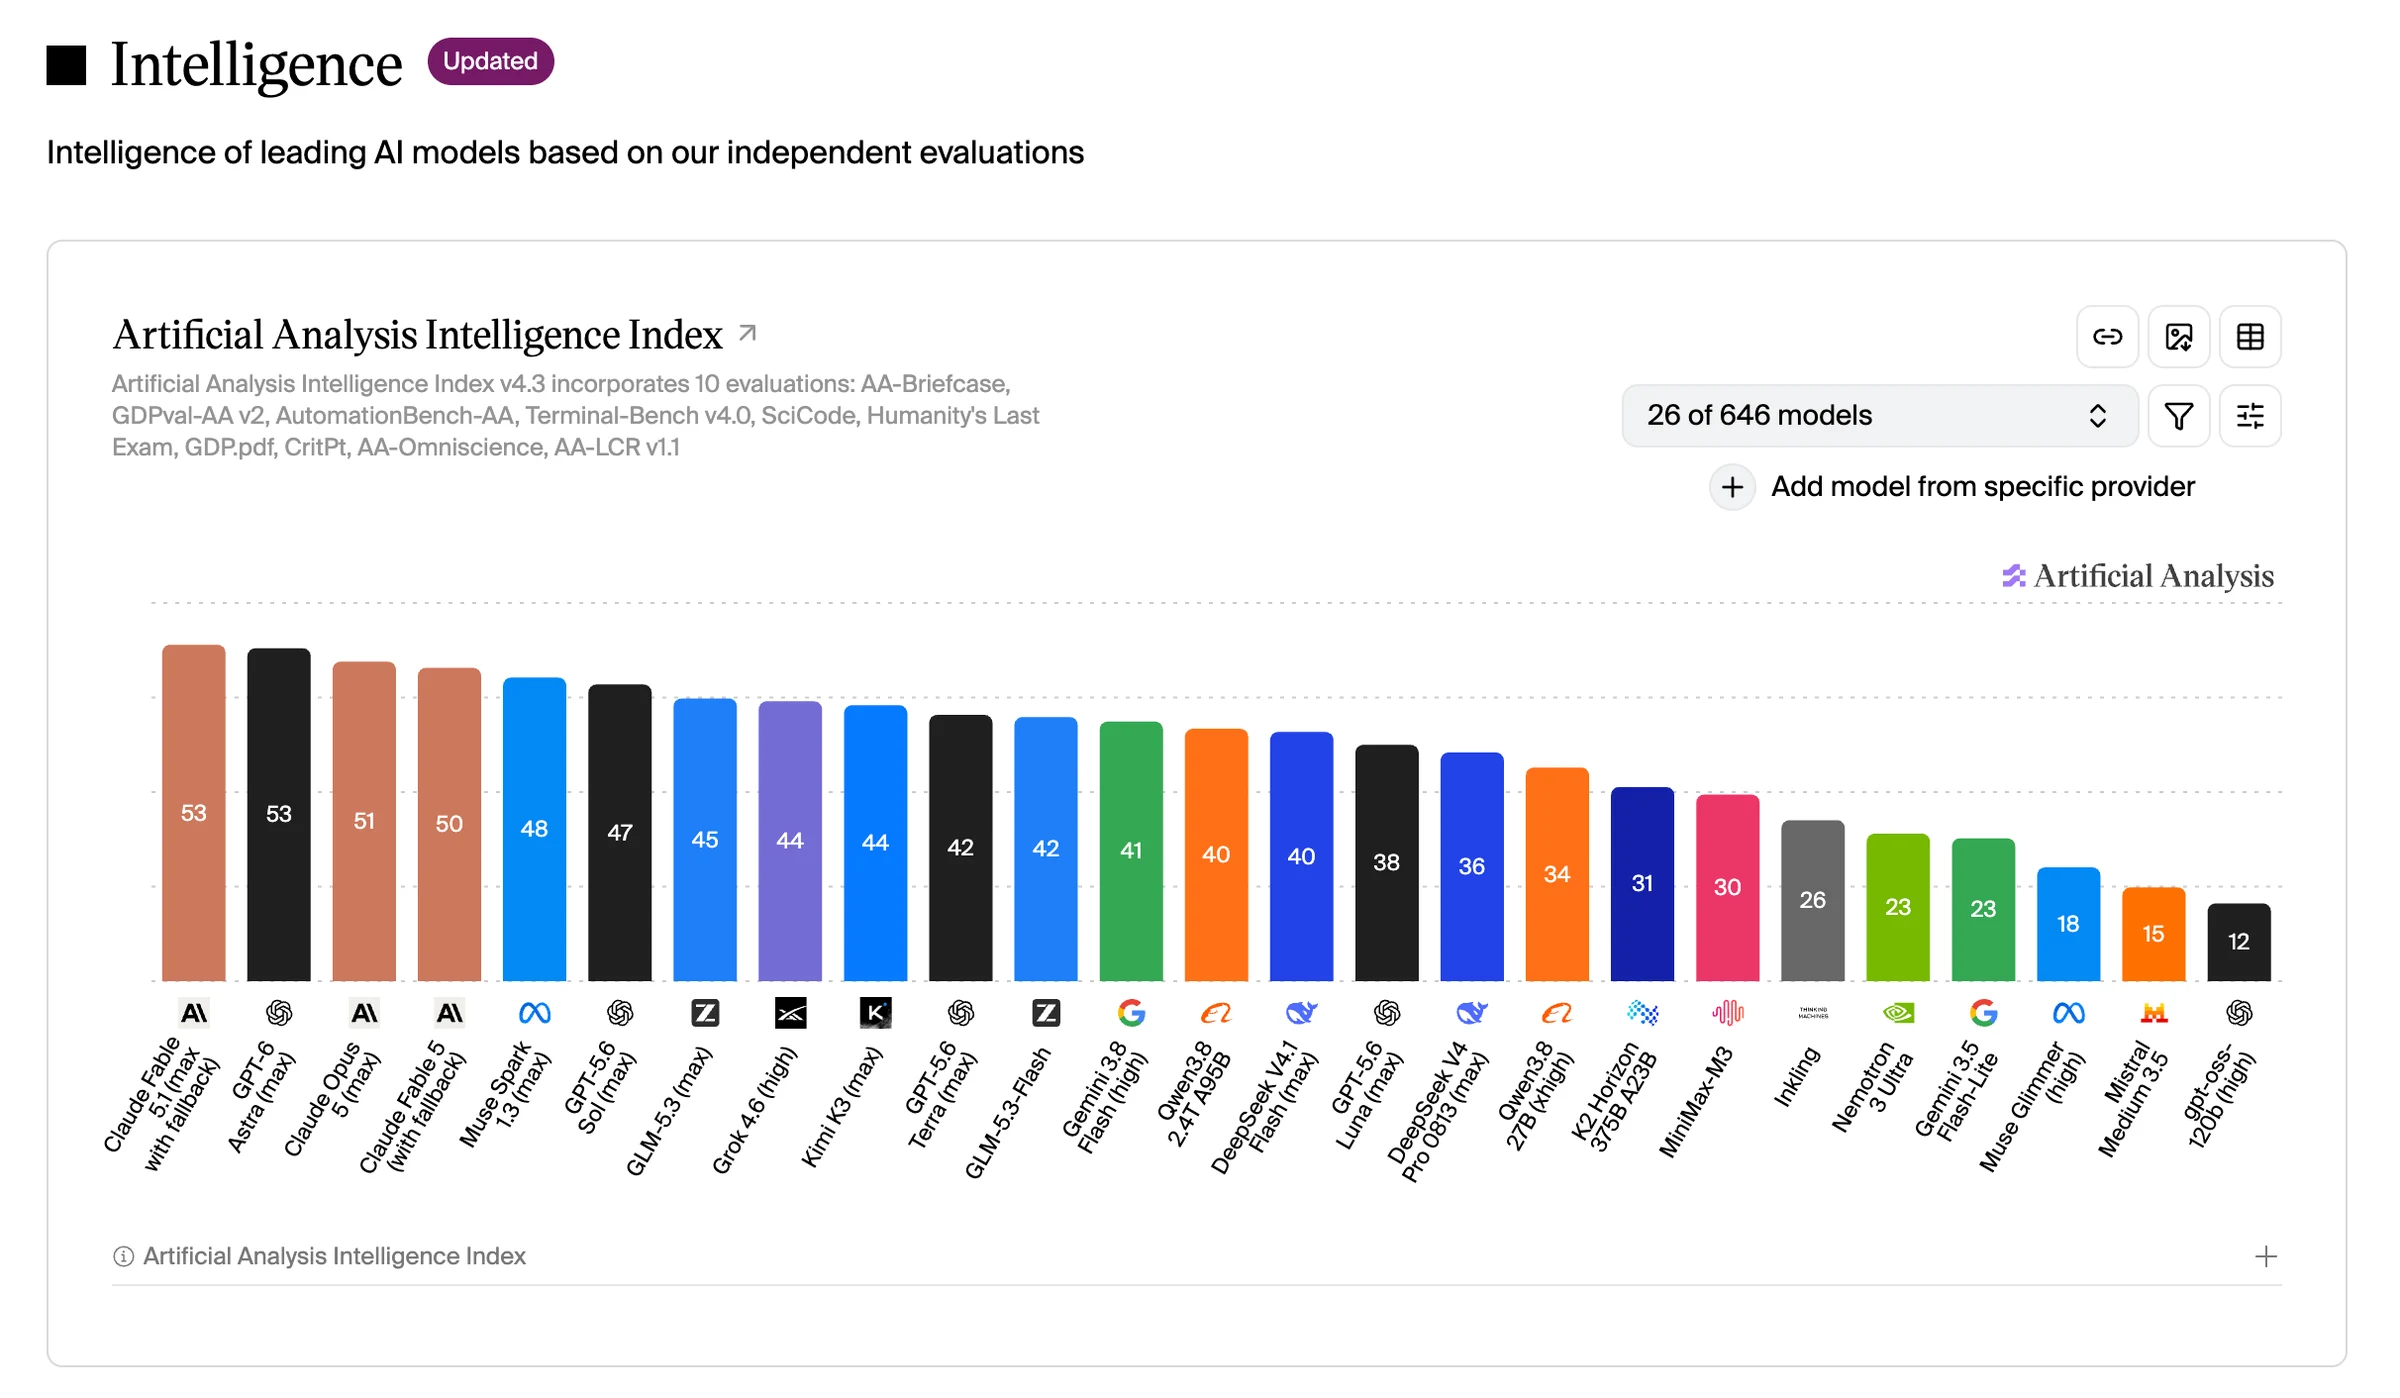
Lorsque j'entraînais des modèles pour les départements métier, j'ai faussement supposé que les modèles les plus récents avec les meilleures performances sur les classements généraux performeraient mieux dans les scénarios métier.
Lorsqu'un modèle aux performances exceptionnelles sur le classement général est apparu, j'ai promis avec assurance que je pourrais rapidement fournir un modèle affiné encore meilleur.
Mais ce n'était pas le cas, car chaque modèle utilise des données très différentes lors de l'entraînement préliminaire et de l'entraînement posterior. Certains modèles ont eu la chance de voir énormément de données similaires à votre activité lors de l'entraînement préliminaire, rendant l'affinage naturellement plus efficace ; tandis que d'autres, malgré de solides capacités générales, sont tout simplement incompatibles avec votre domaine, quel que soit l'affinage.
Avant de sélectionner un modèle, les métriques générales ne peuvent servir que de référence. La sélection finale du modèle doit être basée sur les performances sur vos données métier réelles.
Peut-on choisir un bon modèle en posant simplement quelques questions ?
Lors de la sélection des modèles, nous consultons souvent d'abord les classements, les téléchargements ou les avis en ligne. Nous pourrions aussi préparer directement quelques questions pour interroger le modèle et voir comment il répond. Ces méthodes peuvent nous aider à comprendre rapidement un modèle, mais elles ont toutes certaines limites.
Par exemple, un nombre élevé de téléchargements ne signifie pas nécessairement que le modèle est le plus performant — cela peut aussi être lié à la date de publication, à l'échelle des paramètres et aux barrières d'utilisation. Répondre correctement à quelques questions ne signifie pas non plus que le modèle peut maintenir le même niveau de performance sur l'ensemble des problèmes similaires.
Surtout lors du choix entre plusieurs modèles, si chaque modèle est testé avec des questions différentes, ou si les critères d'évaluation diffèrent, la comparaison directe devient difficile. Parfois, deux modèles semblent tous deux bien répondre, mais lorsqu'ils sont réellement testés sur des centaines ou des milliers de données, il peut y avoir des différences significatives en termes de précision et de stabilité.
L'objectif de l'évaluation des modèles est de transformer des normes d'évaluation incohérentes en une méthodologie de test plus unifiée. Par exemple, préparer 500 questions de test fixes, faire répondre les modèles candidats comme Qwen et DeepSeek séparément, puis utiliser les mêmes règles pour calculer la précision. Ainsi, on peut comparer les performances globales de différents modèles tout en réduisant l'influence du jugement personnel sur les résultats.
Grâce à l'évaluation des modèles, nous pouvons non seulement voir le score final d'un modèle, mais aussi analyser plus en détail sur quels types de tâches le modèle performe bien, quelles catégories de questions il a tendance à mal traiter, et quelle est l'écart entre différents modèles. Ces résultats peuvent nous aider à filtrer les modèles les plus appropriés parmi plusieurs candidats, et fournir une référence pour les tests de données métier, l'affinage et le déploiement ultérieurs.
Que mesurent réellement les scores des benchmarks ?
Pour faciliter la comparaison entre différents modèles, les benchmarks incluent divers types de données, par exemple :
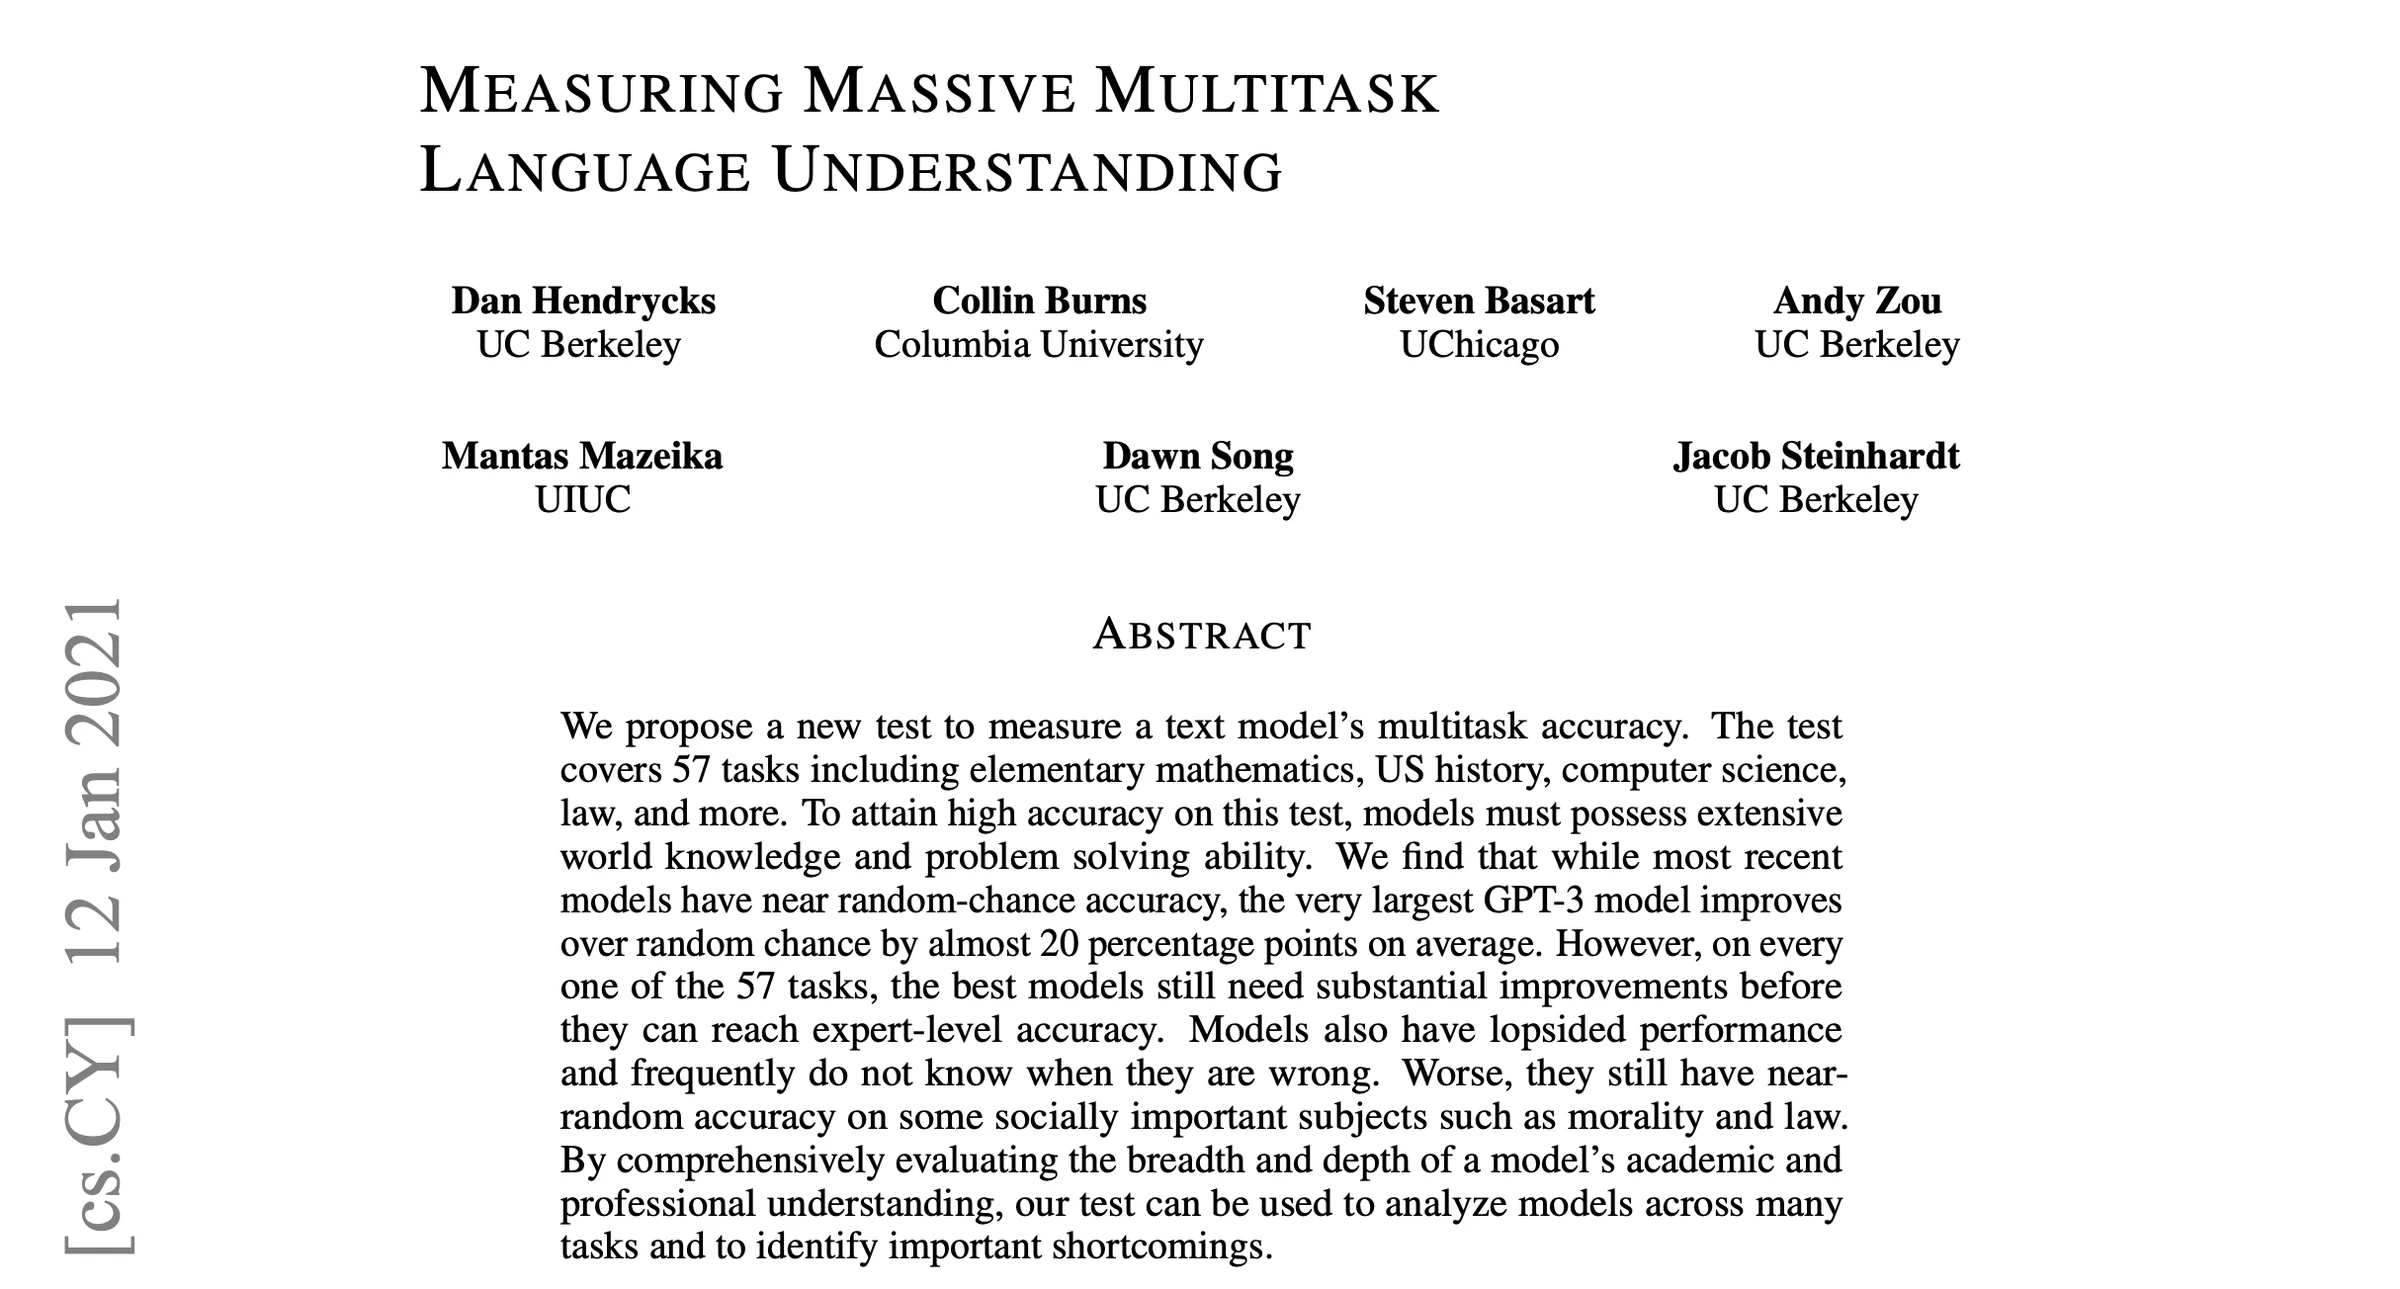
MMLU contient des questions de plusieurs disciplines dont les mathématiques, l'histoire, l'informatique et le droit, principalement utilisées pour observer les capacités de connaissance et de raisonnement du modèle ;
C-Eval et CMMLU contiennent davantage de questions d'examen et de connaissances en chinois, permettant de tester les capacités de connaissances en chinois du modèle ;
GSM8K est principalement composé de problèmes mathématiques, permettant de tester les capacités de raisonnement mathématique ;
HumanEval teste principalement la capacité du modèle à écrire du code selon les exigences ;
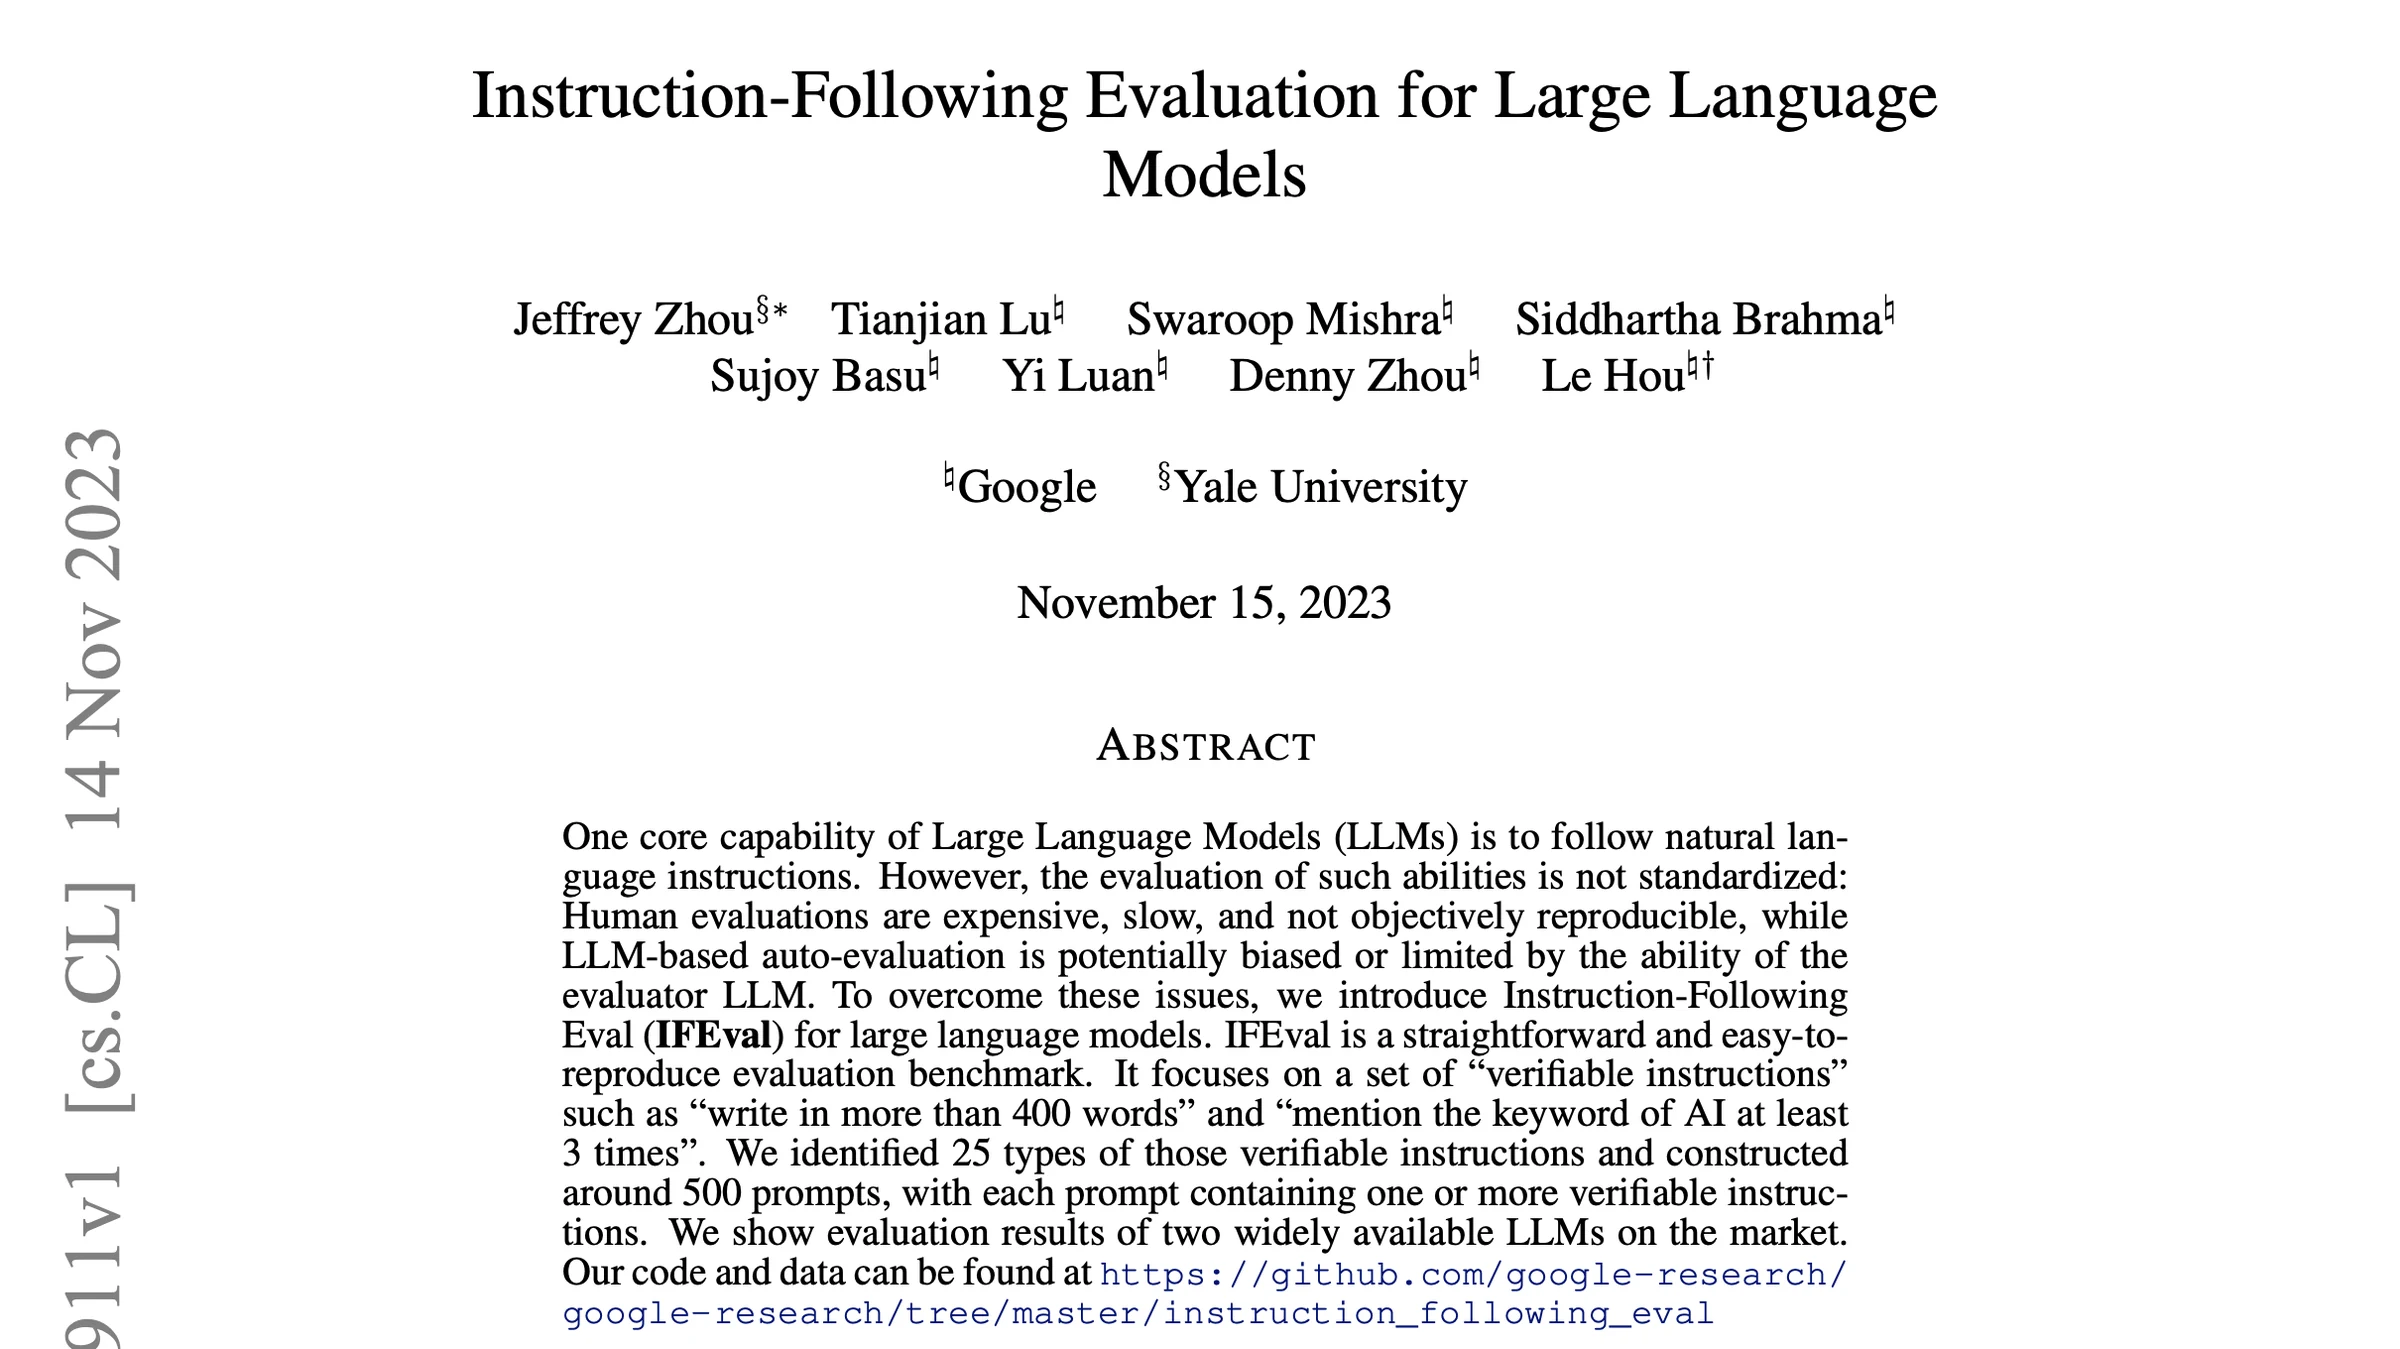
IFEval se concentre sur la capacité du modèle à accomplir les tâches selon les spécifications de l'utilisateur.
Lors de l'évaluation réelle, vous pouvez sélectionner les données qui correspondent mieux à votre propre scénario en fonction de vos besoins métier. Par exemple, si le scénario se concentre davantage sur les performances Q&A en connaissances chinoises, vous pouvez privilégier les ensembles de données liés à la compréhension du chinois, aux connaissances et au raisonnement ; si le modèle est principalement utilisé pour le raisonnement mathématique, vous pouvez vous concentrer sur les ensembles de données mathématiques comme GSM8K.
Grâce à ces benchmarks publics, vous pouvez comparer les performances de différents modèles sur les mêmes données et filtrer les modèles dont les capacités répondent mieux à vos exigences. Cependant, de bons scores aux benchmarks ne garantissent pas nécessairement l'utilité du modèle dans les applications métier réelles.
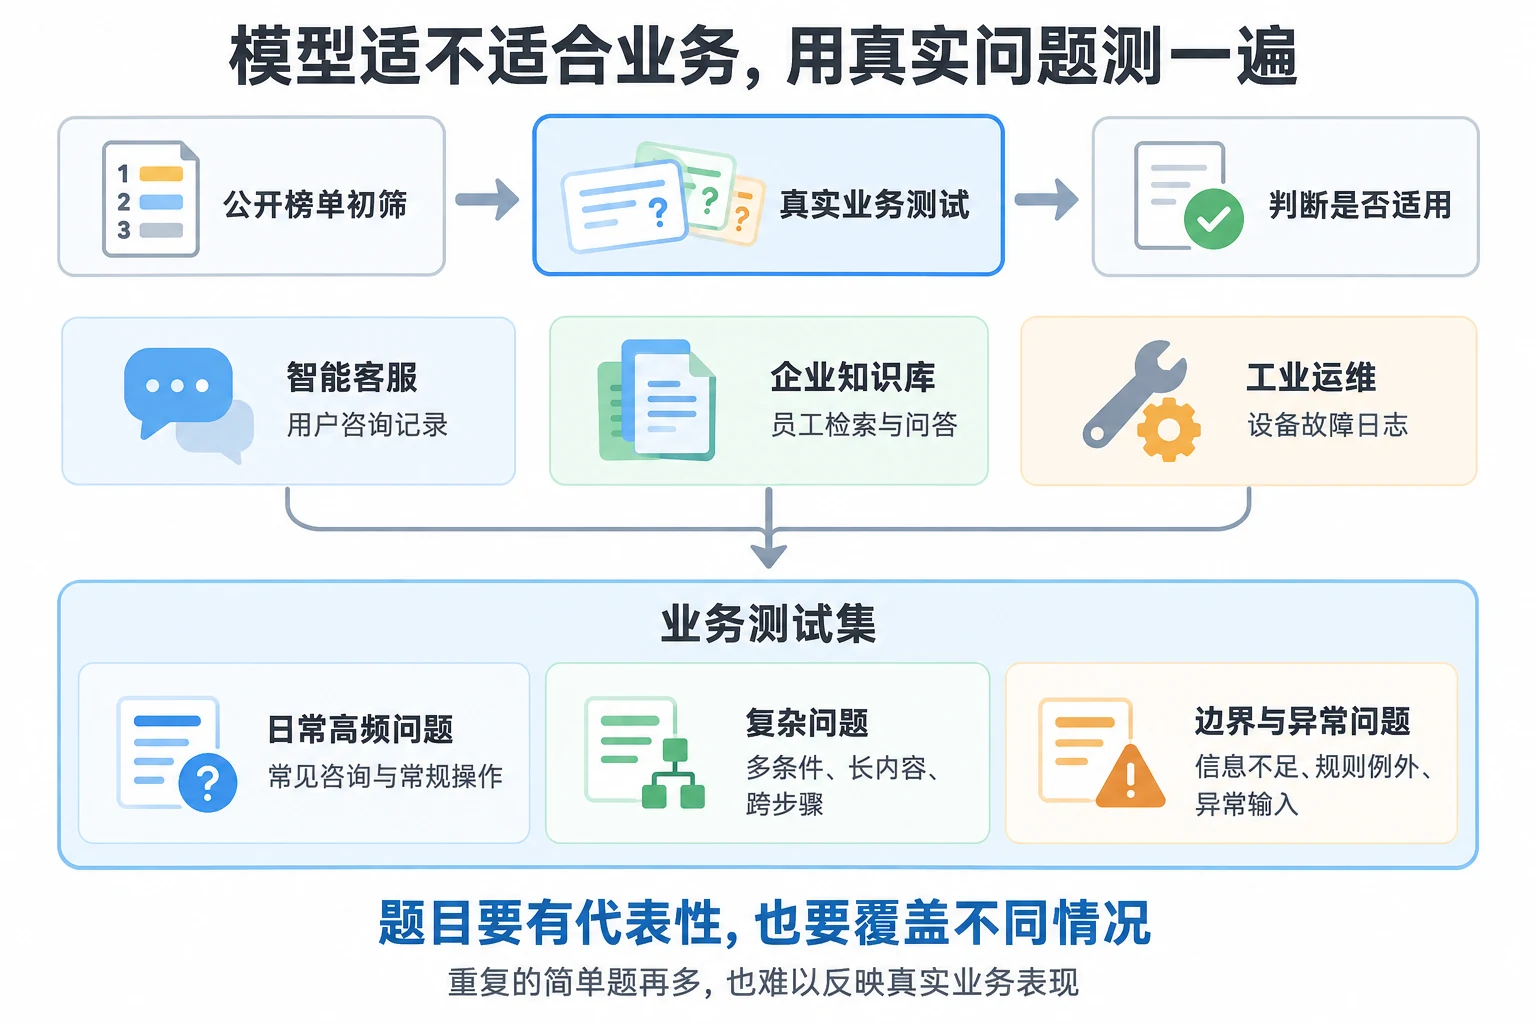
Les données des benchmarks publics sont toutes génériques, tandis que les scénarios métier réels peuvent contenir de nombreuses terminologies professionnelles et règles internes difficiles à évaluer via des ensembles de données publics. En d'autres termes, lors de la sélection des modèles, vous pouvez utiliser les benchmarks pour un premier filtrage afin d'identifier les modèles aux bonnes performances, mais pour l'efficacité spécifique au scénario, vous devez encore utiliser des données métier pour l'évaluation.
Testez à nouveau avec vos propres données métier
Les benchmarks généraux testent les capacités générales d'un modèle, tandis que l'évaluation métier se concentre sur ses performances réelles dans des scénarios spécifiques. Après la première phase de filtrage, la question centrale suivante est claire : ce modèle est-il adapté à notre activité ?
L'évaluation des données métier utilise essentiellement des données générées par de vraies opérations métier pour valider le modèle. Par exemple : pour le service client intelligent, utilisez les vrais enregistrements de consultations ; pour les bases de connaissances d'entreprise, utilisez la recherche et les questions-réponses quotidiennes des employés ; pour l'exploitation industrielle, utilisez les journaux de pannes d'équipement du terrain.
Lors de la préparation des données d'évaluation, les gens ont souvent l'idée fausse que plus de données est toujours mieux. Comparé à la quantité pure, la représentativité et la couverture des données sont en réalité plus critiques. Si vous préparez des dizaines de milliers de données mais que la plupart sont des questions simples et répétitives, même des scores de test élevés n'auront pas beaucoup de valeur de référence. Un ensemble de tests métier raisonnable doit avoir un gradient clair : il doit inclure des questions de base à haute fréquence quotidienne, ainsi qu'une certaine proportion de questions complexes à longue portée et de questions anomales aux limites. Seul un test par couches de données réelles peut garantir que les résultats sont suffisamment objectifs.
Comment EvalScope peut-il aider pour l'évaluation ?
EvalScope est un cadre d'évaluation de grands modèles lancé par la communauté ModelScope, capable d'effectuer une évaluation unifiée et une comparaison horizontale de l'efficacité et des performances d'inférence de différents modèles. EvalScope prend en charge une gamme relativement large, incluant les grands modèles de langage, les modèles multimodaux, et les modèles de recherche courants tels que Embedding et Reranker. Les avantages d'EvalScope se reflètent dans les aspects suivants :
Équilibrer les benchmarks généraux et l'évaluation métier personnalisée
EvalScope est livré avec des ensembles de données de benchmark publics courants pré-installés tels que MMLU, GSM8K et HumanEval, permettant une évaluation directe des capacités de connaissances générales, de mathématiques, de code et de raisonnement logique des modèles. De plus, il prend en charge des ensembles d'évaluation personnalisés — par exemple, l'introduction de données métier réelles telles que la classification de texte, les questions-réponses et l'extraction d'informations dans le processus d'évaluation, permettant ainsi de juger avec précision les performances du modèle dans des scénarios métier spécifiques.
Prise en charge de plusieurs formats de modèles et appels de services
Le cadre EvalScope prend en charge à la fois l'évaluation de modèles locaux hors ligne et les interfaces au format OpenAI standard. Pour les services de modèles déployés via des moteurs d'inférence grand public tels que vLLM et SGLang, ils peuvent être directement intégrés pour l'évaluation, s'adaptant à différents environnements de développement et de déploiement).
Capacité de test de stress des performances d'inférence
En plus de l'évaluation de l'efficacité, les performances opérationnelles d'un modèle après déploiement sont également un critère important pour la sélection. EvalScope peut simuler des requêtes concurrentes multi-utilisateurs, testant des métriques clés telles que le débit, la latence des requêtes, le Time to First Token (TTFT) et le Time Per Output Token (TPOT), reflétant intuitivement la capacité et la vitesse de réponse du service sous scénarios concurrents.
Analyse comparative multidimensionnelle et visualisation des rapports
Une fois l'évaluation terminée, le cadre EvalScope prend en charge la génération automatique de rapports statistiques et de graphiques comparatifs.
Lancez une évaluation pour voir les performances réelles du modèle
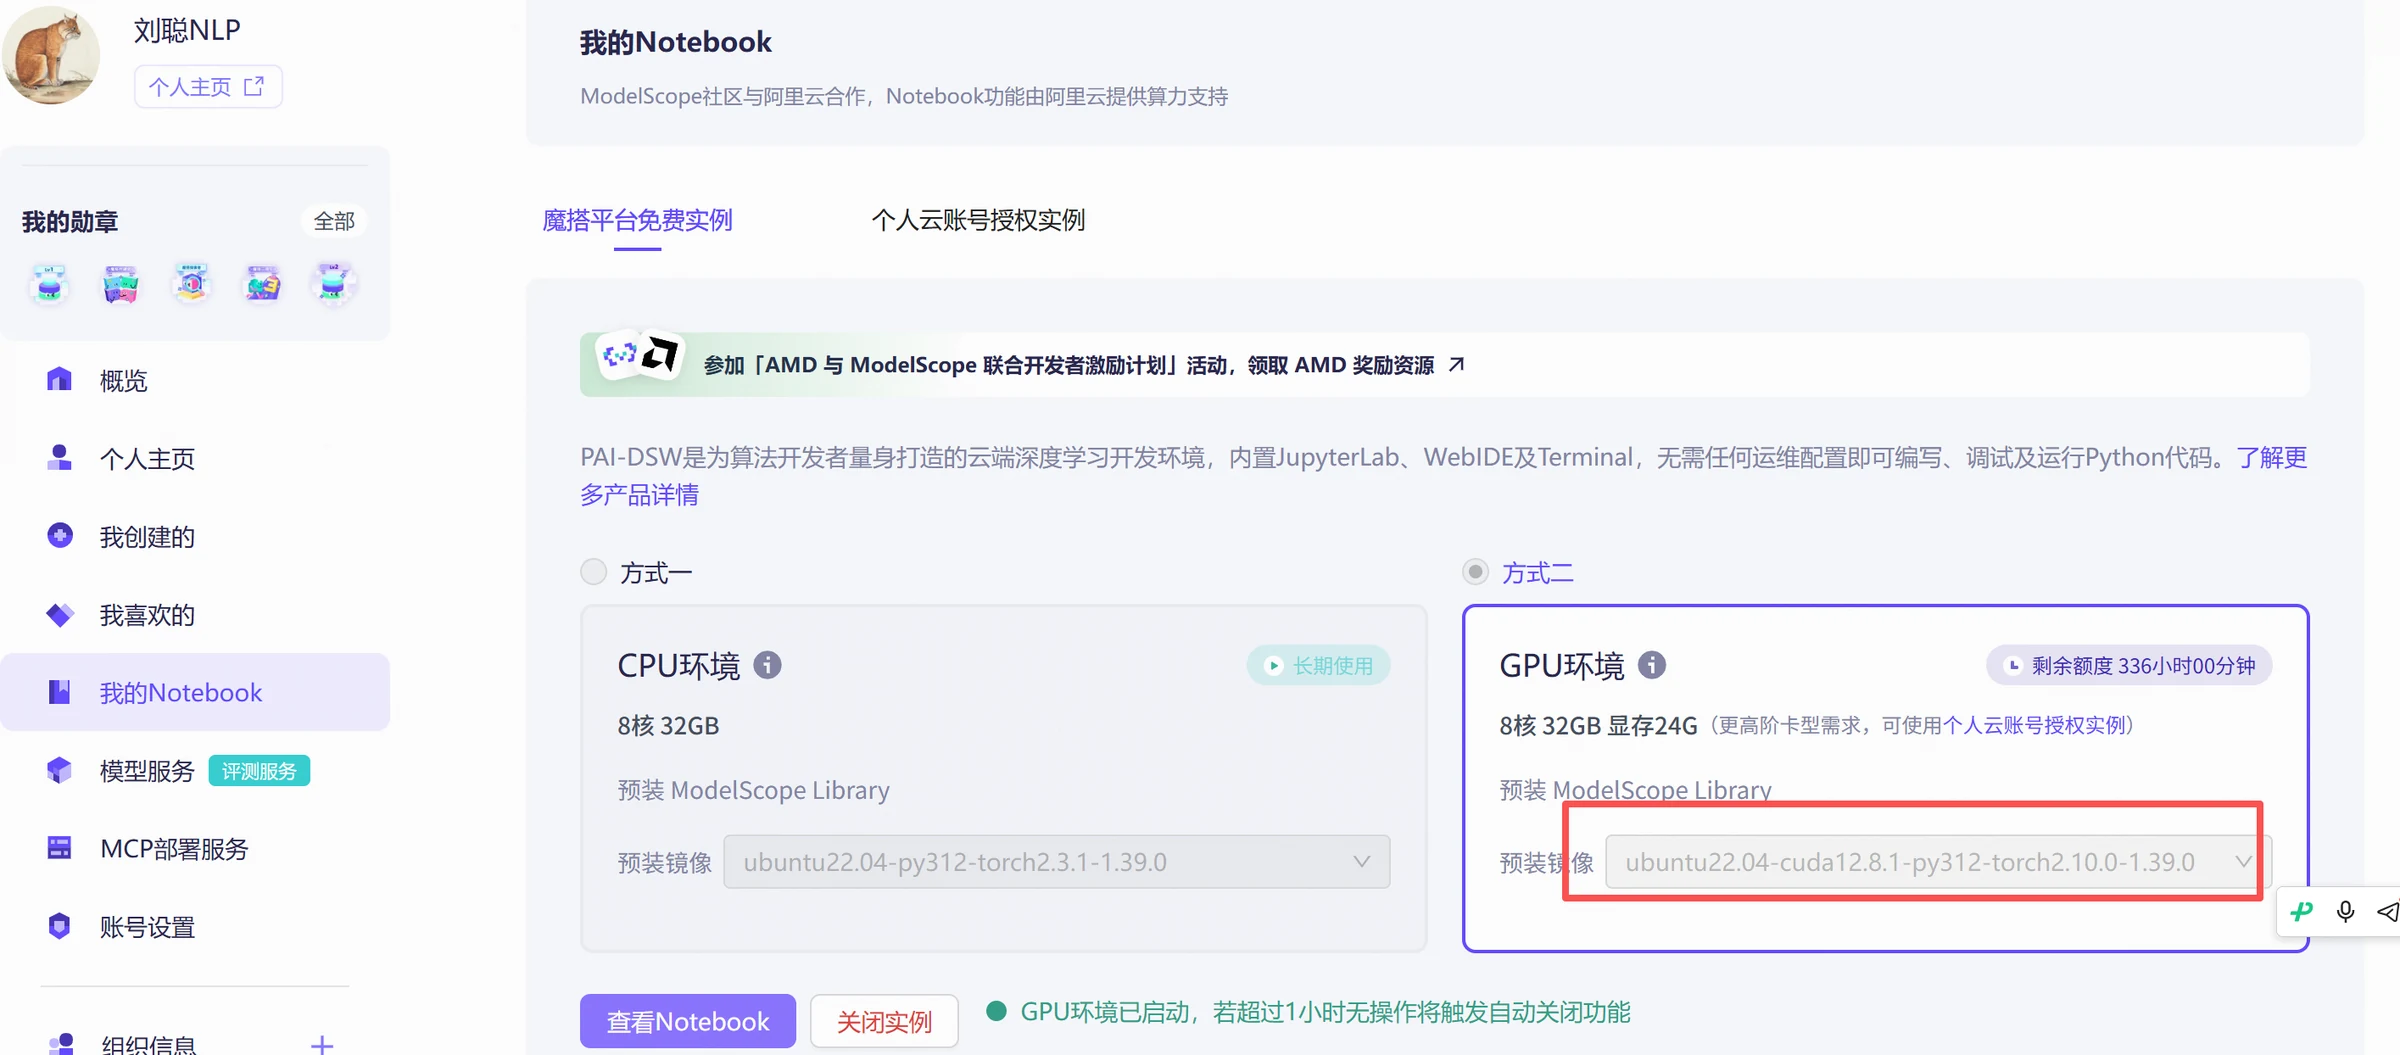
Cette expérience utilise le Notebook de ModelScope avec l'image ubuntu22.04-cuda12.8.1-py312-torch2.10.0-1.39.0
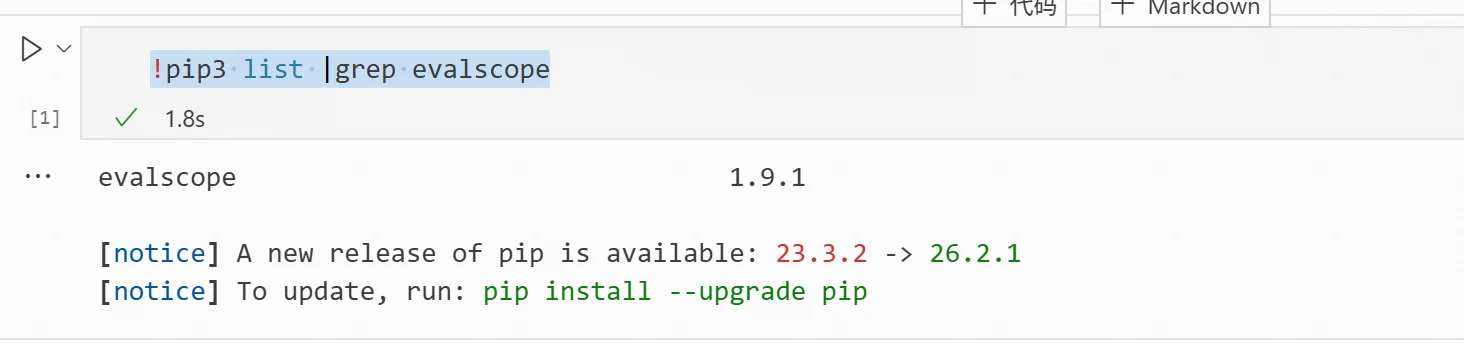
Vérifiez si evalscope est déjà installé dans l'environnement
!pip3 list |grep evalscope
La sortie suivante dans le terminal indique qu'evalscope est déjà installé
S'il n'est pas installé, vous pouvez l'installer directement via pip
!pip3 install evalscope
# Si vous avez besoin de plus de fonctionnalités, utilisez les commandes suivantes pour installer
!pip3 install -e '.[opencompass]'   # Installer le backend OpenCompass
!pip3 install -e '.[perf]'          # Installer les dépendances Perf
!pip3 install -e '.[app]'           # Installer les dépendances de visualisation
!pip3 install -e '.[all]'           # Installer tous les backends (Native, OpenCompass, VLMEv)
Commencez par utiliser un ensemble de données public pour tester les capacités de base
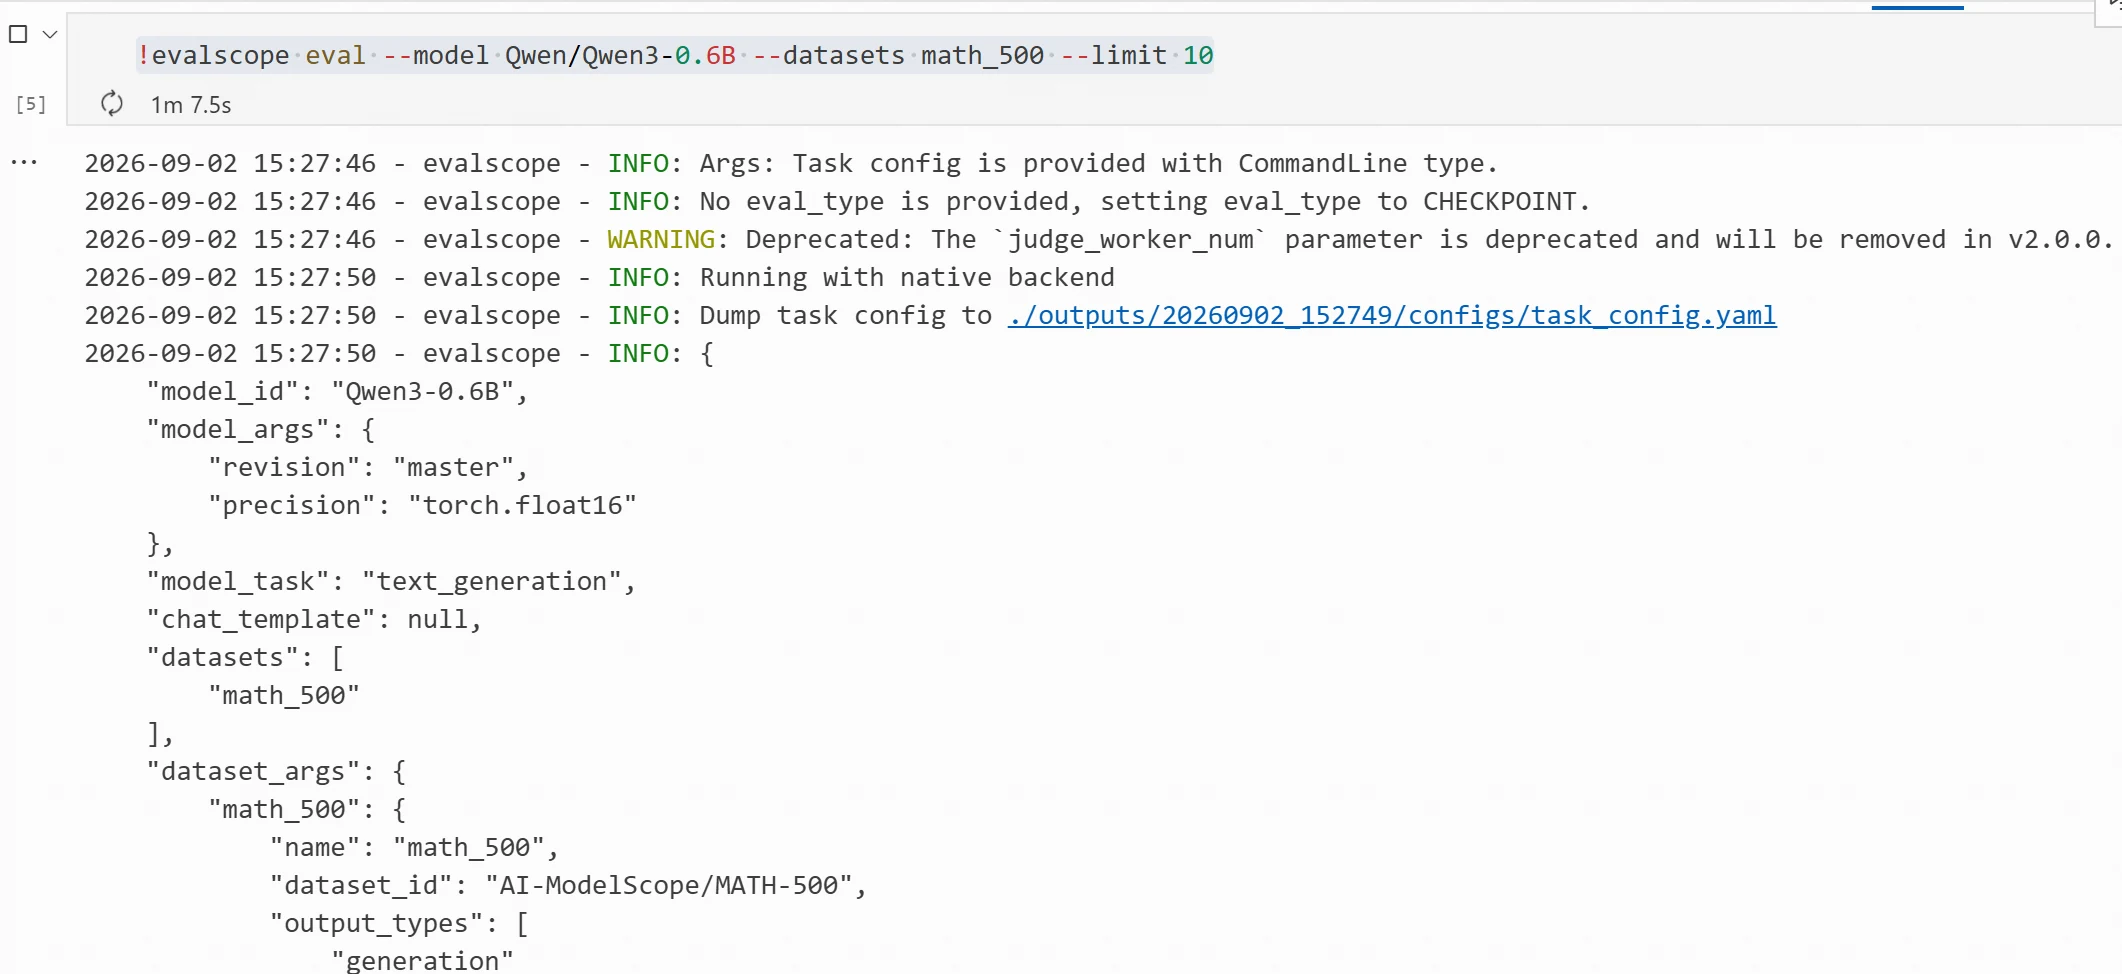
Après l'installation, nous pouvons utiliser un ensemble de données public pour l'évaluation, comme math_500. En utilisant le modèle Qwen3-0.6B, pour un test rapide nous pouvons sélectionner seulement 10 données pour l'évaluation. La commande d'évaluation est la suivante :
Le paramètre --model spécifie le nom du modèle ou le chemin du modèle local,
--datasets spécifie l'ensemble de données d'évaluation,
--limit spécifie combien de données tester.
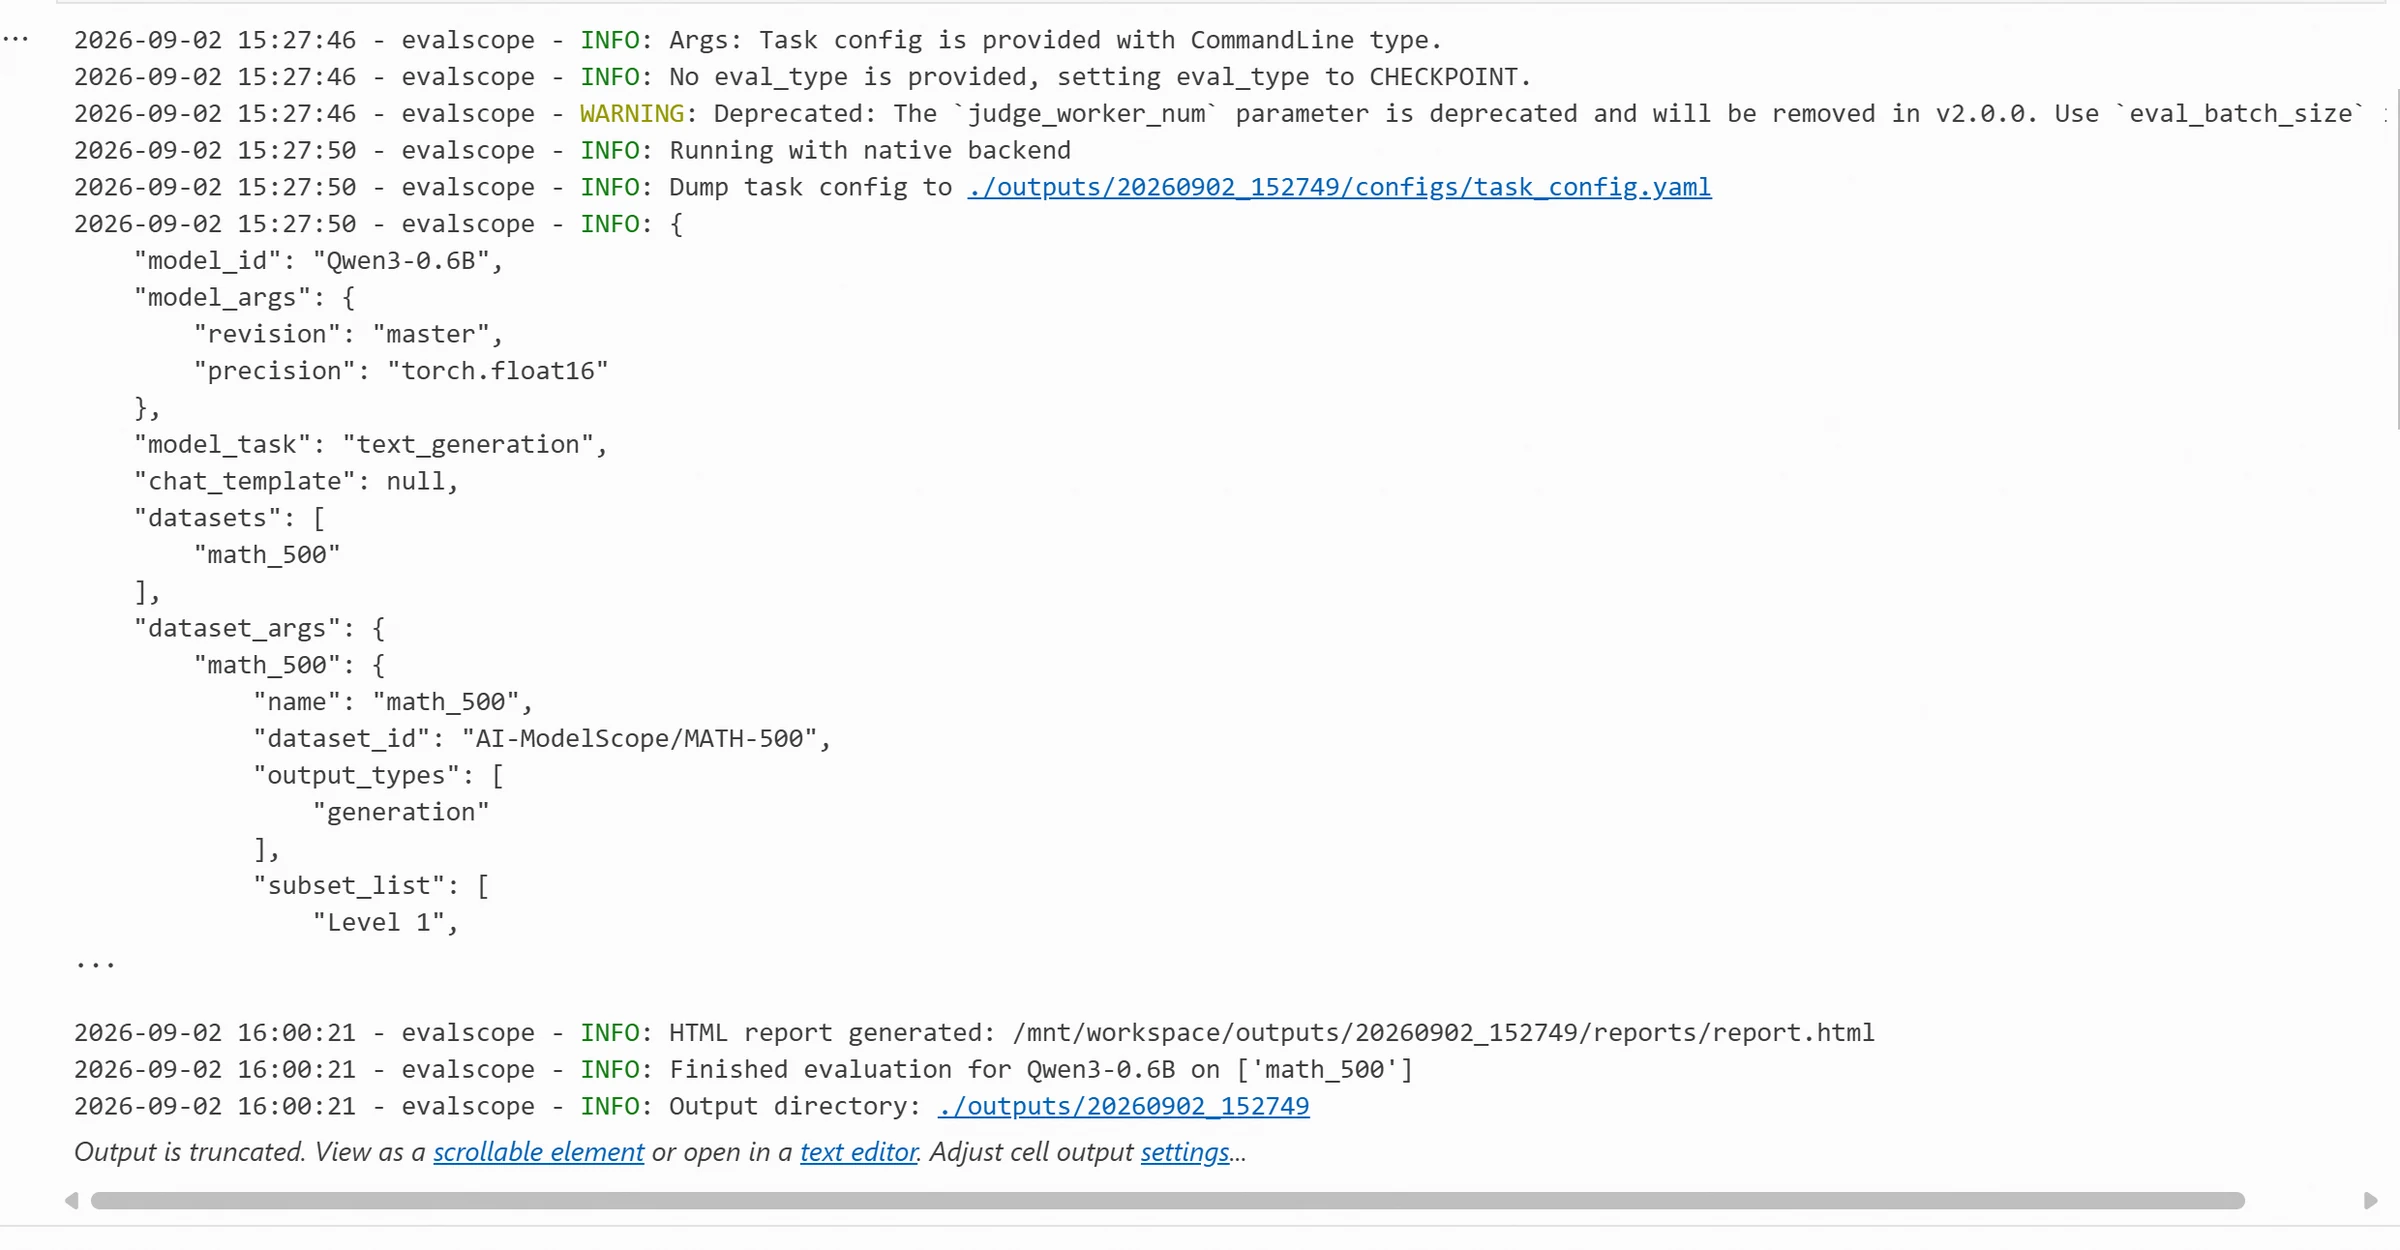
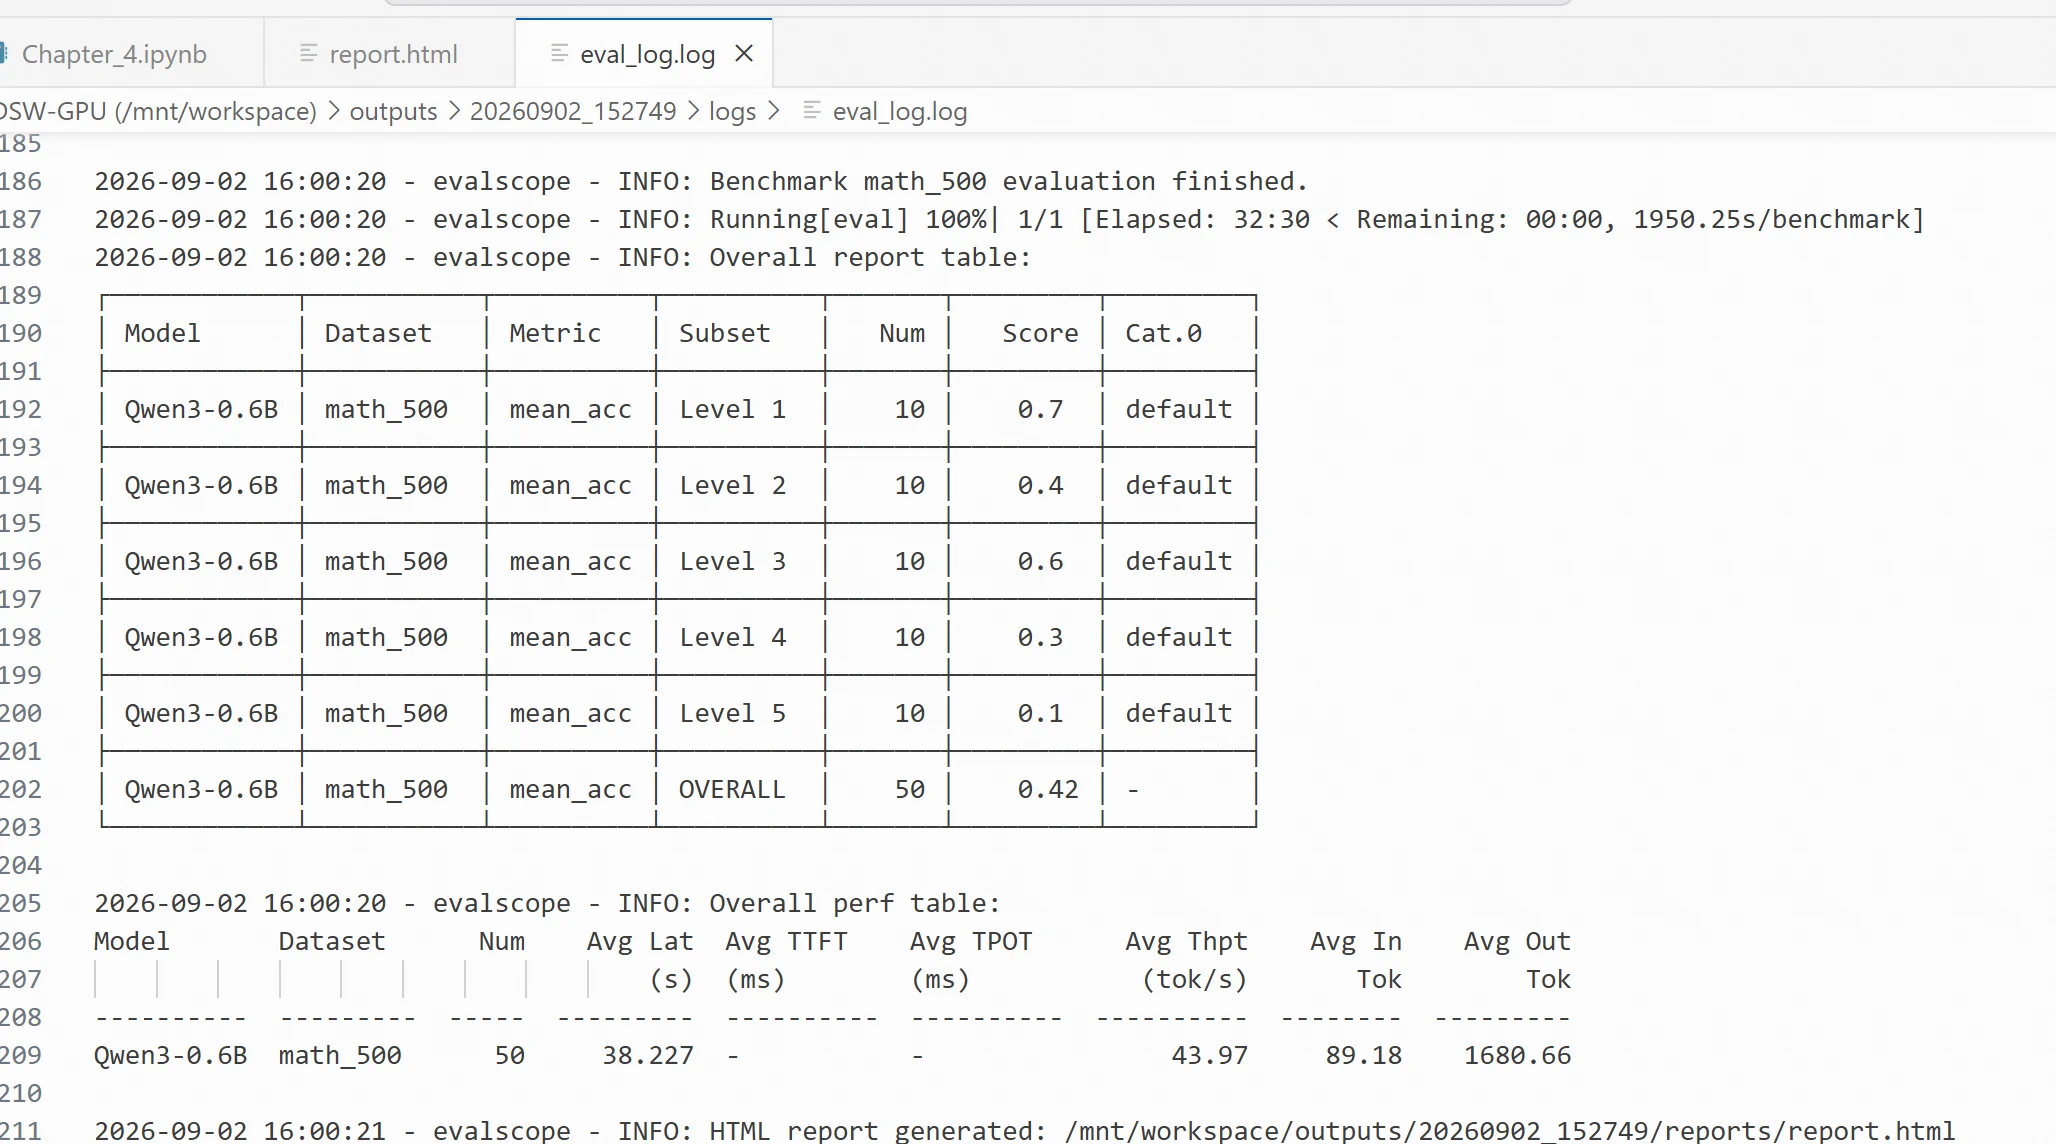
Les résultats de sortie sont les suivants :
Vous pouvez consulter les résultats d'évaluation dans le répertoire correspondant. eval_log.log enregistre les résultats d'évaluation pour les 10 données.
Passez aux données métier pour tester les performances de recherche
Pour évaluer les performances du modèle sur les données métier, nous pouvons définir des données personnalisées pour l'évaluation. Ce chapitre utilise des données de recherche publiques d'un opérateur de télécommunications pour évaluer le modèle Qwen3-Embedding-0.6B.
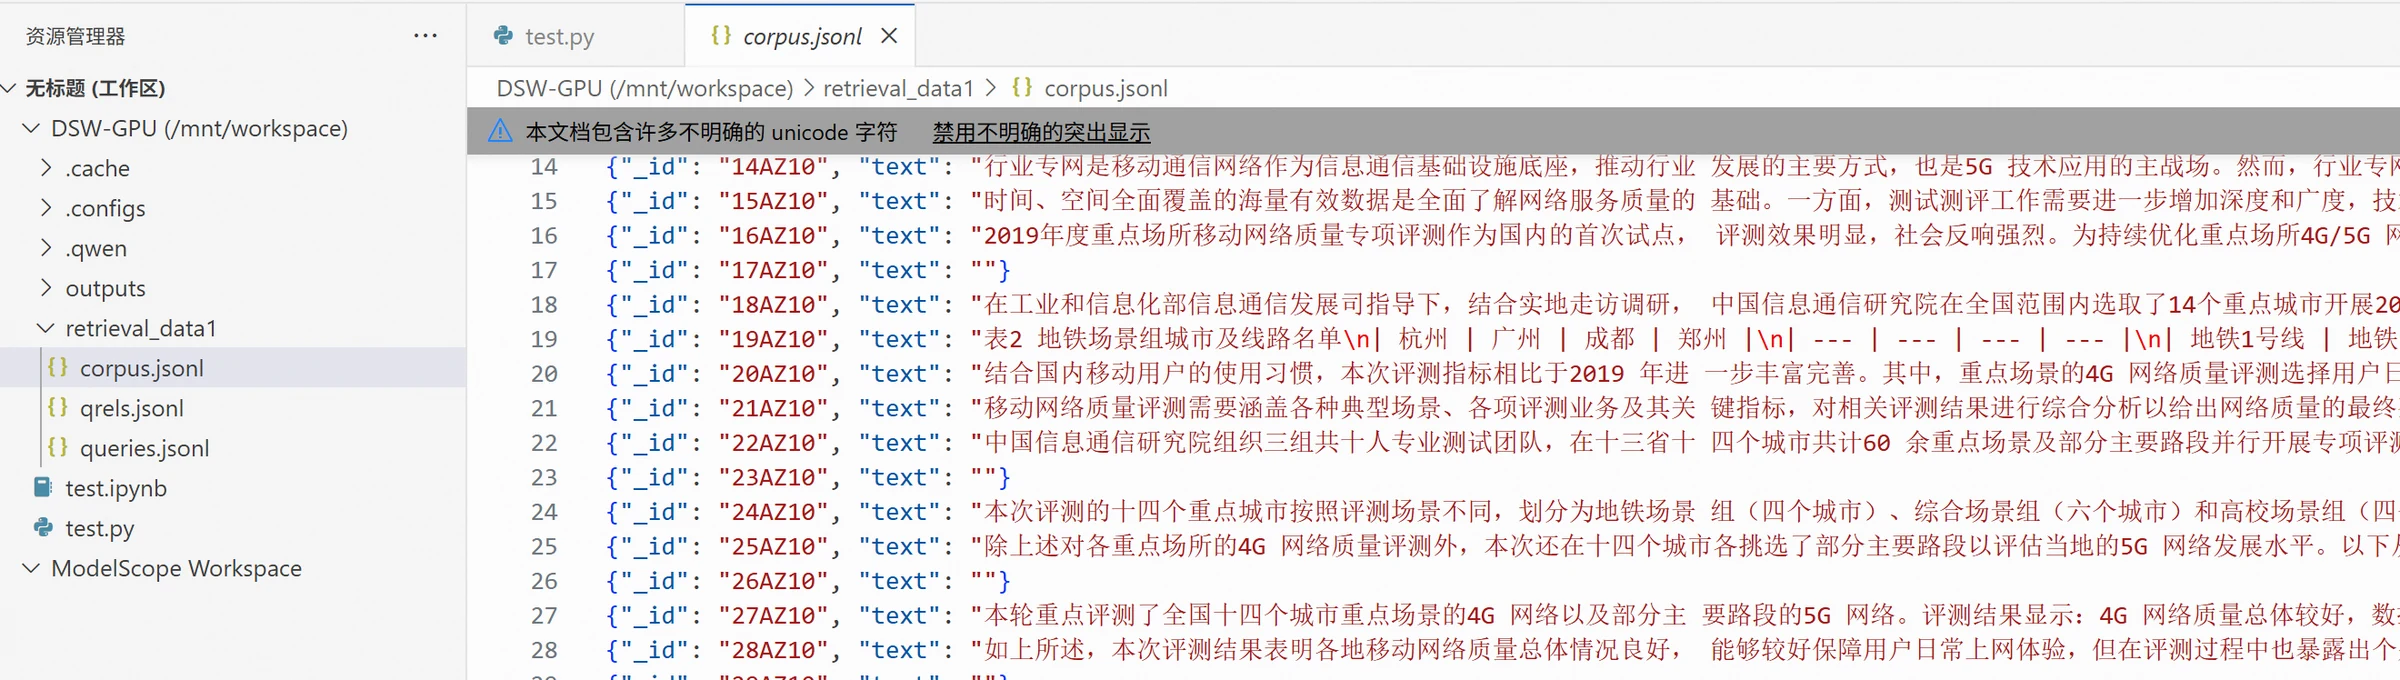
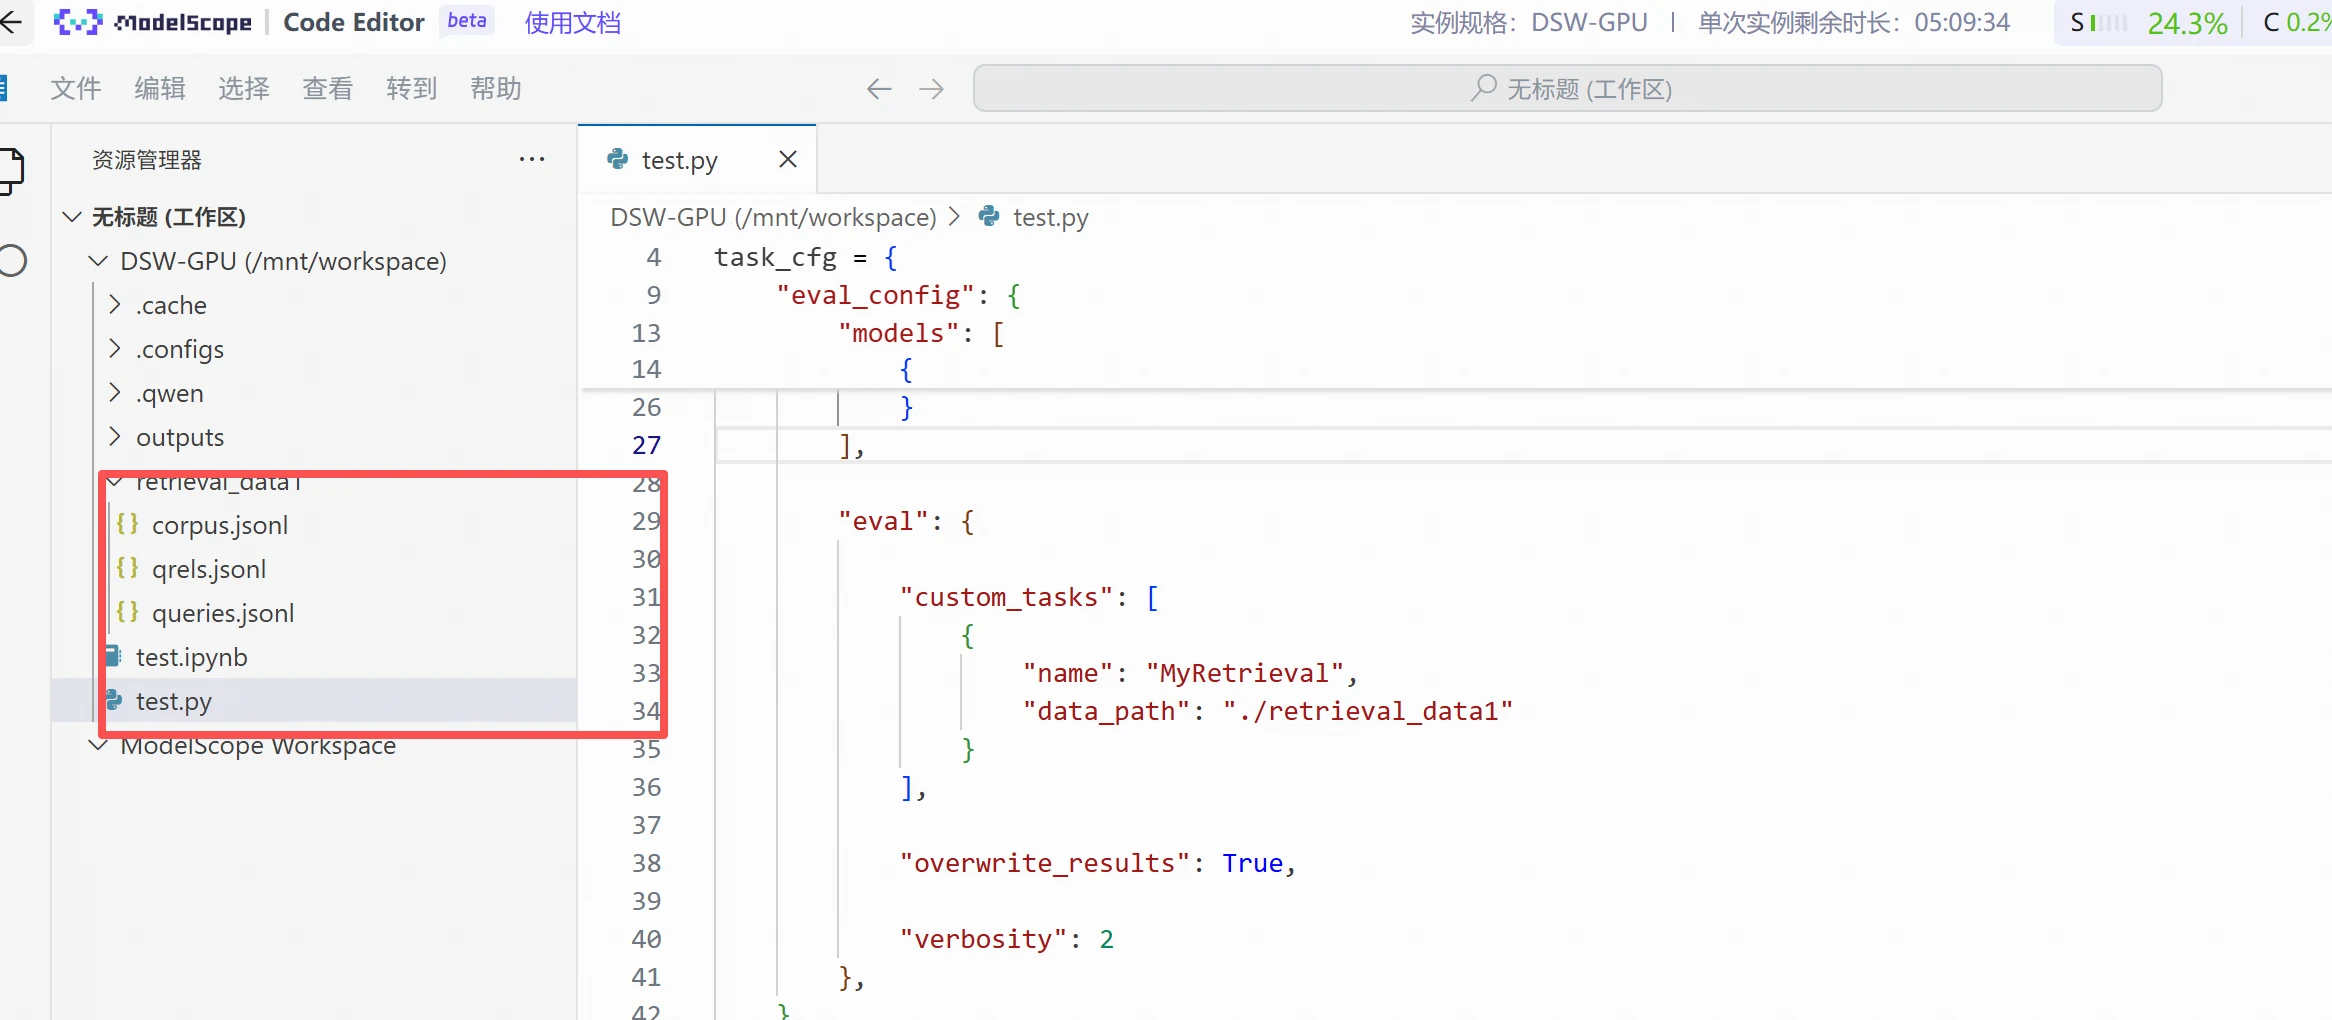
Où corpus.jsonl contient les données de la collection de documents, avec le format : incluant {"_id": "xxx", "text": "xxx"}, où _id est l'identifiant du corpus et text est le texte du corpus. Le format est le suivant :
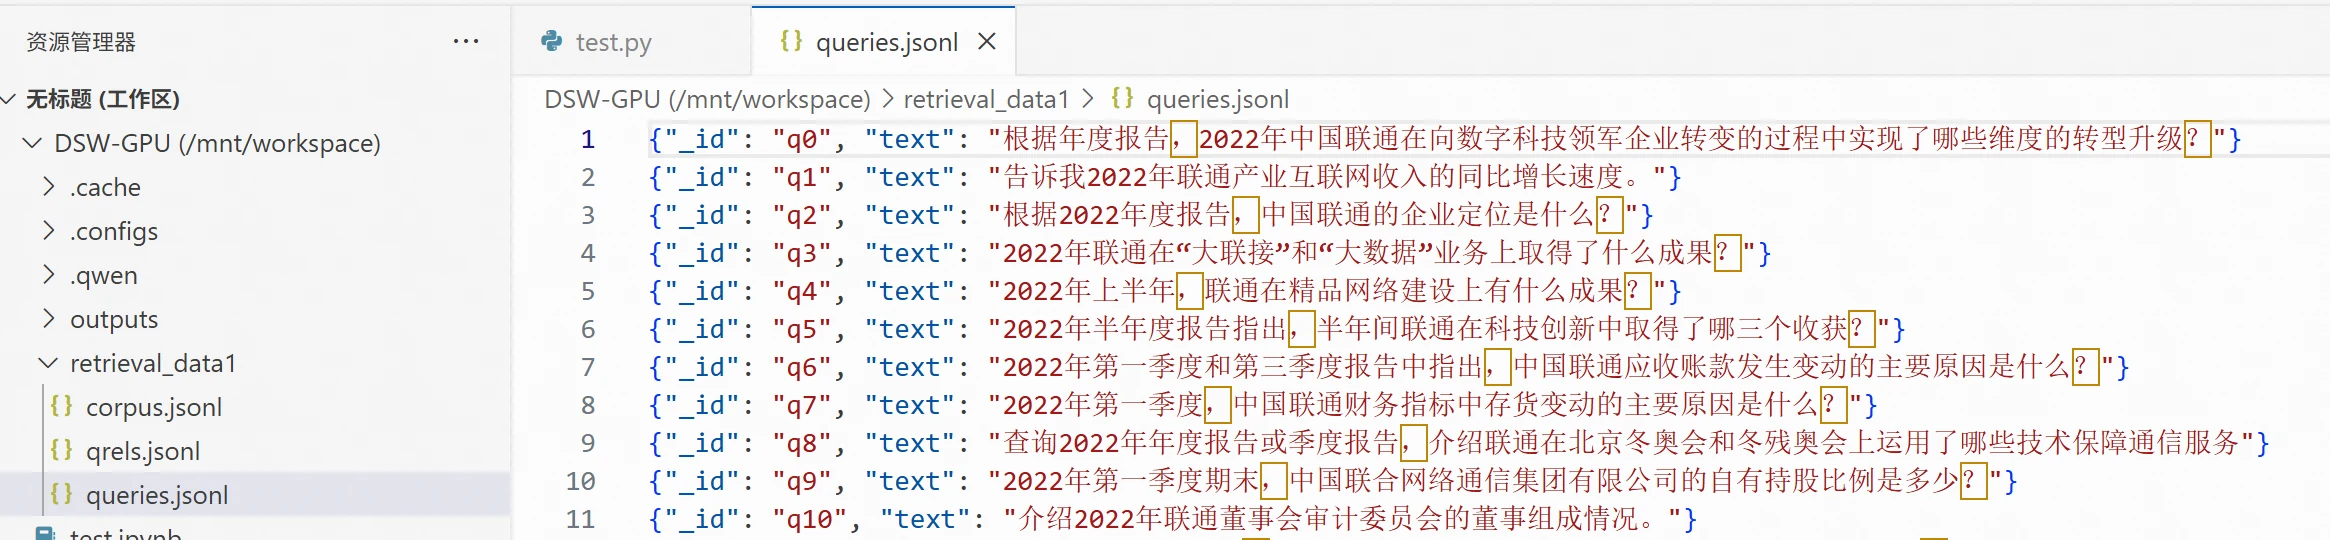
queries.jsonl est le fichier de requêtes, chaque ligne incluant {"_id": "xxx", "text": "xxx"}, où _id est l'identifiant de la requête et text est le texte de la requête. Le format est le suivant :
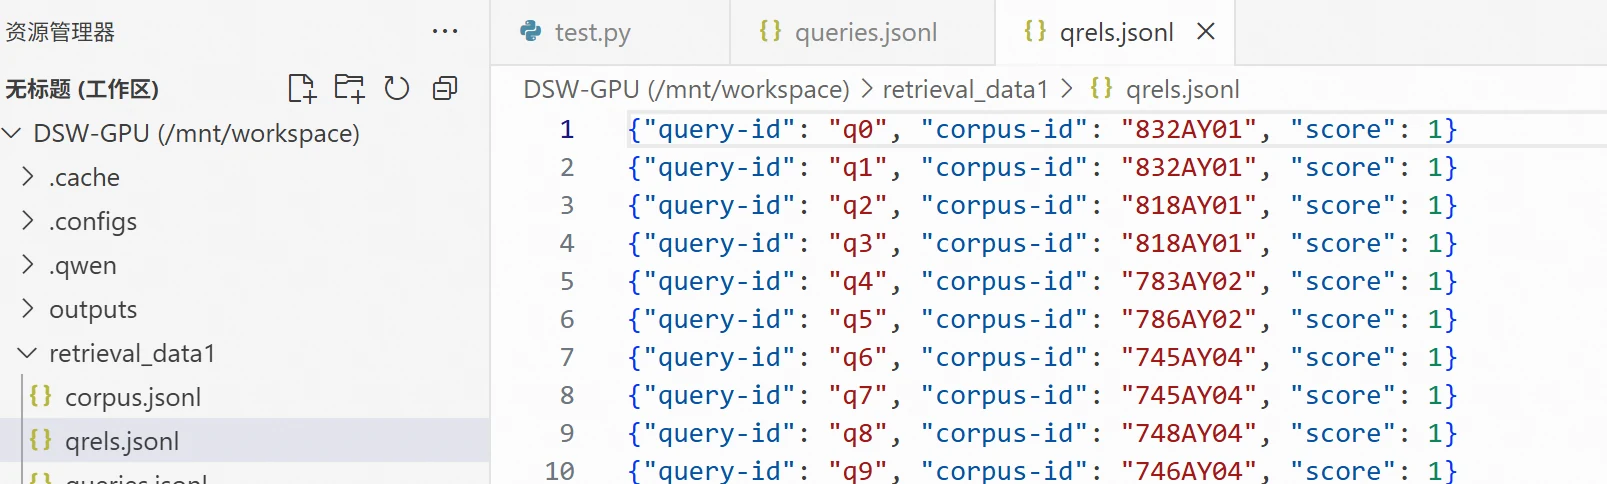
qrels.jsonl est le fichier des réponses correctes, c'est-à-dire les documents corrects correspondant à chaque question. Chaque ligne inclut {"query-id": "xxx", "corpus-id": "xxx", "score": 1}, où query-id est l'identifiant de la requête, corpus-id est l'identifiant de la collection de documents, et score est le score de pertinence. Le format est le suivant :
Il suffit de faire un clic droit et d'uploader ces trois fichiers dans le répertoire spécifié,
Installez le package mteb
!pip install mteb
Installez le package langchain_core
!pip install langchain_core
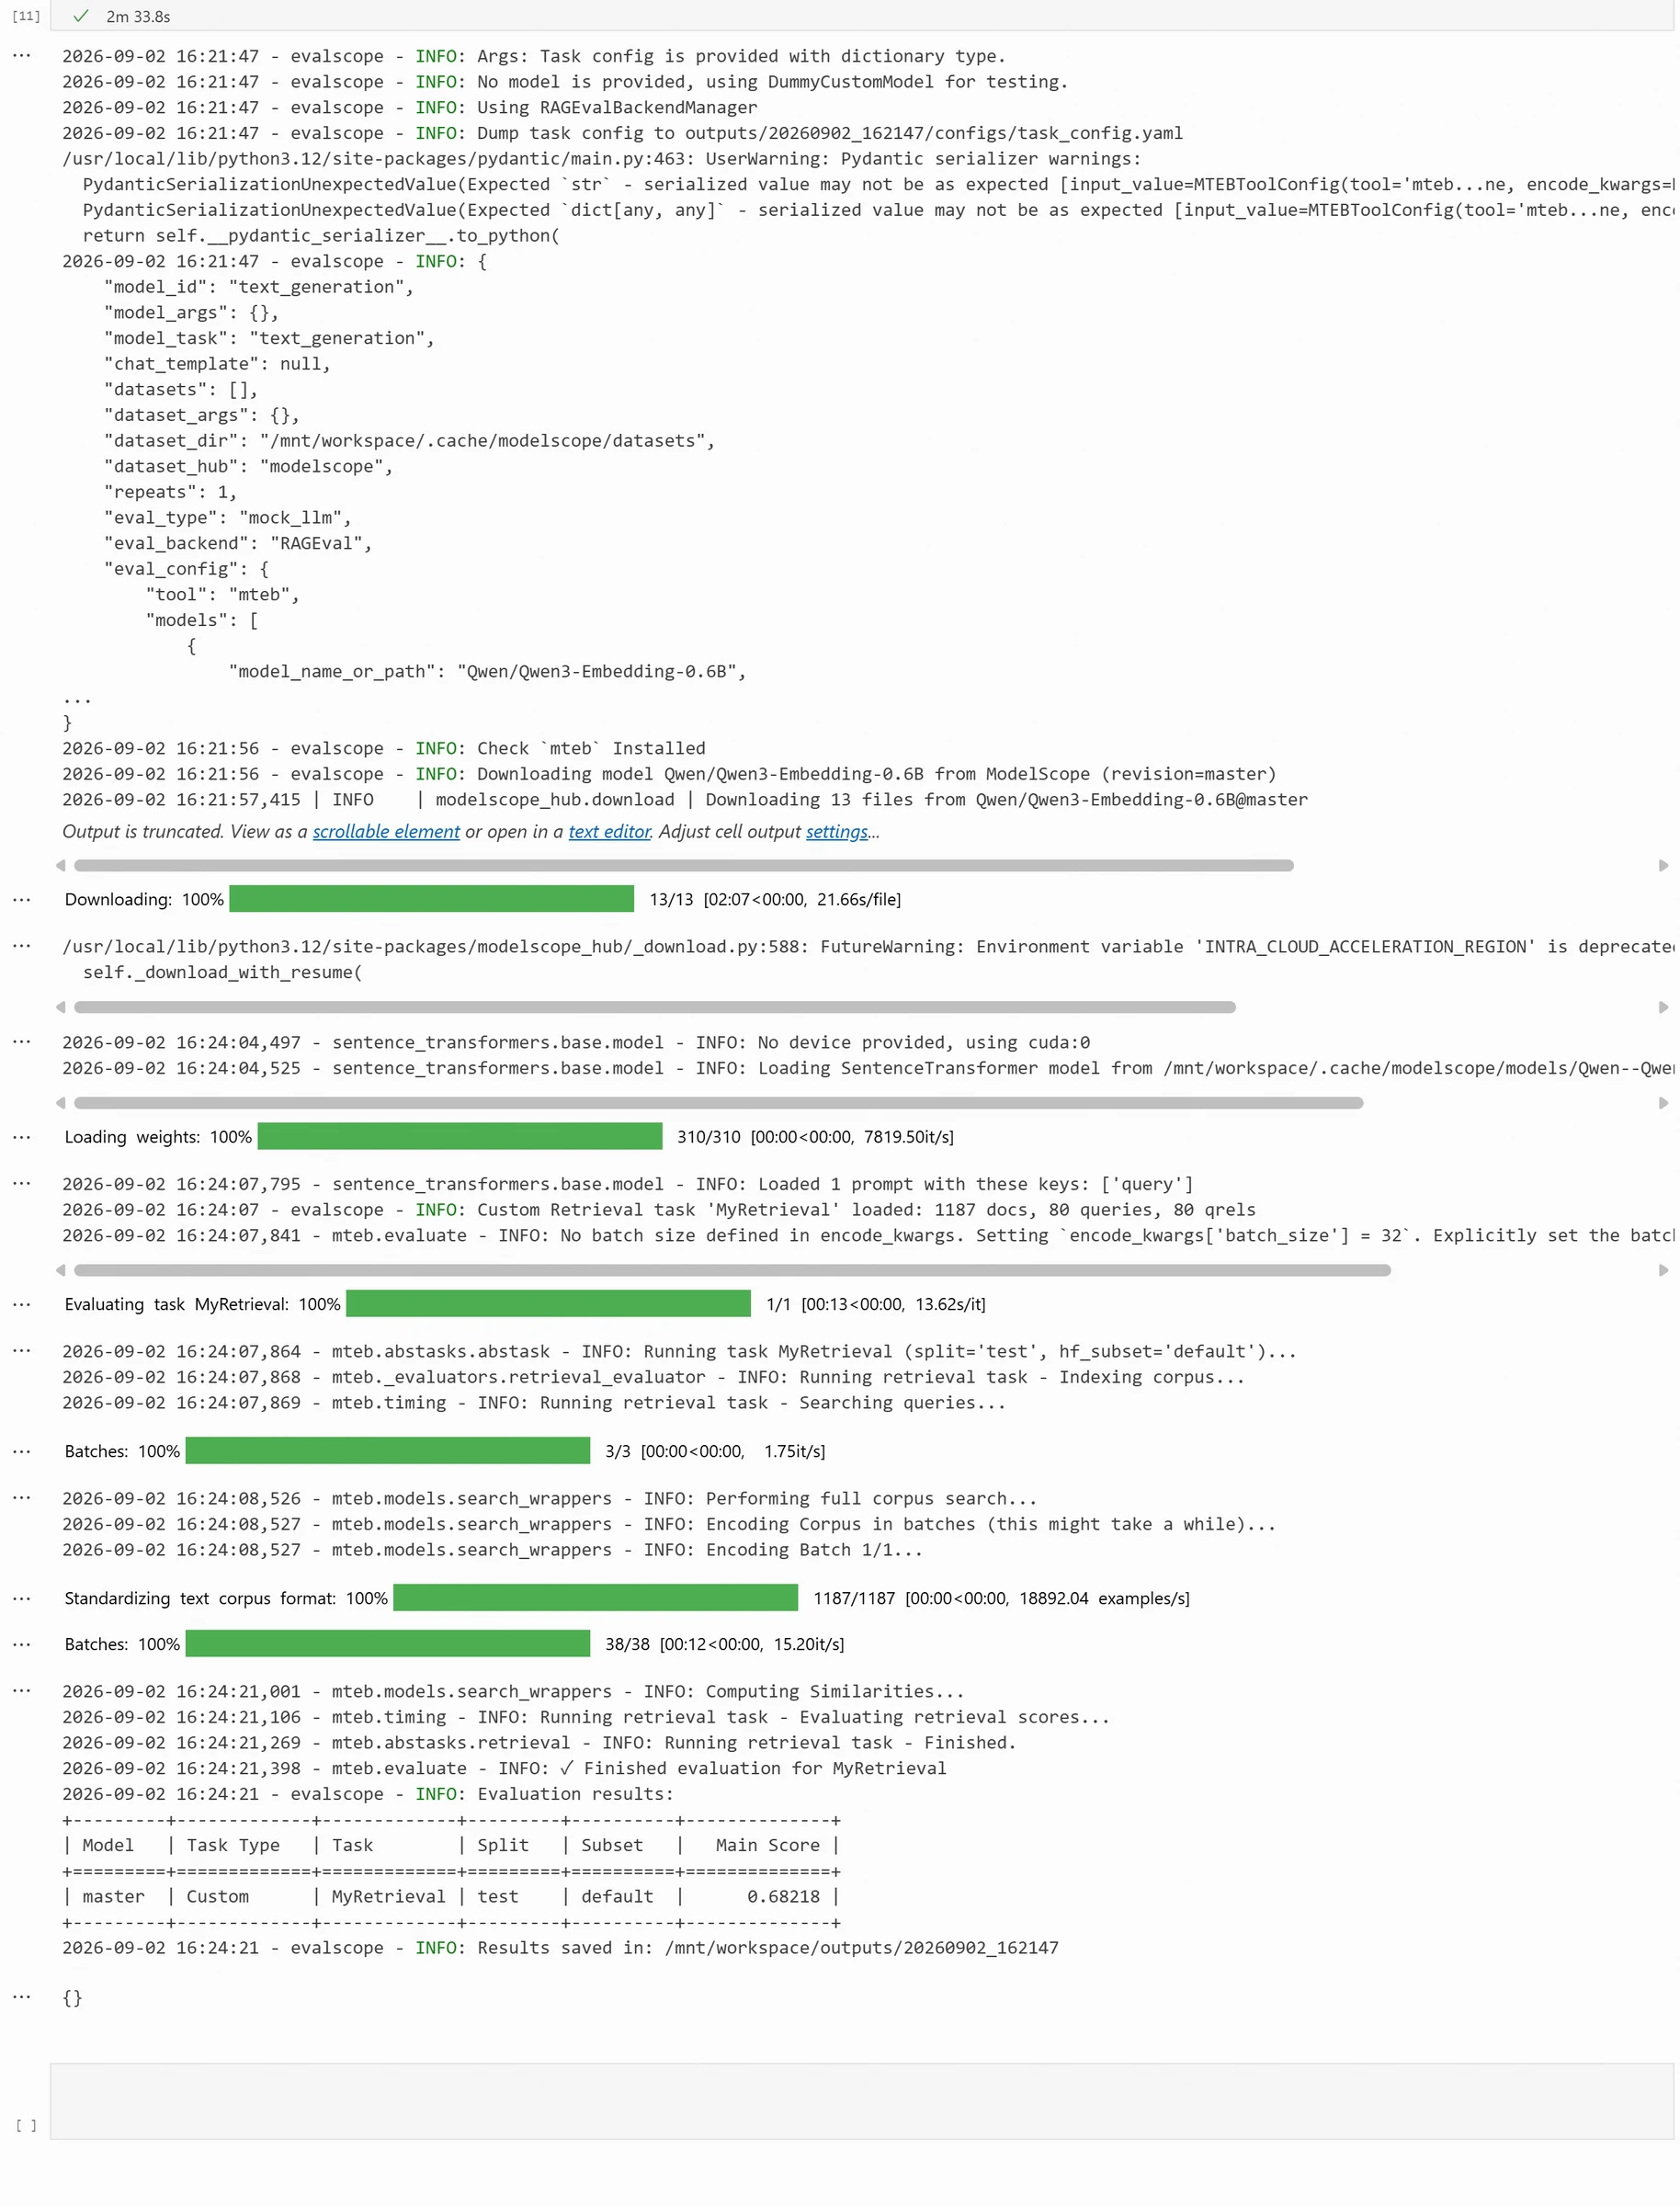
Ensuite, nous pouvons évaluer les performances de recherche de l'Embedding. Le code est le suivant :
Pas seulement l'efficacité — aussi les performances
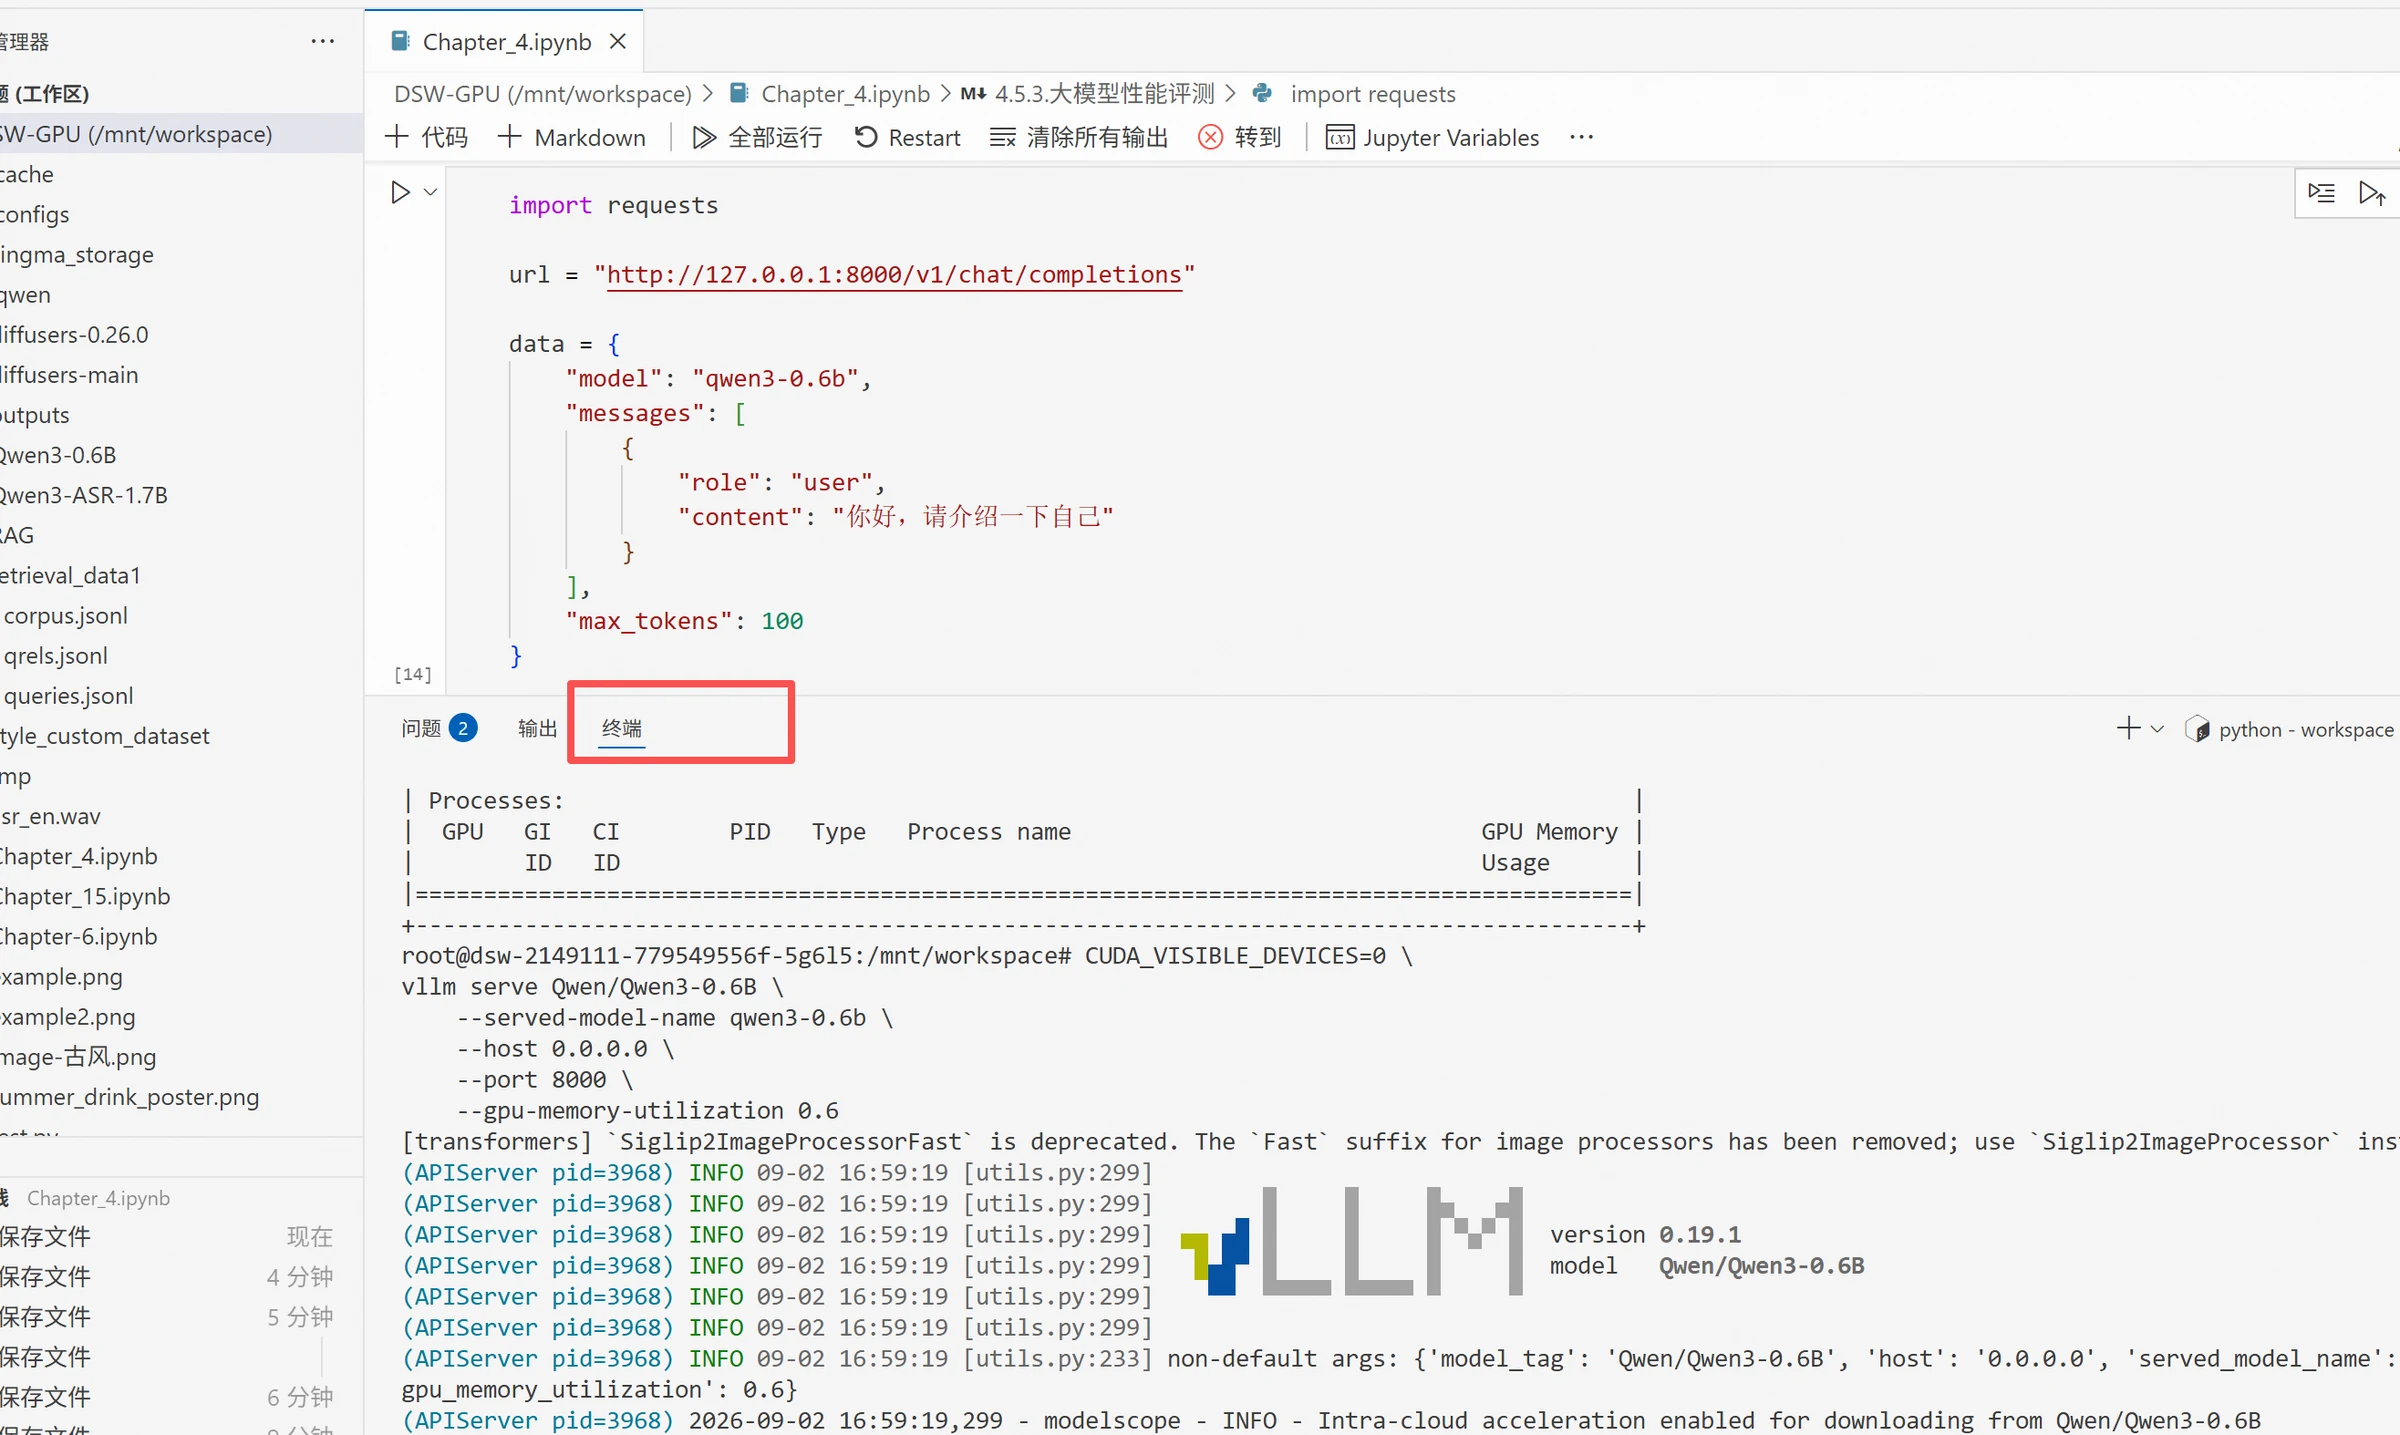
Après avoir terminé le test d'efficacité du modèle, vous pouvez continuer avec le test de stress des performances. Si le modèle est déjà déployé via des cadres d'inférence comme vLLM, vous pouvez utiliser EvalScope pour envoyer des requêtes au service du modèle avec différents niveaux de concurrence.
Par exemple, vous pouvez définir différents niveaux de concurrence de 1, 10, 50 et 100 pour observer le débit, la latence du premier token et le taux de réussite des requêtes à mesure que la concurrence augmente. Les résultats des tests de performance d'EvalScope peuvent suivre des métriques telles que le RPS, le débit de sortie, la latence moyenne et les P50/P99, et sauvegarder les résultats comme rapport de test.
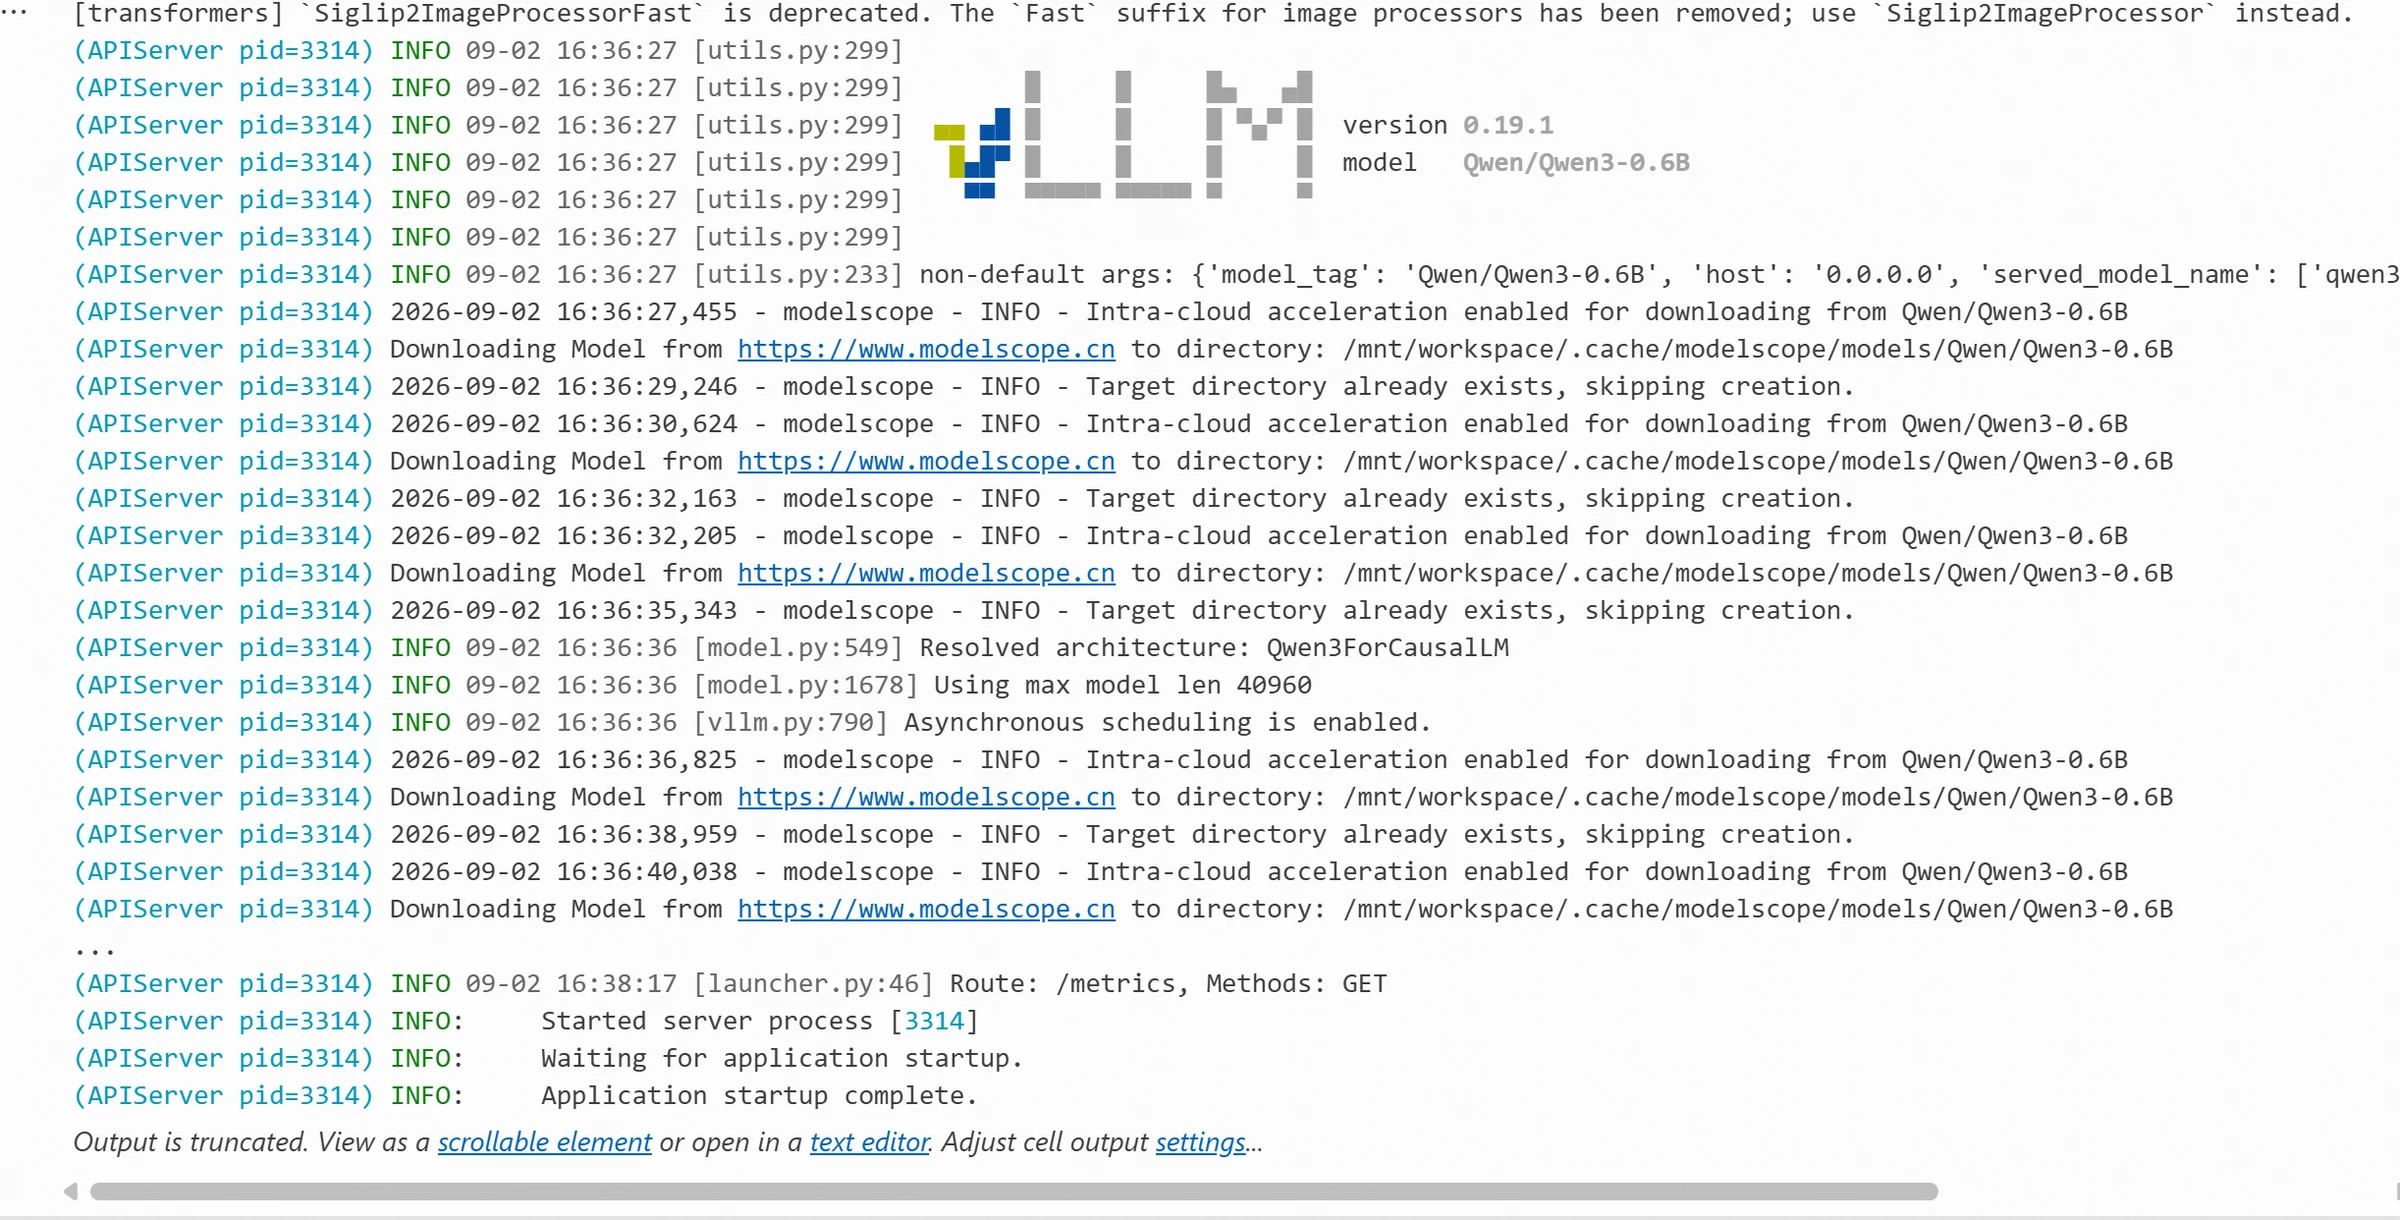
Sous cette image, l'installation du package par défaut peut provoquer des erreurs. Vous pouvez résoudre ce problème en rétrogradant la version de modelscope :
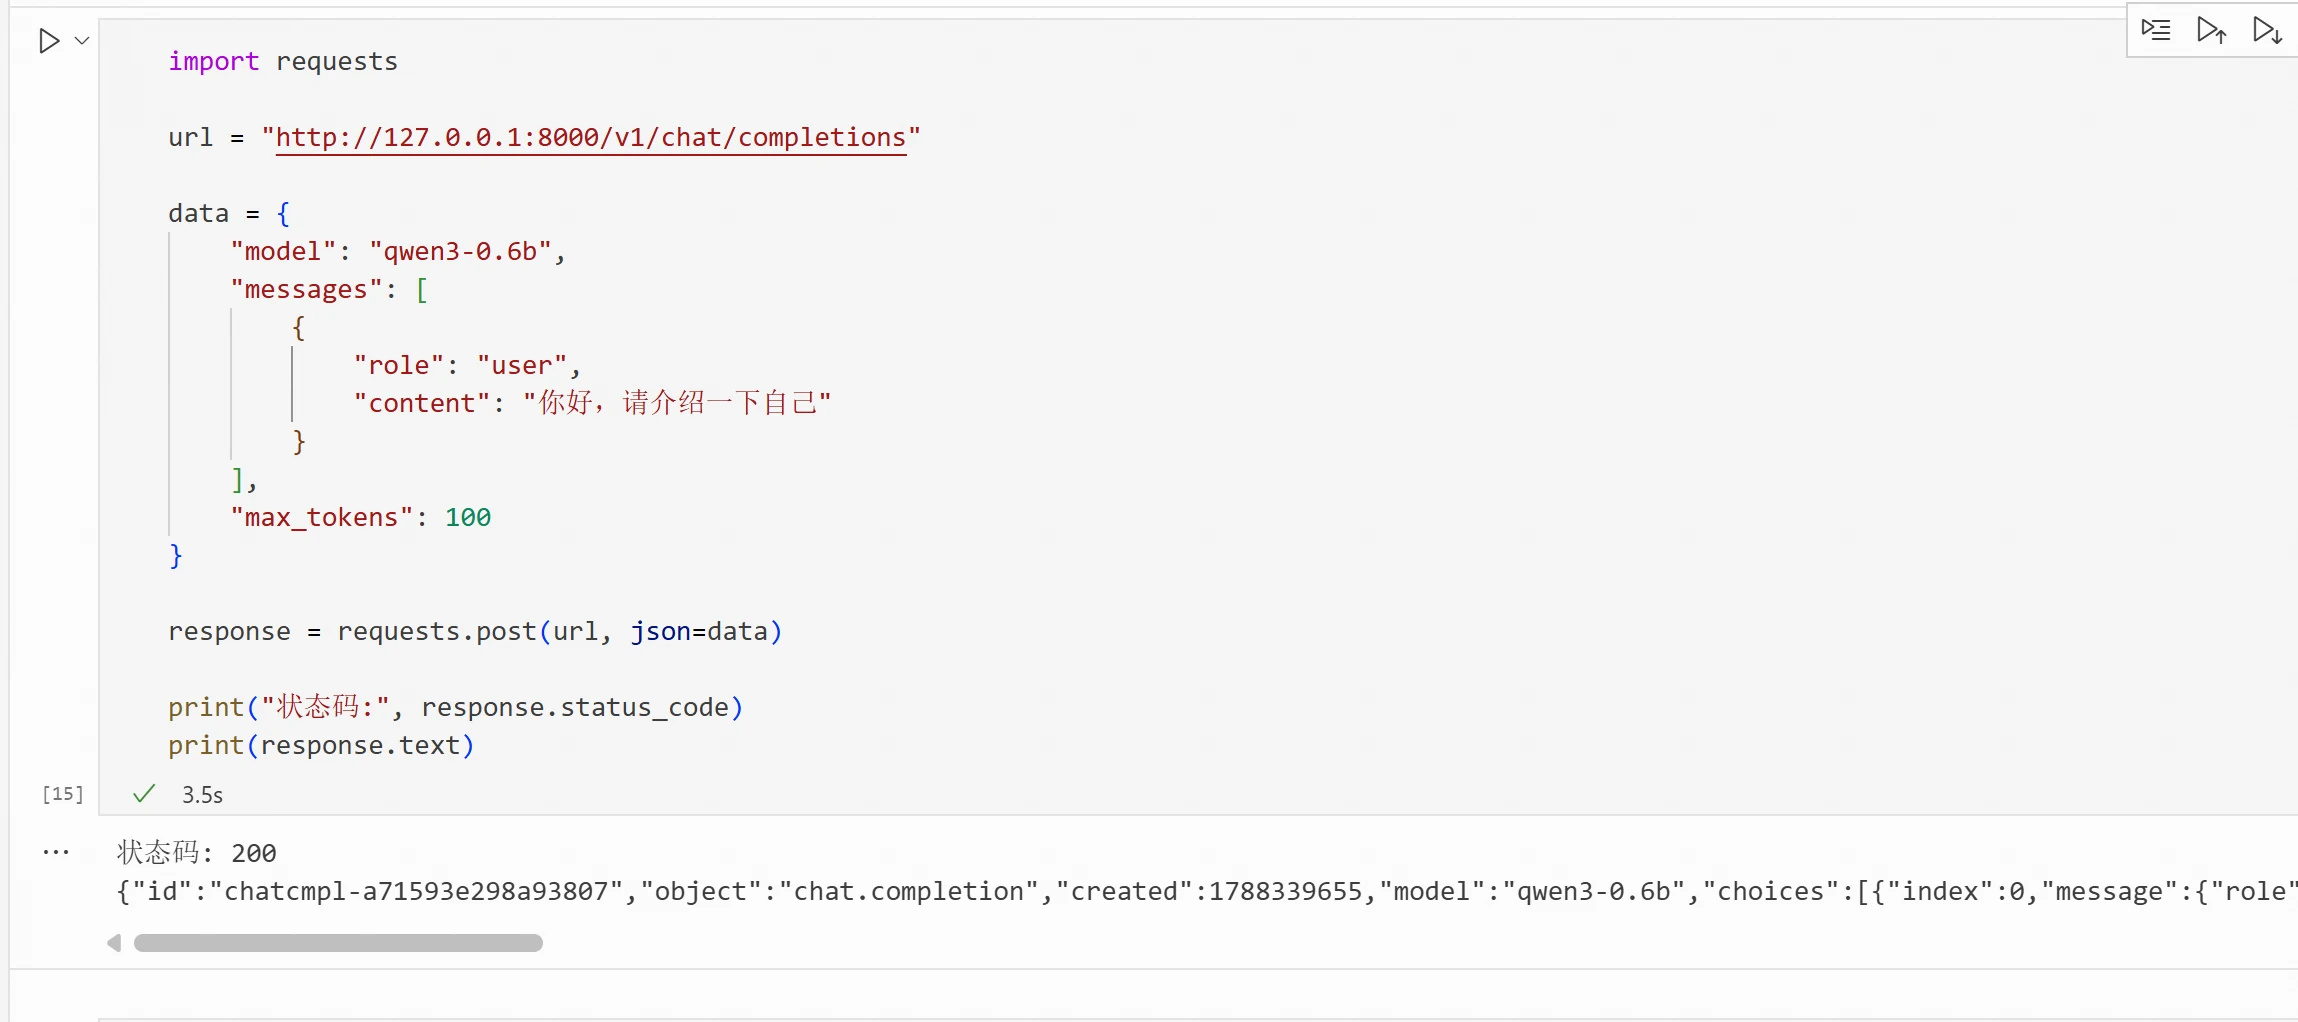
Si l'API est accessible, elle affichera la sortie du modèle :
Ensuite, utilisez EvalScope pour évaluer les performances. Les métriques sur lesquelles nous nous concentrons généralement incluent le Time to First Token (TTFT) et le Time Per Output Token (TPOT).
--model qwen3.5-2b : Nom du modèle, doit correspondre au nom du modèle configuré dans le service d'inférence vLLM
--url http://127.0.0.1:8000/v1/chat/completions : Le point de terminaison API réel du service du modèle
--api-key sk-123456 : Clé d'authentification API. Doit être fournie si le serveur requiert une authentification ; si non configurée, ce paramètre peut être omis.
--dataset random : Spécifie l'ensemble de données de test en mode génération aléatoire, pas besoin de préparer de fichiers de test locaux.
--tokenizer-path Qwen/Qwen3.5-2B : Spécifie le chemin ou le nom du modèle Hugging Face du Tokenizer, utilisé pour contrôler précisément la longueur des Tokens du texte généré.
--min-prompt-length 1024 et --max-prompt-length 1024 : Contrôlent la plage de longueur des invites d'entrée. Les deux sont définis à 1024, signifiant que chaque requête a une longueur d'entrée fixe de 1024 Tokens.
--min-tokens 1024 et --max-tokens 1024 : Contrôlent la plage de longueur de sortie générée par le modèle. Les deux sont définis à 1024, forçant le modèle à produire 1024 Tokens fixes à chaque fois (en ignorant les tokens de fin).
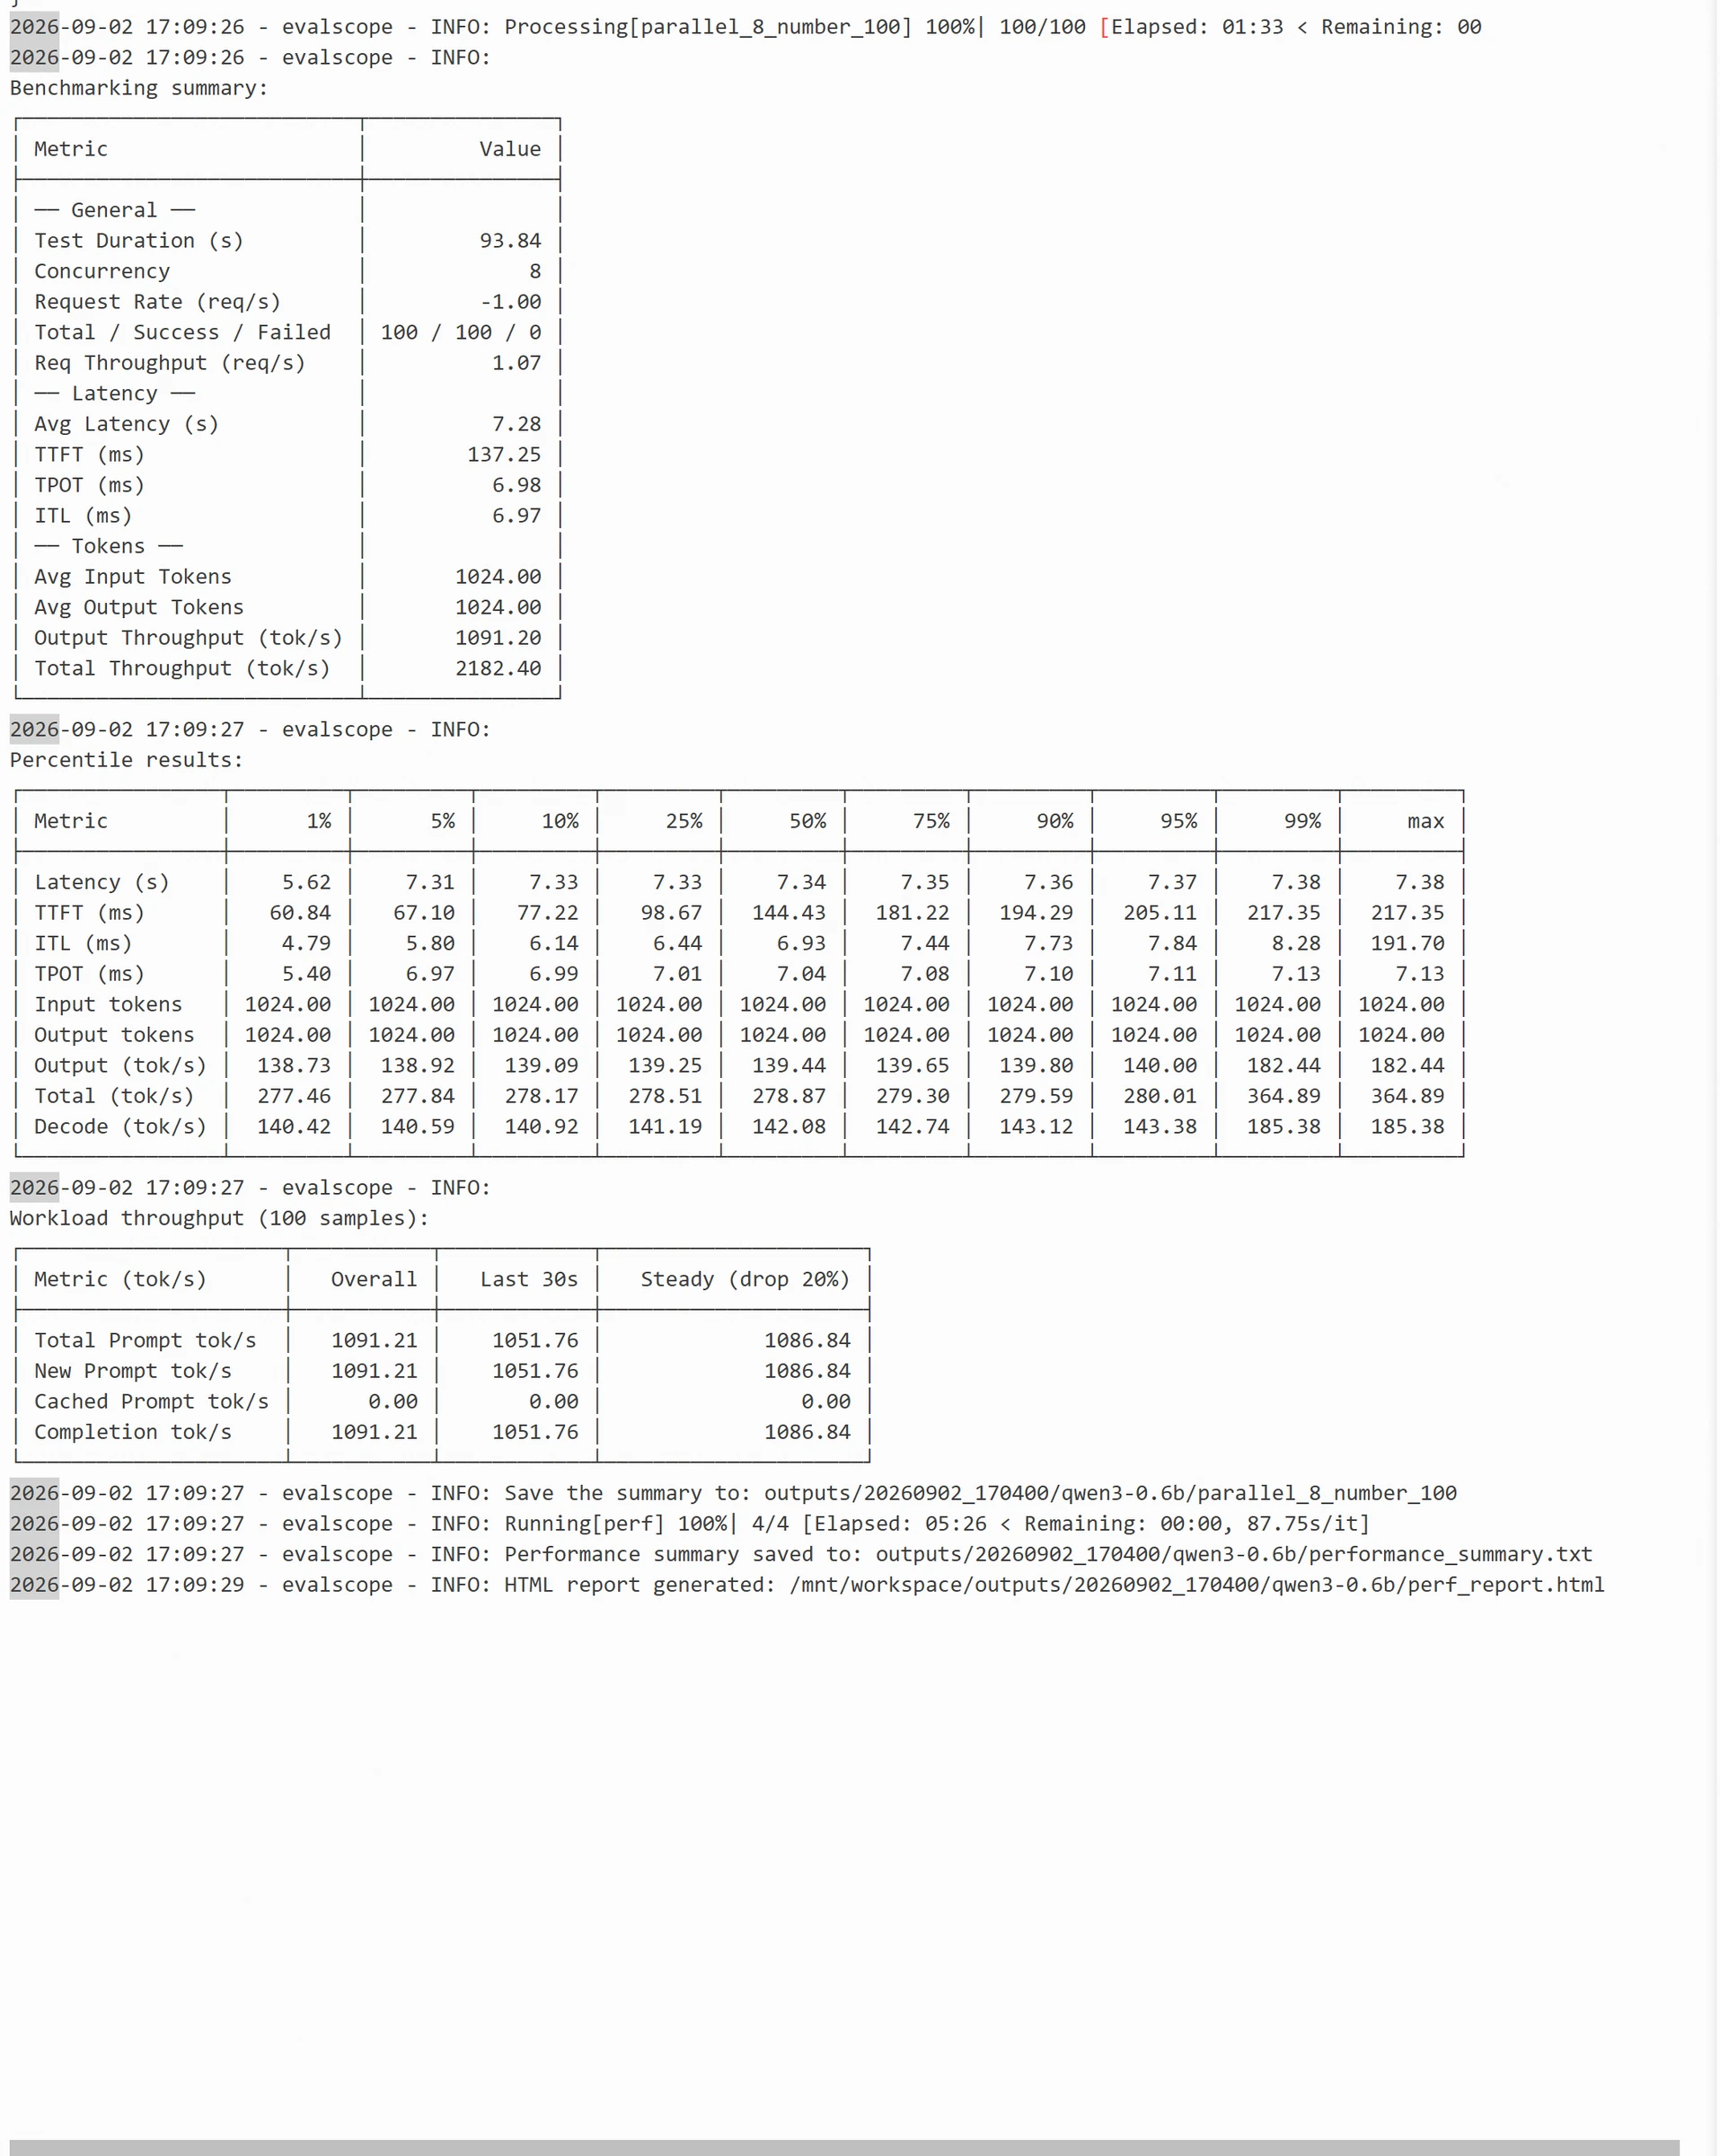
--parallel 1 2 4 8 : Définit les niveaux de concurrence. Pendant le test de stress, il simule séquentiellement 1, 2, 4 et 8 utilisateurs simultanément pour observer les performances du système sous différentes pressions de concurrence.
--number 10 20 50 100 : Définit le nombre total de requêtes pour chaque niveau de concurrence. Cette liste correspond un à un avec --parallel. Par exemple, à concurrence 1, un total de 10 requêtes sont envoyées ; à concurrence 8, un total de 100 requêtes sont envoyées.
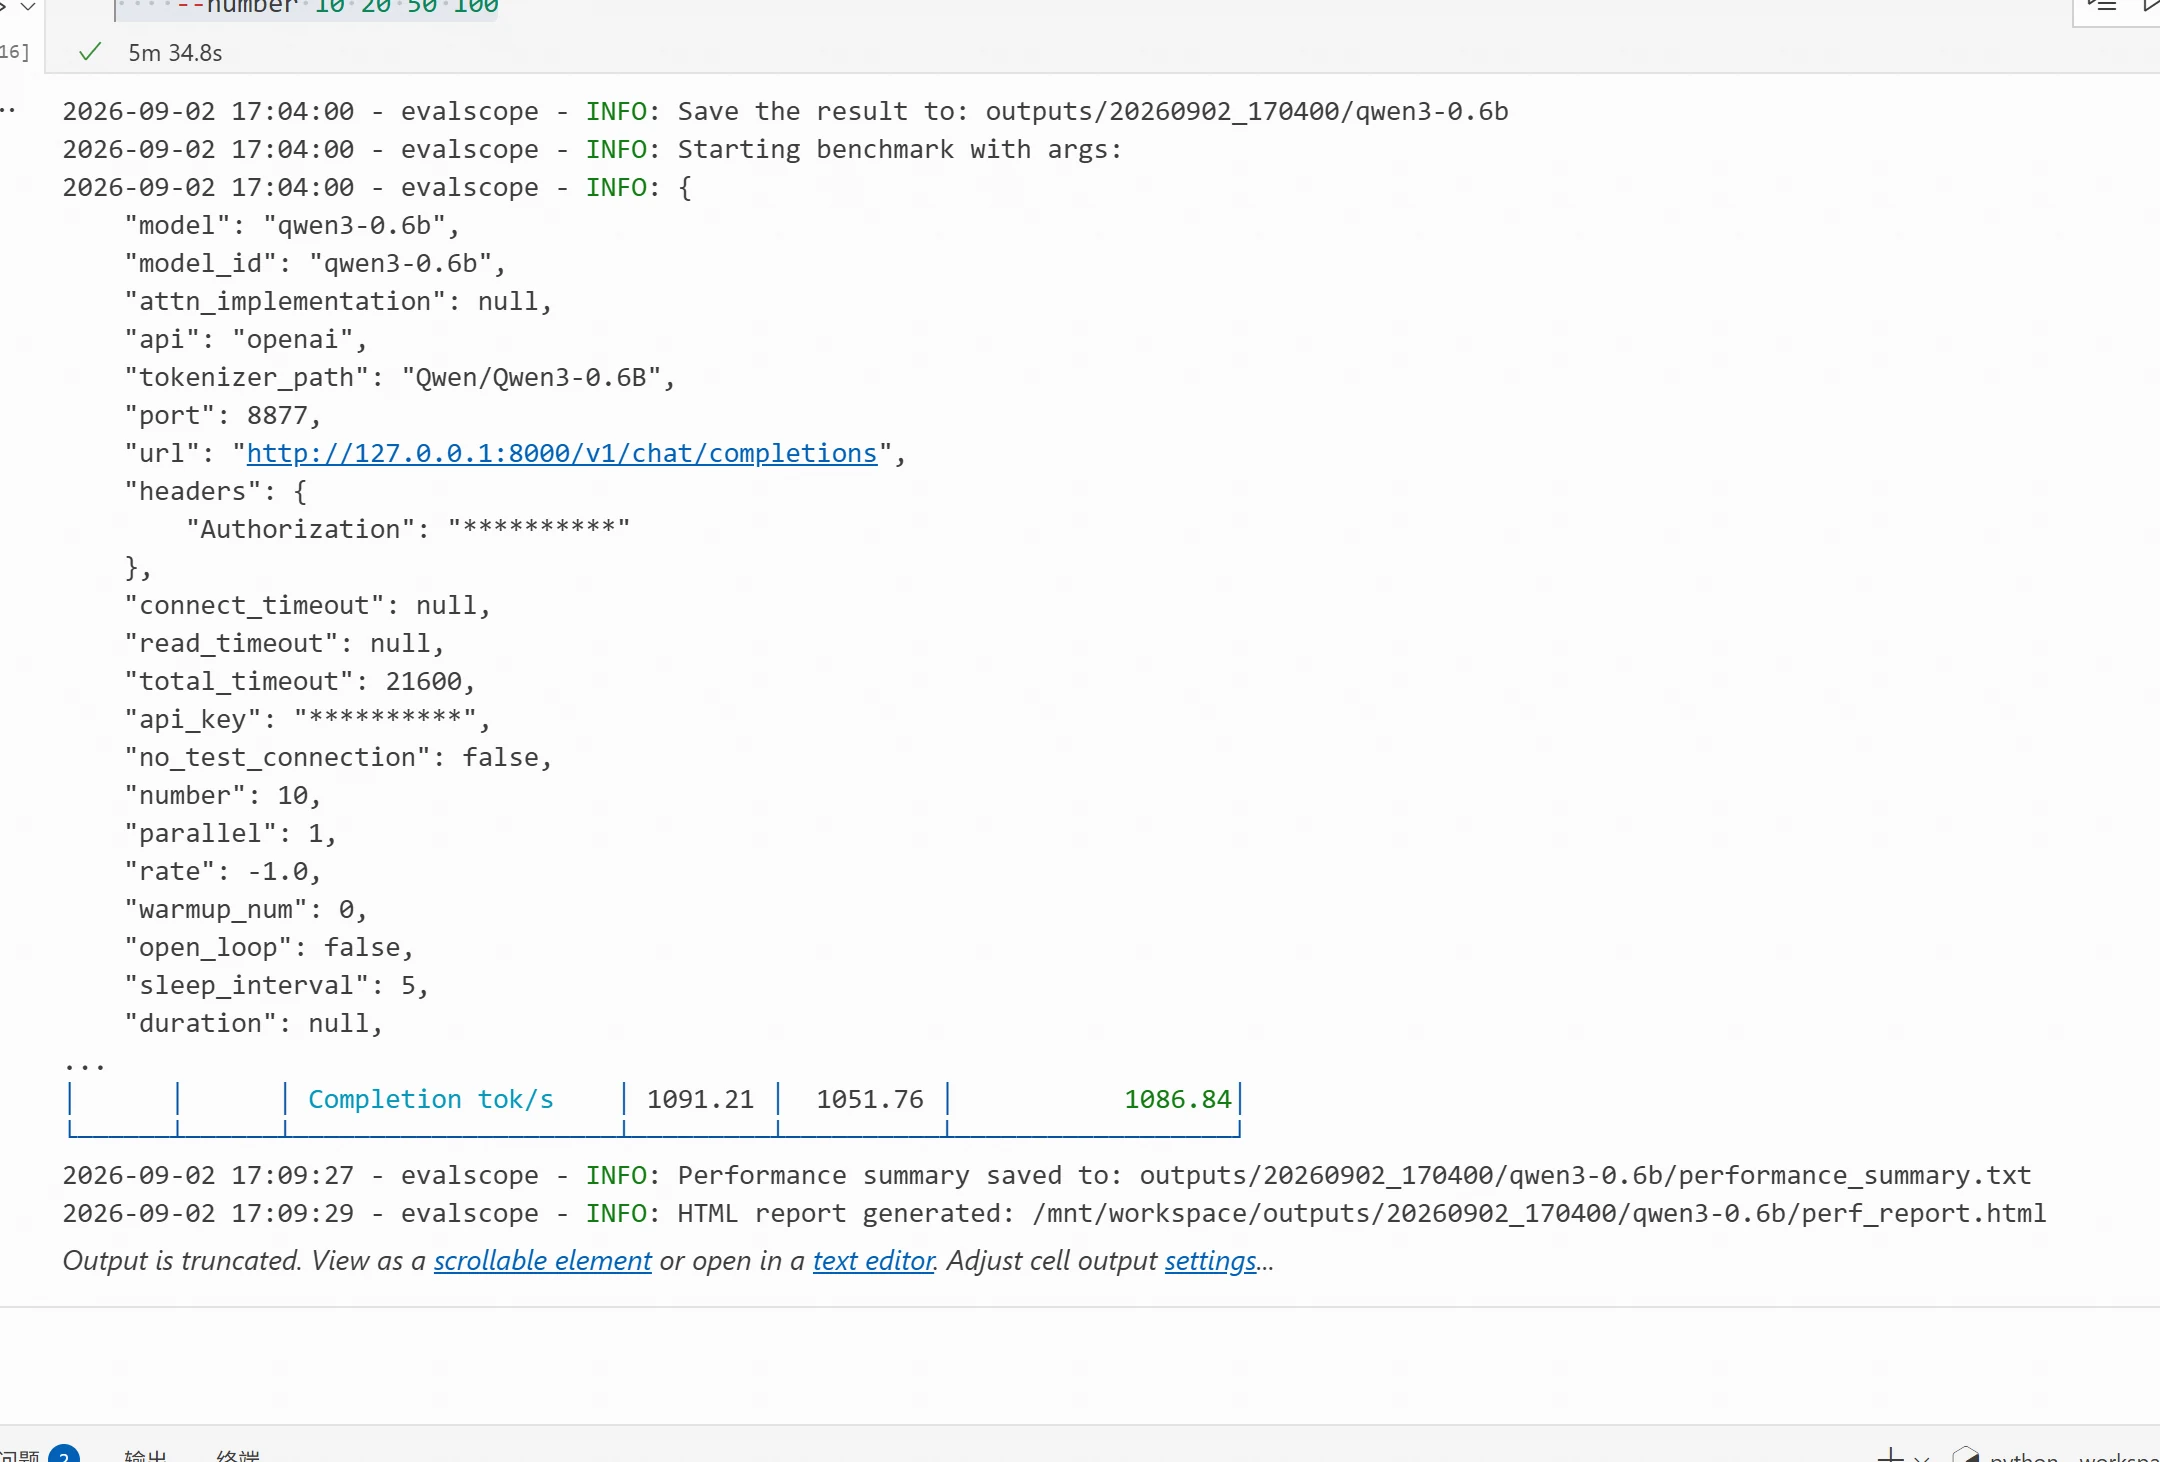
Les résultats de benchmark.log sont les suivants :
EvalScope nous fournit une méthode pour évaluer rapidement les modèles. Vous pouvez consulter le contenu du rapport HTML correspondant dans le répertoire de sortie. Pour plus d'utilisation d'EvalScope, visitez https://evalscope.readthedocs.io/zh-cn/v1.6.1/get_started/introduction.html.
Pour le processus d'expérience spécifique, référez-vous à : https://modelscope.cn/gallery/liucong/5a794182-147f-4c97-83c5-233ca6965f4b
Surprise
Essayez d'utiliser vos propres données métier réelles pour tester l'efficacité des modèles open-source actuels !