Fine-tuning et évaluation • Débutant⏱️ 25 min de lecture
Fine-Tuning with ms-swift
Rapidement utiliser ms-swift pour effectuer une légère ré-entraînement de modèles open source
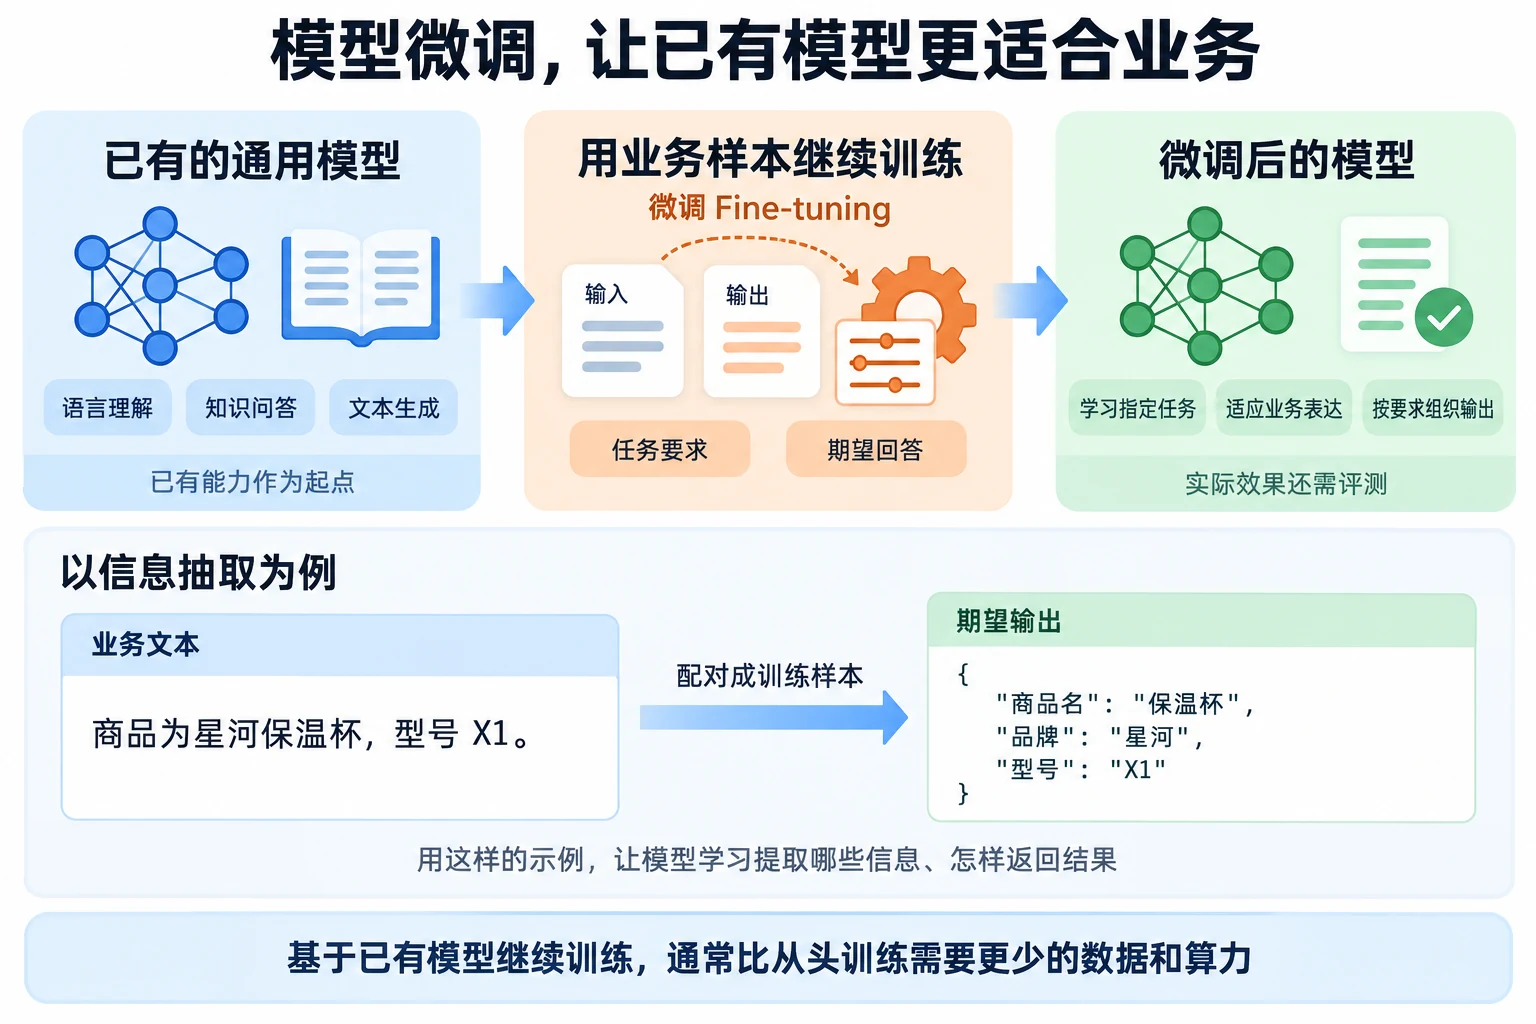
Lorsque les modèles généraux ne peuvent pas directement satisfaire les besoins spécifiques de votre activité, vous pouvez utiliser vos propres données d'entreprise pour ré-entraîner le modèle, permettant au modèle d'apprendre davantage sur des tâches spécifiques et des modes de sortie spécifiques.
Prenez par exemple une tâche d'identification d'entités dans le commerce en ligne, nous avons besoin que le modèle identifie les noms de produits, les noms de marques, les modèles dans le texte, et donne la catégorie correspondante et la position. Le modèle peut parler de ces produits de manière fluide, mais lors de son utilisation finale, les informations extraites ne doivent pas être manquées, les champs doivent être uniques, et le format de sortie doit être stable.
Si les exigences de la tâche et de la sortie sont claires, et que vous avez des exemples de données préparés, vous pouvez essayer de les utiliser pour la ré-entraînement, permettant au modèle d'apprendre le travail que nous souhaitons qu'il accomplisse. Quant à savoir s'il faut mettre à jour tous les paramètres ou si votre carte graphique est suffisante, il faut le combiner avec les exigences de la tâche et les ressources.
Ensuite, nous utiliserons ms-swift, en commençant par une ré-entraînement LoRA, et passant par la préparation des données, l'entraînement, la fusion des poids et la prédiction.
Quels sont les changements exacts du modèle lors de la ré-entraînement ?
Les grands modèles généraux possèdent déjà des capacités puissantes de compréhension de langage, de réponse à des questions et de génération de texte. Cependant, dans les cas d'usage réels, le comportement des modèles généraux ne satisfait pas toujours directement les besoins spécifiques.
Par exemple, nous voulons que le modèle puisse accomplir avec précision une tâche d'extraction d'informations, et qu'il fournisse les résultats selon un format spécifié, ou réponde de manière uniforme à des questions spécifiques. Pour ces besoins, il est possible d'utiliser des données spécifiques pour entraîner le modèle existant, afin qu'il apprenne davantage des exigences de la tâche et des modes de réponse, en fait, ce processus s'appelle la ré-entraînement du modèle (Fine-tuning).
La ré-entraînement n'est pas de re-entraîner un modèle à partir de zéro, mais d'ajuster les capacités existantes du modèle pour qu'il soit plus adapté aux scénarios d'application spécifiques. Par rapport à l'entraînement de grands modèles à partir de zéro, la ré-entraînement nécessite généralement moins de ressources en données et en calcul.
Actuellement, la méthode la plus courante pour la ré-entraînement des grands modèles est SFT (Supervised Fine-Tuning, ré-entraînement supervisé). SFT utilise des données avec des réponses standard pour entraîner le modèle, chaque exemple d'entraînement contient généralement une entrée et la sortie correspondante, permettant au modèle d'apprendre ce que doit générer en réponse à une entrée donnée. Par exemple, dans une tâche d'extraction d'informations, on peut utiliser un texte comme entrée et les résultats d'extraction d'entités corrects comme sortie. SFT convient particulièrement aux tâches pour lesquelles on peut préparer des échantillons d'entraînement clairs, par exemple la classification de texte, l'extraction d'informations, les questions-réponses et la génération de texte en format fixe.
En dehors de SFT, l'entraînement des grands modèles peut également utiliser l'apprentissage par renforcement (Reinforcement Learning, RL). Contrairement à SFT qui fournit directement des réponses standard, l'apprentissage par renforcement évalue principalement la qualité des résultats générés par le modèle à l'aide de signaux de récompense, et ajuste continuellement le comportement de sortie du modèle en fonction des résultats de récompense. SFT et l'apprentissage par renforcement appartiennent tous deux à la phase de post-entraînement des grands modèles. La post-entraînement désigne une série de entraînements effectués après que le modèle ait terminé sa pré-entraînement à grande échelle, afin d'améliorer les capacités de suivi des instructions, de raisonnement et de compétences spécifiques. L'entraînement des grands modèles commence généralement par l'apprentissage via SFT sur la manière de suivre les instructions, puis combine des méthodes telles que l'apprentissage par renforcement pour optimiser la qualité des réponses et le comportement du modèle.
Quelles sont les différences entre entraînement avec tous les paramètres, LoRA et QLoRA ?
En fonction des méthodes d'entraînement et des ressources matérielles, il est possible de choisir entre entraînement avec tous les paramètres, LoRA, QLoRA ou ré-entraînement avec tous les paramètres. Les différentes méthodes présentent des différences dans le nombre de paramètres d'entraînement, l'utilisation de l'espace mémoire et le coût de calcul.
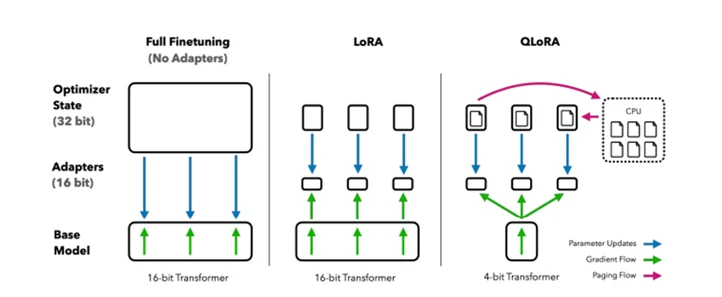
Entraînement avec tous les paramètres (Full Fine-Tuning), pendant l'entraînement, tous les paramètres du modèle participent à la mise à jour, donc le modèle peut effectuer une adaptation plus complète. L'entraînement avec tous les paramètres nécessite également plus de ressources en espace mémoire et de calcul, avec un coût d'entraînement plus élevé.
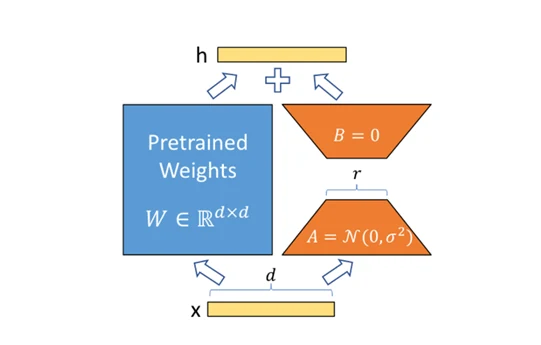
Ré-entraînement LoRA (Low-Rank Adaptation), pour réduire les exigences en ressources matérielles pour la ré-entraînement des grands modèles, le principe central de LoRA est de geler les poids du modèle pré-entraîné et d'injecter des matrices de rang inférieur dans chaque couche de l'architecture Transformer, ce qui réduit considérablement le nombre de paramètres ré-entraînables dans les tâches downstream. Pendant l'entraînement, il suffit de fixer les paramètres originaux du modèle, puis d'entraîner les matrices de réduction A et d'élévation B. Le schéma illustratif de LoRA est le suivant.
En détail, supposons que la matrice pré-entraînée soit $W_0 \in \mathbb{R}^{d \times k}$ , sa mise à jour peut être représentée comme :
W = W_0 + \Delta W = W_0 + BA
où $\Delta W$ représente les changements de poids à apprendre pendant la ré-entraînement,
B \in \mathbb{R}^{d \times r}, \quad
A \in \mathbb{R}^{r \times k}, \quad
r \ll \min(d,k)
,A et B sont les paramètres nouvellement ajoutés et entraînés par LoRA. Après l'entraînement du modèle, un fichier Adapter LoRA séparé est obtenu, enregistrant les paramètres obtenus lors de cette ré-entraînement. Pendant l'utilisation, il faut charger le modèle de base et l'Adapter correspondant ensemble.
Ré-entraînement QLoRA (Quantized LoRA), LoRA réduit principalement les coûts de ressources liés au nombre de paramètres d'entraînement, le modèle de base lui-même doit encore être chargé en mémoire. Si la taille du modèle est grande, le chargement du modèle de base peut encore occuper beaucoup d'espace mémoire. Pour réduire davantage les besoins en espace mémoire, il est possible d'utiliser une ré-entraînement QLoRA.
La architecture du modèle est illustrée dans le schéma ci-dessous, on peut voir que QLoRA est une amélioration de LoRA, et le principal mode d'amélioration est l'utilisation de la précision 4-bit et des optimisations de pagination pour réduire la consommation de mémoire du modèle.
QLoRA peut être simplement considérée comme une combinaison de quantification et de LoRA. Elle quantifie le modèle de base avec une faible précision, les innovations principales de QLoRA sont les suivantes :
4bit NormalFloat (NF4), NF4 est un nouveau type de données, qui est le choix optimal théoriquement en information pour les poids suivant une distribution normale ;
Quantification binaire, la quantification binaire réduit l'utilisation moyenne de la mémoire, elle est réalisée en quantifiant à nouveau les constantes déjà quantifiées ;
Optimiseur de pagination, l'optimiseur de pagination utilise des mécanismes pour gérer les pics de mémoire, et prévenir les erreurs de mémoire insuffisante lors des points de contrôle des gradients.
Comment choisir la méthode de ré-entraînement, en fonction de la tâche et de la carte graphique
La sélection de la méthode de ré-entraînement dépend principalement de la combinaison des facteurs suivants : la taille du modèle, les exigences de la tâche, les ressources GPU et le coût d'entraînement. Chaque méthode a des scénarios d'application spécifiques, et l'augmentation du nombre de paramètres mis à jour n'implique pas nécessairement une meilleure performance de ré-entraînement pour la plupart des tâches de ré-entraînement. On peut d'abord essayer de ré-entraîner avec LoRA. LoRA ne nécessite que l'entraînement de quelques paramètres ajoutés, avec des exigences plus faibles en espace mémoire GPU et en ressources de calcul, et le fichier Adapter obtenu après l'entraînement est également plus petit, ce qui est plus facile à enregistrer.
Si la taille du modèle de base est grande, même en utilisant LoRA, il n'y a pas assez d'espace mémoire pour entraîner après le chargement du modèle, il est possible de considérer ensuite QLoRA. QLoRA réduit les besoins en espace mémoire du modèle de base par quantification, permettant aux modèles plus grands d'être ré-entraînés avec des ressources GPU limitées. QLoRA convient particulièrement aux scénarios où la taille du modèle est grande et les ressources GPU sont limitées.
Si les ressources GPU sont suffisantes et que l'on souhaite effectuer une adaptation plus complète du modèle, on peut considérer l'entraînement avec tous les paramètres. Comme l'entraînement avec tous les paramètres met à jour tous les paramètres du modèle, il a des exigences plus élevées en espace mémoire, en ressources de calcul et en données d'entraînement, et le coût d'entraînement et d'enregistrement du modèle est également plus élevé, donc il faut le combiner avec la tâche réelle pour déterminer si il est nécessaire d'utiliser cette méthode.
Dans les projets réels, on peut d'abord valider l'effet avec un coût plus faible, puis choisir de augmenter le coût d'entraînement en fonction des besoins réels. Si LoRA peut déjà atteindre les résultats escomptés, il n'y a généralement pas de nécessité de choisir l'entraînement avec tous les paramètres uniquement pour mettre à jour plus de paramètres.
Utiliser ms-swift pour passer en revue une ré-entraînement
Quelles sont les tâches que ms-swift nous épargne ?
ms-swift (SWIFT, Scalable lightWeight Infrastructure for Fine-Tuning) est un framework open source de ModelScope pour l'entraînement et le déploiement de grands modèles, principalement axé sur les grands modèles de langage et les grands modèles multimodaux, offrant un ensemble complet d'outils pour la formation du modèle, la ré-entraînement, la prédiction, l'évaluation et le déploiement.
Il est actuellement compatible avec les grands modèles de langage Qwen, DeepSeek, Llama, GLM, InternLM, ainsi que les modèles multimodaux Qwen-VL, InternVL, et il supporte également l'entraînement de modèles ou tâches tels que Embedding, Reranker et classification de texte.
On peut consulter les méthodes d'utilisation sur ms-swift.
En dehors de l'entraînement, ms-swift fournit également un processus de modèle plus complet. Après l'entraînement, on peut directement utiliser swift infer pour la prédiction du modèle, ou utiliser swift deploy pour déployer le modèle comme un service API compatible avec OpenAI. Pour la prédiction et le déploiement, il est possible de combiner des moteurs de prédiction tels que vLLM, SGLang, LMDeploy pour accélérer le processus.
Pour les débutants, un point caractéristique de ms-swift est de encapsuler de nombreuses configurations complexes du processus d'entraînement de grands modèles. En spécifiant le modèle de base, les données d'entraînement, la méthode de ré-entraînement et les paramètres d'entraînement via des arguments de ligne de commande, on peut accomplir une ré-entraînement de modèle. Dans l'expérience suivante, nous utiliserons ms-swift pour accomplir un processus complet de ré-entraînement de modèle, incluant la préparation des données d'entraînement, le démarrage de l'entraînement LoRA, la vérification des résultats d'entraînement, la fusion des poids LoRA et le chargement du modèle ré-entraîné pour la prédiction et le déploiement.
Commencer par une tâche d'identification d'entités, et commencer à entraîner
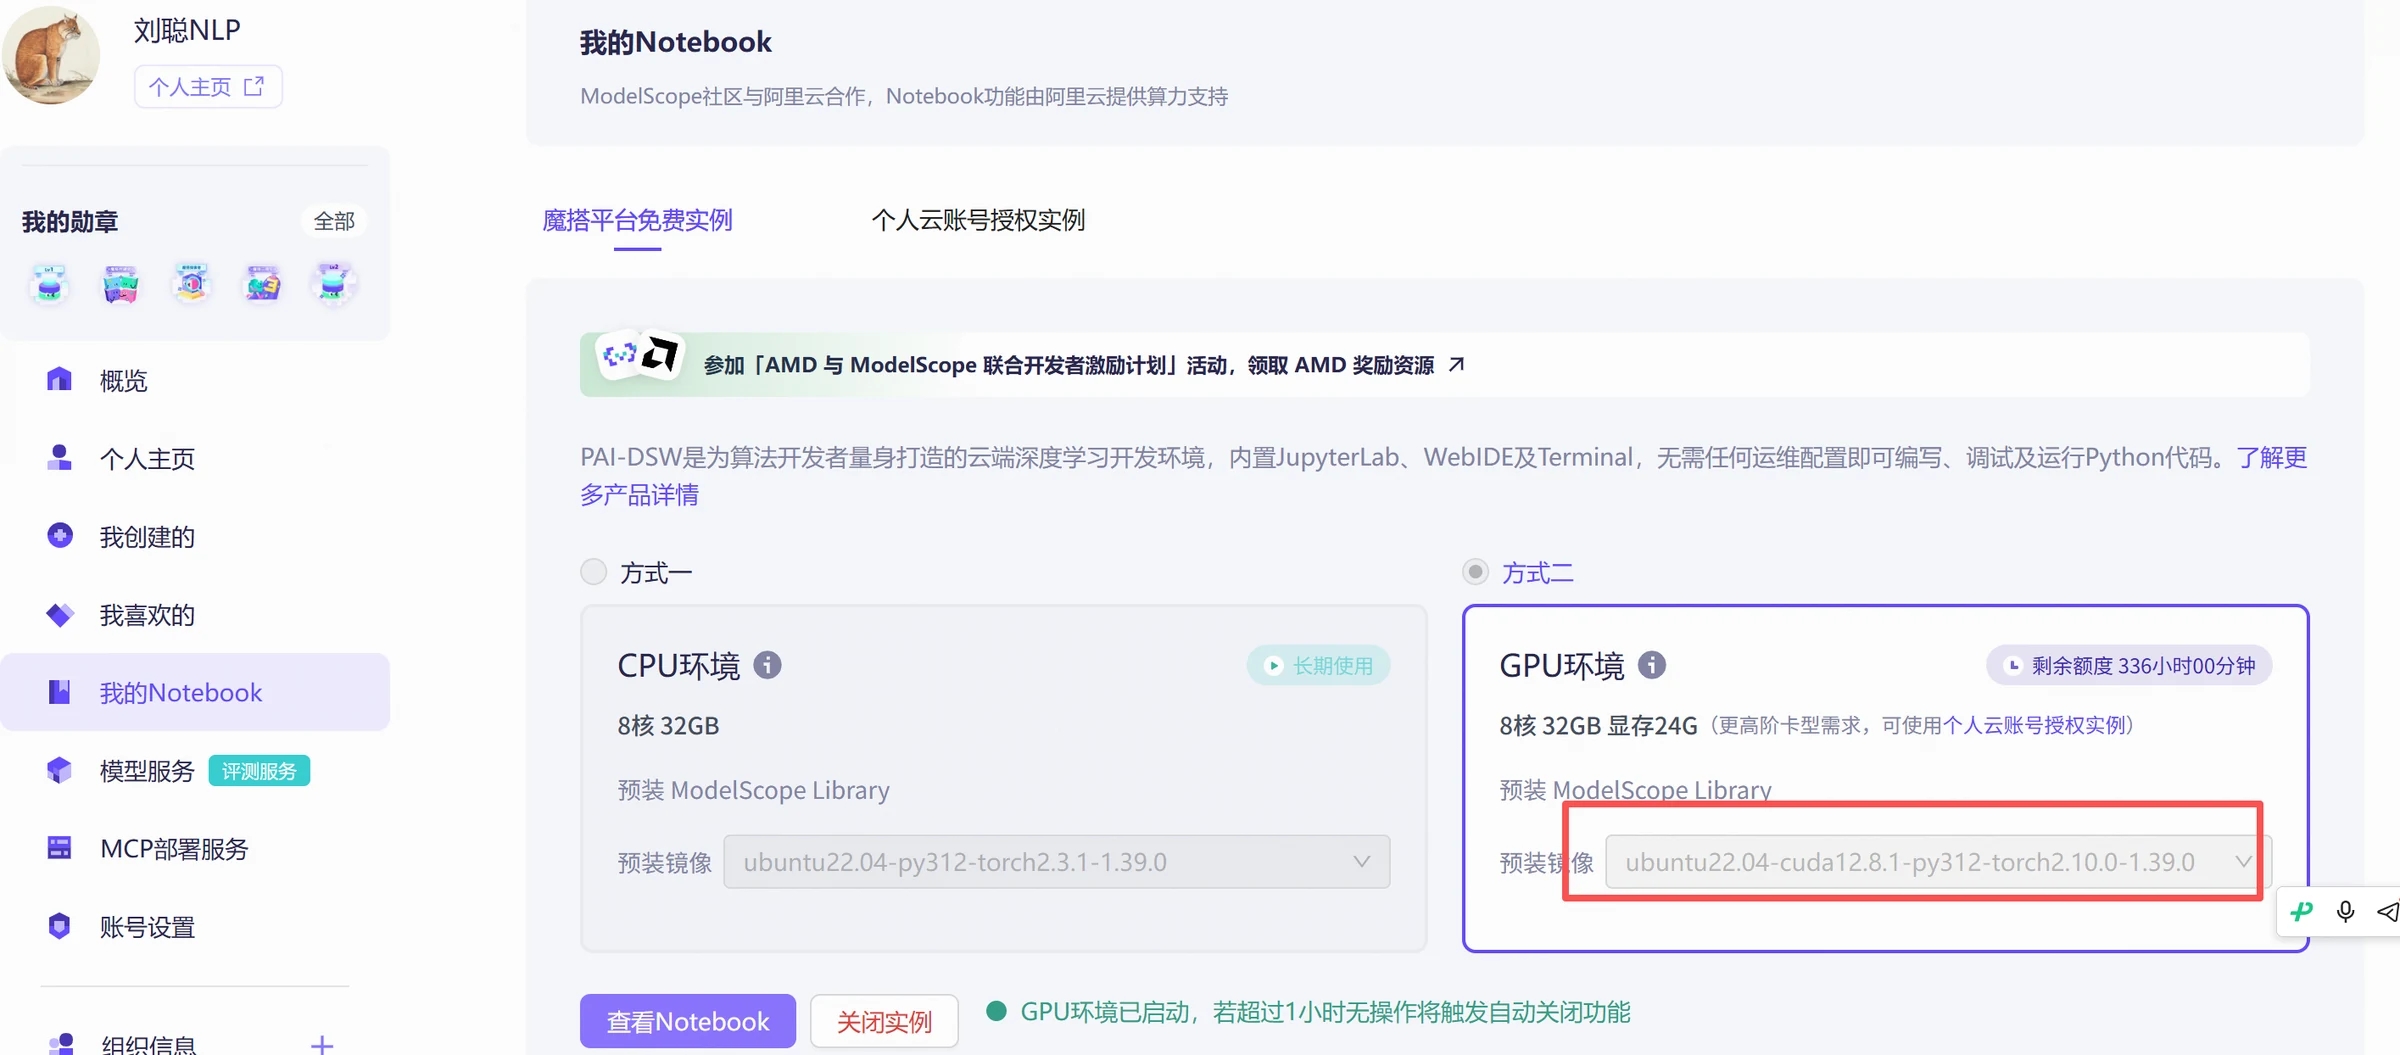
Ensuite, nous allons utiliser une tâche d'identification d'entités comme exemple, pour démontrer le processus complet de ré-entraînement de modèle dans un environnement de notebook de ModelScope, incluant la préparation des données, l'entraînement du modèle et la prédiction du modèle ré-entraîné. En utilisant cet exemple, on peut comprendre comment utiliser ms-swift pour accomplir une ré-entraînement de grands modèles à partir de zéro. L'expérience continue d'utiliser l'image de l'environnement ubuntu22.04-cuda12.8.1-py312-torch2.10.0-1.39.0.
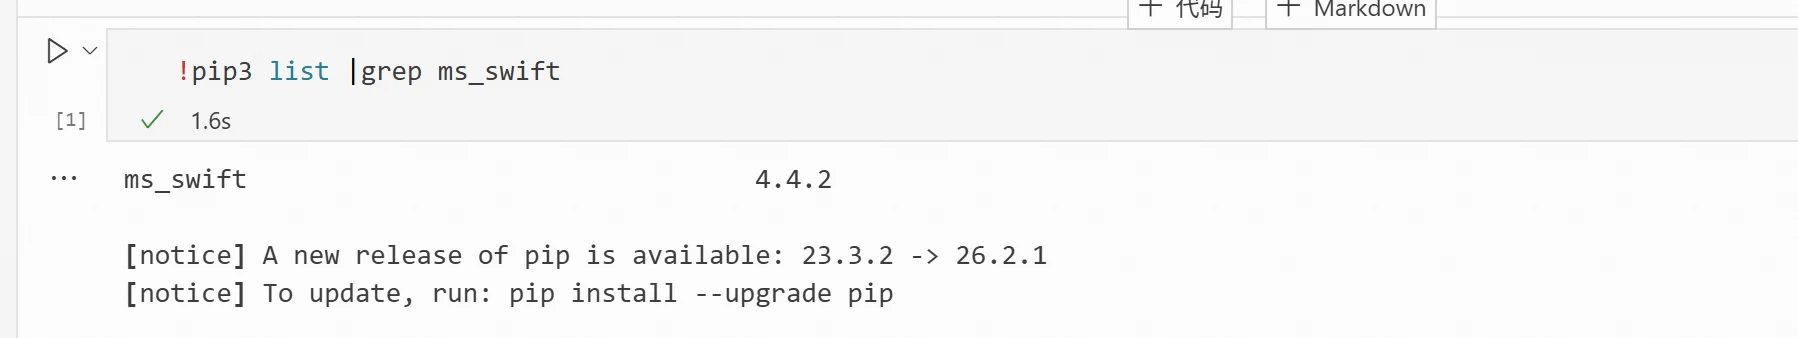
1) Vérifier si ms-swift est déjà installé dans l'environnement, notez que le paquet d'installation est ms_swift
!pip3 list |grep ms_swift
Si le résultat est de la forme suivante, cela signifie que ms-swift est déjà installé
Si ce n'est pas installé, exécuter
!pip3 install ms-swift
Préparation des données, les données de cette expérience sont des données open source, pour une tâche d'identification d'entités dans le commerce en ligne, le jeu de données contient quatre types d'entités : HCCX pour le nom de produit, HPPX pour le nom de marque, XH pour le modèle de produit, MISC pour les autres entités, incluant le pays, la taille/capacité, les personnes, les œuvres et les événements.
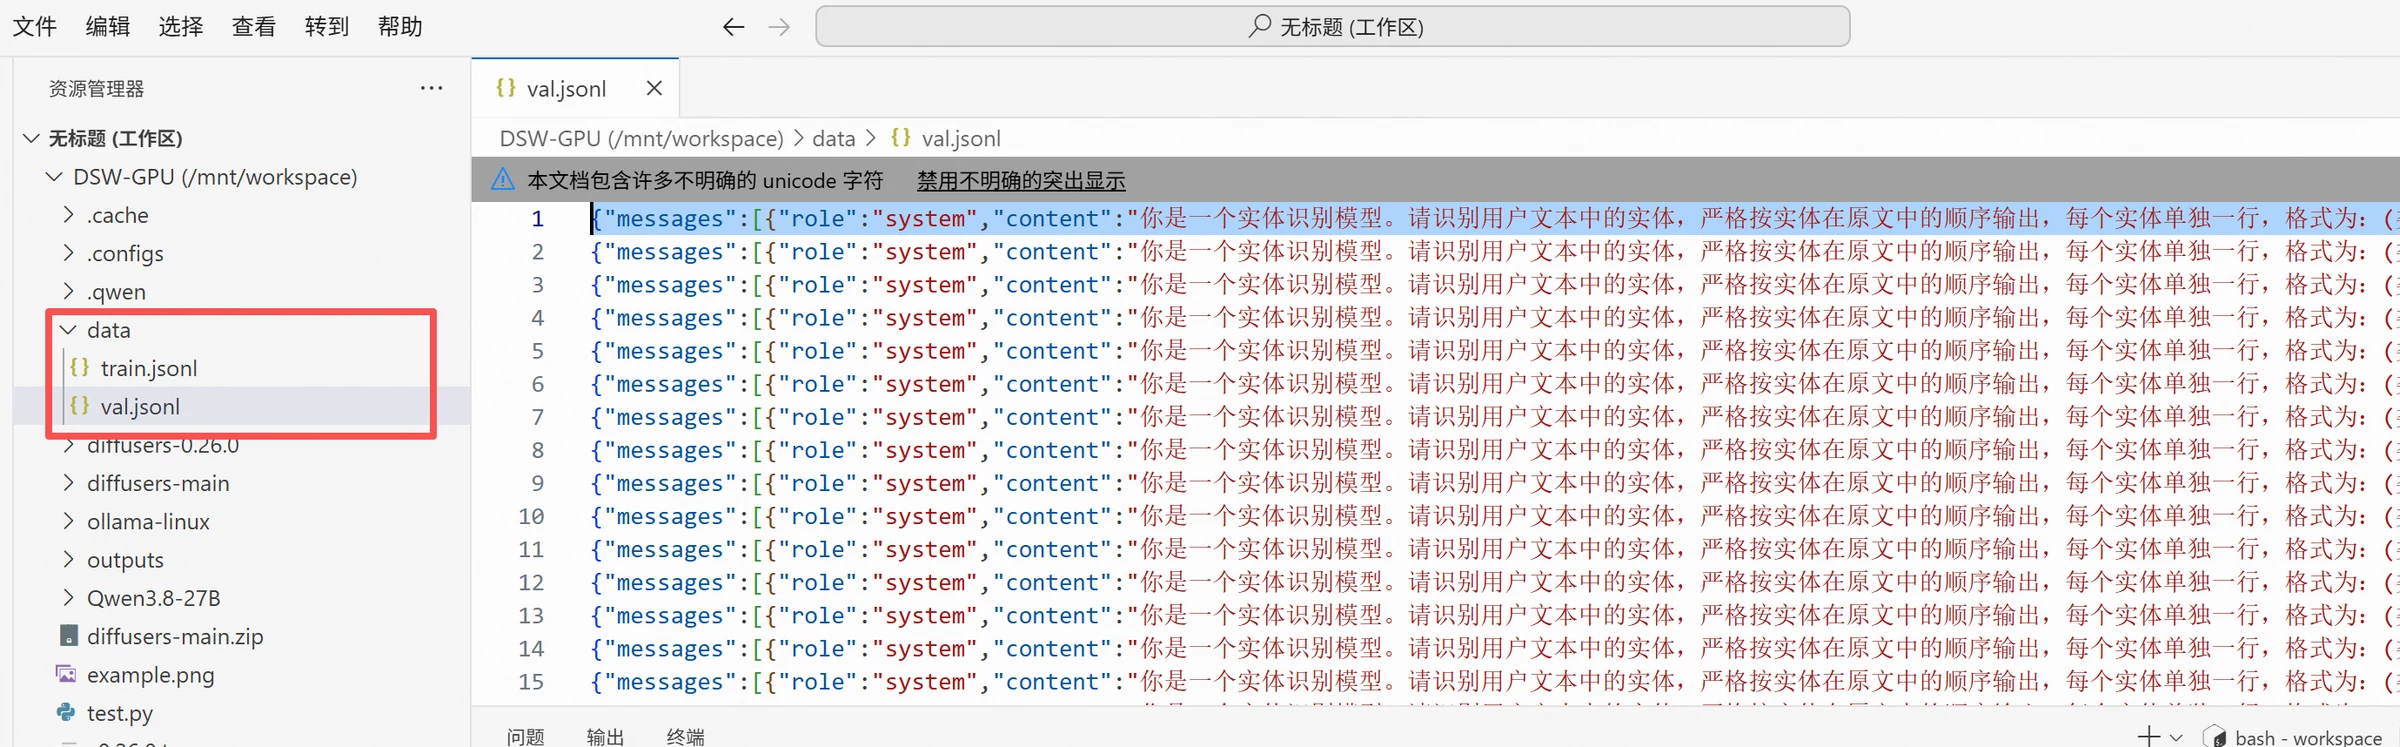
Créer un nouveau répertoire data, puis téléverser les données par clic droit dans le répertoire, la forme des données est la suivante, cette tâche ne demande qu'à ce que le modèle affiche la catégorie de l'entité, l'entité elle-même et la position de l'entité dans le texte, les données sont divisées en ensemble d'entraînement et ensemble de validation, dont train.jsonl contient 5400 lignes et val.jsonl contient 600 lignes.
{"messages":[{"role":"system","content":"Tu es un modèle d'identification d'entités. Identifie les entités dans le texte de l'utilisateur, sortis strictement selon l'ordre des entités dans le texte original, une entité par ligne, format : (type, texte de l'entité, position de départ). La position de départ commence à 0 ; le type peut être l'un de HCCX, HPPX, MISC, XH. Quand il n'y a pas d'entité, il ne faut pas sortir : Aucune entité. Ne sort pas d'explications, Markdown ou autre contenu."},{"role":"user","content":"推bb护肤刮痧l背疗橄榄油全身按开背足体按油身m油5摩油摩精00"},{"role":"assistant","content":"(HCCX,橄榄油,10)\n(HCCX,按油,20)\n(HCCX,油,24)\n(HCCX,油,27)"}]
Le format du répertoire est le suivant :
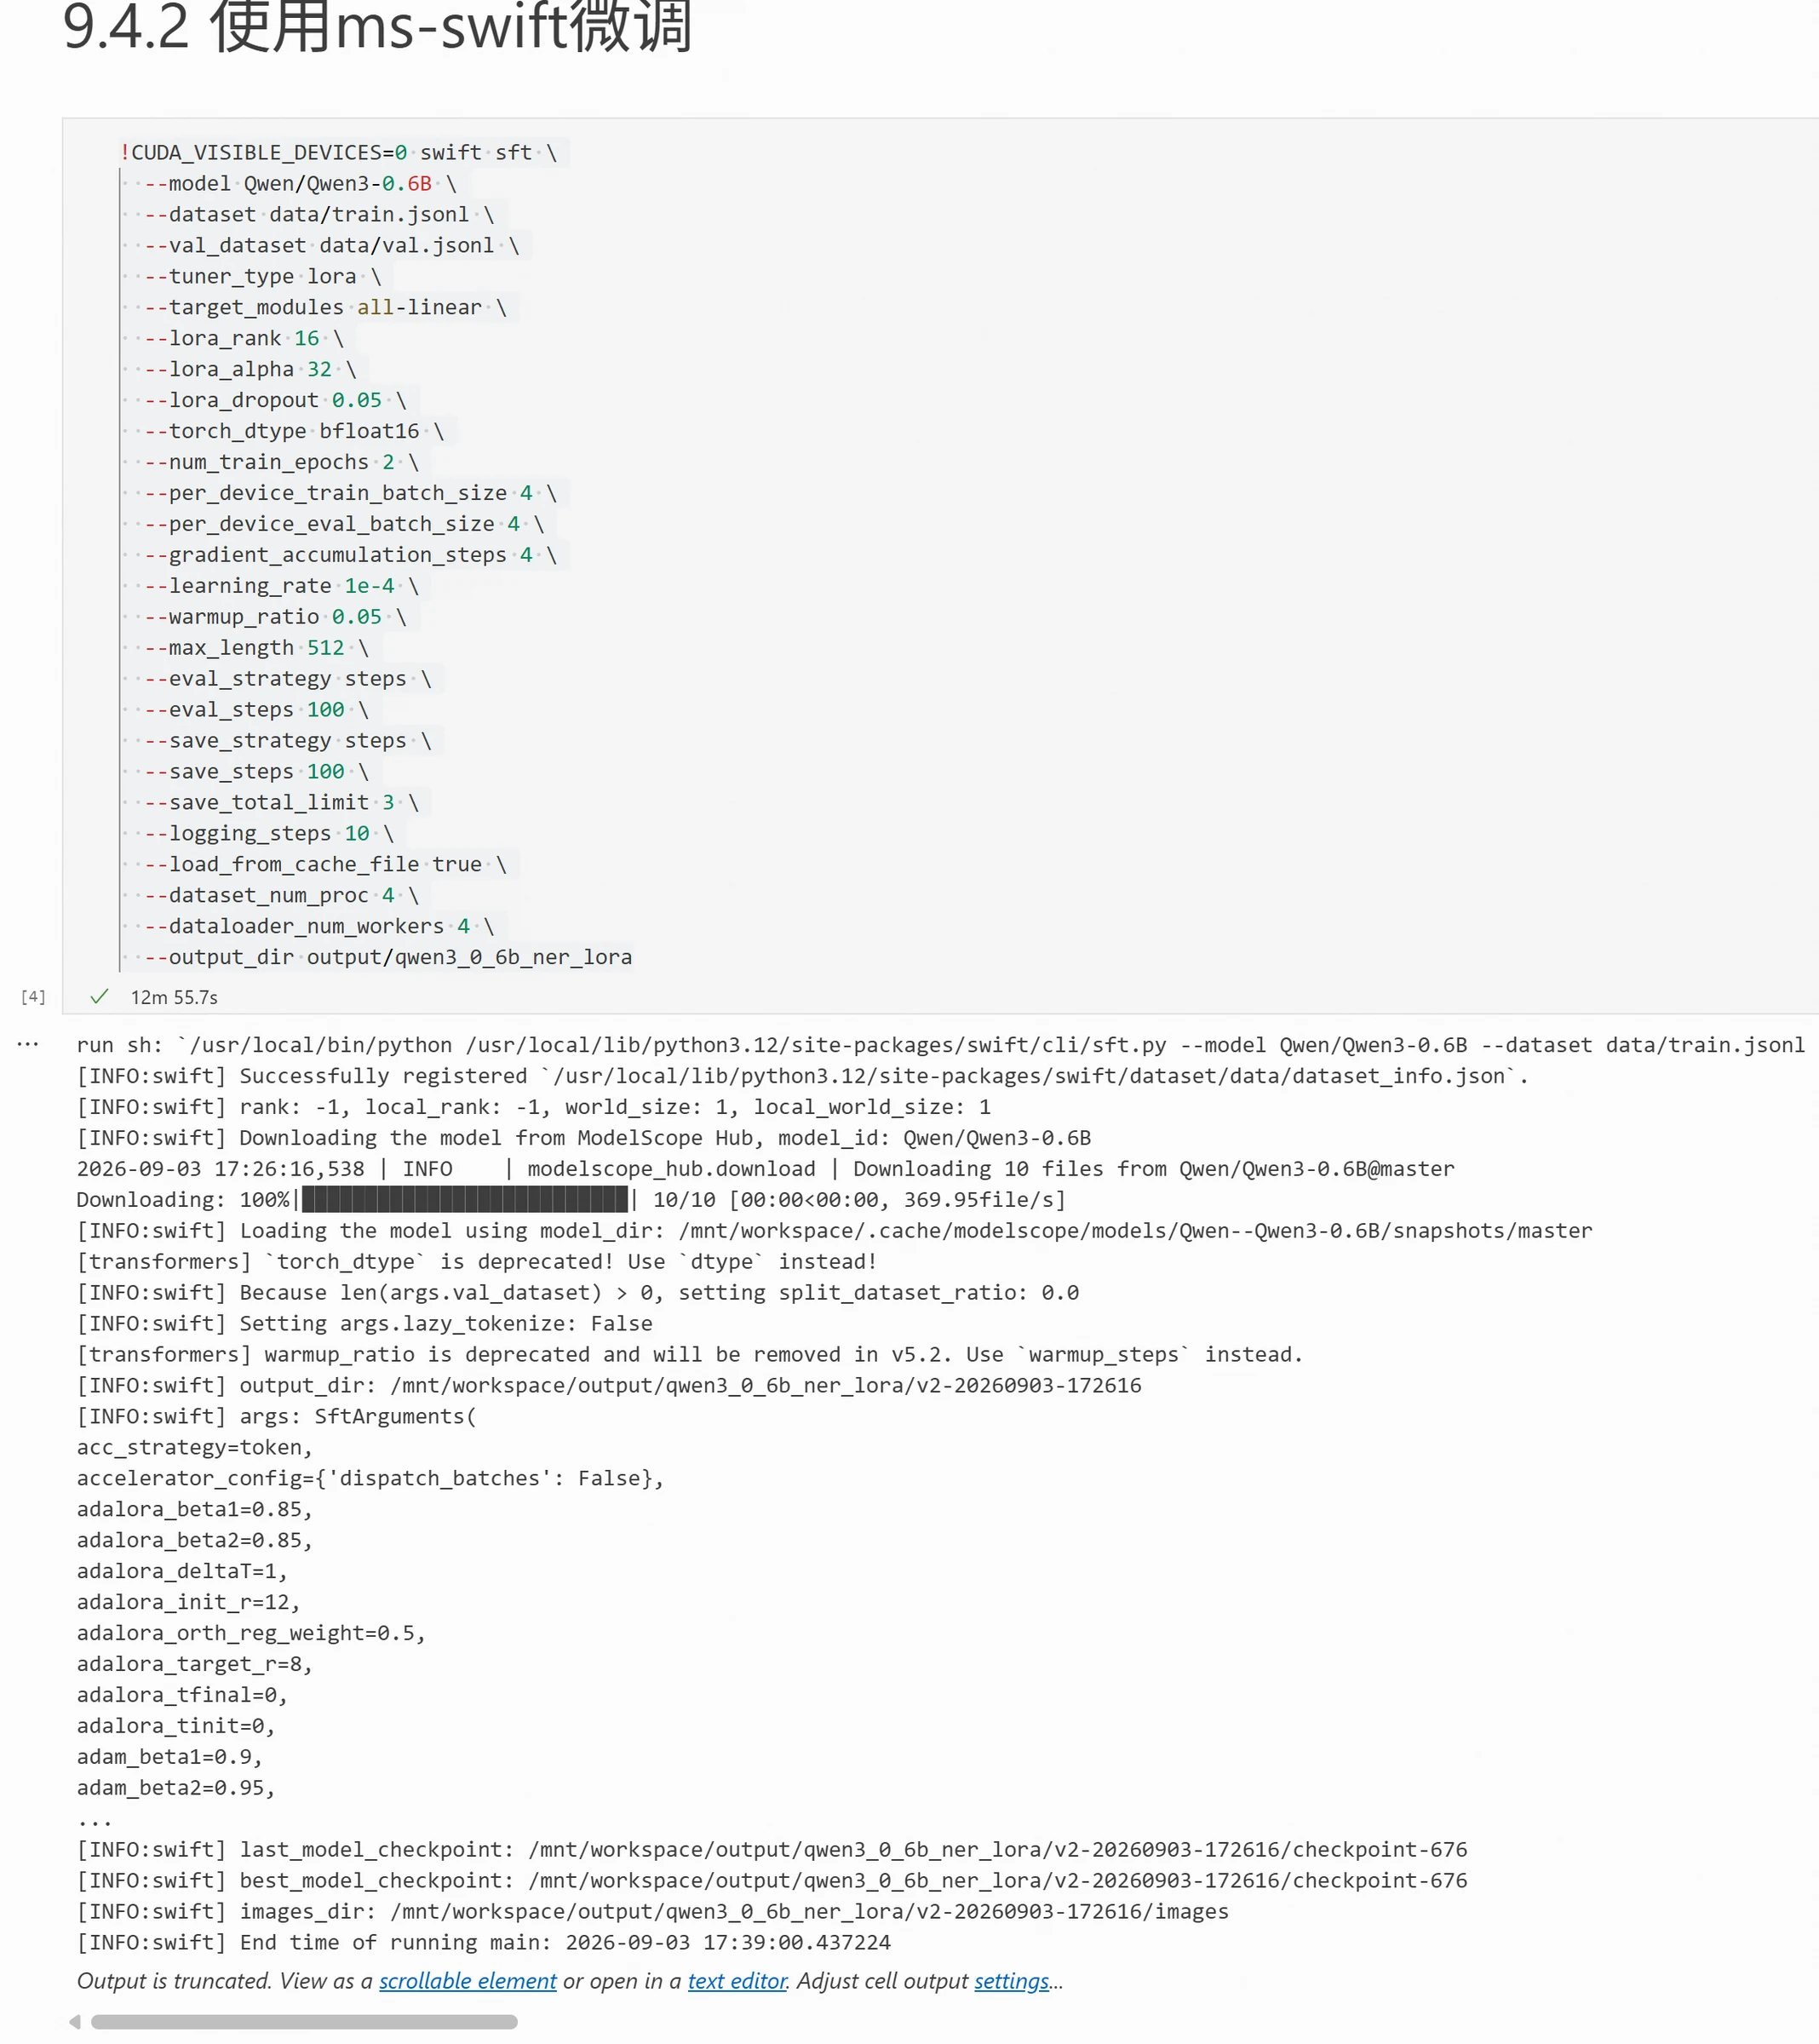
Entraînement du modèle, dans cette partie, nous utilisons Qwen/Qwen3-0.6B pour la ré-entraînement, il suffit d'entrer la commande suivante dans le terminal
4 lignes de données par étape sur la carte graphique
--gradient_accumulation_steps 4
Mettre à jour les paramètres une fois toutes les 4 étapes
--learning_rate 1e-4
Taux d'apprentissage LoRA
--max_length 512
Longueur maximale d'un échantillon
--eval_steps 100
Valider toutes les 100 étapes
--save_steps 100
Enregistrer toutes les 100 étapes
--save_total_limit 3
Ne conserver que 3 points de contrôle
--output_dir
Emplacement de sauvegarde du modèle et des logs
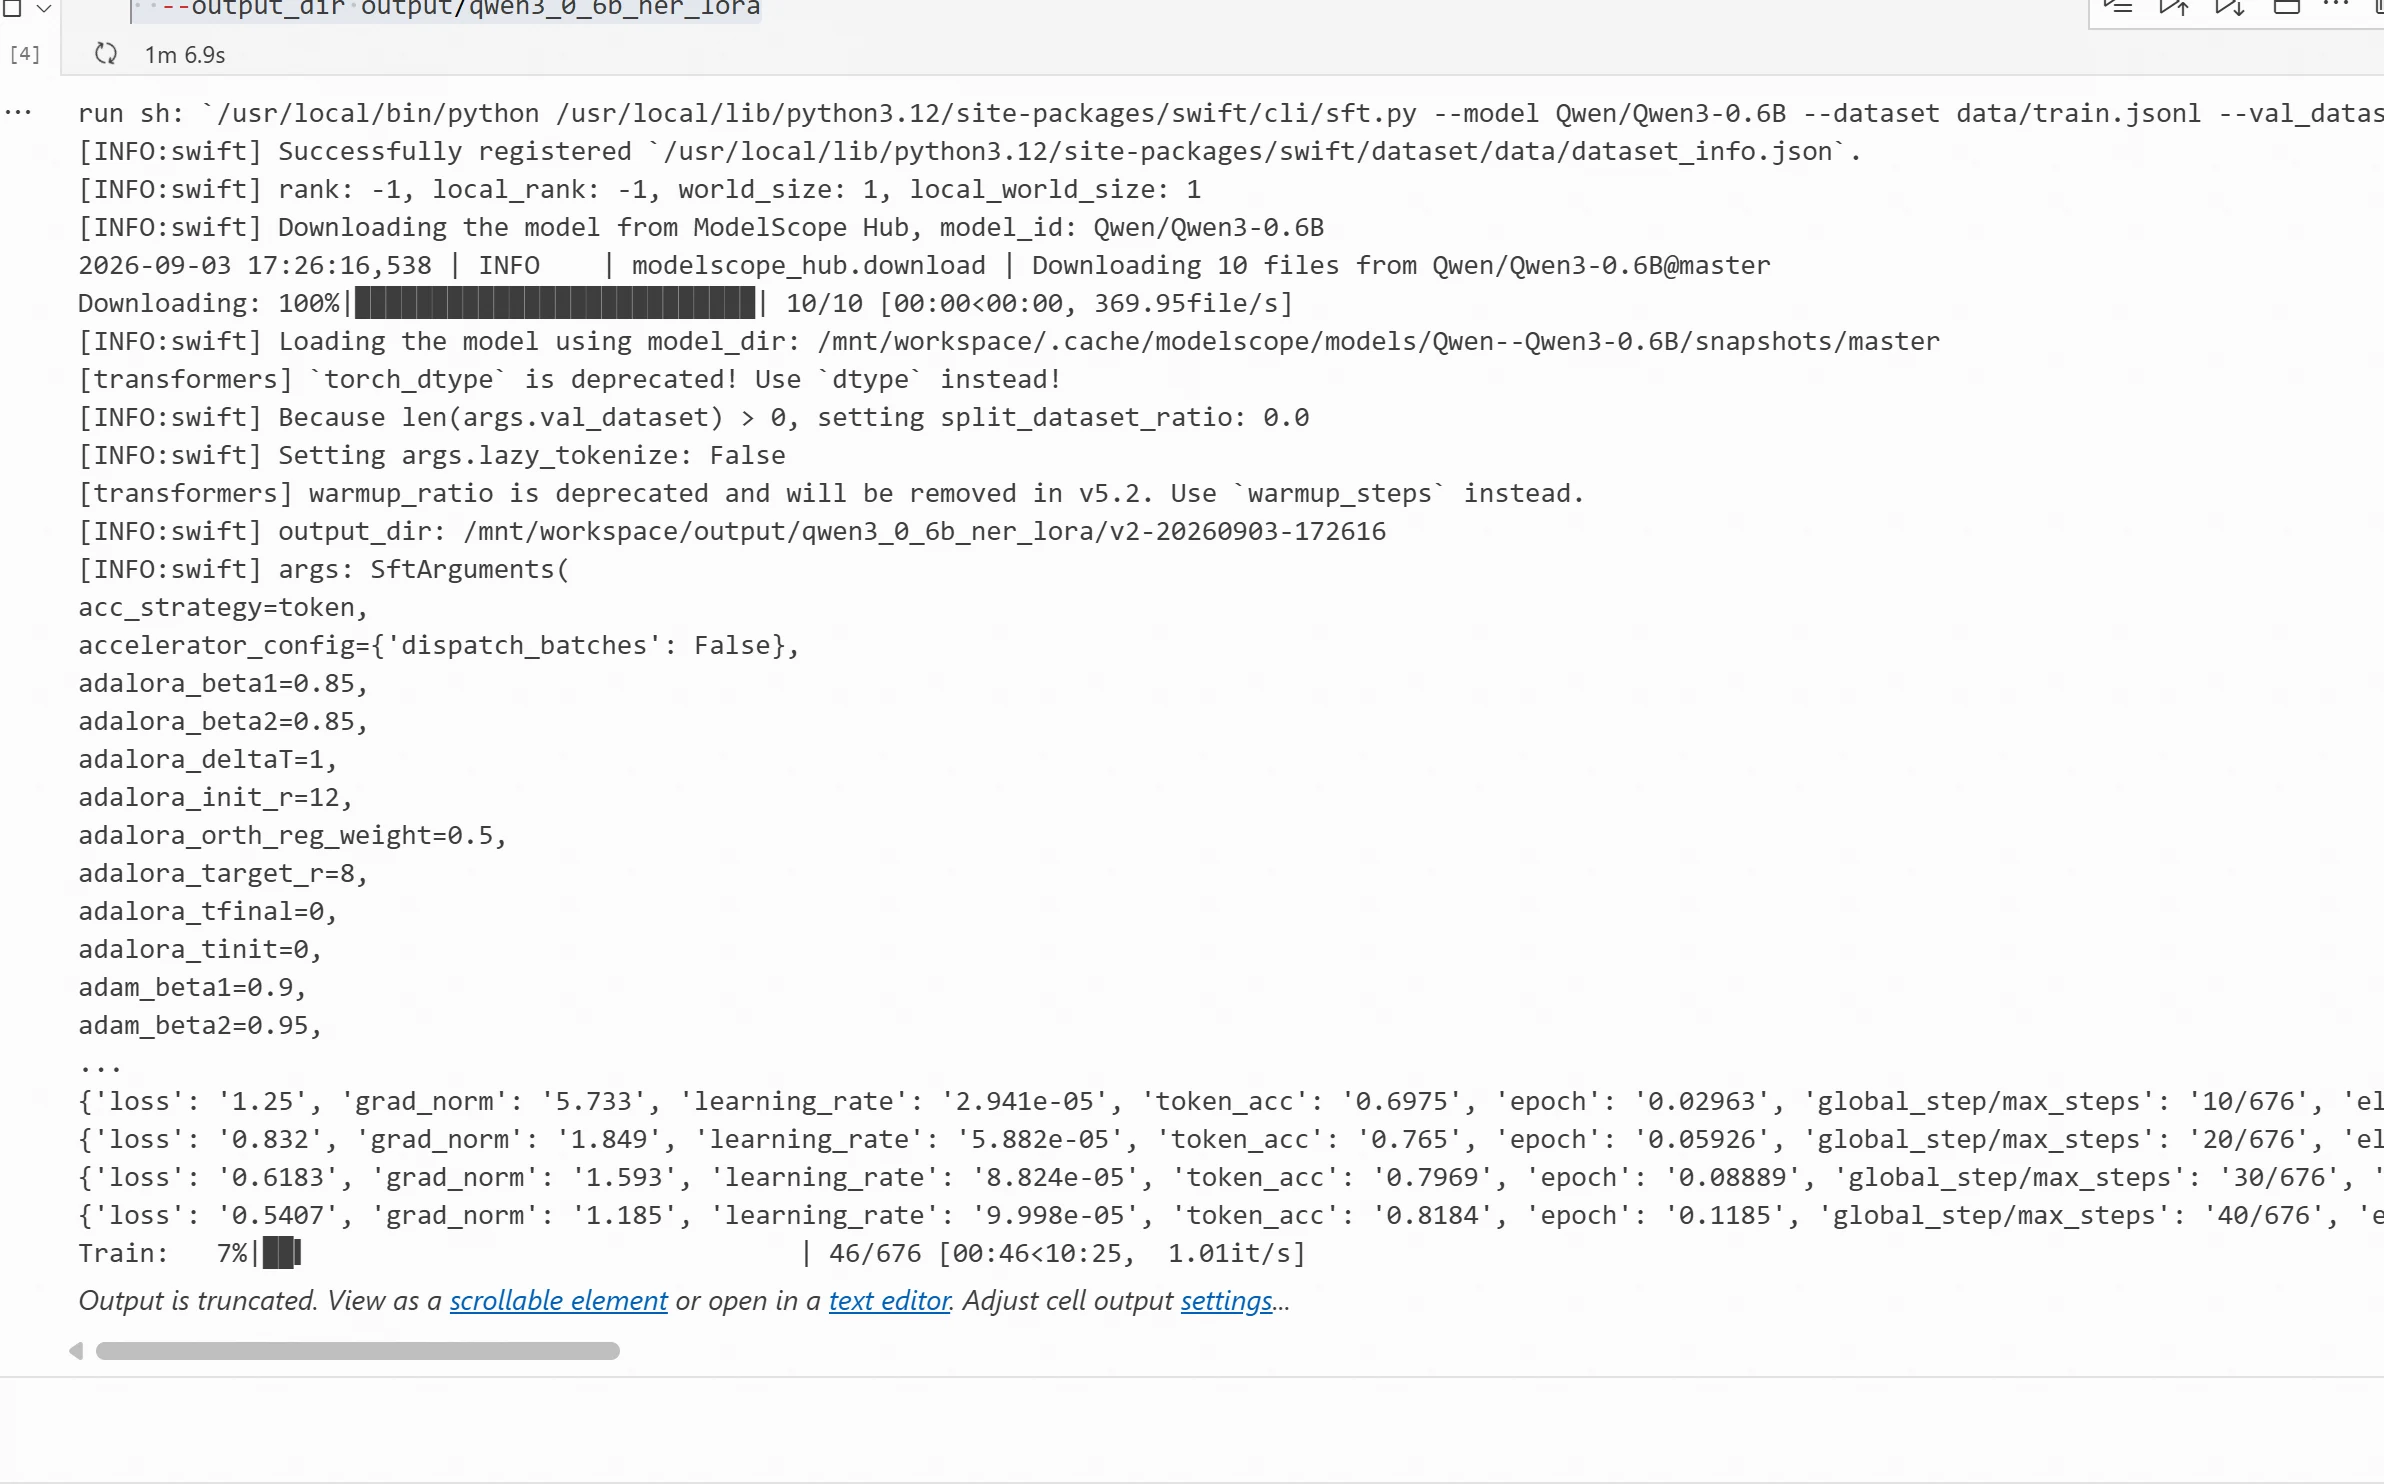
Après le démarrage de l'entraînement, ms-swift affichera des informations sur l'état actuel de l'entraînement, comme suit :
Le modèle a été entraîné, comment l'utiliser ?
Comment fusionner les poids LoRA avec le modèle de base
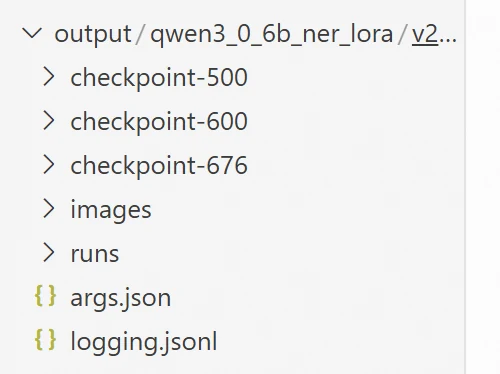
Après la fin de l'entraînement LoRA, un Adapter LoRA correspondant est sauvegardé. L'Adapter n'est pas un grand modèle complet, donc lors de son utilisation, il faut également charger le modèle de base original. En utilisant le chemin de sortie du script d'entraînement, on peut voir le checkpoint ainsi que le fichier Adapter correspondant dans le répertoire. Pendant le déploiement hors ligne ou la migration du modèle, il est plus pratique de fusionner l'Adapter LoRA avec le modèle de base pour générer un modèle complet. La forme du répertoire après l'entraînement est la suivante :
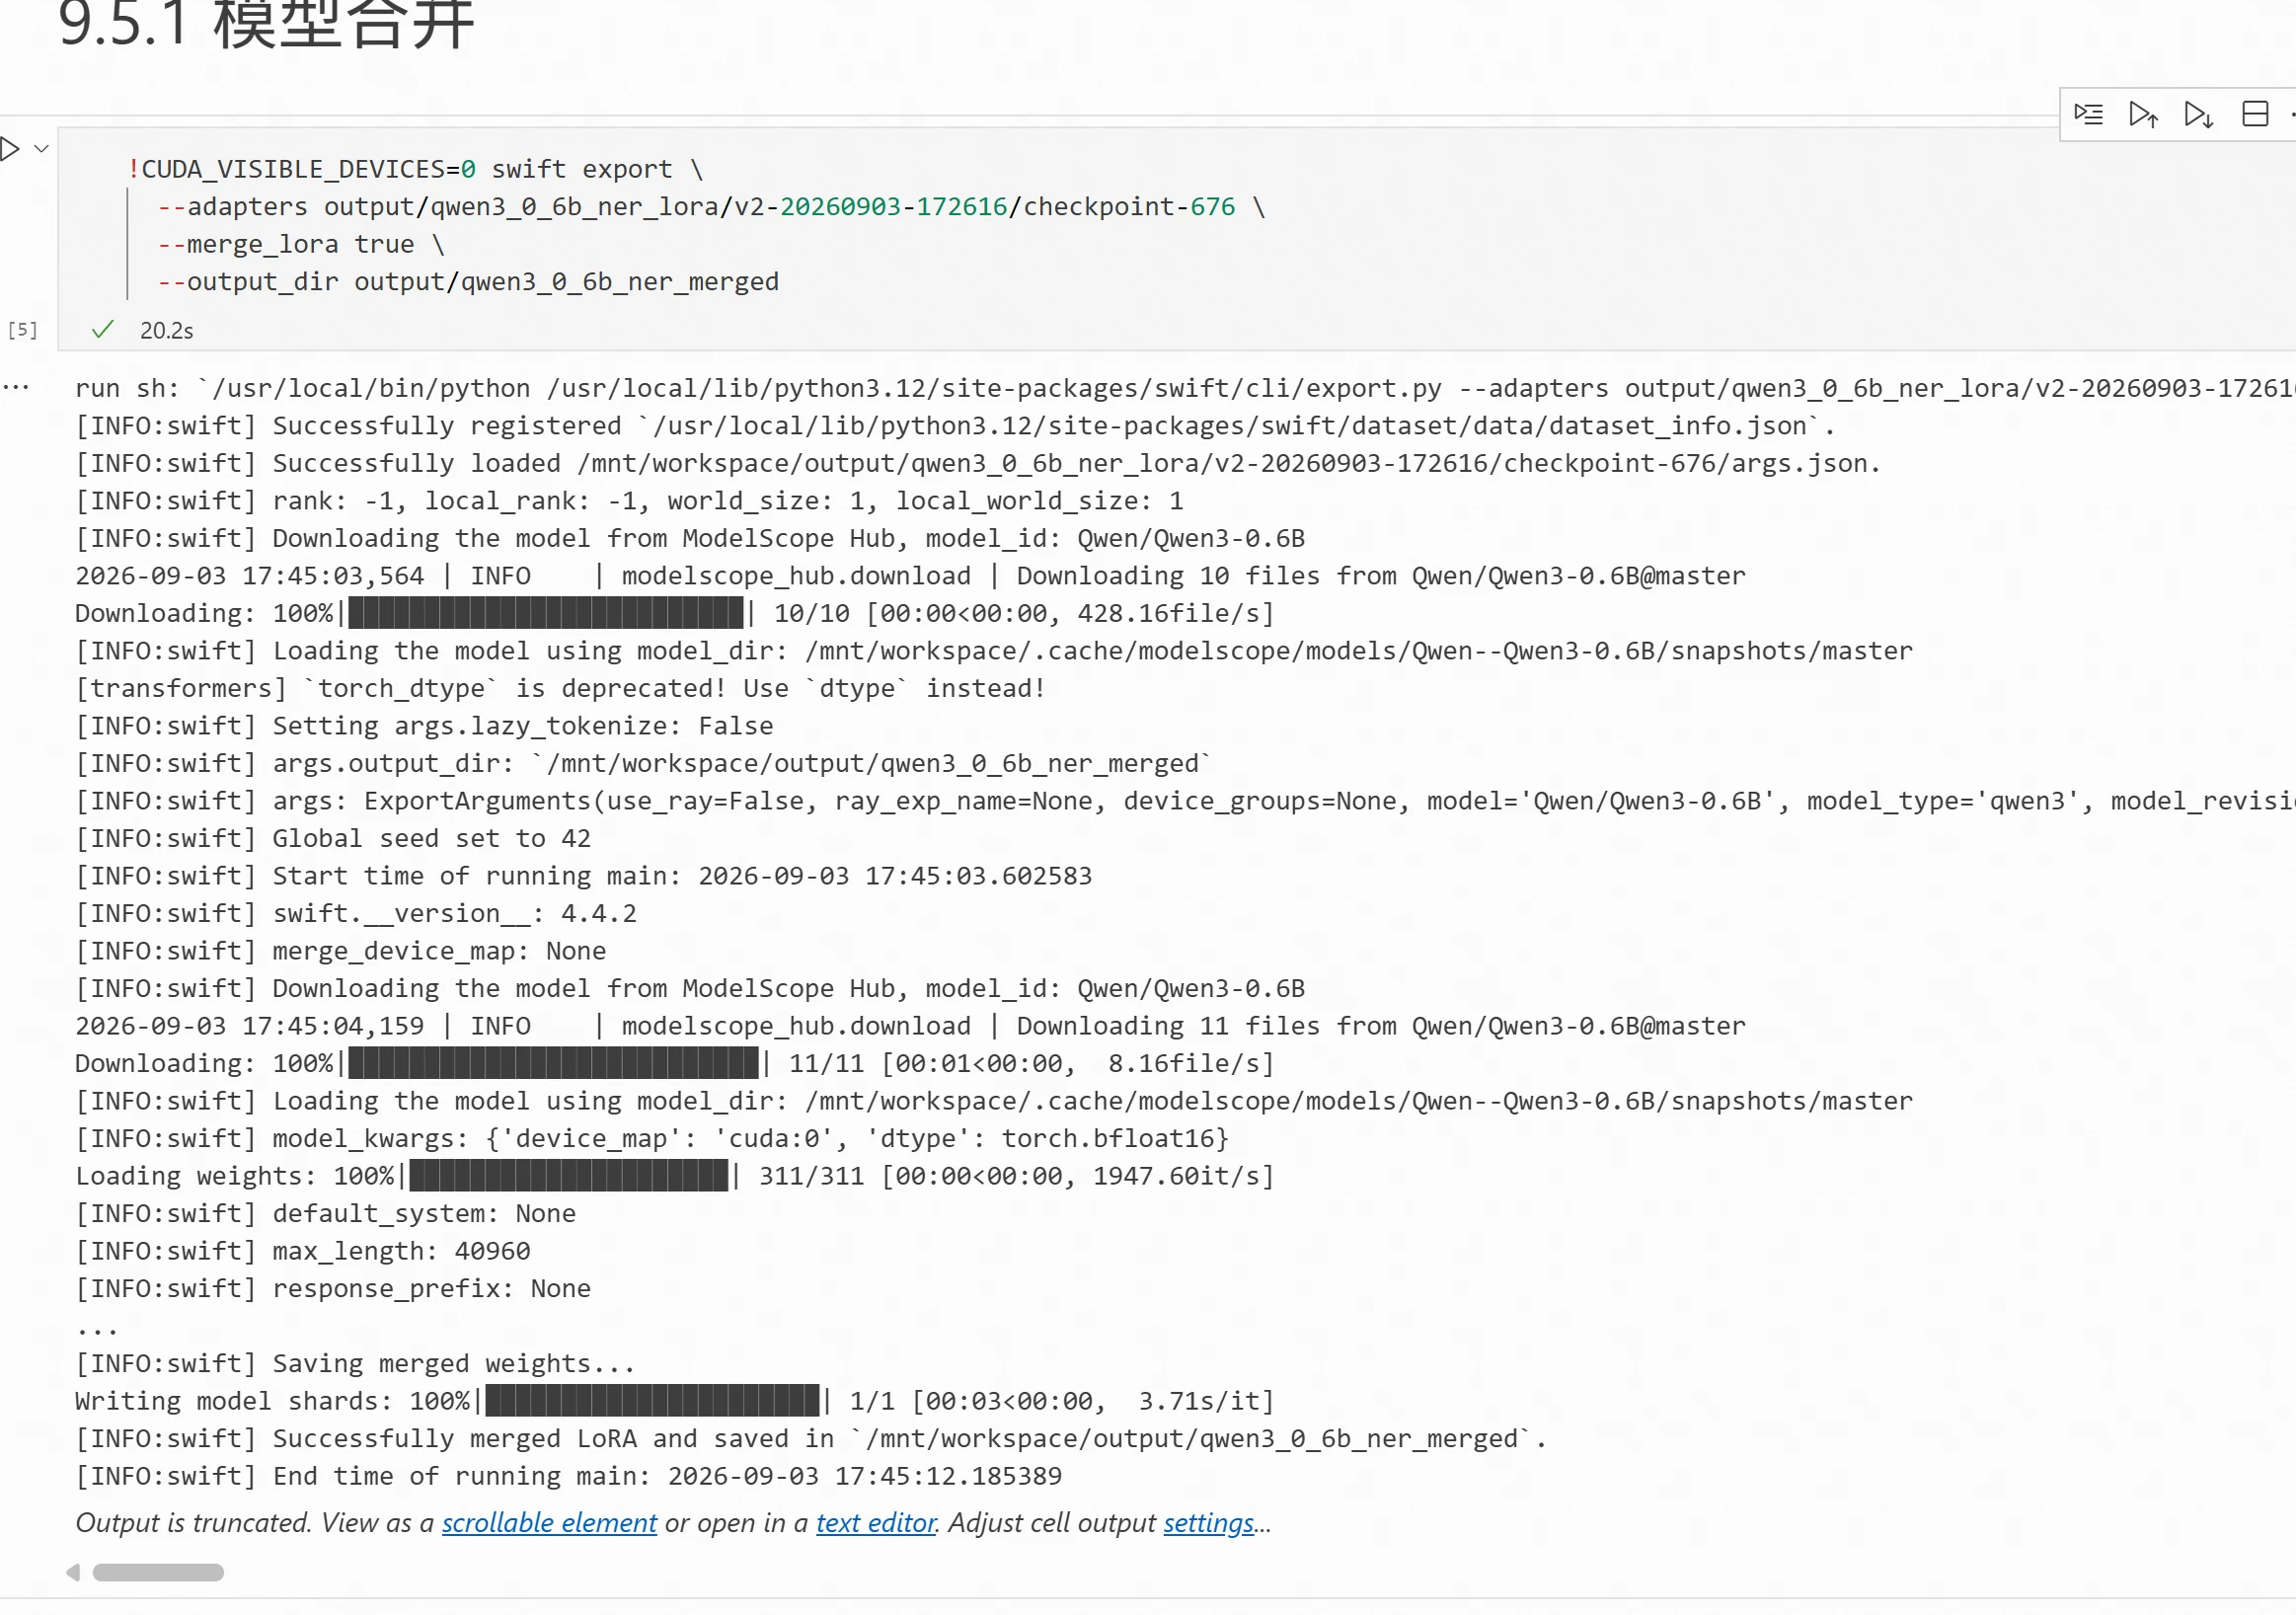
où --adapters spécifie le chemin du checkpoint LoRA obtenu lors de l'entraînement, --merge_lora true indique de fusionner les paramètres LoRA avec le modèle de base, et --output_dir spécifie le répertoire de sauvegarde du modèle fusionné.
Le résultat de l'exécution est le suivant :
Charger le modèle ré-entraîné et tester son efficacité réelle
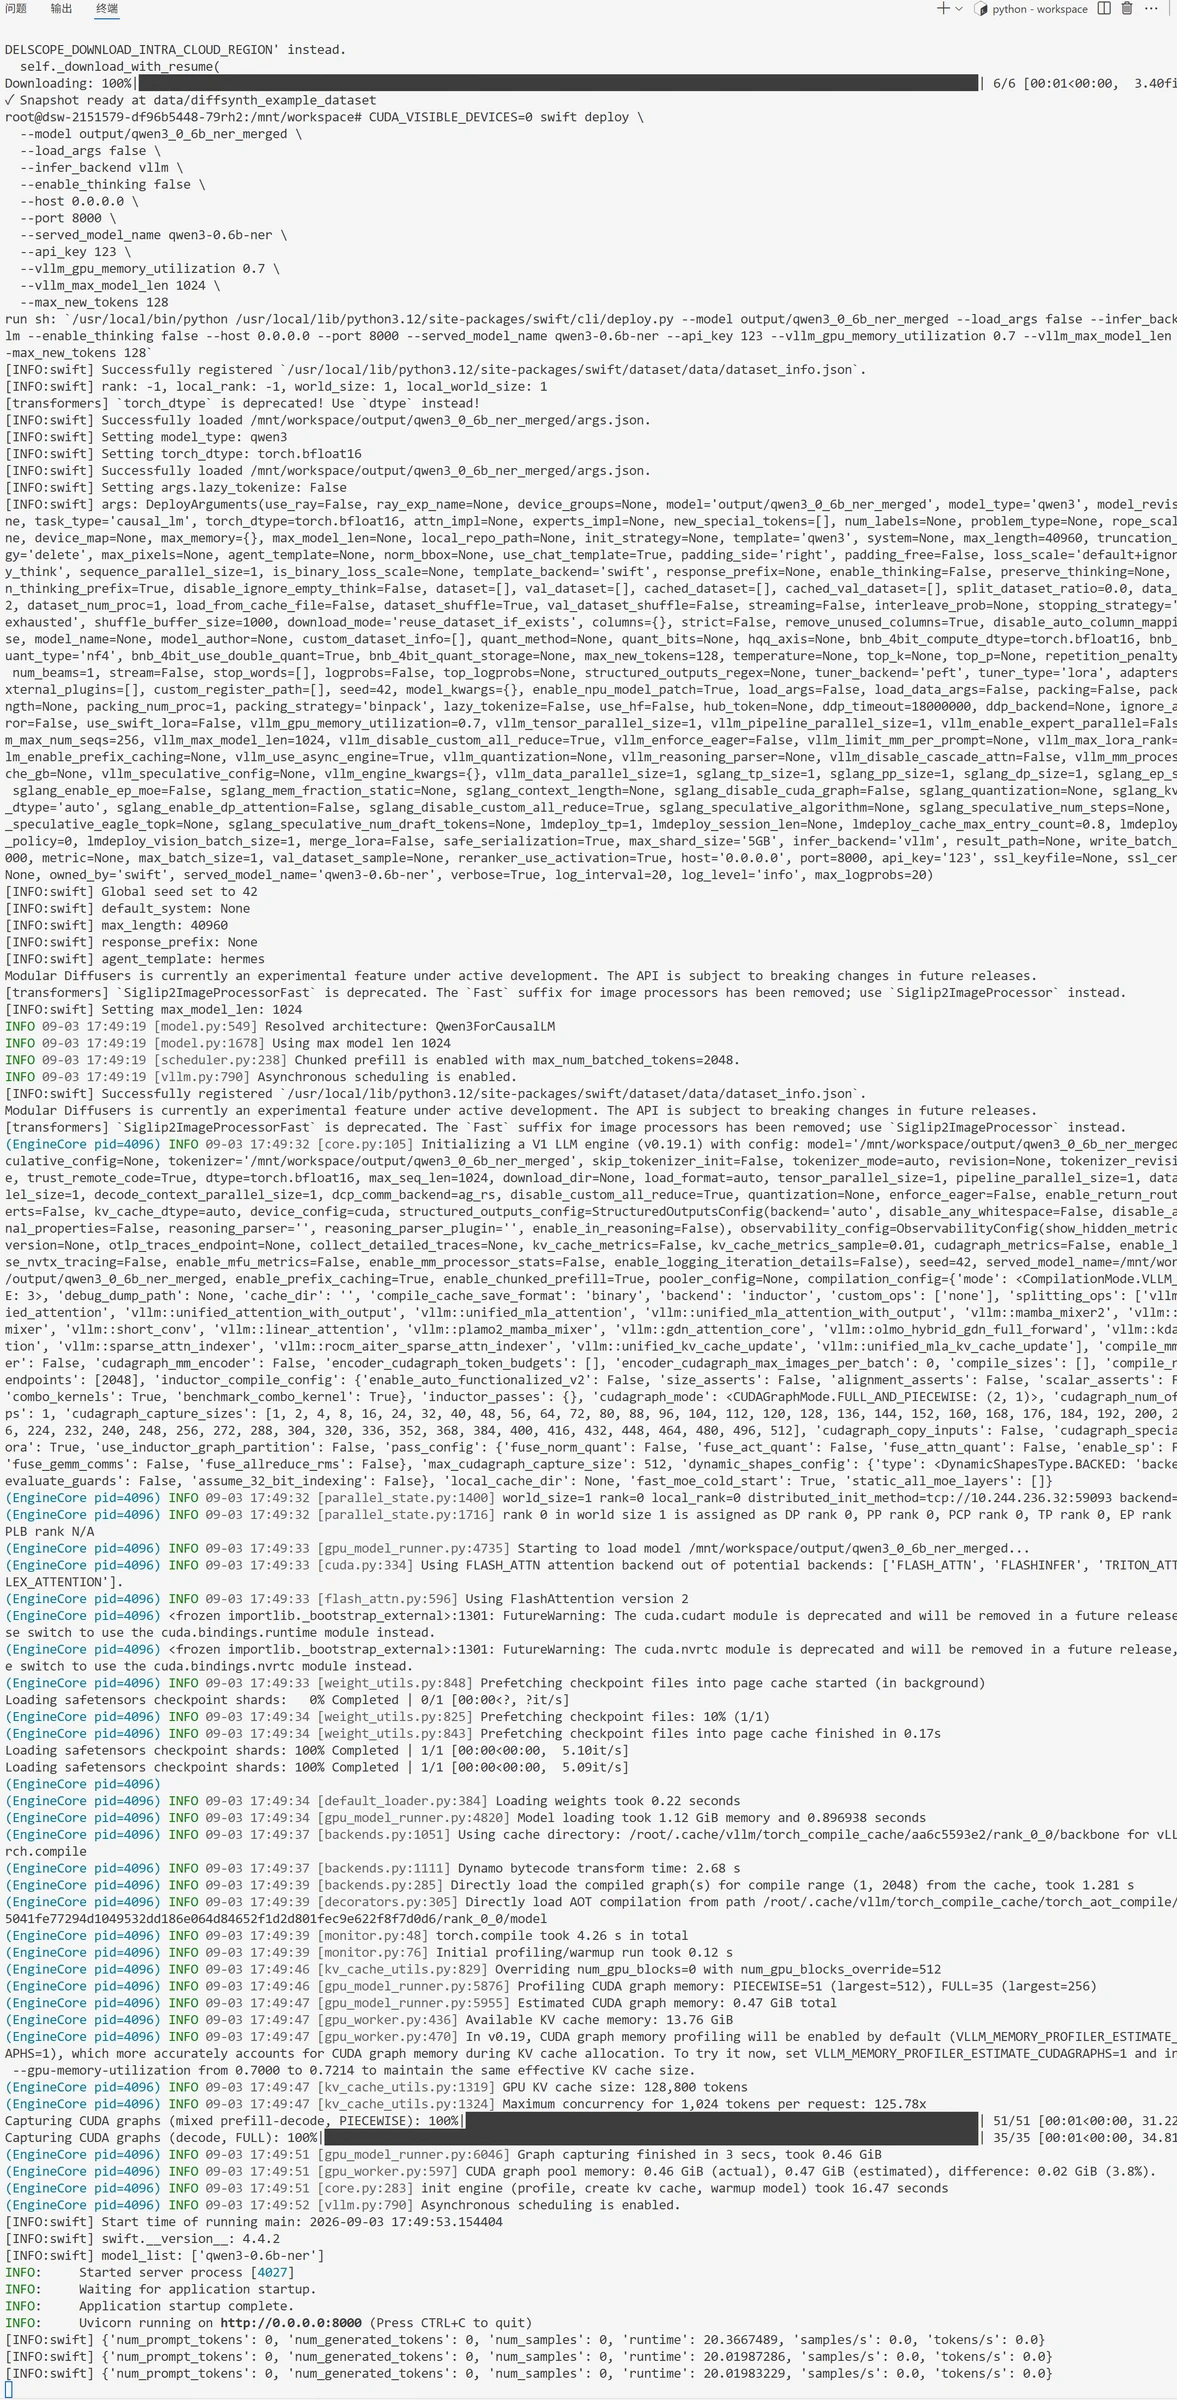
Après la fusion, on peut directement charger le modèle complet généré pour la prédiction. Pour faciliter l'appel par les applications, on peut également démarrer le modèle en tant que service API compatible avec OpenAI. C'est également un service permanent, il faut le démarrer dans le terminal, on peut se référer à la septième recette sur la manière de démarrer des commandes dans le terminal, la commande de démarrage est la suivante :
Démarrer le service de modèle compatible avec OpenAI de ms-swift
--model
Spécifier le répertoire du modèle complet fusionné
--load_args
Ne pas charger les paramètres dans args.json du répertoire
--infer_backend
Utiliser le moteur de prédiction vLLM
--enable_thinking
Arrêter le mode de réflexion de Qwen3
--host
Adresse IP de l'interface
--port
Port
--served_model_name
Configurer le nom du modèle accessible via l'API
--api_key
Configurer la clé d'API d'accès à l'interface
--vllm_gpu_memory_utilization
Utiliser environ 70% de l'espace mémoire GPU
--vllm_max_model_len
Longueur maximale de tous les tokens
--max_new_tokens
Longueur maximale de sortie
Après le démarrage du modèle, le résultat est le suivant :
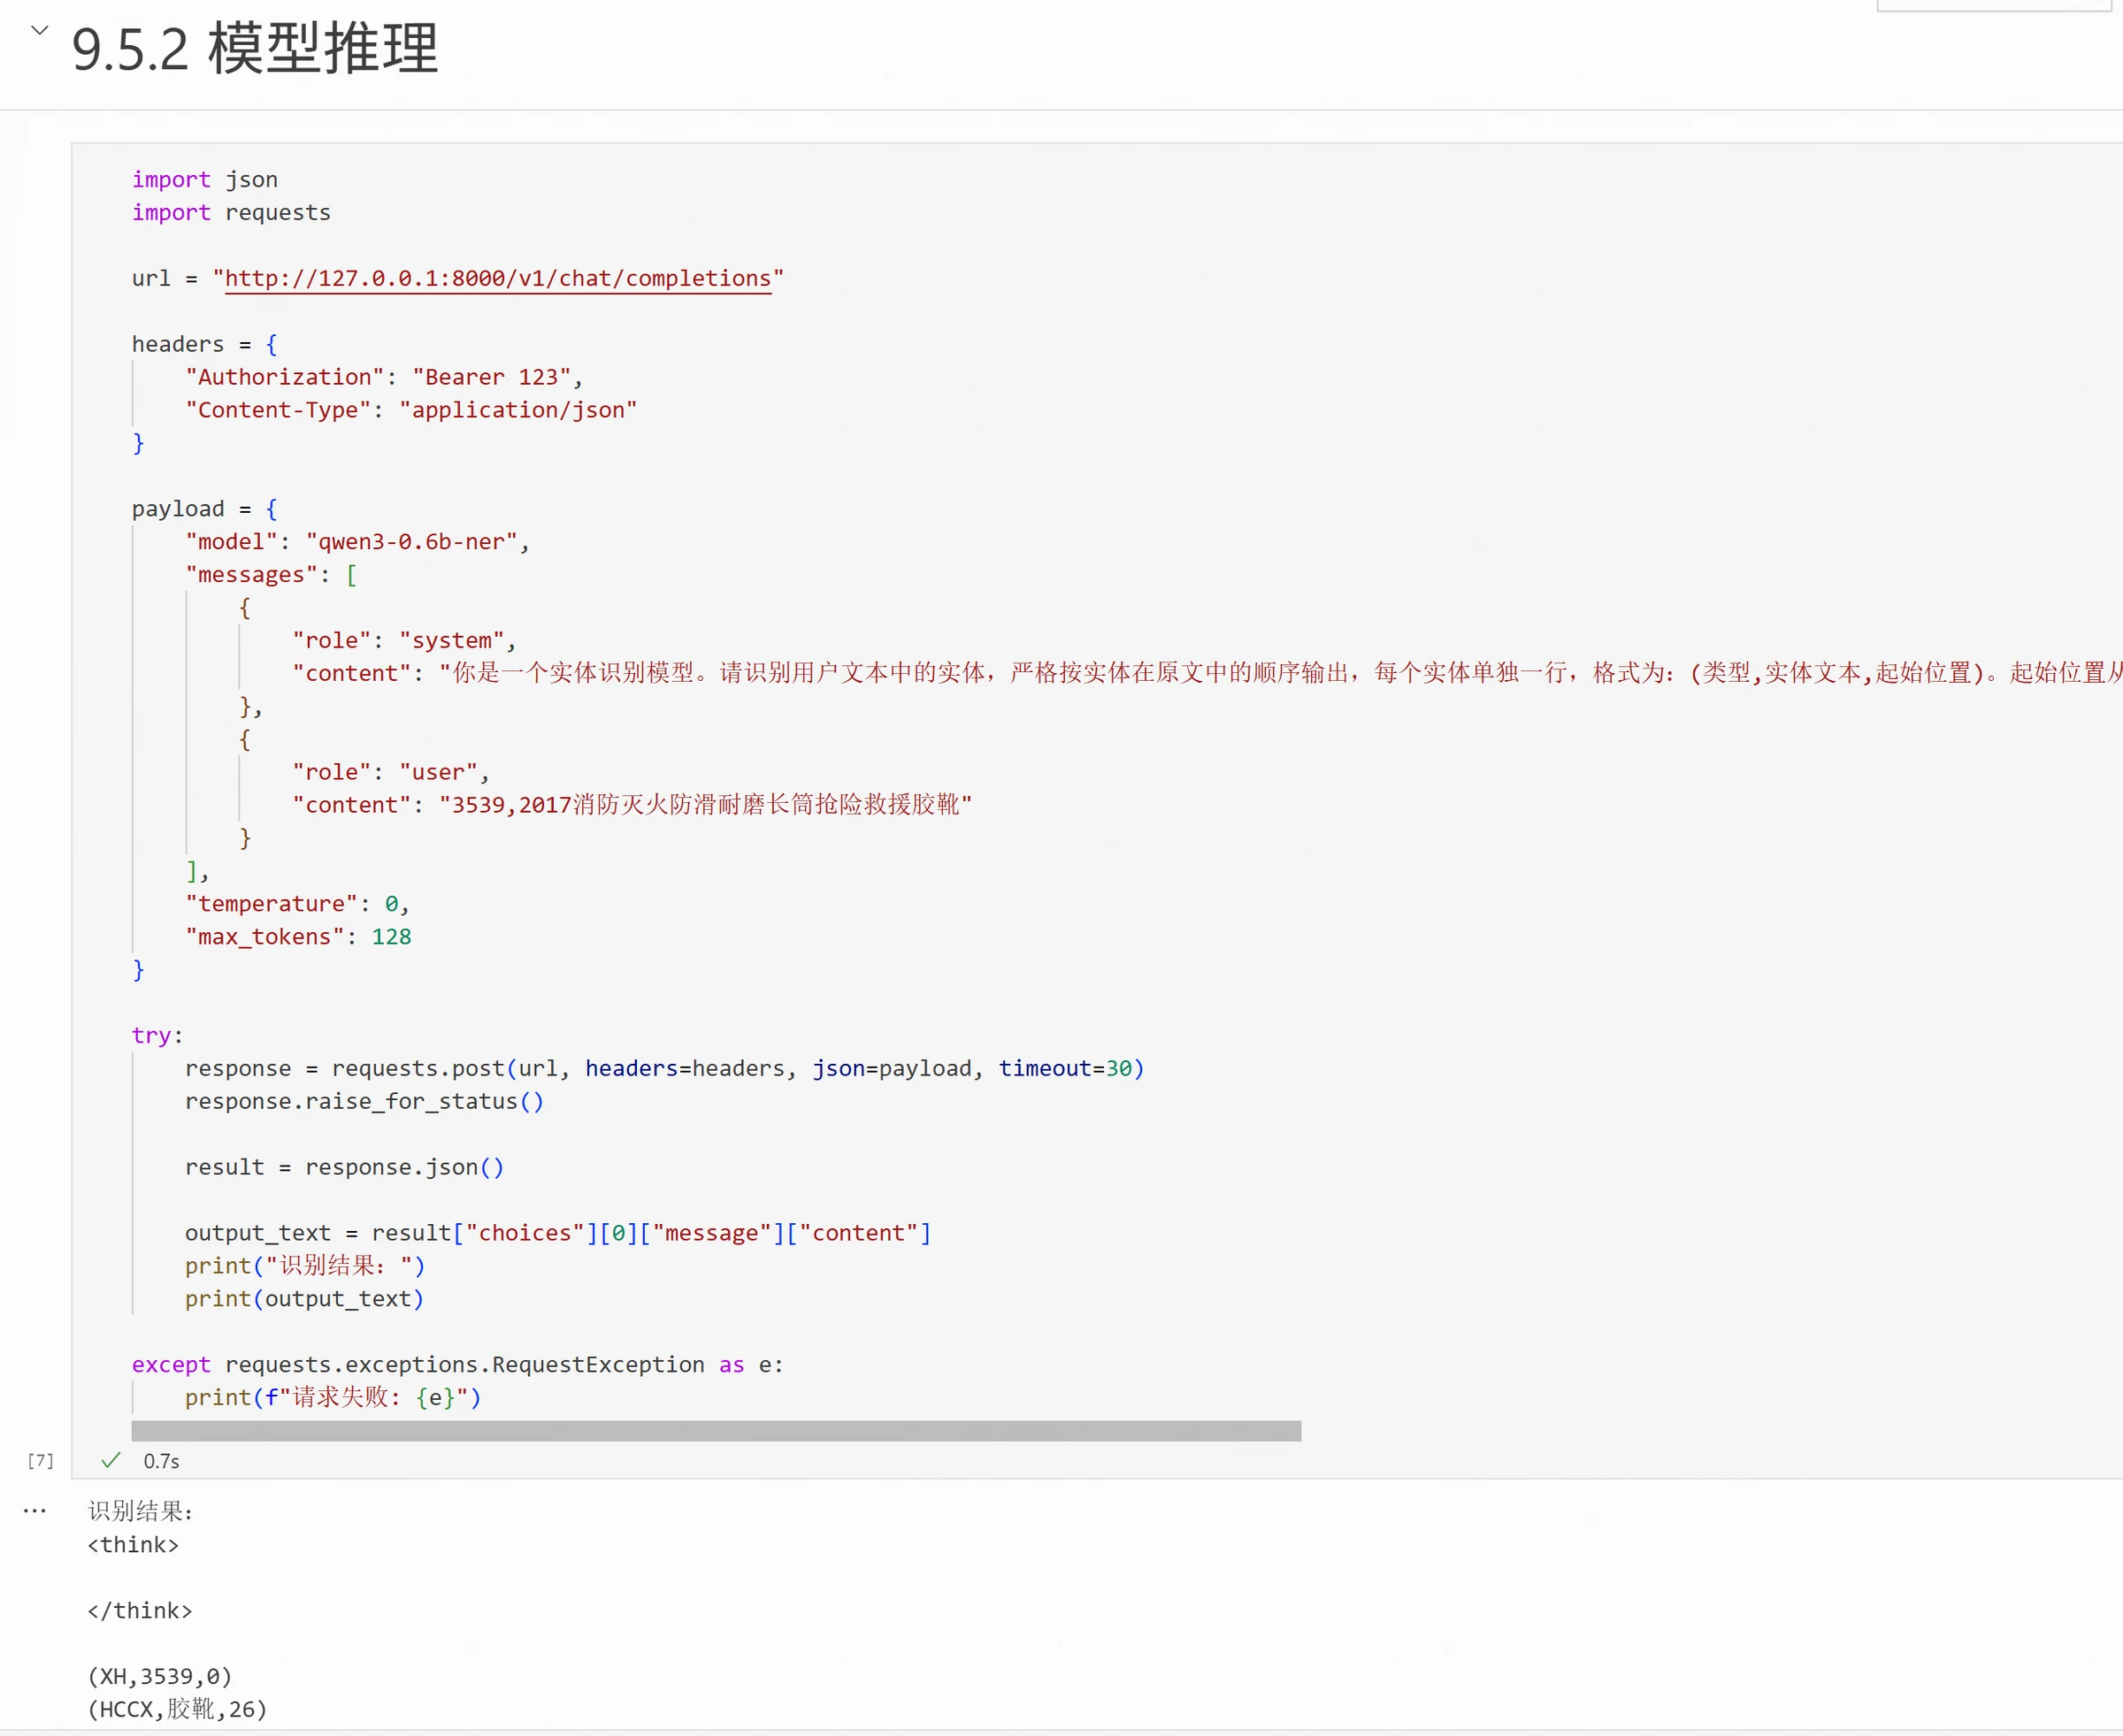
Après le démarrage du modèle, on peut tester si l'interface est connectée, le code est le suivant :
import json
import requests

url = "http://127.0.0.1:8000/v1/chat/completions"

headers = {
    "Authorization": "Bearer 123",
    "Content-Type": "application/json"
}

payload = {
    "model": "qwen3-0.6b-ner",
    "messages": [
        {
            "role": "system",
            "content": "Tu es un modèle d'identification d'entités. Identifie les entités dans le texte de l'utilisateur, sortis strictement selon l'ordre des entités dans le texte original, une entité par ligne, format : (type, texte de l'entité, position de départ). La position de départ commence à 0 ; le type peut être l'un de HCCX, HPPX, MISC, XH. Quand il n'y a pas d'entité, il ne faut pas sortir : Aucune entité. Ne sort pas d'explications, Markdown, think markers ou autre contenu."
        },
        {
            "role": "user",
            "content": "3539,2017消防灭火防滑耐磨长筒抢险救援胶靴"
        }
    ],
    "temperature": 0,
    "max_tokens": 128
}

try:
    response = requests.post(url, headers=headers, json=payload, timeout=30)
    response.raise_for_status()

    result = response.json()

    output_text = result["choices"][0]["message"]["content"]
    print("Résultat d'identification :")
    print(output_text)

except requests.exceptions.RequestException as e:
    print(f"Échec de la requête : {e}")
Le résultat de sortie du modèle est le suivant, on peut également utiliser des expressions régulières pour enlever les tags think.
Toutes les données d'expérience et les codes de cette section peuvent être consultés sur : https://modelscope.cn/gallery/liucong/ab458cbd-b47f-4830-91b6-314ea2036fc6