Après le fine-tuning, le modèle peut répondre aux demandes comme requis. Cependant, si l'on compare plusieurs réponses pour la même question, on constate que certaines sont meilleures que d'autres, et certaines peuvent paraître plus agréables.
Par exemple, dans le contexte d'une demande de remboursement, tout en informant l'utilisateur où demander un remboursement, une réponse ne fournit que l'entrée d'opération, tandis qu'une autre réponse explique également que le processus d'examen est nécessaire, et que le remboursement dépend de la situation de la commande. Les deux réponses traitent du remboursement, mais la deuxième en informe l'utilisateur sur les étapes futures potentielles et réduit ainsi les malentendus.
Lors du SFT (Supervised Fine-Tuning), nous avons collecté des réponses comme celles-ci pour les utiliser comme exemples d'apprentissage pour le modèle. Maintenant, nous pouvons également comparer plusieurs réponses à la même question pour indiquer au modèle quelle réponse nous préférons et quels sont les critères d'évaluation.
C'est l'alignement de préférences, et nous y commencerons.
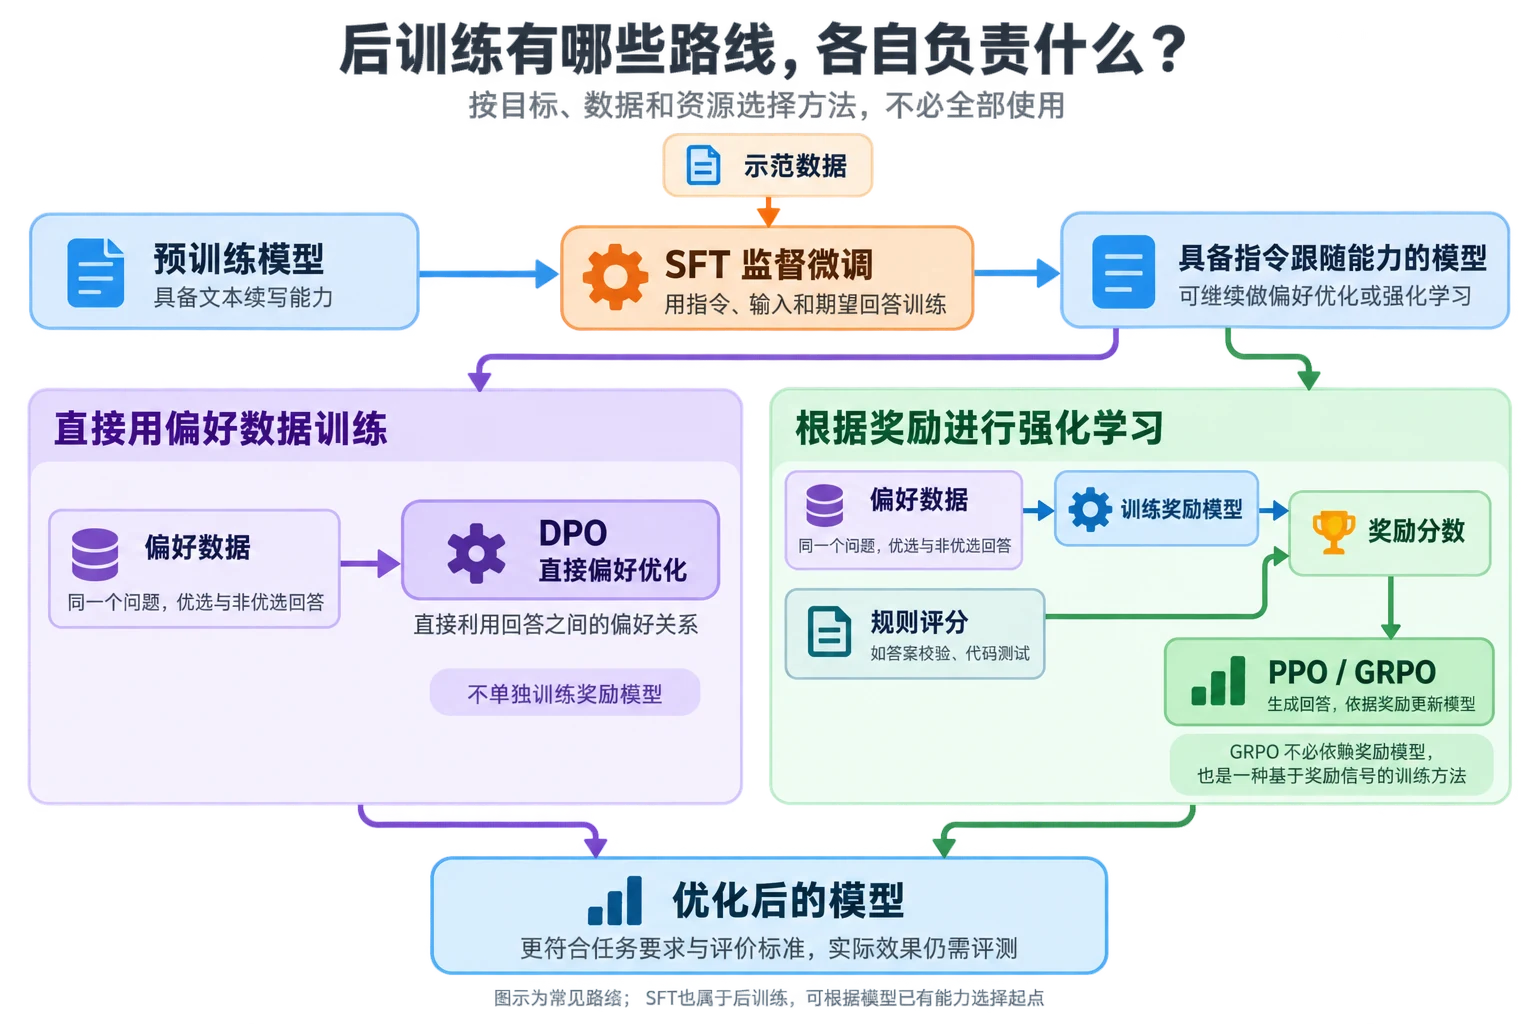
L'objectif principal du post-traitement des grands modèles est d'aider les modèles de base dotés de capacités de continuation de texte à devenir plus efficaces dans les tâches spécifiques comme la conversation directe, la suivie des instructions et la réalisation de tâches. Le post-traitement n'est pas une algorithme unique, mais un ensemble de méthodes d'entraînement. Les méthodes courantes incluent SFT (Supervised Fine-Tuning), l'optimisation de préférences, l'entraînement de modèles de récompense et l'apprentissage par renforcement, les modèles différents choisissant des combinaisons différentes en fonction de l'objectif d'entraînement, des conditions de données et des coûts.
Parmi elles, SFT utilise des données de la forme « instruction, entrée et réponse attendue » pour apprendre au modèle à comprendre les tâches, suivre les instructions et répondre selon le format et la manière attendus. Sur cette base, on peut utiliser des données de préférences pour l'alignement, par exemple en construisant des réponses optimales et non optimales pour la même question, permettant au modèle d'apprendre les critères d'évaluation humains ou d'affaires. Les données de préférences peuvent être utilisées pour entraîner un modèle de récompense, transformer les préférences humaines en scores de récompense calculables, puis utiliser des méthodes de renforcement comme PPO (Proximal Policy Optimization) ou GRPO (Group Relative Policy Optimization) pour optimiser continuellement la stratégie de génération du modèle ; ou bien utiliser des méthodes comme DPO (Direct Preference Optimization) directement, en inscrivant la relation de préférence entre les réponses optimales et non optimales dans l'objectif d'entraînement, sans nécessiter une entraînement séparé de modèle de récompense.
Se connecter pour rejoindre la discussion
Par conséquent, le post-traitement des grands modèles n'a pas de processus fixe, et SFT, les modèles de récompense, PPO, GRPO et DPO ont des rôles différents. SFT est principalement utilisé pour établir une capacité de suivi des instructions de base, les modèles de récompense fournissent des signaux d'évaluation quantifiables, PPO et GRPO optimisent la stratégie de génération en se basant sur les signaux de récompense, tandis que DPO utilise directement les données de préférences pour l'alignement du modèle. Dans le processus de formation réelle, ces méthodes n'ont pas besoin d'être toutes utilisées, ni d'être combinées dans un ordre strict, mais doivent être choisies de manière flexible en fonction de la capacité du modèle, de l'objectif de la tâche et des ressources d'entraînement.
SFT (Supervised Fine-Tuning) est le micro-tuning supervisé. Il utilise des données d'entrée et de sortie attendues déjà organisées pour continuer à entraîner le modèle, augmentant la probabilité de générer une réponse attendue lorsque le modèle voit des entrées similaires.
Une donnée SFT peut être écrite comme suit :
{
  "instruction": "Générer une réponse de service client à partir de la question de l'utilisateur",
  "input": "Membre : Je souhaite faire une demande de remboursement car j'ai été automatiquement facturé hier.",
  "output": "Veuillez d'abord vérifier le statut de la commande de renouvellement dans la page des commandes. Lorsque les conditions de remboursement sont remplies, vous pouvez soumettre une demande dans les détails de la commande ; si la page ne contient pas d'entrée de remboursement, veuillez contacter le service client pour une vérification."
}
Lors de l'entraînement, le tokenizer convertit les instructions, les entrées et les réponses en tokens. Le modèle prédit le prochain token en se basant sur les tokens précédents, puis calcule la perte en comparant les résultats de prédiction avec la réponse attendue. Le SFT des grands modèles utilise généralement la perte de cross-entropy et la formation par contrainte : lors de l'entraînement à chaque position, le modèle voit le contexte correct déjà fourni dans les données, plutôt que le contenu incorrect qu'il vient de générer. Beaucoup d'implémentations de micro-tuning d'instructions ne calculent la perte que sur la partie réponse, les instructions et les entrées de l'utilisateur servent à fournir le contexte, mais ne sont pas exigées pour être re-générées par le modèle.
Le premier changement du SFT est le format de tâche. Le modèle comprendra peu à peu que l'entrée est une consultation de l'utilisateur et que la sortie doit être une réponse de service client, et non une continuation de la question de l'utilisateur. Pour l'extraction d'informations, il peut apprendre à générer des champs JSON fixes ; pour les notes de réunion, il peut apprendre à organiser le contenu en fonction des informations de réunion, des conclusions clés et des points d'action. Ensuite, le SFT change la manière de réponse du modèle. L'intonation, la longueur, la structure des paragraphes, le niveau d'explication et la manière de rejeter une demande dans les données d'entraînement deviennent des modèles que le modèle imite. Si les réponses attendues sont généralement concises, le modèle tendra à donner des conclusions directement ; si les exemples exigent une justification avant les étapes, le modèle apprendra cette manière d'organisation. Le SFT peut également faire en sorte que le modèle soit exposé à des exemples de domaine. Les conditions de commande, les conditions de remboursement et l'accès à un service client dans les données de service client, la structure des clauses dans les données juridiques, l'utilisation des interfaces dans les données de code influencent la sortie du modèle dans les tâches correspondantes. Cependant, cela ne signifie pas que le modèle a automatiquement maîtrisé toute la connaissance du domaine. Le modèle a l'opportunité d'apprendre ces modèles dans les mises à jour de paramètres uniquement si les données d'entraînement couvrent les tâches, les termes et les manières de traitement concernés.
Le but de l'entraînement du SFT reste fondamentalement l'imitation de la sortie attendue. Il permet au modèle de savoir comment répondre à ce type de question, mais ne garantit pas que les faits dans la réponse ont été vérifiés, et ne peut pas apprendre à comparer toutes les réponses possibles avec une seule démonstration. Pour la même question de remboursement, on peut obtenir les réponses suivantes :
Réponse A : Veuillez demander un remboursement dans les détails de la commande. Si l'opération n'est pas possible, veuillez contacter le service client.
Réponse B : Vous pouvez d'abord vérifier le statut de la commande. Lorsque les conditions de remboursement sont remplies, vous pouvez soumettre une demande dans les détails de la commande ; si la page ne contient pas d'entrée de remboursement, veuillez contacter le service client pour une vérification. Les résultats de remboursement et le temps de virement sont soumis à l'examen réel.
Les deux réponses sont liées au remboursement, mais la réponse B ajoute les conditions d'examen, évite les promesses de résultats de remboursement fixes et est plus adaptée si le secteur accorde plus d'importance à l'information complète et à la limite de conformité. Le SFT peut donner la réponse B comme exemple à l'apprentissage du modèle, tandis que les données de préférences peuvent donner à la fois A et B et indiquer pourquoi B est plus préféré. C'est le passage de l'apprentissage supervisé à l'alignement de préférences.
L'alignement de préférences se concentre sur le fait que, face à plusieurs réponses possibles, nous devrions préférer laquelle. Elle compare généralement le meilleur et le pire des réponses pour la même entrée et transforme les exigences comme l'exactitude, la pertinence, l'utilité, la manière d'exprimer, la sécurité en signaux d'entraînement. Par rapport à SFT, SFT enseigne au modèle « comment répondre », utilisant généralement un seul entrée pour une seule sortie attendue, permettant au modèle d'apprendre le format de tâche, la structure de contenu, l'expression de domaine et la manière de répondre de base ; l'alignement de préférences, en revanche, après que le modèle ait déjà une certaine capacité de réponse, enseigne au modèle « comment répondre de manière meilleure ».
Par exemple, dans le contexte de service client, si une réponse manque les conditions d'examen, promet un résultat de remboursement fixe ou transforme les éléments incertains en résultats fixes, elle peut être marquée comme une réponse moins bonne ; si une autre réponse peut clairement indiquer le chemin de procédure, conserver les limites d'examen nécessaires et ne pas inclure des promesses sans fondement, elle peut être marquée comme une réponse plus optimale. En utilisant de nombreuses comparaisons de ce type pour l'entraînement, le modèle augmentera progressivement la probabilité de générer des réponses optimales, et tendra à produire des résultats conformes aux exigences du secteur dans des questions similaires. Il est important de noter que l'alignement de préférences n'apprend pas une « valeur humaine abstraite et unique », mais des critères d'évaluation définis pour une tâche spécifique en utilisant une fonction de récompense. Les tâches différentes nécessitent des données de préférences construites pour correspondre aux tâches. Par conséquent, avant de construire les données de préférences, il faut d'abord définir « quoi est meilleur », sinon les annotateurs peuvent donner des choix contradictoires en raison de leurs interprétations différentes.
De plus, l'alignement de préférences ne peut pas remplacer la vérification des faits. Une réponse peut être fluide, amicale, mais citer une politique incorrecte ; une autre réponse peut être correcte en fait, mais ne suivre pas le format de sortie requis. Par conséquent, les systèmes d'évaluation réels définissent généralement des critères pour la vérification des faits, la complétion de la tâche, le style d'expression et la conformité. Pour les contenus pouvant être vérifiés automatiquement, on peut combiner des tests de code, des vérifications de réponses, des vérifications de format et des règles d'affaires pour réduire la dépendance subjective de l'humain et les biais.
Les données de préférences (Preference Data) sont utilisées pour indiquer au modèle « quelle réponse est meilleure parmi plusieurs ». Elles diffèrent le plus de SFT : SFT fournit généralement un seul entrée et une seule réponse attendue, tandis que les données de préférences préparent plusieurs réponses candidates pour la même entrée prompt et marquent leur relation de meilleure et moins bonne. La forme la plus courante des données de préférences est composée d'un entrée, d'une réponse choisie et d'une réponse rejetée :
{
  "prompt": "Membre : Je souhaite faire une demande de remboursement car j'ai été automatiquement facturé hier.",
  "chosen": "Veuillez d'abord vérifier le statut de la commande. Lorsque les conditions de remboursement sont remplies, vous pouvez soumettre une demande dans les détails de la commande ; si la page ne contient pas d'entrée de remboursement, veuillez contacter le service client pour une vérification.",
  "rejected": "Vous pouvez obtenir un remboursement dans les trois jours ouvrables."
}
Dans ce cas, chosen représente la réponse plus appropriée selon les critères d'évaluation actuels, et rejected représente la réponse relativement moins appropriée. La réponse rejetée n'est pas nécessairement entièrement incorrecte, elle peut aussi manquer des conditions essentielles, être trop longue, avoir une intonation non adaptée, ou inclure des promesses sans fondement. Les données de préférences expriment une relation relative, et non un étiquetage permanent de correct ou incorrect pour chaque réponse.
Les données de préférences sont généralement construites selon le processus suivant :
Si un même entrée génère A, B, C et D réponses, les résultats d'annotation sont B > A, A > D, D > C, on peut convertir cela en plusieurs paires de préférences. Dans la pratique, il n'est pas nécessaire d'enumerer toutes les combinaisons. Les réponses avec des différences trop petites sont difficiles à annoter de manière stable, tandis que les réponses avec des différences trop grandes peuvent faire que le modèle apprenne simplement à éviter les erreurs de bas niveau. Les données les plus précieuses sont souvent issues de réponses toutes lisibles, mais présentant des différences claires sur les conditions clés, les limites factuelles ou la complétion de la tâche.
La construction des annotations de préférences peut être influencée par certains facteurs de surface. Une réponse plus longue semble plus complète, une réponse avec un vocabulaire plus confiant semble plus fiable, la réponse placée en premier peut être plus facilement choisie. Pour réduire ces biais, on peut ajuster aléatoirement l'ordre des candidats, cacher le nom du modèle, exiger que les annotateurs vérifient séparément les faits, la complétion de la tâche, le style et la sécurité, et effectuer des annotations répétées par plusieurs personnes sur certains échantillons. Si les annotateurs de la même batch ont souvent des opinions différentes, cela indique généralement que les critères d'évaluation ne sont pas clairs, plutôt que de simplement supprimer une minorité d'opinions.
Les données de préférences ont déjà représenté « quelle réponse est meilleure pour le même prompt » par la relation relative entre chosen et rejected. Le rôle du modèle de récompense (Reward Model, RM) est d'utiliser ces données de préférences pour apprendre une fonction de notation automatique, en transformant les résultats de comparaison humains en signaux de récompense utilisables par les algorithmes de renforcement suivants. Les modèles de récompense courants se basent sur un modèle de langage, avec une couche de notation ajoutée en fin. Pendant l'entraînement, le prompt et la réponse sont concaténés en une séquence, passée par le modèle pour obtenir l'état caché, puis une couche de notation donne un nombre.
Le modèle de récompense n'a pas besoin de savoir combien de points chaque réponse devrait obtenir, il n'a besoin que d'apprendre une relation relative : dans ce prompt, le score de chosen devrait être supérieur au score de rejected. Pendant l'entraînement, on soumet généralement le prompt concaténé avec les deux réponses candidates :
Prompt + chosen   → rchosen
Prompt + rejected → rrejected
où rchosen et rrejected sont les scores scalaires de la récompense model pour la réponse choisie et la réponse rejetée. L'objectif de l'entraînement est de faire en sorte que le score de la réponse choisie soit supérieur au score de la réponse rejetée. Une perte courante de tri par paires peut s'écrire comme :
\mathcal{L} = -\log \sigma\left(r_{\text{chosen}} - r_{\text{rejected}}\right)
où r_chosen et r_rejected représentent les notes du modèle de récompense pour la réponse choisie et la réponse rejetée, et σ mappe la différence de scores entre 0 et 1. Plus le score de la réponse choisie est élevé et celui de la réponse rejetée est faible, plus la perte est petite. Après une grande entraînement avec des données de préférences, le modèle de récompense peut évaluer les réponses inconnues.
Le modèle de récompense se base généralement sur un modèle de langage, avec une couche de notation ajoutée pour donner un score scalaire. Il prend en entrée toujours le prompt et la réponse textuelle, mais sa sortie n'est plus la prédiction du prochain token, mais un score pour indiquer la qualité relative. Ce score n'a pas de signification physique unifiée, ni ne peut être interprété comme « taux de réussite » ou « 10 points sur 10 ». Ce qui est significatif, c'est le classement des réponses entre elles dans le même modèle de récompense. Par exemple, une réponse obtient 6 points, une autre 4 points, cela signifie que la première est, selon le modèle de récompense actuel, plus conforme aux critères de préférence, mais ne signifie pas qu'elle est « de meilleure qualité » dans un sens objectif.
Ce que le modèle de récompense apprend, dépend fortement des données de préférences construites. Si les annotateurs dans les données de préférences tendent toujours à choisir les réponses plus longues, le modèle de récompense peut prendre la longueur pour un indicateur de qualité ; si les annotateurs accordent trop d'importance à la fluidité linguistique, il peut attribuer de hauts scores à des réponses avec de beaux mots mais contenant des fautes factuelles. Par conséquent, le modèle de récompense ne comprend pas vraiment ce qu'est une réponse correcte, mais imite simplement les régles d'évaluation reflétées dans les données de préférences. C'est pourquoi, après l'entraînement du modèle de récompense, il faut également effectuer une évaluation séparée.
En raison du fait que le modèle de récompense ne modifie pas directement le modèle de langage, par la suite, dans les phases de PPO, GRPO, etc., le modèle de stratégie continue de générer de nouvelles réponses, le modèle de récompense les note, et l'algorithme de renforcement met à jour les paramètres du modèle en fonction des résultats de récompense, faisant en sorte que le modèle augmente la probabilité de générer des réponses avec de hauts scores. Il est important de noter que si le modèle de stratégie découvre certains schémas de surface qui peuvent régulièrement obtenir de hauts scores, il pourrait répéter l'utilisation de ces schémas, au lieu de véritablement améliorer les capacités de la tâche, phénomène souvent appelé Reward Hacking (Hacking de la récompense). Par conséquent, le modèle de récompense doit non seulement distinguer les réponses optimales et moins optimales dans les données d'entraînement, mais aussi éviter d'être « trompé » par des caractéristiques de surface simples comme la longueur, des expressions fixes, des modèles de format.
RLHF (Reinforcement Learning from Human Feedback) est souvent appelé apprentissage par renforcement basé sur la rétroaction humaine. Il décrit comment la rétroaction humaine entre dans l'entraînement par renforcement, il s'agit d'un cadre d'entraînement, pas d'un algorithme d'optimisation spécifique, ni d'une structure de modèle fixe.
La voie classique de RLHF inclut trois étapes :
La voie classique de RLHF est divisée en trois étapes continues comme suit. La première étape est effectuée par les annotateurs qui écrivent des réponses de démonstration, et ces données sont utilisées pour terminer le SFT. La deuxième étape fait que le modèle génère plusieurs réponses pour le même prompt, puis les annotateurs les trient, et les données de comparaison sont utilisées pour entraîner le modèle de récompense. La troisième étape fait que le modèle de stratégie génère de nouvelles réponses, le modèle de récompense les note, et l'algorithme de PPO met à jour le modèle. Les trois types de données ont des rôles différents : les données de démonstration enseignent au modèle « comment répondre », les données de comparaison enseignent au modèle de récompense « comment évaluer », et le prompt et le signal de récompense sont utilisés pour l'apprentissage par renforcement.
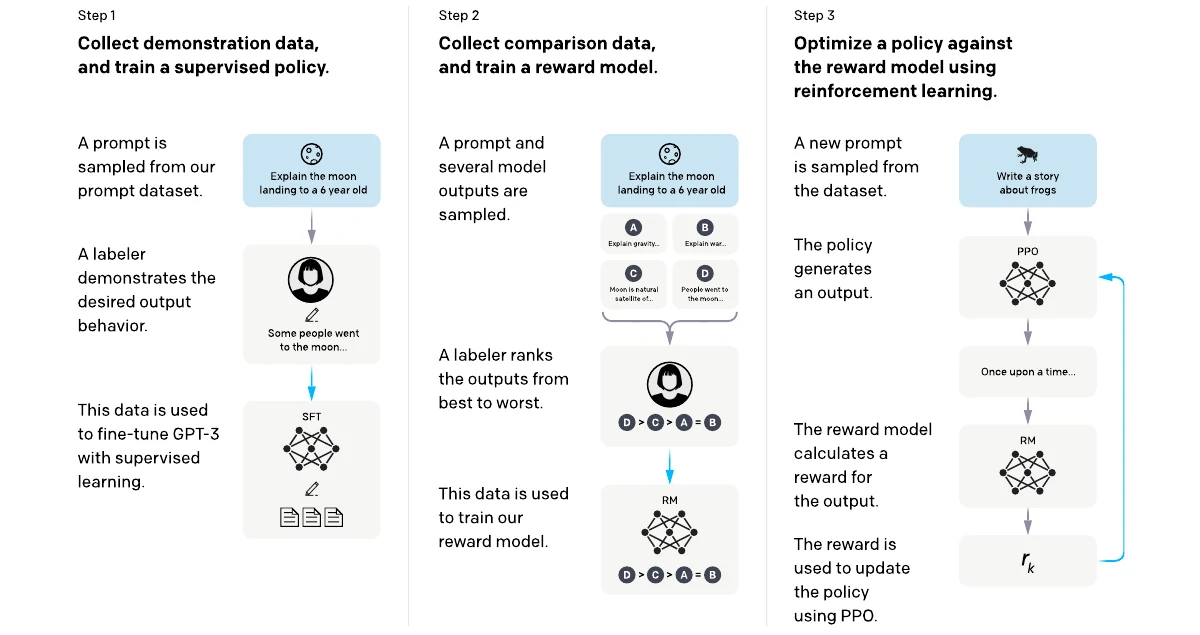
En plaçant ce processus dans le concept d'apprentissage par renforcement, le modèle de langage est le modèle de stratégie, le prompt et les tokens déjà générés forment l'état courant, le choix du prochain token par le modèle correspond à une action, et le passage de l'ouverture de réponse à la fin de génération constitue une trajectoire complète.
Dans le RLHF, le modèle de récompense donne généralement un score global à la fin de la réponse, et l'algorithme de renforcement décide ensuite quels choix de token augmenter la probabilité. L'entraînement par RLHF conserve également généralement un modèle de référence. Le modèle de référence est généralement le modèle SFT gelé, utilisé pour empêcher le modèle de stratégie en entraînement de s'éloigner trop de ses capacités de langage initiales.
PPO (Proximal Policy Optimization) est une algorithme de gradient de stratégie, son objectif principal est d'augmenter la récompense tout en limitant l'amplitude de chaque mise à jour de paramètres. Les grands modèles ont beaucoup de paramètres, si un lot de réponses obtient des scores élevés, le modèle peut rapidement se concentrer sur quelques modèles de récompense, voire détruire ses capacités de langage initiales. Le « proximal » dans PPO met l'accent sur le fait que la nouvelle stratégie doit être mise à jour de manière progressive autour de l'ancienne stratégie. Dans le post-traitement des grands modèles, une itération de PPO inclut généralement deux phases. La première est l'échantillonnage : extraire un lot d'entrées de la collection de prompts, faire le modèle de stratégie actuel générer des réponses, enregistrer la probabilité du token pour le token actuel dans l'ancienne stratégie, puis donner des scores par le modèle de récompense. La deuxième phase est la mise à jour : calculer l'avantage en fonction des récompenses et des estimations de valeur, utiliser ces échantillons pour mettre à jour le modèle de stratégie et le modèle de valeur. Après plusieurs petites mises à jour par lot, on utilise le nouveau modèle de stratégie pour générer de nouvelles données.
PPO compare la probabilité du token pour le token donné par la stratégie nouvelle et la stratégie ancienne. Le ratio de probabilité peut être simplifié en :
r_t(\theta)
=
\frac{\text{probabilité de la nouvelle stratégie de choisir le token actuel}}
{\text{probabilité de l'ancienne stratégie de choisir le token actuel}}
où rₜ est le score calculé, θ est le modèle à optimiser.
Lorsque rₜ est proche de 1, cela signifie que les stratégies nouvelles et anciennes sont similaires ; lorsque rₜ est nettement supérieur à 1, cela signifie que la nouvelle stratégie est plus préférentielle pour le token actuel ; lorsque rₜ est nettement inférieur à 1, cela signifie que la nouvelle stratégie a réduit sa probabilité. Cependant, la variation de probabilité seule n'est pas suffisante, il faut aussi l'avantage Aₜ pour déterminer si le choix du token est meilleur ou moins bon. L'avantage positif doit augmenter la probabilité de cette sélection, tandis qu'un avantage négatif doit la réduire.
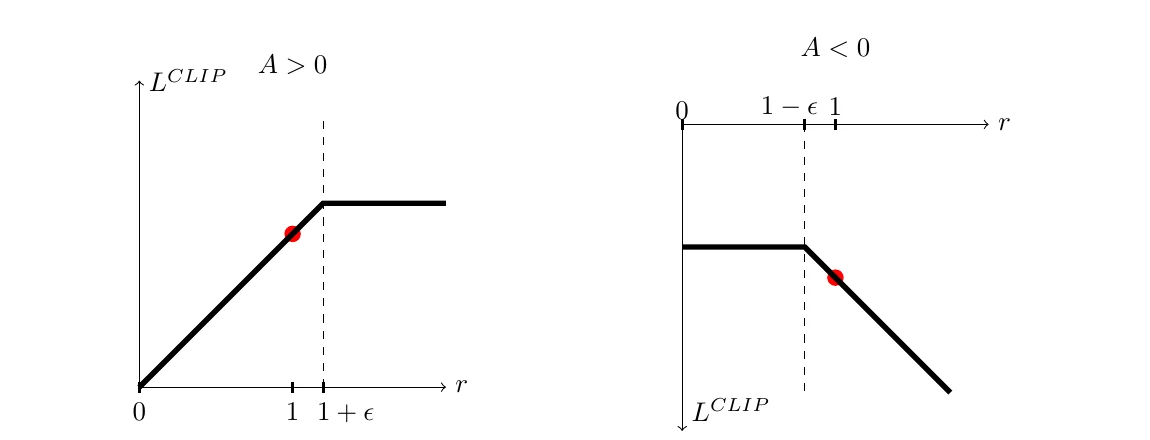
La figure de gauche représente le cas où l'avantage est positif. Lorsque le ratio de probabilité augmente de 1 vers la droite, l'objectif augmente d'abord ; après avoir dépassé 1+ε, la courbe se plonge, et augmenter davantage la probabilité de ce token ne améliore plus l'objectif. La figure de droite représente le cas où l'avantage est négatif. Lorsque le ratio de probabilité descend sous 1-ε, l'objectif ne s'améliore plus. Les deux courbes montrent que PPO permet à la stratégie de s'ajuster dans la bonne direction, mais atténue les bénéfices supplémentaires provenant d'une mise à jour excessive.
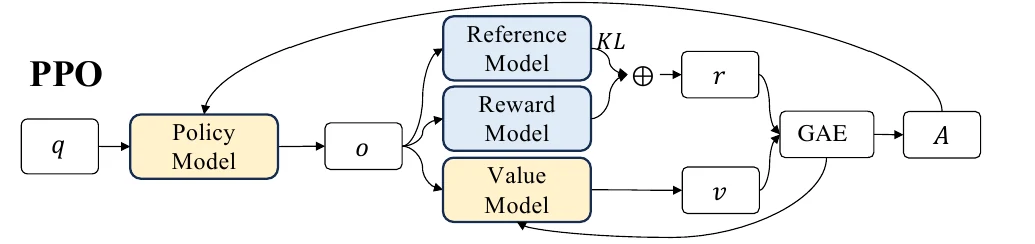
Une formation typique de PPO pour un grand modèle nécessite de maintenir plusieurs composants : le modèle de stratégie est responsable de générer et de recevoir des mises à jour ; la stratégie ancienne est une capture d'écran des paramètres de stratégie lors de l'échantillonnage, utilisée pour calculer le ratio de probabilité ; le modèle de référence est un modèle gelé de SFT, utilisé pour calculer la contrainte de KL ; le modèle de récompense évalue les réponses complètes ; le modèle de valeur est responsable de l'estimation des bénéfices possibles à chaque position de génération. L'estimation de valeur du modèle de valeur diffère de la récompense réelle, PPO utilise généralement des méthodes comme GAE (Generalized Advantage Estimation) pour organiser ces différences en avantages pour chaque token. Le processus global de PPO est illustré comme suit. Le modèle de stratégie génère une réponse o en fonction de l'entrée q, la récompense est formée par le modèle de récompense et le modèle de référence, l'estimation de valeur est v, puis l'avantage est calculé par GAE. Le modèle de stratégie est mis à jour en fonction de l'avantage et de l'objectif de troncature, et le modèle de valeur apprend une estimation plus précise des bénéfices par la perte de valeur.
GRPO (Group Relative Policy Optimization) est une variante de PPO, qui conserve les idées de échantillonnage de stratégie, de troncature du ratio de probabilité et de contrainte de KL, la principale différence étant qu'elle n'utilise plus un modèle de valeur séparé, mais utilise l'estimation de l'avantage relative au sein d'un groupe pour plusieurs réponses à la même entrée. Le cadre global de GRPO est illustré comme suit. Pour une entrée q, le modèle de stratégie génère un groupe de réponses o₁ à oG, et le modèle de récompense ou un système de règles donne des scores r₁ à rG.
Le système calcule d'abord la moyenne et l'écart-type des récompenses de ce groupe, puis transforme les scores de chaque réponse en avantage relatif au sein du groupe. Les réponses avec des scores supérieurs à la moyenne du groupe obtiennent un avantage positif, celles avec des scores inférieurs à la moyenne obtiennent un avantage négatif. Pour les tâches qui donnent une récompense globale à la fin de la réponse, les tokens dans la même réponse partagent l'avantage relatif obtenu par cette réponse ; si des récompenses de processus sont fournies, on peut créer un retour de feedback plus fin au niveau des tokens. Ensuite, GRPO compare comme PPO le ratio de probabilité entre les stratégies nouvelles et anciennes, et met à jour le modèle de stratégie par la troncature de l'objectif et la contrainte de KL.
Par rapport à PPO, GRPO réduit les coûts de paramètres, de mémoire visible et de formation dus au modèle de valeur, mais cela ne signifie pas que le coût de formation est nécessairement faible. Chaque prompt nécessite de générer plusieurs réponses, et le sampling de réponses consomme beaucoup de ressources de calcul. Si les scores des réponses dans un groupe sont identiques, l'écart-type est proche de 0, la comparaison au sein du groupe ne peut pas fournir d'indicateurs efficaces, et la mise en œuvre nécessite de sauter, de l'aplatir ou de re-samplifier ces données. La taille du groupe, la température d'échantillonnage, l'échelle de récompense et le coefficient de KL influencent également la stabilité de l'entraînement. Par exemple, pour un problème mathématique, on génère quatre réponses, deux sont correctes, une a une erreur de calcul, une n'est pas terminée. Le système peut utiliser des règles de vérification de réponse pour les noter, puis comparer les résultats au sein des quatre résultats. La réponse correcte et complète obtient un avantage élevé, les réponses incorrectes ou non terminées obtiennent un avantage faible, le modèle augmente ainsi la probabilité de la meilleure solution. Pour les tâches de code, on peut utiliser les résultats de compilation et les tests unitaires comme récompense, sans nécessairement entraîner un modèle de récompense séparé.
DPO (Direct Preference Optimization). Dans le titre de son article, les auteurs indiquent