Image LoRA with DiffSynth
Personnalisation ? Entraîner une LoRA d'image avec DiffSynth
Dans les applications réelles, un modèle de génération d'images générique n'est pas toujours capable de générer avec précision des personnages, des produits ou des styles d'image spécifiques. Si l'on souhaite que le modèle génère des caractéristiques visuelles spécifiques, telles que des personnages, des produits ou des styles, on peut utiliser LoRA pour le entraîner. Ce chapitre présente d'abord les concepts fondamentaux des modèles de génération d'images et de LoRA, puis utilise DiffSynth pour effectuer un entraînement de LoRA d'image.
Un seul prompt, comment il devient une image ?
Actuellement, les modèles de génération d'images courants sont composés principalement d'un encodeur de texte, d'un modèle de diffusion et d'un VAE. Après que l'utilisateur entre un prompt, le modèle comprend d'abord le contenu du texte, génère ensuite progressivement des caractéristiques d'image, puis convertit ces caractéristiques en images directement visibles.
L'encodeur de texte est responsable de comprendre le prompt, en transformant le texte en des caractéristiques textuelles que le modèle peut traiter. Par exemple, pour l'entrée "un chat orange portant des lunettes assis sur une plage", l'encodeur de texte codera "chat orange", "lunettes", "plage" et autres éléments, fournissant des conditions pour la génération d'image ultérieure.
Le modèle de diffusion est le composant central de la génération d'image. Il commence avec du bruit aléatoire, en se basant sur les caractéristiques textuelles pour supprimer progressivement le bruit par plusieurs calculs, formant ainsi les objets, les couleurs et les structures de l'image. Par exemple, lors de la génération de l'image précédente, la scène initiale est juste du bruit aléatoire, et après plusieurs itérations, le chat orange, les lunettes et la plage se formeront progressivement.
Le VAE (Variational Autoencoder, autoencodeur variational) est responsable de la conversion entre l'espace d'images et l'espace de caractéristiques. Pour réduire le coût de calcul, le modèle de diffusion ne calcule généralement pas directement sur des images de haute résolution, mais dans un espace de caractéristiques compressées. Après la génération, le VAE convertit les caractéristiques d'image en l'image finale.
En combinant ces composants, un processus de génération de texte vers image de base est le suivant :
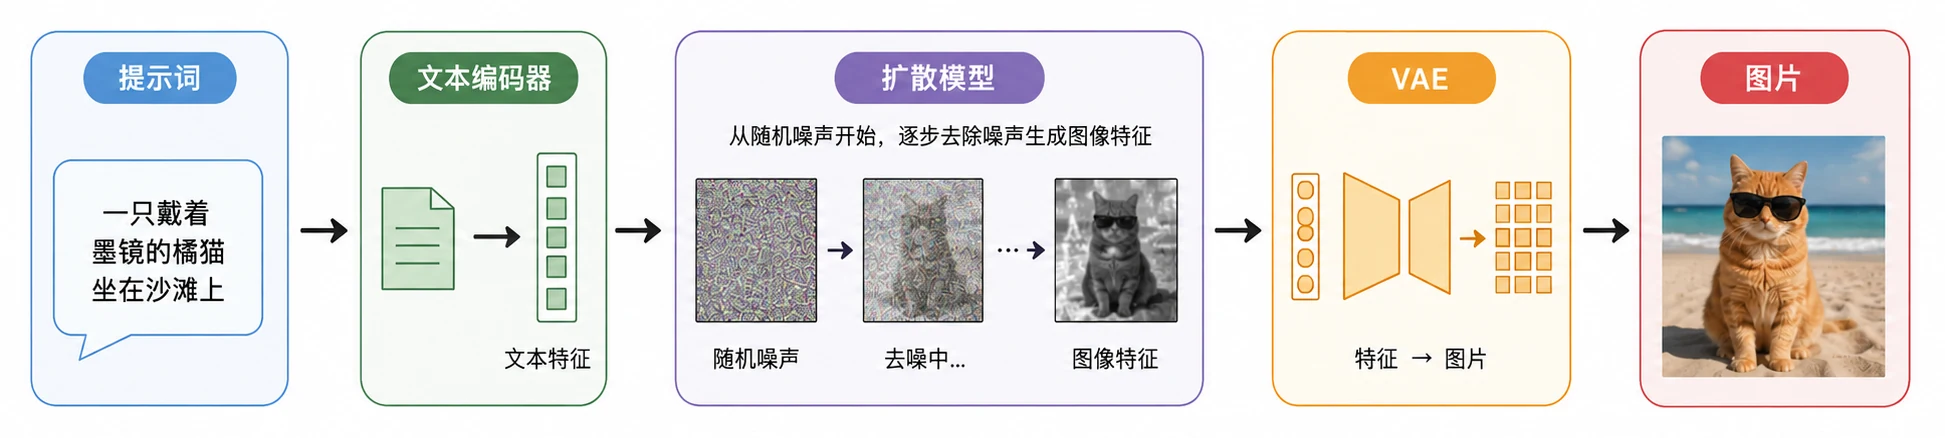
Après que l'utilisateur entre un prompt, le modèle passe par des étapes de codage de texte, génération de caractéristiques d'image et réduction d'image, pour finalement obtenir l'image. Les modèles de génération d'images différents peuvent avoir des structures spécifiques, mais le processus global doit convertir l'entrée de texte en sortie d'image.
Pour que le modèle dessine mieux, qu'est-ce que la LoRA d'image peut faire ?
Les modèles de génération d'images génériques sont généralement entraînés avec un grand nombre d'images, ce qui leur permet de générer divers types de contenu, mais les résultats de génération pour des personnages, des produits ou des styles d'image spécifiques peuvent ne pas être assez précis.
Par exemple, si l'on souhaite que le modèle génère un produit spécifique, même si le prompt contient une description détaillée de la couleur, de la forme et de l'apparence du produit, les résultats de génération peuvent différer considérablement du produit réel.
On peut entraîner le modèle pour qu'il apprenne ces nouvelles caractéristiques visuelles, mais réentraîner tout le modèle nécessite de grandes quantités de données d'entraînement et de ressources de calcul. Pour l'apprentissage de ces caractéristiques spécifiques, on peut utiliser la méthode d'entraînement paramétrique efficace LoRA, son principe est expliqué dans la section 9.2 de cet article. Pendant l'entraînement, la plupart des paramètres du modèle original sont gelés, seuls les nouveaux paramètres sont entraînés, ce qui permet au modèle d'apprendre de nouvelles caractéristiques.
Pour entraîner une LoRA d'image, il suffit de préparer un petit nombre d'images cibles pour que le modèle apprenne des caractéristiques visuelles spécifiques, telles que des personnages, des produits, des styles ou d'autres éléments. Après l'entraînement, le fichier LoRA obtenu est beaucoup plus petit que le modèle complet. Lors de l'utilisation, on charge le modèle original, puis le LoRA correspondant, et on peut utiliser les caractéristiques visuelles nouvellement appris.
Avant l'entraînement, il faut clarifier ce que le modèle doit apprendre
En fonction des objectifs d'apprentissage, la LoRA d'image peut être classée en LoRA de style, LoRA de personnage, LoRA de produit et LoRA de concept, etc.
LoRA de style
La LoRA de style apprend le style visuel global de l'image : la couleur, les lignes, la composition, la manière de présenter. Pour l'entraînement, il faut préparer un groupe d'images de style similaire, les contenus des images peuvent être différents, mais le style global doit rester cohérent.
Par exemple : en utilisant un groupe d'images dans le style de l'encre et du papier (xuěshuǐhuà), on peut entraîner une LoRA de style
Discussion
Se connecter pour rejoindre la discussion